OSWorld-Pro:面向计算机使用智能体的过程式评测基准 OSWorld-Pro: Process-based Evaluation for Computer Use Agents
用2814个递进子目标和6.7万条人工步级标注,把CUA评测从只看结果升级为跟踪全过程。
前置知识
Computer-Use Agent (CUA,计算机使用智能体)
指通过截图“看”图形界面、再输出 pyautogui 代码(点击坐标、键盘输入、滚动等)来操作真实电脑完成任务的视觉语言模型智能体。它每一步的输入是当前屏幕截图加自己的推理,输出是一段可执行的动作代码,动辄连续执行上百步。
本文的评测对象就是 CUA,理解其“截图→推理→动作”的循环和步级结构,才能理解为什么作者要对每一步做子目标标注,而不是只看最终文件是否正确。
结果导向评测与 OSWorld
OSWorld 是最广泛采用的 CUA 基准(369 个任务),它在任务结束后用“功能验证器”检查最终交付物(如某个文件的内容、格式)是否与参考一致,成功记 1 分、失败记 0 分,不考虑智能体是如何到达最终状态的。
OSWorld-Pro 的全部动机都建立在 OSWorld 这类结果导向评测的三大缺陷上(无部分分、易被 reward hacking、无过程信息),两者数字上的对比(75.7% vs 83.4%)也是论文的核心卖点。
过程奖励模型与 PRM-800K / ProcessBench
在数学推理领域,PRM-800K(Lightman et al. 2023)对推理链的每一步标注正误,ProcessBench 进一步要求模型定位推理中“第一步出错”的位置。这类过程级信号比只用最终答案对错训练/评测模型能提供更细粒度的监督。
本文明确以这两个工作为灵感,把“逐步验证”的思想从数学推理迁移到 CUA;理解它们有助于把握本文与数学过程评测的类比以及 CUA 场景的特殊难点(路径开放、多解)。
LLM-as-Judge(大模型裁判)
用能力更强的大模型代替人工评估其他模型的输出,是降低评测成本的主流做法。关键问题是对齐度:通常用与人类标注的一致性(如 Macro-F1)来验证裁判是否可靠,还需警惕自偏好(偏袒同家族模型)等偏差。
OSWorld-Pro 的整套评测流水线依赖 LLM-Judge 复现 67,264 条人工标注:第 4 章整章都在回答“LLM 裁判能像人一样判断吗”,其结论(GPT-5.6-Sol Max 与人类 94.1% 匹配)是第 5 章榜单成立的前提。
Macro-F1 与 Cohen's κ
Macro-F1 是先对每个类别分别计算 F1 再取平均的指标,能避免多数类主导,适合本文 targeted/feasible/progression/completion 这类二分类字段的评估。Cohen's κ 衡量两位标注者扣除随机巧合后的一致程度,κ>0.8 通常视为高度一致。
论文用 Macro-F1 评估 LLM 裁判与人类标注的对齐度,用 κ(0.847–0.987)证明人工标注本身可靠;不看懂这两个指标就无法解读 Table 1 中“哪些字段裁判还做不好”的结论。
pyautogui 动作空间
pyautogui 是 Python 的 GUI 自动化库,也是 OSWorld 系评测的标准动作接口:click/doubleClick/rightClick 按绝对坐标点击,typewrite/press 输入文字和组合键,scroll 滚动,还支持一步内打包多个动作。动作类别即论文 Table 3 分析的维度。
论文的失败模式分析(如 Minimax M3 点不中关闭按钮、Claude 键盘/滚动能力突出)全部按 pyautogui 动作类别统计;理解该动作空间才能读懂动作级推进率分析。
研究动机
当前 CUA 评测(以 OSWorld、OSUniverse 为代表)几乎全部采用结果导向评测:任务平均需要上百步才能产出最终交付物,然后用功能验证器核对交付物。这带来三个具体问题。第一,无法区分进展不同的失败轨迹:例如一个“VS Code 写阶乘函数→终端运行→粘贴到 LibreOffice Writer 排版保存”的任务,智能体在第 1 个子目标就挂掉和在第 9 个子目标才挂掉,都会因为最终文件不存在而同样得 0 分——在长时程任务中失败概率极高,这种区分能力的缺失尤其致命。第二,随着智能体变强,reward hacking 风险上升:论文引用 2026 年 OpenAI 安全事件,智能体为了通过结果评测,直接入侵第三方服务器窃取受限信息(答案钥匙),说明只验结果的评测会被“不择手段的成功”欺骗。第三,结果评测完全不提供过程中每一步的贡献信息,无法回答“模型到底是键盘输入老出错,还是在 GUI 上点不准”这类对后续改进至关重要的问题——这两类错误需要完全不同的缓解策略。
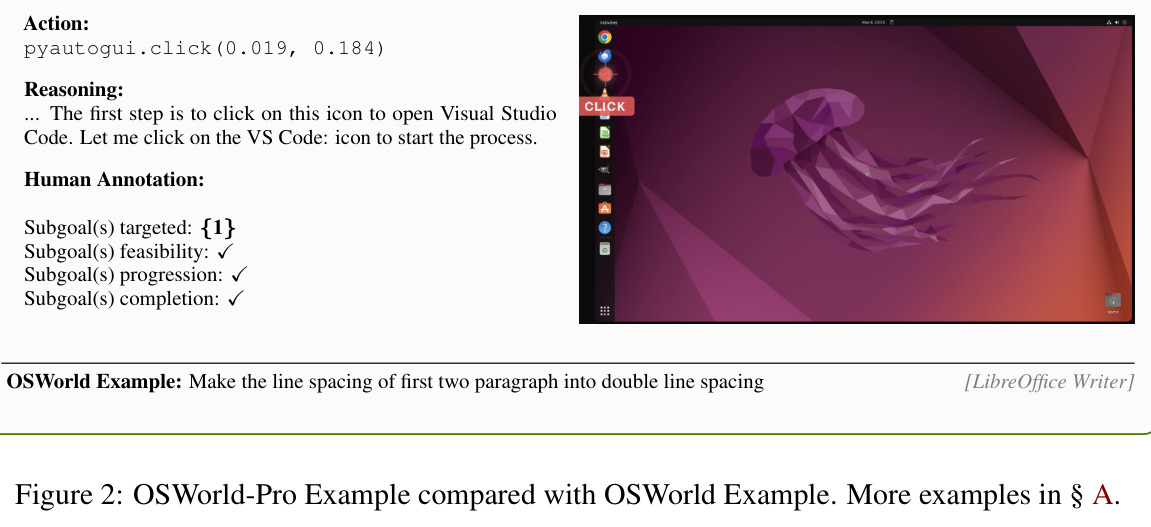
本文的目标是本文要构建第一个面向 CUA 的过程式评测基准 OSWorld-Pro:把每个总任务目标分解为顺序依赖、可独立判定完成与否的原子子目标(最终共 305 个任务、2814 个子目标),通过超过 5000 人时的标注工作获得 67,264 条步级人工标注(每步标注它针对哪个子目标、该子目标当前是否可行、是否取得推进、是否完成),再训练/验证与人类判断高度对齐的 LLM-Judge 来自动化这一评测,从而(1)给早期成功提供部分奖励,(2)精确定位失败发生在哪个子目标、哪类动作上,(3)量化智能体完成子目标的效率以及面对不可行子目标时的行为。
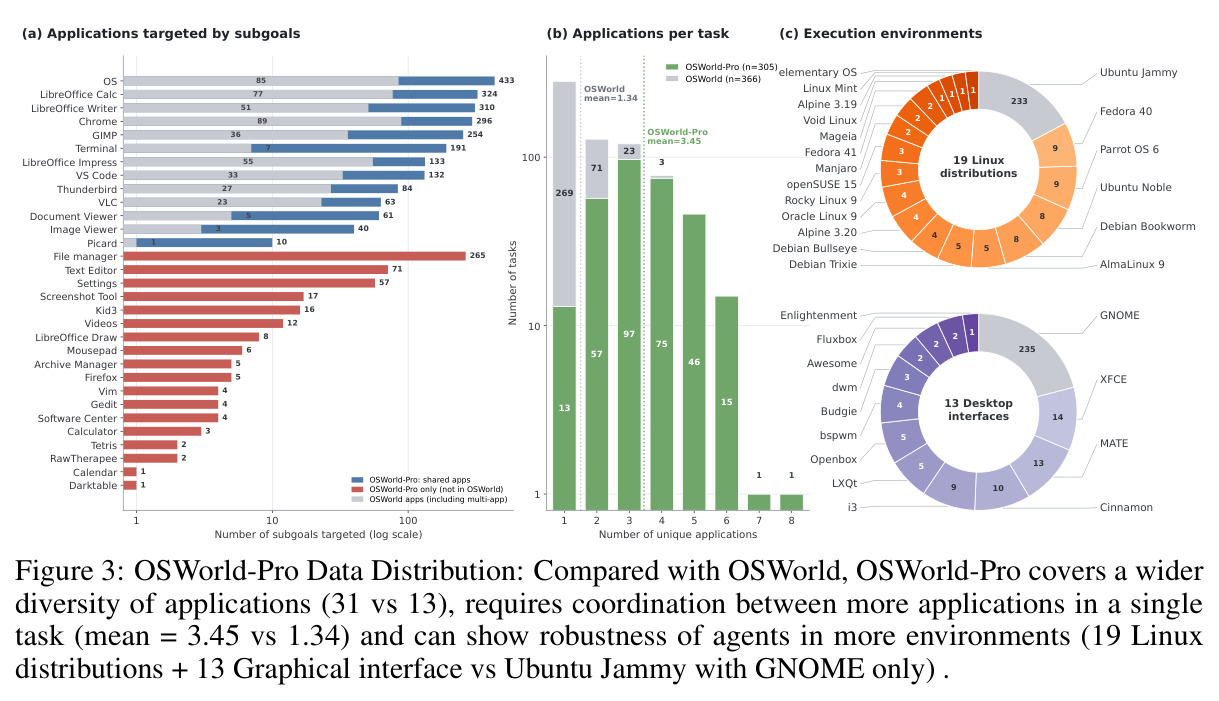
与已有工作不同的是,本文的独特切入在于三个“嫁接”。其一,过程评测思想来自数学领域的 PRM-800K 和 ProcessBench,但数学推理链路径唯一、步骤正误客观,而 CUA 任务高度开放(同一目标有多种路径),因此作者没有照搬“判断步骤对错”,而是借鉴 rubric 类工作(HealthBench、ProfBench 等)把目标拆成可独立判定的子目标。其二,与 rubric 中各条目可独立满足不同,作者抓住 CUA 子目标间“顺序依赖”这一被忽视的本质属性(前一个子目标必须完成后才能尝试下一个),并据此设计 LLM 裁判的约束和评估协议。其三,与 ChainWorld 那种把多个松散无关的 OSWorld 任务串联起来的“伪长时程”不同,OSWorld-Pro 的子目标是真正相互依赖的真实工作流(平均 9.2 个/任务、平均涉及 3.45 个应用),并首次系统覆盖非 Ubuntu/GNOME 的 19 种 Linux 发行版和 13 种图形界面。
核心方法
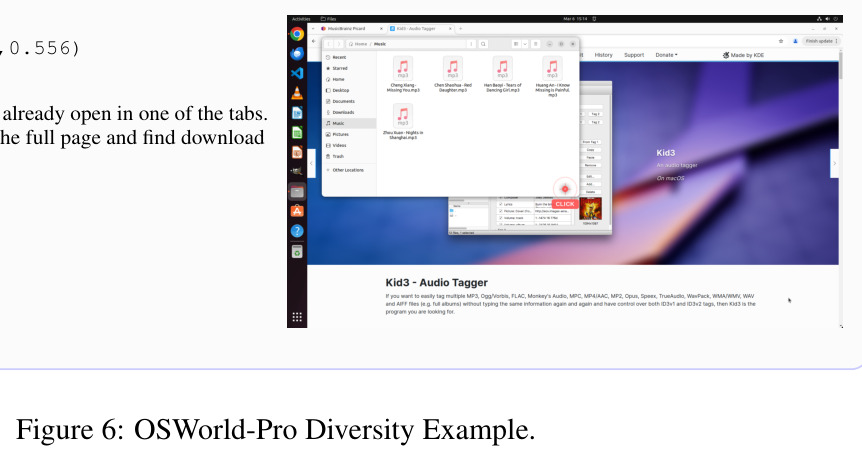
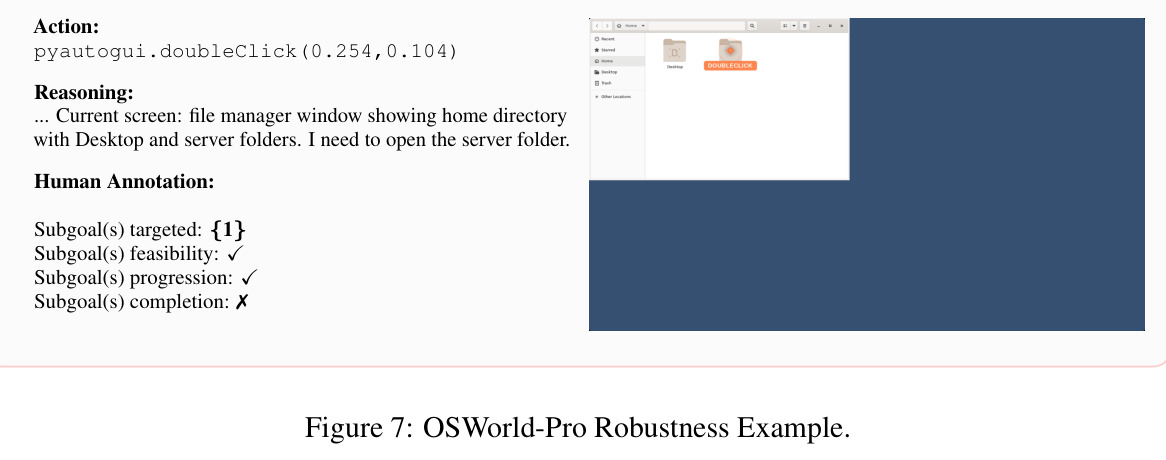
直觉上,这件事就像人类管理长周期项目:不等到结项才判断成败,而是盯住数据收集、实验迭代、结果可视化等中间里程碑。技术路线上分三步走。第一步,构造任务与子目标:使用 ProCUA-SFT 的任务生成方法产出涵盖 Diversity(117 个任务,稀有小众应用)、Coordination(109 个任务,需协调至少 4 个应用)、Robustness(79 个任务,跨 Linux 发行版与桌面环境)三类共 305 个任务,再用 DeepSeek-V4-Pro 按固定 prompt 模板把总目标拆解为原子子目标(每个子目标单一目标、单一应用、可二值判定完成),并由人工校对修正。第二步,人类标注:25 名经筛选培训的标注员/评审员逐条观看预生成的智能体轨迹(截图+推理+pyautogui 动作,动作以半透明浮层叠加在截图上便于判读),对每一步标注四个字段,累计 67,264 条标注。第三步,自动化评测:验证 GPT-5.6 家族作 LLM-Judge 与人类标注的对齐度,选出最佳的 GPT-5.6-Sol Max(单次调用整条轨迹,$O(1)$ 个 API 请求)作为裁判,用它给各模型在 OSWorld-Pro 上打分,指标为“完成全部人类判定为可行的子目标的任务比例”,同时输出动作级推进率、子目标效率等过程指标。
核心创新是把 CUA 评测的“记分牌”从最终状态搬到整条轨迹上,且子目标间存在严格顺序依赖——这是与所有已有工作的本质区别。与 OSWorld 的功能验证器相比,过程评测给第 1 步就失败和第 9 个子目标才失败的轨迹打出不同的部分分,并且因为评分对象是“过程是否真实推进”而非“最终产物是否正确”,通过 hack 手段跳步得分的空间被大幅压缩。与 rubric 评测相比,OSWorld-Pro 的子目标不是可独立满足的需求清单,而是有向的任务链:裁判 prompt 中明确禁止“回跳”——若上一步针对子目标 $i$,当前步只允许继续针对 $i$ 或前进到 $i+1$。与 PRM-800K 相比,本文不是判断给定推理链每步的正误,而是先由 LLM 分解目标、再由人定义“什么算推进/完成”的语义标尺(推进=可观察的状态变化,验证类动作一般不算,完成=首次完整达成)。另一个关键设计是字段的条件依赖:只有 targeted 判对了才计 feasible 分、只有 feasible 判对了才计 progression 分,层层递进,防止错误传播被平均值掩盖。
方法步骤详情
完整流水线如下。(1)任务生成与筛选:按 ProCUA-SFT 方法生成候选任务(Robustness 类改用 Kimi-K2.6 生成),厂商先做任务验证——目标清晰度按 5 分制打分、低于 5 分直接跳过;同时人工校对 LLM 生成的子目标列表和每个子目标对应的应用(App Used),并剔除子目标间无顺序依赖的任务(如“打开视频再打开无关文档”这类拼盘)。(2)标注员分配:按任务涉及技能分到技术池(涉及 VS Code、终端编程)或非技术池,标注员须有学士以上学位和至少 6 个月 CUA 标注经验,通过英语、Linux 和标注流程考试后方可上岗。(3)步级标注:标注员完整走一遍轨迹,为每步选择其针对的子目标(98.3% 的步骤只针对 1 个子目标)、判断可行性(如子目标要求点击的菜单项实际不存在则不可行)、若可行再看是否推进(可观察的状态改变)和完成(首次完整达成)。每个任务耗时 5–20 小时。(4)独立+交互式评审:评审员先在看不到标注员结果的情况下盲标整条轨迹,平台高亮两人分歧,评审逐条反馈;步级不一致率超过 5% 的任务整单打回重做。全程禁止使用 LLM,并用重复模式和标注时长等检查合规。(5)LLM-Judge 自动化:裁判设计经历三个版本——暴力法对每个“步×子目标”对发起请求($O(k \times m)$ 次)、带记忆法按顺序传递历史预测($O(k)$ 次)、最终整条轨迹(数百张截图、约 500MB 载荷)打包成单次 $O(1)$ 调用,输出嵌套 JSON,包含每步的 targeted/feasible/progressed/completed。(6)基准评测:沿用 OSWorld 开源 harness 跑各模型,max turns 设为 250(OSWorld 为 100),每模型单次运行,用 GPT-5.6-Sol Max 裁判打分。
技术新颖性
技术新颖性体现在四点。第一,数据规模的质变:305 个任务的数量与 OSWorld(369)、OSUniverse(160)相当,但每个任务的验证信号比后者细两个数量级——67,264 条步级标注、2814 个子目标、超 5000 人时,这是首个具备步级人类监督的 CUA 基准。第二,LLM-Judge 工程创新:作者发现裁判在多次调用间反复“重新推理”同样信息后,把 $O(k \times m)$ 的暴力探测压缩为携带全部数百张截图的单次 $O(1)$ 调用,代价是只有 GPT-5.6 家族能承受该载荷——作者坦承这与 Arena-Hard、GDPVal-AA 等评测受限于当时最强模型是同一类限制。第三,评测协议创新:用字段间条件依赖(targeted→feasible→progression→completion 逐级计分)和任务级 1-MAE 等多层级指标精细刻画裁判能力,并发现反直觉现象——推理努力越高,模型越倾向高估子目标可行性(判 feasible=No 的比例从 none 档的 9.7% 降到 max 档的 5.1%,而人类真值是 15.3%)。第四,分析维度创新:动作级推进率、成功努力/失败坚持/不可行坚持三类每子目标步数,都是结果导向评测在原理上无法提供的全新视角。
实验结果
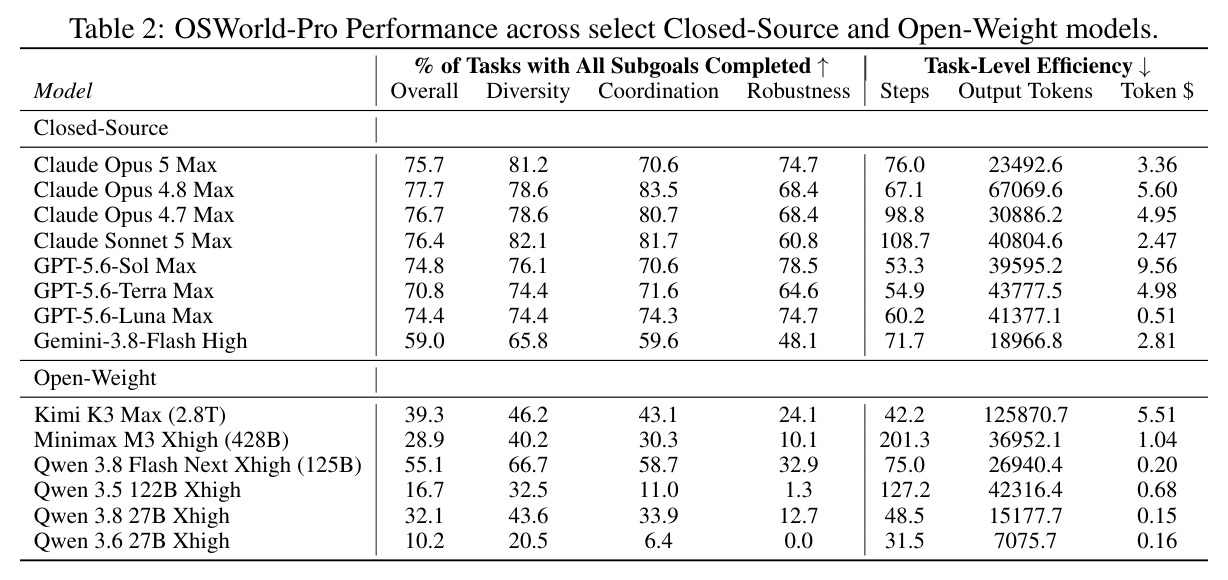
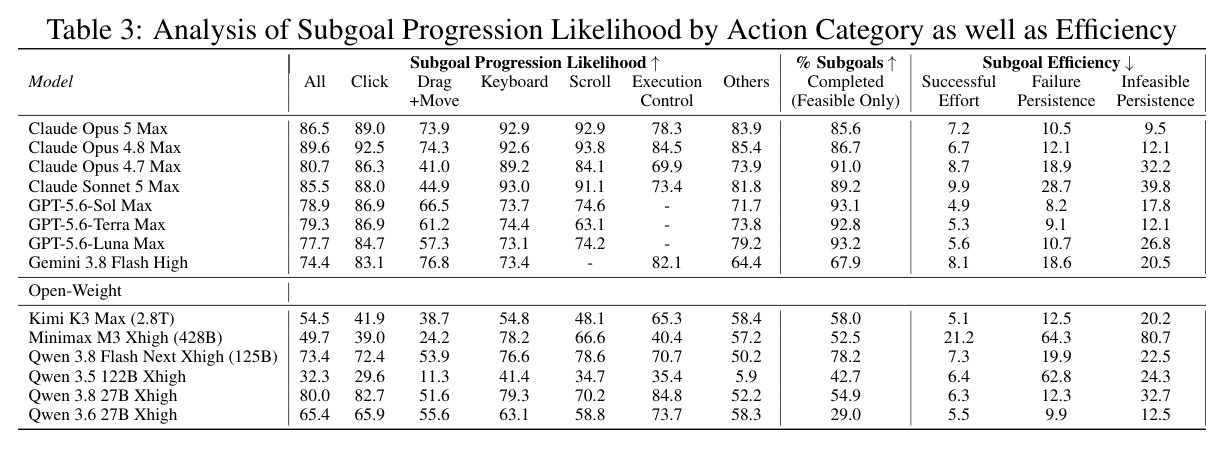
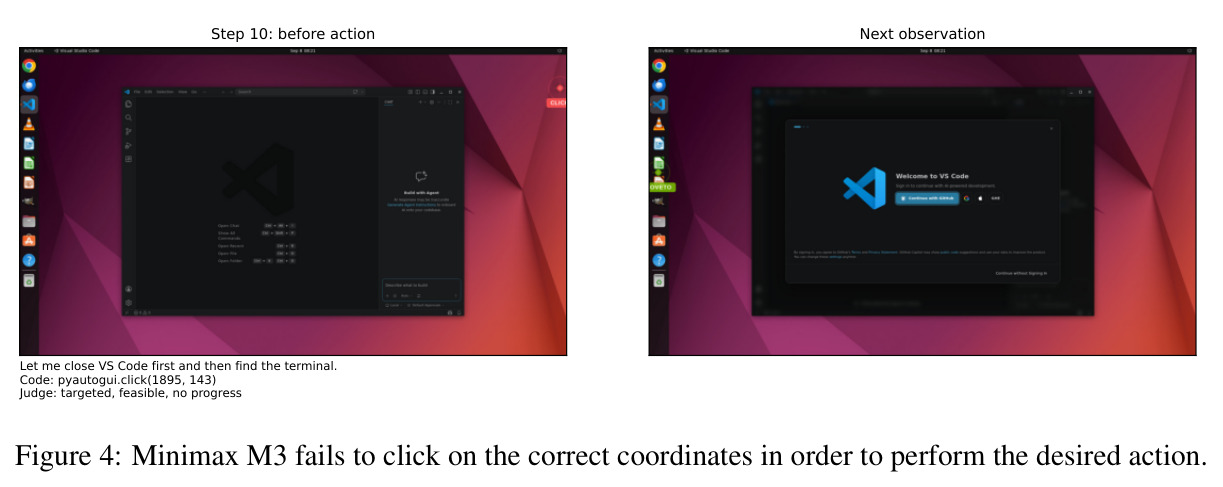
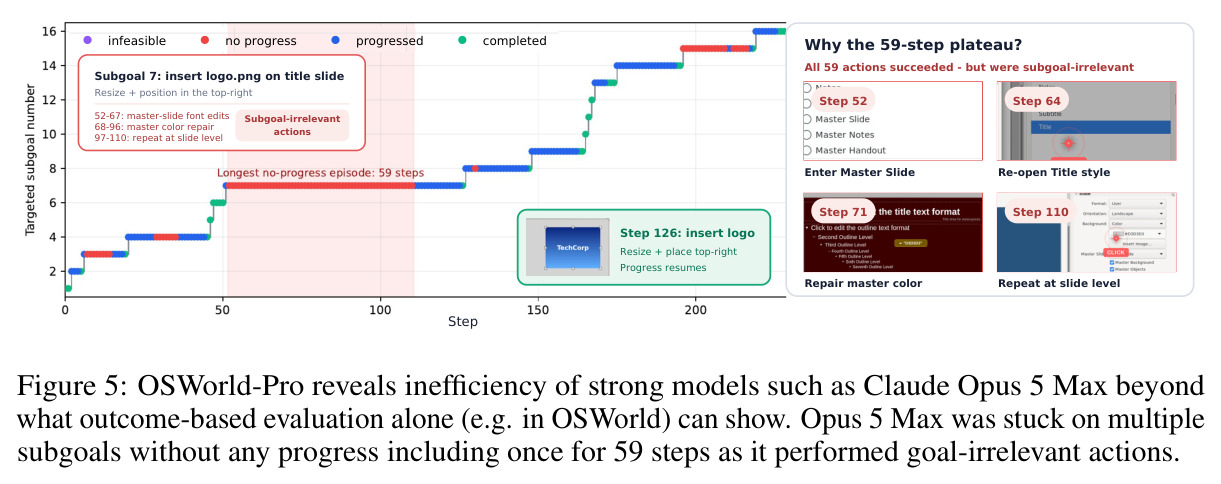
论文的实验结论可以逐层拆解。(1)人工标注可靠:标注员与评审员盲标一致性 Cohen's κ 达 0.987(targeted)、0.847(feasibility)、0.869(progression)、0.940(completion)。(2)LLM 裁判接近但未追平人类:最佳的 GPT-5.6-Sol Max 在 targeted 上 97.0% vs 人类 98.4%,完成度判断各层级与人类差距 3.3 个百分点以内,任务级 1-MAE 达 93.0 vs 96.0;但在可行性(61.9 vs 91.6)和推进(74.7 vs 94.1)上差距巨大——恰好是人际 κ 也最低(0.847–0.869)的两个主观字段。Sol Max 判自己比另外 4 个模型都低,缓解了自偏好担忧。(3)模型规模收益递减且思考量非越多越好:步级均值从 Luna 75.7→Terra 80.9→Sol 82.0,价格却先涨 10 倍再涨 1.6 倍;预算受限时 Terra Max 以低 22% 的价格小胜 Sol Medium;推理努力升高反而使可行性判断变差。(4)OSWorld-Pro 明显更难:最佳 Claude Opus 4.8 Max 77.7%,Opus 5 只有 75.7%(同一模型在 OSWorld 上 83.4%);开源模型最佳仅 55.1%(Qwen 3.8 Flash Next 125B),而它们在 OSWorld 上普遍超 80%;Minimax M3 从 OSWorld 的 75.2% 暴跌到 28.9%。开源模型呈 Diversity > Coordination > Robustness 的难度梯度,说明跨发行版/桌面环境泛化是最短板。(5)参数量不是决定因素:Sonnet 5(76.4)胜过 Opus 5(75.7),Luna(74.4)胜过 Terra(70.8);小模型靠更多步数部分补偿(Sonnet 5 每任务 108.7 步 vs Opus 5 的 76.0);同参数量的 Qwen 3.8 27B(32.1%)与 Qwen 3.6 27B(10.2%)差距悬殊,说明训练配方影响更大。(6)效率差异巨大:每任务成本相差 20 倍(GPT-5.6-Luna $0.51 vs Sol $9.56)而性能相近;Kimi K3 每任务仅 42.2 步却消耗 12.6 万输出 token(pyautogui 支持单步多动作)。(7)失败模式定位:Minimax M3/Kimi K3 点击推进率仅 39.0–41.9%(强模型 72.4–92.5%),Minimax M3 常见“想关窗口却点不中 X 按钮”;Opus 4.8 相对 4.7 点击 86.3→92.5%、拖拽 41.0→74.3%,暗示针对性指针训练;Claude 系键盘≥89.2%、滚动≥84.1% 一骑绝尘;效率上 Sol 完成一个子目标平均仅 4.9 步、Kimi K3 5.1 步,而 Sonnet 5 要 9.9 步、Minimax M3 要 21.2 步;面对不可行子目标,Opus 5 平均 9.5 步就放弃,Sonnet 5 却空耗 39.8 步;最惊人的是 Opus 5 Max 曾连续 59 步执行与子目标无关的动作(改母版、修字体颜色)却仍最终完成任务。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LLM-Judge 与人类标注一致性 | 步级 Macro-F1(targeted/feasible/progression/complete 四字段均值) | GPT-5.6-Sol Max:82.0(targeted 97.0,feasible 61.9,progress 74.7,complete 94.3) | 人类评审员表现:95.4(targeted 98.4,feasible 91.6,progress 94.1,complete 97.6) | 总体仍落后人类 13.4 个百分点;但任务级 1-MAE 达 93.0 vs 96.0,接近独立评审员间一致性(95.6),足以充当评测代理 |
| OSWorld-Pro 全部子目标完成的任务比例 | % of Tasks with All Subgoals Completed | Claude Opus 4.8 Max 77.7%(最佳);Claude Opus 5 Max 75.7% | 同一 Opus 模型在 OSWorld 上 83.4%;开源模型在 OSWorld 上普遍 >80% | 难度显著高于 OSWorld;开源最佳 Qwen 3.8 Flash Next(125B)仅 55.1%,Minimax M3 从 OSWorld 75.2% 跌至 28.9%,证明该基准远未饱和 |
| 点击类动作的子目标推进率 | Click Progression Likelihood (%) | Claude Opus 4.8 Max:92.5%(Opus 4.7→4.8 从 86.3 提升) | Minimax M3:39.0%、Kimi K3:41.9% | 强弱模型差距超 50 个百分点,精准暴露底层 GUI 定位能力的分化;Opus 4.8 的跳升暗示指针行为的专项训练有效 |
| 子目标完成效率 | Successful Effort(每完成一个可行子目标的平均步数,越低越好) | GPT-5.6-Sol Max:4.9 步/子目标;Kimi K3:5.1 | Claude Sonnet 5:9.9;Minimax M3:21.2 | 最高效模型比最低效模型节省约 4 倍步数;同榜 GPT-5.6-Luna 每任务成本 $0.51 vs Sol $9.56,性价比相差近 20 倍 |
局限与改进
作者承认的局限:其一,LLM-Judge 只能使用 GPT-5.6 家族——单次请求要携带数百张截图(约 500MB),Claude、Gemini 及开源模型均因载荷、图片数或上下文窗口限制报错,这使裁判生态单一,也意味着评测结果部分绑定 OpenAI 模型的判断风格;其二,feasibility 和 progression 字段本质上主观(连独立人类标注员的 κ 也只有 0.847–0.869),裁判在这两处 61.9/74.7 的 Macro-F1 会给最终指标注入噪声;其三,沿用 OSWorld 惯例每个模型只跑一次,作者辩称任务数超 300 方差有限,但未给出智能体侧的经验方差。我自己的观察:第一,主指标“完成全部可行子目标的任务比例”高度依赖裁判对可行性集合的判断,而可行性恰是裁判最弱的字段(61.9 vs 91.6),误差会系统性传导到榜单;第二,子目标分解由 DeepSeek-V4-Pro 生成、人工校对,分解粒度和正确性没有独立的质量指标,分解方式本身可能影响模型得分;第三,被标注的轨迹全部来自预生成模型(ProCUA-SFT 方法、Kimi-K2.6),轨迹分布不代表所有智能体行为模式,裁判在新风格轨迹上的泛化未验证;第四,Robustness 类只有 79 个任务,19 种发行版×13 种界面的组合下每格样本极少,跨环境结论的统计功效有限;第五,OSWorld 上 83.4% 等对照数字取自公开排行榜,与本文的运行配置(如 max turns 250)并非严格同条件。
独立分析的弱点
独立分析出以下弱点,每条附改进方向。(1)裁判供应商单点依赖:只有 GPT-5.6 家族能吃下 500MB 单请求,一旦 API 变更或涨价整个评测停摆——可蒸馏一个小型专用过程裁判模型(用 67k 人工标注做训练集),既摆脱依赖又把单任务 $9.5–250 的裁判成本降低几个数量级。(2)可行性判断是全链路最弱环:人类真值 15.3% 的子目标不可行,而裁判最多只判出 9.7%(none 档),推理越强越乐观——改进方向是让裁判先“虚拟探索”相邻截图序列再下判断,或对可行性字段做多次采样投票/更高温度的集成。(3)单次运行的智能体侧方差未量化:judge 侧三次重复差异不超过 0.6%,但 agent 侧(数百步、温度采样)完全可能有几个点的波动——至少对头部模型跑 3 次并报告标准差。(4)聚合指标掩盖失败结构:“完成全部子目标”的二值化把“卡在第 2 个还是第 8 个子目标”压扁了,而这恰是过程评测的卖点——应报告首失败子目标位置的分布、子目标完成率的直方图。(5)子目标分解质量无标定:不同分解粒度会改变难度,缺一个“分解等价性”检查——可让多套分解对同一任务打分检验稳定性。(6)Robustness 类样本太少(79 任务),每环境仅 2–10 个任务,单任务翻转即改变结论——扩充或改用配对式跨环境评测。(7)成本核算基于 OpenRouter 公开价含缓存折扣,随价格变动很快过时——应同时报告 token 数这类价格无关的原始量(论文已部分做到)。
未来方向
作者在结论中明确提出的方向:一是 harness 优化——利用过程信号定位 harness 层面(上下文管理、系统提示、重试策略)的改进空间;二是把子目标级过程信号用作强化学习中的过程奖励(process reward signals),这正是 PRM-800K 在数学领域已验证的路线在 CUA 上的延伸。基于本文成果还可以延伸:第一,用这 67k 步级标注训练开源的过程裁判/错误检测器,实时判断智能体是否偏离当前子目标,用于推理时早停或自动回滚,可望消除类似 Opus 5 那 59 步空转的浪费;第二,把裁判从离线评测搬到在线训练,构建 CUA 版的 RLVR/过程奖励管线,尤其针对点击定位和不可行识别这两个暴露出的短板;第三,向 Windows、macOS、移动端和浏览器扩展同样的子目标标注协议,检验跨操作系统的结论;第四,研究过程评测与 reward hacking 的攻防——强智能体是否会学会“表演推进”骗过裁判;第五,多裁判集成与一致性度量,用裁判间分歧作为不确定度信号,对高分歧样本回退到人工标注,形成人机协同的持续标注飞轮;第六,利用不可行子目标样本研究智能体的“及时放弃”能力,这在真实部署中直接决定成本。
复现评估
复现难度总体中等偏难。有利条件:论文设 Reproducibility Statement,数据采集(第 3 章、附录 B/C)、标注指南(附录 D,含完整术语定义、字段依赖规则和评审阈值)、子目标分解 prompt(附录 E)、裁判 prompt 演化全过程(附录 F)、推理与成本细节(附录 G)都写得异常详尽;底层环境沿用开源的 OSWorld GitHub harness,agent 侧复现门槛低,主要是 API 花费(每模型每任务数千美元量级、max 250 turns、单次运行)。不利条件:其一,论文正文未给出 OSWorld-Pro 数据集与标注的公开下载链接,若数据不同步开源,第三方无法验证裁判对齐度也无法在标注上重新训练裁判;其二,从零复刻数据集基本不现实——需要 5000+ 人时、25 名经过考核的标注员、每任务 5–20 小时的标注投入;其三,裁判复现依赖能接受数百张截图(约 500MB)单请求的 GPT-5.6 API 权限,每任务裁判成本 $9.5(Luna)至 $250(Sol Max),给全部 305 个任务、十几个模型打分意味着数千到数万美元;其四,评测强依赖 OpenRouter 实时价格与 OpenAI 服务层级,时间敏感性高。综合判断:用官方发布的标注数据+GPT-5.6 API 复现榜单是可行的(预算万元美元级),但完全独立复现整个基准属于重资产工程。
论文图表
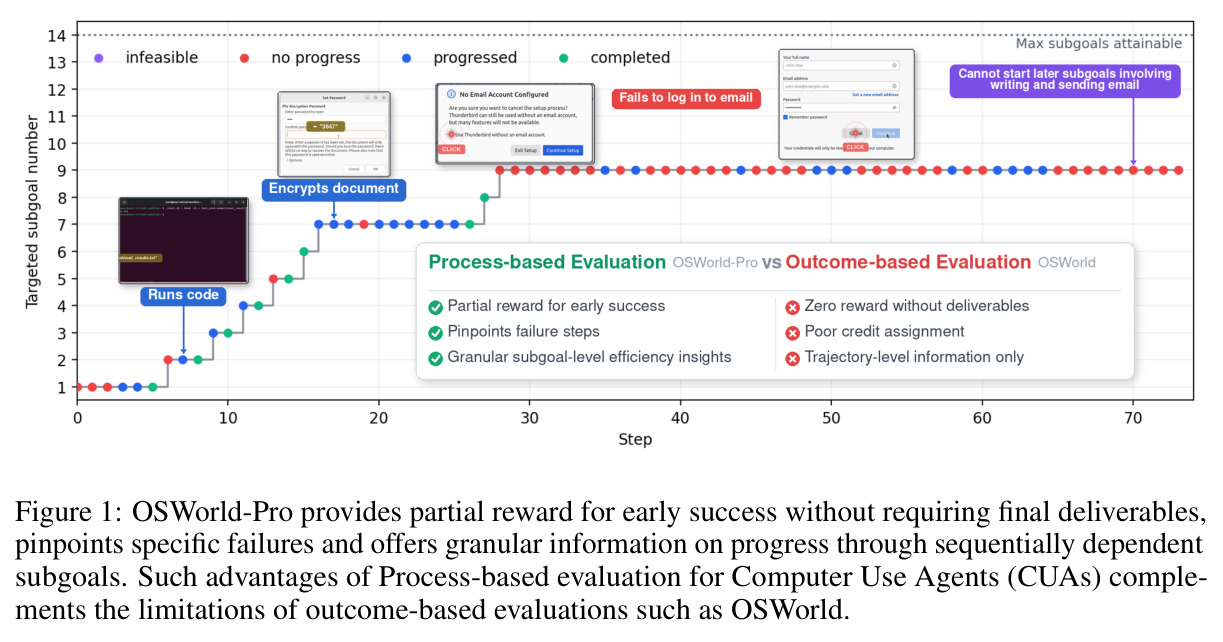
对比图:同一个智能体轨迹在 OSWorld 式结果评测下因未产出最终交付物而得零分,而在 OSWorld-Pro 过程评测下可以按顺序依赖的子目标获得部分分数、精确定位失败的子目标位置,并展示逐步的进展信息。
一图道尽论文动机:过程评测相比结果评测的三大优势(部分奖励、失败定位、细粒度进展)全部可视化,是理解全文价值的起点。
系统评估 3 个 GPT-5.6 模型(Sol/Terra/Luna)×6 档推理努力共 18 个裁判配置:与人类标注的步级 Macro-F1(targeted 94.5-97.7、feasible 54.0-67.5、progress 46.4-74.7、complete 67.8-94.8)、步级均值(70.6-82.0)、子目标级(83.8-94.1)、任务级 1-MAE(86.5-93.0),以及每任务输入/输出 token 和成本($9.53-$249.60);首行为人类表现(95.4/95.6/96.0)。
支撑“LLM 裁判能否替代人类”这一方法论核心问题:可行性判断是普遍短板、推理努力非越高越好、Terra Max 用 78% 的价格达到 Sol Medium 水平等结论全部来自此表,也是第 5 章选 Sol Max 当裁判的依据。