无需推理轨迹的专家模型训练:面向领域专家蒸馏 Training Specialist Models without Reasoning Trajectories for Domain Expert Distillation
QA-only专家训练隐式选择轨迹分布,蒸馏学生严格继承教师的特化—泛化画像
前置知识
知识蒸馏(专家蒸馏)
用一个大模型(教师)生成的输出去训练小模型(学生)。本文特指“专家蒸馏”流水线:先在领域数据上把通用模型微调成专家,再让专家生成带推理过程的语料来训练学生。由于学生只从教师采样的数据中学习,教师生成什么、学生就学到什么,教师如何被训练因此成为决定性变量。
本文全部论证建立在“学生学到的等于教师生成的轨迹”这一机制上,理解蒸馏是读懂前提。
QA-only 监督与教师强制 SFT
监督微调(SFT)用标注数据最大化正确输出的似然。QA-only 指数据只有问答对 $(q,a)$、没有中间推理步骤,训练用教师强制逐 token 最大化答案似然,从不显式监督推理过程。多数领域数据集(SMol、OPUS 等)天然只有这种形态,因为专家推理过程既难获取又难验证。
这是论文的核心设定:没有黄金轨迹时,专家生成什么样的推理处于欠定状态,引出全文问题。
KL 散度
衡量两个概率分布差异的指标 $\mathrm{KL}(P\|Q)=\sum_x P(x)\log\frac{P(x)}{Q(x)}$,为 0 当且仅当两分布相同。本文用它度量微调后模型相对基座模型输出分布的“漂移”程度,它也出现在蒸馏目标的理论分解 $\mathrm{KL}+\mathcal{H}$ 中,贯穿实证与机制分析。
“分布漂移”是全文识别出的控制轴:KL 小意味着保留通用能力,KL 大意味着激进特化。
LoRA 与层选择微调(LST)
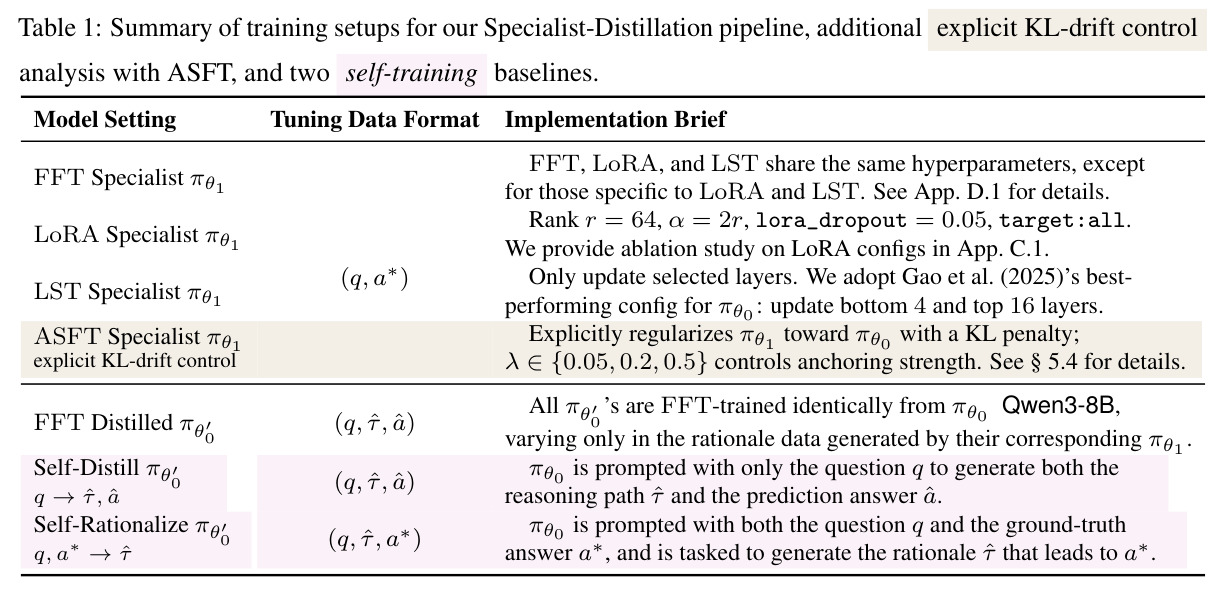
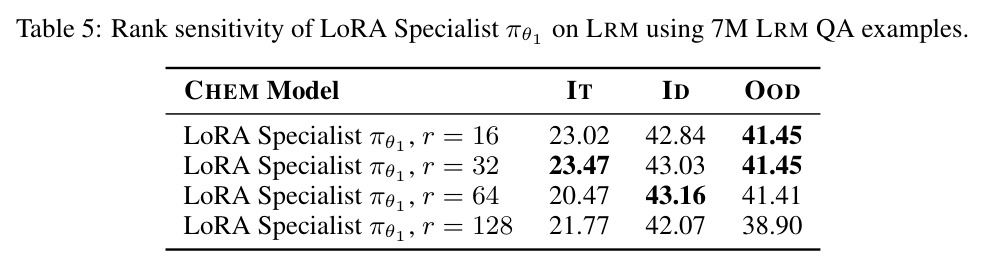
LoRA 冻结原模型权重,只训练注入的低秩矩阵 $\Delta W=BA$(秩 $r$),本文用 $r{=}64,\alpha{=}128$、作用于全部模块。LST 更直接:只微调选定的层(本文沿用 Gao et al. 的最优配置,更新底部 4 层和顶部 16 层)。两者都通过限制可更新参数空间,隐式约束模型偏离基座的程度。
它们是本文对比的三种专家训练策略中的两种,用于检验“更新空间受限”如何塑造轨迹分布。
思维链(CoT)与推理轨迹
让模型在给出最终答案前先生成中间推理步骤。在蒸馏语境下,教师生成的思维链就是“轨迹” $\tau$,是传递给学生的核心监督信号。轨迹可以是实质性推理 $\tau_+$、走捷径的伪推理 $\tau_\sim$,甚至是空轨迹 $\tau_\emptyset$,质量天差地别。
论文研究的正是这些轨迹的分布如何被专家的优化方式隐式决定,并如何决定学生能力。
Spearman 秩相关
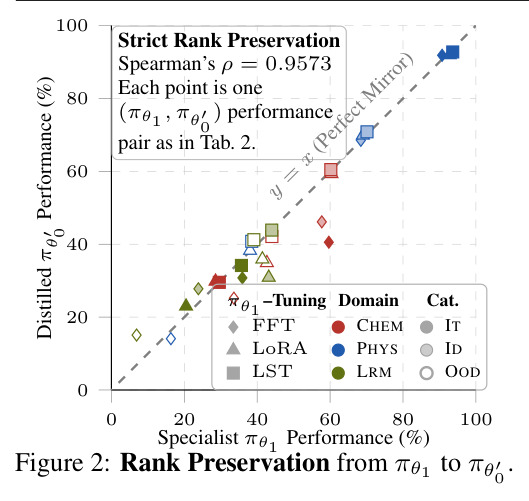
衡量两组排序单调一致程度的非参数统计量 $\rho\in[-1,1]$,为 1 表示排序完全一致、0 表示无关联。它只看名次不看数值差,适合比较两个模型在多个基准上的表现排序。本文用它量化专家与学生在 27 项评测上的成绩排序是否一致。
$\rho=0.9573$ 是“学生继承教师特化-泛化画像”这一核心结论的关键统计证据。
研究动机
领域专家蒸馏的标准流水线是:先在领域数据上把通用模型微调成“专家”,再让专家生成带推理过程的语料训练学生。但领域数据集通常只有问答对 $(q,a)$,没有黄金推理轨迹——专家级推理过程既难获取又难验证。于是专家只用最终答案做教师强制训练:例如 SMol 化学(14 个子任务)、MegaScience 大学物理子集、OPUS 英↔8 种低资源语言翻译,全部只有答案监督。在答案分布约束下其实存在无数条可行的轨迹分布:实质性推理 $\tau_+$、走捷径 $\tau_\sim$、甚至空轨迹 $\tau_\emptyset$,答案似然 $\log \pi_\theta(a|q)$ 对它们不加区分。专家最终生成什么样的推理、这些推理能否充当高质量蒸馏数据,此前从未被系统研究过。
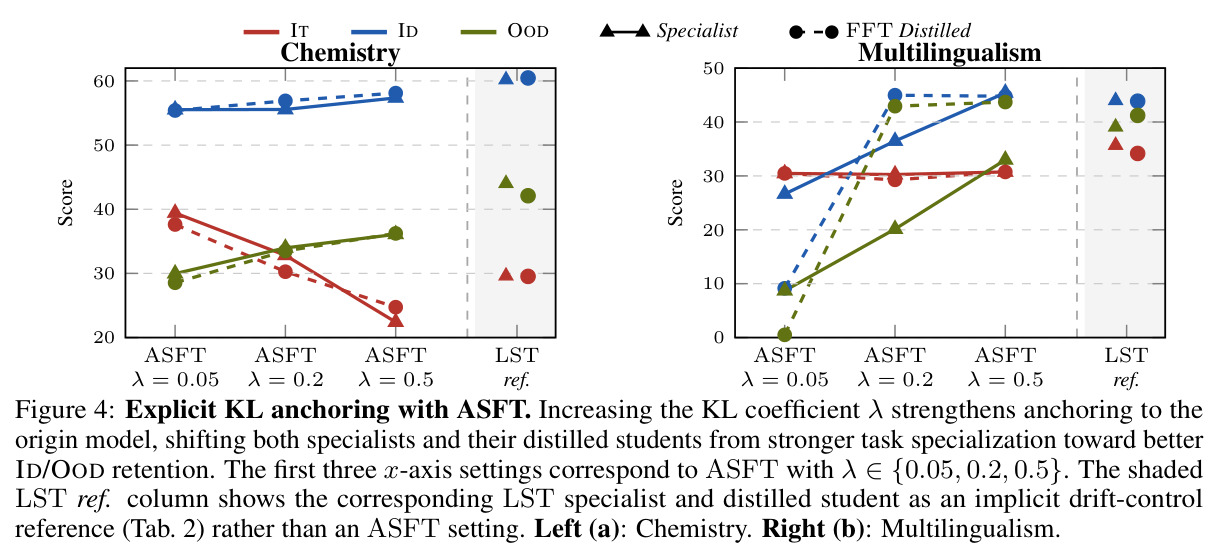
本文的目标是本文要回答三个层层递进的问题。其一:在只有 $(q,a)$ 监督时,专家模型生成的推理轨迹由什么决定?作者从理论上论证 QA 监督在轨迹层面是欠定的,而优化过程本身会隐式选出一个特定轨迹分布。其二:这种隐式选择会不会传递给蒸馏学生?作者用学生蒸馏作“不可知探测器”,在化学、物理、低资源多语言三个领域、9 组专家-学生配对、27 项评测上系统验证专家与学生的特化-泛化画像是否一致,包括教师学生来自完全不同模型家族的情形。其三:这种传递是否可控?作者把“分布漂移”(专家相对基座的偏移程度)识别为控制轴,比较 FFT、LoRA、LST 的隐式控制与 ASFT 显式 KL 锚定(系数 $\lambda\in\{0.05,0.2,0.5\}$)能否按预期移动特化-泛化权衡点。
与已有工作不同的是,已有工作围绕蒸馏流程设计展开:比较“先适应后蒸馏”与“先蒸馏后适应”、构造高质量领域监督、用自蒸馏缓解遗忘、按师生能力差距调配蒸馏数据等,但都把专家训练当作黑盒数据生成器,没人追问“专家被答案监督训练后到底学到了哪种推理行为”。本文的切入角度是把学生蒸馏重新定义为观测仪器:学生不继承专家的参数和优化约束,只接收采样的轨迹数据;在受控流水线下(同一初始化 Qwen3-8B、等量过滤后数据、完全相同的 FFT 学生配置),学生之间的性能差异就纯净地反映轨迹数据本身携带的监督信号。这把“专家隐式选了什么”这一不可直接观测的问题,转化成“学生学到了什么”这一可测量问题,进而用 KL 散度和 ASFT 把 LST 的隐式锚定与显式正则统一到“分布漂移”这一根轴上。
核心方法
论文把 QA-only 专家蒸馏形式化为轨迹分布选择。答案似然 $\log \pi_\theta(a|q)=\log\sum_{\tau\to a}\pi_\theta(\tau|q)$ 的监督只约束答案、不约束轨迹;但梯度分解(式 3)表明 $\nabla\log\pi_\theta(a|q)=\sum_{\tau\to a}p_\theta(\tau|q,a)\nabla\log\pi_\theta(\tau|q)$,后验权重 $p_\theta\propto\pi_\theta(\tau|q)$ 使高概率轨迹主导更新,反复优化即从可行分布中隐式选定一个。技术路线:以 Qwen3-8B 为基座,用 FFT、LoRA($r{=}64$)、LST(更新底部 4 层加顶部 16 层)在三域数据上训专家;专家每题采样 3 条思维链并过滤(答案等价加结构完整,翻译按 spBLEU 留前 20%)得约 360K 蒸馏池;学生全部同配置 FFT、等量数据训练。最终 27 项评测中师生成绩 Spearman $\rho=0.9573$。
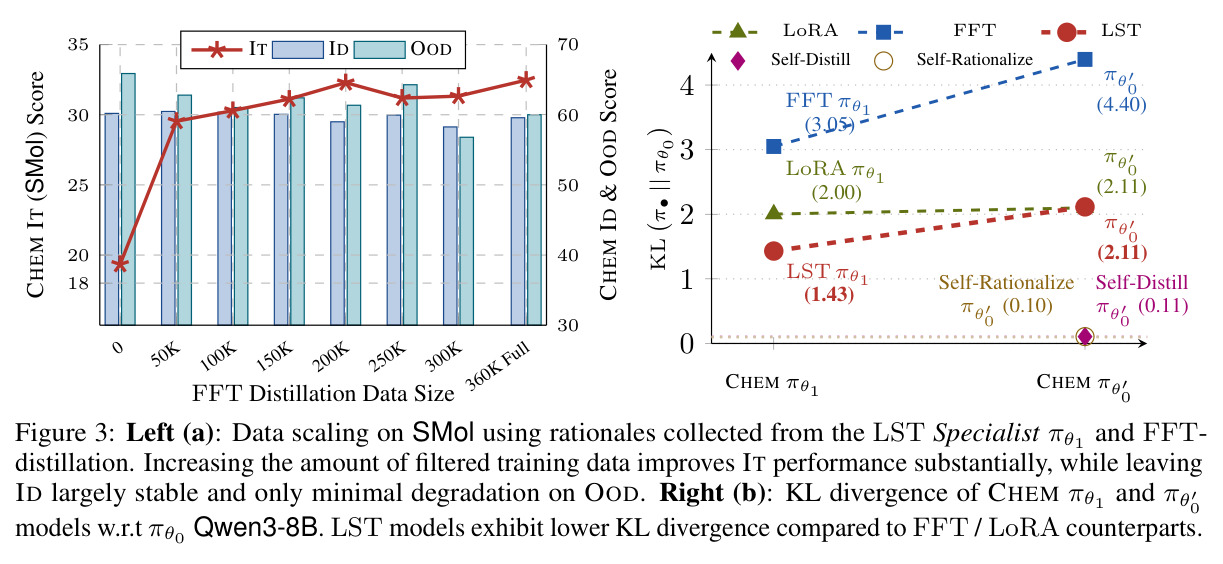
核心创新是改写蒸馏目标看穿本质:$\mathcal{L}(\theta'_0)=\mathbb{E}_{\tau\sim\pi_{\theta_1}}[-\log\pi_{\theta'_0}(\tau|q)]=\mathrm{KL}(\pi_{\theta_1}\|\pi_{\theta'_0})+\mathcal{H}(\pi_{\theta_1})$,熵项与学生无关,故训练学生等价于最小化与教师轨迹分布的 KL——学生逼近的不是答案,而是教师被其优化方式塑造成的轨迹分布,这解释了为什么“专家怎么训”比“专家多大”更重要。第二是 KL 约束视角:$\pi_{\theta_1}(\tau|q)\propto\pi_{\theta_0}(\tau|q)\exp(w(\tau,q,a)/\lambda)$,QA 微调只是对基座轨迹分布的再加权,FFT、LoRA、LST、ASFT 的差异被统一为“再加权多激进”:CHEM 上师生相对基座的 KL 从 LST 约 0.10、LoRA 约 2.11 到 FFT 约 4.40,ASFT 则提供连续可调旋钮,把策略选择变成单轴控制问题。
方法步骤详情
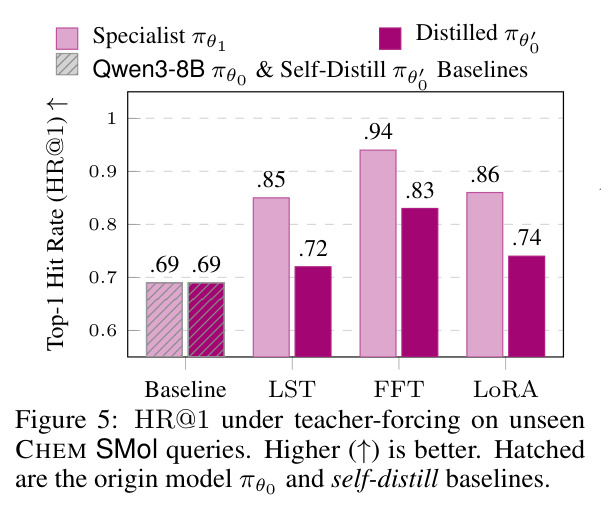
流程分五步。(1) 领域 QA 训练:在 SMol(14 子任务)、MegaScience 大学物理、OPUS 英↔8 低资源语言三套 $(q,a)$ 数据上,分别以 FFT、LoRA、LST 微调 Qwen3-8B 得到专家;另训 ASFT 专家($\lambda\in\{0.05,0.2,0.5\}$)。(2) 轨迹生成:每个专家对训练问题采样 3 条思维链 $(\hat\tau,\hat a)$,化学 50K 查询共 150K 条。(3) 过滤:仅保留答案等价、恰含一对 think 标签的完整轨迹;物理另加符号与数值验证,翻译按句级 spBLEU 保留前 20%,汇总成约 360K 蒸馏池。(4) 学生训练:从同一 Qwen3-8B 初始化,FFT、等量子采样、相同超参;设 Self-Distill(只给问题)与 Self-Rationalize(给问题加答案补推理)两个基线。(5) 评测与机制分析:IT/ID/OOD 三层基准加 5 个共享 OOD 基准,用 KL 散度、教师强制 HR@1、轨迹完整率与长度统计解释因果。
技术新颖性
新颖性体现在四点。第一,“蒸馏即探针”的实验设计是范式性的:以往蒸馏研究问“学生学得多好”,本文问“学生暴露了教师数据的什么性质”,通过固定学生端一切变量做差分比较,把因果归因干净地落在专家优化方式上。第二,式 3 的梯度分解给出了“优化即选择”的机制解释——答案监督下高概率轨迹主导梯度,训练自动把概率质量集中到少数轨迹上;式 5 则证明学生优化目标精确等于 KL 加常数熵,为“学生继承教师画像”提供理论基础。第三,把四种看似无关的微调策略(FFT/LoRA/LST/ASFT)统一到分布漂移维度,并用 ASFT 的 $\lambda$ 扫描证明该维度连续可调:多语言蒸馏学生的 ID/OOD 随 $\lambda$ 从 0.05 增到 0.5,由 9.15/0.51 升至 44.79/43.71。第四,对 Self-Rationalize 的失效(LRM IT 从 29.48 崩到 6.02、轨迹完整率仅 16.18%)给出结构性解释:强行让弱模型事后合理化会破坏生成流形,产生有毒监督。
实验结果
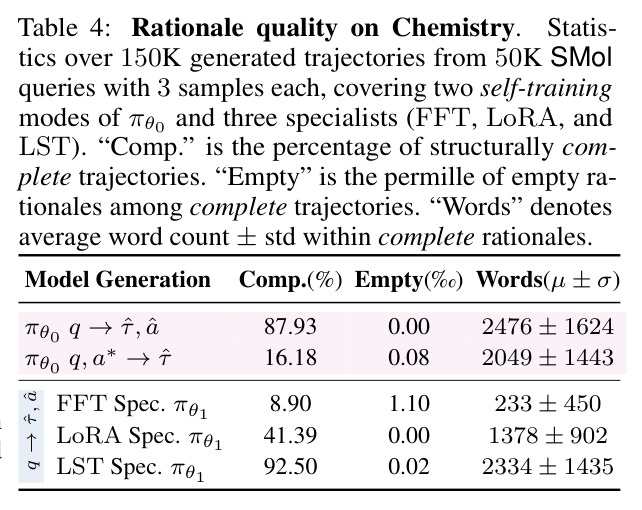
(1) 目标域提升:LST 蒸馏学生三域 IT 为 29.54/92.75/34.17,超 4 倍大的 32B 模型(25.35/92.45/33.78);FFT 专家 CHEM IT 达 59.65 但 OOD 从 42.22 崩至 33.60。(2) 师生画像一致:27 项评测 Spearman $\rho=0.9573$,置换检验 $p\approx0.0093$。(3) 跨家族成立:S1-mini→Qwen3-8B,LST-S1m 学生 IT 涨 13.38 且鲁棒,FFT-S1m 连过拟合也传递(学生 25.90)。(4) 数据扩展 50K→360K,CHEM IT 由 19.3 升至 32.5,ID 稳、OOD 微降。(5) 漂移 LST≈0.10<LoRA≈2.11<FFT≈4.40;ASFT 锚定从 0.05 增到 0.5,多语言学生 ID/OOD 由 9.15/0.51 升至 44.79/43.71。(6) 轨迹质量:FFT 完整率 8.90%、233 词,LST 92.50%、2334 词;HR@1 上 FFT 0.94,LST/LoRA 约 0.85。
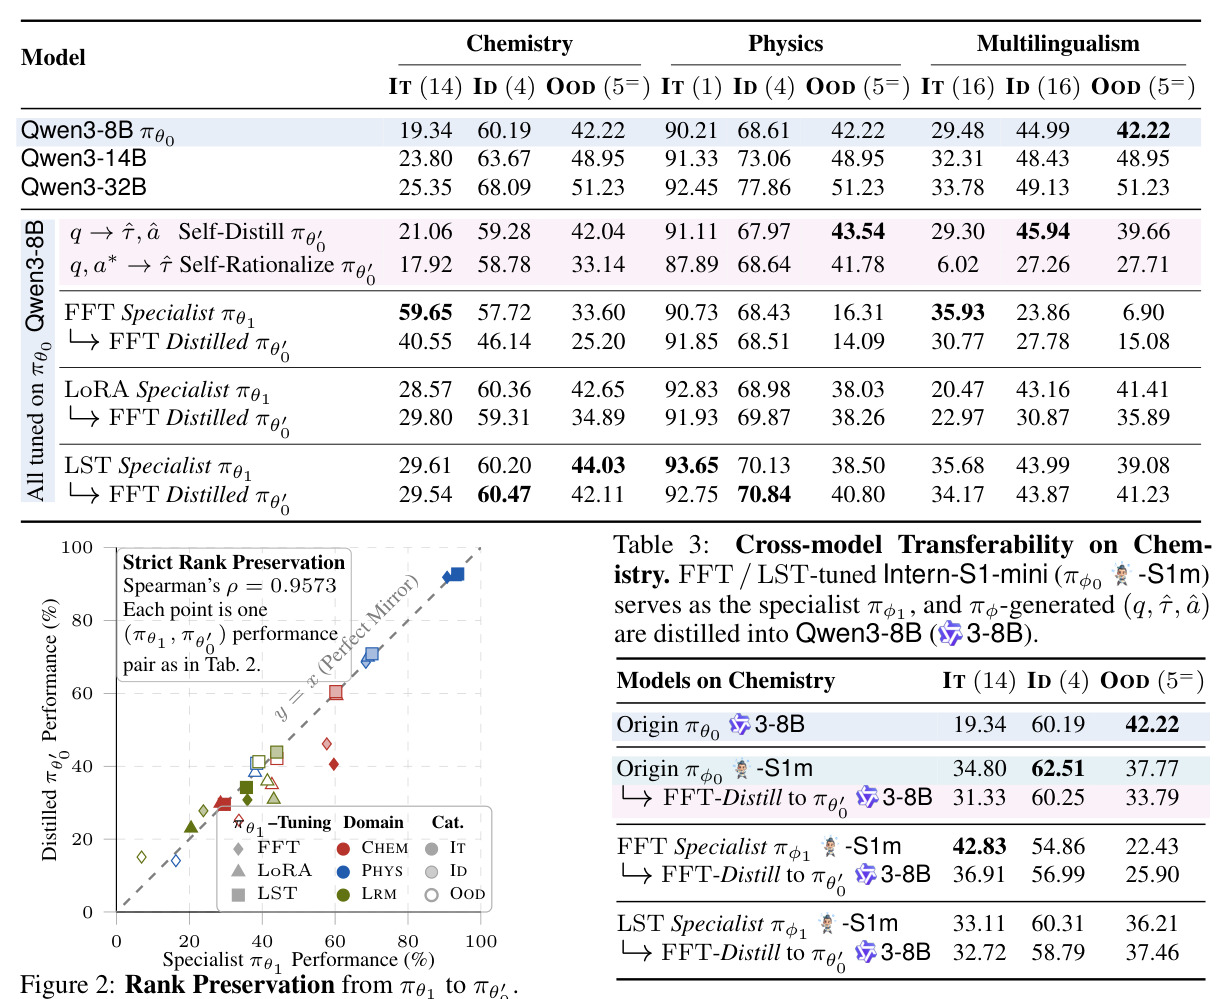
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 化学 SMol 域内任务(IT,14 子任务聚合) | 聚合得分 | FFT 专家 59.65;LST 蒸馏学生 29.54 | Qwen3-8B 原模型 19.34;Self-Distill 基线 21.06 | LST 学生 +10.20;FFT 专家 +40.31 但 OOD 从 42.22 崩到 33.60 |
| 物理域内(PHYS 基准大学子集) | 宏平均 | LST 蒸馏学生 92.75(LST 专家 93.65) | Qwen3-8B 90.21;Qwen3-32B 92.45 | +2.54,8B 学生反超 4 倍大的 32B 模型 |
| 低资源多语言翻译(Flores-101,16 个方向) | 宏平均 | LST 蒸馏学生 34.17 | Qwen3-8B 29.48;Self-Rationalize 基线仅 6.02 | +4.69,超过 Qwen3-32B 的 33.78 |
| 共享 OOD 基准(5 个,覆盖复杂推理/数学/代码) | 宏平均 | LST 蒸馏学生 40.80–42.11(三域) | FFT 蒸馏学生仅 14.09–25.20 | 漂移控制可保留约 15–26 分的通用能力 |
| 专家-学生在 27 项评测上的表现一致性 | Spearman 秩相关 ρ | 0.9573 | —(若画像不迁移,排序应接近随机) | 域内分块精确置换检验 p=2/215≈0.0093 |
局限与改进
作者承认:主分析集中在 Qwen3-8B(把基座放大到 Qwen3-14B 的验证在附录 C.2);LST 的层选择沿用 Gao et al. 的固定配置,未建立不同层选择与 KL 半径的对应关系,并明确不声称 LST 优化的是 KL 约束目标。我自己的观察有五点:其一,轨迹过滤只检查答案等价与结构完整,会引入“答案对但推理错”的幸存者偏差,论文未对推理逻辑正确性做人工或模型评估;其二,三个领域都以答案可验证为前提(SMol 有确定输出格式、物理有符号数值验证、翻译有 spBLEU),能否推广到开放式领域(写作、咨询)存疑;其三,秩相关的 27 个数据点来自仅 9 组配对且共享教师配置族,样本独立性有限;其四,ASFT 显式锚定实验只在化学和多语言两个域上做,物理域缺失;其五,共享 OOD 仅 5 个基准且原模型在三域下数值完全相同(42.22),通用能力评测的覆盖面偏窄。
独立分析的弱点
弱点一:正确性过滤不等于推理正确。过滤只验证 $\hat a$ 与黄金答案等价及结构完整,走捷径的轨迹只要答案对就会被保留,伪推理可能被当作监督蒸馏下去。改进方向:引入过程奖励模型或自洽性投票对轨迹打分,而不只看终点。弱点二:依赖答案可验证域。三套数据(SMol、物理、翻译)都能自动判分,开放式任务无法套用;可探索用强模型判分或成对偏好信号替代黄金答案。弱点三:等量数据假设与质量未完全解耦。不同专家的过滤通过率差异巨大(FFT 仅 8.90%,LST 达 92.50%),等量子采样使 FFT 学生可用数据池极小,“数据量”与“数据质量”两个因素仍有混淆;可设计固定通过量的配对实验分离二者。弱点四:KL 只在化学域系统测量且仅为 token 级诊断量,无法证明因果;应在所有域测量并拟合漂移-泛化的定量曲线,甚至在线监测。弱点五:LST 的“底部 4 层加顶部 16 层”是外借的最优配置,其与隐式锚定的关系只是经验关联,缺少对层组合的系统消融,实践者难以在自己的模型上选层。
未来方向
作者方向:把漂移控制做成训练中的在线调度(动态调 $\lambda$ 或层选择);在更多领域和更大模型上验证传递规律;研究专家优化与下游强化学习的交互。基于成果可延伸的方向:(1) 把式 7 的再加权视角变成显式算法——直接按 $w(\tau,q,a)$ 对基座采样轨迹,跳过昂贵的专家训练环节;(2) 刻画漂移-性能的帕累托前沿,为给定部署场景(需要极致特化还是保留通用能力)自动选点;(3) 研究多专家混合蒸馏时轨迹分布如何合成、是否会发生分布冲突;(4) 与过程奖励模型结合,过滤“答案对但推理错”的轨迹,弥补本文过滤准则的盲区;(5) 探索在偏好学习、对比学习等非 QA 监督下,是否同样存在“优化隐式选择轨迹分布”的现象;(6) 从理论上把 LST 的受限更新子空间与隐式 KL 半径建立形式化对应,补上论文明确留白的理论缺口。
复现评估
复现条件较好。作者公开了代码(GitHub CONE-MT/DCO 仓库下的 specialist_distillation 目录)、模型与数据集(HuggingFace collection yileitu/qaonly-specialist-distillation),包括 FFT/LoRA/LST 专家、蒸馏数据与过滤后的轨迹池,附录 D/E 给出了训练、推理、过滤与评测的完整协议描述。算力上以 Qwen3-8B 为中心:LoRA(r=64)和 LST(仅 20 层)训练成本中等,FFT 为 8B 全参微调;最大开销是轨迹采样(每题 3 条、化学 150K 条、多域合计数十万级 CoT 生成),估算需多卡 A100/H100 运行数天。复现难度评估为中等:基准均为公开数据(SMol、MegaScience、OPUS、Flores-101、LiveCodeBench 等),但过滤管线细节多(子任务特定判分规则、spBLEU 前 20% 截断、等量子采样协议),逐位复现分数较难;若评测脚本随代码完整发布,则可对表验证主要结论。
论文图表
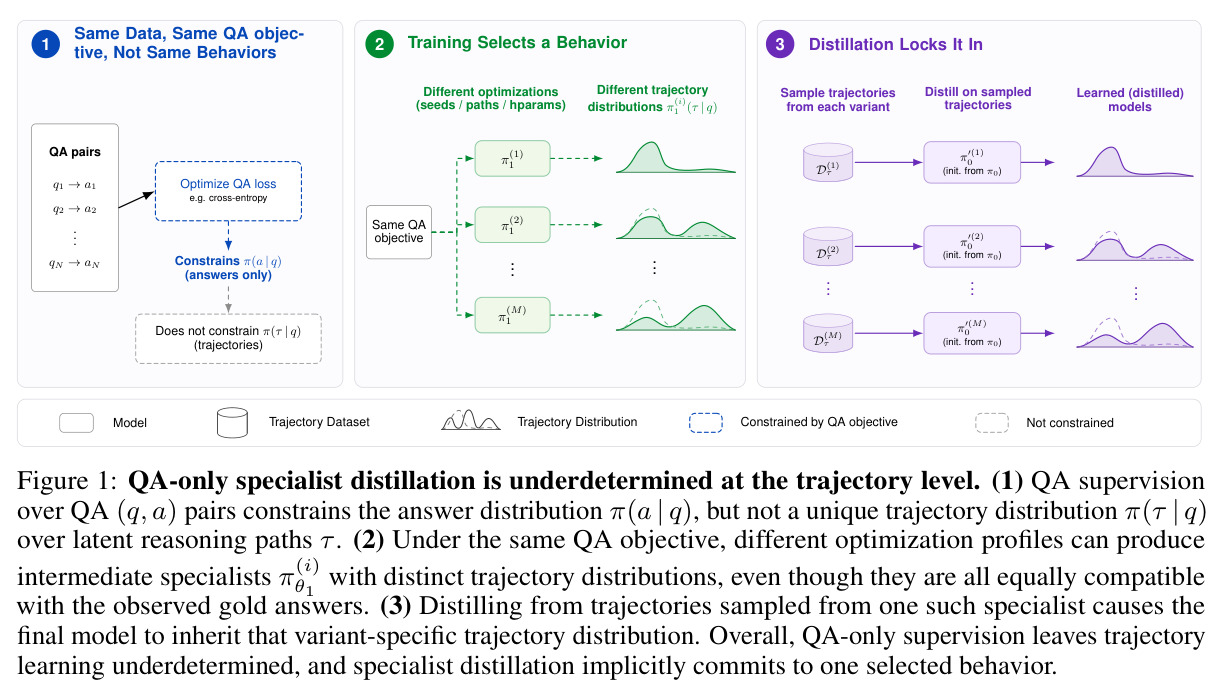
三格示意图:(1) 对问答对 $(q,a)$ 的 QA 监督只约束答案分布 $\pi(a|q)$,不约束唯一的轨迹分布 $\pi(\tau|q)$;(2) 在同一 QA 目标下,不同优化配置(随机种子、路径、超参)产生轨迹分布各异的中间专家 $\pi^{(i)}_{\theta_1}$,它们都与观测到的黄金答案相容;(3) 从某个专家采样轨迹去蒸馏,最终模型就继承该变体特有的轨迹分布。
这是全文的问题设定和核心论点的可视化:QA-only 蒸馏在轨迹层面欠定,专家优化隐式做出选择。看懂这张图就抓住了论文要解决的悖论。