漂移约束优化:指令模型微调中唯有方向重要 Drift-Constrained Optimization: Only Direction Matters in Fine-Tuning Instruct Models
把行为漂移设为硬预算后,微调变成方向选择问题:只训问答对也能提升任务且不伤原有能力
前置知识
KL散度(锚定KL)
KL散度 $D_{KL}(P\|Q)$ 衡量两个分布的差异。本文用锚定KL $KL(\pi_{\theta_0}\|\pi_\theta)$:以参考模型为 $P$,惩罚参考模型支持的行为在新模型中丢失的概率质量,呈模式覆盖特性;反向KL则是模式寻求,允许新模型直接丢弃旧行为。微调最怕遗忘,锚定KL能直接度量旧能力是否还在。
全文的漂移预算 $D_{ref}(\theta)\le\delta$ 就用锚定KL定义,理解其方向性才能明白为何它适合刻画遗忘。
Fisher信息矩阵
$F=\mathbb{E}[\nabla_\theta\log\pi_{\theta_0}(y|x)\,\nabla_\theta\log\pi_{\theta_0}(y|x)^\top]$,衡量输出分布对参数扰动的敏感度。对锚定KL做二阶泰勒展开得 $D_{ref}\approx\frac{1}{2}\Delta\theta^\top F\Delta\theta$,即 $F$ 定义了参数空间中的局部行为距离度量,如同欧氏空间中单位阵度量长度平方。
本文的行为坐标系(半径 $\rho$ 与方向 $v$)完全建立在 $F$ 之上,所有方向效率比较都以 $F$ 为标尺。
自然梯度
在线性目标 $\min g^\top\Delta\theta$ 加二次约束 $\Delta\theta^\top F\Delta\theta\le 2\delta$ 下,最优更新方向为 $-F^{-1}g$($g$ 为任务梯度),即Fisher度量下的最速下降方向。它回答了行为漂移固定时任务损失下降最快往哪走,是方向选择问题的解析最优解。
论文证明匹配漂移下微调本质是方向选择,其最优方向正是自然梯度,这把Amari的经典结果变成了比较各微调方法的基准。
灾难性遗忘
模型在新任务上训练后大幅丧失原有通用能力(推理、代码、指令遵循等)的现象。缓解手段包括正则化、旧数据重放、限制参数更新等。强指令模型的推理依赖显式生成思维链,训练分布稍有偏移就可能破坏这一能力,因此对遗忘尤其敏感。
本文核心动机就是SFT不控制遗忘;其框架把遗忘多少变成显式漂移预算,再用方向选择同时保任务与保能力。
LoRA与参数子集微调
LoRA把权重更新约束为低秩形式 $\Delta W=BA$(秩 $\le k$),只训练少量参数;参数子集微调(如只训某些层)直接冻结其余参数。传统视角下它们是省显存的手段,本文统一视其为限制可行方向族 $S$ 的方式,与全参微调在同一方向效率框架下比较。
论文的层选择微调(LST)就是参数子集微调的实例,理解这层统一视角才能读懂其方法与实验设计逻辑。
spBLEU与xCOMET
机器翻译自动评测指标。spBLEU在子词切分后统计n-gram重合度,偏词汇层面;xCOMET是基于大模型的参考式质量估计,输入源句、译文与参考,输出语义质量分(本文约30-75),与人工评价更相关。本文在FLORES-101上以英、中、尼泊尔语、宿务语4个枢轴语言平均后报告。
翻译实验(Table 1/3/4)的核心指标就是xCOMET与spBLEU,不了解其含义无法判断超过专门翻译系统这一结论的分量。
研究动机
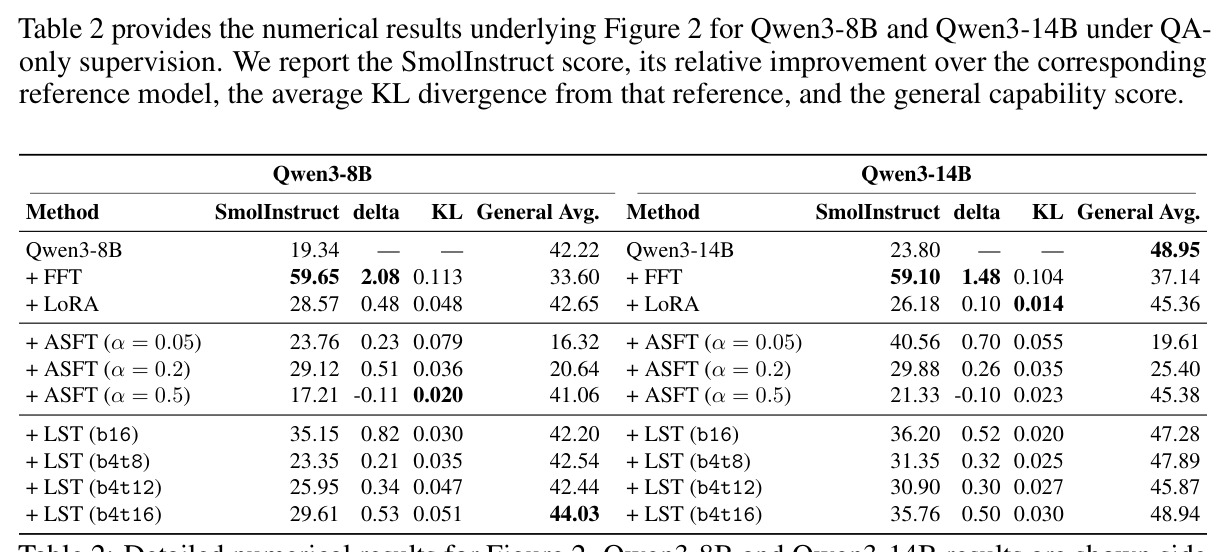
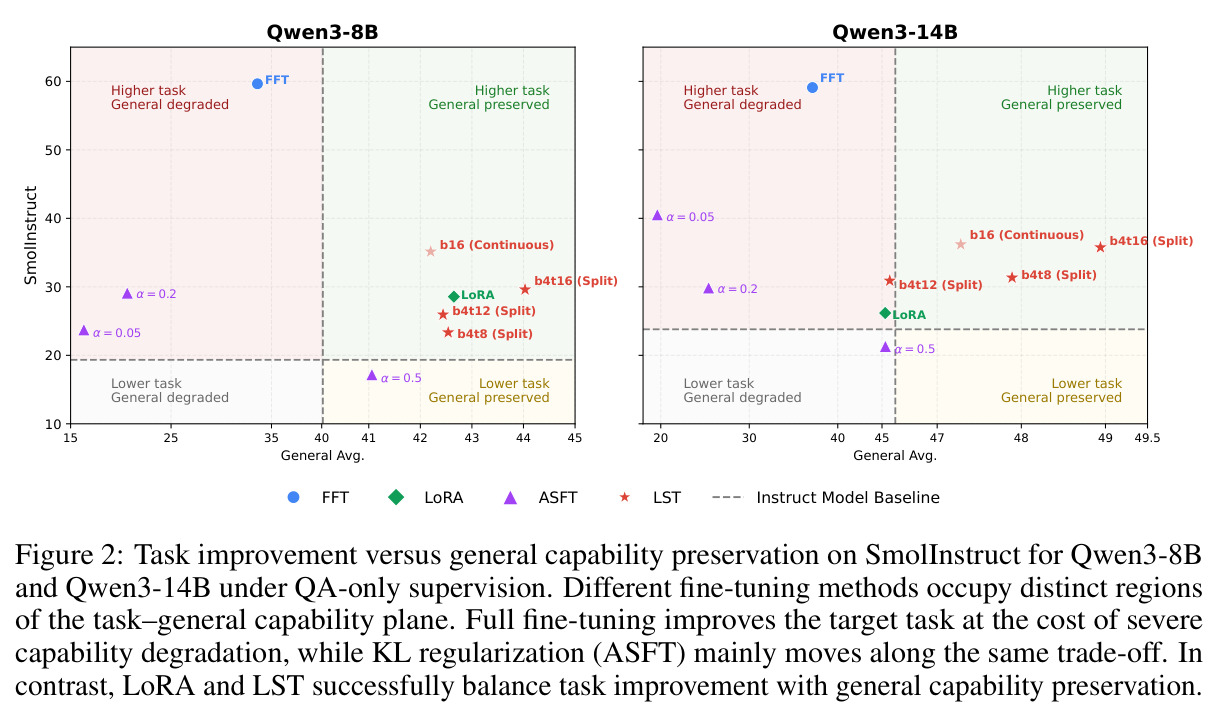
强指令模型(如 Qwen3-8B/14B)的能力高度依赖推理时显式生成思维链,而标准 SFT 只优化目标任务,完全不约束模型行为偏离参考模型的程度,代价往往训完才显现。论文给出一个极端但真实的例子:用 30 万条 MegaScience 问答对直接微调 Qwen3-8B(训练只给最终答案、不给推理轨迹),训练过程中与参考模型的 KL 漂移单调上升,而平均下游推理成绩先降后仅勉强回到原点,始终没有明显超过初始模型。在化学指令集 SmolInstruct 上,全参数微调(FFT)把 Qwen3-8B 的任务分从 19.34 拉到 59.65,但通用能力均值从 42.22 暴跌到 33.60;多语言翻译上 FFT 也只改善英语中心方向,尼泊尔语方向 spBLEU 从 7.53 掉到 4.81。常见的 KL 正则(ASFT)只能在任务提升与能力保持的权衡曲线上滑动,无法跳出。
本文的目标是本文想把行为漂移从训练后被动观察的副产品,变成训练前主动设定的组织变量:优化开始前先给定漂移预算 $\delta$,在 $\min_\theta T(\theta)\ \text{s.t.}\ D_{ref}(\theta)\le\delta$ 下最大化目标任务。具体目标有三:一是建立以漂移为中心的 SFT 分析框架,说明预算固定后剩下的唯一自由度是更新方向,并定义可跨方法比较的方向效率 $\eta(u)$;二是验证一个可证伪的预测——改变可用方向能定性地改变微调结局;三是在只给答案、不给推理的最严苛 QA-only 设定下,找到能同时提升目标任务、保留推理与通用能力的具体方向,并在科学推理与 100 多语言翻译上产出实用模型。
与已有工作不同的是,已有工作分两条路:PPO 等 KL 约束强化学习和 ASFT 类方法把漂移折进目标函数当惩罚项;LoRA、层冻结等结构化微调从参数效率或经验出发限制更新位置,但缺乏统一解释。本文的独特之处在于漂移优先的视角反转:先固定漂移预算,再把全参微调、LoRA、参数子集微调统一为同一方向选择问题在不同可行方向族上的实例,用方向效率 $\eta(u)=-g^\top u/\sqrt{u^\top F u}$ 比较优劣。几何上,所有更新都以参考模型 $\theta_0$ 为公共原点、以 Fisher 矩阵 $F$ 为公共度量,异构方法第一次变得可比。作者还刻意选择锚定 KL 而非反向 KL,论证前者才能真正度量旧行为是否被保留。
核心方法
直觉:如果把微调想象成从参考模型出发、只能在半径为 $\rho$ 的行为球内移动,那么走多远已被预算锁死,唯一能优化的是往哪走。技术上分三步:首先用锚定 KL 定义漂移 $D_{ref}(\theta)=\mathbb{E}_{x\sim D_{general}}KL(\pi_{\theta_0}\|\pi_\theta)$,在 $\theta_0$ 处二阶展开得 $\frac{1}{2}\Delta\theta^\top F\Delta\theta$,获得共享的 Fisher 几何;其次把更新分解为 $\Delta\theta=\rho v$(半径×方向),在固定 $\rho$ 下任务改进等价于最大化方向效率 $\eta(u)=-g^\top u/\sqrt{u^\top F u}$,最优解为自然梯度方向 $-F^{-1}g$;最后把各种微调参数化视为可行方向族 $S$,并用按架构分层的参数冻结来实例化——即层选择微调(LST),例如先训底部 4 层再训顶部 16 层的 b4t16 配置。
核心创新是把漂移约束当作几何约束而非目标函数惩罚项。ASFT 之类把 $\lambda D_{ref}(\theta)$ 加进损失,只能沿着同一条任务-通用权衡曲线滑动:正则弱则任务涨、能力崩,正则强则能力保住、任务不动。而几何约束问的是:在同样的漂移预算下,哪个方向族能同时把两者做到最好?这一视角给出可证伪预测:匹配漂移时改变方向会定性地改变微调结局。QA-only 微调失败正是最严苛的检验场——同一份数据、同一个目标函数,FFT 失败而 b4t16 式 LST 成功,直接证明成败由方向而非数据或算力决定。作者还强调锚定 KL(模式覆盖)与反向 KL(模式寻求)的差别:遗忘恰恰表现为参考分布支持的行为消失,只有锚定 KL 能捕捉。
方法步骤详情
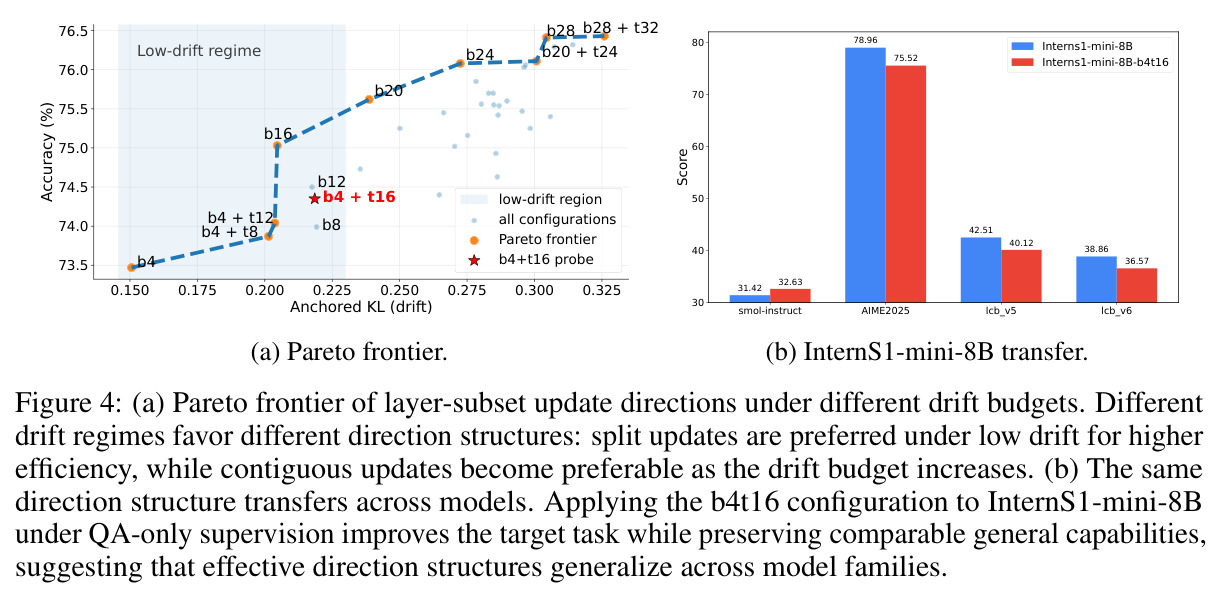
第一步,设定漂移度量:冻结词嵌入与输出读出层 $(W_0,b_0)$,用 $p^0_\theta(\cdot|x)=\mathrm{softmax}(h_\theta(x)W_0^\top+b_0)$ 作为行为代理,计算相对参考模型的锚定 KL。第二步,选定方向族:在 Transformer 天然层级上取两段式子集 $M(l_1,l_2)=\{1..l_1\}\cup\{l_2..L\}$,记号如 b4t16 表示先微调底部 4 层、再从该检查点出发微调顶部 16 层,中间层全程冻结;对照组为连续 bn、全参 FFT、LoRA(秩 64)、ASFT。第三步,QA-only 训练:科学推理用 SmolInstruct 30 万样本、翻译用 Lego-MT 约 280 万句对(100+ 语言),只用问答对交叉熵损失。第四步,评估:任务侧用 SmolInstruct 官方总分解与 FLORES-101(xCOMET/spBLEU,4 个枢轴语言平均),能力侧用 AIME25/26(32 次采样)、LiveCodeBench v5/v6(pass@1)、BBEH 合成通用均值,并报告经验方向效率 $\eta=\Delta_{Task}/\sqrt{KL}$。第五步,分析:匹配漂移比较、匹配参数量比较、Pareto 前沿、层间隔(gap)消融、跨模型迁移(InternS1-mini-8B)与 RL 初始化实验。
技术新颖性
新颖性有四层。理论层面:首次把行为漂移作为 SFT 的一阶分析量,给出锚定 KL 诱导的共享 Fisher 几何与径向-方向分解 $\Delta\theta=\rho v$,并证明匹配漂移下的最优方向是 $-F^{-1}g$,把为什么 LoRA 有时好有时坏归因于可行方向族的方向效率差异。方法层面:用最粗糙的层冻结就足以逆转 QA-only 失败,说明有效方向以家族形式存在而非孤立点,无需昂贵的二阶优化。实验设计层面:QA-only 设定(只给答案、推理时却要求完整思维链)是刻意构造的压力测试,把方向这一变量从数据、目标函数、算力等混杂因素中剥离。工程层面:发现底+顶分层训练的方向结构(b4t8/b4t12/b4t16)在两个模型、两类任务上一致有效,且该结构可零改动迁移到 InternS1-mini-8B。
实验结果
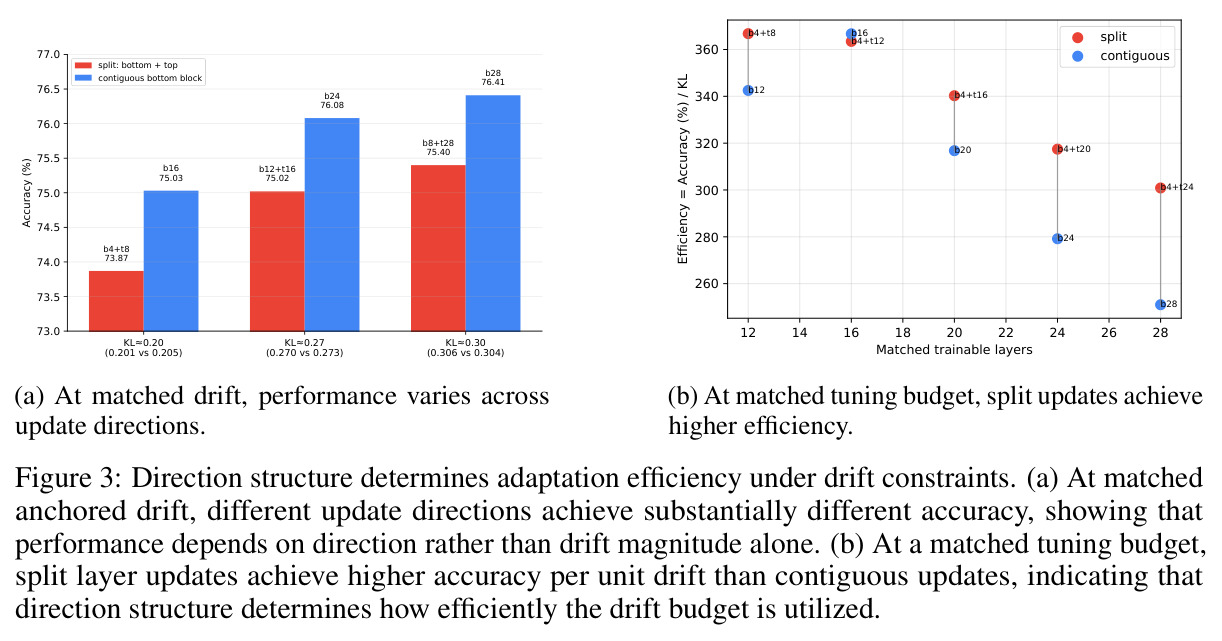
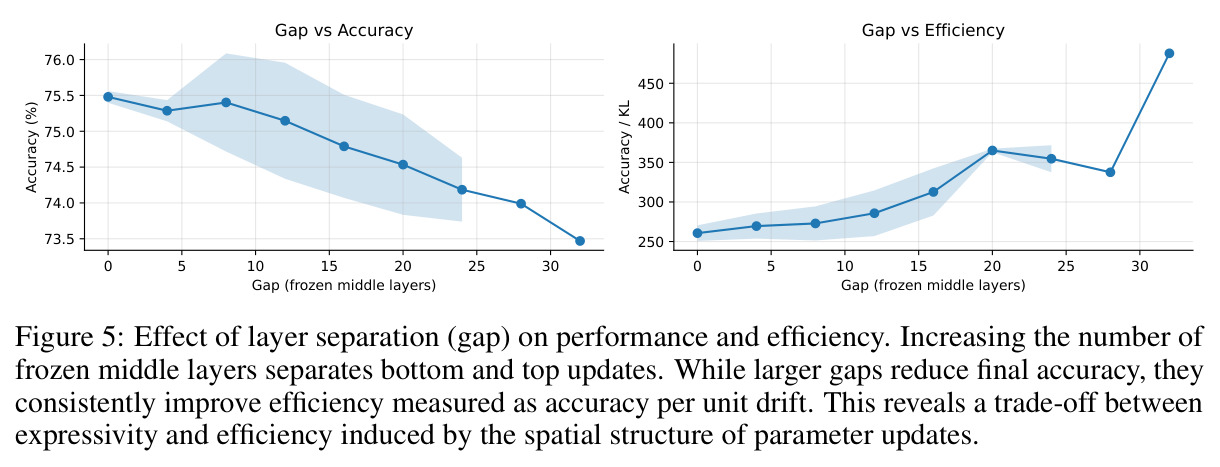
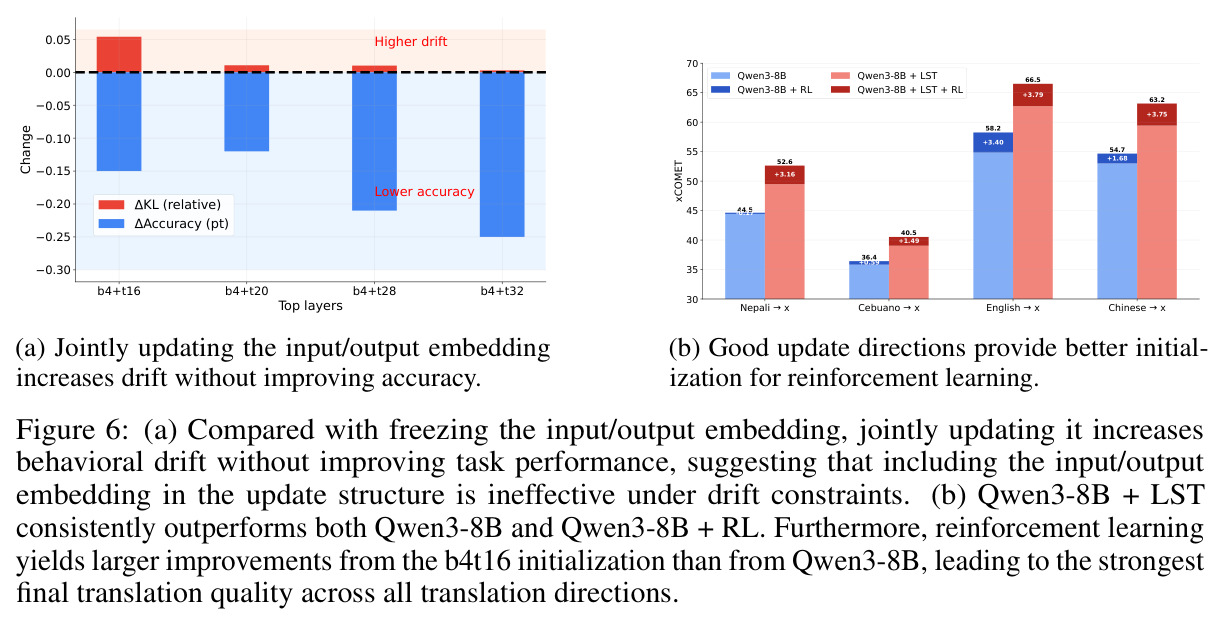
证据链五步。(1)QA-only FFT 确实失败:Qwen3-8B 在 SmolInstruct 上任务分 19.34→59.65(+207.8%)但通用均值 42.22→33.60;14B 为 23.80→59.10、48.95→37.14,KL 单调上升且推理始终未超基线。(2)LST 逆转失败:8B 的 b4t16 得 29.61(+53.1%)且通用升至 44.03;14B b4t8 +31.7%、b4t16 +50.3%,通用 47.89/48.94 几乎无损。(3)匹配漂移对照:14B 上 ASFT(α=0.5)KL=0.023 时任务 -10.38%,LST b4t8 KL=0.025 时 +31.72%。(4)翻译:8B b4t16 把 xCOMET 从 47.07/51.40(lg→x/x→lg)提到 52.66/55.60,超过 Seed-X-PPO-7B(47.76/51.31)等全部专门系统;14B b4t16 达 56.51/58.31;而 FFT(KL 0.32)退到 42.05/47.02,LoRA(KL 0.11)任务为负,连续 b16(KL 0.10)远差于分段 b4t8(KL 0.12)。(5)方向结构:匹配 KL(0.270 vs 0.273)时连续 b24 准确率高于分段,但匹配层数预算时分段(b4+t20)效率更高;gap 增大效率升、终性能降;训 lm_head 只增漂移不增准确率;b4t16 零调参迁移到 InternS1-mini-8B 仍有效;翻译模型全方向优于 Qwen3-8B+RL,且以其为初始化做 RL 增益更大(各方向约 +0.6~+3.8 xCOMET)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 化学指令微调(QA-only,Qwen3-8B) | SmolInstruct 总分 / 通用能力均值 | LST b4t16:29.61 / 44.03;LST b16:35.15 / 42.20 | FFT:59.65 / 33.60(参考模型 19.34 / 42.22) | 任务分提升 53%-82% 的同时通用能力不降反升,而 FFT 任务虽最高但通用暴跌 8.6 分 |
| 化学指令微调(QA-only,Qwen3-14B,匹配漂移) | SmolInstruct 相对变化 @ 匹配 KL | LST b4t8:+31.72%(KL=0.025) | ASFT α=0.5:-10.38%(KL=0.023) | 同等漂移预算下方向选择带来约 42 个百分点的差距 |
| 多语言翻译(Qwen3-8B,100+ 语言) | FLORES-101 xCOMET(lg→x / x→lg 枢轴平均) | LST b4t16:52.66 / 55.60 | 参考模型 47.07 / 51.40;最强专门系统 Hunyuan-MT1.5-7B 51.50、Tower-Plus-9B 52.44 | 较参考模型 +11.9% / +8.2%,匹配或超越全部专门翻译系统 |
| 多语言翻译(Qwen3-14B) | FLORES-101 xCOMET(lg→x / x→lg) | LST b4t16:56.51 / 58.31 | 参考模型 51.85 / 55.21;Seed-X-PPO-7B 47.76 / 51.31 | +4.66 / +3.10 分,全面领先所有专门系统 |
| 微调后强化学习初始化(翻译) | xCOMET 各方向增益 | Qwen3-8B+LST+RL:所有翻译方向最强 | Qwen3-8B+RL(WALAR) | LST 初始化使 RL 增益更大(各方向约 +0.6~+3.8),且 LST 模型本身已全面优于 base+RL |
局限与改进
作者承认的局限:实验只在 Qwen3 级别指令模型和科学推理、多语言迁移两个领域验证,未覆盖更大规模模型、多模态或其他下游任务;框架只提供优化视角的解释,没有完全说清底层机制;层选择只是结构化方向的一种实例,可能存在更好或更可扩展的方向构造方式。我的补充观察:第一,论文从未真正先设预算、再在约束下优化——KL 都是事后测量,实验实为一组方向族的网格搜索(b16、b4t8/b4t12/b4t16 等十余个配置),理论中的 $\eta(u)$ 最大化从未被求解,$-F^{-1}g$ 也因参数量太大无法计算;第二,漂移度量用冻结读出层的行为代理,其与真实 $\pi_\theta$ 的近似误差未量化;第三,两段式层子集限制较强,未探索注意力头、MLP 等更细粒度结构;第四,效率-表现权衡(gap 越大效率越高但终性能越低)缺乏机制性解释,选哪个配置仍靠经验;第五,翻译 b4t16 模型的通用均值 38.85 仍低于基线 42.22,能力保持并非零成本;第六,实验未报告随机种子方差。
独立分析的弱点
独立分析的弱点与改进方向:(1)缺乏构造性算法——目前是人工网格搜索层组合,配置有限且随组合数增长不可扩展;改进方向:用对角 Fisher 或 K-FAC 近似估计各模块的 $\eta(u)$ 代理分数,做贪心或可微搜索自动选层,把方向选择从探针升级为算法。(2)预算约束是软的——没有训练中向 Fisher 球投影或早停机制,无法保证最终 KL≤δ;改进方向:引入 K-FAC 自然梯度步长控制或基于代理 KL 的在线预算控制器,实现真正的约束优化。(3)漂移代理保真度存疑——冻结读出层会低估词表相关漂移,而 Figure 6a 显示更新 lm_head 只增漂移不增收益,说明代理与真实行为间仍有系统性偏差;改进方向:在子集词表上直接估计真实 KL 并校准。(4)底部+顶部为何高效缺机制解释——可能与表层语言特征在中下层、任务抽象映射在顶层的分工有关;改进方向:用 logit lens、表示探针、注意力消融等定位两段层各自贡献。(5)通用评测覆盖窄——AIME/LCB/BBEH 偏推理与代码,指令遵循、安全、多语言理解未测;改进方向:扩充 BenchMAX 全套任务并报告逐项结果与多种子方差。
未来方向
作者提出的方向:推广到更大模型家族、多模态模型与其他下游领域;探索层选择之外更好的方向结构化方式;进一步解释方向效率背后的机制。基于本文成果可延伸的方向:(1)把方向选择与二阶优化结合——用 LoRA 参数化下的 Kronecker 分解近似 $F$,直接优化 $\eta(u)$,让预算内最优方向可计算而非可搜索;(2)把漂移预算做成调度量——训练早期紧预算保能力、后期放宽换性能,与课程学习结合;(3)方向结构迁移规律——b4t16 在 Qwen3 与 InternS1 上都有效,值得在 Llama、DeepSeek 等家族系统验证,形成架构级微调配方;(4)与后续 RL 的理论衔接——为何好的 SFT 方向能放大 RL 增益(约 +0.6~+3.8 xCOMET),可研究 SFT 漂移方向与 RL 策略改进方向的子空间重叠度;(5)持续学习场景——多个任务依次微调时用方向预算分配避免累积遗忘;(6)与模型合并、任务向量手术式微调结合,因为方向族视角天然适配任务向量的加减操作。
复现评估
复现条件较好。代码开源于 GitHub(CONE-MT/DCO),模型发布在 HuggingFace(LLaMAX/Dco 合集);训练数据全部公开:SmolInstruct(化学,30 万采样)、MegaScience(分析用 30 万+5 万保留集)、Lego-MT(翻译,约 280 万句对);评测集 FLORES-101、AIME25/26、LiveCodeBench v5/v6、BBEH 均公开,评测框架 BenchMAX 与 OpenCompass 标准化。基座模型 Qwen3-8B/14B、InternS1-mini-8B 及对比系统(Seed-X-PPO-7B、Tower-Plus-9B、Hunyuan-MT1.5-7B、Aya-Expanse-8B、Qwen3-8B-WALAR)全部可获取。算力需求为 8 张 NVIDIA H200 训练 8B-14B 模型,属中高门槛;AIME 评测需 32 次采样、FLORES-101 涉及 100+ 语言对,评测算力与工程量不小。层配置(连续/分段、b16、b4t8/b4t12/b4t16)在正文与附录交代清楚,Appendix E-G 提供完整数字。主要不确定性:部分训练超参在附录 E 需仔细核对,匹配漂移比较需自行复算 KL。总体复现难度中等,有 8 卡 A100/H200 级资源的团队可在数周内复现主结果,仅复现翻译主表门槛更低。
论文图表
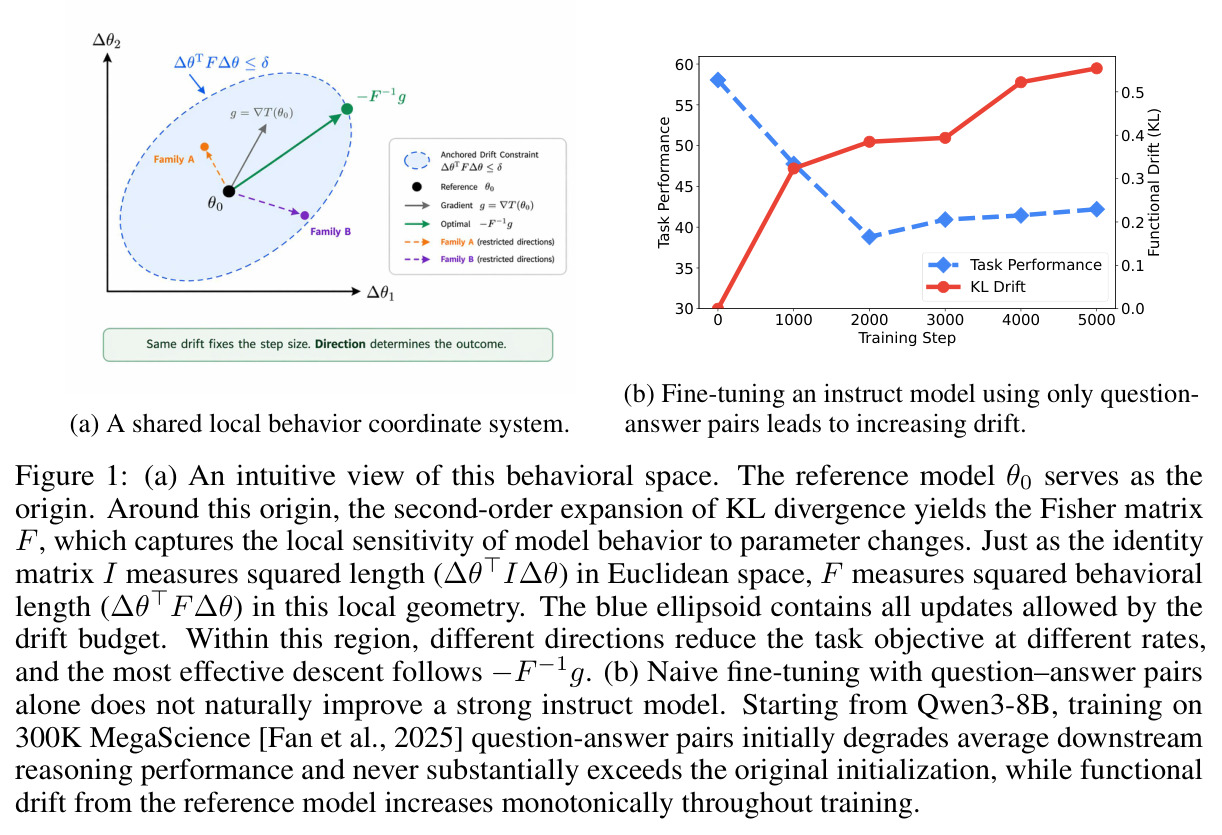
左图给出行为空间直觉:参考模型 $\theta_0$ 为原点,锚定 KL 二阶展开诱导 Fisher 矩阵 $F$,如同欧氏空间的长度度量;蓝色椭球是漂移预算允许的更新区域,不同方向的任务下降速率不同,最有效方向为 $-F^{-1}g$。右图显示 Qwen3-8B 在 30 万 MegaScience 问答对上的训练过程:KL 功能漂移单调上升,而平均下游推理成绩先跌后仅勉强回到原点。
一图同时呈现理论框架(行为坐标系、漂移预算、方向选择)与核心动机现象(QA-only 微调失败),是理解全文的钥匙。
主表:以 Qwen3-8B/14B 为参考,列出各方向族(S_Full、S_LoRA、S_ASFT、连续/分段 LST)的经验方向效率 η、锚定 KL、任务变化、通用能力变化及 xCOMET 平均分,并与 Seed-X-PPO-7B、Tower-Plus-9B、Hunyuan-MT1.5-7B、Aya-Expanse-8B 统一协议对比。核心结论:仅用 QA-only 监督,分段 LST 在 0.1 量级 KL 下取得强任务提升,xCOMET 达 52.66/55.60(8B)与 56.51/58.31(14B),匹配或超越所有专门翻译系统;FFT/LoRA/连续 b16 在相近漂移下明显更差。
论文的主结果表,是方向效率决定成败和弱监督比肩专家系统两大主张的数字依据。
按枢轴语言(ne/ceb/en/zh→x)分别报告 spBLEU 与 xCOMET:FFT 主要改善 en→x(55.61)却让 ne→x 从 44.62 掉到 36.30;LST b4t16 各枢轴全面上升(如 ne→x 44.62→49.47);连续 b16 各枢轴大幅退化。
展示英语中心与真多语言的差别和各配置逐语言行为,支撑方法在低资源语言上的实际价值判断。
反方向(x→ne/ceb/en/zh)的逐枢轴 spBLEU 与 xCOMET:LST b4t16 在 x→ne 46.84→57.12、x→ceb 26.28→28.27(8B;14B 达 29.11)等方向显著提升;FFT 在 x→ne 掉到 35.77、x→ceb 掉到 22.01。
与 Table 3 合起来覆盖全部翻译方向,验证提升不是单一方向的偏科,而是跨 100+ 语言的一致改进。