分组值注意力:经由按需键重构的高效KV缓存 Grouped Value Attention: Efficient KV Caching via On-Demand Key Reconstruction
只缓存分组值,把键的线性映射吸收进查询按需重构,KV缓存省45-47%而精度几乎持平
前置知识
KV 缓存
自回归解码时每步只需最新 token 的查询,但注意力需要所有历史位置的键和值,因此推理引擎把它们缓存在显存中。多头注意力下每层每序列要存 $2THd_h$ 个标量($T$ 为缓存长度、$H$ 为头数、$d_h$ 为头宽),随上下文长度线性增长,成为长上下文服务中显存容量与内存带宽的双重瓶颈。
全文围绕如何压缩这条缓存展开,文中所有缓存计数公式($N_{GQA}$、$N_{MLA}$、$N_{GVA}$)和 45-47% 的节省结论都必须在这一背景下才能理解。
分组查询注意力(GQA)
MHA 与 MQA 之间的折中:$H$ 个查询头分成 $G$ 组,每组共享一个键-值头,缓存降为 $2TGd_h$,质量接近 MHA、解码速度接近 MQA,被 Llama 2 70B 等主流开源模型采用。$G=H$ 退化为 MHA,$G=1$ 退化为 MQA。
GVA 直接建立在 GQA 的分组结构之上,保留了同样的查询头数与值分组,只替换键的来源,是本文全部对比实验的基线。
RoPE 与解耦 RoPE
RoPE 通过对查询和键施加位置相关的旋转矩阵 $R_t$ 来编码相对位置。解耦 RoPE(源自 DeepSeek MLA)把每个头拆成不旋转的内容切片和宽度 $d_r$ 的旋转位置切片,位置键跨头共享、单独缓存,保证相对位置计算中间没有学习到的变换。标准 RoPE 若作用于重构键,相对旋转 $R_{j-t}$ 会夹在查询与映射之间,破坏矩阵吸收。
理解 RoPE 为何与吸收冲突、解耦设计如何绕开这一障碍,是看懂 GVA 整体方案(尤其 Algorithm 1 和缓存公式 $T(Gd_h+d_r)$)的前提。
矩阵吸收(absorption)
当键是缓存值的固定线性变换时,如 $k_j = v_j M$,内积可以重排:$q(k_j)^\top = (qM^\top)v_j^\top$。即在查询侧一次性算好 $\tilde{q}=qM^\top$,之后直接与原始缓存做内积,键张量完全无需被物化或存储。这是 MLA 解码时省掉 up-projection 的同款技巧。
吸收恒等式是 GVA 解码路径的理论核心:正因为 $M_h$ 固定、可吸收进查询,内容键才不需要写入缓存,整个'只存值'的方案才成立。
多头潜在注意力(MLA)
DeepSeek 提出的 KV 压缩方案:把键值压进宽度 $d_c$ 的联合低秩隐变量,加上宽度 $d_r$ 的共享 RoPE 切片一起缓存(共 $T(d_c+d_r)$),解码时隐变量到键的 up-projection 可吸收进查询。代价是缓存路径上多一个学习到的瓶颈投影,解码实现更复杂。
MLA 是本文最主要的对比方法:GVA 与它的根本区别在于持久状态是值本身而非压缩隐变量,理解这一点才能把握论文的定位与贡献边界。
研究动机
自回归解码每生成一个 token 都要读取所有历史位置的键和值,KV 缓存因此随上下文长度线性增长:多头注意力每层每序列需存 $2THd_h$ 个标量,在长上下文服务中成为显存容量和缓存读取带宽的主导成本。已有方案各有代价:GQA 把 $H$ 个查询头分成 $G$ 组共享键值头,缓存降到 $2TGd_h$,但每个位置仍要写键、值两条完整流;MQA 压到单组($G=1$)缓存最小,却以质量和部分场景下的训练稳定性为代价;DeepSeek 的 MLA 把键值压进宽度 $d_c$ 的联合隐变量加 $d_r$ 的共享 RoPE 切片(共 $T(d_c+d_r)$),缓存更小,但引入额外投影和更复杂的解码路径。问题依然开放:能否设计一种缓存表示,把每个 token 的持久状态压到 GQA 的一半左右,同时零样本质量不出现可感知的下降?
本文的目标是本文的目标是构造一种'只存值'的注意力缓存方案:利用值本身已经携带注意力聚合所需内容这一观察,把评分用的键改为从缓存值通过学习到的线性映射按需重构($K=VM$),并让该映射在推理期固定、可被吸收进查询,从而使内容键完全不需要被缓存或物化;位置信息由极小的共享解耦 RoPE 通道保留。量化目标是:在与 GQA 相同的分组与查询头配置下,把持久缓存标量从 $2TGd_h$ 降到 $T(Gd_h+d_r)$,即在所研究配置下减少约 45-47%;并在 350M 参数、30B FineWeb-Edu token 的受控预训练中,使五项零样本基准的平均精度保持在 GQA 同一水平(44.35 对 44.36)。作者明确定位这是'质量几乎无损的缓存减半',而非追求质量提升。
与已有工作不同的是,切入角度的独特之处在于对'缓存里该放什么'的重新选择。GQA/MQA 缓存键和值两条流、按头分组共享;MLA 把两者融合压缩成一个学习出的隐变量。本文则注意到键和值编码的是同一底层 token 内容,于是反问:键既然只用于打分,能否不存、要用时从值线性导出?由此得到 $K_h=V_{g(h)}M_h$ 的每查询头重构映射,用 $H$ 个映射从 $G$ 条值流恢复出 $H$ 条彼此不同的内容键流——这甚至比 GQA 的组内共享键拥有更多键多样性。作者还先做了消融式的失败尝试 Shared KV(直接令 $K=V$,缓存正好减半),发现训练损失始终无法恢复到 GQA 水平,从而论证'必须有专门的重构映射'这一设计必要性。这条从失败对照出发的证据链,在注意力架构类工作中相当少见。
核心方法
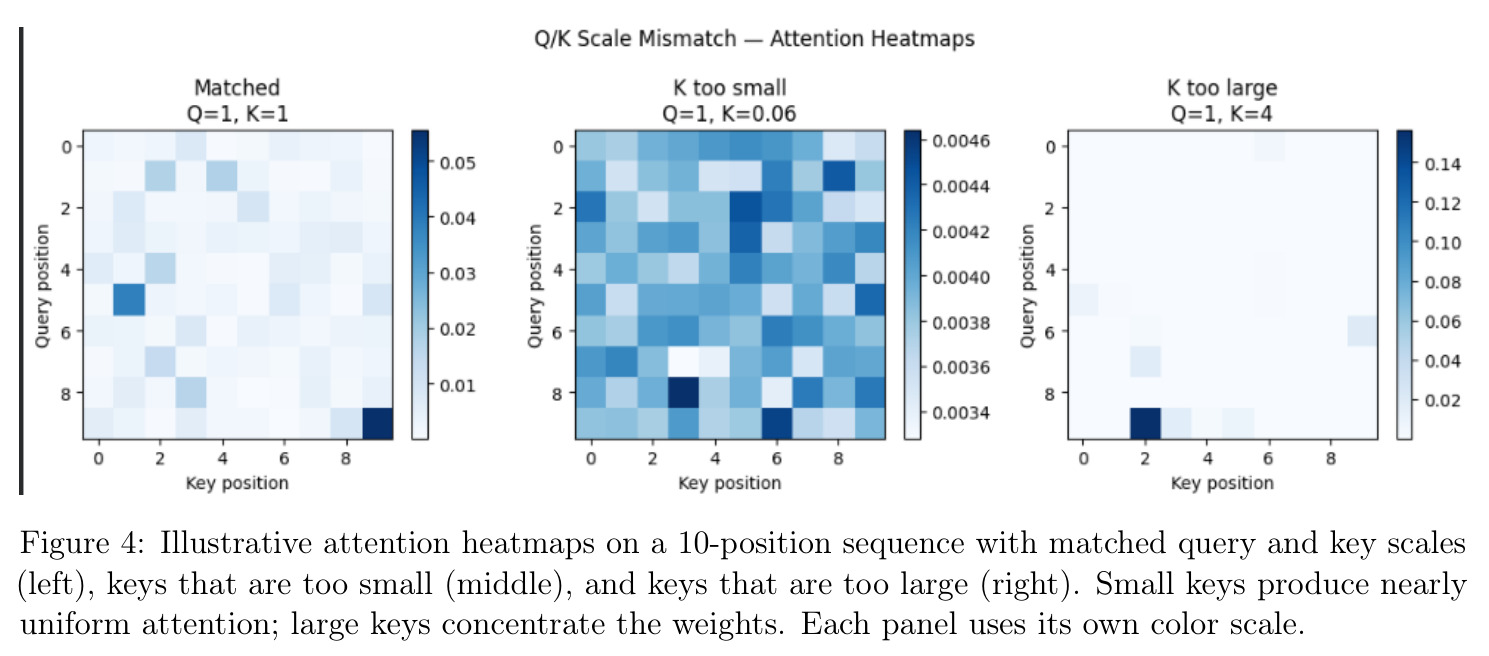
直觉上,注意力中键负责打分、值负责被加权聚合,两者源自同一 token 表示,因此'打分视图'可以从'存储视图'线性变换得到。技术上,GVA 保留 GQA 的分组结构($H$ 个查询头共享 $G$ 个值头),只改键:每个查询头 $h$ 配映射 $M_h\in\mathbb{R}^{d_h\times d_n}$,内容键按 $k^{\text{nope}}_{j,h}=v_{j,g(h)}M_h$ 重构,缓存里只有分组值。解码时利用吸收恒等式 $q_h(v_jM_h)^\top=(q_hM_h^\top)v_j^\top$,每个新 token 只需对每头算一次 $\tilde{q}_{t,h}=q^{\text{nope}}_{t,h}M_h^\top$,直接与值缓存做内积,内容键从未被物化。位置由解耦 RoPE 通道承担:宽度 $d_r$ 的共享位置键 $k^{\text{rope}}_j=(x_jW_r)R_j^\top$ 单独缓存,仅占每 token 几个标量。每层每序列持久缓存 $N_{GVA}=T(Gd_h+d_r)$,相对 GQA 的 $2TGd_h$ 约省 45-47%。
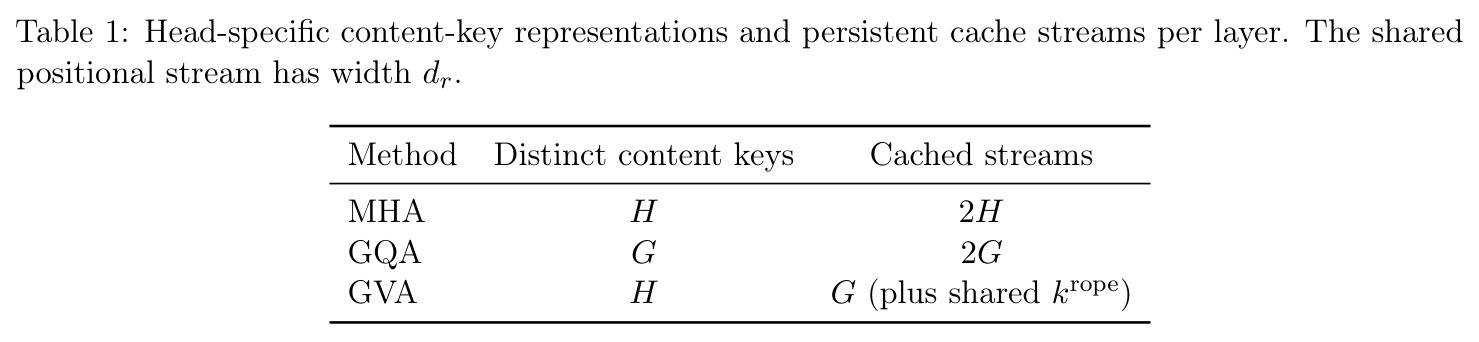
核心创新是'值为持久状态、键按需重构、映射吸收进查询'三位一体。与 GQA 的本质区别:GQA 组内所有查询头对同一个键向量打分(每层 $G$ 条键流),而 GVA 用每头独立的 $M_h$ 从同样的 $G$ 条值流重构出 $H$ 条彼此不同的内容键流,键多样性由映射参数提供,持久缓存却仍是 $G$ 条值流加一条共享位置流。与 MLA 的本质区别:MLA 的持久状态是压缩隐变量,参与聚合前必须先 up-projection;GVA 的持久状态就是直接参与加权和的值本身,缓存路径上没有任何额外投影,保留了'直接的值路径'。两者为省缓存付的代价也不同:MLA 付一个学习瓶颈投影,GVA 付一个值到键的线性映射。此外,标准 RoPE 的相对旋转 $R_{j-t}$ 依赖查询-键位置对且夹在 $q_t$ 与 $M^\top$ 之间,会破坏吸收;解耦 RoPE 把位置信息隔离到旋转之间没有学习参数的小切片中,是使整个方案成立的关键拼图。
方法步骤详情
训练时每个 token 计算 $q_t=x_tW_Q$、$v_t=x_tW_V$,每头查询拆成不旋转内容切片与宽度 $d_r$ 的旋转切片;值按 $G$ 组写入缓存;内容键由 $k^{\text{nope}}_{j,h}=v_{j,g(h)}M_h$ 现算,共享位置键单独缓存;分数为内容项加位置项,以标准因果注意力训练。初始化按 $\sigma_M=\sigma_Q/(\sigma_V\sqrt{d_{in}})$ 匹配键与查询的初始 RMS,避免重构键初始尺度过小、注意力近乎均匀。解码侧(Algorithm 1):对当前隐状态算 $q_t,v_t$,把 $v_{t,g}$ 追加进各组值缓存、$k^{\text{rope}}_t$ 追加进位置缓存;对每头旋转位置切片、吸收内容切片得 $\tilde{q}_{t,h}=q^{\text{nope}}_{t,h}M_h^\top$;分数由 $\tilde{q}_{t,h}$ 与组内值缓存的内积加上位置项得到,softmax 后对值加权求和输出,全程不物化内容键。
技术新颖性
新颖性可拆成三点。第一,缓存表示的选择本身是新的:把'存什么'(值,聚合所需)与'用什么打分'(从值线性导出的键)解耦,据作者所述这是首个以值为持久内容状态的 KV 压缩设计;吸收技巧虽源自 MLA,但 MLA 吸收的是隐变量 up-projection,GVA 把它推广为值-键映射的查询侧吸收。第二,每查询头独立映射 $M_h$ 以 $G$ 条值流的缓存成本实现 $H$ 条不同键流(Table 1),逆转了 GQA'省缓存必然共享键'的权衡,这是相对 GQA 的结构性优势;MLA 也是共享隐变量加每头 up-projection 来恢复键,思路相通但持久状态不同。第三,两个支撑性工程创新:尺度匹配初始化 $\sigma_M=\sigma_Q/(\sigma_V\sqrt{d_{in}})$ 解决了重构键初始 RMS 远低于查询、早期注意力近乎均匀、损失难以恢复的问题;以及诚实的失败对照 Shared KV 表明单个向量兼任键值不可行,为'必须专门重构'提供了消融证据。
实验结果
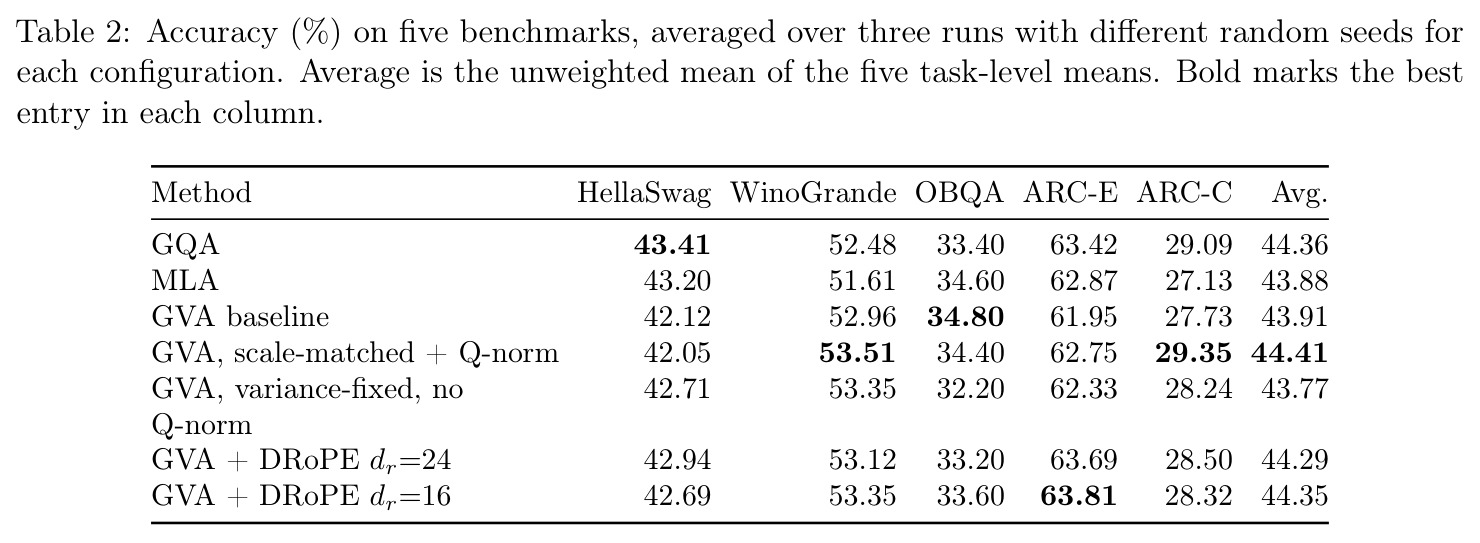
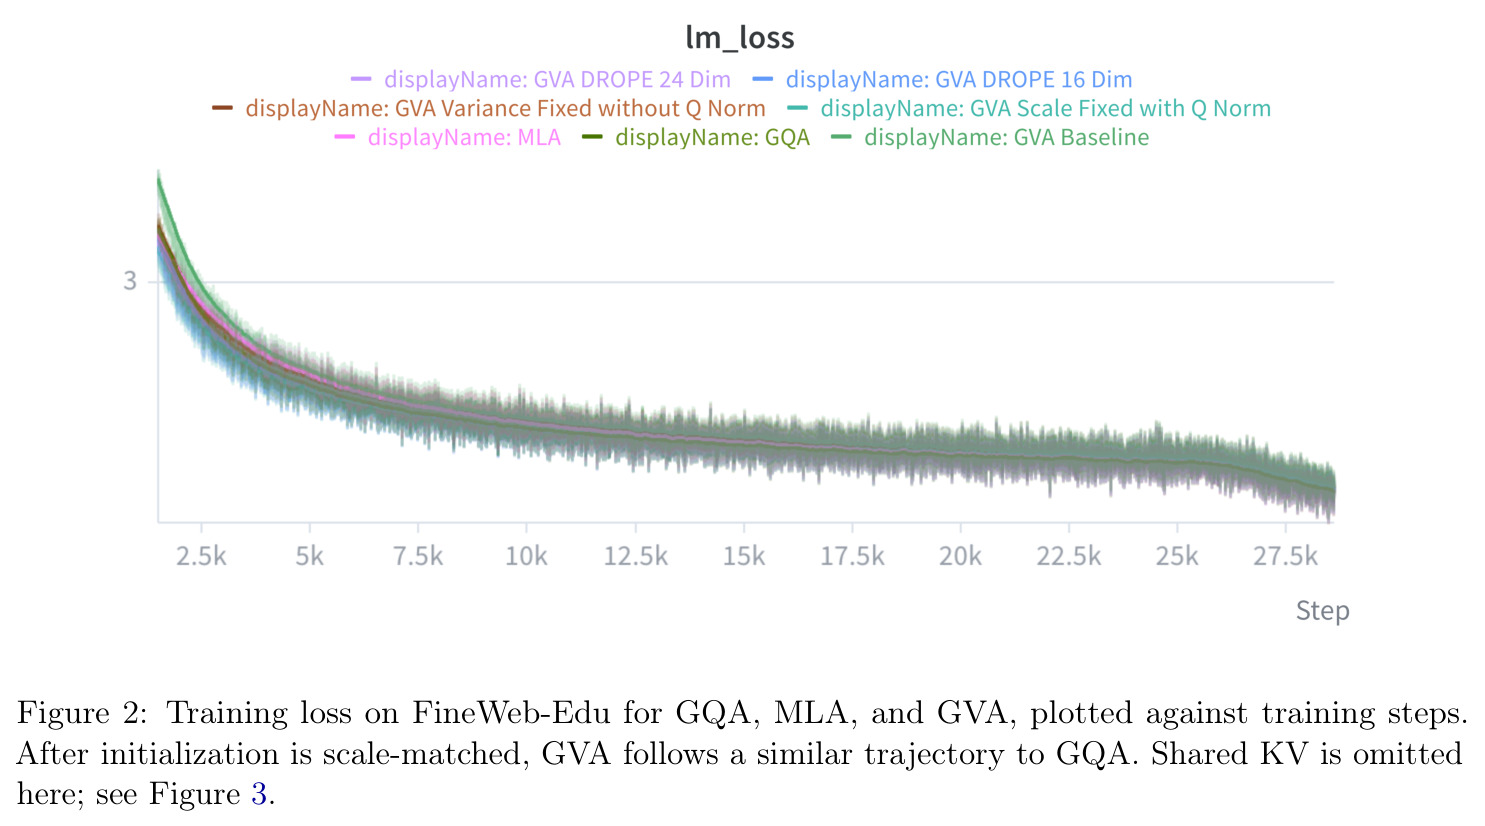
训练损失(Figure 2):350M 模型、30B token 设置下,尺度匹配后的 GVA 轨迹与 GQA、MLA 几乎重合;标准初始化的 baseline 早期更差、后期收窄,印证附录 A 的尺度解释;DRoPE 变体无二次崩溃。Shared KV 消融(Figure 3):$K=V$ 使缓存正好减半,但损失全程高于 GQA 且不闭合。下游精度(Table 2,每配置 3 seeds 平均):GQA 44.36,MLA 43.88,GVA baseline 43.91,scale-matched+Q-norm 达 44.41 为最强 GVA,variance-fixed 43.77;服务设计 GVA+DRoPE 在 $d_r=16$ 时平均 44.35,仅比 GQA 低 0.01pp,单项互有胜负,$d_r=24$ 时 44.29,故 $d_r=16$ 是更好工作点。缓存:DRoPE 版本 $T(Gd_h+d_r)$ 相对 GQA 的 $2TGd_h$ 约省 47%($d_r=16$)/45%($d_r=24$)。作者强调这些是表示级计数而非实测服务内存,系统级测量尚未报告。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五项零样本基准平均(HellaSwag/WinoGrande/OBQA/ARC-E/ARC-C) | 平均准确率(%,3 seeds 均值) | 44.35(GVA+DRoPE, dr=16) | 44.36(GQA)/ 43.88(MLA) | -0.01pp(与 GQA 基本持平),同时缓存标量减少约 47% |
| HellaSwag | 零样本准确率(%) | 42.69(GVA+DRoPE, dr=16) | 43.41(GQA) | -0.72pp |
| WinoGrande | 零样本准确率(%) | 53.35(GVA+DRoPE, dr=16) | 52.48(GQA) | +0.87pp |
| OpenBookQA | 零样本准确率(%) | 33.60(GVA+DRoPE, dr=16) | 33.40(GQA) | +0.20pp |
| ARC-Easy | 零样本准确率(%) | 63.81(GVA+DRoPE, dr=16) | 63.42(GQA) | +0.39pp |
| ARC-Challenge | 零样本准确率(%) | 28.32(GVA+DRoPE, dr=16) | 29.09(GQA) | -0.77pp |
| 每层每序列 KV 缓存标量数 | 相对 GQA($2TGd_h$)的比例 | $T(Gd_h+d_r)$,约为 GQA 的 53%(dr=16)/ 55%(dr=24) | $2TGd_h$(GQA) | 缓存减少约 47%(dr=16)/ 45%(dr=24);值-only 变体为理想减半 |
局限与改进
作者明确承认的局限:所有对比只在约 350M 参数、30B FineWeb-Edu tokens 这一个规模与数据混合上进行;每个配置仅 3 个随机种子,平均分上 0.01 个百分点的差异不应被解读为统计显著;DRoPE $d_r=24$ 的平均分(44.29)低于 GQA,说明对位置切片宽度敏感,且未系统扫描 RoPE 宽度、加法式与切分式的内容/位置宽度分配、以及更长上下文;45-47% 的缓存削减是表示级计数,不是实测服务内存,融合解码吞吐、峰值显存、批容量均未报告;自定义解码内核仍在测试、代码尚未开源。我的补充观察:小模型上'键可由值线性导出'的假设未必随规模保持,7B 以上是否成立未知;评测完全缺少长上下文与检索型任务,$d_r=16$ 的共享位置通道在 32k/128k 语境下是否够用没有证据;与 KV 量化、稀疏化、滑动窗口等正交压缩手段的组合效果未讨论;prefill 阶段因每头独立重构映射,注意力计算形状与 GQA 不同,其对首 token 延迟的影响也未测量。
独立分析的弱点
第一,规模单一:仅 350M 验证,应在 1B/7B/13B 复现,并分析 $M_h$ 的有效秩与奇异值谱随规模的变化,检验 $K=VM$ 的表达能力是否成为瓶颈。第二,系统收益未兑现:省 47% 标量不等于省 47% 带宽或延迟,若内核实现不佳可能得不偿失,应尽快发布融合核并与 GQA、MLA 内核做同硬件 TTFT/TPOT/吞吐对比。第三,统计功效不足:3 个 seeds 撑不起 0.01pp 量级的结论,应增加种子数并报告方差与显著性检验。第四,位置宽度敏感:$d_r=24$ 反而比 $d_r=16$ 差提示超参未调优,应系统扫描 $d_r\in\{8,16,24,32,64\}$ 并结合上下文长度做外推实验。第五,缺长上下文评测:应在 needle-in-a-haystack、长文档问答上验证共享位置通道的容量极限。第六,映射参数开销未分析:每层新增 $H\cdot d_h\cdot d_n$ 参数虽与序列长度无关,但与 MLA 投影相比,参数量-缓存-质量的三角权衡值得量化,必要时可对 $M_h$ 做低秩或跨层共享约束。
未来方向
作者提出的后续工作:完成自定义解码内核的端到端推理性能评估(融合解码吞吐、峰值服务内存、批容量)并开源发布;系统扫描 RoPE 宽度、模型规模与随机种子;探索内容/位置宽度的加法式与切分式分配。基于本文成果可自然延伸的方向:将 GVA 与 KV 量化结合——值成为持久状态后同时影响打分与聚合,其量化友好性与误差传播值得专门研究;对 $M_h$ 做结构化约束(低秩、块对角、跨层共享)以压缩映射参数;在 vLLM/SGLang 等服务框架中集成,实测长上下文与大批量并发下的真实收益;检验'值即可用键源'假设在更大规模与更长上下文下是否成立;理论上刻画哪些注意力模式无法由值线性重构键表达,为这类方法给出适用边界;在相同缓存预算下与 MLA 隐变量路线做系统的质量对比,而非仅比较固定配置下的绝对值。
复现评估
开源情况:论文称自定义解码内核与完整实现'即将开源'(open-source release planned soon),截至论文写作尚未发布;早期 Shared KV 实验的产物 Lumma-0.6B-Base 已开源在 Hugging Face,可作部分参考。数据与评测均为公开资源:FineWeb-Edu 的 30B token 子集、HellaSwag/WinoGrande/OpenBookQA/ARC 五项零样本基准均可用 lm-eval-harness 复现。算力方面,350M 模型在 30B token 上从零训练属于单机多卡数天量级(论文未给出具体 GPU 配置),每配置 3 个种子意味着约 3 倍开销,完整复现 Table 2 的 7 行约需 21 次训练。难度评估:概念与算法描述清晰(Algorithm 1 给出了解码伪码,附录 A 给出初始化推导),中等偏易;主要障碍是训练配方未完整披露——优化器超参、ZClip 配置、上下文长度、具体的 $G$ 与头数等细节缺失,需等官方代码发布后才能严格对齐。
论文图表
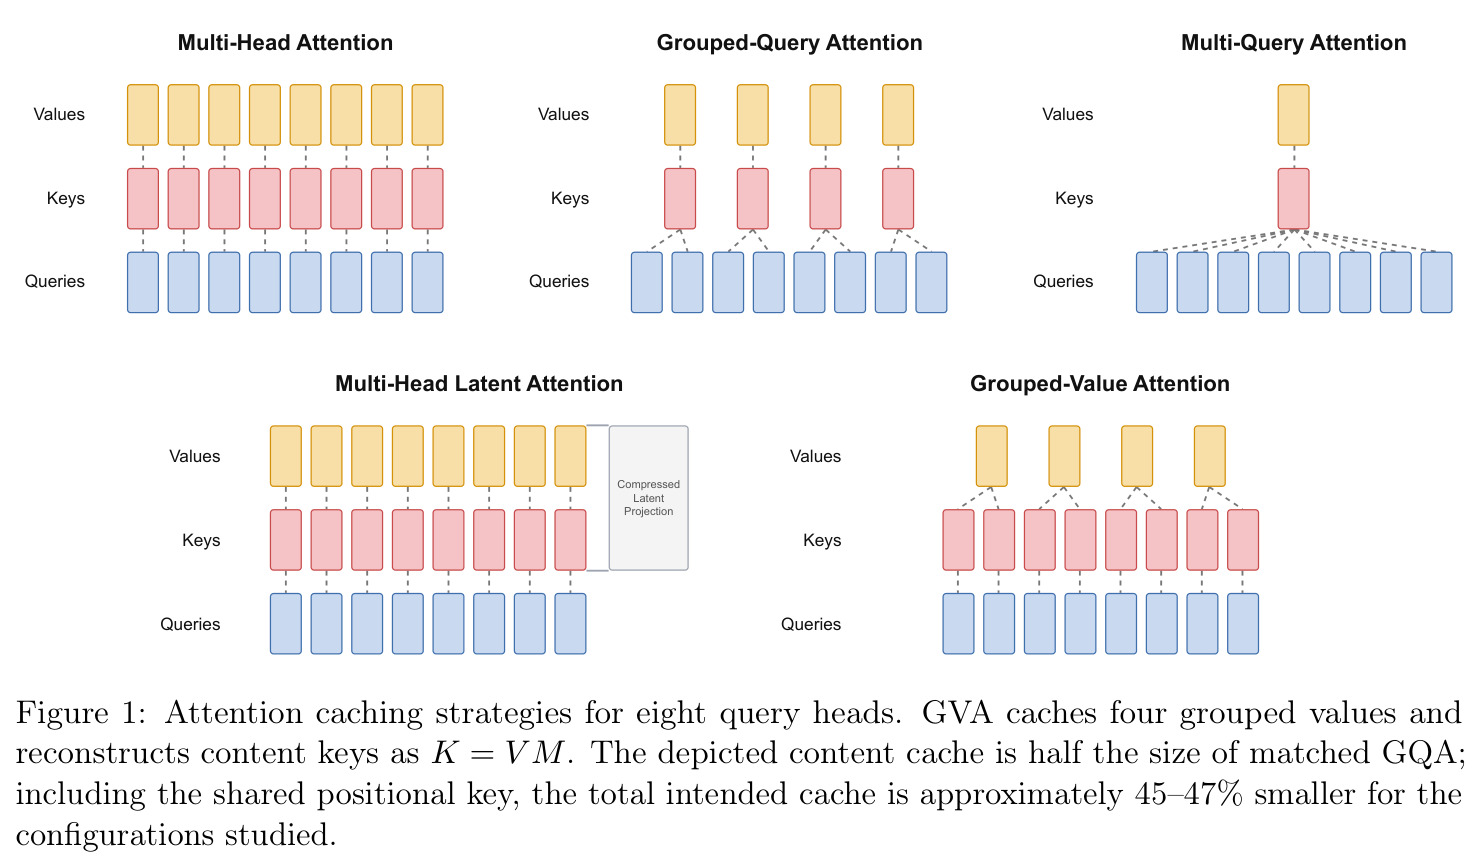
以 8 个查询头为例并排画出五种注意力缓存策略:MHA 缓存 8 组键与 8 组值,GQA 缓存分组后的键值流,MQA 只留单组,MLA 缓存压缩隐变量加共享 RoPE 切片,GVA 只缓存 4 条分组值流并以线性映射 $K=VM$ 重构内容键,图中还标注了隐变量投影路径。
一张图看清 GVA 在缓存策略谱系中的位置,以及它与 GQA/MLA 在'缓存里到底放了什么'上的本质差异,是理解全文贡献的入口。
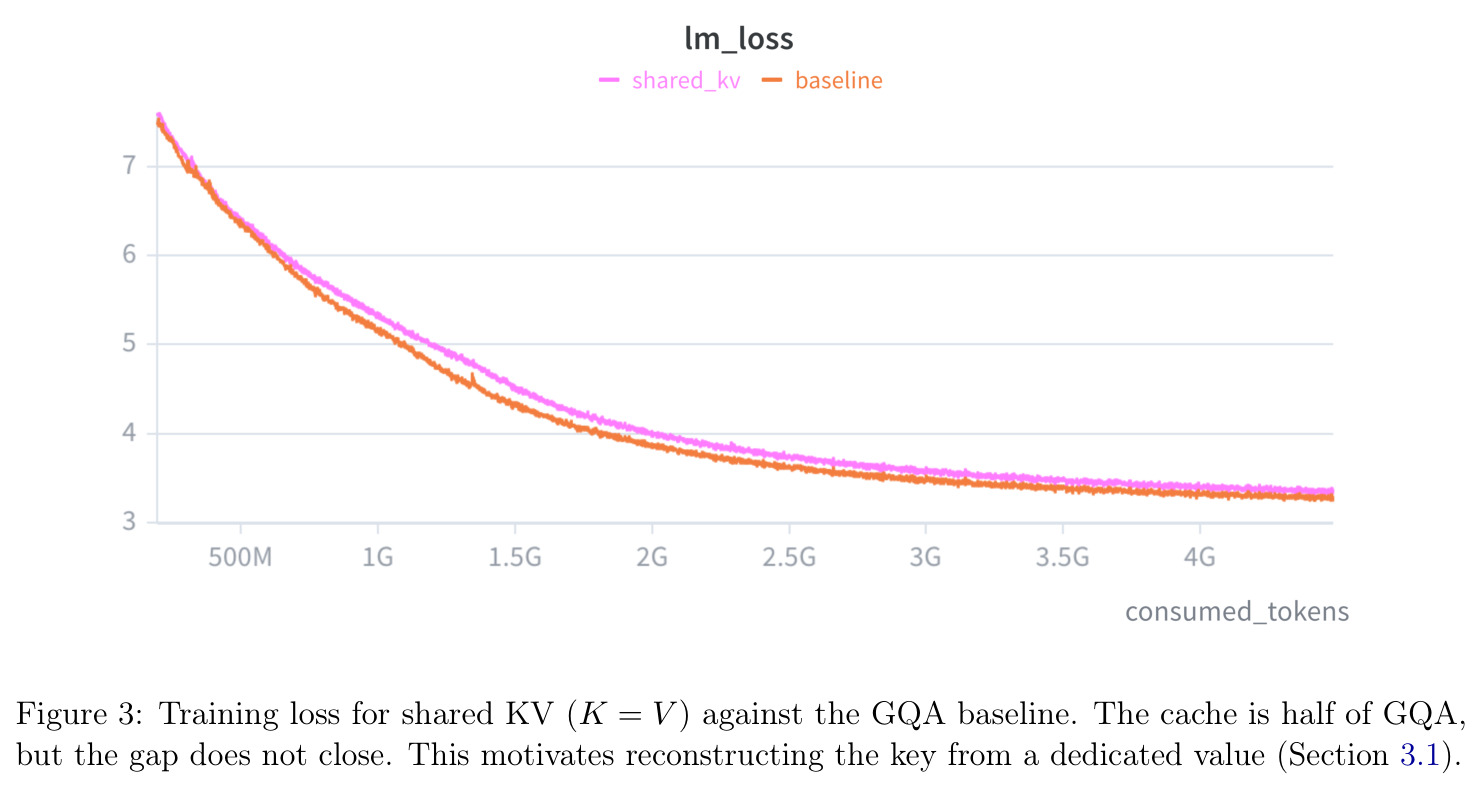
对比 $K=V$ 的共享 KV 设计与 GQA 基线的训练损失曲线:缓存虽然正好减半,但损失全程高于 GQA 且差距始终不闭合。
这是论文关键的失败消融:它证明单个向量无法同时承担打分与被检索两个角色,从而论证'必须有专门的重构映射',是 GVA 设计逻辑的证据起点。