随机注意力:重新思考面向高效推理的 KV 缓存驱逐 Random Attention: Rethinking KV Cache Eviction for Efficient Reasoning
保留提示词、按头随机驱逐的免评分KV缓存压缩,精度追平最强基线且吞吐高32–43%。
前置知识
KV 缓存
Transformer 自回归解码时,每层每个注意力头会把已算好的键($K$)和值($V$)向量缓存下来,避免每生成一个 token 就重算全部历史。缓存大小与序列长度、层数、KV 头数成正比,32k token 的长思维链会把大量显存耗在 KV 上,成为推理模型的内存瓶颈。
本文讨论的一切——驱逐、预算 $K$、吞吐——都建立在理解 KV 缓存结构与显存开销之上,不懂它就无法理解压缩的动机。
KV 缓存驱逐
解码期的压缩技术:缓存只保留固定预算 $K$ 对 KV 加最近 $r$ 条缓冲区,缓冲区每 $r$ 步填满就触发一次驱逐,按某种分数永久丢弃超出部分。它不同于稀疏注意力选择(保留全部但只计算子集),驱逐不可逆,丢错无法恢复,显存有硬上限。
Random Attention 就是一种驱逐策略,理解驱逐的周期机制与不可逆性,才能读懂其“保提示词+随机”设计的含义与风险。
注意力头与 GQA
每个注意力头独立维护自己的 Q/K/V 投影。现代模型多用分组查询注意力(GQA),多个查询头共享一个 KV 头(如 Qwen3-4B 有 8 个 KV 头)。同一个 token 在每个 KV 头各有一份副本,驱逐决策按头独立做出,一枚 token 只有在所有 KV 头都丢掉它时才真正消失。
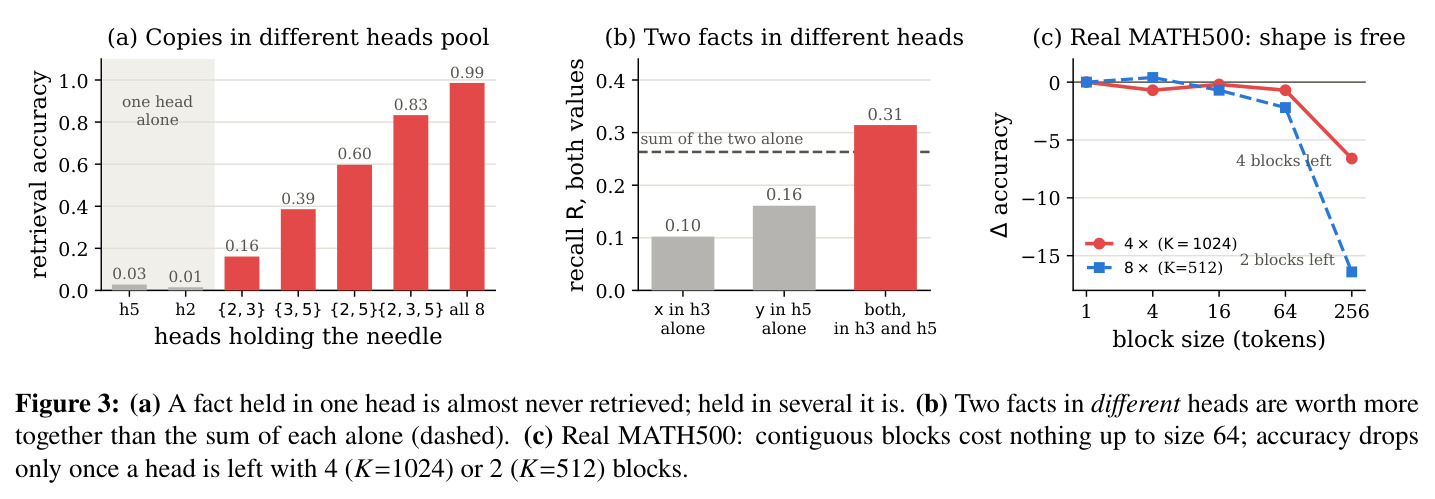
论文的核心机制发现——跨头冗余与超可加的 pooling(单头 3% vs 八头 99%)——完全依赖逐头驱逐与 GQA 结构。
注意力 sink
StreamingLLM 发现序列最早几个 token 会吸收异常高的注意力权重(softmax 偏置所致),即使内容无关也几乎不应被驱逐。多数驱逐方法默认只保留这些 sink token 和最近窗口,而不保护其余提示词(问题本身)。
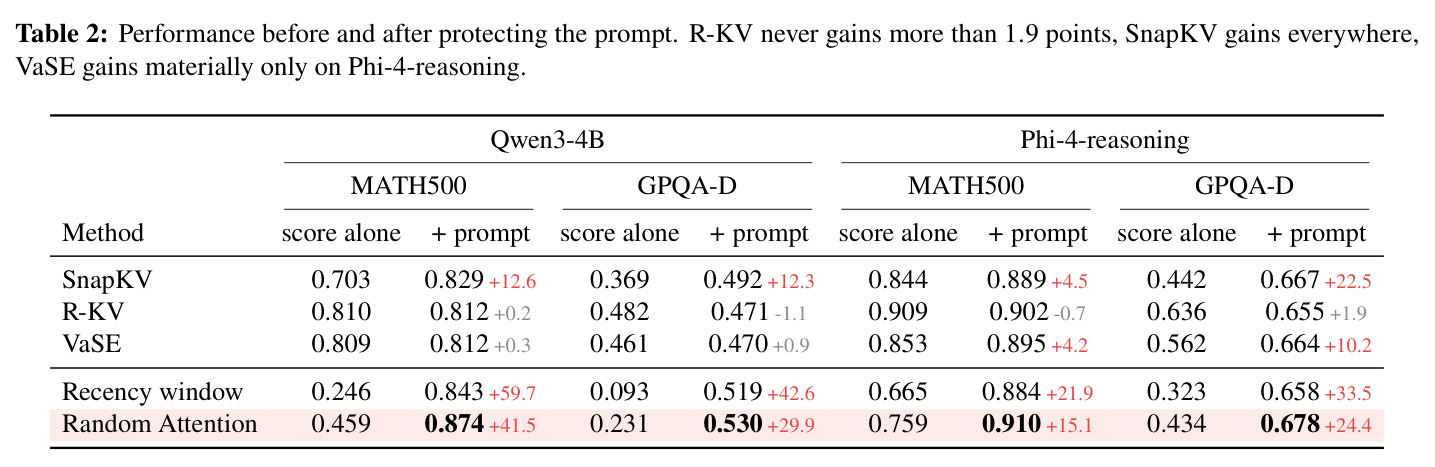
区分“默认只保 sink”与“全保提示词”两种保护 regime,是理解 Table 2 受控实验、即论文第一个核心论证的前提。
vLLM 与 PagedAttention
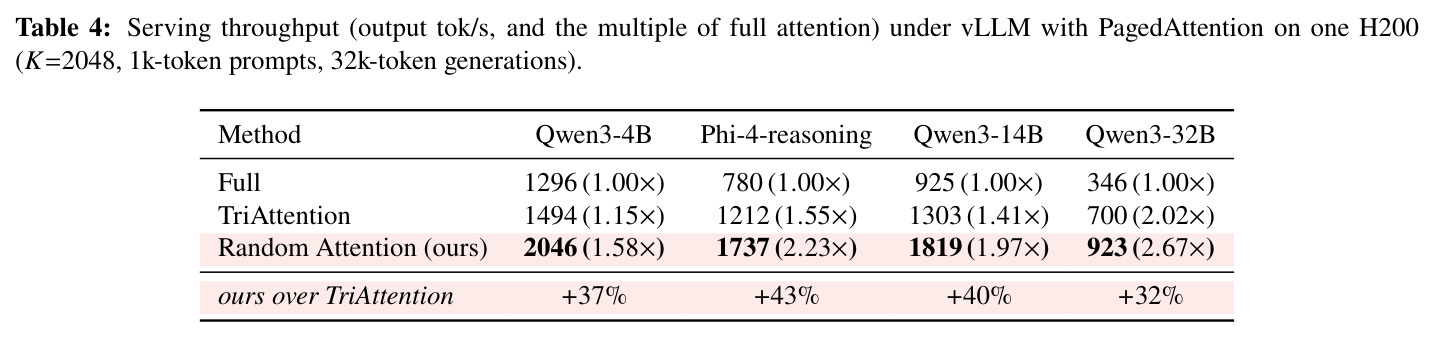
vLLM 是主流 LLM 服务系统,用分页方式管理 KV 缓存显存,显存不足时会抢占请求。压缩缓存能让单卡同时容纳更多并发请求从而提高吞吐;但内容相关的打分在分页状态下需要沿块表额外扫描缓存,这正是免评分的随机策略拿到 32–43% 吞吐优势的来源。
Table 4 的吞吐优势在 vLLM+PagedAttention 下测得,需理解其分页、抢占与批间同步机制才能解释差距为何这么大。
研究动机
推理模型靠生成长达数万 token 的思维链解决难题,KV 缓存随生成长度线性增长,成为严重显存瓶颈:32k token 生成时 Qwen3-32B 在单张 H200 上全注意力吞吐仅 346 tok/s。现有 KV 缓存驱逐方法共享同一范式:为每个缓存 token 估计一个“未来重要性”分数并保留 top-$K$。这条路线从 H2O 的累积注意力、SnapKV 的最近窗口注意力,到 R-KV 的注意力加冗余惩罚、VaSE 的值幅度、TriAttention 的位置相关三角统计,一代代改进分数设计;每代分数都靠与任务精度相关的启发式观察来论证,但所有方法共同的隐含前提——“选择信号决定压缩后的精度”——从未被直接检验,也没人量化过这个信号本身到底贡献几分。
本文的目标是本文的目标是直接检验上述前提,回答“驱逐策略的精度到底由什么决定”。具体做法是构造一个零信号策略 Random Attention:无条件保留全部提示词(系统提示、聊天模板与问题,共 $\ell_p$ 个位置),对其余缓存 token 在每个 KV 头内部做独立均匀随机驱逐,完全不计算任何分数。作者要求它在 4 个模型(Qwen3-4B/14B/32B、Phi-4-reasoning)与 6 个推理任务(MATH500、GPQA-D、AIME、HMMT、LiveCodeBench)上、在约 4× 压缩的匹配预算下与最强基线比精度,并在 vLLM 部署中比吞吐;若它能追平基线,则证明信号几乎无用,并让它成为今后任何新选择信号必须击败的零假设基线。
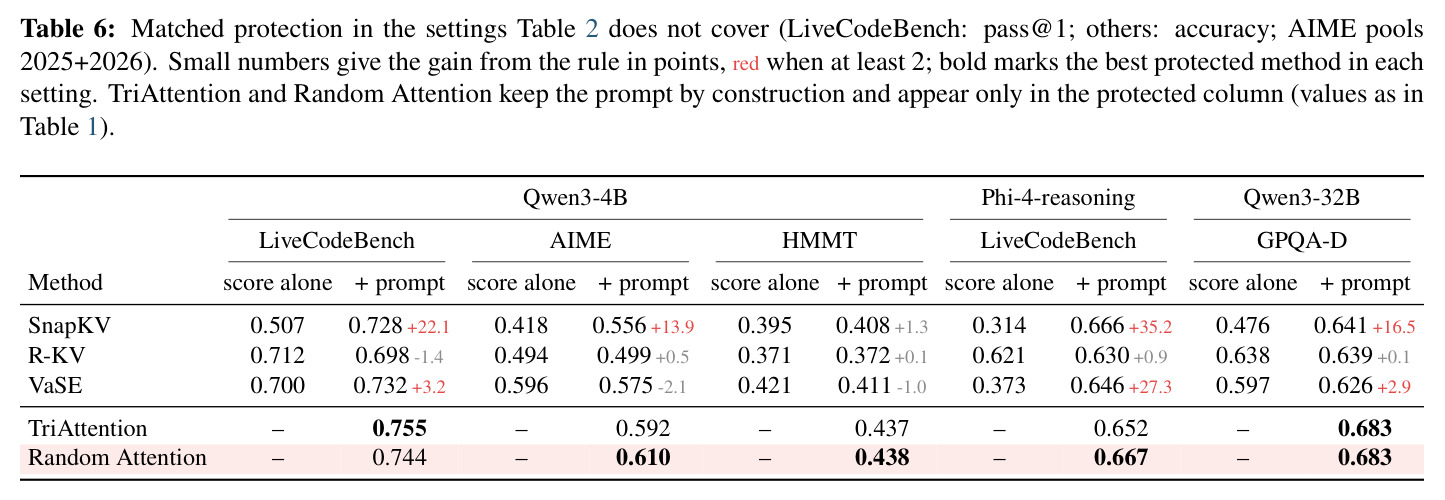
与已有工作不同的是,独特切入在于把两个被历史实验混淆的变量拆开:以往所有对比中,“方法的分数”与“方法默认是否保护提示词”是绑定的——TriAttention 默认保留全部输入,而 SnapKV、R-KV、VaSE 只保注意力 sink,跨文献结论因此难以比较(Chen et al. 2026 也指出协议差异使结果不可比)。本文通过受控实验给每个方法统一加上“保提示词”规则,把分数的贡献与提示词保护的贡献分离;再用植入事实探针(把合成事实插进真实思维链、精确控制哪些 KV 头保留它)直接度量推理轨迹的跨头冗余与文本冗余,从机制上解释随机为何够用。这是首个在匹配预算、匹配提示词保护下系统对比信号式选择与纯随机的解码期驱逐研究。
核心方法
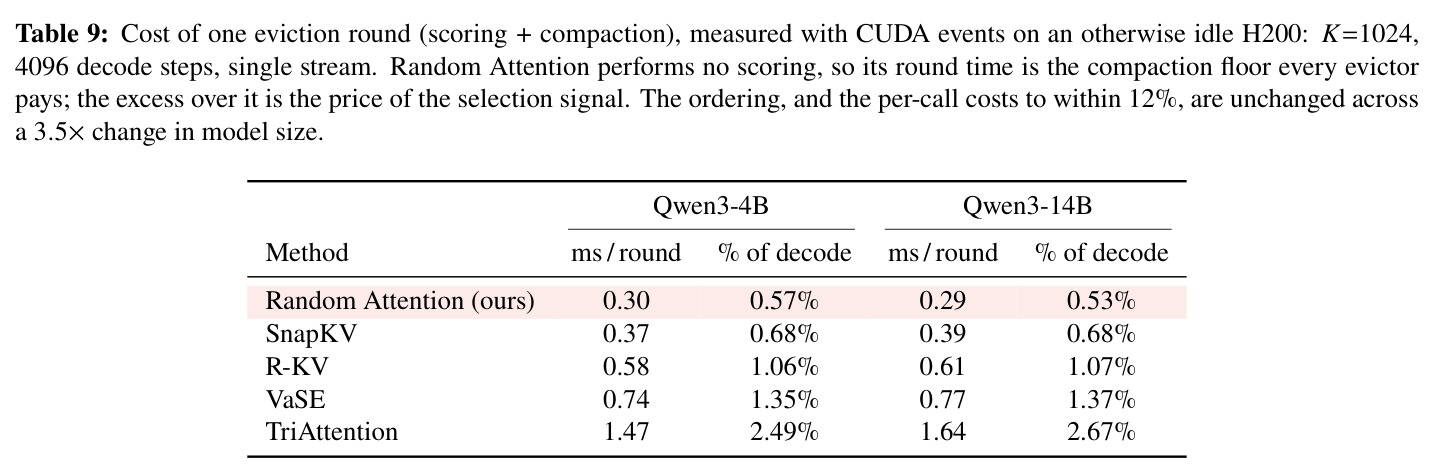
直觉是把缓存内容分成两类:不可再生的输入(问题只说一次,驱逐即永久丢失)和模型自己写的推理轨迹(工作状态,会随生成不断复述仍需要的中间结论)。对前者无条件全保;对后者用随机采样把预算均匀铺开。技术上沿用 Cai et al. 与 Chang et al. 的解码期周期驱逐框架:缓存保持 $K$ 对持久预算加最近 $r\ll K$ 对缓冲区,每 $r$ 步缓冲区填满触发一次驱逐;Random Attention 给候选集 $\mathcal{C}_t$ 中每个位置抽 i.i.d. 均匀随机分数 $s_i\sim\text{Uniform}(0,1)$,提示词位置置 $+\infty$,每个 KV 头独立保留 top-$K$。每次驱逐的全部开销就是一次 rand 加一次 topk,这是能写出的最弱“选择信号”,因此它同时是可部署方法与零假设。
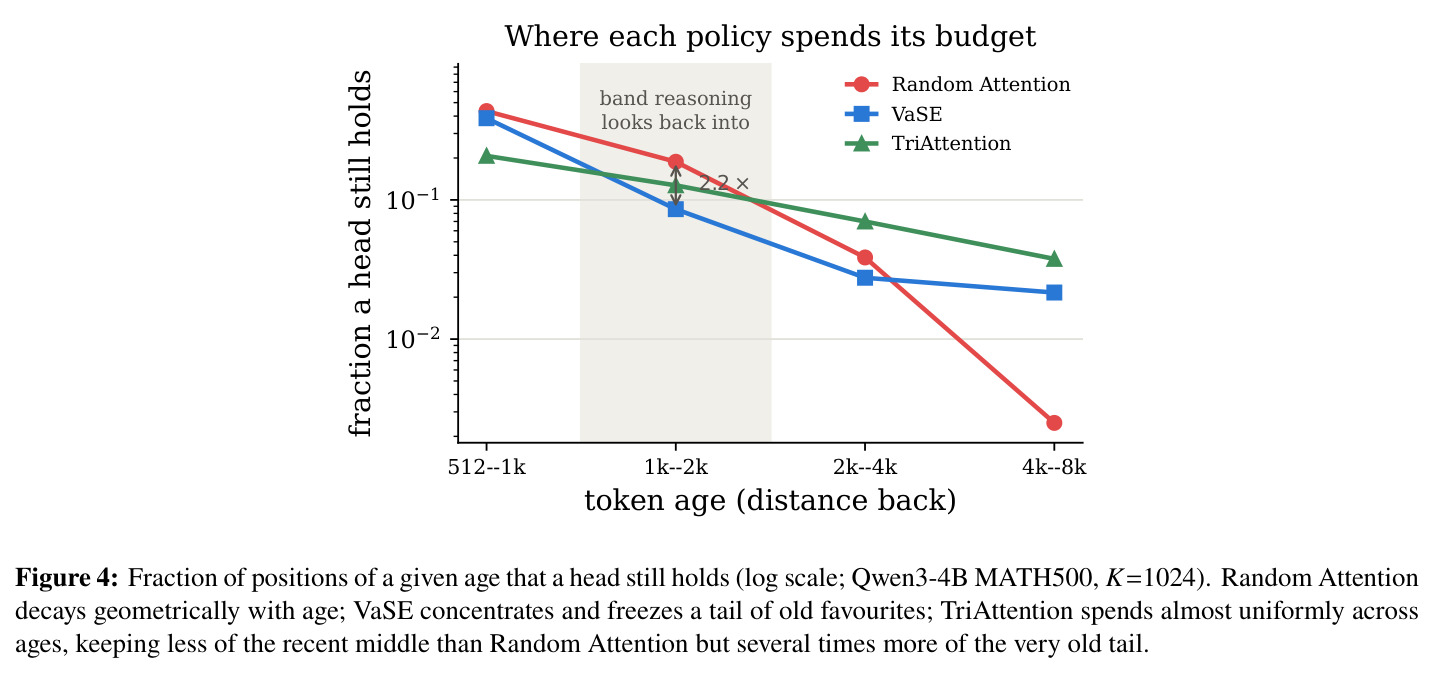
核心创新是“零信号”这一反直觉立场。H2O、SnapKV、R-KV、VaSE、TriAttention 的分数都依赖注意力统计或内容统计,需要对缓存做计算与排序;Random Attention 只有两条结构规则——保护提示词、逐头独立随机——除此之外不携带任何内容信息。它因此有双重身份:既是可部署方法(无需校准、无需调参、无需评分通道,实测是最快的驱逐器),又是零假设基线——任何在匹配预算且同样保护提示词时打不过它的信号式选择器,都没能从其信号中提取可用信息。这把研究重心从“如何更聪明地排序”转移到“如何保护不可再生内容”与“如何找回只说一次的事实”两个真问题。
方法步骤详情
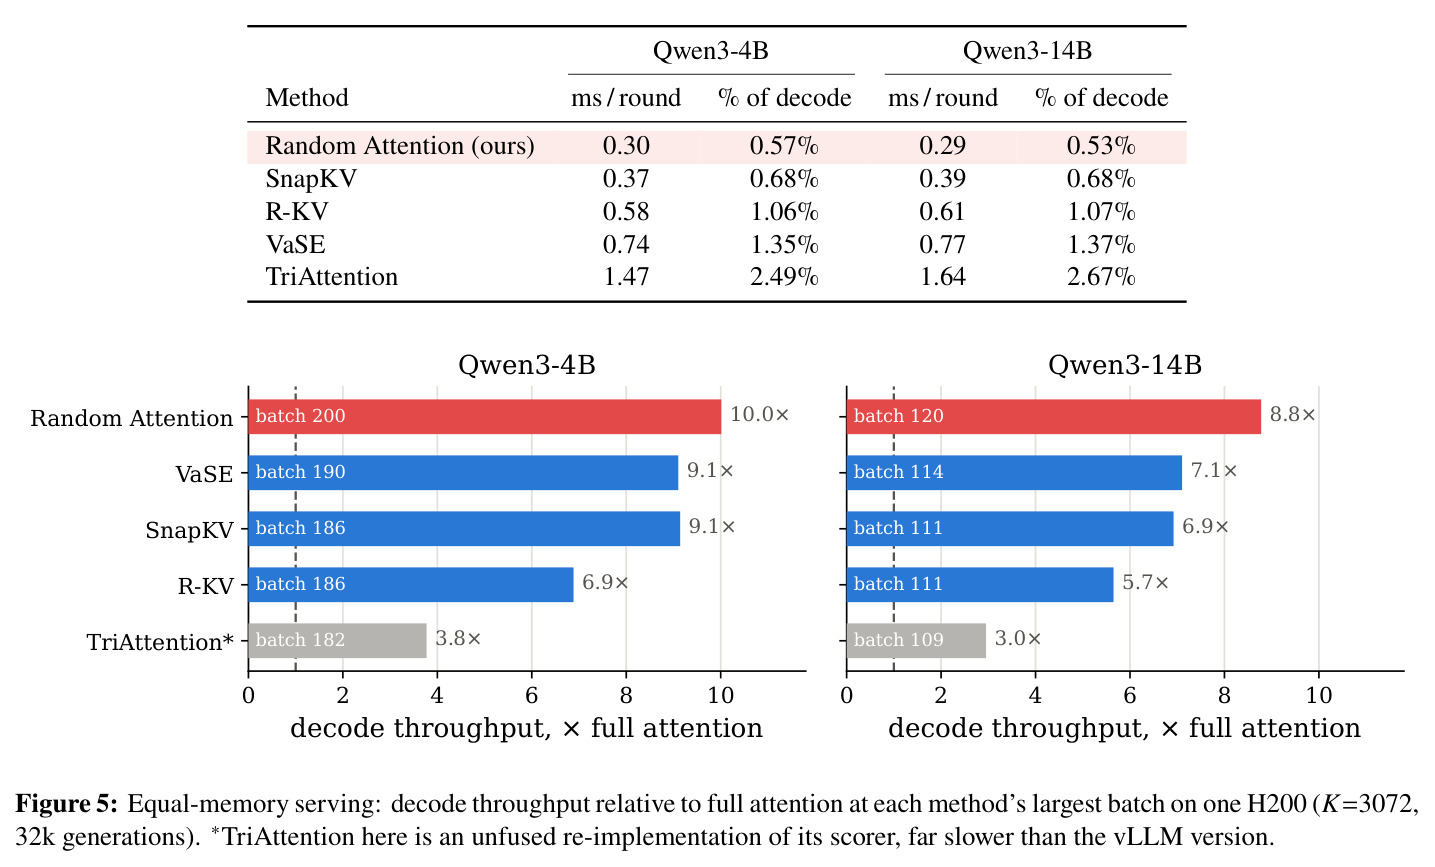
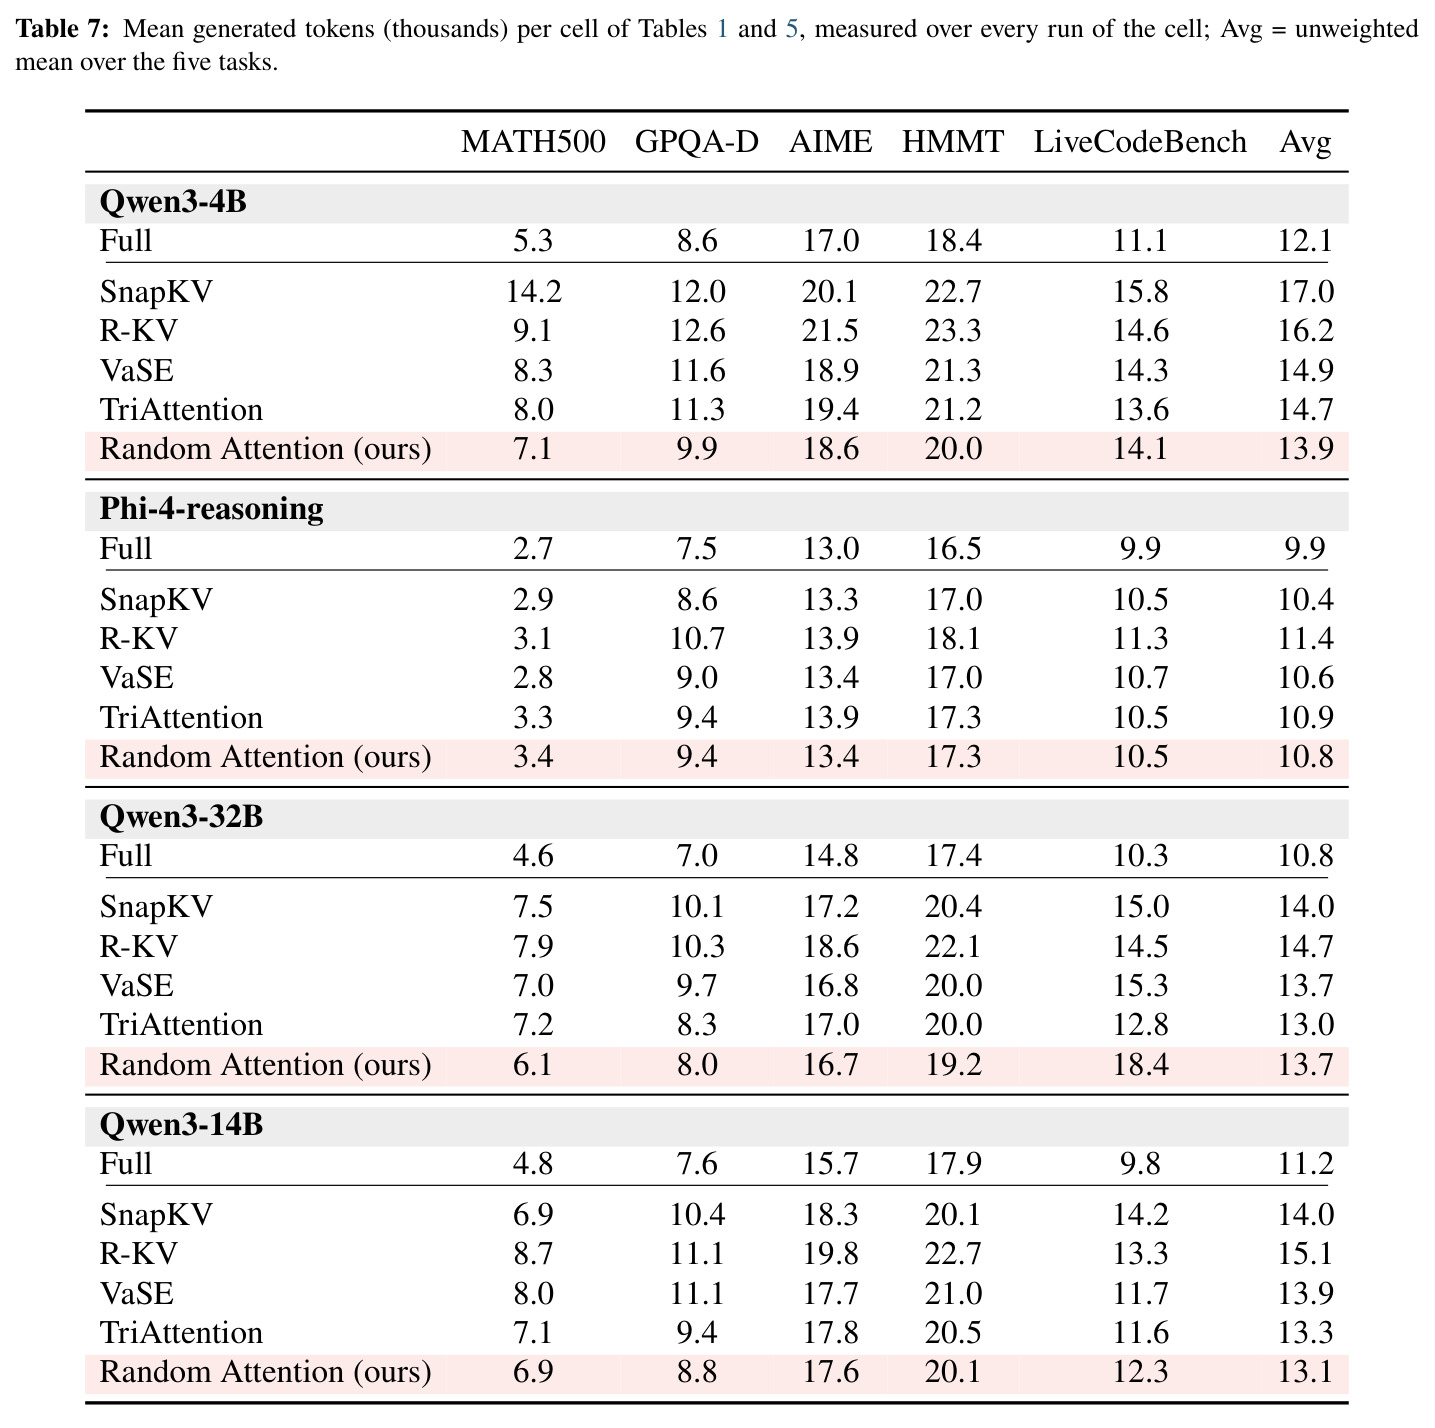
完整流程:1) 预填充后,位置 $1,\dots,\ell_p$ 的 KV(系统提示、聊天模板、问题)标记为永不驱逐;2) 解码时每步追加一个 KV 对进入最近缓冲区;3) 每 $r$ 步缓冲区满触发驱逐,对候选集 $\mathcal{C}_t$(缓冲区外的缓存位置)中每个位置抽 $u_i\sim\text{Uniform}(0,1)$,并把提示词位置分数置 $+\infty$;4) 执行 Algorithm 1:rand 生成形状 $(B,H_{\text{kv}},S)$ 的分数张量,强制保留提示词切片,topk 返回每个 KV 头保留的 $K$ 个位置;5) 被驱逐的 KV 对永久丢弃。vLLM 集成中它无需像 TriAttention 那样沿块表逐层重扫缓存计算分数,只做一次压缩,因此服务时单次驱逐仅 0.30 ms,而 TriAttention 需 1.47–1.64 ms;128 路并发下每 64 个 token 压一次,一个负载约 62k 次压缩,差距被成倍放大。
技术新颖性
方法本身只有 4 行伪代码,真正的新颖性是支撑它的三条机制性实证发现。其一,提示词是缓存中脆弱的部分:统一“保提示词”规则后,SnapKV 在 Phi-4-reasoning 的 GPQA-D 上升 22.5 分(0.442→0.667),纯 recency window 在 Qwen3-4B MATH500 上升 59.7 分(0.246→0.843),而本来就保提示词的 R-KV 最多只涨 1.9 分——说明基线间大部分差距其实是提示词保护差异而非分数质量。其二,推理轨迹靠双重冗余自保:文本层(模型复述所需内容)加跨头层(每个 KV 头各存一份副本),单头保留的植入事实只有 3% 检索率,两特定头 60%、三头 83%、八头 99%,pooling 强超可加。其三,副本形状无关:事实打散成跨头碎片(检索 0.33)与完整句子(0.39)几乎等效,真实 MATH500 上连续块长到 64 token 也无损。
实验结果
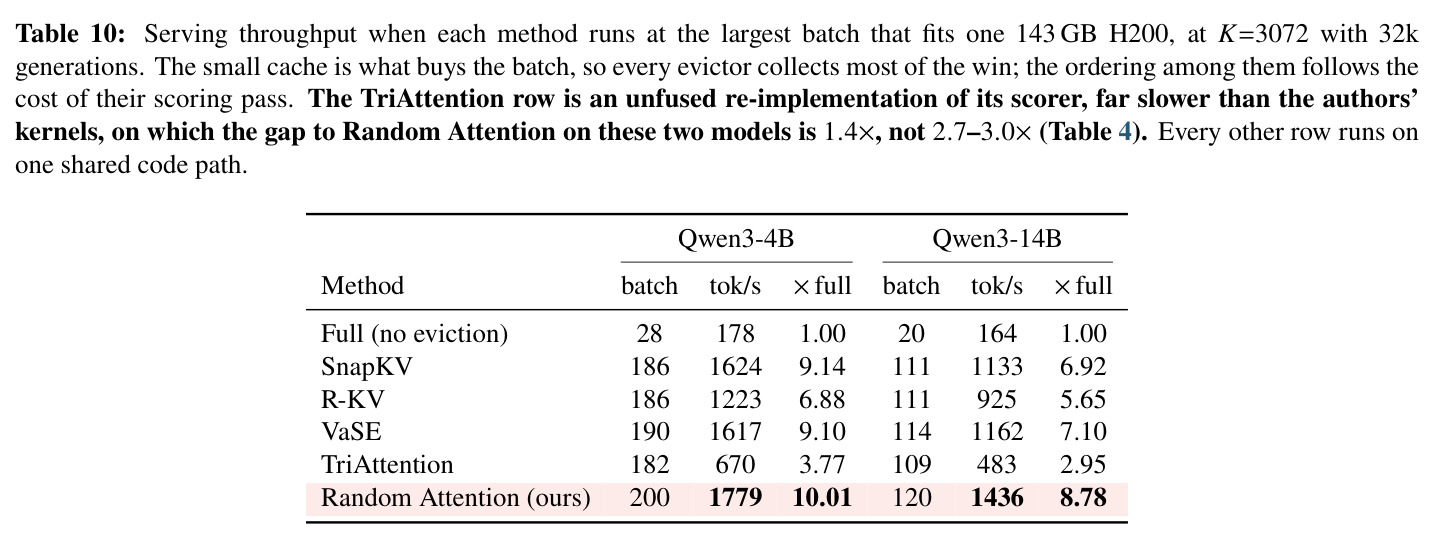
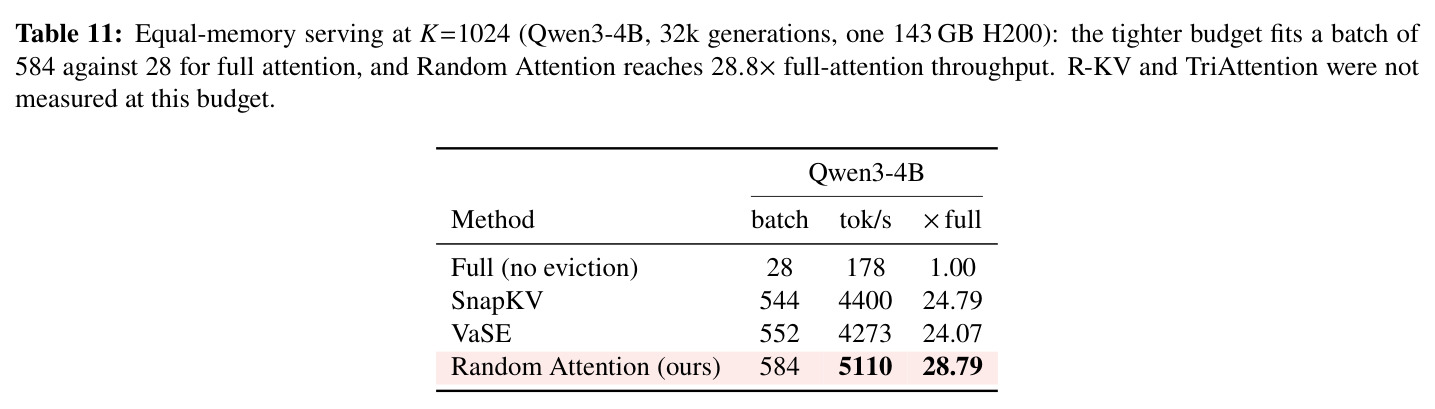
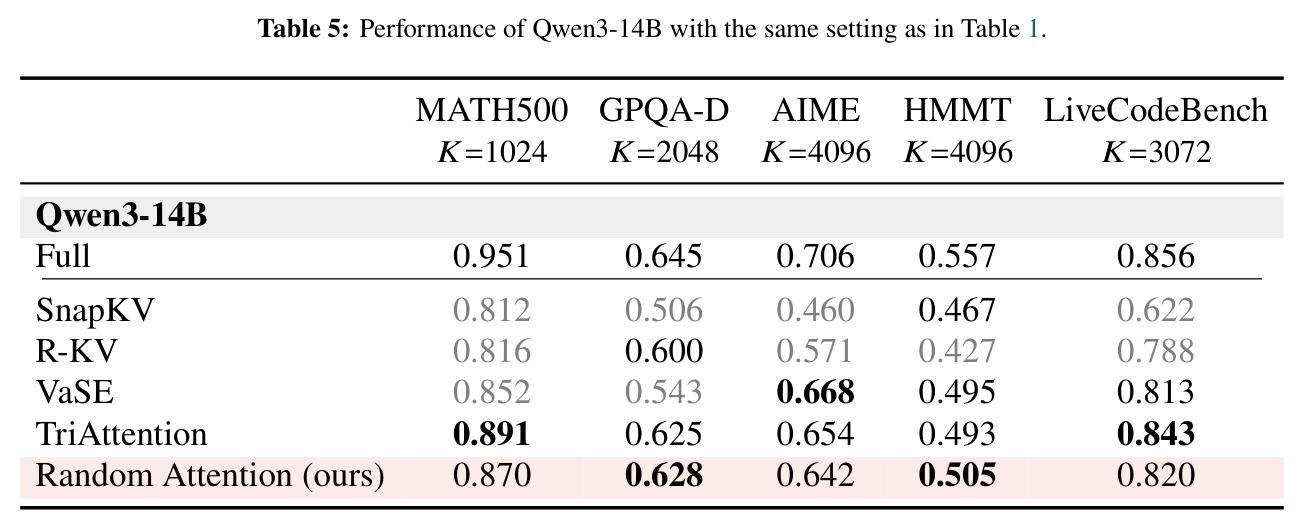
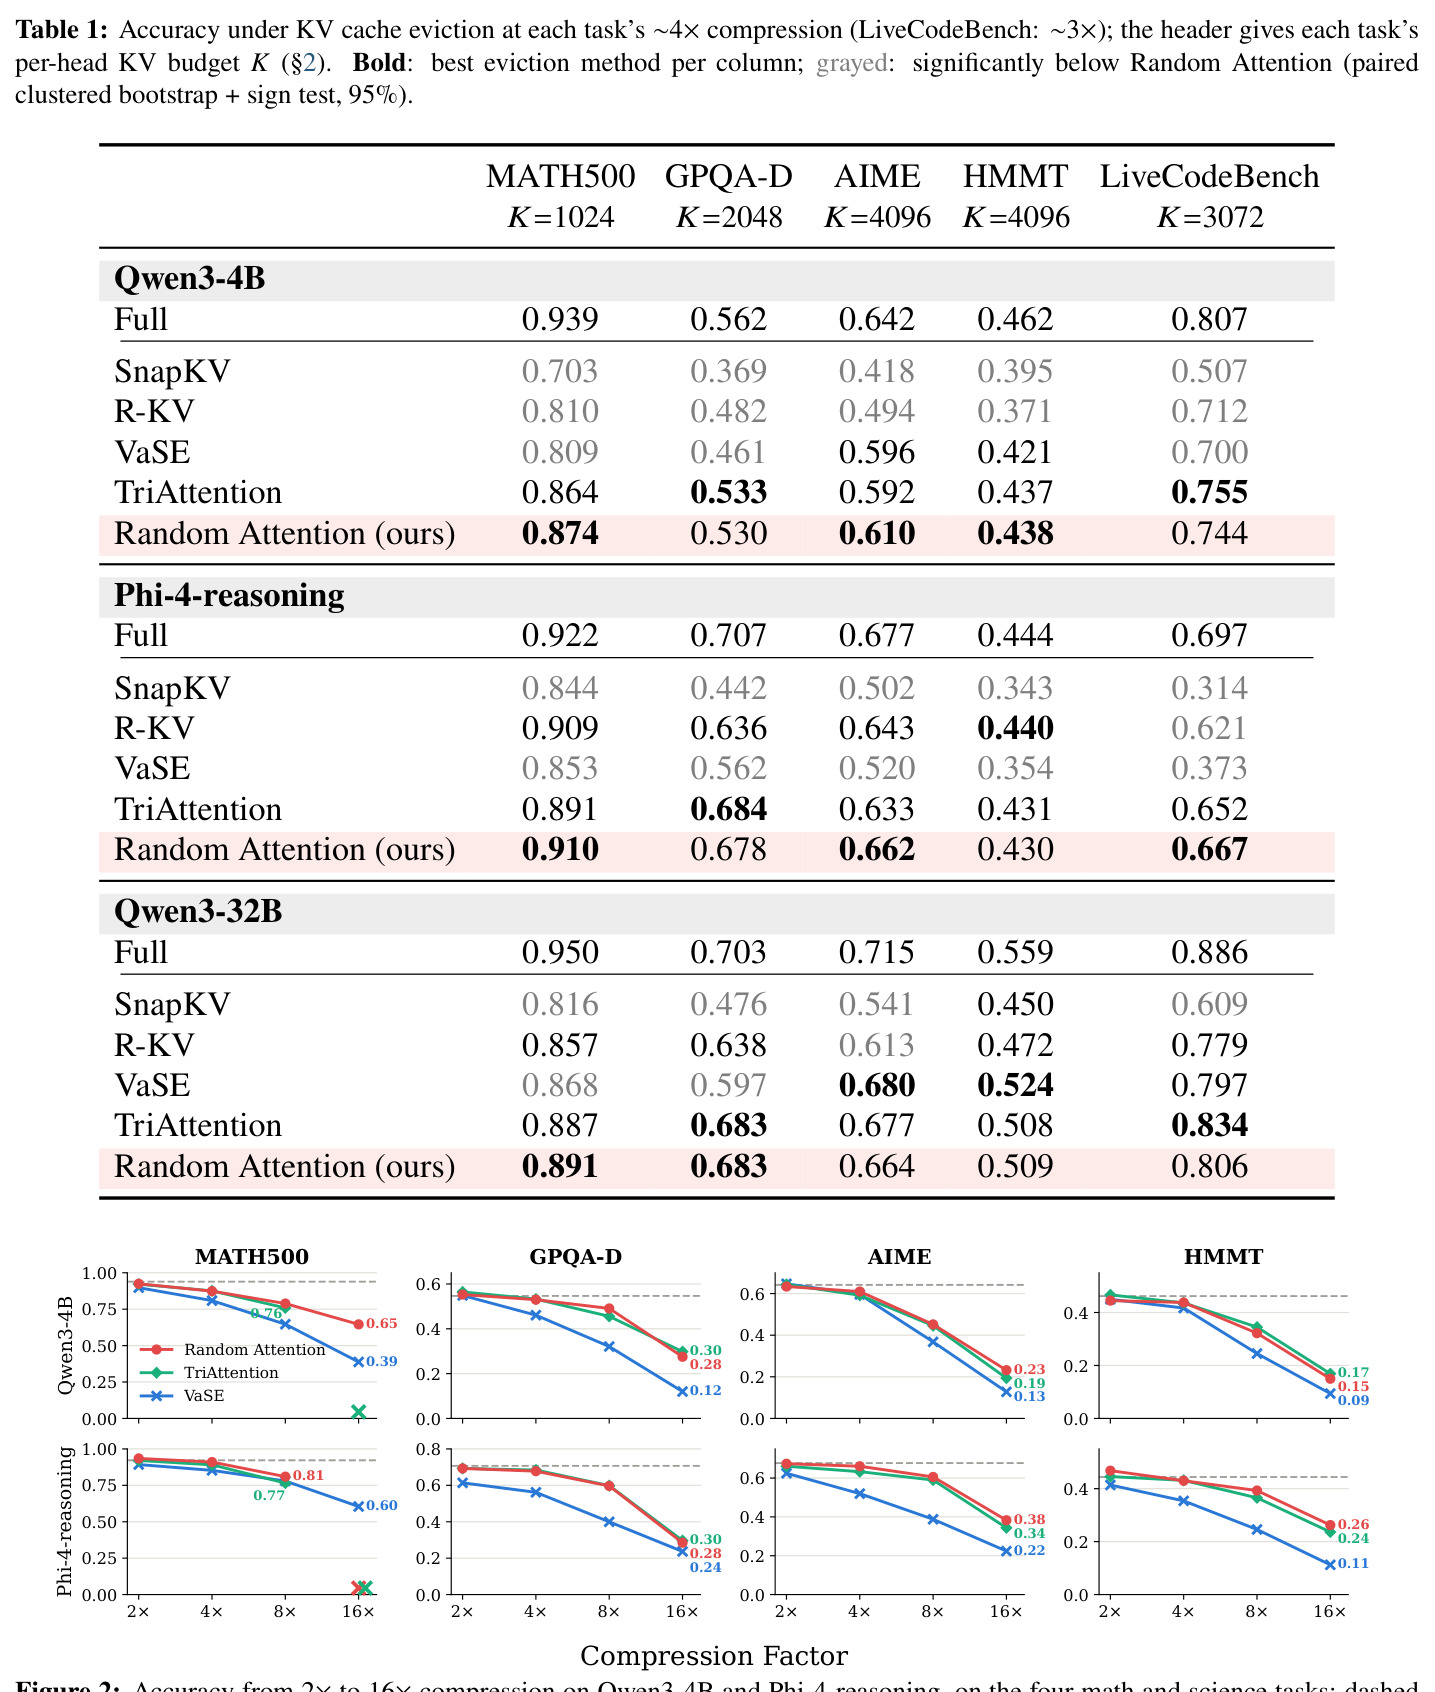
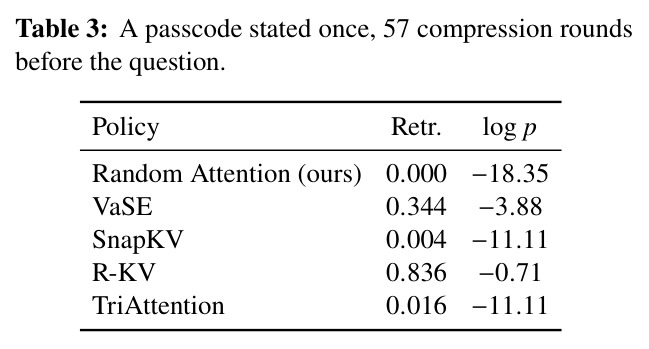
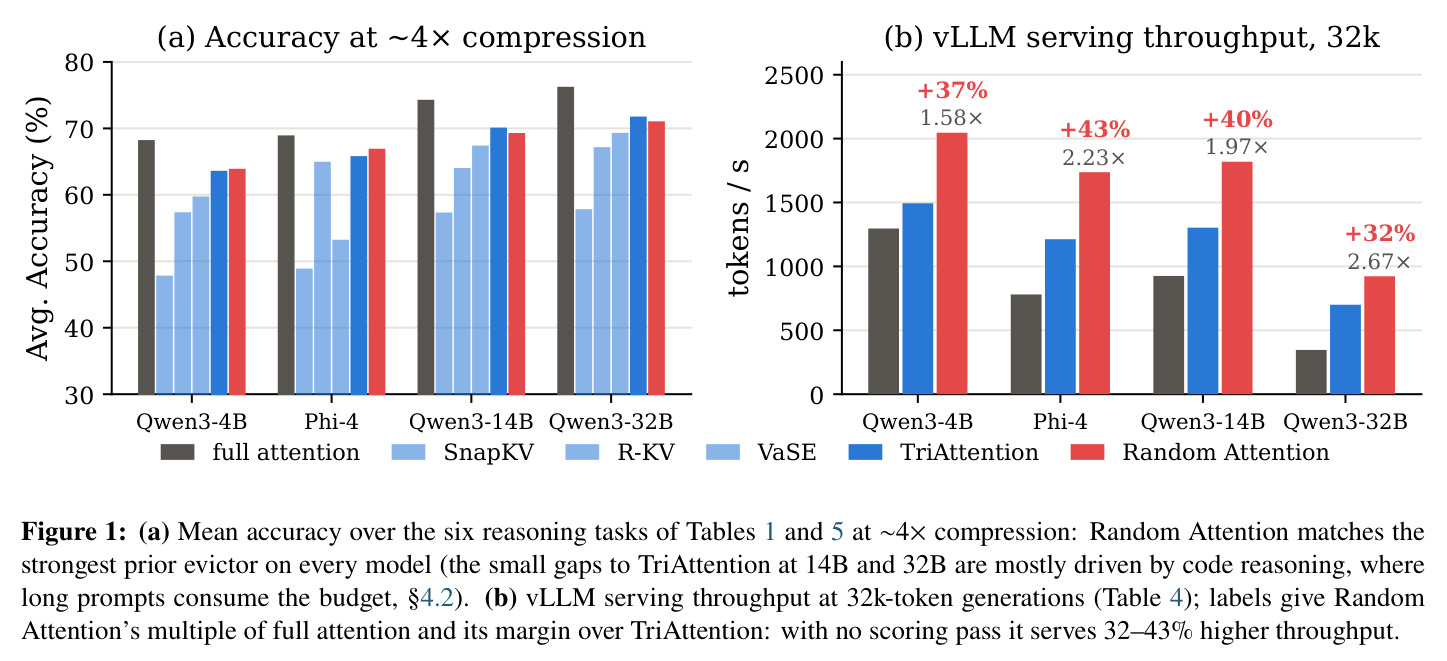
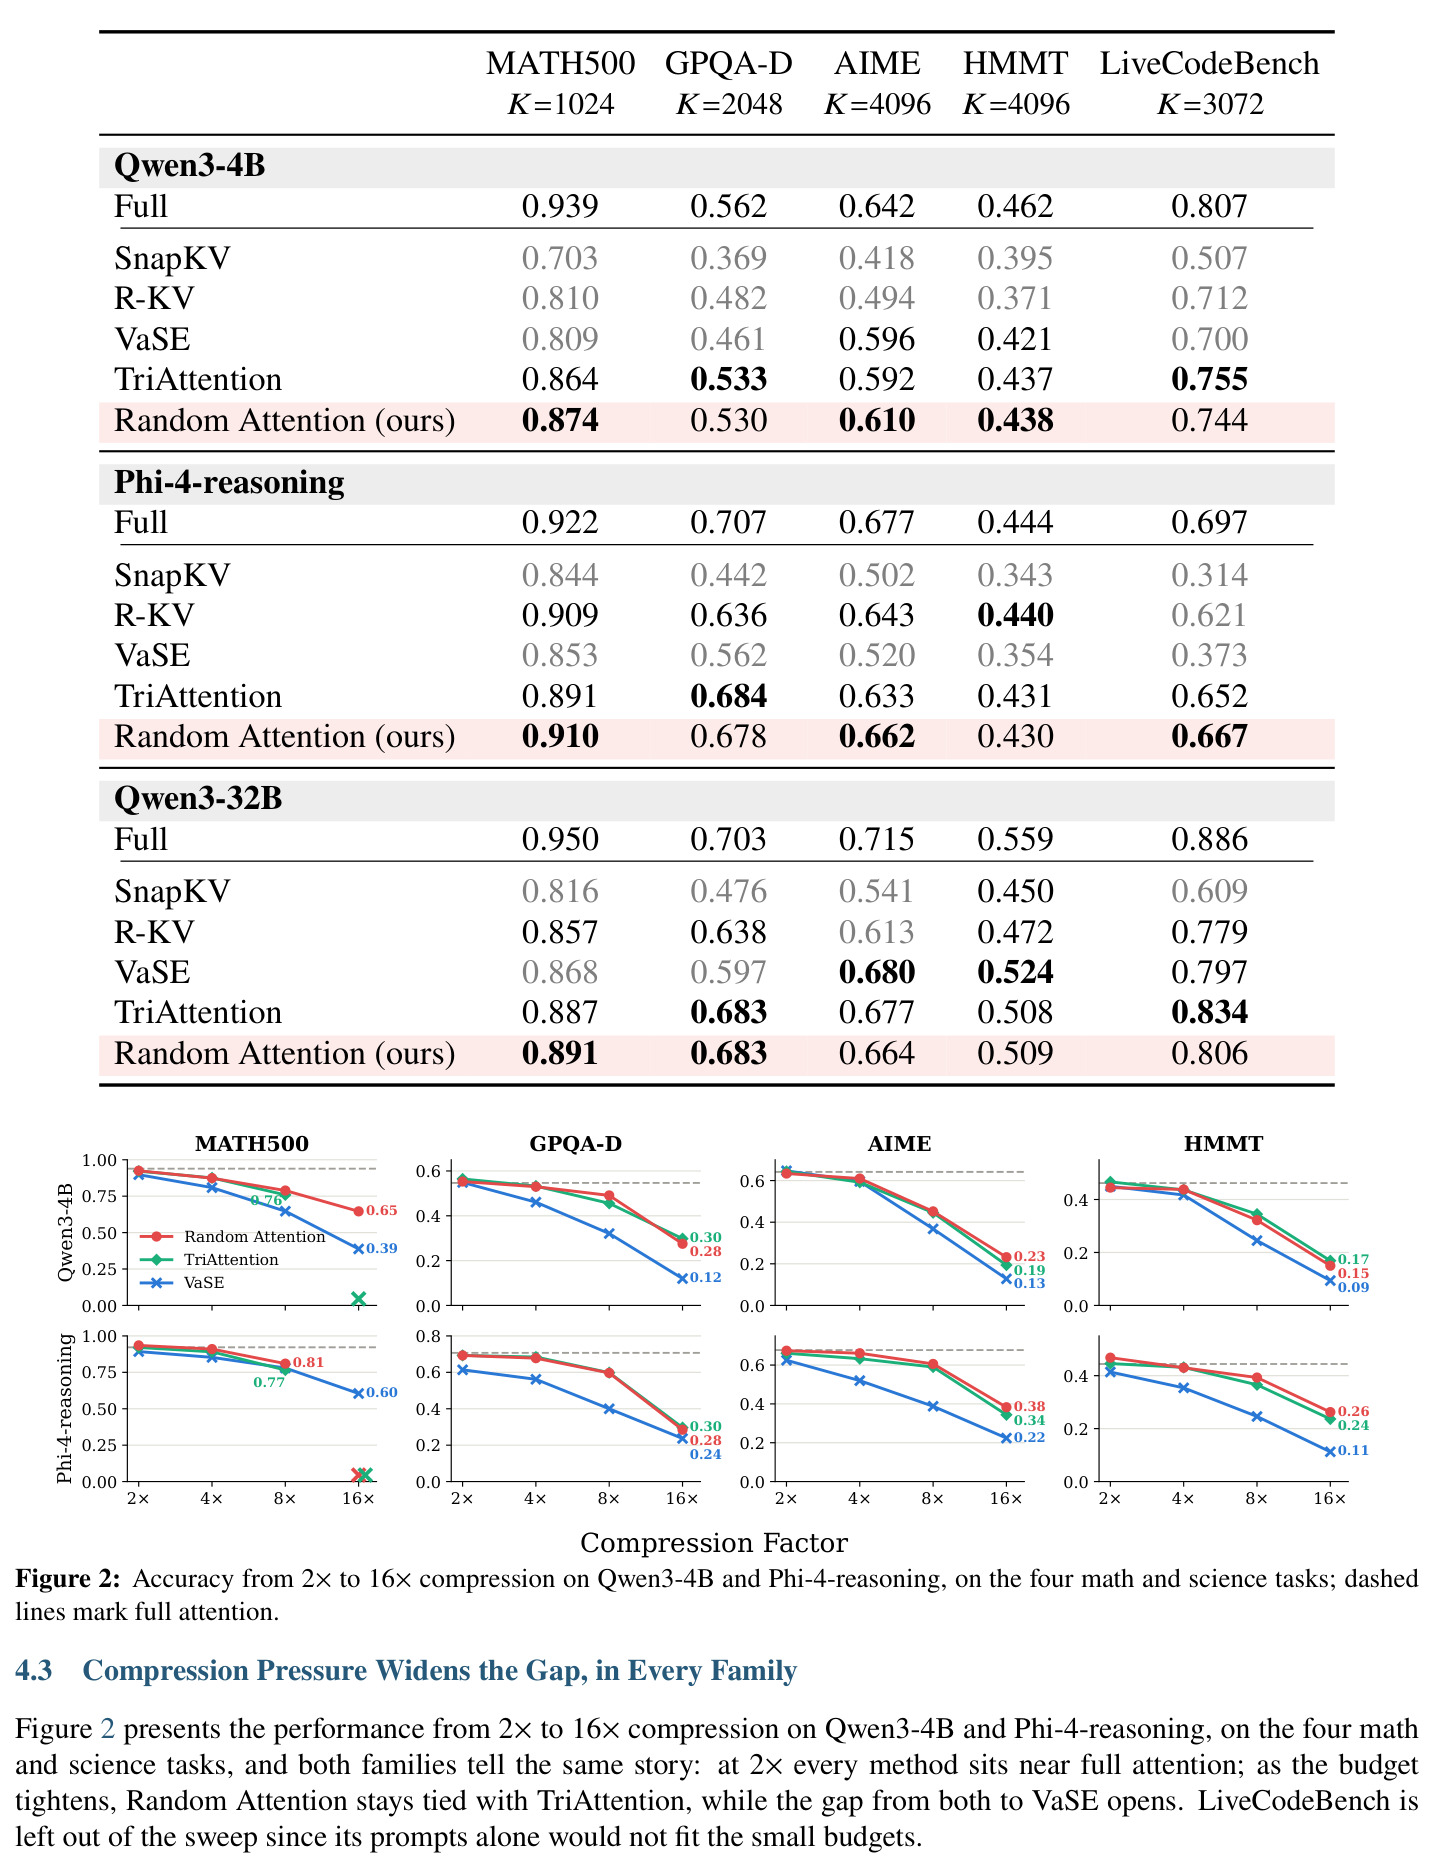
主结果(Table 1,约 4× 压缩,配对 bootstrap + 符号检验):Random Attention 在 60 个基线格中 31 格显著领先、仅 1 格落后。Qwen3-4B 上 MATH500 达 0.874(Full 0.939,最强基线 TriAttention 0.864)、GPQA-D 0.530、AIME 0.610、HMMT 0.438、LiveCodeBench 0.744;压缩从 2× 加压到 16×(Figure 2)后仍与 TriAttention 并列。唯一显著落后是 Qwen3-32B LiveCodeBench:0.806 对 0.834,因 557 token 的长提示词吃预算。效率(Table 4,vLLM,$K{=}2048$,32k 生成):吞吐达全注意力 1.58×–2.67×(Qwen3-4B 2046 对 TriAttention 1494 tok/s),领先 32–43%。短板是密码探针(Table 3):57 轮压缩后检索率 0.000、$\log p=-18.35$,远逊 R-KV 的 0.836。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MATH500(Qwen3-4B,K=1024,约4×压缩) | 准确率(boxed 答案判定) | 0.874 | 最强基线 TriAttention 0.864;Full 上限 0.939 | 高于最强基线 1.0 点且配对检验显著 |
| GPQA-Diamond(Qwen3-4B,K=2048) | 准确率 | 0.530 | TriAttention 0.533;SnapKV 0.369 | 与最强基线打平(噪声内),显著高于 SnapKV/R-KV/VaSE |
| AIME 2025+2026 合并(Qwen3-4B,K=4096,16 次采样平均) | 准确率 | 0.610 | VaSE 0.596;TriAttention 0.592 | 较最强基线约 +1.4 点,无任何基线显著超过它 |
| LiveCodeBench-v6(Qwen3-32B,K=3072,约3×压缩) | pass@1(真实测试执行) | 0.806 | TriAttention 0.834 | 落后约 3 分,为主表唯一显著基线胜局(长提示词所致) |
| vLLM 服务吞吐(4 模型,K=2048,32k 生成,H200) | 输出 tok/s | 2046/1737/1819/923(全注意力的 1.58×–2.67×) | TriAttention 1494/1212/1303/700(1.15×–2.02×) | +32% ~ +43% |
局限与改进
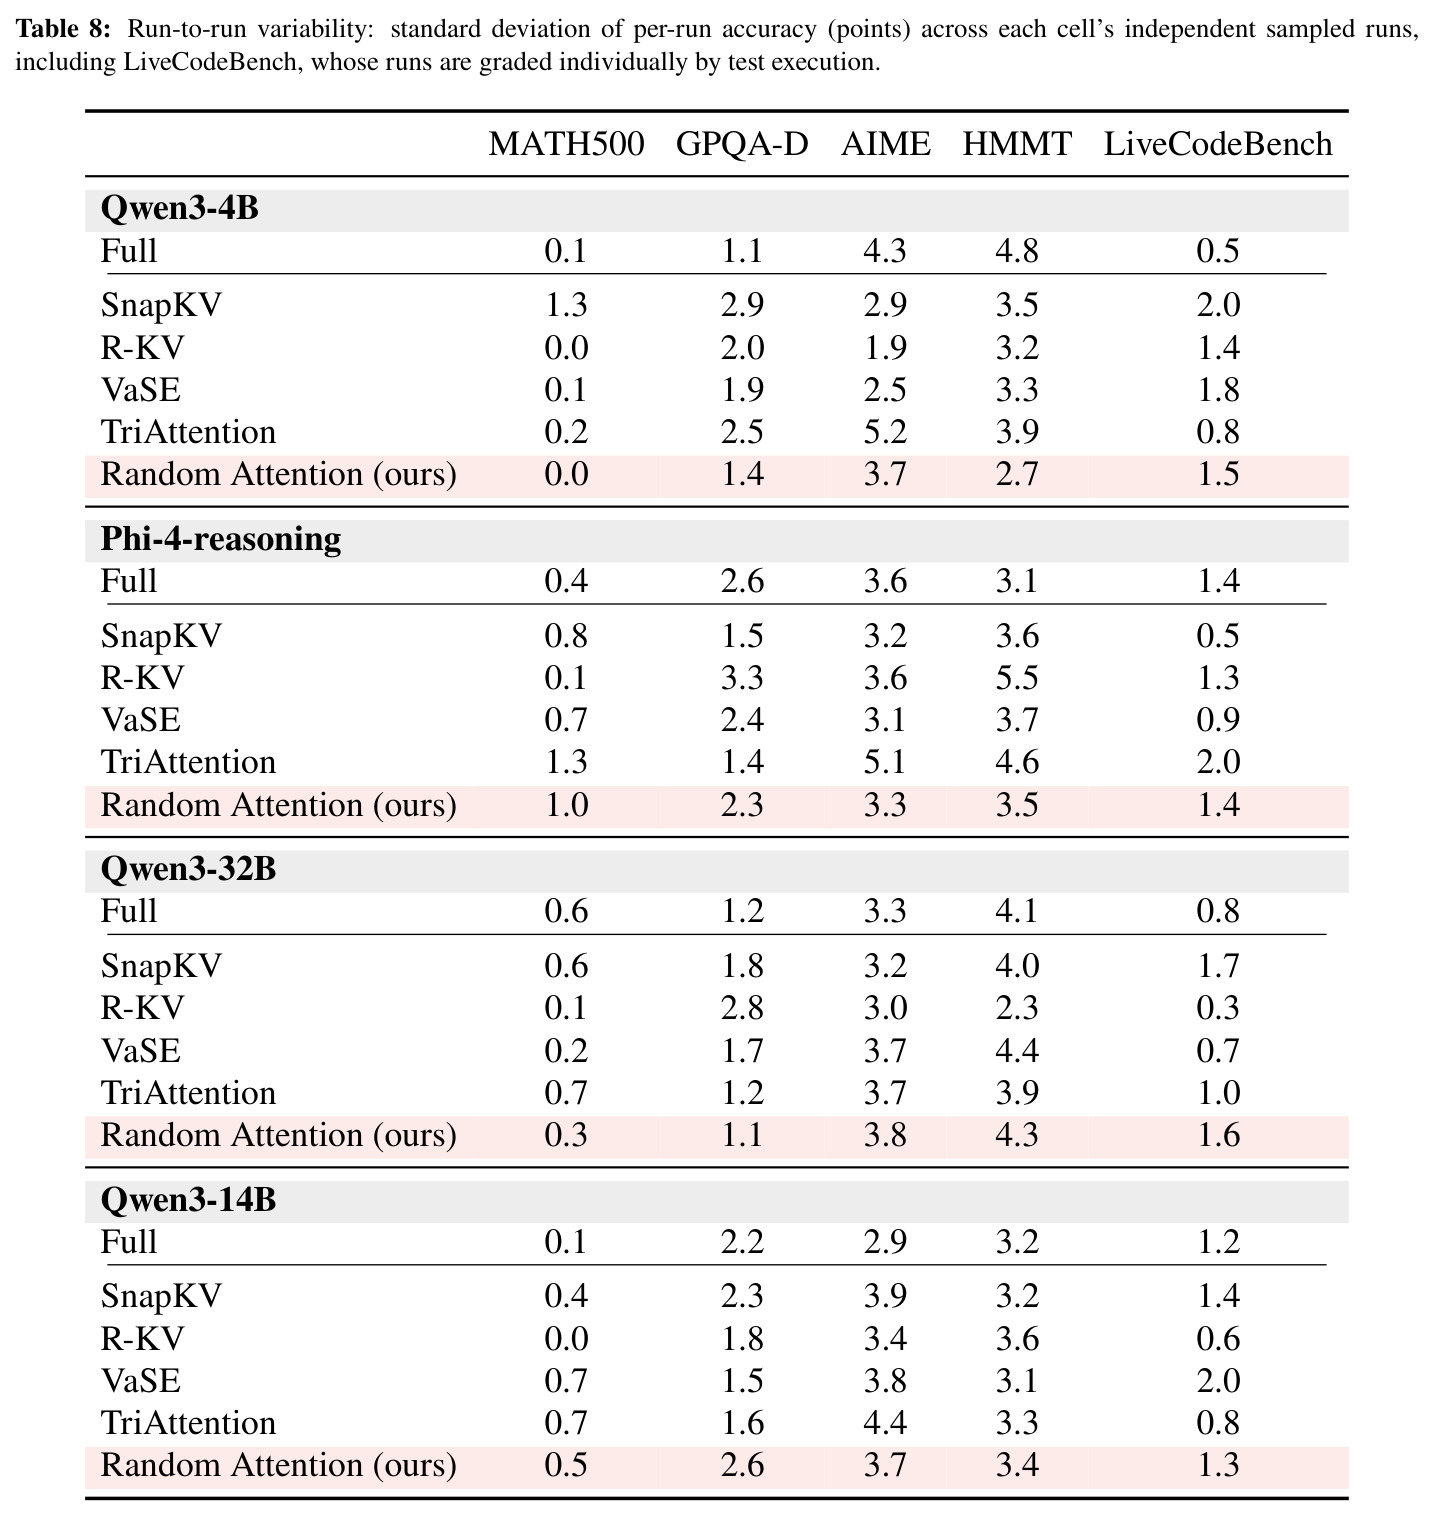
作者承认与本文观察到的局限:1) 一次性事实几乎全失——密码只说一次、经 57 轮压缩后提问,Random Attention 检索 0.000、$\log p=-18.35$,而按累积注意力打分的 R-KV 达 0.836,说明无信号策略保护不了“只出现一次且后文不复述”的信息;2) 代码任务长提示词挤压预算:LiveCodeBench 提示平均 557 token(MATH500 的 6 倍),最长可占 $K{=}3072$ 的一半,导致对 TriAttention 落后约 3 分;3) 结论依赖思维链的自我复述习惯,若训练方式改变复述行为(如把驱逐引入训练的 Prefix Sliding 类工作),结论需重验。我的补充:实验限于 4B–32B 开源模型与“短提示+长生成”regime,对长上下文理解和 10 万 token 级思维链未验证;AIME 仅 30 题、HMMT 60 题,运行间标准差约 ±5 分,个别 1–2 分的领先解释力有限。
独立分析的弱点
独立弱点分析:1) 对 needle 型信息零保护——若用户在提示中给出后文只出现一次的关键约束(API 参数、格式要求),随机驱逐大概率丢失,改进方向是混合策略:用轻量语义去重检测“未被复述”的句子并钉住,其余照常随机;2) 全保提示词在代码任务浪费预算——LiveCodeBench 提示平均 557 token,其中 I/O 格式等脚手架本可压缩,改进方向是按内容类型分预算或对提示做抽取式摘要;3) 逐头独立随机使各头保留集合不同,不利于调试与逐层分析,改进方向是固定随机种子加分层抽样保证覆盖;4) 吞吐对比依赖 TriAttention 的 vLLM 实现质量——作者自认等内存实验里 3 倍差距来自其未融合的重实现而非方法本身,32–43% 这一数字可能随对方工程优化而缩小;5) 未与 KV 量化、稀疏注意力等正交压缩手段组合评测,实际部署中的收益可能重叠或冲突。
未来方向
作者明确留下两个开放问题:一是长提示词的预算管理,尤其代码任务中保护整个提示词会占用可观预算,需要更聪明的提示词压缩规则;二是恢复“只说一次、从不复述”的罕见事实,这必须依赖内容相关信号,是随机策略无法覆盖的残留需求。可延伸方向:把冗余度显式建模,按 token 被复述次数动态决定随机或保分;利用检索头特化现象(探针显示 Qwen3-4B 仅 3/8 个 KV 头单独可用),按头重要性差异化分配预算;把双层冗余(文本复述+跨头副本)的结论在 RL 训练出的更长思维链上重验;与 Prefix Sliding 式训练内驱逐及 KV 量化组合成混合压缩栈;以及把“必须先保提示词”固化为评测协议的硬性要求,避免后续论文重蹈混淆。
复现评估
复现条件良好。代码开源于 github.com/SalesforceAIResearch/Random-Attention;核心算法仅 4 行(rand、强制保提示、topk),主要工程量在 vLLM PagedAttention 集成与四个基线的对齐复现。数据与模型全为公开资源:MATH500(500 题)、GPQA-D(198 题)、AIME 2025/2026(各 30 题)、HMMT(60 题)、LiveCodeBench-v6(383 题),模型为 Qwen3-4B/14B/32B 与 Phi-4-reasoning。采样协议完整公开(Qwen3 温度 0.6、Phi-4 温度 0.8,核采样 0.95,重复 2/4/16 次),显著性检验为配对问题聚类 bootstrap 加精确符号检验,作者还宣称公开逐实例日志。算力方面,精度实验需单卡 A100/H200 级跑 32k 生成长度,吞吐实验需 143GB H200。全网格复现成本中等偏上,但方法本身的复现难度很低。
论文图表