虚拟头注意力(VHA) Virtual Head Attention
两个可折叠的线性变换让 GQA-2 同时赢下 KV 缓存、FLOPs 与质量的不可能三角
前置知识
分组查询注意力(GQA)
将查询头分成若干组,同组内所有查询头共享同一组键值头(KV head),是 MHA 与 MQA 的折中。KV 缓存大小与 KV 头数成正比,LLaMA 3、Qwen 等主流模型常用 8 个 KV 头。KV 头越少缓存越小,但组尺寸变大、多个查询头被迫共享同一份 K/V,注意力多样性下降、质量受损。
VHA 的目标部署形态就是只有 2 个 KV 头的 GQA-2,全文所有缓存压缩比、FLOPs 与质量对比都以 GQA 为基线。
KV 缓存
自回归解码时为避免重复计算而缓存的每层 Key/Value 张量,BF16 下每层每 token 占 4×H_kv×d 字节,随序列长度线性增长。它直接决定单卡可容纳的并发请求数与解码延迟,是长上下文推理的首要显存瓶颈。
论文'不可能三角'的第一顶点就是 KV 缓存,VHA 用 2 个 KV 头把它压到 1.00 KB/层/token 的架构最小值。
MLA 与 MFA
MLA(Multi-head Latent Attention)把 KV 投影到共享低秩隐空间,缓存 1.12 KB 但需要定制内核与非标准推理流程;MFA 通过增大头维把缓存压到 1 KB,质量接近 GQA-8,但训练与 prefill FLOPs 增加 49.8%(1.7B, S=4096)。两者都只改善了三角中的部分顶点。
它们是论文的主要对比对象,理解各自在缓存/FLOPs/质量上的代价,才能看懂 VHA 声称的帕累托最优。
结构重参数化(RepVGG / LoRA)
训练时使用多分支或低秩分解等更丰富的参数化形式,推理时把线性结构合并回单一权重矩阵,实现训练期有正则收益、部署期零额外开销:RepVGG 把 3×3+1×1+恒等分支合并为一个卷积,LoRA 用 W+BA 做参数高效微调。
VHA 把这一范式从单个权重矩阵推广到注意力的头维度,是理解本文'训练富参数化、推理零开销'设计哲学的关键。
Kronecker 积吸收恒等式
对按行展开有 vecrow(MY)ᵀ = vecrow(Y)ᵀ(Mᵀ⊗I_d)。因此对注意力输出头维度做线性混合 Y'=(I+BAᵀ)Y 后再乘 W_O,等价于先用 (I_Hv+ABᵀ)⊗I_d 左乘 W_O 得到新矩阵 W'_O。这使 Postmix 能被无损折叠进输出投影。
这是 Postmix 在推理期零开销消失的数学依据,也是 VHA 能精确退化为标准 GQA-2、直接复用 vLLM/SGLang 的关键一步。
解码访存瓶颈与 Tensor Core
自回归解码每步只生成一个 token,算术强度低,性能受显存带宽而非算力限制,因此 KV 缓存大小直接决定解码速度与并发能力。KV 头越少、查询头与 KV 头的组尺寸越大(VHA 在大模型上组尺寸达 64),越能吃满 Tensor Core 的并行度。
解释了为什么把 KV 头从 8 降到 2 在工程上极具价值,以及 VHA 为何强调'组尺寸 64'这一卖点。
研究动机
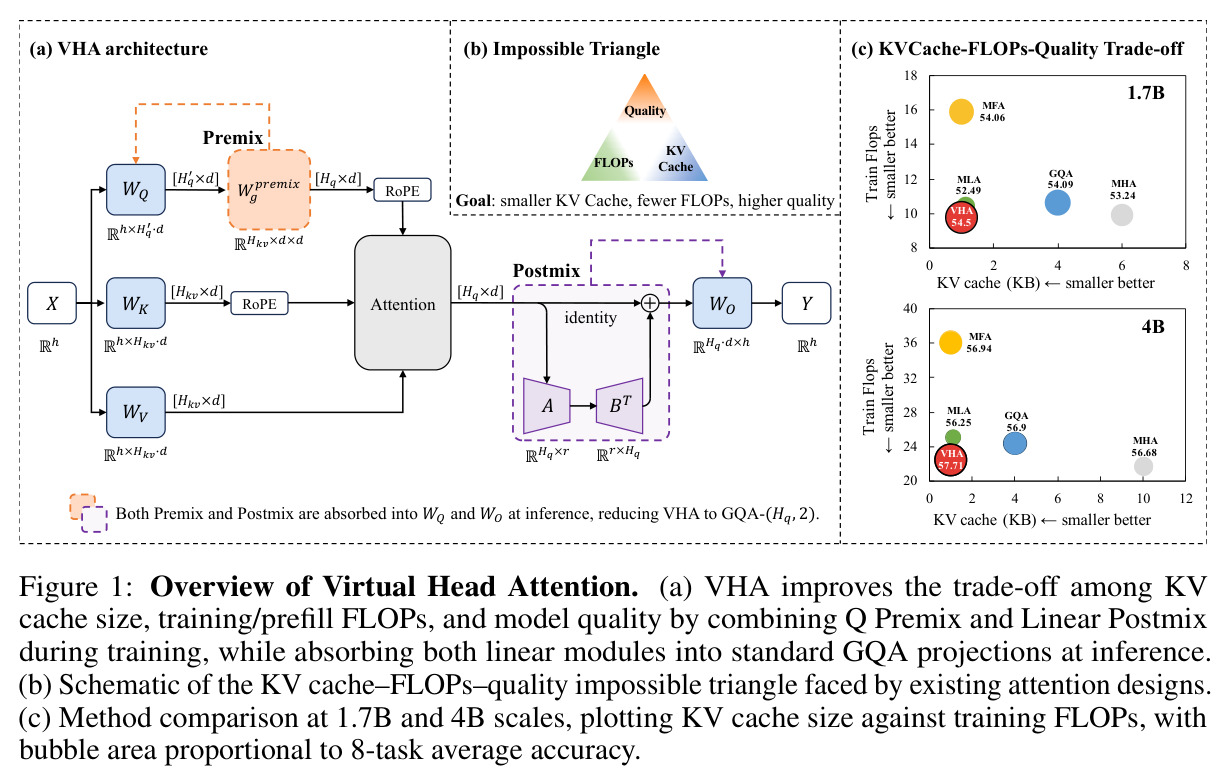
长上下文大模型中,注意力机制同时决定三件互相冲突的事:KV 缓存大小、训练/prefill FLOPs 和模型质量,论文称之为'不可能三角'。以 1.7B 模型为例:GQA-8 质量最好(8 基准平均 54.09%),但每层每 token 要 4.00 KB(BF16)缓存;直接砍到 2 个 KV 头(GQA-2)缓存降到 1.00 KB,组尺寸过大导致注意力多样性骤降,质量损失 1.00%;MLA 把缓存压到 1.12 KB,却在多个规模上质量垫底(1.7B 仅 52.49%);MFA 把缓存压到 1.00 KB、质量接近 GQA-8(54.06%),代价是训练/prefill FLOPs 增加 49.8%。也就是说,现有每个方法都只改善了三角的一两条边,没有一个能在缓存、算力、质量三点上同时达标,而这正是长上下文推理同时做到省显存、跑得快、效果好的核心障碍。
本文的目标是本文目标是设计一个注意力机制,同时改善三个顶点:把 KV 缓存压到架构最小值(每层每 token 1.00 KB,即仅 2 个 KV 头)、让训练和 prefill FLOPs 低于 GQA 基线(实测降 6.5%–8.1%),并且质量不降反升(超过 GQA-8 基线 0.05%–0.81%)。同时严格约束推理期可以无损合并回标准 GQA-2 架构,直接复用 vLLM、SGLang 等主流服务框架的全部 GQA 优化,不引入任何定制内核或额外运行时结构。作者还在 0.6B 到 30B-A3B MoE 共五个规模、4K 到 128K 上下文上验证该设计的可扩展性,使其能够落地到工业级模型。
与已有工作不同的是,已有的'虚拟头/头间通信'思路各有短板:SAS 把少量低维 KV 头投影到高维去模拟更多头、LRKV 共享全秩 KV 基再加低秩残差,两者都作用在 KV 侧且额外结构保留在推理期;Talking-Heads 在注意力权重空间混合,运行期必须保留;MLA 则需要定制内核。VHA 的独特切入是在查询侧做虚拟化:Premix 只用每 KV 组一个 d×d 的近恒等矩阵,把减半的物理查询头展开成虚拟头;Postmix 在输出头维度用低秩 I+ABᵀ 做跨组融合。由于全部是线性操作,训练期的富参数化可以在推理期被精确折叠进 W_Q 与 W_O,从结构上把'表达能力'与'部署形态'解耦——这是所有现有方法都没有同时做到的。
核心方法
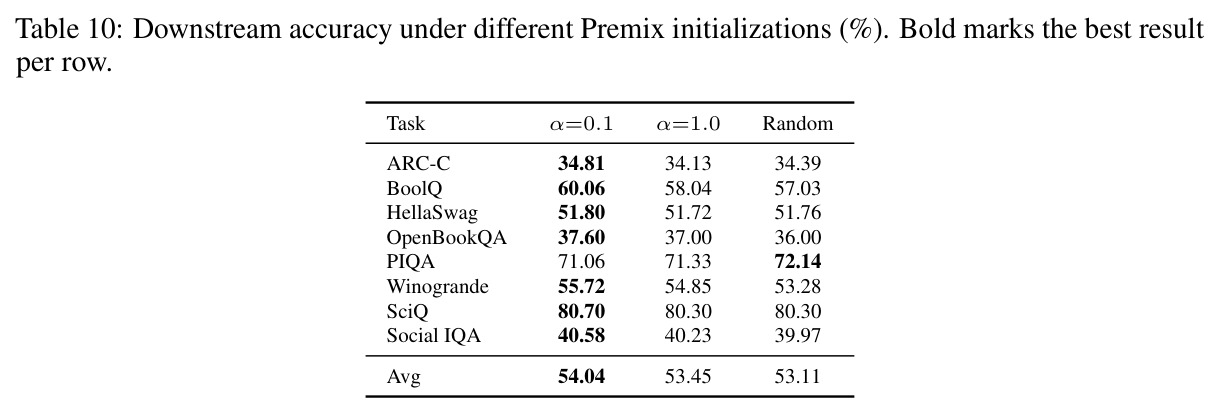
直觉上,把 KV 头从 8 砍到 2 的质量损失来自两个可分离的缺陷:其一,每个 KV 组内查询头太少且共享同一份 K/V,注意力方向多样性不足;其二,不同 KV 组的输出之间完全没有信息交换。VHA 用两个线性模块分别对症下药:Q Premix 在每个 KV 组内对查询做近恒等线性变换 $\tilde{Q}_{i,g} = Q_i W_{\text{premix}}^g$,把 $H_q/2$ 个物理头展开成 $H_v = 2 \times H_q/2 = H_q$ 个虚拟头,恢复注意力多样性;Linear Postmix 对注意力输出在头维度做低秩残差混合 $Y' = (I + BA^\top)Y$,打通跨组通信。因为两个模块都严格线性,推理时 Premix 可折叠进查询投影、Postmix 可折叠进输出投影,模型退化为标准 GQA-2。技术路线上刻意用近恒等/零初始化,保证训练初期行为接近基线、不破坏预训练稳定性。
核心创新是把 RepVGG/LoRA 式重参数化从'单层权重'搬到'注意力的头维度',并用结构化因式分解解释收益:定义 $fW_Q^{(i,g)} = W_Q^{(i)} W_{\text{premix}}^g$,可以证明对任意输入和参数,Premix 再注意力完全等价于一个标准 $H_v$ 头 GQA,只是每个虚拟头的查询投影被约束在低维流形 $\{W_Q^{(i)} W_{\text{premix}}^g\}$ 上。前向虽等价,但 $W_Q^{(i)}$ 与 $W_{\text{premix}}^g$ 的梯度跨所有组和物理头耦合,优化景观不同,带来类似 LoRA 的隐式正则;同时 Q 路径的参数与 FLOPs 从 $H_v h d$ 降到 $H'_q h d + H_{kv} d^2$,1.7B 上约省 50%,这是 VHA 训练 FLOPs 下降 7.9% 的主要来源。Postmix 在数学上完全冗余(可吸收进 $W_O$),消融却显示加上它能在 1.7B 再贡献约 1.19% 的相对提升,同样是低秩约束加分离梯度路径带来的隐式正则效应。
方法步骤详情
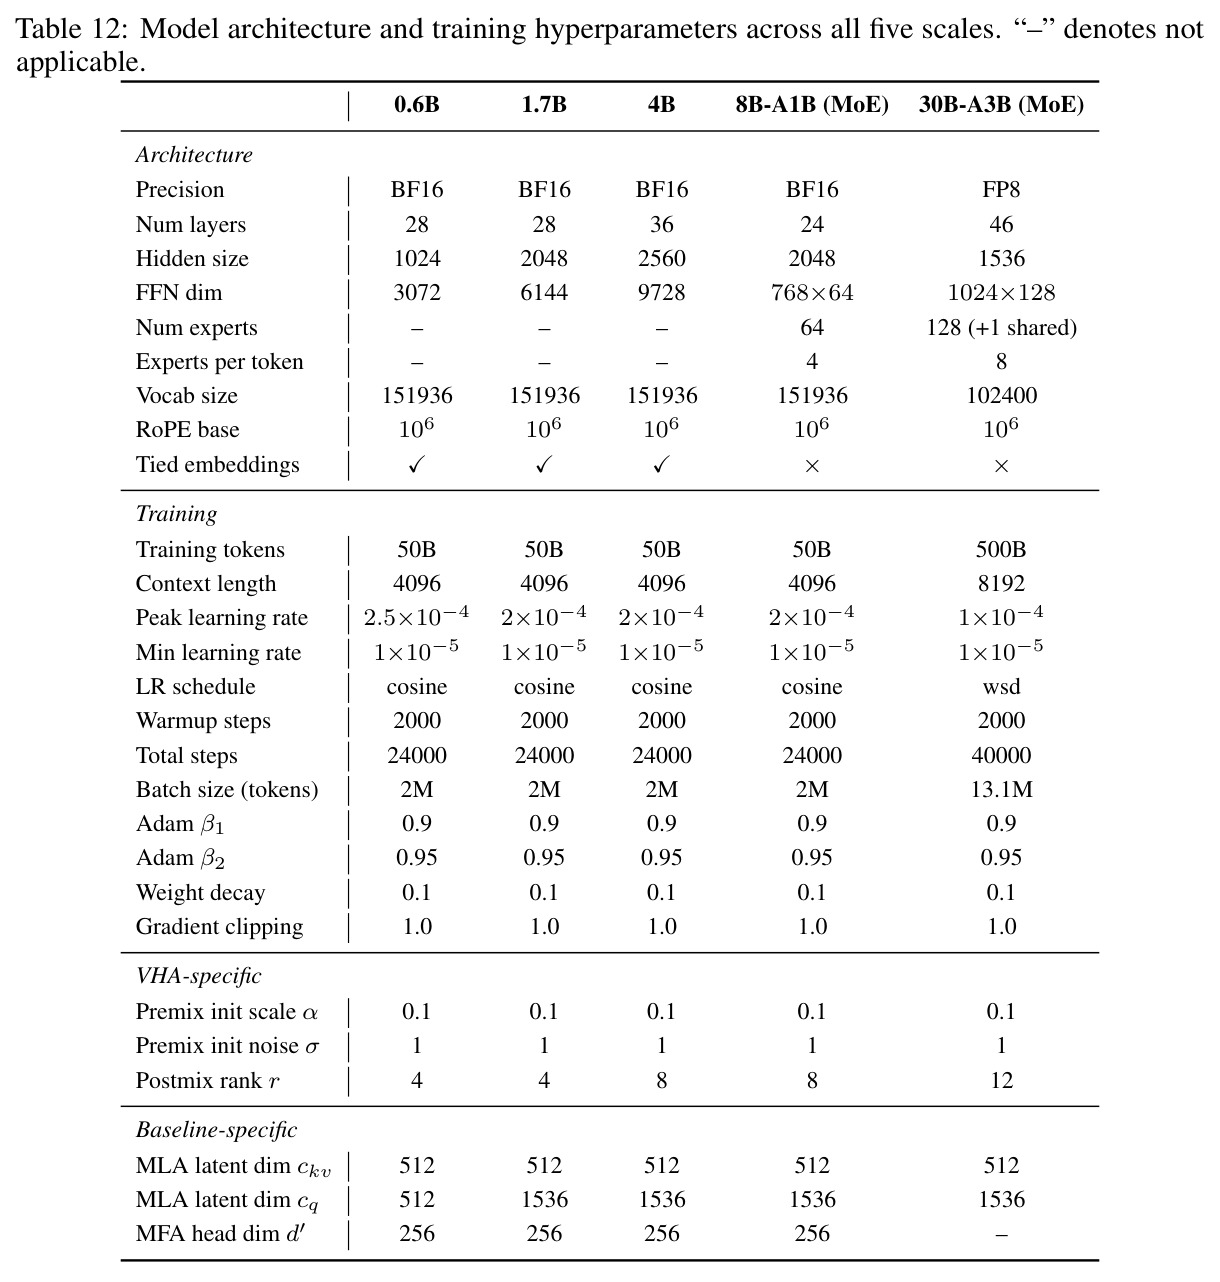
第一步,选定形状:物理查询头减半 $H'_q = H_q/2$,KV 头 $H_{kv}=2$,虚拟头数 $H_v = H_{kv}H'_q = H_q$,如 1.7B 用 8-2-2、4B 用 16-2-2。第二步,前向:$X \in \mathbb{R}^{S\times h}$ 投影出 $H'_q$ 个物理查询头和 2 个 KV 头,对每组 $g$ 施加 $\tilde{Q}_{i,g} = Q_i W_{\text{premix}}^g$,$W_{\text{premix}}^g$ 以 $I+\alpha\epsilon$ 初始化($\epsilon\sim\mathcal{N}(0,\sigma^2)$),再照常做 RoPE 与缩放点积注意力。第三步,Postmix:$Y' = Y + BA^\top Y$,$A,B \in \mathbb{R}^{H_v\times r}$,$r = H'_q/2$(1.7B 为 4),$A$ 小随机、$B$ 置零初始化,经 $W_O$ 输出。第四步,正常预训练。第五步,推理前一次性折叠:预计算 $fW_Q^{(i,g)} = W_Q^{(i)}W_{\text{premix}}^g$ 与 $W'_O = ((I_{H_v}+AB^\top)\otimes I_d)W_O$,模型变为标准 GQA-2,直接用 vLLM/SGLang 部署,零额外开销。
技术新颖性
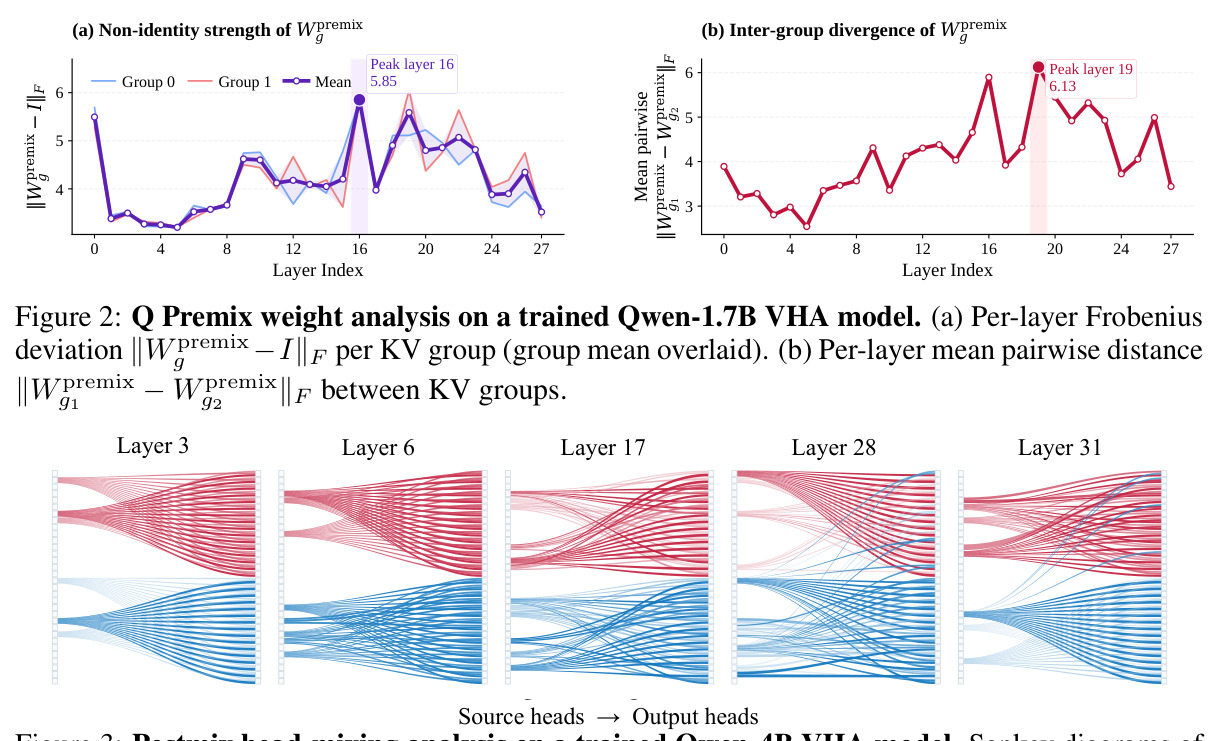
技术新颖性体现在三点。第一,虚拟化位置新:与 SAS(KV 侧虚拟化)、LRKV(KV 空间残差)、Talking-Heads(注意力权重空间混合、运行期必须保留)不同,VHA 在查询侧虚拟化、在输出侧融合,且全部结构线性可吸收,部署时彻底消失。第二,'训练富、推理简'的解耦新:训练期是带约束的低维流形参数化(结构化 Q 投影加低秩头混合),推理期精确等价于标准 GQA-2,这继承了 RepVGG 的重参数化哲学,但首次作用于头维度而非卷积核或权重矩阵。第三,可解释性强:论文用 Frobenius 范数和 Sankey 图直接检验训练后的矩阵,证明 Premix 学到组条件化的查询几何(偏离恒等的峰值范数 5.85、组间差异峰值 6.13),Postmix 学到以组内重分配为主、稀疏跨组桥接的低秩通信(Figure 2/3),两个模块功能互补、缺一不可,而不是单纯的参数堆叠。
实验结果
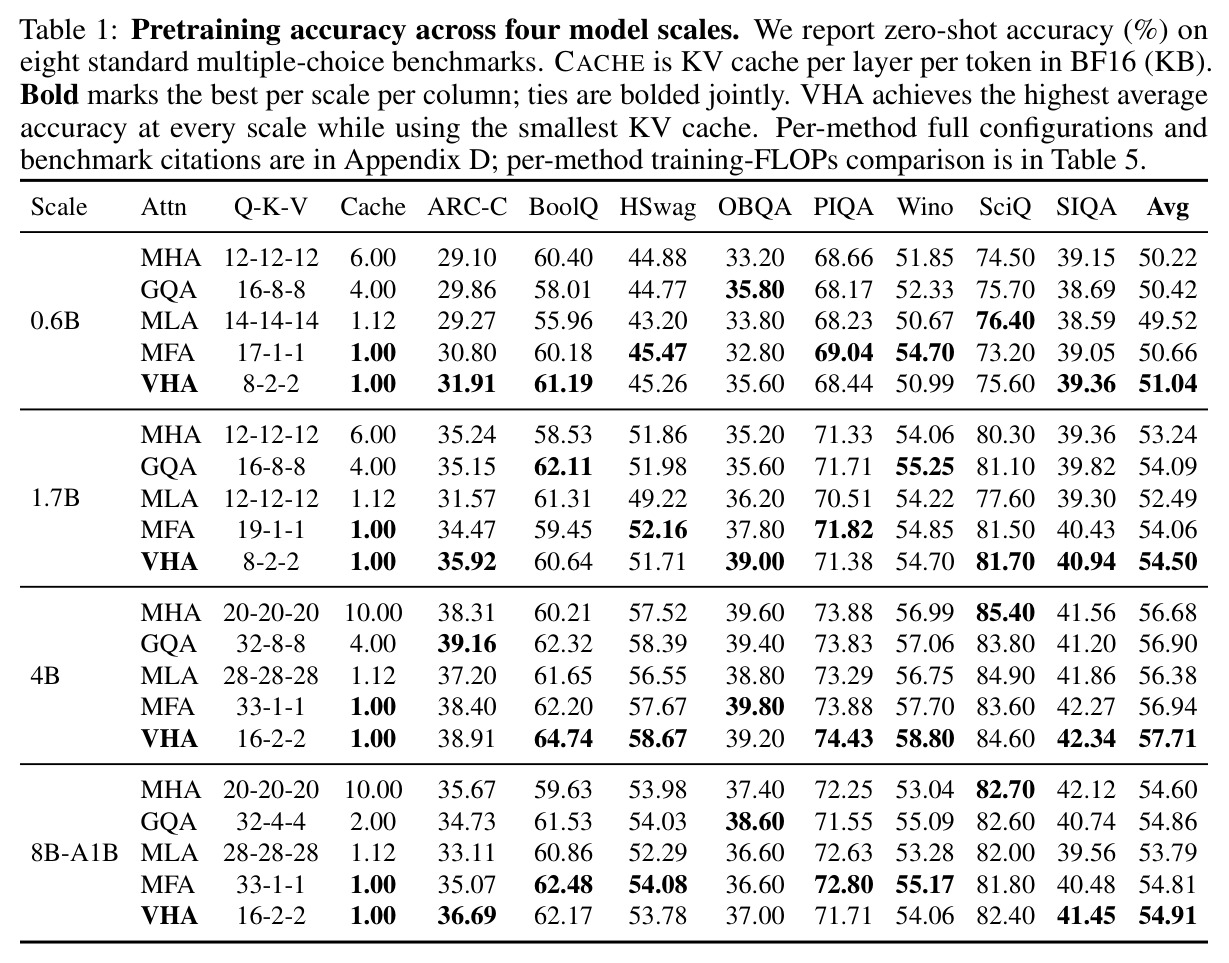
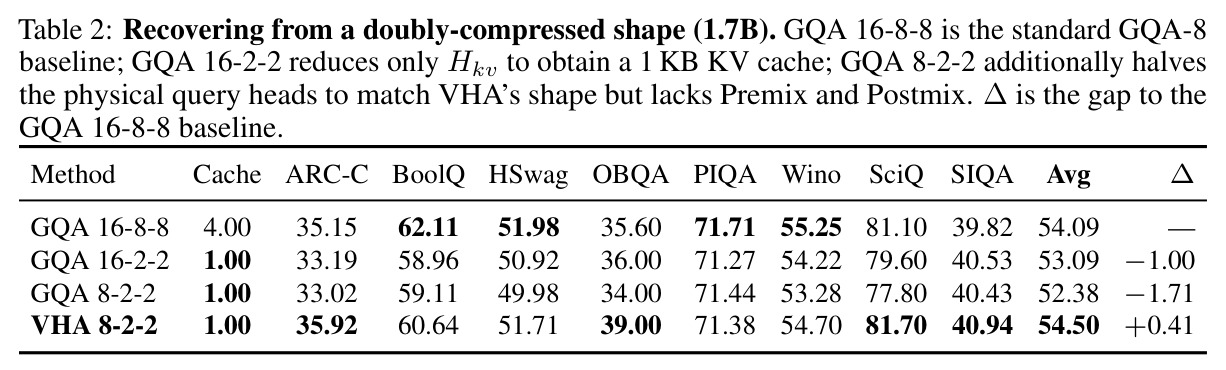
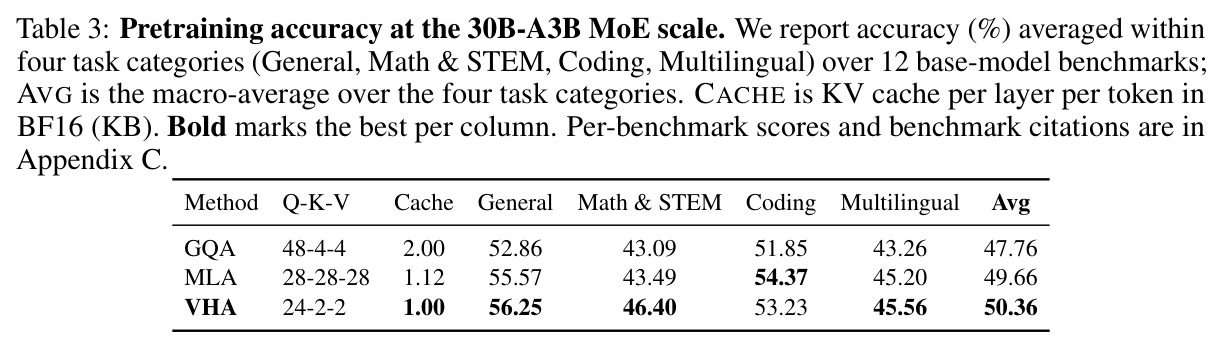
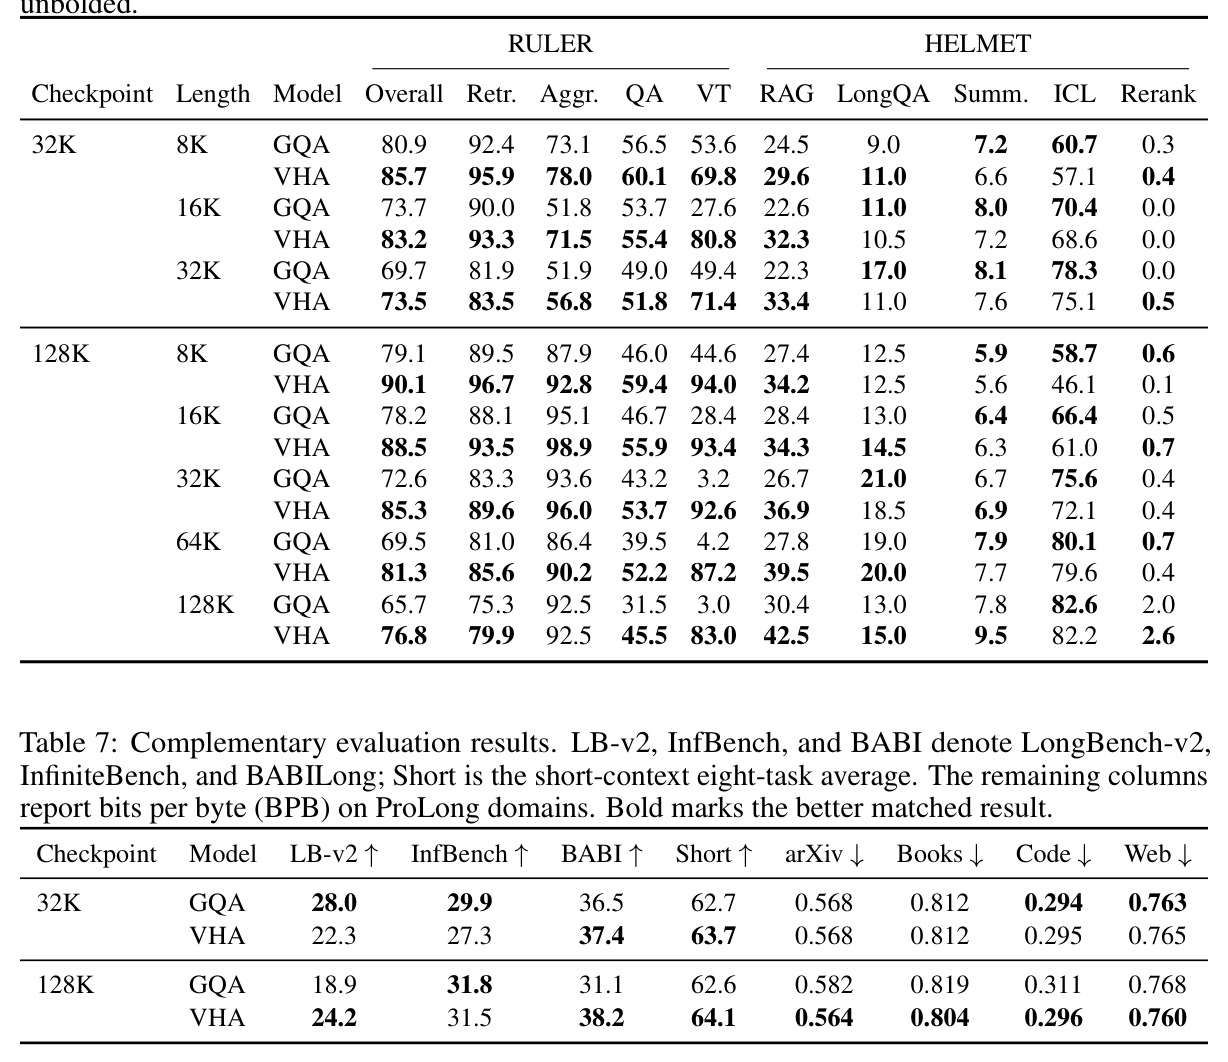
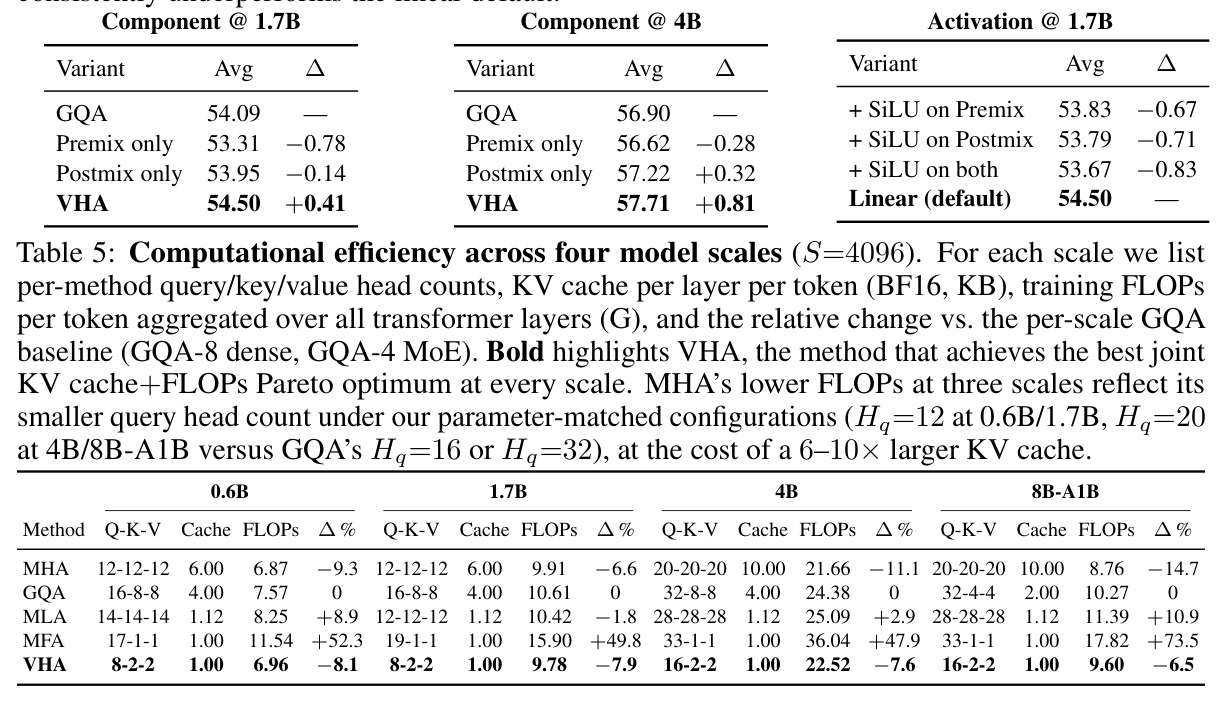
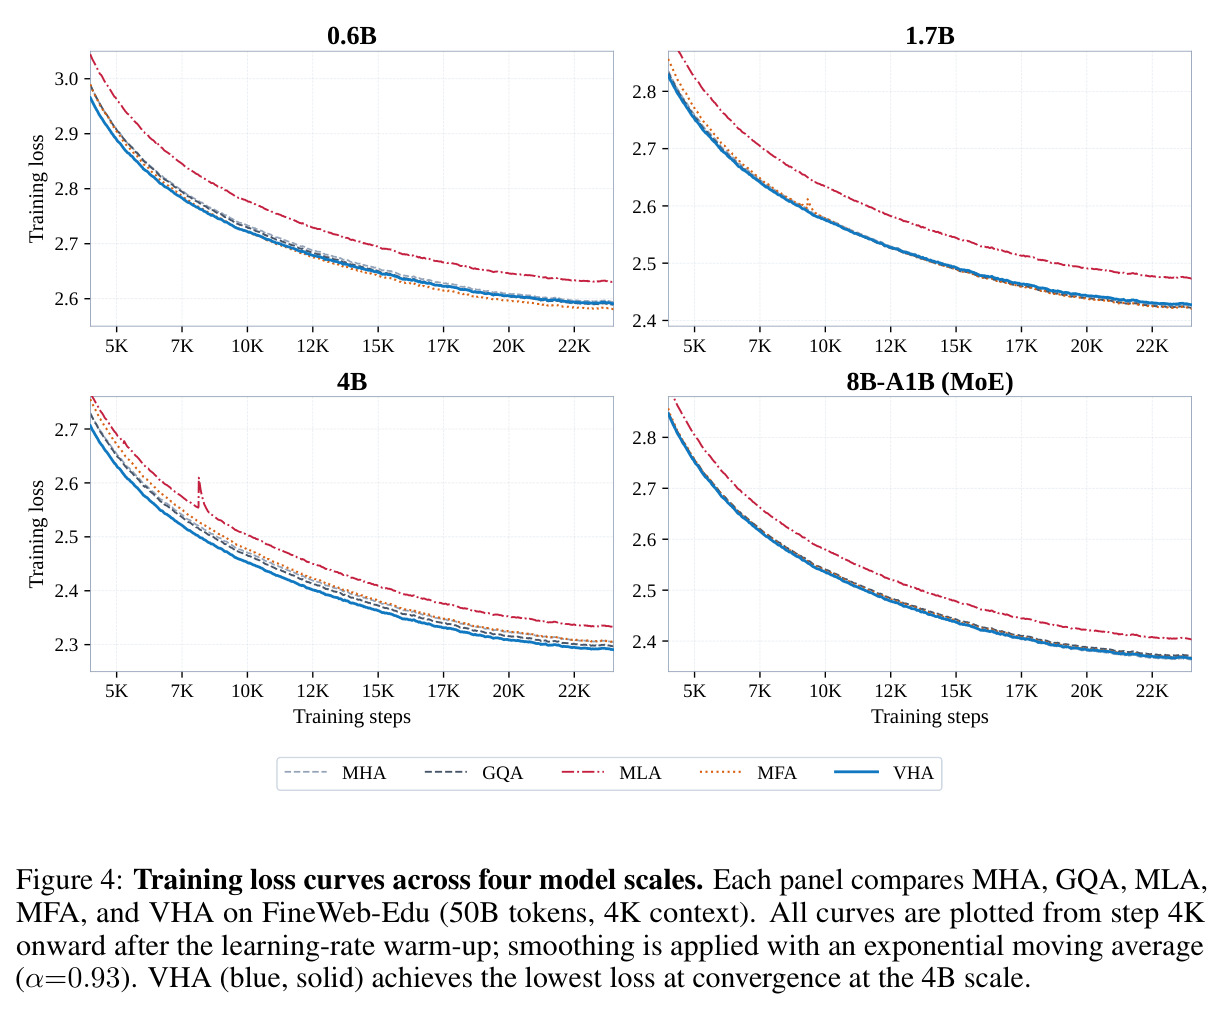
跨规模一致性(Table 1):Qwen3 架构、50B token FineWeb-Edu、4K 上下文下,VHA 在 0.6B/1.7B/4B/8B-A1B 四个规模全部超过 GQA 基线 0.05%–0.81%(1.7B:54.50 vs 54.09;4B:57.71 vs 56.90),缓存 1.00 KB 为全场最小(GQA-8 的 1/4),同等缓存下还压制 MFA 0.10%–0.77%。双重压缩恢复(Table 2):1.7B 上 GQA 16-2-2 损失 −1.00%,8-2-2 累计 −1.71%,VHA 用相同形状反超 +0.41%。工业规模(Table 3):30B-A3B MoE、500B token、8K、FP8 下,VHA 宏平均 50.36%,超 GQA-4 +2.60、超 MLA +0.70。长上下文:10B-A1B 匹配对比中 RULER 8K–128K 平均 84.4 vs 73.0(+11.4),LongBench-v2 24.2 vs 18.9,BABILong 38.2 vs 31.1。消融(Table 4):仅 Premix 53.31、仅 Postmix 53.95、完整 VHA 54.50;秩 4→128 单调降到 54.15;线性换 SiLU 掉 0.67–0.83。效率(Table 5):VHA 是唯一缓存最小且 FLOPs 低于基线者(−8.1/−7.9/−7.6/−6.5%),MFA 多付 47.9%–73.5%。机制分析(Figure 2/3)证实两模块功能互补真实存在。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 1.7B 预训练(8 基准零样本平均) | 平均准确率 (%) | 54.50(VHA 8-2-2,缓存 1.00 KB) | 54.09(GQA 16-8-8,缓存 4.00 KB);MFA 54.06;MLA 52.49 | +0.41%(vs GQA),缓存缩小 4 倍 |
| 4B 预训练(8 基准零样本平均) | 平均准确率 (%) | 57.71(VHA 16-2-2) | 56.90(GQA-8);56.94(MFA) | +0.81%(四个规模中最大) |
| 0.6B / 8B-A1B MoE 预训练 | 8 基准平均准确率 (%) | 51.04 / 54.91 | 50.42(GQA)/ 54.86(GQA-4) | +0.62% / +0.05% |
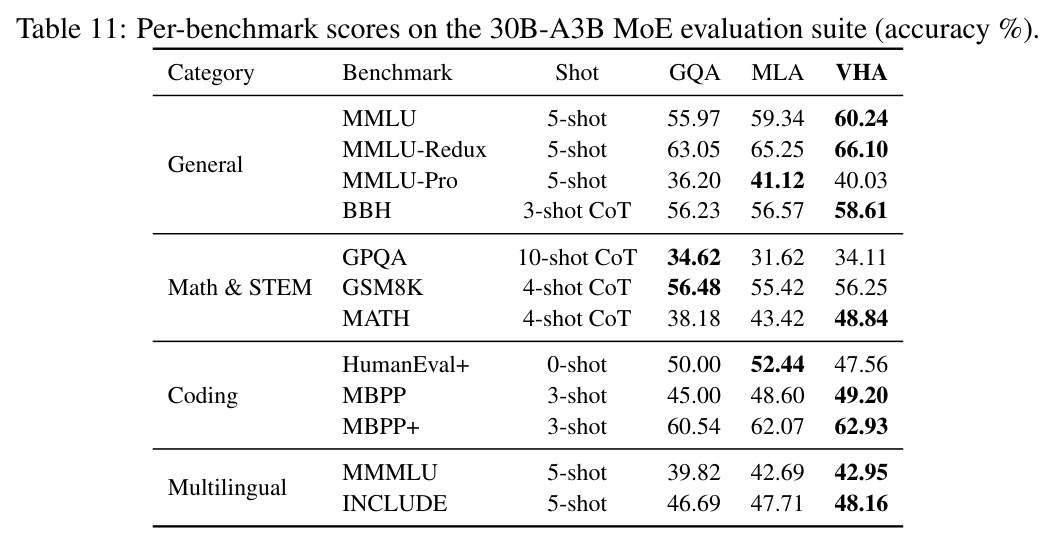
| 30B-A3B MoE 工业预训练(500B token, 8K 上下文) | 12 基准四类任务宏平均 (%) | 50.36(VHA 24-2-2,缓存 1.00 KB) | 47.76(GQA-4);49.66(MLA) | +2.60% / +0.70% |
| 10B-A1B 长上下文 mid-training 后评测(8K–128K) | RULER 长度平均分 | 84.4(全注意力层 2 个 KV 头) | 73.0(GQA,4 个 KV 头) | +11.4 |
| 训练/prefill 计算量(1.7B, S=4096) | 每 token 训练 FLOPs 相对 GQA 变化 | −7.9% | 0%(GQA);MFA +49.8%;MLA −1.8% | 唯一低于 GQA 基线的同缓存方法 |
局限与改进
作者承认的局限:MLA 在其实验中表现不佳可能与 50B token 的训练预算有关,更长训练下结论可能改变;Postmix 在数学上冗余,其收益依赖隐式正则效应,作者未完全排除其随规模放大会衰减的可能。我自己的观察:第一,解码 2–4 倍加速是访存瓶颈下的理论推断,论文没有给出实测吞吐或延迟数据;第二,30B-A3B 工业实验用内部语料,无法独立复现,且只评测 base model 的 12 个基准,没有指令跟随或对话能力评测;第三,长上下文对比中全注意力层只占 1/4(全:滑窗 = 1:3),但 RULER +11.4 的差距相当大,是否完全由 2 vs 4 个 KV 头造成值得更细的消融;第四,与 KV 量化(INT8/INT4)、跨层缓存共享(CLA/YOCO)等正交技术的组合未验证;第五,Premix 每组引入 $d \times d$ 参数,折叠前的训练显存与数值稳定性在超大规模下缺少讨论。
独立分析的弱点
弱点一:组件贡献不稳定——1.7B 上 Postmix-only 只比基线低 0.14%,4B 上 Postmix-only 甚至 +0.32%,而 Premix-only 在 1.7B 是 −0.78%,说明两个模块的收益随规模此消彼长,放大到更大规模时最优组合可能偏移,改进方向是按规模或按层自适应选择模块与秩。弱点二:训练预算偏小(50B token),小数据下结构正则的收益通常更明显,建议补充 500B token 以上的 dense 复现来验证结论不衰减。弱点三:缺乏系统级评测,KV 缓存减半带来的解码加速只有理论推断,应给出 vLLM/SGLang 端到端吞吐、TTFT/TBOT 实测,以及 KV INT8/INT4 量化下的质量表现。弱点四:Postmix 秩固定 $r = H'_q/2$ 只是经验选择,秩扫描只在 1.7B 上做了三个点,缺少跨规模验证。弱点五:把 MLA 的失败归因于训练预算,但没有做 budget-scaling 实验(如 50B/200B/500B 三档对照)来支撑这一解释。每个弱点都指向同一类改进:更系统的规模扫描与端到端工程验证。
未来方向
作者提出的可延伸方向:把 Premix/Postmix 与滑动窗口、稀疏注意力进一步组合,压低全注意力层占比;查询侧虚拟化与 KV 侧方法(SAS/LRKV)正交叠加,探索双重虚拟化是否互补;把重参数化思路用于 MLA,构造可吸收的 MLA 变体以摆脱定制内核。基于成果可延伸的研究:第一,训练动力学理论化——论文附录 G 给出梯度耦合的形式分析,可以继续刻画结构化流形上的隐式正则何时有效、何时退化为冗余;第二,秩与初始化的自适应调度,例如按层深度可学习的 $r$ 或 $\alpha$,替代全局固定超参;第三,与 KV 量化、跨层 KV 共享(CLA/YOCO)、投机解码等推理优化栈的组合评测,验证 1.00 KB 缓存在激进量化下是否仍是帕累托点;第四,研究 Premix 学到的组条件查询几何能否蒸馏回物理查询头本身,把'虚拟头'变成真实的架构先验;第五,在 RLHF/指令微调后评测,检验虚拟头结构是否在 SFT 阶段保持稳定。
复现评估
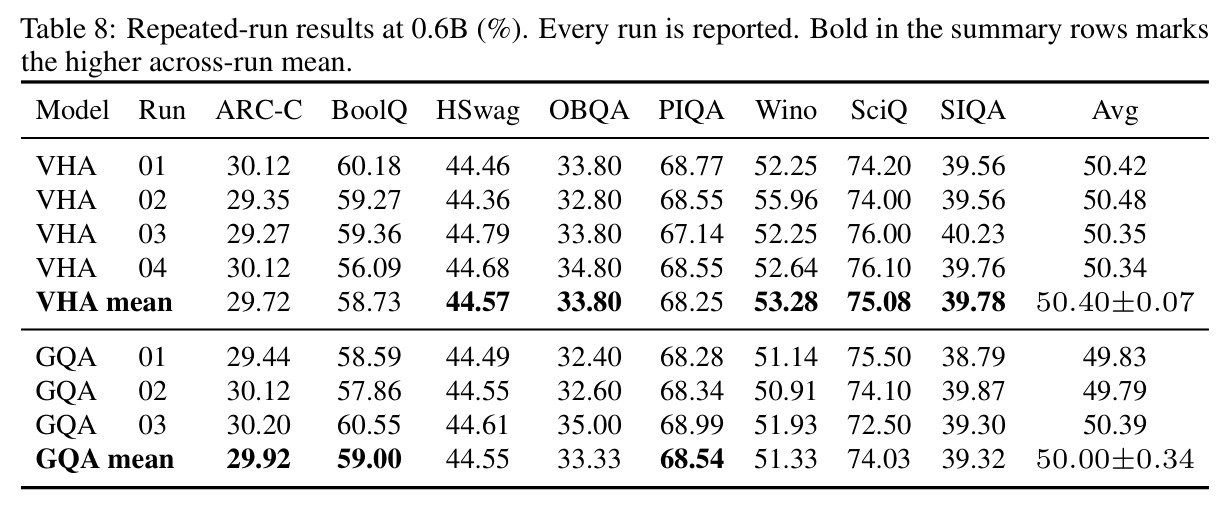
复现条件较好:源码已在 GitHub 开源(PaddlePaddle/VHA,基于 PaddlePaddle 生态);小规模实验全部基于公开数据 FineWeb-Edu(50B token)与 Qwen3 架构,附录 D 给出完整配置与训练超参,0.6B/1.7B/4B dense 与 8B-A1B MoE 在数百卡量级即可复现,论文还报告了重复实验方差(0.6B:VHA 50.40±0.07,n=4;GQA 50.00±0.34,n=3),可信度较高。困难部分:30B-A3B 工业实验使用内部多领域语料、500B token、FP8 混合精度,普通实验室无法完整复现,只能依赖附录 C 的分基准数字做核对;10B-A1B 长上下文对比基于 MiMo-2.5-Flash 风格骨干,阶段式 mid-training 配方在附录 A,复现需要多阶段训练管线与 128K 长上下文评测基建。总体而言,支撑核心结论的 Table 1/2/4/5 可在公开设置下独立验证,工业级数字只能选择信任原文;推理折叠只需一次离线矩阵乘,工程改造成本低。
论文图表