RelateAnything:来自任意输入的实时开放词汇关系预测 RelateAnything: Real-Time Open-Vocabulary Relation Prediction From Any Inputs
53M参数开放词汇关系模型,接受任意区域来源与推理时词表,20ms实时输出打分关系
前置知识
场景图生成(Scene Graph Generation, SGG)
将图像解析为 ⟨主语, 谓词, 宾语⟩ 三元组集合的任务,例如〈人-骑-马〉、〈杯子-在…上-桌子〉,是视觉关系理解的结构化表示。传统做法在 Visual Genome 的 50 个谓词固定词表(VG150)上训练一个谓词分类头,且关系打分以检测到的物体类别标签为条件。
本文要颠覆的正是这一范式的三个支柱(固定词表、类别条件化、域内评测),理解它才能看清 RelateAnything 改变了什么、以及为什么跨数据集评测是新的设定。
开放词汇(Open-Vocabulary)范式
模型在推理时接受任意类别/谓词字符串列表作为输入,词表以冻结文本编码器算出的嵌入矩阵形式存在,而非可学习的分类器权重,因此更换词表只需替换一个矩阵、无需重训练。OWL-ViT、GroundingDINO、YOLO-World 等检测器和 SAM 等分割器已实现这一点。
论文的核心论点是:检测和分割已完成'词表外置',关系预测还没有。整篇工作(模型、语料、基准)就是为关系预测补上这场转型的三块拼图。
正例-未标注学习(Positive-Unlabeled Learning)
当谓词词表扩大到一万量级时,'未标注'不再等于'错误':一对标注了 riding 的〈人,马〉同时隐含为真的 sitting on,把它们当负样本惩罚会教模型压制正确答案。PU 学习把未标注样本视为正负混合,估计其真为正的概率并对负样本折扣(本文用 $\ell_{pred}(i,j,q)+\log(1-\hat P(q|p))$)。
这是 10,102 个自由文本谓词可训练的关键:不做 PU 处理,词表越大模型学到的错误抑制越多,五位数词表反而有害。
对比文本编码器的反义词坍缩
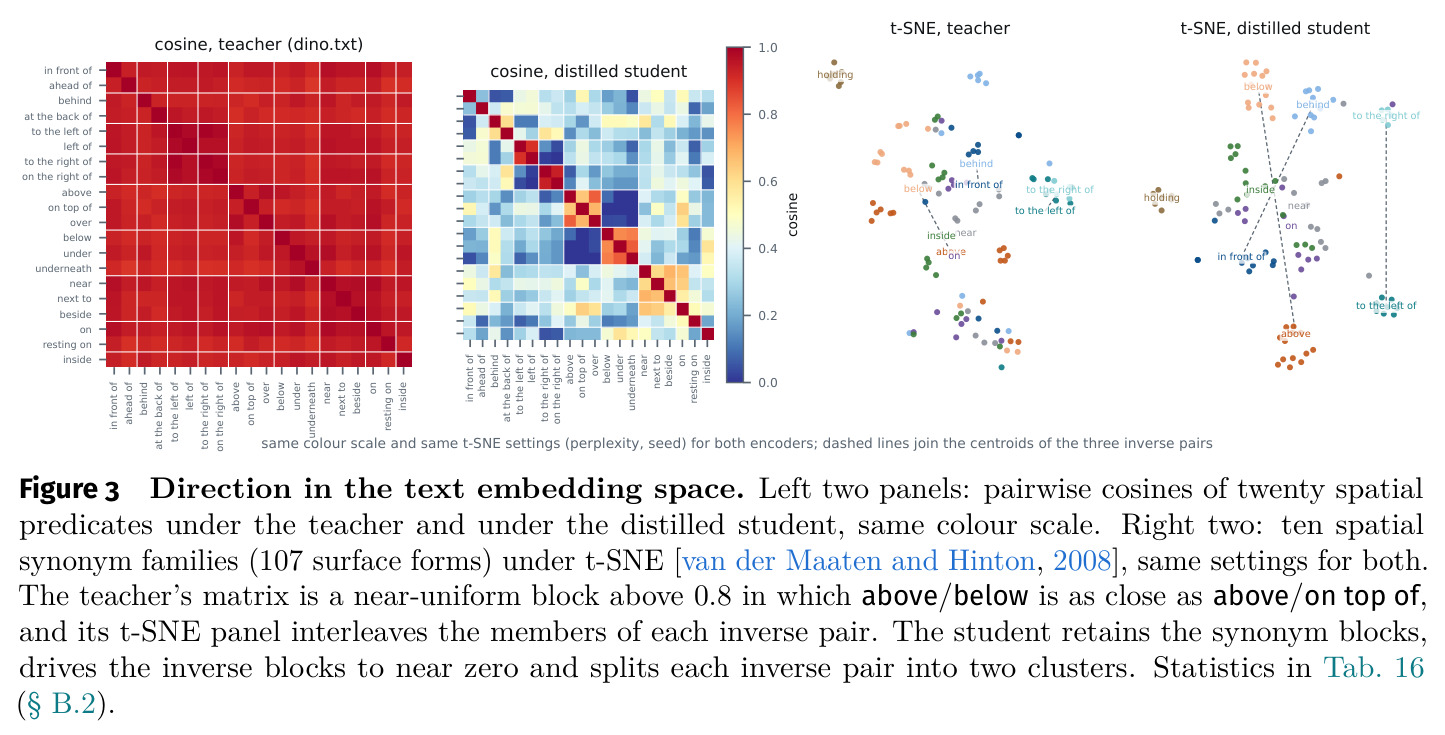
对比学习训练的文本编码器(CLIP 类)按上下文分布组织嵌入空间,而反义词出现的语境几乎相同,于是 above/below 被嵌到余弦相似度 0.95(to the left of/to the right of 达 0.99),与同义词对(平均 0.96)不可区分。由于关系模型是对这些文本方向做余弦回归,文本空间里反义词几乎同向意味着任何视觉模型都无法把它们分开。
这解释了为什么必须蒸馏带反义词排斥项的学生编码器,也是所有'拿现成 CLIP 算相似度做关系'方法的共同上限。
R@K 与 mR@K(micro 与 macro 召回)
R@K 是图像标注三元组出现在预测分数前 K 名的比例,逐三元组平均(micro),被高频谓词主导;mR@K 是每个谓词各自 R@K 的平均(macro),稀有谓词与 on 权重相同。两者经常给出相反的模型排序。
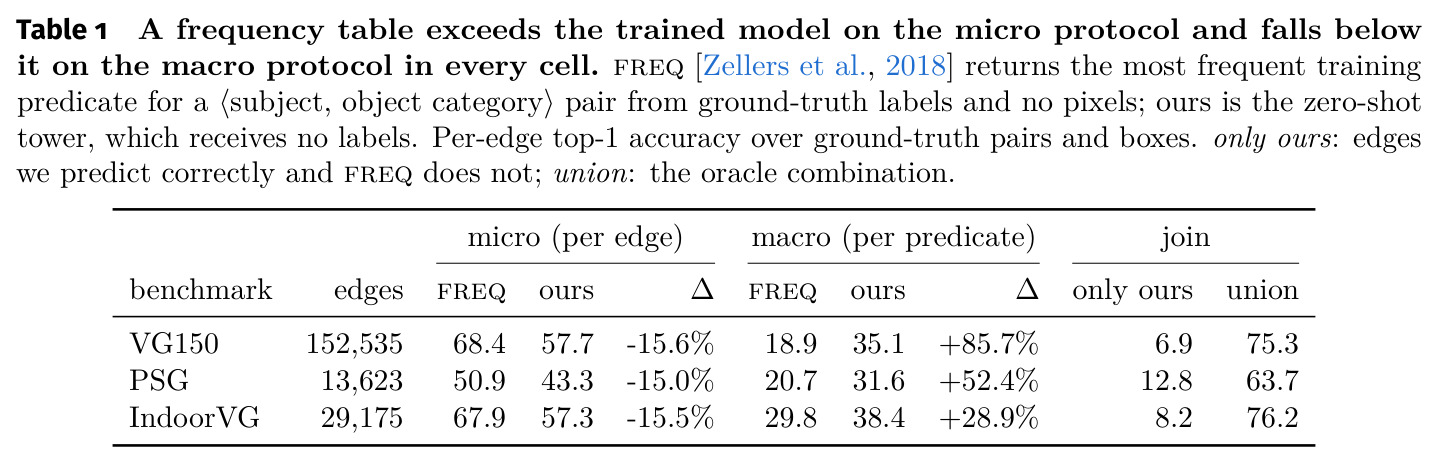
论文 §5 的核心发现:排行榜排序用的 micro 指标可被一个不看像素的物体类别对频率表赢过(VG150 上 68.4 对 57.7),因此 largely 是先验匹配分数,这直接催生了六轴协议。
共享三元组质量(shared triplet mass)
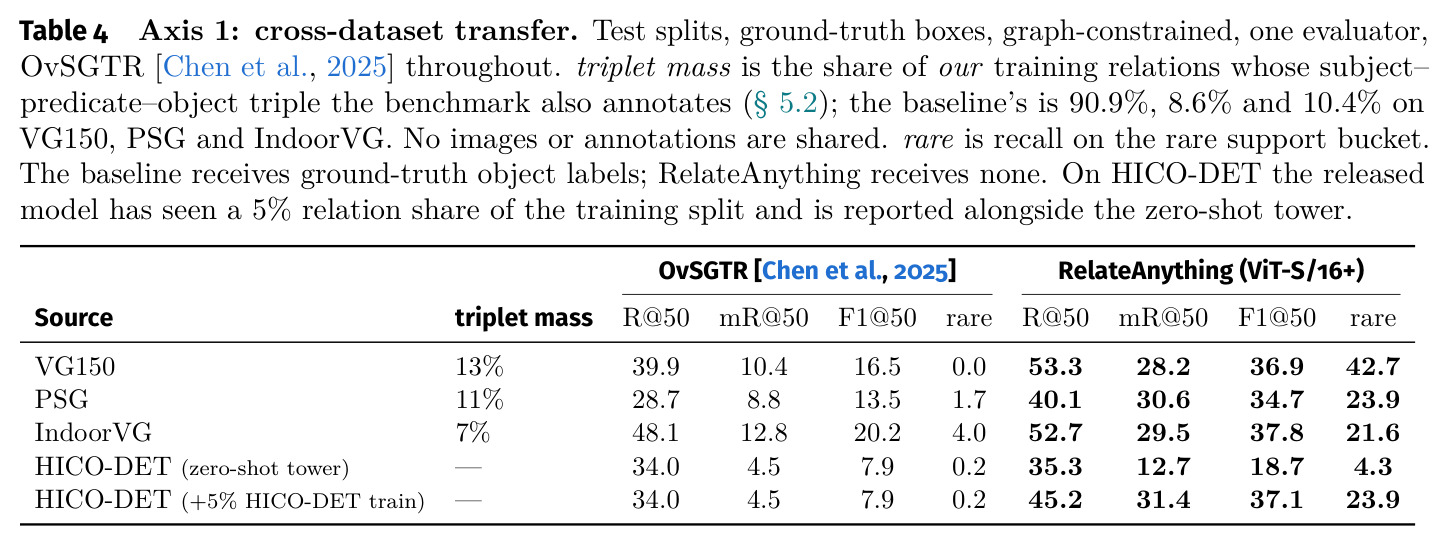
训练语料的关系实例中,其 ⟨主语类别, 谓词, 宾语类别⟩ 三元组也被目标基准标注的比例。谓词字符串相同不等于标注相同——'人在马上 on' 与 '书在桌上 on' 是不同的三元组。本文混合语料与 VG150 的三元组共享度为 12.8%,而基线微调语料高达 90.9%。
论文证明该统计量可预测基准召回,是最便宜的诚实报告手段,也是读懂 Tab. 3/4 中每个召回数字背后的域内先验优势的钥匙。
研究动机
开放词汇检测已接受推理时给定的任意类别列表,可提示分割返回不带类名的区域——在这两个领域,分类词表已从模型内部移到输入端。但关系预测没有完成这场转型:场景图模型仍在 VG150 的 50 个谓词或 PSG 的 56 个谓词上训练与评测,主流架构的关系头以预测的物体类别标签为条件,因而被绑死在单一检测器和单一标签空间上。论文指出三个障碍,且都不是建模问题。其一,监督不存在:关系标注是视觉中最昂贵最不可靠的标注形式,一张含 $N$ 个物体的图有 $N(N-1)$ 个候选对,Visual Genome 标注者写下 36,549 个谓词字符串,社区只保留最高频的 50 个,被丢弃的部分恰是开放词汇模型要服务的对象;已有的机器生成语料要么投影到固定类表、要么完全不检查标注者。其二,架构用不上这种监督:以物体标签为条件的关系头继承了标签空间,编码成单条 caption 的词表被限制在约 150 个字符串。其三,度量看不见词表扩大:基准词表与训练词表共享,召回奖励的是与语料的一致性——一个不看像素的频率表在排序排行榜的 micro 指标上以 68.4 对 57.7(VG150)超过训练好的模型。
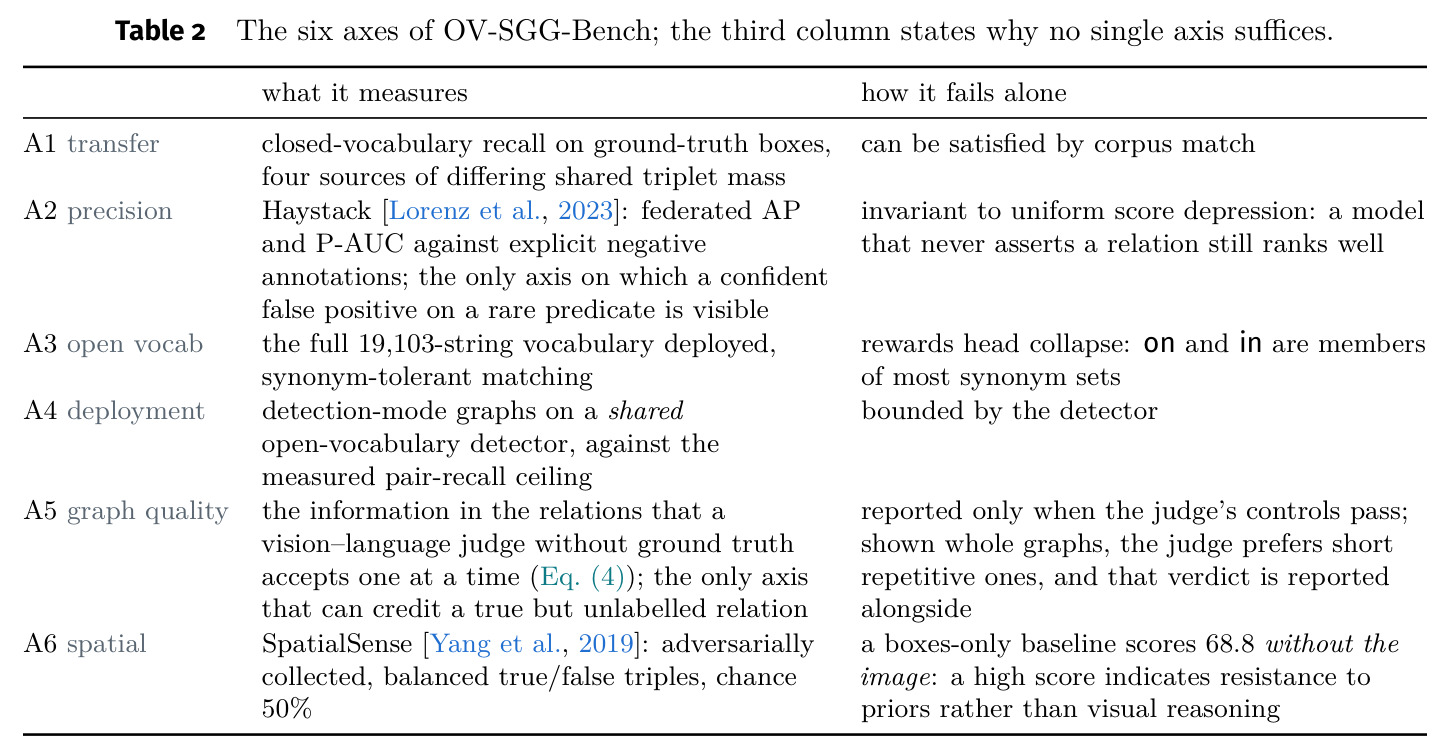
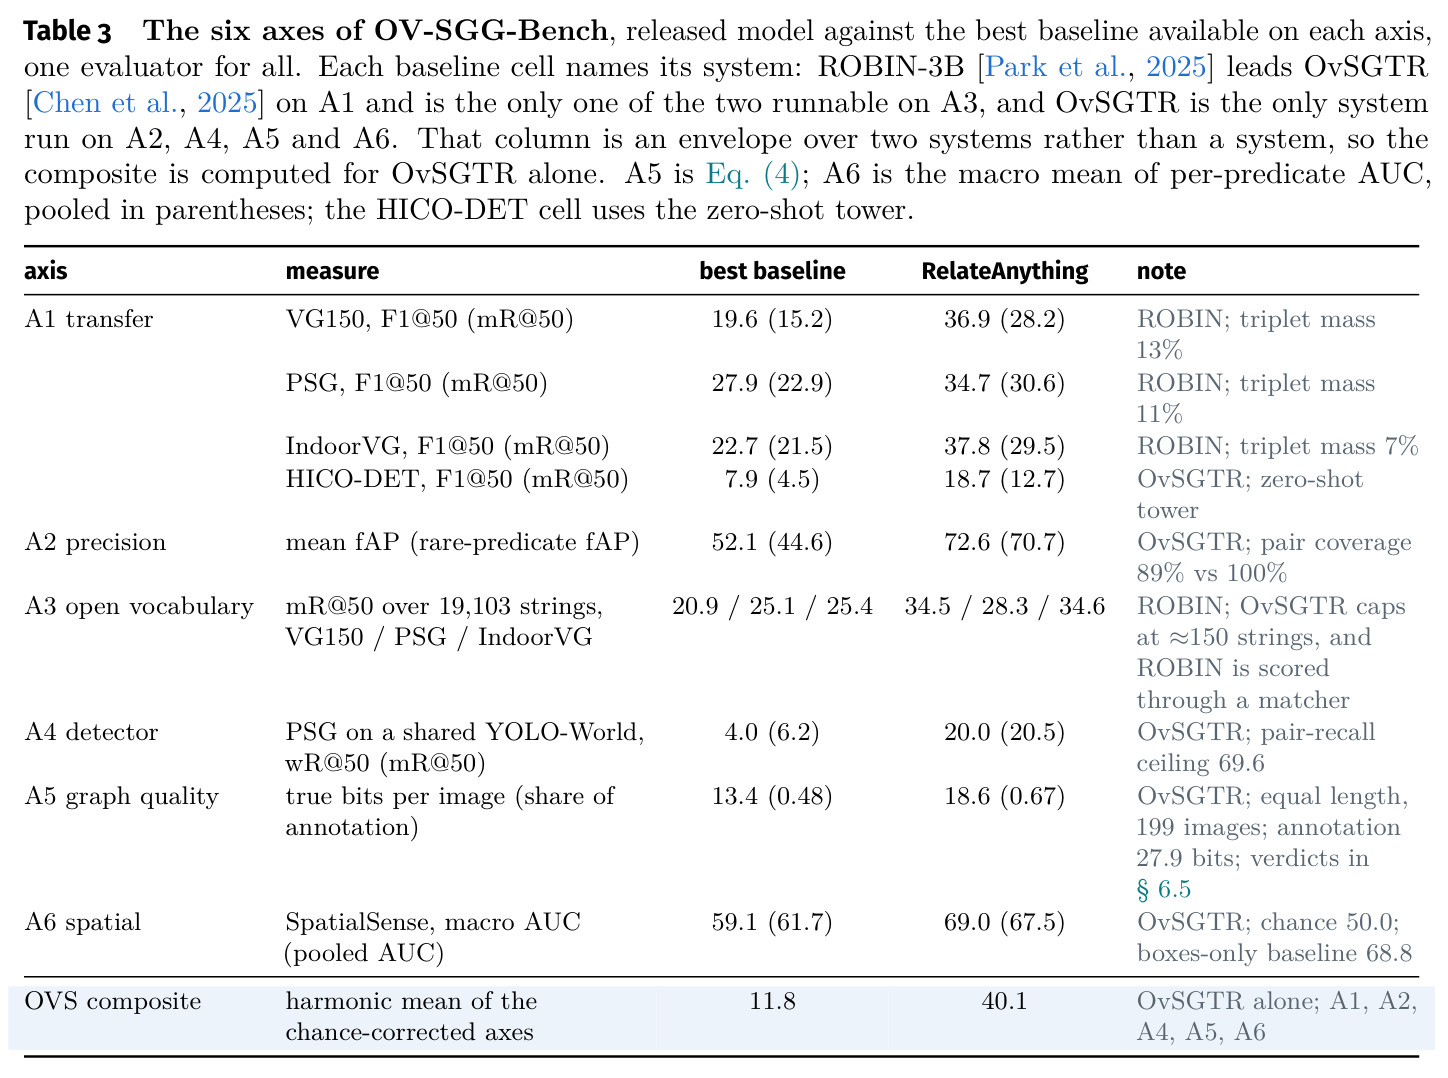
本文的目标是本文要一并移除这三个障碍,并测量它们彼此的影响。具体目标有三:第一,构建 RelateAnything——一个 53M 参数、单卡 20ms/帧的关系模型,输入只有图像像素和一组来自任意来源(任何检测器、类无关分割器或人工标注)的区域,输出是按推理时以字符串列表给出的谓词词表打分的三元组 $(i,j,p)$;物体类别标签在任何阶段都不进入网络,词表是一块文本嵌入矩阵,更换无需重训练。第二,构建 RA-4M 语料——474,413 张图、4,282,531 条关系、10,102 个自由文本谓词,由 VLM 对编号框标记生成,并经确定性几何门验证,是首个既自由文本又经几何验证的关系语料。第三,构建 OV-SGG-Bench——六轴跨数据集评测协议,每个轴都对论文分析出的先验与计分约定免疫,各轴以调和平均合成综合分 OVS 以惩罚偏科,让'扩大词表'不再被记为退步。
与已有工作不同的是,独特之处在于把问题诊断为测量与数据问题而非建模问题,并以'先修度量'为纲:论文先用整节篇幅证明标准场景图召回在很大程度上是先验匹配分数——共享三元组质量可预测基准召回;PSG 测试上 78% 的预测边落在语料从未标注的 pair 上(标注倾向还原为接触先验);标准匹配器允许重复计分,每个 GT 框平均被 2.99 个检测覆盖;检测器工作点移动配对召回上限 12–49%,而排行榜上所有已发表方法之间的差距只有 4.3 点。另一独特切入是把 VLM 用作标注者而非预测器,并成为第一个对机器生成关系语料做几何验证的工作(拒绝 11.3% 候选,拒绝即真负例)。训练端则首次在五位数谓词词表上把监督显式当作正例-未标注问题处理,并修正对比文本编码器的反义词坍缩(above/below 余弦 0.95)——这两点是让大词表有益而非有害的前提。
核心方法
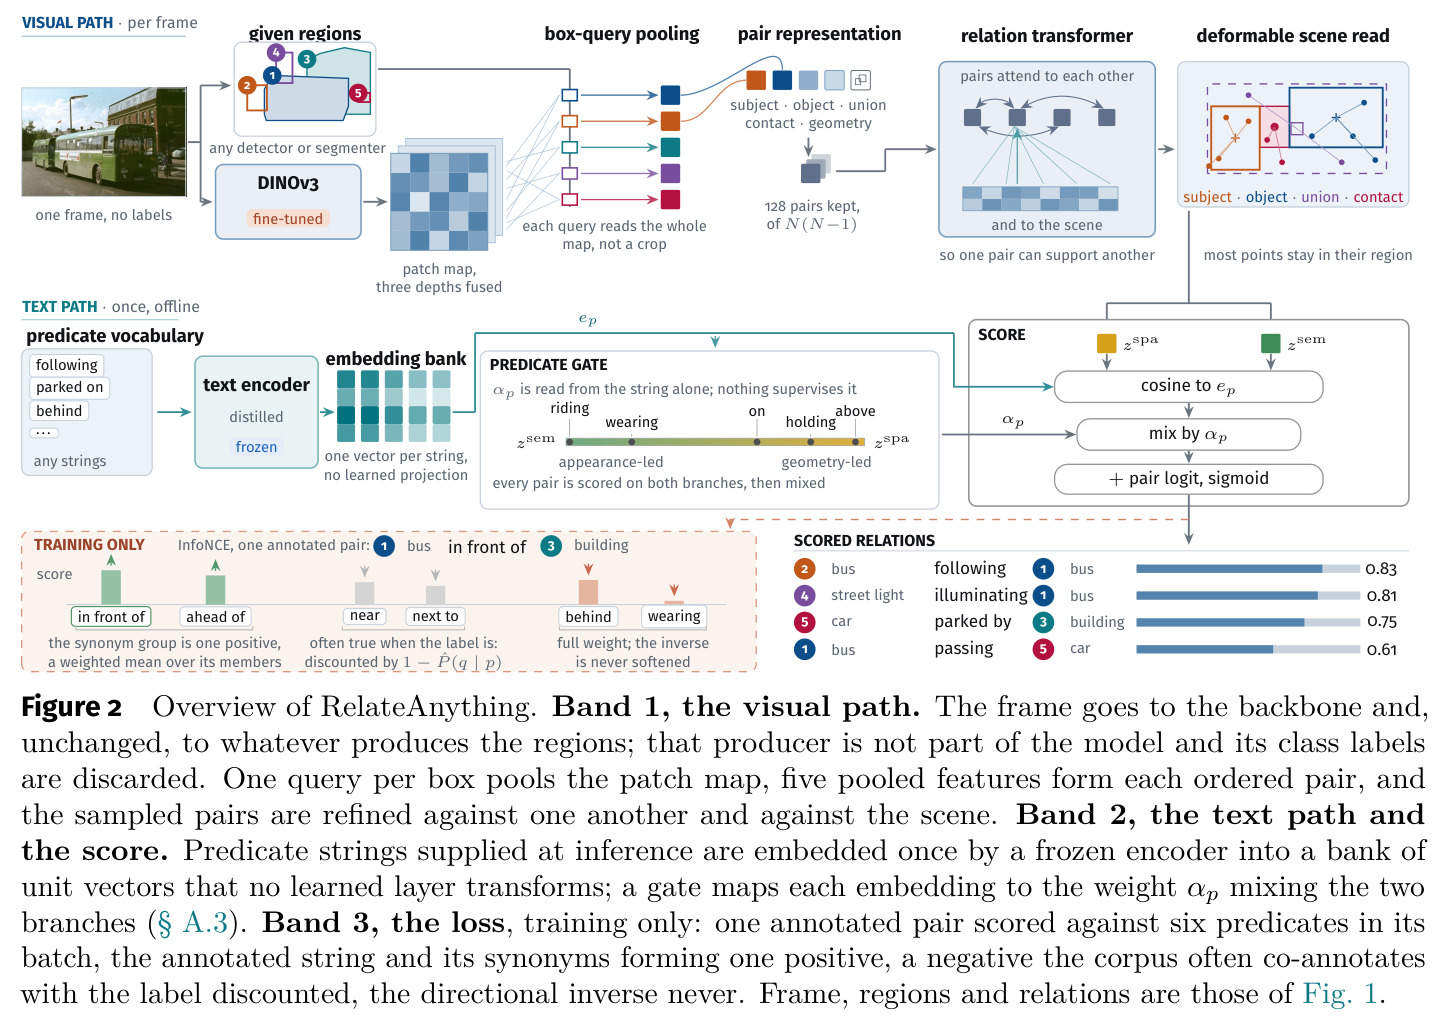
直觉:把关系打分变成'视觉对嵌入'与'谓词文本嵌入'之间的余弦相似度,文本侧没有任何可学习变换,所以换词表就是换一个矩阵;物体类别永不输入,所以区域来源随便换。技术路线:视觉路径用 DINOv3 骨干(ViT-S/16+)在 $448\times448$ 下编码图像,在第 $-6,-3,-1$ 层读取 patch 特征并学习加权融合;每个框 $b_i$ 用傅里叶位置编码形成查询,对全图 patch token 做交叉注意力软池化得到物体特征 $v_i=\mathrm{Attn}(q(b_i),F,F)$——物体表示天然包含它交互的上下文而非裁剪。对特征为 $x_{ij}=[v_i;v_j;v_{\cup(i,j)};v_{\cap(i,j)};\mathrm{MLP}(g_{ij})]\,W_{\mathrm{proj}}\in\mathbb{R}^{512}$,其中 $v_\cup$ 池化并集框、$v_\cap$ 池化接触区(相交取交集、否则取间隙),$g_{ij}\in\mathbb{R}^{19}$ 是尺度不变几何特征;随后一个关系 transformer 让 128 个采样对彼此自注意力并交叉关注场景 token,再加一级可变形读取(围绕四个锚点预测采样偏移、经零初始化门读特征图),使 parked on 可参考路面、hanging from 可参考上方悬挂点。打分用双分支混合:$\ell_{\mathrm{pred}}(i,j,p)=\tau\,\alpha_p\cos(z^{\mathrm{spa}}_{ij},e_p)+\tau(1-\alpha_p)\cos(z^{\mathrm{sem}}_{ij},e_p)+\beta$,门控 $\alpha_p=g(e_p)$ 只依赖文本嵌入,因此对未见字符串有定义;学到的门强烈双峰——投影/邻近关系走几何分支,动作走外观分支。
与已有方法的本质区别有三。第一,词表即输入:没有谓词分类器,分数是余弦相似度,文本侧没有拟合训练词表的投影层(这种投影对后给字符串无定义),19,103 个谓词字符串由冻结的蒸馏学生编码器离线嵌入为单位向量库,换词表是矩阵替换。第二,在五位数词表上训练需要两个非标准处理:(a) 监督是正例-未标注的——〈人,马〉标注 riding 则 sitting on、mounted on 亦真,惩罚它们等于教模型压制正确答案;解法是 batch-local InfoNCE,正例为标注谓词的同义词组(按同义概率加权平均,等张回归拟合于 1,177 个词汇同义对),负例按估计共现概率折扣:$\ell_{\mathrm{pred}}(i,j,q)+\log(1-\hat P(q\,|\,p))$,$\hat P$ 在 706k 多标注框对上由共标注计数、文本余弦和频率配合 Elkan–Noto 修正拟合;两个豁免不可少——已标注谓词永不降权、方向性反例(above vs below)永远全权重,因为这是区分方向的唯一信号。(b) 文本空间本身有缺陷:教师编码器把 above/below 嵌到余弦 0.95,与同义词(0.96)不可区分;解法是蒸馏 512 维学生编码器,目标含反义词排斥 hinge 与邻域保持项,蒸馏后同义-反义 AUC 从 0.85 升到 0.99、反义平均余弦从 0.92 降到 0.09、hubness 从 8.1 降到 1.3。已有开放词汇方法只是把分类器换成与现成文本嵌入的相似度,继承的是同一个有缺陷的文本空间。
方法步骤详情
步骤一(语料生成):在每个框中心画带索引的彩色圆点作编号标记,让 Gemma 26B VLM 做'语义、grow、空间'三次遍历生成关系——grounding 是标注者的输入而非其输出的推断。步骤二(几何验证):确定性几何门只在框几何逻辑上约束该谓词时才拒绝(containment 要求包含、contact 要求相交),拒绝 11.3% 原始候选且拒绝即真负例;left/right、above/below 做方向 repair(交换主宾、保留表面形式);每个验证过的方向性关系再以 0.5 概率从另一端点重述为逆谓词,使语料方向平衡。产出 474,413 图、4,282,531 关系、10,102 谓词、9.03 关系/图,成本 104 GPU 小时;与同图同框的源标注比密度 1.7 倍(9.03 对 5.29)、词表 107 倍。步骤三(训练数据):谓词库 19,103 串 = RA-4M 的 10,102 + 取自 SVG/GQA/PSG 词表的 9,001(只作答案空间不作监督);zero-shot 塔混合 RA-4M 与泄漏过滤的原始 VG 自由文本(40,615 图、758,547 关系,91.9%/8.1% 按图),发布塔再加 5% 关系份额的 HICO-DET;所有评测 split 按图像 ID 表与感知近重复检索排除(移除 8,687 语料图、32,456 张 VG 图)。步骤四(训练):主损失为 batch-local InfoNCE(同义词组正例 + PU 折扣负例),辅以逐格 sigmoid、方向 swap hinge(按估计方向性概率加权)、背景抑制、物体-文本接地四项;两阶段对采样先按几何可行性留 400 个、再按学习到的 relatedness 留 128 个(保留 99.79% 正例;穷举打分只多 1.02% 成本且无增益)。步骤五(推理):区域来自任意检测/分割器,谓词字符串离线嵌入,编译带来 1.5–1.8 倍加速,单帧 20ms,CPU fp16 亦可达 7 FPS。
技术新颖性
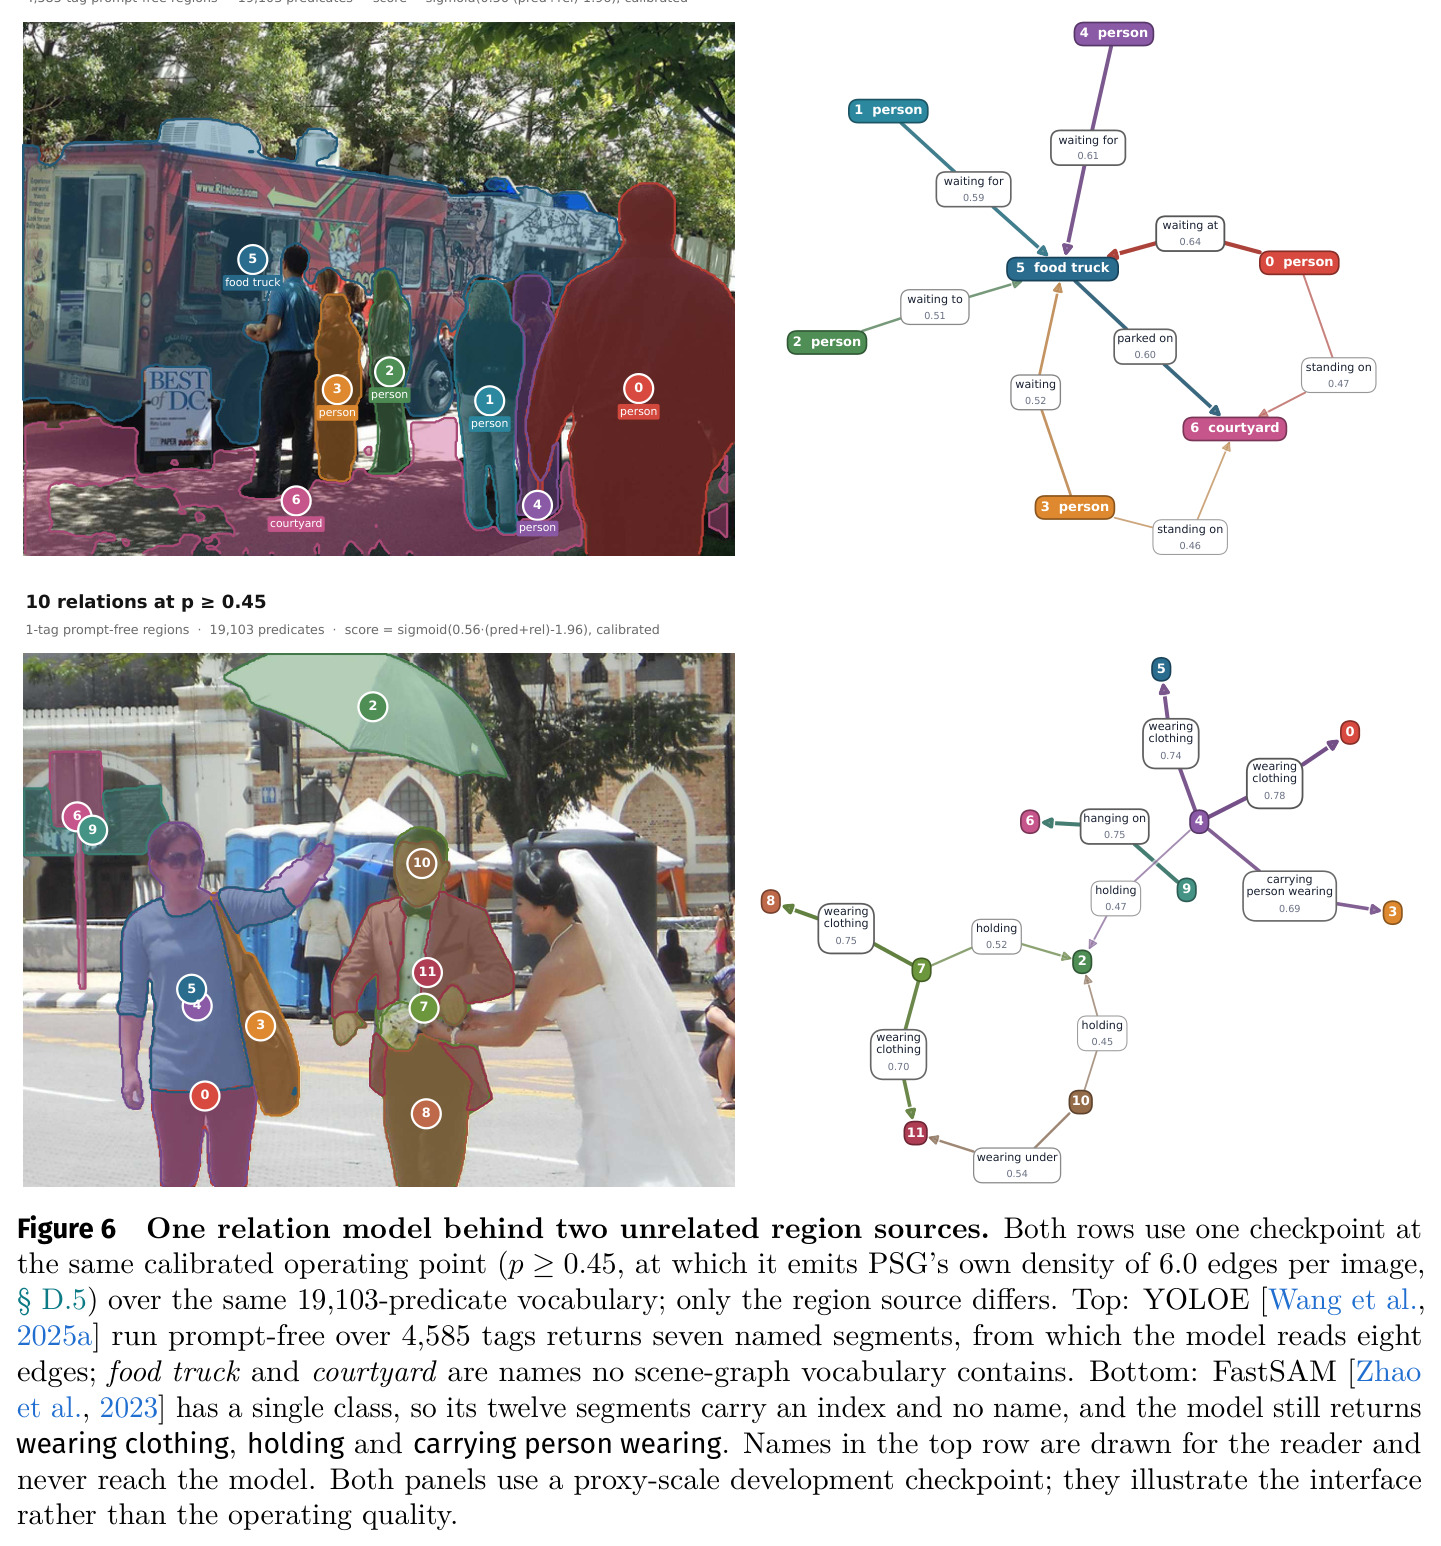
技术新颖性可从四层看。数据层:RA-4M 是第一个既自由文本又对所标注框做几何验证的关系语料——GPT4SGG、MegaSG、Synthetic Visual Genome、All-Seeing 等都直接接受或用第二个模型过滤 VLM 输出,无一验证几何;'门只在几何逻辑约束谓词时触发'的设计使拒绝成为真负例、几何无法约束的部分作为已知残差被计数而非假装检查过。架构层:类别标签永不输入 + 词表为无变换嵌入银行,这两个约束此前从未同时成立,它使 SAM、FastSAM、YOLOE、LVIS 1,198 类框等任意区域源即插即用(Fig. 6 演示同一 checkpoint 读两种完全不同的区域源)。目标函数层:PU 折扣、同义词组正例、反义词排斥蒸馏三者共同让五位数词表可训练,且所有语义常数(同义权重、方向性概率、标注率下限)由语料拟合而非手设。评测层:首次量化共享三元组质量、匹配器重复计分、检测器工作点这三个被长期忽略的因素,并把'按数据集间评测、无基准贡献训练图'引入场景图生成——这一设定基本未被探索,因为既有结果几乎都是域内报告。结果是 53M 参数在跨数据集设置下以 2.3–3.5 倍平均召回胜过 3B VLM 场景图模型 ROBIN-3B,参数不到其 2%。
实验结果
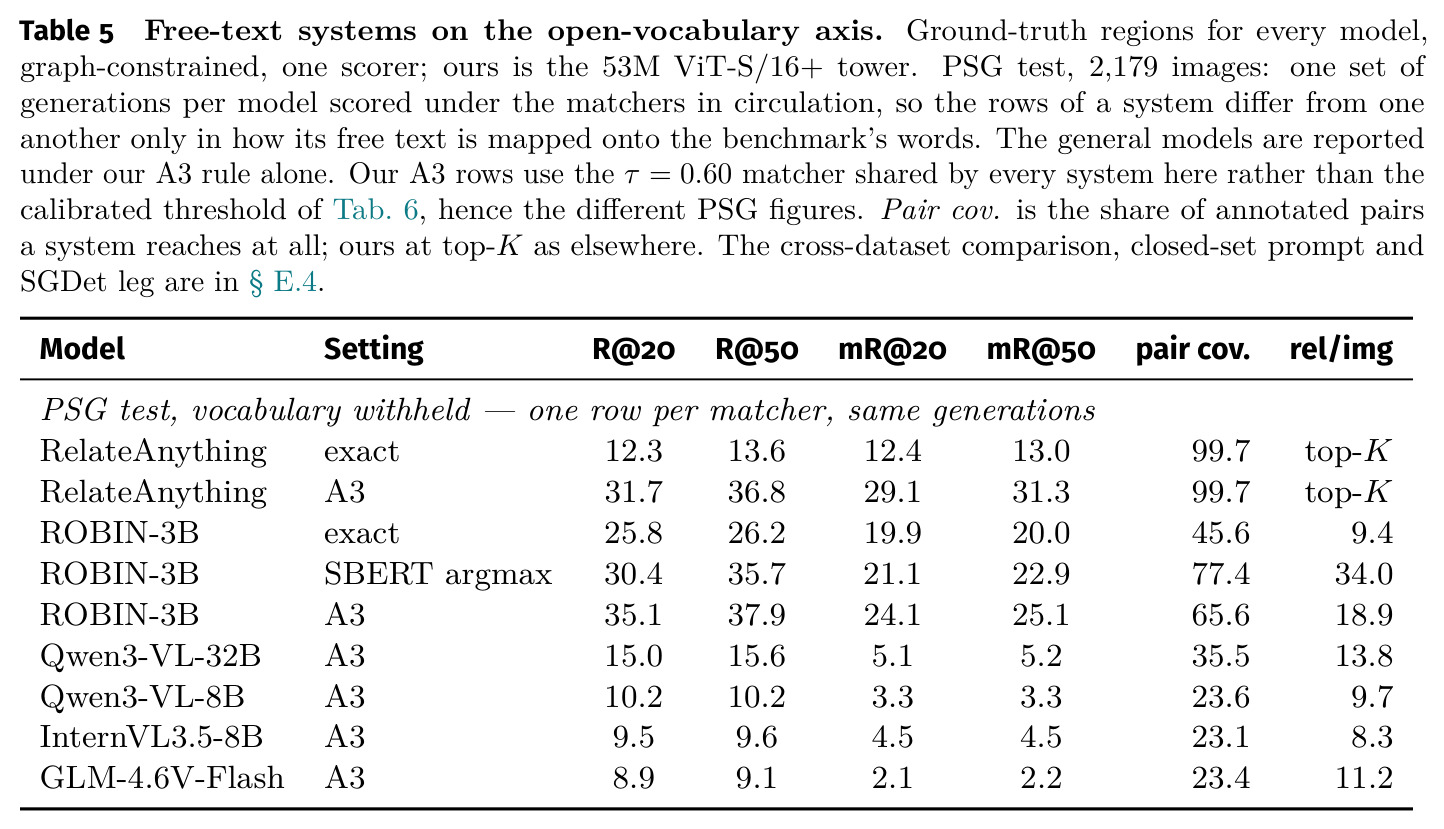
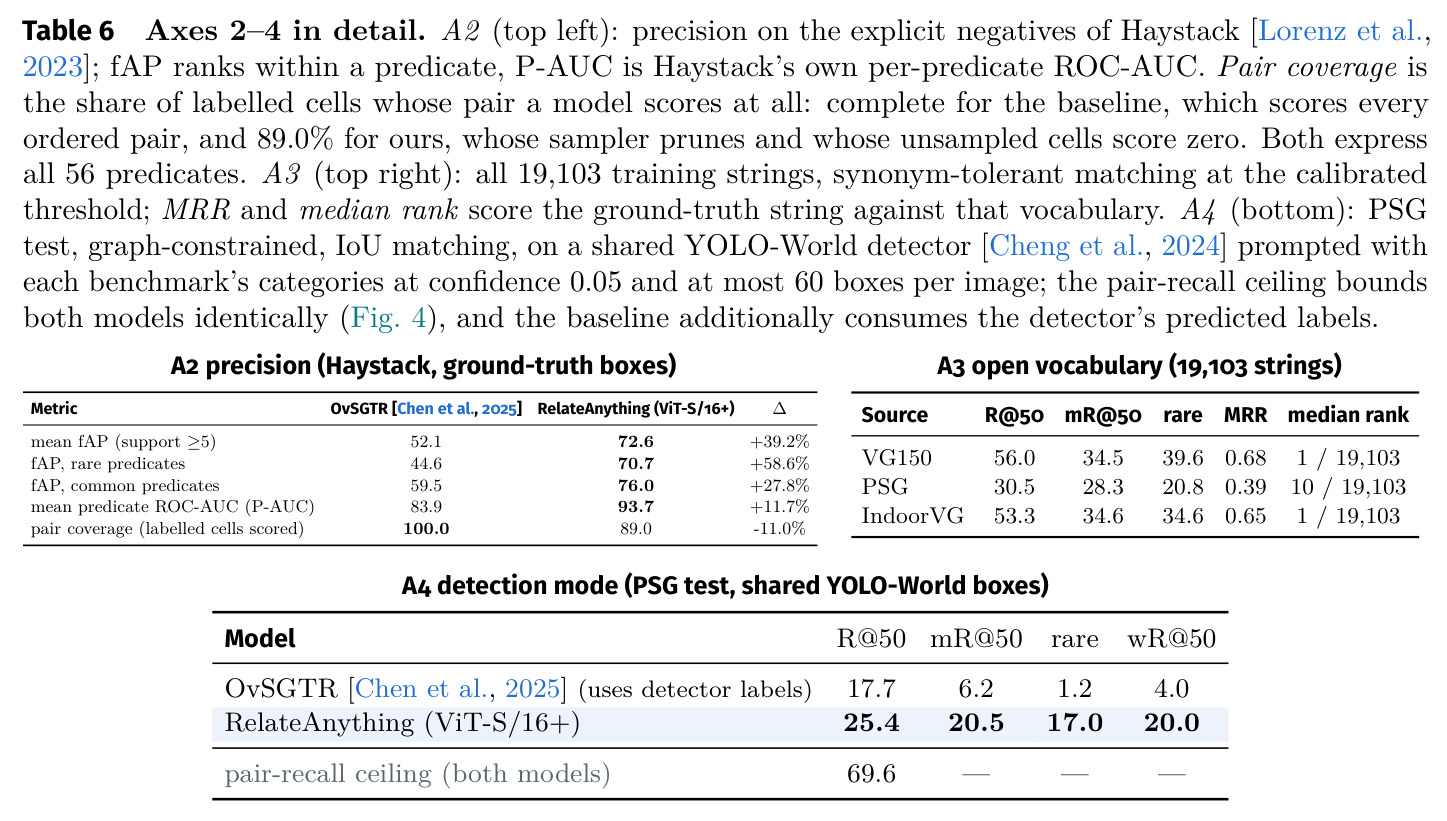
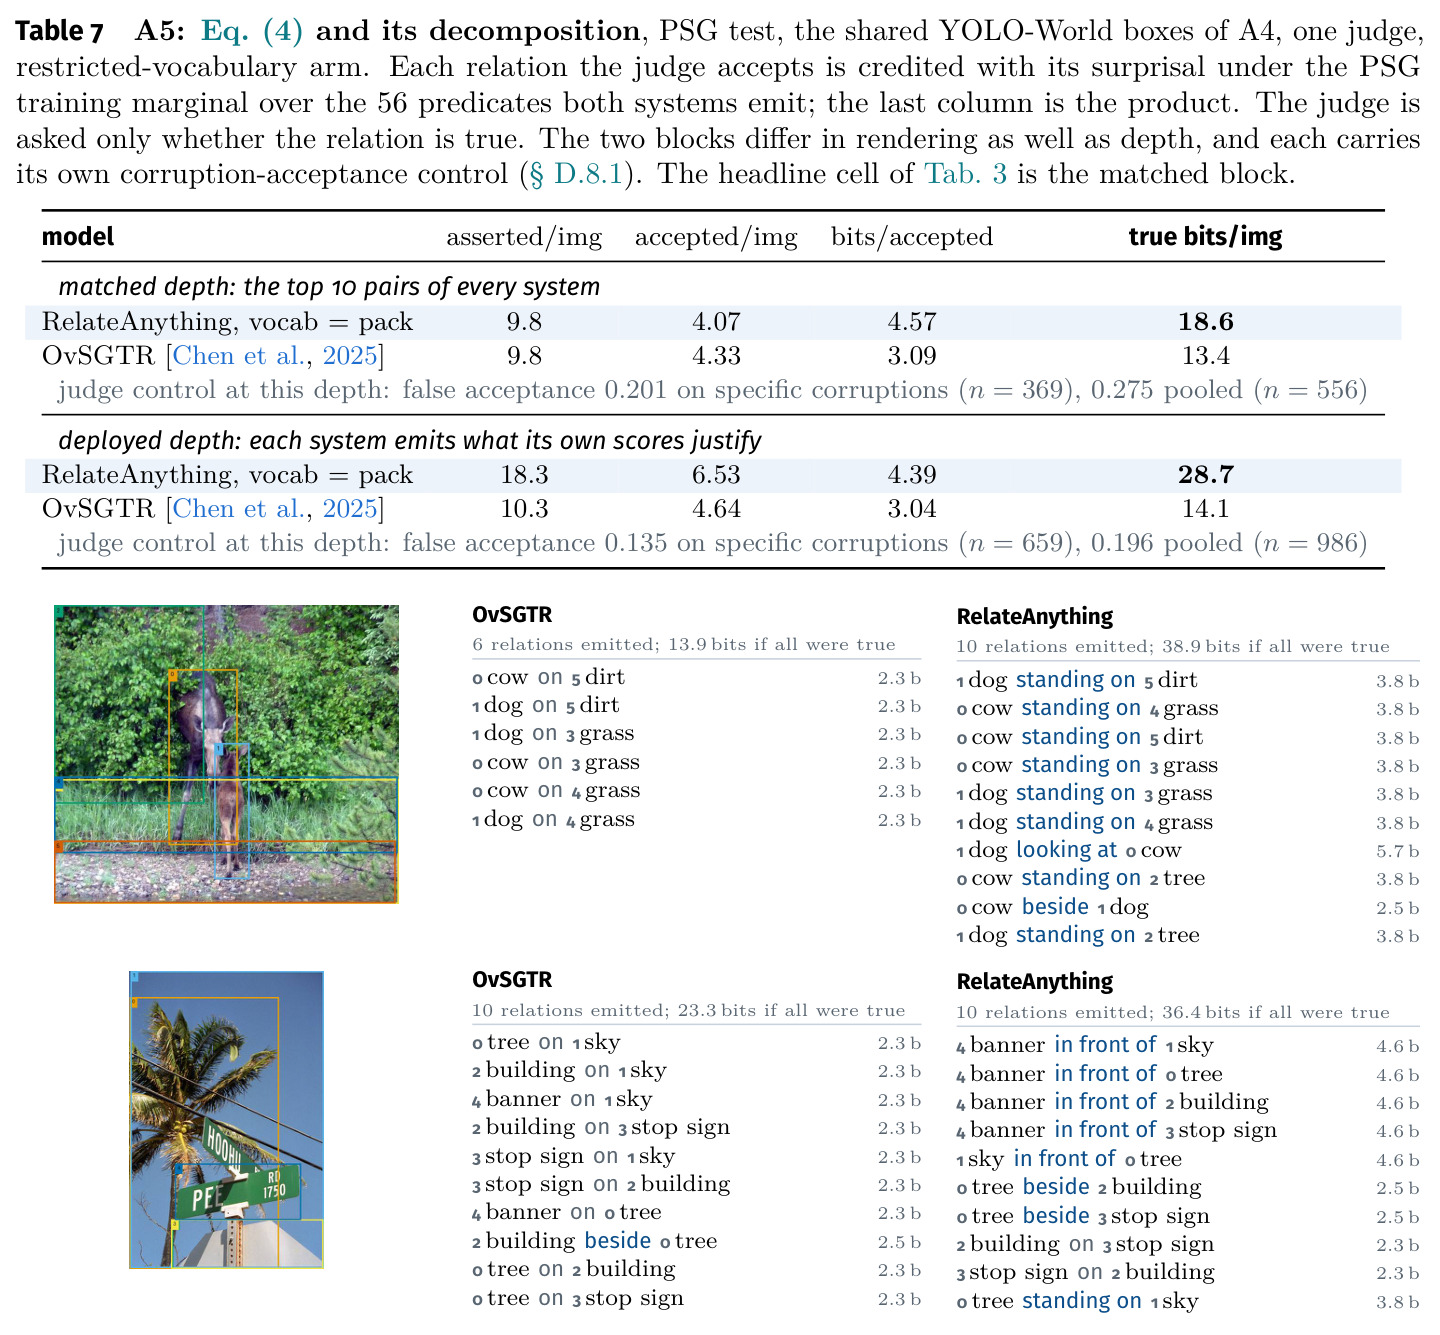
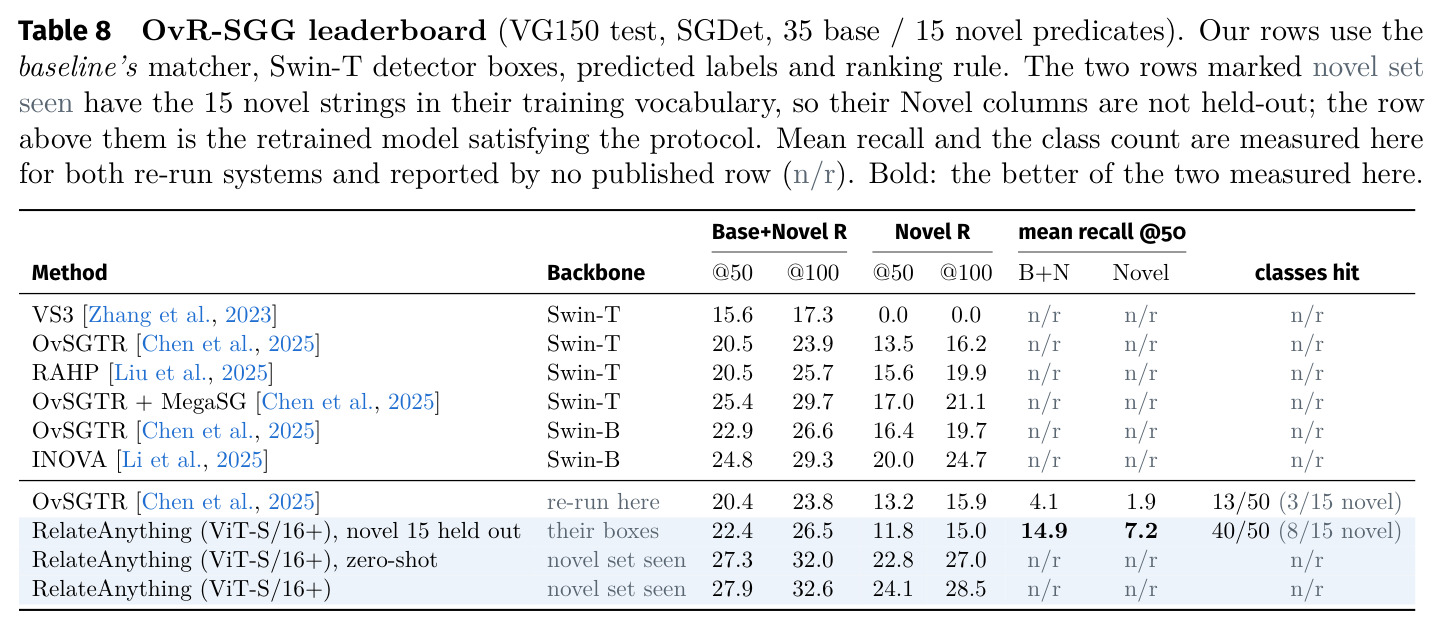
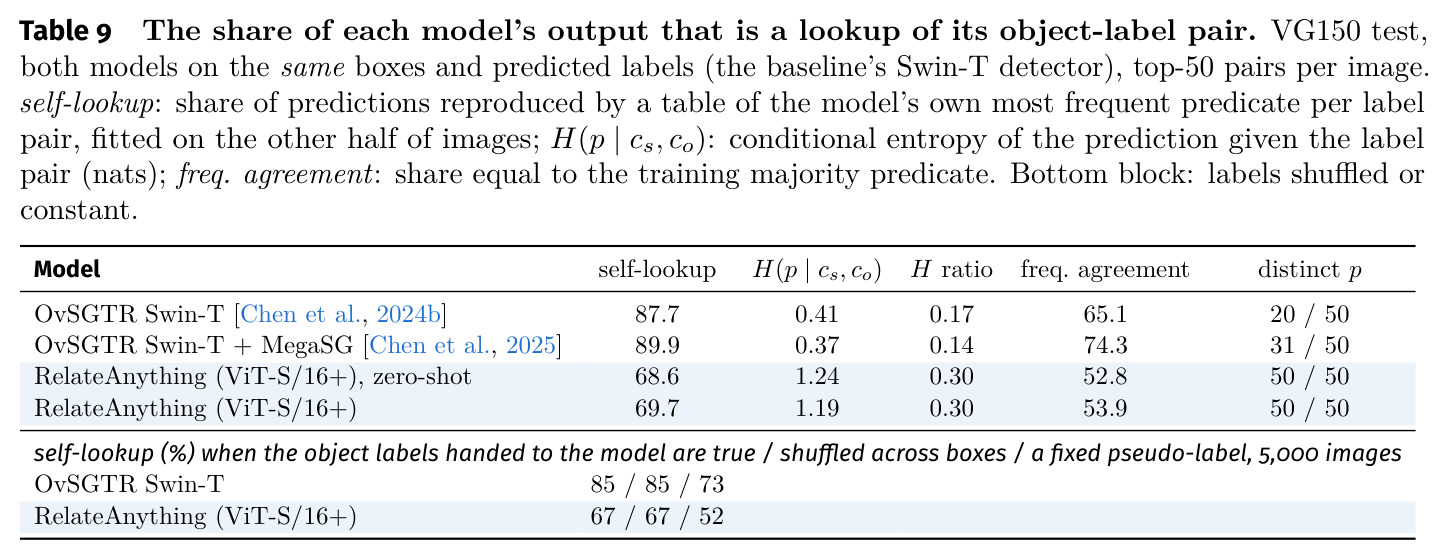
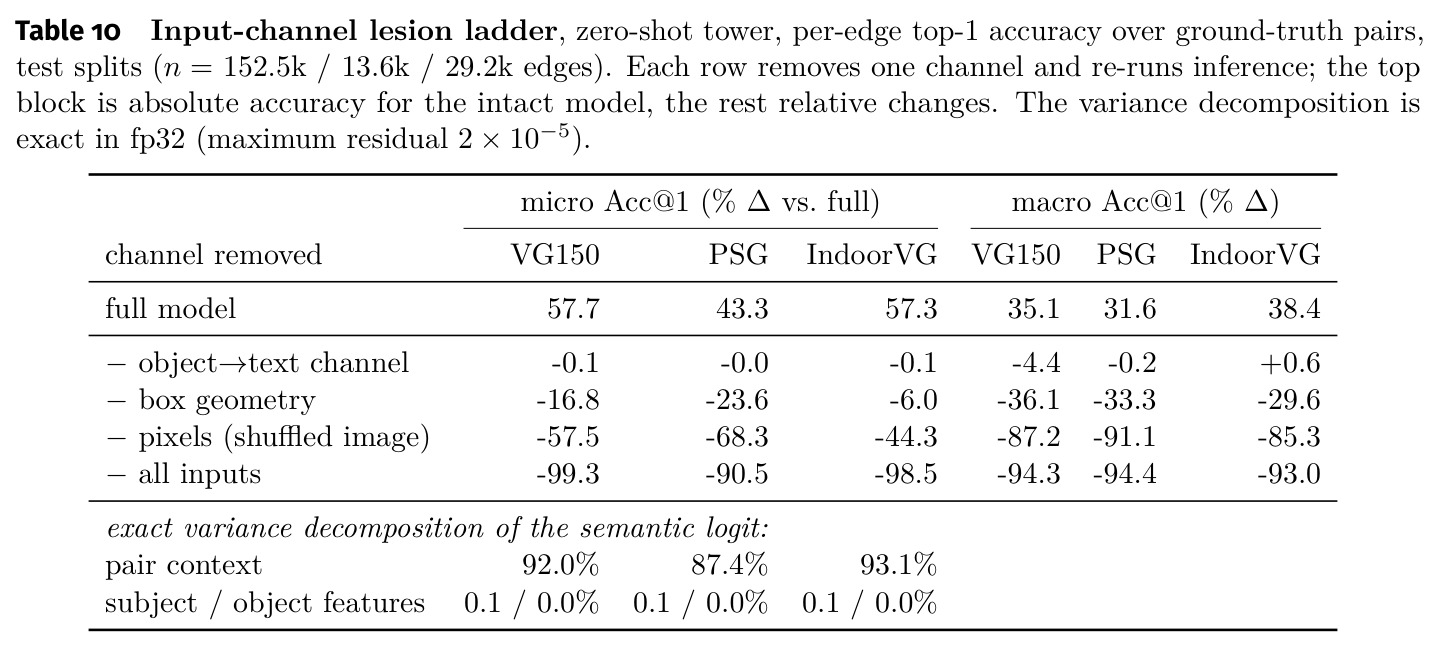
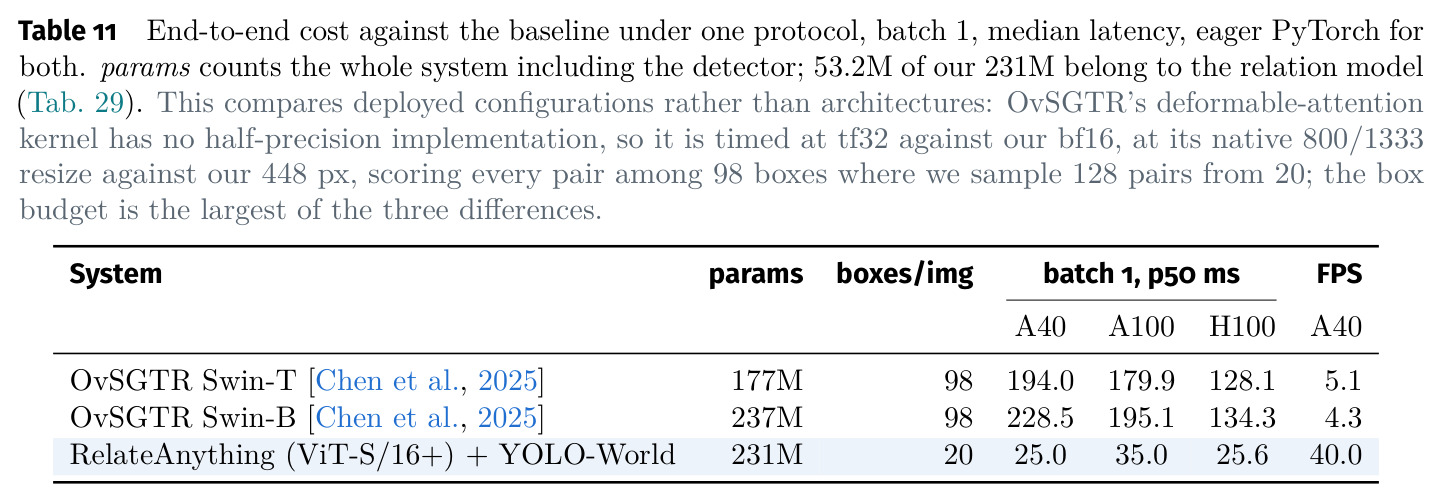
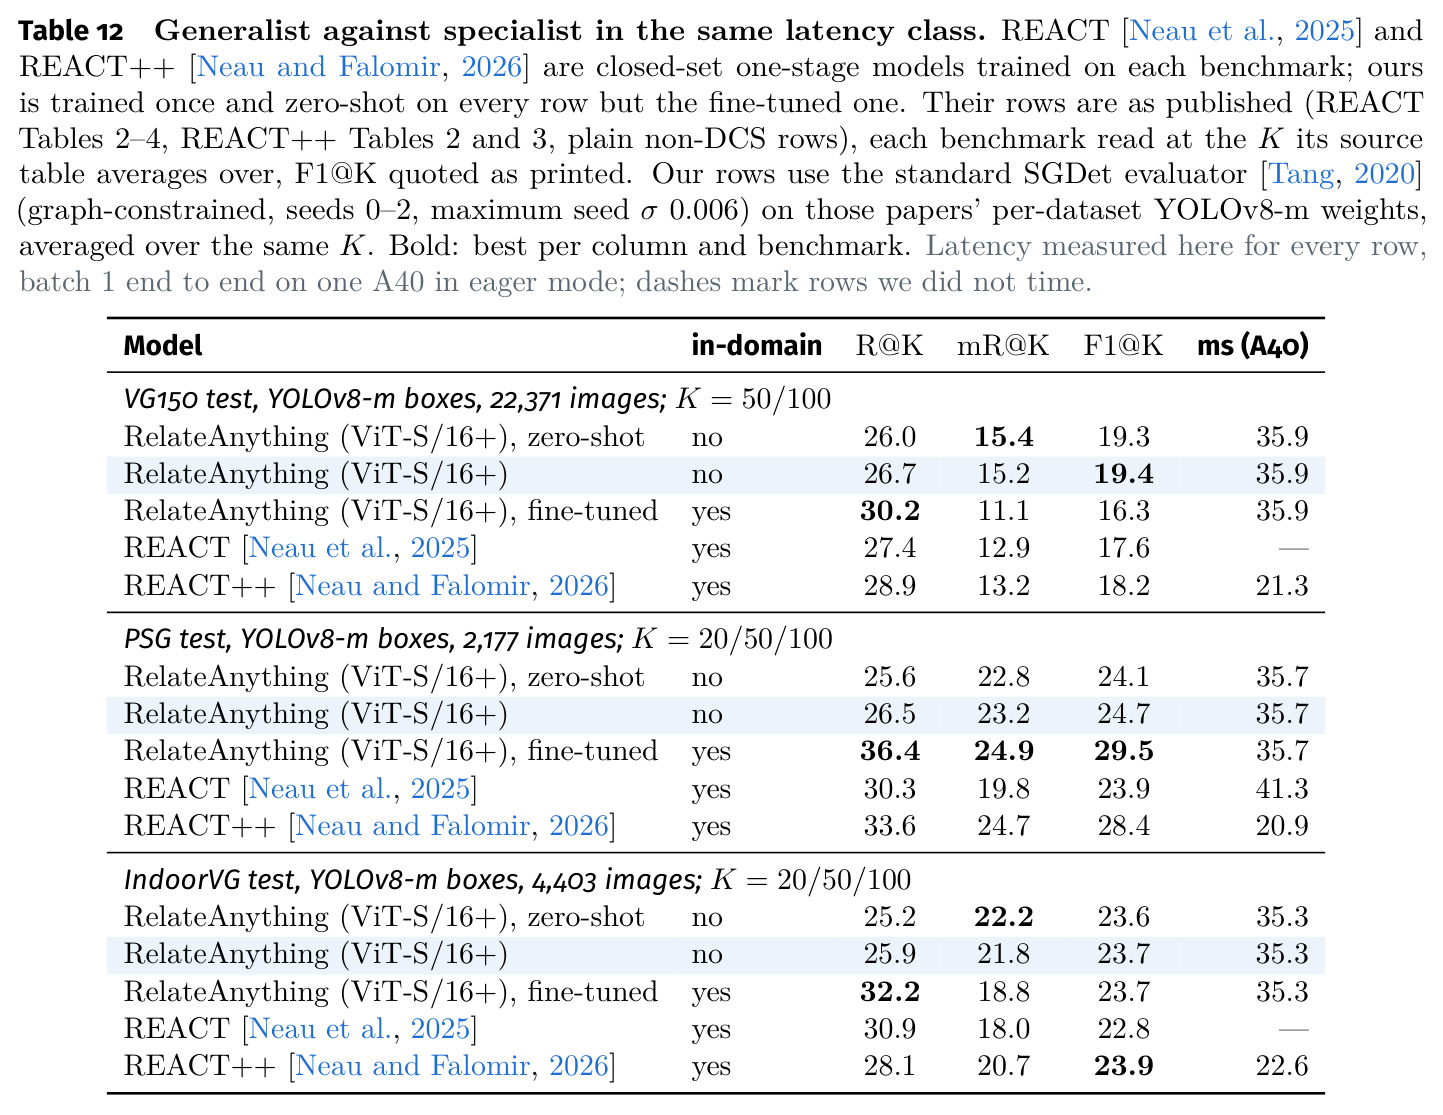
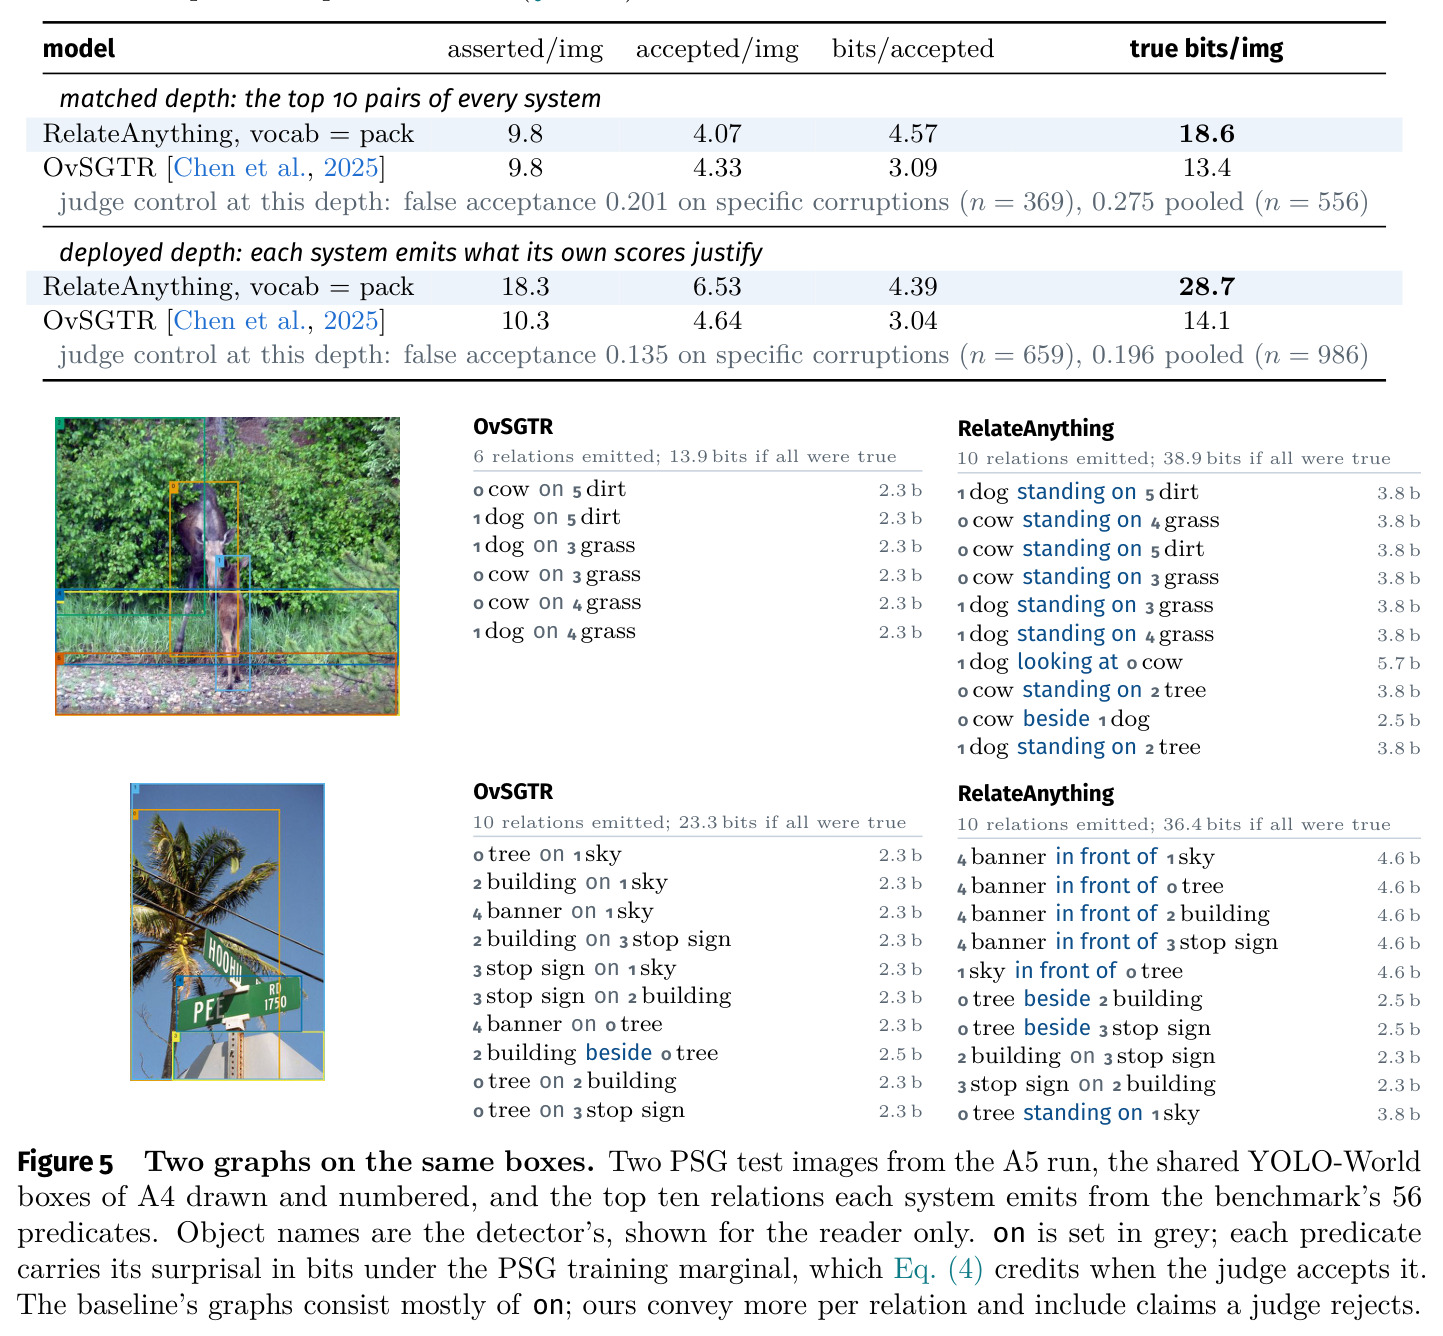
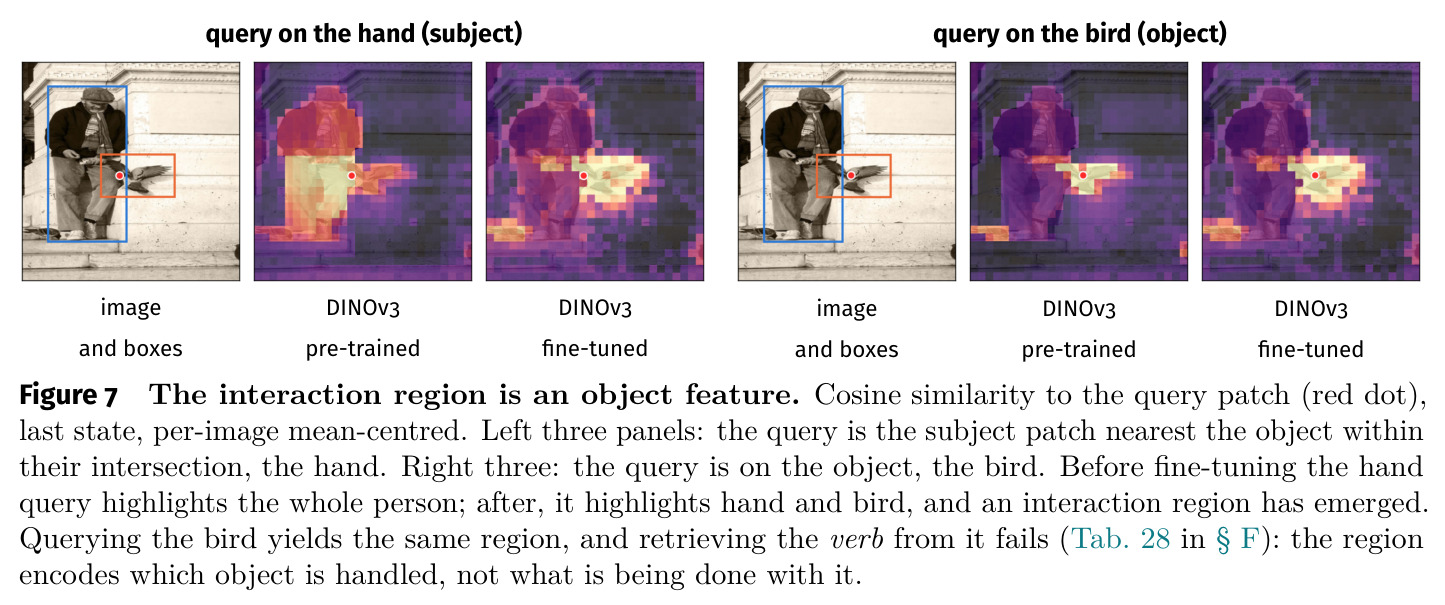
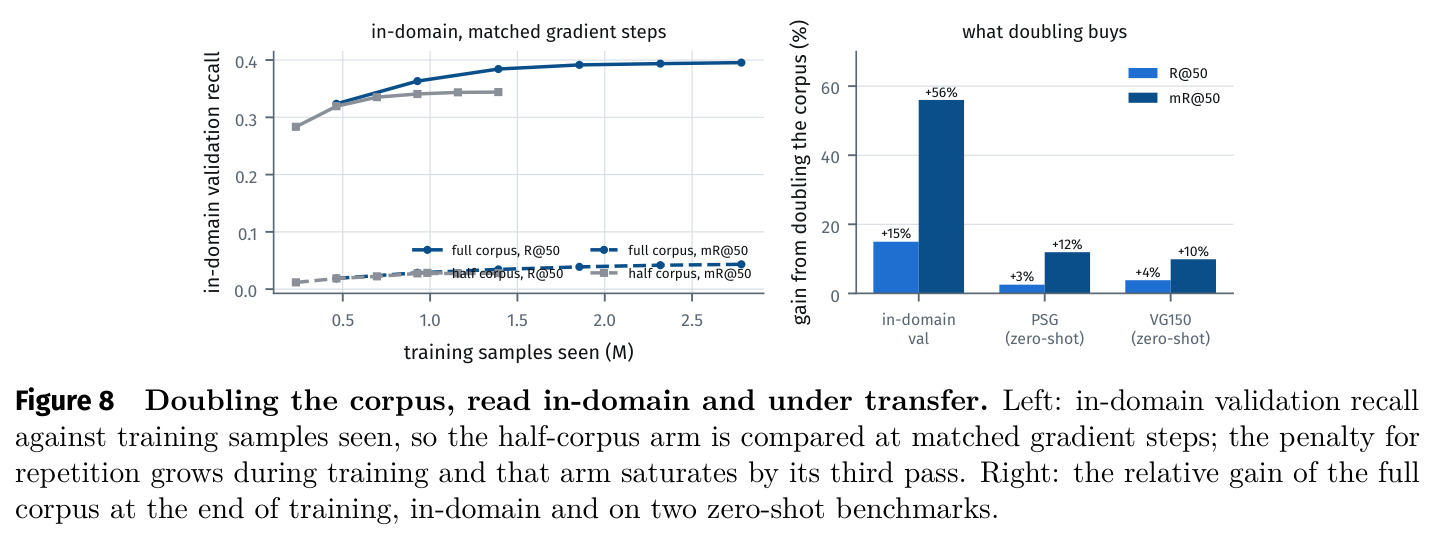
所有实验均为跨数据集(仅 HICO-DET 5% 份额行与三个微调行例外)。(1) A1 迁移(GT 框、图约束):F1@50 在 VG150/PSG/IndoorVG 为 36.9/34.7/37.8,全面超过更强的基线 ROBIN-3B(19.6/27.9/22.7);HICO-DET 上 zero-shot 塔 18.7 对 OvSGTR 7.9;平均召回为基线 2.3–3.5 倍、稀有桶 5–21 倍(VG150 上基线稀有召回恰为 0.0)。(2) A2 显式负例精度(Haystack:2,870 正例对 23,174 个人工裁定负例、26,044 标注格):mean fAP 72.6 对 52.1(+39.2%),稀有 fAP 70.7 对 44.6(+58.6%),P-AUC 93.7 对 83.9;同一组预测若按'未标注即负例'计分 AP 仅 0.035,差异全部来自协议假设。(3) A3 全词表(答案集 withheld):从 19,103 串作答时 VG150 R@50 56.0 反而高于给基准 50 词的 53.3,真实字符串中位排名 1/19,103;matcher 决定 mR 排序——exact 匹配 ROBIN 领先(20.0 对 13.0),$\tau=0.60$ 同义容忍匹配本文领先(31.3 对 25.1)。(4) A4 共享 YOLO-World(配对召回上限 0.696):mR@50 20.5 对 6.2(3.3 倍)、稀有 17.0 对 1.2(14 倍);换真实框后保持率仅 62–63%(PSG)/31–32%(IndoorVG),瓶颈在检测器。(5) A5 判官×信息量:匹配深度 18.6 对 13.4 bits/图、部署深度 28.7 对 14.1;基线接受率略高但 66% 的关系是 on(定价 2.31 bits),整图对比判官反而偏好基线(49/58)。(6) A6 SpatialSense:macro AUC 0.690 对 0.591,九个谓词全胜、基线三个谓词不高于 chance,但两模型都不及不看图的 boxes-only 基线 68.8%。综合 OVS 40.1 对 11.8。(7) 成本:A40 batch-1 端到端 25.0ms/40FPS 对 OvSGTR Swin-T 194ms/5.1FPS(7.8 倍);零样本 F1@K 对闭集实时专家 REACT++(21–23ms)在 VG150 之上。(8) 机制:关系 logit 方差 87–93% 来自对上下文,主体/客体特征仅 0.1%/0.0%;基线 88–90% 输出可被'标签对→最频谓词'查找表复现,本文仅 69–70%;关系微调使类选择性 0.242→0.281 而关系选择性 0.133→0.138 不变,动词检索 0.269 低于 chance 0.424。(9) 域内测量高估迁移增益约 5 倍(语料翻倍域内 mR +56%、迁移 +9.9–11.9%);加入稀疏的 Open Images(4.33 关系/图、25% 份额)在所有轴为负(HICO-DET 尾部 $-40.2$%)——稀疏标注比没有更糟。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨数据集迁移(VG150,GT 框) | F1@50 | 36.9 | 19.6(ROBIN-3B,最强可用基线) | +88.3%(mR@50 28.2 对 15.2,+85%) |
| 跨数据集迁移(PSG,GT 框) | F1@50 / mR@50 | 34.7 / 30.6 | 27.9 / 22.9(ROBIN-3B) | +24.4% / +33.6% |
| 人-物交互(HICO-DET,zero-shot 塔) | F1@50 / mR@50 | 18.7 / 12.7 | 7.9 / 4.5(OvSGTR+MegaSG) | 2.4× / 2.8× |
| 显式负例精度(Haystack) | mean fAP / 稀有 fAP | 72.6 / 70.7 | 52.1 / 44.6(OvSGTR+MegaSG) | +39.2% / +58.6% |
| 全词表开放词汇、答案集 withheld(VG150) | mR@50(19,103 串,同义容忍匹配) | 34.5 | 20.9(ROBIN-3B) | +65%;R@50 56.0 vs 给 50 词的 53.3 |
| 检测模式(PSG,共享 YOLO-World) | mR@50 / 稀有 R@50 | 20.5 / 17.0 | 6.2 / 1.2(OvSGTR+MegaSG) | 3.3× / 14×(配对召回上限 0.696) |
| 无 GT 图质量(VLM 判官×谓词信息量) | 真实 bits/图(匹配深度) | 18.6 | 13.4(OvSGTR+MegaSG) | +38.8%(占标注 27.9 bits 的 0.67 对 0.48) |
| 对抗性空间关系(SpatialSense) | macro AUC | 0.690 | 0.591(OvSGTR+MegaSG) | +9.9 点(chance 0.50,boxes-only 基线 0.688) |
| 六轴综合 | OVS(机会校正轴的调和平均) | 40.1 | 11.8(OvSGTR) | 3.4× |
| 端到端推理(batch-1,A40) | 延迟 / FPS | 25.0 ms / 40 FPS | 194.0 ms / 5.1 FPS(OvSGTR Swin-T) | 7.8× |
局限与改进
作者承认的局限:其一,所有基准的谓词字符串都在训练词表内,真正概念保持的变体只在 OvR-SGG 的 15 个 held-out 谓词上跑过(重训后 Novel R@50 11.8,落后于 MegaSG 预训练与 Swin-B 行,作者明言不做宣称),全四基准的概念 held-out 未运行;其二,若干结论基于单种子,1.3% 噪声底内的差异如实标注;其三,RA-4M 缺少人工抽检的精度估计——几何门只覆盖几何可约束谓词,约 22% 的 looking at/watching 框不相交无法验证,错误实例接地、大框先验标签等会流入语料;其四,解耦结论(关系监督不产生关系特征)仅对本配方成立;其五,A5 的另两个判官裁决(整图对比 49/58、单关系接受率)偏向基线,逐关系精度是真实短板,不能容忍假边的部署应选更短的图;其六,部署损失由检测器召回主导。我的补充观察:A6 上两模型都不及 boxes-only 基线,说明空间投影推理仍接近先验水平,是全文最弱的轴;A4 绝对数字依赖 0.05 置信阈值的选取;A5 依赖单一 VLM 判官且其 corruption 接受率 0.135–0.275 不低;基线消耗物体标签而本文不消耗,虽声明此不对称偏向基线,但两类系统输入信息不同,并非严格同类比较。
独立分析的弱点
独立分析的弱点:(1) 语料精度不可审计——4.3M 机器标注没有人工置信区间,下游模型上限未知,改进方向是分层抽样人工评分并公开错误清单,对 gaze 等不可验证类做专门审计。(2) 空间关系接近先验水平——A6 macro AUC 0.690 不及不看图的 68.8% 基线,从 RGB 学投影几何仍困难,改进方向是引入深度/3D 或多视角线索,或对投影谓词做合成数据增广。(3) 检测器召回是部署瓶颈——GT 框换真实框后保持率仅 31–63%,且更大关系模型无济于事(+114% 参数对综合分 $-0.1$%),改进方向是配对召回感知的框提议或与检测器联合训练。(4) 关系特征缺失——动词检索 0.269 低于 chance 0.424,骨干没有可供检测器共享的关系表示,若要共享骨干需要 patch 级关系目标。(5) A5 方法学脆弱——判官无法感知重复、逐关系打真伪反而偏向 on,改进方向是成对比较加序列级信息量指标、多判官交叉。(6) matcher 敏感性未解决——A3 被排除出综合分正因如此,自由文本到基准词表的映射协议仍需社区共识。(7) 稀疏标注的 PU 阈值由损失函数决定而非数据,接入第三方语料前必须审计其标注密度,否则如 Open Images 实验一样有害。(8) 单种子与单一判官家族,关键结论的稳健性需要多重复验。
未来方向
作者明确提出或暗示的方向:其一,下一最值得改进的组件是检测器而非关系模型——容量阶梯显示配对召回上限主导部署差距,关系感知的检测器或联合优化是自然延伸;其二,跨所有四基准的概念级 held-out 评测变体尚未运行,架构上允许(谓词矩阵从不学习);其三,把推荐报告实践制度化——在每个召回数字旁标注共享三元组质量、声明匹配器与检测器工作点及配对召回上限。基于成果可延伸的:把反义词排斥蒸馏推广到其他依赖文本方向的任务(HOI 检测、visual grounding、VQA);用 RA-4M 训练生成式 VLM 的关系接地而非打分式输出,或两者混合;结合深度估计或 3D 表征攻 A6 的投影推理;20ms 延迟与 CPU 可运行性(fp16 八线程 7 FPS、与 fp32 top-1 一致性 0.955)适合机器人闭环中的实时场景图;六轴协议可移植到 HOI、视频关系检测与具身导航;稀疏标注有害的发现提示可为 PU 折扣建立自动语料质量审计;§7 的探针(类选择性/关系选择性、交互区域检索)可发展为关系预训练的诊断工具集。
复现评估
复现条件在同类工作中属优秀:代码(github.com/Maelic/RelateAnything)、模型权重(HuggingFace collections/maelic/relateanything,含 zero-shot 与 released 两个塔)与数据(huggingface.co/datasets/maelic/RA-4M)全部公开。模型仅 53M 参数、448 输入、bf16,单张 A40 上 20ms/帧,复训与评测的算力门槛低;语料生成仅 104 GPU 小时(Gemma 26B 三遍历加几何门)。附录给出完整超配方(Tab. 14)、PU 折扣拟合、等张回归、文本蒸馏五目标、几何门算法及全部消融;评测器把 OvR-SGG 的十二个已发表数字复现到 0.35 点内,协议可信且可校验。需要注意的难点:A5 需要 VLM 判官的推理预算与控制实验;两塔混合比例与泄漏过滤依赖显式 ID 表和感知近重复检索;容量阶梯、语料翻倍等关键结论为单种子,复现时须留意 1.3% 噪声底;文本编码器若更换教师需重调邻域保持权重。综合评估:数据、代码、权重齐备,入门级 GPU 即可推理,复训约需单卡数天量级,属于高复现性论文。
论文图表
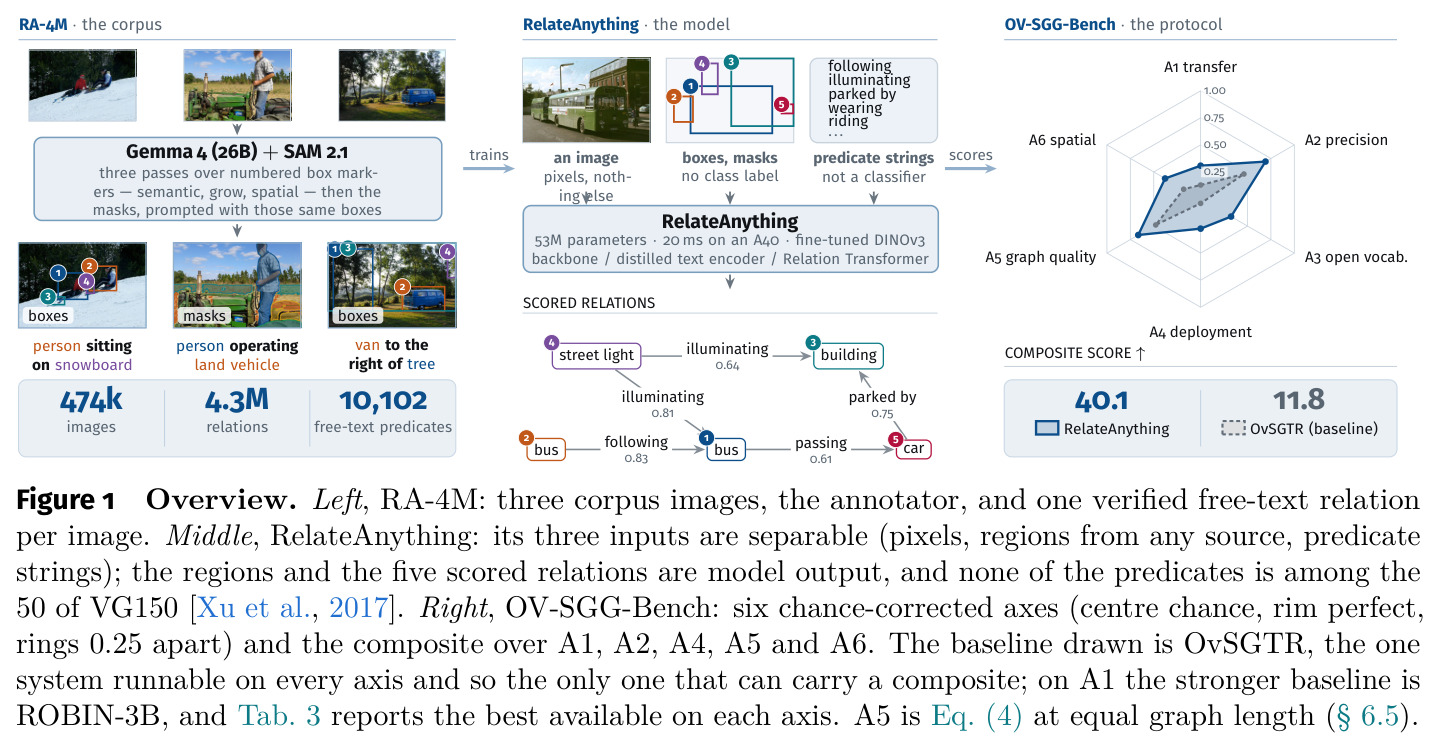
三联总览图。左侧是 RA-4M 语料:474k 图、4.3M 关系、10,102 个自由文本谓词,标注器为 Gemma 26B+SAM 2.1 的三次遍历几何验证流程。中间是 RelateAnything:53M 参数,输入三要素(像素、任意来源的区域、谓词字符串)可分离,20ms/帧,输出打分关系,示例中没有一个谓词属于 VG150 的 50 词。右侧是 OV-SGG-Bench 六轴雷达与综合分:本文 40.1 对基线 OvSGTR 11.8。
一图看懂论文的三大贡献(语料、模型、基准)及其相互关系,是全文的地图;模型'三输入可分离'的接口设计在此最直观。
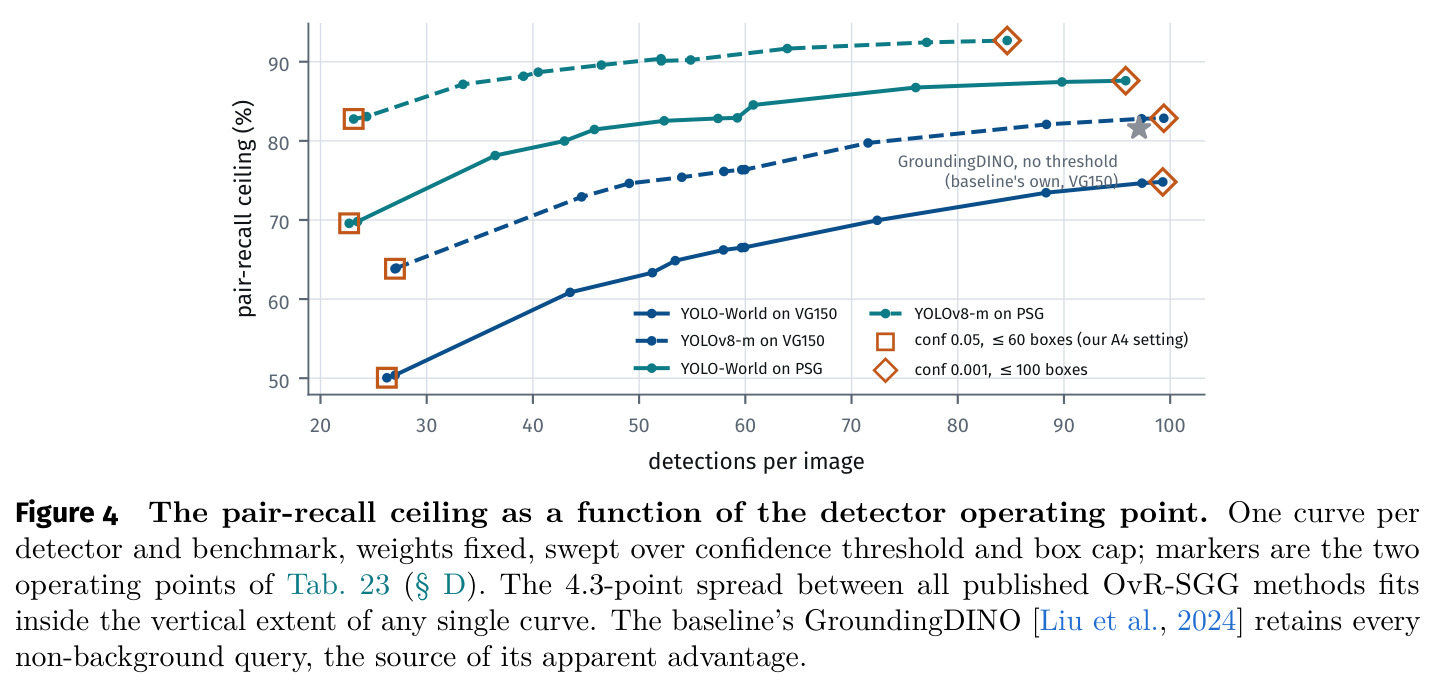
固定检测器权重、只扫置信阈值与框上限时配对召回上限的移动曲线:四个检测器/基准组合上相对移动 12–49%;VG150 上变化 19 点,而 OvR-SGG 排行榜所有已发表方法之间的差距只有 4.3 点——即计分约定的影响超过被测方法间的差异。基线的 GroundingDINO 因不设阈值保留 97 框/图而显得更强,等预算下 YOLO 反超(0.83 对 0.82)。
它是 §5.3 '检测器工作点是被忽略的自由参数'这一发现的关键图,直接支撑 A4 轴'必须报告配对召回上限'的协议设计与所有 SGDet 数字的正确解读。