RTAformer:面向视频场景图生成的关系转变感知Transformer RTAformer: Relation-Transition-Aware Transformer for Video Scene Graph Generation
用相邻帧关系查询差异的校准注入,破解视频场景图生成中的关系语义惯性
前置知识
视频场景图生成(VidSGG)
将视频每帧内容表示为结构化图:节点是检测到的物体(带边界框和类别),边是物体间的关系三元组 ⟨subject, predicate, object⟩,如「person–looking at–cup」。区别于单张图片的场景图生成,VidSGG 要求图随时间演化,既要保持物体身份的连续性(同一个人在相邻帧还是同一个人),又要捕捉关系的动态变化(从 looking at 变成 not looking at)。
本文的全部动机、方法和实验都围绕 VidSGG 展开,理解这个任务的目标(物体定位 + 类别分类 + 关系预测的联合输出)才能理解作者提出的失败模式和解决方案。
DETR 式查询机制与集合预测
DETR 把检测建模为集合预测:用 $N_q$ 个可学习的查询向量,经自注意力(查询间交换信息)和交叉注意力(从图像特征取证据)迭代精炼,再经匈牙利匹配与真值对齐后计算损失。VidSGG 中的一阶段方法(OED、ARN、UNO)沿用此范式,但查询代表的是候选的「主语-宾语交互对」而非单个物体,即三元组查询。
RTAformer 是一个一阶段 set-prediction 框架,其空间解析器的两个级联解码器、时序聚合解码器全部建立在查询机制上;不理解查询就无法理解「关系查询差异」这一核心信号。
关系语义惯性(Relational Semantic Inertia)
本文定义的失败模式:当同一对物体在相邻帧间持续可见、但真实关系已经改变时,模型因时序聚合偏向一致性而沿用上一帧的谓词预测。例如 person–cup 对持续存在,真实关系从 looking at 变为 not looking at,基线模型仍输出 looking at。作者的 OED 复现在关系转变帧子集上 R@10 仅 34.3,比非转变帧的 45.9 低 11.6 个点。
这是论文要解决的核心问题,也是 RTAformer 三个组件(分离流、TADI、SSIA)各自存在的理由,必须先理解这个失败模式才能理解设计动机。
对比学习与 InfoNCE 损失
对比学习通过拉近正样本对、推远负样本对来学习表征。InfoNCE 损失形式为 $\ell(a,b,i)=-\log \frac{\exp(a^\top b/\kappa)}{\sum_{k\neq i}\exp(a^\top z_k/\kappa)}$,其中 $\kappa$ 是温度系数。本文的 SSIA 用对称 InfoNCE 拉齐相邻帧同一索引的实例对查询嵌入,锚点有效性由真值物体持久性(类别一致且 IoU>0.3)筛选。
SSIA 是 RTAformer 训练阶段的正则化组件,直接决定了 TADI 所依赖的「同一索引查询跨帧语义一致」假设能否成立,是复现和改进本文绕不开的知识。
Recall@K 与 mean Recall@K
R@K 是场景图生成的标准指标:排名前 K 的三元组预测中命中真值的比例。mR@K 进一步对每个谓词类别分别计算再取平均,避免高频谓词(如 looking at、above)主导整体指标、掩盖长尾类别表现。SGDET 协议要求模型同时完成物体定位、类别分类和关系预测;With Constraint 限制每对物体只取最高分谓词,No Constraint 允许多谓词。
论文所有实验(主表、消融、转变子集对比)都以 R@K/mR@K 报告,且作者特意在转变/非转变帧子集上拆分对比来验证核心主张,不熟悉这些指标就无法评估证据强度。
研究动机
VidSGG 现有方法普遍通过跨帧聚合来利用时序上下文(STTran 的时序 transformer、OED 对实例和关系查询的跨帧交叉注意力、ARN 的时序特征建模等),但这种对「一致性」的强调恰恰遮蔽了关系的突变。典型场景是:同一对物体(如 person–cup/glass/bottle)在相邻帧持续可见,真实关系却从 looking at 变为 not looking at,而 OED 基线在目标帧仍输出 looking at。作者在 Action Genome 测试集上量化了这一失败:其 OED 复现在关系转变帧子集上 SGDET R@10 只有 34.3,而非转变帧子集为 45.9,差距达 11.6 个百分点(with constraint)。作者将这种模型沿用过期谓词预测的现象命名为关系语义惯性。由于 $35$ 类物体和 $25$ 类谓词中大量关系是长尾类别,惯性还会连带损害类平衡的 mR 指标,影响下游具身导航、视频问答等依赖准确关系演化的应用。
本文的目标是本文的目标是构建一个一阶段 VidSGG 框架,能够区分两种时间尺度完全不同的动态:物体身份的持久性(缓慢、平滑)和谓词的突变(快速、离散)。具体来说,要在不引入外部跟踪器或时序后处理的前提下:(1)用相邻帧关系查询的差异作为显式信号引导谓词更新,而不是任由时序平滑抹平变化;(2)保证这种同索引查询差异是有意义的,即跨帧查询对同一实体对的语义映射保持一致;(3)在整体召回和类平衡召回上超越现有方法,并特别在关系转变帧上取得比非转变帧更大的增益。
与已有工作不同的是,最接近的工作 TR2 虽然也关注时变关系,但其做法是用文本引导监督帧间关系特征差异,并用短时消息 token 调制前帧特征的贡献。本文的独特切入点在于:把相邻帧关系查询差异 $\Delta_q$ 当作谓词更新的直接输入信号,并且在时序聚合之前就完成校准注入,而非事后调制;同时用分离的实例流/关系流来显式解耦实体持久性与关系变化,而现有方法把两者混在同一时序聚合里。此外,作者首次把关系语义惯性作为明确的失败模式提出,并构造了可复用的关系转变帧评测协议(物体 IoU 阈值 0.3 + 谓词集合不相交判据,从 105,356 个持久对邻接中筛出 35,523 个转变,占 33.7%),为后续工作提供了针对性的评估基准。
核心方法
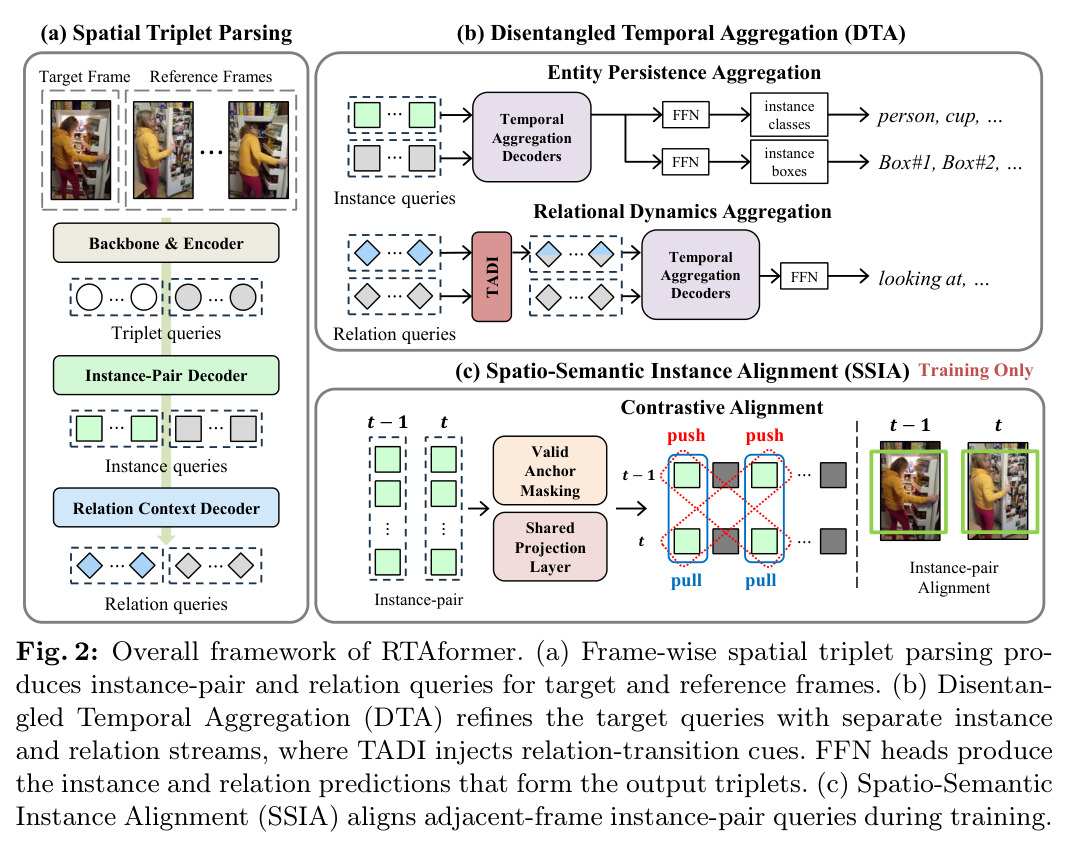
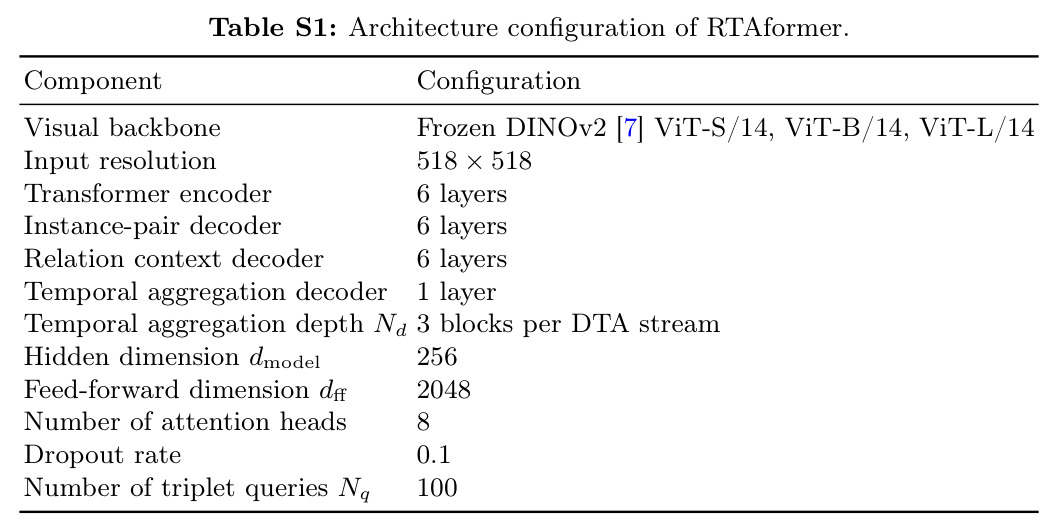
直觉上,RTAformer 把「物体还认识」和「关系要更新」当作两件时间尺度不同的事分开处理:物体身份跨帧稳定,适合平滑的时序聚合;谓词可能突变,需要把相邻帧的变化量显式喂给解码器。技术路线是一个一阶段集合预测框架,含三个组件:(1)逐帧空间三元组解析——冻结的 DINOv2 ViT 骨干加 Transformer 编码器提取每帧特征后,两个级联解码器把 $N_q=100$ 个可学习三元组查询先变成实例对查询 $Q_t^{ins}$,再以其为条件产生关系查询 $Q_t^{rel}$;(2)解耦时序聚合 DTA——目标帧查询在实例流和关系流中分别经过 $N_d=3$ 个时序聚合解码器:实例流按物体置信度选参考查询聚合持久实体证据,关系流先经 TADI 注入相邻帧关系查询差异的校准信号再聚合,每阶段参考查询数按 $K_d=\alpha_d N_{ref}N_q$、$\alpha=(0.8,0.5,0.3)$ 逐级收窄;(3)SSIA——训练时对相邻帧同索引实例对查询施加对比对齐,为 TADI 的同索引差分提供跨帧一致性保障,推理时零开销。
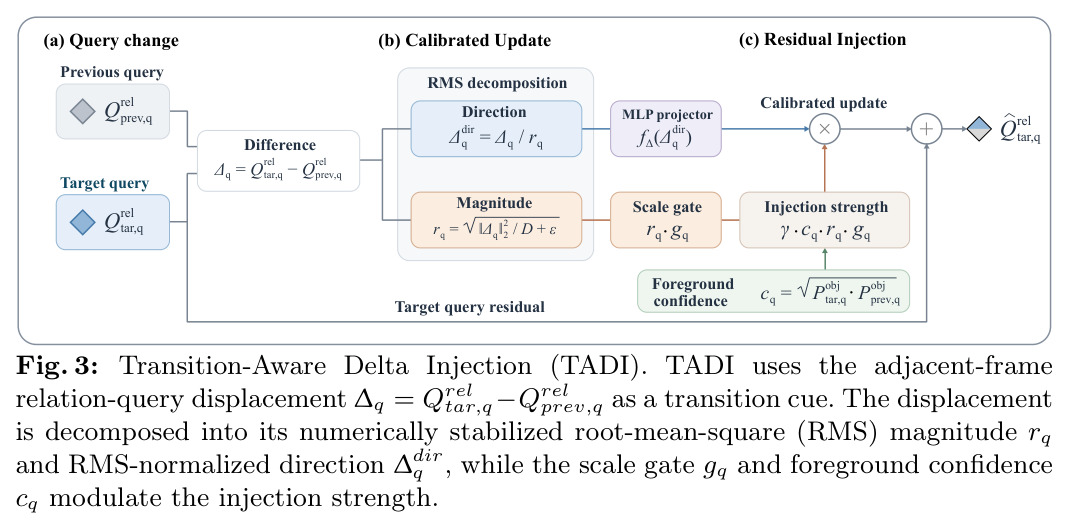
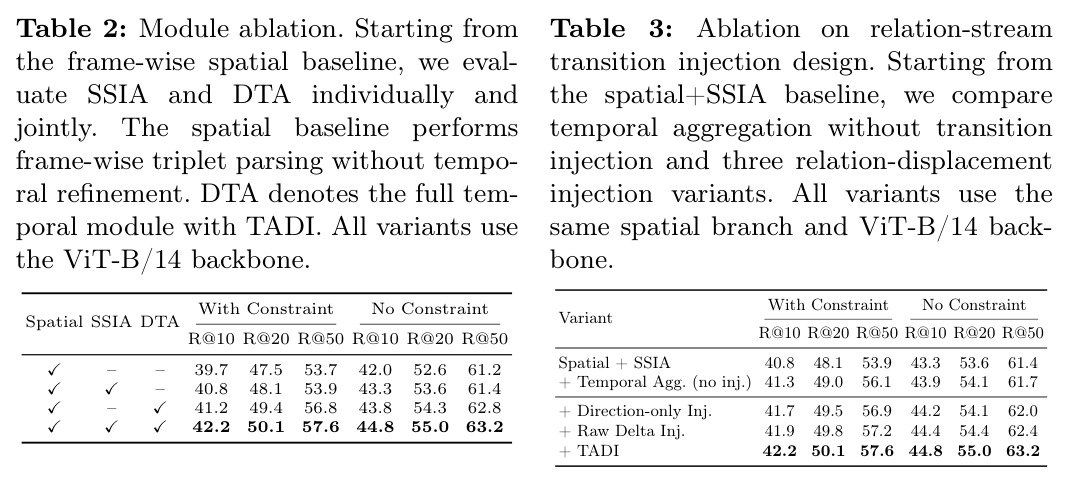
核心创新是 TADI(Transition-Aware Delta Injection):把同索引关系查询在相邻帧间的位移 $\Delta_q = Q_{tar,q}^{rel} - Q_{prev,q}^{rel}$ 视为谓词即将更新的候选线索,但不直接注入原始 $\Delta_q$,而是先做 RMS 分解:数值稳定的幅度 $r_q=\sqrt{\|\Delta_q\|_2^2/D+\epsilon}$ 和归一化方向 $\Delta_q^{dir}=\Delta_q/r_q$,幅度经两层 MLP 预测有界尺度门控 $g_q=1+\tanh(f_g(\log(1+r_q)))$;再用前后帧前景置信度的几何平均 $c_q=\sqrt{P_{tar,q}^{obj}\cdot P_{prev,q}^{obj}}$ 调制,任一侧置信度低就削弱注入。最终更新式为 $\widehat{Q}_{tar,q}^{rel} = Q_{tar,q}^{rel} + \gamma\,c_q\,r_q\,g_q\,f_\Delta(\Delta_q^{dir})$,其中 $f_\Delta$ 是可学习投影器,全局强度 $\gamma=\gamma_{max}\sigma(\rho_\gamma)$ 有上界。与已有方法的本质区别:时序聚合的目的是利用上下文(趋向平滑),而 TADI 的目的是打破平滑(显式注入变化),两者被拆分到关系流的先后两个环节;消融显示完整 TADI(42.2 R@10)优于原始差分注入(41.9)和仅方向注入(41.7),说明简单喂差分并非最优。
方法步骤详情
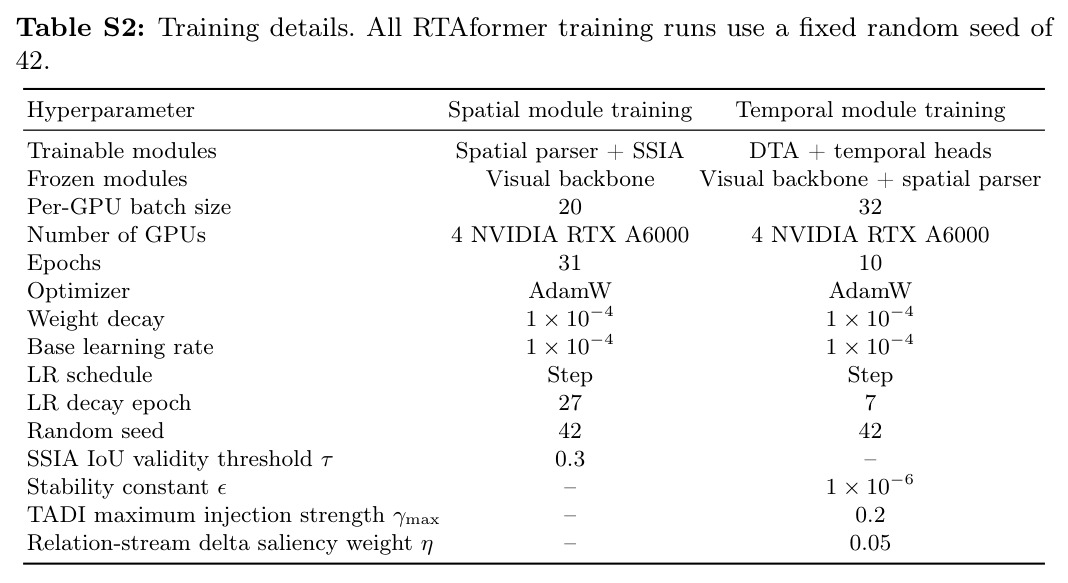
完整流程分四步。第一步,逐帧空间解析:每帧特征 $F_t$ 送入实例对解码器,经查询间自注意力和对 $F_t$ 的交叉注意力把 $Q$ 精炼为 $Q_t^{ins}$;关系上下文解码器以 $Q_t^{ins}$ 为查询输入(关系语义依赖主宾对的身份与空间构型)产生 $Q_t^{rel}$,目标帧和 $N_{ref}$ 个参考帧共用同一解析器。第二步,TADI 注入:对每个查询索引 $q$ 计算目标帧与前一帧关系查询的位移 $\Delta_q$(式 4),分解出幅度 $r_q$ 与方向 $\Delta_q^{dir}$,计算尺度门控 $g_q$(式 5)和前景置信度门控 $c_q$(式 6),按式 7 得到注入后的 $\widehat{Q}_{tar}^{rel}$ 作为关系流初始输入;实例流以原始 $Q_{tar}^{ins}$ 初始化。第三步,双流时序聚合:每阶段对目标查询做自注意力、对流特定得分选出的 Top-$K_d$ 参考查询做交叉注意力再过 FFN。实例流得分用物体分类头的对数置信度(式 3);关系流得分综合物体置信度、谓词置信度(注意力/空间/接触三族最大概率之积)和位移显著性 $\log(1+\eta\bar{a}_{q(j)})$(式 8)。经 3 个阶段得到 $Q_{tar}^{ins,\ast}$ 与 $Q_{tar}^{rel,\ast}$,送入预测头做物体分类、框回归和谓词分类。第四步,两阶段训练:Phase 1 冻结骨干训练空间解析器,损失 $\mathcal{L}_{g1}=\mathcal{L}_{SGG}^{spatial}+\lambda_{ssia}\mathcal{L}_{SSIA}$,其中 SSIA 用匈牙利匹配的 $M$ 个匹配索引、以真值持久性(类别一致且 IoU$>\tau=0.3$)筛选锚点,对 $\ell_2$ 归一化投影嵌入施加对称 InfoNCE($\kappa=0.1$);Phase 2 冻结骨干和空间模块,只在序列级片段上优化 DTA 与时序预测头。推理时一次完成,无外部跟踪器和时序后处理。
技术新颖性
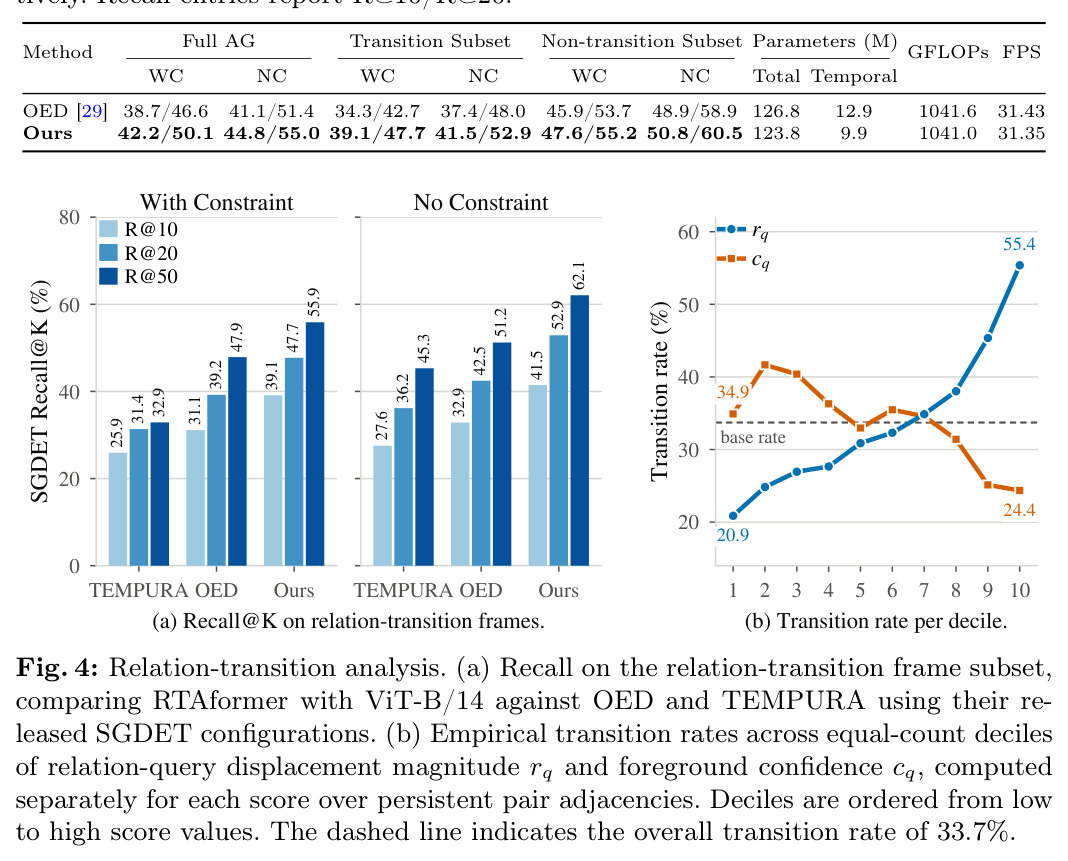
技术上新颖之处有四点。其一,问题层面的概念化:首次把关系语义惯性作为 VidSGG 的明确失败模式提出,并用 11.6 个点的子集差距给出量化证据,这比单纯刷指标更有示范意义。其二,TADI 的校准设计:把位移分解为幅度与方向分别处理(幅度决定注入强度、方向决定更新内容),配合可学习尺度门控、置信度门控和有界全局强度 $\gamma$,消融(Table 3)证明该设计系统性地优于原始差分(41.9 vs 42.2 R@10)和仅方向注入(41.7),说明简单地把差分喂进网络并非最优。其三,SSIA 解决了同索引差分的合法性问题:DETR 式解码并不保证跨帧查询对应同一实体,作者用真值持久性筛选锚点做对比对齐,且只在训练期生效、推理零开销。其四,位移本身就是转变信号的经验发现:$r_q$ 的分位数与真实转变率单调相关(20.9%→55.4%),AUROC 0.621,这为「查询位移携带谓词转变信息」提供了独立于最终指标的因果链证据,也解释了参考查询排序中位移显著性项的设计。相比 UNO/OED/ARN 等把时序上下文作为唯一时序信号的方案,本文引入了第二种正交的时序信号(变化量本身)。
实验结果
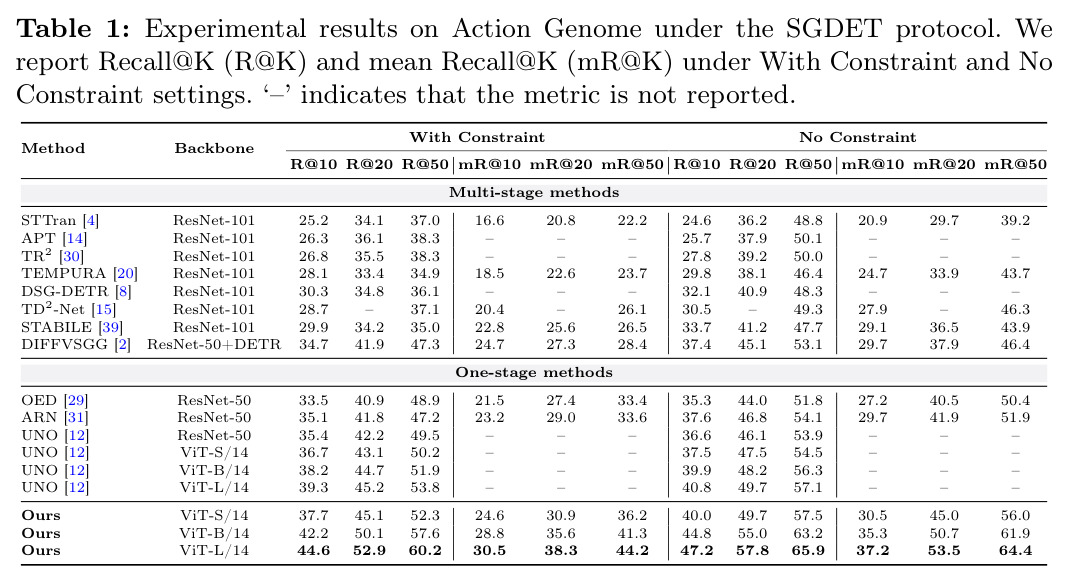
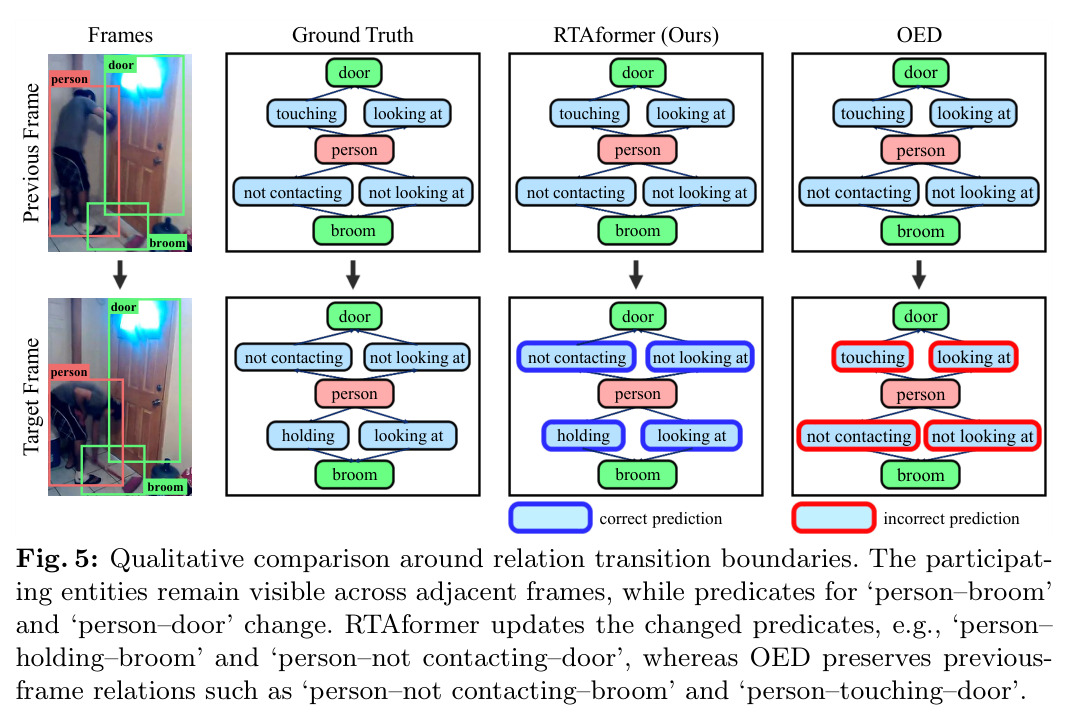
主实验(Table 1,Action Genome SGDET):ViT-L/14 在 With Constraint 下 R@10/20/50 为 44.6/52.9/60.2,No Constraint 下为 47.2/57.8/65.9,均为表中最高;mR@K 达 30.5/38.3/44.2(WC)和 37.2/53.5/64.4(NC),在有报告 mR 的方法中全面领先 ARN(mR@50 WC 33.6)和 DIFFVSGG(28.4)。与同用冻结 DINOv2 骨干的 UNO 受控对比,R@10 提升 5.3(WC)/6.4(NC)个点(ViT-L),且增益随骨干规模扩大(ViT-S 仅 1.0/2.5)。模块消融(Table 2,ViT-B/14):空间基线 39.7 R@10(WC),单独加 SSIA 到 40.8,单独加 DTA 到 41.2,叠加 42.2,说明 SSIA 在有 DTA 时仍有贡献(41.2→42.2)。注入设计消融(Table 3):纯时序聚合 41.3,仅方向注入 41.7,原始差分 41.9,完整 TADI 42.2,校准各环节均有增益。骨干受控对比(Table 4,同 ViT-B/14 重实现 OED):OED 转变子集 R@10 仅 34.3,比非转变子集 45.9 低 11.6 个点;RTAformer 在转变子集提升 4.8 个点(39.1),非转变子集仅提升 1.7(47.6),NC 下为 4.1 vs 1.9;且总参数(123.8M vs 126.8M)与时序模块参数(9.9M vs 12.9M)更少,GFLOPs 与 FPS 基本持平(1041.0 vs 1041.6,31.35 vs 31.43)。机制分析(Fig 4b):对 105,356 个持久对邻接,位移幅度 $r_q$ 从低到高分十档,真实转变率从 20.9% 单调升至 55.4%(总体 33.7%);转变样本平均 $r_q$ 0.396 高于非转变的 0.289,直接用 $r_q$ 当转变分数 AUROC 0.621;对照的置信度 $c_q$ 转变时反而更低(0.517 vs 0.591,AUROC 0.442),支持其作门控而非信号。定性结果(Fig 5):person–broom 从 not contacting 变 holding、person–door 从 touching 变 not contacting 时,OED 沿用旧谓词,RTAformer 正确更新。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Action Genome VidSGG(SGDET,With Constraint) | R@10 | 44.6(ViT-L/14) | UNO 39.3(同骨干 ViT-L/14) | +5.3 个百分点 |
| Action Genome VidSGG(SGDET,No Constraint) | R@10 | 47.2(ViT-L/14) | UNO 40.8(同骨干 ViT-L/14) | +6.4 个百分点 |
| Action Genome VidSGG(SGDET,With Constraint) | mR@50 | 44.2(ViT-L/14) | ARN 33.6(ResNet-50) | +10.6 个百分点(注意骨干不一致,仅供参考) |
| 关系转变帧子集(SGDET R@10,With Constraint,骨干受控 ViT-B/14) | R@10 | 39.1 | OED 复现 34.3 | +4.8 个百分点(非转变子集仅 +1.7) |
| 位移幅度作为转变分数(105,356 持久对邻接) | AUROC | 0.621(无需训练分类器) | 随机 0.5;置信度 $c_q$ 反向仅 0.442 | 验证查询位移携带转变信息 |
局限与改进
作者明确承认两点:DETR 式解码不保证同索引查询跨帧精确对应同一实体对,SSIA 只是软性鼓励一致性,TADI 的差分信号因此可能有表征漂移残留;评测仅覆盖 Action Genome 的 SGDET 协议,未在其它 VidSGG 数据集或协议(如 PredCLS、SGGDET)上验证泛化性。我补充几点观察:一是位移信号的判别力有限,AUROC 0.621 意味着近四成的转变无法仅凭 $r_q$ 区分,TADI 更多是提供可用线索而非可靠探测器;二是转变子集的构造依赖谓词集合「不相交」这一严格判据,部分重叠的关系变化(如同时保持部分谓词)被排除,实际惯性问题可能更广;三是 mR@K 对比中多数基线(UNO、DSG-DETR、APT、TR2)未报告 mR,与 DIFFVSGG 的对比还存在骨干不一致;四是 $\Delta_q$ 只取前一帧,对持续数帧的关系渐变或快速抖动场景缺乏建模;五是用真值物体持久性构造 SSIA 锚点在训练可行,但也意味着对标注框质量有依赖。
独立分析的弱点
第一,同索引对应假设脆弱:DETR 集合预测的查询没有固有的跨帧身份,若 SSIA 对齐失败(如密集遮挡后重现),$\Delta_q$ 可能是两个不同实体对查询之差,注入的是噪声而非转变线索。改进方向是引入查询级软匹配(基于框 IoU 或查询相似度重排参考帧查询索引),或在 TADI 中改用跨索引注意力。第二,单帧差分视野太窄:只用 $t-1$ 与 $t$,无法区分瞬时抖动与持续转变,易被检测噪声触发假阳性注入,可引入多窗口差分或对 $r_q$ 做时间平滑。第三,计算开销不低:即便骨干冻结,总 GFLOPs 约 1041,需 4 张 RTX A6000 训练,两阶段调度加上 $\lambda_{SSIA}$、$\eta$、$\gamma_{max}$ 等超参也增加工程负担;可探索蒸馏到 ResNet-50 规模、或验证 DTA 作为可插拔模块向其它 VidSGG 框架迁移。第四,评测协议单一:只测 Action Genome 的 SGDET,未覆盖 PredCLS/SGGDET 等协议,与 DIFFVSGG(ResNet-50+DETR 达 34.7 R@10)的对比还存在输入分辨率差异。第五,长尾问题未被 TADI 直接处理:惯性失败可能集中于低频谓词(模型对 not contacting 等负向谓词记忆更弱),应分析 TADI 增益的谓词类别分布,并与 TEMPURA 式记忆去偏等正交方法组合。
未来方向
作者指出的方向:把「对关系变化的响应度」作为与整体精度并列的评测维度,将转变子集协议推广为社区标准;在更多数据集和协议上验证。基于本文成果可延伸的方向:一是把 $r_q$ 显式用于推理期决策——例如高位移时抑制上一帧谓词先验、低位移时加强平滑,形成自适应的时序先验调度;二是研究查询级跟踪与 TADI 的结合,让查询本身携带身份(借鉴 TrackFormer/MOTR 的查询传播),从根上解决同索引对应问题;三是把关系转变检测作为独立头输出置信度,服务下游具身规划中的「关系失效检测」;四是扩展到开放词汇谓词和长视频流式场景(滑窗 DTA + 增量 SSIA);五是与文本引导的 TR2 思路融合——用 $\Delta_q^{dir}$ 与文本嵌入对齐,验证位移方向是否蕴含可解释的语义变化方向;六是在 mR 长尾维度上验证 TADI 是否主要帮助了低频谓词的更新,若成立可与去偏损失正交叠加。
复现评估
复现条件较好但有门槛。有利因素:代码已开源(github.com/sejong-rcv/RTAformer);Action Genome 公开(234,253 帧标注、35 物体类、25 谓词类);骨干用冻结的 DINOv2 ViT-S/B/L(无需训练骨干);论文给出关键超参——$N_q=100$、编码器与两个解码器各 6 层、双流各 3 个时序聚合解码器、$\alpha=(0.8,0.5,0.3)$、SSIA 的 $\kappa=0.1$、$\tau=0.3$、$\lambda_{SSIA}=0.1$、AdamW、4×RTX A6000。不利因素:AG 数据预处理(帧采样、框与关系标注对齐)历来繁琐,常需参考 STTran/OED 的脚本;复现 Table 4 的公平对比需自行把 OED 换成 DINOv2 骨干(作者的重实现版未必随代码发布);训练约需 4 张 48GB 级 GPU,ViT-L 变体显存压力更大;转变子集构造细节(IoU 0.3、谓词集合不相交判据)描述清晰,但评测脚本是否随代码发布需确认。总体评估:中等偏高难度,熟悉 DETR 类代码库的团队预计一到两周可跑通主结果。
论文图表
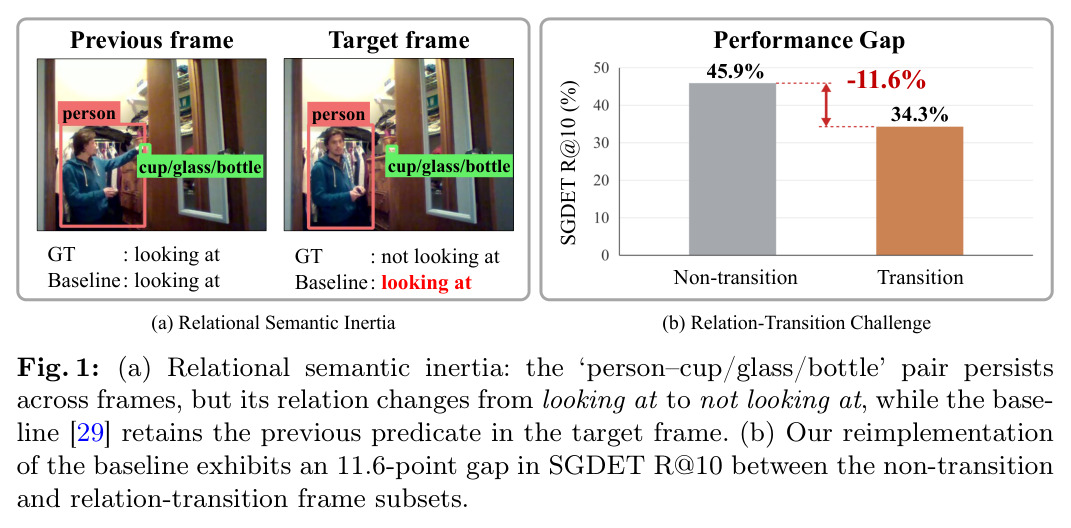
左半部分是一个具体失败案例:前帧与目标帧中 person 和 cup 持续可见,真值关系从 looking at 变为 not looking at,基线模型却沿用 looking at;右半部分是柱状图,显示 OED 复现在非转变帧子集 R@10 为 45.9%,转变帧子集仅 34.3%,差距 11.6 个百分点。
这张图同时给出了问题的直观案例和量化证据,是理解「关系语义惯性」这一核心概念和全文动机的入口,11.6 个点的子集差距也是后文所有实验的对照起点。