面向事件预测的语言模型与外部先验能力门控池化 Competence-Gated Pooling of Language Models and Priors for Event Forecasting
按域从已解决结果估计源权重,判定语言模型何时能改进市场等外部预测
前置知识
Brier 分数
概率预测的标准评分:$B(q)=\mathbb{E}[(q-y)^2]$,其中 $q$ 是预测概率、$y\in\{0,1\}$ 是真实结果,数值越低越好。它同时惩罚过度自信与欠自信,是严格合适的评分规则。论文所有理论推导(最优权重、组合价值、路由恒等式)都在 Brier 损失下进行,主结果如 0.0771→0.0732 也以它为单位。
读懂"何时模型分歧有价值"的推导和所有实验表格都必须以 Brier 分数为基准,否则无法判断 0.0039 这类增益的意义。
仿射池化与预测组合
把外部预测 $g$ 与模型预测 $f$ 线性组合:$h_\lambda=g+\lambda(f-g)$,$\lambda=0$ 表示完全信外部,$\lambda=1$ 表示完全信模型,负权重则作为纠错项。Bates-Granger (1969) 的经典结论是最优线性组合可优于任一单独预测,这是本文两源分析和全局基线的数学基础。
本文的能力门控本质上是把全局仿射池化按域细化,最优权重 $\lambda_k^\star=-\mathbb{E}_k[de]/A_k$ 的闭式解直接来自这一框架。
相对能力(relative competence)
本文核心概念:模型的价值不是独立准确率,而是相对某个已有外部预测(市场、群体或统计预测)的边际增益。形式化为组合价值 $\Delta_{pool}^k=B_k(g)-\min_\lambda B_k(h_\lambda)=\mathbb{E}_k[de]^2/A_k$,其中 $d=f-g$ 是分歧、$e=g-y$ 是外部误差,只有分歧与外部误差相关时增益才为正。
整篇论文的问题定义、门控设计和弃答实验都围绕这一概念展开,不理解它就无法理解为何模型的口头置信度在论文中"失灵"。
收缩估计(shrinkage)
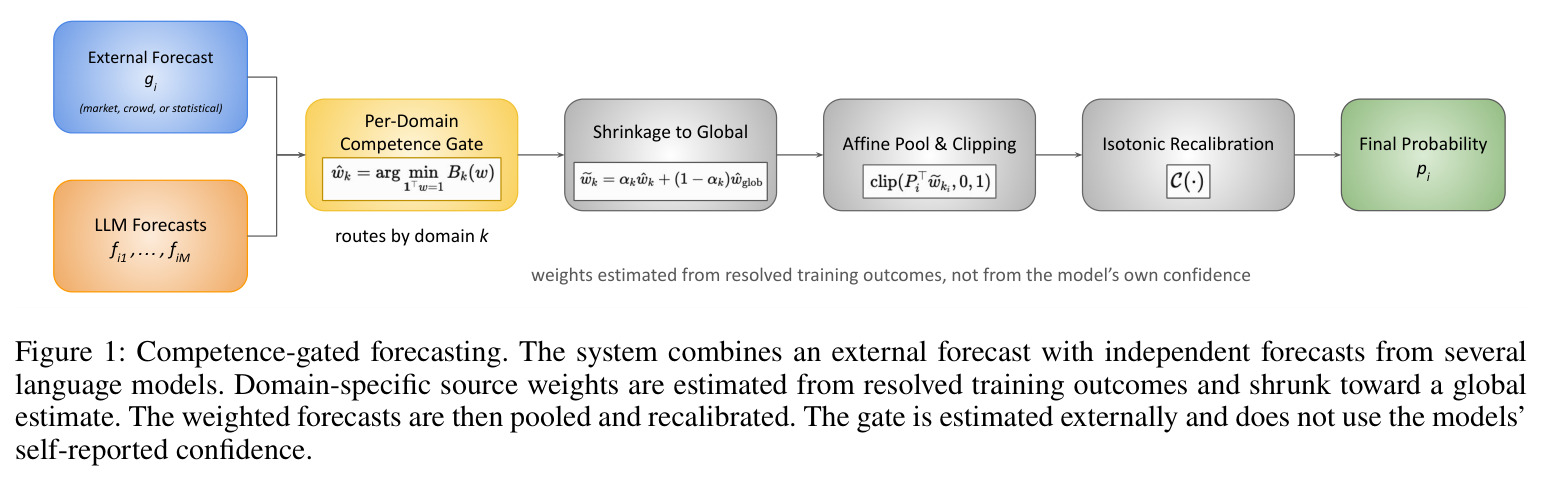
小样本下直接估计每个域的参数方差很大,收缩估计把域级估计 $\hat{w}_k$ 向全局估计 $\hat{w}_{glob}$ 拉近:$\tilde{w}_k=\alpha_k\hat{w}_k+(1-\alpha_k)\hat{w}_{glob}$,其中 $\alpha_k=n_k/(n_k+\tau)$,样本越少越贴近全局。本文用内层验证折按 Brier 分数选择收缩强度 $\tau$。
论文八个来源中 ACLED、Wikipedia、DBnomics 等结构化域样本很小,收缩是门控在这些域上稳定不崩的关键设计。
等渗回归校准
非参数单调校准方法:在保序(单调不减)约束下最小化平方误差,把任意分数映射为校准后的概率,源自 Zadrozny-Elkan (2002)。本文对所有校准类方法(含 logistic 堆叠基线)统一使用同一等渗再校准协议,保证比较公平。
门控输出要经 $\hat{p}_i=C(\mathrm{clip}(P_i^\top\tilde{w}_{k_i},0,1))$ 再校准才进入评测,理解这一步才能分清池化与校准各自的贡献。
ForecastBench 与数据泄漏控制
ForecastBench 是动态更新的 LLM 预测能力基准(Karger 等 2025),按预测日快照保存市场/群体概率。LLM 预训练语料可能包含已解决事件的结果,造成泄漏;常用对策包括只评解决日晚于训练截止时间的题目(本文泄漏控制子集 2,103 题)和 question-only、无检索的设置。
本文结论的可信度建立在泄漏控制上,主结果正是在解决日不早于 2025-06-01 的泄漏控制子集上以 p=0.006 得到复现的。
研究动机
在真实部署的预测系统中,语言模型很少是唯一的概率来源:系统往往已经持有预测市场(Polymarket、Manifold)、群体智慧(Metaculus、INFER)或统计模型给出的外部预测。此时真正要回答的不是"模型独立预测准不准",而是"在已有外部预测的前提下,模型还值不值得用"。现有 LLM 预测研究(如 Halawi 等 2024 的检索增强方法、ForecastBench 基准)主要度量独立准确率,live 基准还显示主流模型仍落后专家群体;口头置信度研究(Xiong 等 2024)针对的是模型对自身答案的绝对不确定性,而非相对某个外部来源的比较性判断。作者在 ForecastBench 上构造了 2,357 道已解决二选题、八个来源、正例率仅 18.5% 的评测池,指出独立准确率既不能回答何时该替换外部预测,也不能回答何时该把模型与它池化使用——一个模型可能独立表现很差,但其分歧恰好纠正了外部来源的错误。
本文的目标是本文的目标是把"混合系统要不要用语言模型"形式化为相对能力问题并给出可操作的解法。具体包括三件事:第一,在 Brier 损失下推导模型分歧改进外部预测的精确条件,即组合价值 $\Delta_{pool}^k=\mathbb{E}_k[de]^2/A_k$,并给出域级路由相对全局池化的增益恒等式(Theorem 1);第二,构造能力门控——按域从已解决结果估计源权重、向全局权重收缩、对池化结果等渗再校准——在 2,357 道题、五个语言模型(Qwen2.5-7B/14B/32B、Qwen3-8B、Gemini-2.5-flash)上验证它显著优于全局组合;第三,检验口头置信度能否识别"模型优于外部预测"的题目,并对比基于结果估计的能力信号在弃答/选择性预测中的表现。
与已有工作不同的是,已有文献分头处理这个问题:经典预测组合(Bates-Granger 1969、Granger-Ramanathan 1984)给出线性池化,局部预测池、贝叶斯预测合成等允许上下文相关权重,但都不针对"混合系统必须估计模型相对已有外部来源的边际价值"这一比较目标;LLM 混合预测系统则通常只报告平均提升,不回答何时该用。本文的独特切入有三点:把问题定义为相对能力并推导出分歧何时有用的闭式条件与路由恒等式,使增益从经验观察变成可计算判据;给出每个域一个闭式、可解释的源权重向量,而非黑箱堆叠;评测设计刻意保守——模型只看题目(question-only、无检索、看不到外部概率以免复制),结构化先验只在训练折内构造,并额外做泄漏控制子集、官方 live-market 子集与 ARIMA 泄漏安全先验三重检验,把相对能力与搜索质量、数据污染分离开。
核心方法
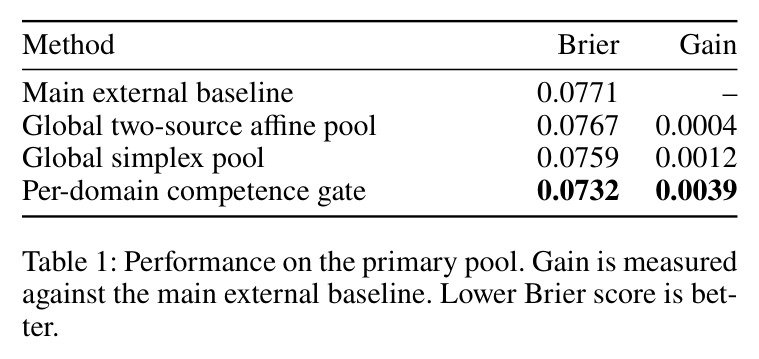
直觉上,模型只有在"它的分歧恰好指向外部来源犯错"时才有组合价值;分歧若与外部误差无关,池化只会注入噪声。技术上先在两源设定下做精确二次分解:对仿射池 $h_\lambda=g+\lambda(f-g)$,记分歧 $d=f-g$、外部误差 $e=g-y$、$A_k=\mathbb{E}_k[d^2]$,则域内最优权重 $\lambda_k^\star=-\mathbb{E}_k[de]/A_k$,组合价值 $\Delta_{pool}^k=\mathbb{E}_k[de]^2/A_k$;再由风险的二次展开得到 Theorem 1:路由相对全局权重的增益为 $\sum_k\pi_kA_k(\lambda_k^\star-\lambda^\star_{glob})^2$。随后扩展为多源能力门控:按域用带单纯形约束的岭回归从已解决结果估计源权重,向全局权重收缩,再做等渗再校准。在 2,357 题五折交叉验证下,门控把主外部基线从 0.0771 降到 0.0732 Brier。
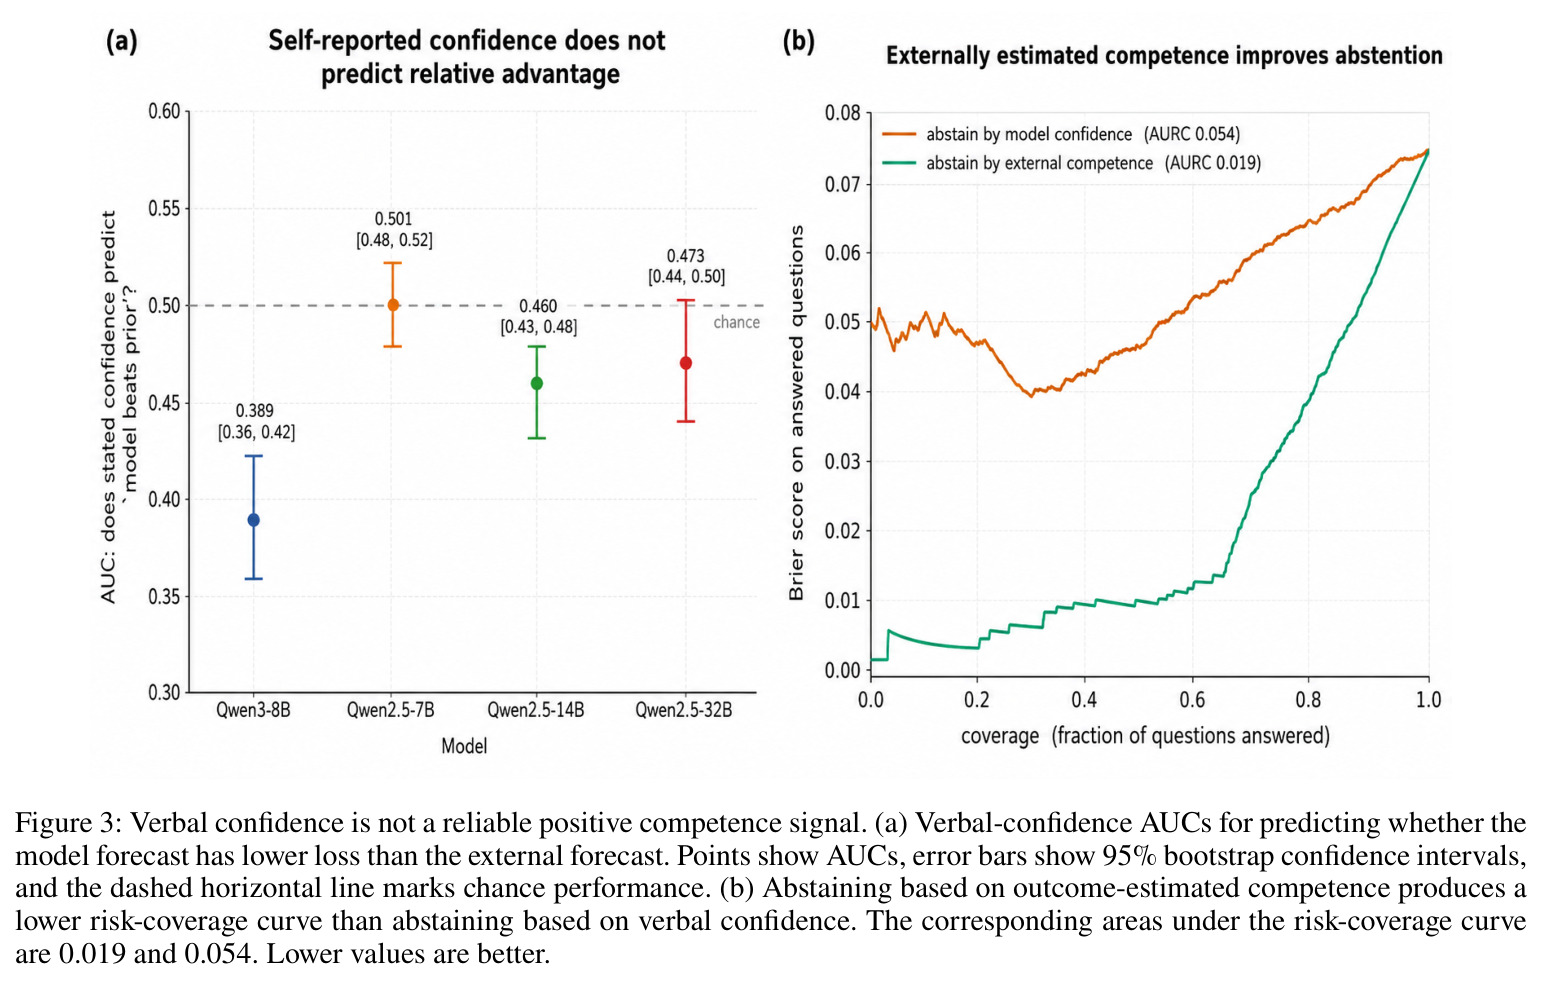
核心创新是把"要不要用模型"从准确性问题改写成比较性、可分解的统计量:模型带来的组合增益等于 $\mathbb{E}_k[de]^2/A_k$,即模型分歧与外部来源误差的协相关的平方除以分歧方差——分歧本身不产生价值,只有与外部错误对齐的分歧才有价值。这与两处已有做法有本质区别。其一,与传统全局线性池化相比,Theorem 1 给出路由增益的精确恒等式 $\sum_k\pi_kA_k(\lambda_k^\star-\lambda^\star_{glob})^2$,它预测增益只在各域偏好不同权重时出现,且论文实测训练折预测值 0.0035 与相对单纯形池的实现增益 0.0027 量级一致,理论与实测闭环。其二,与口头置信度路线相比,门控权重完全从已解决结果外部估计,不用模型自我报告——因为实验证明 4 个 Qwen 模型的口头置信度 AUC 仅 0.389–0.501,无法可靠识别相对优势;"对自己的答案有信心"与"比市场更可靠"是两种不同的置信。语言模型也不观察外部概率,避免复制带来的信息损失。
方法步骤详情
第一步,数据准备:从 ForecastBench 取 2,357 道已解决二选题,来源含 Polymarket、Manifold 两个市场、Metaculus、INFER 两个群体及 FRED、ACLED 等结构化数据共八个,保留预测日真实概率;172 道结构化题仅用训练折结果率构造先验,正例率 18.5%。第二步,域级权重估计:在单纯形约束下最小化预测平方误差加 $\rho\|w\|_2^2$ 正则,得域级 $\hat{w}_k$,另估全局 $\hat{w}_{glob}$,负权重作为纠错项保留。第三步,收缩:$\tilde{w}_k=\alpha_k\hat{w}_k+(1-\alpha_k)\hat{w}_{glob}$,$\alpha_k=n_k/(n_k+\tau)$,$\tau$ 内层验证折选出,小域自动贴近全局。第四步,池化与再校准:对 held-out 题输出 $\hat{p}_i=C(\mathrm{clip}(P_i^\top\tilde{w}_{k_i},0,1))$。第五步,五折交叉验证加配对 bootstrap 双侧 p 值评估,辅以时间切分等鲁棒性检查。
技术新颖性
技术新颖性体现在四点。一是闭式可解释性:岭回归加单纯形约束有解析解,每个域得到一个源权重向量,能直接读出语言模型与外部来源各自的话语权,这是黑箱域感知 logistic 堆叠(本文实测 0.0740)不具备的。二是理论-实测闭环:Theorem 1 的路由恒等式给出增益的先验预测,论文验证训练折权重算出的路由项 0.0035 与相对全局单纯形池的 held-out 实现增益 0.0027 量级吻合,把"何时路由有用"变成可计算判据而非经验观察。三是信息隔离设计:语言模型不观察外部概率、不做检索,从源头避免复制外部预测;作者还专门做了把外部概率展示给模型的消融,证明这会增加抄袭并降低门控可用的独立信息。四是与部署决策对齐:门控同时给出池化权重与按域能力估计,天然支持弃答与选择性预测,实测按结果估计能力弃答的风险-覆盖曲线 AUC 从口头置信度的 0.054 降到 0.019。相比之下,SOTA 上下文堆叠只提供精度,不提供权重解释与路由分解。
实验结果
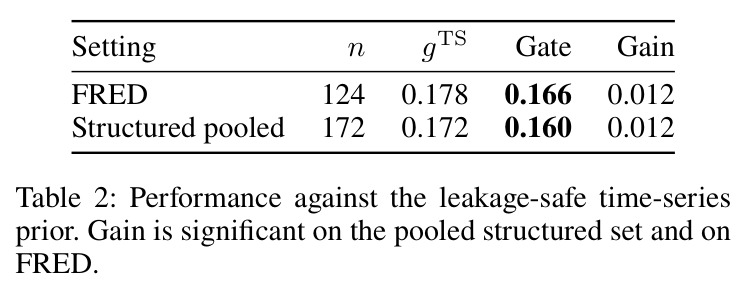
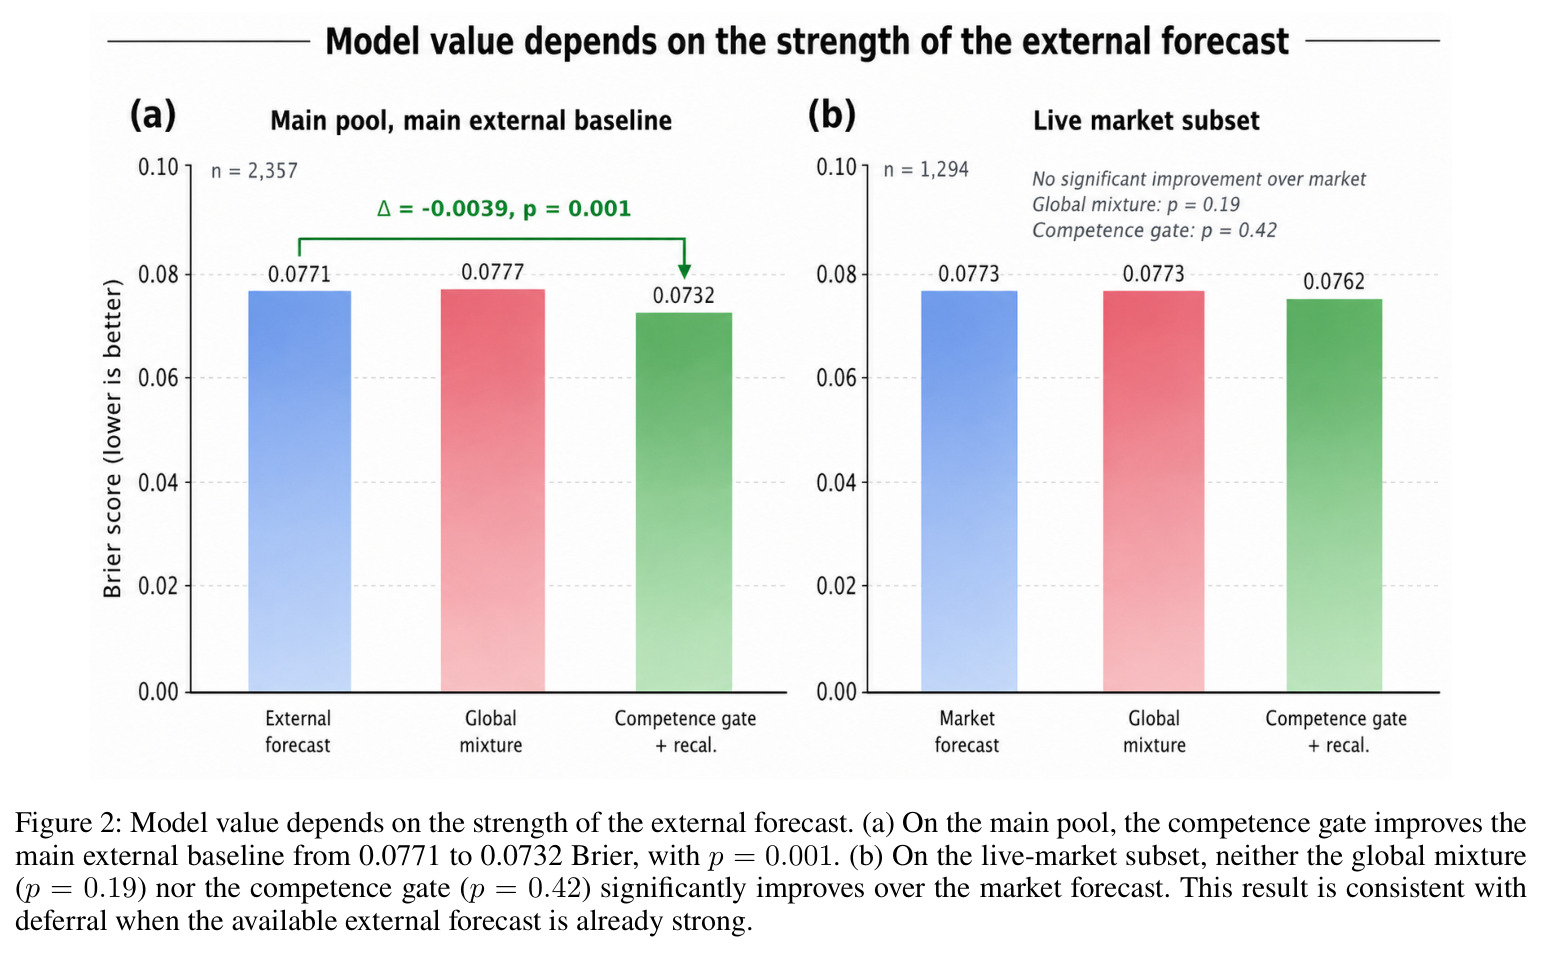
主池(2,357 题):主外部基线 Brier 0.0771;全局仿射池 0.0767(p=0.39 不显著);全局单纯形池 0.0759(p=0.08);域级能力门控 0.0732,相对基线增益 0.0039(p=0.001)、相对单纯形池 0.0027(p=0.010)——收益来自按域路由而非池化本身。live-market 子集(1,294 题)上门控 p=0.42 不显著,基本让位于市场。泄漏控制子集(2,103 题)基线 0.0805、门控 0.0767(p=0.006)。结构化数据:172 题合并集 ARIMA 先验 0.172、门控 0.160,增益 0.012(95% CI [0.003,0.021],p=0.014);FRED 124 题 0.178→0.166(p=0.041)。自评实验:4 个 Qwen 口头置信度 AUC 仅 0.389–0.501,Qwen3-8B 为 0.389;其 sharpness AUC 0.559、采样一致性 0.566 也偏弱;按结果估计能力弃答的风险-覆盖 AUC 0.019,远优于口头置信度的 0.054。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 主池混合预测(2,357 题八来源) | Brier 分数 | 0.0732(域级能力门控) | 0.0771(主外部基线);全局单纯形池 0.0759 | 相对基线 -0.0039(p=0.001),相对单纯形池 -0.0027(p=0.010) |
| 泄漏控制子集(2,103 题,解决日 ≥ 2025-06-01) | Brier 分数 | 0.0767 | 0.0805(主外部基线) | -0.0038(p=0.006,显著) |
| 结构化合并集(172 题) | Brier 分数 | 0.160 | 0.172(ARIMA 泄漏安全时间序列先验 gTS) | -0.012(95% CI [0.003,0.021],p=0.014) |
| FRED 经济数据题(124 题) | Brier 分数 | 0.166 | 0.178(gTS 时间序列先验) | -0.012(p=0.041) |
| 官方 ForecastBench live-market 子集(1,294 题) | Brier 分数显著性 | 无显著改进,门控基本让位于市场 | 真实市场概率 | 无(门控 p=0.42,全局混合 p=0.19) |
| 弃答/选择性预测(按能力排序逐渐弃答) | 风险-覆盖曲线 AUC(越低越好) | 0.019(结果估计能力) | 0.054(口头置信度) | -0.035 |
| 相对优势识别(模型是否优于外部预测) | AUC | 0.389–0.501(口头置信度,不可靠) | 0.5(随机水平) | 无正向信号;结果估计能力配合弃答显著更优 |
局限与改进
作者承认的局限:门控只用了来源域这一粗糙的"状态标签",题目级的期限、分歧幅度、群体离散度、市场流动性等特征可支持更细路由;主池来自人工策划的 ForecastBench,ACLED、Wikipedia、DBnomics 样本太小无法单独给出显著性结论;时间序列分析依赖序列匹配、历史数据 vintage 和 ARIMA 的高斯预测假设;历史评测无法根除训练数据污染,泄漏控制子集只能缓解;实验未建模延迟、token 用量与 API 成本;门控需要已解决结果,向未见域迁移的能力未验证,保守做法是初始贴近外部来源、积累证据后再加权。我的补充观察:自评结论只覆盖 4 个 Qwen 模型加 Gemini-2.5-flash 共五个模型,且 sharpness/一致性只测了 Qwen3-8B,不能外推为全模型家族规律;正例率仅 18.5%,Brier 分数天然偏低,跨数据集比较需谨慎;负权重虽提升精度(非负单纯形版 0.0748)但"信任"解释力打折;门控收益绝对量约 0.004 Brier,实际部署价值取决于相对其工程与推断成本的权衡。
独立分析的弱点
第一,冷启动与迁移问题:门控权重必须从已解决结果中学出,新领域或市场结构漂移时无从下手,作者的"初始贴近外部来源"只是保守策略而非解决方案,可引入层级贝叶斯先验或跨域元学习来共享能力估计。第二,域标签粗糙:用来源当域把同一市场内差异巨大的题目混在一起,而实测把分组打乱或随机化会使增益缩水十倍以上,说明收益高度依赖分组质量,值得探索基于期限、分歧、流动性的题目级特征路由。第三,自评信号测得太浅:只测了口头置信度、预测 sharpness 与采样一致性,未测 logit 熵、hidden-state 探针等内部信号,"模型不知道自己相对更强"的结论因此偏强,需要同一目标下的系统对比。第四,评估维度单一:Brier 受基率影响(正例率 18.5%),未报告按期限、按域的完整收益分解,也没有 token 成本与延迟维度的收益-成本曲线,而 selective use 的卖点恰恰是成本感知路由,这块证据缺失。第五,单预测日快照的概率输入使结论对数据管道细节(历史 vintage)敏感。
未来方向
作者明确提出的方向:把能力估计细化到题目级,引入期限、分歧幅度、群体离散度、先验不确定性、市场流动性等特征做更细路由;在同一比较目标上系统评估基于结果的能力信号与模型内部不确定性信号;做前瞻性在线评估而非历史回测,彻底排除污染。基于成果可延伸的方向:其一,把路由恒等式 $\sum_k\pi_kA_k(\lambda_k^\star-\lambda^\star_{glob})^2$ 用作在线监控指标,滚动估计 $\mathbb{E}[de]^2/A_k$ 以检测模型相对价值的漂移并触发重训;其二,把门控与 learning to defer 框架(Mozannar-Sontag 2020)结合,统一处理模型间选择、工具选择与人类判断选择;其三,引入成本感知目标,在 Brier 增益上扣除 token 与延迟成本做联合优化,产出显式的"何时调用模型"决策阈值;其四,用内部表征探针替代口头置信度检验更强自评信号是否存在;其五,在 FRED 之外扩充结构化数据源规模,弥补 ACLED、Wikipedia、DBnomics 统计功效不足的问题。
复现评估
复现难度中等偏低。数据基础是公开的 ForecastBench(Karger 等 2025),作者给出严格筛选规则(二选结果、预测日有来源值、正期限、解决日不早于 2025-01-01、去重、剔除答案出现在题面中的题目),主池 2,357 题、结构化 172 题、live-market 1,294 题、正例率 18.5% 均可核对。模型侧 4 个 Qwen(Qwen2.5-7B/14B/32B、Qwen3-8B)为开源权重,用 vLLM 0.25.1、bfloat16、温度 0,在最多 4 张 A100-80GB 上推理;Gemini-2.5-flash 需 Google API。门控、等渗校准、五折交叉验证与 bootstrap 全在 AMD EPYC 7763 CPU 上离线运行,计算量很小,重头成本只在 LLM 推理缓存。超参数、硬件与结构化先验构造细节在补充材料中,但正文未明说代码是否开源;ARIMA 先验依赖历史数据 vintage 的获取与序列匹配,是复现中最不确定、最费工的环节。
论文图表