火灾不可逆损伤后的目标理解特征恢复 Feature Recovery for Object Understanding After Irreversible Fire Damage
提出TRACE火灾损伤基准与即插即用FRM模块,将受损特征映射回完好对齐表征以识别烧毁物体。
前置知识
冻结宿主与即插即用模块
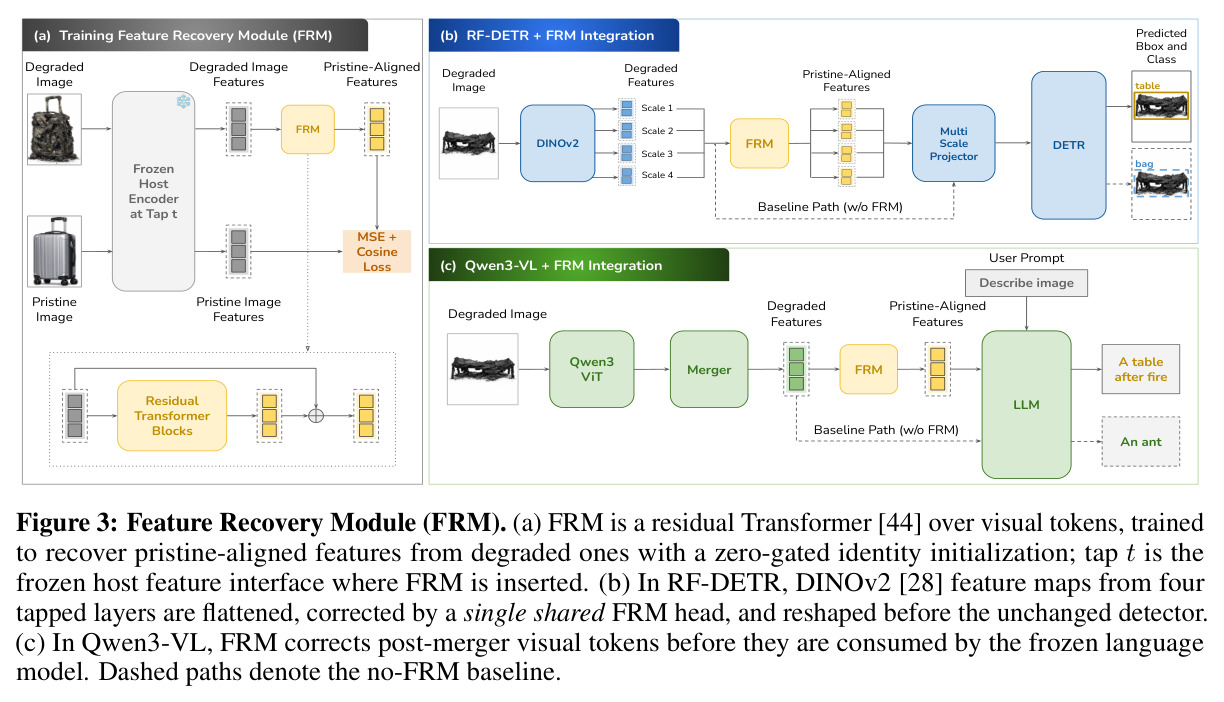
指把预训练模型(检测器、CLIP/SigLIP编码器、VLM)的全部权重冻结不动,只在其内部某个特征接口处插入一个小的可训练模块。这样宿主在训练时见到的特征分布不被破坏,部署时只需替换特征路径,推理代码完全不变。本文的FRM就是这类模块:训练时只有FRM的参数更新,编码器、投影器、检测头和语言模型全部冻结。
FRM的核心卖点就是宿主冻结下的特征校正,理解'改特征不改权重'与'微调'的区别是读懂本文方法定位和实验设计(如FRM能叠加在微调之上)的前提。
特征tap点
tap point指在冻结网络中选定的一个可读写的中间特征接口:从此处读出特征张量、施加校正后再写回原管线。tap越靠前空间分辨率越高、越保留局部细节;越靠后(尤其post-projector/post-merger等LLM-facing接口)特征越接近下游头实际消费的空间,校正越能直接转化为任务性能。本文用 $\mathcal{E}_t(x)\in\mathbb{R}^{N_t\times D_t}$ 表示tap $t$ 处的特征。
tap点选择是FRM的关键消融:Qwen3-VL post-merger比pre-merger的检索R@1从72.90提升到85.28,理解tap的权衡才能看懂第4节和Table 9。
零初始化残差门控
残差Transformer的每个块写成 $u_m=\hat{u}_m+\alpha_m^{mlp}\odot\mathrm{MLP}(\mathrm{LN}(\hat{u}_m))$,其中逐通道门控 $\alpha_m^{attn},\alpha_m^{mlp}\in\mathbb{R}^D$ 初始化为全零,因此初始时修正量 $\Delta_\theta(z)=0$,整个模块严格等于恒等映射,训练从宿主原有行为平滑出发,类似ReZero/零初始化注意力门控的技巧。
这解释了FRM为何稳定易训且不破坏宿主原有性能(检测任务上完好图像mAP几乎无损),是理解其架构设计动机的关键。
CLIP/SigLIP特征空间与画廊检索
CLIP和SigLIP是图文对比预训练的视觉编码器,其图像嵌入可用于以图搜图的检索任务。画廊检索(gallery retrieval)指以退化物体图像为查询,在候选完好图像库中按特征余弦相似度排序,用Recall@1/R@5衡量是否找回配对的完好参照。特征恢复则用MSE和token级余弦相似度度量恢复后的特征与完好目标特征的接近程度。
本文五个任务中有两个(特征恢复、画廊检索)直接建立在这些度量上,且用CLIP/SigLIP实验证明'火灾退化造成特征流形上的结构化位移'这一核心论点。
域适应、测试时适应与图像修复
域适应(DA)通过协方差匹配、伪标签或原型对齐把源域特征对齐到目标域分布;测试时适应(TTA)在部署时用无标注测试数据做伪监督在线调整模型;图像修复(restoration)如Restormer、WildIR在像素空间从退化观测恢复高质量图像。三者与本文设置的区别在于:火灾退化让每级严重度各自成分布、像素级逆问题病态(烧掉的部分无法唯一还原)、且部署时未必能做在线优化。
论文Related Work和实验基线(SFA、DATR、Restormer、WildIR)全部围绕这三类范式,理解它们各自失效的原因才能明白FRM'配对监督+特征空间校正'的切入点为何有效。
研究动机
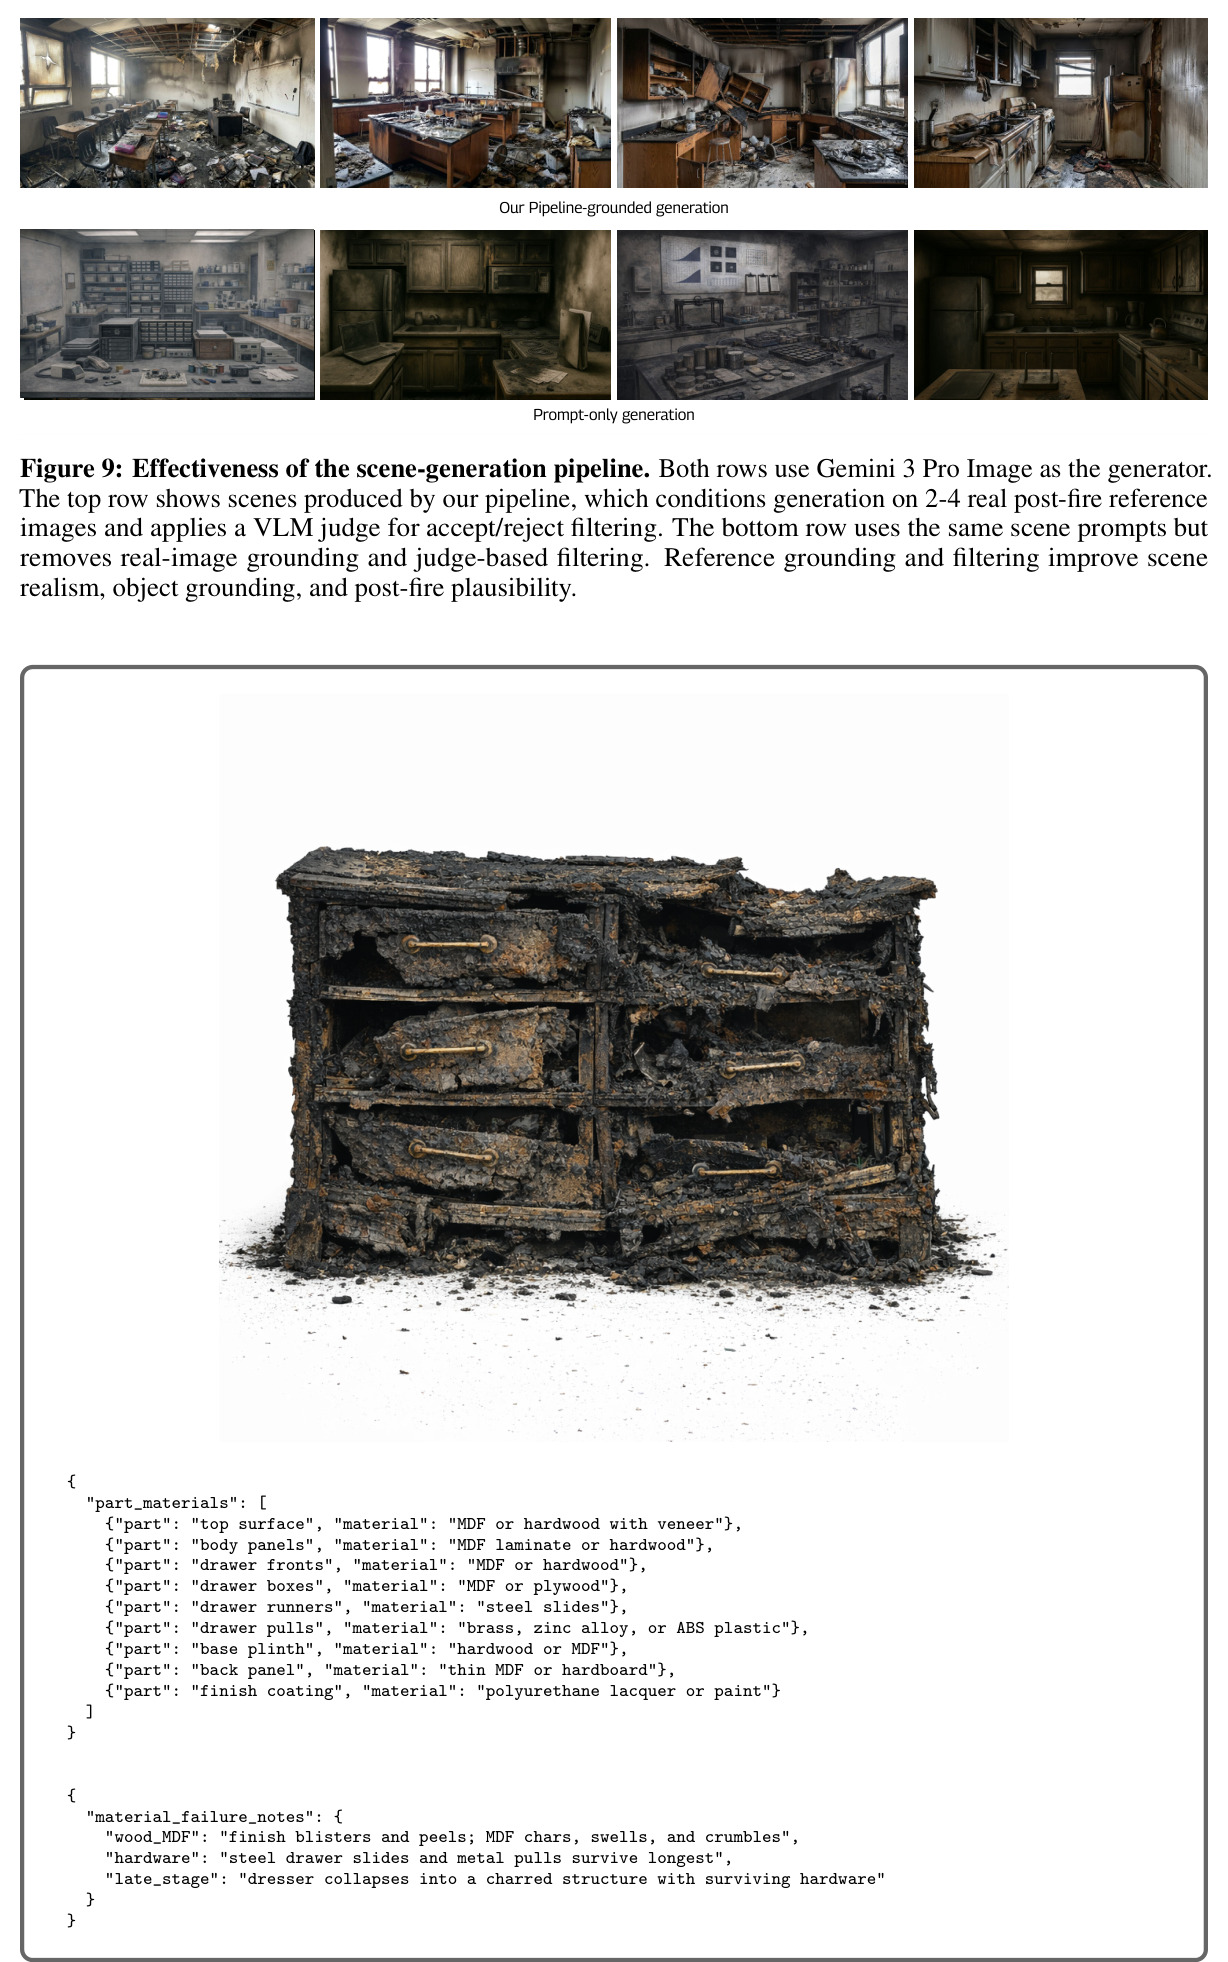
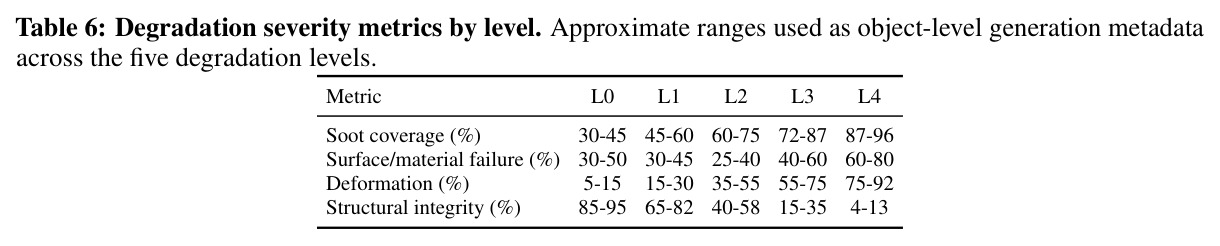
现实火灾后环境中,物体经历不可逆的物理转变:木材碳化、塑料熔化变形、金属氧化、玻璃热震碎裂,几何形状、材料状态与表面外观同时改变。这与经典图像退化(噪声、模糊、天气)有本质区别——后者只扰动像素外观,物体本身完好且可恢复。作者实测发现现有模型在这种退化下集体失效:从最轻(L0)到最重(L4)退化,RF-DETR检测mAP相对下降71%,且在IoU≥0.5下定位正确的框中有92.9%被分错类别;VLM同样崩溃,InternVL3.5的退化到完好检索R@1从93.85跌至28.11,Qwen2.5-VL从76.92跌至32.31。而现有数据资源完全覆盖不了这个场景:标准检测基准(COCO等)以完好物体为主,鲁棒性测试套件只在外观上扰动而保持几何脚手架和材质身份不变,自然灾害数据集又停留在航拍/社交媒体的建筑或场景级损伤评估。但消防员需要在废墟中定位气雾罐、燃气罐等危险品,调查人员要重建起火前室内物品清单,保险定损员要凭残骸清点财产——这些都要求模型能从烧毁残骸推理出'它烧毁前是什么'。
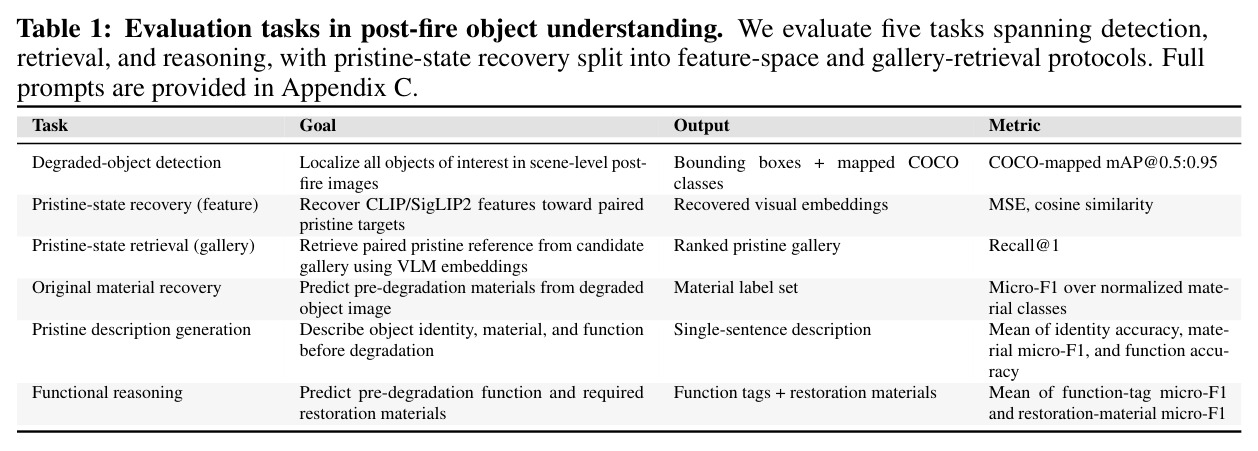
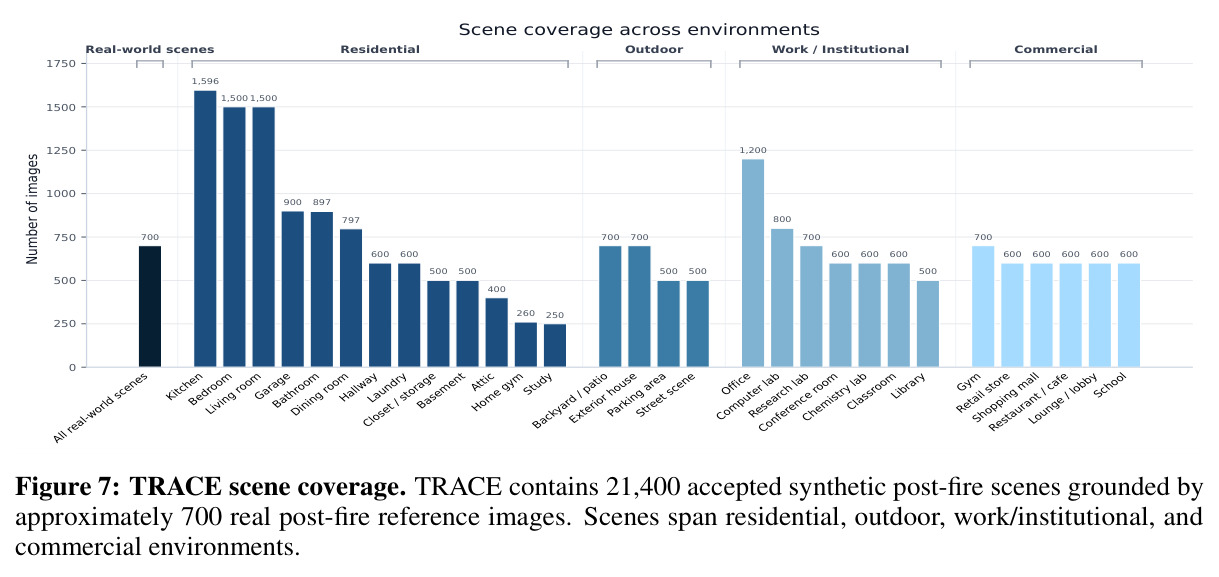
本文的目标是本文要同时解决基准和方法两个层面的问题。基准层面,构建首个面向物体级不可逆物理退化的基准TRACE:提供21.4K张以真实火灾图像为参照的合成火后场景(含边界框、材质标签、退化描述),以及499个物体身份、189个物体类型的配对完好到退化轨迹(每条1张完好图+5级渐进退化图,共2,994张物体图,另有500张真实火灾裁剪用于测试),并定义五个覆盖定位与退化前理解的任务——退化目标检测、完好状态特征恢复与画廊检索、原始材质恢复、完好描述生成、功能推理。方法层面,设计一个轻量、即插即用的特征恢复模块FRM:在冻结宿主全部权重的前提下,把退化特征映射到与配对完好特征对齐的表征,使检测器、CLIP/SigLIP编码器和五个VLM在全部任务上获得随严重程度放大的提升。
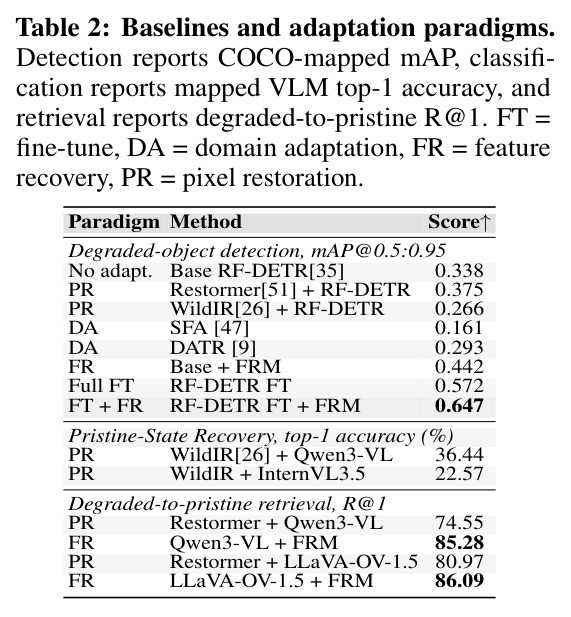
与已有工作不同的是,本文有三个独特切入角度。第一,把'退化'从外观扰动重新定义为物体本身的物理转变,并强调配对监督的价值:每个物体同时拥有完好与退化观测及实例级对应关系,使研究者能直接测量表征漂移本身,而不只是在偏移分布上测端到端精度;这是TRACE与所有鲁棒性基准的根本区别。第二,与自然的像素级修复路线相反,作者论证严重物理退化使像素级逆问题天然病态——被烧毁的部件和材料线索在图像中已不存在、无法从像素唯一还原,Restormer即便用TRACE配对数据微调后作为预处理也只带来有限增益,因此应转向特征空间修复:直接在宿主自己的表征空间内把退化特征拉回完好特征位置,复用预训练模型已编码的语义知识。第三,与域适应和测试时适应不同,FRM只需在配对数据上训练一次、部署时零优化开销,且监督信号是实例级配对对应而非聚合分布统计——实验证明统计式域适应(SFA 0.161、DATR 0.293 mAP)反而低于冻结基线0.338,印证了这一区分的必要性。
核心方法
直觉上,火灾改变的是物体本身,但预训练编码器早已学过完好物体的语义表征;退化图像的特征只是在这个表征空间里'被推移'了,如果能学一个小映射把退化特征推回原位,冻结的下游模型就能照常工作。技术路线如下:对任意冻结视觉编码器 $\mathcal{E}$,选定特征接口tap点 $t$,退化图像 $x^\ell_i$(退化级别 $\ell\in\{0,...,4\}$)与配对完好图像 $x^p_i$ 在同一tap处分别产生特征 $\mathcal{E}_t(x^\ell_i)$ 与 $\mathcal{E}_t(x^p_i)$。FRM学习一个形状保持的函数 $h_\theta(z)=z+\Delta_\theta(z)$,目标是 $\tilde{z}^{\ell,i}_t=h_\theta(\mathcal{E}_t(x^\ell_i))\approx\mathcal{E}_t(x^p_i)$,校正后的特征送入完全不变的下游管线。训练目标只依赖配对特征,损失为MSE加token级余弦对齐:$$\mathcal{L}_{FRM}(\tilde{z},z^p)=\tfrac{1}{BND}\|\tilde{z}-z^p\|_2^2+\lambda_{cos}\tfrac{1}{BN}\sum_{b,n}\left(1-\cos(\tilde{z}_{b,n},z^p_{b,n})\right)$$ 其中 $\lambda_{cos}=0.1$ 由验证集选出;MSE约束token幅度,余弦项惩罚方向漂移。所有宿主权重全程冻结,完好分支不回传梯度。
核心创新是'特征空间修复+零初始化残差+宿主全冻结'的组合,与已有方法的本质区别有三。与微调不同,FRM从不改动编码器权重,因此保留宿主训练时的特征分布;且实验显示二者修复的失败模式不同——微调RF-DETR到0.572 mAP后,FRM还能再加13.1%到0.647,说明微调拓宽了编码器输入分布,而FRM纠正的是微调后仍残留的特征错位。与像素修复不同,FRM在特征流形上做校正,回避了物理退化下像素逆问题的病态性(烧掉的部分无法唯一还原)。与域适应不同,FRM用实例级配对对应关系而非分布统计做监督。架构上最关键的设计是零门控初始化:每个残差Transformer块的MSA和MLP输出都乘以逐通道可学习门控 $\alpha^{attn}_m,\alpha^{mlp}_m\in\mathbb{R}^D$,初始化为零,故初始时 $\Delta_\theta(z)=0$、FRM严格等于恒等映射,训练从宿主原行为平滑出发。另一个重要发现是tap点应选在越靠近下游消费端越好:Qwen3-VL post-merger比pre-merger高12.4点R@1(85.28 vs 72.90),InternVL3.5 post-projector比pre-projector高11.1点(74.92 vs 63.84)——校正应该发生在下游头真正消费的那份特征上。
方法步骤详情
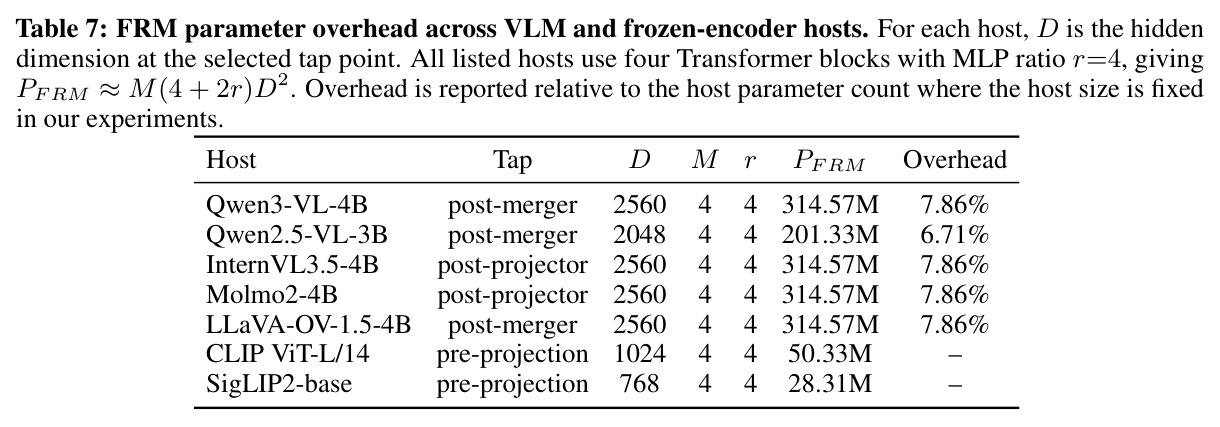
完整流程分四步。第一步,数据准备:TRACE物体级提供499条轨迹(1张完好图+L0到L4五级退化图),按物体身份80/10/10划分保证同一身份不跨集;训练每宿主只需约2,000配对样本,空间增广仅限保持patch网格对应的变换(水平翻转、90度旋转、步长对齐缩放),同一变换同时施加于配对两侧,禁止任意偏移裁剪以免破坏token对应。第二步,选tap点并抽取特征:VLM选post-merger/post-projector的LLM-facing接口(如Qwen3-VL在448×448输入、patch 16下得到196个token、$D=2560$);RF-DETR在DINOv2编码器第 $s\in\{3,6,9,12\}$ 层抽四个36×36网格($z_s\in\mathbb{R}^{B\times384\times36\times36}$),展平为 $u_s\in\mathbb{R}^{B\times1296\times384}$ 后共用同一个FRM头校正再重塑回去,损失对四尺度独立计算取平均。第三步,训练FRM:VLM默认 $M=4$ 块、8头注意力、MLP比率 $r=4$(检测器 $M=1$),优化MSE+0.1×余弦损失;完好特征可一次性缓存复用,单卡A100缓存模式下约1小时收敛、在线前向约3小时。第四步,部署推理:FRM插在训练好的tap处,冻结编码器产出退化特征,FRM校正为完好对齐特征,其余管线一字不改。参数开销为 $P_{FRM}\approx M(4+2r)D^2$,可按预算 $M(4+2r)\le\varepsilon P_{host}/D^2$ 选容量:RF-DETR-Medium用1.77M参数(占33.7M的5.25%),Qwen3-VL-4B用314.57M参数(占4.0B的7.86%)。
技术新颖性
技术新颖性体现在三个层面。问题定义新:TRACE是首个物体级不可逆物理退化且带配对完好-退化轨迹的基准,此前的鲁棒性工作都默认物体本身完好、可从观测恢复,而TRACE要求模型推理'这个东西烧毁前是什么、由什么制成、有什么功能',这是一个全新的监督信号形态(退化前的反事实状态)。方法定位新:FRM是训练一次、跨数据即插的残差特征校正器,同时区别于三类最近邻方法——域适应需要对齐一个连贯目标分布(而每级退化各自诱导不同分布)、测试时适应需要部署时在无配对数据上做伪监督优化、图像修复在像素空间解病态逆问题且误差会向下游识别器传播;FRM只用配对特征、宿主全冻结、一次训练部署时零额外优化。架构极简且可预算控制:形状保持的token级残差校正,不改任何宿主结构或推理代码,参数量随宿主维度平方增长且有闭式上界公式,可以按部署开销预算 ε 反推容量配置(块数M、MLP比率r)。消融进一步证明设计的必要性:去掉余弦项的LN-MSE会让检索掉到57.83(低于无FRM基线74.55),单用MSE为83.17,MSE+0.1余弦最优85.28。
实验结果
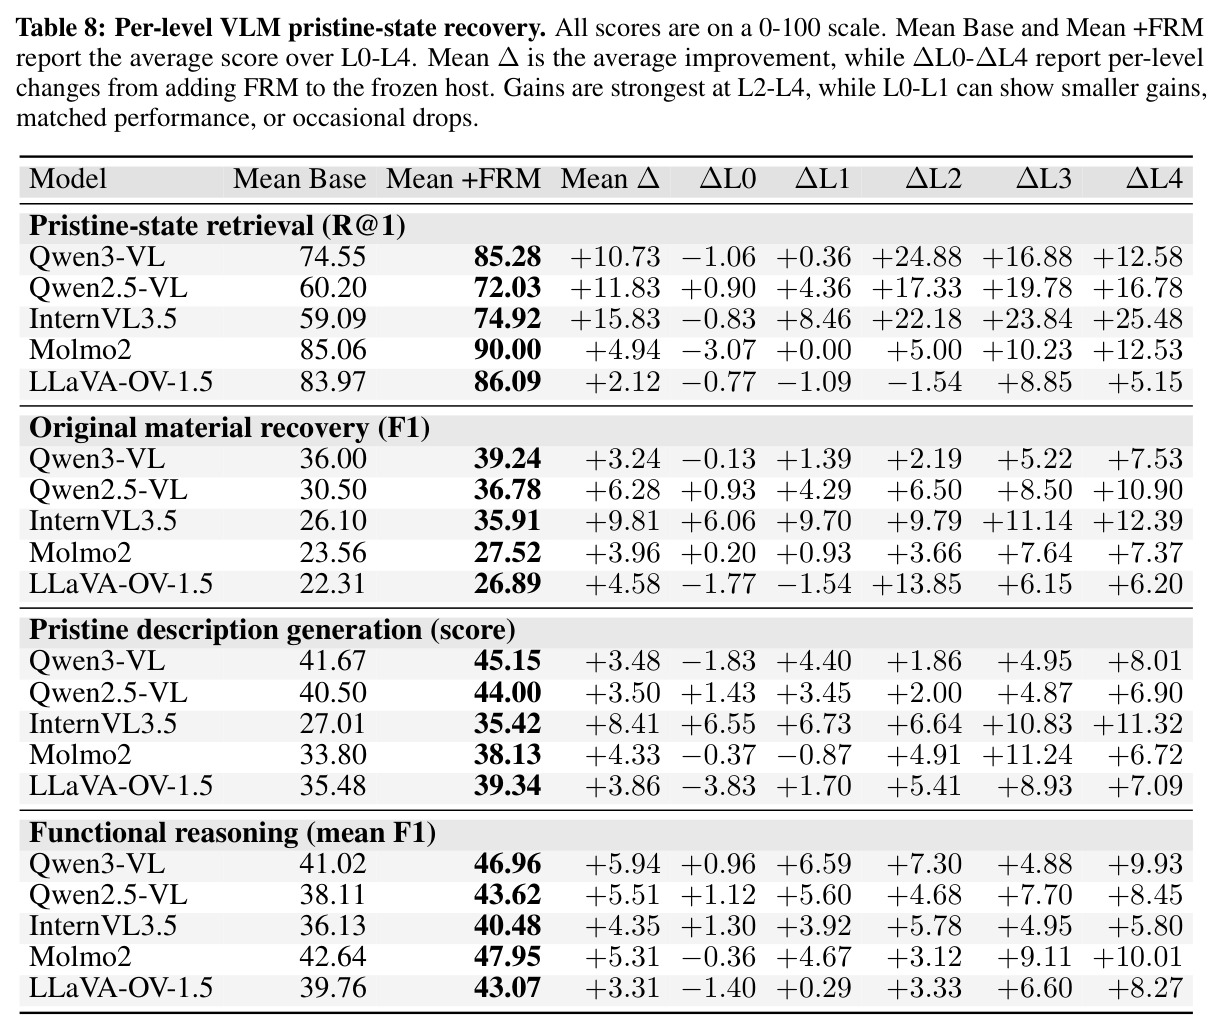
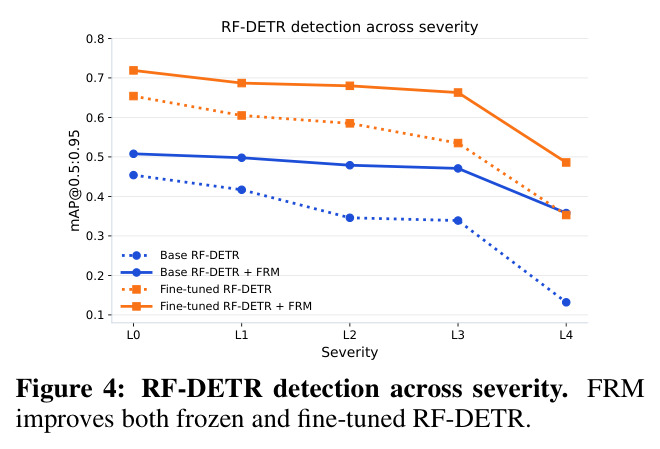
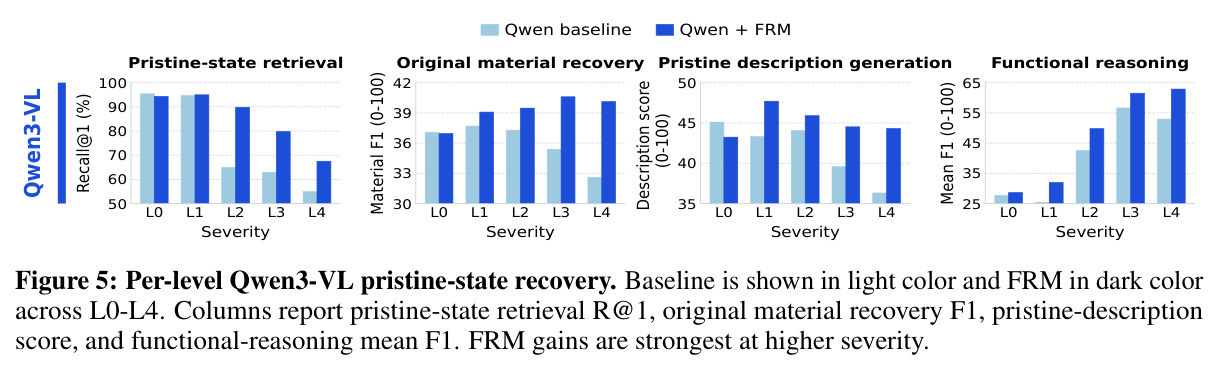
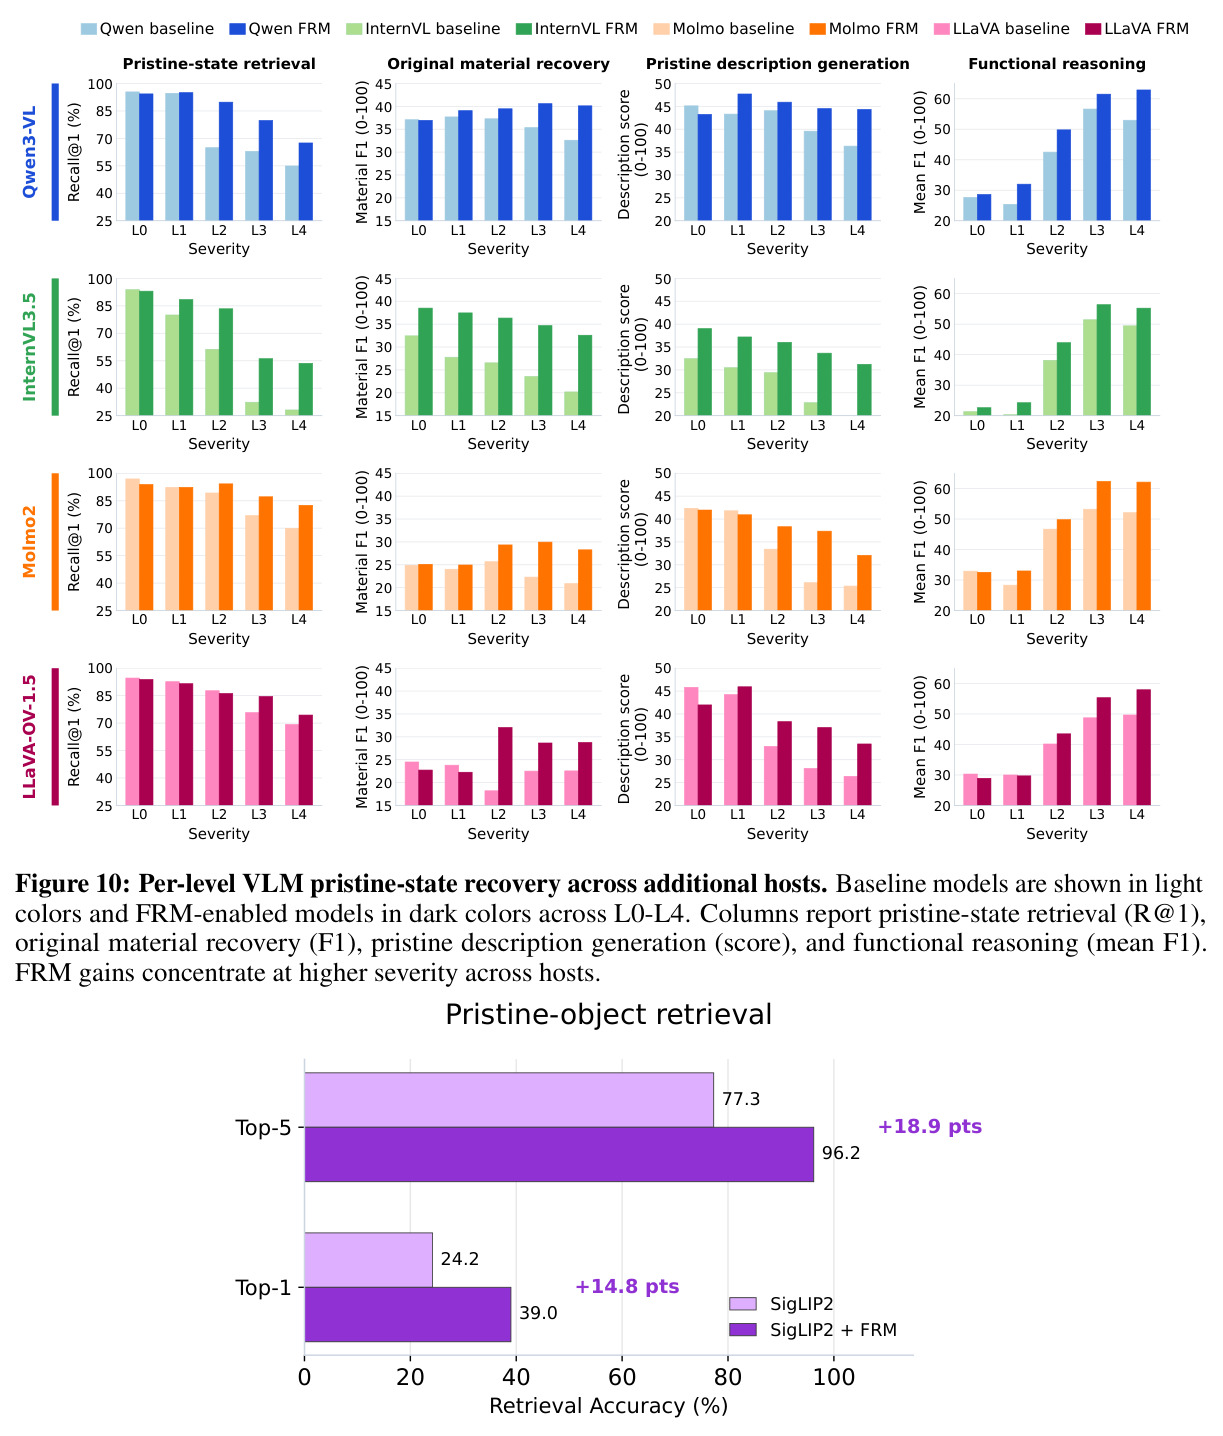
主要发现按实验逐一分析。(1)场景级检测(Table 2):冻结RF-DETR 0.338 mAP@0.5:0.95,加FRM升至0.442(相对提升30.8%);在微调RF-DETR(0.572)之上FRM再涨13.1%到0.647,且完好图像性能几乎无损(0.001 mAP以内);对照范式全部失败——像素修复Restormer仅0.375、WildIR把性能拖到0.266,统计域适应SFA 0.161、DATR 0.293均低于冻结基线,证明分布级对齐无法处理实例级的结构化特征漂移。(2)冻结编码器特征恢复(Table 3):CLIP ViT-L/14的MSE从0.6719降到0.4686(-30.3%)、余弦相似度从0.6537升至0.7492(+0.095);SigLIP2的MSE从2.4172降到1.3693(-43.4%)、余弦+0.138,检索R@1从24.2升至39.0、R@5从77.3升至96.2,逼近完好查询100%天花板,支持'火灾退化造成跨编码器家族的结构化特征位移'这一论点。(3)五个冻结VLM四个任务(Table 4):检索R@1增益为Qwen3-VL +10.73(74.55→85.28)、Qwen2.5-VL +11.83、InternVL3.5 +15.83(59.09→74.92)、Molmo2 +4.94、LLaVA-OV-1.5 +2.12;材质恢复以InternVL3.5最大+9.81(26.10→35.91);描述生成InternVL3.5 +8.41(27.01→35.42);功能推理各宿主+3.31到+5.94。(4)增益随严重度放大(Table 8):检索在L0-L1平均仅+0.73点、L2-L4达+14.66点,功能推理L3-L4平均+7.6点,排除固定校正偏差的解释,说明FRM确实在纠正随物理退化增长的位移。(5)真实火灾裁剪迁移(Table 5):Qwen3-VL在500张真实裁剪上L2-L4检索49.16→53.03(+3.87)、描述27.47→32.53(+5.06),L4级仍全部正向(检索+2.75)。总体:跨8个冻结宿主(RF-DETR、CLIP、SigLIP2和5个VLM),FRM在所有任务上带来9.0–30.8%相对提升,四个VLM任务的平均相对增益为检索12.5%、材质20.1%、描述13.2%、功能推理12.4%。
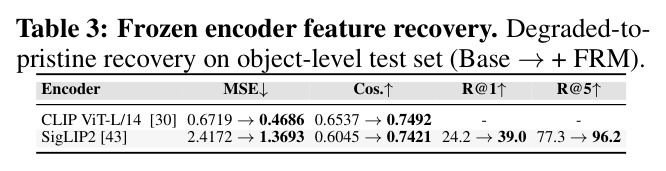
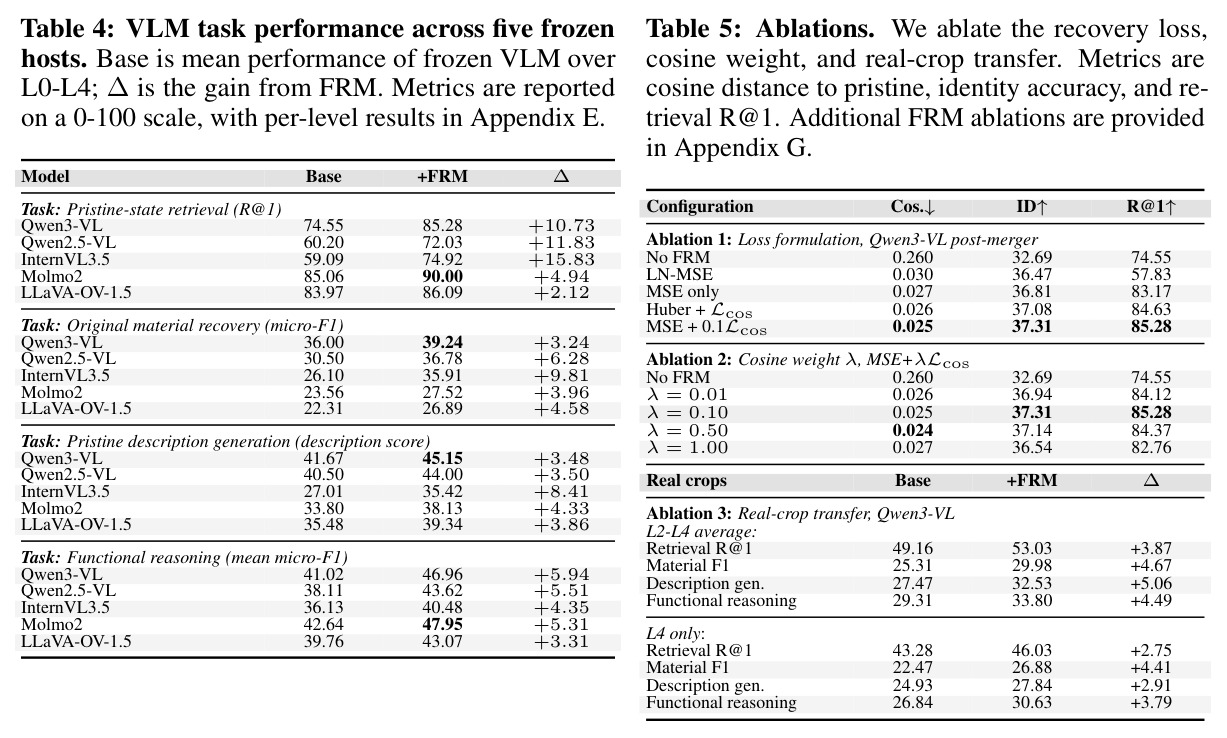
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 退化目标检测(场景级) | COCO-mapped mAP@0.5:0.95 | 0.442(冻结RF-DETR + FRM);微调宿主上0.647 | 0.338(冻结RF-DETR);微调RF-DETR 0.572 | 冻结宿主相对+30.8%;微调宿主上再+13.1%,完好图像性能损失<0.001 mAP |
| 退化到完好检索(SigLIP2) | Recall@1 / Recall@5 | 39.0 / 96.2 | 24.2 / 77.3 | +14.8 / +18.9 点,Top-5逼近100%完好查询天花板 |
| VLM完好状态画廊检索(五模型) | Recall@1 | Qwen3-VL 85.28;InternVL3.5 74.92 | Qwen3-VL 74.55;InternVL3.5 59.09 | 平均+10.73点;InternVL3.5最大+15.83点,L2-L4平均+14.66点 |
| 原始材质恢复(11类) | micro-F1 | InternVL3.5 35.91;Qwen2.5-VL 36.78 | InternVL3.5 26.10;Qwen2.5-VL 30.50 | InternVL3.5 +9.81点;五模型平均相对增益20.1% |
| 完好描述生成 | 描述得分(身份准确率/材质F1/功能准确率等权均值,0-100) | InternVL3.5 35.42;Qwen3-VL 45.15 | InternVL3.5 27.01;Qwen3-VL 41.67 | InternVL3.5 +8.41点;五模型平均相对增益13.2% |
| 功能推理(功能标签+修复材质) | 两项micro-F1的均值 | Qwen3-VL 46.96;Molmo2 47.95 | Qwen3-VL 41.02;Molmo2 42.64 | 五模型平均+4.9点(L3-L4平均+7.6点),相对增益12.4% |
局限与改进
作者承认的局限有五点。其一,恢复方向是任务依赖的:FRM把特征推向完好对齐状态,会恰好抹掉回答'描述这场火灾造成的损伤'这类当前状态查询所需的损伤信号,此类查询应关闭FRM,理想的查询感知门控尚未实现。其二,模块绑定特定的(编码器,tap,特征空间)三元组,换宿主必须重训一个独立模块。其三,新增物体身份需要配对监督——1张完好视觉锚加至少3张跨严重度退化观测,放宽该要求是开放问题。其四,真实裁剪上增益为正但小于合成数据,反映生成模型能力上限、真实图像严重度标签近似、杂乱火场条件以及生成未能覆盖的材料失效模式带来的合成-真实差距。其五,身份恢复只是人类在重度退化下的线索之一,房间布局、邻近物体、幸存结构部件都携带FRM目前忽略的信息。我的补充观察:物体级轨迹是白底棚拍合成图,与真实火场的背景杂乱、遮挡、部分可见差异显著,这可能是真实裁剪增益缩水的主因;描述与功能任务的评分依赖同义词表加GPT-5裁判兜底(身份11%、功能15%的样本需裁判),存在评分噪声;检测评估的COCO映射仅覆盖55/80类,TRACE特有的危险品类别(气雾罐、燃气罐)恰恰被排除在mAP之外,削弱了最实用场景的量化评估;314.57M参数的FRM对每个VLM各一份,多宿主部署的存储成本不低;功能推理基线存在'粗猜测'伪影(如回答'container'可部分匹配宽泛标签),指标提升的业务价值需与检索、身份准确率联合解读。
独立分析的弱点
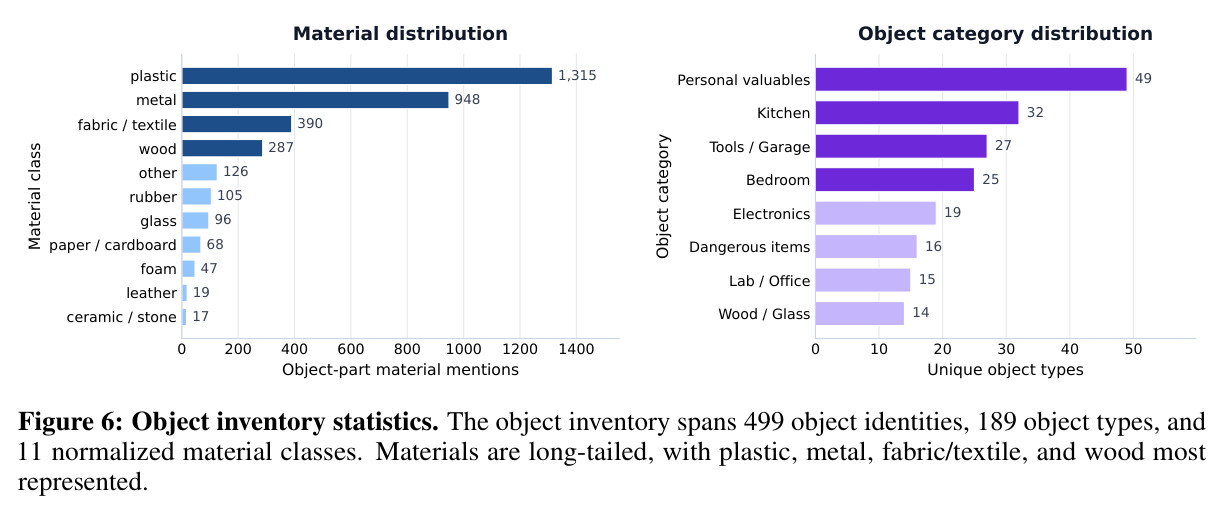
弱点一:单向恢复导致能力割裂。FRM把所有查询都当成'退化前是什么'来处理,一旦用户问损伤程度或现场安全评估(消防场景的真实需求),特征已被'洗白'。改进方向:训练查询感知的路由器,按查询意图在恒等映射与恢复映射之间插值,或让FRM同时输出完好对齐与损伤描述两组特征。弱点二:宿主绑定与数据依赖。每个(编码器,tap)配置需单独训练FRM,五个VLM就是五个314.57M的模块;新增物体身份还要求配对采集。改进方向:研究宿主无关的通用退化漂移校正器加每宿主轻量适配头,或利用文本到图像模型在特征空间合成配对监督以降低采集成本。弱点三:训练分布是白底棚拍图,与真实火场(复杂背景、严重遮挡、碎片堆积)差距明显,真实裁剪上检索仅+3.87点。改进方向:用ControlNet类可控生成把物体轨迹嵌入真实火场背景,或在场景级合成中直接实例化选定物体形成in-the-wild配对。弱点四:纯token级校正、无上下文。人类在L4级靠幸存金属硬件、空间排布和房间功能推断身份,FRM只看物体自身token。改进方向:在LLM侧融合场景级上下文、引入部件级推理(论文已标注part-level材质),或让FRM以场景特征为条件。弱点五:评估协议的脆弱性。材质类别极度长尾(塑料1,315次提及vs陶瓷17次),材质F1可能被头部类别主导;GPT-5裁判兜底引入不可完全复现的因素(作者实测换严格规则仅变化0.8分以内,但该结论依赖具体数据集)。
未来方向
作者明确提出的方向:(1)查询感知门控机制,让单一冻结宿主同时服务完好状态查询(FRM开)与损伤状态查询(FRM关);(2)把配对监督配方推广到其他不可逆变换——洪水损伤、建筑坍塌、风化,只要存在灾前视觉参考即可套用'特征空间配对恢复'框架;(3)融合空间上下文与部件级理解,利用房间布局、邻近物体和幸存结构部件辅助重度退化下的身份推断;(4)放宽新增物体身份对配对监督(至少3张退化观测)的要求;(5)缩小合成-真实差距,包括更好的生成模型和更细的真实严重度标注。基于本文成果可自然延伸的方向:把FRM用于视频时序退化下的变换目标检索(与TOR视频协议对接);对学习到的修正量 $\Delta_\theta$ 做低秩/方向分析,检验其是否对应特征流形上可解释的'退化方向',这可能启发更轻的线性校正器;在保险与司法应用前为完好状态预测附加不确定性量化(作者在Impact Statement中承认当前缺失);探索FRM与检索增强生成结合,把校正后的特征直接用于跨模态证据检索。
复现评估
复现条件总体友好,难度中等。开源情况:作者承诺发布数据集、生成与评估流水线和训练代码;附录B给出物体轨迹与场景生成的完整prompt模板(包括各材料的失效行为规则、五级退化定义、判官打分标准),附录C给出全部五个任务的prompt、同义词归一化表和精确评分公式,附录D给出各宿主tap点与FRM配置——协议透明度很高。数据成本:场景级21,400张由Gemini 3 Pro Image生成(约29,000候选经Gemini 3 Flash判官≥0.7过滤,接受率73.8%),依赖约700张真实火灾参照图(主要来自Fire360及研究许可的网页来源),需要商业API预算但量级可控;物体级2,994张(499轨迹×6状态)。标注可靠性有量化验证:300物体分层子集上双标注者一致率93.4%,Cohen's κ=0.836。算力门槛低:单卡A100即可,FRM训练在缓存特征下约1小时、在线前向约3小时收敛(约2,000配对样本),推理开销仅为宿主7.86%(VLM)或5.25%(检测器)参数量的一次额外前向。主要复现风险在于数据侧:若自己重新生成数据,合成质量依赖Gemini 3系模型且判官阈值0.7需要调;若直接使用发布版本数据,则任何有单张A100的团队都能在数小时内复现核心FRM结果。
论文图表
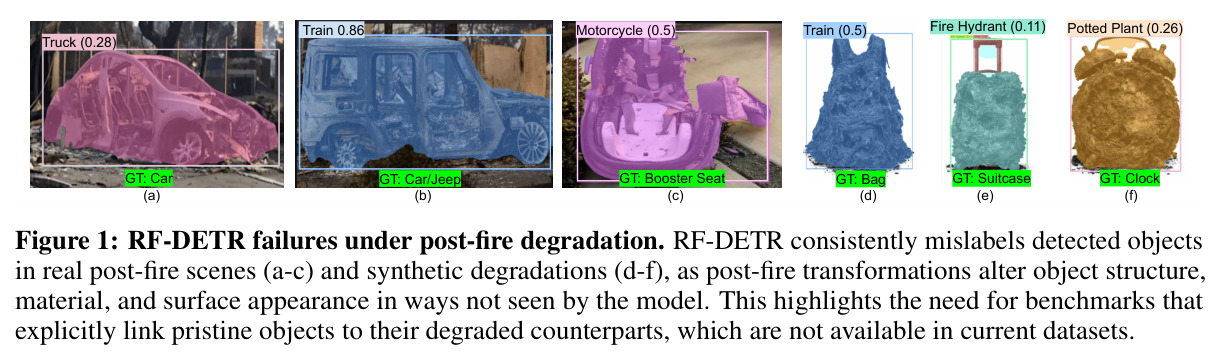
六个例子(a-f)展示RF-DETR在真实火后场景(a-c)和合成退化(d-f)中系统性错标检测到的物体:真值是汽车/吉普被判成火车(0.86)、摩托车(0.5)、消防栓(0.11)、盆栽(0.26)等,置信度普遍很低。
开篇即用具体失败案例建立问题动机:火后形变同时改变结构、材质和外观,导致检测器定位到了框却认不出类别,直观说明为什么需要显式链接完好-退化对应的数据。
展示TRACE两大子集:(a) 以真实火后图像为参照生成的场景(书房、室外等),标注包含边界框、材质标签和描述;(b) 物体退化轨迹,如聚碳酸酯行李箱、塑料饭盒、木柜、金属凳从完好态到L0-L4的渐进退化,附带部件级材质标注。
一图看懂数据集的组织方式和规模感,理解'场景级子集'与'物体级配对轨迹'两种数据形态是理解后续五个任务和FRM训练监督的基础。
三组消融:(1) 损失形式——LN-MSE使检索跌至57.83(低于无FRM的74.55),MSE单独83.17,Huber+余弦84.63,MSE+0.1余弦最优85.28;(2) 余弦权重λ扫描——0.01/0.1/0.5/1.0对应84.12/85.28/84.37/82.76;(3) 500张真实裁剪迁移——Qwen3-VL在L2-L4各任务均正增益(检索+3.87、材质+4.67等),L4仍正向。
证明损失设计的每个组件都必要(尤其token幅度与方向对齐缺一不可),并用真实数据检验合成训练的迁移能力,是方法可靠性的关键证据。
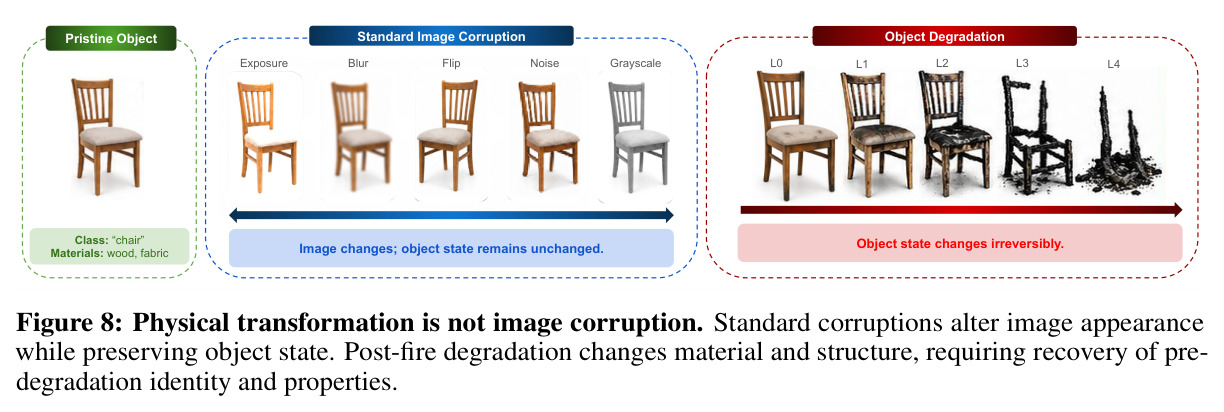
对比标准图像退化(曝光、模糊、翻转、噪声、灰度)与物体退化(L0-L4)作用于同一把木+布椅子:前者只改图像外观、物体状态不变,后者不可逆地改变材质与结构。
一图说明本文问题设定与整个图像鲁棒性文献的本质区别,是'为什么现有基准和方法都不适用'这一动机的最简洁表达。
两组集成消融:(1) DeepStack——Qwen3-VL无FRM身份准确率32.69,FRM关DeepStack 37.31,FRM开DeepStack 36.54(略降),完好天花板43.08;(2) tap点——Qwen3-VL post-merger 85.28 vs pre-merger 72.90,InternVL3.5 post-projector 74.92 vs pre-projector 63.84。
回答'应该在校正哪里'这一部署关键问题:LLM-facing的下游接口一致优于早期视觉token接口,为FRM在新宿主上的落地提供选型依据。