Pelican-Sim 1.0:面向具身智能的通用世界模型模拟器 Pelican-Sim 1.0: A General World Model Simulator for Embodied Intelligence
统一28维动作与URDF骨架视频双路条件的世界模型,支持数据生成、策略评估、动作选择与策略改进。
前置知识
动作条件世界模型
学习环境动力学的生成模型:给定初始RGB观测、候选机器人动作序列和任务指令,预测未来视频帧,相当于一个可无限次查询的“学习型模拟器”,能在真实执行之前评估行为的视觉后果。
本文的全部贡献——数据生成、策略评估排序、动作选择、策略改进——都建立在“给定动作就能预测未来观测”这一核心能力之上。
Flow Matching(流匹配)
一种生成建模范式:构造噪声到数据的线性插值路径 $Z_\tau = (1-\tau)Z_0 + \tau\epsilon$,训练网络预测速度场 $U_\tau = \epsilon - Z_0$,推理时从纯噪声积分常微分方程到数据端,训练目标比DDPM更简洁。
Pelican-Sim 用目标帧流匹配损失(式5)训练视频预测,35步到4步的加速蒸馏也基于概率流ODE轨迹,是读懂方法与加速两节的钥匙。
Video DiT 与稀疏混合专家(MoE)
Diffusion Transformer 用Transformer充当扩散/流匹配的去噪骨干;稀疏MoE把每层的稠密FFN换成路由器加多个专家FFN,每个token只激活top-K个路由专家与共享专家,以稀疏激活换取更大容量。
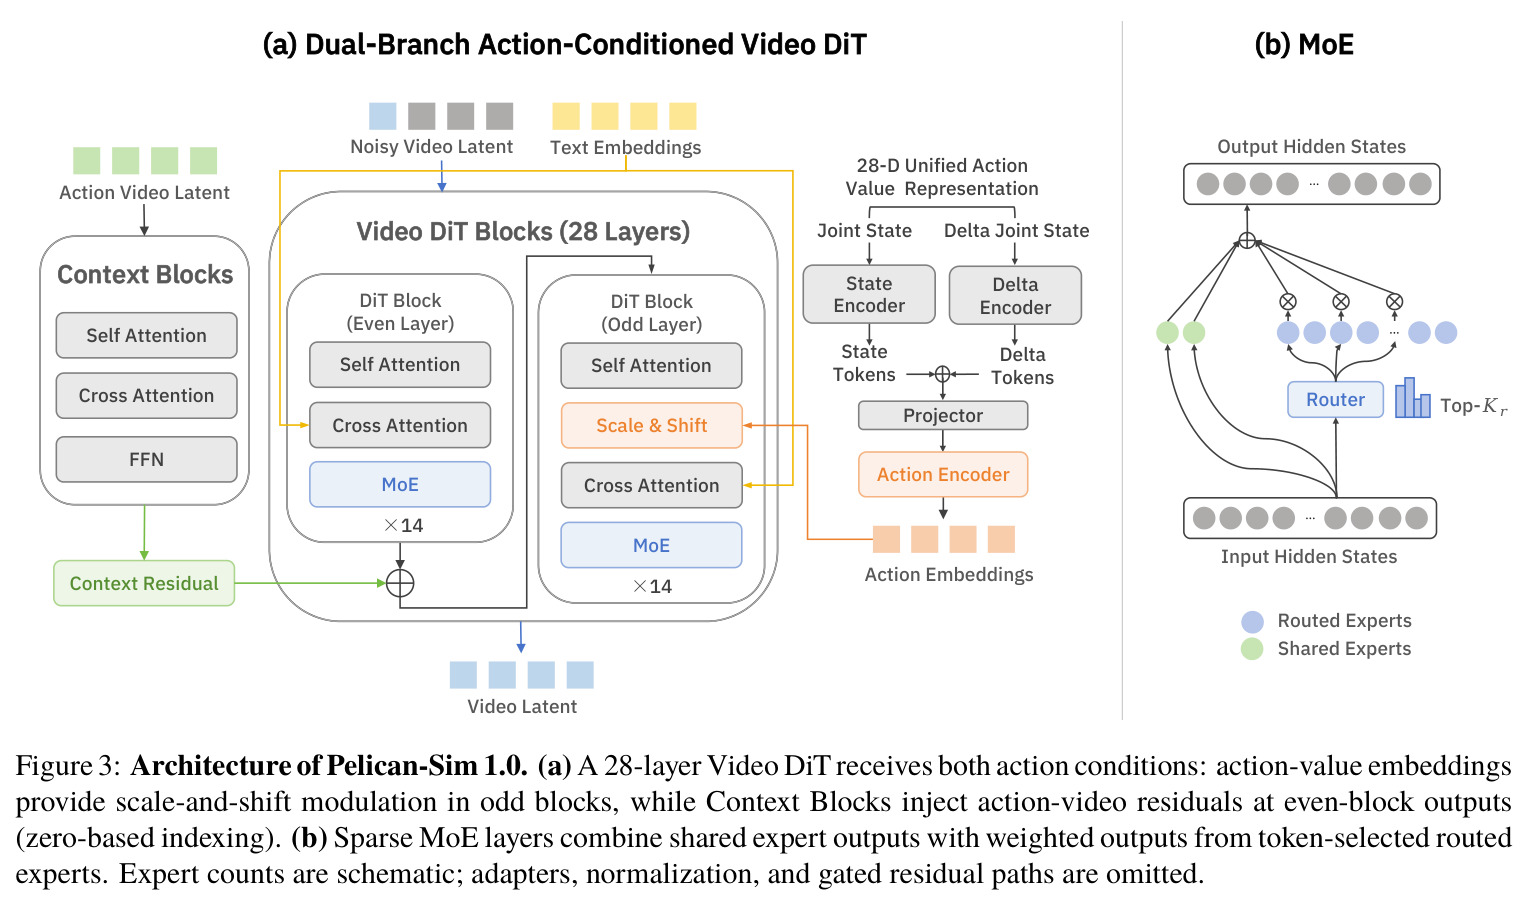
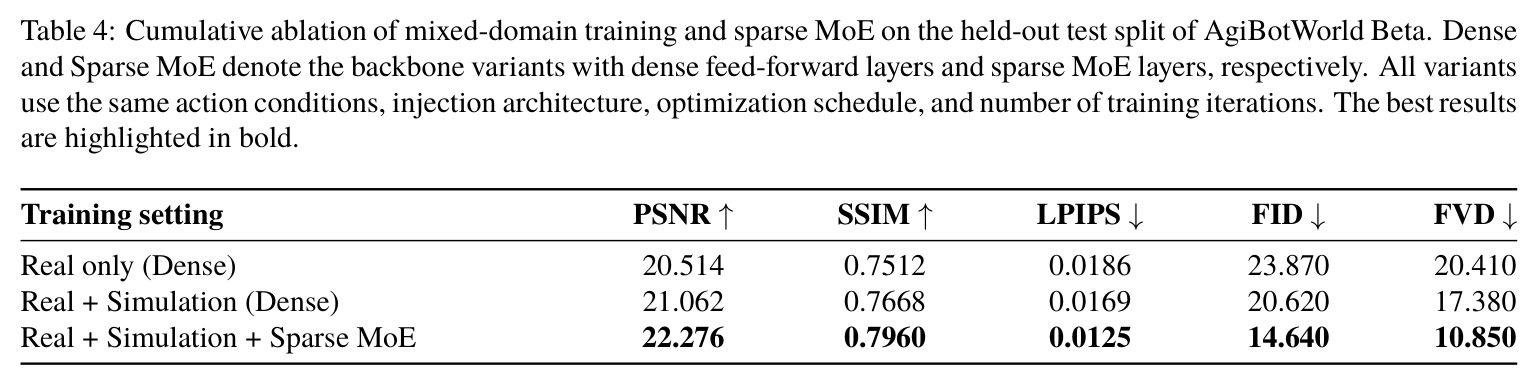
本文以Cosmos-Predict 2.5的28层Video DiT为骨干,把FFN换成1共享+8路由、top-2的sigmoid路由MoE以吸收异构机器人动力学,带来FVD下降6.530。
URDF 与正向运动学
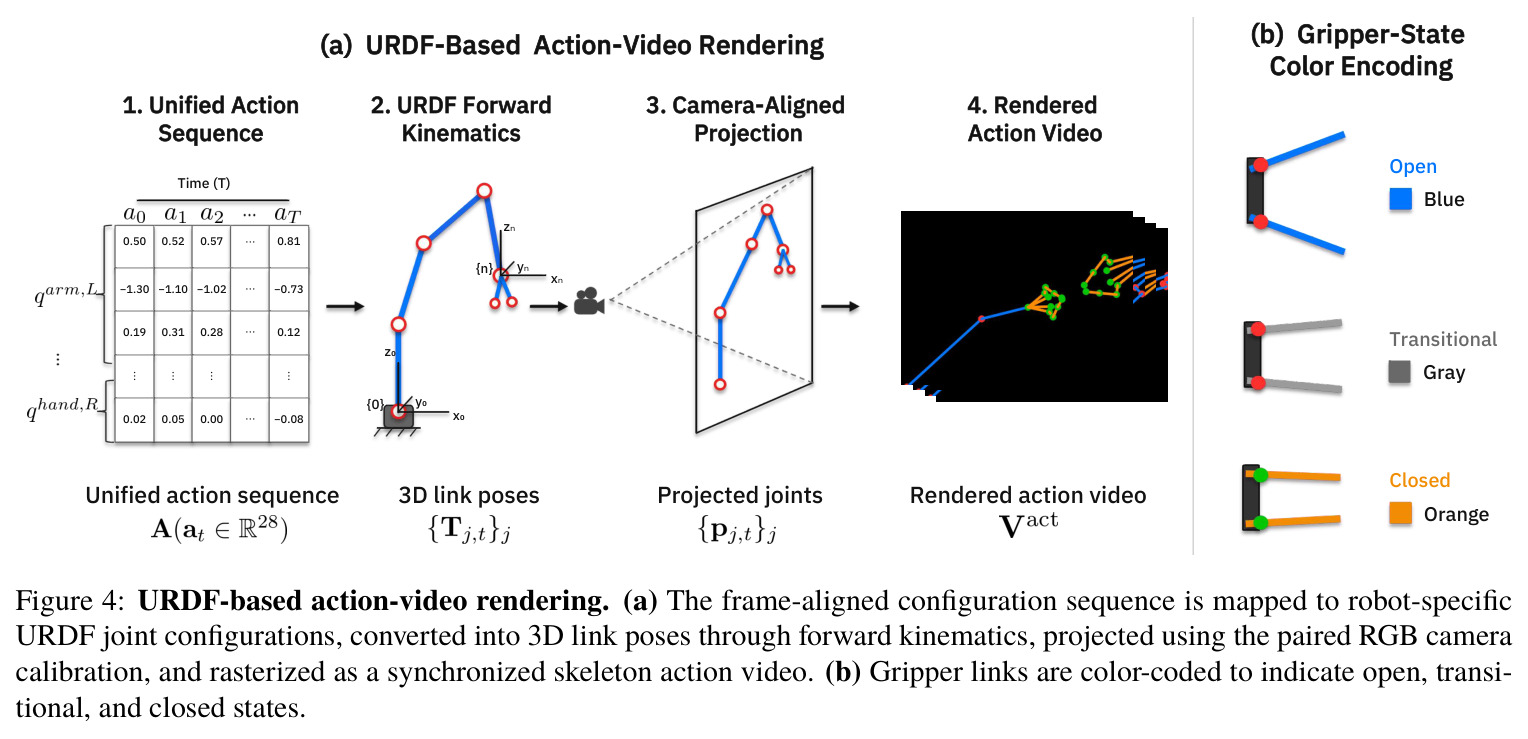
URDF是描述机器人连杆-关节结构与几何的标准化文件;给定关节角,正向运动学沿运动链逐级相乘齐次变换得到各连杆位姿 $T_{j,t}=FK_j(U,q_t)$,再经相机内外参投影即可在图像上画出机器人骨架。
本文的第二路动作条件——与RGB相机对齐的URDF整臂骨架动作视频——正是由该管线从28维动作值确定性渲染而来。
VLA 策略与 GRPO
VLA指以视觉和语言为输入、直接输出动作的大模型策略(如π0.5、OpenVLA-OFT、Diffusion Policy);GRPO在同一初始条件采样一组轨迹,用组内归一化回报作优势 $\hat{A}_k$ 进行带裁剪的策略梯度更新。
数据生成实验用π0.5衡量增强数据价值,动作选择用Diffusion Policy出候选,策略改进用GRPO在世界模型想象rollout上更新OpenVLA-OFT,三个下游实验都依赖这些概念。
PSNR/SSIM/FVD 等指标
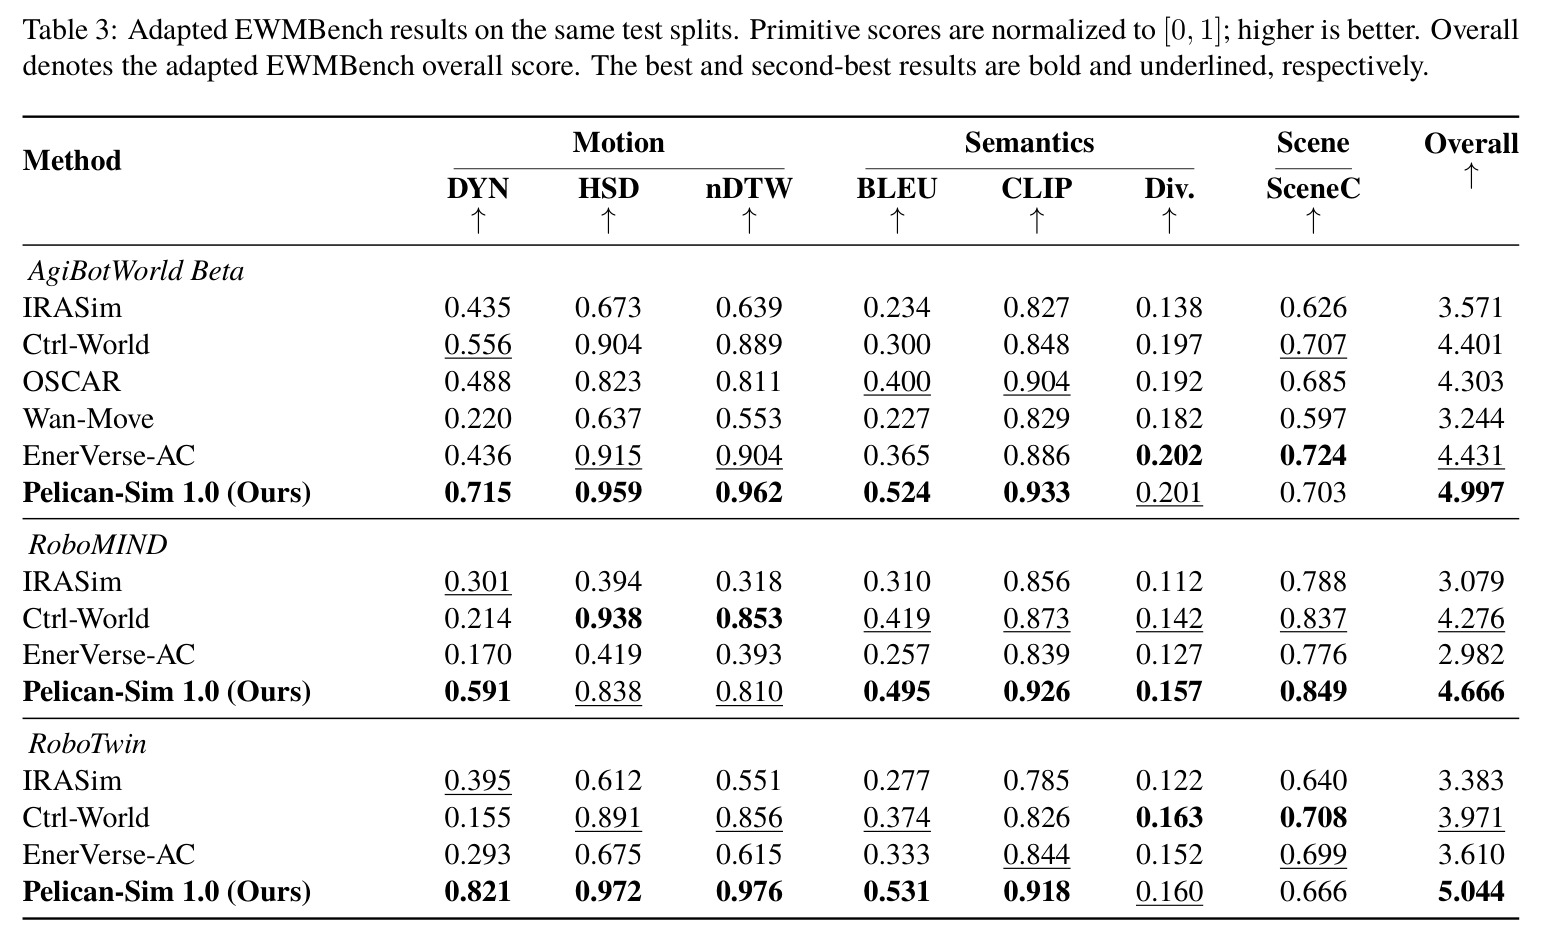
PSNR/SSIM度量像素级保真度,LPIPS度量感知相似度,FID度量图像分布距离,FVD度量时空视频分布距离;EWMBench则从运动正确性(DYN等)、语义对齐与场景一致性等角度综合评估动作跟随质量。
论文与IRASim、Ctrl-World、EnerVerse-AC等基线的全部定量对比都建立在这五类指标加适配版EWMBench之上。
研究动机
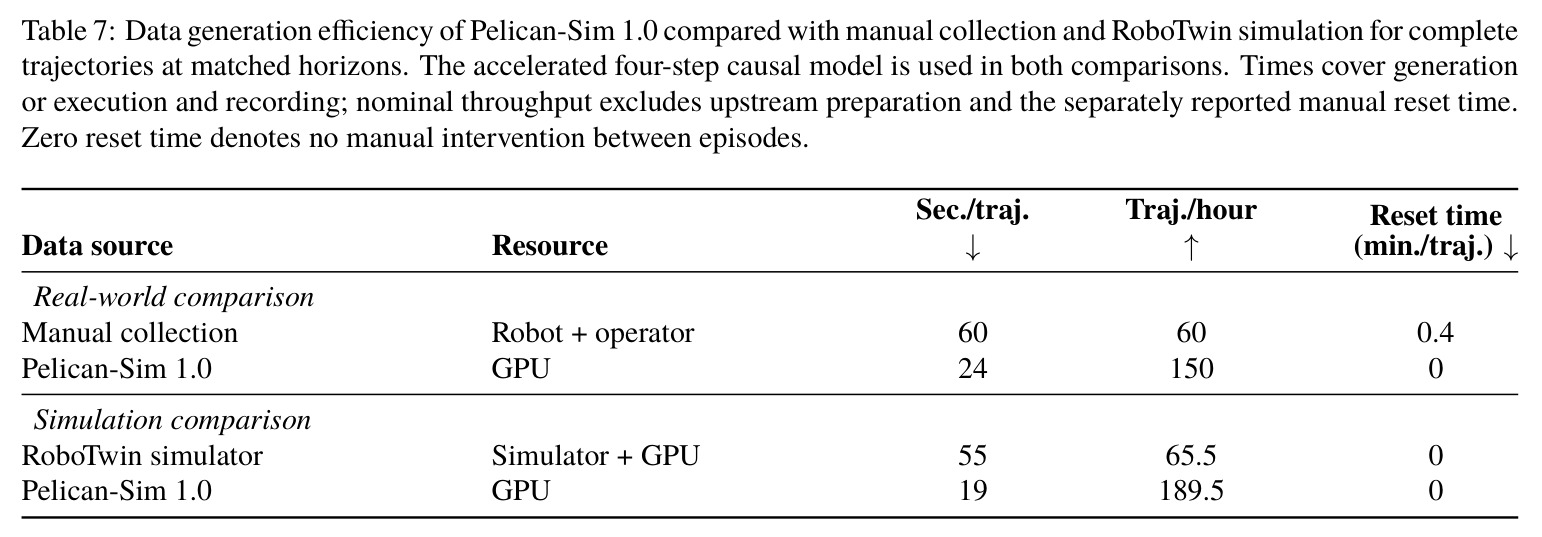
现有动作条件世界模型在跨本体场景下存在表示两难。数值路线(IRASim、Ctrl-World 直接用关节角与夹爪开合)保住了精确构型,但没有显式的图像空间运动引导,模型必须为每一种机器人、每一个相机配置从零学习“数值到像素运动”的映射;视觉路线则各有盲区——EnerVerse-AC 的末端执行器热图只给局部位姿、整臂关节欠约束,BridgeV2W/GeniWorld 的机器人掩码只编码投影占据而非关节连通,VAP/OSCAR 的骨架暴露了运动链但其图像投影一般无法唯一反解底层关节构型。同时机器人数据极其昂贵:论文实测人工采集一条完整任务轨迹需 60 秒,且每条平均还要 0.4 分钟人工重置场景,限制了策略学习的可用数据规模;而已有的机器人世界模型也都没有采用 token 级稀疏 MoE 来吸收异构动力学。
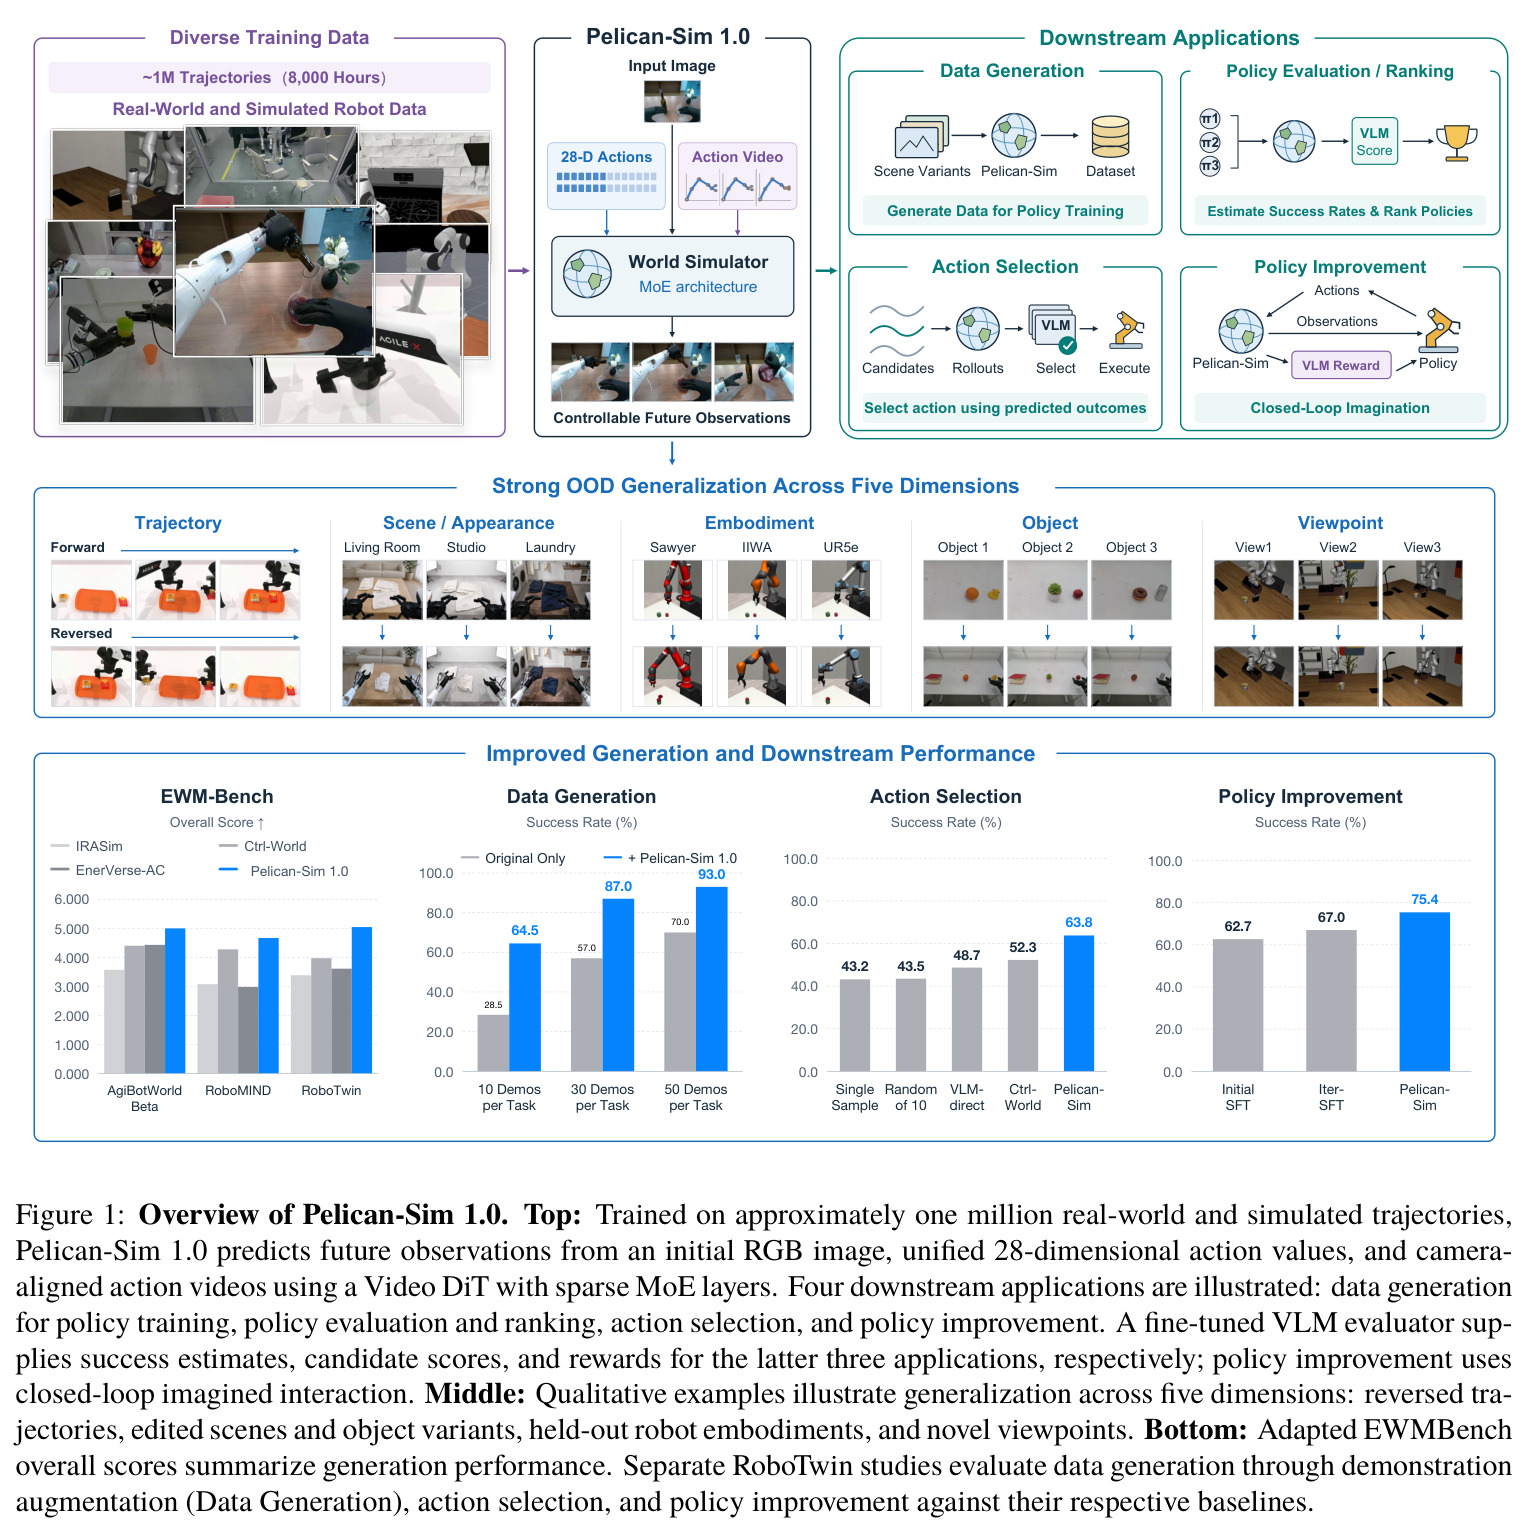
本文的目标是本文的目标是构建一个通用动作条件世界模型模拟器:输入首帧 RGB、帧对齐的机器人构型序列与可选任务指令,输出未来观测视频;用一套固定动作接口覆盖单臂/双臂、平行夹爪/灵巧手等主流本体,使异构机器人数据能在同一个模型里联合训练;在真实与仿真混合语料上同时保住视觉保真度和动作跟随精度;把推理压缩到能支撑大规模重复查询的速度(35步压到4步、5.67倍加速);并在同一框架下验证四类下游应用——生成数据增强策略训练、VLM 辅助的策略评估与排序、候选动作选择、以及闭环想象 rollout 的策略改进。
与已有工作不同的是,独特切入是“同步双路动作表示+交错注入”。与已有方法单用数值或单用视觉动作不同,本文把同一条轨迹同时编码为保留精确构型的 28 维统一布局,和由 URDF 与相机标定渲染、与 RGB 像素级对齐的整臂骨架视频(夹爪按开/合/过渡三态着色),两路分别以调制和残差方式交替注入同一个 Video DiT;再配 token 级稀疏 MoE 按内容而非本体身份路由,吸收异构动力学;并用渐进式因果蒸馏把 35 步采样压到 4 步。最后在约 100 万条、8000 小时的真实+仿真混合轨迹上训练验证,并以轨迹、场景、本体、物体、视角五个维度的受控分布偏移实验系统检验泛化能力。
核心方法
直觉:让模型既“读到”精确的关节命令,又“看到”命令对应的画面运动,就像操作员同时看示教器数值和机械臂动画。技术上以 Cosmos-Predict 2.5 的 28 层潜在 Video DiT 为骨干:28 维动作值分解为初始构型 $s$ 与缩放帧间增量 $\delta_t=(a_t-a_{t-1})\odot\eta$,经两个 MLP 编码为状态 token 与增量块 token,广播到潜变量网格后由块级残差适配器生成缩放-平移参数 $\gamma^\ell,\beta^\ell$,在 14 个奇数块内调制自注意力后的特征;动作视频则用与 RGB 相同的 video tokenizer 编码,经并行 Context Blocks 在 14 个偶数块输出处加残差。训练只用目标帧的流匹配损失(式5),条件帧潜变量保持干净;每块 FFN 替换为 1 共享+8 路由、top-2 sigmoid 路由的稀疏 MoE与负载均衡损失。语料约 100 万条轨迹、8000 小时,训练 500K 迭代、32 张 B200、学习率 $3.05\times10^{-5}$。
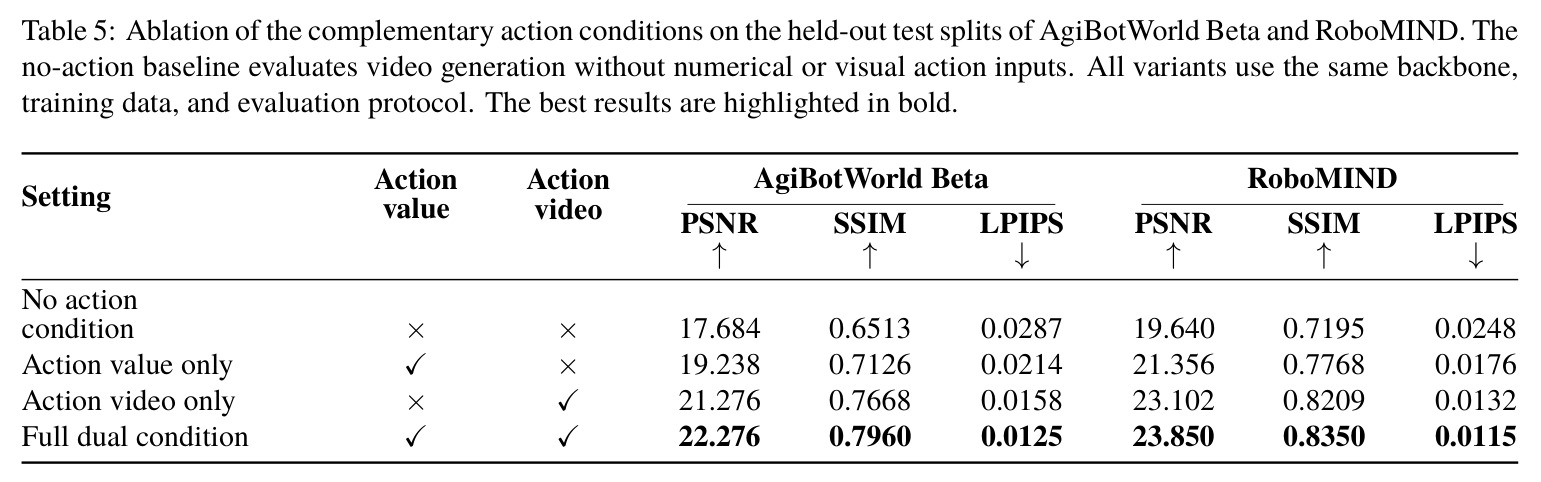
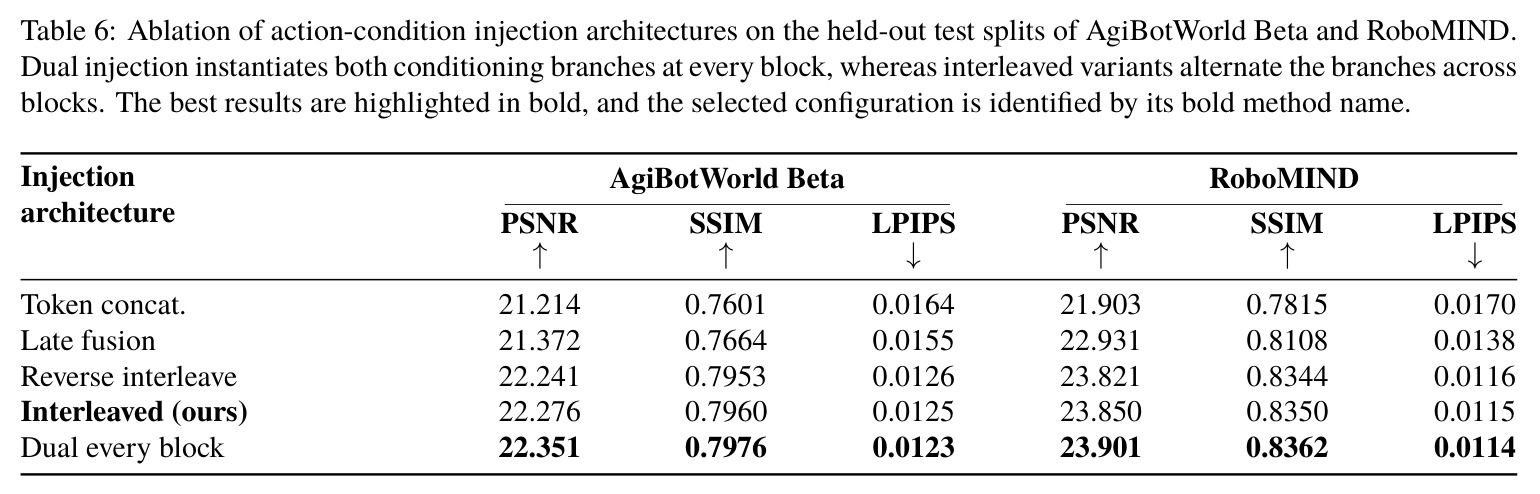
核心创新有三。其一是互补动作条件的联合保留:数值分支保住图像投影无法唯一确定的关节构型,视觉分支把整臂连杆连通性与夹爪状态显式画进与 RGB 对齐的骨架视频,二者是同一轨迹的同步双视图而非两个独立控制信号——消融显示双条件比仅动作视频高 1.000 dB(AgiBotWorld Beta)与 0.748 dB(RoboMIND)PSNR,说明数值信息不可被视觉条件替代。其二是交错注入架构:数值路在奇数块做 scale-shift 调制、视觉路在偶数块加残差,比后融合高 0.904 dB,而与每块双重注入仅差 0.075 dB,证明互补信息可沿网络深度渐进融合,无需为每块重复配置两套条件模块。其三是在机器人世界模型中引入 token-choice 稀疏 MoE:按 token 特征而非预定义本体身份分配专家,共享专家提供公共通路,在相同混域训练下 FVD 比稠密骨干降 6.530,为异构机器人动力学提供了内容自适应的建模容量。
方法步骤详情
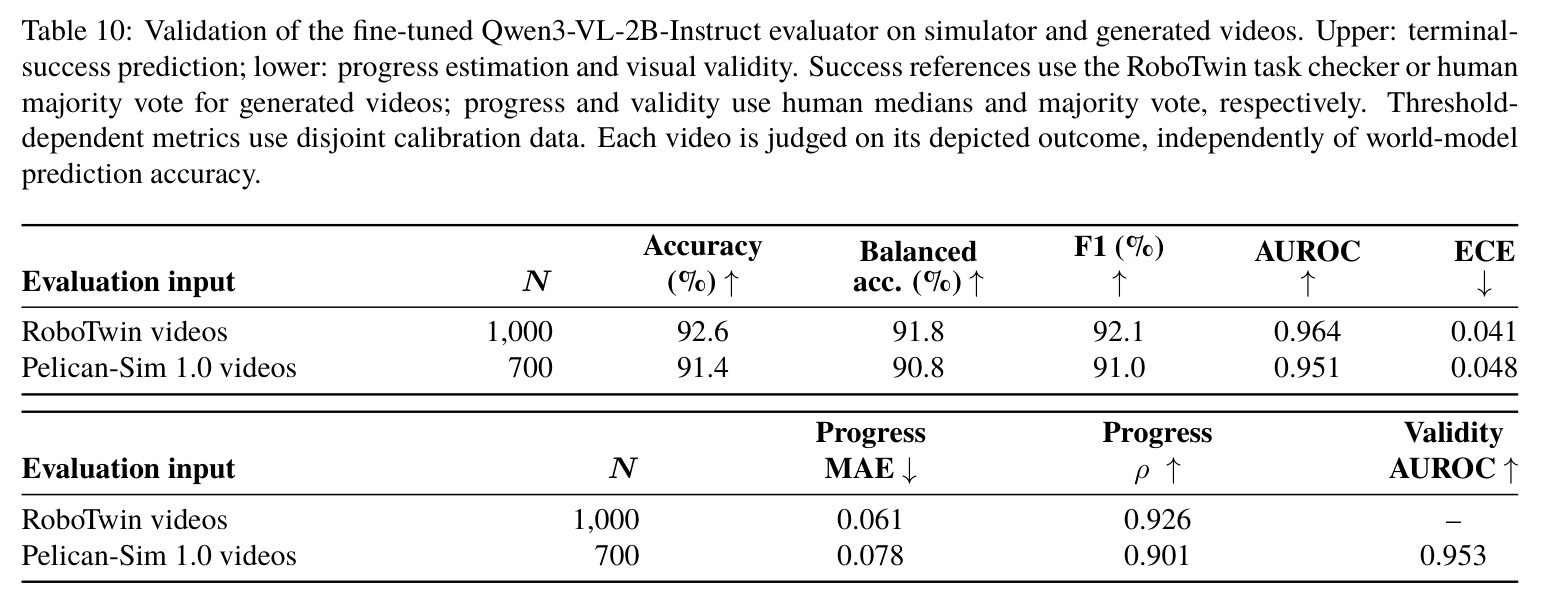
①动作统一化:每帧构型打包为 $a_t=[q_{arm};g;q_{hand}]$,左右各 14 维(7 臂关节+1 夹爪+6 灵巧手)共 28 维,缺失部件零填充、单臂整侧置零。②动作视频渲染:$q^U_t=\Psi_U(a_t)$ 转 URDF 关节序,正向运动学求连杆位姿,经内参 $K$ 与外参 $T_{cam}$ 投影、光栅化为骨架视频,夹爪按蓝/橙/灰着色开/合/过渡。③编码注入:状态与增量块经 MLP 编码后调制 14 个奇数块(式14);动作视频潜变量经 Context Blocks 在偶数块输出加残差(式16)。④MoE 前向:AdaLN 表示经 sigmoid 加偏置路由选 top-2 专家,混合权重按无偏亲和度归一并乘 $\kappa_r=2.5$,路由倍率 $s_r$ 前 2000 步线性升到 1,配负载均衡损失。⑤训练加速:35 步双向模型先改分块因果并 teacher forcing 得因果教师,用其概率流 ODE 轨迹初始化 4 步学生,再以分布匹配蒸馏做 self-forcing 自回归训练,推理带 KV 缓存。⑥下游评估器:LoRA 微调 Qwen3-VL-2B,三头输出成功置信 $q_\phi$、进度 $p_\phi$、有效性 $a_\phi$,输入指令+检查单+16 帧采样,选择效用 $u_\phi=a_\phi[q_\phi+\lambda(1-q_\phi)p_\phi]$。
技术新颖性
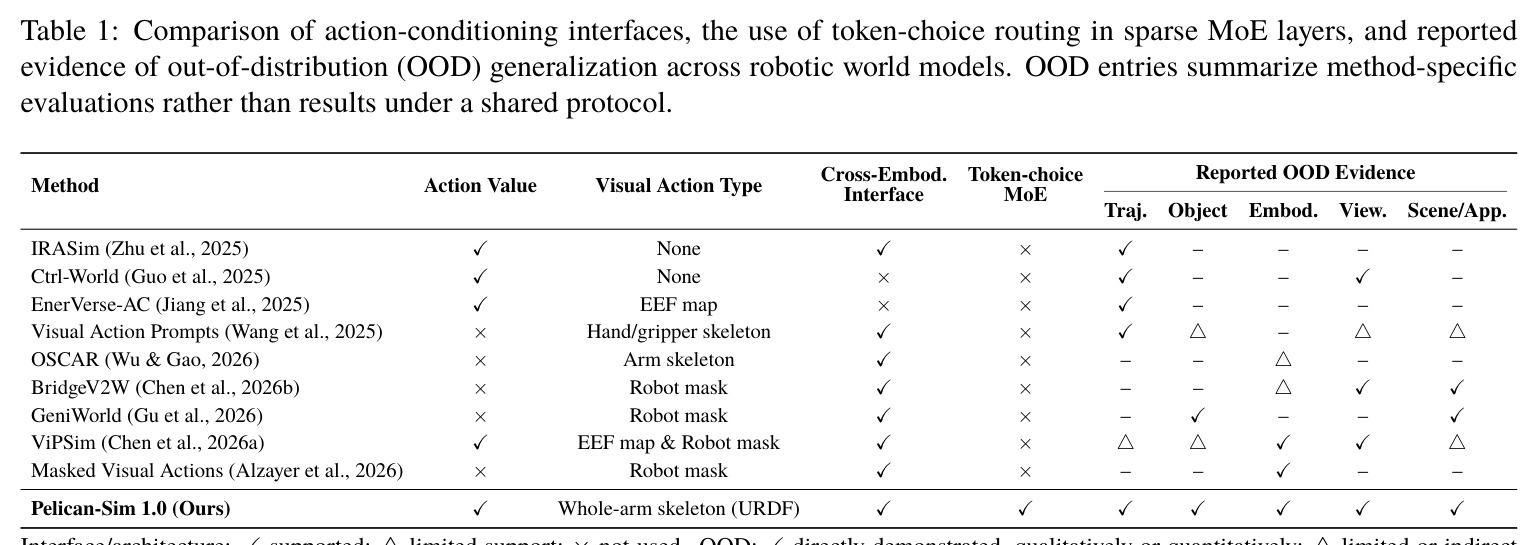
对照 Table 1,同时具备数值动作接口、URDF 整臂骨架视觉条件、跨本体接口、token-choice MoE,并在轨迹/物体/本体/视角/场景五个 OOD 维度都有证据的,此前没有先例。与 EnerVerse-AC、ViPSim 的混合条件相比,本文视觉条件是整臂骨架而非 EEF 图或掩码,且两路条件作用在同一个 DiT 的交替块上而非简单拼接或后融合;与 VAP、OSCAR 的纯骨架路线相比,完整数值构型被保留,不会因投影歧义丢失信息;与 BridgeV2W/GeniWorld 的掩码路线相比,显式编码了关节连通性。加速方面,把因果适配与少步蒸馏解耦的渐进流程(因果教师→ODE 轨迹初始化学生→DMD self-forcing)在保持任务与动作接口完全不变的前提下实现 5.67 倍加速。此外,用 VLM 进度增量+有效性加权的密集奖励(式21)在世界模型想象 rollout 上运行 GRPO 改进 VLA 策略,把生成式模拟器、VLM 评估器与 RL 优化器串成完整闭环,也是较新的系统级组合。
实验结果
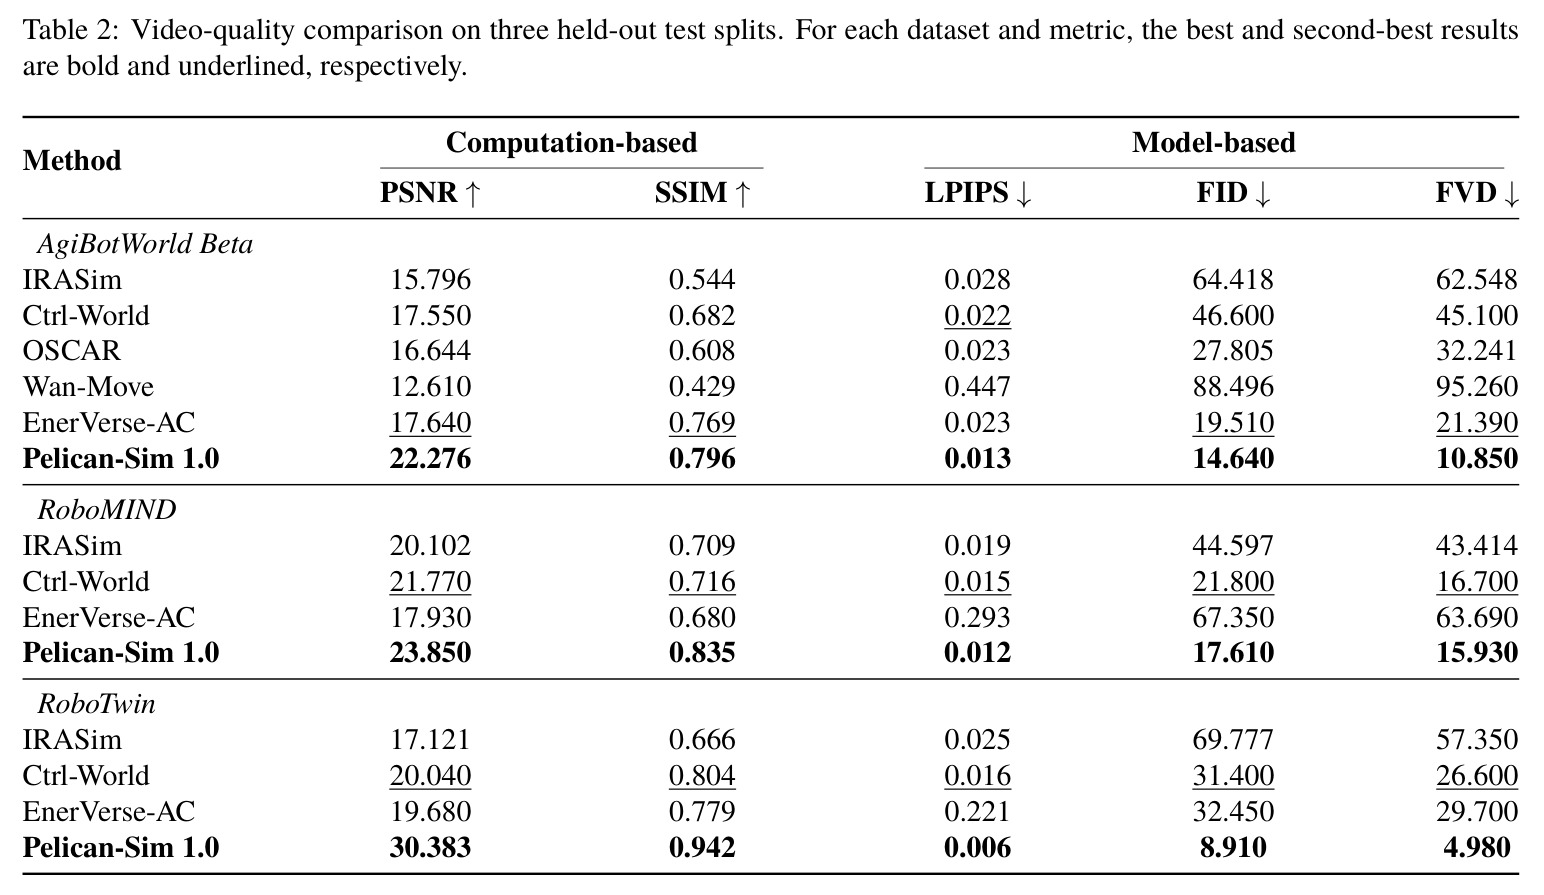
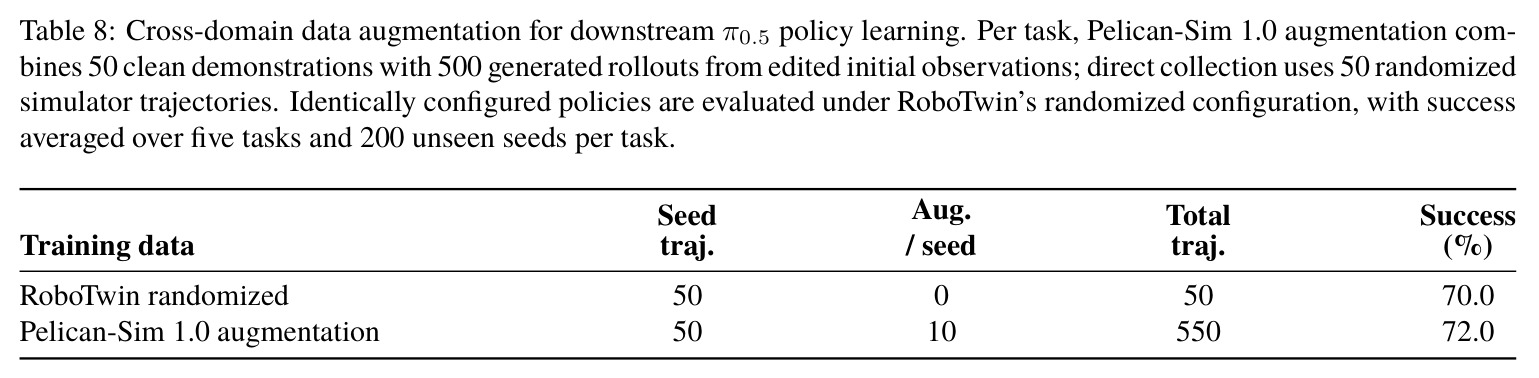
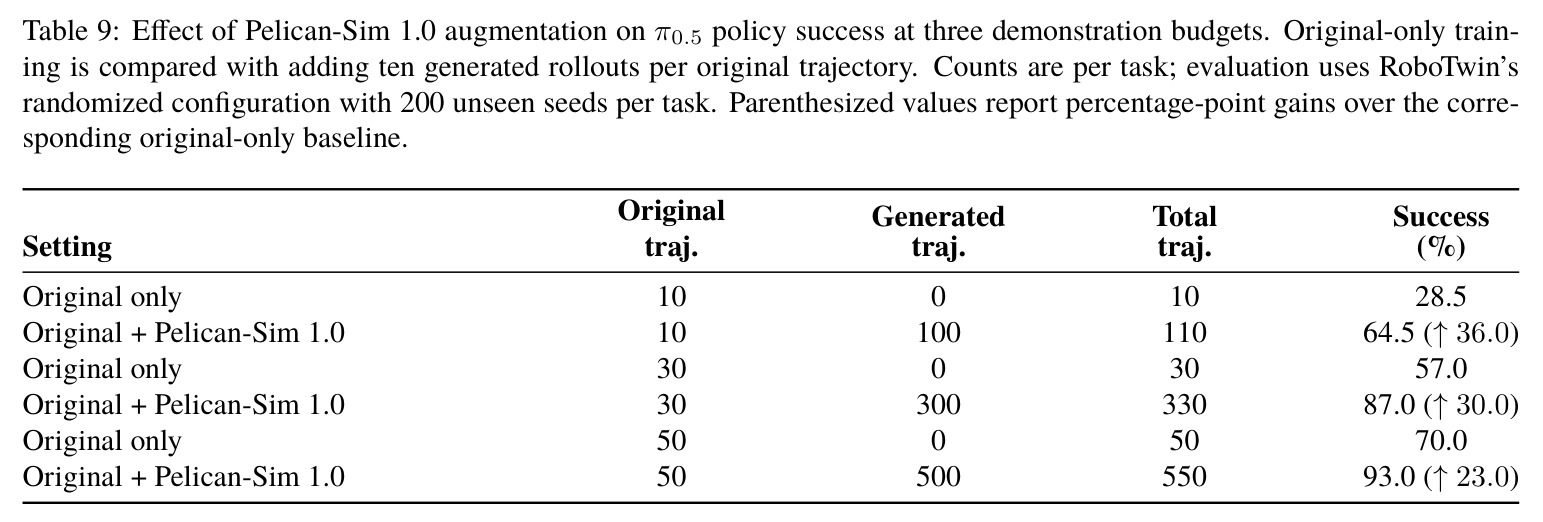
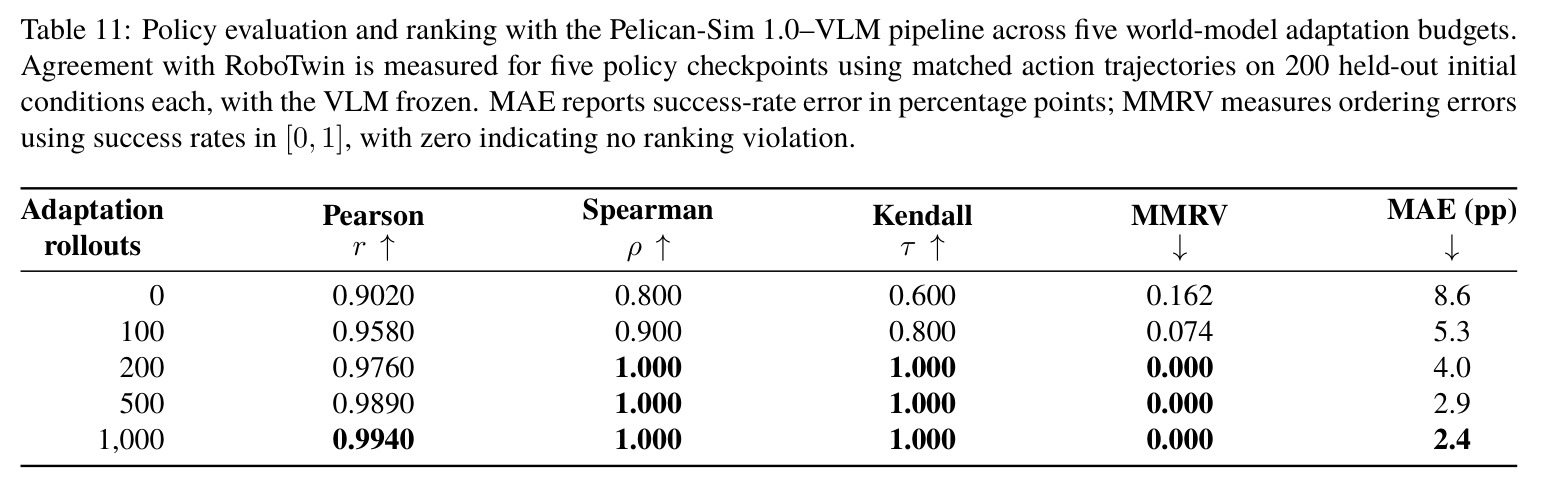
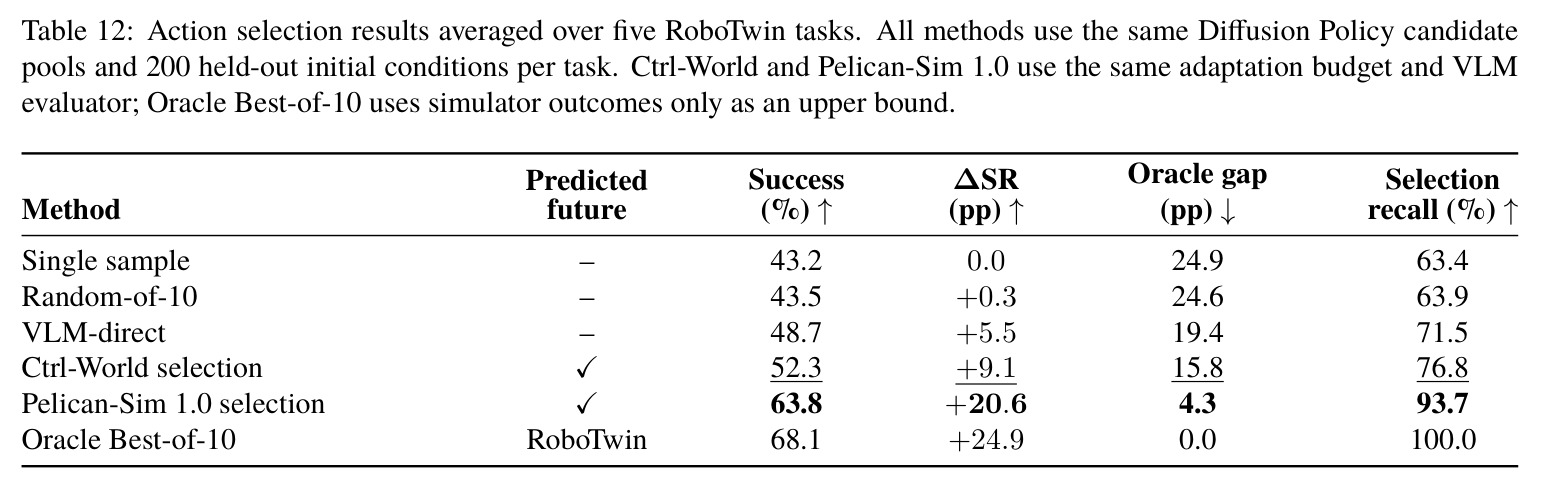
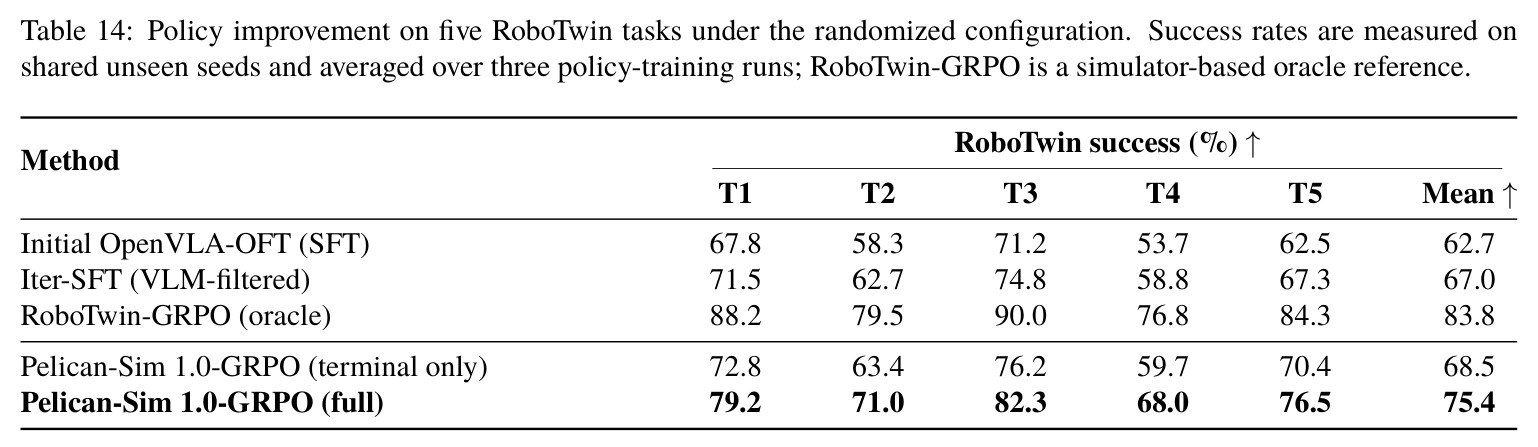
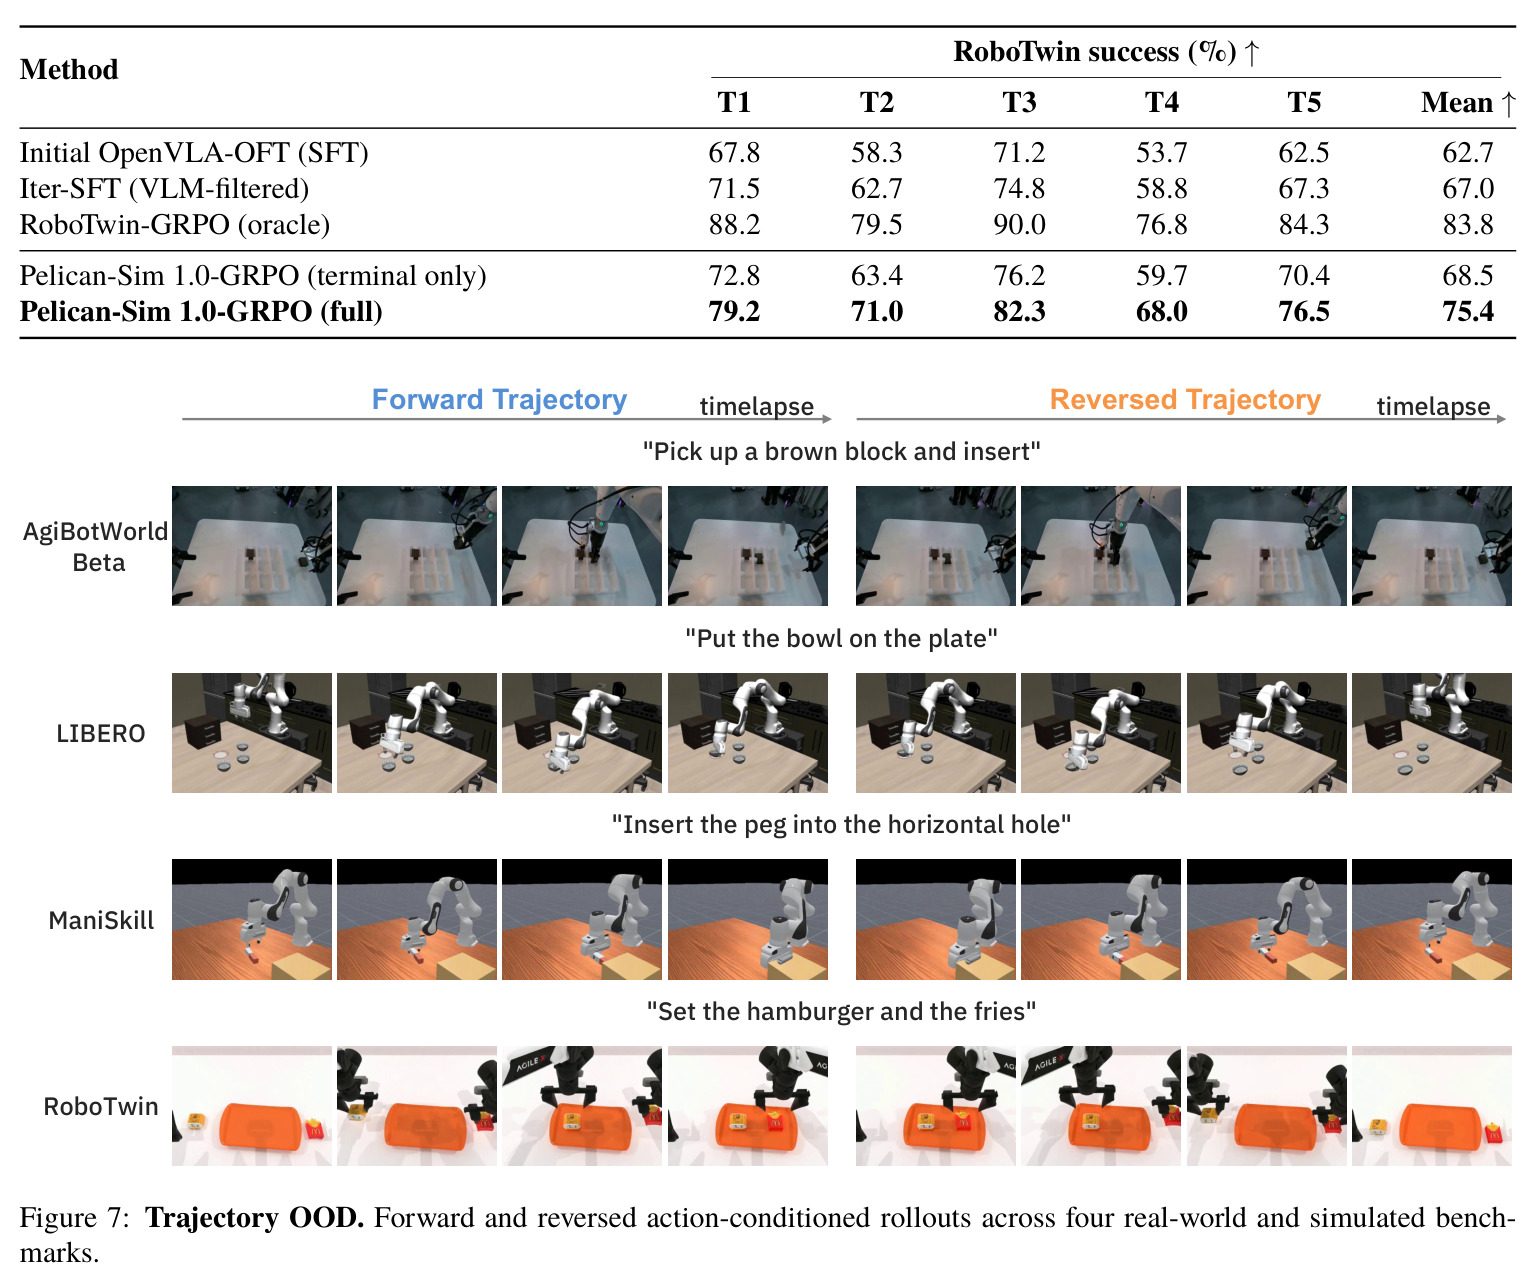
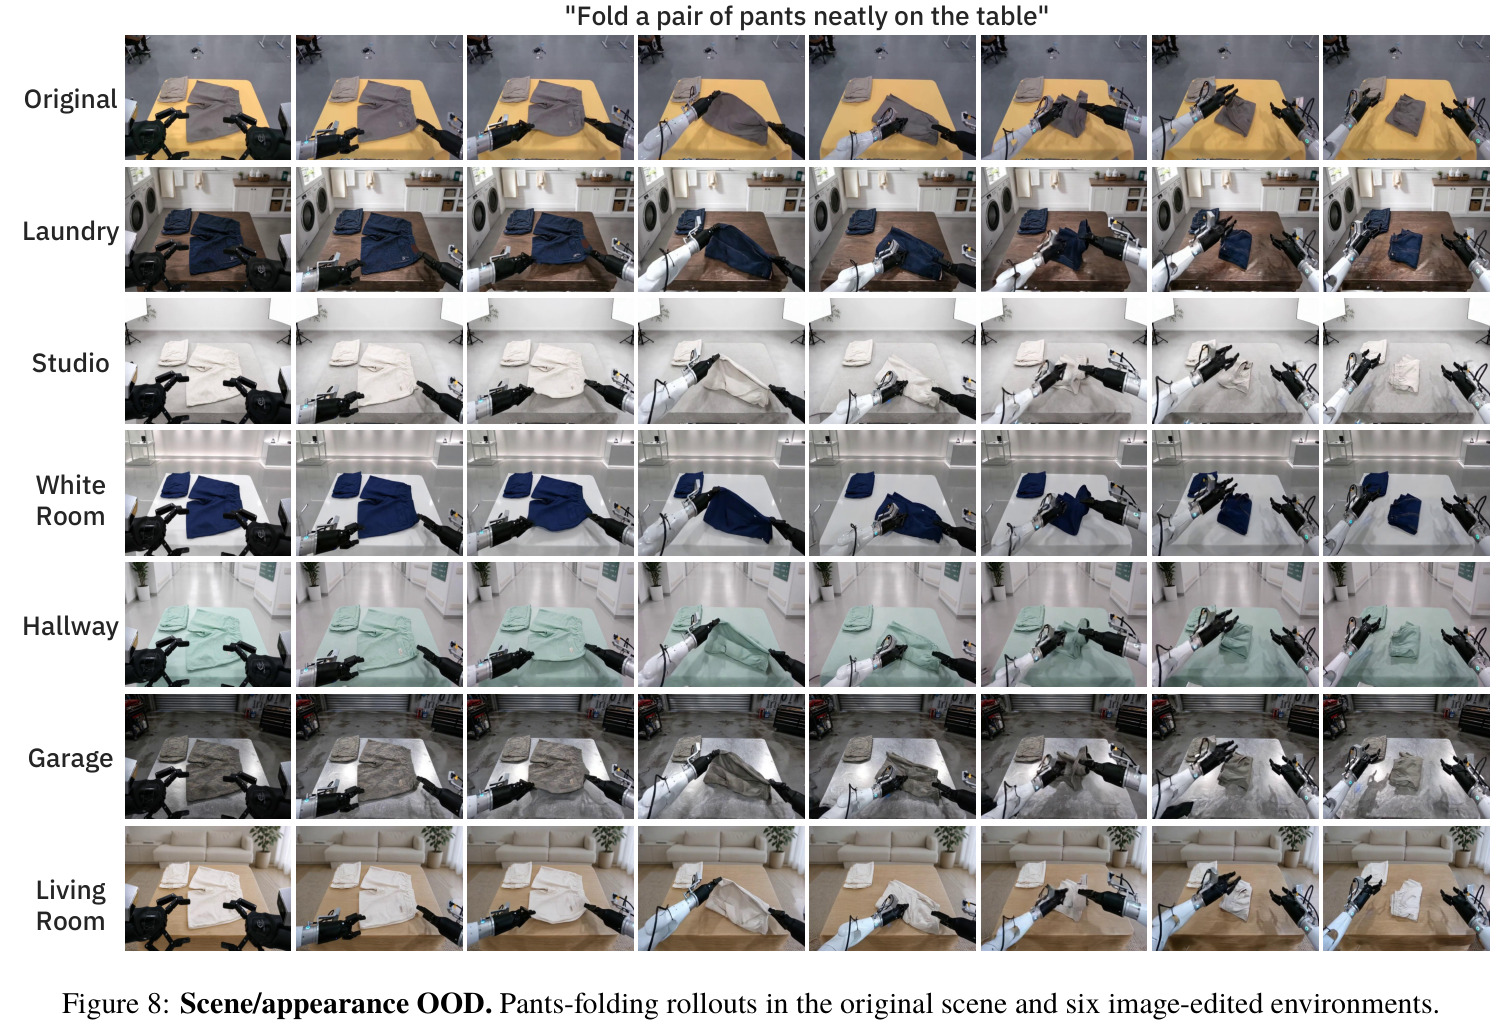
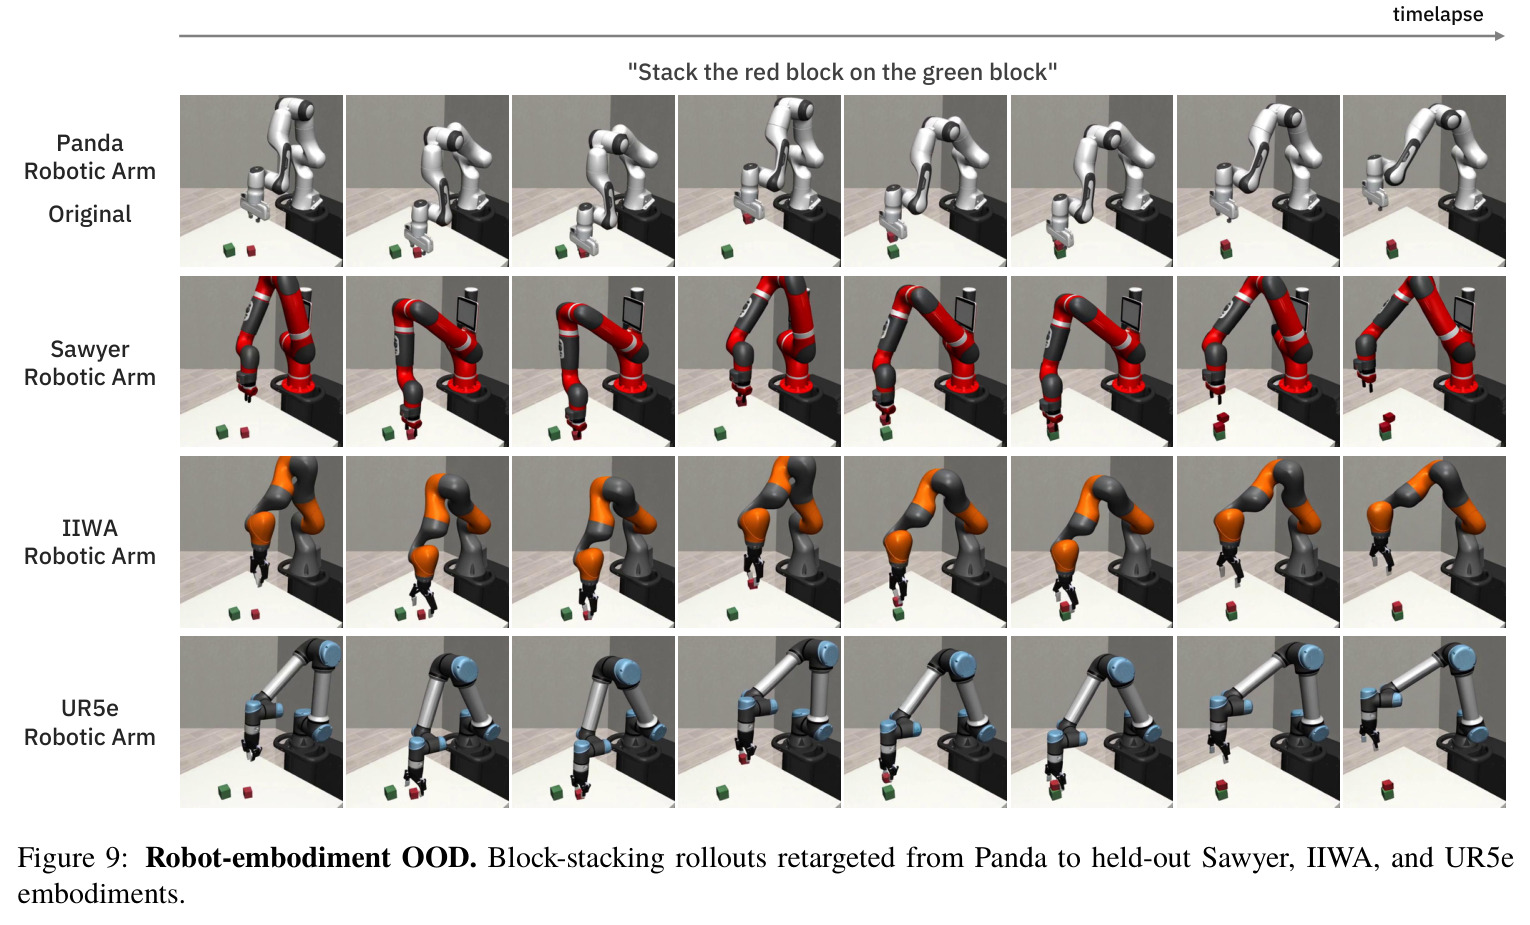
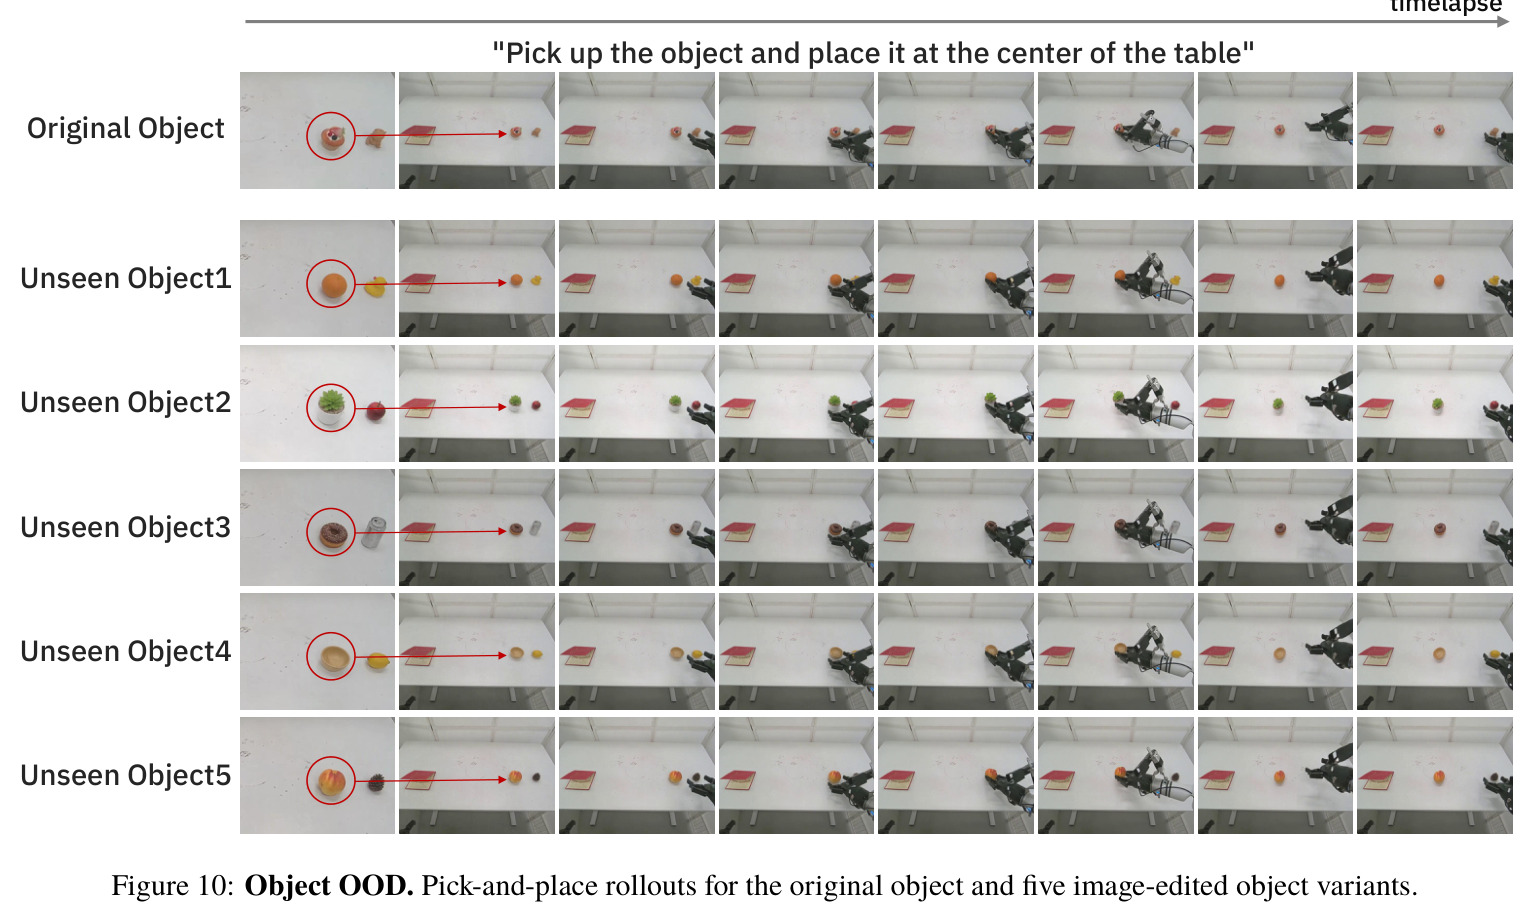
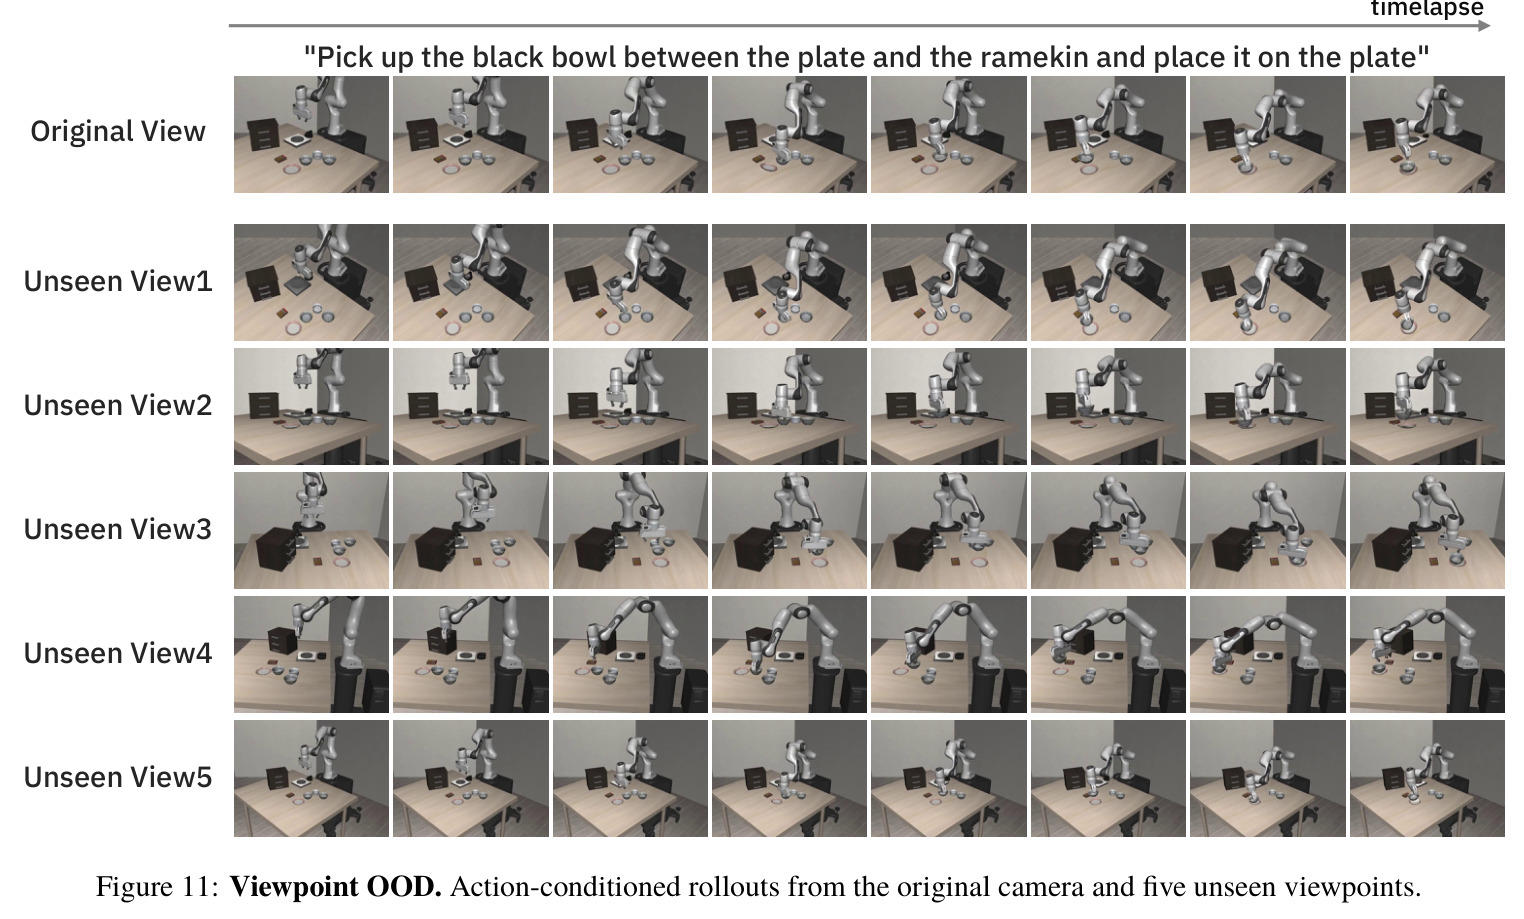
①视频质量(Table 2):三测试集五项指标全部最佳——AgiBotWorld Beta PSNR 22.276(最强基线 17.640,+4.636 dB)、FVD 10.850;RoboMIND PSNR 23.850(+2.080);RoboTwin PSNR 30.383(+10.343)、FVD 26.600→4.980。适配 EWMBench 总分 4.997/4.666/5.044(+0.566/+0.390/+1.073),RoboTwin DYN 0.821(+0.426),HSD、nDTW 等细项部分落后。②消融:混域训练 +0.548 dB、稀疏 MoE 再 +1.214 dB(FVD −6.530);双条件比仅动作视频 +1.000 dB;交错注入比后融合 +0.904 dB。③数据生成:19 秒/条对 RoboTwin 的 55 秒(2.89 倍);50 演示+500 生成轨迹训 π0.5 达 93.0% 对 70.0%;10 演示增强后 64.5% 接近 50 演示的 70.0%。④策略评估:1000 条适配 rollout 下 Pearson r=0.994、MAE 2.4 pp;200 条即完全复现排序。⑤动作选择:63.8% 对单样本 43.2%(相对 +47.7%),距 Oracle 68.1% 仅 4.3 pp。⑥策略改进:75.4% 对 SFT 62.7%(相对 +20.3%),仍低于 oracle 83.8%。⑦OOD:轨迹倒放、场景编辑、未见本体、物体替换、新视角均定性成立。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 动作条件视频预测(AgiBotWorld Beta) | PSNR (dB) | 22.276 | 17.640(EnerVerse-AC,次优) | +4.636 dB |
| 动作条件视频预测(RoboTwin) | FVD | 4.980 | 26.600(Ctrl-World) | −21.620 |
| 动作条件视频预测(RoboMIND) | PSNR (dB) | 23.850 | 21.770(Ctrl-World) | +2.080 dB |
| 少样本数据增强策略学习(RoboTwin, π0.5) | 任务成功率 | 93.0%(50 演示+500 生成轨迹) | 70.0%(仅 50 条演示) | +23.0 pp |
| 策略评估与排序(5 个 checkpoint,1000 条适配 rollout) | Pearson r / MAE | 0.994 / 2.4 pp | 0.902 / 8.6 pp(0 条适配 rollout) | r +0.092,MAE −6.2 pp,200 条即完全复现排序 |
| Best-of-10 动作选择(RoboTwin 五任务) | 成功率 | 63.8% | 43.2%(单样本)/ 52.3%(Ctrl-World 选择) | +20.6 pp(相对 +47.7%)/ +11.5 pp |
| 闭环想象 GRPO 策略改进 | 平均成功率 | 75.4% | 62.7%(初始 SFT) | +12.7 pp(相对 +20.3%) |
| 轨迹生成效率(对 RoboTwin 仿真器) | 每条轨迹耗时 | 19 s(189.5 条/小时) | 55 s(65.5 条/小时) | 2.89 倍吞吐 |
局限与改进
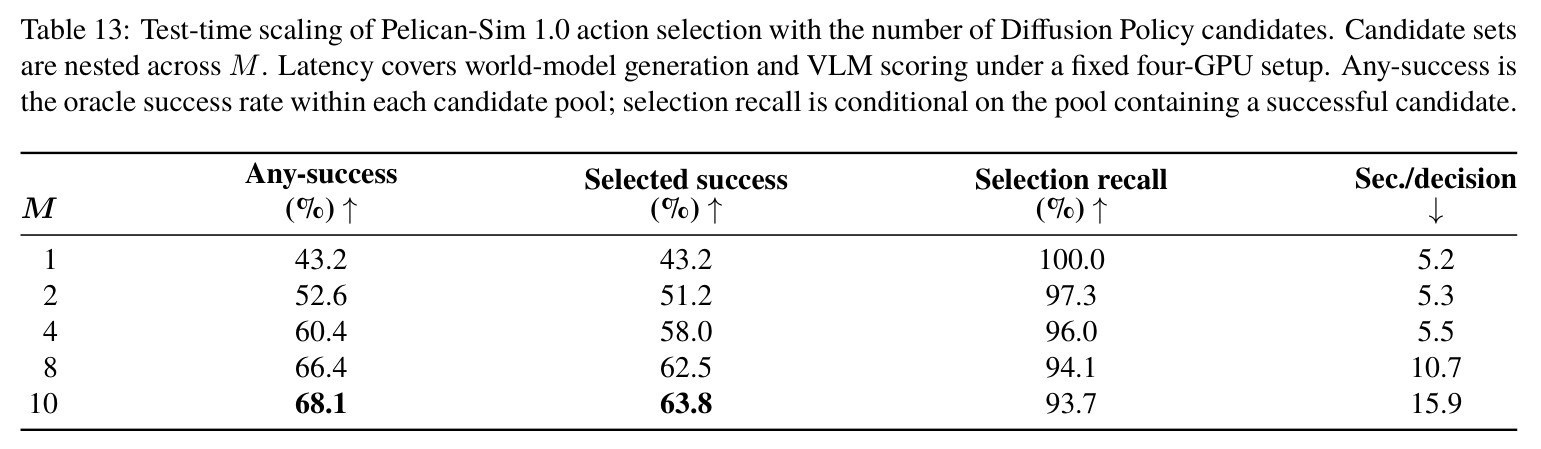
作者承认或暗示的局限:评测切分是各源数据内部 90%/5%/5% 划分而非完全未见的数据集;适配 EWMBench 部分细项落后——RoboMIND 的 HSD(0.838 对 Ctrl-World 0.938)与 nDTW(0.810 对 0.853),以及部分数据集的 SceneC 与 Diversity;混合域训练收益混杂了语料规模增长效应,作者自己注明这并非纯粹的域组合效果;骨架条件只是软引导,不对生成的 RGB 施加硬运动学约束;接触丰富动力学也不假设严格时间可逆。我的补充观察:下游四类应用全部只在 RoboTwin 五个仿真任务上验证,结论外推有限;动作选择在 M=10 时延迟 15.9 秒/决策且召回降到 93.7%,难以实时闭环使用;VLM 评估器在生成视频上精度 91.4% 低于真实视频的 92.6%,该误差会传递给策略评估与奖励信号;策略改进仍比仿真 oracle 低 8.4 pp,说明想象与现实的差距尚未消除;所有实验固定在 480×640 分辨率、93 帧规格,未报告变长、变分辨率表现。
独立分析的弱点
①想象误差累积:闭环 GRPO 完全依赖自回归想象 rollout,长时程误差会漂移,最终比 oracle 低 8.4 pp——可引入周期性真实观测校正,或按评估器不确定性自适应截断 rollout。②评估器是单点瓶颈:Qwen3-VL-2B 仅采样 16 帧,可能漏掉短暂的接触失败瞬间,且在生成视频上精度下降——可用自适应关键帧采样,或对真实/生成视频做域对齐训练缩小判定偏差。③动作选择开销大:每决策最高 15.9 秒,且候选变多召回反而下降(100%→93.7%)——可级联早停(低置信才扩充候选),或蒸馏出跳过视频生成的直接打分头。④28 维布局扩展性差:自由度多于 7 的手臂或更高自由度灵巧手会溢出维度,只能靠零填充浪费容量——可改成本体条件化的可变长动作嵌入加布局描述符。⑤下游验证域窄:四类应用只在 RoboTwin 仿真五任务上进行,真实机器人闭环、长时程多阶段任务均未验证——应在真实平台与更难任务序列上重复 Table 12/14 的实验再下通用性结论。
未来方向
作者提出三个方向:其一,扩充语料覆盖更多本体、物体交互、传感条件与长时程行为,并系统研究这种覆盖对跨域迁移的影响;其二,精确刻画因果适配与少步蒸馏的质量-效率权衡,特别是对细粒度动力学、rollout 稳定性与泛化的影响,探索自适应计算和混合师生推理来降低延迟;其三,建立能区分“源内预测”与“显式分布偏移下迁移”的评测协议,用感知保真、动作一致性、物理合理性与下游效用综合度量通用性。在此之上可以延伸:把 Pelican-Sim 作为 Pelican-Unify 系列的仿真模块做端到端闭环验证;把五个定性 OOD 实验升级为带量化指标的公开 benchmark;在真实机器人上测试想象 rollout 训练的 sim-to-real 迁移效果;以及引入深度、点云等 3D 先验来改善接触动力学与物理合理性建模。
复现评估
作者承诺开源模型 checkpoint 与推理代码(GitHub: Open-X-Humanoid/Pelican-Sim1.0)。训练语料大部分为公开数据集(AgiBotWorld Beta、RoboMIND、LIBERO、ManiSkill2、RoboTwin、RoboCasa),RealSource World 的可得性未明确;数据清洗依赖 VLM 校验、自动对齐重渲染与人工把关,流程细节较难完全复刻。算力门槛高:32 张 NVIDIA B200、500K 迭代、全局 batch 32,属工业级配置;VLM 评估器还需三人标注 700 条视频(多数投票)加任务检查单设计;蒸馏是多阶段流程(因果教师→4 步学生→DMD self-forcing),超参敏感。相对而言,推理与下游应用复现可行性好:4 步因果模型 21 帧仅 2.2 秒,动作选择单决策 5.2-15.9 秒(4 GPU),RoboTwin 仿真器开源易得。总体评估:复现推理与数据生成属中等难度,从头完整复现训练是大厂级工程。
论文图表
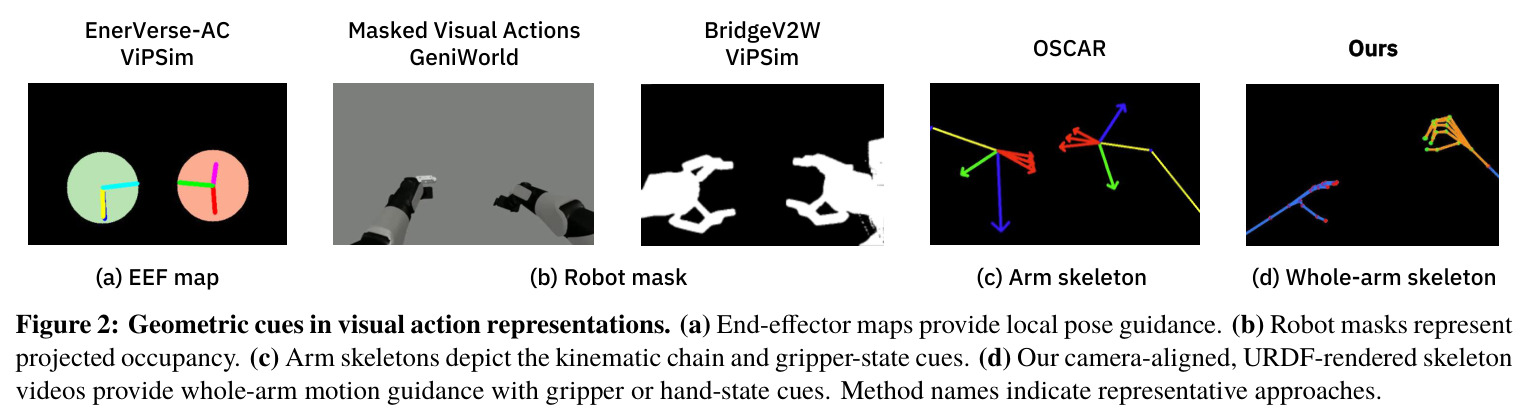
对比四类视觉动作条件携带的几何线索:(a)末端执行器图仅提供局部位姿、整臂欠约束;(b)机器人掩码只编码投影占据;(c)手臂骨架显示运动链与夹爪状态;(d)本文的相机对齐URDF整臂骨架视频同时提供整臂运动引导和夹爪/手部状态线索。
直观解释了为什么现有视觉动作条件不充分、本文为何要渲染整臂骨架视频,是动机论证的核心插图。
AgiBotWorld Beta(平行夹爪与灵巧手任务)、LIBERO、ManiSkill任务上的三行对比:预测(Pred)、动作视频条件(AC)、真值(GT),时间从左到右推进。
定性展示模型跨数据源、跨本体、跨夹爪类型都能紧密跟随指令轨迹并保持时间连贯性。
RealSource World叠杯子、RoboCasa炉台到台面移物、RoboMIND擦桌布、RoboTwin抓马克杯等任务的Pred/AC/GT三行定性对比。
与Figure 5共同覆盖全部训练数据源的定性证据,补充真实与仿真混合域上的生成质量展示。