ActionSplice:交互式世界模型的采样中途动作编辑 ActionSplice: In-Flight Action Editing for Interactive World Models
轻量校正器把被打断的采样状态即时传输到新动作轨迹,无需回滚即可让动作编辑当场生效
前置知识
块自回归世界模型
将交互式视频生成切分为"块"的模型:在一个动作条件下生成 $T$ 个潜帧组成的 chunk,再用 $K$ 步扩散求解器逐步去噪后才展示给用户,块与块之间自回归衔接。动作在一个 chunk 内保持固定,因此控制变化的频率被限制在块的生成速率上。
本文要解决的核心矛盾正发生在块内:新动作在 chunk 采样中途到达时,现有系统默认只能等下一个块才能响应,或付出回滚重算的代价。
可恢复求解器状态
扩散采样在第 $r$ 步留下的内部表示:对 minWM 是缓存的干净预测 $x_r$(需配合存储的转移噪声经原生调度器重建 $z_r$),对 HY-WM1.5 是确定性 Euler 求解器状态 $z_r$。拿到它就能从第 $r$ 步继续跑剩余的 $K-r$ 步而无需从头开始。
ActionSplice 校正的对象正是这种 backbone 原生的可恢复状态,能否正确插入并续算是整个方法成立的技术前提。
匹配反事实回滚
训练目标 $s_r^\star$ 的构造方式:从相同的初始状态、已提交历史、求解调度和随机输入出发,仅把动作换成修订后的 $a^+$,重放前 $r$ 步求解评估,得到"如果一开始就用新动作,第 $r$ 步本应是什么状态"。CSTT 版本还会在每次重放后把时间前缀 $0..m-1$ 钳制回源分支的值。
这是全文监督信号的核心:校正器学习的正是从被旧动作塑形的 $s_r^-$ 到反事实目标 $s_r^\star$ 的残差传输,回滚只在训练与评估时执行、推理时绝不运行。
LPIPS 与 PSNR
LPIPS 基于深度特征衡量感知差异,越低越相似;PSNR 是像素级峰值信噪比,越高失真越小。本文用它们衡量校正后的活动 chunk 与"完全回滚重算"这一反事实参考之间的保真度,并辅以 SSIM、边界误差和相机轨迹误差 Rdist/Tdist。
论文的主要量化结论(如 LPIPS 相对条件交换降低 61.5% 和 75.9%)都以这些指标给出,理解指标定义才能读懂实验对比。
FiLM 条件化
Feature-wise Linear Modulation:用辅助嵌入(如时间步、控制量)通过逐通道仿射变换 $\gamma \odot h + \beta$ 调制网络隐层特征,让同一网络感知不同条件输入,广泛用于扩散模型的时间步注入。
ActionSplice 的校正器用 FiLM 把相机控制嵌入和求解步嵌入注入六块残差 3D 编解码器,是理解其网络设计的关键。
掩码残差预测
校正器不直接输出新状态,而是预测残差并用时间掩码逐元素筛选:$\hat{s}_r = s_r^- + M_m \odot C_{\phi_q}(I_r, M_m)$。掩码外的坐标被硬性保留为零修改,且掩码在通道与空间维上广播。
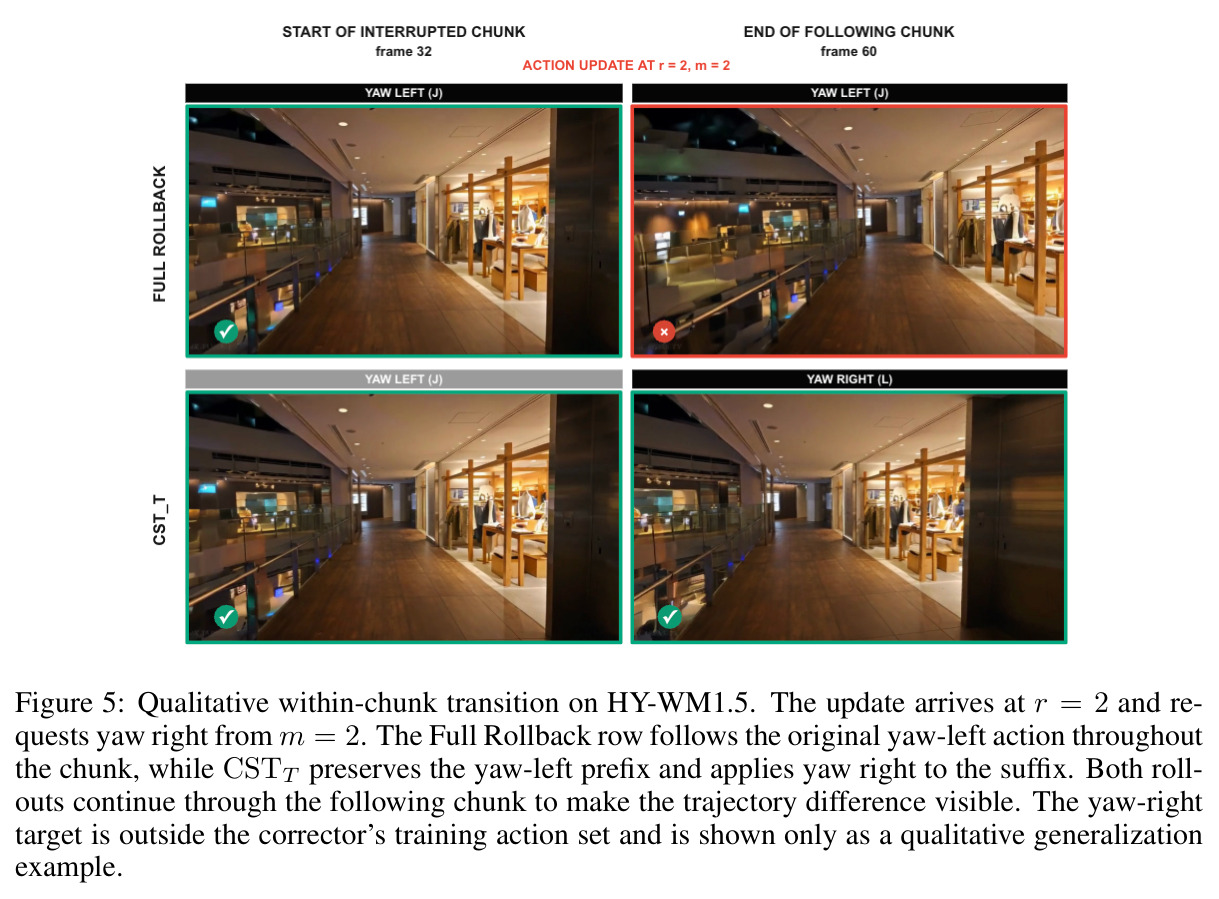
CSTT 变体完全依赖这个机制保证时间前缀严格不变,是"块内时间拼接"能成立的结构性保证而非软约束。
研究动机
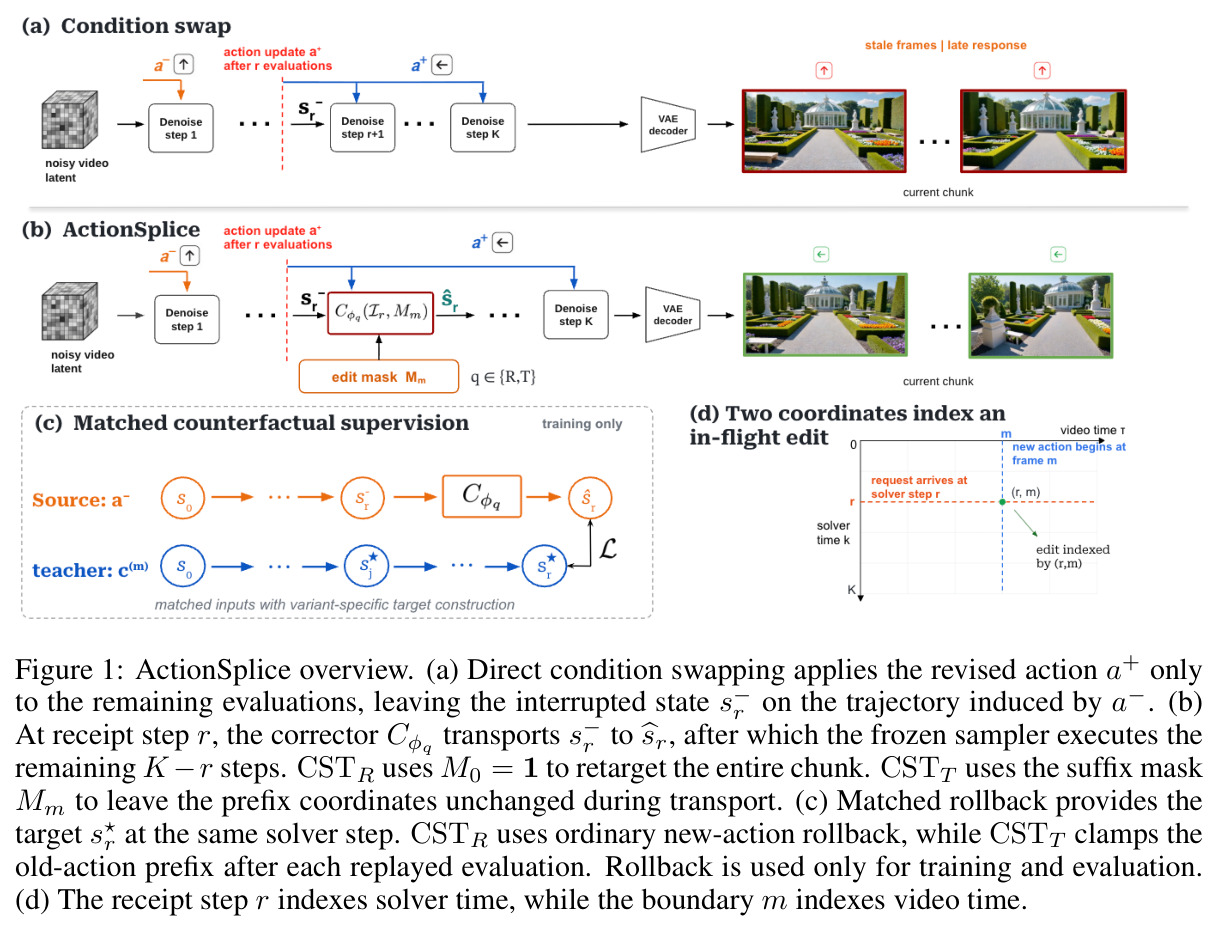
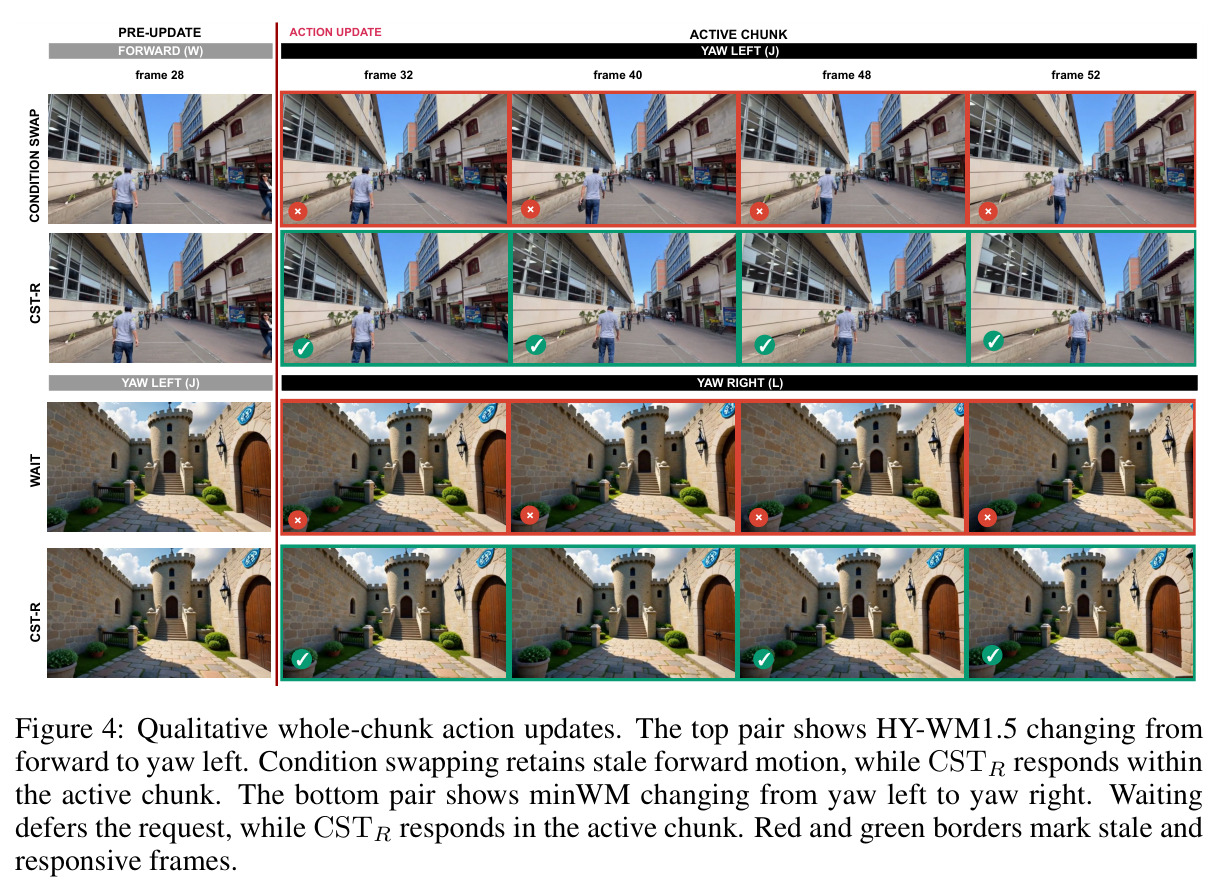
块自回归视频世界模型在单个动作下生成若干潜帧,用 $K$ 步求解器去噪后才显示。当新动作在求解第 $r$ 步之后才到达时,现有系统只有三个都很糟糕的选择。其一是等待下一个块:能保住轨迹但响应延迟巨大——实测 minWM 像素就绪延迟 6815.0 ms、HY-WM1.5 高达 11711.2 ms,且控制变化频率被限制在块的粒度。其二是直接条件交换:把新动作喂给剩余评估,但活动状态 $s_r^-$ 仍留在旧动作轨迹上,产生"陈旧帧"——HY-WM1.5 上它相对回滚参考的 LPIPS 为 0.3446,人类评测中动作遵循率只有 84.2%、平均 8.89 个陈旧帧。其三是完全回滚:从第 0 步在新动作下重放,能精确到达反事实状态 $s_r^\star$,却要重复已完成的 $r$ 次骨干评估——HY-WM1.5 像素就绪延迟 8706.8 ms,仅比等待快 1.34×。本质障碍是状态错位:中断时刻的状态已被旧动作塑形,任何"只改条件不改状态"的方案都无法消除这种惯性。
本文的目标是本文研究并追求"可中断性"(interruptibility):把采样中途到达的动作并入正在生成的活动 chunk,同时保留已完成的计算和已提交的历史。作者把这个目标形式化为四条硬性要求:(1) 编辑必须停留在当前求解步 $r$,即产出的状态要与完全回滚在第 $r$ 步到达的 $s_r^\star$ 对齐;(2) 必须保留不可编辑的已提交历史部分;(3) 修订后的动作必须在活动 chunk 内可见,而不是推迟到下一个块;(4) 不允许重放已完成的 $r$ 次求解评估。理想情况是推理时只需一次轻量校正加 $K-r$ 次骨干评估,就能同时逼近完全回滚的保真度和条件交换的速度。论文还要求该机制在世界模型与采样器完全冻结的前提下即插即用,并支持两种时间粒度:整块重定向(CSTR,服务用户/规划器的异步动作修订)与块内指定边界的动作切换(CSTT,服务定时动作转换)。
与已有工作不同的是,已有工作都没有估计"修订动作在当前求解步会诱导出什么状态"。交互条件变化一类(Delta Forcing 的信任域转向、Echo-Forcing 的场景记忆、LongLive 的缓存刷新、Anchor Forcing 的锚点记忆、Visko Orbis 的实时提示更新)修改的都是未来条件或注意力记忆,活动求解状态仍停留在旧轨迹上。推理复用加速一类(TeaCache、Pyramid Attention Broadcast、Sparse VideoGen、X-Cache、C3ache、Chorus)复用的是条件不变时才有效的计算,动作一变这些缓存就失效。可修正去噪一类(Diffusion Forcing、Diffusion ReRoll、SDEdit、EDICT、Layered Diffusion Brushes、FateZero)通过重加噪、反演或中间潜变量缓存来修改内容,但不估计冻结世界模型中同步骤的反事实求解状态。ActionSplice 的独特切入是把问题命名为反事实状态传输(CST),明确拒绝共享潜空间假设,在每个骨干各自的可恢复状态空间内定义同一反事实干预,并用匹配回滚对来学习同步骤校正,让采样在不重放的情况下直接续算。
核心方法
直觉:中断时刻的状态 $s_r^-$ 在旧动作轨迹上,而"有用的目标"是完全回滚在同一求解步会到达的状态 $s_r^\star$。既然回滚只在训练与评估时执行,就可以离线构造大量 $(s_r^-, s_r^\star)$ 配对,训练一个轻量校正器在同一步内把前者推向后者。技术路线上,校正器 $C_{\phi_q}$ 接收中断上下文 $I_r$(被打断状态、初始状态、已提交历史、新旧动作条件、保留的采样器信息)和时间掩码 $M_m$,预测掩码残差:$\hat{s}_r = s_r^- + M_m \odot C_{\phi_q}(I_r, M_m)$(式 2)。修正后的表示被插回合法求解器状态:minWM 校正的是干净预测 $\hat{x}_r$,用存储的转移噪声经原生调度器重建 $z_r$;HY-WM1.5 直接校正 Euler 状态 $\hat{z}_r$,无需重建。随后失效动作相关的临时缓存、保留历史缓存,在新控制调度 $c(m)$ 下续算剩余 $K-r$ 步。两个变体:CSTR 取 $m=0$、$M_0=1$ 重定向整块;CSTT 对 $\tau \geq m$ 的后缀施加新动作、前缀严格保留。推理开销为一次校正器评估加 $K-r$ 次骨干评估,而完全回滚需要 $K$ 次骨干评估。
核心创新是把采样中途动作编辑表述为可恢复求解器状态之间的匹配反事实传输(Counterfactual State Transport, CST)。与条件交换的本质区别在于:交换只改后续评估的条件、状态本身不动,新动作要靠剩余步骤慢慢"拽"过来;CST 则直接估计并跳到新动作在同一步诱导的状态。监督设计是灵魂——匹配的源分支与教师分支共享提示、初始状态、历史、求解调度、到达步和随机输入,唯一差异是施加的动作调度,从而把动作更新引起的状态变化隔离成干净的回归目标。CST 不假设共享潜空间、不在模型间迁移权重,而是为每个骨干、每个变体单独训练校正器:minWM 用干净预测传输,HY-WM1.5 用 Euler 状态传输。CSTT 的硬输出掩码使前缀修正恒为零($s_r^\star[\tau] = s_r^-[\tau],\ \tau < m$),让前缀保留成为结构保证而非软约束。递归训练还让校正器见到自己修正后产生的历史,缩小训练与循环推理的分布差距。全程世界模型与采样器冻结,只有校正器被训练。
方法步骤详情
训练数据:150 个场景提示(120 训练 / 30 留出),每提示固定种子。CSTR 每条递归轨迹含 3 次中断、4 个动作段(共 48-64 潜帧),得 360 训练 / 90 留出捕获;CSTT 在边界 $m \in \{1,2,3\}$ 上均衡,同样 360/90;六种前向/后向/左转定向切换均衡。网络:每个骨干 × 变体一个六块残差 3D 编解码器,FiLM 注入相机控制与求解步嵌入,CSTT 额外接收掩码 $M_m$。损失:传输损失 $\mathcal{L}_{tr} = \mathrm{NMSE}_M(\Delta s_r^c, \Delta s_r^\star)$,其中 $\mathrm{NMSE}_M(u,v) = \frac{\|M \odot (u-v)\|_2^2 / N_M}{\max(\|M \odot v\|_2^2 / N_M, \epsilon)}$;CSTT 加边界项得 $\mathcal{L} = \mathcal{L}_{tr} + \lambda_{mid}\mathcal{L}_{mid}$(式 5),辅以解码 LPIPS、时间与边界项(权重 0.05/0.1/0.1)。优化:AdamW 4000 步,batch size 1,权重衰减 $10^{-4}$,梯度裁剪 1.0,学习率余弦 $10^{-5} \to 10^{-6}$,EMA 衰减 0.999,选留出传输 NMSE 最低的检查点。推理:动作在第 $r$ 步后到达 → 组装上下文 $I_r$ → 校正器一次前向得 $\hat{s}_r$ → 插回求解状态(minWM 用转移噪声重建 $z_r$,HY-WM1.5 直接用)→ 失效动作临时缓存 → 以 $c(m)$ 续算 $K-r$ 步出帧。
技术新颖性
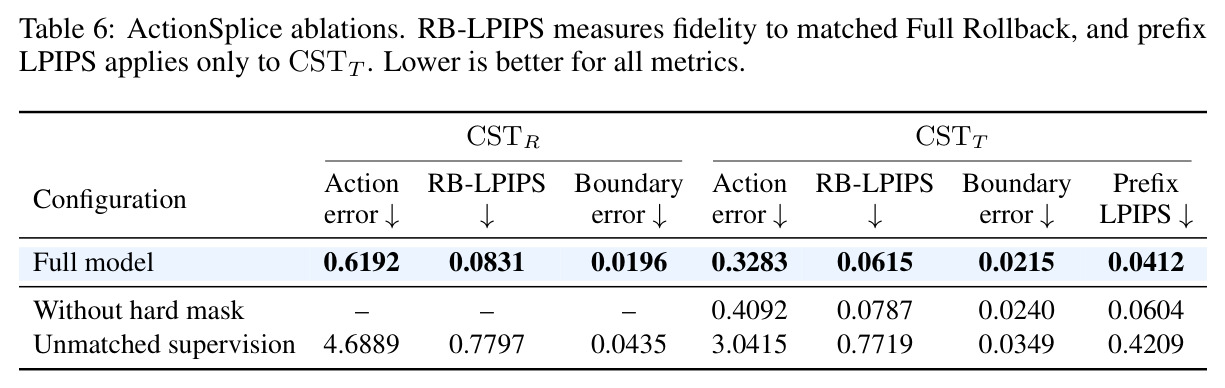
技术新颖性有四点。第一,问题级:首次把"采样中途动作编辑"定义成同步骤反事实状态估计问题,此前的方法要么推迟动作(等待)、要么只换条件(交换)、要么付出重复计算(回滚),没有人估计"修订动作此刻应诱导的状态"。第二,机制级:不学新世界模型、不改采样器,只学一个残差校正器,且针对每个骨干的原生传输表示分别定义(clean-prediction transport vs Euler solver-state transport),显式拒绝跨模型共享潜空间——这让方法即插即用,代价是每个骨干需重训。第三,结构级:CSTT 用硬输出掩码实现块内时间拼接,把动作切换边界 $m$ 放进活动 chunk 内部,控制粒度首次细于"一块一动作";掩码保证前缀修正恒为零,前缀保真是可证明的结构性质。第四,训练级:匹配反事实监督 + 递归训练的组合经消融验证是性能来源——去掉匹配监督后 CSTR 动作误差从 0.6192 恶化到 4.6889、RB-LPIPS 从 0.0831 升到 0.7797,去掉硬掩码使 CSTT 前缀 LPIPS 从 0.0412 升到 0.0604,证明配对构造和掩码缺一不可,而非架构本身带来收益。
实验结果
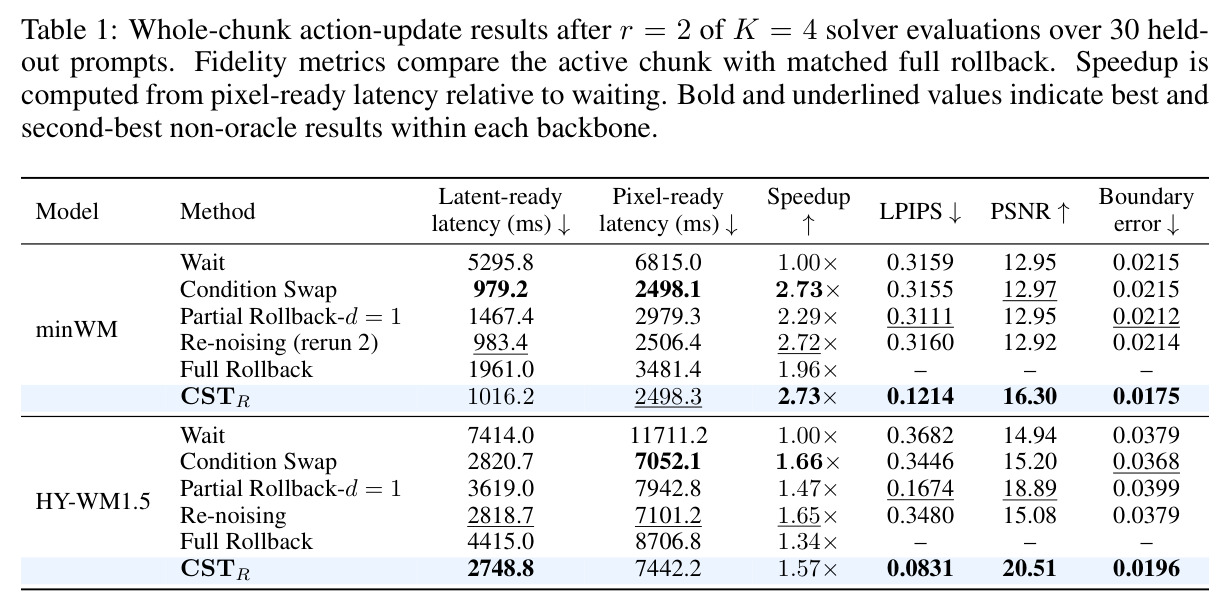
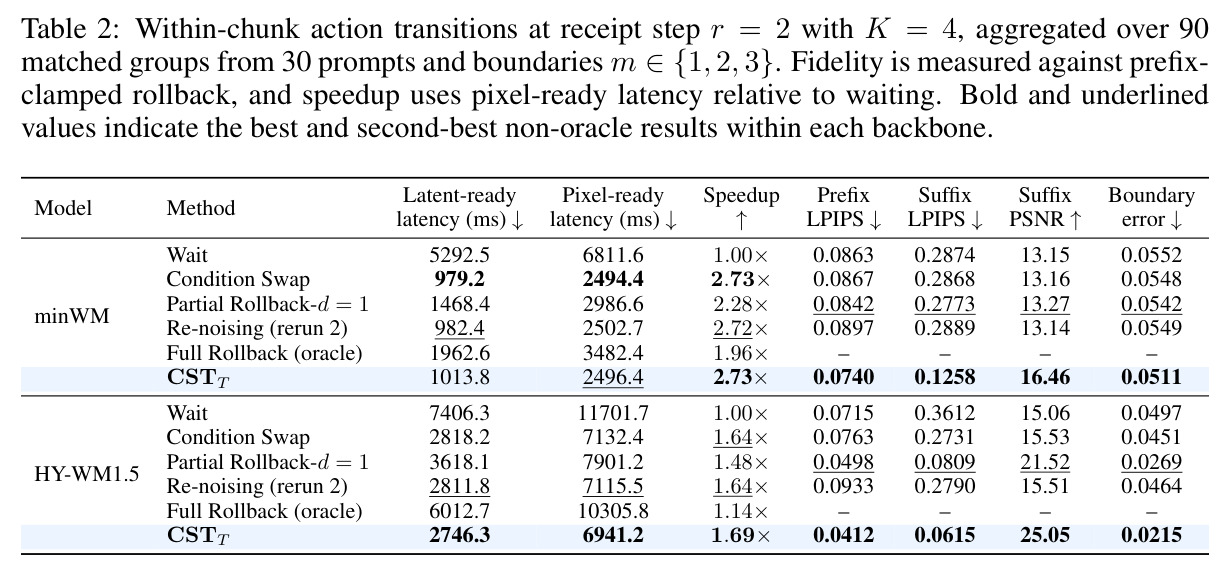
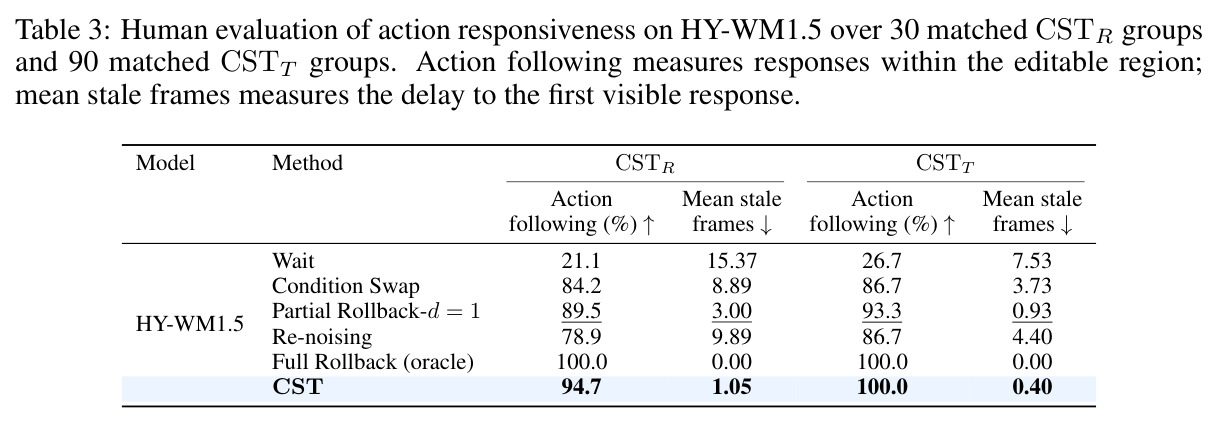
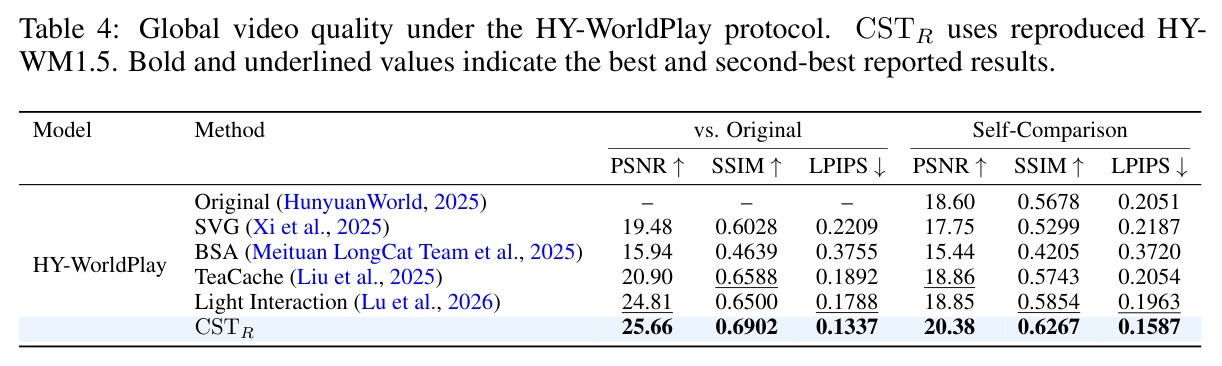
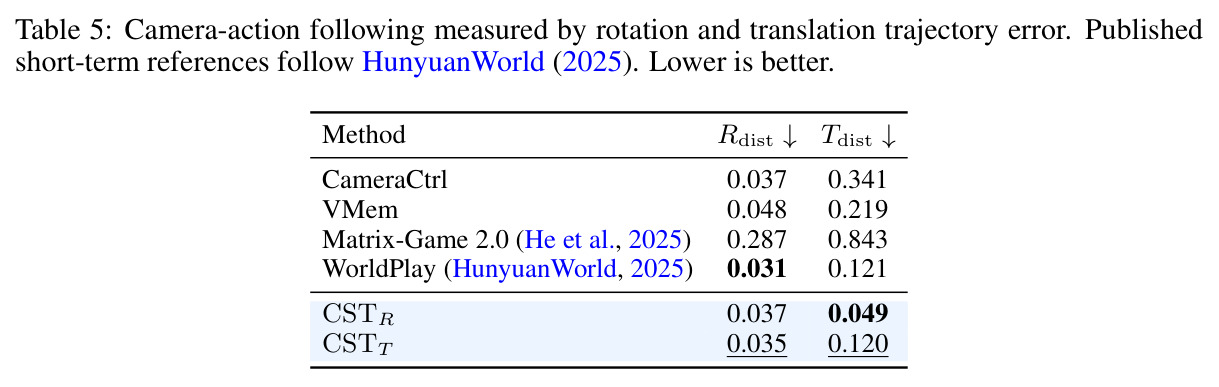
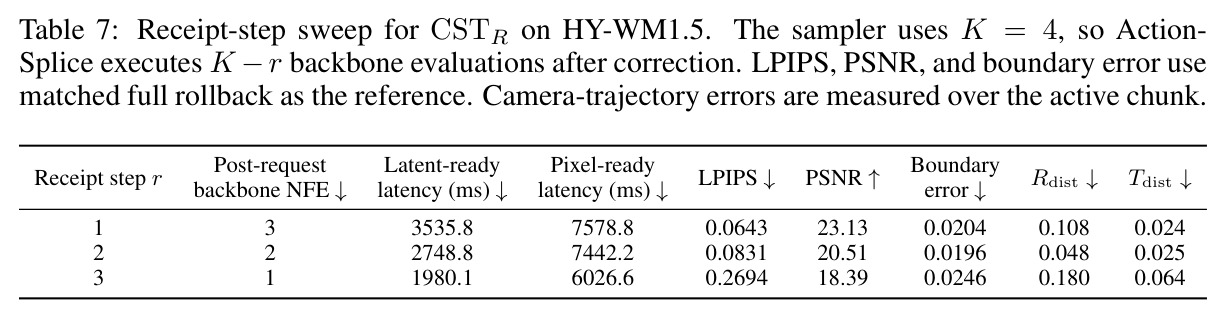
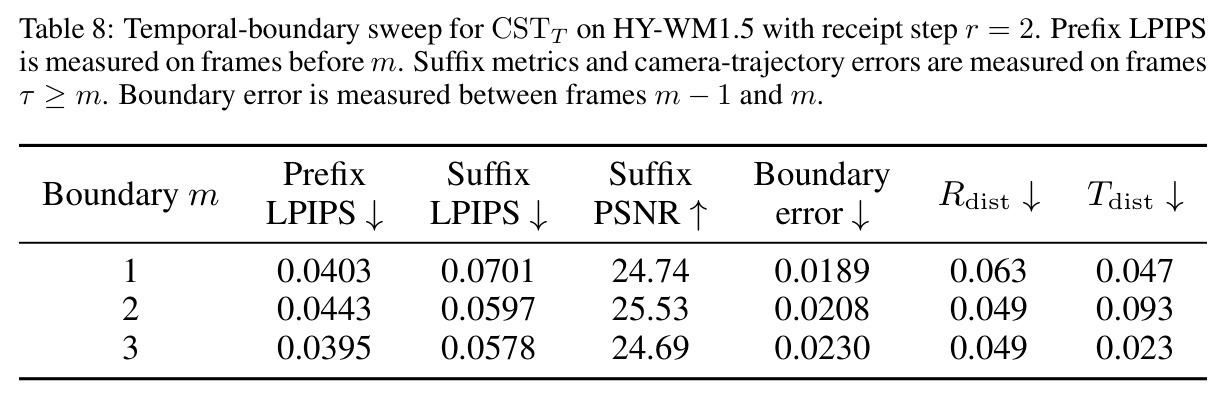
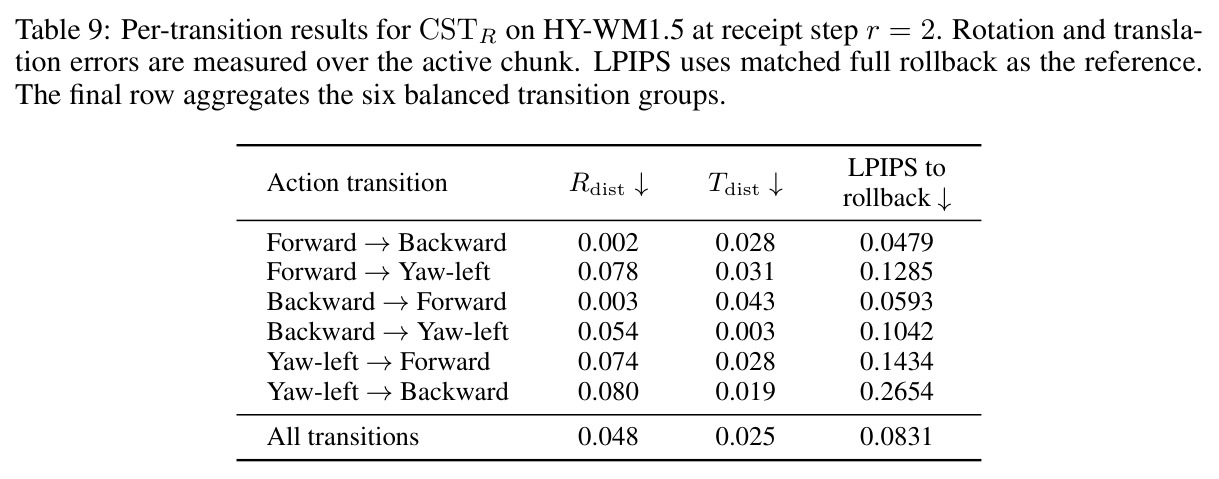
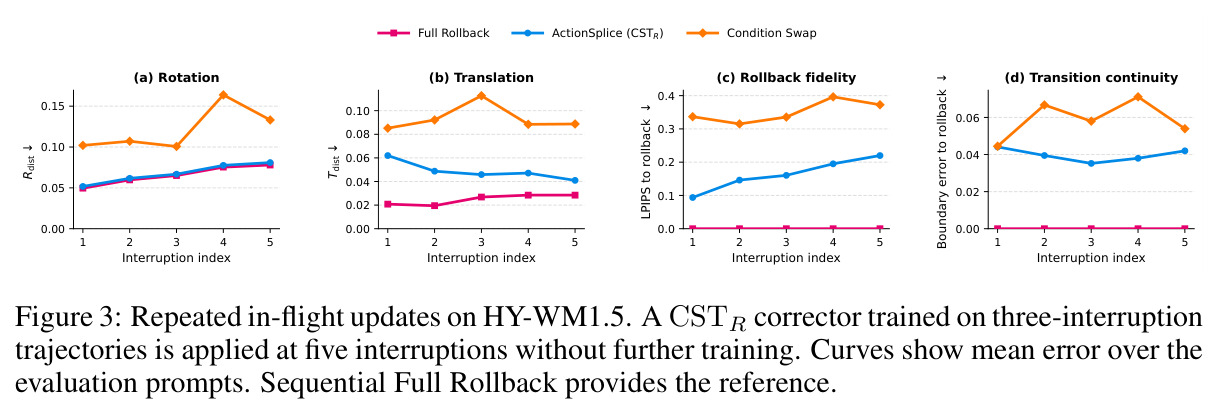
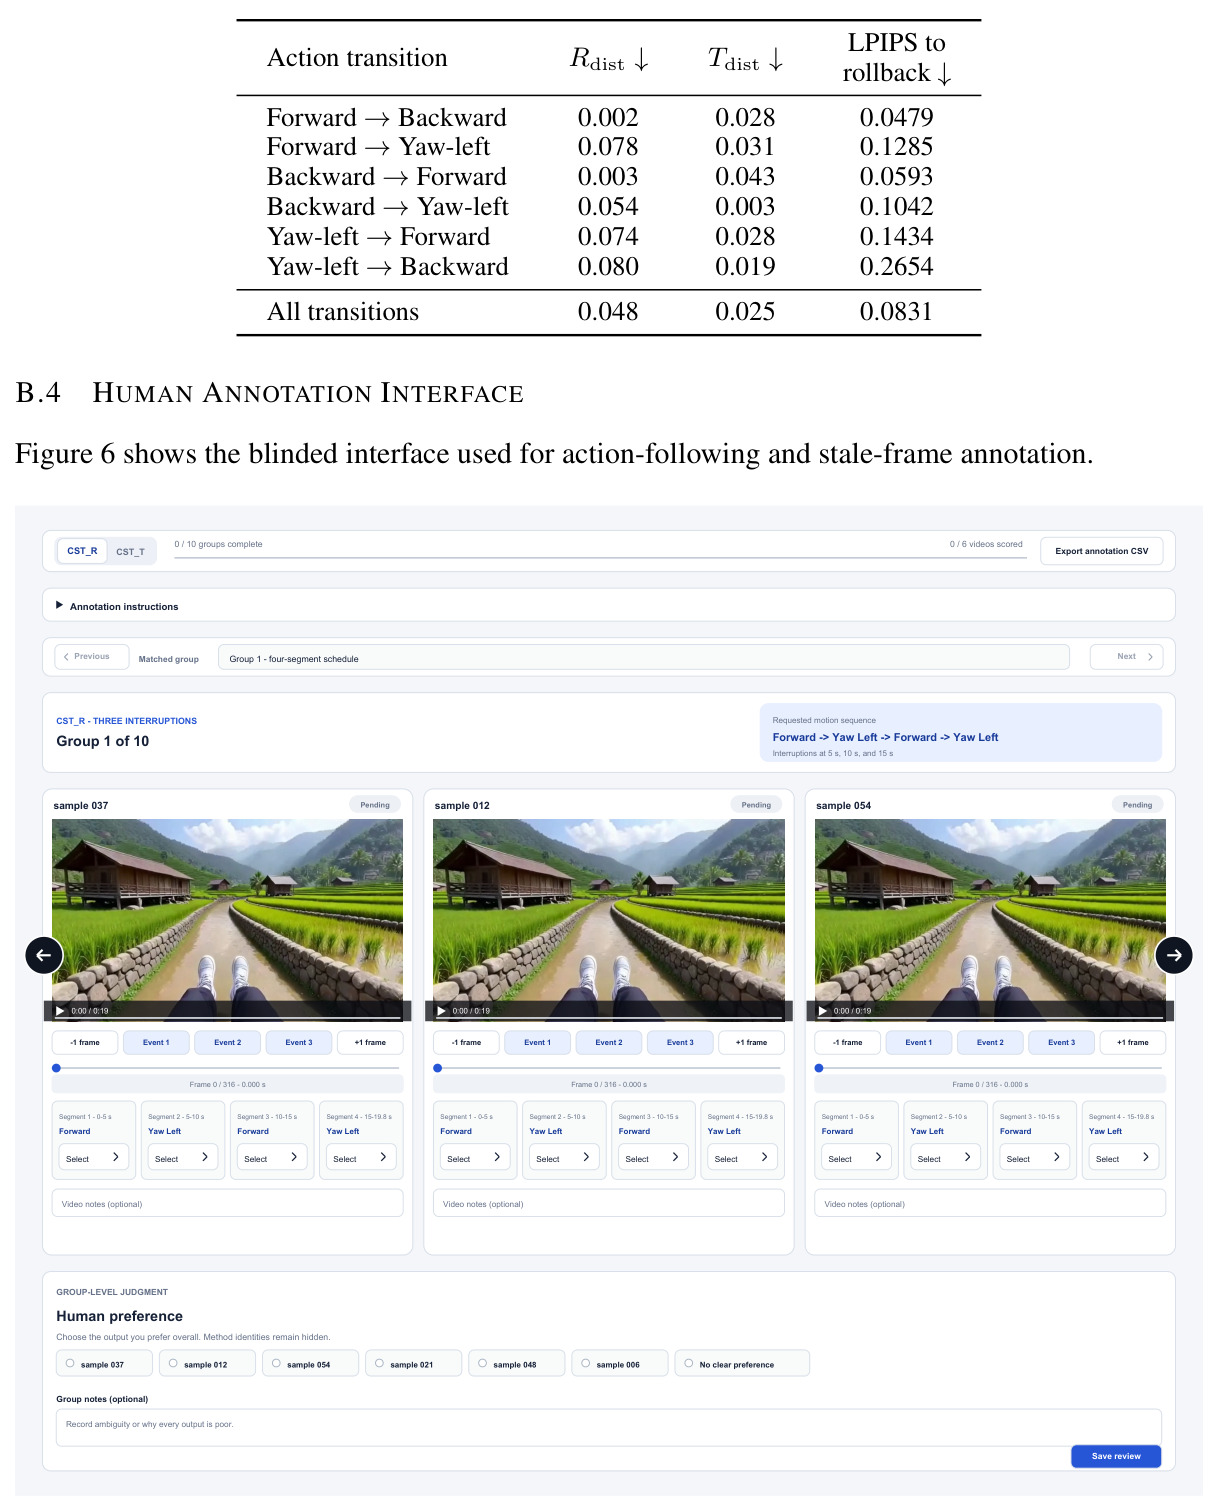
整块更新(Table 1,r=2/K=4,30 留出提示):minWM 上 CSTR 相对匹配回滚的 LPIPS 为 0.1214,比条件交换 0.3155 低 61.5%,PSNR 16.30 dB(+3.33 dB),像素就绪 2498.3 ms 与交换持平(2.73× 于等待),边界误差 0.0175 为非 oracle 最低;HY-WM1.5 上 LPIPS 0.0831(低 75.9%)、PSNR 20.51 dB(+5.31 dB)、1.57× 于等待。块内切换(Table 2,90 匹配组):CSTT 在 minWM 后缀 LPIPS 0.1258(低 56.1%)、后缀 PSNR 16.46 dB(+3.30 dB)、前缀 LPIPS 0.0740 最佳、2.73×;HY-WM1.5 后缀 LPIPS 0.0615(低 77.5%)、后缀 PSNR 25.05 dB(+9.52 dB)、1.69×。人类盲评(Table 3):CSTR 遵循率 94.7%、1.05 陈旧帧,CSTT 100%、0.40,近追平 oracle 的 100%/0,条件交换仅 84.2%/8.89。HY-WorldPlay(Table 4):CSTR 取 25.66 PSNR、0.6902 SSIM、0.1337 LPIPS,全面超过 Light Interaction 的 24.81/0.6500/0.1788。相机跟随(Table 5):CSTR Rdist 0.037、Tdist 0.049(后者远优于 WorldPlay 的 0.121)。消融(Table 6):去匹配监督使 CSTR 动作误差 0.6192→4.6889;去硬掩码使 CSTT 前缀 LPIPS 0.0412→0.0604。敏感性:r=3 时 LPIPS 恶化到 0.2694(Table 7);$m \in \{1,2,3\}$ 性能相当(Table 8);Yaw-left→Backward 最难(LPIPS 0.2654,Table 9)。图 3 证明五次连续中断(训练仅见三次)下误差贴近顺序完全回滚、未显著累积。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 整块动作更新保真(minWM–Wan Action2V,r=2/K=4,30 留出提示) | 相对匹配回滚的 LPIPS(中位数) | CSTR 0.1214(PSNR 16.30 dB,像素就绪 2498.3 ms) | 条件交换 0.3155(PSNR 12.97 dB,2498.1 ms) | LPIPS 降低 61.5%,PSNR +3.33 dB,速度与基线持平(2.73× 于等待) |
| 整块动作更新保真(HY-WM1.5) | 相对匹配回滚的 LPIPS | CSTR 0.0831(PSNR 20.51 dB,像素就绪 7442.2 ms) | 条件交换 0.3446(PSNR 15.20 dB,7052.1 ms) | LPIPS 降低 75.9%,PSNR +5.31 dB,像素就绪 1.57× 于等待 |
| 块内动作切换(minWM,m∈{1,2,3},90 匹配组) | 后缀 LPIPS / 前缀 LPIPS | CSTT 0.1258 / 0.0740 | 条件交换 0.2868 / 0.0867 | 后缀 LPIPS 降低 56.1%,后缀 PSNR +3.30 dB,2.73× 于等待 |
| 块内动作切换(HY-WM1.5) | 后缀 LPIPS / 后缀 PSNR | CSTT 0.0615 / 25.05 dB | 条件交换 0.2731 / 15.53 dB | 后缀 LPIPS 降低 77.5%,PSNR +9.52 dB,1.69× 于等待 |
| 动作响应人类盲评(HY-WM1.5) | 动作遵循率 / 平均陈旧帧 | CSTR 94.7% / 1.05;CSTT 100% / 0.40 | 条件交换 84.2% / 8.89(等待仅 21.1% / 15.37) | 接近 oracle(100% / 0.00),陈旧帧减少约 8 倍 |
| HY-WorldPlay 全局视频质量 | PSNR / SSIM / LPIPS(vs 原始 rollout) | CSTR 25.66 / 0.6902 / 0.1337 | 已发表最佳 Light Interaction 24.81 / 0.6500 / 0.1788 | 三项指标均为已报道最佳 |
| 相机-动作轨迹跟随 | Rdist / Tdist(越低越好) | CSTR 0.037 / 0.049;CSTT 0.035 / 0.120 | WorldPlay 0.031 / 0.121 | Tdist 显著更优(0.049 vs 0.121),Rdist 与 WorldPlay 相当 |
局限与改进
作者承认且可见的局限:其一,每个骨干 × 变体都要单独训练校正器(共 4 个),不支持跨模型迁移,论文明确表示 CST 不假设共享潜空间。其二,训练动作集仅限前向/后向/左转三种相机动作的六种定向切换,图 5 的右转只是定性泛化示例、不在训练集内;文本提示或其他控制模态未验证。其三,到达步敏感性:r=3 时 HY-WM1.5 的 LPIPS 从 r=1 的 0.0643 恶化到 0.2694,Rdist 从 0.108 升到 0.180,说明打断越晚剩余可修正空间越小。其四,切换难度不对称:Yaw-left→Backward 的回滚相对 LPIPS 达 0.2654,远差于 Forward→Backward 的 0.0479。我自己的观察:HY-WM1.5 上即便用 CSTT,像素就绪仍需 6941.2 ms,它只解决"响应性"而非"吞吐量",离实时互动还有数量级差距;人类评测规模小(CSTR 仅 30 组),主观指标置信区间未知;方法依赖能读取并写回骨干内部状态(干净预测缓存或 Euler 状态)的实现细节,对闭源模型的适配成本不明;校正器多一次前向也带来少量额外延迟(minWM latent-ready 1016.2 ms vs 交换的 979.2 ms)。
独立分析的弱点
弱点一:逐骨干、逐变体训练四个校正器,扩展成本线性增长,每接入一个新世界模型都要重建捕获流水线。改进方向:设计骨干条件化的共享校正器(把传输表示统一成接口、用 adapter 区分骨干),或先学骨干无关的元传输先验再少量微调。弱点二:动作词汇只有三种相机动作、六种定向切换,真实交互涉及文本事件、物体操纵等开放控制;Yaw-left→Backward 的 LPIPS 高达 0.2654 说明动作差幅越大传输越难。改进:把动作条件换成连续嵌入、扩大训练切换集合、按动作差幅加权损失。弱点三:晚打断退化严重(r=3 时 LPIPS 0.2694、PSNR 18.39 dB),因为只剩 1 步评估来不及让残差被求解器消化。改进:对 $r = K-1$ 设计混合策略(小规模部分回滚或对最后一步做多次自迭代校正),或训练时对大 $r$ 的样本加权。弱点四:只提升响应性不提升速度,HY-WM1.5 像素就绪仍需 7442 ms。改进:与 few-step 蒸馏、缓存复用、稀疏注意力等加速方法正交组合——HY-WorldPlay 的结果已暗示 CST 与加速类方法可以共存。弱点五:评测规模小(30 提示、90 组人类标注),自建协议只在 HY-WorldPlay 一处与公开基准交叉验证。改进:扩充提示多样性、公开标注协议与数据、接入更多第三方基准。
未来方向
论文自身铺垫的方向:在 HY-WorldPlay 协议上与加速类方法叠加;把 CSTT 的定时切换用于规划器产生的动作序列(论文称其支持 scheduled action transitions);递归训练框架可扩展到更多中断次数(已验证训练见 3 次、推理 5 次仍稳健)。基于成果可延伸的研究:其一,把 CST 从相机动作推广到文本提示编辑与场景事件——与 LongLive、Visko Orbis 的提示切换对标,本质上"修订条件"与"修订动作"在 CST 框架下是同一问题,只是条件编码不同;其二,把边界 $m$ 做成连续或可微版本,实现任意时刻的动作混合与渐变转向,而非硬切换;其三,理论层面分析传输误差在递归中断下的传播与收缩条件,解释图 3 中误差为何不累积,并给出校正器容量的必要条件;其四,接入机器人闭环控制——世界模型中的 in-flight 编辑恰好对应策略在执行中途修改指令的场景;其五,研究 $K$ 很小(1-4 步蒸馏模型)时校正器的信息瓶颈,因为可用的"剩余步数"更少、单步携带的修正量必须更大,这直接影响与实时蒸馏世界模型的兼容性。
复现评估
论文声明代码与训练好的校正器权重开源("Code and trained corrector weights are open source"),这是复现的最大利好。数据无需外部数据集:150 个提示定义的场景由两个世界模型自己 rollout 生成,固定种子、固定 120/30 划分,捕获格式(求解轨迹 + $r \in \{1,2,3\}$ 的中断状态)在附录 A.2 有明确描述。训练成本很低:batch size 1、AdamW 4000 步、六块 3D 编解码器,单卡数小时量级。主要工程门槛有三:(1) 需要同时运行 minWM(A100)与 HY-WM1.5(H100)两个骨干并在其推理代码中插桩,拿到可恢复内部状态——minWM 校正干净预测且必须保留转移噪声张量用于重建,HY-WM1.5 需直接读写 Euler 状态;(2) 匹配回滚参考的生成要严格共享初始状态、历史与随机输入,实现稍有偏差指标就不可比;(3) 人类评测(动作遵循率/陈旧帧)需要盲评界面(图 6 给出了完整设计)与标注人力。总体属中等难度:权重与代码齐备时定量结果可复现,人类评测部分只能近似重复。
论文图表
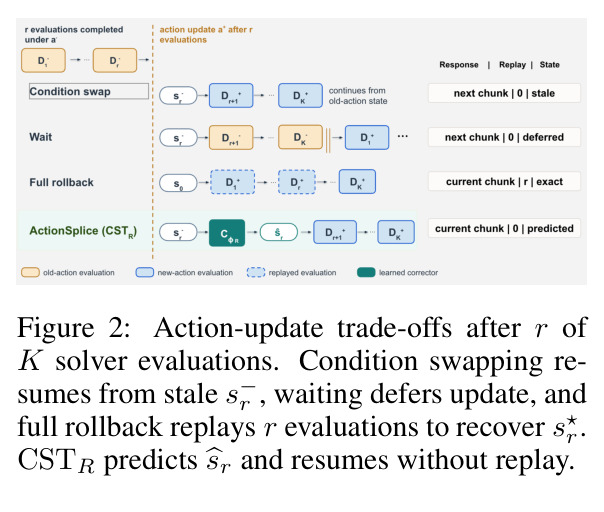
示意新动作在第 $r/K$ 步到达后的四种处理路径及其代价:条件交换从陈旧的 $s_r^-$ 续算(状态仍在旧轨迹)、等待推迟更新(延迟换正确)、完全回滚重放 $r$ 次评估以恢复 $s_r^\star$(正确但重复计算)、CSTR 通过预测 $\hat{s}_r$ 直接续算(不重放)。
它把"状态错位"这一核心问题与三种基线方案的取舍可视化,是理解论文动机与定位的最直观入口。