Ambient @ EgoLongQA 2026:将长视频感知蒸馏到 2B 以下模型 Ambient @ EgoLongQA 2026: Distilling Long-Video perception into a Sub-2B Model
只蒸馏智能体的感知模块而非整个智能体,2B 模型单次前向拿下长视频问答 ≤2B 组第一
前置知识
知识蒸馏(轨迹蒸馏)
用大模型(教师)的输出行为训练小模型(学生),使学生逼近教师表现。常见做法是在教师生成的数据上做监督微调(SFT),或最小化与教师软标签的 KL 散度。本文采用轨迹蒸馏:让教师在训练视频上运行并记录其推理文本,再拿这些文本当学生的训练数据。
全文方法就是围绕'蒸馏哪个组件、怎么过滤蒸馏数据'展开,不理解蒸馏就无法理解学生为何一次前向就能接近教师级精度。
工具调用智能体流水线
让大模型在多轮循环中调用外部工具(如视频片段检索 focus_clip/search_clip)完成任务:模型观察工具返回结果、决定下一步动作,直到给出最终答案。这类系统效果好但延迟高、参数量大,因为每一轮都要完整跑一遍大模型。
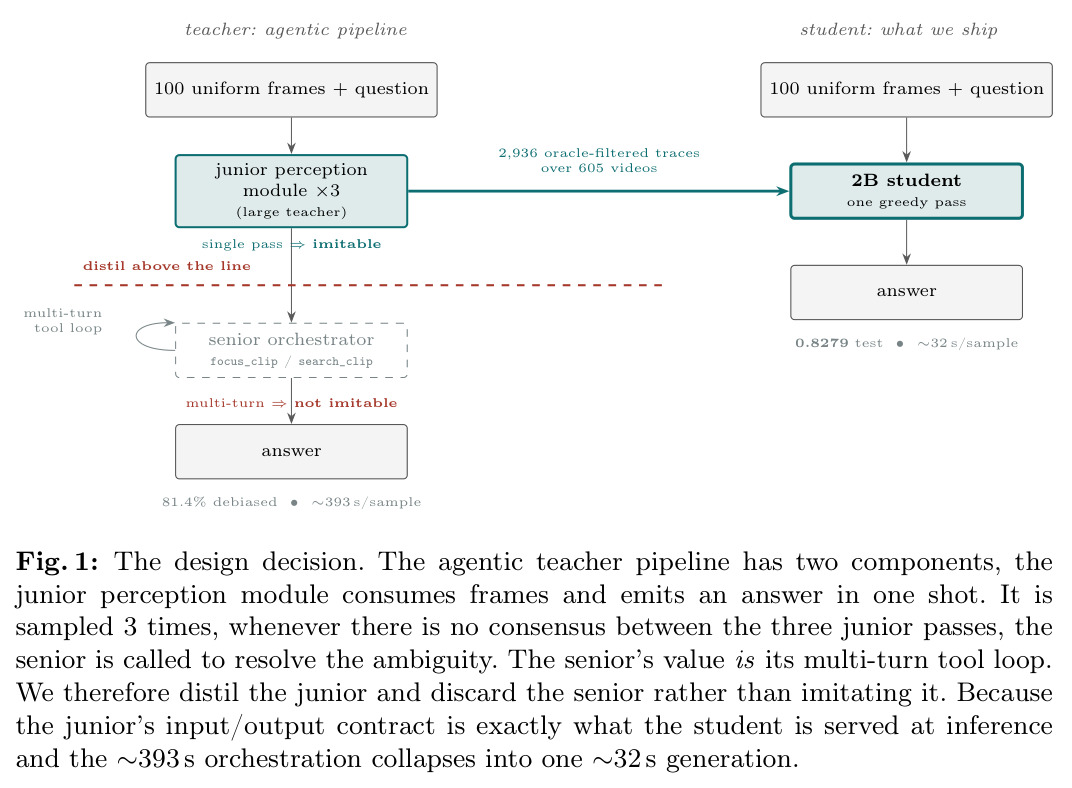
教师是'三次初级采样+高级工具循环'的智能体,本文核心决策是只蒸馏其中单次前向的初级感知模块、丢弃高级编排器,必须先懂智能体结构才能理解这一取舍。
选项选择偏置(answer prior / selection bias)
语言模型对选项标识符(A/B/C/D)本身有系统性偏好。当基准答案分布不均匀时(本文验证集'永远答 C'可得 63.4%),模型会学到'答 C'这类捷径而非真实感知能力,导致指标虚高、分布外泛化变差。
本文定量发现监督蒸馏会把基准自身的答案先验搬进学生(预测 C 率从 19% 升到 40%),并据此设计了先验校正的训练集与评测集,这是读懂所有实验数字的前提。
词表嵌入剪枝
删除嵌入表中任务用不到的 token 行以缩减参数量。本文保留 token id $[0, 143000)$ 不动、显式保留少量稀有 token、重定位 33 个新增/特殊 token 并逐行复制嵌入向量,使保留行上的 logits 与原模型完全一致,属于可证明无损的压缩。
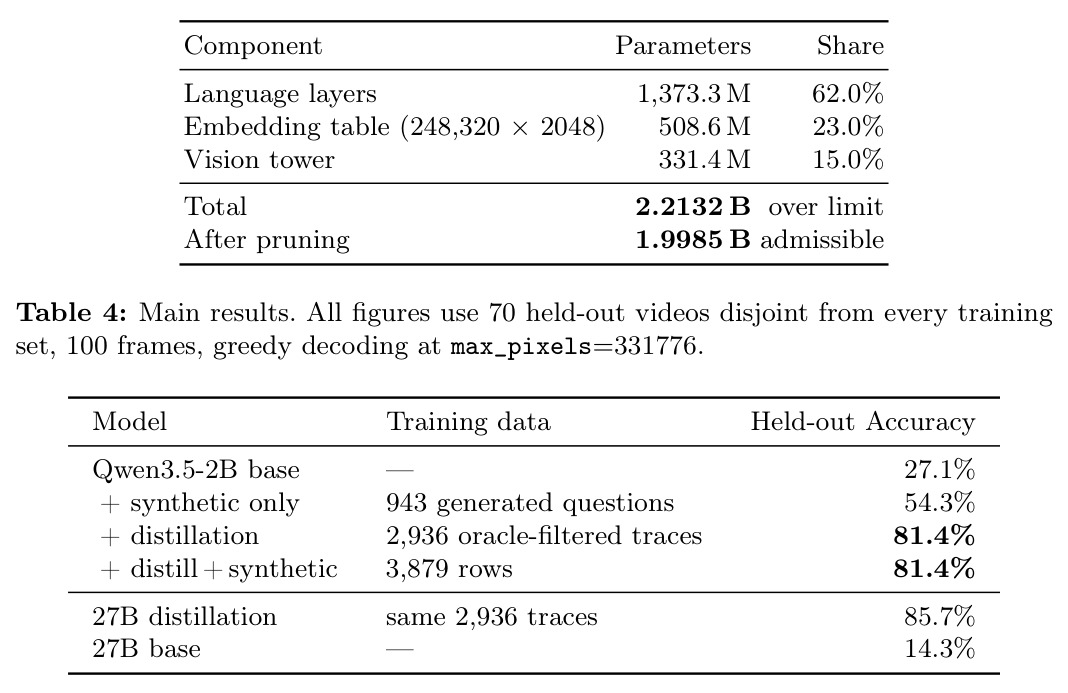
2B 骨干(2.2132B)超出赛事参数上限,把嵌入表从 248,320 行剪到 143,469 行、降到 1.9985B 是参赛合规的关键一步,也是本文的贡献点之一。
LoRA 低秩适配微调
冻结原模型权重,只在每层旁挂一对低秩矩阵 $\Delta W = BA$(秩 $r$,缩放系数 $\alpha$)参与训练。本文用 $r=16$、$\alpha=32$,一个 epoch、batch size 1 配梯度累积 8 即完成训练,大幅降低算力门槛。
学生的全部训练都用 LoRA 完成,这是论文能用 2,936 条轨迹加 943 道合成题的小数据把 2B 模型练到 81.4% 的原因。
动态分辨率与多模态旋转位置编码(M-RoPE)
Qwen3.5 的视觉塔可按输入动态切分视觉 token,配合 M-RoPE 使位置编码与分辨率解耦,于是同一适配器可以在比训练时更高的分辨率下推理。本文在 max_pixels=50176(每帧约 64 个视觉 token)训练、在 331776(约 423 token)推理,值 +5.8 个点。
它解释了论文'训练成本降约 6 倍且不掉精度'的工程结论,也是主结果表中所有数字的标准评测配置(100 帧、贪心解码)。
研究动机
EgoLongQA 任务要求模型对约十分钟长的第一视角(egocentric)视频回答四选一问题,问题常是两跳复合式:先锚定一个事件,再问相对它发生的另一件事,≤2B 组的限制覆盖整个多模态检查点(含视觉塔)。对付这种任务的强方案是智能体:采样帧、描述视频、用工具检索候选片段再推理。作者自己的 Ambient 流水线(三次初级感知采样+带 clip 检索工具的高级编排器)在分布鲁棒评测上达到 81.4%,但每题约 393 秒、参数量远超 2B,在小型模型上完全不可行;裸的 Qwen3.5-2B 基线只有 27.1%。更麻烦的是基准本身有严重答案先验:验证集上'永远答 C'就能拿 63.4%,直接在验证集上训练会把'选 C'这条捷径学进模型,指标虚高而感知能力并没有提升。
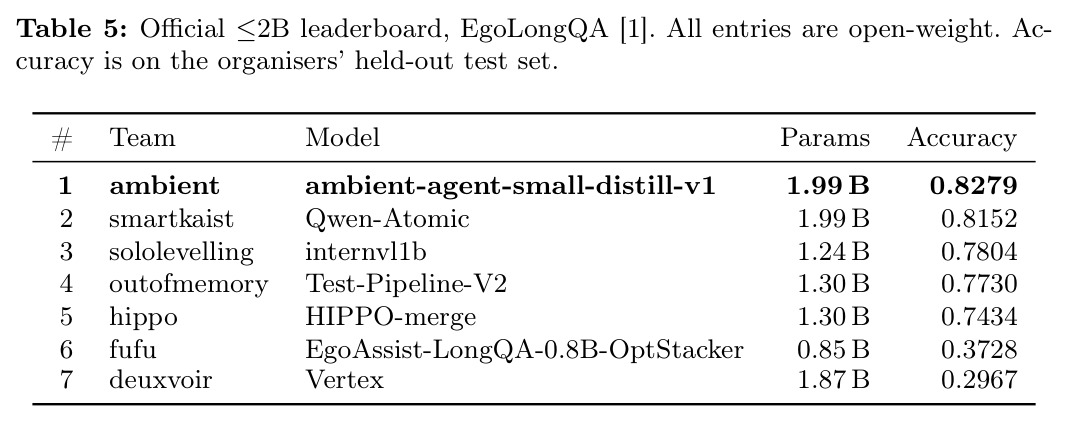
本文的目标是目标是打造一个在 ≤2B 参数上限内(含视觉塔)能与大参数智能体流水线竞争的第一视角长视频问答系统:单次贪心前向出答案,每题约 32 秒而非 393 秒,并拿下 ECCV 2026 Wearable-AI Challenge EgoLongQA 赛道 ≤2B 组第一(官方测试集 0.8279)。具体拆成三个子目标:其一,把智能体的能力迁移进小模型且训练/推理零错配;其二,把 2.2132B 的骨干压到 1.9985B 的合规线以下、且不改变任何生成行为;其三,构造不受答案先验污染的训练集与评测集,让 27.1% 的基线被真实感知能力提升到 80% 以上,而不是靠'永远答 C'作弊。
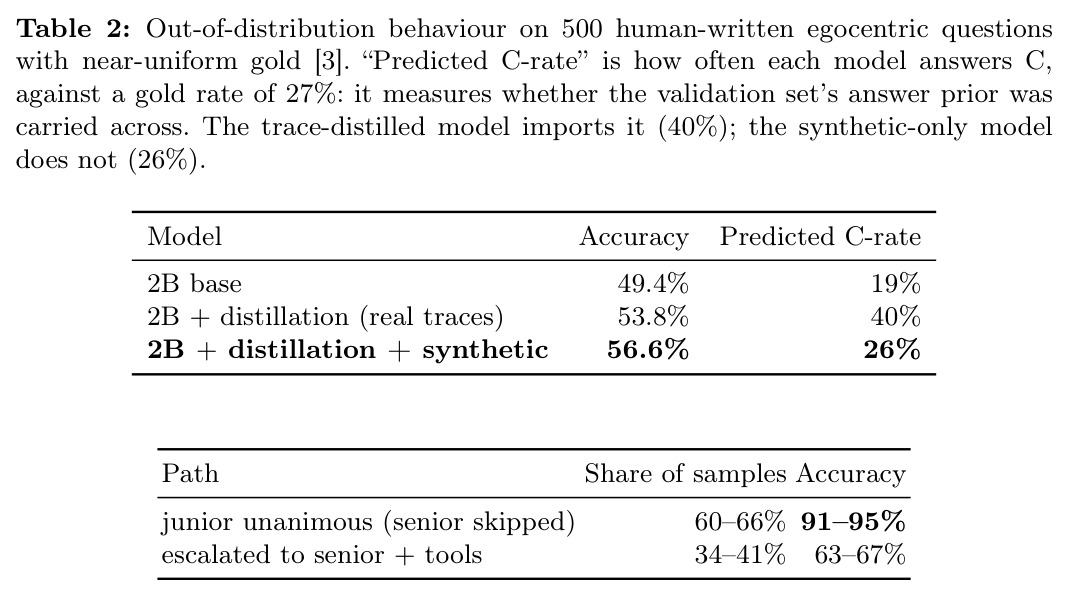
与已有工作不同的是,独特切入是'组件级蒸馏':不模仿整个智能体,而是先测量流水线内部两条路径各自的贡献——初级一致路径占 60–66% 的样本、准确率 91–95%,被升级到高级工具循环的硬样本只占 34–41%、准确率 63–67%。既然大部分精度来自单次前向的初级模块,而高级编排器的价值恰恰在于不可被单次前向表达的多轮工具循环,那就蒸馏前者、丢弃后者。再配合三条互补设计:用'答案正确且三次采样一致'的 oracle 过滤教师轨迹来提纯数据;把训练与留出集的选项重排成均匀金标分布以阻断先验迁移;用可证明零 logit 变化的词表剪枝满足参数上限。这套'先测量再决定蒸馏什么'的思路,是与常见'直接拿教师输出做 SFT'做法的本质区别。
核心方法
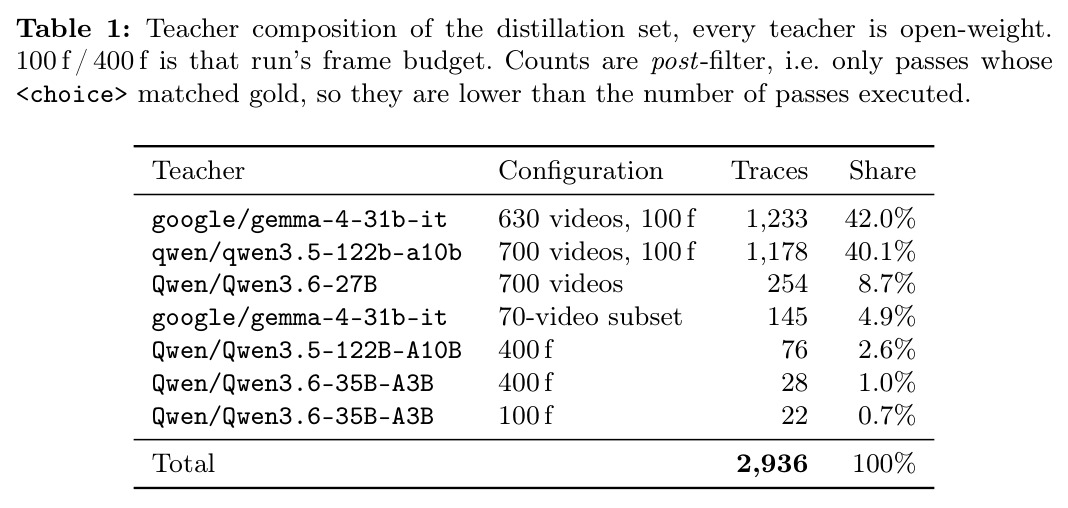
直觉上,智能体的精度可以搬进小模型,前提是蒸馏对的那块东西。技术路线分四步。第一步跑教师:多个开放权重模型(gemma-4-31b-it、Qwen3.5-122B-A10B、Qwen3.6-27B、Qwen3.6-35B-A3B)在训练视频上执行初级感知契约并采集轨迹。第二步过滤:只保留 与金标一致且三次采样全体一致的轨迹,得到 605 个视频上的 2,936 条轨迹,每题中位数 5 种不同描述。第三步训练:Qwen3.5-2B 学生以 LoRA($r=16$、$\alpha=32$)训练一个 epoch,输入 100 帧均匀采样+问题+四选项,输出带时间戳的视频描述和结构化答案, 跨度的 token 权重设为 3 倍,低分辨率训练、高分辨率推理。第四步合规:剪掉词表未用行,从 2.2132B 降到 1.9985B,保留行 logits 差实测恰为 0,70/70 留出项生成字节级一致。
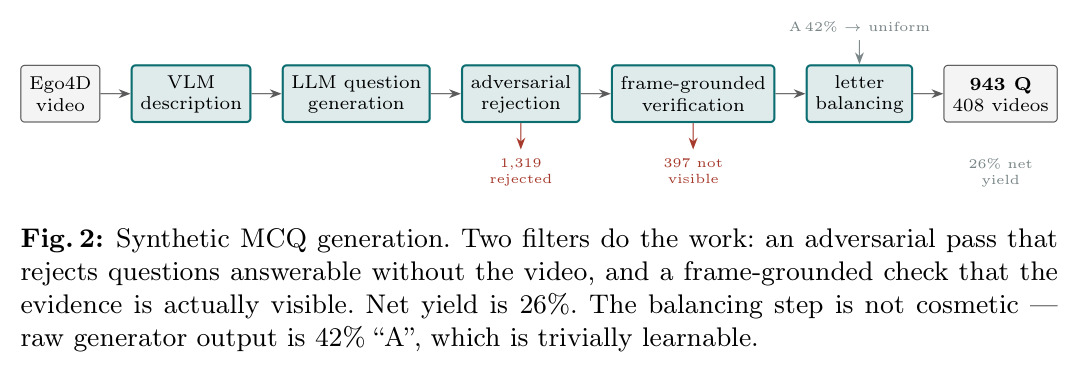
核心创新有三点。其一是'单次前向可模仿、多轮工具循环不可模仿'这条判据:初级模块的输入输出契约与学生推理时收到的完全一致(100 帧+问题+四选项 → 加 结构化答案),训练/测试零错配,因此能把约 393 秒的编排坍缩成一次约 32 秒的生成而不损失大部分精度;而高级编排器的价值在多轮工具循环,蒸馏它只会教学生模仿轨迹形状而非能力。其二是发现监督蒸馏会搬运基准的答案先验:真实轨迹蒸馏使学生在 500 道 OOD 人类问题上的预测 C 率从 19% 升到 40%(金标率 27%),混入 943 道字母均衡合成题后降回 26%,同时 OOD 准确率从 53.8% 升到 56.6%——合成数据的价值在去先验而非提同分布精度。其三是生成式模型的词表剪枝不对称性:分类器删行容易,生成模型的每个被删 token 都可能出现在输出里,本文靠 tokenizer 保持原 id、模型代码重映射后查表、逐行复制嵌入,实现可证明的零 logit 变化。
方法步骤详情
完整流程如下。步骤一,教师轨迹采集:在 600–700 个训练视频上运行门控级联——三次初级采样,全票一致则接受并跳过高级,否则升级到带 focus_clip/search_clip 工具的编排器;只收集初级轨迹。步骤二,oracle 过滤:保留 等于金标且三次一致的轨迹,由 gemma-4-31b-it、Qwen3.5-122B-A10B 等七个开放权重运行共贡献 2,936 条。步骤三,合成数据:Ego4D 视频 → VLM 描述 → LLM 出题 → 对抗性拒绝(1,319 道无视频也可答的题被拒)→ 帧落地验证(397 道证据不可见)→ 字母均衡(原始输出 42% 是 A),净产率 26%,得 943 题/408 视频。步骤四,LoRA 训练:batch size 1、梯度累积 8、cosine 调度、一个 epoch(第二个 epoch 掉 4.3 个点)、 跨度 3× token 权重,低分辨率训练、高分辨率推理。步骤五,词表剪枝:保留 id $[0, 143000)$、显式保留稀有 token、重定位 33 个特殊 token,tokenizer 仍输出原空间 id,由模型代码重映射后查表。
技术新颖性
技术新颖性体现在四个层面。第一,'蒸馏什么'由测量驱动:分解门控级联两条路径的样本占比与准确率(初级一致 60–66% 样本/91–95%,升级路径 34–41%/63–67%),把组件选择从直觉变成数据决策,并给出'2/3 的验证集已被初级以 90%+ 解决'的实证依据。第二,oracle 过滤叠加三次一致性过滤相当于对教师自我蒸馏提纯,每题中位数 5 种描述带来描述多样性。第三,把文献中用于估计推理时选择偏差的选项重排装置反用作训练与评测的数据构造,定量展示蒸馏搬运先验的现象(C 率 40% 对 26%)。第四,给出面向生成式模型的无损词表剪枝协议与 70/70 字节级一致验证。此外论文诚实报告负结果:GRPO 在仅约 25 个'同分布且未见'提示视频时无可复现增益;帧预算的效应方向取决于模型容量(2B 上 100→400 帧掉 4.4 个点,35B 上反而 +11.2 个点),这些负结果本身就有方法论价值。
实验结果
主结果(70 个与所有训练集不相交的留出视频、100 帧、贪心解码、max_pixels=331776):Qwen3.5-2B 基线 27.1%;+943 道合成题 54.3%;+2,936 条蒸馏轨迹 81.4%(提升 54.3 个点,约 3 倍);蒸馏+合成(3,879 行)仍为 81.4%——合成数据在同分布留出集上不再加分,但在 500 道 OOD 人类问题上把 53.8% 提到 56.6%,预测 C 率从 40% 降到 26%(基线为 49.4%/19%)。同一批轨迹喂给 27B 学生得 85.7%(表中 27B 基线 14.3%,正文另提及 65% 单遍基线)。词表剪枝从 2.2132B 到 1.9985B,保留行 logit 差为 0,70/70 留出项生成字节级一致。官方 ≤2B 排行榜第一:0.8279,领先第二名 smartkaist Qwen-Atomic(0.8152)1.27 个百分点,与验证数字相差 1.4 个点以内。延迟从约 393 秒/题降到约 32 秒/题,约 12 倍加速;学生以 1.1% 的参数量达到大型流水线精度的约 89%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| EgoLongQA ≤2B 官方留出测试集 | Accuracy | 0.8279(1.99B,第一名) | 亚军 smartkaist Qwen-Atomic 0.8152(1.99B) | +1.27 个百分点 |
| 去偏留出集(70 视频,选项重排为均匀金标) | Accuracy | 81.4%(蒸馏+合成,3,879 行训练数据) | Qwen3.5-2B 基线 27.1% | +54.3 个百分点(约 3 倍) |
| 同一去偏留出集,27B 学生 | Accuracy | 85.7%(用相同 2,936 条轨迹) | 27B 基线 14.3%(表 4 数字) | +71.4 个百分点 |
| OOD:500 道人类撰写第一视角问题(近均匀金标) | Accuracy / 预测 C 率(金标 C 率 27%) | 56.6% / 26%(蒸馏+合成) | 仅轨迹蒸馏 53.8% / 40%;2B 基线 49.4% / 19% | 准确率 +2.8 个百分点,C 率 -14 个百分点 |
| 单题推理延迟(十分钟视频问答) | 秒/样本 | 约 32 s(单次贪心前向) | 智能体流水线约 393 s(三次采样+工具循环) | 约 12 倍加速 |
局限与改进
作者承认的局限:其一,全部使用开放权重教师付出了约 1.4 个点的代价(对比最佳闭源初级模型);其二,合成数据没有提高同分布留出精度,只改善 OOD 鲁棒性;其三,GRPO 强化学习无可复现增益,作者只有猜想(同分布且未见的提示视频仅约 25 个)而非实验确证。我自己的观察:第一,oracle 过滤天然剔除了教师失败的难题——被升级到高级的 34–41% 硬样本恰恰没进训练数据,学生学不到如何攻克它们,这可能是继续提分的隐性天花板;第二,答案先验靠人工重排选项消除,是基准特定的补丁,遇到未重排的自然测试分布仍可能暴露先验;第三,评测全部来自单一赛事基准,向其他长视频/第一视角数据集的泛化未验证;第四,均匀 100 帧采样对稀疏事件有先天弱点,且'小模型加帧反而变差'(2B 上 400 帧掉 4.4 个点)与 27B 上 +11.2 个点对照,说明 2B 容量本身是信息摄入瓶颈;第五,竞赛报告性质使部分工程细节(如具体训练卡时)着墨不多。
独立分析的弱点
独立分析的弱点与改进方向:第一,oracle 过滤造成'易例偏置',学生只见过教师答对且自洽的样本,而流水线里被升级到高级的 34–41% 硬样本(教师在此仅 63–67% 准确)完全没有对应训练信号;改进方向是把高级编排器解决硬样本的最终结论改写成单遍格式轨迹(如把工具检索到的片段证据内联为文本)一并蒸馏,或对不一致样本做难度加权采样。第二,先验校正依赖人工选项重排,重排后的分布与真实测试分布仍有差异,且'永远答 C 得 63.4%'的原始验证集对复现者有误导性;改进方向是发布去偏版官方基准,或用成对选项对比做推理时自校正。第三,合成集仅 943 题/408 视频、OOD 集仅 500 题,统计功效有限,26% 的净产率也意味着大量算力花在被拒题上;改进方向是扩大出题规模并做数据配比消融。第四,GRPO 失败的归因(缺同分布未见提示)未经对照实验证实;改进方向是先合成数千个同分布未见视频的题目再重跑 RL。第五,词表剪枝假设任务语言已知,若推理输入含被剪语言会产生未定义映射;改进方向是明确文档化降级行为并提供可插拔的嵌入恢复方案。
未来方向
作者提出的方向:后续工作应解决 RL 的数据约束——论文指出 DAPO 的解耦裁剪/动态采样与 Dr. GRPO 去除长度和难度偏差都不解决'同分布且未见的 rollout 提示只有约 25 个视频'这一实际约束,因此造数据是前置条件。基于本文成果可延伸的方向:其一,把'组件级蒸馏'判据推广到其他工具智能体——凡输入输出契约与部署时一致的单次子模块都值得蒸馏,多轮循环部分可尝试把工具调用轨迹文本化后扁平蒸馏;其二,帧预算负结果(2B 掉 4.4 个点、35B 升 11.2 个点)暗示小模型需要自适应关键帧选择或视频 token 压缩,而非均匀稠密采样;其三,27B 学生 85.7% 与流水线极限之间仍有空间,可探索更强教师混合、放宽一致性过滤并加难度加权、以及多 epoch 配合先验再校正的课程学习;其四,把净产率 26% 的合成题流水线扩展到 Ego4D 之外的数据源,检验 OOD 鲁棒性收益的普适性;其五,词表剪枝协议若标准化,可成为各类参数受限赛事的通用合规工具。
复现评估
复现条件相当好:代码在 GitHub(ambient-intelligence-hq/egolongqa-2b),模型与数据集在 Hugging Face 公开;所有教师均为开放权重(对比闭源初级教师只损失约 1.4 个点);学生基座 Qwen3.5-2B 公开。训练数据小(2,936 条轨迹+943 道合成题共 3,879 行),LoRA $r=16$、单 epoch、batch size 1 配梯度累积 8、低分辨率训练使成本再降约 6 倍,单张高端 GPU 量级即可完成学生训练;推理每题约 32 秒。难点在三处:EgoLongQA 基准与官方测试集依赖赛事方基础设施,外部者只能用作者发布的去偏留出集;若要从头重采教师轨迹,需在 600–700 个十分钟视频上跑 122B 级模型各三次采样,算力开销不小;合成数据依赖 Ego4D,需签数据许可。数字自洽性好(测试 0.8279 与验证 81.4% 相差 1.4 个点以内,剪枝前后生成字节级一致)。综合评:学生训练易、教师轨迹重建难,整体复现难度中等。
论文图表
骨干参数构成:语言层 1,373.3M(62.0%)、嵌入表 248,320×2048 共 508.6M(23.0%)、视觉塔 331.4M(15.0%),合计 2.2132B 超出上限;剪枝后 1.9985B 合规。
说明为什么词表剪枝是满足参数上限的关键路径:嵌入表占 23% 且权重绑定使每删一行都是直接节省,为第 2.6 节的无损剪枝方案提供量化动机。