LongLive-Plug:面向视频生成的一次蒸馏、全模型复用框架 LongLive-Plug: Once-for-All Distillation for Video Generation
将CFG、少步采样与长上下文纠错一次性蒸馏为可复用LoRA,免训练插拔到54个下游视频模型
前置知识
Classifier-Free Guidance (CFG)
扩散模型中放大文本条件影响力的采样技巧:每个去噪步同时用网络计算条件预测 $v_c$ 与无条件预测 $v_\emptyset$,再按 $v = v_\emptyset + w(v_c - v_\emptyset)$ 外推组合,其中引导强度 $w$ 控制文本贴合程度。代价是每步要做两次前向传播,推理开销翻倍。
本文第一项蒸馏能力就是把两分支合并为单次前向的 CFG 蒸馏,并且巧妙保留了引导强度的连续可调性(通过 LoRA 推理权重做旋钮),这是理解解耦蒸馏设计的核心背景。
LoRA(低秩适配)
冻结预训练权重 $W$,只训练低秩增量 $\Delta W = AB$($A,B$ 秩远小于原维度),推理时相加即得 $W + \Delta W$。增量小、可插拔、可合并,常用于微调大模型而不改动基座本身。
本文把蒸馏出的三种'能力'(CFG、少步、长上下文)全部封装为基座上的功能 LoRA,正因 LoRA 可拆卸可合并,才能免训练地插拔到各种下游特化模型上。
分布匹配蒸馏(DMD/DMD2)
一类少步蒸馏方法:让学生模型的生成分布匹配教师模型的得分函数定义的分布,绕开逐步去噪轨迹的模仿,从而把 30-50 步采样压缩到 4 步甚至 1 步。DMD2 加入回归损失与抗伪影技巧后质量更稳。
本文的 few-step LoRA 用 DMD2 以 CFG 引导教师为监督训练出 4 步采样能力,是主实验(SCOPE、ControlNet 加速)的技术底座。
因果自回归(AR)长视频生成
视频模型按短片段因果生成:每段以之前生成内容的 KV 缓存为历史条件,使用因果注意力掩码(只看过去不看未来),可滚动生成任意长视频。误差会随 rollout 逐步累积导致画质劣化。
本文长上下文 LoRA 专为纠正这种累积误差而设计,且明确指出 LoRA 不改变注意力掩码,因此只能迁移到'本身已支持因果 AR 推理'的下游模型,这是兼容性边界的关键。
FVD 与 VBench
FVD(Fréchet Video Distance)在特征空间中度量生成视频与真实视频分布的距离,越低越好,是视频生成的标准指标。VBench 是多维视频评测基准,包含成像质量、美学、主体/背景一致性、时序闪烁、运动平滑度等维度。
主实验的定量结论(如 SCOPE 上 FVD 从 805.5 降到 478.7、ReWorld 长视频 7 维均值提升)全部建立在这两套指标上,不熟悉就无法读懂结果表。
研究动机
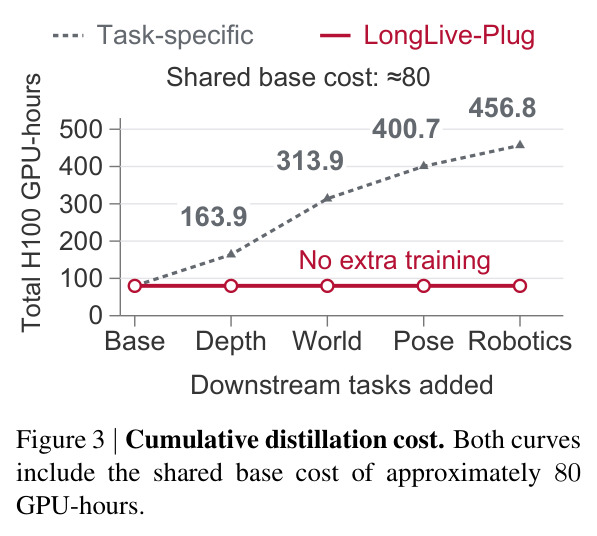
大规模视频扩散 transformer(Wan、HunyuanVideo、Cosmos 等)已成为可复用基座,但下游应用越来越依赖特化模型:可控生成与个性化、视频编辑、面向机器人和具身智能的动作条件世界模拟等。开发这类特化模型几乎总附带一个蒸馏阶段——要么把 30-50 步采样加速到几步,要么改进长视频生成质量——而且这个阶段对每个新模型都要重复一遍,每次都要重新准备数据、跑教师监督、做训练调参。以本文统计为例,在 Wan2.2-TI2V-5B 上为深度条件生成、世界模型、姿态条件生成、机器人模拟分别做任务专用蒸馏,各需 83.9、150.0、86.8、56.1 H100 GPU 时,四个任务额外累计 376.8 GPU 时。更麻烦的是,主流少步蒸馏方法(CausVid、Self Forcing)把 CFG 与少步生成耦合在一个模型里联合蒸馏,引导强度被永久固定在训练时的 scale,而不同下游任务对引导强度的偏好各不相同,单一固定 scale 无法通吃。
本文的目标是本文要建立'一次蒸馏、处处复用'(once-for-all)的工作流:在每个基座模型家族上只做一次蒸馏,把三种最常用的能力——单次前向的 CFG 蒸馏、基于 DMD2 的 4 步少步采样、面向因果自回归生成的长上下文误差纠正——分别封装成基座上的可复用功能 LoRA。之后任何一个兼容的下游特化模型(无论是全量微调、加条件分支如 ControlNet,还是扩展输出通道如 RGBA 生成)都能免训练地挂载这些 LoRA,直接获得加速与长视频质量提升,并且引导强度仍可通过推理权重连续调节以适配不同任务偏好。
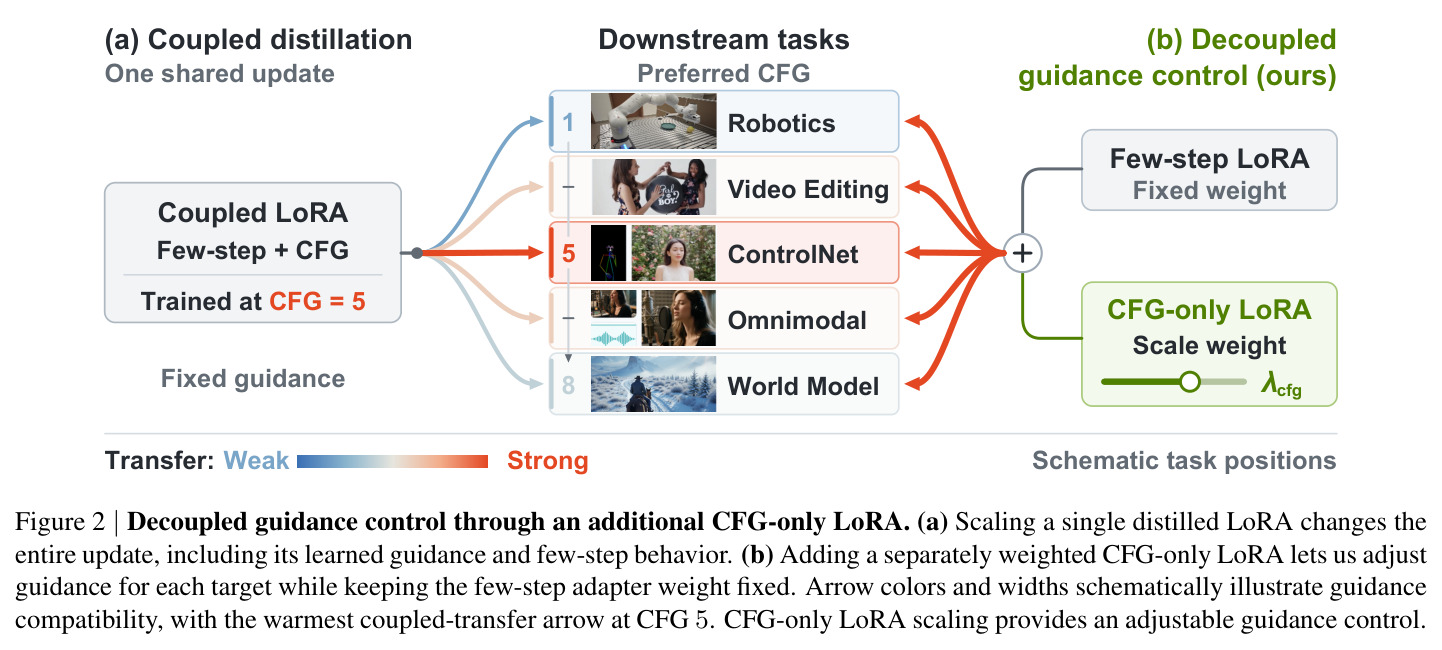
与已有工作不同的是,本文的独特切入角度有三层。其一是解耦蒸馏:不同于 CausVid/Self Forcing 把 CFG 和少步能力联合压进一个模型,本文把两者拆成独立的 CFG-only LoRA 与 few-step LoRA,让 CFG LoRA 的推理权重 $\lambda_{cfg}$ 充当近似线性的'引导旋钮',而联合蒸馏的 LoRA 一旦整体缩放就会扰动少步行为甚至崩塌。其二是首次系统性研究'什么样的蒸馏才能迁移',给出两个经验规律:适配器秩过小虽能拟合基座教师但迁移差、蒸馏提示越多样迁移越好。其三是方向性区别于已有工作:LCM-LoRA 面向图像一致性蒸馏复用,Plug-and-Play Diffusion Distillation 迁移的是非 LoRA 引导网络且限于图像微调模型,CASA 则是把下游 LoRA 迁往少步模型(方向相反);本文把'能力 LoRA'扩展到视频的加速与长上下文纠错,覆盖面广得多。
核心方法
直觉上,蒸馏学到的'加速能力'其实是相对基座的一组权重修正:下游特化模型只是基座的小改动(微调、加条件分支、扩输出通道),这组修正对它们大概率仍然有效,没必要重学一遍。技术路线分三步。第一步,冻结基座 $F_{\theta_0}$,在宽泛 T2V 提示上分别蒸馏出三个功能 LoRA:CFG 蒸馏以教师引导输出 $v_{cfg}^{(w)} = v_\emptyset + w(v_c - v_\emptyset)$ 为固定目标,训练单次前向的条件输出逼近它;few-step 蒸馏用 DMD2 让基座获得 4 步采样能力;长上下文蒸馏在因果 AR 版基座上用 Streaming Long Tuning 加 DMD 训练误差纠正 LoRA。第二步,部署时对兼容下游模型 $F_{\theta_\tau}$ 做权重合并 $F_{\theta_\tau} \oplus \phi$,即把 LoRA 增量加到对应层、完整保留下游自身任务权重,无任何下游训练或再蒸馏。第三步,推理时通过 $\lambda_{step}$ 和 $\lambda_{cfg}$ 两个权重独立控制少步行为与引导强度。
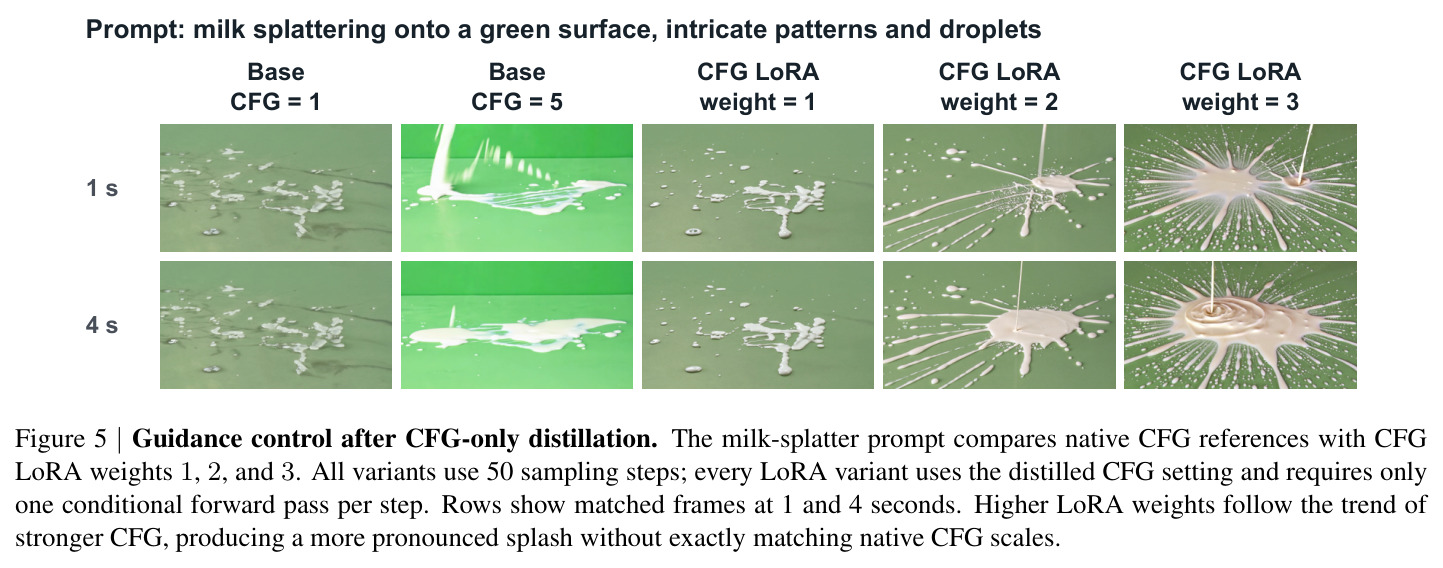
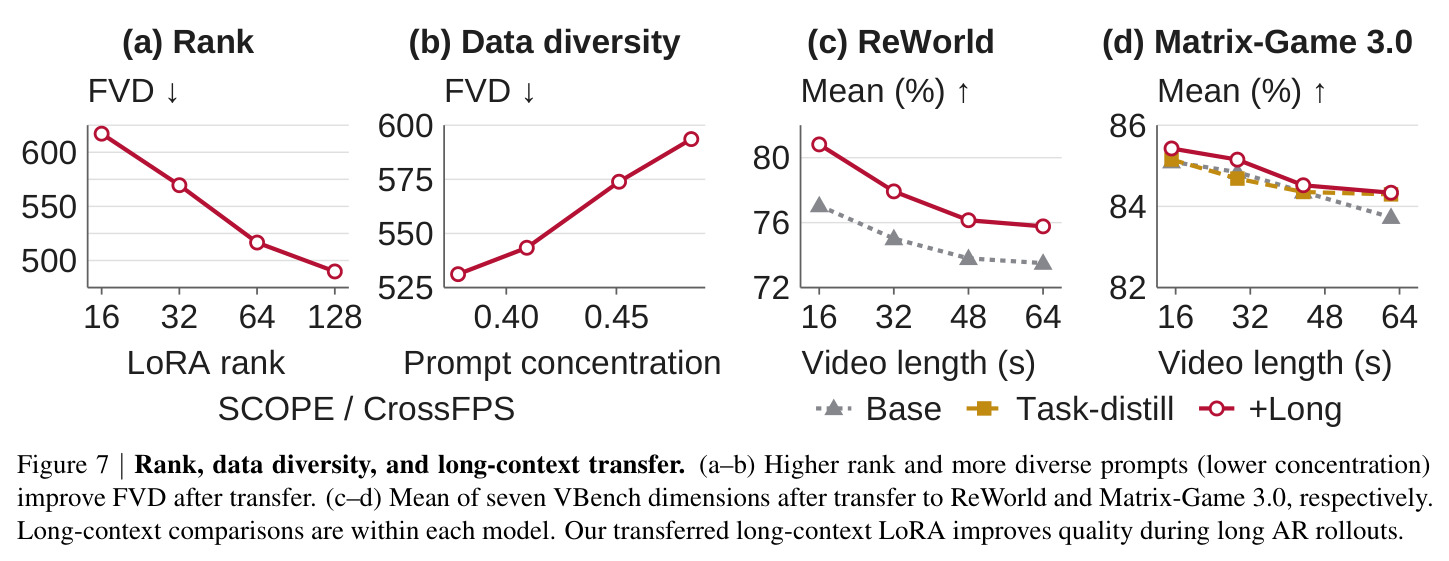
核心创新是'解耦的引导旋钮'。固定教师引导 scale $w_{train}$ 训练 CFG-only LoRA 后,推理时缩放其权重 $\lambda_{cfg}$ 可近似线性地改变有效引导强度:$F_{\theta_0} \oplus \lambda_{cfg}\phi_{cfg} \approx v_c + \lambda_{cfg}(v_{cfg}^{(w_{train})} - v_c)$,等价于有效 scale $e_w = 1 + \lambda_{cfg}(w_{train} - 1)$,权重 0 与 1 分别退回条件模型与完整蒸馏效果。配套两条迁移经验规律同样关键:适配器秩从 16 加倍到 128,迁移后 FVD 单调改善 21%(小 LoRA 能拟合基座教师却迁移差,源拟合度不决定迁移所需容量);蒸馏提示集中度越高迁移越差,FVD 恶化 12%,宽泛 T2V 提示的行为多样性是迁移质量之源。推理时两层合并为 $W_\ell^{(\tau)} = W_\ell^{(\tau)} + \lambda_{step}\Delta W_{\ell,step} + \lambda_{cfg}\Delta W_{\ell,cfg}$,不增加任何前向。
方法步骤详情
步骤一(CFG 蒸馏):输入基座 $F_{\theta_0}$ 与宽泛 T2V 提示集,对噪声潜变量 $z_t$ 计算条件输出 $v_c$ 与无条件输出 $v_\emptyset$,按固定 scale $w_{train}$(实验取 5)构造教师目标 $v_{cfg}^{(w)} = v_\emptyset + w(v_c - v_\emptyset)$,只训练 $\phi_{cfg}$ 最小化单次条件输出与目标的平方误差,骨干、调度、注意力模式全部不动。步骤二(few-step 蒸馏):用 DMD2 以 CFG 引导教师为监督训练 $\phi_{step}$,获得 4 步采样能力。步骤三(长上下文蒸馏):在冻结因果 AR 基座上,学生从缓存历史生成短片段、教师以 DMD 监督新片段,rollout 变长时 detach 前置历史使梯度局部化(Streaming Long Tuning),得到 $\phi_{long}$。步骤四(部署):采样前对每个兼容下游模型合并加权增量 $W_\ell^{(\tau)} + \lambda_{step}\Delta W_{\ell,step} + \lambda_{cfg}\Delta W_{\ell,cfg}$,保留下游任务模块,无额外前向。步骤五(调优):按任务偏好旋 $\lambda_{cfg}$(SCOPE 用 $(1,3)$、ControlNet 用 $(1,1)$)。
技术新颖性
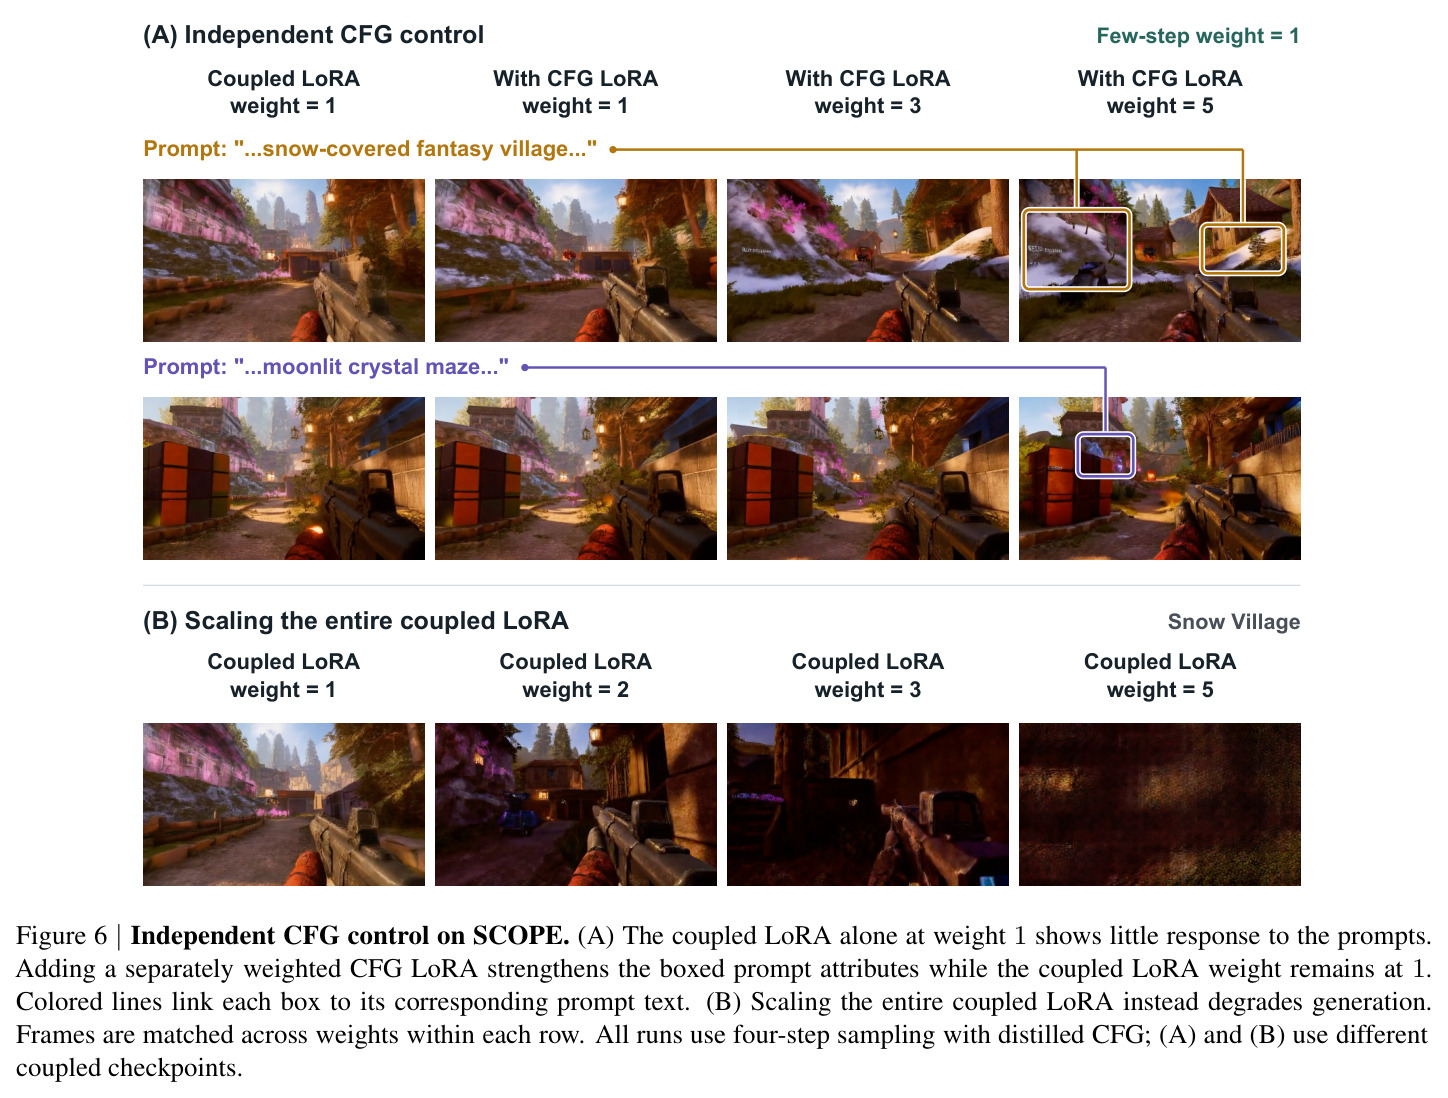
技术新颖性体现在四个方面。第一,解耦 CFG 与少步蒸馏并证明 CFG-only LoRA 权重是近似线性的引导旋钮,这是对'联合蒸馏锁死引导强度'这一行业默认做法的直接颠覆:SCOPE 实验显示全局缩放耦合 LoRA 到权重 5 会画面变暗扭曲直至崩塌,而独立 CFG LoRA 从 1 升到 5 能平滑增强雪村与水晶迷宫的属性表达且少步行为不动。第二,把功能 LoRA 从图像(LCM-LoRA、adapter guidance distillation)推广到视频,并同时覆盖加速与长上下文两类能力,验证了 54 个下游模型、3 个基座家族、8 个任务类别的免训练部署。第三,首次给出'迁移导向蒸馏'的系统性消融:秩与提示多样性两条经验规律直接回答'在源上训得好不等于迁得动'。第四,长上下文 LoRA 借 Streaming Long Tuning 与 detach 历史的 DMD 训练,把误差纠正也变成可迁移资产——此前 FlashMotion、DreamDojo、BiWM 等都需对每个目标模型单独蒸馏。
实验结果
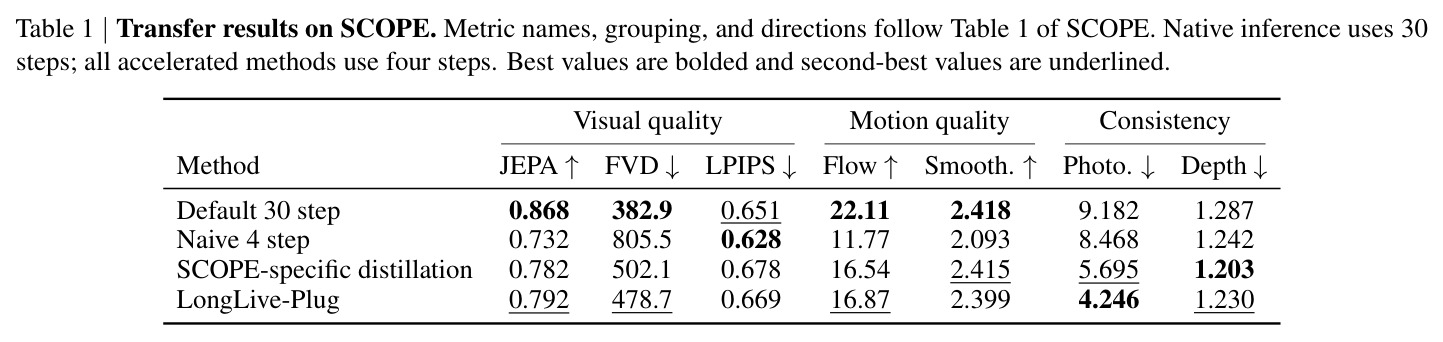
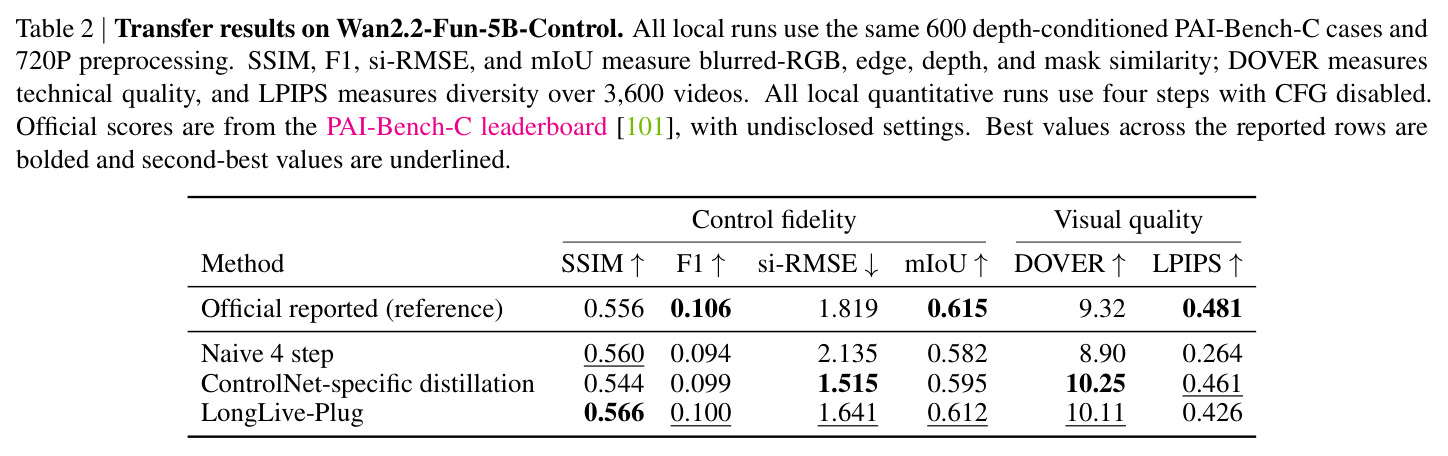
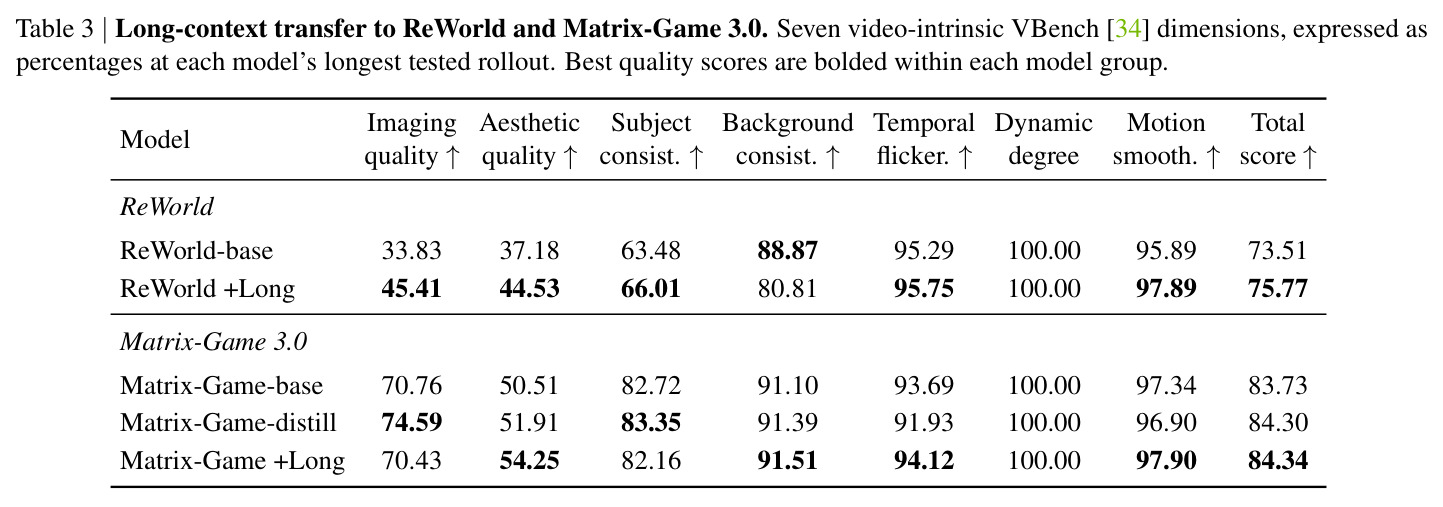
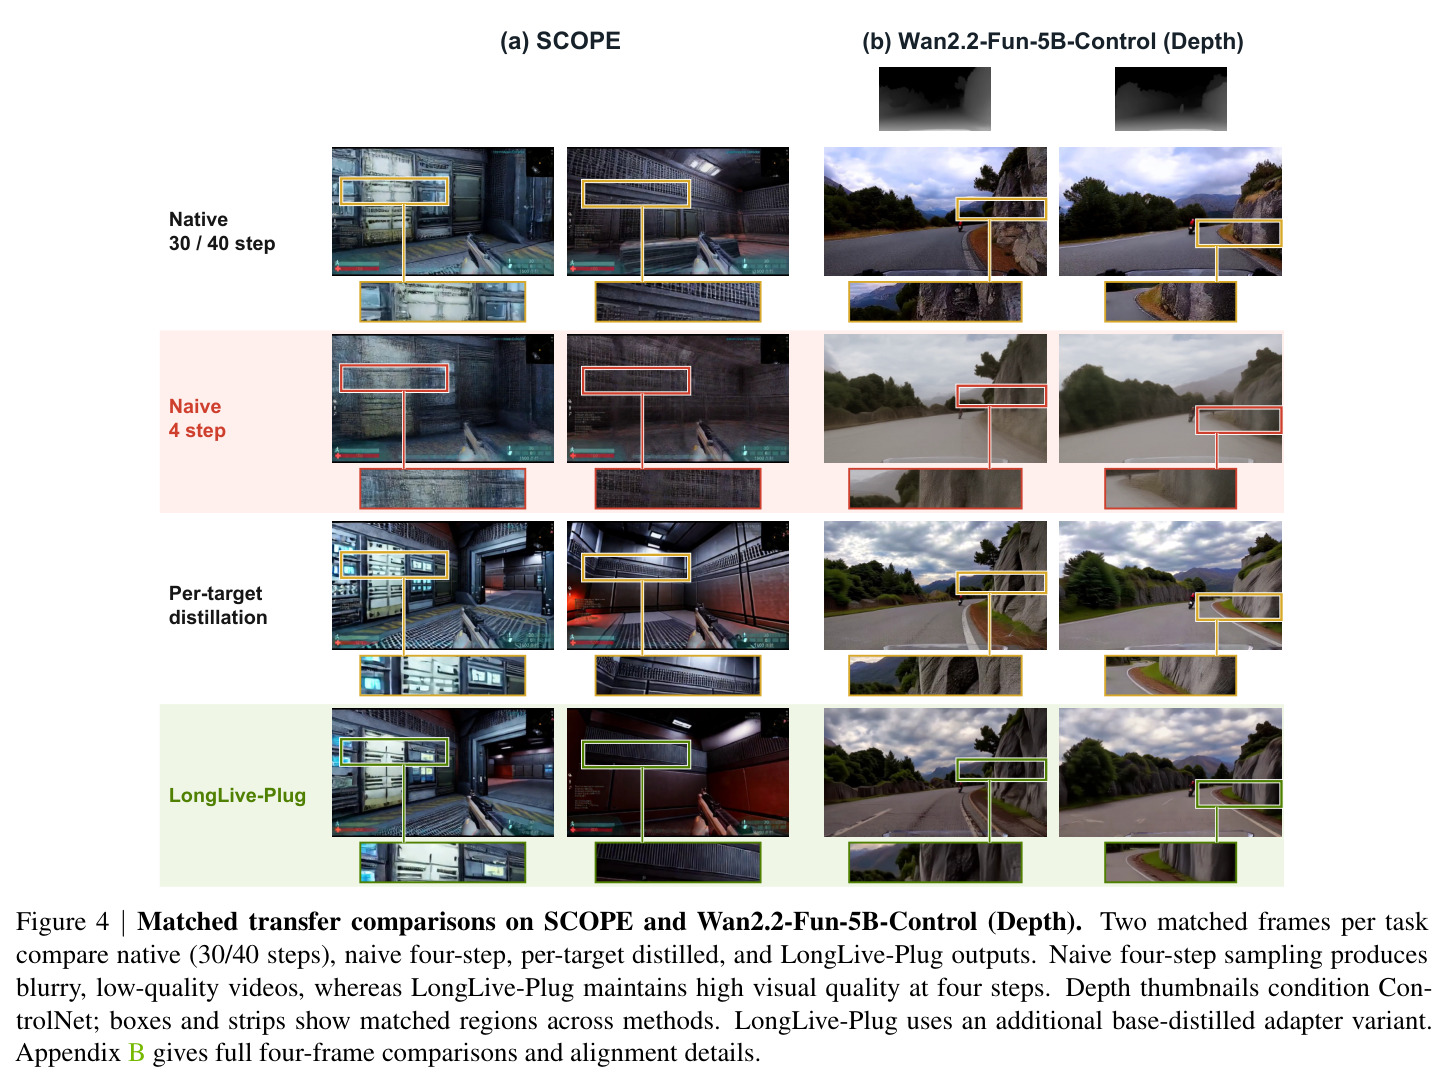
实验覆盖加速迁移、CFG 可控性与长上下文三块,基座为 Wan2.2-TI2V-5B。SCOPE 世界模型(1378 个 CrossFPS 片段)上,4 步 LongLive-Plug 取得 FVD 478.7,优于朴素 4 步的 805.5 和 SCOPE 专用蒸馏的 502.1(原生 30 步为 382.9),JEPA 0.792 高于专用蒸馏的 0.782,深度 Photometric 误差 4.246 远低于朴素 4 步的 8.468。Wan2.2-Fun-5B-Control 的 600 个深度条件 PAI-Bench-C 用例上,六指标全面超越朴素 4 步:SSIM 0.560→0.566、si-RMSE 2.135→1.641、DOVER 8.90→10.11、LPIPS 0.264→0.426,与专用蒸馏互有胜负(其 DOVER 10.25、si-RMSE 1.515 略优)。覆盖面上,在 Wan2.1-14B、Wan2.2-TI2V-5B、MiniMax-H3 三个家族共 54 个下游模型、8 个任务类别验证免训练部署,去噪步数降低 5-12.5 倍;成本上基座蒸馏一次约 80 H100 GPU 时(32 卡约 2.5 小时),四个任务专用蒸馏累计 456.8 GPU 时。CFG 可控性:$w_{train}=5$ 时 $\lambda_{cfg}$ 从 1 调到 3 牛奶飞溅增强;SCOPE 上独立 CFG LoRA 权重 1→5 平滑增强提示属性,而整体缩放耦合 LoRA 到 5 时画面崩塌。消融:秩 16→128 迁移 FVD 改善 21%,提示集中度上升使 FVD 恶化 12%。长上下文:+Long 使 ReWorld 64 秒 rollout 的 VBench 7 维均值从 73.51 升到 75.77(成像质量 33.83→45.41);Matrix-Game 3.0 的 62.18 秒处取得 84.34,略超官方 3 步专用蒸馏的 84.30 与原生 50 步的 83.73。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SCOPE 世界模型生成(1378 个 CrossFPS 片段,4 步采样) | FVD ↓ | 478.7 | 朴素 4 步 805.5;SCOPE 专用蒸馏 502.1;原生 30 步 382.9 | 较朴素 4 步降低 40.6%,并反超任务专用蒸馏 4.6% |
| SCOPE 世界模型生成 | JEPA 语义相似度 ↑ | 0.792 | SCOPE 专用蒸馏 0.782;原生 30 步 0.868 | 语义保持优于专用蒸馏,接近原生多步 |
| Wan2.2-Fun-5B-Control 深度条件生成(600 个 PAI-Bench-C 用例) | 深度 si-RMSE ↓ | 1.641 | 朴素 4 步 2.135;专用蒸馏 1.515 | 较朴素 4 步降低 23.1%,接近专用蒸馏 |
| Wan2.2-Fun-5B-Control 深度条件生成 | DOVER 视频质量 ↑ | 10.11 | 朴素 4 步 8.90;专用蒸馏 10.25 | 较朴素 4 步提升 13.6%,与专用蒸馏基本持平 |
| ReWorld 世界模型 64 秒自回归 rollout | VBench 7 维均值 ↑ | 75.77(+Long,4 步) | ReWorld 原生 73.51(24 步) | 提升 2.26 分,且在达训练时长 8 倍的长度上全面领先 |
| Matrix-Game 3.0 世界模型 62.18 秒 rollout | VBench 7 维均值 ↑ | 84.34(+Long,4 步) | 原生 50 步 83.73;官方 3 步任务专用蒸馏 84.30 | 免训练条件下追平任务专用蒸馏 |
| 蒸馏成本对比(Wan2.2-TI2V-5B 上叠加 4 个下游任务) | 累计 H100 GPU 时 | 约 80(仅基座一次蒸馏) | 任务专用累计 456.8 | 节省约 82.5% 训练算力 |
局限与改进
作者明确承认四点:复用只对每个基座的兼容后代成立,超出兼容范围即失效;长上下文迁移要求目标模型本身已支持因果 AR 推理,因为 LoRA 更新不改变注意力掩码,无法给双向注意力模型凭空补上因果性;迁移质量存在任务相关的 trade-off,并非所有指标都赢专用蒸馏(如 ControlNet 上专用蒸馏 si-RMSE 1.515 更优、DOVER 10.25 略高);CFG LoRA 权重只提供近似引导控制,线性对应关系在下游特化后可能偏移,迁移后需要重新调整。我自己补充几点观察:原生 30/40 步的绝对质量仍然最高(SCOPE 上 FVD 382.9 对 478.7),本文交换的是速度而非无损压缩;54 个模型的覆盖验证多数只确认'能跑、质量不塌',深度定量只在 SCOPE 与 ControlNet 两个任务上完成;'兼容性'缺乏形式化判据,用户面对新下游模型时只能靠试;评测依赖 FVD、DOVER、VBench 等代理指标,与人类感知的对齐程度有限;GC-LoRA 旋钮的外推范围($\lambda_{cfg}>1$ 对应超训练 scale)缺乏理论保证。
独立分析的弱点
第一,兼容性边界模糊:只给出'已验证 54 个模型'清单,未形式化定义何种架构改动仍在兼容范围内,遇到新变体只能试错。改进方向:训练轻量兼容性探针,用小规模生成样本的分布偏移自动预测迁移是否安全。第二,CFG 旋钮的线性假设 $e_w = 1 + \lambda_{cfg}(w_{train}-1)$ 是经验近似,在重度特化下游上响应可能非线性甚至失稳;可为每个下游模型内置校准提示自动搜索 $\lambda_{cfg}$。第三,步数固定为 4,缺少步数-质量连续调节,可探索多预算蒸馏或步数条件化。第四,长上下文能力锁死在因果 AR 模型,覆盖不了双向注意力视频模型;可研究配合注意力掩码修改的联合方案。第五,定量验证集中在 SCOPE 与 ControlNet 两个任务,54 个模型大多只做部署验证;应按任务类别补齐与专用蒸馏的全面对比并加入人类评测。第六,加速未与量化、KV 缓存压缩等正交手段叠加分析,组合收益未知。
未来方向
作者提出的方向包括:公开全部代码、LoRA checkpoint 与训练/评测配置,扩展验证更多兼容模型;论文措辞暗示覆盖列表(Tab. 5)之外'可能支持额外兼容模型',即持续扩大验证矩阵。基于本文成果可自然延伸的方向有:其一,把秩与提示多样性两条经验规律升级为可预测的 scaling law,实现'给定目标迁移质量反推训练预算'的迁移导向蒸馏理论;其二,自动 $\lambda_{cfg}$ 校准与引导强度调度(不同去噪阶段用不同强度),把旋钮变成完整的引导控制接口;其三,探索跨家族 LoRA 迁移(如 Wan 系蒸馏的能力能否部分迁移到 HunyuanVideo 系),检验能力表示的普适性;其四,在交互式世界模型(Matrix-Game 类)中把长上下文 LoRA 与动作条件、记忆机制联合训练,处理更长时程的一致性;其五,将此范式推广到图像编辑、音频生成等其他模态的蒸馏复用,并与蒸馏量化、投机解码等正交加速组合,逼近'基座一次蒸馏、生态全量复用'的终局。
复现评估
复现条件较友好。作者承诺公开所有代码与产物:LoRA checkpoint、训练与评测配置、复现脚本,实现细节见附录 A。三个基座(Wan2.1-14B、Wan2.2-TI2V-5B、MiniMax-H3)及 SCOPE、Wan2.2-Fun-5B-Control、ReWorld、Matrix-Game 3.0 均为社区可获取模型;评测集 SCOPE/CrossFPS 1378 片段与 PAI-Bench-C 600 深度用例有公开协议。算力门槛是亮点:基座蒸馏一次仅约 80 H100 GPU 时(32 卡约 2.5 小时),单卡用户可直接下载 checkpoint 做免训练部署;若从头复现三个 LoRA 加上秩/数据消融,估计需数百 H100 GPU 时,中型实验室可承受。难点在评测管线搭建:FVD、DOVER、VBench、PAI-Bench-C 各有环境依赖,长上下文评测需在 16-64 秒 rollout 上匹配相机轨迹与随机性。另注意部分对照引用官方榜单分数(设置未公开),完全复现表格数字需自行重跑基线。
论文图表
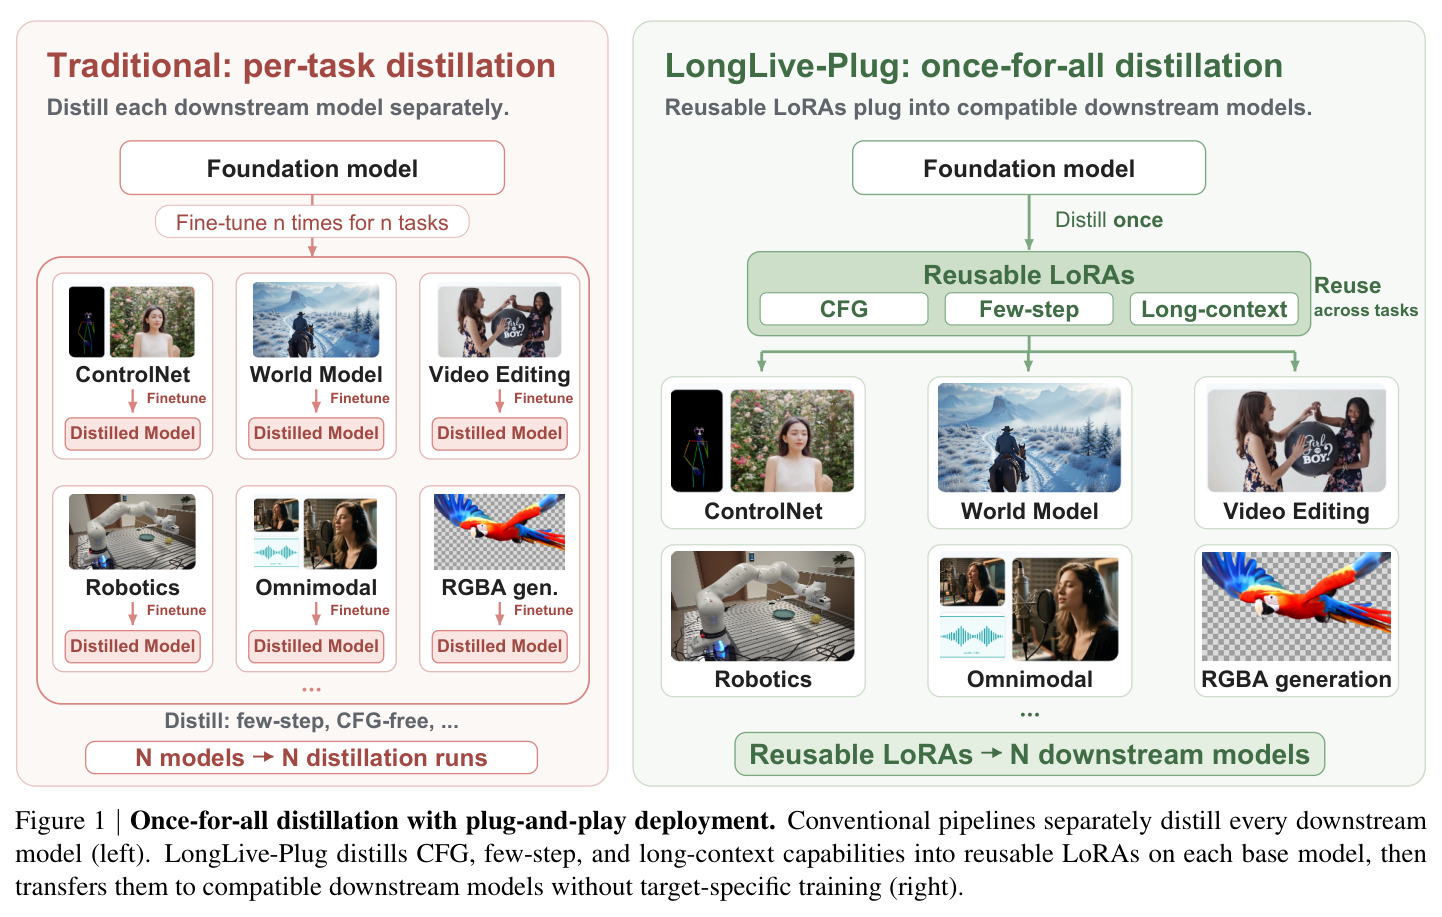
对比图:左侧传统流程中,ControlNet、世界模型、视频编辑、机器人、全模态、RGBA 生成等 n 个下游模型各自从基座微调后还要各做一次蒸馏,N 个模型 N 次蒸馏;右侧 LongLive-Plug 只在基座上蒸馏一次,得到 CFG、few-step、long-context 三个可复用 LoRA,即插即用服务所有下游模型。
一图概括全文动机与方法框架:把'每任务重复蒸馏'的成本问题与'能力封装为可复用 LoRA'的解法放在一张图里,是理解论文定位的入口。