基于条件偏移的少步流式视频生成 Few-Step Streaming Video Generation via Condition Shifting
用负文本条件在生成器内共享伪速度估计,去除DMD独立伪网络,实现少步流式视频生成
前置知识
Flow Matching(流匹配)
一种连续生成范式:对噪声 $z$ 与数据 $x$ 用最优传输线性插值路径 $x_t = tz + (1-t)x$,训练速度预测器 $F_\theta$ 回归已知目标速度 $u_r(x,z) = z - x$,损失为 $\mathcal{L}_{FM} = \mathbb{E}\|F_\theta(x_t,t,c) - u_r\|^2$。采样时从 $t=1$ 的纯噪声出发,沿概率流ODE $dx_t/dt = v(x_t,t,c)$ 数值积分到 $t=0$ 得到数据。
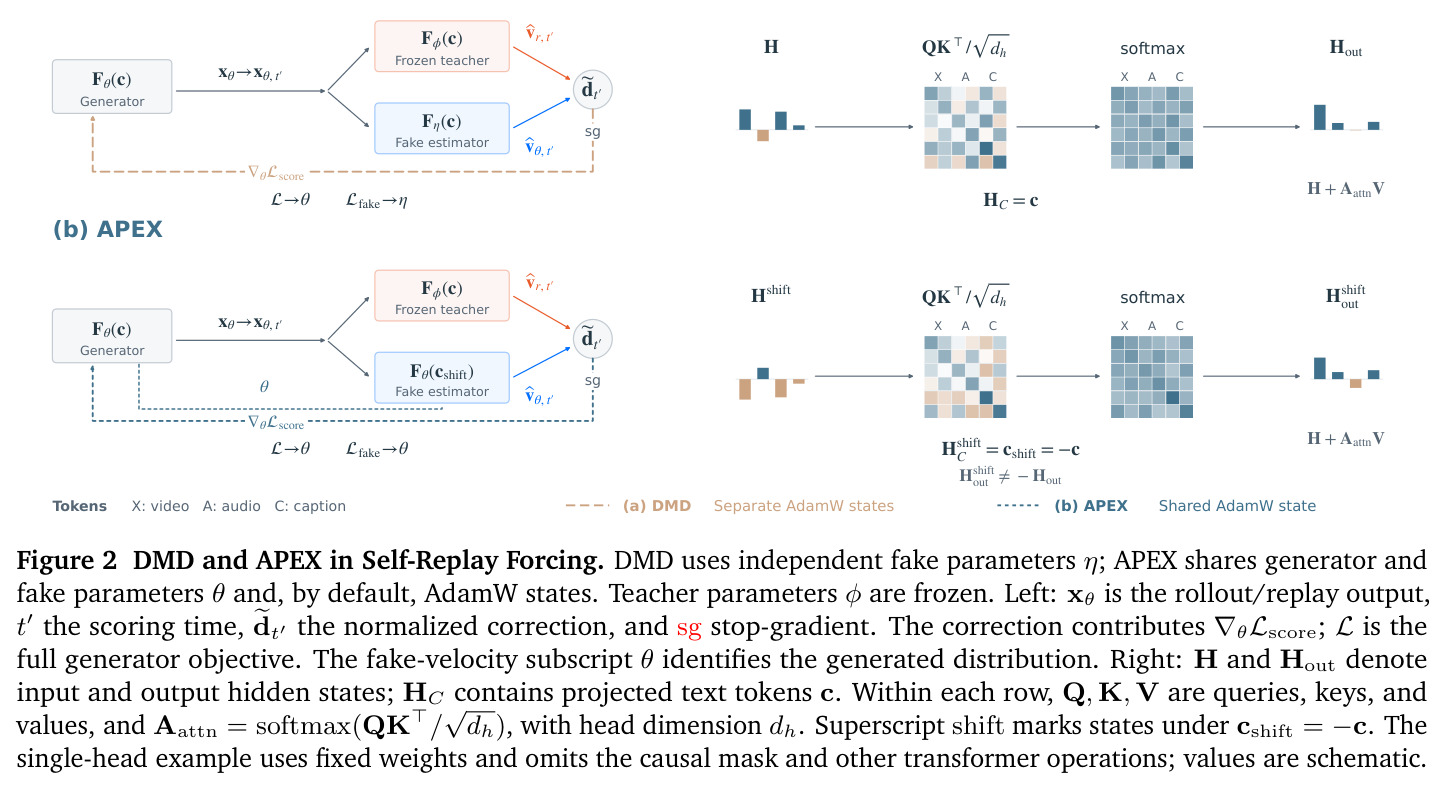
本文的蒸馏框架完全建立在速度场上:fake估计与参考教师输出的都是速度,二者干净潜变量之差与速度差成正比($\hat d_{t'} = t'(\hat v^{\theta,t'} - \hat v^{r,t'})$),不懂流匹配就无法理解修正项的构造。
DMD(Distribution Matching Distillation,分布匹配蒸馏)
少步蒸馏的主流方法:冻结的预训练教师提供真实分布的参考分数/速度,另设一个独立的fake-score网络在生成器当前输出的加噪样本上训练,逼近生成分布的分数;两个分数(速度)之差近似反向KL散度的梯度,用于更新少步生成器 $G_\theta(z,c) = z - F_\theta(z,1,c)$。
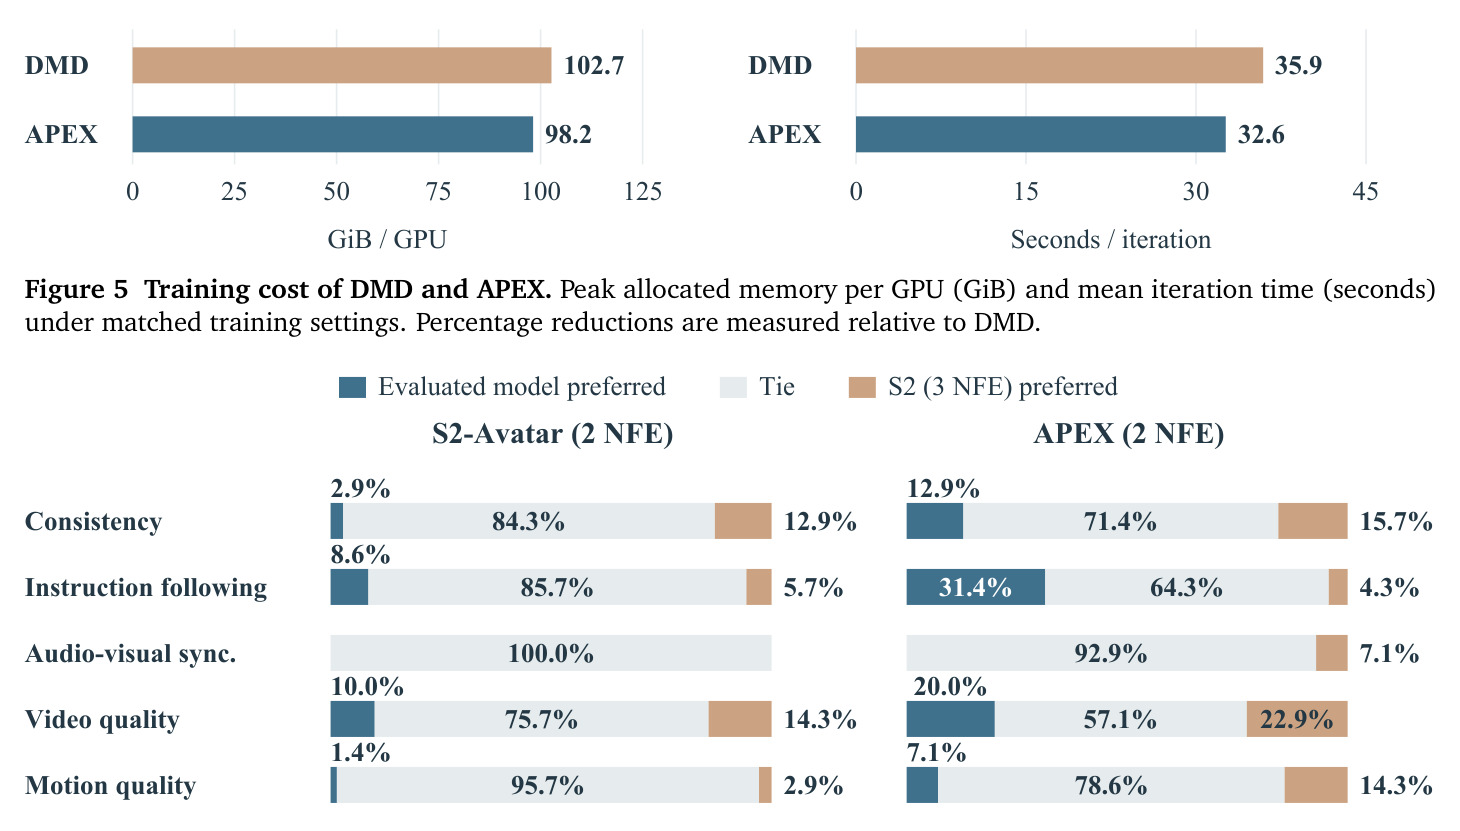
本文要解决的核心痛点就是DMD的独立fake网络:它带来额外显存与计算(每GPU峰值102.7 GiB、迭代35.9秒),且必须持续追赶演化中的生成器。理解DMD的师徒双网络结构,才能体会条件偏移方案的省法。
NFE 与少步采样
NFE(Number of Function Evaluations)指采样时骨干网络的前向评估次数。多步扩散/流模型每条样本需数十次NFE;一致性模型、区间映射等少步方法通过蒸馏把生成压缩到 $G_\theta(z,c) = z - F_\theta(z,1,c)$ 这样的1-2步映射。本文中每个视频块的骨干NFE为3(或2),另有一步共用的2×空间Refiner单独计。
流式生成每产出一个新块都要付一次完整去噪成本,180秒视频逐块累加后NFE开销是主要算力瓶颈,这正是少步蒸馏对流式场景价值巨大的原因。
流式自回归视频生成与扩散强迫(Diffusion Forcing)
长视频按块(block)自回归生成:块 $i$ 的潜变量 $x_i$ 在因果注意力掩码下关注自身token、条件与前序视频块,上下文 $h_i$ 含参考图、历史帧与音频。扩散强迫(DF)给序列中每块赋予独立噪声级 $t_i$,使一段带噪片段仍可一次性前向并保留跨块梯度。
流式设定下fake估计器要跟踪的是带因果历史回放的输出分布,而非孤立样本;本文的评分时间 $t'$、回放时间 $t_i$ 都嵌在这个因果结构里,不熟悉它就看不懂训练流程。
Self-Replay Forcing(SRF,自回放强迫)
S2-Avatar(Vidu S2)提出的流式视听生成训练方案:先做一次detach的自回归rollout,从中采样片段并用扩散强迫的噪声级重新加噪,再做一次可微因果前向,使片段内跨块梯度可传而外部历史保持detach;同时保留冻结教师与感知正则化 $\mathcal{L}_{perc}$。
本文完整保留SRF的回放流程、冻结教师与感知正则,只把其中的DMD式fake估计器替换为条件偏移版本。SRF是理解本文实验设定(回放时间 $t_i \in \{0.75, 0.9375, 0.99\}$ 等)的背景框架。
条件偏移(Condition Shifting)
用一个网络承载两种角色:输入原始投影文本嵌入 $c$ 时执行少步生成;输入其相反数 $c^{shift} = -c$(在transformer块之前取负)时执行生成分布的fake速度估计。同一套参数 $\theta$、正的扩散时间,靠条件符号路由到不同计算模式;隐藏态 $H^{shift}_{out} \neq -H_{out}$,说明负条件激活的是不同模式而非输出取反。
这是本文的核心机制与标题由来。原版APEX在非流式设定提出该机制,本文把它推广到带因果历史的流式视频;理解"条件符号即角色开关"是读懂全文的前提。
研究动机
少步采样对流式视频生成至关重要:流式系统每产出一个新视频块都要支付整条去噪链路的成本,180秒长视频逐块生成时,即便每块只做3次骨干网络评估(3 NFE),累计开销也非常可观,因此蒸馏压缩NFE是刚需。主流方案DMD用冻结教师提供参考分数,另设一个独立的fake-score网络在生成器输出上训练,以分数差逼近反向KL梯度。把这套配方搬到S2-Avatar级别的大型视听骨干上有两大痛点:其一,fake网络是另一套完整参数,DMD训练时每GPU峰值分配显存达102.7 GiB、平均单次迭代35.9秒,维护并更新这个辅助网络占了相当份额;其二,生成器分布在训练中不断漂移,fake网络必须持续跟踪,两组网络的学习率与更新节奏需要小心协调,否则训练不稳定。流式场景还额外加码:fake估计器跟踪的是带因果历史(参考图、前序块、音频)的自回放输出,分布随历史滚动演化,跟踪难度更高。
本文的目标是本文的目标可以概括为"一减一保一证"。减:在S2-Avatar的Self-Replay Forcing框架内彻底移除DMD的独立fake-score网络,把生成分布的速度场估计收进生成器自身参数,目标是相对DMD降低训练显存与时间(实测目标:匹配设置下峰值显存从102.7 GiB下降、迭代时间从35.9秒缩短)。保:完整保留S2-Avatar的冻结参考教师(提供与原方案相同的参考引导)、自回放流程与感知正则化,不改动数据与训练流水线。证:让3 NFE甚至2 NFE的180秒流式视频生成在指令遵循等关键维度不输乃至超过原S2-Avatar的3 NFE基线,并通过70例专家人评、全部320例StreamAV-Bench基准以及训练成本测量给出系统证据。
与已有工作不同的是,已有工作证明"生成与分布估计可共享一个网络":TwinFlow用正/负时间分别标记真实轨迹与fake轨迹;原版APEX用条件输入选择fake估计器,但均在图像或非流式设定下验证。流式视频的独特困难在于fake估计器要跟踪的是带因果历史的自回放输出,分布随回放滚动漂移。本文的独特切入是把APEX的条件偏移机制嵌入S2-Avatar的Self-Replay Forcing:在transformer块之前将投影文本取负得到 $c^{shift} = -c$,偏移条件选择fake估计、原始条件选择生成,两角色共享全部参数 $\theta$ 乃至默认共享AdamW优化器状态,同时保留S2的冻结教师提供参考预测与DMD式目标。据论文所述,这是首个在带因果历史的流式视听生成中用单网络双角色完成分布匹配蒸馏的方案,并用独立测量量化了相对DMD的训练节省。
核心方法
直觉上,让同一个网络身兼二职:读到原始文本嵌入 $c$ 时是少步生成器,读到相反数 $c^{shift} = -c$ 时是生成分布的fake速度估计器,条件符号如同角色开关。技术路线:先做detach的自回归rollout生成视频块;采样回放片段并按扩散强迫以回放时间 $t_i \in (0.75, 0.9375, 0.99)$ 加噪,一次可微因果前向产出干净预测;再将输出整体detach、在统一评分时间 $t'$ 重加噪 $x^{sg,\theta}_{t'} = (1-t')x^{sg,\theta} + t'\epsilon'$,用偏移条件预测fake速度 $\hat v^{\theta,t'} = F_\theta(x^{sg,\theta}_{t'}, t', c^{shift})$,以 $\epsilon' - x^{sg,\theta}$ 为目标做流匹配损失 $\mathcal{L}_{fake}$;冻结教师 $F_\phi$ 对同一输入预测参考速度,干净潜变量差 $\hat d_{t'} = t'(\hat v^{\theta,t'} - \hat v^{r,t'})$ 经归一化后作为detach修正项构成 $\mathcal{L}_{score}$;总损失 $\mathcal{L} = \mathcal{L}_{score} + \mathcal{L}_{perc}$ 与fake更新在共享参数上交替,默认共享AdamW状态。推理用原始文本条件,每块3或2次骨干NFE,外加共用单步2×空间Refiner。
核心创新是"条件偏移 + 共享优化器状态"取代DMD的独立fake网络。DMD中fake估计器是独立参数 $\eta$,既占显存算力(实测每GPU峰值102.7 GiB、迭代35.9秒),又要追赶演化中的生成器分布;本文把fake角色编码进条件符号:投影文本在进入transformer块之前取负 $c^{shift} = -c$,注意力机制自然把同一套权重路由到不同计算模式——论文Figure 2用单头注意力示意隐藏态 $H^{shift}_{out} \neq -H_{out}$,说明负条件激活的是网络的不同模式而非简单输出取反。由此生成器与fake估计器共享全部参数 $\theta$,默认还共享AdamW动量状态,fake估计随生成器同步演化、无需协调两组超参;同时保留S2-Avatar的冻结教师 $F_\phi$ 提供参考速度与DMD目标,以及SRF回放与感知正则。与TwinFlow的正负时间方案相比,本文在条件维度区分角色、时间轴恒为正,更契合流式生成中每块噪声级各异的因果结构。
方法步骤详情
训练迭代六步。(1)自回归rollout:以原始文本条件逐块生成,外部历史detach。(2)回放前向:采样片段,按扩散强迫以 $t_i \in \{0.75, 0.9375, 0.99\}$(默认等权)加噪并排序,可微因果前向输出干净预测 $\hat x_i^0 = x_i^{t_i} - t_i F_\theta(x_i^{t_i}, t_i, c_i \mid h_i)$。(3)fake估计:评估块 $x^\theta_{1:N}$ 整体stop-gradient后在评分时间 $t'$ 重加噪(式5),偏移条件预测 $\hat v^{\theta,t'}$(式6),以 $\epsilon' - x^{sg,\theta}$ 为目标计算 $\mathcal{L}_{fake}$(式7),仅更新偏移分支。(4)参考引导:冻结教师对同一输入预测 $\hat v^{r,t'}$,干净潜变量差 $\hat d_{t'} = \hat x^{0,r} - \hat x^{0,\theta} = t'(\hat v^{\theta,t'} - \hat v^{r,t'})$(式9),按附录B.3归一化为 $\tilde d_{t'}$。(5)生成器修正:$\mathcal{L}_{score} = \mathbb{E}\,\mathrm{MSE}(x^\theta_{1:N},\ \mathrm{sg}(x^\theta_{1:N} + \tilde d_{1:N}))$(式10),目标固定,梯度经回放输出及因果表征传播。(6)联合更新:$\mathcal{L} = \mathcal{L}_{score} + \mathcal{L}_{perc}$ 与第(3)步在共享 $\theta$ 上交替,默认共享AdamW状态,教师 $\phi$ 冻结。推理:原始文本条件按3(或2)NFE/块生成,再过共用单步2× Refiner。
技术新颖性
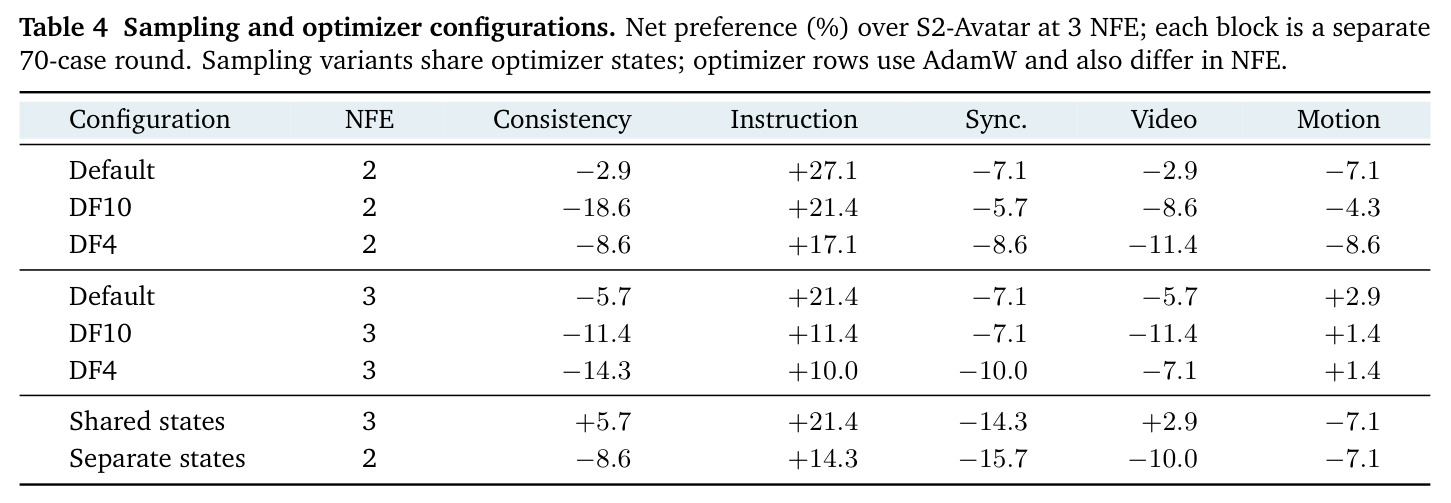
新颖性有三。第一,机制迁移的首创性:把APEX条件偏移从图像/非流式设定首次推广到带因果历史的流式视听生成,fake估计器拟合的是Self-Replay Forcing回放输出——模型自己在因果历史下生成的序列,分布随回放滚动漂移;论文证明共享参数估计器能跟踪这种动态分布(指令遵循净偏好3 NFE为+21.4%、2 NFE为+27.1%,均为正)。第二,效率论证扎实:匹配训练设置下的独立测量显示,相对DMD每GPU峰值显存从102.7降至98.2 GiB(-4.4%,省4.5 GiB),平均迭代时间从35.9降至32.6秒(-9.2%),且是在保留冻结教师的前提下取得的。第三,消融审慎:不仅测共享/分离AdamW状态(共享3 NFE +21.4%,分离2 NFE +14.3%),还扫描回放时间采样(默认等权 vs DF4权重(4,1,1)、DF10权重(10,1,1)),确认默认配置最优。此外式(11)给出 $\hat d_{t'} = -\frac{t'}{1-t'}(\hat s^{\theta,t'} - \hat s^{r,t'})$,把速度域修正与DMD的分数差理论接通。
实验结果
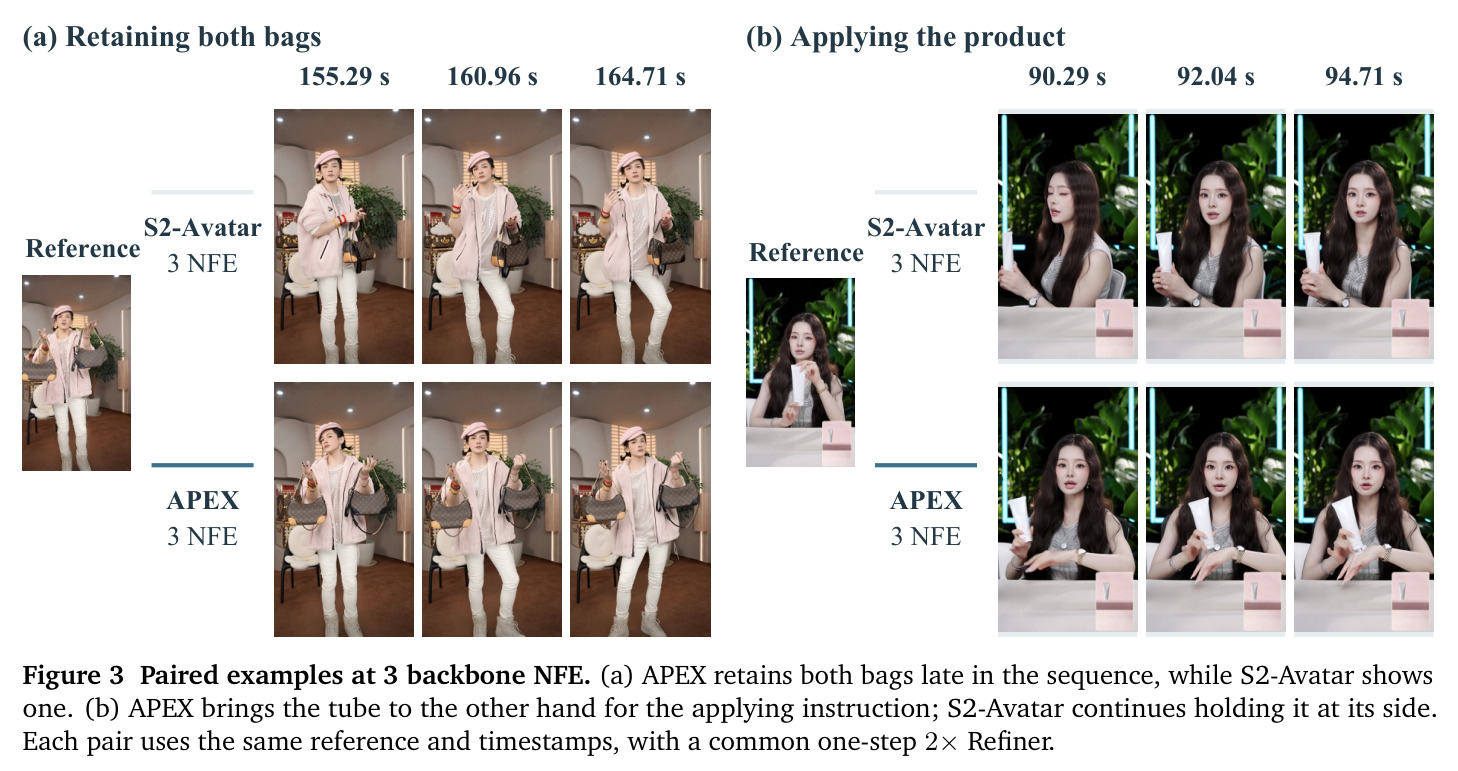
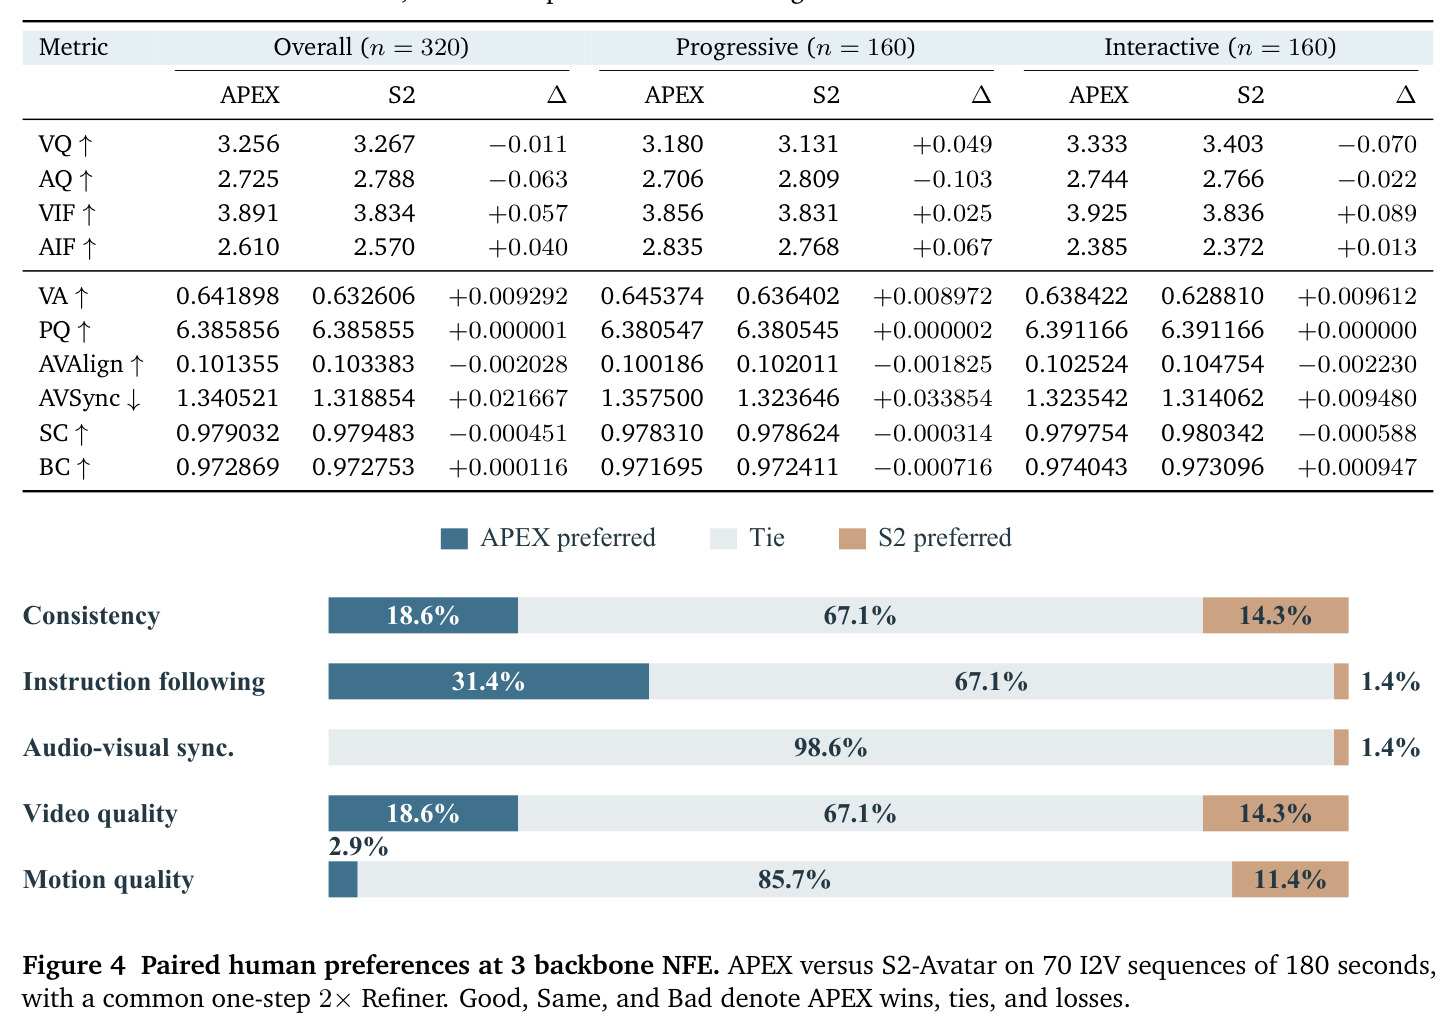
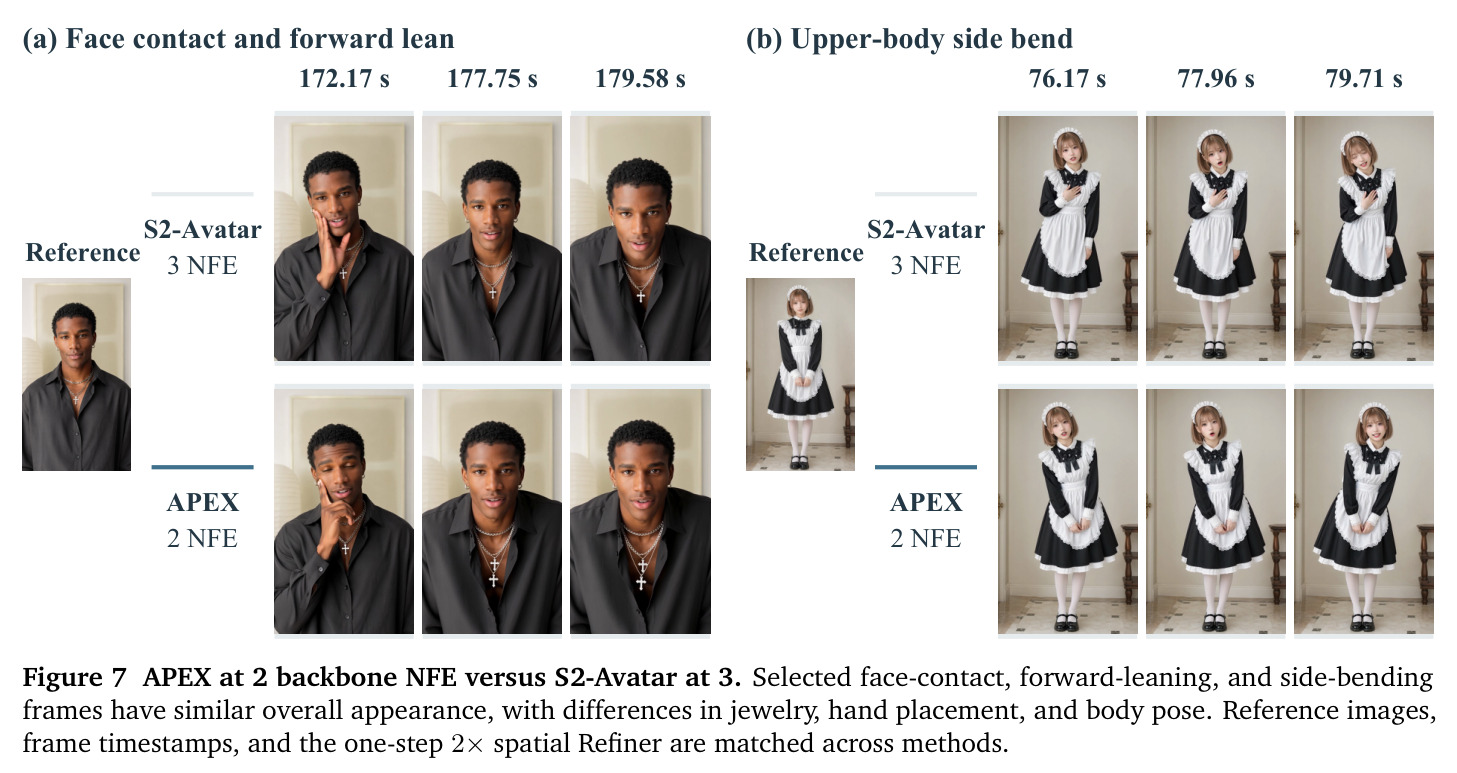
核心结果分四块。(1)基准对比:全320例StreamAV-Bench上,APEX在12个可比模型中VA、VIF、AIF三项第一、VQ第二;相对S2-Avatar,VIF总体+0.057(Progressive 3.856 vs 3.831,Interactive +0.089),AIF总体+0.040(Progressive +0.067),VA三轨全升(总体0.641898 vs 0.632606,+0.009292);代价是AQ总体-0.063、AVSync误差1.319→1.341秒、AVAlign -0.002028,VQ总体-0.011(Progressive +0.049但Interactive -0.070),BC(+0.000116)与PQ(+0.000001)基本持平。(2)人评:70对180秒I2V序列上,指令遵循22胜47平1负、净偏好+30.0%(MOS 4.17 vs 3.99)为最强项;一致性与视频质量各+4.3%;音画同步69/70平、仅1负(-1.4%,MOS 4.23 vs 4.26);运动质量偏向S2-Avatar(-8.6%);两模型可用率均为62/70即88.6%。(3)训练效率:峰值显存102.7→98.2 GiB(-4.4%),迭代时间35.9→32.6秒(-9.2%)。(4)低步数与消融:2 NFE下APEX对S2-Avatar(3 NFE)指令净偏好+27.1%(22胜45平3负),而S2-Avatar自降2 NFE仅+2.9%;回放时间默认等权最优(2 NFE +27.1%、3 NFE +21.4%),DF10/DF4加权反而下降;共享AdamW状态3 NFE +21.4%,分离状态2 NFE +14.3%。
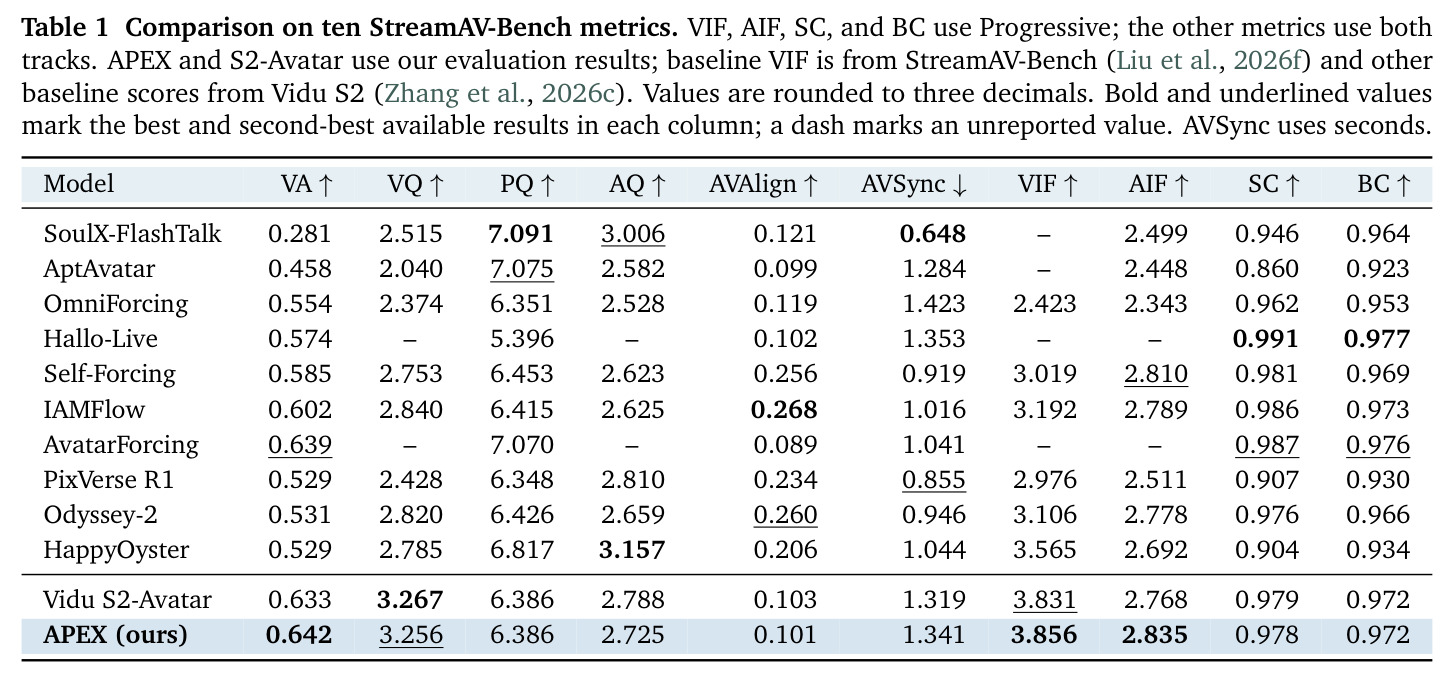
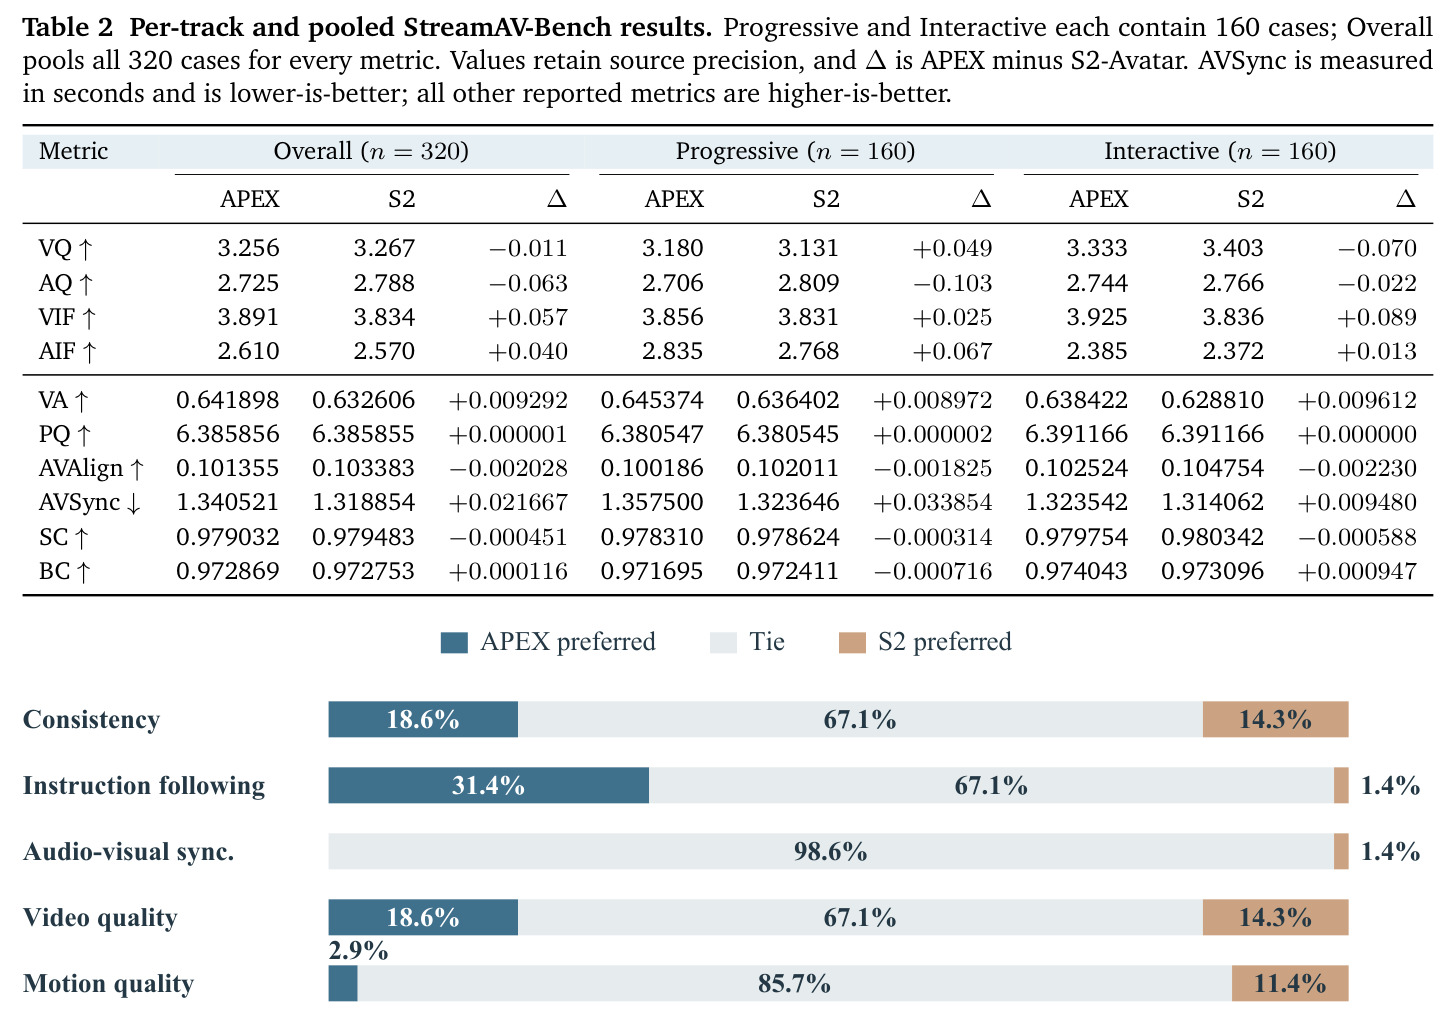
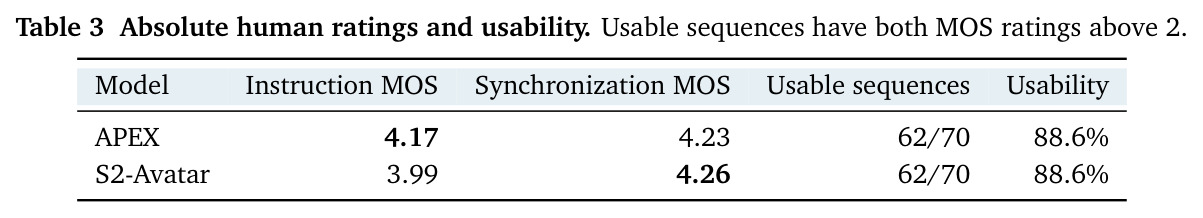
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式视频生成(StreamAV-Bench,Progressive 160例) | VIF 视频指令遵循 | 3.856 | 3.831(S2-Avatar,12模型中最高基线) | +0.025,12模型中排名第一 |
| 流式视频生成(StreamAV-Bench,320例总体) | VA 视觉美学 | 0.641898 | 0.632606(S2-Avatar) | +0.009292,两轨均提升,排名第一 |
| 流式视频生成(Progressive) | AIF 音频指令遵循 | 2.835 | 2.768(S2-Avatar) | +0.067,排名第一 |
| 180秒I2V人评(70对序列) | 指令遵循净偏好(Good-Same-Bad) | +30.0%(22胜/47平/1负),MOS 4.17 | S2-Avatar 3 NFE,MOS 3.99 | 净偏好+30.0%,MOS +0.18 |
| 2 NFE少步生成(70对人评) | 指令遵循净偏好 vs S2-Avatar 3 NFE | APEX 2 NFE:+27.1%(22胜/45平/3负) | S2-Avatar 2 NFE:仅+2.9% | 领先24.2个百分点 |
| 训练效率(匹配训练设置,相对DMD) | 每GPU峰值分配显存 | 98.2 GiB | 102.7 GiB(DMD) | -4.4%(省4.5 GiB) |
| 训练效率(匹配训练设置,相对DMD) | 平均迭代时间 | 32.6 秒/迭代 | 35.9 秒/迭代(DMD) | -9.2%(省3.3秒) |
| 音画同步(320例总体) | AVSync 时序偏移误差(秒,越低越好) | 1.341 s | 1.319 s(S2-Avatar) | 误差+0.022 s(该项为负向 trade-off) |
局限与改进
作者明确承认的取舍:运动质量人评偏向S2-Avatar(净偏好-8.6%,2 NFE下-7.1%),说明蒸馏后的少步生成在时序动态上仍有损失;音画同步误差略升(AVSync 1.319→1.341秒,人评70对中1负0胜),AVAlign总体-0.002028;AQ总体-0.063(Progressive轨-0.103),音频与音画相关指标是系统性短板;VQ在Interactive轨-0.070、总体-0.011,视觉质量并非全面占优。我的补充观察:多项指标差距极小(BC +0.000116、PQ +0.000001、SC -0.000451),实际意义有限;人评仅70对且评审为艺术/美学背景专家,论文未报告置信区间或显著性检验,+30.0%的净偏好(基于22胜1负)统计功效存疑;优化器消融中共享状态配3 NFE、分离状态配2 NFE,NFE与优化器两个变量同时改变,无法干净分离优化器状态本身的效应;所有质量结论均相对S2-Avatar单一基线,未与"用省下的显存做更大batch的DMD"这类算力对齐基线比较,也未评测其他骨干上的泛化。
独立分析的弱点
弱点一:运动质量退化(人评净偏好-8.6%)。detached修正目标 $\tilde d_{t'}$ 来自单时间点 $t'$ 的速度差,可能系统性低估时序动态;改进方向是在 $\mathcal{L}_{score}$ 中对运动敏感区域加权,或引入光流/运动感知正则,或多评分时间联合监督。弱点二:音画同步小幅恶化(AVSync误差1.319→1.341秒、AVAlign -0.002028)。共享参数双角色可能在对齐敏感表征上互相干扰,可仅对音频相关层保留独立参数,或在偏移条件中注入模态标识而非简单取负。弱点三:条件符号复用限制表达——生成与fake估计的最优表征未必能用 $c$ 与 $-c$ 两个线性对立点完全分开,Figure 2虽示意 $H^{shift}_{out} \neq -H_{out}$,但缺少两角色干扰的量化分析;可补充探针实验或改用可学习偏移向量。弱点四:优化器消融混杂NFE变量(共享配3 NFE、分离配2 NFE),应在同一NFE下对照。弱点五:结论绑定S2-Avatar单一骨干与同一训练数据,跨骨干泛化未验证,且运动/同步退化的根因(蒸馏本身 vs 条件偏移)缺少归因实验。
未来方向
作者方向上:论文指出式(11)的induced score要作为真实条件分数需在common conditioning下校准,附录B.3/B.8给出梯度推导与GAN联系,未来可深入条件偏移下的分数校准理论;运动质量与音画同步的trade-off是明确改进空间。基于成果可延伸:(1)多角色条件偏移——用 $c$、$-c$ 之外的正交变换同时承载教师模拟、critic等更多角色,进一步压缩训练开销;(2)2 NFE已具+27.1%正偏好,可探索1 NFE极限并与量化、KV-cache压缩叠加逼近实时流式;(3)把共享估计器思想移植到DMD2等变体,在视频上系统对比收敛性与质量;(4)回放时间采样从固定集合 $\{0.75, 0.9375, 0.99\}$ 等权改为可学习或按损失加权调度(当前DF4/DF10加权反而降低指令偏好,说明简单加权不是答案);(5)在超过180秒的视频、多角色交互与开放域内容上检验分布持续漂移下共享估计器的稳定性。
复现评估
严格复现难度较高。数据与骨干方面:训练完整复用S2-Avatar(Vidu S2)的数据与流水线(直播、口播、影视、独舞、2D/3D动画,见附录C),这些数据与视听骨干大概率不公开;正文未声明代码开源。可复现部分:StreamAV-Bench的160+160评测场景与12个基线分数来自公开基准(表1中APEX与S2-Avatar两行为作者自测结果);方法描述较完整——式(4)-(10)、评分时间 $t'$ 与回放时间集合、损失归一化(附录B.3)均有明确定义,若拿到开放流式视听骨干可尝试移植,但学习率、batch、迭代数等超参未披露。算力方面:匹配测量显示每GPU峰值分配约98-103 GiB,需要H100级别高显存多卡配置,训练成本为周量级;人评需70对180秒序列与美学背景评审,难以复制。综合判断:核心机制可在小规模图像设定先行验证(APEX原论文路径),但本文的流式视频定量结果在缺乏代码与数据的情况下几乎无法严格复现,更适合作为方法学参考而非复现目标。
论文图表
展示APEX的流式生成与交互能力:上排为Progressive与Interactive两条Track的StreamAV-Bench示例(3 NFE + 2× Refiner,覆盖0至179秒),下四行依次展示物体交互、转身("Turn around")、跳舞("Do a dance")与讲故事("Tell a story")等中文指令的时序帧,标注了各帧的时间戳。
这是读者对系统能力的第一印象:直观呈现180秒级流式生成与中途指令响应的实际效果,帮助理解论文要解决的应用场景(长视频流式生成+实时交互)。
2 NFE下的两组独立70对人评(均以S2-Avatar 3 NFE为参照):APEX 2 NFE的一致性-2.9%、指令遵循+27.1%(31.4%胜/64.3%平/4.3%负)、同步-7.1%、视频-2.9%、运动-7.1%;S2-Avatar 2 NFE仅指令遵循+2.9%、其余维度均为负。
证明APEX在更低推理预算下仍保持指令遵循优势,且其2 NFE明显优于基线自身的2 NFE(+27.1% vs +2.9%),凸显蒸馏质量而非单纯步数效应。