智能体上下文裂解:通过自适应结构化非结构化数据实现令牌高效的数据推理智能体 Token-Efficient Data Reasoning Agents via Adaptive Structuring of Unstructured Data
让智能体在打开文档推理时顺手裂解出结构,后续问题降本53%且精度不损失
前置知识
数据库裂解(Database Cracking)
一种自适应索引技术:不做一次性的完整排序或组织,而是让每条查询到来时顺带对数据做局部重排(例如按查询的值把列划分成片段),使后续查询越来越快。索引工作被摊销进查询执行本身,系统随使用逐步适应工作负载,无需预先知道访问模式。由 Idreos 等人在 CIDR 2007 提出。
本文方法的名字与核心哲学直接源自它:用观察到的查询驱动结构化。区别在于数据库裂解重组已存在的关系,而本文从非结构化文档中凭空创建结构。
预填充与解码(Prefill vs Decode)
Transformer 推理分两阶段:prefill 并行处理所有输入 token,计算密集,成本随输入长度线性增长;decode 逐个生成输出 token,主要受内存带宽限制。把长文档载入上下文的开销几乎全部集中在 prefill 阶段,而短答案的生成(decode)成本很低。
数据推理是典型的 prefill 密集型工作负载:反复打开大文档、最终答案只有几个词。理解这一成本结构,才能理解为何把成本转移到小额受控的 decode 能省下这么多。
KV 缓存与共享前缀复用
自注意力推理时每个 token 的 Key/Value 会被缓存。若两个请求共享相同前缀(例如同一份文档已完成 prefill),可通过 prompt caching 或 shared-prefix serving 复用已算好的 KV 状态,第二次生成只需为新增 token 付 decode 成本,缓存读取在 API 计费中也按更低费率结算。
裂解子智能体正是从已加载文档的 KV 缓存前缀分叉出来的,这是'裂解边际成本几乎为零'这一核心设计的工程基础,也是全文经济学论证成立的前提。
FanOutQA 与多跳问答
一个基于维基百科的宽扇出多跳问答基准:回答一个问题平均要跨约 7 个文档收集证据,例如'曾与希区柯克和斯科塞斯都合作过的演员有哪些'。它提供词面匹配(string accuracy)和 LLM-as-judge 两种自动评分方式,专门考察跨文档的证据组装能力。
它是本文的主实验基准,所有成本与准确率数据都来自它;理解其'宽扇出、文档几乎不重复访问'的特性,才能理解作者为何要人为注入相关问题来制造局部性。
RDF 三元组与知识图谱边
资源描述框架(RDF)用〈主语, 关系, 宾语〉三元组表示事实,如〈希区柯克, 执导, 眩晕〉;海量三元组构成知识图谱。边还可携带基数(单值或列表)、单位等元数据,并可通过出处(provenance)记录证据来源。
裂解对象的数据模型是扩展 RDF 边 $c=\langle s,r,o,\kappa,u,\varepsilon\rangle$,带基数 $\kappa$、单位 $u$ 和证据 $\varepsilon$。读懂这个模型才能理解存储、目录与结构化读取的接口设计。
研究动机
现实世界的大量知识埋在非结构化数据里:网页、法律合同、SEC 文件、财报电话会记录、PDF。LLM 智能体可以模仿人类的多步推理去回答这类复杂问题,准确率远超依赖参数知识或固定 top-$k$ 检索的 RAG,但代价高昂。这类'数据推理'是 prefill 密集型的:智能体必须反复把大文档载入上下文,从散落各处的证据中拼出中间结果,而最终答案往往只有几个词。在 FanOutQA 基准上用 Haiku 模型,回答单个问题最多消耗约 100 万 token、成本接近 1 美元;真实企业问题扇出更大、深度更深,只会更贵。作者用实验标定了机会空间:从 FanOutQA 抽样十个问题,人工把回答所需的全部事实抽取进数据库后重跑智能体,每个任务退化为一次数据发现加一条廉价的 Text2SQL 查询,推理比在原始文档上便宜 28 倍。但预先结构化一切并不可行:文档包含的实体、属性和关系比任何工作负载会用到的多出几个数量级,穷尽抽取等于无界的解码开销,而且在工作负载到来之前,根本不知道哪些结构值得抽取、会被复用多少次。
本文的目标是本文的目标是弥合'智能体精度'与'数据库成本'之间的鸿沟:让系统在保持智能体级答案质量的同时,把数据推理的 token 消耗与 API 成本大幅降下来,并且让系统随使用越来越便宜。具体做法是 agentic context cracking(智能体上下文裂解):系统永远不为了抽取结构而单独打开文档;只有当推理智能体为回答当前问题而打开某个文档时,才'顺路'分叉一个裂解子智能体,用小额固定解码预算(每问题 4K token)从这份已经付费加载的上下文中,投机性地提取有证据支撑的实体、属性和关系,存入裂解对象库;后续相关查询通过结构化读取复用这些对象,从而完全跳过文档打开与 prefill。作者设定了两个可检验的命题:一是在每个测试问题仅有一次复用机会的严苛设定下就能显著降本(实测约 53%),二是随着调查式长工作负载积累,节省应向理想预结构化存储所标定的 28 倍上限收敛。
与已有工作不同的是,已有方案各有盲区,本文的独特切入是把数据库裂解的查询驱动哲学迁移到 LLM 推理。与知识库构建、知识图谱和 GraphRAG 相比,那些方法在查询到来前盲目构建,前期成本高且可能永不摊销;本文只在查询揭示需求后才提取,方向由观察到的查询引导。与逐查询抽取的 query-driven document analytics 相比,本文的产物是可跨问题复用、持续积累的持久结构。与语义缓存(如 GPTCache)相比,语义缓存只能服务近似重复的问题,而裂解对象服务的是目标属性不同但实体重叠的相关问题。与持久化文档和共享前缀 KV 状态的服务系统(Mooncake、CacheGen、CacheBlend 等)相比,KV 状态绑定单一模型、体积远大于源文本、占据 GPU 或主机内存,而裂解产物是纯文本,跨模型升级可迁移。此外本文利用了被忽视的双重局部性:工作负载层面的语义局部性(相关查询反复重开相同文档,这是用户兴趣相似与文档热点共同造成的常态)与推理层面的 KV 复用(文档 prefill 已完成,fork 只付 decode)。二者叠加,才让'自适应地创建尚不存在的结构'第一次在经济上成立。
核心方法
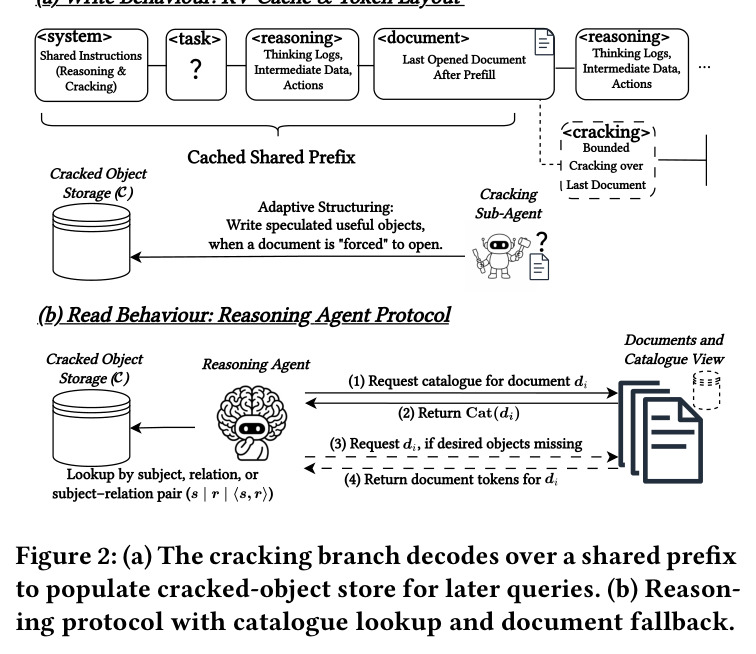
核心直觉是'读一次、付一次':当推理智能体为了回答当前问题打开一个文档时,这份文档的 prefill 已经完成、KV 缓存已经存在,此时分叉一个并行分支去做结构化提取,只需额外支付一小段受控的 decode 费用——这是整篇论文的经济杠杆。技术路线由读写两种行为组成。写行为:文档进入上下文后,裂解子智能体从共享前缀分叉(本地 serving 复用 KV 前缀,API 下命中 prompt cache 按低费率读取),它能看到当前与历史查询,用语义推理投机性地猜测哪些实体集、属性、关系可能服务未来相关查询,以 schema 约束的 JSON 输出裂解对象;后处理负责规范化并只插入有证据支撑的对象。读行为:推理智能体先查目录——一个列出每个文档可用〈主语, 关系, 基数〉对的逻辑视图——若所需结构已在库中就发起结构化读取,拿回紧凑的值与证据,避免文档 prefill;未命中则保守回退打开原始文档。关键工程约束是:裂解分支始终并行于答案依赖路径之外,绝不阻塞或拖慢当前查询,失败也不影响回答。
关键创新首先是与数据库裂解的本质区别:数据库裂解在'已存在的关系'上做自适应重组(例如逐步划分已排序列),而 agentic context cracking 在'不存在结构的地方'自适应地创建结构——文档里并没有表,是子智能体用语义理解提炼出可复用的实体、属性与关系。其次是投机性:裂解不被限制在当前查询请求的属性上,例如查询 NBA 得分王的生涯场均得分时,子智能体可顺带提取篮板、助攻等其他统计量,这正是它能服务'目标属性不同但实体重叠'的未来问题的原因,也是它与语义缓存的分水岭。第三是成本工程的洞察:把结构化时机与文档加载时机绑定,KV 缓存复用使裂解的边际开销仅为每问题 4K token 的解码预算(实测约 12% 开销),远小于它省下的 prefill。第四是产物形态:裂解对象是带证据 $\varepsilon=\langle d,\rho\rangle$(来源文档与支持区域)的纯文本边,不像 KV 缓存绑定模型、体积庞大,它能跨模型升级迁移、随使用复利积累,成为组织的数据护城河。
方法步骤详情
完整流程分六步。第一步,推理智能体接收数据推理问题,规划多步流程并搜索语料库,拥有文件系统式的搜索、导航与打开工具。第二步,当裂解对象读取未命中(miss)时,智能体打开原始文档,prefill 完成后上下文进入 KV 缓存。第三步,裂解子智能体从该缓存前缀分叉,输入当前问题、历史查询与裂解指令,输出受 schema 约束的 JSON,要求列表关系要么完整提取要么整体省略;解码预算为每问题 4K token,跨多次分叉共享,还允许提取查询未请求的'邻近'结构。第四步,后处理规范化:统一数字、单位与日期,校验不变量,把列表展开为独立可索引的边,只插入有证据的裂解对象 $c=\langle s,r,o,\kappa,u,\varepsilon\rangle$,其中基数 $\kappa\in\{\text{singular},\text{list}\}$ 区分单值与集合关系,证据 $\varepsilon=\langle d,\rho\rangle$ 记录源文档与支持区域。第五步,后续查询先查目录 $\mathrm{Cat}(d)\triangleq\pi_{s,r,\kappa}\,\sigma_{\mathrm{doc}(\varepsilon)=d}(C)$,它随搜索结果一起呈现,列出可用的〈主语, 关系, 基数〉对;若结构在库中,智能体发起结构化读取拿回紧凑值与证据,跳过整个文档 prefill。第六步,任何缺失都回退打开原始文档,保证精度下限。
技术新颖性
技术新颖性体现在四个层面。其一,定位在两个极端之间:一边是查询前盲目构建的知识图谱与 GraphRAG,另一边是只服务当前查询的逐文档抽取与 dataspace 式按需集成,本文让观察到的查询增量地引导'抽取什么',且抽取刻意超出当前问题所需(投机),在语义缓存与 KV 持久化之间开辟了新物种——服务相关但不同的问题、可读可推理的纯文本结构。其二,把数据库裂解从'重组已有关系'推广到'从非结构化文本创建结构',并论证了为何在此场景适应性更有价值:穷尽抽取不可行、KV 复用让开销可忽略、收益却随问题扇出放大到数量级。其三,推理系统层面的协同设计:裂解分支严格并行于答案依赖路径之外、有固定 token 预算、失败可降级,这种'外部、异步、有预算'的写路径把降本与鲁棒性解耦。其四,实证锚点清晰:作者用人工构建的理想预结构化存储标定出 28 倍的机会上限,让后续任何自适应结构化工作都有可比较的天花板,这一评测方法论本身也有贡献。
实验结果
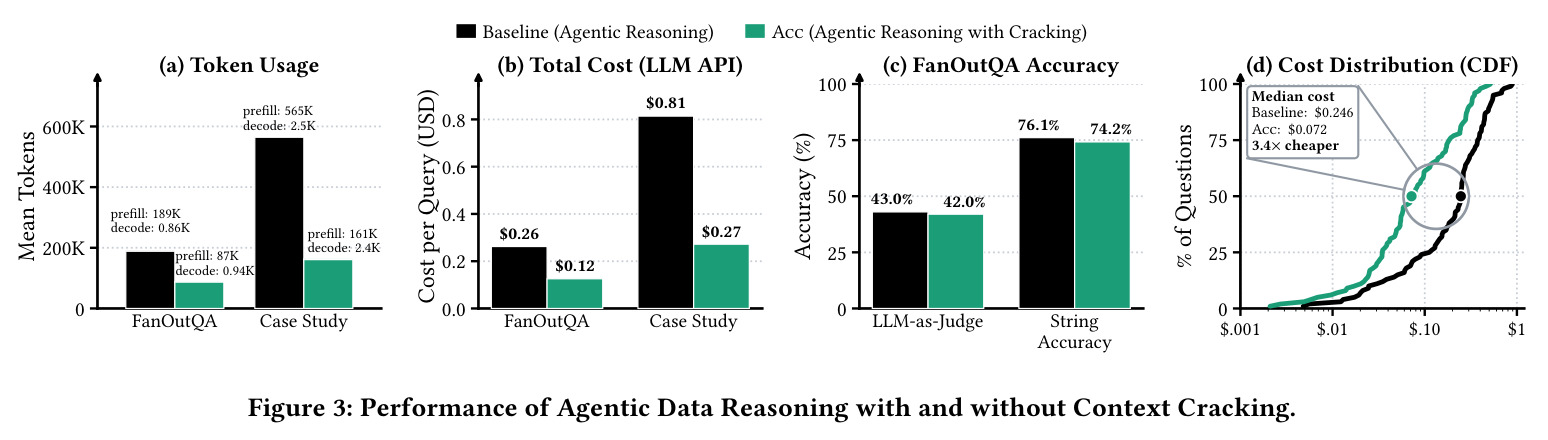
主实验在 FanOutQA 上进行:用 claude-opus-5 为每个测试问题生成一个'实体重叠但目标属性不同'的相关问题并经人工校验,裂解对象库完全由前置相关问题填充,主指标只报原始测试问题;另设希区柯克案例研究(先问 20 个相关背景问题,再评 10 个复用裂解对象的测试问题),模型统一为 Claude-Haiku-4.5 并开启 prompt caching。结果:平均 prefill 从 189K 降到 87K token(FanOutQA)、从 565K 降到 161K(案例研究),decode 始终低于 3K;平均成本从 0.26 降到 0.12 美元(降 53%),案例研究从 0.81 降到 0.27 美元(约 3 倍)。精度几乎无损:LLM-as-judge 准确率 43.0%→42.0%($p=0.39$,无统计显著差异),词面匹配 76.1%→74.2%(降约 2 点,主要源于答案规范化)。成本分布上,中位数从 0.246 降到 0.072 美元(3.4 倍),第 10 百分位便宜 9 倍,但第 90 百分位比基线贵 1.24 倍——无复用机会的问题只承担开销;裂解在约四分之三的问题上占优。4K 解码预算每问题仅增加约 12% 开销,产出约 150 个裂解对象。整体上裂解保留了智能体对 top-5/top-10 RAG 的精度优势,同时把成本向 28 倍便宜的理想存储方向收敛。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FanOutQA 多跳问答(每测试问题配一个 LLM 生成、人工校验的相关问题) | 每题平均 LLM API 成本 | 0.12 美元 | 0.26 美元(基线智能体推理) | 降低 53%(约 2.2 倍) |
| FanOutQA 多跳问答 | LLM-as-judge 准确率 | 42.0% | 43.0% | 下降 1.0 个百分点(p=0.39,无统计显著差异) |
| FanOutQA 多跳问答 | 词面匹配准确率(string accuracy) | 74.2% | 76.1% | 下降约 2 个百分点(主要因答案规范化) |
| 希区柯克电影案例研究(20 个前置相关问题 + 10 个测试问题) | 每题平均 LLM API 成本 | 0.27 美元 | 0.81 美元 | 约 3 倍降本 |
| FanOutQA / 案例研究 | 平均 prefill token 数 | 87K / 161K | 189K / 565K | 分别降低约 54% 和 71% |
| FanOutQA 每题成本分布 | 中位数成本 | 0.072 美元 | 0.246 美元 | 3.4 倍;第 10 百分位达 9 倍,第 90 百分位为基线的 1.24 倍 |
| 理想人工预结构化存储 vs 原始文档推理(机会标定) | 每题成本比 | 裂解方法随使用向此上限收敛 | 在原始文档上的智能体推理 | 理想存储便宜 28 倍,且随扇出扩大差距进一步增长 |
局限与改进
作者承认的局限:一是只暴露受限的读取函数而非完整 SQL 空间,计数、聚合、连接与直接多跳查询尚不可用,需要在可靠性与表达力之间权衡;二是假设语料静态,文档编辑需要删除受影响的裂解对象或从变更中增量精炼,尚未实现;三是基准全部基于公开的维基百科内容,模型可能见过这些数据,而企业私有文档(模型未见、跨用户重复查询)才是复用潜力更大的场景,目前缺少带长查询历史的真实部署基准;四是 4K 解码预算统一分配,不按查询或文档自适应,更大预算产出更多但更窄、更少被复用的对象。我自己的观察:评测设计中每个测试问题恰好注入一个相关问题,这种 1:1 的复用设定与真实工作负载的局部性分布可能不符,难以外推;约四分之一的问题完全没有复用、净亏损 1.24 倍,论文未给出识别'不值得裂解'的机制;词面准确率下降 2 点虽归因于答案规范化,但未做误差细分;案例研究仅 10 个测试问题,统计功效有限;跨模型迁移这一卖点只有论证没有实验;API 实验用 prompt caching 计费模拟 fork,本地 serving 的真实 KV fork 收益未被直接验证。
独立分析的弱点
独立分析出的弱点及改进方向:第一,无复用问题净亏损(第 90 百分位为基线的 1.24 倍),改进方向是训练轻量复用概率预测器,依据文档历史访问频率、查询流相似度与实体重叠度决定是否分叉裂解、分叉多大预算,让期望收益为负时干脆不裂解。第二,固定 4K 预算一刀切,热门文档(文档热点)应获得更大预算、冷门文档应跳过,可借鉴自适应索引按收益调整分裂粒度的思路做按文档、按查询的动态预算分配。第三,目录只支持按主语-关系的点读取,无法表达'列出所有 1980 年前首映的希区柯克电影'这类带谓词的查询,可扩展一层受控的谓词过滤或白名单 SQL 模板,配合只读权限与超时保护。第四,静态语料假设使系统无法应对文档更新,可引入版本化裂解对象与失效协议,类似物化视图的增量维护。第五,评价依赖 LLM 生成的相关问题,其分布偏置可能高估语义局部性,应在带真实查询日志的数据集上复验。第六,裂解对象质量依赖子智能体的投机判断,错误结构可能被反复复用而传播放大,需要加入基于证据回验或使用反馈的置信度淘汰机制。
未来方向
作者明确提出的研究方向:安全地暴露 SQL 能力(计数、聚合、连接、直接多跳查询)以释放结构化的全部价值,同时保持工具接口小、回退显式、生成查询可靠;处理语料编辑,删除受影响对象或从变更增量精炼;构建反映文档长查询历史的企业级基准(最好来自部署系统),这会同时暴露单查询优化与长期系统改进两个层面的机会;更智能的预算分配(按特定查询或文档)。基于本文成果可延伸的方向:把裂解对象库与语义算子框架(如 LOTUS)和 agent-first 数据系统结合,形成可优化的查询计划器;多用户、多智能体共享同一裂解存储时的协作、隔离与冲突处理;用裂解结构加速 GraphRAG 类系统的图构建;对'复用概率与裂解成本'建立理论模型,刻画向理想存储收敛的速度;做跨模型迁移实验(同一对象库在多个不同模型下复用)以实证'数据护城河'论断;以及把该机制推广到代码库、医疗记录等半结构化语料的重复推理场景。
复现评估
复现评估:论文未提及开源代码仓库,但关键组件描述较充分——系统基于公开的 FanOutQA 基准与维基百科语料,模型为 Claude-Haiku-4.5(基线与本文系统的唯一差别是裂解指令与裂解对象读写工具),相关问题由 claude-opus-5 生成并经人工校验,评测口径(prefill/decode token、API 成本、LLM-as-judge 与词面匹配)都是标准指标。算力与成本门槛很低:实验规模约为 FanOutQA 双倍负载加上 30 题的案例研究,按文中单价总成本在几十美元量级,个人即可承担。复现难度中等偏上:API 路线需要正确配置 prompt caching 并按缓存读费率核算 4K 裂解预算带来的约 12% 开销;本地路线需要支持共享前缀 KV 复用的 serving 框架(如 SGLang、vLLM)才能兑现'只付 decode'的核心假设;裂解指令的具体措辞、JSON schema 与规范化规则论文只给了原则性描述,需要自行摸索,而提取质量对提示词敏感,可能造成结果浮动。总体而言数据与设定透明,缺乏代码是最大障碍。
论文图表
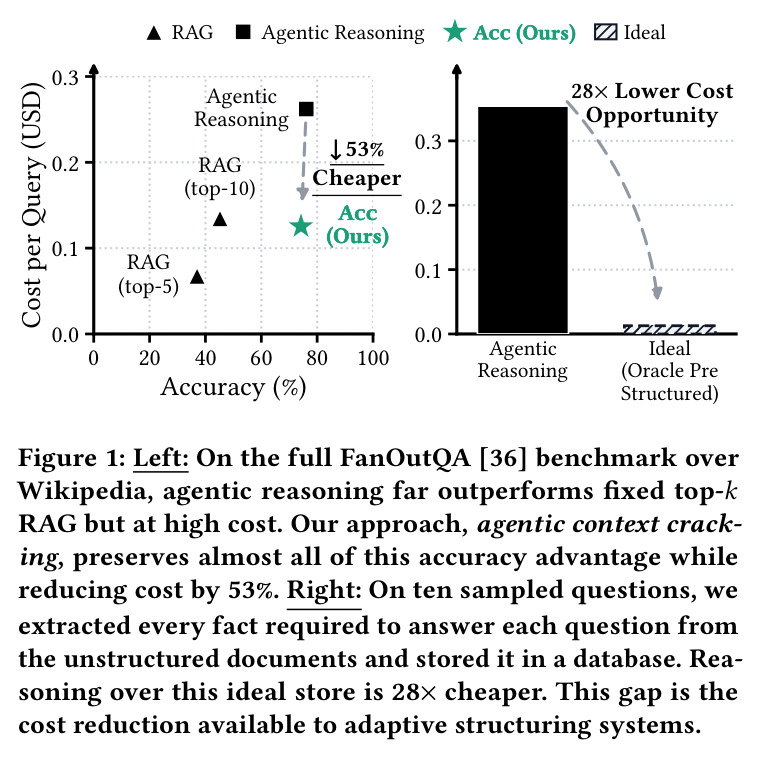
左图在完整 FanOutQA 上给出'准确率-成本'对比:智能体推理的准确率远超 top-5/top-10 RAG(LLM-as-judge 约 43%),但每题成本高一个量级;上下文裂解在成本降低 53% 的同时几乎保留全部精度优势。右图是机会标定:作者从 FanOutQA 抽样十个问题,人工把回答所需的全部事实抽取入库后重跑智能体,每个任务退化为数据发现加一条短查询,不打开任何文档,推理比在原始文档上便宜 28 倍;裂解方法的目标就是随使用向这条理想线收敛。
这是全文的'头条图':左图论证了为什么值得做(智能体精度远超 RAG 但成本不可负担),右图定量标出了自适应结构化的机会上限(28 倍)并展示裂解所处的位置。读懂此图即可把握论文的动机、方法定位与潜力上限。