面向智能体的缓存工程 Cache Engineering for Agents
让智能体直接增删KV缓存,免重预填充,平均提分1.7点、降本27.7%
前置知识
KV 缓存(KV Cache)
Transformer 自回归推理时,注意力的 Key/Value 中间状态与每个 token 一一对应。缓存它们后,生成下一个 token 只需计算新 token 的隐状态并与历史 KV 做注意力,避免重复前向计算。KV 缓存大小随上下文长度线性增长,是长程智能体任务中显存与 I/O 的主要开销。
本文的全部操作对象就是活跃 KV 缓存:drop 把部分 KV 从后续注意力中剔除,repos 改写保留键的位置编码,理解 KV 缓存的语义是读懂缓存工程的前提。
Prefill 与 Decode 两阶段推理
LLM 推理分两阶段:prefill 一次性并行处理整段输入并生成其 KV 缓存,decode 逐 token 自回归生成。若历史文本被编辑(修剪或摘要),其后缀的 KV 状态全部失效,必须对保留文本重新 prefill,产生与保留量成正比的额外计算,这是上下文工程的核心隐性成本。
缓存工程的核心卖点就是保留 KV 零重 prefill;而重 prefill 成本是对比基线(摘要式上下文工程)的主要开销,贯穿全文所有实验与成本核算。
前缀缓存与 Radix 树
主流服务系统(SGLang、vLLM 等)用基数树按 token 前缀组织 KV 缓存:相同前缀的请求共享子树的 KV 页,前缀匹配命中即可免于重算;配合 LRU 等策略驱逐空闲缓存。其隐含假设是 token 前缀唯一决定缓存状态,因此'前缀相同即可复用'。
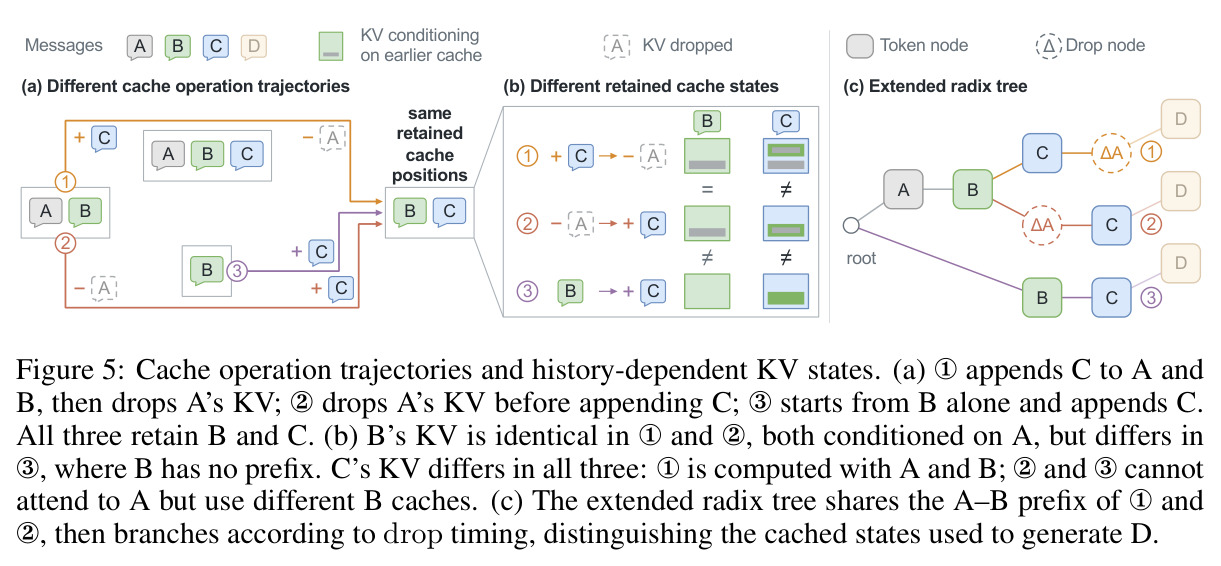
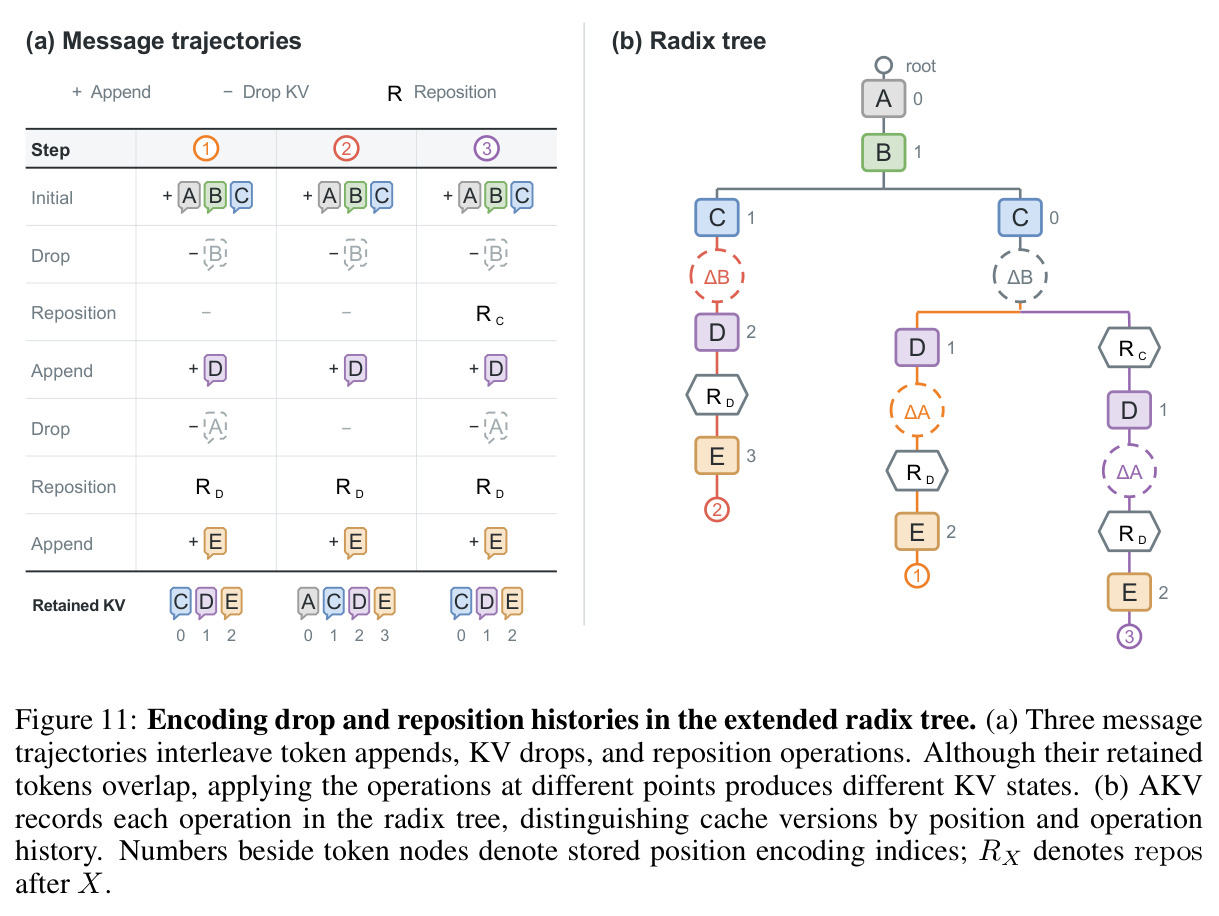
AKV 的扩展 radix 树是本文系统贡献的核心:历史依赖缓存打破了'前缀唯一决定状态'的假设,必须先理解原有机制,才能理解为何需要 drop 节点与 reposition 节点。
RoPE 旋转位置编码
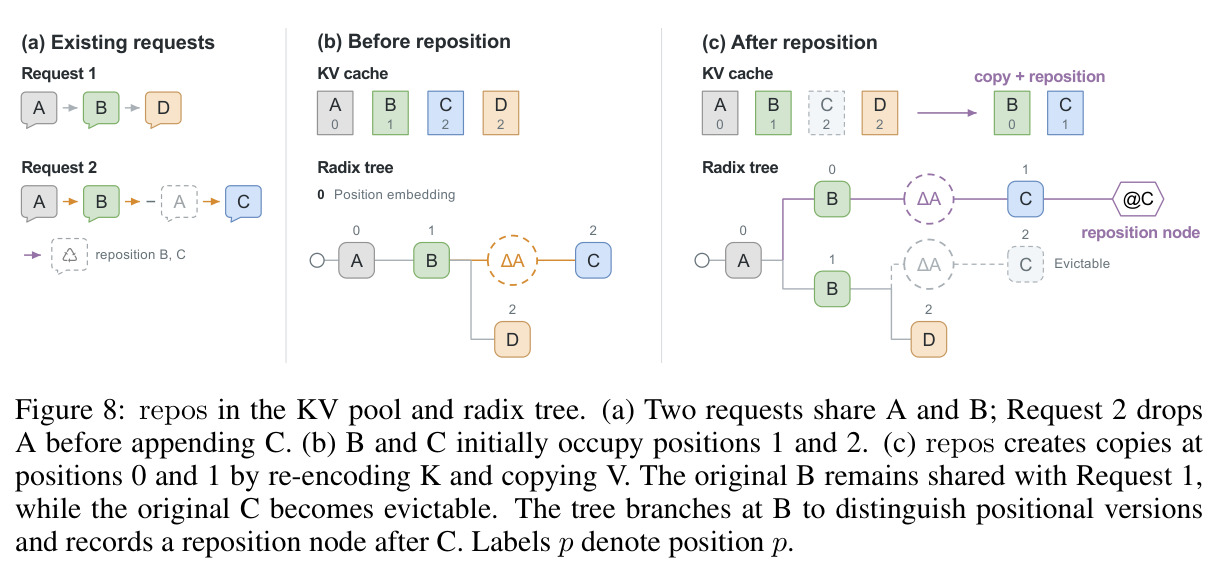
RoPE 把位置 $p$ 的信息通过旋转矩阵 $R(p)$ 作用于注意力的 Key(Value 不携带位置)。因此改变一个已缓存键的位置无需重算隐状态,只需左乘可逆旋转 $R(q)R(p)^{-1}$ 即可把它从位置 $p$ 变换到 $q$,是一个廉价的线性变换。
repos 操作的数学基础正是 $K \leftarrow R(q)R(p)^{-1}K$:它使位置重排能在服务端低成本完成,也让复用时跨位置版本的键变换成为可能。
上下文工程(Context Engineering)
在文本层面管理智能体对话历史的做法:当上下文长度达到阈值时,对旧消息做 LLM 摘要或直接修剪,只保留最近若干轮。它修改了逻辑 token 序列的前缀,导致后续 KV 缓存全部失效并触发重 prefill,摘要还可能丢失中间轮次的关键信息,形成成本与精度的两难。
它是本文的两个对照基线(Standard 高阈值摘要与 Text Engineering 低阈值摘要),缓存工程的动机与优势全部在与它的对比中展现。
递归自我改进(RSI)
让智能体评估自身策略、生成改进版本并在验证集上迭代筛选的自动化流程。本文用它自动搜索缓存丢弃策略:在 20 个 BCP 任务上迭代优化,在 100 个保留任务上评估,最终找到比人工专家设计更省成本且不损精度的策略。
RSI 实验展示了缓存工程作为可编程接口的独特价值:缓存策略成为可搜索、可自动改进的对象,而不仅是固定的人工规则。
研究动机
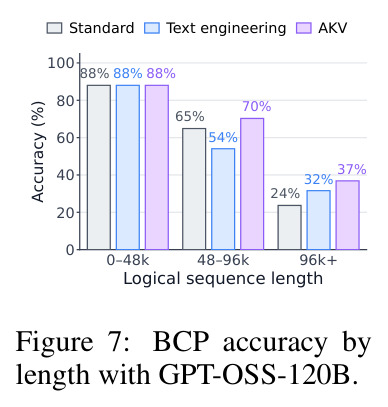
智能体执行上百轮推理-工具调用循环时轨迹持续增长,KV 缓存的读取与存储成为主导成本:作者实测 BCP 任务上 KV 缓存读取占总 API 成本的 82.4%。同时轨迹可能超过模型最大上下文长度,且当被注意的 KV 数量或位置范围超出模型可靠处理范围时精度会严重退化。主流方案上下文工程存在明确两难:在 GPT-OSS-120B 的 100 个 BCP 任务上,修剪式(保留最近 12 轮工具响应)因保留后缀必须重 prefill,成本达全上下文基线的 1.85 倍;摘要式(48K 阈值)虽降本约 7%,精度却下降 5 个百分点。常见 harness 因此把裁剪推迟到阈值、然后激进砍掉大部分轨迹,进一步牺牲中间轮次信息,重 prefill 成本与任务精度难以兼得。
本文的目标是本文目标是让智能体在不修改文本轨迹、不重 prefill 保留上下文的前提下直接控制活跃 KV 缓存:可以增量地丢弃选定的旧 KV、用位置重编码调整保留键,从而在给定成本预算下保留更多近期信息,并突破位置编码上限继续执行。相应地,需要重新设计服务系统,使其能正确复用、及时驱逐、并在单次前向内恢复这些'历史依赖'的缓存状态,同时保持与现有 API 兼容的无状态接口,最终把理论效率潜力转化为真实智能体工作负载下可测的吞吐与延迟收益,同时改善任务精度与推理成本。
与已有工作不同的是,已有工作分三层且互不打通:文本级上下文工程改写轨迹、必然触发重 prefill;缓存级压缩/驱逐/复用由系统根据低层信号(位置、注意力分数)自动决策,智能体无法介入高层语义判断;服务系统级的前缀缓存优化假设 token 前缀唯一决定缓存状态。本文的独特切入有三点:首次把缓存控制权交给智能体与 harness,形式化 append/drop/repos 三个缓存操作;率先指出历史依赖问题——相同 token 前缀在不同 drop/repos 顺序下产生不同缓存状态,朴素前缀匹配会静默复用错误状态;进而以算法与系统共设计(AKV 引擎)一并解决正确复用、隔离驱逐与单次前向恢复三个服务难题。
核心方法
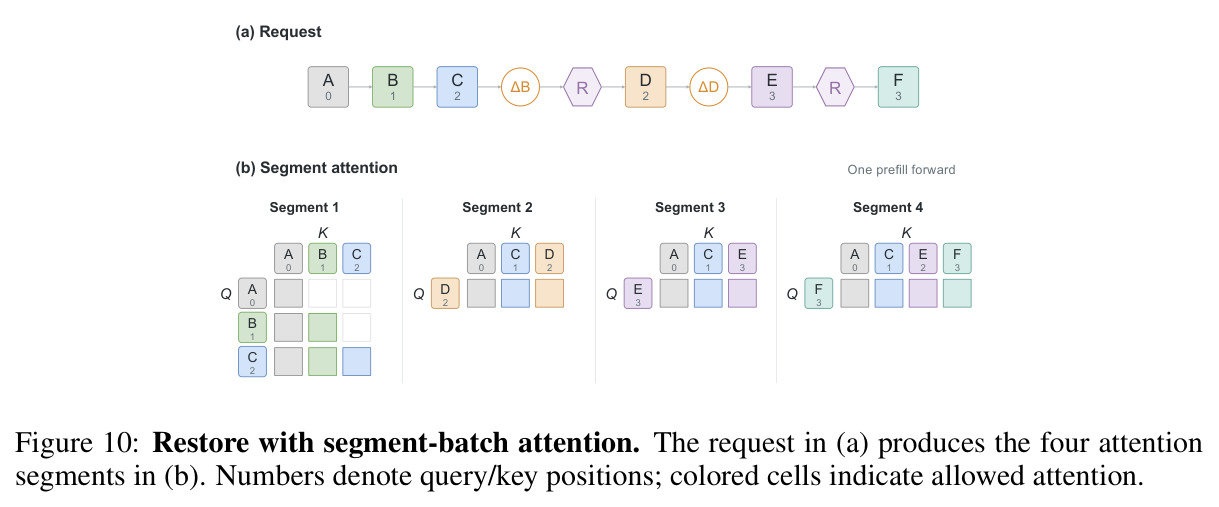
直觉起点来自注意力统计:BCP 轨迹中旧 token 获得的注意力远低于新 token,且同等相对位置下工具响应获得的注意力低于助手消息,旧工具响应的 KV 是低价值、高占用的部分。与其改写文本触发重 prefill,不如只把这些 KV 从后续注意力中剔除,保留的 KV 原样复用。技术路线分两层:算法层定义三个原语——append 正常为新 token 添加 KV;$\mathrm{drop}(P)$ 把活跃逻辑索引集 $P$ 对应的条目移除,$C \leftarrow C \setminus \{C_i : i \in P\}$;repos 用 RoPE 旋转 $K \leftarrow R(q)R(p)^{-1}K$ 把 $r$ 个保留键位置重排为 $0,\ldots,r-1$。缓存操作序列 $o_{1:m}$ 完全决定当前缓存状态。系统层由 AKV 引擎承载:对外提供 messages 加 cache 字段的无状态 API,对内用扩展 radix 树管理复用与驱逐,用分段批注意力在单次前向中恢复缺失状态。
核心创新是'控制权转移 + 状态不变性'。上下文工程改写逻辑 token 序列:前缀一变,后缀 KV 全部作废,重算成本与保留量成正比,因此只能等到达阈值后一次性暴力裁剪。缓存工程保持逻辑序列逐字节不变,只修改注意力可见的缓存集合:保留 KV 零重算,丢弃可以细粒度、渐进式进行,在同等成本预算下能保留更多近期信息。且由于注意力汇聚等现象,保留缓存在计算时已吸收被丢弃历史的信息(Figure 1 的嵌套色块),丢 KV 不等于丢信息。第二个本质创新是识别并解决历史依赖性:Figure 5 中三条轨迹都保留 B、C 的 KV,但 drop 与 append 的先后顺序不同导致 C 的缓存状态三者互不相同——传统'前缀即状态'的复用判定会给出错误结果,必须把操作历史与 token 前缀一起编入缓存索引。
方法步骤详情
第一步接口:请求沿用 messages 字段给出完整逻辑序列,可选 cache 字段以 operate-after 语法描述操作,如 "drop": {"1": [0]} 表示在消息 1 后丢弃消息 0 的 KV,"reposition": [2] 表示消息 2 后执行 repos。第二步复用:服务端在扩展 radix 树上做 exact matching 与 retrigger matching,后者忽略位置索引寻找可旋转复用的兼容前缀,命中键按 $K_t = R(p_t)R(p_s)^{-1}K_s$ 变换而无需重算隐状态。第三步恢复:在 drop/repos 触发点把 query 切成多个段,每段因果注意自身与之前各段的活跃缓存,FFN 整段批处理以免重复读权重,单次前向重建全部缺失 KV。第四步驱逐:被所有请求 drop 的 KV 优先驱逐,只释放物理页、树节点留占位;repos 的位置版本独立驱逐。第五步策略:默认工具响应滚动丢弃(保留最近 $K=12$ 轮工具响应与全部推理 KV),repos 阈值 96K;另有 RSI 自动策略与 Cache-as-Tool。
技术新颖性
新颖性有四层。其一,形式化贡献:缓存操作与操作序列给出历史依赖缓存状态的确定性描述,把'相同 token 前缀不等于相同缓存状态'从工程直觉上升为需要系统正面支持的问题定义。其二,系统贡献:AKV 是首个允许智能体直接控制缓存的 serving 系统(此前缓存完全由系统独占管理);扩展 radix 树用 drop 节点与 reposition 节点把操作历史织入前缀索引,统一支持正确复用、请求隔离的驱逐与恢复;分段批注意力把多段可见性差异的恢复压缩进一次前向,避免按段重读 FFN 权重这一主要显存流量来源。其三,算法-系统共设计:滚动丢弃策略与服务引擎协同评估,成本核算把 repos 按 cache-hit 费率计费,刻意高估自身成本以保证对比保守。其四,可编程性:缓存策略成为可搜索、可由 RSI 自动改进的对象,这是上下文工程难以做到的,因为文本编辑天然绑定重算成本。
实验结果
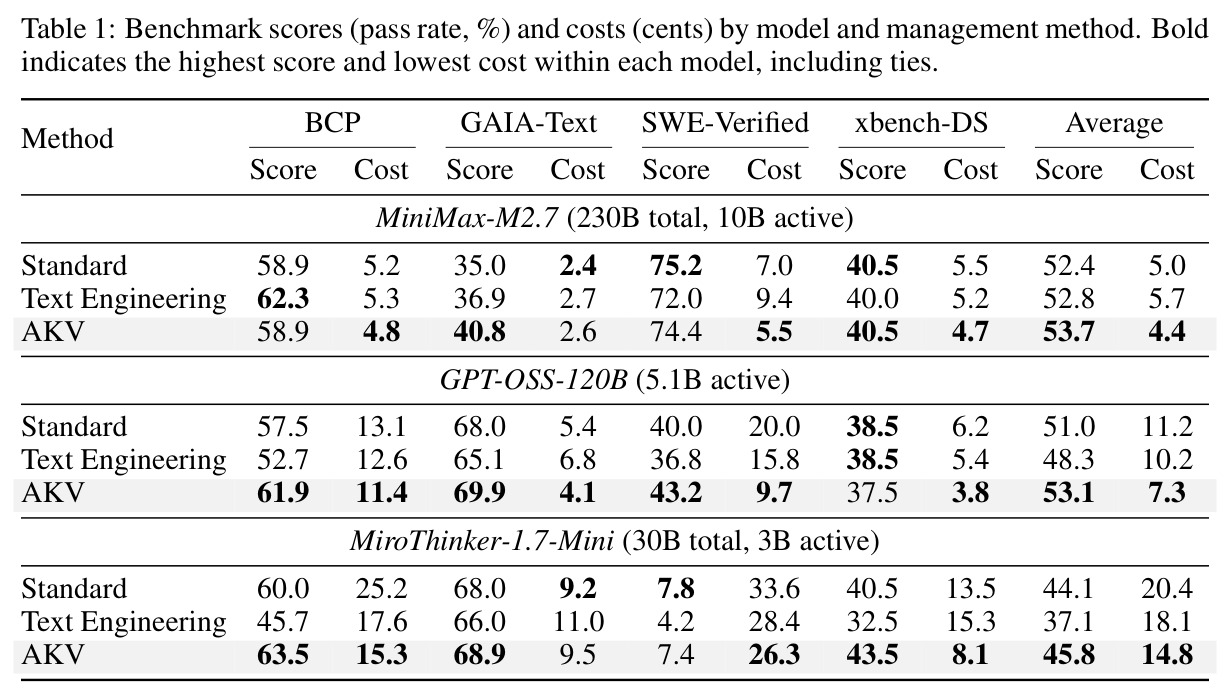
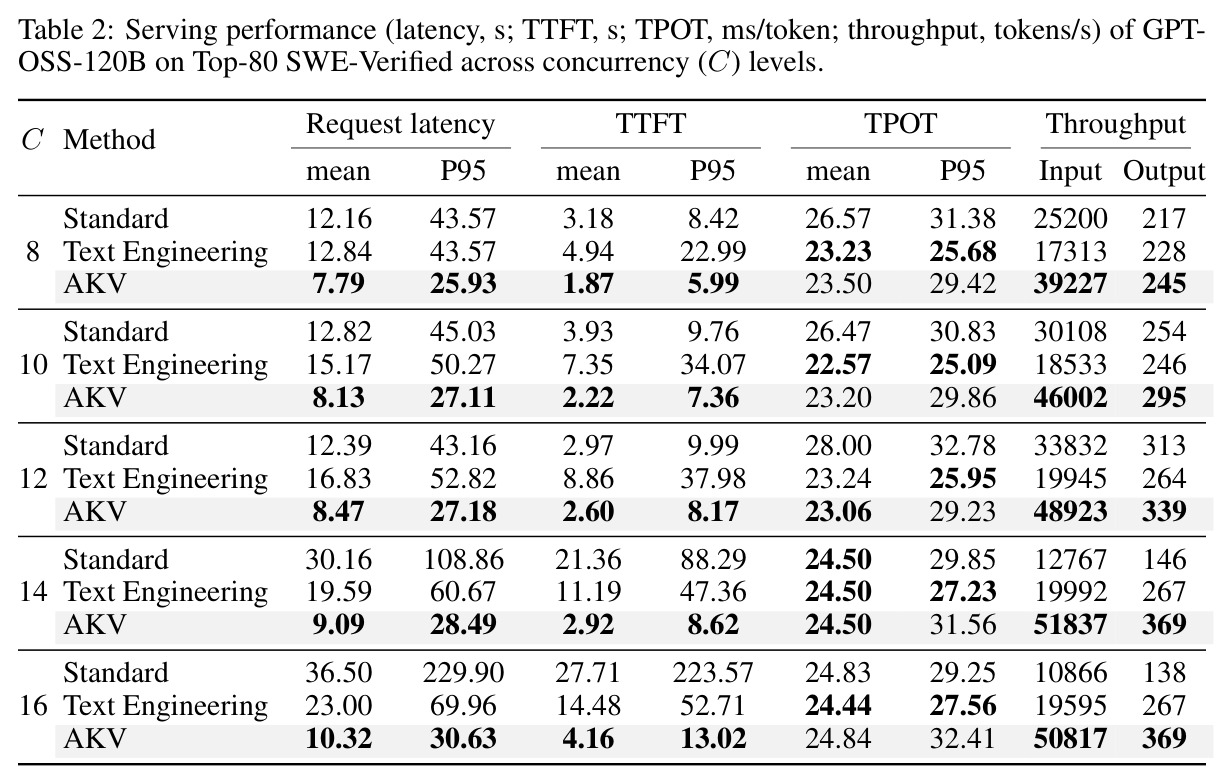
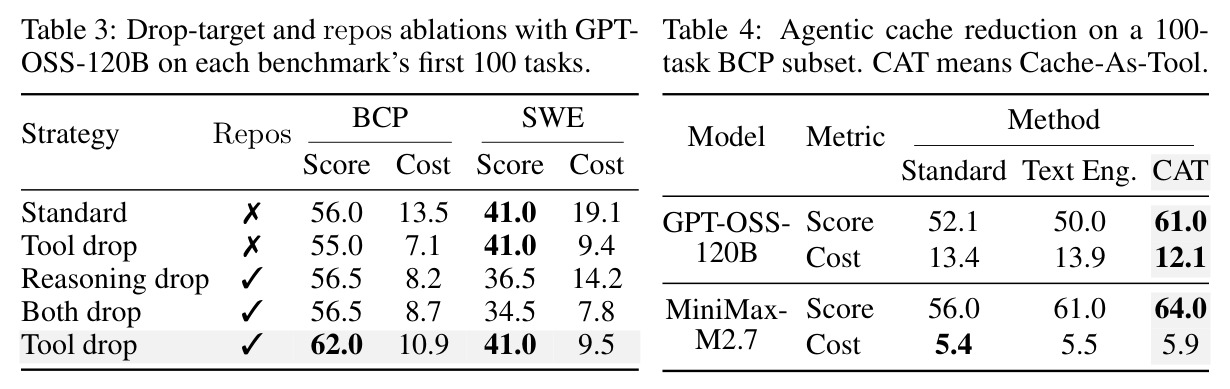
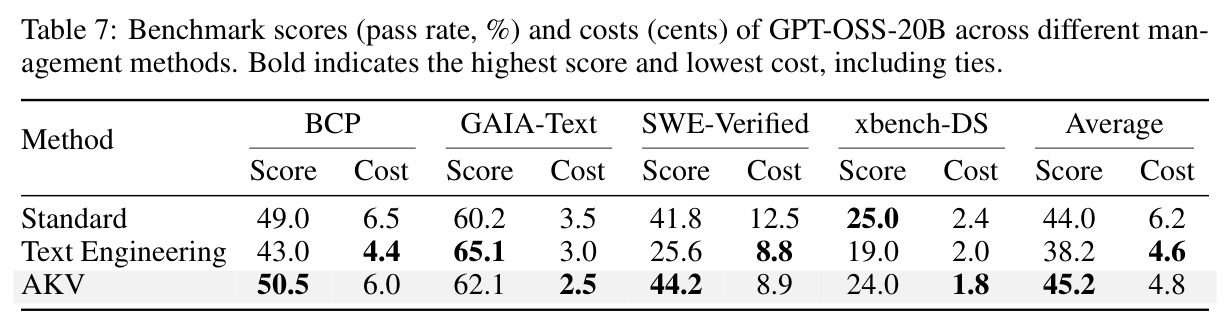
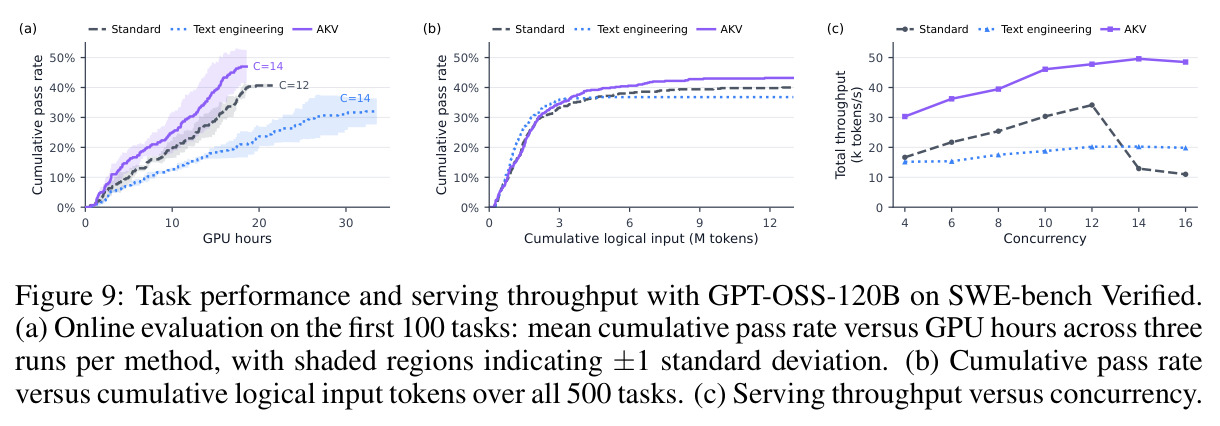
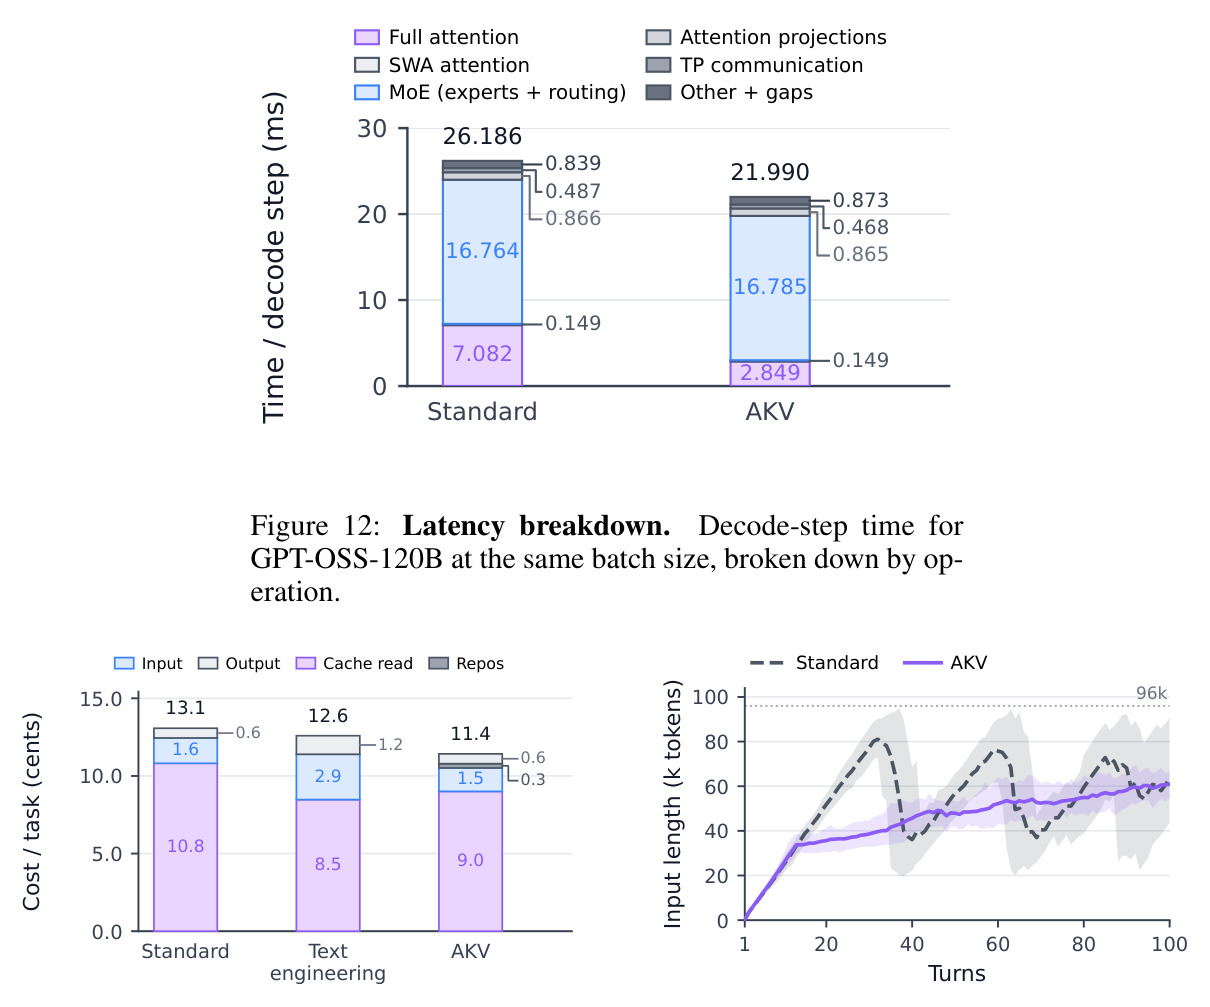
精度与成本(Table 1):AKV 平均成功率最高,较 Standard 提升 1.3–2.1%、较 Text Engineering 提升 0.9–8.7%,成本较两者降 27.7%/21.9%;如 GPT-OSS-120B:53.1 分对 51.0/48.3,7.3 美分对 11.2/10.2。服务效率(Table 2):平均/P95 延迟较 Standard 加速 1.36×/1.51×,C=16 时 Standard 的 P95 达 229.9s、AKV 仅 30.63s。机制(Figure 12/13):decode 全注意力时间降 59.8%,cache-read/cache-miss 成本分别较 Standard/Text Eng 降约 17%/48%。消融(Table 3):工具响应 drop 加 repos 最优(BCP 62.0 对 56.0),丢推理缓存反而降分。RSI(Figure 4):自动策略较 Standard 降 17.8%、较专家设计再降 7.1%。Cache-as-Tool(Table 4):61.0%/64.0% 均为子集最高。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 智能体基准平均(BCP / GAIA-Text / SWE-Verified / xbench-DS,三个模型) | 平均成功率(pass rate, %) | AKV 三模型平均分均最高:MiniMax-M2.7 53.7、GPT-OSS-120B 53.1、MiroThinker-1.7-Mini 45.8 | Standard 高阈值摘要(52.4 / 51.0 / 44.1)与 Text Engineering 低阈值摘要(52.8 / 48.3 / 37.1) | 较两基线分别提升 1.3–2.1 与 0.9–8.7 个百分点 |
| 推理成本(同上基准) | 平均每任务 API 成本(美分) | GPT-OSS-120B 7.3 美分;三模型整体较 Standard 平均降 27.7% | Standard 11.2 美分、Text Engineering 10.2 美分(GPT-OSS-120B) | -27.7%(vs Standard)/ -21.9%(vs Text Engineering) |
| 服务效率(Top-80 SWE-bench Verified 轨迹回放,GPT-OSS-120B,8×A800) | P95 请求延迟(s)/ 输出吞吐(tokens/s) | C=14 时 P95 28.49s;峰值输出吞吐 369 tokens/s(C=14/16) | Standard 同并发 P95 108.86s;其峰值输出 313 tokens/s(C=12) | P95 延迟加速 1.51×、平均延迟 1.36×;输入/输出吞吐 1.53×/1.18× |
| 缓存策略自动搜索(BCP 100 个保留任务,MiniMax-M2.7) | 每任务成本相对降幅 | RSI 第 3/6 次迭代策略较 Standard 分别降 15.6%/17.8%,精度保持 | 专家手工设计的工具响应滚动丢弃(K=12) | 较专家设计再降 7.1% 成本 |
局限与改进
作者承认的局限:缓存工程策略仅是初步探索(手工滚动丢弃加 RSI 示例),尚未在该方案下训练智能体;服务支持也未扩展到线性注意力模型。我的补充观察:其一,RoPE 旋转复用引入有限精度误差,论文 correctness 论证明确不要求与重算逐位等价,对温度 0 的严格复现和需要数值一致性的场景是隐患;其二,repos 把保留键位置重置为 $0,\ldots,r-1$,抹掉了绝对时间距离,模型并未在'压缩位置'分布上训练过,超长轨迹下的泛化性存疑;其三,drop 策略对对象选择敏感——Table 3 显示丢推理缓存使 SWE 得分从 41.0 跌到 34.5–36.5,说明'什么能丢'高度依赖任务类型,静态规则难以迁移;其四,成本按 API 费率估算且 repos 按 cache-hit 计费,但服务端键旋转与位置版本复制的显存占用和带宽开销未单独量化;其五,QA 类基准依赖 GLM-5.2 判分存在噪声,SWE 效率实验只回放 Top-80 长上下文任务,代表性偏向长轨迹场景。
独立分析的弱点
第一,策略静态性:滚动丢弃按消息类型加新近度裁剪,忽略内容相关性,对旧工具结果仍被间接依赖的任务(如长程代码库探索中早期文件读取)可能误删,改进方向是引入轻量注意力统计或学习型打分动态选择 drop 对象。第二,接口表达力:operate-after 语法假设线性消息序列,不支持分支、回滚与并行工具调用,可扩展操作历史以支持树状轨迹。第三,训练缺位:模型从未针对 drop 后的注意力分布和 repos 后的压缩位置分布训练,小模型 GPT-OSS-20B 增益明显缩水即为例证,应在缓存工程方案下做适配训练或 RL。第四,数值一致性:RoPE 旋转复用与重算存在微小偏差,缺少误差界与容差分析,对需要可复现性的评估流程不友好。第五,评测广度:判分依赖单一 LLM judge,SWE 效率实验仅回放 Top-80 任务,且未与 AgentKV、IntentKV、SideQuest 等并发工作定量对比。第六,恢复成本:极端 drop 密度下分段注意力会增加 prefill 计算开销,论文未给出该开销的上界。
未来方向
作者明确提出的方向:进一步探索更丰富的缓存工程策略;在该方案下训练智能体(例如用 RL 把 drop/repos 纳入动作空间,让模型学会主动管理缓存);把服务支持扩展到线性注意力模型(其位置语义与 RoPE 不同,repos 机制需重新设计)。基于本文成果可自然延伸的方向:其一,把缓存操作与 KV 量化、低秩压缩等正交技术组合,先 drop 再量化以叠加收益;其二,多租户场景下历史依赖缓存的跨请求共享与隔离策略,扩展 radix 树的匹配语义;其三,将 RSI 从单一基准扩展到多基准联合的策略搜索,甚至在线自适应调整 $K$ 与 repos 阈值;其四,把 cache 字段推广为行业标准的 API 扩展(类似 prompt caching 的普及路径),并研究缓存操作历史的隐私与安全影响;其五,针对 Mamba/线性注意力等位置无关或状态压缩模型设计等价的'状态编辑'原语,使缓存工程成为跨架构的通用抽象。
复现评估
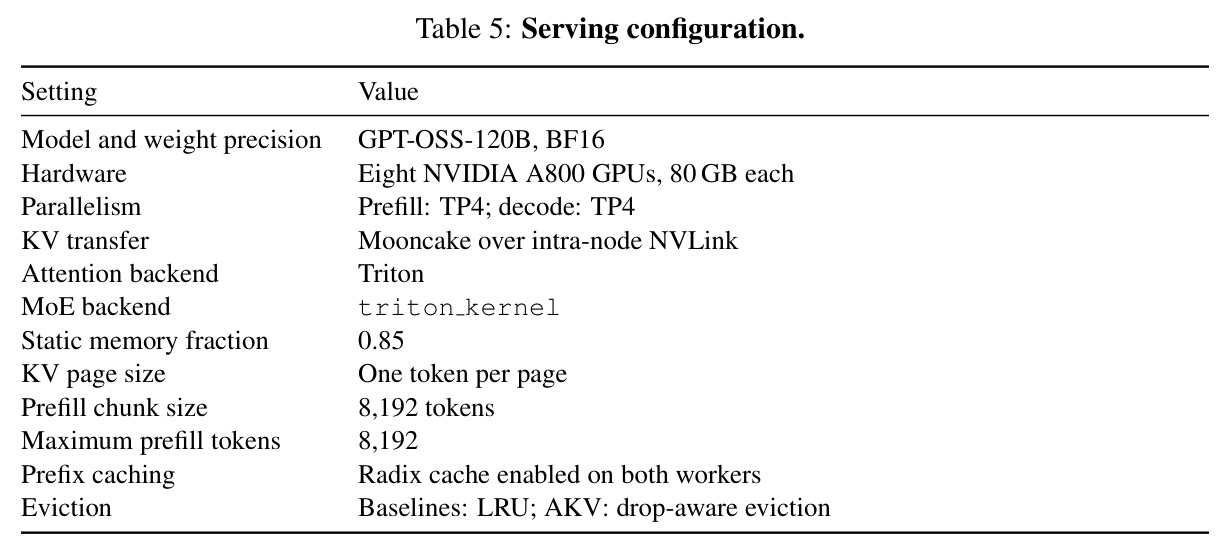
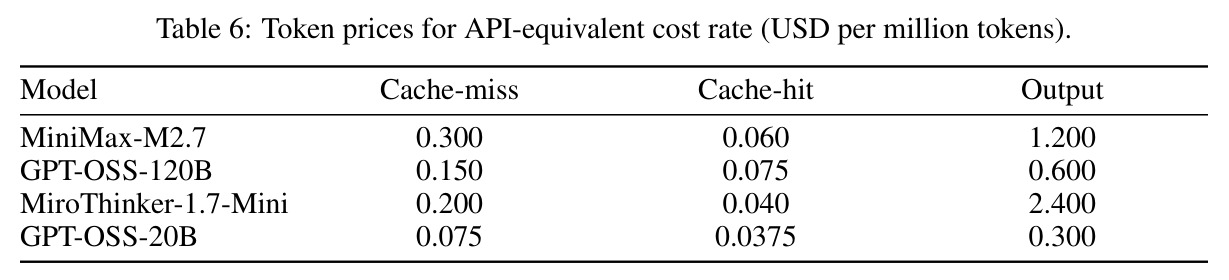
复现条件较好。代码开源在 https://github.com/thu-nics/AKV,基于 SGLang v0.5.20 实现;附录给出完整服务配置(8×A800-80GB,prefill 与 decode 各 4 卡 TP4,BF16 权重,Mooncake 走 NVLink,Triton attention 后端)与评测细节:BCP 用官方 harness 配 Qwen3-Embedding-8B 检索,SWE 用 mini-SWE-agent,判分统一用 GLM-5.2,成本按公开 API 费率逐 token 核算且 Table 6 给出全部单价;摘要基线复用 Pi 的提示词模板并在附录全文给出。主要门槛在算力:serving 实验需 8 张 A800 级 GPU 承载 120B BF16 模型,学术实验室可行但成本不低;若只验证算法层收益,可退化为 API 等价成本核算。风险点:RoPE 旋转复用有有限精度误差,温度 0 亦难逐位对齐;完整 3 模型 × 4 基准矩阵需数周量级投入。总体难度中等,配置齐全、代码开源是明显加分项。
论文图表
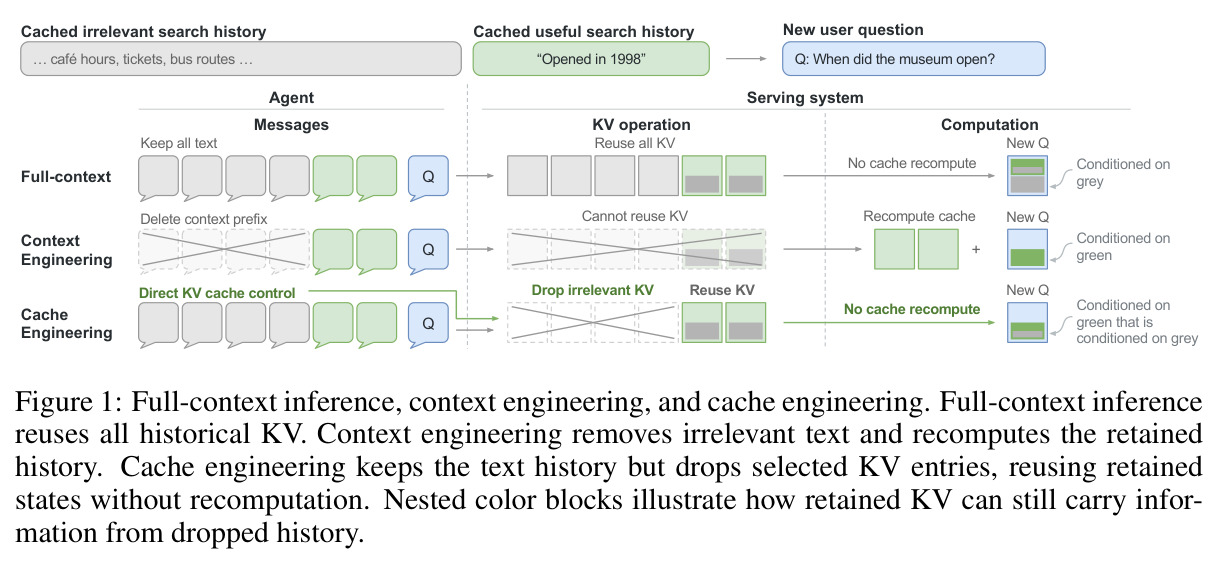
用同一个'博物馆何时开馆'问答场景对比三种范式:全上下文推理复用全部历史 KV、保留无关搜索历史;上下文工程删除前缀文本后必须重算保留历史的缓存;缓存工程保留文本历史但只丢弃选定 KV 条目,保留状态零重算。嵌套色块示意保留的 KV 在计算时已吸收被丢弃历史的信息。
一图讲清论文核心主张:不改文本、只改缓存可见性,即可绕开重 prefill,这是全文动机与方法的视觉总纲。
对 10 个 BCP 请求求平均的逐 token 注意力分布:横轴为相对 token 位置,旧 token 的注意力显著低于新 token,且同等相对位置下工具响应获得的注意力低于助手消息。
为'该丢什么'提供经验依据:旧工具响应是低注意力、高占用的部分,直接导出工具响应滚动丢弃这一默认策略。
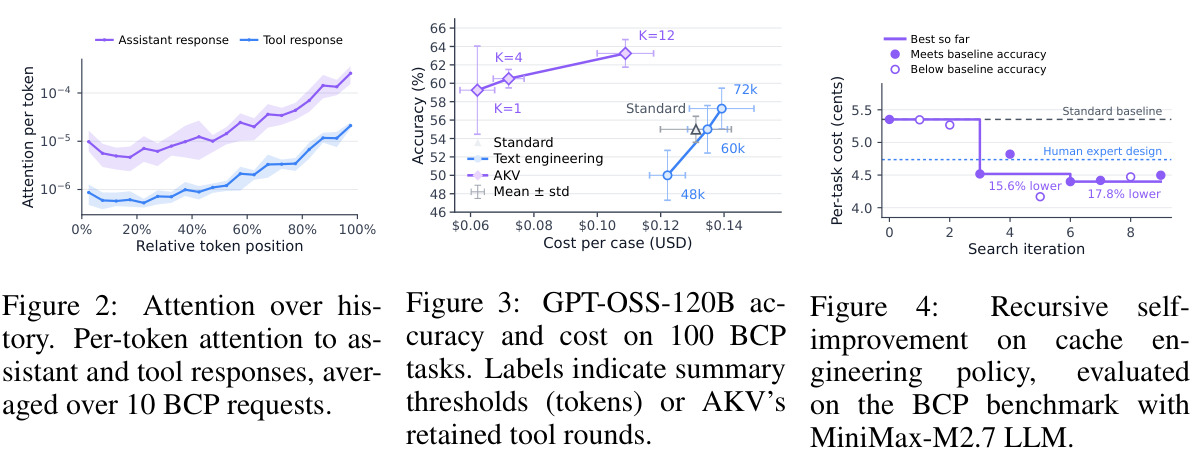
100 个 BCP 任务上精度与成本的散点:修剪式(K=4/12)成本最高达全上下文 1.85 倍;摘要式(48K/60K/72K 阈值)降本约 7% 但精度降 5 个百分点;AKV 滚动丢弃(保留 12 轮)同时实现更高精度与更低成本。
量化呈现'重 prefill 成本 vs 任务精度'的两难,以及缓存工程如何同时改善两端,是动机部分最关键的实验证据。
RSI 在 20 个 BCP 任务上迭代优化缓存策略、在 100 个保留任务上评估:第 3、6 次迭代的策略较 Standard 分别降 15.6% 与 17.8% 成本,且精度保持在 Standard 基线附近,优于 K=12 的专家设计。
展示缓存策略作为可搜索、可自动改进对象的价值,是方法可编程性的直接实验支撑。
一个具体的 AKV 请求示例:messages 字段给出完整逻辑序列(与现有 API 兼容),cache 字段以 operate-after 语法描述 "drop": {"1": [0], "2": [1]} 与 "reposition": [2],右侧标注对应的 append/drop/repos 操作序列。
展示无状态接口的实际形态,说明客户端如何在不追踪服务器缓存驻留的情况下精确描述缓存操作。
BCP 上每任务平均成本分解:Standard 13.1 美分中缓存读取占 10.8(约 82.4%);AKV 总成本 11.4 美分,cache-read 降约 17%;相对 Text Engineering(12.6,cache-miss 输入 8.5),AKV 免重 prefill 使 cache-miss 输入成本降约 48%(9.0 中仅 1.5)。
解释成本节省从何而来:一类来自少读缓存,一类来自免重算,同时给出引言中 82.4% 这一关键数字的出处。
BCP 上 100 轮的活跃上下文长度曲线:Standard 累积到 96K 后被摘要截断、呈锯齿状;AKV 持续滚动丢弃超预算的旧工具响应 KV,活跃上下文随推理积累缓慢爬坡、增速显著更低,且可突破 96K 位置阈值继续运行。
直观展示滚动丢弃与阈值触发摘要在缓存增长形态上的本质差异,对应精度与成本优势的直接原因。
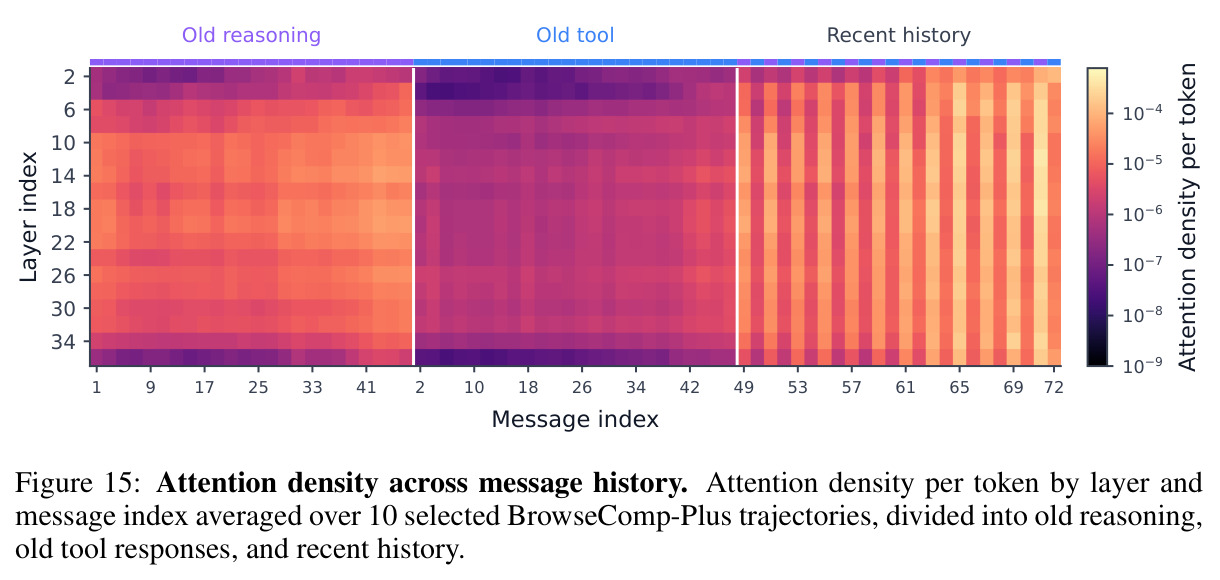
10 条 BCP 轨迹上按层与消息索引统计的每 token 注意力密度,历史被分为旧推理、旧工具响应与近期历史三段:多数层中旧工具响应获得的注意力低于旧推理,近期历史获得最多注意力,跨层模式一致。
比 Figure 2 更细的分层证据,系统性地支撑'保留推理与近期 KV、优先丢弃旧工具响应 KV'的策略设计选择。
把缓存管理暴露为模型可调用工具(CAT)的对比:GPT-OSS-120B 得分 61.0(Standard 52.1、Text Eng 50.0),成本 12.1 美分;MiniMax-M2.7 得分 64.0(56.0/61.0),成本升至 5.9 美分因执行了更多轮次。
验证'智能体主动决策何时清理缓存'这一更激进的用法可行且有效,展示缓存工程接口的上限潜力。