排序质量相同、决策不同:度量并降低 LLM 评分器的顺序依赖 Equal Ranking Quality, Different Decisions: Measuring and Reducing Order Dependence in LLM Scorers
排序质量相同的评分器换序后决策迥异,OC-SFT 以排列一致性惩罚稳定三类下游决策
前置知识
批式逐点评分(batched pointwise scoring)
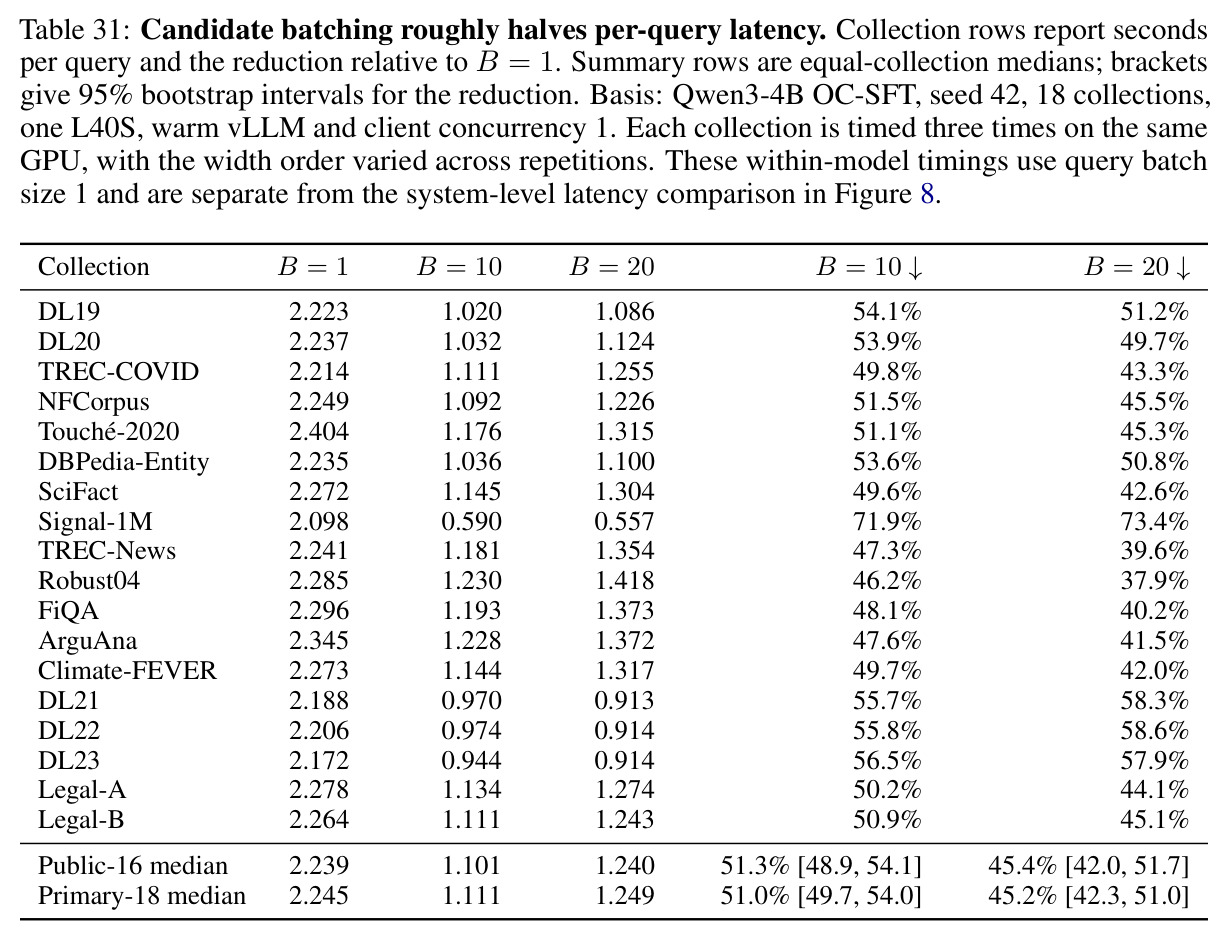
把 B 个候选与 query 放进同一个 prompt,让 LLM 对每个候选各输出一个分数:既不像 pointwise cross-encoder(monoT5、RankLLaMA)那样每候选一次前向,也不像生成式 listwise reranker(RankGPT、RankZephyr)那样只输出排名列表。它同时保留逐候选分数(可供阈值消费)与共享上下文(B=20 时每查询延迟比逐候选降低约 45%),代价是候选分数互相条件化。
这是论文的研究对象,全部度量、训练目标与服务设计都围绕共享 prompt 下的逐候选分数展开,不理解这一设定就无法理解呈现依赖从何而来。
nDCG@10 与 τ-PSI
nDCG@10 衡量前 10 位的排序质量,只读相对次序、不看绝对分数,因此截止线附近的绝对分数漂移几乎不影响它。τ-PSI 是本文采用的顺序不稳定度指数:对每个实例在 M=10 个随机排列下打分得到排名 $r_1,\dots,r_M$,计算 $\tau\text{-PSI}=\frac{1-\text{mean}_{i<j}\,\tau(r_i,r_j)}{2}$,其中 τ 为 Kendall 秩相关;0 表示完全稳定,0.5 等价于不相关,1 表示完全反转。
论文的核心论证是 nDCG@10 无法区分决策不同的评分器,而 τ-PSI 的排列预算恰好足够顺带测出决策稳定性,这是作者对评估协议的核心主张。
Lost in the middle 与位置偏差
长上下文语言模型对输入不同位置的注意力不均匀,呈 U 形(Liu et al., 2024):开头与结尾的信息利用更好,中部被忽略。在重排序与 LLM judge 场景中,这表现为候选的名次与其在 prompt 中的位置强相关,仅交换顺序即可翻转两候选间的判定。
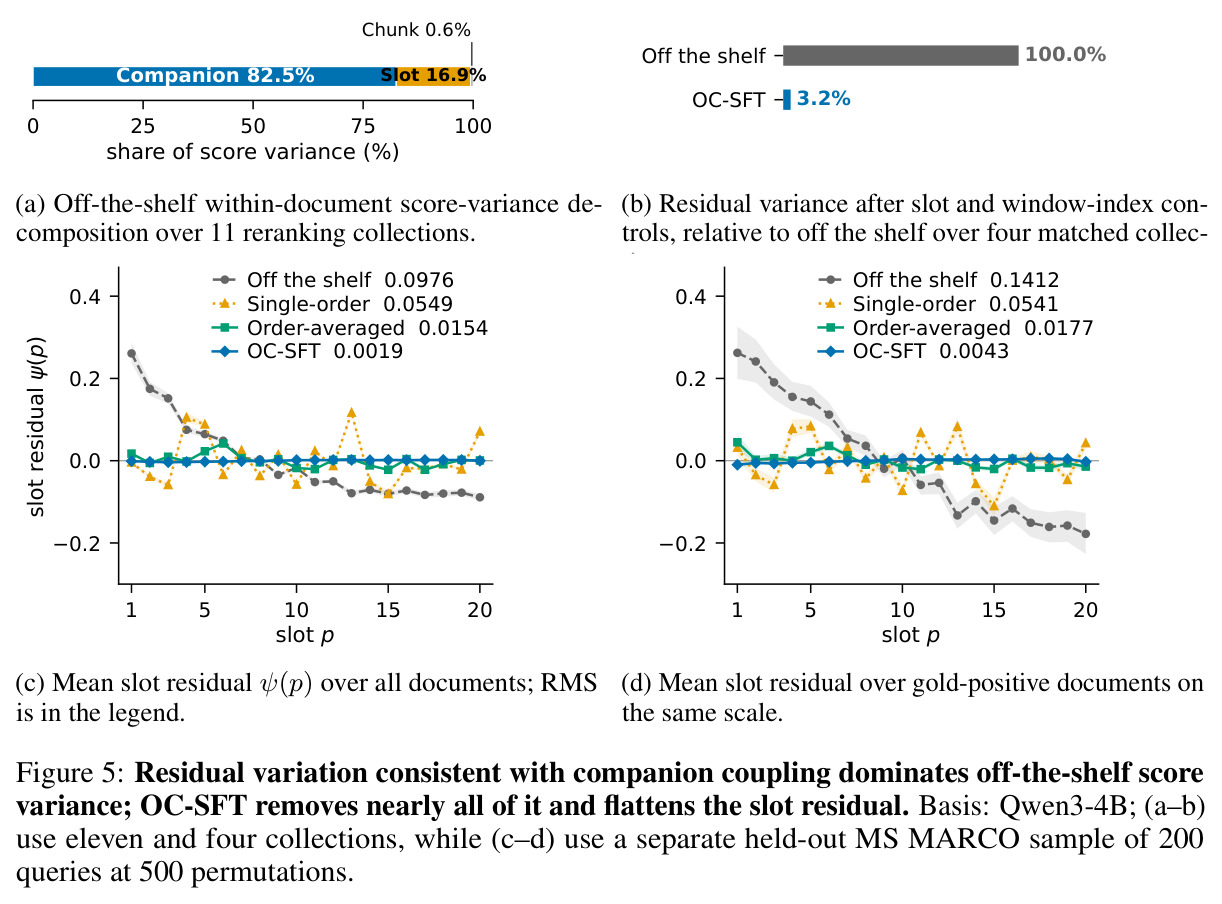
这是顺序依赖的机制根源:理解分数为何随排列变化、以及伴随候选耦合为何贡献了 82.5% 的文档内分数方差,才能理解为什么惩罚残差有效。
自蒸馏与银标签
用模型对无标注数据打分生成的标签称银标签;当教师就是学生自己的基座时称为自蒸馏。论文默认教师=学生基座(对 MS MARCO 约 30K 查询的 top-100 候选打 0–3 级),因此报告的提升不可能来自更强的外部教师,标签构建也只需一次教师前向。
OC-SFT 与 order-averaged 蒸馏的成本对比(教师标注 1 次 vs 10 次)完全建立在这一设置上,且自蒸馏设计排除了『教师更强所以更好』的混淆解释。
一致性正则化
半监督学习的经典思想(Mean Teacher、R-Drop):同一输入的两个随机扰动视图应产生一致的输出,训练时惩罚其分歧以获得对扰动的鲁棒性。本文把它从离散答案选择迁移到连续分数:同一候选窗口在两个排列视图下的分数差即顺序残差 $\delta_B$,惩罚其经验方差。
OC-SFT 的损失函数就是这一原理的实例;理解它才能看懂方法设计、为什么两个视图(N=2)就够、以及 EMA mean-teacher 消融为何失败。
LoRA 微调
低秩适配:冻结原模型权重,只训练注入每层注意力与 MLP 投影的低秩矩阵。本文统一用 rank 16、alpha 32、dropout 0.05,挂在 q/k/v/o/gate/up/down 七组投影上,AdamW、学习率 2e-4、1 epoch、有效批 64。
论文所有训练变体(含全部基线)都用同一 LoRA 配置保证可比性,且作者直接发布了 11 个 dense 基座的 LoRA adapter,复现门槛很低。
研究动机
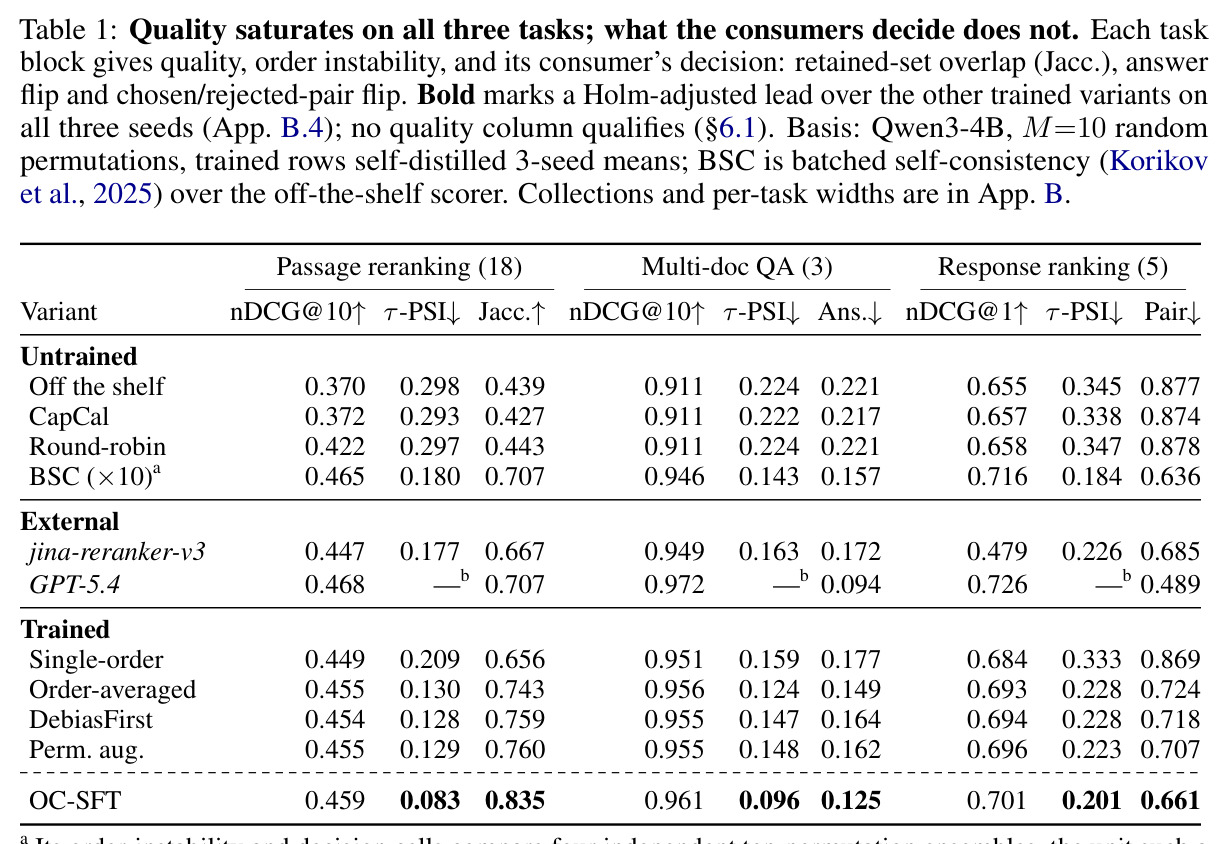
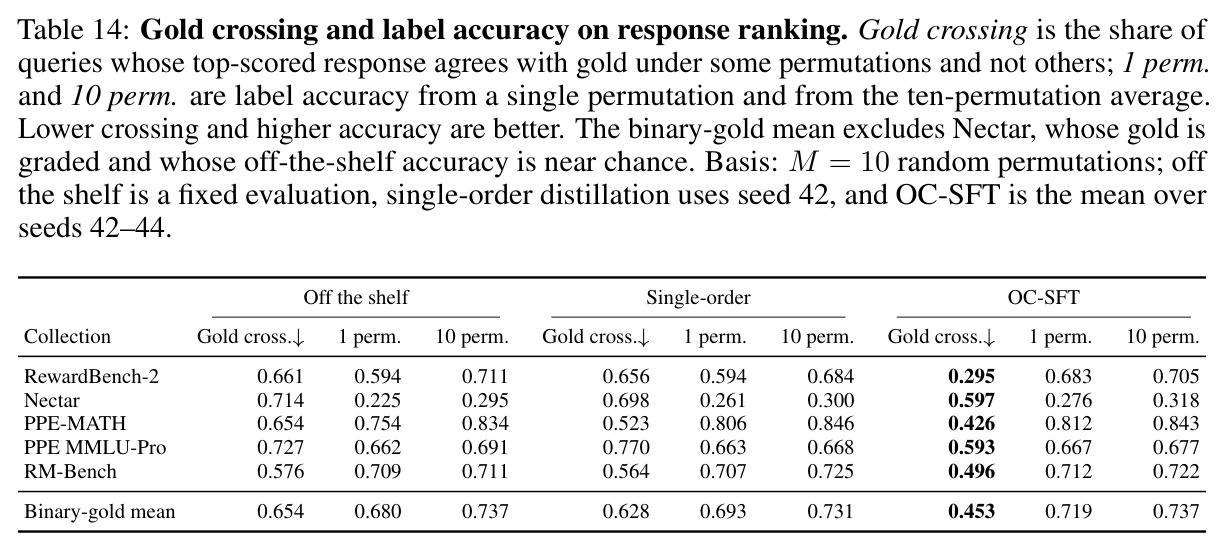
批式逐点评分器把多个候选放进同一个 prompt,一次前向给出每个候选的分数,输出被三类下游消费者直接使用:阈值过滤器决定哪些文档进入复审队列或生成上下文,reader 从最高分文档生成回答,偏好模型的分数决定 chosen/rejected 对进入偏好训练。由于候选共享 prompt,一个候选的得分取决于整个 prompt 而不只是它自己——作者称之为呈现依赖:候选顺序、分窗规则、槽位标记、答案骨架四个通道都可能改变分数。这暴露出评估盲区:排序质量指标完全无法反映决策层面的不稳定。例如 off-the-shelf 的 Qwen3-4B 在 Climate-FEVER 上对同一 100 个候选,两种排列的 nDCG@10 都精确等于 0.6131,但阈值保留集相差 5 篇,reader 甚至把同一声明从 SUPPORTED 读成 NOT ENOUGH INFO;响应排序上,顺序决定偏好模型 top 选择是否正确,10 个随机排列下 65.4% 的查询受此影响。五个训练后评分器 nDCG@10 差距不足 0.010,重排后保留集 Jaccard 重叠却只有 0.66–0.84:质量相同的评分器做出的是不同的决策。
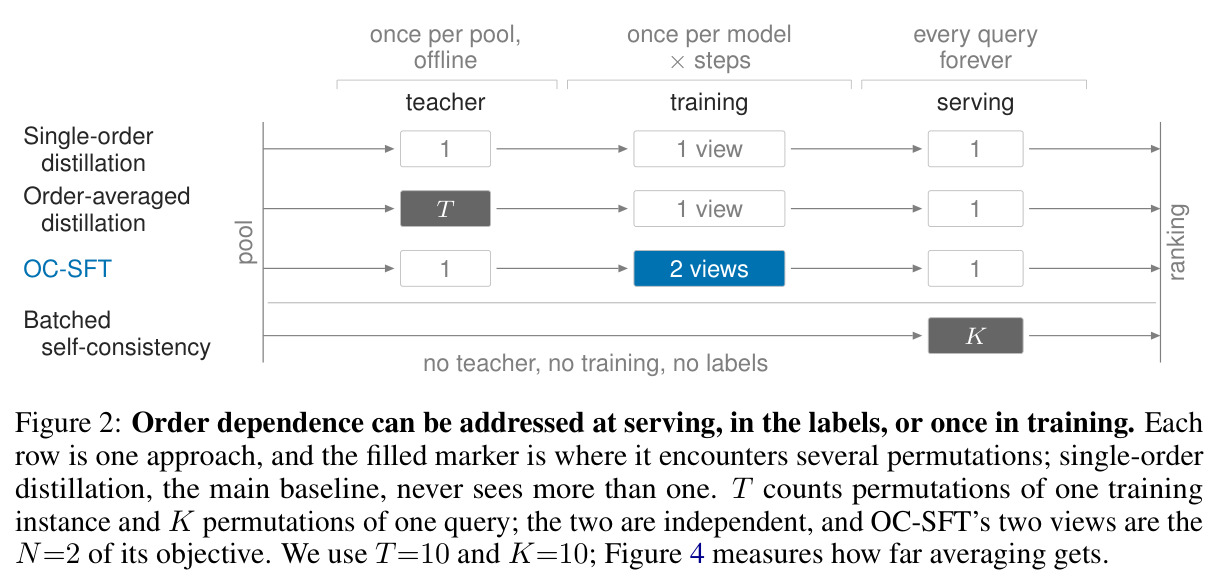
本文的目标是论文要回答一个训练问题:当 prompt 端修补无法消除顺序依赖时,能否通过改变训练目标,在保持排序质量的前提下,让三类消费者的决策在候选换序后保持可复现。具体分三步:其一,建立以消费者产出为中心的度量协议——阈值保留集的 F1 与 Jaccard 重叠、reader 的 verdict flip 与 answer flip、偏好选择的 pair flip,辅以排序层面的 τ-PSI;其二,系统比较代价落点不同的三类补救方案(推理时 K 排列平均的 BSC、标签端 T 排列平均的蒸馏、训练端一致性惩罚),并检验 prompt 端修复(round-robin 分窗、CapCal logit 校准)是否有效;其三,提出 OC-SFT 并验证它在段落重排、多文档 QA、响应排序三个任务和 12 个基座上,以单排列服务的成本取得所有训练目标中最优的决策稳定性,进而主张这类评分器的对比必须报告决策稳定性而非只报排序指标。
与已有工作不同的是,独特切入角度有三点。第一,度量对象从『排序怎么动』转向『消费者产出什么』:已有位置偏差研究(如 Zeng et al. 的敏感度指数)和 LLM judge 一致性研究都停留在评分器自身输出层面,本文首次把保留集重叠、verdict/answer flip、pair flip 作为一等指标,并证明在质量匹配时排序质量与决策稳定性彻底分离。第二,修补位置的选择:推理时排列平均(BSC)每查询付 K 倍成本,order-averaged 蒸馏在标签端付 T=10 倍教师前向,而 OC-SFT 借鉴半监督学习的一致性正则化,把成本一次性放进训练——惩罚学生自己在 N 个排列视图下的分数分歧,标签只需教师一次前向。第三,对分数做分解 $f_B(x,\pi)=\mu_B(x)+\delta_B(x,\pi)$,其中 $\mu_B$ 是顺序边际、$\delta_B$ 是顺序残差:已有方法经标签间接逼近 $\mu_B$,OC-SFT 则直接惩罚 $\delta_B$ 的经验方差,从而在权重中实现单次前向的顺序稳定。
核心方法
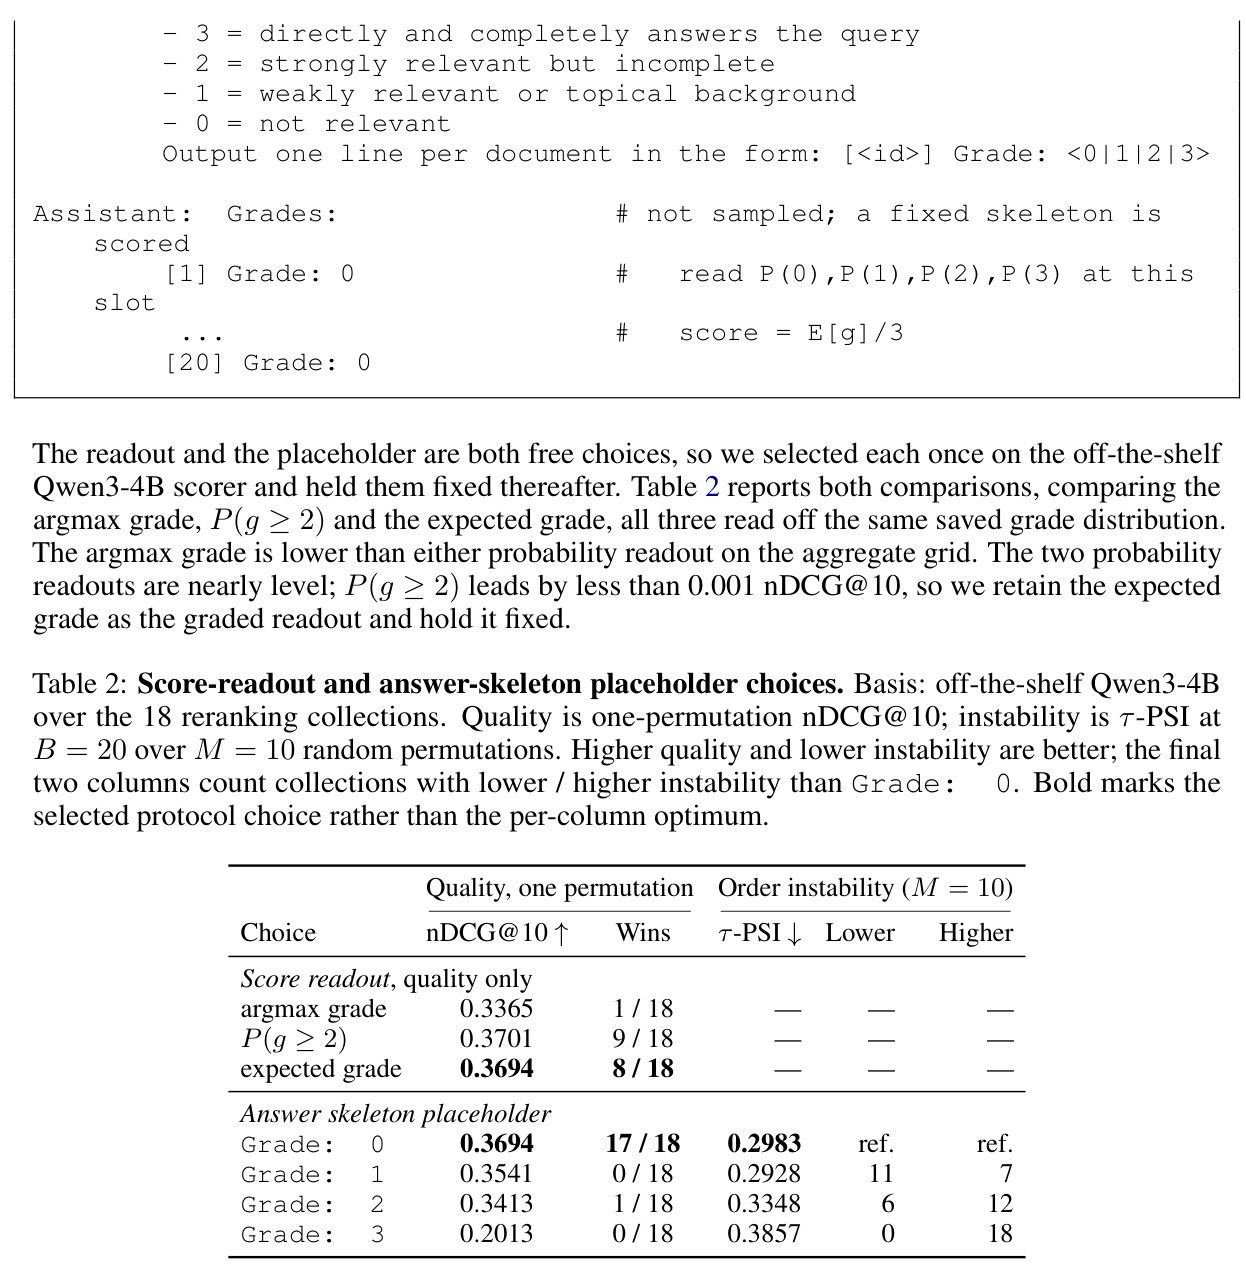
直觉上,分数对顺序的敏感来自共享 prompt 引入的顺序残差:同一候选在不同排列下得分不同,而阈值读取的是绝对分数,截止线附近的微小残差就足以决定一篇文档的去留。因此最经济的做法不是在服务时多次采样再平均,而是训练模型让残差本身变小。技术路线分四步:先把分数读取方式固定——在 prompt 末尾附加固定的 Grades: 答案骨架,一次前向读取每个槽位上 {0,1,2,3} 四个等级 token 的概率,取期望等级 $E[g]=\sum_g g\,P(g)$ 归一化到 [0,1] 作为分数,全程无采样、无解码温度;再把教师固定为自蒸馏(学生自己的基座打银标签,约 30K 条 MS MARCO 查询),使各变体只在目标函数上有差异;然后比较五种训练目标:单序蒸馏、order-averaged 蒸馏、DebiasFirst、排列增强与 OC-SFT;最后全部用 LoRA(rank 16)训练,服务时单排列一次前向,B=20 时每查询延迟比逐候选评分降低约 45%,且读取方式在任意宽度下不变,一个 checkpoint 可以跨 B 服务而无需重训。
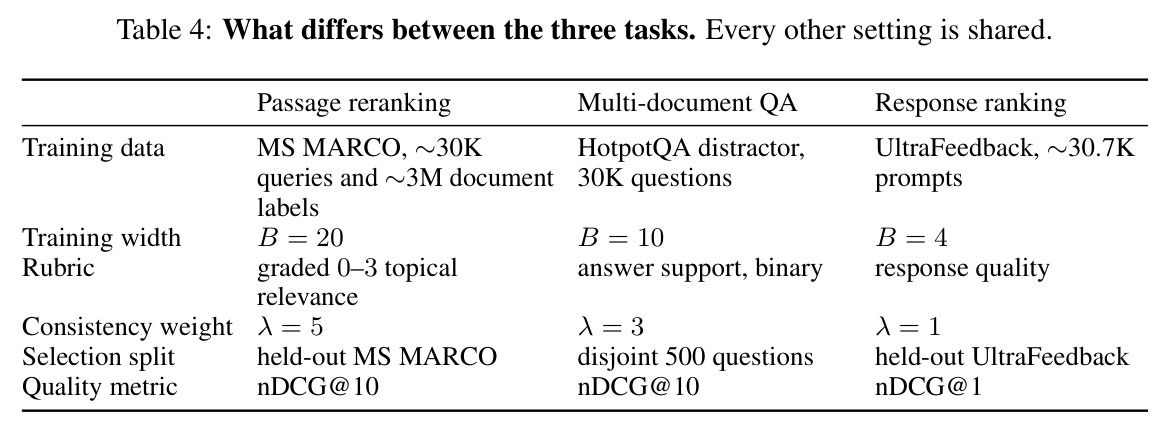
核心创新是 OC-SFT 的目标设计。已有思路是把平均做进标签:order-averaged 蒸馏用 T=10 个打乱的教师顺序预计算每个候选的平均分作目标,间接逼近顺序边际 $\mu_B$,标签成本乘以 10。OC-SFT 反其道而行:保留单序教师目标,对同一 B=20 窗口取 N=2 个随机排列视图,损失为 $$\mathcal{L}_{\text{OC-SFT}}=\underset{d}{\text{mean}}\,(s_1(d)-\tilde{y}(d))^2+\lambda\sum_{i=1}^{N}\underset{d}{\text{mean}}\,(s_i(d)-\bar{s}(d))^2$$ 第一项是相关性锚点,只有第一个视图携带教师监督,增加视图数不增加标注成本;第二项是学生自身分数的经验顺序方差,期望上正比于 $E_\pi\|\delta_B(x,\pi)\|^2$,直接惩罚顺序残差。与已有方法的本质区别在于:它约束的是学生而非标签,以顺序不变性本身为目标;且惩罚的是方差的有界化而非归零,因此得到的是衰减而非保证。消融证明两项缺一不可——去掉锚点,模型退化成一致但与相关性无关的评分器;$\lambda=0$ 则完全退回单序蒸馏。
方法步骤详情
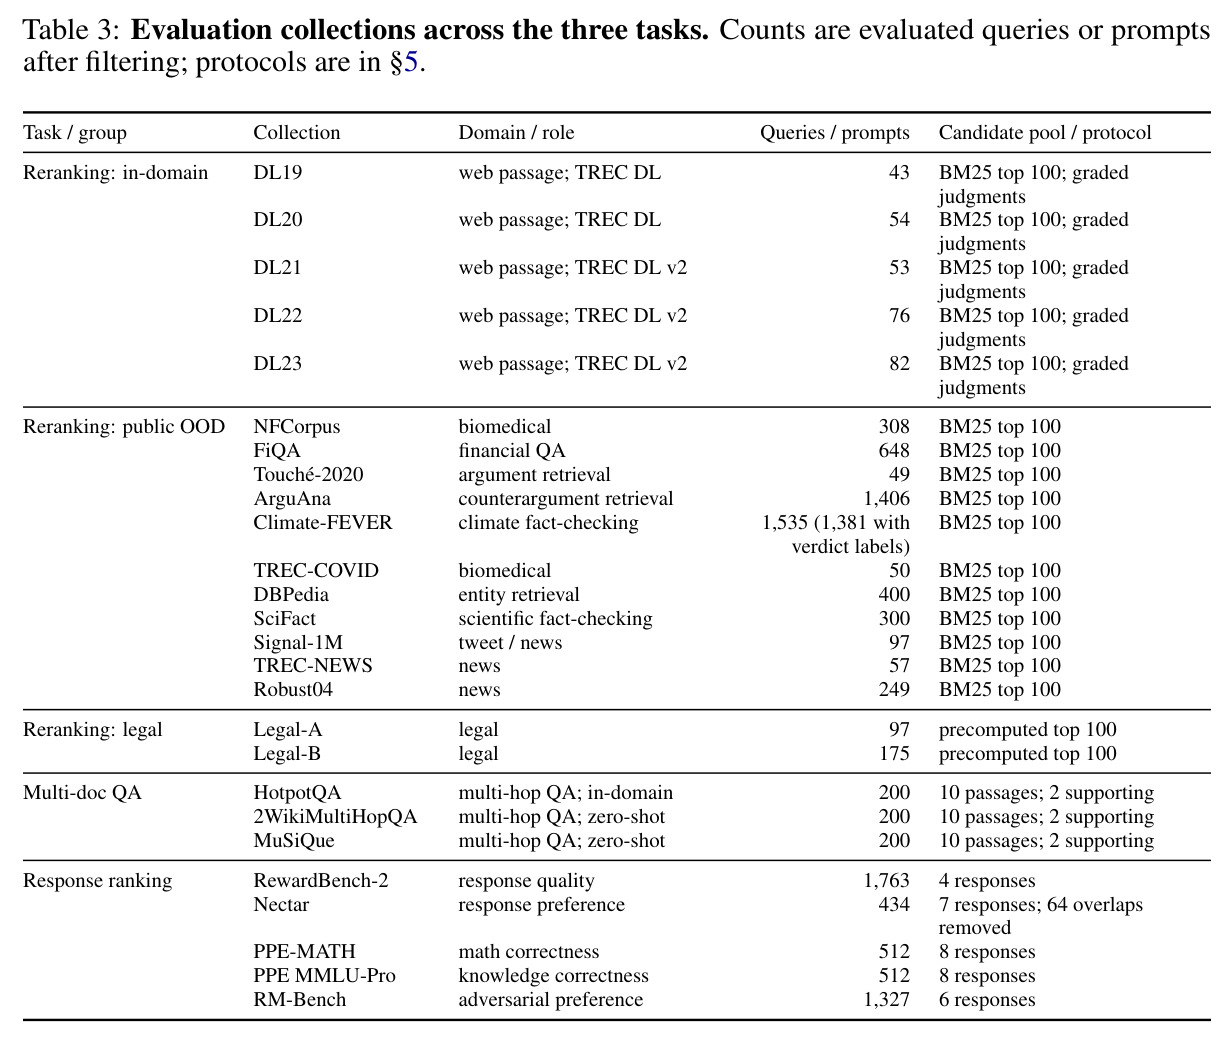
流程如下。第一步构建数据:MS MARCO 约 30K 查询,BM25 取 top-100 切成 5 个 B=20 连续窗口;自蒸馏教师用统一读取方式(4 级评分指令 + query + 带 [i] 标记的 20 篇文档 + 固定 Grades: 骨架,一次前向读各槽 4 个等级 token 概率,期望等级为分)打银标签。第二步训练:每个优化步把同一窗口在两个随机排列下各前向一次(视图对由 query 与窗口 ID 的种子固定,锚点视图为第一个),计算锚点项与顺序方差项;$\lambda$ 前 500 步从 0 线性升到目标(重排 λ=5、QA λ=3、响应排序 λ=1,按 held-out 质量网格选择);LoRA rank 16、AdamW、1 epoch、有效批 64,4B 学生约 90 GPU 小时。第三步服务与评估:服务时按第一阶段顺序单排列一次前向;评估时每个实例在 M=10 个随机排列下重打分,计算 $\tau\text{-PSI}=\frac{1-\text{mean}_{i<j}\tau(r_i,r_j)}{2}$、F1 调优阈值下的保留集 Jaccard、两个冻结 reader 的 verdict/answer flip 及响应排序 pair flip。QA 用 B=10、响应排序训练用 B=4,其余共享。
技术新颖性
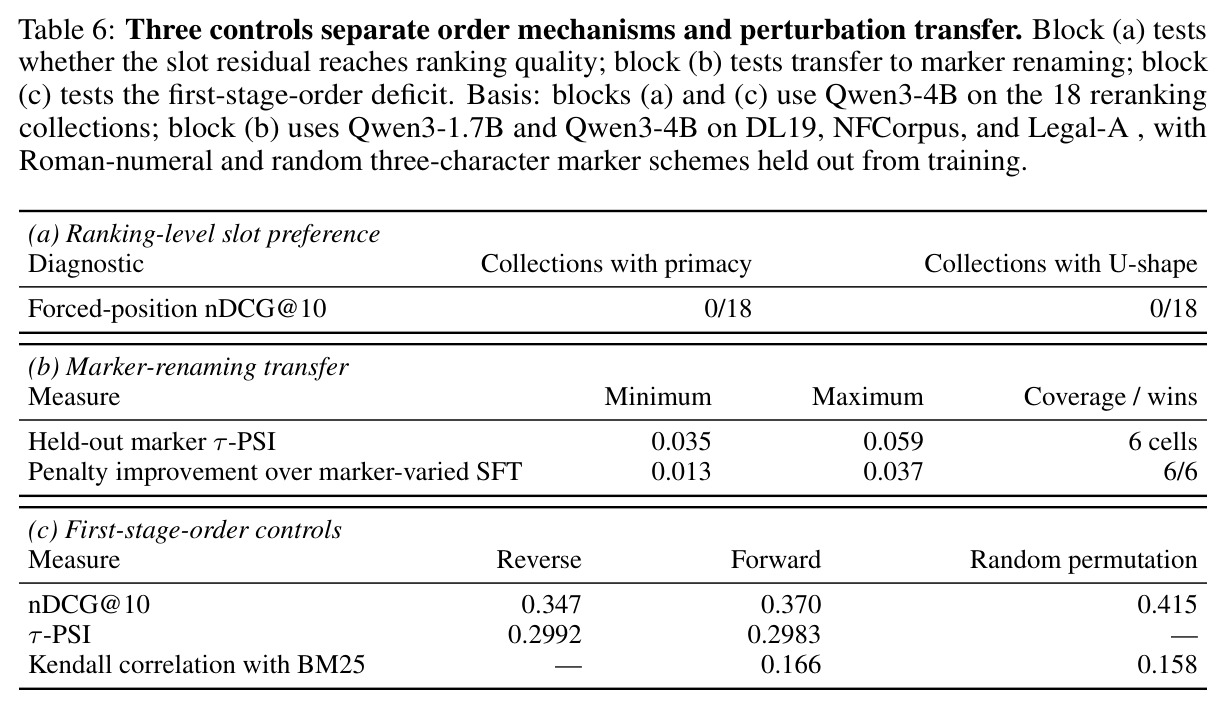
新颖性体现在四层。其一,问题形式化新:明确提出呈现依赖概念,把顺序、分窗规则、槽位标记、答案骨架统一为 presentation 四通道,并证明只动顺序通道就足以让质量相同的评分器做出不同决策——此前没有工作把 reranker/judge 的稳定性度量接到消费者决策上。其二,目标函数新:把一致性正则化从离散答案选择迁移到连续分数的阈值决策;锚点+方差惩罚结构使教师标注保持一次(对比 order-averaged 的 T=10),两个视图(N=2)即可估计方差且到 N=8 无质量变化。其三,度量协议新:τ-PSI 改编自 Zeng et al. 的索引但作用于秩层面,并证明稳定性指标的排列预算足以顺带测出决策稳定性;匹配保留率后重叠增益依然成立,排除阈值位置混淆。其四,控制实验系统:方差分解(Figure 5)显示伴随耦合占 off-the-shelf 文档内分数方差的 82.5%、槽位效应 16.9%,OC-SFT 把残差方差压到原始的 3.2%;有效性控制(Table 7)排除平局坍缩(exact ties 仅 0.351%)、分数分散与质量混杂,Top-10 不稳定度 0.193 对单序 0.343,18/18 集合一致。
实验结果
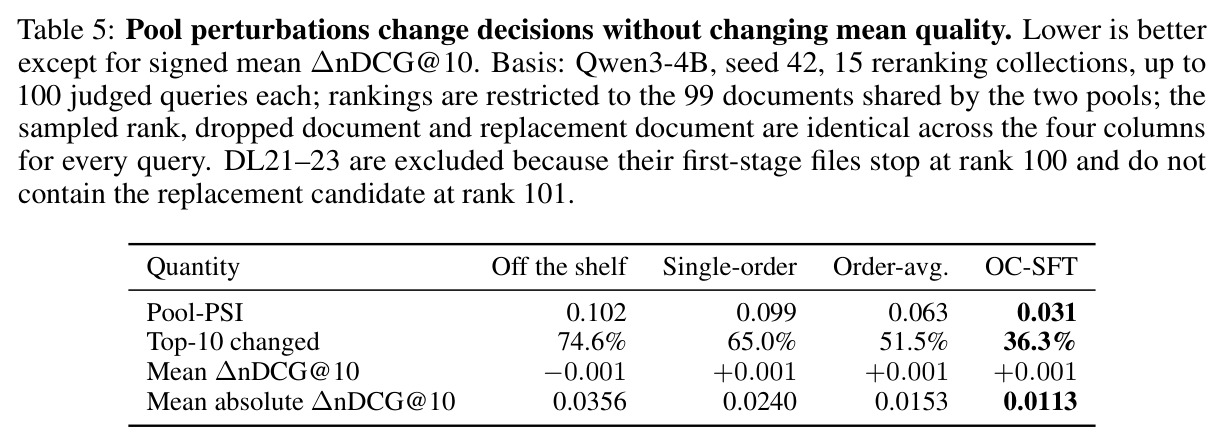
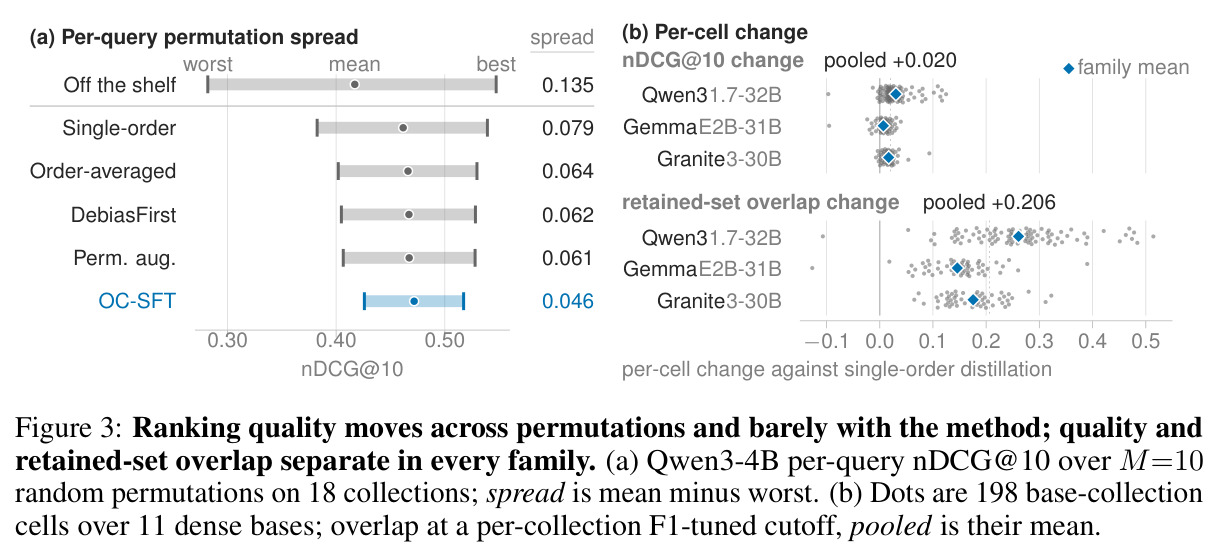
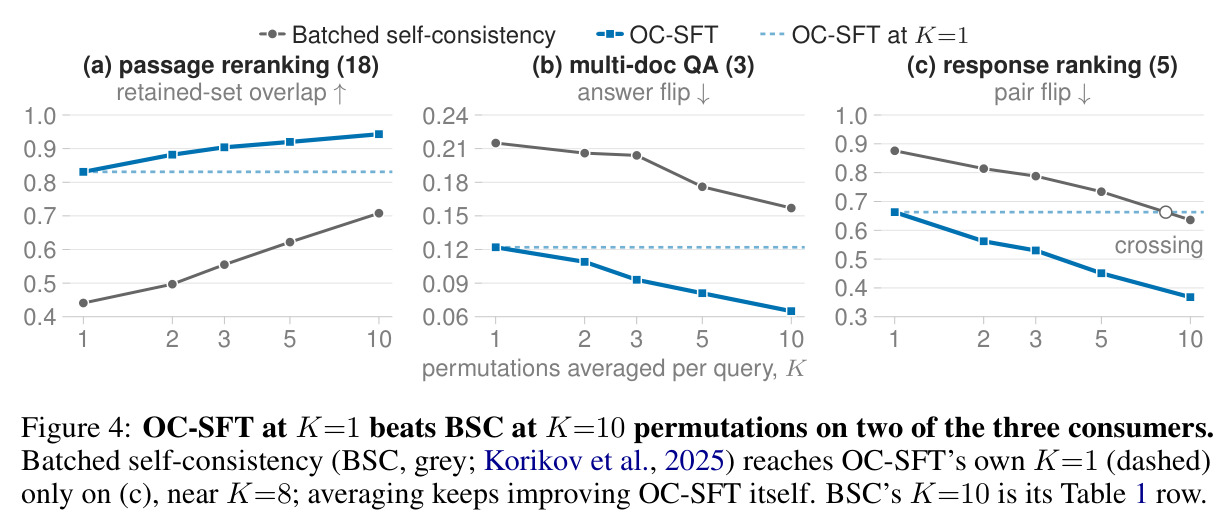
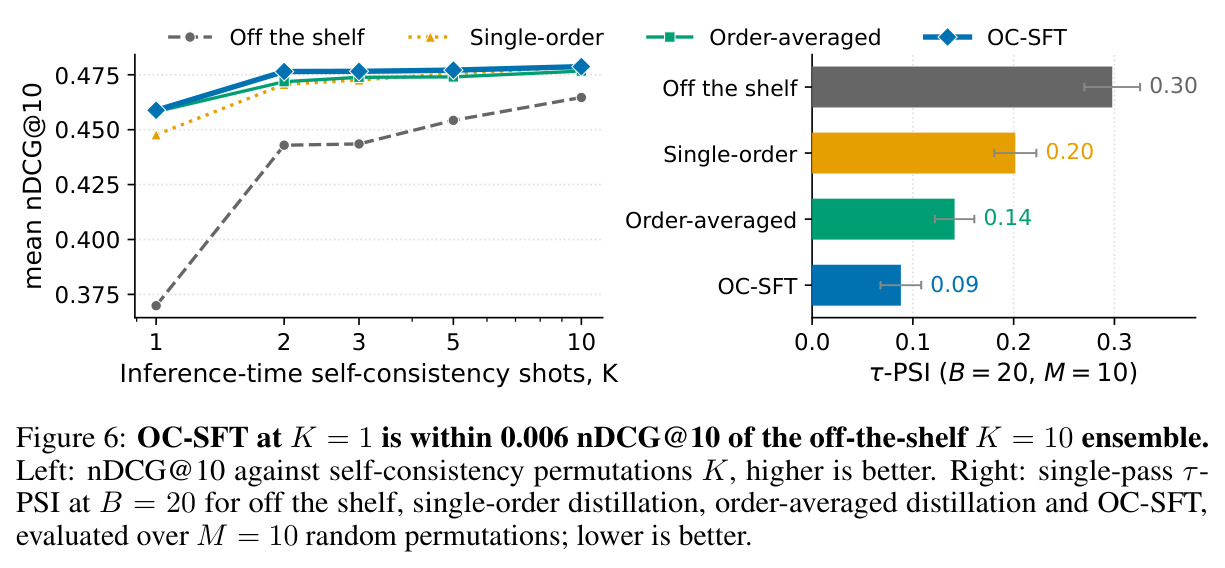
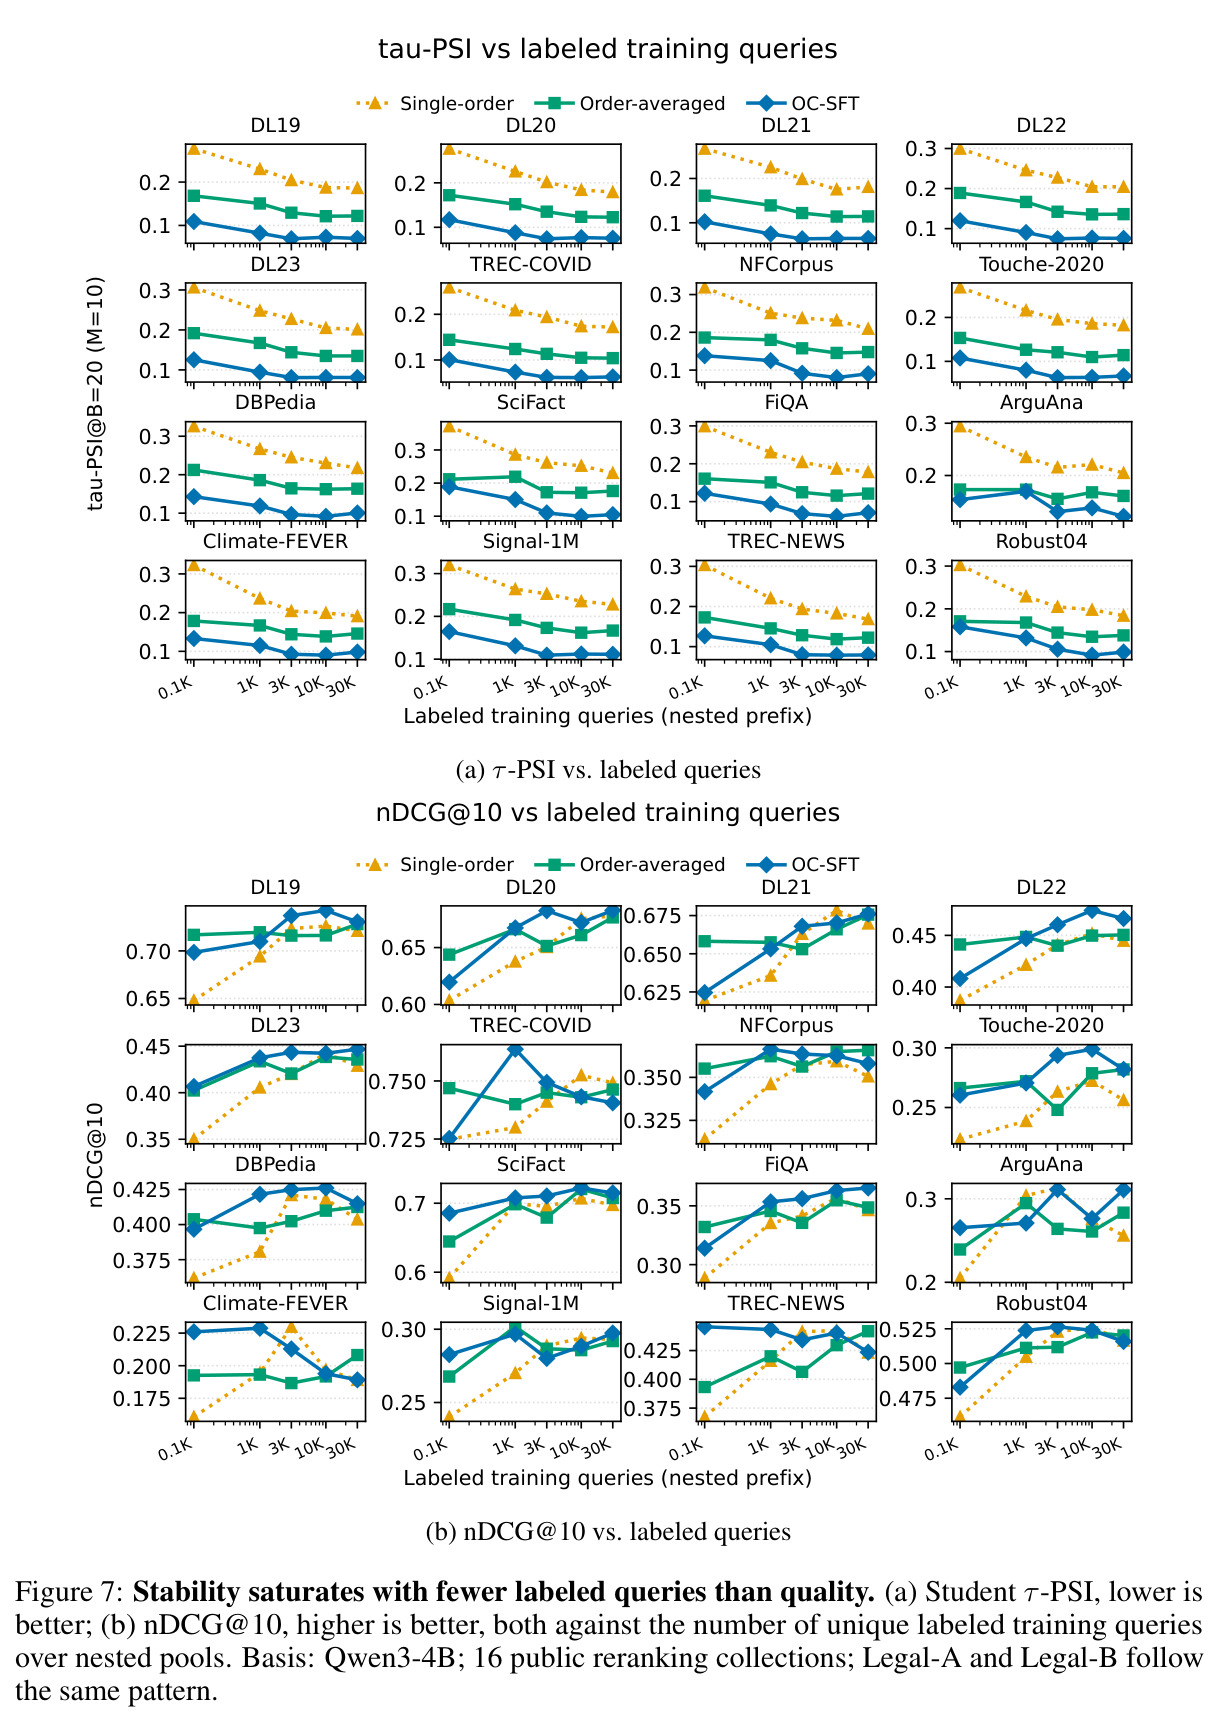
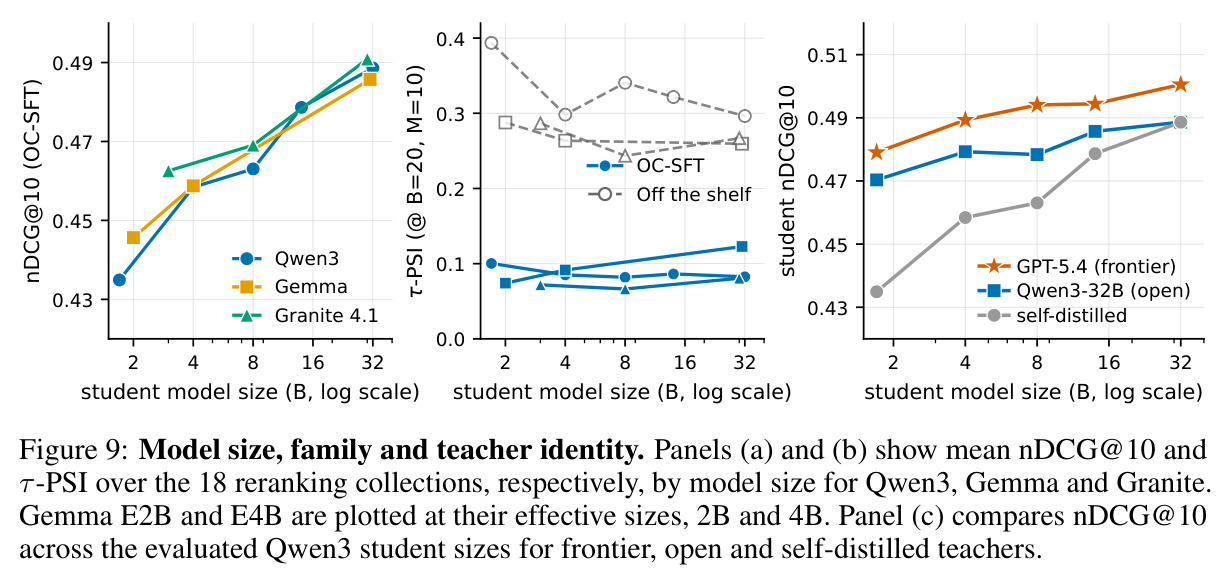
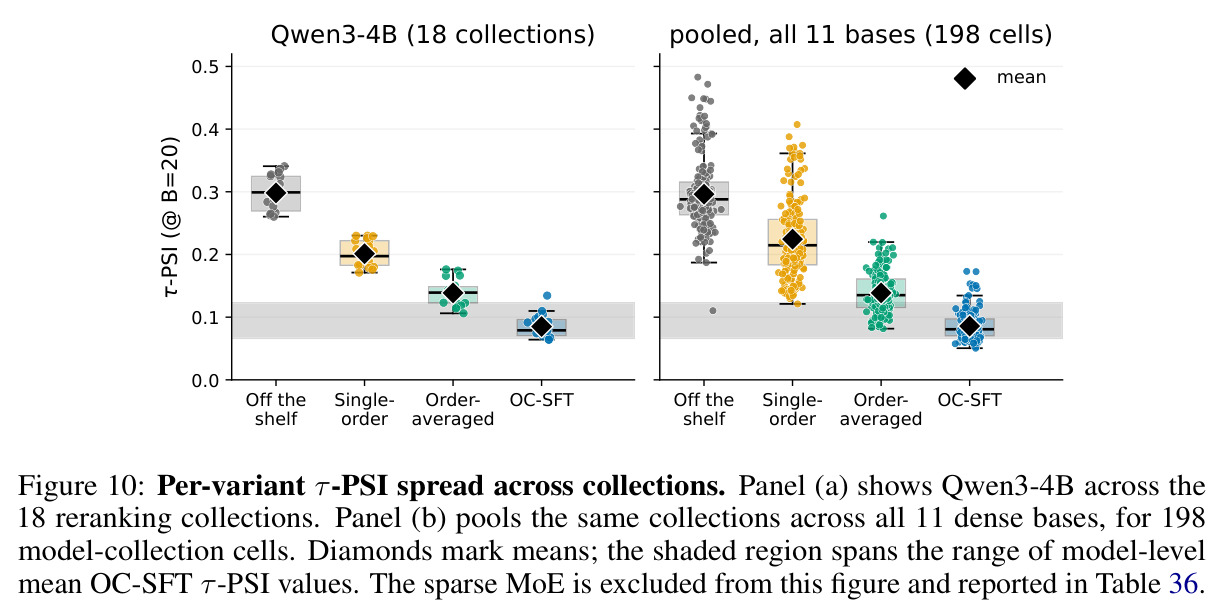
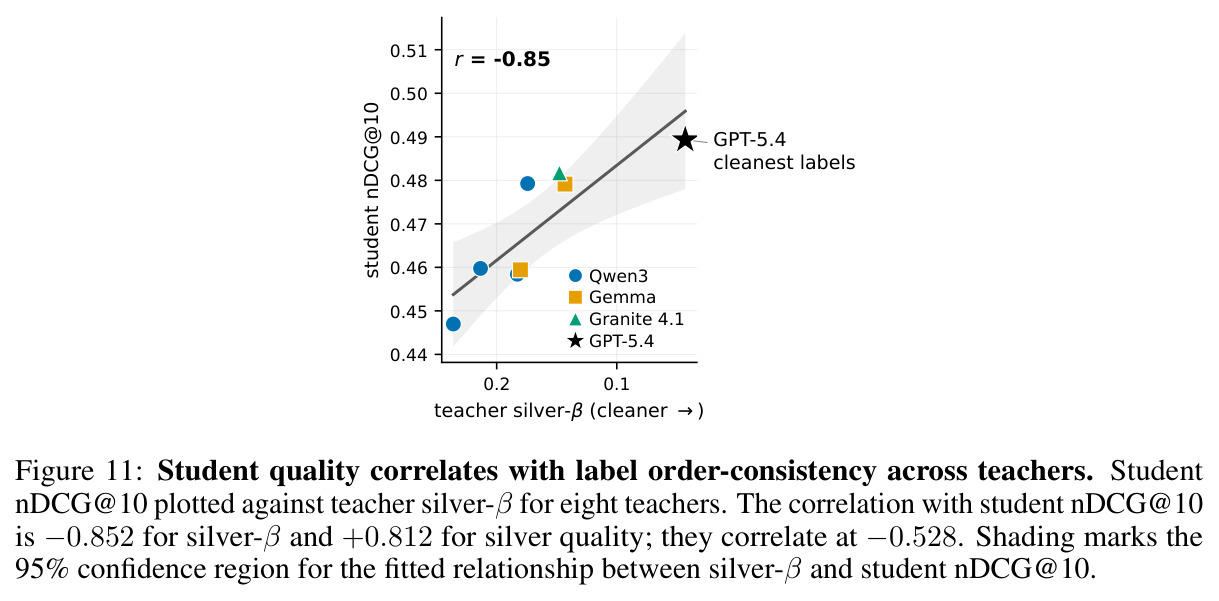
第一,质量饱和而决策不饱和(Table 1):五个训练变体在 18 个重排集合上 nDCG@10 差距 ≤0.010,保留集重叠却从 0.656(单序)到 0.835(OC-SFT)相差一个数量级;七个质量相近系统中 11/18 个集合上质量最优者与稳定性最优者不同;GPT-5.4 质量 0.468 最高,重叠 0.707 却低于 OC-SFT 的 0.835。第二,OC-SFT 在所有消费者上最优:QA answer flip 0.125(对手 0.149–0.177)、响应排序 pair flip 0.661(单序 0.869)、重排 Jaccard 0.835,且 12 个基座上 τ-PSI 全部最低,198 个 cell 的 pooled 重叠增益 +0.206(Figure 3)。第三,一次 OC-SFT 排列胜过十次原始模型平均(Figure 4):BSC 在 K=10 仍未在两个消费者上达到 OC-SFT K=1 水平;训练与平均可叠加,K=10 重叠 0.950。第四,对未训练过的池替换扰动,Pool-PSI 0.031 对单序 0.099(Table 5);1K 标注的稳定性超过 30K 标签的 order-averaged 蒸馏(Figure 7)。第五,伴随耦合占原始分数方差 82.5%,OC-SFT 残差仅为原始 3.2%(Figure 5);silver-β 与学生质量相关 −0.852,开源教师逼近 GPT-5.4 至 0.016 内(Figure 9、11)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 段落重排序(18 个集合,含 DL19-23、BEIR 11 个、法律 2 个) | nDCG@10 | 0.459(OC-SFT,自蒸馏 3 seed 均值) | 单序蒸馏 0.449;off-the-shelf 0.370;BSC×10 0.465;jina-reranker-v3 0.447;GPT-5.4 0.468 | 对单序 +0.010,训练组内最高且与最强系统差距在 0.010 内(质量列无统计学显著领先) |
| 段落重排序 | τ-PSI(顺序不稳定度,越低越好) | 0.083 | 单序蒸馏 0.209;order-averaged 0.130;DebiasFirst 0.128;排列增强 0.129;off-the-shelf 0.298 | 较最强训练基线(0.128–0.130)降低约 35%,较单序降低 60% |
| 段落重排序 | 保留集 Jaccard 重叠(F1 调优阈值,M=10 排列) | 0.835 | 单序蒸馏 0.656;order-averaged 0.743;DebiasFirst 0.759;jina-v3 0.667;GPT-5.4 0.707 | +0.179 对单序;对全部训练基线 +0.076 以上(Holm 校正后 p≤0.0013) |
| 多文档 QA(HotpotQA 及零样本迁移 2 集合) | answer flip(两个冻结 reader 的答案翻转率) | 0.125(nDCG@10 0.961,τ-PSI 0.096) | order-averaged 0.149;排列增强 0.162;DebiasFirst 0.164;单序 0.177;off-the-shelf 0.221 | 翻转率最低,nDCG@10 亦为训练组最高(0.961 vs 0.951–0.956) |
| 响应排序(RewardBench-2、Nectar、PPE、RM-Bench 等 5 集合) | pair flip(chosen/rejected 对翻转率) | 0.661(nDCG@1 0.701,τ-PSI 0.201) | 单序蒸馏 0.869;order-averaged 0.724;DebiasFirst 0.718;排列增强 0.707;off-the-shelf 0.877 | 对单序 −0.208,对 order-averaged −0.063;nDCG@1 为训练组最高 |
局限与改进
作者承认的局限(App. A):测量用均匀随机排列,代表典型而非最坏呈现;阈值、reader 和偏好模型全部冻结,若共同再训练部分不稳定可能被吸收,报告降幅可能偏大;只测了供给偏好训练的 chosen/rejected 对,未验证下游模型拟合后不稳定是否残留;答案骨架固定为 Grade: 0 一种;改进是衰减而非消除,固定顺序下保留集复现率也只有 0.985(推理引擎批次噪声);全部集合为英文、无思维链,推理型检索(BRIGHT)未测;ArguAna 是反复出现的集合级反例;18 集合均值含两个专有法律集合;GPT-5.4 绑定 API 版本,对比不完全可复现。我的观察:λ 与 checkpoint 只按排序质量挑选,稳定性未纳入选择准则;OC-SFT 的两个视图只做窗口内槽位置换、同伴候选不变,对池替换的泛化更像副产品而非设计保证;惩罚只压缩方差不归零,截止线平局处排名仍会翻转(exact ties 反而升至 0.351%);两候选及以下的极小池未覆盖,而 pairwise judge 恰是常见场景。
独立分析的弱点
独立分析的弱点及改进方向。第一,衰减不等于不变:顺序方差被压低但保留,接近平局的候选排名仍随排列翻转,对法律检索这类要求可审计的高风险场景不足;改进方向是把一致性目标推进到决策层,如用 RL 奖励决策一致(PA-GRPO 思路的连续分数版)或阈值附近 paired 校准。第二,呈现通道只堵住一个:marker 重命名敏感性既未被顺序一致性训练也未被 marker 多样化 SFT 移除(held-out τ-PSI 0.035–0.059),答案骨架的影响同样在;改进方向是把顺序、marker、骨架统一进多视图一致性目标——作者已证明加 marker 惩罚在 6/6 个 held-out cell 上有效。第三,结构化不变路线未充分探索:移植限制跨候选注意力的机制后质量与稳定性双降,说明免费的顺序不变在此读取方式下不可得,需要既保持跨候选信息又集合不变的设计(SetRank 式集合编码加语言模型先验)。第四,稳定性评估本身需 M=10 次前向,虽可复用 τ-PSI 排列预算,对实践者仍是负担。第五,λ 全程恒定且逐窗口相同,可按模型不确定性加权,让更不确定的窗口接受更强约束。
未来方向
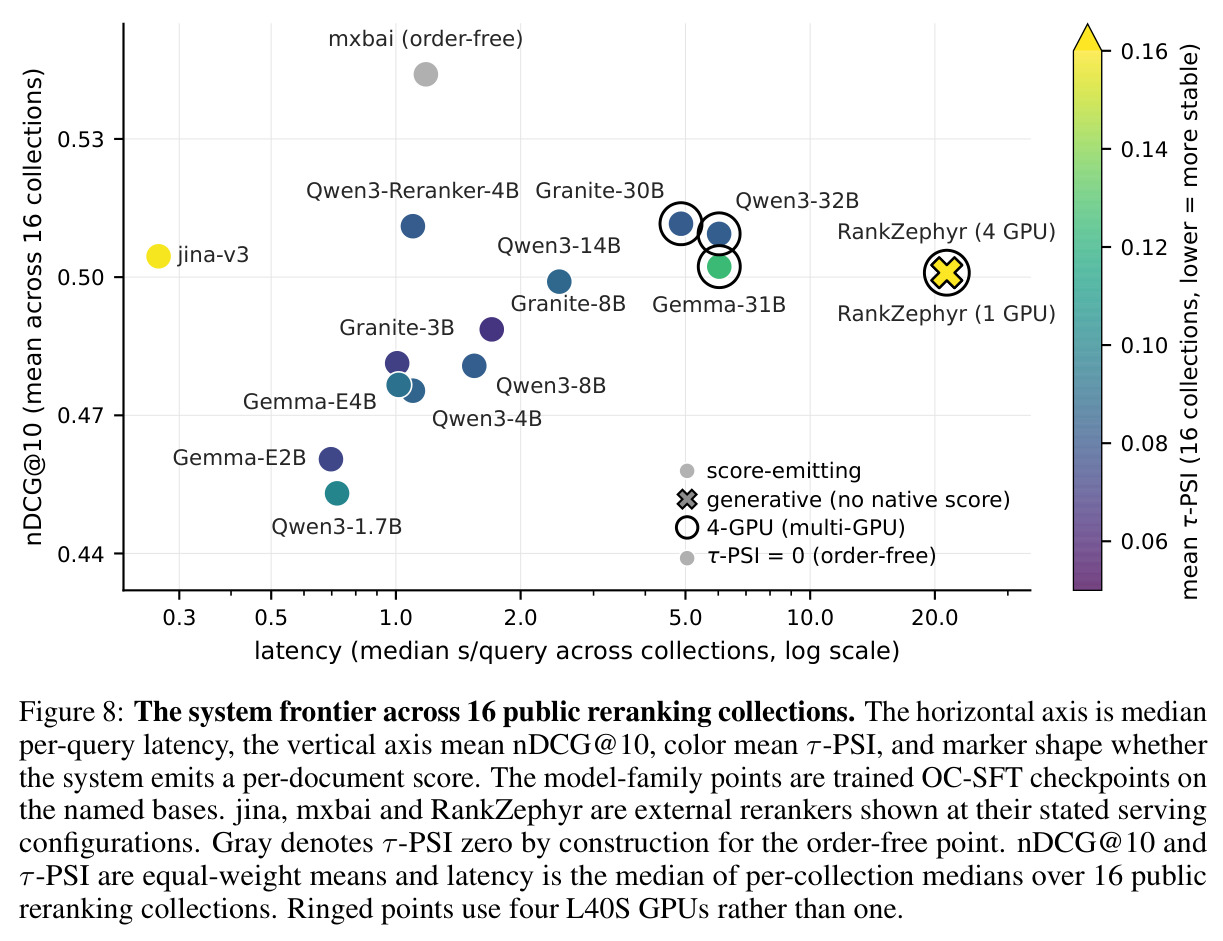
作者提出的方向包括:教师选择应同时报告标签质量与标签顺序一致性(silver-β),二者与学生质量相关 −0.852 与 +0.812 且互相相关 −0.528,银标签换序稳定性应成为教师评测指标;检验消费者共同适配后的稳定性差异;把 PA-GRPO 类 RL 奖励在连续分数上重新定义后与本目标结合。基于本文成果可延伸的方向:其一,把顺序一致性目标接入偏好训练管线——用 OC-SFT 稳定的评分器生成 DPO/RLHF 的 chosen/rejected 对,测量下游策略增益与训练方差,直接回应 65.4% 查询受顺序影响的发现;其二,多通道统一一致性目标,同时覆盖顺序、companion、marker、骨架与池组成扰动;其三,迁移到 LLM judge 与响应侧奖励模型(Skywork-Reward-V2 类),检验 nDCG@1 0.701、pair flip 0.661 的趋势是否跨域成立;其四,理论刻画残差方差、λ 与质量-稳定性 Pareto 前沿的关系,把 Figure 8 的系统前沿参数化;其五,扩展到推理型 reranker、非英语语料与两候选池的成对一致性版本。
复现评估
复现条件相当好。开源情况:代码在 github.com/thomsonreuters/presentation-dependence,发布 τ-PSI 实现、完整评估 harness、评分 prompt 与答案骨架模板、训练与推理代码,以及银标签、11 个 dense 基座的 LoRA adapter 和全部评估配置命令。数据:训练用 MS MARCO(约 30K 查询)、HotpotQA(30K)、UltraFeedback(约 30.7K)全部公开;评估的 16 个公开集合公开,但 Table 1 的 18 集合均值含两个专有法律集合(Legal-A/B),外界无法完整复现该均值(附录有 16 集合公开均值可对照)。算力:主结果学生约 90 GPU 小时(8×A100-40GB 单节点,LoRA rank 16);完整公开评估 60–90 小时单张 L40S-48GB,单个集合约 1 小时。难度中等偏低:教师为自蒸馏、无需外部模型,单节点可复现主结果;注意 GPT-5.4 对比绑定 gpt-5.4-2026-03-05 部署版本、重打分因引擎批处理有数值噪声(固定顺序下保留集复现 0.985),稳定性评估还需 M=10 排列的推理开销。
论文图表
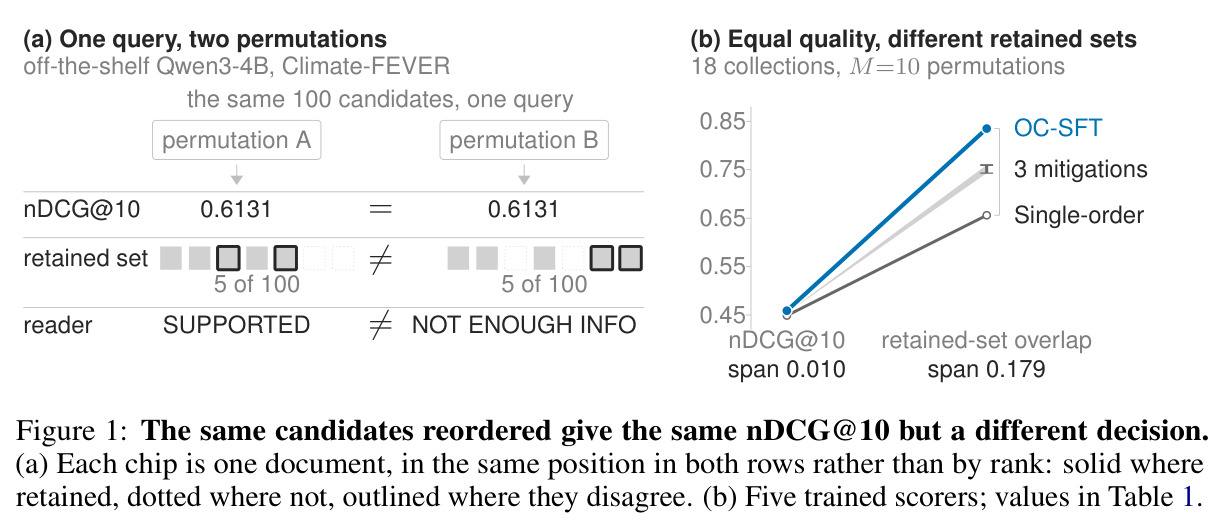
两个子图。(a) 展示 Climate-FEVER 上同一查询的 100 个候选在两种排列下的打分:两行芯片按文档在两种排列中的同一位置对齐,实心为被阈值保留、点线为未保留、描边为两者不一致——nDCG@10 都是 0.6131,保留集却相差 5/100,reader 把同一声明从 SUPPORTED 读成 NOT ENOUGH INFO。(b) 展示 5 个训练评分器在 18 个集合、M=10 排列下:nDCG@10 跨度仅 0.010,保留集重叠跨度却达 0.179。
这是全文论点的缩影:排序质量指标对决策不稳定完全盲视。理解这张图就理解了论文为什么要引入决策稳定性度量。