知何时不可复用:自主LLM后训练中的条件化经验迁移 Knowing When Not to Reuse: Conditional Experience Transfer in Autonomous LLM Post-Training
提出BCIT方法,在复用历史训练经验前先校验其是否适用于当前模型状态。
前置知识
自主后训练闭环(Autonomous Post-Training)
指由 LLM Agent 驱动的自动化模型改进流程:Agent 提出一个训练更新(如换数据配比、换损失函数),实际执行训练得到候选模型,用评估反馈决定采纳或修改下一个提案,如此迭代。代表系统有 LaMDAgent、TREX,评测基准有 PostTrainBench、Agent2RL-Bench。
本文的问题正是在这个闭环里产生的:闭环会积累大量「某更新在某时某处有效」的历史记录,论文研究的就是这些历史能否、以及何时可以被安全复用。
负迁移(Negative Transfer)
迁移学习中的经典现象:源任务上学到的信息不仅没帮助目标任务,反而造成伤害。传统研究在任务或表征层面刻画它(Taskonomy、LEEP、LogME)。在大模型后训练场景下,它表现为:在旧父模型上有效的微调配方,换到新父模型后目标不涨或保留指标暴跌。
本文把负迁移问题从「任务层面」下沉到「单个候选更新 × 当前模型状态」的决策粒度,核心实验(24 个匹配对照中 13 个不改善目标)就是负迁移的直接证据。
上下文绑定的证据(State-Bound Evidence)
一次更新的观测效果依赖于它执行时的父模型、数据、训练阶段和评估协议,因此历史记录只支持「在源上下文 $x_s$ 下有效」这一命题,不等价于「从任何父模型重训都有效」的无条件许可。论文用 Toulmin 实践论证模型类比:观测增益是通过「warrant(适用保证)」支持主张的,显式例外可以推翻它。
这是全文的核心概念:BCIT 的记录结构 $(i, x_s, E_s, B_i, \rho_i)$、乘法评分 $Q_i = S_i A_i$、硬冲突否决,全都是在工程化「证据不能脱离上下文」这一原则。
有界验证试验(Bounded Validation Trial)
在投入全量训练预算之前,从当前父模型出发、以 capped 预算(本文为标称全量的 20%)跑一次短训练,用与全量训练相同的冻结评估数据度量目标变化 $\Delta^{val}$,结果分 Pass/Fail/Inconclusive 三类。其临时检查点永不晋升,只作为「当前状态证据」指导授权决策。
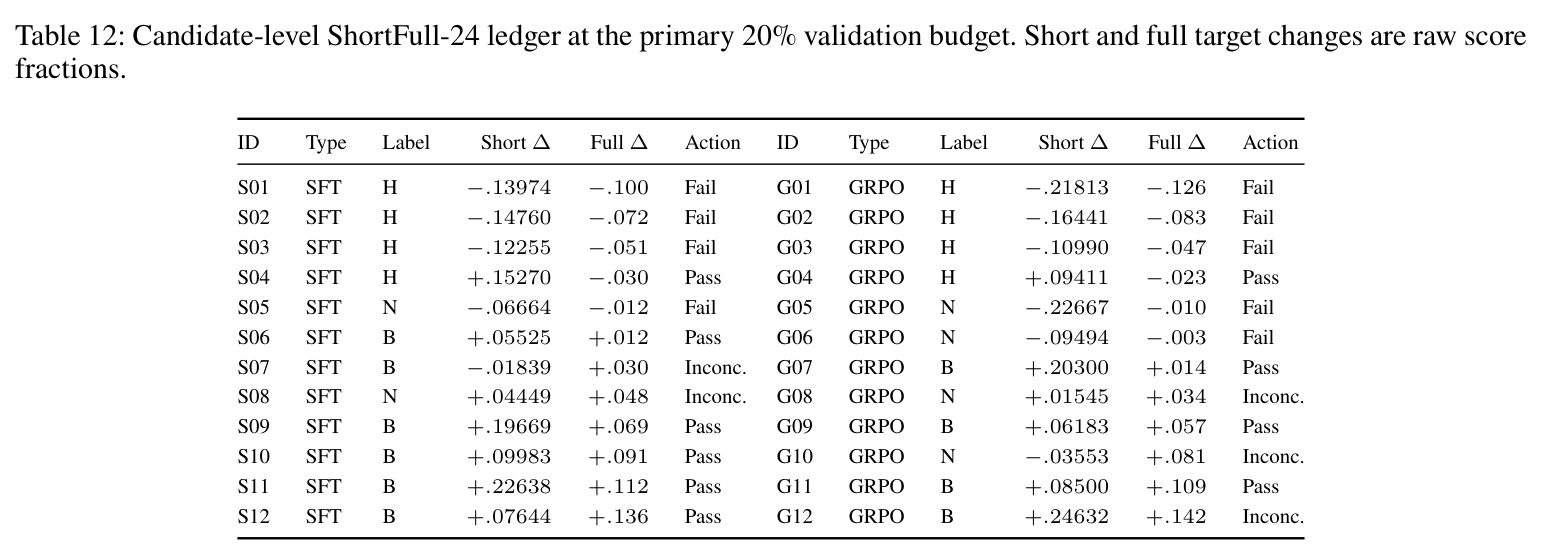
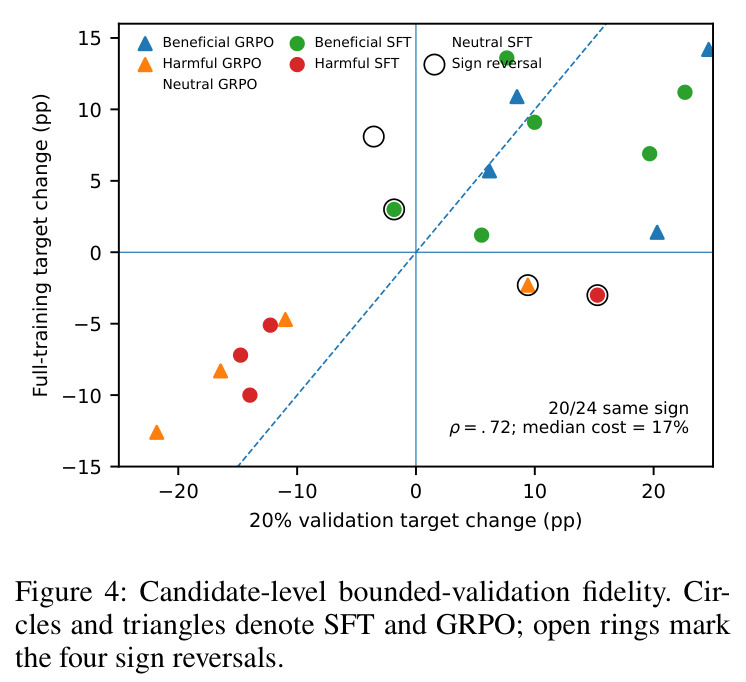
它是 BCIT 三分支(拒绝-验证-训练)中承上启下的一环;论文用专门的 ShortFull-24 研究量化了这种短跑对全跑的预测保真度(方向一致率 83.3%,$\rho=.72$)。
SFT 与 GRPO
SFT(监督微调)用标注数据做下一词元预测的参数全量更新;GRPO(Group Relative Policy Optimization)是一种 RL 后训练算法,对同一提示采样一组回答、以组内相对优势为基线计算策略梯度。本文的候选更新池同时包含 12 个 SFT 型和 12 个 GRPO 型原子干预。
理解候选记录里的「原子更新」究竟是什么(如 Standard SQL SFT、Execution-reward GRPO),以及 Table 9 中 SFT/GRPO 各 12 条匹配效应的含义,需要这两个算法的基本图像。
IFEval 与保留约束
IFEval 包含 541 个提示、834 条可验证指令,分别报告 prompt 级和 instruction 级严格准确率。本文把它作为所有能力共享的保留约束:任何更新在训练、验证、采纳各阶段都不得让 IFEval 相对初始父模型下跌超过 2 个百分点,且不可被目标分数补偿。
论文反复强调「目标提升不等于更新有益」——多个候选目标涨分但 IFEval 崩塌 10–22 pp,正是这类保留违反构成了有害更新,是授权决策要拦截的主要对象。
研究动机
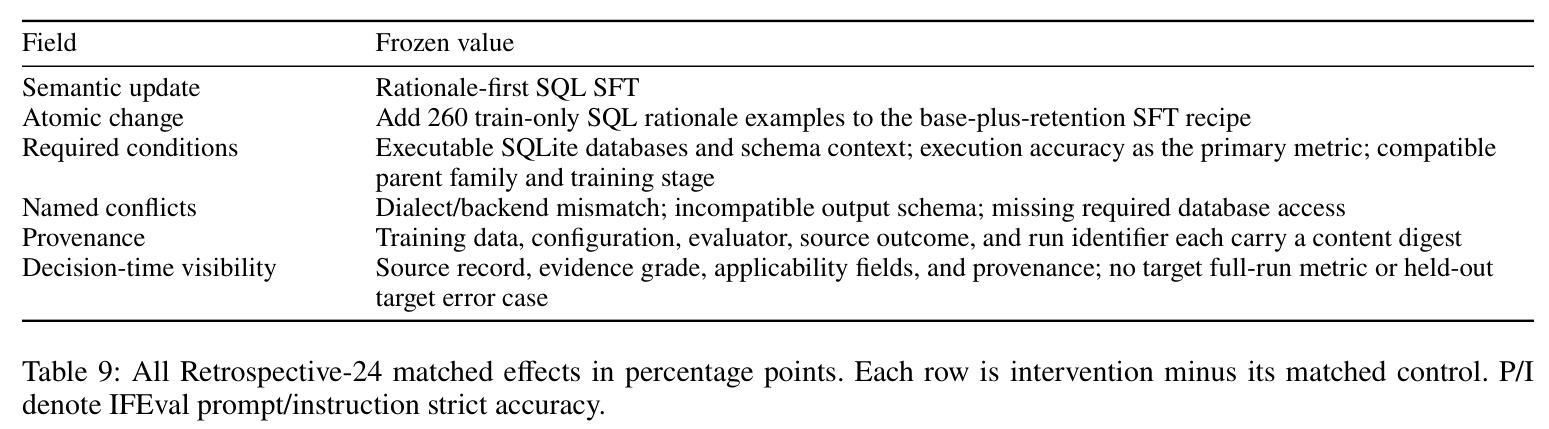
自主后训练系统(LaMDAgent、TREX、Agent2RL-Bench 等)在迭代中会积累一份「更新-结局」历史,但这份历史不能自我执行:一次更新的效果依赖于它当时的父模型、数据配比、训练阶段和评估协议,在旧父模型上观测到的成功只是源上下文绑定的证据。若把历史成功当作无上下文的许可直接复用,代价有两层:一是浪费稀缺训练算力,二是被错误晋升的子模型会成为后续决策的父模型,进一步扭曲训练轨迹。论文用 Retrospective-24 诊断量化了这一风险:在 24 个匹配候选-上下文对(每能力族 8 个)中,13 个候选不改善目标(11 正、3 中、10 负),而 11 个目标改善的候选中只有 3 个同时保住两项保留指标。典型反例触目惊心:标准 SQL SFT 使 BIRD 提升 2.250 pp,但 IFEval prompt/instruction 级分别暴跌 22.736/18.705 pp;随机采样函数调用 SFT 使 BFCL +1.351 pp 但 IFEval −11.091/−8.153 pp。即便语义同族的迁移内部也涨跌互现。
本文的目标是本文要把「是否复用历史经验」确立为自主后训练中一个独立的控制问题——条件化经验迁移(conditional experience transfer),并给出可操作的方法:对当前父模型 $m_t$ 下的每个具体候选 $c_i$,在全量权重训练之前,由授权策略从 ${Reject, Validate, Train}$ 三个动作中选择其一。目标是在候选流、证据、算力完全匹配的条件下:(1)显著减少有害候选的授权而不牺牲有益候选的覆盖(防止平凡的「全部拒绝」占优);(2)验证有界验证试验对全量训练的预测保真度;(3)在等算力成对比较中提升最终共享模型的跨任务均值,同时满足 IFEval 的 $-2$ pp 保留边界。实验载体是用一个 Qwen3-4B 模型顺序适应金融推理(FinQA→TAT-QA)、text-to-SQL(Spider→BIRD)、函数调用(xLAM→BFCL)三个能力,顺序晋升不断更换父模型,构成经验迁移的压力测试。
与已有工作不同的是,已有工作都不回答本文的核心决策问题。自主流水线方向(LaMDAgent、TREX、EvoTrainer、AutoPipe)改进候选生成与迭代训练,不处理「父模型已变后旧证据还算不算数」;可迁移性估计方向(Taskonomy、LEEP、LogME、负迁移理论)在任务或预训练模型层面打分,粒度太粗且不涉及权重更新的具体授权;案例推理与 Agent 记忆方向(ExpeL、Reflexion、Agent Workflow Memory)检索和改写可复用内容,而非决定是否为一个具体候选分配训练算力;任务算术、模型汤、TIES-Merging 在集成时处理兼容性,持续学习在训练后限制遗忘,都发生在 BCIT 所在决策点之后。BCIT 的独特切入是在候选生成与全量训练之间插入一个透明的「拒绝-验证-训练」授权层:用源证据强度与当前兼容性的乘积 $Q_i = S_i A_i$ 编码「高源分数不能补偿上下文错配」,用不可补偿的命名硬冲突实现 Toulmin 意义上的「例外可推翻论证」,并用结果盲审计与等算力成对实验来评估这一层本身的价值。
核心方法
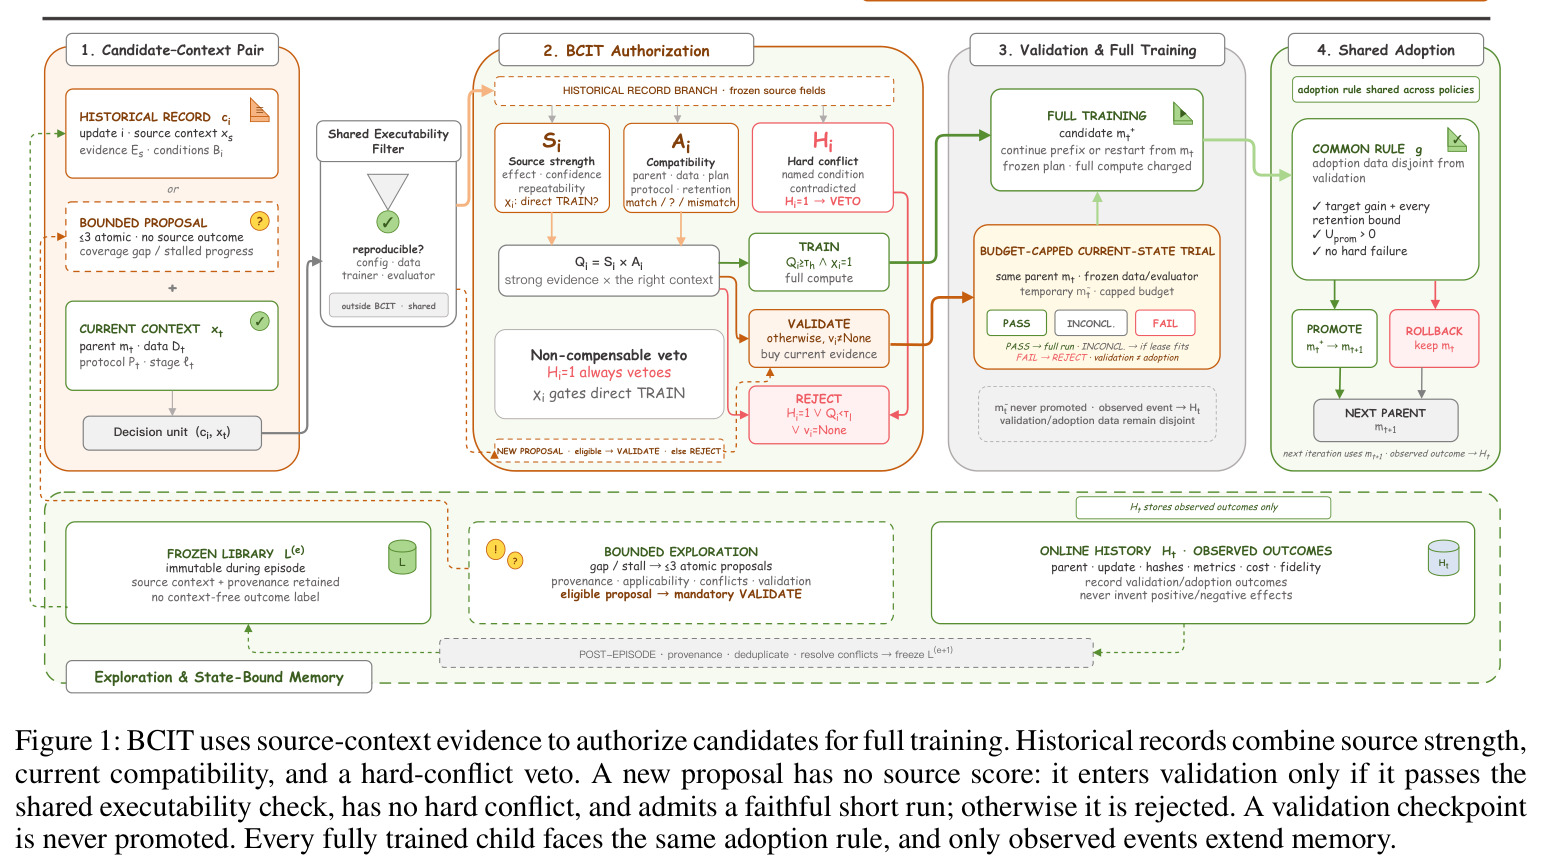
直觉上,BCIT 把「过去某更新有效」从「现在可以花全量算力重训」中剥离出来:前者是源上下文下的观测,后者是需要当前状态证据支持的授权。技术上,每条历史经验被冻结为状态绑定记录 $c_i^{hist} = (i, x_s, E_s, B_i, \rho_i)$,其中 $i$ 是原子更新,$x_s$ 是源上下文(源父模型、数据、协议、阶段),$E_s$ 是观测到的源证据,$B_i$ 是预指定适用条件与命名冲突,$\rho_i$ 是指向模型/数据/配置/评估产物的溯源哈希。授权时,确定性编译器只读源记录与当前上下文结构化元数据(禁止读目标结局,时间戳与哈希防追溯篡改),计算三个量:源强度 $S_i = d(e_i)\,\mathrm{clip}(\delta_i^{src}/\kappa_i, 0, 1)$,其中证据等级折扣 $d(A/B/C) = 1/.75/.5$、$\kappa_i$ 为预指定归一化尺度、负源效应截断为零;当前兼容性 $A_i$ 为五个训练前字段(能力族匹配、训练数据可用性与同一性、运行时可用性、当前父兼容性、评估/输出协议兼容性)取 0/.5/1(错配/未决/匹配)的均值;硬冲突指示 $H_i$ 仅当命名必要条件被矛盾时为 1。正分取乘积 $Q_i = S_i A_i$。决策规则为:$H_i = 1$ 或 $Q_i < \tau_l = .30$ 则拒绝;$Q_i \ge \tau_h = .70$ 且证据为复制的匹配对照($\chi_i = 1$)才可直接全量训练;其余且存在忠实短跑($\nu_i \neq None$)走有界验证,验证 Pass 转全量、Fail 拒绝、Inconclusive 仅在冻结回退租约允许时全量。所有全量训练后的子模型统一面对共享采纳规则 $g$:目标增益达阈、全部保留约束满足、无硬失败才晋升父模型,否则回滚——授权不等于晋升,验证检查点永不晋升。
核心创新有三点,且都与既有方法的本质区别明确。第一,证据的上下文绑定:记录只支持「在 $x_s$ 观测到的效应」,系统性地拒绝给更新打无上下文的正/负标签——新提案被表示为 $c_i^{prop} = (i, \bot, \bot, B_i, \rho_i)$,不伪造任何源分数,因此只能通过真实的有界验证获得全量预算,这从结构上堵住了「把历史成功洗成无条件许可」的路径。第二,乘法组合与非补偿否决:$Q_i = S_i \times A_i$,源强度再高也无法补偿当前上下文错配(与 Flat-Additive 基线的加法分数 $(S_i + A_i + 1 - H_i)/3$ 形成对照——加法下证据可以买断冲突,硬冲突退化为普通特征);而 $H_i = 1$ 的一票否决实现了「显式例外推翻论证」,实验显示去掉该否决会使有害授权率从 25.0% 升到 50.0%。第三,边界冻结与结果盲:适用条件、阈值 $\tau_l/.\tau_h$、采纳规则、预算、评估器全部在结局开放前冻结,且「只有实际执行的事件能扩展记忆」——episode 内历史 $H_t$ 不可变,每 episode 至多 3 个原子探索提案且必须验证,episode 后才能经溯源检查、去重、冲突复核整合出新库版本 $L^{(e+1)} = \mathrm{Consolidate}(L^{(e)}, H_T^{(e)})$。
方法步骤详情
完整流程分六步。第 1 步,共享可执行性过滤(所有对比策略相同,故其排除不计入 BCIT 功劳):凡配置、数据、训练器或评估器不可复现的候选直接丢弃。第 2 步,授权编译:确定性编译器从冻结经验库读取候选记录,计算源强度 $S_i$(证据等级折扣乘以归一化源效应 $\delta_i^{src}/\kappa_i$,使用重复配对运行的下置信界或记录点估计)、兼容性 $A_i$(五项 0/.5/1 字段均值)、硬冲突 $H_i$,以及验证可行性 $\nu_i \in \{\mathrm{Continue}, \mathrm{Restart}, None\}$(验证是全跑前缀 / 独立短跑后重启 / 无忠实短跑)。第 3 步,决策路由:历史候选按 $H_i = 1 \lor Q_i < .30 \Rightarrow Reject$;$Q_i \ge .70 \land \chi_i = 1 \Rightarrow Train$;$\nu_i \neq None \Rightarrow Validate$;否则 Reject。新提案无 $S_i$ 与 $\chi_i$,只有 $H_i = 0$ 且存在忠实短跑才 Validate(Eq.13),每 episode 探索配额 $q = 3$。第 4 步,有界验证:从当前父模型 $m_t$ 以 $b_i^{val} \le \bar{b}^{val}$(标称全量的 20%)训练得临时检查点 $\tilde{m}_t$,用冻结的同一评估数据计算 $\Delta_i^{val} = M_{val}(\tilde{m}_t) - M_{val}(m_t)$;目标达验证阈值、全部保留界保持、无格式/解析/执行失败记 Pass,触发预指定退化或护栏条件记 Fail,其余 Inconclusive。第 5 步,全量训练与共享采纳:$m_t^+(i) = \mathrm{Train}(m_t, i, b_i^{full})$,在独立于验证数据的采纳数据上按规则 $g$ 计算晋升效用 $U^{prom} = \frac{1}{|F|}\sum_{r \in F} \Delta_r^{prom}/\kappa_r$,要求各能力达最小有意义增益、$U^{prom} > 0$、无硬失败才晋升,否则回滚到 $m_t$。第 6 步,记忆与探索:episode 内 $H_t$ 不可变且只记录已执行事件(决策、哈希、动作、成本、指标、保真度、结局;拒绝只记冻结理由),episode 后经 $\mathrm{Consolidate}$ 生成新冻结库版本。训练栈为 Qwen3-4B 全参数 SFT/GRPO,LlamaFactory + DeepSpeed ZeRO-2,bfloat16,4 GPU 有效 batch 32,学习率 $6 \times 10^{-6}$,余弦调度,4096 上下文。
技术新颖性
技术新颖性体现在四个层面。其一,问题层面:首次把「源上下文证据是否值得为已改变的父模型分配验证或全量训练算力」作为一等决策问题形式化,定义了状态绑定决策单元 $(c_i, x_t)$ 和 $Reject/Validate/Train$ 动作空间,与任务级迁移估计和内容级经验检索正交。其二,方法层面:乘法评分 $Q_i = S_i A_i$ + 非补偿硬冲突 + 「只有 A 级复制证据可跳过验证」($E^{direct} = \{A\}$,点估计永远不能绕过验证)构成一套透明、规定式(非学习)的授权算术,任何决策都可被追溯到冻结字段。其三,评估方法学层面:这套实验设计本身有贡献——匹配对照设计让原子干预效应可解释(每对共享父模型、种子、数据规模、评估样本与预算);结果盲审计(决策先冻结、结局后开放、哈希防篡改);验证保真度研究让全部 24 个候选都跑短+全(避免 pass-only 选择偏差);等算力 6 配对种子 episode + 精确符号翻转检验($2/64 = .03125$ 为最小可达 p 值)+ 事后修订需预注册的协议修正案。其四,诚实性层面:作者明确区分方向性证据(McNemar $p = .25$ 的 24 单元审计)与推断性证据(6 配对 episode),把组件消融标记为描述性,这种证据分级在同类系统论文中少见。
实验结果
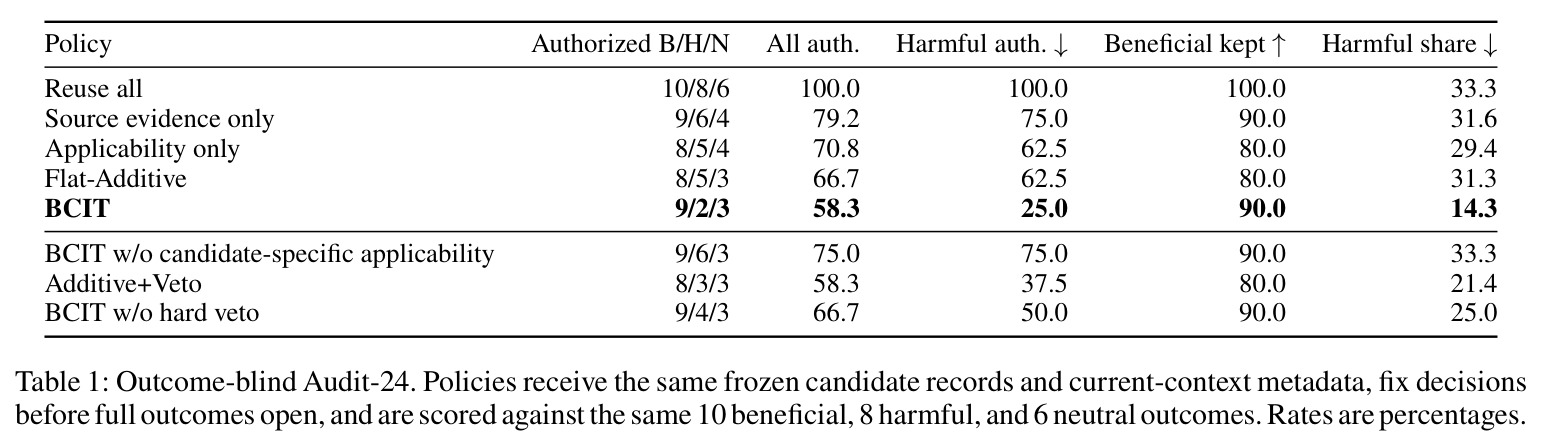
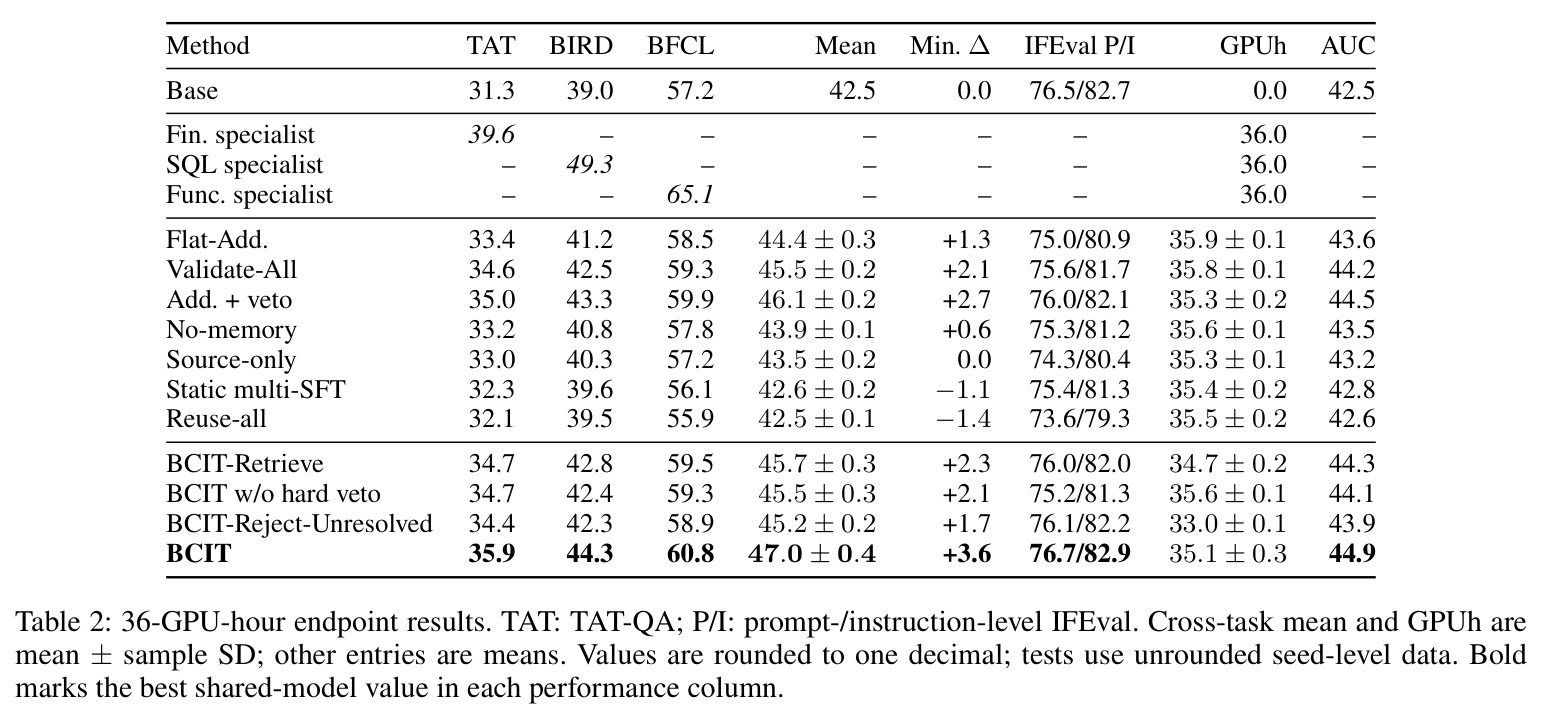
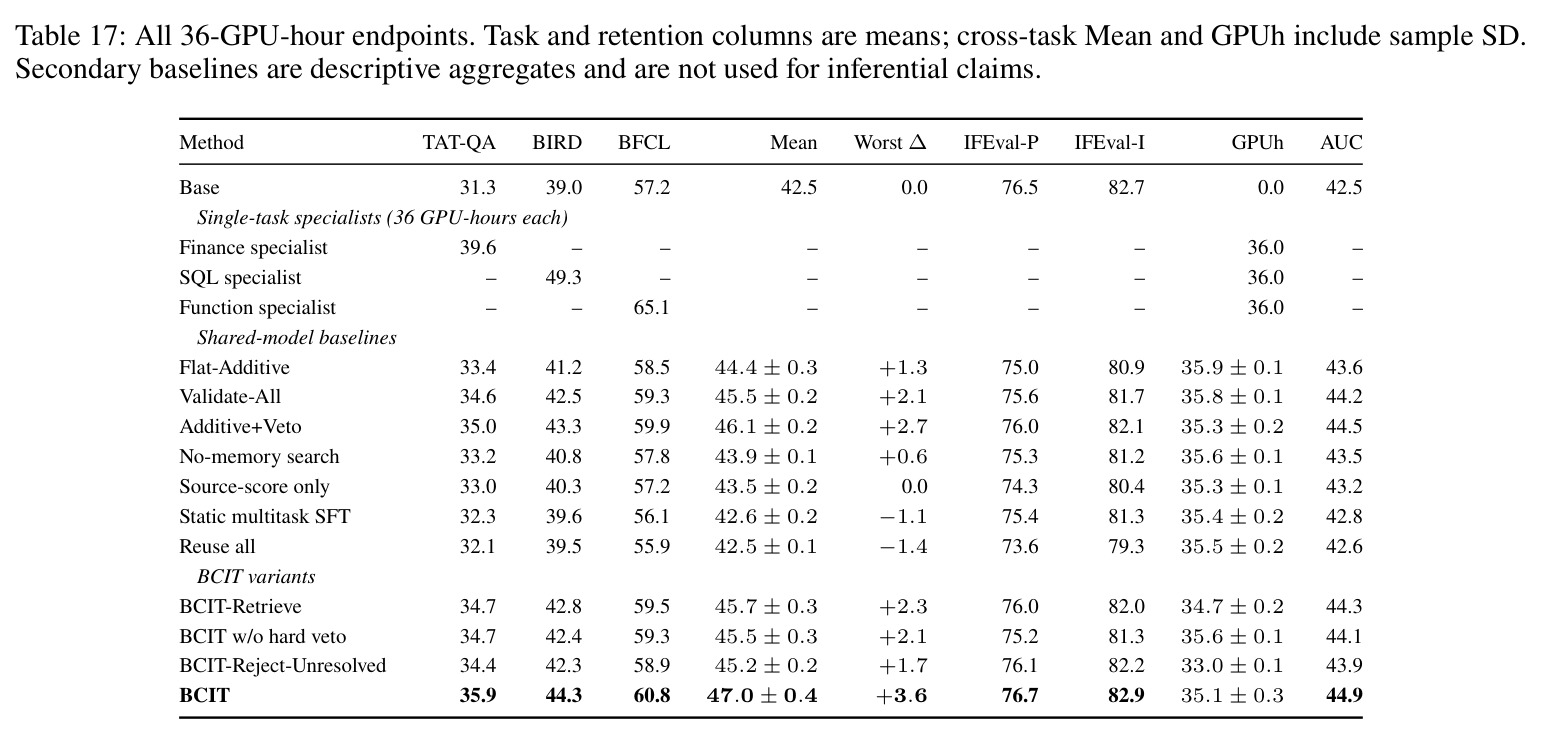
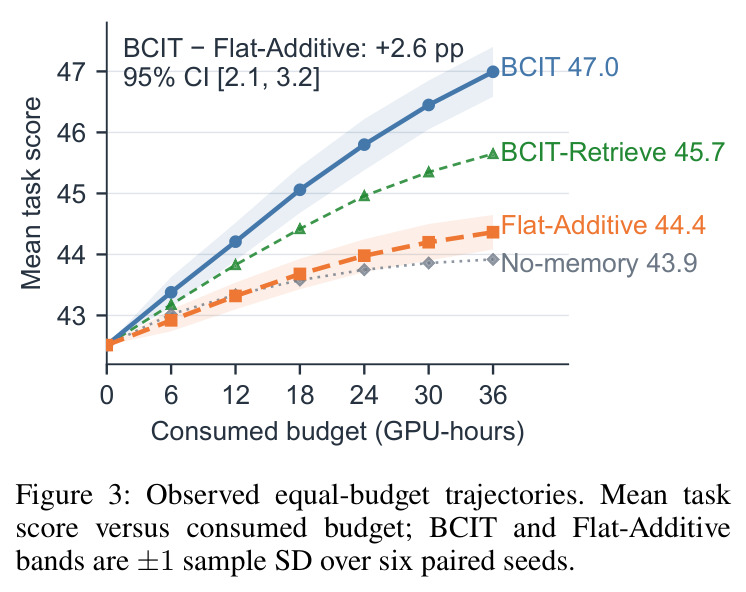
实验围绕四个递进问题展开,证据链完整。RQ1(效应异质性,Retrospective-24):24 个匹配候选-上下文对中目标效应 11 正/3 中/10 负,且 11 个目标改善者中仅 3 个同时保住两项 IFEval 指标;语义同族迁移内部同样涨跌互现(金融 5 涨 3 跌、SQL 3 涨 2 平 3 跌、函数 3 涨 1 平 4 跌)。最危险的两类更新:标准 SQL SFT 目标 +2.250 pp 但 IFEval-P/I −22.736/−18.705 pp;随机采样函数 SFT 目标 +1.351 pp 但 −11.091/−8.153 pp。RQ2(结果盲授权审计,Audit-24 含 10 有益/8 有害/6 中性):BCIT 授权 2/8 有害、9/10 有益,有害授权率 25.0% 对 Flat-Additive 的 62.5%,有益覆盖 90.0% 对 80.0%,授权中有害占比 14.3% 对 31.3%;McNemar 检验 $p = .25$,属方向性队列证据。结构归因清晰:去掉候选特定适用条件有害授权升至 75.0%,加法+否决为 37.5%,去掉 BCIT 硬否决为 50.0%——适用条件、乘法组合、硬否决三者互补。RQ3(验证保真度,ShortFull-24):20% 标称预算下短/全目标方向一致 20/24(83.3%,精确二项 95% CI [62.6%, 95.3%]),Spearman $\rho = .72$;Pass 识别有益全跑的精度 80.0%、召回 80.0%,中位成本仅为全量的 17%;预算敏感性呈单调改善(5%/10%/20% 预算对应 62.5%/75.0%/83.3% 一致率);但仍有 4 次符号反转(S04/S07/G04/G10)和 2 个假 Pass(混淆矩阵 TP/FP/FN/TN = 8/2/2/12)。RQ4(等算力 36 GPU 时 episode,6 配对种子):BCIT 终点均值 47.0±0.4 对 Flat-Additive 44.4±0.3,配对差 +2.63 pp(95% CI [2.10, 3.16],全部 6 对同号,精确符号翻转 $p = .03125$),任务级增益 TAT-QA +2.48、BIRD +3.04、BFCL +2.37;协议修正案的更强基线也被超越:对 Validate-All +1.50 [0.85, 2.14] 且平均少用 0.74 GPU 时,对 Additive+Veto +0.90 [0.27, 1.52];轨迹质量 AUC 为 44.9,优于 Flat-Additive 43.6 与 Validate-All 44.2(配对 +0.70 [0.22, 1.18]),但对 Additive+Veto 的 +0.47 区间含零,不构成优势主张。过程指标:BCIT 晋升 46/62(74.2%)对 Flat-Additive 28/63(44.4%)。组件消融(3 种子,描述性):去硬否决 −1.49 pp,Reject-Unresolved(拒一切验证路由候选)−1.76 pp。参照系:Base 均值 42.5;三个单任务专家(各花满 36 GPU 时、只评估自己任务)达 39.6/49.3/65.1,说明 BCIT 是共享模型下的最优而非绝对上限;IFEval 所有策略均守住 −2 pp 边界(BCIT 76.7/82.9)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨能力最终共享模型质量(TAT-QA+BIRD+BFCL 均值,36 GPU 时端点) | 6 配对种子 Mean(配对差 95% CI) | BCIT 47.0 ± 0.4 | Flat-Additive 44.4 ± 0.3;Validate-All 45.5 ± 0.2;Additive+Veto 46.1 ± 0.2;No-memory 43.9;Reuse-all 42.5 | +2.63 pp / +1.50 pp / +0.90 pp,全部 6 对同号(符号翻转 p=.03125);对 Validate-All 另少用 0.74 GPU 时 |
| 有害候选授权(Audit-24 结果盲审计,8 个有害单元) | HER 有害授权率 | 25.0%(2/8) | Flat-Additive 62.5%(5/8);去适用条件 75.0%;去硬否决 50.0% | −37.5 pp(McNemar p=.25,方向性) |
| 有益候选保留(Audit-24,10 个有益单元) | BCov 有益覆盖率 | 90.0%(9/10) | Flat-Additive 80.0%(8/10);Applicability-only 80.0% | +10 pp,同时授权中有害占比从 31.3% 降至 14.3% |
| 有界验证保真度(ShortFull-24,24 个候选均跑短+全) | 短/全目标方向一致率与 Pass 判别 | 83.3%(20/24),ρ=.72;Pass 对有益全跑精度 80.0%/召回 80.0%,中位成本 17% 全量 | 机制研究无对比策略;预算敏感性 5%/10% 预算对应 62.5%/75.0% | 20% 预算下比 5% 预算一致率 +20.8 pp,支持 20% 主操作点 |
| TAT-QA(金融问答,源 FinQA) | Official F1 | 35.9 | Base 31.3;Flat-Additive 33.4;Finance 专家 39.6(独占 36 GPU 时) | +4.6 vs Base,共享模型中最高 |
| BIRD(text-to-SQL,源 Spider) | Execution accuracy(400 例) | 44.3 | Base 39.0;Flat-Additive 41.2;SQL 专家 49.3(独占 36 GPU 时) | +5.3 vs Base,共享模型中最高 |
| BFCL(函数调用,源 xLAM) | Full match(444 例) | 60.8 | Base 57.2;Flat-Additive 58.5;Function 专家 65.1(独占 36 GPU 时) | +3.6 vs Base,共享模型中最高 |
| 保留约束(指令遵循) | IFEval prompt-/instruction-level 严格准确率 | 76.7 / 82.9(相对 Base 76.5/82.7 为 +0.2/+0.2) | 预指定 −2 pp 边界;Reuse-all 73.6/79.3 已逼近违规 | BCIT 同时是任务均值与 IFEval 双最高,守住全部保留边界 |
局限与改进
作者明确承认的局限:证据只覆盖一个 4B 模型、三个目标能力、一个保留基准(IFEval)和人工规定的边界;四项经验研究共享候选集、彼此互补而非独立重复;只有完整策略比较具备 6 个配对种子的推断力,组件消融仅 3 种子且为描述性;验证保真度与算力权衡可能随模型规模、数据和调度变化;学习型边界、更广领域、更长轨迹留作未来工作。此外 RQ2 的 $p = .25$ 表明有害授权率差异只是方向性队列证据,HER 的 95% 边际区间 [3.2, 65.1] 极宽。我的补充观察:其一,授权质量的置信区间宽达几十个百分点,24 单元审计远不足以支撑精确的错误率估计;其二,AUC 轨迹指标对 Additive+Veto 不显著,说明 BCIT 的优势集中在终点而非全程,早停场景收益不确定;其三,所有候选由作者团队编制(虽有候选卡 schema),「原子更新」池仅 24 个,经验库规模极小,检索、去重、冲突检测在库增大后的可扩展性完全未验证;其四,$\tau_l/.\tau_h$、20% 验证预算、$q=3$ 探索配额等超参的敏感性只部分探索(验证预算有扫描,阈值没有);其五,Inconclusive→全量的回退租约是研究设定而非由 $Q_i$ 推导,实际预算竞争下的行为未知。
独立分析的弱点
弱点一:人工边界是系统的阿喀琉斯之踵。适用条件的五字段打分、命名硬冲突词表、证据等级(A/B/C)、归一化尺度 $\kappa_i$ 全部依赖领域专家预先编写;换到新领域时,未写入词表的冲突模式(如新的输出协议不兼容)不会被 $H_i$ 捕获,系统会静默退化成 Flat-Additive 类行为。改进方向:用 LLM 提案 + 人工抽检半自动生成条件与冲突词表,并对其假阳/假阴率做校准实验。弱点二:统计功效不足。6 个配对种子的最小可达 p 值就是 .03125,任何单点波动都可能翻转结论;24 单元审计的区间宽度(HER [3.2, 65.1])使「25.0% vs 62.5%」的实际差距高度不确定。改进方向:扩大候选池与 episode 数,或改用分层/聚类稳健推断(同能力族单元相关)。弱点三:验证保真度不完美且有系统性缺口。4 次符号反转中 3 次是短跑正/全跑负(S04、S04、G04 均 Pass 但全跑有害),即假 Pass 偏向高估短跑收益;GRPO 的短跑一致性($\rho=.671$)低于 SFT($\rho=.755$),RL 更新的高方差可能是根因。改进方向:对高方差候选用多种子短跑取稳健统计,或引入学习型早期停机把 20% 固定预算变成自适应预算。弱点四:阈值与配额的任意性。$\tau_l=.30/\tau_h=.70$、折扣 1/.75/.5、$q=3$ 均无敏感性分析,跨域迁移时校准集(与评估单元不相交)从哪来也未说明。改进方向:报告阈值扫描曲线,并用在线校准(如 conformal 方法)替代固定阈值。弱点五:保留维度单一。仅 IFEval 一个约束,真实部署需要安全、幻觉率、格式合规等多维 guardrail,多维约束下共享采纳规则 $g$ 的可行域会急剧收缩,方法是否仍能保持 74.2% 的晋升率存疑。改进方向:把保留约束向量化,研究约束间的权衡前沿。
未来方向
作者提出的方向:学习型边界(用数据驱动方法替代人工规定的适用条件、冲突与折扣)、更广泛的领域与工具、更长的顺序适应轨迹、以及验证保真度和算力权衡在更大模型规模下的稳定性。基于本文成果可以延伸的方向:其一,把 BCIT 授权层接入 PostTrainBench、Agent2RL-Bench、EvoTrainer 等公开自主后训练框架做外部验证——本文的候选流是自建的,第三方环境的候选分布可能更接近对抗性;其二,经验库规模化研究:当库从 24 条增长到数千条时,需要检索排序、冲突索引与库内冲突消解,$\mathrm{Consolidate}$ 的溯源检查如何并行化也是工程问题;其三,用因果推断(倾向得分匹配、分层)替代完全匹配对照,降低每对「对照+干预」双跑的成本——目前每个匹配对都要跑两次全量训练来标定效应;其四,多父模型场景:当系统同时维护主模型与多个 LoRA 分支时,「当前上下文」的定义、$A_i$ 的计算以及晋升语义都需要重新形式化;其五,把硬冲突词表标准化为可跨团队共享的 schema(类似能力卡/模型卡),使经验库具备网络效应;其六,理论上刻画 $Q_i = S_i A_i$ 与验证保真度之间的关系——什么条件下短跑方向一致性可以给出有害授权率的上界,这将把本文的经验规则升级为有保证的授权准则。
复现评估
可复现性在同类系统论文中属于第一梯队。透明度方面:正文加附录给出了完整协议冻结清单(manifest 含基础模型、种子、记忆快照、候选清单、检索顺序、证据等级、阈值、评估器、解析器、数据角色、资源上限、停止规则与分析规范)、训练默认值(Qwen3-4B、LlamaFactory/PyTorch、bfloat16、DeepSpeed ZeRO-2、4 GPU、有效 batch 32、学习率 $6 \times 10^{-6}$、余弦调度、4096 上下文)、候选级完整账本(Table 9 的 24 个匹配效应、Table 12 的 24 条短/全记录)、种子级端点(Table 14/15/16/17 覆盖全部策略与种子)以及统计检验的精确定义(精确符号翻转枚举 $2^6 = 64$、McNemar 不和谐表、配对 t 区间),并提到附有 CSV。数据方面:FinQA、Spider、xLAM、TAT-QA、BIRD、BFCL、IFEval 全部公开,训练/验证/采纳/终评按角色切分即使同源也不重叠。主要障碍:论文未提及开源代码(截至该版本),候选卡、经验库 schema、验证编译器与审计脚本需按论文描述自行实现,这部分工程量不小且是实现正确性的关键;算力方面,复现一组主对比(BCIT vs Flat-Additive,6 配对种子,每 episode ≤36 GPU 时)约需 430+ GPU 时,加上 Validate-All、Additive+Veto、消融与专家基线,完整复现约需 1500–2000 GPU 时,4×A100 级团队需数周;而只复现 RQ1/RQ2/RQ3 这类诊断与审计(仅需已记录结局与冻结决策)则几乎零算力成本,适合先验证记分与决策逻辑再投入训练。
论文图表
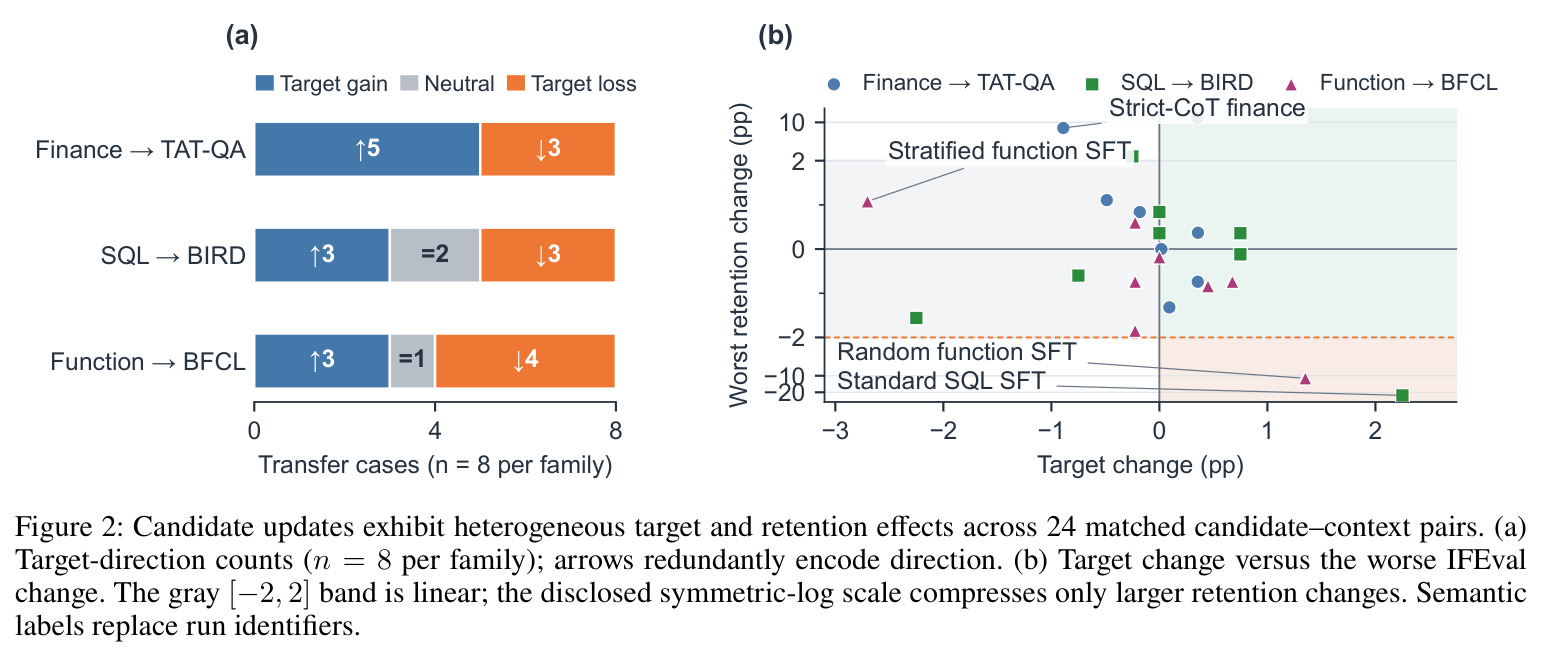
(a) 三个迁移族(金融→TAT-QA、SQL→BIRD、函数→BFCL)各 8 个匹配对的目标方向计数:金融 5 涨 3 跌、SQL 3 涨 2 平 3 跌、函数 3 涨 1 平 4 跌。(b) 每个候选的目标变化(横轴)对更差一侧 IFEval 变化(纵轴,对称 log 轴)的散点,灰色 [−2, 2] 带标记保留边界;标准 SQL SFT 和随机函数 SFT 等危险更新位于「目标微涨、保留暴跌」的左上区域。
这是问题存在的直接可视化证据:语义同族迁移内部效应剧烈异质,且目标提升与保留安全高度冲突——正是这张图说明了为什么「复用历史成功」必须先做条件校验。