EVOKE:激发智能体中的世界知识以实现可迁移决策 EVOKE: Eliciting World Knowledge in Agents for Transferable Decision-Making
固定状态换目标重排动作偏好,激发预训练世界知识,实现未见环境的可迁移决策
前置知识
世界模型(World Model)
强化学习中对环境动力学的内部建模:给定状态 $s$ 和动作 $a$,预测环境会转移到什么状态、产生什么观察。基于模型的算法用它做'想象-然后-规划'。对 LLM 智能体,现有方法(IWM、PaW、EnvRL、ITP、MemWM 等)通过额外的下一状态预测目标或独立的预测模型来获得它。
本文反对的正是这条路线:它主张数字环境中的动作后果知识已在预训练中内化,问题应从'获取'变为'激发'。理解世界模型范式,才能看懂论文对比的基线群体与立场转变。
单目标监督与情境习惯
指后训练时每个交互状态只与一个固定任务目标配对(SFT 逐步模仿,或单目标 RL 的任务奖励)。此时策略无需理解动作后果,只需记住'这类情境下通常接什么动作'(情境习惯)即可拟合训练信号;习惯在训练分布内有效,换到新环境立即失效。
这是论文诊断出的病根:单目标监督对'激发预训练知识'几乎没有压力。EVOKE 的全部设计都是为了补上这个缺失的压力维度。
目标条件策略
策略形式为 $\pi(a|g,s,h)$:同一状态在不同目标 $g$ 下输出不同动作。相关谱系包括 UVFA(跨目标泛化的价值函数)、successor features(分离环境动力学与任务奖励以利迁移)、HER 与 Hindsight SL(用已达成目标给轨迹重新标注)。
EVOKE 属于目标条件学习,但把监督压到单个决策层面——'同一状态、多目标、偏好翻转',必须与轨迹级重标注一脉区分开。
对比排序损失(listwise + pairwise)
不学单点标签而学相对顺序:listwise 项 $\mathcal{L}_{set}$ 用 softmax 把概率质量整体抬升到正例集合 $P$;pairwise 项 $\mathcal{L}_{pair}$ 要求每个正例得分高于每个竞争者,即 $\log\sigma(r_p-r_n)$。配合硬负例(模型自己偏爱但被判定错误的样本)效果最强。
这是 EVOKE 的训练目标本身;消融显示同样的数据、只把排序换成模仿(SFT),未见环境成功率就差 7.5 个点,说明损失设计是收益来源之一。
DAgger 数据集聚合
模仿学习算法(Ross et al., 2011):用当前策略 rollout 采集它实际会到达的状态并请专家标注,逐轮聚合所有数据训练,使训练分布逼近策略自身分布,缓解复合误差。
EVOKE 的多轮循环(采集→目标干预→动作评估→聚合重训)直接沿用该机制,保证硬负例始终对齐当前策略正在犯的错误。
线性探针(Linear Probe)
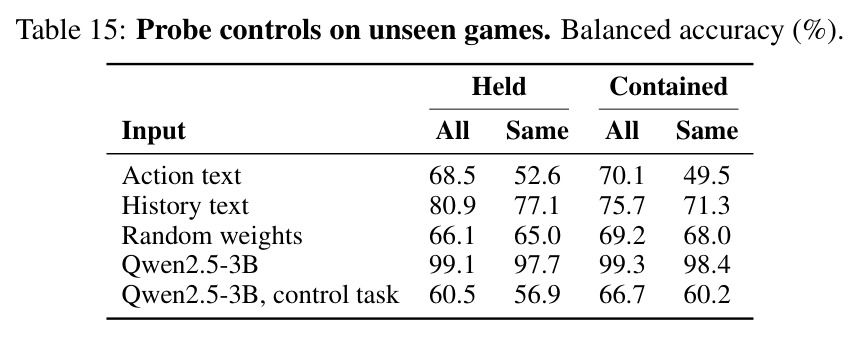
冻结模型,仅在某层隐藏状态上训练一个线性分类器去预测某属性。若线性可分,说明该信息已编码在表示中;配合控制任务(随机标签)与随机权重基线,可排除'探针记忆'与'表面文本线索'两种假象。
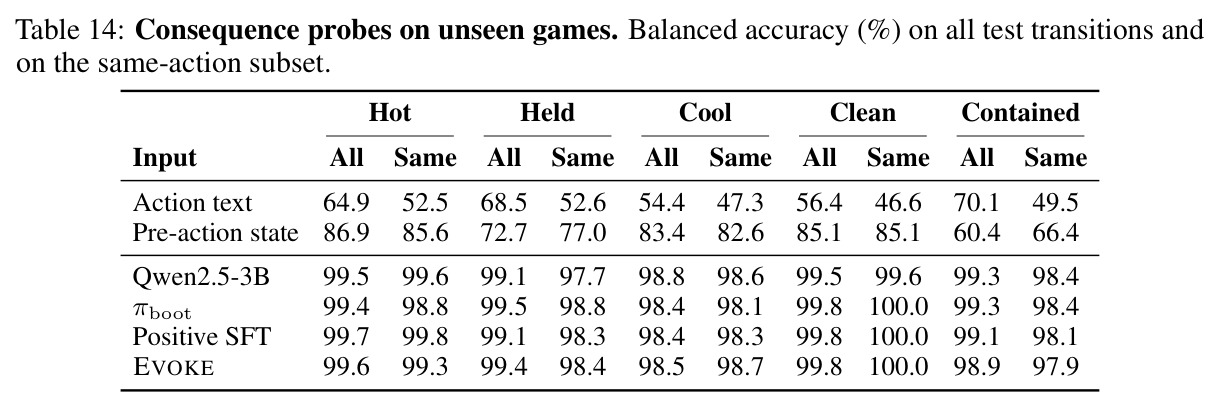
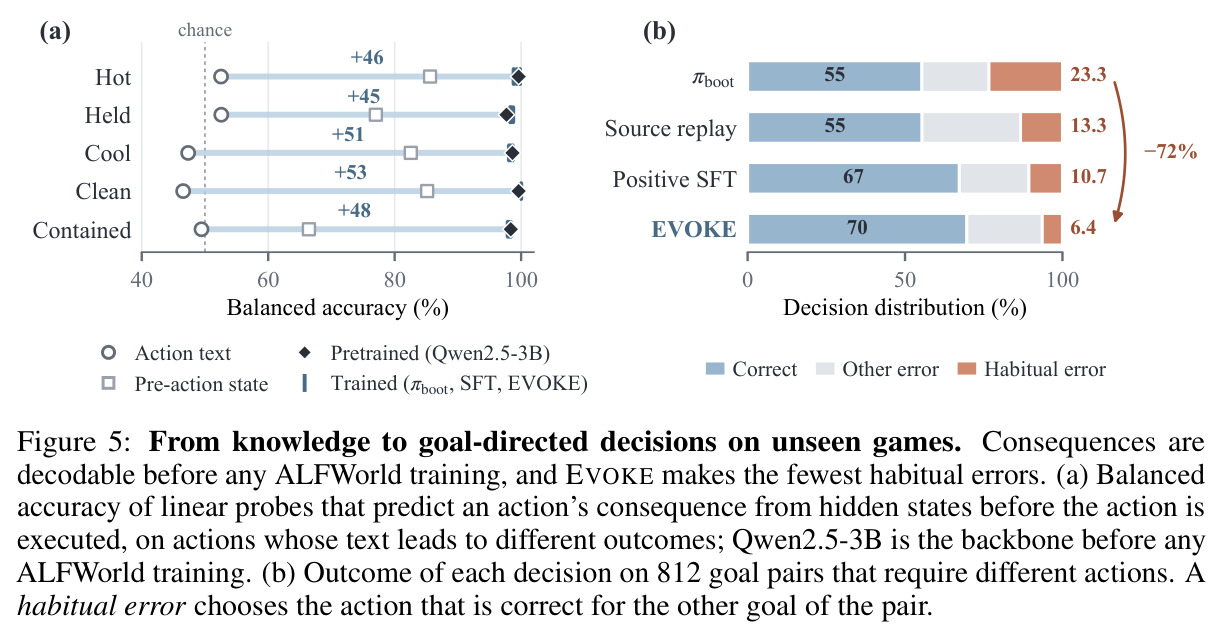
第 5 节用它证明动作后果在未做任何 ALFWorld 训练的原版 Qwen2.5-3B 表示中已约 99% 可解码——这是'知识本来就在'这一核心论点的直接证据。
研究动机
经过后训练的 LLM 智能体在多步交互任务上表现出色,但迁移到未见环境时性能大幅下降,学到的策略绑定于训练时见过的任务与环境。现有补救思路是世界模型方法:训练智能体先预测动作的未来观察再决策(如 IWM、PaW、EnvRL、ITP),但这条路线有两大代价:其一,附加的预测目标使训练更昂贵,且大量被要求预测的内容与当前决策无关(Grimm et al., 2020 的价值等价问题);其二,当预测的未来被用于规划时,误差会随步数复合放大。更根本的是,LLM 智能体主要在网站、搜索引擎等数字环境中行动,动作后果大多落在预训练习得的世界知识范围内——'下单即结束购买'在任何购物网站都成立;From Word to World(Li et al., 2026a)也证实预训练 LLM 仅凭少量示例就能较好预测文本环境的状态转移。真正的问题出在典型的单目标后训练上:一个访问状态总与某个固定训练目标配对,策略只需记住'这个情境下习惯性的下一步'就能拟合监督信号(如在结账页就学会总是下单),这类表浅习惯在训练分布内有效,换环境即崩溃。
本文的目标是本文的目标是把问题的提法从'获取世界知识'改为'激发世界知识':既然 LLM 在预训练中已经内化了动作后果知识,后训练就不应再附加预测目标去重新学习,而应构造一种训练压力,迫使策略在决策时真正调用这些已有知识。具体目标有三:一是让动作偏好依赖于目标——固定状态与交互历史、换一个目标时,同一组候选动作的排序必须翻转,使任何依赖情境习惯或单目标关联的策略都无法排序正确;二是在不增加预测损失、不引入独立世界模型模块、不增加推理时规划的前提下,同时提升任务成功率、未见环境泛化能力和数据效率;三用受控实验把收益归因到具体机制,验证'预训练表示本已编码动作后果,EVOKE 只是把表示转化为目标导向决策'这条因果链。
与已有工作不同的是,独特切入角度来自一条理论结果:Richens et al. (2025) 证明,在足够丰富的多步目标集合上都胜任的智能体,必然包含一个可从其目标条件行为中恢复的世界模型。这提示不必显式监督预测——只要在'固定状态、变换目标'的维度上施加决策监督,世界知识就会被逼出来。与既有工作的差别清晰可辨:世界模型方法(WALL-E、ITP、MemWM、IWM、PaW、EnvRL 等)都在预测维度上增加目标或训练独立模型;策略优化与蒸馏方法(GRPO、ETO、OPSD、SDAR、Skill-SD 等)训练信号的计算方式各异,但每个状态都只在原始目标下被监督,策略可以靠习惯拟合;跨目标学习线(UVFA、successor features、HER、Hindsight SL)在轨迹层面重标注目标,而 EVOKE 把目标多样性压缩到单个决策层面:同一状态、同一历史、同一候选动作集,在不同目标下评估并训练排序偏好,且标签来自真实执行的环境响应而非任何模型的预测。
核心方法
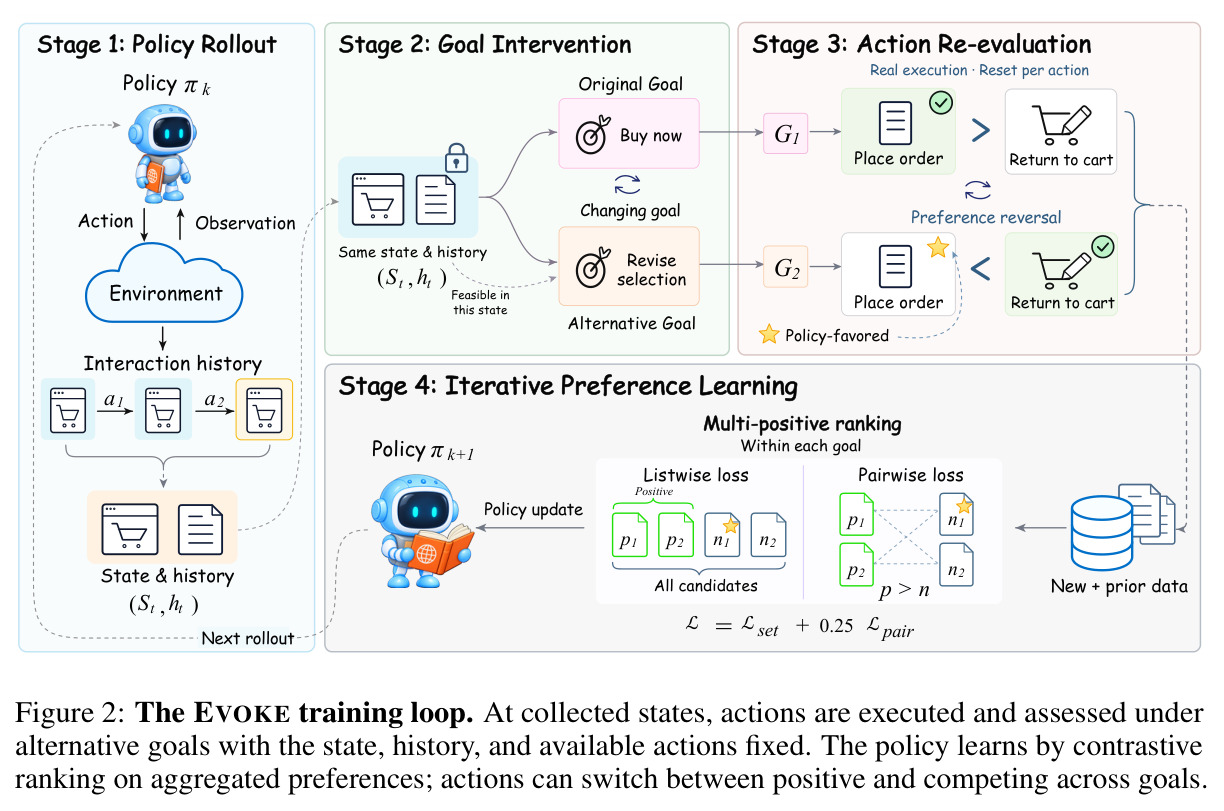
先看直觉:智能体停在结账页,状态、历史与可选动作完全相同;目标'立即购买'时正确动作是下单,目标'修改选购'时正确动作是返回购物车。若策略只靠情境习惯(见到结账页就下单),它在第二个目标下必然排错——排序正确的唯一途径是把'每个动作会做什么'(跨目标不变)与'当前目标需要什么'关联起来,而这正是预训练世界知识。技术路线上,EVOKE 训练策略 $\pi_\theta$ 从输入 $x_g=(g,h,\mathcal{A}(s))$(目标 $g$、可见交互历史 $h$、当前状态可用动作集 $\mathcal{A}(s)$)中选择下一动作文本,重复一个 DAgger 式四阶段循环:从策略自身 rollout 采集决策状态;在每个状态上保持状态、历史与候选集不动、注入替代目标(goal intervention);在环境中真实执行各候选动作、由 LLM 标注者依据观测结果打正/负标签;用 listwise + pairwise 对比排序损失训练,负例优先选策略自己偏爱但错误的动作。部署时就是一个标准策略:无世界模型模块、无推理时规划、无标注者。
核心创新是'固定状态下的目标干预'作为监督信号来源,其形式化基础是式 (1):$T_g(s'|s,a)=T(s'|s,a)$,$J_g(s,h,a)=\sum_{s'} T(s'|s,a)\,u_g(h,s,a,s')$——动作的转移动力学 $T$ 对所有目标共享,随目标变化的只是效用 $u_g$,即'动作做什么'与'动作值多少'被显式分离。当同一组候选动作在不同目标下的偏好集合不同(偏好翻转)时,任何从上下文到动作的固定映射都无法在所有目标下排序正确,排序压力于是逼着策略调用共享的动作后果知识。与已有方法的本质区别有三:其一,世界模型方法把后果知识当作额外预测目标去'获取',EVOKE 把它当作预训练已有资产去'激发'——不加预测损失、无独立模型、无部署开销;其二,单目标 SFT/RL 中每个状态只被一个目标标注,策略可用习惯拟合,EVOKE 用目标多样性补上这一缺失的压力维度;其三,负例不是随机动作,而是策略自己偏爱但被判定更差的动作(policy-favored hard negatives),直接打击策略最可能犯的习惯性错误。
方法步骤详情
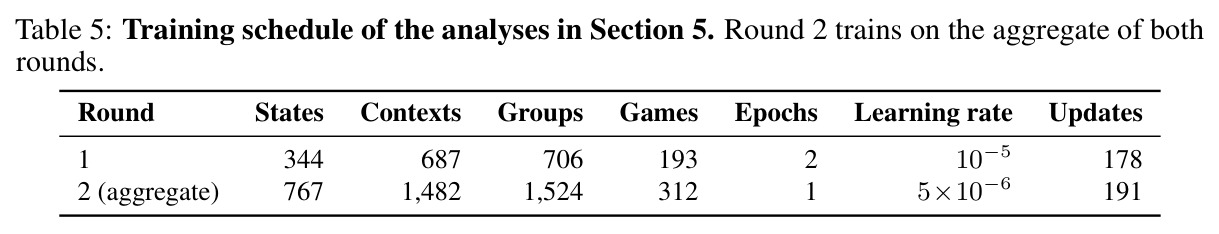
完整流程七步。(1) 初始化:用成功演示拆成的逐步输入-动作对做 SFT 得 $\pi_{boot}$(2,700 局训练游戏、16,247 条逐步样本,LoRA rank 16、缩放 16,学习率 $2\times10^{-4}$,1 个 epoch)。(2) 决策状态采集:$\pi_{boot}$ 在训练游戏中交互,逐步记录目标与可见历史使状态可重访;既采样取得进展的步骤,也采样绕路、重复动作、走向失败的步骤(第 1 轮 344 个状态/193 局,聚合后 767 个状态/312 局)。(3) 目标干预:Qwen2.5-72B-Instruct 标注者对每个状态提议替代目标,在环境中连同成功条件一起实例化,保留与场景兼容、尚未满足、可从当前状态达成的目标;原始任务文本从可见历史中移除,确保策略只能靠目标区分情境。(4) 落地动作评估:候选取自共享动作集 $\mathcal{A}(s)$,每个候选从同一状态真实执行一次(单步看不出效果时加短续交互),标注者根据目标、执行前历史与观测结果,把推进目标的动作标为正例 $P$、更差者归入竞争者 $N$、证据不足者弃用。(5) 硬负例填充:优先放策略的贪心动作(当它不是正例时),再放策略高概率的非正例动作,最后放其他类型动作补覆盖;每组至多 4 正例 + 4 竞争者(最终数据中每组织均 1.6 个正例、固定 4 个竞争者)。(6) 对比排序:动作得分取完成文本的平均 token 对数概率 $z_\theta(a|x_g)=\frac{1}{|c(a)|}\sum_{t}\log\pi_\theta(c_t(a)|x_g,c_{<t}(a))$,$r_a=z_\theta/\tau$;损失 $\mathcal{L}=\mathcal{L}_{set}+\lambda\mathcal{L}_{pair}$,其中 $\mathcal{L}_{set}=-\log\frac{\sum_{p\in P}e^{r_p}}{\sum_{a\in P\cup N}e^{r_a}}$,$\mathcal{L}_{pair}=-\frac{1}{|P||N|}\sum_{p\in P}\sum_{n\in N}\log\sigma(r_p-r_n)$,$\tau=1$、$\lambda=0.25$。(7) 迭代聚合:新策略会到达新状态、暴露新错误,下一轮用当前策略重跑全流程,并在全部轮次数据上训练(第 2 轮 lr $5\times10^{-6}$,两轮共 178+191 次更新,backbone 全程冻结、LoRA 续训)。
技术新颖性
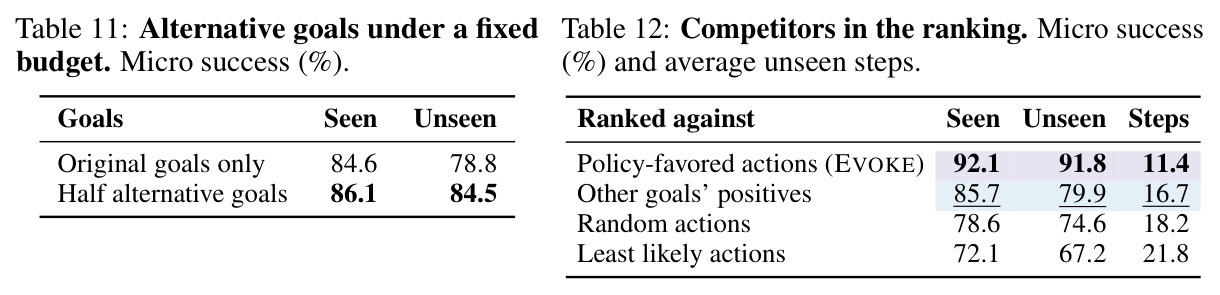
技术新颖性可从四个层面分析。(1) 问题重定义:把'LLM 智能体如何获得世界模型'重定义为'如何激发已内化的世界知识',这一转变基于数字环境动作后果落在预训练分布内的经验证据,从而绕开预测式世界模型的训练开销与规划误差复合两大痛点。(2) 监督信号设计:目标干预本质上是对单个决策做'反事实对照实验'——固定干预变量以外的所有因素,只动目标,观察偏好应如何翻转;这与 HER/Hindsight SL 的轨迹重标注不同(它们为已达成目标构造新演示,不要求同一状态下不同目标的偏好相互对立),也与 GRPO 类方法依赖固定目标下的任务奖励不同。(3) 损失设计:多正例 listwise + pairwise 排序允许一个情境有多个正确动作,并显式压低策略自身的高概率错误,弥补 SFT 只抬升正例、不压制错误习惯的缺陷;消融(Table 12)证实竞争者必须是策略偏爱的动作才有最大收益。(4) 标签落地:标注者只判断'已执行的结果'而非预测结果,保证标签反映环境真实响应,避免 LLM 预测偏差进入训练信号;标注者仅在数据构建时使用,部署时不增加任何成本。
实验结果
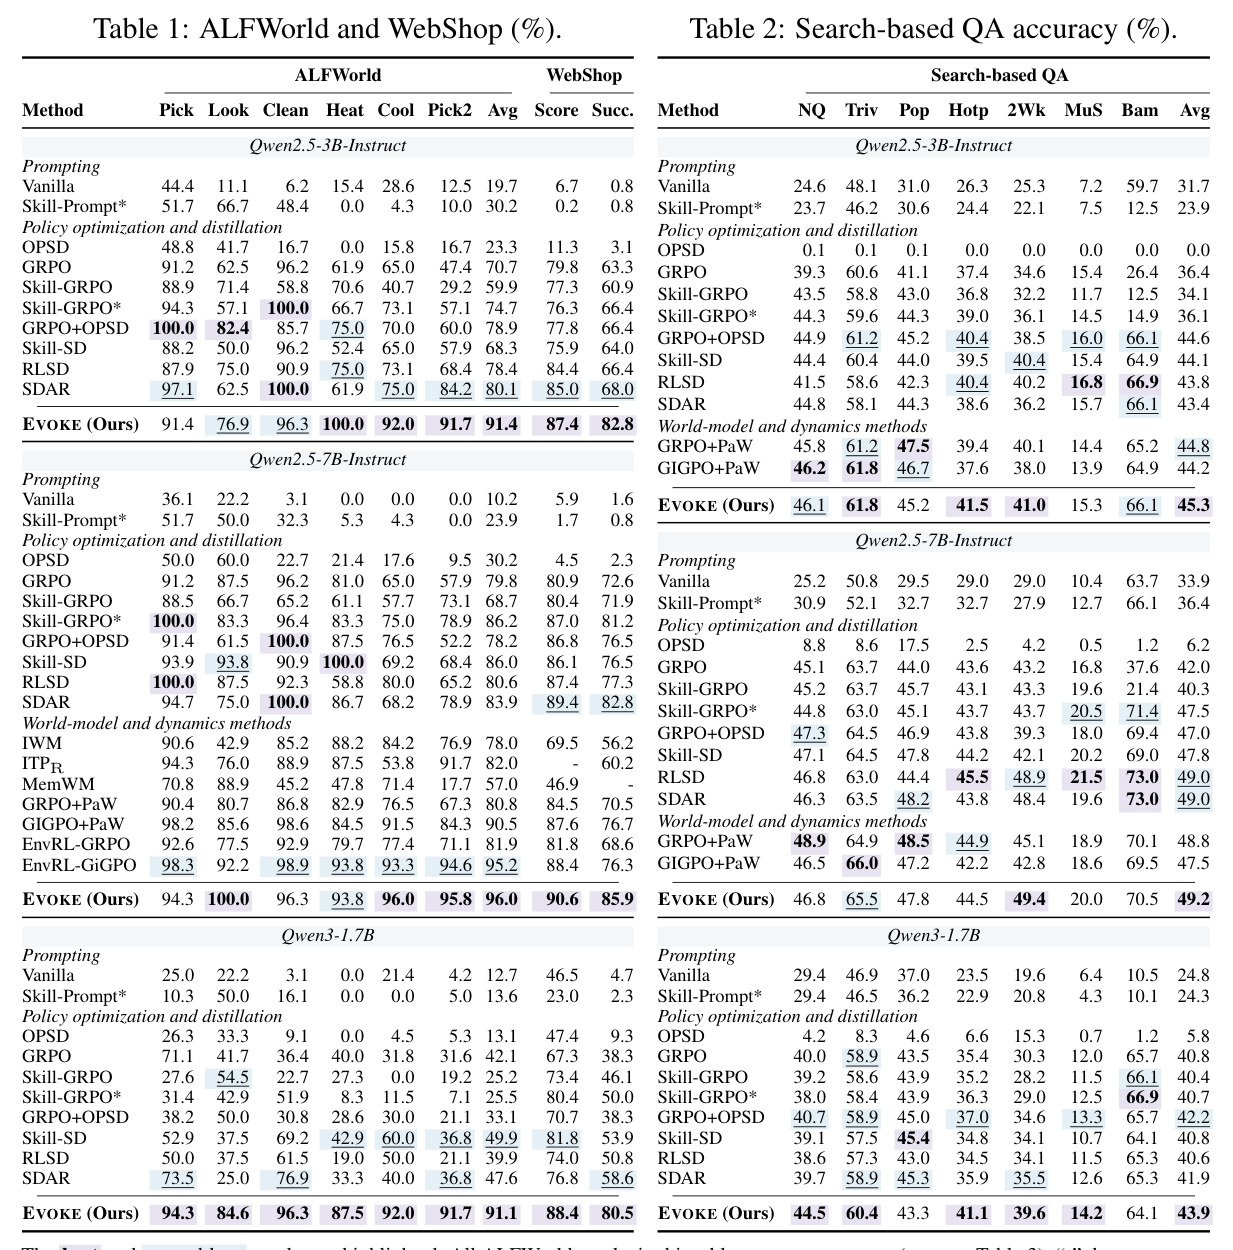
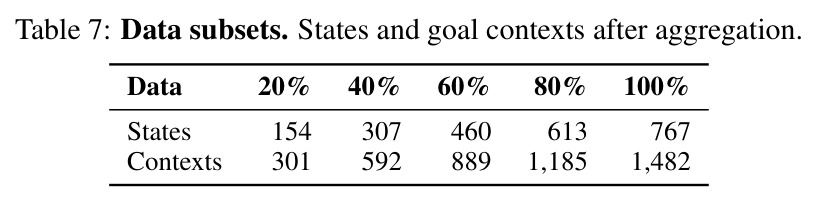
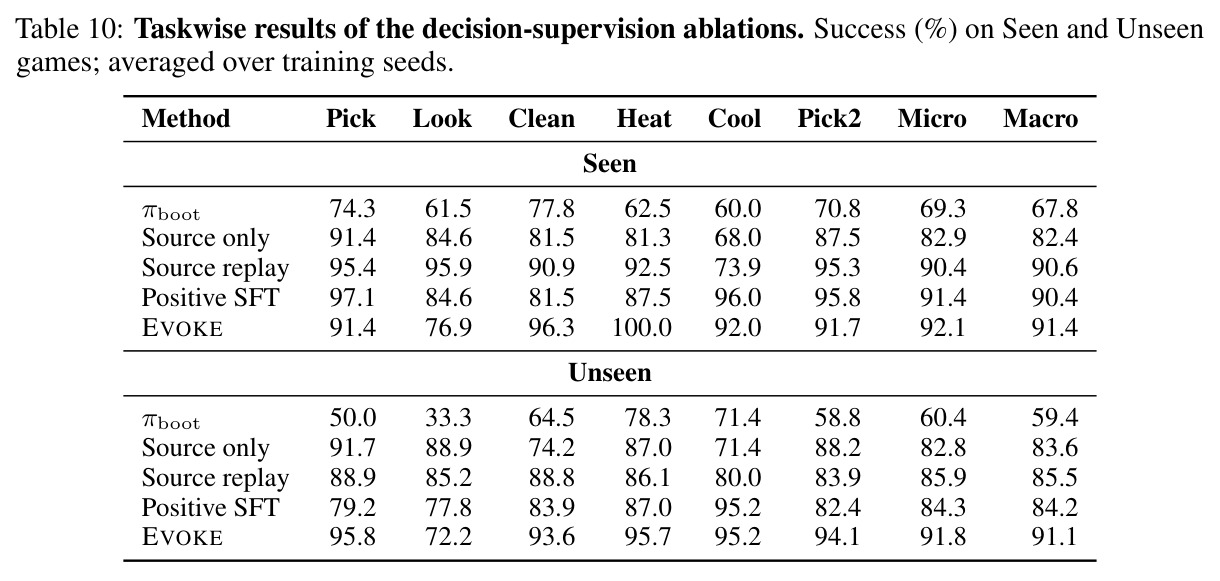
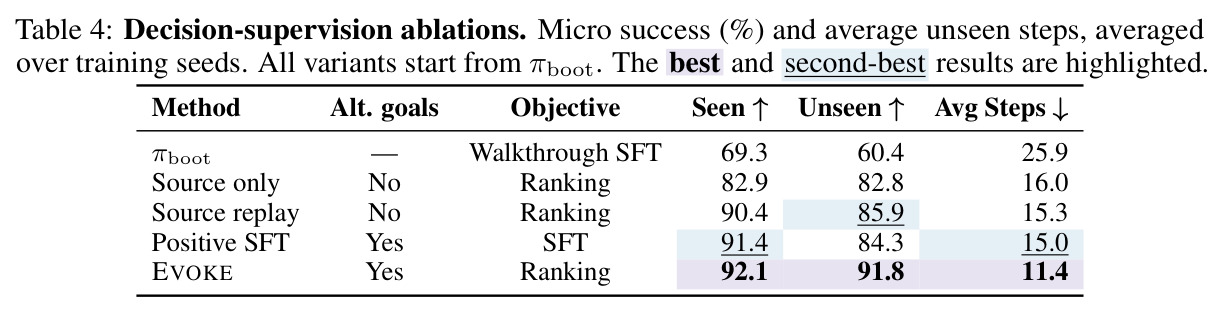
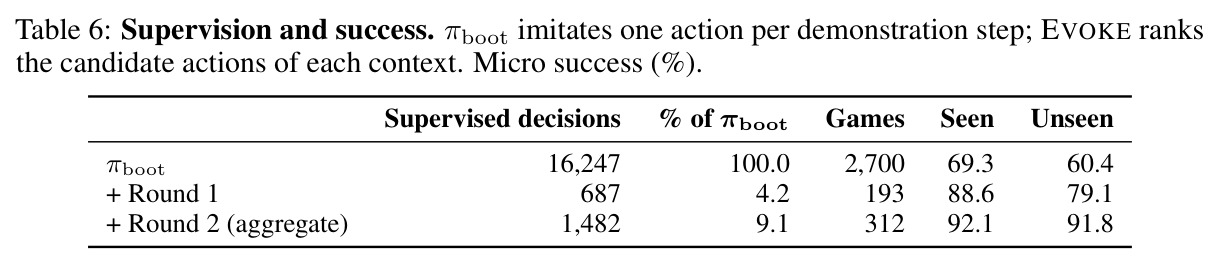
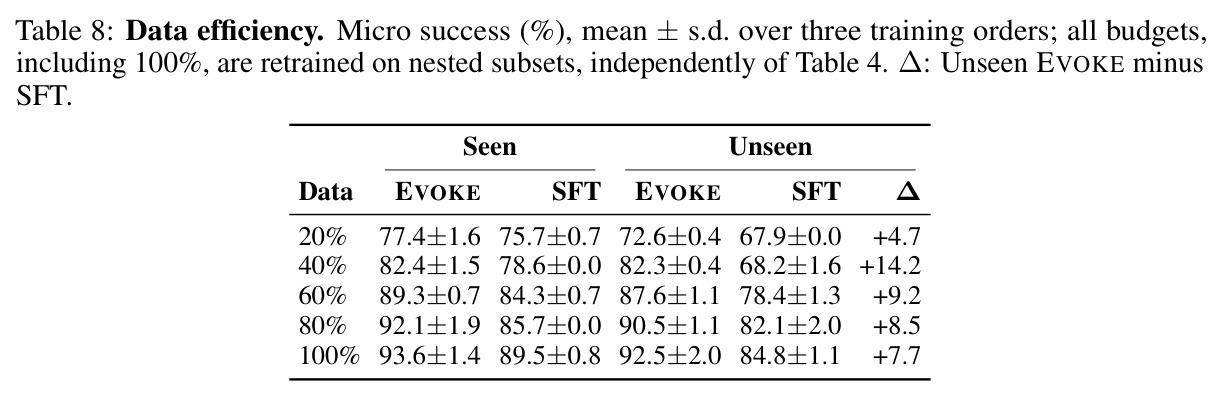
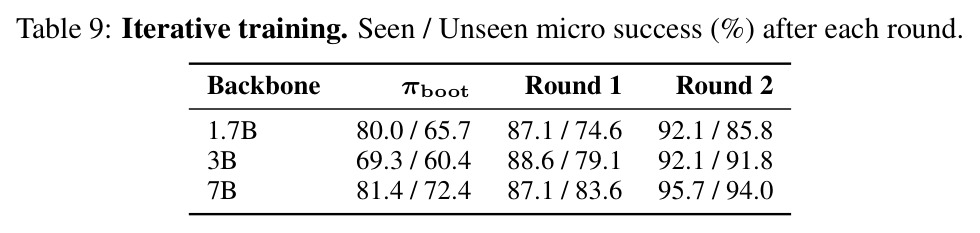
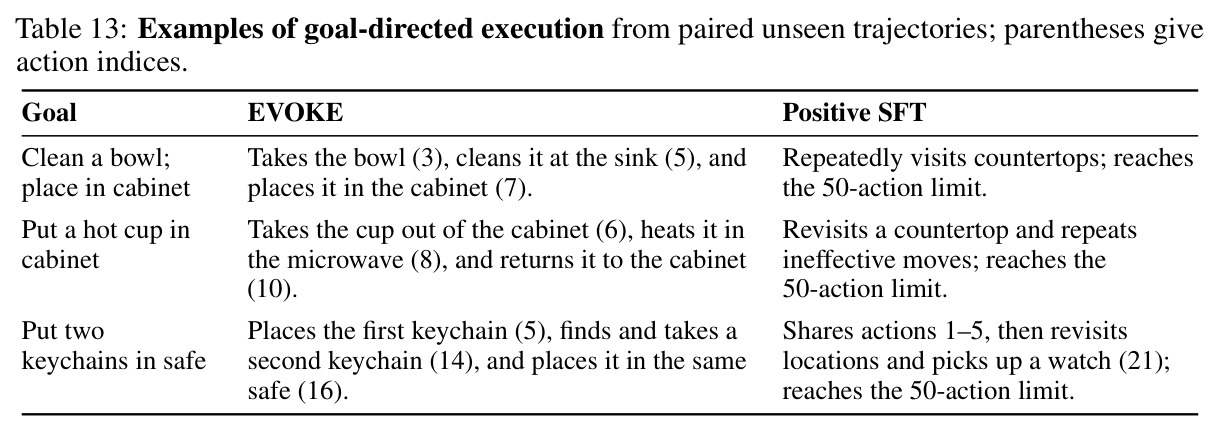
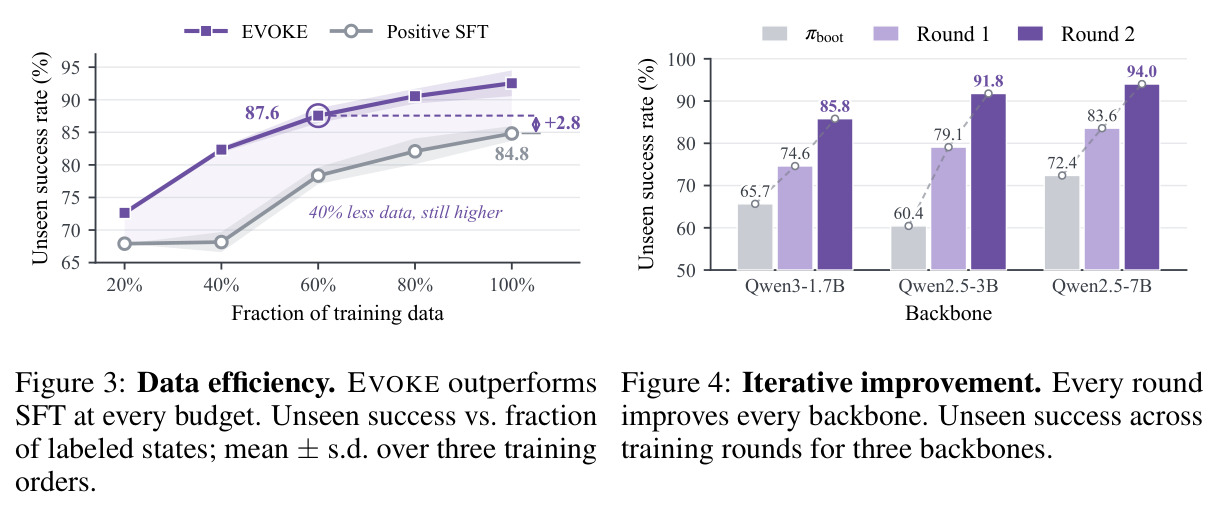
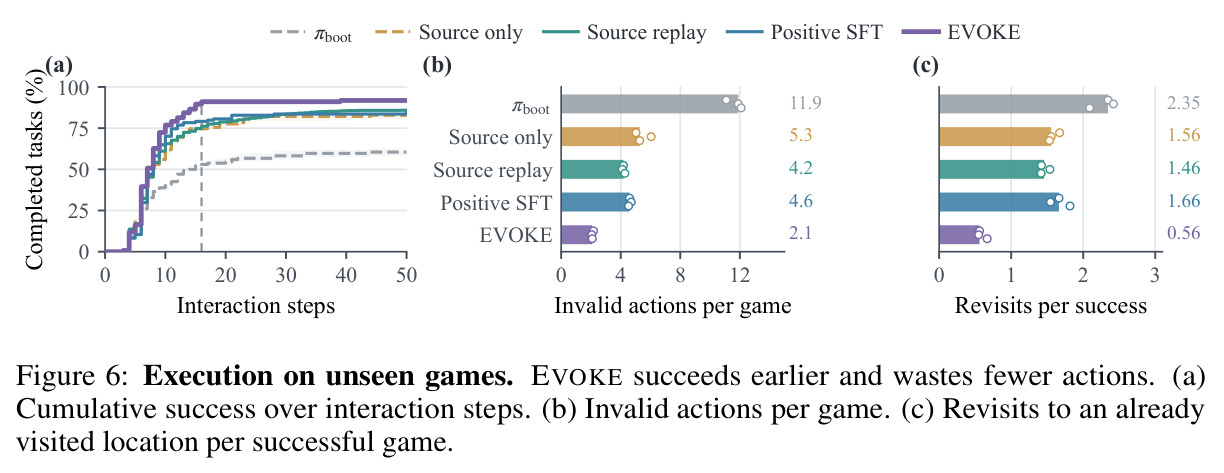
主结果(Tables 1-3):EVOKE 在全部三个 backbone、全部基准上取得最佳平均成绩。ALFWorld Seen 平均成功率:Qwen2.5-3B 达 91.4%(最佳基线 SDAR 80.1%、GRPO+OPSD 78.9%);7B 达 96.0%,超过所有世界模型与动力学方法(EnvRL-GiGPO 95.2%、GIGPO+PaW 90.5%);最小的 Qwen3-1.7B 上优势最大:91.1% vs SDAR 47.6%。WebShop 上 7B 得分 90.6/成功率 85.9%(SDAR 89.4/82.8%),3B 成功率 82.8% vs SDAR 68.0%。搜索式 QA 基线差距较小(每题仅少数检索决策),EVOKE 仍全面领先:7B 49.2% vs RLSD/SDAR 49.0%,3B 45.3% vs GRPO+PaW 44.8%,1.7B 43.9% vs GRPO 40.8%。未见环境 ALFWorld 泛化优势显著:3B 91.1% vs PCSD 85.9%,7B 93.1% vs AHEAD 83.8%,1.7B 84.6% vs GRSD 84.0%。消融(Table 4,3B):去掉替代目标(Source only)未见成功率从 91.8% 跌至 82.8%、每局动作多 40.7%;把原目标数据重复到相同更新量(Source replay)也只到 85.9%;相同干预数据改用模仿(Positive SFT)在 seen 上几乎持平(91.4)但 unseen 落后 7.5 点(84.3),证明收益来自'目标干预 × 排序目标函数'而非单纯更多数据。数据效率(Fig 3/Table 8):20%-100% 嵌套子集共 15 组配对实验 EVOKE 全胜,60% 数据(87.6%)已超 SFT 全量(84.8%),40% 数据时差距最大(+14.2)。迭代(Fig 4/Table 9):两轮 DAgger 式聚合使三个 backbone 未见成功率提升 20.1-31.3 点(3B:60.4→79.1→91.8),总监督决策量仅为 $\pi_{boot}$ 演示步数的约 9.1%(1,482/16,247)。知识探针(Fig 5a/Tables 14-15):五项动作后果(held/contained/hot/clean/cool)在未做任何 ALFWorld 训练的原版 Qwen2.5-3B 表示中即 98.8-99.5% 可解码,在'同一动作文本对应不同结果'的难子集上仍 >97%,而动作文本基线接近随机(46.6-52.6%)、随机权重架构仅 65.0-68.0%;但 $\pi_{boot}$ 未见成功率仅 60.4%——知识在而未用。目标对测试(Fig 5b):812 个'同状态不同目标、正例集不相交'的目标对上,随机选择仅 0.3% 正确,$\pi_{boot}$ 联合准确率仅 19.5% 且决策级错误过半是习惯性错误(23.3%);EVOKE 联合准确率提升 27.3 点(95% CI [23.6,31.2]),习惯性错误降至 6.4%,比 Positive SFT 低 4.3 点(CI [3.0,5.6])。执行质量(Fig 6):EVOKE 在 20 步内解出 91.0% 未见游戏(其他变体至多 80.6%),每局动作少 24.4-28.9%,无效动作 2.1 次/局(Positive SFT 4.6),重访 0.56 次/成功局(其他变体 1.46-1.66),且在五者共同解出的 70 局上动作数仍最少——是决策更优而非更多试错。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld 家务任务 Seen(Qwen2.5-3B) | 六类任务平均成功率 (%) | 91.4 | SDAR 80.1 / GRPO+OPSD 78.9 | +11.3(对比最佳基线) |
| ALFWorld Seen(Qwen2.5-7B) | 平均成功率 (%) | 96.0 | EnvRL-GiGPO 95.2 / Skill-GRPO* 86.2 | +0.8(超所有世界模型方法;对比非世界模型基线 +9.8) |
| ALFWorld Seen(Qwen3-1.7B) | 平均成功率 (%) | 91.1 | SDAR 47.6 / GRPO 42.1 | +43.5(小模型上收益最大) |
| WebShop(Qwen2.5-7B) | 任务得分 / 成功率 (%) | 90.6 / 85.9 | SDAR 89.4 / 82.8 | +1.2 / +3.1 |
| 搜索式 QA 七数据集平均(Qwen2.5-7B) | 答案准确率 (%) | 49.2 | RLSD 49.0 / SDAR 49.0 | +0.2(决策步数少的任务收益收窄) |
| ALFWorld Unseen(Qwen2.5-3B) | 未见游戏成功率 (%) | 91.1 | PCSD 85.9 / AHEAD 82.6 | +5.2 |
| ALFWorld Unseen(Qwen2.5-7B) | 未见游戏成功率 (%) | 93.1 | AHEAD 83.8 / EnvRL-GiGPO 81.8 | +9.3 |
| 消融:排序 vs 模仿(同干预数据,3B Unseen) | 未见成功率 (%) | 91.8(EVOKE) | Positive SFT 84.3 / Source replay 85.9 | +7.5 / +5.9,且每局步数少 24.4% / 25.5% |
| 数据效率(40% 标注状态,3B Unseen) | 未见成功率 (%) | 82.3±0.4 | SFT 68.2±1.6 | +14.2(最大差距点);60% 数据 87.6 已超 SFT 全量 84.8 |
| 目标对联合决策(812 对,3B) | 双目标同时选对率 (%) | 约 46.8(19.5+27.3) | πboot 19.5(随机 0.3) | +27.3(95% CI [23.6,31.2]),习惯性错误 23.3%→6.4% |
| 硬负例设计消融(3B Unseen) | 未见成功率 (%) | 91.8(策略偏爱负例) | 随机动作 74.6 / 最不可能动作 67.2 | +17.2 / +24.6 |
| 固定预算下目标干预(600 状态,3B Unseen) | 未见成功率 (%) | 84.5(半数上下文用替代目标) | 仅原始目标 78.8 | +5.7,配对种子 95% CI [1.3, 9.5] |
局限与改进
作者承认的局限:搜索式 QA 上收益幅度小(7B 仅 +0.2),因为每题只有少量检索决策、各基线本就接近;数据构建依赖 LLM 标注者(Qwen2.5-72B)与真实执行,有可观成本。我自己的观察:(1) 每个候选动作都要在环境中真实执行一次并在动作之间重置状态(Fig 2 的 Reset per action),这要求环境支持低成本重置——在真实网站、操作系统或机器人上不现实,方法目前实质上绑定于模拟器类环境;(2) 替代目标必须'可从当前状态达成且尚未满足',由另一个 LLM 提议,其覆盖面与正确性成为方法天花板,论文未量化标注噪声率;(3) 探针与目标对等诊断实验只在 ALFWorld 上进行,'知识本来就在'的结论对 WebShop/QA 只是间接推断;(4) 评测设定为给定动作集 $\mathcal{A}(s)$、贪心解码、50 步上限、不做合法性屏蔽或输出修复,与其他论文已发表数字的可比性依赖严格同协议复跑;(5) 整个范式的前提是后果知识已被预训练内化——一旦环境动力学超出预训练分布(专有企业系统、物理世界),'激发'失效,仍需预测或交互学习,论文对这一边界只有一句带过。
独立分析的弱点
独立弱点分析:(1) 标注者瓶颈——替代目标提议与正负例判定都压在 Qwen2.5-72B 上;若标注者对某领域后果的把握弱于策略本身(如专业软件操作),标签会反向拖累训练。改进方向:用环境自带的成功条件做自动校验替代部分 LLM 判定,或引入多标注者一致性过滤与置信加权。(2) 执行开销与状态重置——每个状态的多目标 × 多候选意味着大量真实 rollout 与重置;改进方向是学一个轻量代理动力学仅用于生成标签(不进部署、不背预测误差复合的锅),或复用已执行转移做 off-policy 评估。(3) 目标空间覆盖不足——只采样'可达成且未满足'的目标可能错过最能区分好坏策略的边界目标;可引入课程式目标生成,优先选择当前策略排序与真实效用差距最大的目标。(4) 梯度冲突风险——同一状态下不同目标的偏好翻转信号相互冲突,作者靠组内计算损失与聚合训练缓解,但目标数与数据规模增大时冲突如何演化未研究;可按状态-目标对分组适配器或做梯度投影。(5) 缺少探索——EVOKE 是纯决策监督,没有奖励驱动的探索,性能上限受标注覆盖约束;与 RL 的组合(先排序预训练、后任务奖励微调)是自然补全。(6) 对'知识已内化'前提无检测机制——实际应用中应先跑探针诊断知识是否在,再决定用激发还是预测路线。
未来方向
作者提出的方向:把'通过决策监督激发世界知识'确立为与预测式世界模型互补的实用路线;理论侧,Richens et al. (2025) 的丰富性条件提示可以研究'多大的目标多样性才足以恢复世界模型'、目标集合结构如何影响世界模型的可辨识性。基于本文成果可延伸的方向:(1) 目标干预 + RL 的混合训练:用 EVOKE 建立目标条件偏好先验,再用 GRPO 在任务奖励上微调,可能兼得泛化与任务特异性能;(2) 迁移到 GUI/计算机使用智能体(真实网页、桌面 UI),关键挑战是无重置环境下的反事实动作评估,可用页面快照缓存或学习型模拟器近似;(3) 把'知识可解码但行为不用'的差距($\pi_{boot}$ 探针 99% vs 未见成功率 60.4%) formalize 为通用的'知识利用率'诊断指标,用于模型选择、数据分配与预训练配方评估;(4) 规模律检验:在更强预训练模型上激发式收益是否随内化知识增多而放大(Qwen3-1.7B 上 +43.5 点的巨大增益已是初步信号);(5) 推理时应用:同一状态并行评估多个目标假设,实现测试时目标消歧、意图澄清或安全约束检查;(6) 把目标干预扩展到非文本模态(GUI 截图、具身观测),检验'激发'论证是否跨模态成立。
复现评估
复现评估:作者承诺开源源代码、训练好的 checkpoint 与实验脚本(首页有 Project Page / Code / Model 链接),论文提供了超出常规的细节:偏好构建与训练目标(附录 A)、全部超参数(LoRA rank 16/缩放 16 挂在 attention QKVO 与 FFN gate/up/down 投影;lr 第 1 轮 $10^{-5}$、第 2 轮 $5\times10^{-6}$;$\tau=1$、$\lambda=0.25$;梯度累积 8;backbone 冻结)、评测协议(140/134 局、50 步上限、贪心自由生成、3 个评测种子取中位数、对训练种子平均、10,000 次自助重采的置信区间)、诊断细节(附录 D:探针的层/正则选择协议、目标对构建规则)。所有基准公开(ALFWorld、WebShop、NQ/TriviaQA/PopQA/HotpotQA/2Wiki/MuSiQue/Bamboogle)。主要门槛:(1) 数据构建需要 Qwen2.5-72B-Instruct 作标注者(API 或多卡推理成本),且每个候选动作需真实执行并重置的模拟器时间;(2) 训练本身很轻——两轮共 369 次更新的 LoRA,3B/7B 级模型单卡可训,主要工程量在 2,700 局的状态采集与 1,482 个决策的标注管线。总体难度中等:环节多但文档充分,建议先用公开 checkpoint 验证评测协议,再复跑数据管线。
论文图表
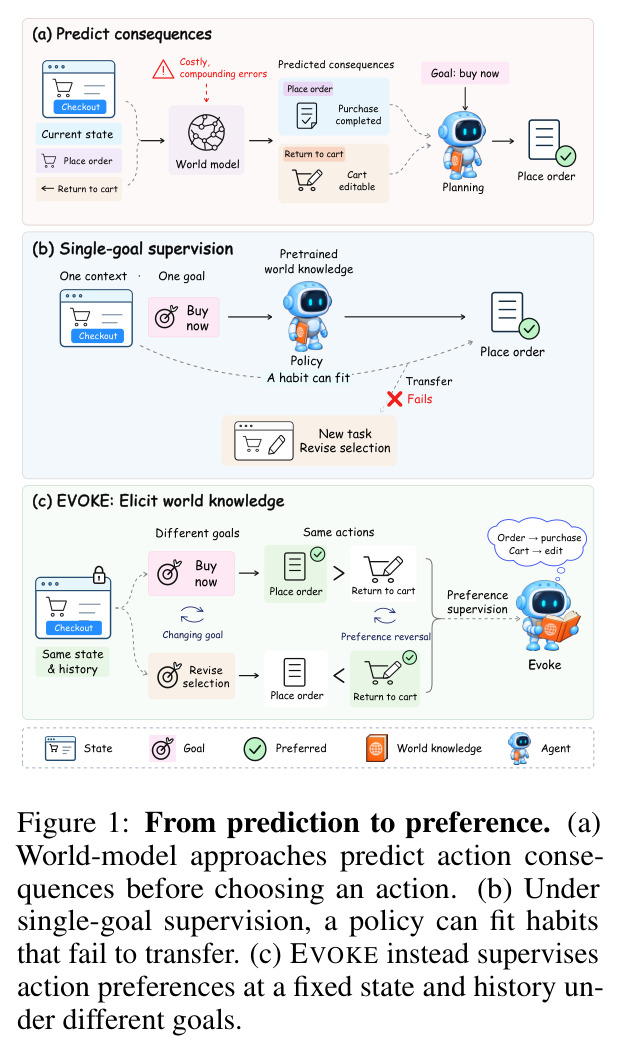
三栏对比示意图:(a) 世界模型方法在决策前预测动作后果(下单→购买完成、返回购物车→购物车可编辑),预测误差在规划中复合;(b) 单目标监督下同一情境只配一个目标,策略学出'情境→习惯动作'的映射,在新任务上失效;(c) EVOKE 在固定状态与历史下引入不同目标(立即购买 vs 修改选购),同一动作(下单/返回购物车)的偏好在不同目标间翻转,以此激发预训练世界知识。
一张图讲清论文的核心论点与立场转变——从'预测后果'到'监督偏好翻转',是理解全文动机的钥匙。
三个 backbone 经两轮 DAgger 式聚合训练的未见成功率轨迹:Qwen3-1.7B 65.7→74.6→85.8;Qwen2.5-3B 60.4→79.1→91.8;Qwen2.5-7B 72.4→83.6→94.0,每轮都有明显增益,两轮合计提升 20.1-31.3 个点。
证明'采集-干预-排序'循环能持续暴露并修正新策略的错误,且总监督决策量仅为 $\pi_{boot}$ 演示步数的约 9.1%。