CARD:面向个性化文本生成的簇级适配与奖励引导解码 CARD: Cluster-level Adaptation with Reward-guided Decoding for Personalized Text Generation
用簇级LoRA先验加用户向量的解码时奖励引导,实现免每用户微调的可扩展个性化生成
前置知识
LoRA(低秩适配)
LoRA 是参数高效微调技术:冻结预训练权重 $W_b$,在注意力等目标模块旁注入低秩分解 $\Delta W = BA$(秩 $r \ll d$),只训练 $B,A$ 两个小矩阵。本文用 rank 16、alpha 16,作用于 Qwen3-8B 的 q,k,v,o,gate,up,down 全部投影模块,为每个用户簇训练一个 LoRA 作为组级风格先验。
CARD 的组级适配层就是每簇一个 LoRA;理解 LoRA 的秩与参数量才能看懂它如何摊销个性化成本,以及与每用户 PEFT(如 OPPU)在存储上的数量级差异。
Bradley–Terry 成对偏好损失(DPO 的基础)
Bradley–Terry 模型假设成对比较中 $y^+$ 优于 $y^-$ 的概率为 $\sigma(r(y^+) - r(y^-))$。DPO 把奖励差替换为策略与参考模型的对数概率比 $\log\frac{\pi(y^+|x)}{\pi_{ref}(y^+|x)} - \log\frac{\pi(y^-|x)}{\pi_{ref}(y^-|x)}$,从而无需显式奖励模型即可直接优化策略。本文用它训练投影头与用户偏好向量。
CARD 的用户向量 $\lambda_u$ 与映射矩阵 $P,U$ 正是通过该成对损失学习的,理解它才能明白负例构造如何转化为稳定的梯度信号。
检索增强生成(RAG)
推理前用 BM25 等稀疏检索器或 Contriever 等稠密检索器从用户历史中取 top-k 相关条目拼进 prompt,让冻结模型参考历史作答。优点是免训练即插即用;缺点是生成器本身不变,个性化停留在表层模仿,且对检索质量、prompt 设计和上下文窗口长度敏感。
RAG 是本文最重要的对照范式,主表中 BM25/Contriever/PAG 基线都属此类;理解其'把历史塞进上下文'的机制,才能体会 CARD '把偏好压进 128 维向量'的设计动机。
每用户参数高效微调(OPPU 范式)
为每个用户训练独立的轻量模块(如专属 LoRA),底座模型全体共享。能学到深层用户行为,但每用户参数量为 $O(rHL)$($r$ 秩、$H$ 隐层维度、$L$ 层数),用户规模增大时存储与训练成本线性膨胀,新用户接入必须先做一次优化,规模化部署困难。
OPPU 是 CARD 直接对比的 PEFT 基线;CARD 把每用户存储压到 $O(D)$($D=128$ 维向量),这一对比是其可扩展性卖点的核心,不懂 OPPU 就无法理解论文的效率叙事。
ROUGE-1 / ROUGE-L
文本生成常用自动指标:ROUGE-1 统计生成与参考答案的一元词重叠 F1,ROUGE-L 基于最长公共子序列衡量结构相似度。两者都只看词面重叠,对'风格像不像用户'并不敏感。
LaMP/LongLaMP 主表全部用 R-1/R-L,而论文用 LLM judge 与人工评估发现 Group LoRA 的风格增益被 ROUGE 低估(LaMP-5 上 LLM 评分提升 50.0%、人工提升 94.4%),读表时必须知道指标边界。
解码时对齐 / logit steering
在冻结模型上不改权重、只在每步解码时修改 logits:$\tilde{\ell}_t = \ell_t + \beta \Delta\ell_t$,其中 $\Delta\ell$ 由奖励模型或偏好向量给出,相当于按用户偏好对候选 token 重排序。PAD 等方法需要在推理时对多个模型并行前向,开销较大。
CARD 的用户级个性化完全在解码时完成,仅做 Top-k 低秩 logit 修正(复杂度 $O(kJ)$),这是其推理效率、快速用户切换和隐私保护主张的技术根基。
研究动机
个性化文本生成(让模型按特定用户的风格与偏好写作)在真实部署中面临系统性的两难。现有方案分两类:一类是检索增强(RAG、PAG),把用户历史检索后拼进 prompt,但生成器本身保持冻结,个性化往往停留在表层模仿,且对检索质量与 prompt 设计高度敏感;另一类是参数高效微调(PEFT,如 OPPU 为每个用户训练专属 LoRA),能捕捉更深层的用户行为,但每用户参数的存储与维护成本随用户规模线性增长,新用户接入必须做一次额外优化。更麻烦的是监督信号问题:PEFT 个性化通常需要把用户偏好转成显式偏好对(供 DPO 类目标使用),人工标注贵得不可行,而'拿用户文本对比随机负例'的启发式构造会把主题内容与写作风格纠缠在一起——正负例说的根本不是同一件事,模型学到的可能只是'别谈这个话题'而不是'别用这种口吻',导致偏好信号不可靠,在历史稀疏的用户上性能尤其脆弱。近期的分层方案 PROPER 尝试用组级适配摊薄成本,但在不引入高额每用户参数的前提下实现个体级保真,仍是悬而未决的问题。
本文的目标是本文要回答的核心问题是:能否利用组级先验换取效率,同时把个体偏好完全推到轻量的解码时控制?具体目标分三层。第一,用无监督聚类把风格相近的用户分组,每组训练共享 LoRA 适配器,摊销适配成本,并为历史很少的低资源用户提供兜底先验,防止灾难性失败。第二,设计一种完全不需要人工标注的隐式偏好学习机制:构造'同输入、异风格'的偏好对,把主题内容与风格信号解耦,为学习个体风格偏差提供稳定的监督信号,直接缓解偏好数据稀缺。第三,推理时 backbone 与簇级 LoRA 全部冻结,个性化只通过每用户一个紧凑偏好向量($J=128$ 维)在 logit 层注入,使每用户存储降到 $O(D)$,新用户只需优化这一个向量即可完成接入;同时原始用户文本不进上下文窗口,天然规避长上下文延迟与隐私泄漏,用户向量还可直接存在用户设备上做端侧推理。
与已有工作不同的是,论文的独特之处在于把'个性化信号天然分层'这一结构洞察做成了彻底的工程方案:广义偏好以组级先验的形式被共享,细粒度差异表现为稳定的个体偏差。与 PROPER 等分层方法不同,CARD 不试图让适配层本身完成个体化,而是明确把个体层剥离到解码端,形成'组级参数化 + 个体级信号化'的解耦。在监督构造上,它提出 input-aligned 隐式负例:用该用户所属簇的 LoRA 在完全相同的 prompt 上生成回复作负例,与用户真实回复语义相同、只有风格不同,从根上绕开了随机负例的主题混淆,等于免费获得了一个风格判别信号。在注入方式上,它把用户偏好内化为 $J$ 维向量 $\lambda_u$ 与低秩词汇映射 $U$ 的双线性形式 $\Delta\ell_t = U(z_t \odot \lambda_u)$,可以解读为 reward-guided decoding——偏好向量定义了一个按用户风格给候选词元打分的奖励信号——却不需要像 PAD 那样单独训练一个奖励模型并在推理时并行前向多个网络。
核心方法
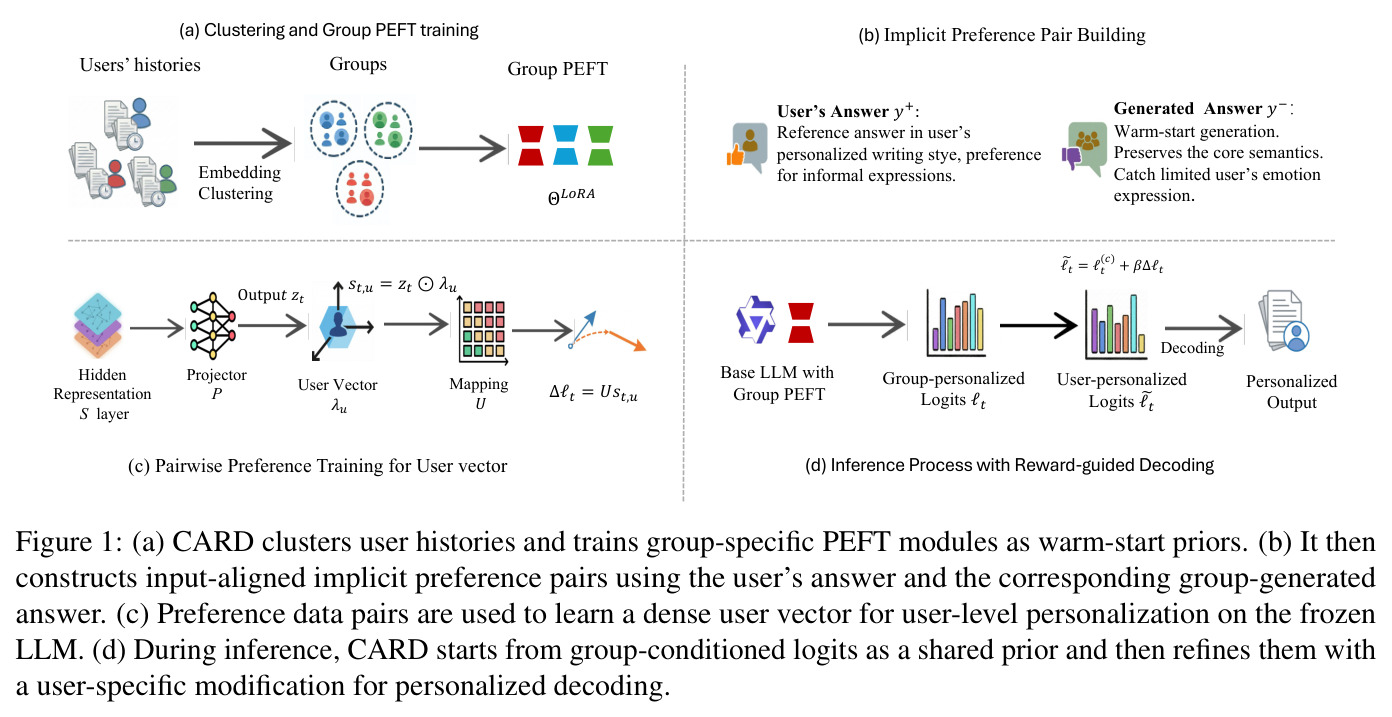
直觉上,CARD 把'像这群人'交给参数、把'像这个人'交给信号。技术路线分三个阶段。阶段一(组级适配):用冻结编码器 BAAI/bge-m3 把每个用户的历史档案编码为向量 $e_u$,K-means 聚成 $K$ 簇(按最近质心分配,$c(u)$ 记录用户所属簇),对每个簇 $C_c$ 在聚合样本上用交叉熵损失 $\mathcal{L}_c = -\sum_{(\tilde{x},y)}\sum_t \log p_{\theta_c}(y_t|\tilde{x},y_{<t})$ 训练一个 rank-16 LoRA $\Theta_c^{LoRA}$(backbone Qwen3-8B 冻结),作为防失败的稳定先验而非个性化终点。阶段二(隐式偏好对):对每条用户交互构造四元组 $(\tilde{x}_n, y_n^+, y_n^-, u_n)$,正例 $y^+ = y_n$ 是用户真实回复,负例 $y^- = M_{c(u_n)}(\tilde{x}_n)$ 是其簇 LoRA 在同一 prompt 上的生成(用 vLLM 批量产出),二者共享语义、只在风格执行上分化。阶段三(用户级个性化):学习共享投影头 $\Psi=(P,U)$ 与每用户偏好向量 $\lambda_u \in \mathbb{R}^J$($J=128$):每个解码步把隐状态投影为 $z_t = P(h_t) \in \mathbb{R}^J$,做通道级调制 $s_{t,u} = z_t \odot \lambda_u$,再经 $U \in \mathbb{R}^{|V| \times J}$ 映射到词表空间得低秩修正 $\Delta\ell_t = U s_{t,u}$,最终 logits 为 $\tilde{\ell}_t = \ell_t^{(c)} + \beta \Delta\ell_t$;修正只作用于簇 logits 的 Top-k 候选($k \ll |V|$),复杂度从 $O(|V| \cdot J)$ 降到 $O(k \cdot J)$,最后用 Bradley–Terry 成对损失联合优化 $P, U$ 与所有训练用户的 $\lambda_u$。
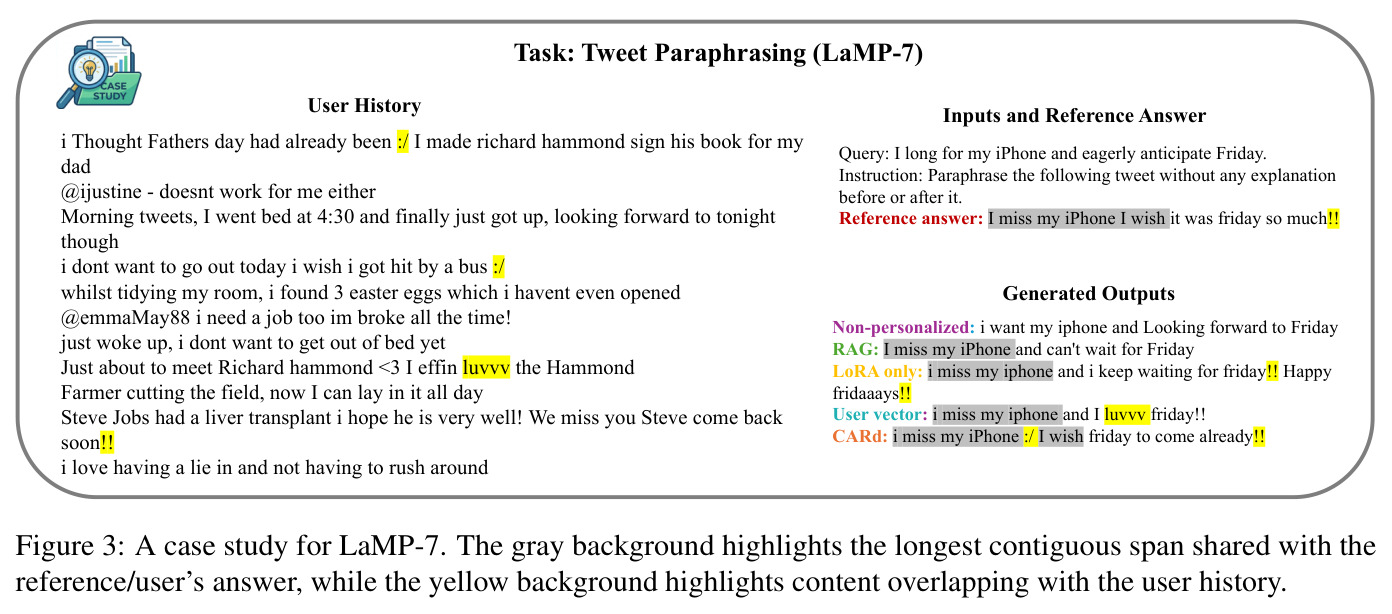
核心创新可以概括为三个'替换'。其一,用簇级生成的同输入负例替换随机负例:因为 $y^-$ 与 $y^+$ 条件在完全相同的 prompt $\tilde{x}$ 上,Bradley–Terry 损失中的梯度只能归因于风格差异而非主题差异,等于免费获得了一个'风格判别器'的监督信号,直接解决了偏好数据稀缺与信号混杂两大痛点——案例分析显示学到的确实是非正式用词、情绪强度、emoji 习惯这类特征。其二,用参数化用户向量替换每用户参数:与 OPPU 的每用户 LoRA(存储 $O(rHL)$)不同,个体差异被压缩为 $J=128$ 维的 $\lambda_u$,其作用机制是通道级缩放——放大或抑制隐状态中与该用户习惯对应的潜在维度——再经共享矩阵 $U$ 投影为对具体词元的奖励。这相当于把一个极简奖励模型因子化为共享的 $U$(怎么读偏好)与私有的 $\lambda_u$(偏好是什么),换用户只需换一个 128 维向量。其三,用解码时注入替换上下文注入:个性化信号不占上下文窗口、不暴露原始文本,backbone 与 LoRA 全程冻结,用户向量可存本地设备,实现快速用户切换与端侧部署。
方法步骤详情
完整流程共七步。第一步,用户表示与聚类:对用户 $u$ 用 bge-m3 编码其历史档案得 $e_u$,按 $\|e_u - \mu_k\|$ 最近质心分入 $K$ 簇之一得到 $c(u)$。第二步,簇级 LoRA 训练:对每簇聚合数据 $\mathcal{D}_c = [\varphi_{task}(x_{u,n}^{raw}, H_u), y_{u,n}]_{u \in C_c}$(输入是任务模板 $\varphi_{task}$ 注入历史后的 $\tilde{x}$),以交叉熵 SFT 训练 $\Theta_c^{LoRA}$;论文配置为 rank/alpha 16/16、目标模块 q,k,v,o,gate,up,down、dropout 0.05、学习率 $2\times10^{-4}$ 余弦衰减、10 epochs、bf16、最大序列 4096。第三步,负例生成:对训练集中每条样本,用 vLLM 运行该簇 LoRA 做贪婪解码,产出组级风格基线 $y_n^- = M_{c(u_n)}(\tilde{x}_n)$,与真实回复 $y_n^+$ 配对。第四步,偏好空间映射与用户向量:每个解码步 $P$ 把 $h_t$ 压缩到 $J=128$ 维风格子空间得 $z_t$,$\lambda_u$ 做逐通道缩放得 $s_{t,u}$。第五步,logit 修正:$U \in \mathbb{R}^{|V| \times J}$ 把 $s_{t,u}$ 投到词表空间得 $\Delta\ell_t$,先按簇 LoRA logits 选出 Top-k 索引集 $I_{t,k}$,仅对这 $k$ 个词元加 $\beta \Delta\ell_{t,v}$($\beta=1.0$),softmax 归一化后贪婪解码(温度 0、重复惩罚 1.1)。第六步,训练:冻结 $W_b$ 与全部 $\Theta_c^{LoRA}$,在偏好数据集 $\mathcal{D}$ 上以 $\mathcal{L} = -\sum \log \sigma(\log p_{pers}(y^+|\tilde{x},u) - \log p_{pers}(y^-|\tilde{x},u))$ 联合优化 $P, U$ 与训练用户的 $\lambda_u$(lr $10^{-2}$ AdamW、batch 4、3 epochs)。第七步,新用户接入:编码其档案、按最近质心分簇后,只需在该用户历史数据上优化一个 $\lambda_u$,全程零骨干训练。
技术新颖性
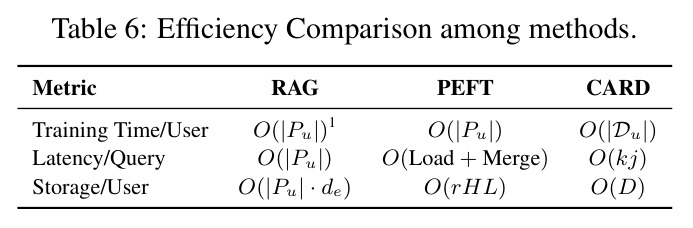
技术新颖性体现在四点。第一,隐式偏好构造的对照设计:与 OPPU/PPLUG 直接用监督信号、或 DPL/PUGC 等从用户内容提取隐式偏好的工作相比,簇基线负例保证正负样本输入严格对齐,是少见的'控制语义变量、只变风格'的成对构造,实验证明这种硬负例让偏好向量捕获的确实是纯风格信号。第二,偏好因子化的极简性:对比 PAD 需要训练独立奖励模型(双线性形式 $R = w_{p_u}^\top \phi(s_t,a)$,特征维度 4096)并在推理时对三个模型($\pi_{LM}$、$\hat{\pi}^*_{\theta}$、$\hat{\pi}_{ref}$)前向,CARD 把类似结构拆成共享投影 $U$ 与 128 维 $\lambda_u$,一步前向加 $O(kJ)$ 修正即可完成,且用户向量训练完全不触碰任何模型权重。第三,层次化摊销的完备复杂度优势:Table 6 显示 CARD 存储 $O(D)$、每查询延迟 $O(kj)$,优于 RAG 的 $O(|P_u|)$ 上下文成本和 PEFT 的每用户参数与加载合并开销;加用户只加向量、加新群体可加簇,各层独立可扩展。第四,隐私与部署叙事:偏好内化为向量后,原始文本可留在端侧由用户本地构建表征,服务方只分发轻量个性化模块,这是检索式与每用户微调范式在结构上都做不到的。
实验结果
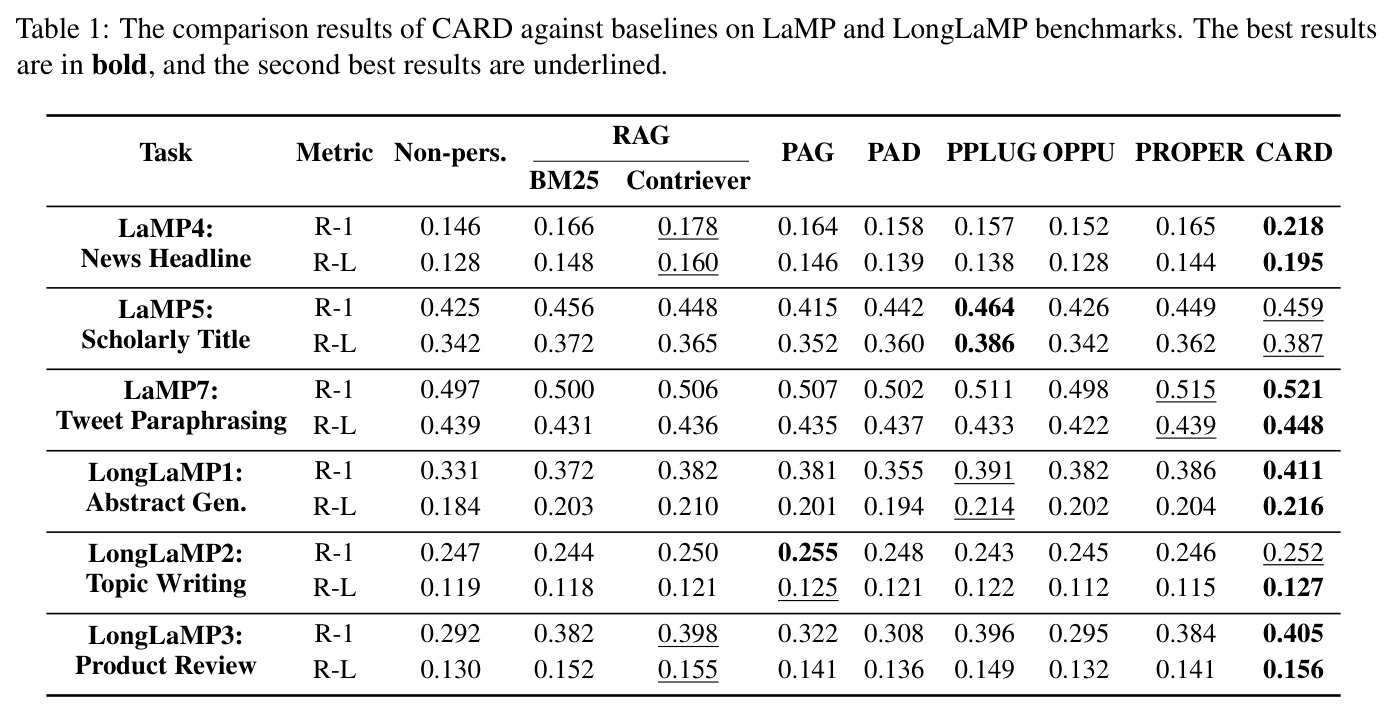
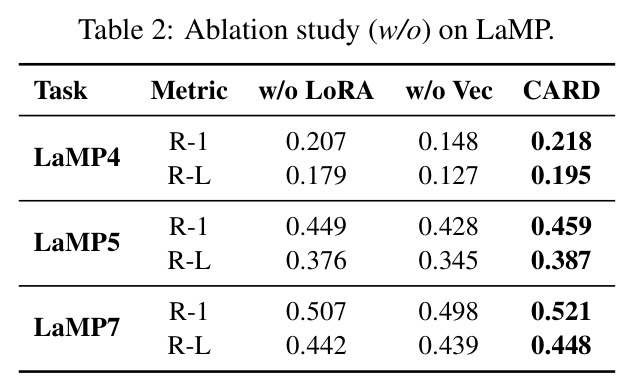
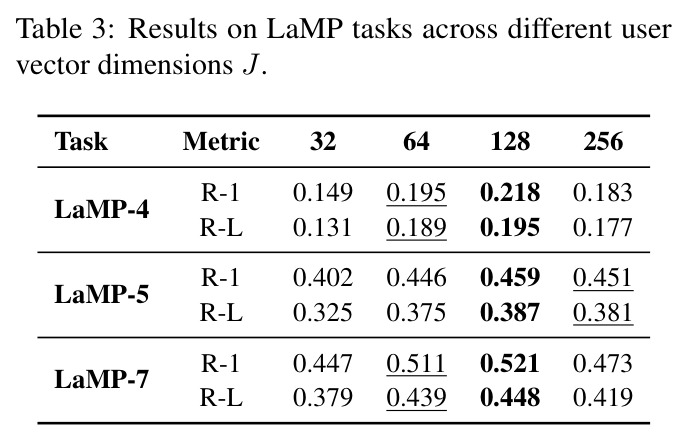
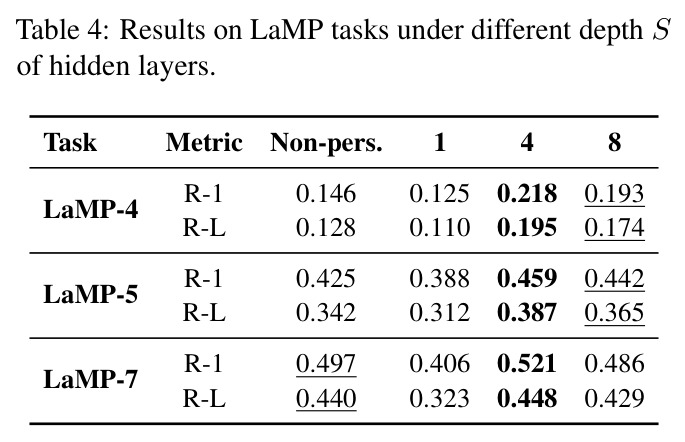
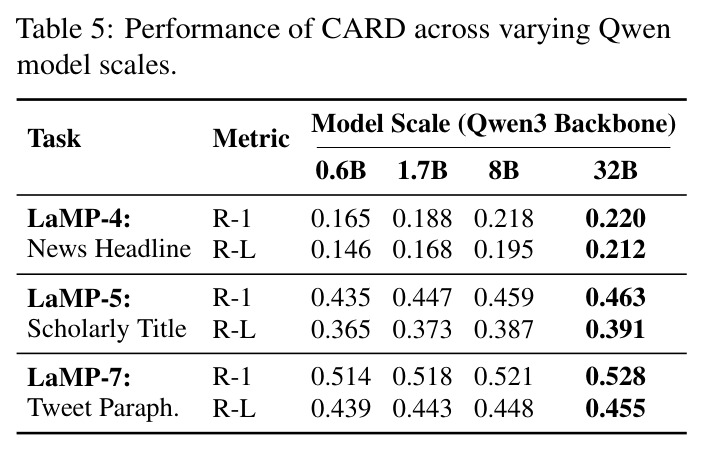
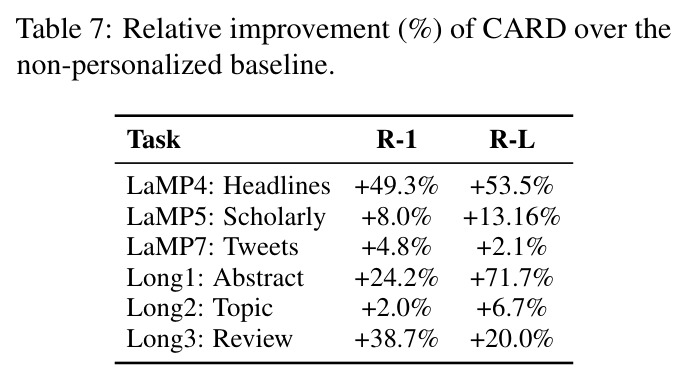
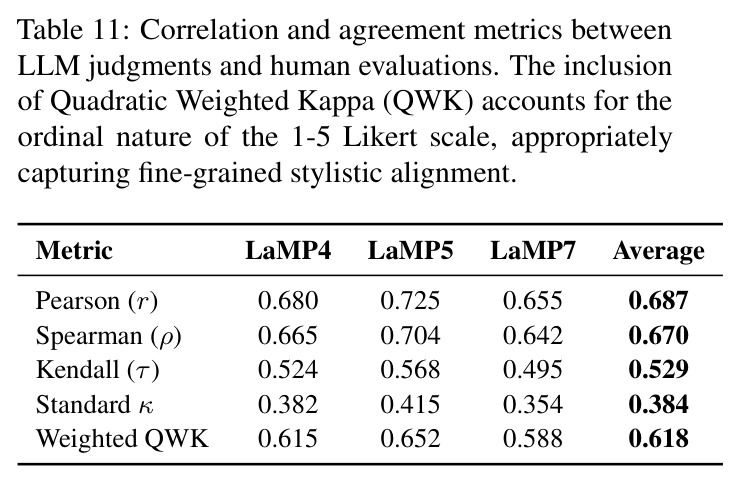
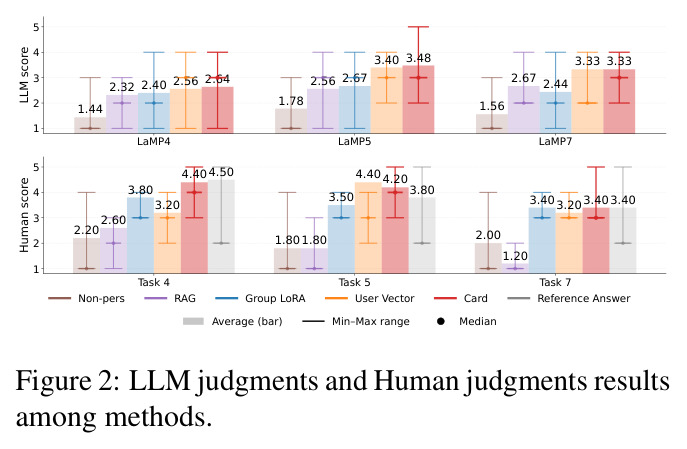
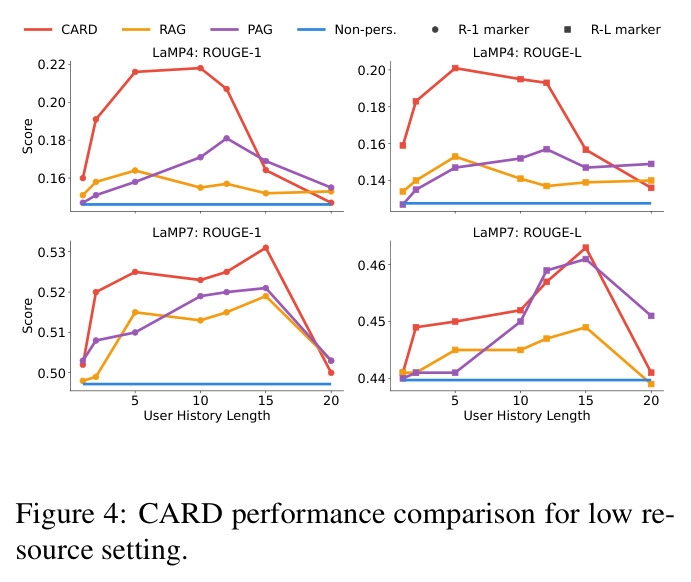
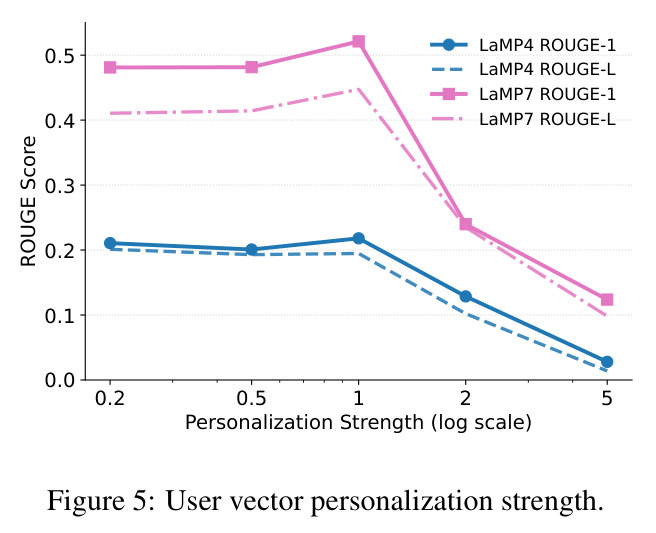
主实验(Table 1)覆盖 LaMP-4/5/7 与 LongLaMP-1/2/3 六个任务、R-1/R-L 两个指标共 12 个设置,CARD 在 10 个设置排名第一,其余两个接近最优。LaMP-4 新闻标题:R-1 从非个性化 0.146 提到 0.218,最强基线 RAG-Contriever 仅 0.178,相对非个性化提升 +49.3%(R-L +53.5%);LaMP-5 学术标题:R-1 0.459 次于 PPLUG 0.464,但 R-L 0.387 最佳;LaMP-7 推文改写:R-1 0.521 最佳(PROPER 0.515),但该任务个性化空间小(相对非个性化仅 +4.8%);LongLaMP-1 摘要生成:R-1 0.411(PPLUG 0.391),R-L 相对提升高达 +71.7%,为六个任务之最;LongLaMP-2 主题写作:R-1 0.252 次于 PAG 0.255,R-L 0.127 最佳;LongLaMP-3 评论写作:R-1 0.405、R-L 0.156 双第一。LLM judge(GPT-5.2)与人工评估(Figure 2)显示更大幅度优势:LLM 打分上 CARD 比非个性化基线在 LaMP-4/5/7 分别高 76.4%/95.5%/113.5%,在 Task 5 甚至超过参考答案 10.5%(说明人工偏好评估本质主观,更偏爱与用户风格对齐而非严格贴合金标);人工评估中 Group LoRA 单独带来 72.7%/94.4%/70.0% 的提升。消融(Table 2)证明两个组件缺一不可:去掉用户向量伤害最大(LaMP-4 R-1 从 0.218 跌到 0.148),去掉 Group LoRA 降至 0.207,且 Group LoRA 的贡献在 LLM/人工评分中远大于 ROUGE,说明风格先验的价值被词面指标系统性低估。低资源实验(Figure 4):仅 5 条历史时 LaMP-4 R-1 达约 0.216(非个性化约 0.146),L≈10 即到峰值约 0.219,样本效率显著优于基线的缓慢爬升;但历史很长时 LaMP-7 反而略降,暗示噪声历史会污染用户向量。模型规模(Table 5):Qwen3 从 0.6B 到 32B,LaMP-4 R-1 从 0.165 升至 0.220,8B→32B 增益趋于饱和(0.218→0.220)。向量维度(Table 3):$J=128$ 最优(LaMP-4 R-1:32 维 0.149、64 维 0.195、128 维 0.218、256 维 0.183,过大反而引入噪声过拟合)。层深(Table 4):聚合第 4 层左右的中层隐状态最优(1 层 0.125、4 层 0.218、8 层 0.193)。个性化强度(Figure 5):中等强度最优,过强则用户向量压过语义内容导致各任务骤降。评估可靠性(Table 11):LLM judge 与人类评分 Pearson 0.687、Spearman 0.670、二次加权 Kappa 0.618,支持其作为人工评估的可信代理。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LaMP-4 新闻标题生成 | ROUGE-1 | 0.218 | RAG (Contriever) 0.178;非个性化 0.146 | 较最强基线 +0.040(约 +22.5%),较非个性化 +49.3% |
| LaMP-5 学术论文标题生成 | ROUGE-1 | 0.459 | PPLUG 0.464 | -0.005(次优;12 项设置中两项未夺魁之一) |
| LaMP-7 推文改写 | ROUGE-1 | 0.521 | PROPER 0.515;非个性化 0.497 | +0.006(较非个性化 +4.8%,任务本身个性化空间小) |
| LongLaMP-1 个性化摘要生成 | ROUGE-L | 0.216 | PPLUG 0.214;非个性化 0.184 | 较非个性化 +71.7%(六个任务中相对提升最大) |
| LongLaMP-3 个性化评论写作 | ROUGE-1 | 0.405 | RAG (Contriever) 0.398;非个性化 0.292 | +0.007(较非个性化 +38.7%) |
| LaMP-4(消融实验) | ROUGE-1 | 完整模型 0.218 | 去用户向量 0.148;去 Group LoRA 0.207 | 用户向量贡献 +0.070,Group LoRA 贡献 +0.011 |
局限与改进
作者在 Limitations 中承认四点:一是组级建模依赖无监督 K-means 聚类,可能无法完全捕捉复杂的用户关系与潜在个性化结构;二是每个用户在解码全程只用单一偏好向量,对多样或随时间演化的偏好表达力有限,且学到的维度不可直接解释;三是框架虽然轻量,但多阶段流水线(聚类、簇训练、负例生成、向量训练)仍需多个组件协调;四是噪声或弱相关的历史会污染用户向量、降低个性化质量,历史过滤、相关性加权、噪声鲁棒档案选择被留作未来工作。我的补充观察:第一,隐式偏好对的质量完全押在簇 LoRA 上——若簇内风格异质,负例可能只是'风格大杂烩'而非干净对照,且为每个训练样本跑一次簇模型推理带来不可忽视的离线算力开销;第二,聚类数 $K$ 的选择与簇分配错误对性能的敏感性缺乏系统分析,新用户被分错簇时上游先验可能直接有害;第三,steering 强度 $\beta$ 固定为 1.0,而 Figure 5 表明性能对强度极其敏感,意味着该超参在不同用户与任务间可能需要自适应调节;第四,评估全部基于 LaMP 系英文基准(社交媒体、学术、评论体裁),对话式个性化、多语言场景、跨任务风格漂移均未验证;第五,LongLaMP-2 上输给检索式 PAG 暗示:当'主题相关知识'比'写作风格'更关键时,把历史压缩进 128 维向量的信息损失就会显形。
独立分析的弱点
独立分析出五个弱点,各配改进方向。其一,硬聚类脆弱:K-means 把每个用户钉死在单一簇中,处于簇边界或横跨多个群体的用户会拿到错配的先验;可引入软分配机制,例如混合专家式的 adapter 加权组合,或让用户向量同时从多个簇 LoRA 的 logits 中混合选择先验。其二,静态单一 $\lambda_u$:同一用户在不同情境下风格侧重不同——学术写作严谨克制、社交发帖口语化带 emoji——单向量无法上下文化;可让 $\lambda_u$ 条件化于当前输入,例如用轻量注意力机制从历史中检索'情境相关偏好'再调制 $z_t$。其三,负例质量与成本绑死在簇模型上:簇 LoRA 偏弱时负例提供的是噪声梯度,且每样本一次簇模型推理的离线成本不小;可改用多负例策略(不同温度、不同簇的生成)或按风格距离对负例过滤后再进训练。其四,噪声历史无防御:真实社交媒体用户充满转发、灌水与无关内容,会稀释用户向量;可在构造 $e_u$ 与训练 $\lambda_u$ 前加入历史清洗模块,或按与当前任务的相关性对历史加权。其五,可解释性与可控性缺失:$J=128$ 维潜空间没有语义锚点,用户无法理解也无法手动调整自己的偏好;若施加稀疏正则或把维度对齐到可解释风格属性(正式度、情绪强度、emoji 频率等),用户可以拿到'偏好旋钮'自行调节,这会显著提升产品化价值。
未来方向
作者明确提出的方向:引入历史过滤、相关性加权与噪声鲁棒的档案选择,提升用户向量在脏数据下的质量。基于其成果可自然延伸的方向包括:一是在线/终身个性化——$\lambda_u$ 只有 128 维,完全可以随新交互流式更新(甚至在端侧更新),做成'偏好随使用不断进化'的系统,论文的 pairwise 目标天然支持增量样本;二是设备端部署——论文已指出用户向量可存本地,配合端侧小模型(0.6B 的 Qwen3 上 R-1 已达 0.165)可实现隐私优先的个性化助手,服务方只分发共享的 $P,U$ 与簇 LoRA;三是与检索混合——LongLaMP-2 的结果表明主题知识靠向量承载不足,可在簇先验+用户向量之上叠加轻量检索,形成'检索供内容、向量供风格'的双通道架构;四是自适应强度控制——按用户历史置信度或生成过程中的不确定性动态调节 $\beta$,避免 Figure 5 所示的过强化崩溃;五是聚类结构动态化——随用户群演化增量重建簇与 LoRA(例如新簇只训练新 adapter),避免全量重训;六是把'同输入异执行'的隐式偏好对构造推广到对话回复、多模态生成等其他个性化任务,验证该监督范式的普适性。
复现评估
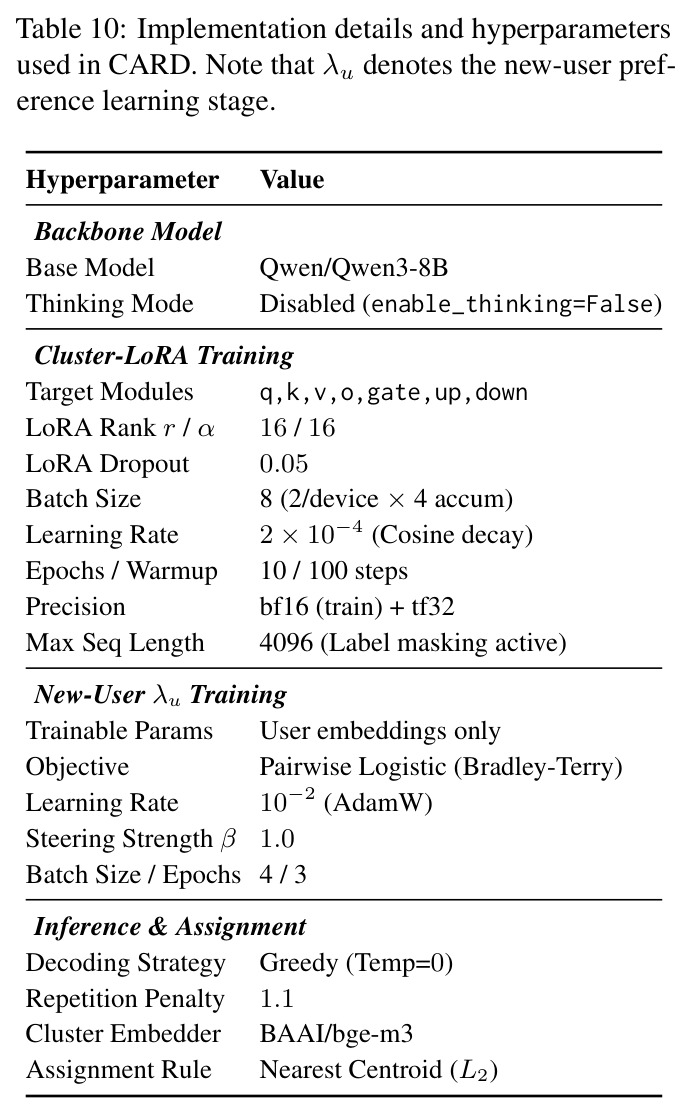
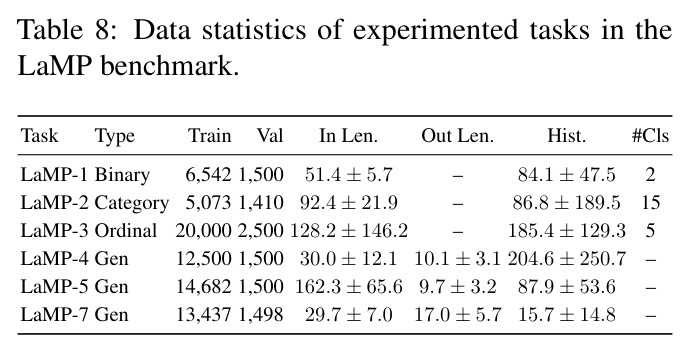
复现条件相当好。代码已开源(GitHub: RainieLLM/CARD,评审期另有匿名版 anonymous.4open.science/r/CARD-86BC);基座 Qwen3-8B 开源,且论文给了 0.6B–32B 全系列结果便于对照;LaMP 与 LongLaMP 均公开可得(因官方测试集未公开,论文用 validation 集做测试,复现时需注意这一点)。Table 10 给出全部关键超参:LoRA rank/alpha 16/16、目标模块 q,k,v,o,gate,up,down、dropout 0.05、学习率 $2\times10^{-4}$ 余弦衰减、10 epochs、warmup 100 步、bf16 训练、序列长 4096、标签掩码开启;用户向量训练用 Bradley–Terry 目标、lr $10^{-2}$ AdamW、batch 4、3 epochs、$\beta=1.0$;聚类编码器 bge-m3、最近质心 L2 分配、贪婪解码加 1.1 重复惩罚。算力方面,8B 模型加 rank-16 LoRA 的 SFT 与每用户向量优化都是单卡(24–80GB)可行负载,负例生成用 vLLM 一次离线批量推理即可完成。两个潜在摩擦点:LLM judge 使用 GPT-5.2(商业 API,复现 judge 指标需付费调用或替换为可比开源 judge),以及若要严格对齐主表需按附录 D 重建 RAG/PAG/PPLUG/OPPU/PROPER/PAD 等多条基线流水线(附录已给出全部 prompt 模板与配置,工作量在工程而非调参)。总体属于中等难度、高确定性复现。
论文图表