PsPLUG:定制化大模型中平衡隐式个性化与显式风格的轻量级插件 Do Implicit Personalization and Explicit Styles Conflict? PsPLUG: A Lightweight Plug-in for Balancing Personalization and Style in Customized LLMs
将个性化建模为分布残差,用3-token软提示插件化解风格指令引发的个性化坍缩
前置知识
LLM 个性化(Personalization)
让 LLM 输出对齐特定用户语言习惯、兴趣与偏好的技术总称。主流路线有三类:检索式(把用户历史直接塞进上下文窗口,如 LaMP 上的 RAG)、每用户微调(为每个用户单独训练 LoRA 适配器,如 OPPU)、轻量插件(注入用户嵌入或软提示,如 PPlug、PAG)。
本文研究的正是这些现有个性化方法在显式风格指令下集体失效的问题,理解三类基线的工作方式才能读懂对比实验的设计与结果。
软提示 / 前缀注入(Soft Prompt / Prefix Injection)
不改动模型权重,而是在输入嵌入层拼接一段可学习的连续向量(前缀),使冻结的骨干模型按前缀信息调整输出。相比 LoRA 等参数级微调,软提示更轻量:切换用户只需替换前缀向量,无需重载模型参数,推理开销恒定。
PsPLUG 本质上就是一个仅 3 个 token 长的软提示插件,前缀机制是其架构设计与效率分析(存储 $O(d_e)$、延迟常数)的基础。
Bradley–Terry 损失与 DPO 偏好优化
成对偏好优化目标:给定偏好对 $(y^+, y^-)$,用 $-\log\sigma(\beta(r(y^+)-r(y^-)))$ 训练模型更偏好 $y^+$。DPO 把隐式奖励定义为策略与参考模型的对数似然差 $r=\log\pi-\log\pi_{ref}$,从而免去显式奖励模型的训练。
PsPLUG 的训练目标就是 BT/DPO 家族的变体,其核心的『残差奖励』正是对数似然差形式的隐式奖励,不理解这套框架就看不懂损失函数的推导。
分布残差(Distributional Residual)视角
本文提出的核心理论视角:个性化不是学习用户的绝对输出分布,而是学习『用户真实语言分布与基础模型中性分布在同一输入下的偏差』。用户亲笔文本编码了个人词汇与结构偏好,零样本 LLM 输出反映群体级先验,二者的对数似然差构成『纯个性化残差』。
这是全文的理论基石:风格条件负样本的构造、残差奖励的定义、推理时 $\alpha$ 只缩放用户分量的设计,全部由这一视角推出。
LaMP 基准
个性化文本生成的标准评测基准,包含多种任务形态:LaMP-1 引用识别(二分类)、LaMP-2M 电影标记(15 类分类)、LaMP-3 产品评分(1–5 分序数回归)、LaMP-4 新闻标题生成、LaMP-5 学术标题生成、LaMP-7 推文改写。每个样本都附带用户历史,评估用 F1/ACC/MAE/RMSE/ROUGE 等任务专属指标。
论文所有实验都在 LaMP 上进行,任务划分、指标选择和数据统计(附录 Table 6/7)都遵循其官方协议,是解读实验表格的背景知识。
研究动机
个性化 LLM 已能通过检索用户历史(RAG/PAG)、每用户微调(OPPU)或软提示插件(PPlug)较好地复现用户偏好,但现代 NLP 应用普遍运行在显式系统指令之下——用户或产品层会要求『用简洁正式的语气回复』『写得温暖幽默』等。论文作者实证发现,一旦引入这类显式约束,现有个性化方法会出现严重的『个性化坍缩』(personalization collapse):强系统指令主导了生成空间,把用户在语气、用词、结构等多个维度上的个性特征几乎完全抹平。论文 Figure 1 给出了直观例子:一位用户在历史中表达了对温馨家常餐厅的喜爱(『Wendy's 总让我想起家庭聚餐 lol』),个性化 LLM 在无风格约束时能带感情地复述这一偏好,但当加入『简洁风格』指令后,输出退化为毫无个人色彩的通用描述(『该餐厅提供高质量家常菜和舒适环境』),个性信号被风格完全覆盖。更深层的病灶在于:现有方法注入用户相关信号时,从未在理论上澄清『什么才是核心的个性化信号』以及『它与基础模型在同一输入下的中性行为是什么关系』(Shenfeld et al., 2025; Kim et al., 2025),导致用户信号与指令信号在模型内部相互纠缠,一有冲突便被显式指令压制。
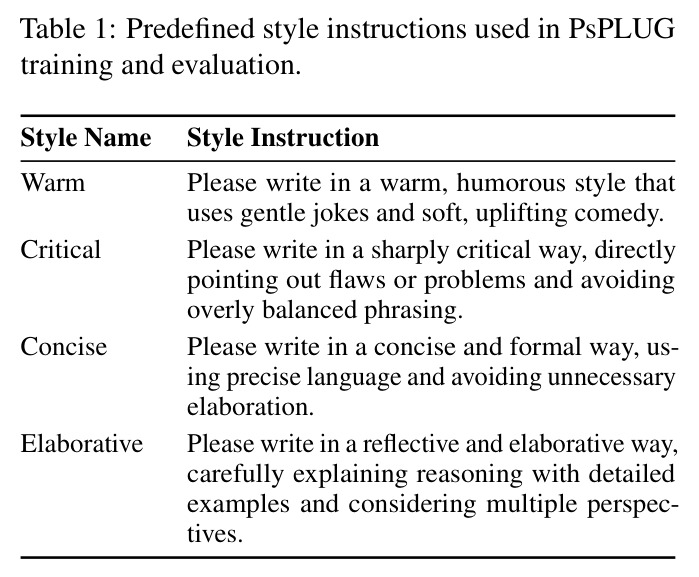
本文的目标是本文的目标是建立『风格约束下的个性化』(style-constrained personalization)能力:构建个性化策略 $\pi_\phi(y \mid x_s, u)$,使其既忠实复现用户的特有行为(词汇、句式、兴趣偏好),又能在同一输出中可靠遵循显式任务级风格指令 $s$(如『简洁正式』『温暖幽默』),两者不互相吞噬。具体要达成三件事:其一,从理论上给出个性化的可分离定义,使模型能『隔离』出风格之上的用户残差信号,而非笼统拟合用户文本;其二,以极低的部署成本实现——不为每个用户做参数微调,插件即插即用、即插即换;其三,提供推理时的连续强度控制:用一个标量系数 $\alpha$ 在『完全服从风格指令』与『最大化个性表达』之间平滑调节权衡,而非只能接受固定的折中。最终在 LaMP 六个任务和四种风格指令下,同时取得优于 SOTA 的个性化保持与精确的风格遵循。
与已有工作不同的是,本文最独特的切入是把个性化形式化为『分布残差』(distributional residual):不学习用户输出的绝对似然,而是定义同一输入 $x_s$ 下两个条件分布的偏差——用户的真实语言分布(其亲笔文本 $y_u$ 编码了个性化词汇与结构偏好)与基础 LLM 的中性分布(零样本输出反映群体级先验),二者的对数似然差即『纯个性化残差』。基于这一视角,训练时在风格增强的上下文 $x_s$ 下构造偏好对:正样本是用户亲笔的 $y_u$,负样本是参考模型自身在同样风格指令下生成的 $y_s \sim \pi_{ref}(\cdot \mid x_s)$——$y_s$ 遵循风格但不含任何用户信息,因此对比这一对就能把『风格遵循』成分从学习信号中对消掉,剩下的正是风格之上的用户特质。这与 LongPO 等标准偏好优化只锚定通用基础分布的做法有本质区别:残差奖励在数学上显式解耦了竞争信号,使模型在强风格约束下依然保有细粒度的 persona 保真度,同时把『偏离多少』的控制权留给了推理时刻。
核心方法
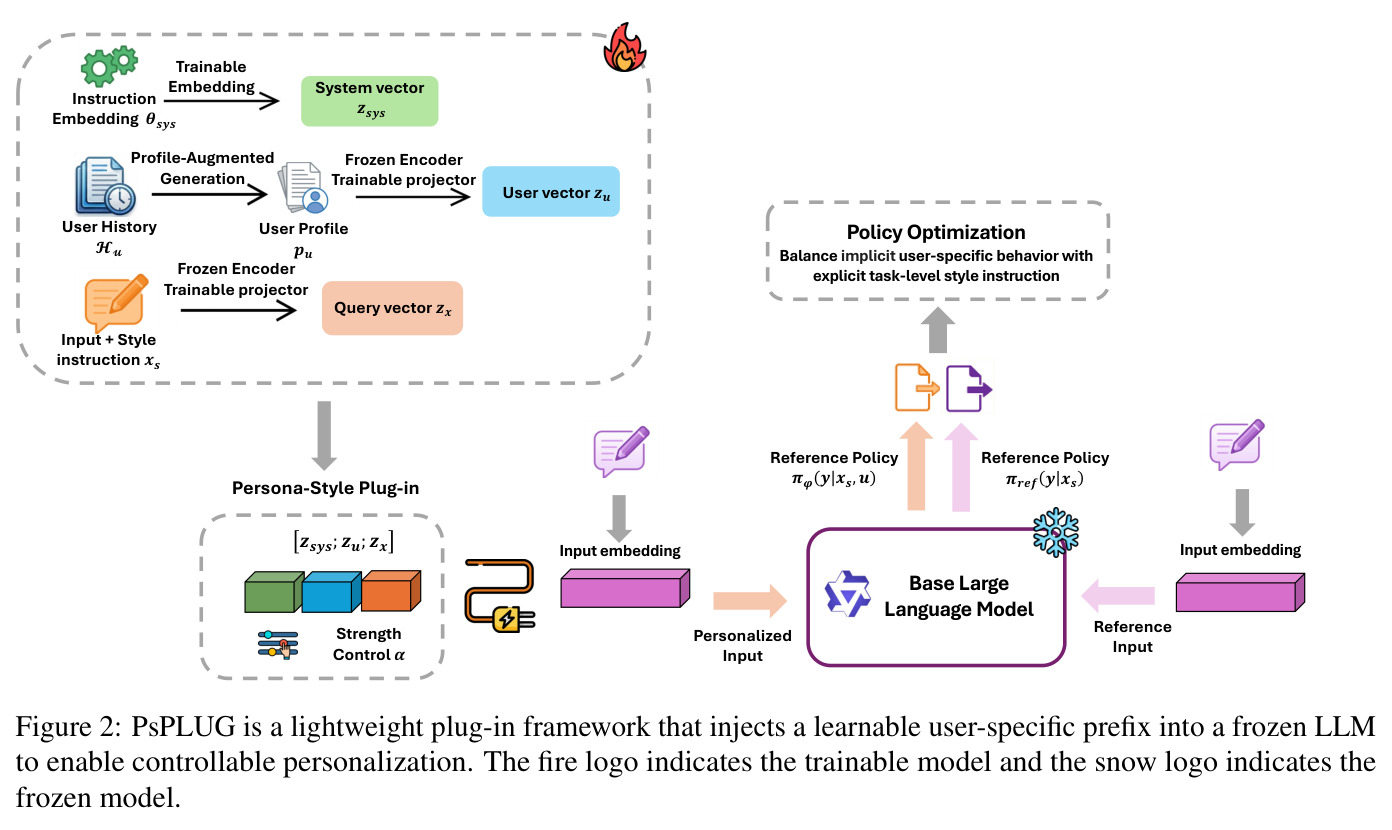
直觉上,PsPLUG 把『个性化』做成一个可随时插拔、随时调音量的小模块:冻结的 Qwen3-8B 骨干负责通用语言能力和风格遵循,一段仅 3 个 token 长的连续前缀负责注入『这个人是谁』。技术上,它在骨干 LLM 的输入嵌入层拼接前缀 $z_{u,x_s}=[z_{sys};\ z_u;\ z_x]$:$z_{sys}$ 是全体用户共享的可训练系统指令嵌入 $\theta_{sys}\in\mathbb{R}^d$;$z_u$ 是用户向量——用户历史 $\mathcal{H}_u$ 先被压缩成一段 Profile-Augmented Generation(PAG)文本描述 $p_u$,经冻结句编码器 BGE-base-en-v1.5 编码并离线缓存,再由可训练 MLP 投影进 LLM 隐空间;$z_x$ 是输入向量——当前提示 $x_s$ 经冻结骨干嵌入池化 $h(x_s)=\mathrm{Pool}(\mathrm{Emb}_{ref}(x_s))$ 后由另一个可训练 MLP 编码。所有向量乘以嵌入尺度因子 $\gamma$(对齐骨干输入嵌入的典型范数)。训练采用风格条件偏好对(用户亲笔回复 vs 模型同风格输出)上的 Bradley–Terry 损失,奖励定义为个性化策略与冻结参考策略的对数似然差;推理时用标量 $\alpha$ 只缩放 $z_u$,实现个性化强度与风格遵循的解耦调节。骨干与嵌入层全程冻结,切换用户只需替换前缀向量,无需重载模型参数。
核心创新是『残差式偏好学习』:把负样本设计成参考模型自己在同一风格指令下的输出 $y_s \sim \pi_{ref}(\cdot \mid x_s)$。因为 $y_s$ 天然满足风格约束 $s$ 却不含任何用户特质,偏好对 $(y^+, y^-)=(y_u, y_s)$ 的对比中『遵循风格』这一成分被完全对消,梯度只推动模型学习用户超出风格的独特残余——这正是『个性化 = 分布残差』的可操作实现。隐式奖励定义为 $r_\phi(y)=\log \pi_\phi(y \mid x_s, u) - \log \pi_{ref}(y \mid x_s)$,参考项把比较锚定在由 $s$ 诱导的基线风格遵循行为上,个性化策略只在『比基线更贴近用户偏好』时才被鼓励偏离。与已有方法的本质区别有两点:其一,PPlug 等插件用标准因果语言建模(CLM)损失直接拟合用户文本,把风格、内容、个性混在一起学,一旦外部强指令与之冲突,学到的用户分布就会被整体压制;其二,LongPO 等 DPO 变体锚定在通用基础分布上,没有显式剥离风格成分。PsPLUG 的残差奖励在数学上分离了两个竞争信号,并且通过仅缩放 $z_u$ 的系数 $\alpha$($z^{(\alpha)}_{u,x_s}=[z_{sys};\ \alpha\cdot z_u;\ z_x]$)把解耦延伸到了推理时刻——$\alpha\to 0$ 时用户信号被抑制,$\alpha>1$ 时放大,而风格遵循与输入理解不受影响。
方法步骤详情
第一步(离线画像):对每个用户,用 vLLM 贪心解码把历史 $\mathcal{H}_u$ 压缩成固定长度的 PAG 描述 $p_u=\mathrm{PAG}(\mathcal{H}_u)$,用冻结的 BGE-base-en-v1.5 取 [CLS] 表示并做 $\ell_2$ 归一化得到 $e_u$,离线缓存。第二步(前缀构造):计算 $z_u=\gamma f^{pag}_\phi(e_u)$、$z_x=\gamma f^{qry}_\phi(h(x_s))$、$z_{sys}=\gamma\,\theta_{sys}$,三者拼接为 3-token 前缀注入输入嵌入层,得到个性化策略 $\pi_\phi(y\mid x_s,u)=\pi_{ref}(y\mid [z_{u,x_s};\ \mathrm{Emb}_{ref}(x_s)])$。第三步(偏好对构造):对每个训练样本,在风格上下文下采样风格-only 基线 $y_s\sim\pi_{ref}(\cdot\mid x_s)$,取 $(y^+,y^-)=(y_u,y_s)$;当无风格指令时 $s=\emptyset$,退化为中性基线 $y_0\sim\pi_{ref}(\cdot\mid x)$,偏好对变为 $(y_u, y_0)$,此时 $z_u$ 成为承载个性化残差的主要载体。第四步(优化):以 $\ell_{style}=-\log\sigma\big(\beta\,\Delta r_\phi\big)$、$\Delta r_\phi=r_\phi(y^+)-r_\phi(y^-)$ 更新插件参数 $\phi$(两个 MLP 投影器与共享嵌入 $\theta_{sys}$),骨干与编码器冻结;训练 5 个 epoch(早停)、学习率 $10^{-4}$、bfloat16 精度、贪心解码评估。第五步(可控推理):计算 $z^{(\alpha)}_{u,x_s}=[z_{sys};\ \alpha\cdot z_u;\ z_x]$,$\alpha$ 在推理期连续可调,$\alpha\to 0$ 逼近纯风格行为、$\alpha>1$ 强化个性化,整个过程无需重训模型或修改指令。
技术新颖性
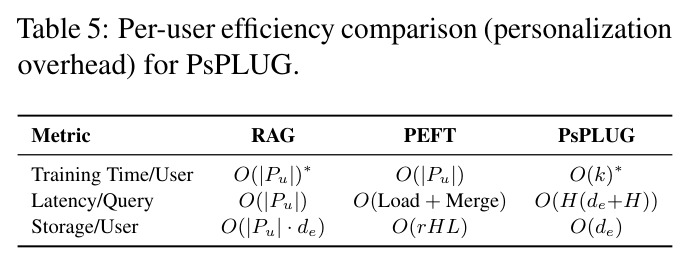
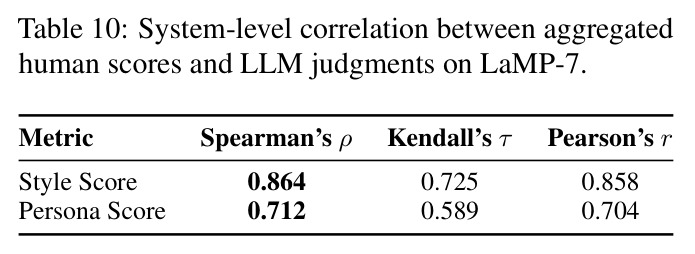
技术新颖性体现在四个层面。理论层面:首次把『个性化』形式化为对中性参考策略的分布残差,明确指出此前工作(PPlug、OPPU、PAG 等)没有澄清『核心个性化信号是什么』这一根本问题,并把风格-个性冲突这一失效模式显式命名为个性化坍缩(personalization collapse),为该问题建立了术语和理论框架。目标函数层面:负样本不是随机的拒绝样本或通用基线,而是参考模型在完全相同风格指令下的自生成输出,使 BT 损失在构造上就剥离了风格成分——这与 LongPO 锚定通用分布、PUGC 从用户生成内容挖偏好对、DPL 从跨用户差异学对比信号的路线都不同。架构层面:前缀三组件(共享指令嵌入 / 用户向量 / 输入向量)职责分离,推理时只缩放用户分量 $\alpha\cdot z_u$,保证强度调节不影响指令遵循与输入理解;用户表示是单一静态向量,存储 $O(d_e)$、推理延迟 $O(H(d_e+H))$,与历史长度 $|\mathcal{P}_u|$ 无关,且 3-token 前缀不增加上下文负担。评测层面:提出 personalization-score 与 style-score 双维度 LLM judge 协议并用人工验证(系统级 Pearson 相关 style 0.858 / persona 0.704),为这一此前缺乏合适评测手段的问题建立了可扩展、可校验的评估框架。
实验结果
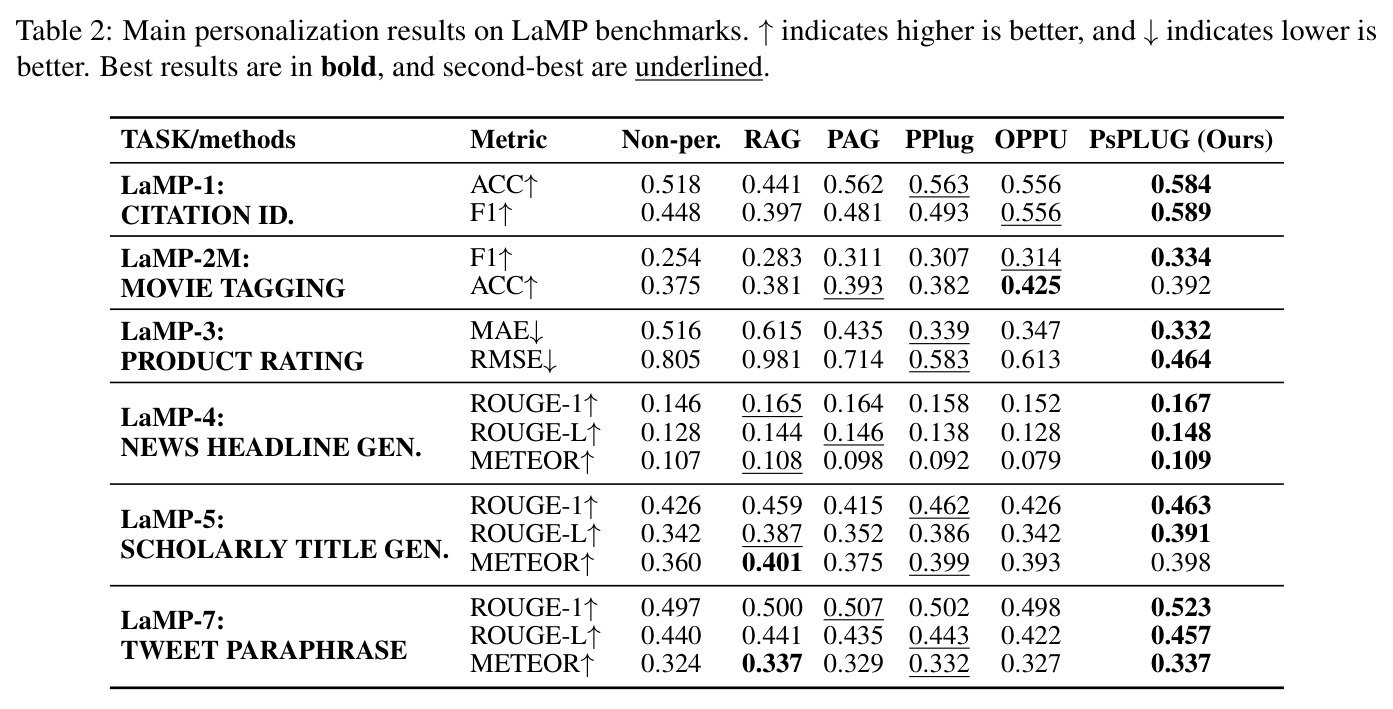
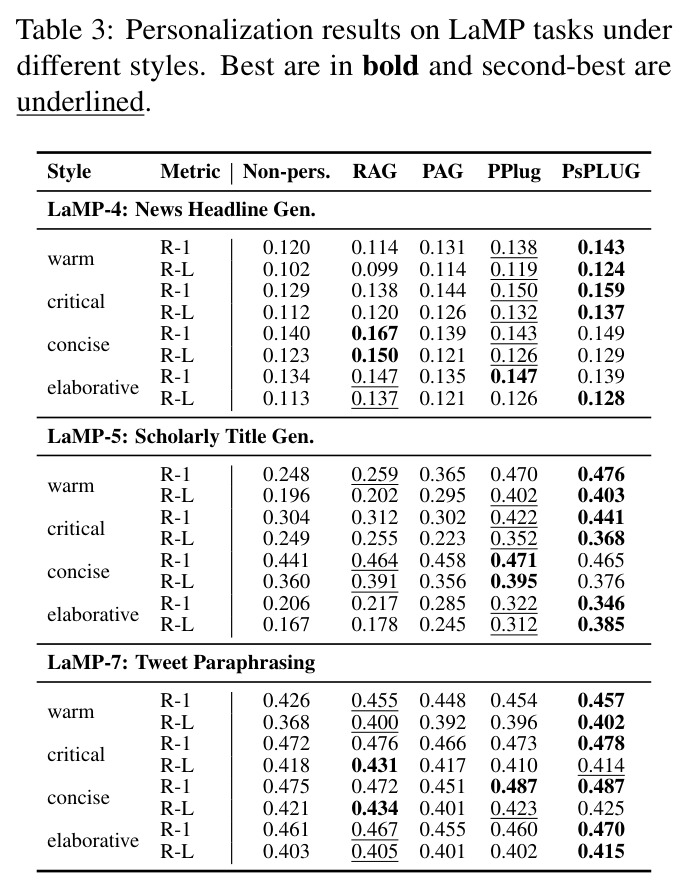
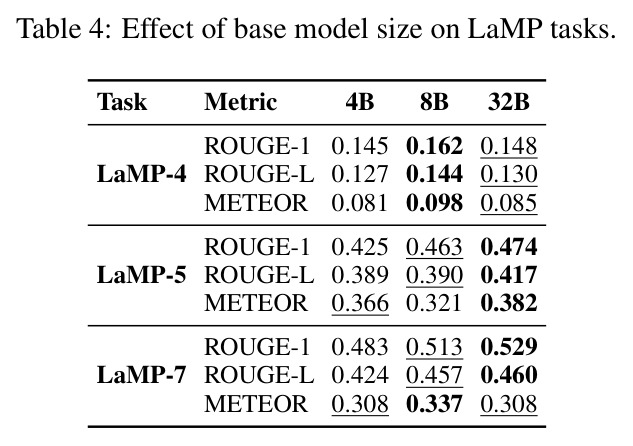
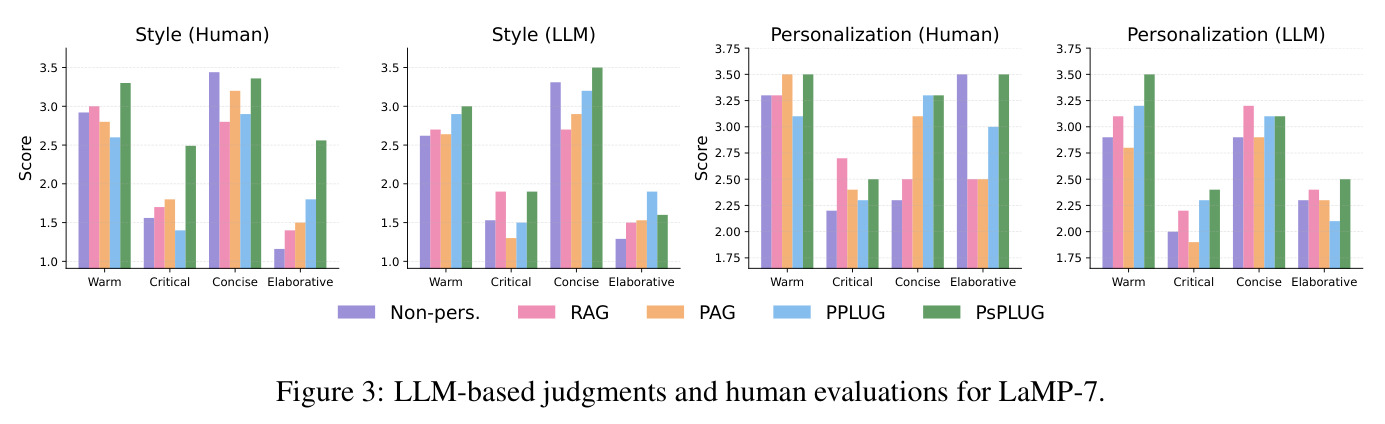
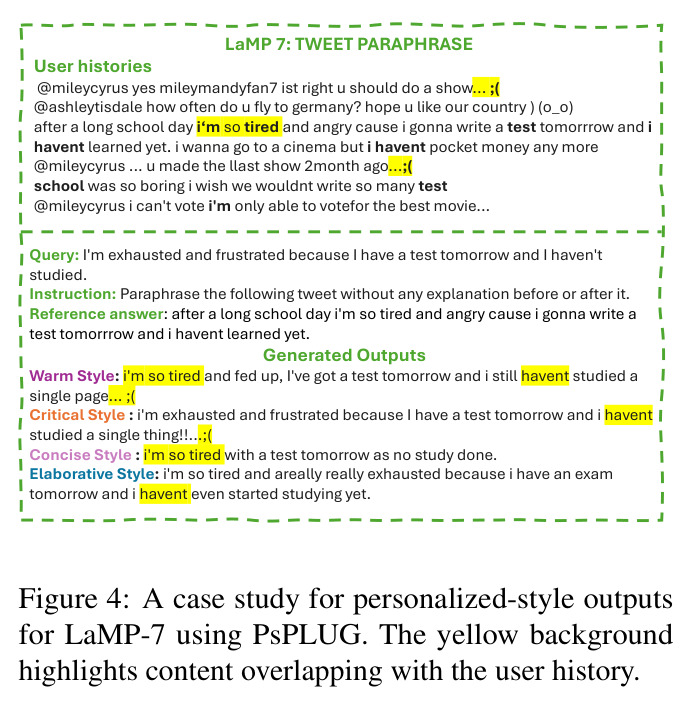
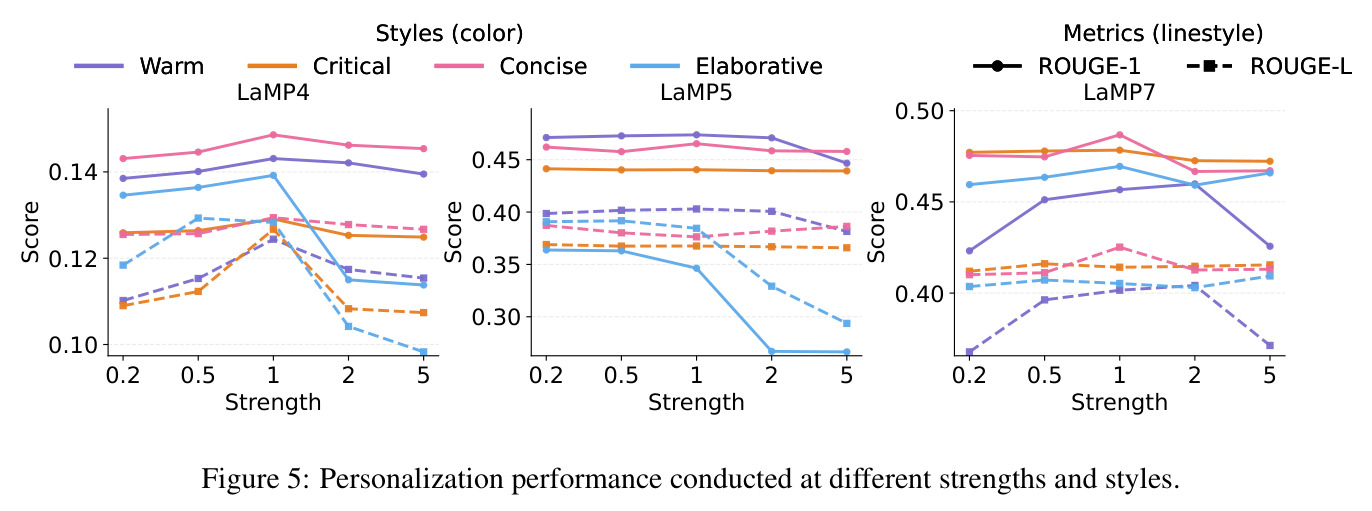
RQ1(无风格指令,Table 2):在 LaMP 六任务上 PsPLUG 全面领先或持平 SOTA。LaMP-1 引用识别 ACC 0.584 / F1 0.589(次优 PPlug ACC 0.563、OPPU F1 0.556);LaMP-3 产品评分 MAE 0.332 / RMSE 0.464,RMSE 显著优于 PPlug 的 0.583 与 OPPU 的 0.613;LaMP-7 推文改写 ROUGE-1 0.523 / ROUGE-L 0.457 / METEOR 0.337 全部第一;LaMP-4 新闻标题三指标均最佳(R-1 0.167 / R-L 0.148 / METEOR 0.109);LaMP-2M 的 F1 0.334 最佳但 ACC 0.392 低于 OPPU 的 0.425;LaMP-5 与 PPlug 基本打平(R-1 0.463 vs 0.462)。RQ2(风格约束下,Table 3 与 Figure 3):PsPLUG 在超过 80% 的 style–task–metric 组合中取得最佳或次佳,较此前基线最多领先 2–4 个 ROUGE 点;例如 LaMP-5 上 warm 风格 R-1 0.476(PPlug 0.470、PAG 0.365)、critical R-1 0.441(PPlug 0.422)、elaborative R-1 0.346(PPlug 0.322)。实验还揭示风格干扰的不对称性:warm/critical 等语气型风格对基线破坏最重,而 concise 与任务结构天然对齐——非个性化基线在 LaMP-5 上加 concise 后 R-1 反而从 0.426 升至 0.441。RQ3(Figure 5):不同风格对强度 $\alpha$ 的响应不同,concise 在各强度下最稳定,warm/elaborative 敏感,elaborative 在 LaMP-5 高强度下急剧退化(冗长与标题任务约束冲突)。RQ4(Table 4/5):8B 骨干常与 32B 相当(LaMP-7 R-1 0.513 vs 0.529),中小模型已具竞争力;开销上 PsPLUG 存储 $O(d_e)$、延迟 $O(H(d_e+H))$,免去 RAG 的 $O(|\mathcal{P}_u|)$ 延迟与 PEFT 的适配器加载开销。评估可靠性(Table 10):LLM judge 与人工评分在 LaMP-7 上系统级强相关——style 分数 Spearman $\rho=0.864$ / Pearson $r=0.858$,persona 分数 $\rho=0.712$ / $r=0.704$,证明 LLM 评估可作粗粒度可靠代理,但在 elaborative 等主观风格上与人工仍有分歧。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LaMP-1 引用识别(无风格) | ACC / F1 | 0.584 / 0.589 | PPlug 0.563 / 0.493;OPPU 0.556 / 0.556 | ACC +2.1 点(vs PPlug),F1 +3.3 点(vs OPPU) |
| LaMP-3 产品评分(无风格) | MAE / RMSE(越低越好) | 0.332 / 0.464 | PPlug 0.339 / 0.583;OPPU 0.347 / 0.613 | RMSE 降低 0.119(vs PPlug) |
| LaMP-7 推文改写(无风格) | ROUGE-1 / ROUGE-L / METEOR | 0.523 / 0.457 / 0.337 | PAG 0.507 / 0.435 / 0.329;RAG 0.500 / 0.441 / 0.337 | R-1 +1.6 点(vs PAG) |
| LaMP-4 新闻标题生成(warm 风格) | ROUGE-1 / ROUGE-L | 0.143 / 0.119 | PPlug 0.138 / 0.119;PAG 0.131 / 0.114 | R-1 +0.5 点(vs PPlug) |
| LaMP-5 学术标题生成(critical 风格) | ROUGE-1 / ROUGE-L | 0.441 / 0.368 | PPlug 0.422 / 0.352;Non-pers. 0.304 / 0.249 | R-1 +1.9 点(vs PPlug) |
| LaMP-5 学术标题生成(elaborative 风格) | ROUGE-1 / ROUGE-L | 0.346 / 0.385 | PPlug 0.322 / 0.312;Non-pers. 0.206 / 0.167 | R-L +7.3 点(vs PPlug) |
| LaMP-7 双维评估(4 风格,LLM+人工) | Style 分数 / Persona 分数 | 所有四风格 style 分数最高;persona 最强或近最强 | Non-pers. / RAG / PAG / PPlug | >80% 的 style–task–metric 设置最佳或次佳 |
| 每用户个性化开销 | 存储 / 查询延迟 | $O(d_e)$ / $O(H(d_e+H))$(3-token 前缀,常数开销) | RAG $O(|\mathcal{P}_u|\cdot d_e)$ / $O(|\mathcal{P}_u|)$;PEFT $O(rHL)$ / Load+Merge | 开销与用户历史长度 $|\mathcal{P}_u|$ 完全解耦 |
局限与改进
作者在 Limitations 一节承认三点:其一,风格条件仅覆盖 4 个预定义类别(Warm/Critical/Concise/Elaborative),而真实世界的风格需求往往更细粒度、开放式、可组合,框架对训练分布之外的风格泛化能力未知;其二,实验局限于 Qwen 系列骨干与 LaMP 基准分布,跨模型架构、多语言、长上下文域的鲁棒性有待验证;其三,本文只处理文本属性这一维度,『解耦』在更复杂轴向上(如事实偏好 vs 表达偏好)仍是开放问题。此外我观察到:用户表示是把历史压缩成单一 PAG 描述再编码为一个静态向量 $e_u$ 并离线缓存,历史很长(如 LaMP-3 平均历史约 185 条)或偏好随场景变化的用户可能遭遇信息瓶颈,且新行为无法实时反映;OPPU(每用户 LoRA)在 LaMP-2M 的 ACC(0.425 vs PsPLUG 0.392)和 LaMP-5 上仍可打平或超过 PsPLUG,说明在无风格约束、允许高成本时每用户微调仍有上限优势;LLM judge 使用 GPT-5.2 PRO,其与人工在 persona 分数上的相关仅 $r\approx 0.704$,且 elaborative 风格上两者分歧明显,评估的绝对数值需谨慎解读;$\alpha$ 是全局标量,只能整体缩放个性强度,无法分维度(语气 vs 用词 vs 结构)调节;最后,风格-任务间根本冲突未被建模——elaborative 在 LaMP-5 高强度下退化表明某些风格与任务格式天然矛盾,单纯放大 $\alpha$ 无法调和。
独立分析的弱点
弱点一:静态单向量用户表示。$z_u$ 来自一次性生成的 PAG 描述编码,当用户历史超出编码器容量或偏好高度多样时存在信息瓶颈,且缓存后无法随新行为更新。改进方向:引入检索式动态用户向量(按当前输入检索相关历史片段再编码),或对 $e_u$ 做定期增量更新。弱点二:风格空间封闭。$z_{sys}$ 是单一共享可训练嵌入,训练与评测均限定在 4 条固定风格指令上,开放式自然语言风格描述(如『像海明威一样简洁』)无法直接注入。改进:用句编码器把任意风格文本映射为 $z_{sys}$,实现开放词汇的风格控制。弱点三:强度控制粒度粗。$\alpha$ 只能整体放大/抑制用户信号,无法选择性保留某些个性维度而把其余让渡给风格。改进:对 $z_u$ 做子空间分解(按语义方向分组),学习维度级的门控或分组缩放。弱点四:评估依赖闭源 LLM judge。GPT-5.2 PRO 的 API 依赖带来成本与可复现性风险,persona 分数与人工一致性仅 $r\approx 0.70$,elaborative 上分歧最大。改进:训练开源 judge(Prometheus 风格)或引入基于用户留出样本的分布级个性化指标。弱点五:风格-任务冲突未解。elaborative 在 LaMP-5 上的坍缩说明强度控制无法弥补风格与任务格式间的根本矛盾。改进:加入任务约束感知的 $\alpha$ 自适应调度,或在目标函数中显式加入任务合规项。
未来方向
作者提出的方向:把解耦从文本属性扩展到更复杂的行为维度;在多语言、长上下文(如 LongLaMP)与异构骨干上验证鲁棒性;探索更细粒度、开放式、可组合的风格条件,把本文定位为抛出『个性-风格解耦』问题的第一步。基于本文成果可自然延伸的方向:其一,与解码时方法结合(如 PAD、DRIFT 等解码期干预),在无法访问模型权重的黑盒 API 场景实现可控个性化;其二,用户向量本地化部署——论文伦理部分设想客户端本地构建用户表示、仅上传轻量个性化模块的隐私架构,值得系统实证;其三,层次化多用户结构:与作者此前的 CARD(聚类级适配与奖励引导解码)思路结合,在 $z_u$ 之上引入用户聚类先验以缓解冷启动;其四,动态强度:训练一个冲突预测器让 $\alpha$ 随输入与风格的冲突程度自适应,替代手工调节;其五,构建 persona–style 双维度的人工标注评测基准,弥补 LLM judge 在 elaborative 等主观风格上与人类的系统性分歧;其六,把残差视角推广到多指令组合(风格+格式+禁忌约束)并存时的信号分离。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/RainieLLM/PsPLUG);LaMP 数据公开且严格匿名化,通过官方 API 获取。附录透明度很高:Table 8 给出全部超参数(骨干 Qwen3-8B 冻结、句编码器 BGE-base-en-v1.5 冻结、PAG 用 vLLM 贪心解码、前缀 3 token、训练 5 epochs 早停、学习率 $10^{-4}$、bfloat16、温度 0.0 贪心解码、历史采样 k=10、编码器最大长度 4096);Table 9 公开了各任务 PAG profile 的生成提示;附录 C 公开了 4 种风格的 LLM judge 完整系统提示与 1–5 分评分细则;附录 D 给出人工-LLM 相关性数据。算力方面,主实验用 8×NVIDIA H100,但训练对象仅两个小 MLP 投影器和 3 个 token 的嵌入,参数量与显存需求都不大,单卡或双卡应可复现训练;主要计算开销在推理侧(为每个用户生成 PAG 描述、为每个训练样本采样风格负样本 $y_s$)。主要复现障碍有二:评测环节依赖 GPT-5.2 PRO 作为 judge(需 API 预算,且模型版本更替可能引入评分偏差);人工验证部分需要标注资源。总体复现难度中等偏低:训练管线本质是带风格条件负样本采样的 DPO,代码、数据、提示全公开,但完整复现论文的 judge 评估数值需要额外 API 成本。
论文图表
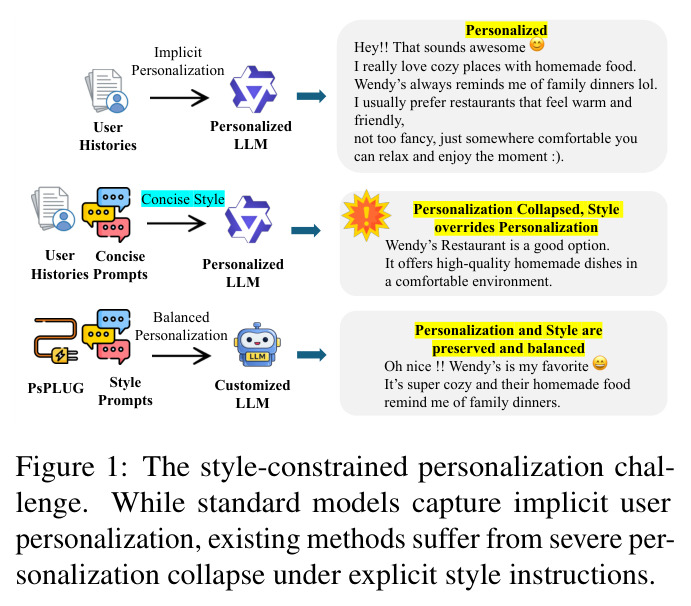
三栏对比示意图。用户历史显示其偏爱温馨家常餐厅(『I really love cozy places with homemade food. Wendy's always reminds me of family dinners lol』)。第一栏:普通个性化 LLM 能带情感地复述该偏好;第二栏:加入『简洁风格』指令后现有方法输出坍缩为通用描述(『It offers high-quality homemade dishes in a comfortable environment』),个性化被风格覆盖;第三栏:PsPLUG 在遵循风格的同时保留了『Wendy's is my favorite』等个人表达,实现个性与风格的平衡。
这是全文问题定义的直观呈现:用同一个具体例子展示了『个性化坍缩』这一失效模式以及 PsPLUG 的修复效果,是理解论文动机的最快入口。