大语言模型基础 Foundations of Large Language Models
系统梳理大语言模型六大基石:预训练、生成建模、提示、对齐、推理与推理增强的教材级综述
前置知识
Transformer 与自注意力机制
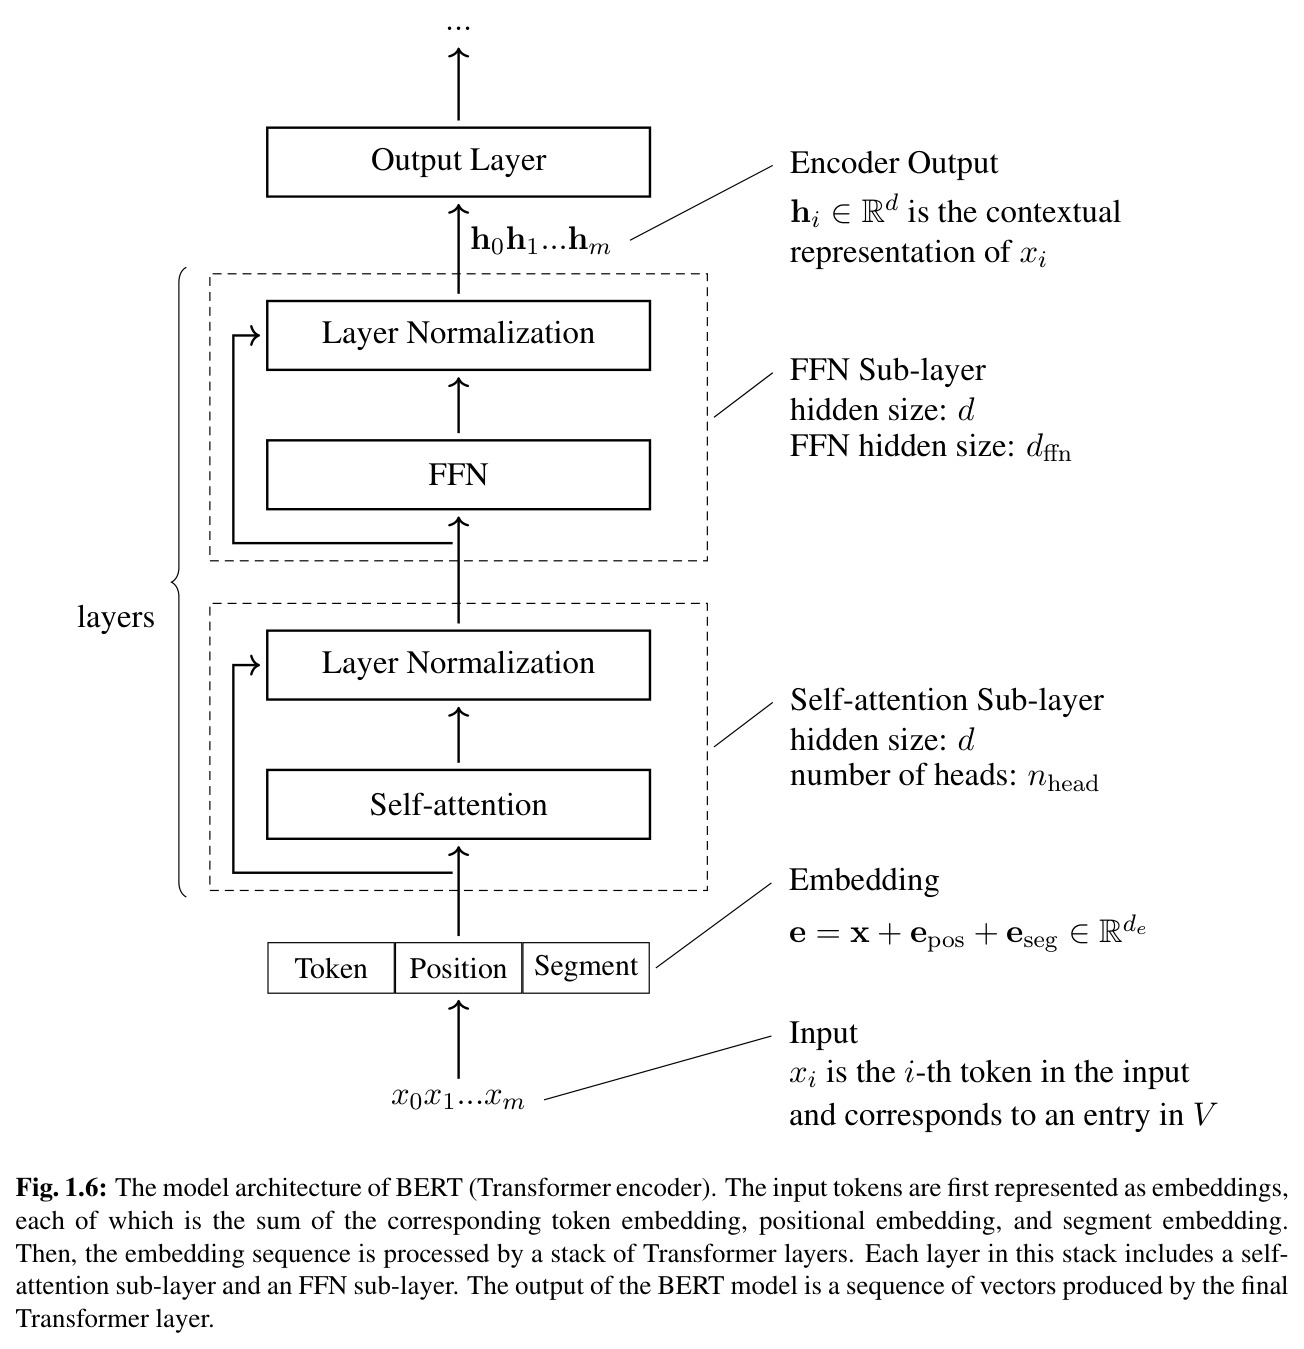
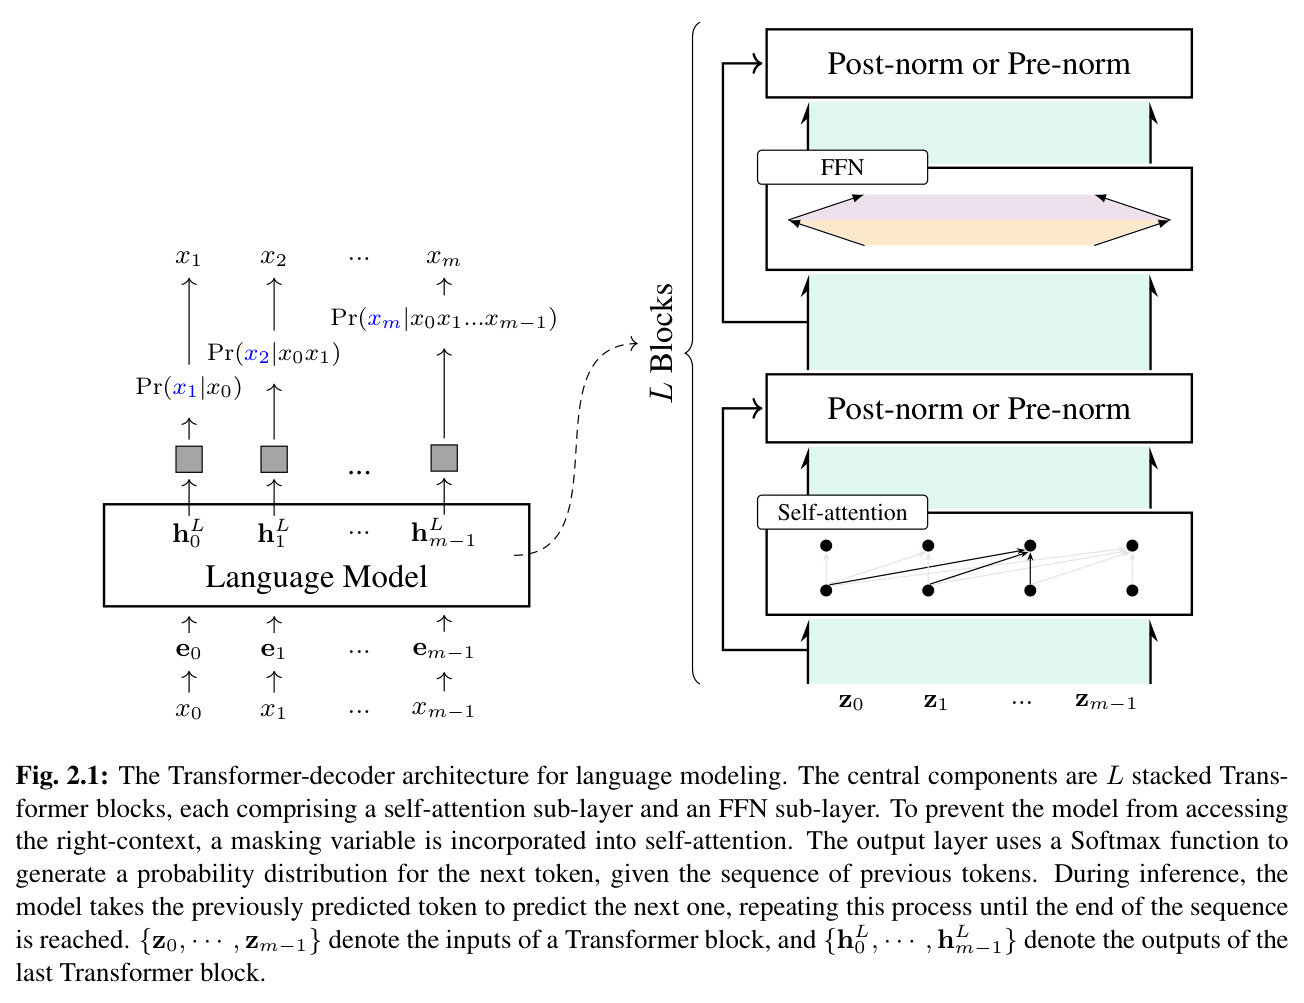
Transformer 是当前几乎所有大语言模型的骨干网络。自注意力让序列中每个位置通过 Query、Key、Value 三个矩阵计算与其他位置的关联权重:$\mathrm{Att}(Q,K,V)=\mathrm{Softmax}(QK^{\top}/\sqrt{d}+\mathrm{Mask})V$,实现对全序列的并行编码;堆叠 $L$ 层并配合多头机制与前馈网络即构成完整模型。
全书第1-2章的预训练任务、第5章的 KV 缓存与推理优化全部建立在 Transformer 的注意力计算之上,不懂自注意力就无法理解后续的架构改造与加速技术。
语言建模与极大似然训练
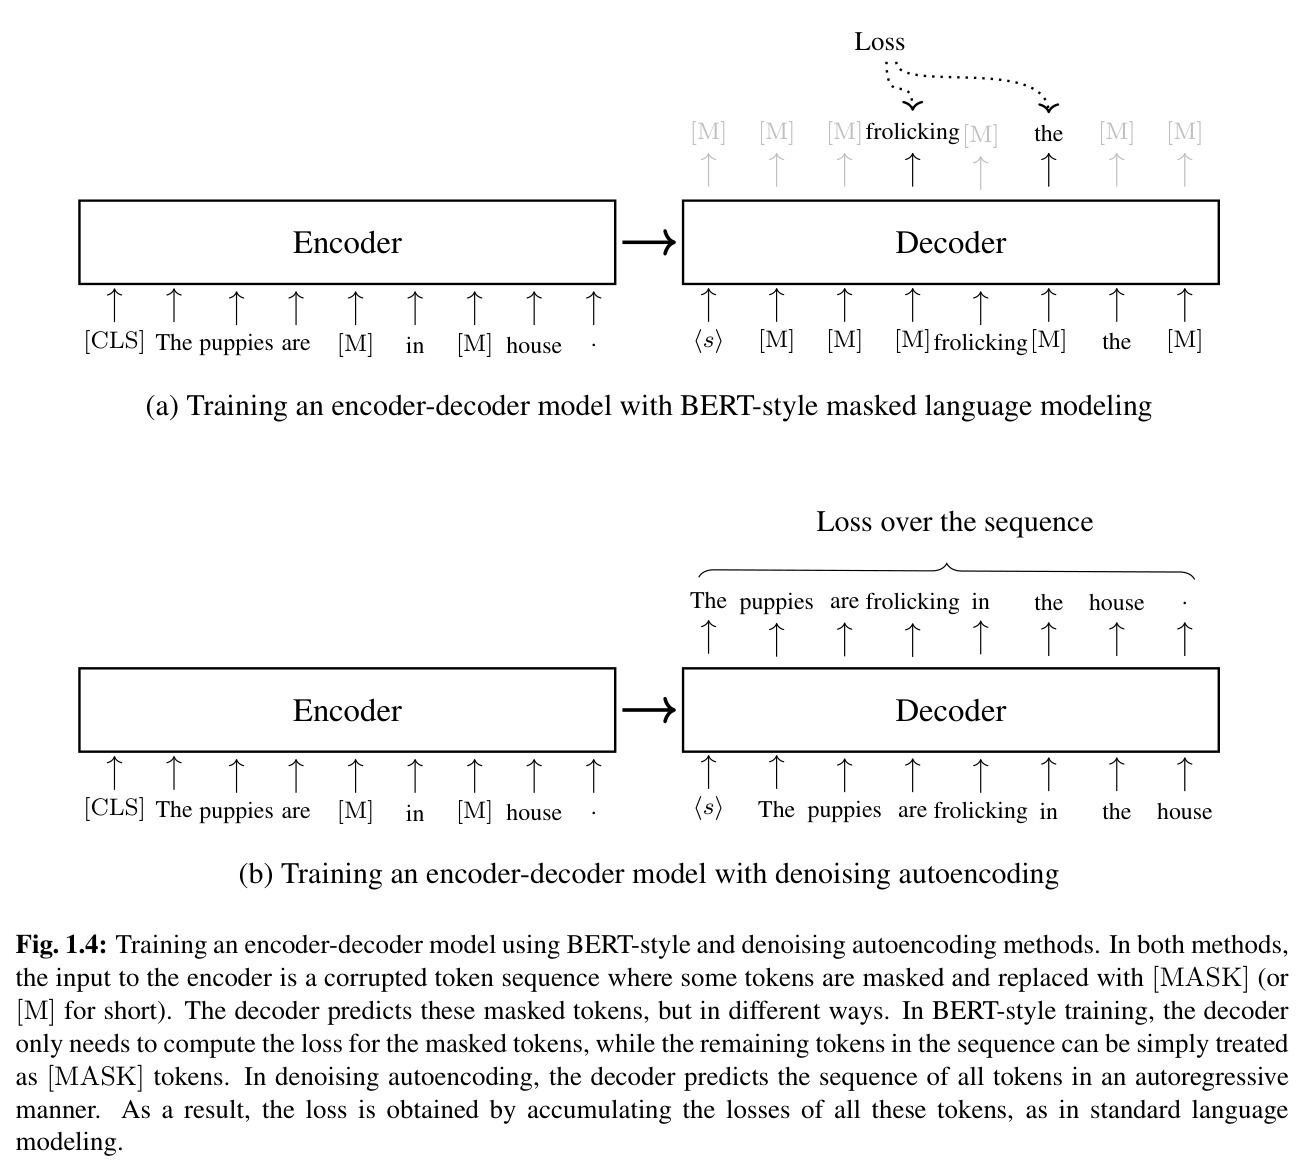
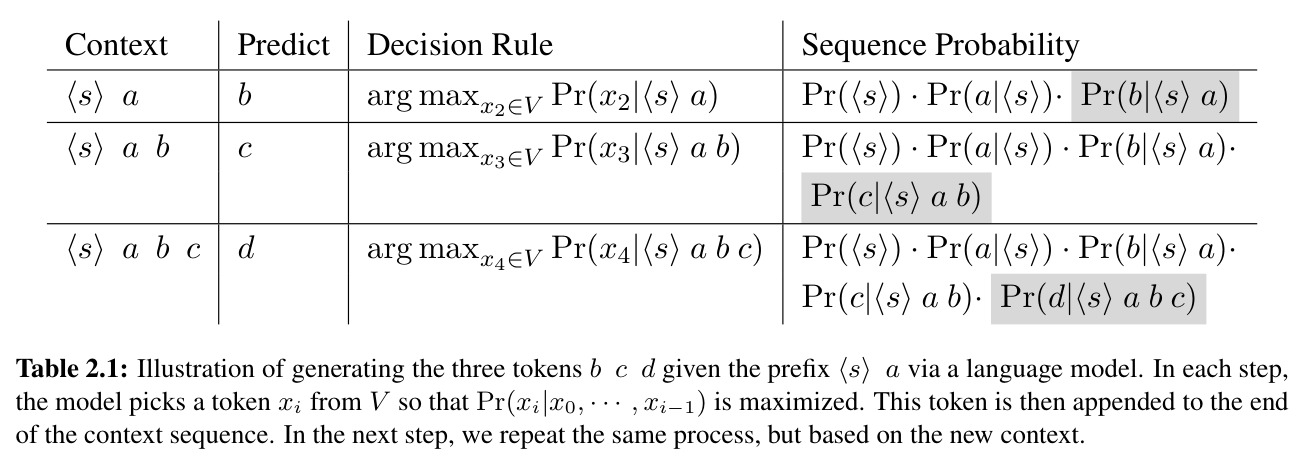
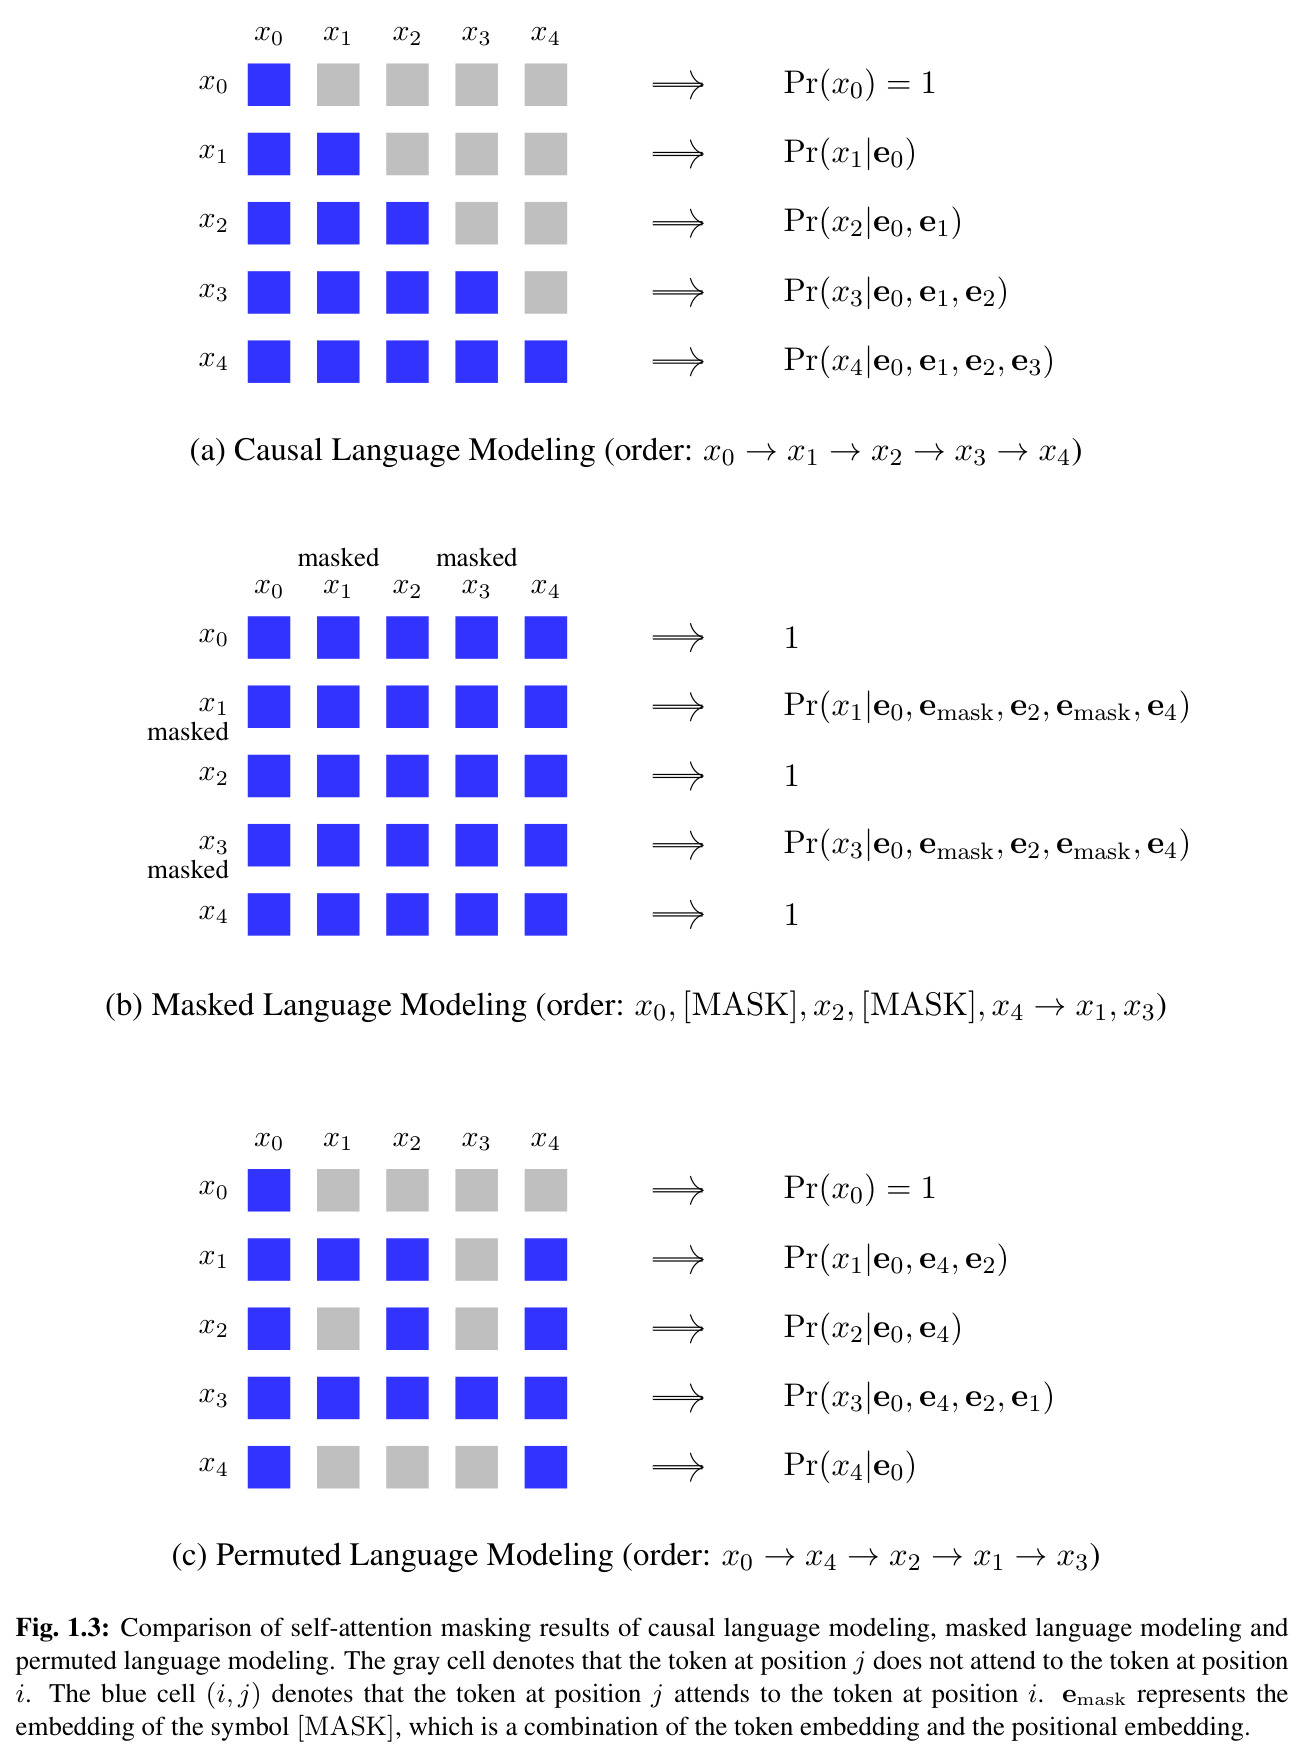
语言模型对下一个 token 的条件概率 $\Pr(y_i\mid x,y_{<i})$ 建模,训练目标是在语料上最大化对数似然 $\hat{\theta}=\arg\max_\theta\sum_{x}\sum_i\log\Pr_\theta(y_i\mid x,y_{<i})$,等价于最小化交叉熵损失。BERT 式掩码建模与之同源,只是把预测目标换成被遮盖的词。
预训练(第1章)、生成模型训练(第2章)、SFT(第4章)与推理学习(第6章)的所有损失函数都是这一目标的变形,是贯穿全书的数学主线。
强化学习基础(策略、奖励与 PPO)
强化学习把决策建模为智能体在状态 $s_t$ 下依策略 $\pi_\theta(a_t\mid s_t)$ 采取动作并获得奖励的过程。策略梯度以 $\nabla_\theta\log\pi_\theta(a_t\mid s_t)A(s_t,a_t)$ 方向更新参数,A2C 引入价值函数估计优势 $A(s_t,a_t)$,PPO 再用重要性采样构造替代目标并以 KL 惩罚限制策略偏移。
第4章的 RLHF 与第6章的过程监督推理训练都用这套语言描述 LLM 的对齐与优化,缺少 RL 词汇会完全读不懂相关章节。
KL 散度
KL 散度 $D_{\mathrm{KL}}(p\,\|\,q)=\sum_i p_i\log\frac{p_i}{q_i}$ 度量两个概率分布的差异,非负且不对称。在 LLM 中它既用于蒸馏(学生逼近教师的输出分布),也用于约束微调后的模型不偏离参考模型太远;DPO 更是从带 KL 约束的奖励最大化目标严格推导而来。
对齐章节的 KL 惩罚、DPO 的完整推导以及第6章在线策略蒸馏的损失函数全部以 KL 散度为核心构件。
KV 缓存与推理显存瓶颈
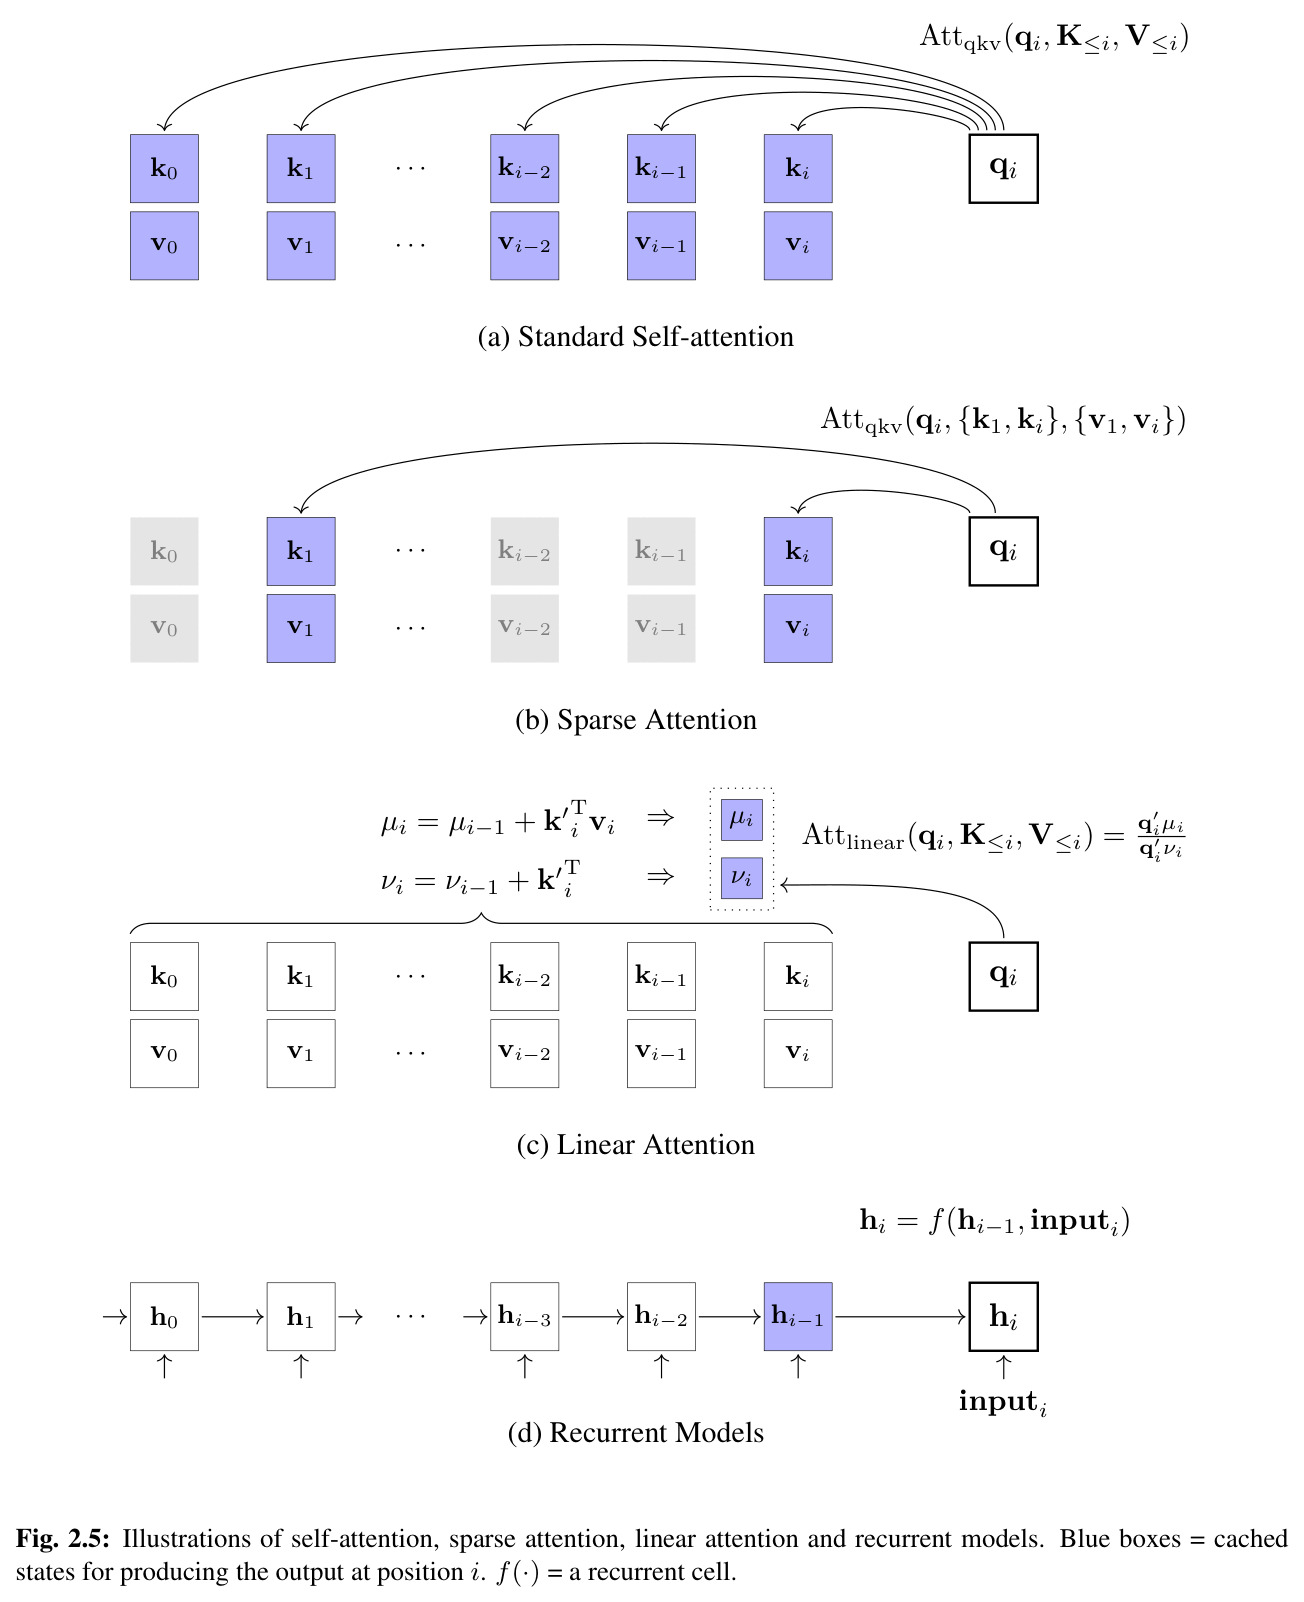
自回归解码时每生成一个 token 都要 attend 到之前所有位置的 Key/Value 向量,推理系统因此把它们缓存在显存中避免重复计算。缓存大小随序列长度与批大小线性增长,使解码阶段成为访存受限(memory-bound)而非计算受限的过程,这是推理加速必须解决的核心矛盾。
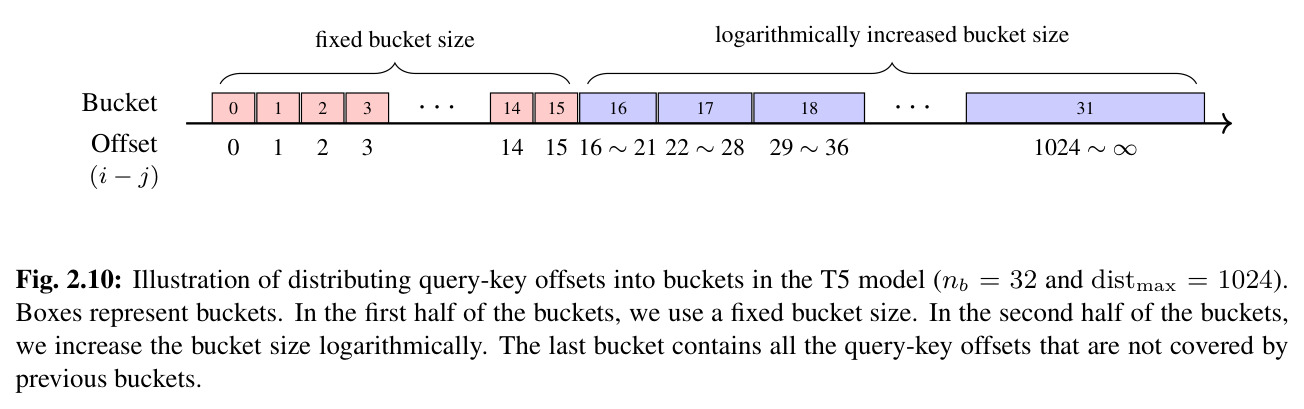
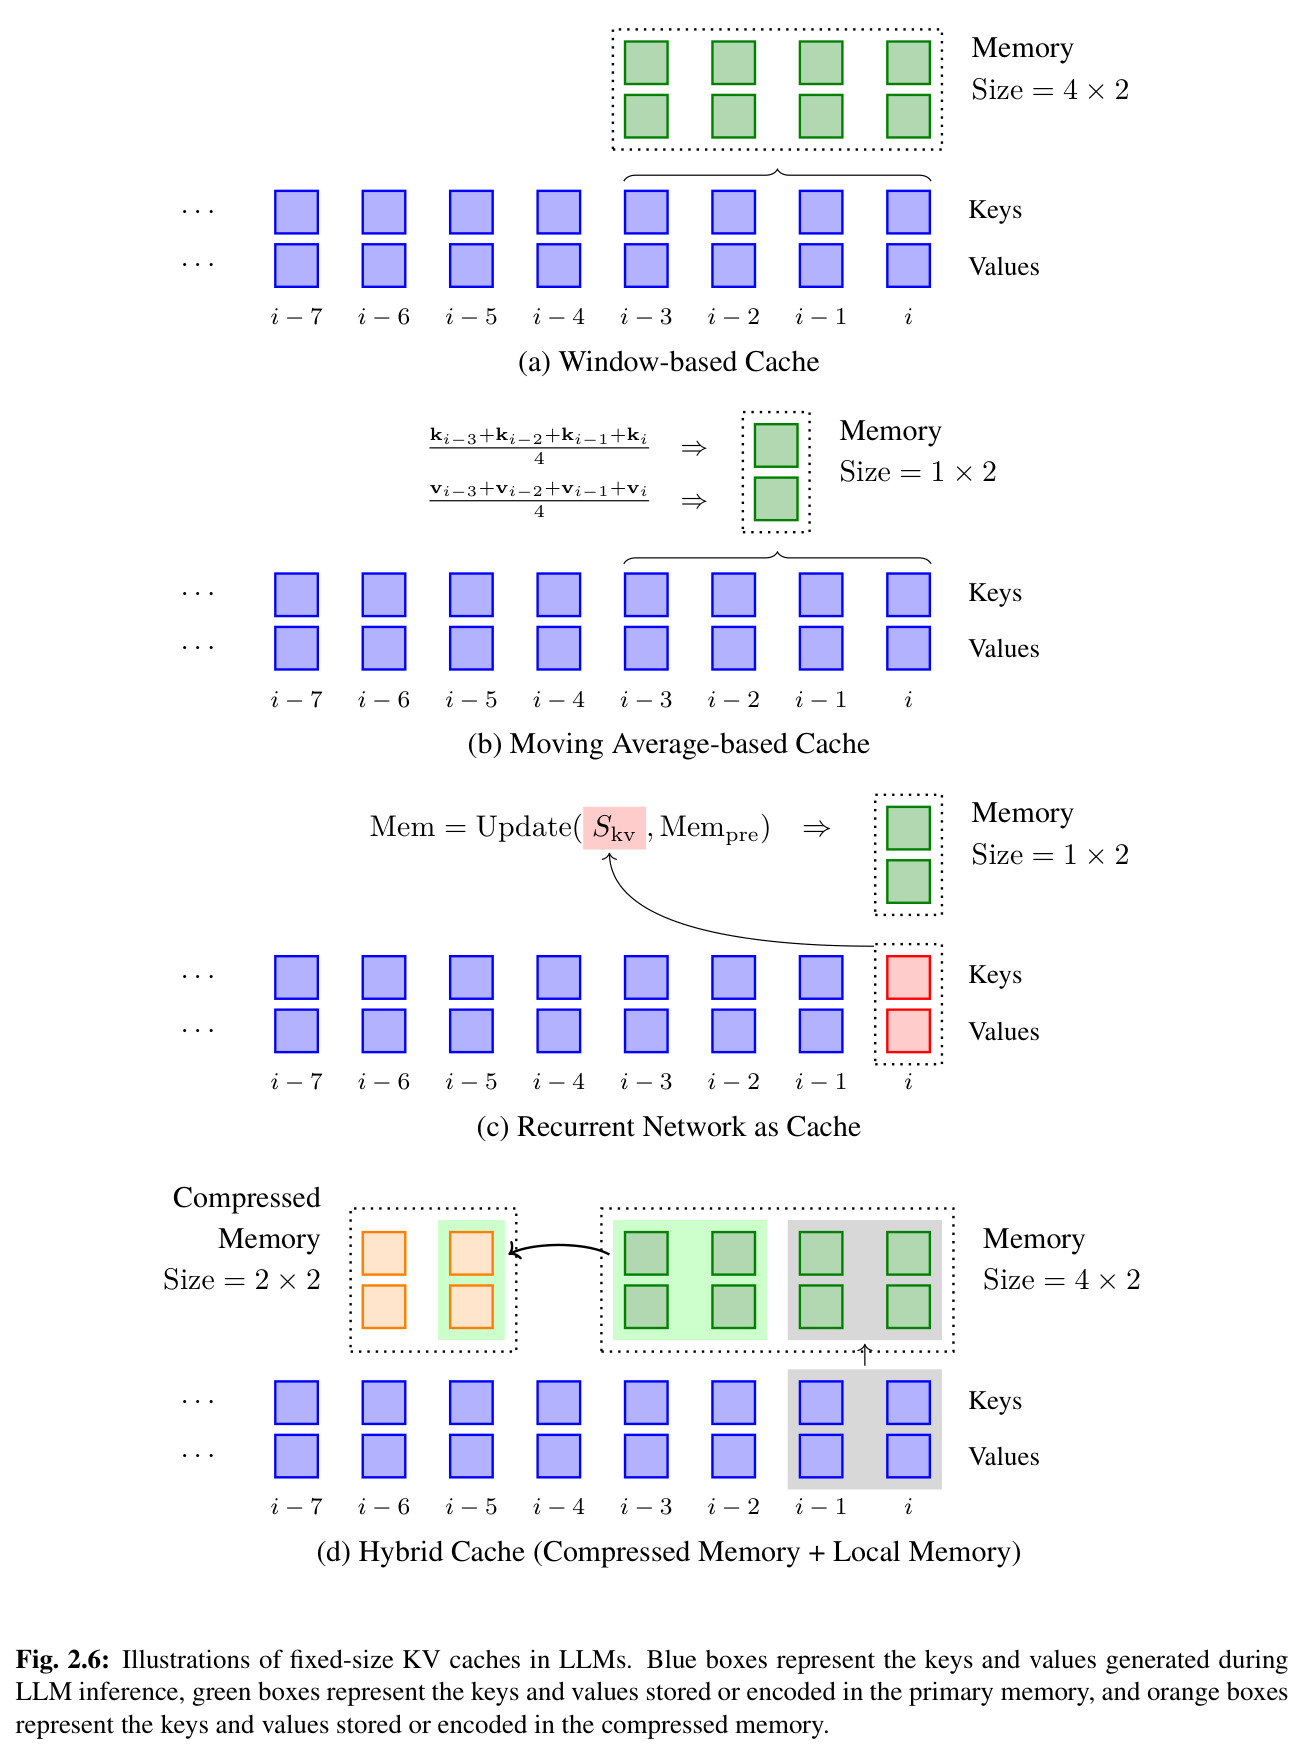
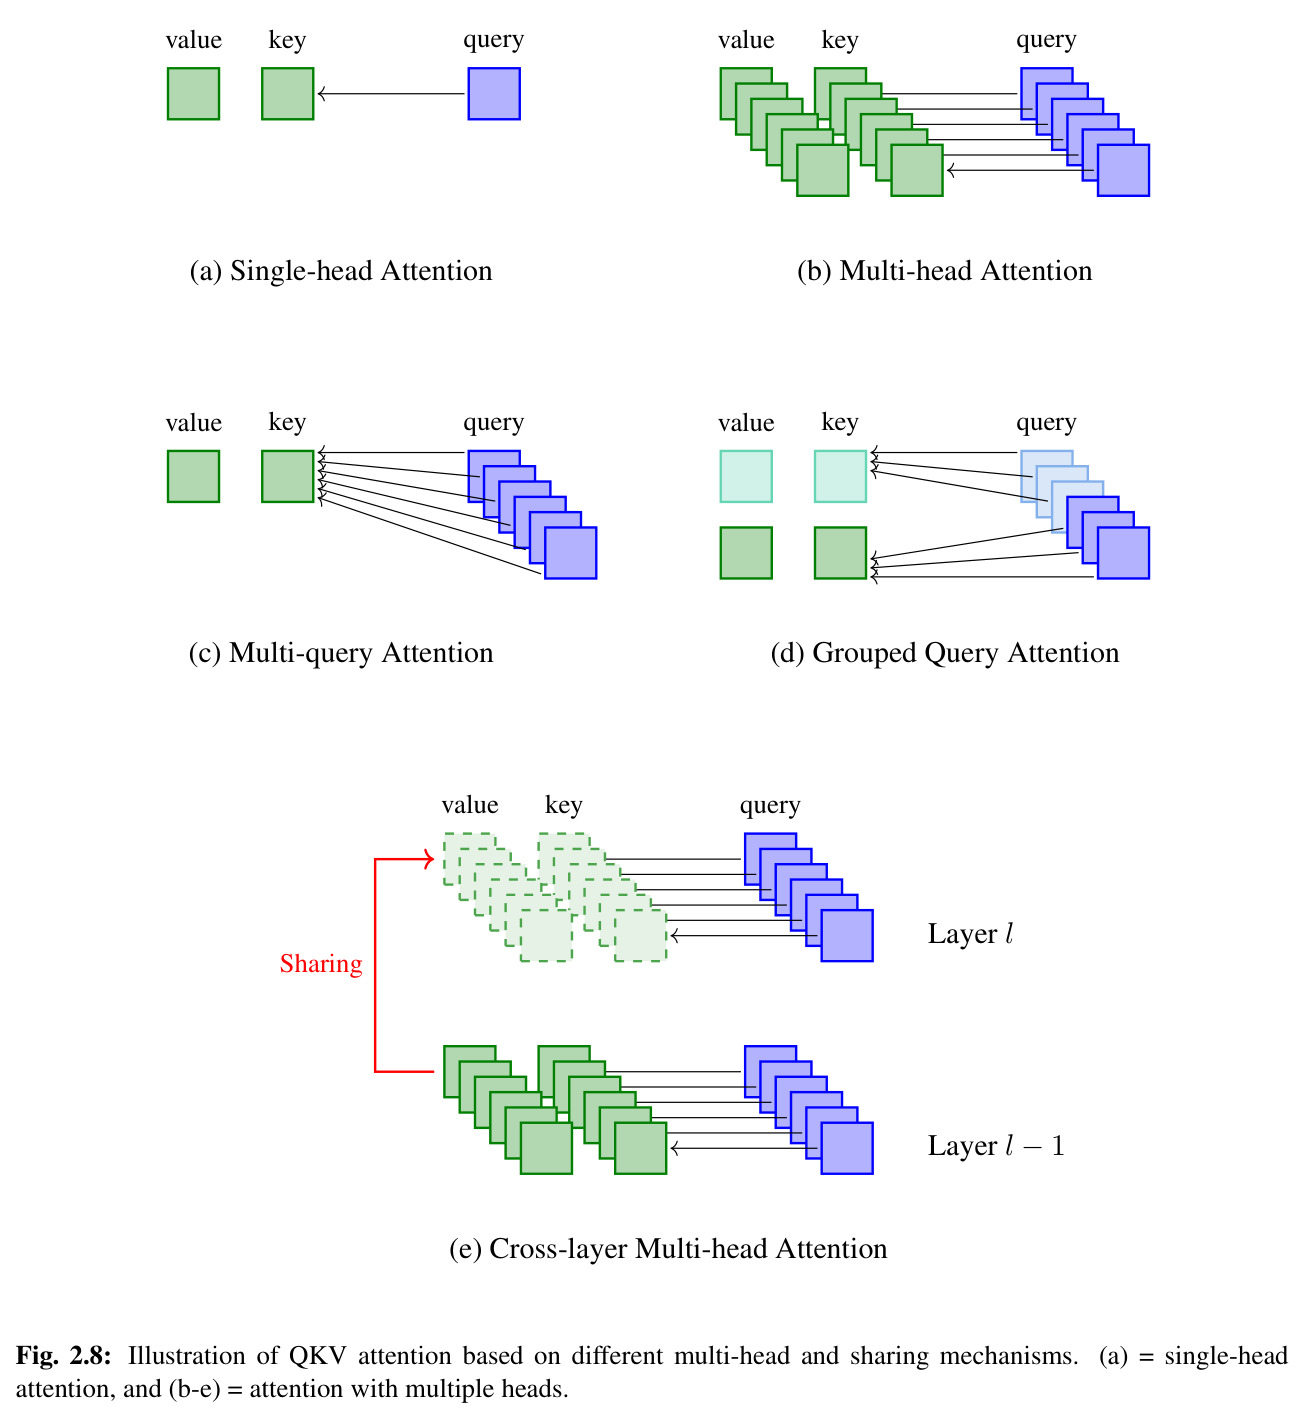
第2章长序列建模中的 MQA/GQA 与缓存压缩、第5章的 PagedAttention、continuous batching 等技术全部围绕 KV 缓存展开。
缩放定律与幂律拟合
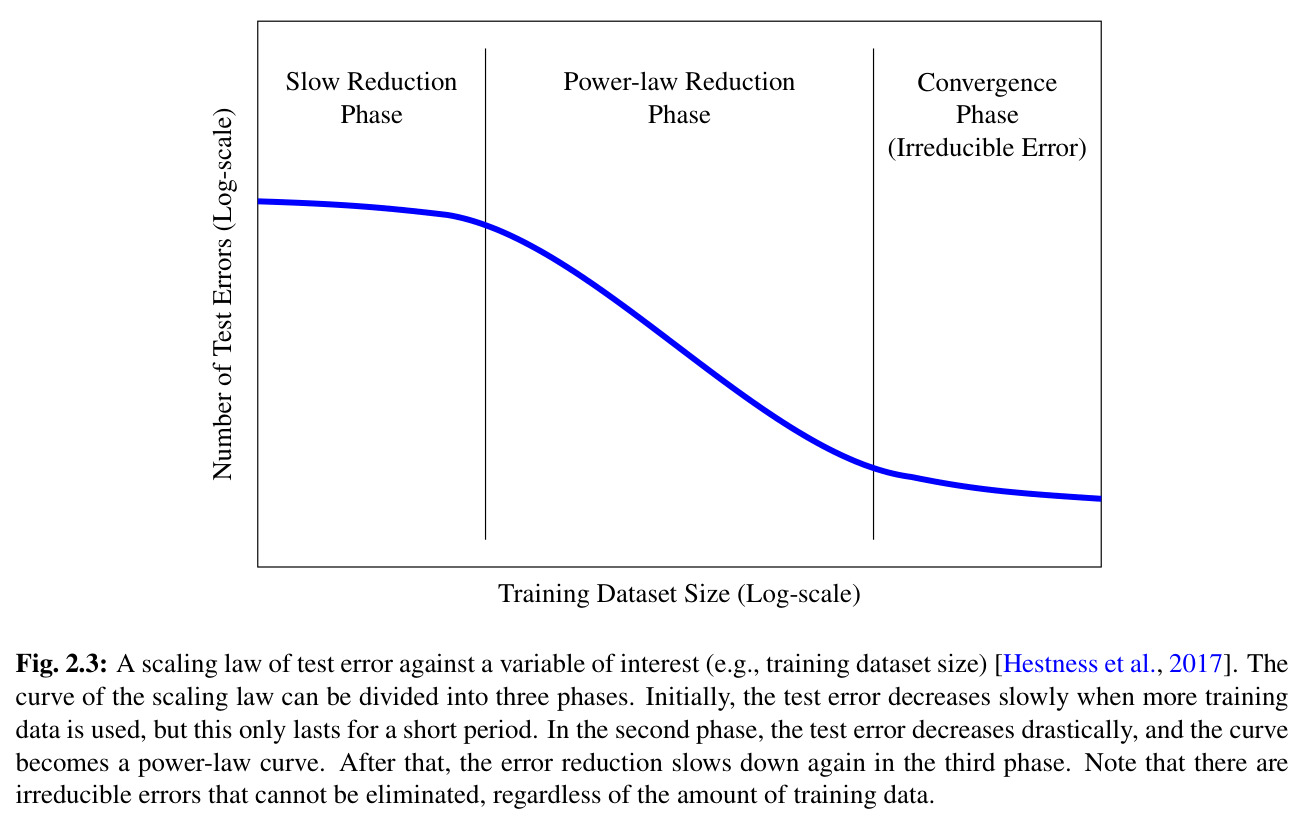
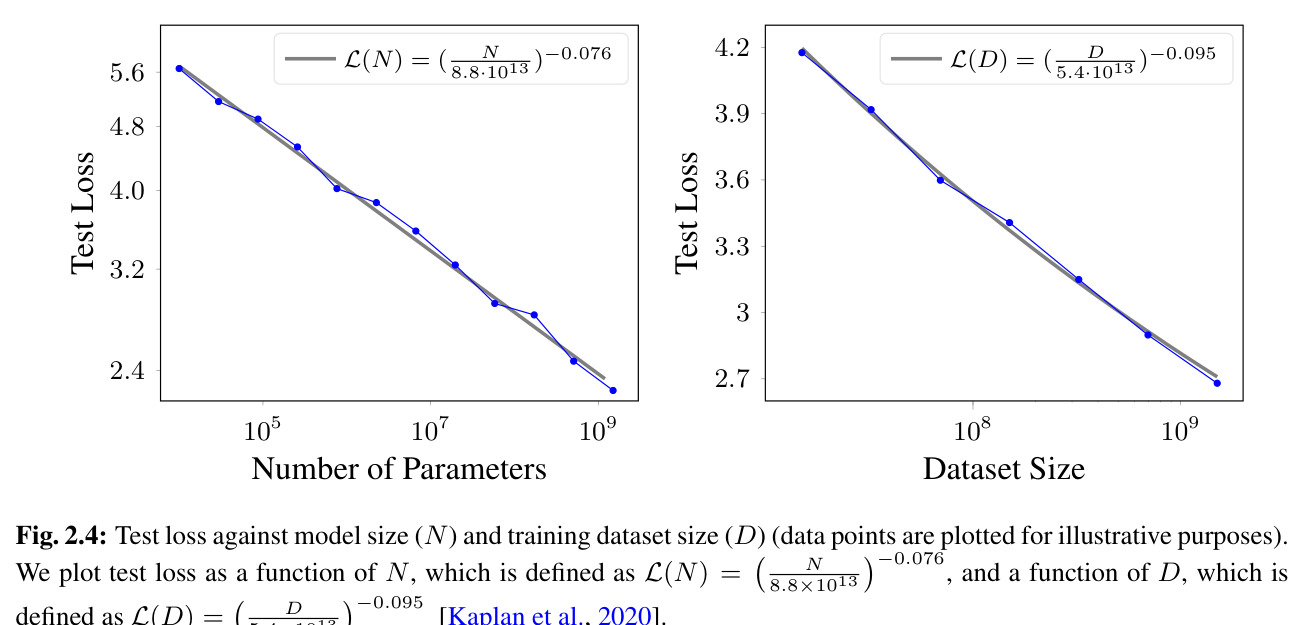
缩放定律用幂律函数刻画测试损失随模型参数量 $N$、数据量 $D$ 等因素的下降规律,如 Kaplan 的 $L(N)=(N_c/N)^{0.076}$、$L(D)=(D_c/D)^{0.095}$,以及加入不可约误差项的 Chinchilla 公式 $L(N,D)=\frac{406.4}{N^{0.34}}+\frac{410.7}{D^{0.28}}+1.69$。
它解释了社区为何持续扩大模型与数据规模,也是理解第2章训练策略与第5-6章推理时扩展(test-time scaling)的背景知识。
研究动机
大语言模型在 2020 年后爆发式发展,但相关知识高度碎片化:预训练、提示、对齐、推理加速、推理模型分散在成千上万篇论文中,术语与记号互不兼容,初学者很难建立完整图景。同时该领域迭代极快——从 BERT 的掩码语言建模,到 GPT-3 的 175B 参数、Llama3.1-405B 的 15.6T token 预训练,再到 o1 与 DeepSeek-R1 的长思维链推理——教材与课程严重滞后,工程人员往往只会调库而不理解每个环节的原理与代价(例如为何解码是访存受限、为何 RLHF 需要 KL 惩罚、为何 Chinchilla 主张少堆参数多补数据)。对非英语母语、缺乏系统科研训练的读者而言,缺少一份既讲清数学推导、又覆盖最新推理模型的系统入门资料,是进入该领域最现实的障碍。
本文的目标是本书的目标是以『基础』为准绳,用统一记号系统讲解大语言模型从构建到应用的完整技术栈:第1章讲预训练范式与 BERT;第2章讲生成式 LLM、大规模训练(数据准备、架构改造、分布式训练、缩放定律)与长序列建模;第3章讲提示工程、上下文学习、思维链与自动/软提示设计;第4章讲指令微调与 RLHF、DPO 对齐;第5章讲解码算法、推理加速系统与推理时扩展;第6章讲推理模型的训练与评测。作者希望读者读完后能理解每个模块的输入输出、关键公式与设计动机,具备跟踪前沿和动手实践的能力;各章尽量自成体系,即使没有 Transformer 基础也不至于无法阅读。
与已有工作不同的是,本书的独特之处在于教科书式的统一视角:它不是罗列最新论文的综述目录,而是把现代 LLM 技术与经典 NLP/机器学习思想贯通起来——例如把 RLHF 的奖励模型与判别式打分模型对照,把 self-consistency 解释为最小贝叶斯风险搜索,把弱到强泛化归结为知识蒸馏问题,把过程监督的奖励整形 $r_t=v_t-v_{t-1}$ 与 RL 中的 reward shaping 相衔接。全书选自 NiuTrans 实验室多年教学积累的 NLPBook 项目(github.com/NiuTrans/NLPBook),每章自成体系、公式推导完整(如从 KL 约束优化逐步消去配分函数推出 DPO 损失),并专节讨论『LLM 能否真正推理』这类批判性问题,这在只有论文堆砌式综述的现有文献中是明显的差异化贡献。
核心方法
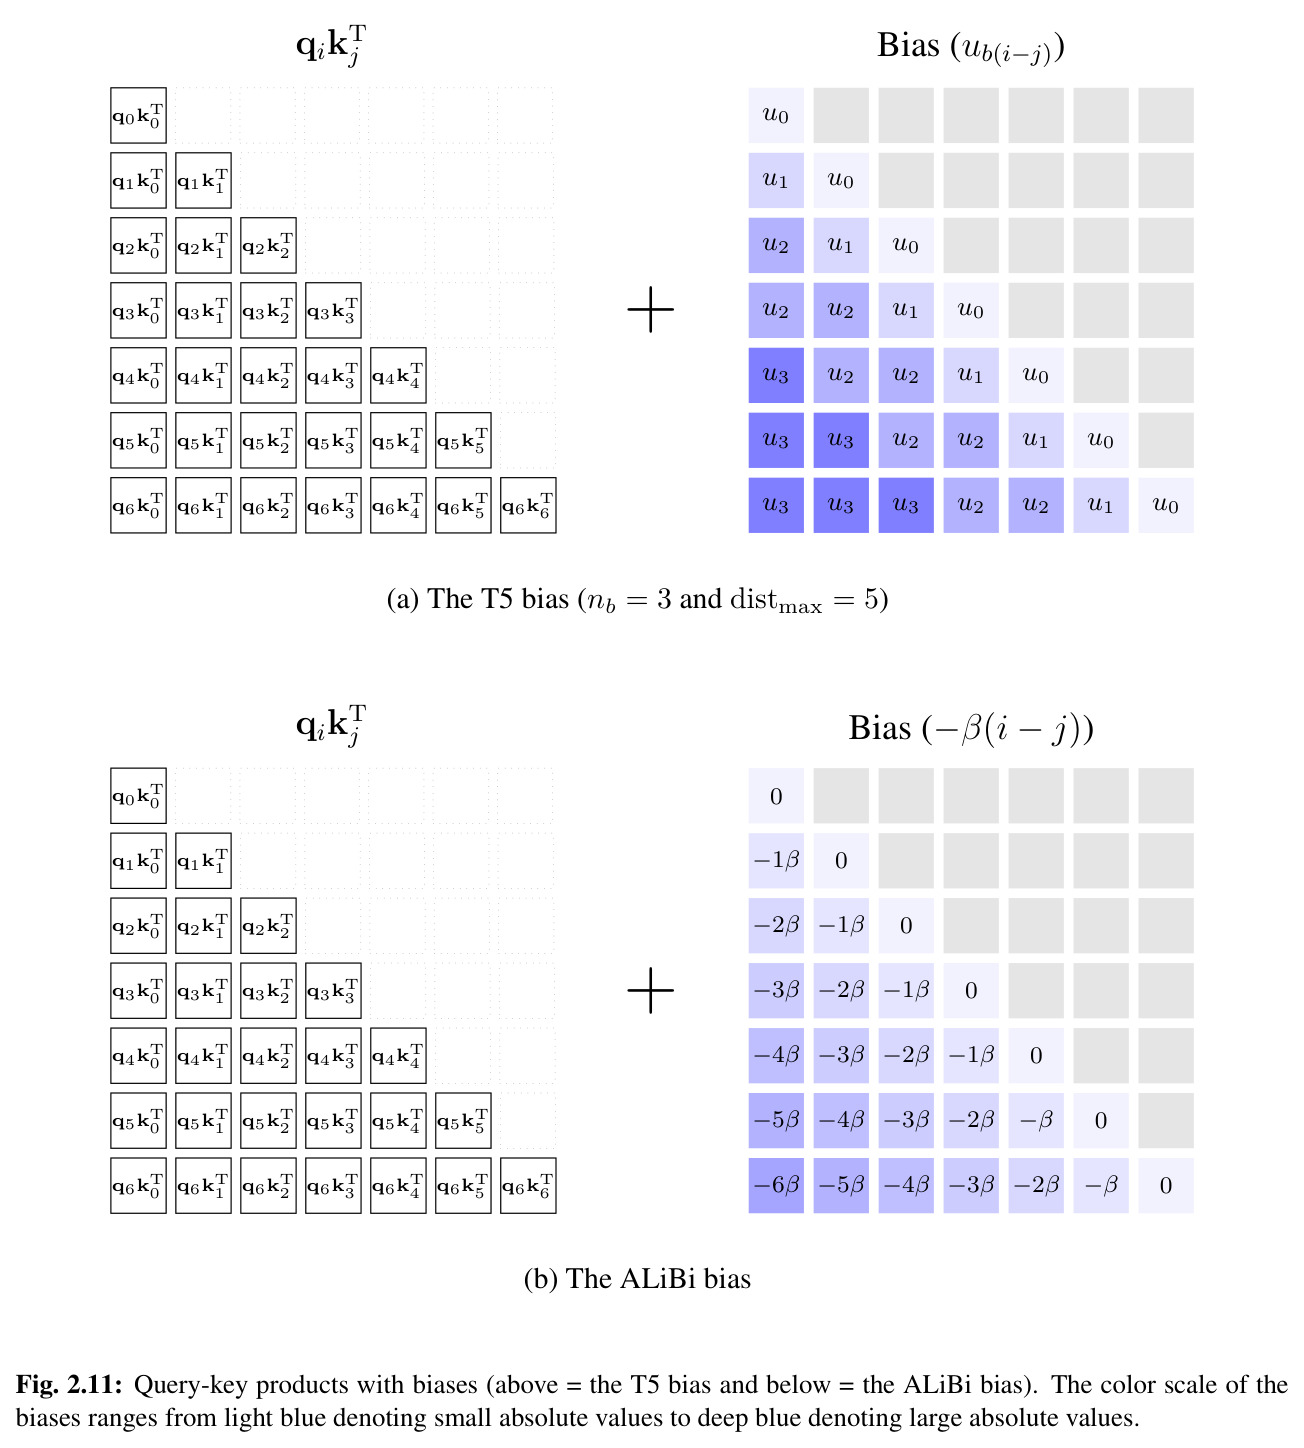
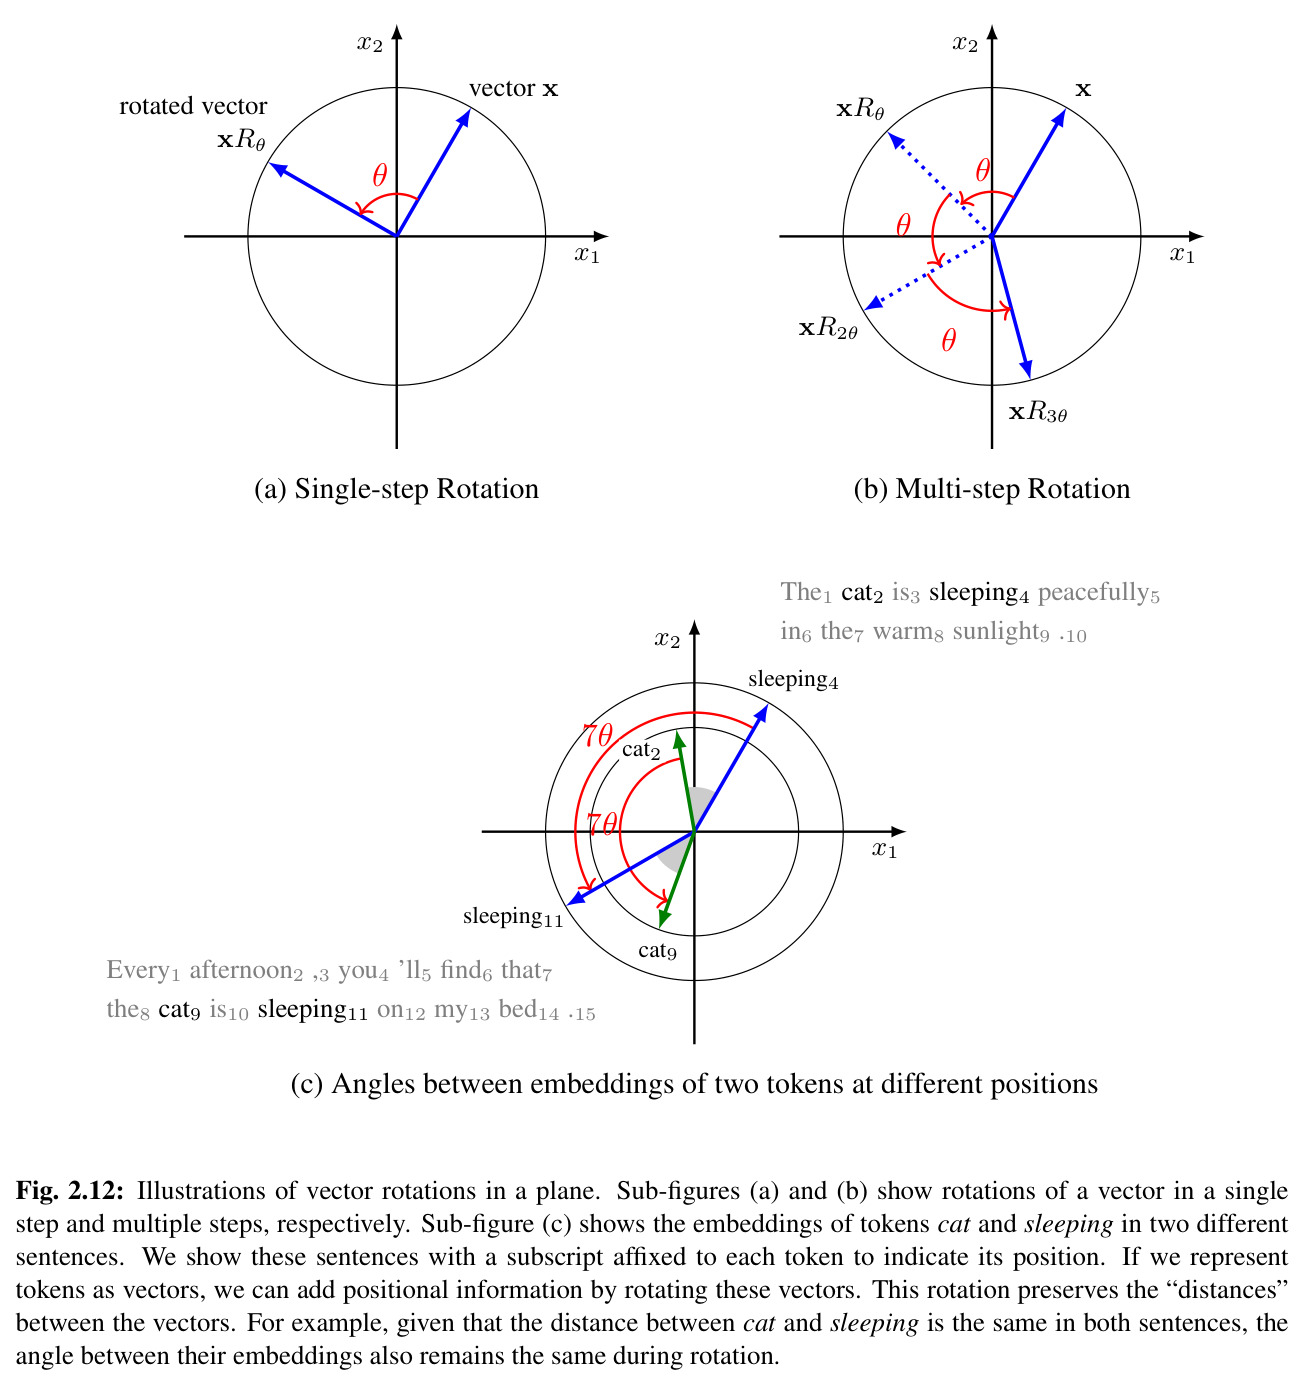
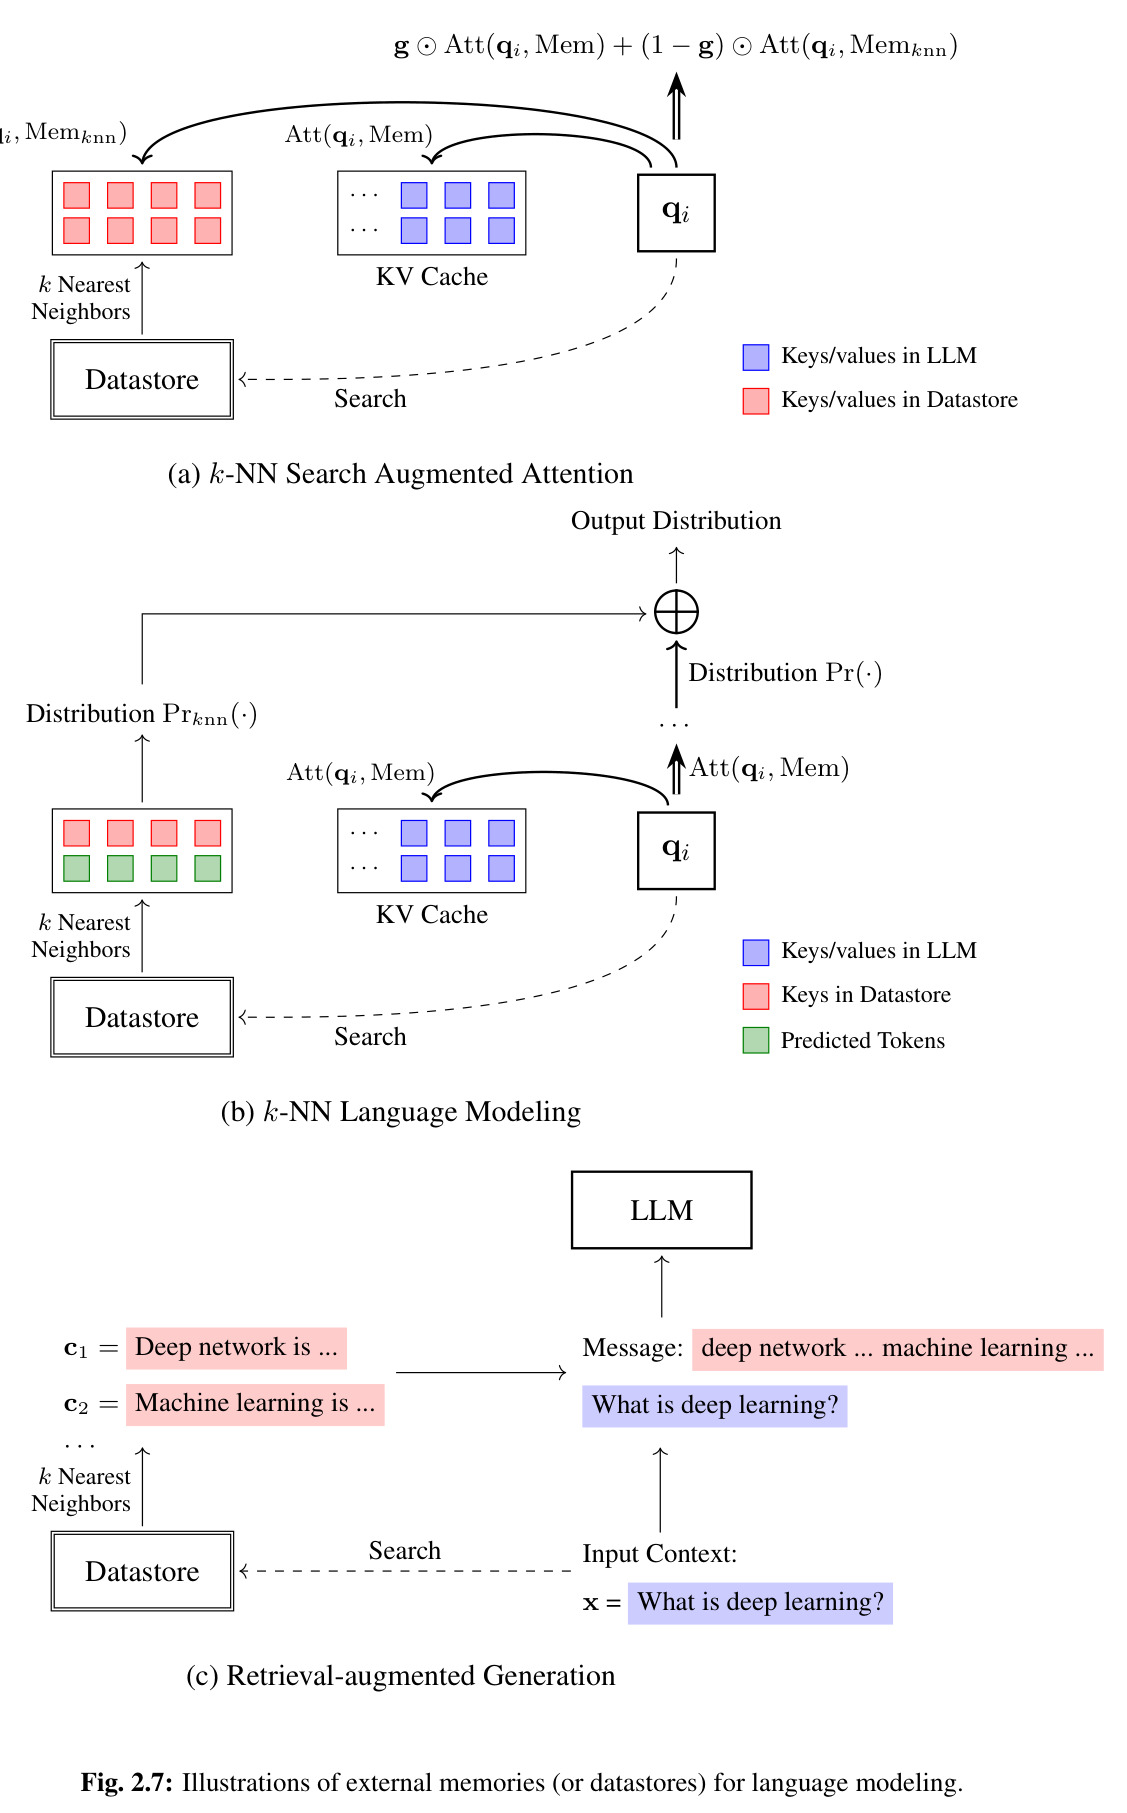
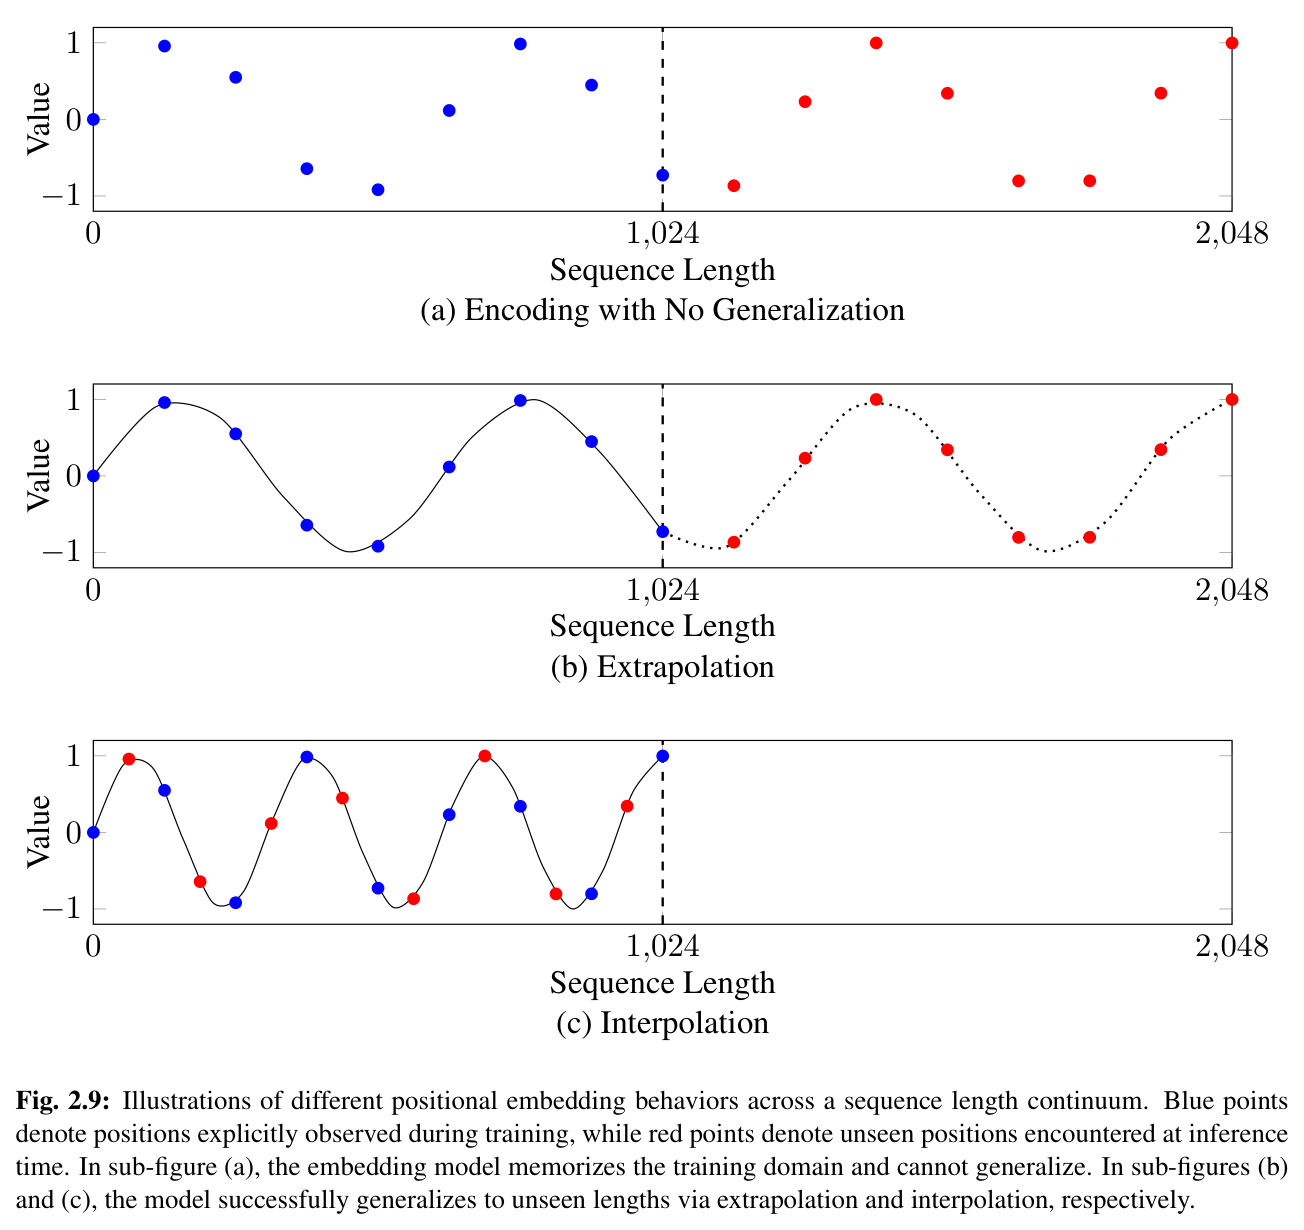
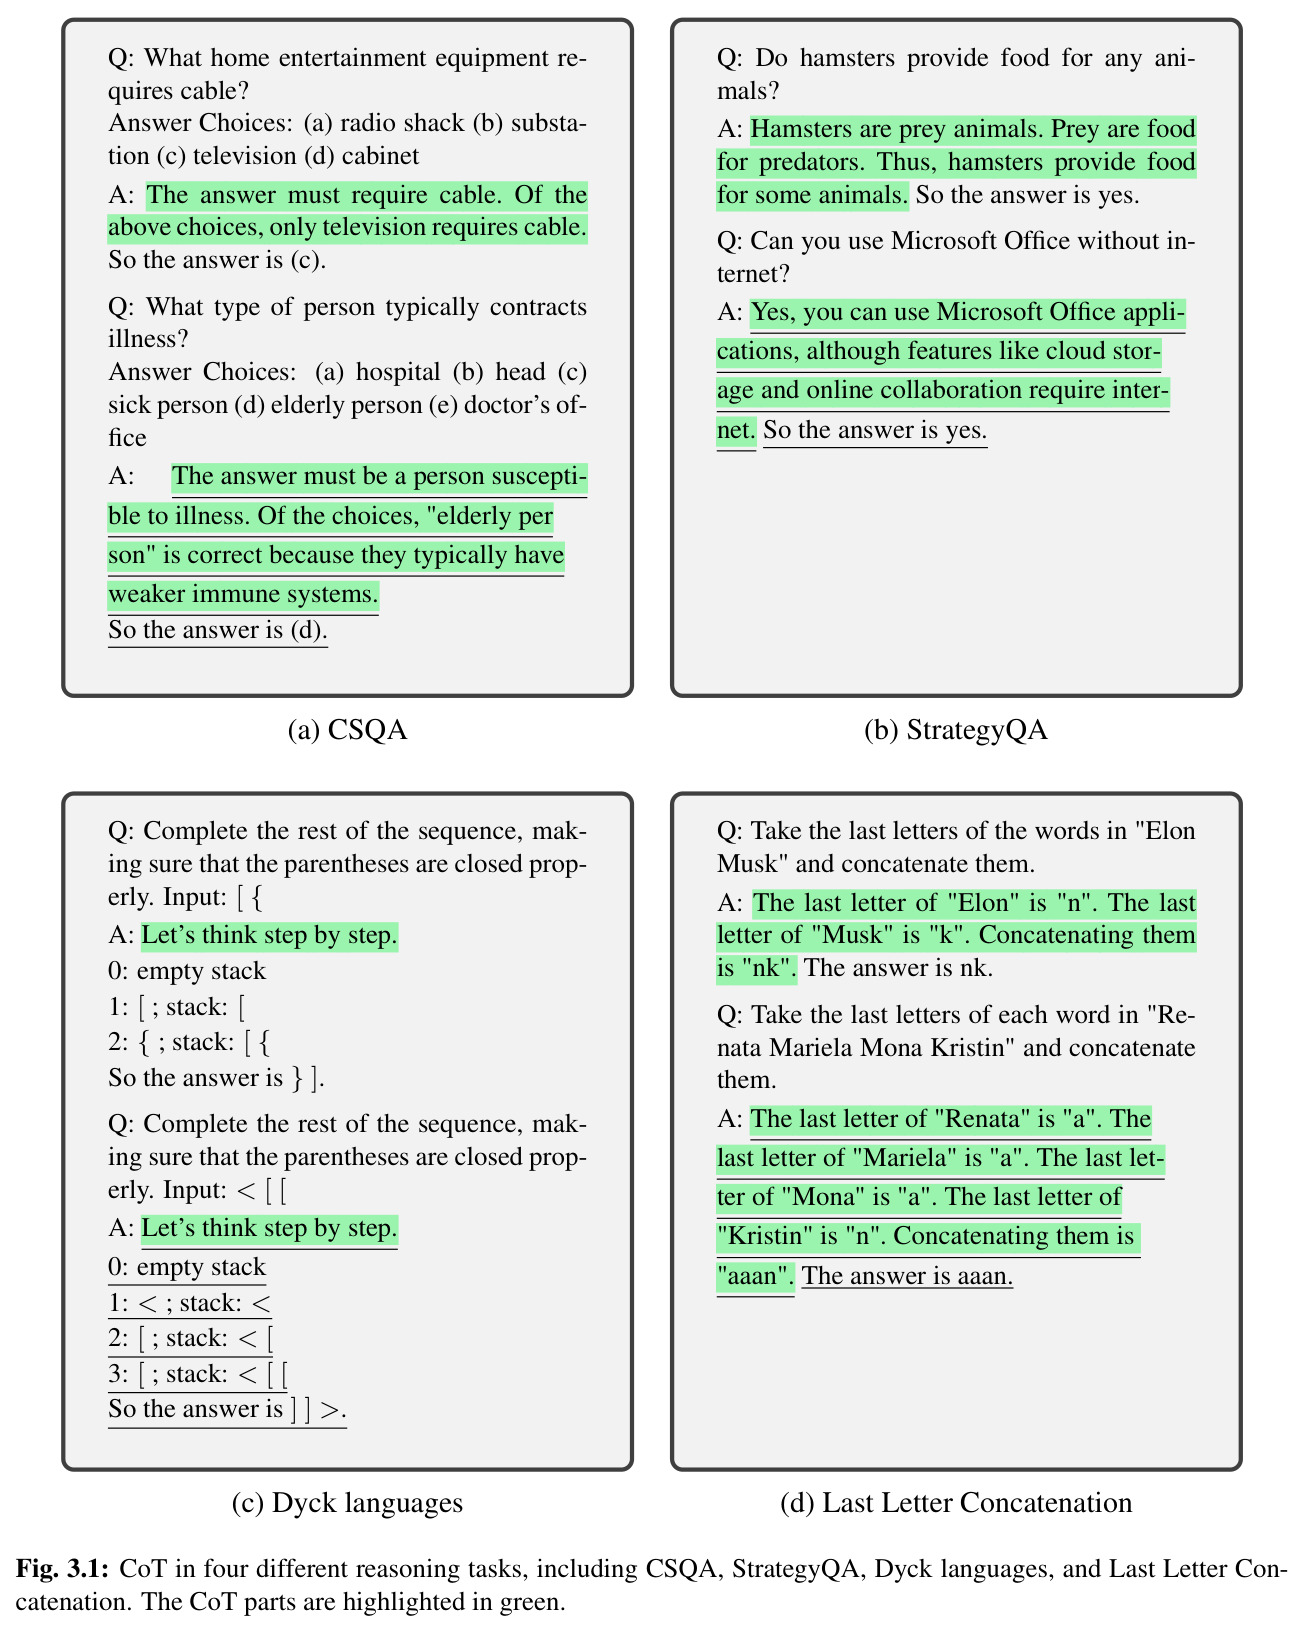
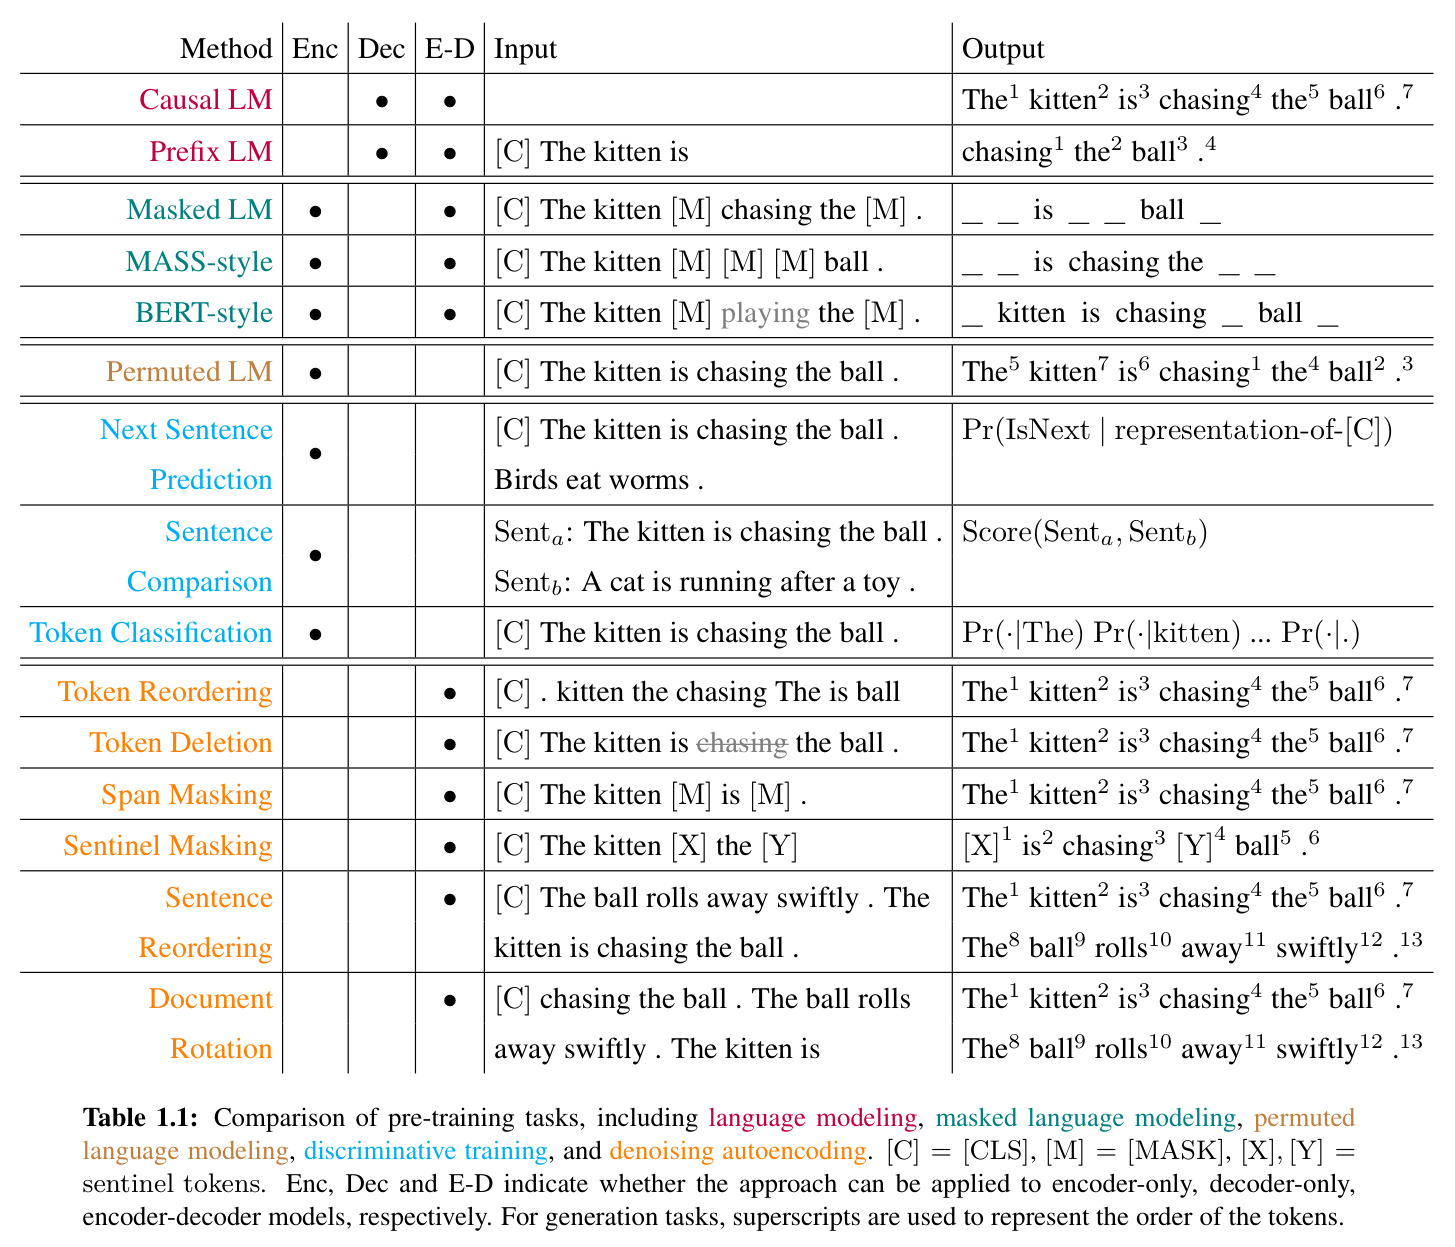
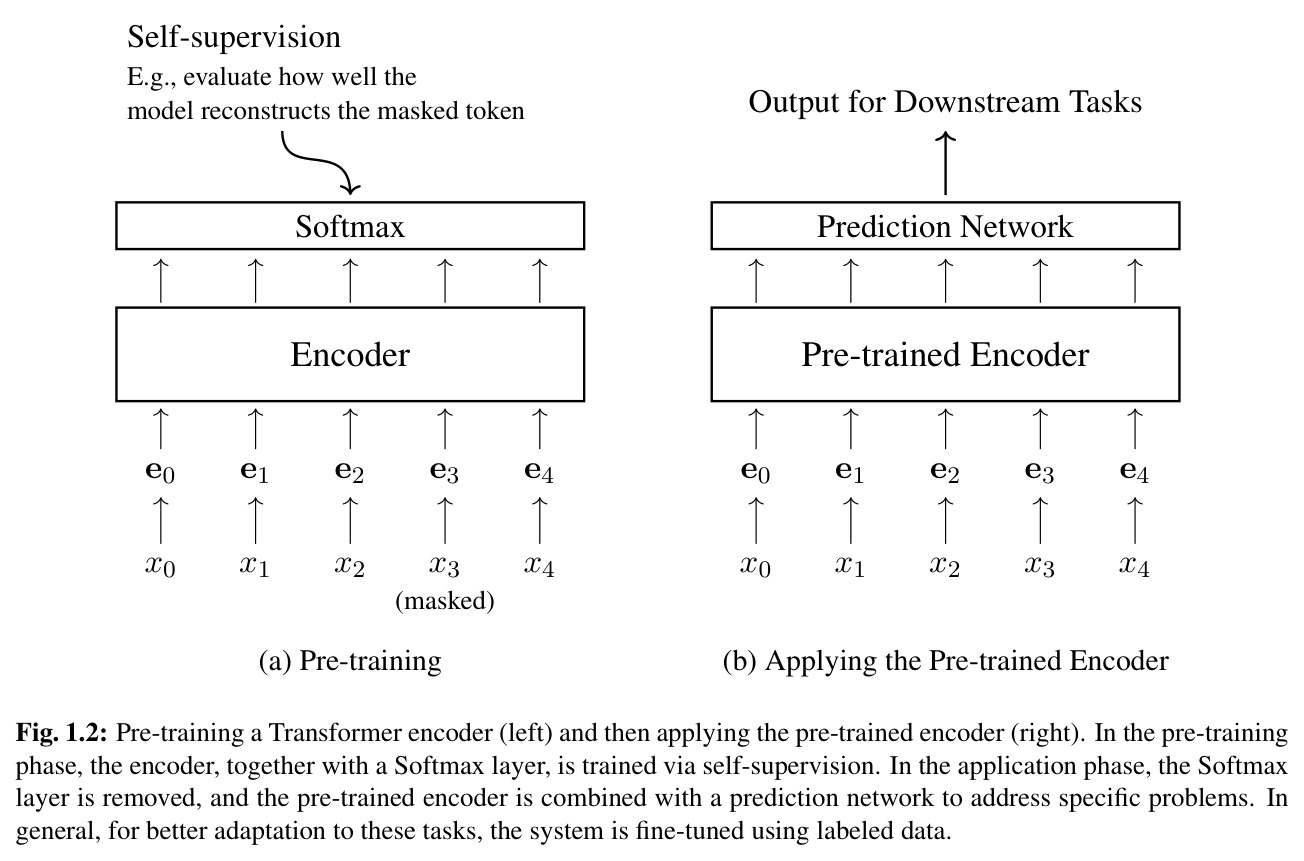
直觉上,本书把大语言模型的发展组织成一条『先预训练、后适配』的主线:先用自监督任务在海量无标注文本上训练基础模型,再通过微调、对齐或提示把通用能力转化为具体任务能力。技术路线上,第1章从无监督/有监督/自监督三种预训练范式的对比出发,给出语言建模、掩码语言建模、置换语言建模、去噪自编码等任务的统一形式,并以 BERT 为完整示例;第2章转向 decoder-only 生成模型,讨论数据准备(质量、多样性、偏见、隐私)、模型改造(Pre-Norm、SwiGLU、RoPE 等)、数据/张量/流水线并行、Kaplan 与 Chinchilla 缩放定律,以及长上下文的 KV 缓存压缩、MQA/GQA 与位置外推/插值;第3章覆盖从 few-shot 提示到思维链、问题分解、自我修正、集成、RAG 与工具使用,再到自动提示优化与软提示;第4章给出 SFT → RLHF → DPO 的对齐流水线;第5章把推理拆成 prefilling 与 decoding 两阶段并讨论解码算法与系统级加速;第6章从提示推理、推理时扩展与过程监督训练三条路径解释 o1/R1 类推理模型。
核心思想是用一套数学记号贯通所有 LLM 技术。书中把各种方法还原为概率建模框架下的本质:预训练任务都是对 $\log\Pr(\cdot\mid\cdot)$ 不同条件形式的构造;解码是搜索问题 $\hat{y}=\arg\max_y\log\Pr(y\mid x)$;对齐是在 KL 约束下的奖励最大化,其闭式解 $\pi^*(y\mid x)\propto\pi_{\mathrm{ref}}(y\mid x)\exp(r(x,y)/\beta)$ 直接导出 DPO;推理时扩展则是搜索空间扩展加验证器。与已有工作的本质区别在于:市面综述多为文献分类与结论罗列,本书提供可推导、可复算的数学主线,并把『训练时扩展』与『推理时扩展』这对概念作为组织新范式的钥匙(见 Table 6.1 的五维对比)——更大模型与更长思考之间存在成本权衡,小模型配合推理时计算扩展可以胜过大模型的即时作答。
方法步骤详情
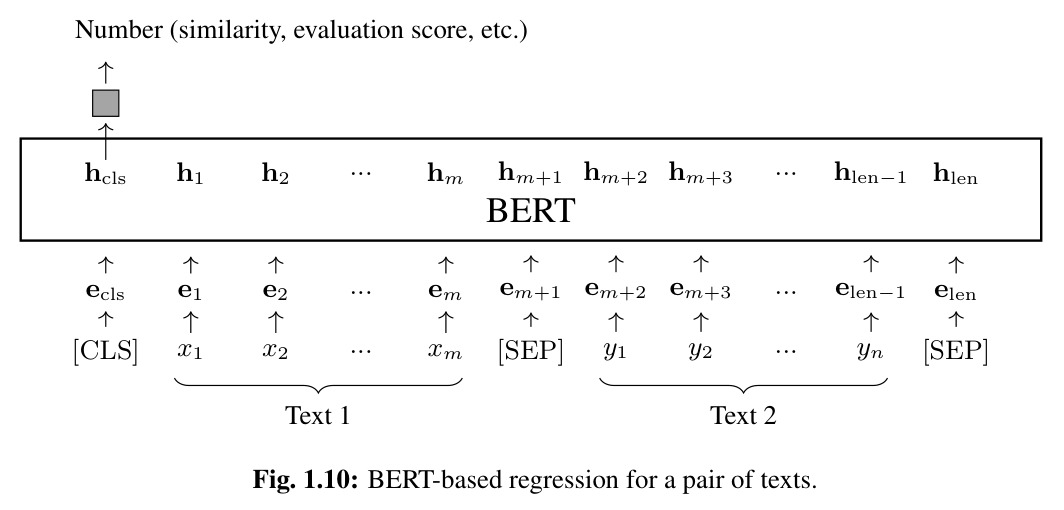
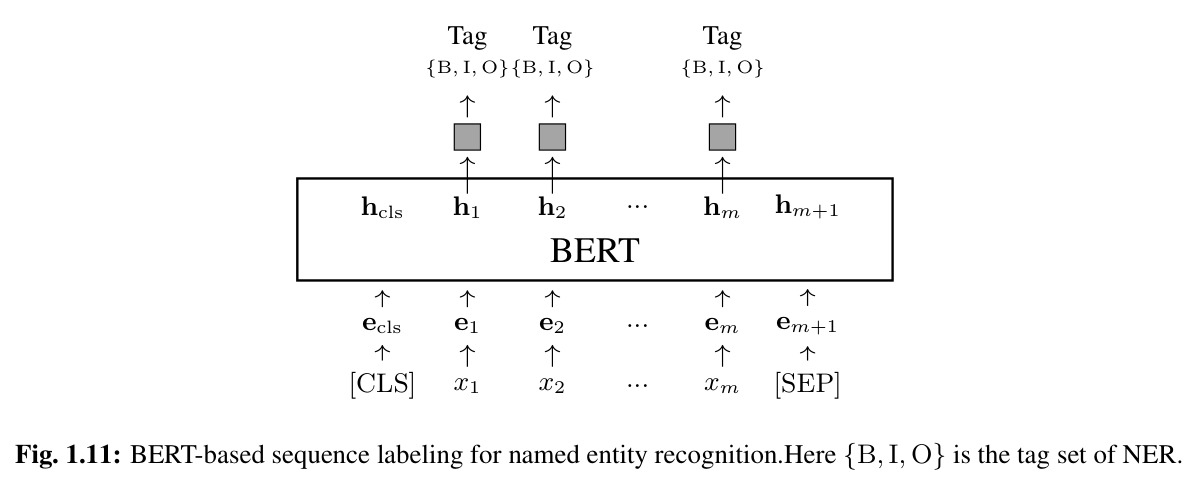
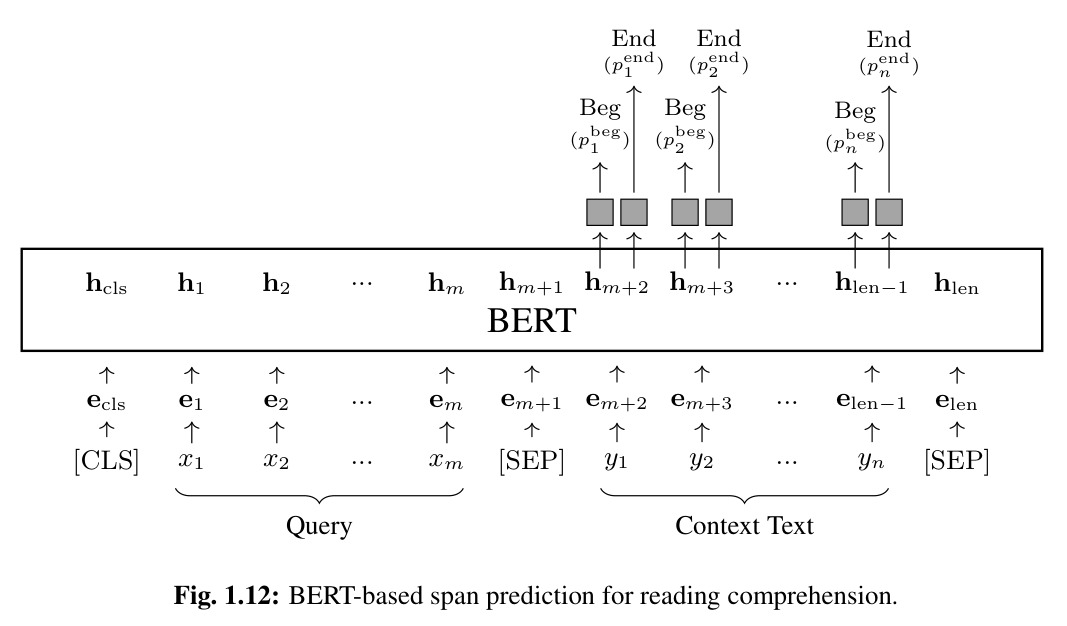
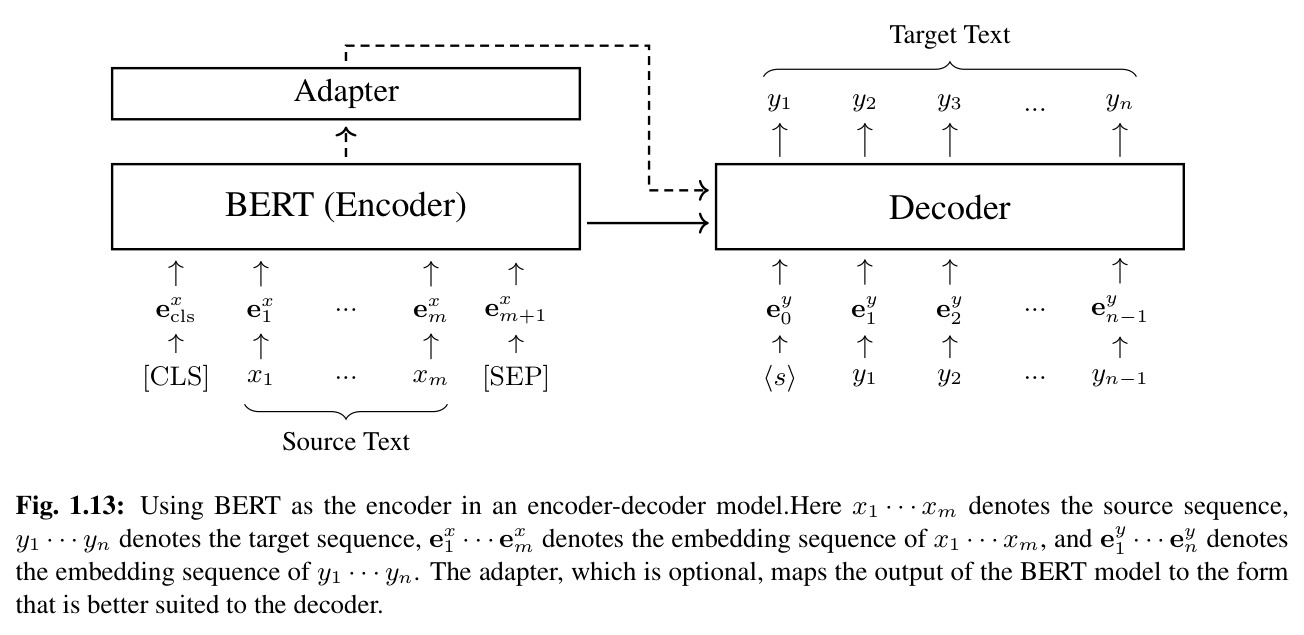
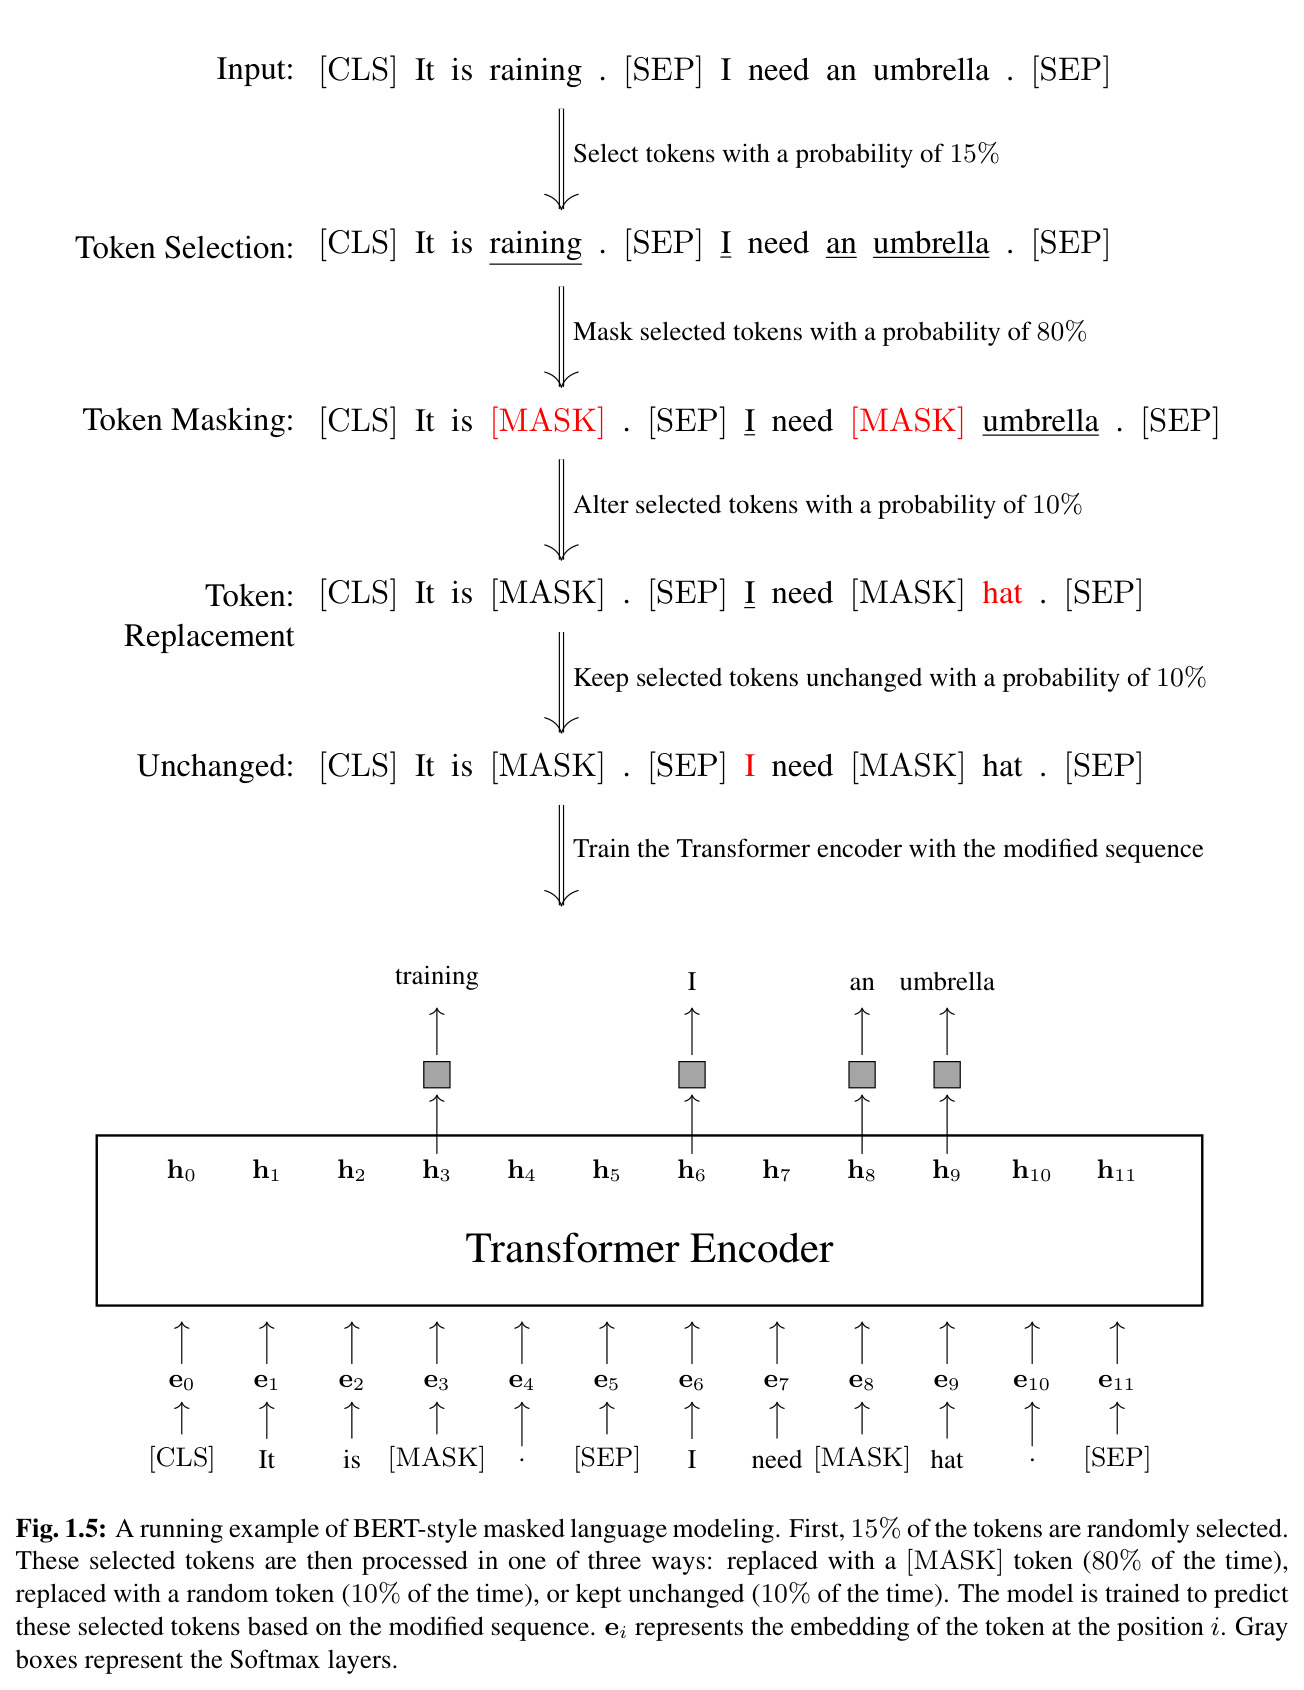
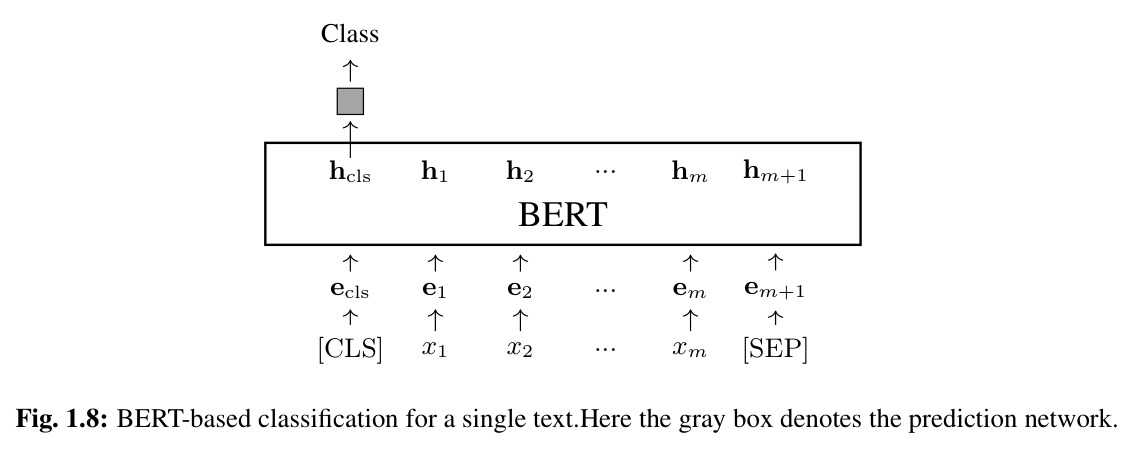
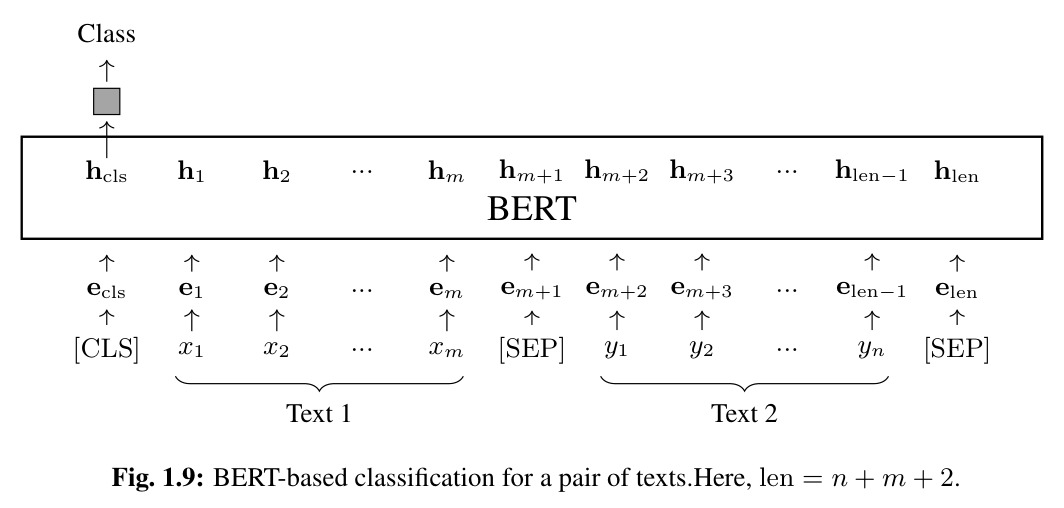
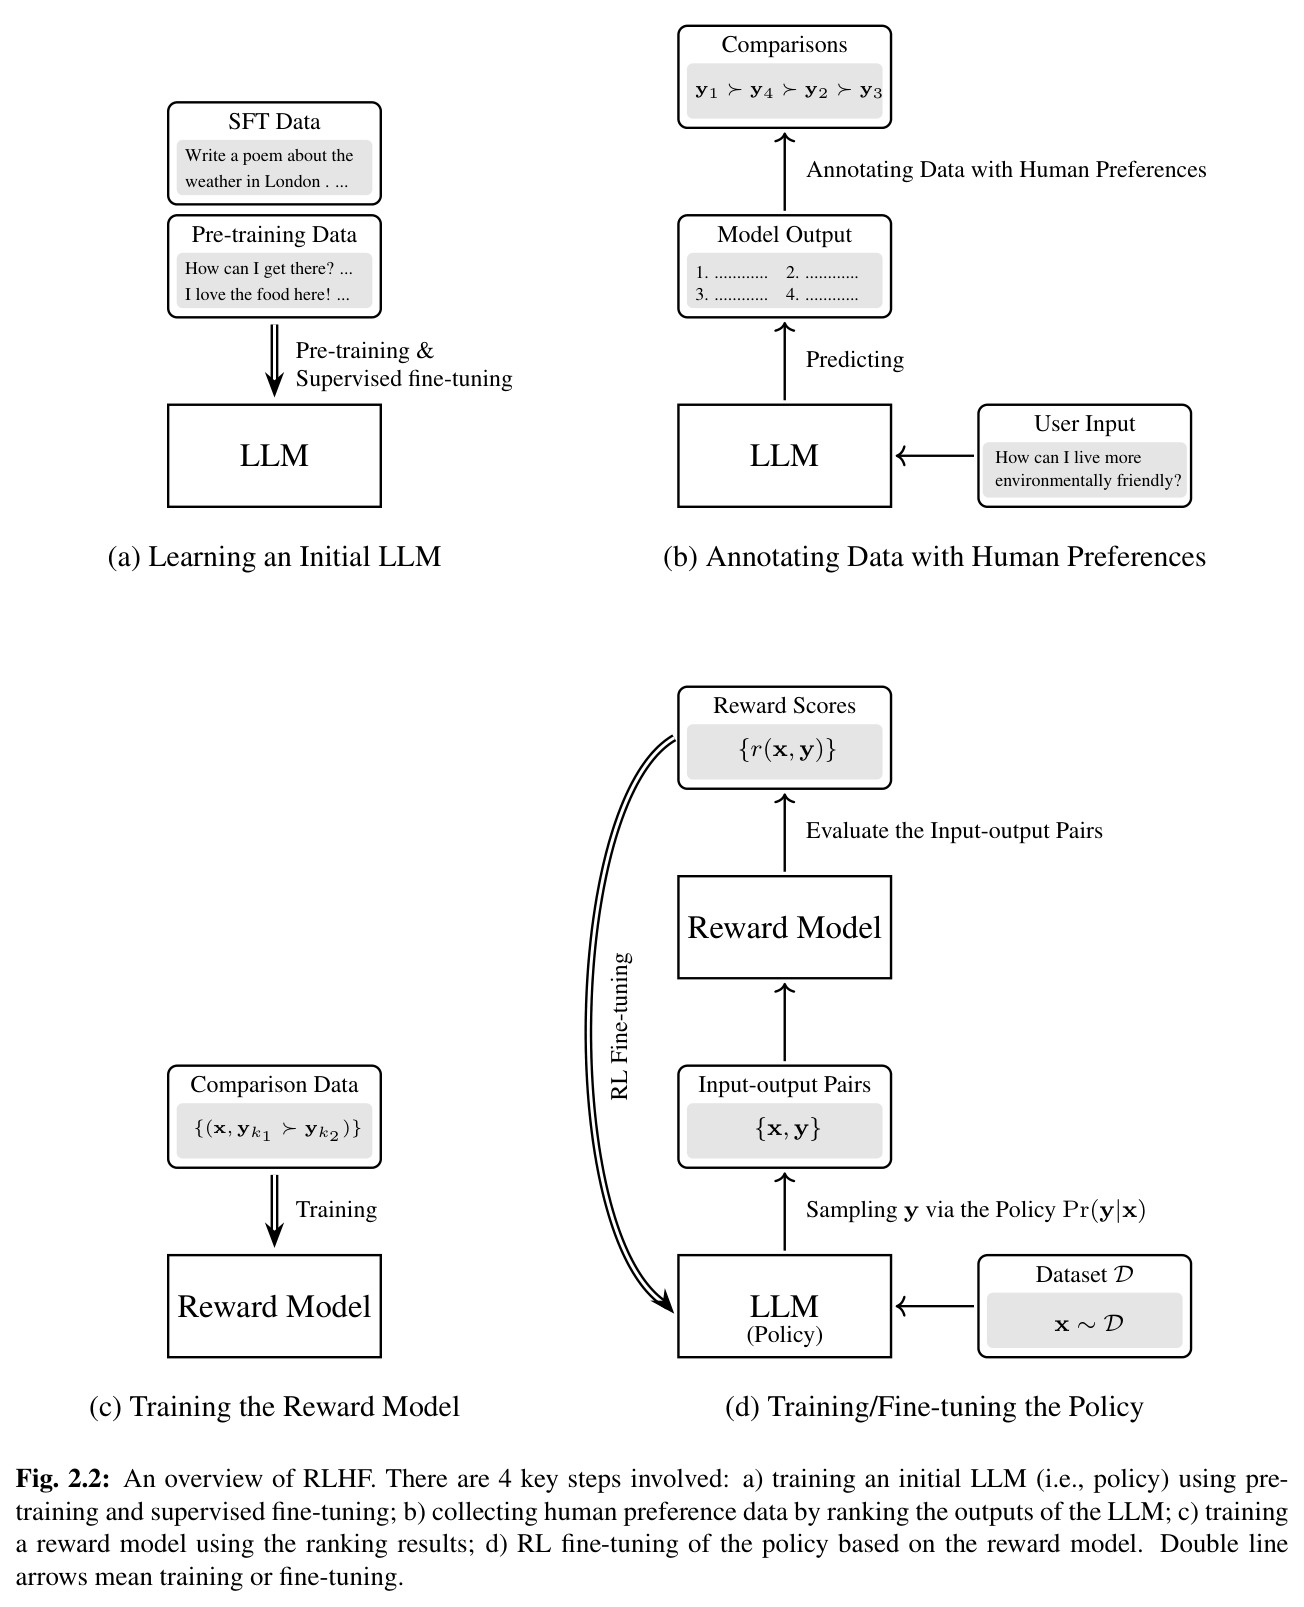
全书按六步推进。第一步(第1章)定义统一序列模型 $o=g_\theta(x_0,\dots,x_m)$,剖析 decoder-only、encoder-only、encoder-decoder 三类预训练任务(Table 1.1),并以 BERT 为例走通 15% 随机遮盖、80/10/10 替换、损失 $\mathrm{Loss}_{\mathrm{BERT}}=\mathrm{Loss}_{\mathrm{mlm}}+\mathrm{Loss}_{\mathrm{nsp}}$ 的训练流程。第二步(第2章)给出极大似然目标与模型规模数据,讲数据清洗、Pre-Norm/SwiGLU 架构改造、DP/TP/PP 并行、Kaplan 与 Chinchilla 缩放定律,再处理长序列:IO 优化、稀疏/线性注意力、MQA/GQA、RoPE 外推与位置插值。第三步(第3章)从基础提示设计讲到上下文学习、思维链(含 zero-shot 版)、问题分解、自我修正、self-consistency 集成、RAG 与工具调用,再到自动提示优化与软提示。第四步(第4章)推导 SFT 损失、self-instruct 数据合成、Bradley-Terry 奖励模型 $r(x,y)=h_{\mathrm{last}}W_r$、PPO 训练与 KL 惩罚,再到 DPO 损失 $\mathcal{L}_{\mathrm{dpo}}(\theta)=-\mathbb{E}\log\Pr_\theta(y_a\succ y_b\mid x)$。第五步(第5章)定义 prefilling/decoding 两阶段框架(Table 5.1)、贪心/束搜索/top-$k$/top-$p$/投机解码等算法、TTFT/ITL 指标与 PagedAttention 等系统优化。第六步(第6章)讨论推理模型:多路径采样、树搜索、生成式与形式化验证器、 监督数据、过程奖励整形、在线策略蒸馏,以及 RL 的 S 形缩放曲线与 Pass@k、Cons@k 评测。
技术新颖性
作为教材型综述,其新颖性体现在三点。其一,覆盖范围的完整性:它较早把推理模型(o1/DeepSeek-R1 式长思维链、过程监督、在线策略蒸馏、生成式验证器)纳入基础教材体系,并收录了 RL 计算量与推理性能呈 S 形曲线等 2025-2026 年的最新实证结论。其二,推导的严格性:书中不止给出公式,还保留完整推导链——例如从 KL 约束的奖励最大化出发,经配分函数 $Z(x)$ 的消去得到 DPO 损失;或证明过程奖励的伸缩求和 $R(x,y)=\sum_t(v_t-v_{t-1})=v_{n_p}-v_0$ 与最终步骤评分一致;这类推导在一般综述中往往被省略。其三,概念的甄别与批判:作者设专节讨论外部推理 vs 内部推理(CoT 文本未必反映模型的真实内部计算,故引入暂停 token、COCONUT、Quiet-STaR 等潜空间推理)、记忆 vs 推理(grokking 现象表明泛化在记忆饱和后突现)以及 LLM 能否真正推理(形式语言能力强、功能语言能力弱,规划任务中把实体名换成无意义词后性能骤降),体现了超越技术罗列的学术判断。
实验结果
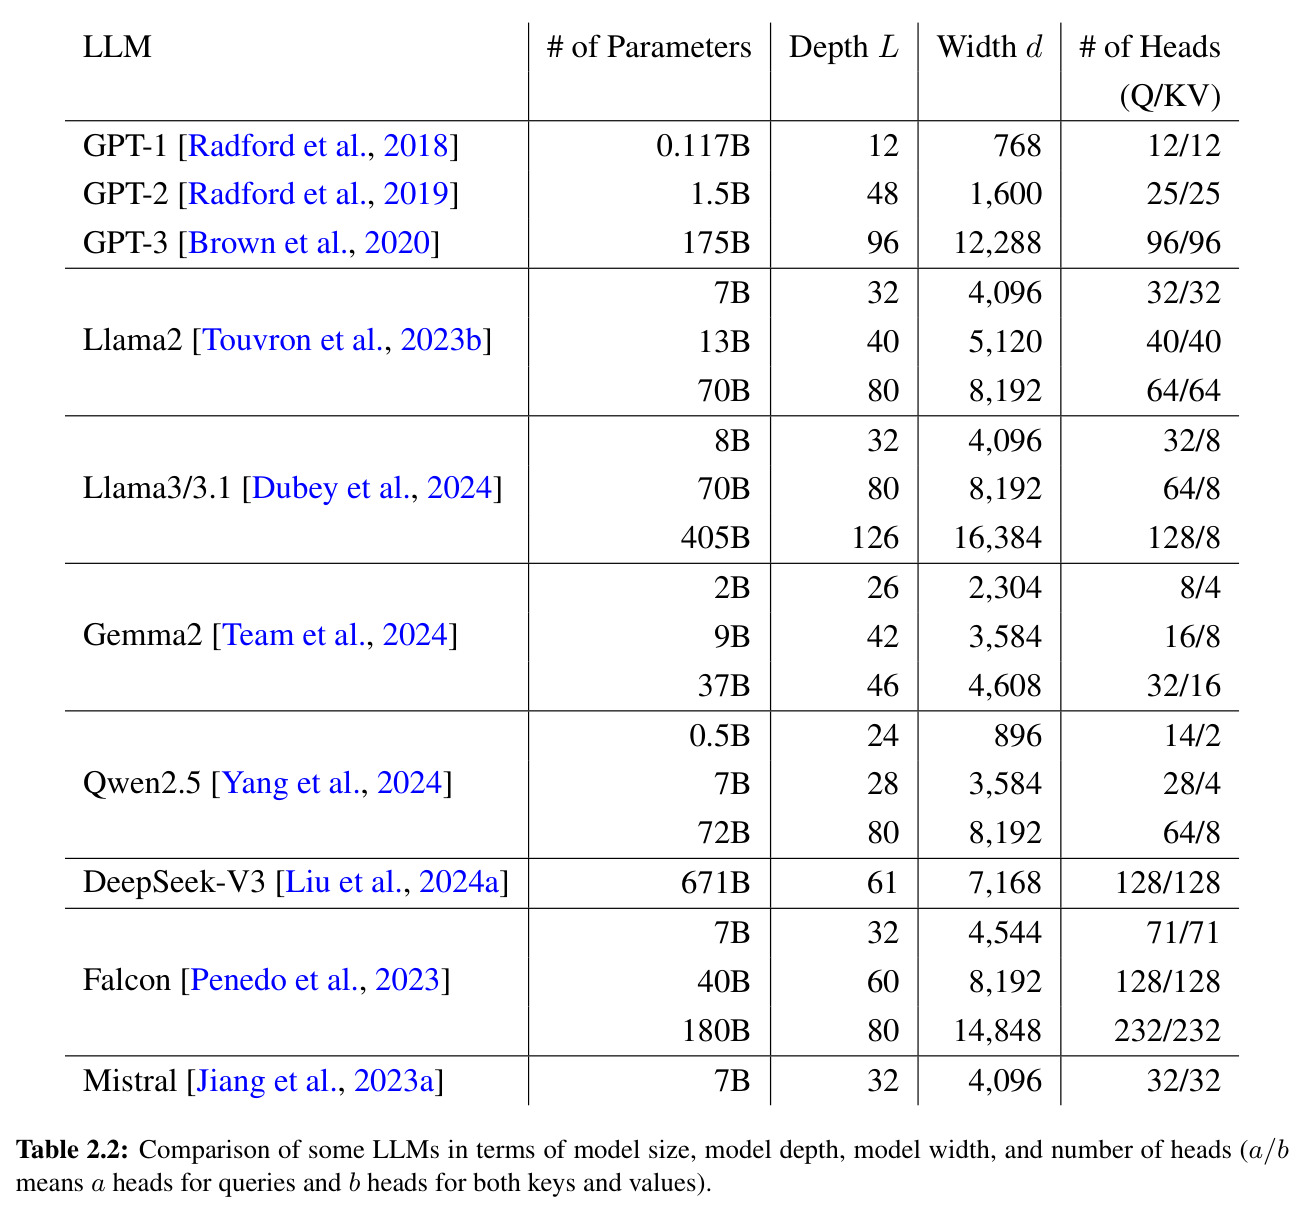
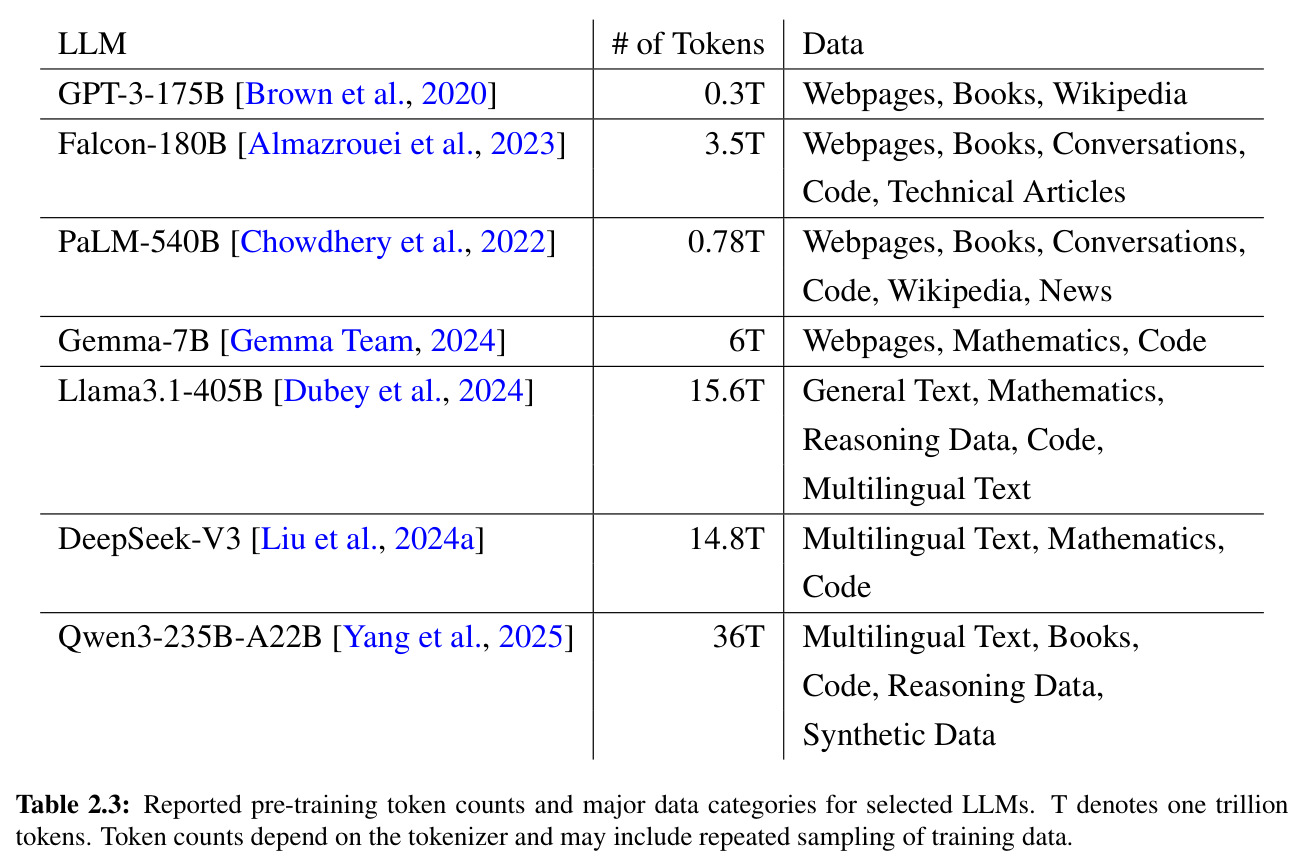
本书不报告原创实验,而是系统汇编领域关键实证结论。规模与数据:GPT-3 有 175B 参数、96 层、宽度 12288;Llama3.1-405B 用 15.6T token 预训练;DeepSeek-V3 达 671B 参数、14.8T token;Qwen3 语料高达 36T token。缩放定律:Kaplan 拟合出 $L(N)=(N/8.8\times10^{13})^{-0.076}$、$L(D)=(D/5.4\times10^{13})^{-0.095}$ 的幂律,Chinchilla 给出 $L(N,D)=\frac{406.4}{N^{0.34}}+\frac{410.7}{D^{0.28}}+1.69$,并导出参数与数据应等比扩展的结论。数据:Penedo 等证明清洗后丢弃 90% 网页数据反而提升效果。对齐:LIMA 仅用 1,000 条精选样本微调 Llama-65B 即具竞争力,而 FLAN 用了 1,836 个任务、1,500 万样本,对比支持『表层对齐假说』;Burns 等实验中 GPT-2 级监督使 GPT-4 级模型在 22 个分类任务上恢复约 80%(PGR≈0.8)的差距。推理:CoT 与 self-consistency 显著提升 GSM8K 等基准成绩;过程监督(PRM800K)优于纯结果监督;大规模 RL 催生 DeepSeek-R1 的『aha moment』,RL 计算量与推理性能呈 S 形曲线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语言建模测试损失随规模的变化 | 测试损失的幂律拟合指数 | 汇编 Kaplan 结果:$L(N)\propto N^{-0.076}$,$L(D)\propto D^{-0.095}$,万亿 token 后仍服从幂律 | 传统观点认为性能增益会在某个规模后彻底消失 | 为继续扩大模型与数据规模提供了定量依据,催生了后续大规模预训练实践 |
| 预训练算力最优分配(Chinchilla) | 每 token 测试损失 | $L(N,D)=\frac{406.4}{N^{0.34}}+\frac{410.7}{D^{0.28}}+1.69$,参数与数据应等比扩展 | Kaplan 缩放定律只单独拟合 $N$ 或 $D$,倾向堆大模型 | 同等算力下应优先补数据而非堆参数,直接影响了 70B 级模型配万亿 token 的训练配方 |
| 指令微调数据效率 | 指令跟随能力(人工/自动评测) | LIMA:1,000 条精选样本微调 Llama-65B 即具竞争力 | FLAN:1,836 个任务、约 1,500 万样本的大规模指令微调 | 证明数据质量远胜数量,支持表层对齐假说,大幅降低对齐门槛 |
| 弱到强泛化(22 个 NLP 分类任务) | 性能差距恢复率 PGR | 约 0.8(GPT-2 级弱监督 → GPT-4 级学生模型) | 无有效监督时 PGR=0,纯模仿弱模型则无法超越弱教师 | 弱监督可恢复约 80% 的差距,为监督超人类 AI 系统提供了初步可行性证据 |
| 网页数据清洗(RefinedWeb/Falcon) | 清洗后保留的数据比例 | 仅保留约 10% 的高质量网页数据用于训练 | 直接使用未过滤的原始网页抓取语料 | 清洗后训练效果更优,确立了质量优先于数量的数据工程准则 |
局限与改进
作者坦承本书定位为『基础』而非前沿全景:为控制篇幅省略了多模态、智能体、安全对齐/红队测试、RAG 系统实现细节等主题,多处以『此处从略』收尾并指向 NLPBook 其余章节。作为教材它不做原创实验,所有数字均引自第三方论文,个别结论(如弱到强泛化 PGR≈0.8)来自特定任务设置,普适性有限。以我的观察另有几点局限:其一,领域迭代极快,v4 版于 2026 年 10 月更新,推理模型一章引用的 S 形缩放曲线、生成式验证器等文献非常新,一两年内可能部分过时;其二,全书以纯文本 LLM 为主线,对视觉、语音与具身推理仅一笔带过,而『推理跨越数据类型』恰是作者自己列出的关键未来方向;其三,缺少可运行的代码、超参数表与算力估算工具,动手复现门槛仍然不低;其四,部分前沿话题(如多语言推理、低资源场景) coverage 较薄,低资源语言的表现问题仅在数据多样性一段被提及。
独立分析的弱点
独立分析本书的弱点:第一,缺乏端到端代码与算力估算——书中讲清了数据/张量/流水线并行的原理,但没有给出『训练一个 7B 模型需要多少 GPU 时』之类的量化工具,初学者仍难落地,改进方向是配套开源 notebook 与成本计算器。第二,评测讨论偏浅:第6章正确指出了 Pass@k、Cons@k 与数据污染问题,但没有提供污染语料去重的可操作流程或抗污染新基准清单。第三,系统与算法割裂:continuous batching、PagedAttention 属系统层,self-consistency、树搜索属算法层,两者在第5章并列陈述却缺少统一的成本模型(如每 token 延迟与搜索宽度的权衡公式),可补充排队论或 roofline 模型视角。第四,安全与伦理着墨不足:偏见、隐私、奖励作弊(reward hacking)各只有一小节,缺少对越狱攻击、幻觉缓解、内容水印等专题的系统处理。第五,公式密集但没有习题与参考实现,教学场景下需要教师自行设计练习;若每章增加一个『最小可运行示例』(例如用百兆参数模型演示缩放定律拟合或 DPO 训练),教学价值会显著提升。
未来方向
作者在第6章明确提出若干方向:让模型学会动态分配思考时间——简单问题不浪费算力、难题才放慢;把推理从数学、代码等有唯一答案的领域扩展到开放式现实任务;实现跨模态(图像、音频、物理环境)推理;以及把推理能力用于自主智能体的『思考-行动-观察』循环并解决循环中迷失与失败恢复的问题。基于本书成果还可延伸:其一,把『记忆 vs 推理』的成本权衡形式化,指导 RAG 外部知识与参数化知识的自动分工——作者已指出 RAG 的本质是把记忆负担外包给数据库;其二,将过程监督推广到缺少唯一正确步骤的开放领域,生成式验证器(自然语言批评)是有希望的起点;其三,研究思维链的忠实性——Turpin 等已证明 CoT 解释可能具有欺骗性,需要结合神经激活分析与机制可解释性工具;其四,弱到强泛化目前只在分类任务上验证,扩展到生成与推理任务是对齐超人类模型的关键一步;其五,构建持续更新、防污染的评测基准与私有保留集,缓解基准饱和问题。
复现评估
本书本身是开放获取资料,源自 NiuTrans 实验室的 NLPBook 项目(github.com/NiuTrans/NLPBook,niutrans.github.io/NLPBook 在线阅读),采用 CC BY-NC 4.0 许可,arXiv 版(2501.09223v4)可自由下载,获取成本近乎为零——有机器学习与 Transformer 基础即可通读。但它不是软件工件:没有统一代码仓库,涉及的实验(BERT、GPT-3、Chinchilla、RLHF、DPO、o1/R1)来自数十个团队,开放程度差异大——BERT、Llama、DeepSeek-V3 已开源,GPT-3/4 与 o1 只有论文。动手验证方面:缩放定律拟合、CoT 提示、self-consistency、DPO 可在单卡到数张 GPU 上复现(开源 7B 模型加 LoRA/DPO 库即可);完整 RLHF 流水线涉及策略、参考、奖励、价值四个大模型,大规模 RL 训练还需高频 rollout 与验证器调用,属机构级工程;弱到强泛化实验依赖闭源 GPT-4 级模型,已无法严格复现。总体而言,读懂与复现小规模实验难度为『低』,完整复现章节级系统难度为『极高』。
论文图表
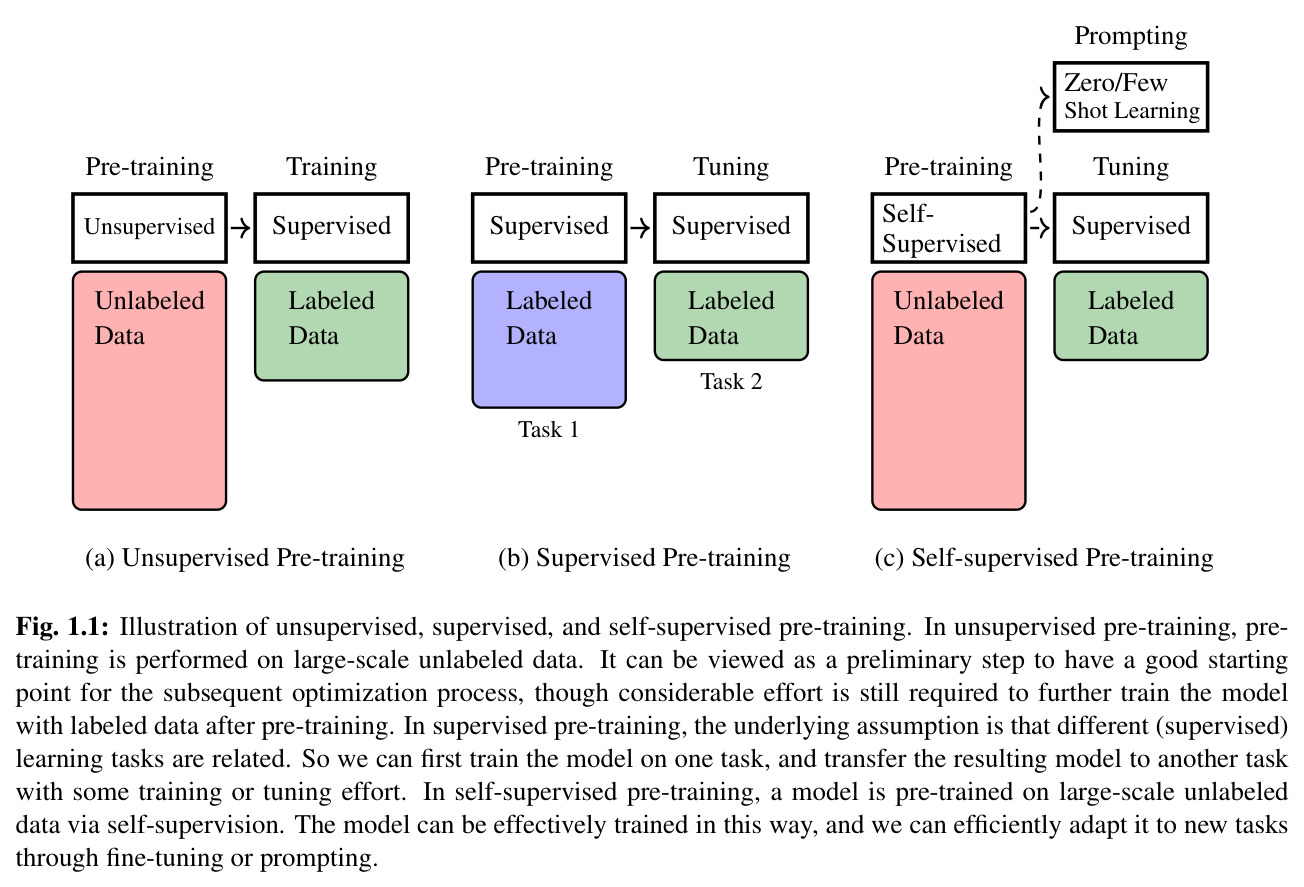
对比三种预训练范式:无监督预训练在无标注数据上为后续监督训练提供更好的初始化;有监督预训练先在任务A上训练再迁移到任务B;自监督预训练直接从文本自身构造监督信号(如预测被遮盖的词),训练后的模型可通过微调或零/少样本提示高效适配新任务。
它界定了全书立论的范式选择——自监督预训练是现代 NLP 基础模型的基石,理解三者差异才能理解 BERT/GPT 为何能利用海量无标注文本。