训练视觉Transformer学会聚焦:空间注意力头特化的涌现 Training Vision Transformers to Focus: Emergence of Spatial Attention Head Specialization
引入内外聚焦损失,让自监督ViT的注意力头自发分化出空间特化能力。
前置知识
DINO 自监督蒸馏
DINO(Self-Distillation with No Labels)是 ViT 自监督训练的主流范式:教师网络与学生网络结构相同但参数不同(教师是学生的指数滑动平均),对同一图像的不同裁剪视图,用教师输出作为软标签去监督学生,损失为交叉熵。DINOv2 在此基础上叠加 iBOT 的 masked-token 预测损失与 KoLeo 特征均匀化损失,无需任何标签即可学得强可迁移的视觉表征。
本文的两个聚焦损失就是在 DINOv2 的蒸馏框架上改损失加权得到的,不懂蒸馏机制就看不懂总损失公式 (4) 的由来。
多头注意力(Multi-Head Attention)
Transformer 每层注意力由 $h$ 个并行的注意力头组成,每个头独立计算一张注意力图(例如 [CLS] token 对各 patch 的注意力权重),最后把各头输出拼接后经线性层融合。理想情况下不同头应捕获不同信息,但实践中常出现多个头激活模式高度相似、都盯着图像中心的问题,这就是本文要解决的注意力冗余。
全文故事都围绕『让不同注意力头各管一片区域』展开,被操作的对象就是最后一层的各个注意力头。
注意力伪影与 Register Tokens
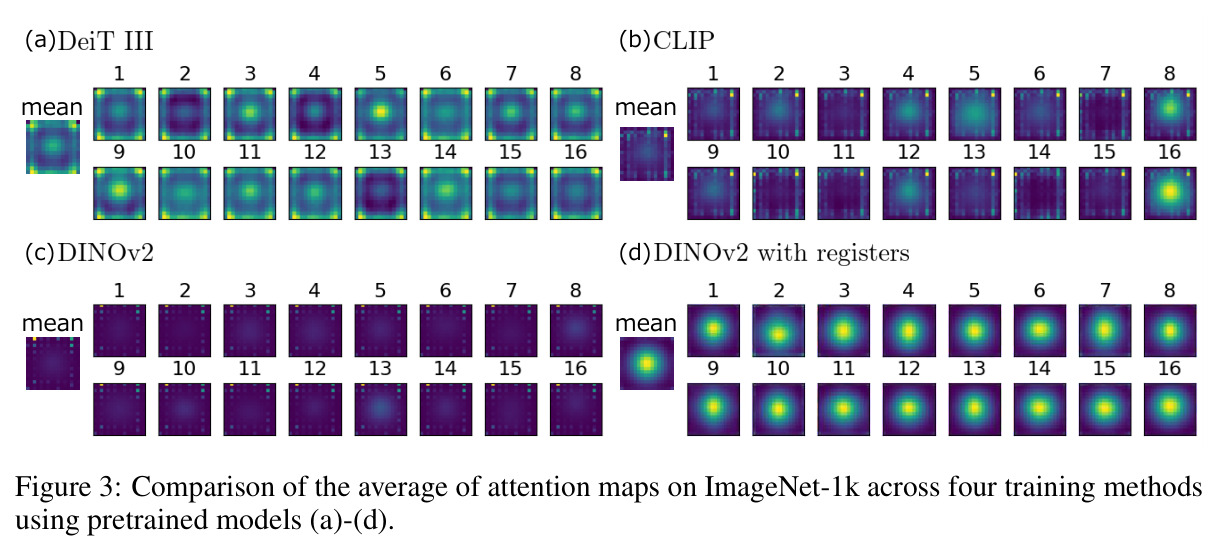
Darcet 等人发现,多种方式训练的 ViT 的注意力图中常出现高范数的离群 token,表现为聚焦在图像外或角落的异常热点(artifacts)。引入额外的 register tokens 后,模型可以把全局信息寄存到这些额外 token 上,注意力图明显更干净。DINOv2 with registers(如 ViT-L/16-Reg)因此成为许多下游工作的首选骨干。
论文在 Sec. 4.1 比较 DeiT III、CLIP、DINOv2、DINOv2+Reg 四种预训练的注意力图质量(Fig. 3),据此选定基线,不知道这段背景就看不懂实验设计的动机。
零样本图像分割
不训练任何分割模型,仅用 ViT 最后一层各头注意力图的头均值作为热图,再按热图的 patch 均值做阈值二值化,得到前景/背景分割掩码,与人工标注对比计算 mIoU、像素准确率 Acc、mAP。它衡量『模型的注意力是否真的对准了物体』,是注意力可解释性最常用的量化代理任务。
这是本文的主实验,聚焦损失带来的空间特化能力,主要靠该任务上 mIoU/Acc/mAP 的提升来量化证明。
PHS(提示引导的注意力头选择)
作者团队此前提出的视觉提示技术:给定二值 ROI 掩码 $R$,先找出在该区域内注意力图输出最大的若干头构成集合 $i_{on}$,然后把最后一层 Multi-Head Attention 中被选头的输出放大 $h/h_{on}$ 倍、其余头置零,使模型整体输出向 ROI 对齐,即 $head_i^{HS} = head_i \times h/h_{on}$(若 $i \in i_{on}$,否则为 0)。提示形状任意,推理期无需重训。
本文把 PHS 从『推理期提示』改造成『训练期损失组件』,用 $P^s_{PHS}(x, R)$ 构造两个新损失,它是整个方法的枢纽,不先理解 PHS 就无法理解损失如何作用。
研究动机
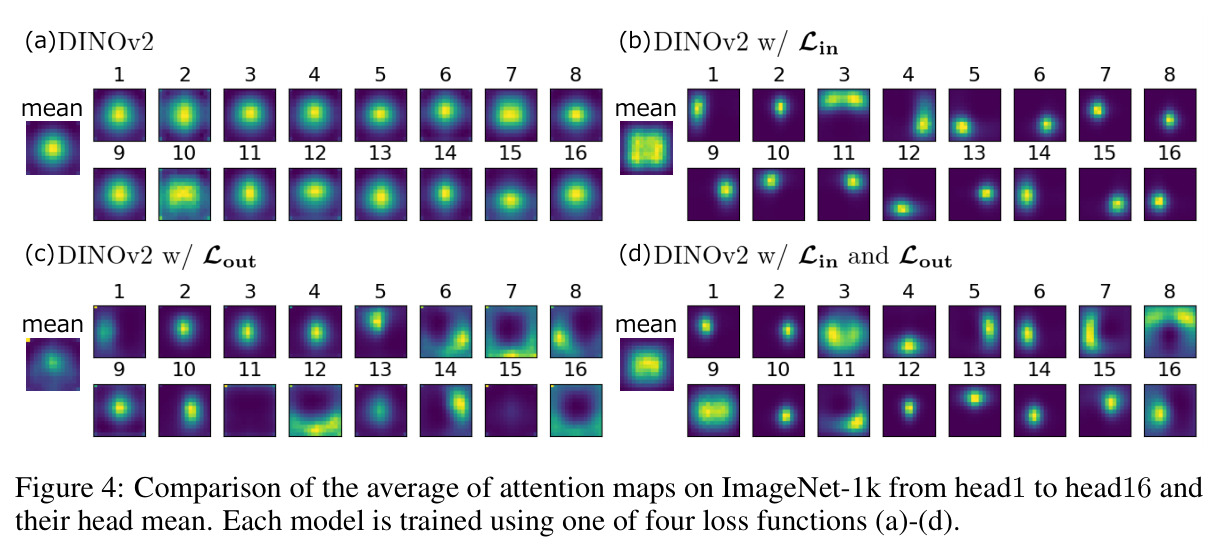
自监督训练的视觉 Transformer(如 DINO/DINOv2)虽然能学到强表征,但训练过程中没有任何机制告诉模型『该看哪里』。后果有两个层面。其一,在密集预测场景下,各注意力头的激活模式高度相似且模糊:DINOv2 的 16 个头几乎全部把注意力压在图像中心附近(Fig. 4(a)),面对多物体图像(例如甜甜圈和它背后的盒子)时所有头都盯着背景盒子,导致分割掩码含混不清。其二,可解释性差:DeiT III、CLIP、DINOv2 的注意力图都存在高范数伪影热点;即使在去掉伪影的 DINOv2 with registers 上,各头依然中心化、彼此冗余,无法提供『哪个头在看哪个区域』的结构化信息。相比之下,有监督方法可以靠标签或先验知识引导注意力,纯自监督范式恰恰缺了这个聚焦环节,这限制了 ViT 在分割、目标发现等密集任务与可解释性分析上的上限。
本文的目标是本文的目标是:在不使用任何标注(不需要物体位置真值、不需要分割掩码)的前提下,给自监督 ViT 的训练过程注入『聚焦机制』,让不同注意力头自发分工、各自关注图像中不同且有意义的区域,作者称之为空间注意力头特化(spatial attention head specialization)的涌现。具体可度量的目标包括:(1) 零样本图像分割超过 DINOv2 基线,例如 ImageNet-Segmentation 的 mIoU 从 63.67% 提升、PASCAL VOC 的 mIoU 从 58.10% 提升;(2) LOST 无监督目标发现超过基线(VOC07 CorLoc 58.6% → 更高);(3) 面向焦点的多目标图像检索 FOIR 的『视觉提示逐物体』方案超过基线;(4) 注意力图在 ImageNet 验证集上的平均可视化呈现多样化、空间聚焦的模式。同时作者明确接受一个代价:单标签分类的 k-NN 精度可能小幅下降。
与已有工作不同的是,已有工作处理注意力冗余的思路都是间接的:要么在架构上做启发式(注意力多样化、block dropping、去冗余知识蒸馏),要么靠监督或先验知识引导(需要标注的注意力引导、附加模块),要么是训练后才做的事后解释(attention rollout、Grad-CAM),都不直接塑造训练动态。本文的切入点是『区域到聚焦的对应关系』(region-to-focus correspondence, ReFoCo):既然 DINO 的成功来自局部裁剪与全局视图的对应(local-to-global),那完全可以再建一条新对应——把图像中随机框选区域的裁剪/掩码视图,与模型『看向该区域』的注意力对应起来。关键洞察有二:一是 PHS 视觉提示提供了把『注意力选择』变成可计算输出的旋钮,使『看哪里』可以写进损失函数;二是训练框 $b_x$ 可以像 DINO 的 local crop 一样随机采样,因此全程零标注。这条『用损失函数直接教注意力聚焦』的路线在此前文献中几乎无人走过。
核心方法
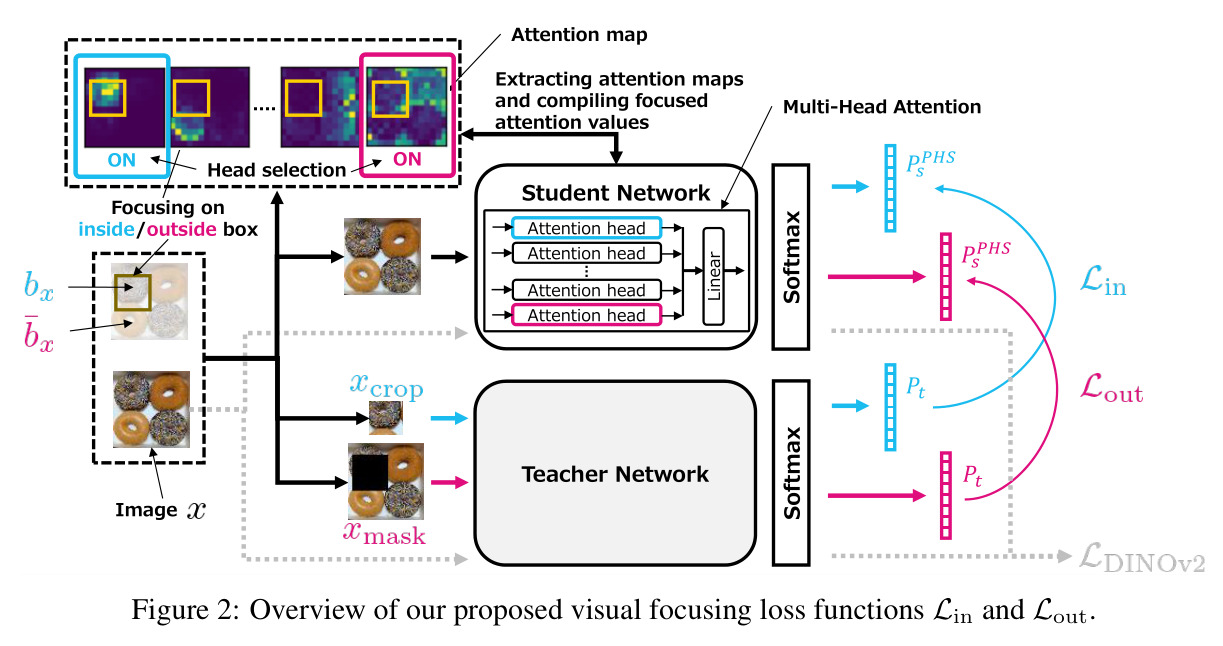
直观地说,DINO 训练像让一群学生各自泛泛地看整张图,结果大家都盯着最显眼的中心;本文则像给每个学生派发不同的观察任务:『这次只准看框里的东西』『这次要绕开框里的东西看其余部分』,久而久之队伍里自然出现各管一域的专家。技术路线是在 DINOv2(含 iBOT、KoLeo 与 register tokens)之上压缩 $\mathcal{L}_{DINO}$ 的权重,腾给两个新损失:$\mathcal{L}_{in}$ 让学生对整图、且被 PHS 提示强制聚焦到随机框 $b_x$ 的输出,对齐教师看框内裁剪图 $x_{crop}$ 的输出;$\mathcal{L}_{out}$ 让学生对整图、被提示聚焦到框外 $\bar{b}_x$,对齐教师看框内被掩图 $x_{mask}$ 的输出。总损失 $$\mathcal{L}_{focus} = (1-w_{in}-w_{out})\,\mathcal{L}_{DINO} + w_{in}\,\mathcal{L}_{in} + w_{out}\,\mathcal{L}_{out} + \mathcal{L}_{iBOT} + 0.1\,\mathcal{L}_{koleo}$$ 在 $w_{in}=w_{out}=0$ 时退化为标准 DINOv2 损失。框逐图随机采样并在两损失间共享,因此全程不需要真值标注。
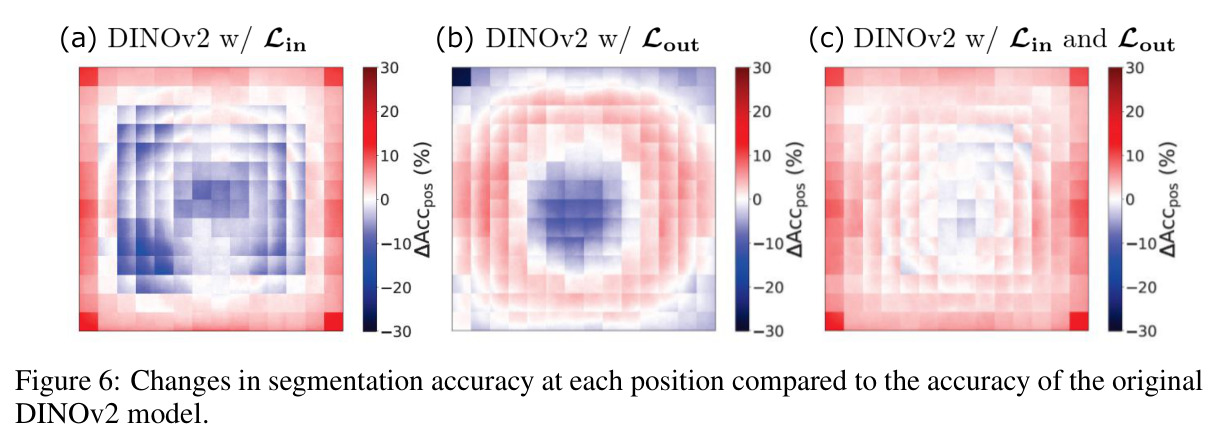
核心创新是把『模型注意力与图像区域的对应』(ReFoCo)显式写进自监督损失,与 DINO 的『局部到全局对应』形成互补。本质区别有三点。第一,监督信号的构造方式:$\mathcal{L}_{in}$ 用教师看裁剪图的输出做目标、$\mathcal{L}_{out}$ 用教师看掩码图的输出做目标,相当于借用 DINO 蒸馏机制,把『区域内容』与『区域位置』绑定的对应关系免费地造了出来——例如掩掉盒子后教师仍能识别图像,学生想对齐就必须学会看框外区域。第二,用 PHS 把注意力变成损失的操作对象:$P^s_{PHS}(x, R)$ 通过放大被选头的输出(乘 $h/h_{on}$)、清零其余头,使学生输出在结构上真正取决于『哪些头在看 ROI』,梯度因此能直接惩罚『该聚焦时没聚焦』,而不是像注意力多样化那样仅对头间相关性做间接正则。第三,两个损失分工明确:$\mathcal{L}_{in}$ 逼出『各看一处』的头,$\mathcal{L}_{out}$ 逼出『避开最显著物体』的头,单独使用各有偏科,联合使用才同时改善外围与中心环形区的分割精度(Fig. 6),这种成对设计是性能提升的关键。
方法步骤详情
第一步,选定基线:比较 DeiT III、CLIP、DINOv2、DINOv2+registers 的注意力图(Fig. 3),前三者均有伪影,故采用 Reg 版本。第二步,采样提示框:对每张图 $x$ 随机指定局部框 $b_x$(类似 local crop),两损失共享。第三步,教师输入:$\mathcal{L}_{in}$ 喂框内裁剪图 $x_{crop}$,$\mathcal{L}_{out}$ 喂框内被掩的图 $x_{mask}$,教师输出概率 $P^t$。第四步,学生输入与 PHS:学生看整图 $x$,但最后一层注意力先按 PHS 处理——统计各头注意力在 ROI($b_x$ 或补集 $\bar{b}_x$)内的输出,选出最大的 $h_{on}$ 个头,选中头输出乘 $h/h_{on}$、其余置零,得到 $P^s_{PHS}(x, R)$。第五步,计算交叉熵损失 $$\mathcal{L}_{in} = -\frac{1}{B}\sum_{x} P^t(x_{crop}) \log P^s_{PHS}(x, R{=}b_x)$$ $\mathcal{L}_{out}$ 同理,改用 $x_{mask}$ 与 $\bar{b}_x$。第六步,按 $\mathcal{L}_{focus}$ 训练:ViT-L/16-Reg 在 ImageNet-1k(无标签)从头训练,对比 $w_{in}{=}w_{out}{=}0$、$w_{in}{=}0.1$、$w_{out}{=}0.1$、$w_{in}{=}w_{out}{=}0.05$ 四种设定。第七步,用教师模型评测分割、目标发现、检索与分类。
技术新颖性
与最近邻工作的区别:注意力多样化(Ren et al., 2025)、block dropping(Bhojanapalli et al., 2021)、去冗余蒸馏都是在模型输出或头间统计上做间接正则,不指定『看向哪里』;先验知识引导的注意力方法与 add-on 模块往往需要标注或改架构;attention rollout、Grad-CAM 只能事后解释,不影响训练。本文的新颖性在于三点组合:(1) 把推理期的视觉提示技术 PHS 首次改造成训练期损失组件,让『注意力头选择』成为损失的一等公民;(2) 仅用随机采样的框、无需任何标注或先验,就能同时催生 inside 型与 outside 型两类空间特化头,实现『零标注的注意力塑形』;(3) 与标准 DINOv2 已有的『内容级头特化』互补而非替代——新方法保留内容特化并叠加空间维度,作者用『涌现』描述这一未被显式监督却稳定出现的现象。此外,损失形式与 DINO 同为交叉熵、量级可比,工程上只是在既有 DINOv2 代码上改损失加权,实现复杂度很低。
实验结果
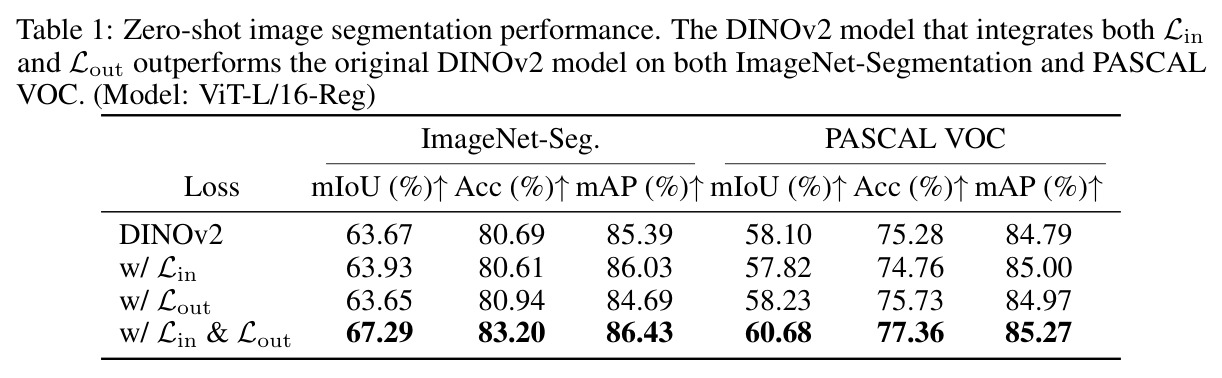
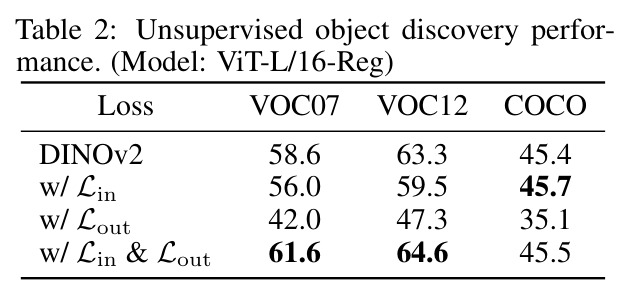
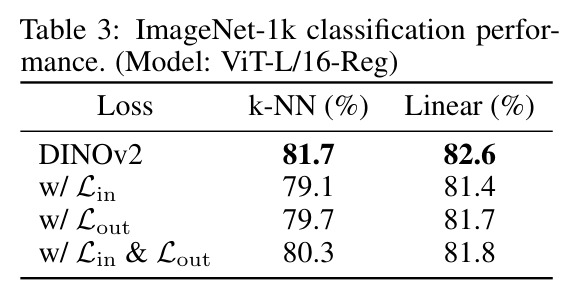
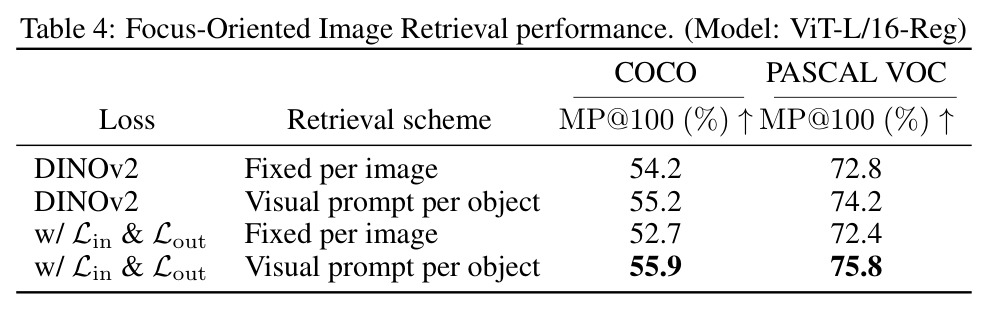
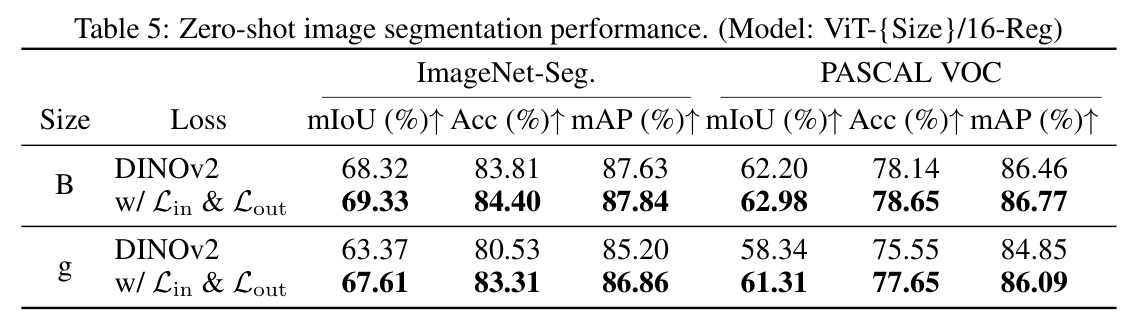
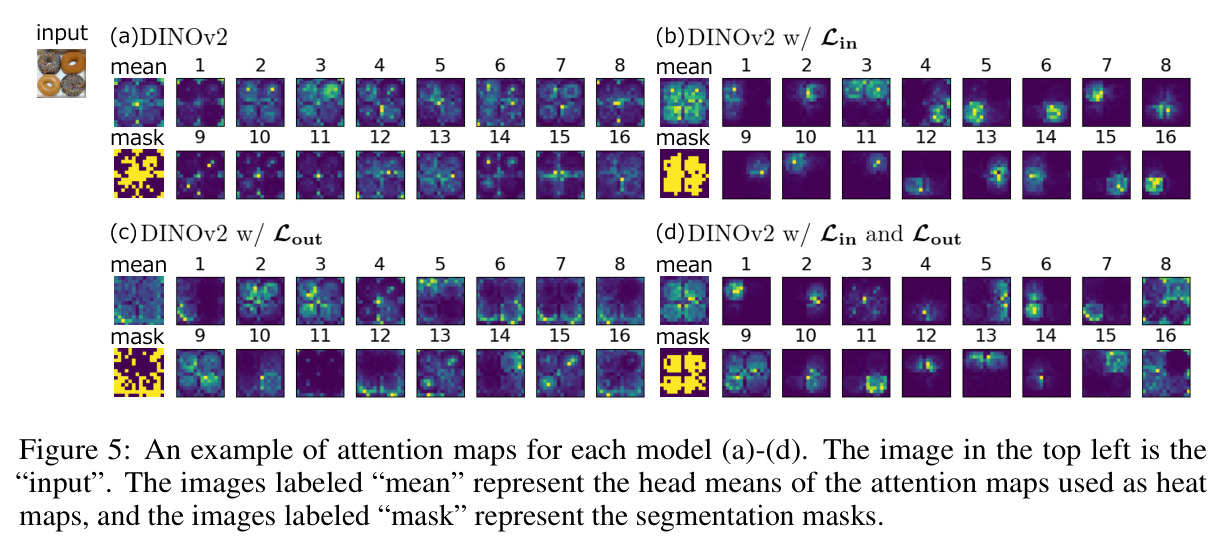
零样本分割(Table 1):单独加任一损失与基线打平(如 $\mathcal{L}_{in}$ 仅 ImageNet-Seg mIoU 63.93% vs 63.67%),联合后全面超越:ImageNet-Seg mIoU 67.29%(+3.62)、Acc 83.20%;VOC mIoU 60.68%(+2.58)、Acc 77.36%。涌现现象(Fig. 4):基线 16 个头几乎全压中心;加 $\mathcal{L}_{in}$ 后各头焦点显著多样化;加 $\mathcal{L}_{out}$ 后出现避开中心的头(但左上角有单 patch 伪影);联合则兼有之且伪影消失。位置分析(Fig. 6):$\mathcal{L}_{in}$ 提升外围、牺牲中心;$\mathcal{L}_{out}$ 提升中心外环形区;联合时中心损失被抵消。目标发现(Table 2):联合后 VOC07 CorLoc 61.6 vs 58.6、VOC12 64.6 vs 63.3、COCO 45.5 vs 45.4;单独 $\mathcal{L}_{out}$ 大跌(VOC07 仅 42.0)。分类(Table 3):k-NN 从 81.7% 降至 80.3%,linear probing 降幅较小(82.6%→81.8%)。FOIR(Table 4):『视觉提示逐物体』方案下联合模型反超基线(COCO 55.9% vs 55.2%、VOC 75.8% vs 74.2%),『固定每图』方案反而更差(52.7 vs 54.2)。尺度鲁棒性(Table 5):ViT-g 上 ImageNet-Seg mIoU 63.37→67.61(+4.24),增益大于 ViT-B 的 68.32→69.33。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 零样本图像分割(ImageNet-Segmentation) | mIoU (%) | 67.29(ViT-L/16-Reg,$\mathcal{L}_{in}$+$\mathcal{L}_{out}$) | 63.67(DINOv2) | +3.62 |
| 零样本图像分割(PASCAL VOC 2012 多类划分) | mIoU (%) | 60.68 | 58.10 | +2.58 |
| 无监督目标发现(LOST,VOC07 trainval) | CorLoc (%) | 61.6 | 58.6 | +3.0 |
| FOIR 多目标图像检索(COCO,视觉提示逐物体) | MP@100 (%) | 55.9 | 55.2 | +0.7 |
| ImageNet-1k 分类(k-NN, k=20) | Top-1 (%) | 80.3 | 81.7 | -1.4(下降) |
| 零样本分割(ViT-g/16-Reg,ImageNet-Seg) | mIoU (%) | 67.61 | 63.37 | +4.24 |
局限与改进
作者明确承认:引入聚焦损失后分类性能下降,k-NN 约降 1–3%(81.7%→80.3%),因此结果不能解读为『全局与密集表征同时全面变强』,方法的目标是引入聚焦机制而非通用增强。独立观察的局限:单独使用 $\mathcal{L}_{out}$ 副作用明显——目标发现 CorLoc 大跌(VOC07 58.6→42.0),且注意力图左上角出现单 patch 伪影,说明 outside 型损失与 DINO/iBOT 目标存在张力,联合权重 $w_{in}{=}w_{out}{=}0.05$ 是精心调出的平衡点,换任务或数据可能需要重调。FOIR 的『固定每图』全局检索方案下反而输给基线(52.7 vs 54.2),说明新模型的全局特征表达被削弱,更适合配合 PHS 逐物体使用。COCO 上的目标发现几乎无提升(45.5 vs 45.4),多目标复杂场景收益有限。此外,机器人视觉、自动驾驶等作者设想的落地场景在本文中完全未实验验证。
独立分析的弱点
第一,随机框采样策略过于朴素:每图只采一个随机框,框可能与物体完全不对齐(框住纯背景),训练信号混入噪声;改进方向是引入显著性引导,或让模型当前注意力自行提议 ROI 的自举式采样,甚至每图采多个框以覆盖多物体。第二,空间特化与分类精度的权衡未解决:k-NN 掉点 1–3% 意味着全局特征被稀释,改进方向是为分类任务冻结主干训练轻量适配器,或在蒸馏中加入全局特征的对比约束来对冲。第三,只有最后一层的头被重塑,且空间分工的『语义性』未被刻画——两个都看左下角的头可能一个看纹理一个看轮廓;改进方向是结合头剪枝与线性探针,量化每个头的语义角色,并把特化扩展到多层。第四,对 PHS 的依赖是双刃剑:推理期不用 PHS 时(固定每图检索),新模型反而更弱,说明特化能力锁在提示机制里;改进方向是让特化『内化』到特征本身,例如加入无提示时的头分布正则。第五,评估集中在单物体主导的 ImageNet-Seg 与 VOC,COCO 提升近乎为零,多目标拥挤场景的价值需要更强的证据。
未来方向
作者提出的方向:由于特化头是空间可分辨的,可以在推理期通过动态屏蔽单个头的信号来实时改写模型输出,提供『即插即用』的模型定制机制,潜在应用包括机器人视觉与自动驾驶中的选择性视觉关注,但本文未做实验验证。基于成果可延伸的方向:(1) 把随机框升级为模型自举的 ROI 提议,形成聚焦与提议互相促进的闭环,可能逼近无监督弱监督分割的上限;(2) 将空间特化与内容特化联合分析,建立『头 = 空间 × 语义』的二维角色图谱,服务可解释性研究;(3) 把同样思想搬到视频(时间维度上的聚焦对应)或多模态模型(文本提示对应图像区域);(4) 在下游微调或 LoRA 中复用 ReFoCo 损失,作为检测、分割等密集任务的辅助损失;(5) 探究特化收益随模型规模的缩放规律——Table 5 显示 ViT-g 的增益(+4.24 mIoU)大于 ViT-B(+1.01),暗示模型越大收益越高,值得在更大规模上系统验证。
复现评估
训练方案完全建立在公开组件之上:DINOv2 with registers 的官方代码开源,PHS 的机制在文中给出了完整公式(ROI 内统计选头 + 缩放置零),数据只需 ImageNet-1k 图像(不用标签),随机框逻辑简单,方法层面的复现门槛不高,主要成本在算力。主配置是从头训练 ViT-L/16-Reg(约 3 亿参数),还训练了 ViT-B 与 ViT-g(约 11 亿参数)验证尺度鲁棒性;DINOv2 级别的训练通常需要数十张 A100 级 GPU 训练数天到数周,个人或小团队难以从零完整复现。可行的替代路线:直接基于公开 DINOv2-Reg 权重做短程继续训练、或用 ViT-S/B 小模型验证趋势,成本可控。评测协议全部使用公开基准与标准协议(Chefer et al. 的热图二值化分割评测、LOST 目标发现、FOIR),评估部分复现成本很低。文中未明确说明代码与权重的开源计划,复现前建议关注作者后续发布。整体判断:方法实现入门级,全量训练属于大厂级算力。
论文图表
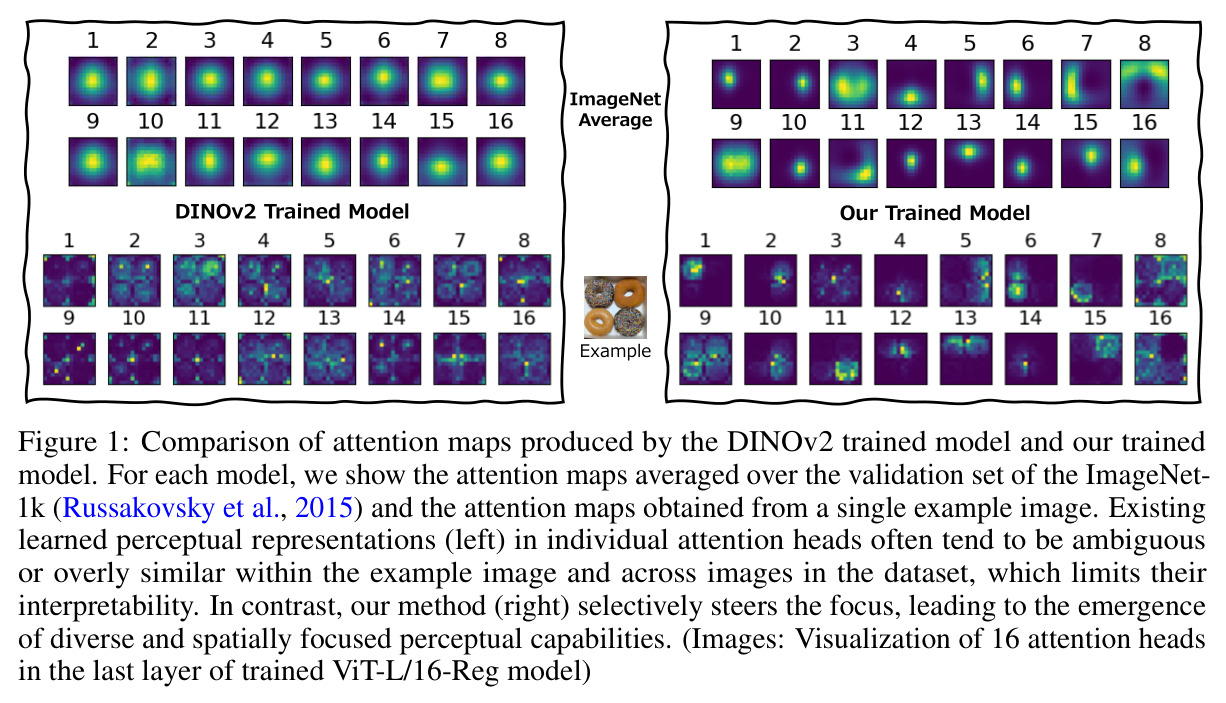
对比 DINOv2 训练模型与本文训练模型(ViT-L/16-Reg 最后层 16 个头)在 ImageNet-1k 验证集上的平均注意力图与单张示例图的注意力。DINOv2 各头模式雷同且集中于中心,本文模型各头焦点分布多样、各看一处。
一图看懂论文的核心主张——空间注意力头特化的涌现,是 Fig. 4 数据集级结论的单图直观版,适合作为论文门面。