可扩展视界的Q学习(HQL) Horizon-Scalable Q-Learning
用免密度的价值比较门控逐转移决定多步目标延伸,使离线Q学习随视界增长保持精确
前置知识
时序差分(TD)学习与自举
TD 学习用自举方式估计价值函数:一步目标为 $Y_t = r_t + \gamma V(s_{t+1})$,即用当前 critic 对下一状态的价值估计代替真实回报。定义一步 Bellman 残差 $e_t = Q_t - r_t - Q_{t+1}$ 与价值误差 $\epsilon_t = Q_t - Q^{\pi}_t$,由于 $Q^{\pi}_t = r_t + Q^{\pi}_{t+1}$,二者满足 $e_t = \epsilon_t - \epsilon_{t+1}$,沿链求和后价值误差恰好等于下游所有残差之和。这意味着 TD loss 小只说明每步残差小,误差仍会沿视界像随机游走一样累积。
本文全部理论分析(误差按 $\Theta(\sqrt{H})$ 累积的误差律)建立在这个残差望远镜求和恒等式上,不懂自举就无法理解为什么一步 TD 在长视界下失效。
n 步回报与偏差-传播权衡
n 步 TD 的目标为 $Y_t^{(n)} = \sum_{j=0}^{n-1} r_{t+j} + V^{\pi}(s_{t+n})$,沿数据轨迹连续跨越 $n$ 个转移再自举,从而把残差累积项除以 $n$、加速价值回传。但代价是目标偏离 $Q^{\pi}$ 的量为被跨越动作的优势之和 $\sum_{j=1}^{n-1} A^{\pi}(s_{t+j}, a_{t+j})$:对近优目标策略这些优势非正,偏差是系统性的、不会平均掉,随 $n$ 增长趋向与视界线性相关的上限 $H|\bar{A}_\mu|$。
论文的核心矛盾正是"回溯越长传播越快但偏差越大",且最优回溯长度逐转移不同,这直接引出逐转移门控的设计动机。
重要性采样与逐步离策略修正(Retrace/V-trace)
离策略数据由行为策略 $\mu$ 采集,直接跨越其动作会引入偏差。逐步重要性修正(Precup 的 per-decision IS、Retrace、V-trace、Q(λ))在每个转移乘上密度比 $\pi(a|s)/\mu(a|s)$(常截断在 1)对目标加权或切断,使得 $Q^{\pi}$ 仍是备份算子的不动点——任何满足 $c_i \le \pi(a_i|s_i)/\mu(a_i|s_i)$ 的门都是"合法门"。这类方法需要显式动作密度或离散可贪心策略。
HQL 的理论贡献是证明其硬门是合法门在指数倾斜策略下 $\tau\to\infty$ 的极限,且完全不需要密度,这是它与 Retrace 一族的本质分界线。
指数倾斜策略与行为正则化 RL
行为正则化离线 RL(AWR、IQL、SAC 类)的目标策略可写成行为策略的指数倾斜形式:$\pi_\theta(a|s) = \mu(a|s)\exp(\tau Q(s,a)) / Z(s)$,其中配分函数 $Z(s) = \mathbb{E}_{a\sim\mu}[\exp(\tau Q(s,a))]$。关键性质是计算重要性比 $\log(\pi/\mu)(a|s) = \tau Q(s,a) - \log Z(s)$ 时行为密度 $\mu$ 在分子分母中恰好消掉,只剩 critic 值与一个可用 $N$ 个行为样本经 log-sum-exp 估计的配分函数。
这个密度消去是全文的点睛之笔:它把"需要密度的重要性修正"转化为"只需要 critic 值排序的门控比较",让门控与流/扩散策略兼容。
流/扩散策略与 best-of-N 采样
流(flow)与扩散(diffusion)模型通过迭代去噪/流匹配生成动作,表达力强但概率密度难以计算,因此传统的重要性修正无法应用于以它们为策略的离线 RL。best-of-N 采样是从这类策略生成高分动作的常用替代:从行为模型采 $N$ 个候选,用 critic 挑最好的一个,本身不需要密度。
HQL 的门正是把日志动作与从 BC 流策略采出的 $N$ 个候选做 best-of-N 式比较,且论文实验全部使用行为流采样器,理解这一点才能看懂门的具体计算成本与消融。
研究动机
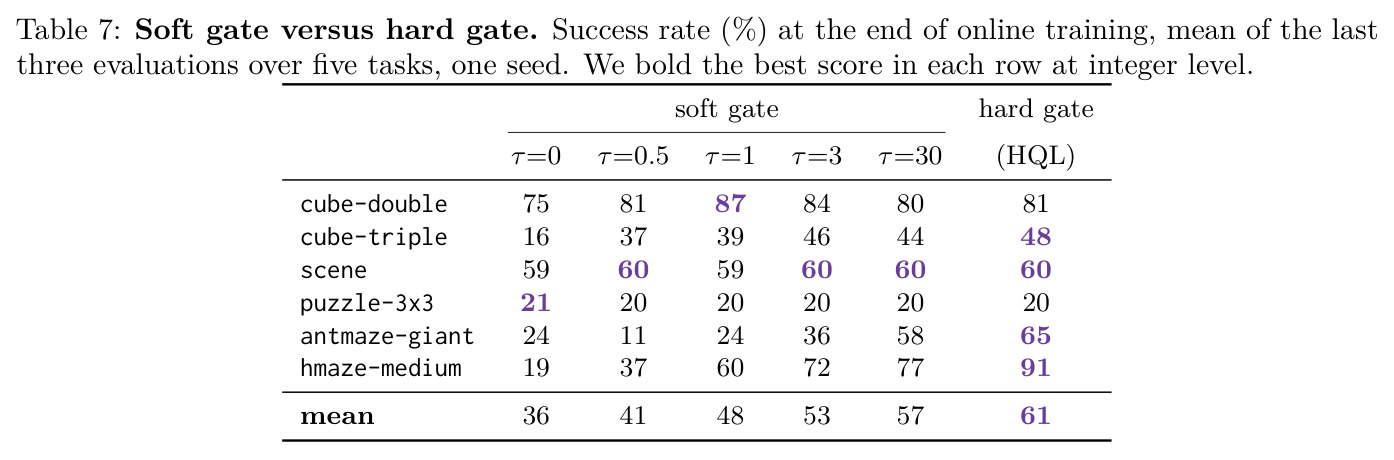
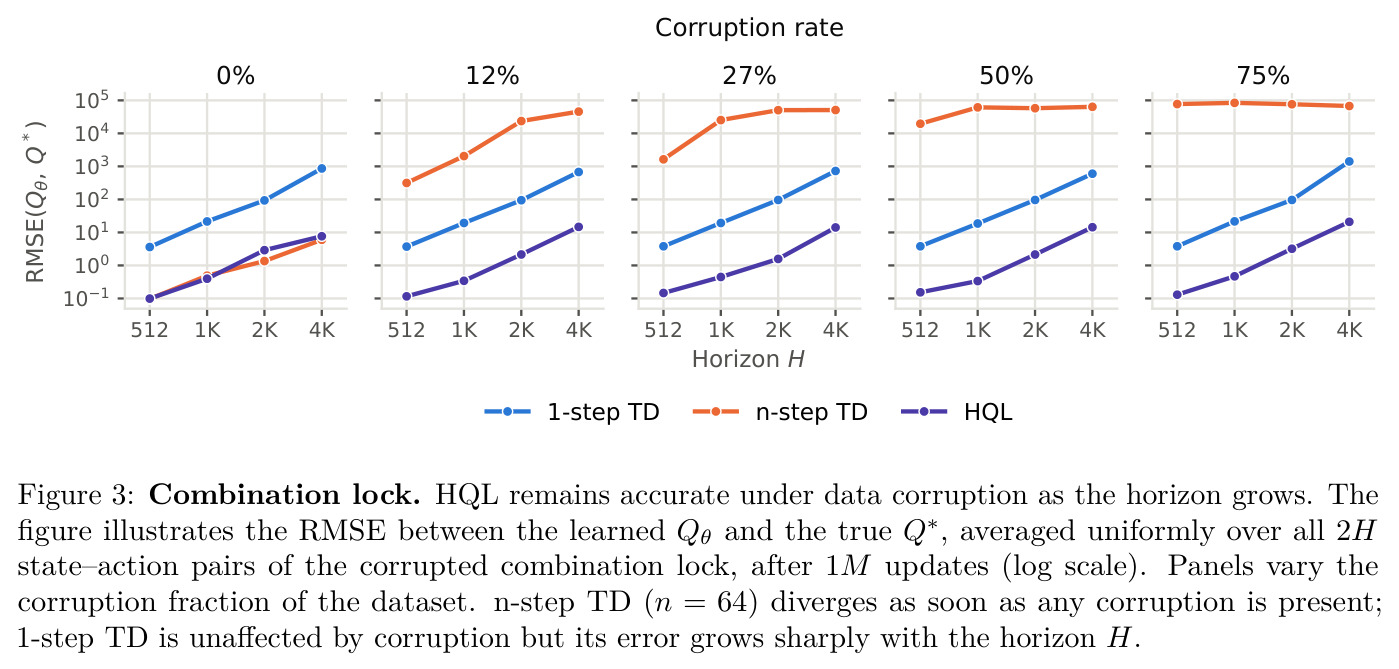
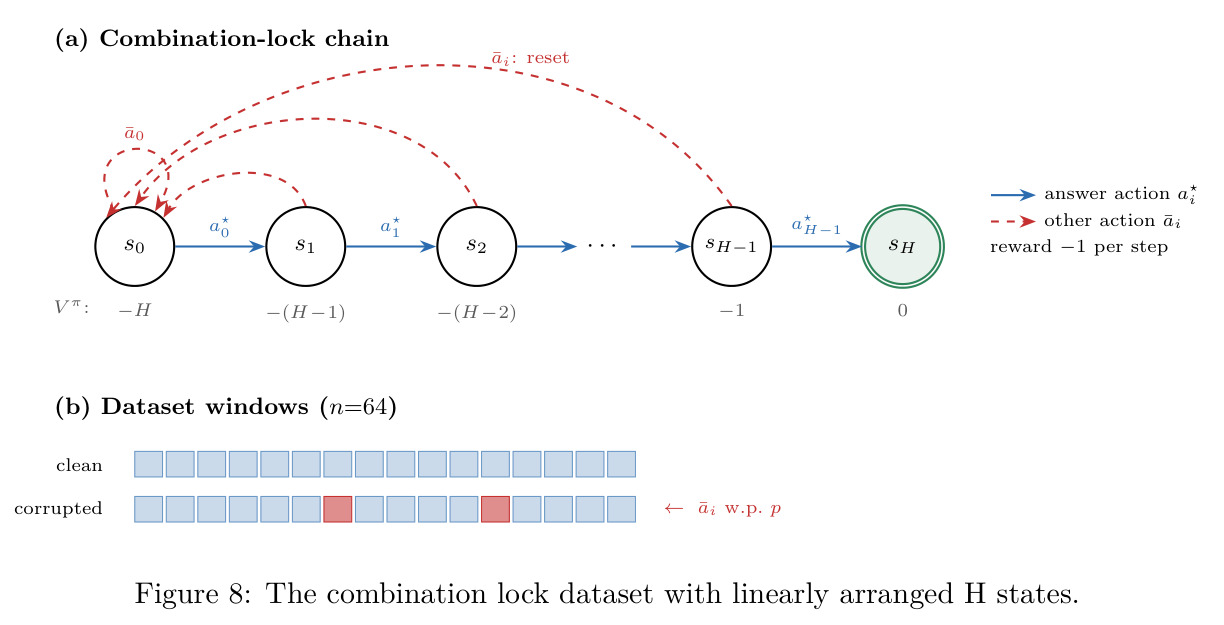
离策略强化学习从行为策略 $\mu$ 采集的离线数据中估计目标策略的 $Q$ 函数,其难度随有效视界(critic 必须跨越多少步转移才能把价值信息传回早期状态)增长而急剧上升。主流 actor-critic 方法用一步 TD:每个目标只回溯一次就自举。作者证明了一个精确的误差律:任意时刻的价值误差恰好等于下游全部一步 Bellman 残差之和 $\epsilon_t = \sum_{\tau=t}^{H-1} e_\tau$,在残差弱相关、零均值的噪声模型下误差按 $\Theta(\sqrt{H})$ 累积——所以 TD loss 只度量每步残差 $L_{TD} = \mathbb{E}[e_t^2] = \sigma^2$,很小也不能保证起始状态估值准确。n 步 TD 靠沿数据轨迹多走几步缩短自举链,但每个被跨越的次优行为动作都引入系统性偏差,其平方随 $n$ 增长趋向 $H^2\bar{A}_\mu^2$;组合锁实验中 64 步 TD 在数据稍有污染时即发散。Retrace、V-trace 等逐步重要性修正可逐转移取舍,但需要动作密度比,而流/扩散策略根本不提供密度,离散贪心判据(Watkins Q(λ))也不适用于连续动作。
本文的目标是本文要设计一个逐转移的门控规则:在每次 TD 更新中自动判断当前日志动作是否值得让多步目标继续跨越——足够好就延伸目标以加速价值传播,不够好就退回一步自举以避免偏差。硬性要求包括:(1) 判据只需 critic 值的排序,对奖励尺度不变,因此不需要估计密度;(2) 不引入软温度超参,唯一超参是从行为策略采样的候选数 $N$;(3) 与表达力强的流/扩散策略及任意策略提取方法(QAM、VGF 等)即插即用兼容;(4) 在匹配 critic 目标数预算的公平比较下,在视界 512-4096 的组合锁、视界 500-4000 步的 OGBench 与 1000-5000 步的 OCBench 上稳定超过一步 TD、n 步 TD、Q-chunking 和 LQL。
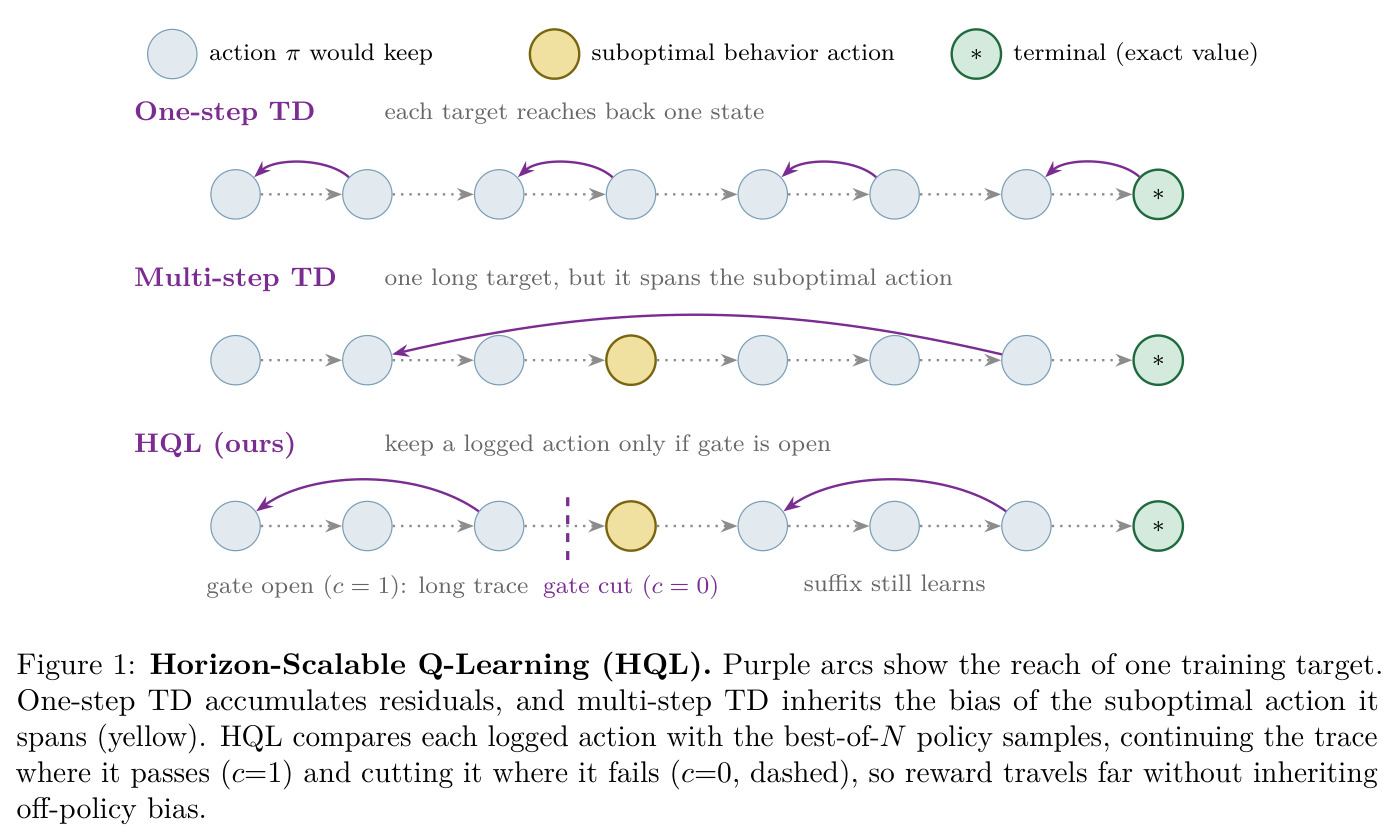
与已有工作不同的是,已有工作分两路,都没有占据本文的位置:其一是逐步修正(Retrace、V-trace、Watkins/Peng Q(λ)、emphatic TD),它们用重要性比逐转移加权,但依赖动作密度或离散贪心策略;其二是视界缩减(层次方法、动作分块/Q-chunking、准度量价值函数),它们改变"什么是一个决策"来缩短链长,但每段内部仍是固定且未修正的备份,偏差被原样继承,且 goal-conditioned 结构依赖奖励假设。作者的独特切入点有两步:先观察到对指数倾斜策略 $\pi \propto \mu\exp(\tau Q)$,重要性比中行为密度恰好消掉,$\log(\pi/\mu) = \tau Q - \log Z$;再观察到当 $\tau \to \infty$ 时合法软门收敛为"critic 值逐个比较"的硬门,不仅消掉温度,实验还证明它强于任何有限 $\tau$。此外 HQL 把一步 TD、n 步 TD、Q-chunking 统一为 $(L, H)$ 两个参数的无门控特例。
核心方法
HQL 的直觉像接力赛中的信任判断:价值信息想沿数据轨迹往回传,但每经过一个日志动作都要先问一句"目标策略自己会不会走这步?"——只有当日志动作不比从策略采出的最好的候选差时才放行;一旦某个动作不够好,就地切断,退回常规一步自举,而被切断的后缀仍然从自己的位置开始学习目标,信息不丢。技术上,HQL 给每个转移附一个二值门 $c_i \in \{0,1\}$,定义门控多步目标 $$Y_t^{\mathrm{hql}} = r_t + \gamma V^{\pi}(s_{t+1}) + \gamma\, c_{t+1}\left(Y_{t+1}^{\mathrm{hql}} - Q(s_{t+1}, a_{t+1})\right)$$ 第一项是常规一步自举,第二项在门开时把下游已学到的、超出 critic 当前估计的部分传回来。$c \equiv 0$ 精确退化为一步 TD,$c \equiv 1$ 退化为未修正多步回报。实现上按轨迹窗口采样、从窗口末端反向递归,窗口内每个位置都产出自己的目标,一次采样得到 $H$ 个回溯长度从 $H$ 到 1 不等的密集目标。
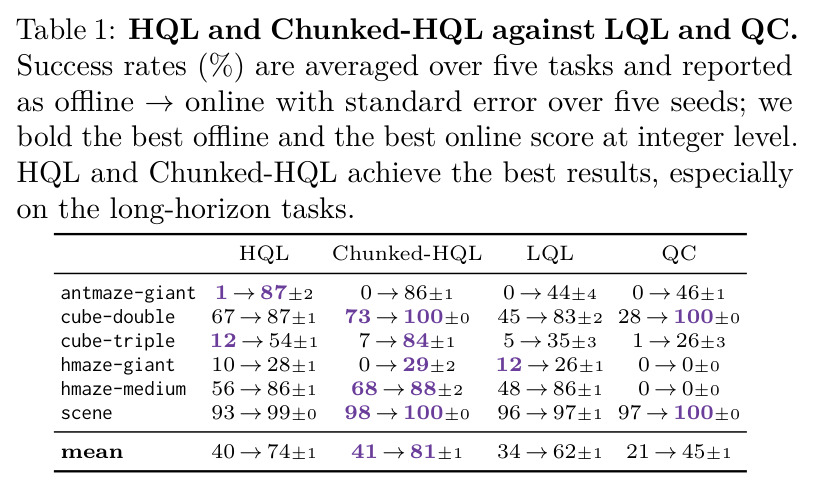
核心创新是免密度的合法门控及其极限形式。经典结论是:表格情形下任何满足 $c_i \le \pi(a_i|s_i)/\mu(a_i|s_i)$ 的门都能保持 $Q^{\pi}$ 为不动点,但流/扩散策略给不出这个比值。作者的关键观察是:对行为正则化 RL 逼近的指数倾斜策略 $\pi_\theta(a|s) \propto \mu(a|s)\exp(\tau Q(s,a))$,行为密度在比值中消掉,$\log(\pi/\mu)(a_i|s_i) = \tau Q(s_i,a_i) - \log Z(s_i)$,其中 $\log Z$ 用 $N$ 个行为样本的 log-sum-exp 估计。由此得到软门 $c_i = \exp(\min(0, \tau Q - \log \hat{Z}))$;当 $\tau \to \infty$ 时它收敛为硬门 $$c_i = \mathbb{I}\left[Q(s_i, a_i) \ge \max_{1 \le m \le N} Q(s_i, a_i^{(m)})\right], \quad a_i^{(m)} \sim \mu(\cdot|s_i)$$ 即"日志动作不输给 BC 策略 $N$ 个候选中最好的那个"。该判据只依赖 critic 值排序:对奖励尺度不变、无需密度、无温度超参、$N$ 是唯一超参。与已有方法的本质区别在于:Retrace 加权比值,Q-chunking 固定整块,n 步 TD 全体一刀切,而 HQL 逐转移地选择性延伸,且被证明是合法门的极限成员。
方法步骤详情
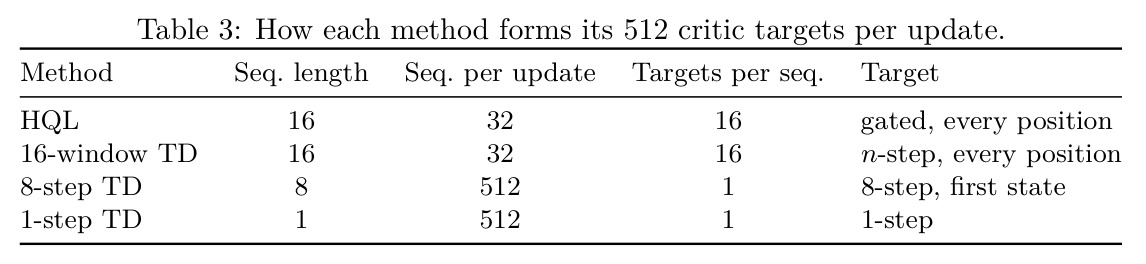
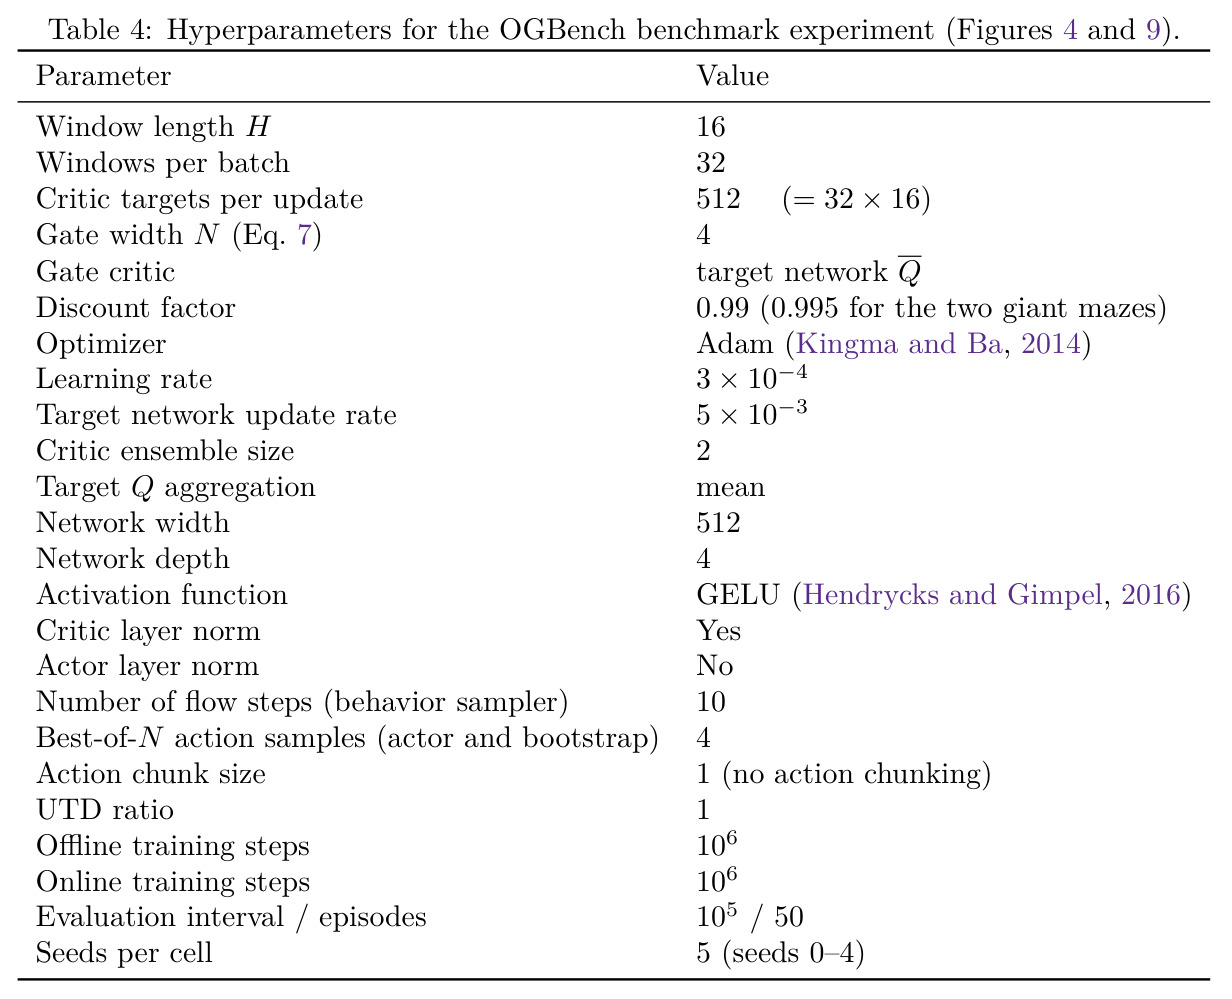
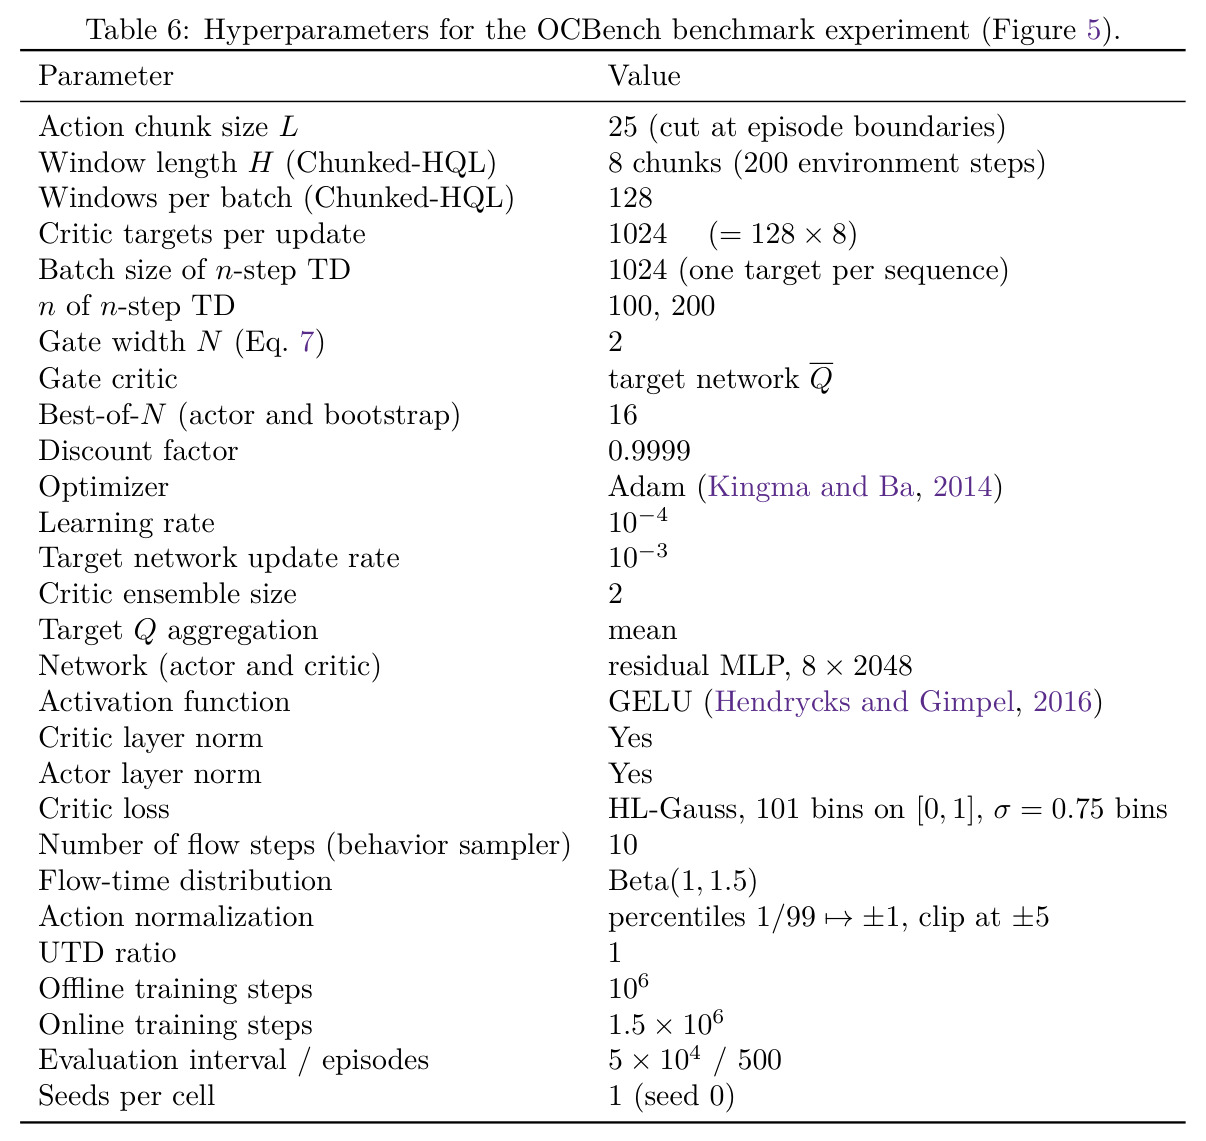
完整流程见 Algorithm 1。第一步,从数据集采样 $B/H$ 个含 $H$ 个连续转移的窗口(OGBench 配置 $H=16$、每批 32 窗口,即每次更新 $32 \times 16 = 512$ 个 critic 目标,与其他基线预算严格对齐;基线如 8-step TD 用 512 条序列各回归首状态一个目标)。第二步,在每个位置 $i$ 用行为流策略(10 步流采样)采 $N=4$ 个候选动作,用目标网络 $Q$ 计算 $N+1$ 个 critic 值并比较得门 $c_i$,每窗口只算一次。第三步,从窗口末端 $j = H-1$(修正项置零)向 $j=0$ 反向递归计算各 $Y_{t+j}^{\mathrm{hql}}$,越过 episode 边界的位置被掩蔽。第四步,把窗口内全部 $H$ 对 $(s_{t+j}, a_{t+j})$ 回归到各自带 stop-gradient 的目标上更新 critic(2-ensemble、取均值)。Chunked-HQL 把决策步长放宽到 $L$:critic 给 $L$ 步动作块整体打分 $Q(s_t, a_{t:t+L})$,门控比较整块,$L=8, H=1$ 即 Q-chunking;OCBench 用 $L=25, H=8$(200 环境步窗口、128 窗口/批、1024 目标),门控 $N=2$、执行与自举用 best-of-16。
技术新颖性
与 Retrace/V-trace/TD(λ) 一族的区别:它们用重要性比连续加权且需要动作密度,HQL 的硬门只需 critic 值排序,天然适配流/扩散等无密度策略,且实验表明硬门(平均 61%)胜过所有有限温度软门(36%-57%)。与 Watkins Q(λ) 的区别:后者在非贪心动作处切断,但要求离散可贪心的目标策略,HQL 用 best-of-N 比较替代贪心判断,适用于连续动作空间。与 Q-chunking 和层次方法的区别:它们段内使用固定未修正备份,HQL 与其正交,叠加后把 QC 从 45% 提到 81%。与固定 $n$ 步 TD 的区别:误差律 $\mathrm{RMSE}(\epsilon_0)^2 \approx \frac{H}{n} L_{TD}^{(n)} + (1-\frac{1}{n})^2 H^2 \bar{A}_\mu^2$ 表明最优回溯长度逐转移不同,HQL 让数据自己决定。统一视角也有新意:$L$ 控制一个决策覆盖多少环境步、$H$ 控制一个目标链多少个决策,一步 TD、n 步 TD、Q-chunking 均为 $(L,H)$ 的无门控特例。
实验结果
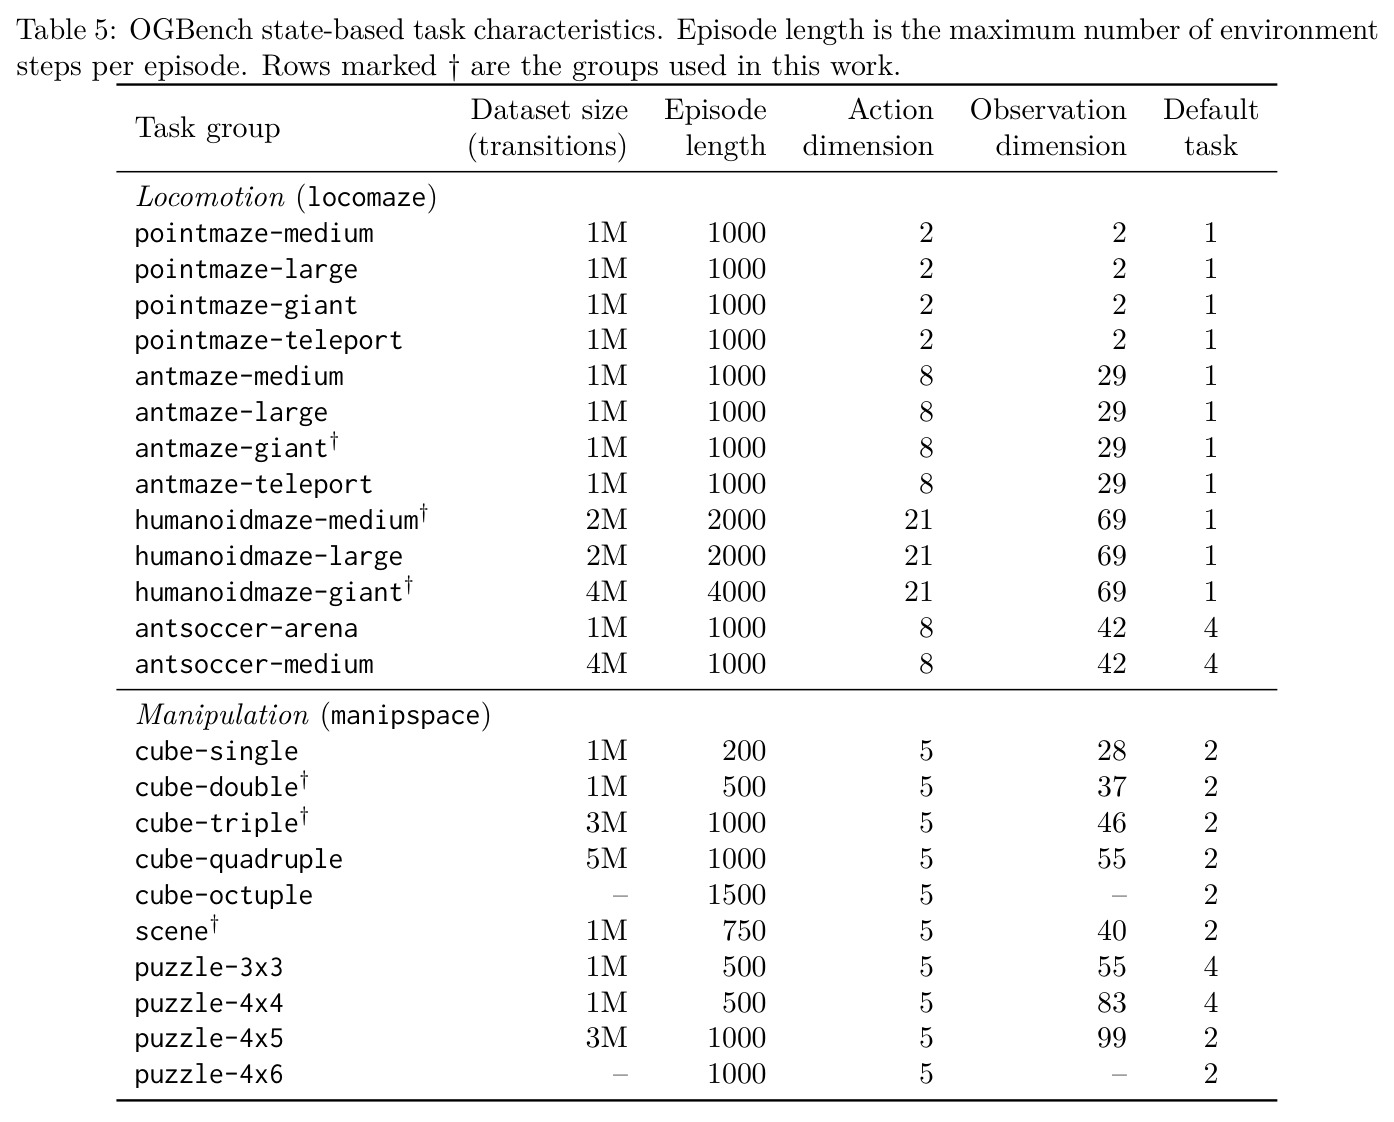
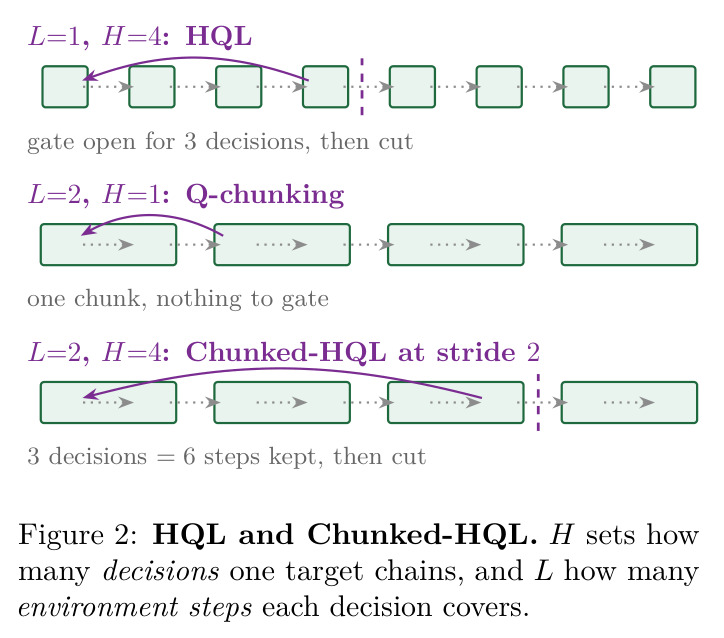
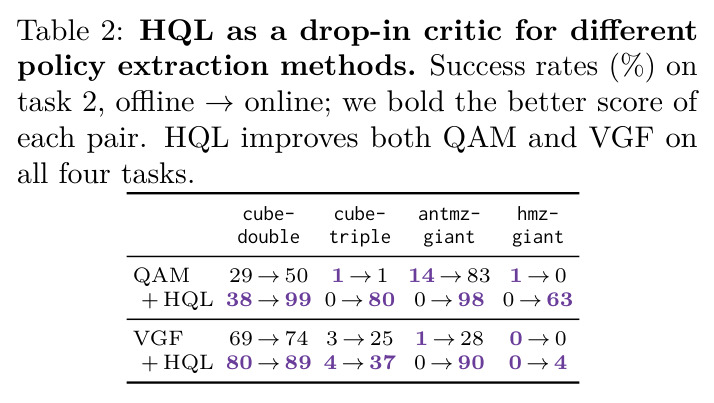
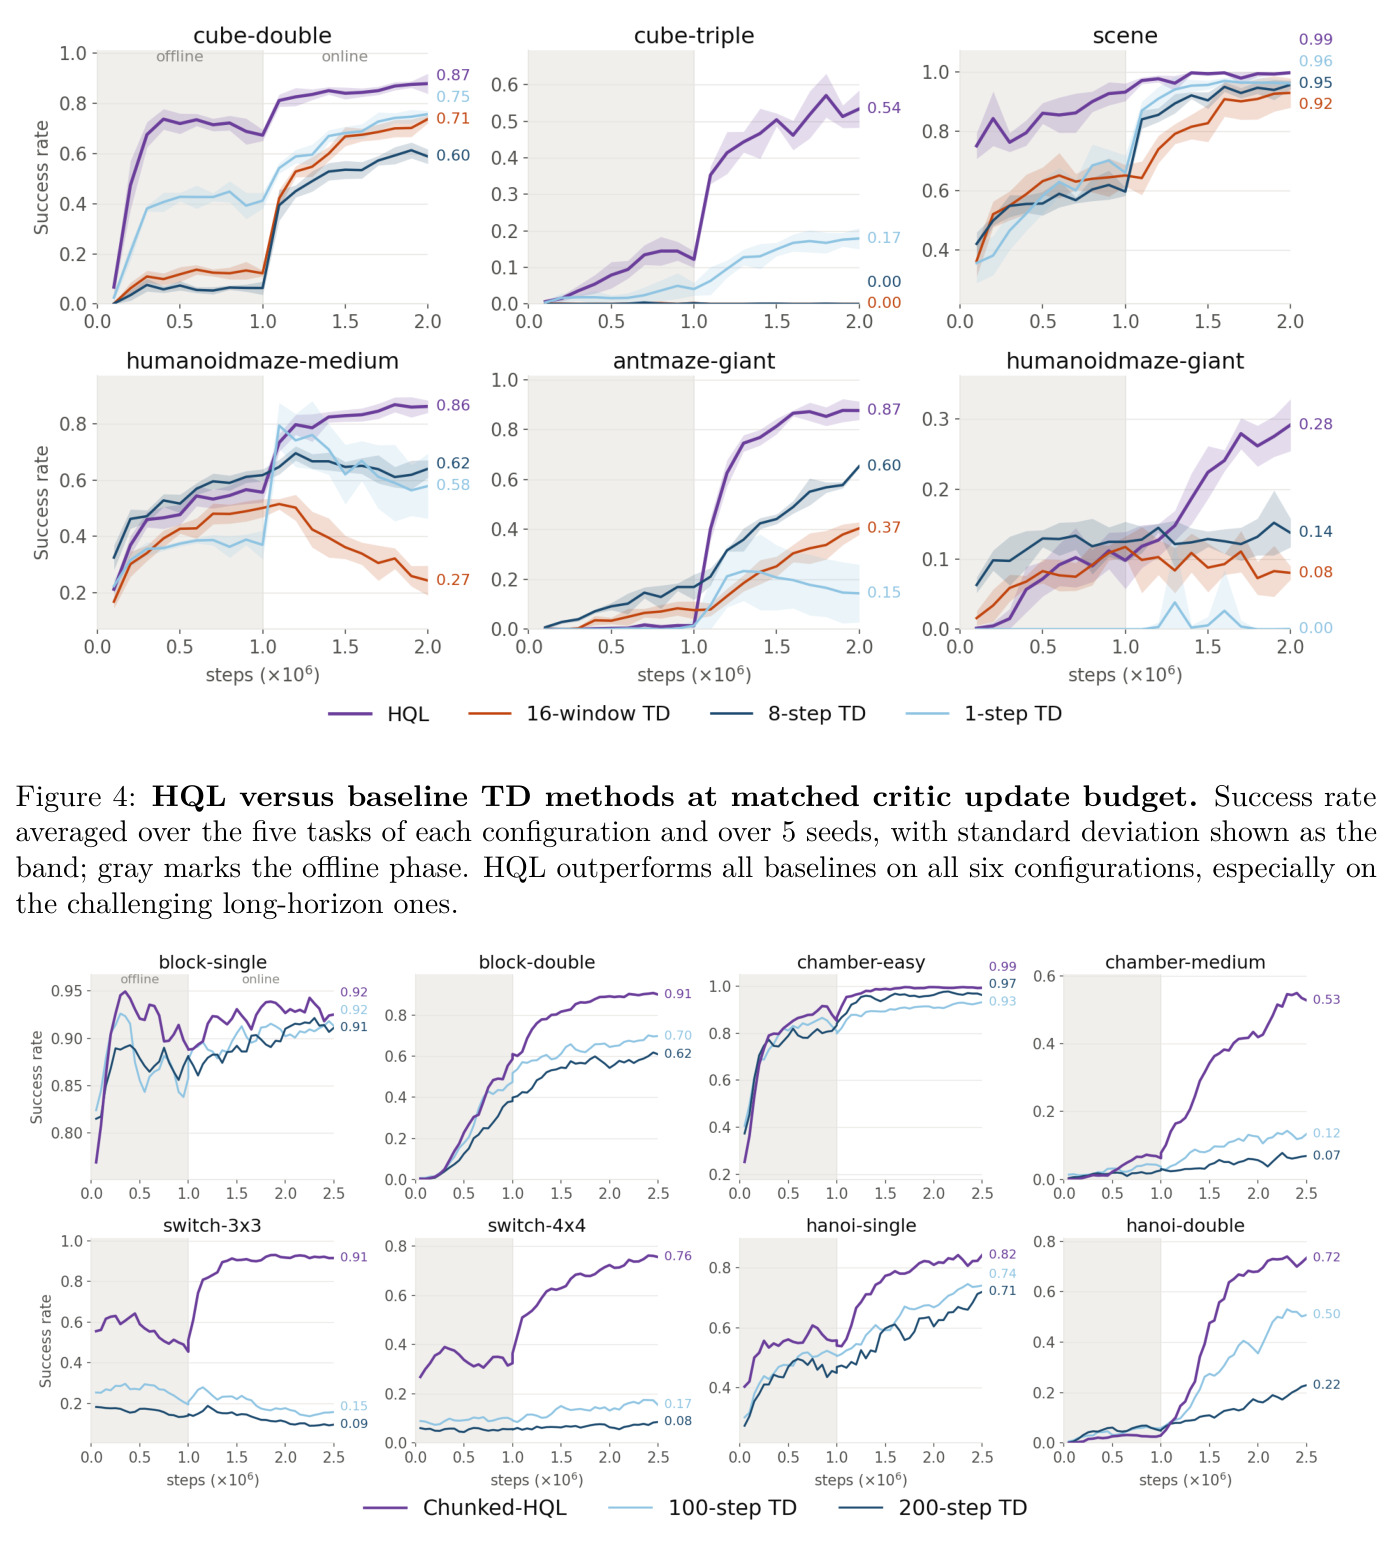
四组实验全部支持方法有效性。(Q1) 组合锁($H \in \{512, 1024, 2048, 4096\}$,污染率 0-75%):干净数据上一步 TD 的 $Q$ 估计 RMSE 从 $H=512$ 到 4096 增长三个数量级,64 步 TD 一旦有任何污染就发散,HQL 在全部视界与污染水平下误差最低。(Q2) OGBench 六配置(5 seeds、预算对齐 512 目标/更新):HQL 在线平均成功率 0.74,对最好的 TD 基线 8-step TD 的 0.49;比 LQL 高 12%(74% vs 62%)、比 Q-chunking 高 29%(74% vs 45%),Chunked-HQL 达 81%。cube-triple 上 HQL 从 0 升到 54%,而两个多步基线为 0。有趣的是 trace 长度统计:77% 的目标恰好一步、17% 两步、6% 三步以上,没有一个超过 16 步窗口中的 6 步——HQL 赢在"选择延伸谁"而非"延伸得远"。OCBench 八个 50Hz 任务:Chunked-HQL($L=25,H=8,N=2$)2.5M 步平均成功率 0.82,对 100 步 TD 0.53、200 步 TD 0.46;switch-3x3 差距最大(0.91 vs 0.15),chamber-medium 为 0.53 vs 0.12,且 200 步 TD 在 8 任务中 7 个劣于 100 步 TD,印证偏差随 $n$ 增长。(Q3) 即插即用:HQL+QAM 在 cube-triple 从 1% 升到 80%、hmaze-giant 从 0% 到 63%;HQL+VGF 在 antmaze-giant 从 28% 到 90%,四任务全部提升。(Q4) 消融:窗口 $H \in \{8,16,32\}$ 影响小(0.607/0.646/0.621),门宽 $N$ 影响大且越小越好($N=4/8/16$ 对应 0.596/0.521/0.461),硬门平均 61% 胜过软门 $\tau \in \{0,0.5,1,3,30\}$ 的 36%/41%/48%/53%/57%。
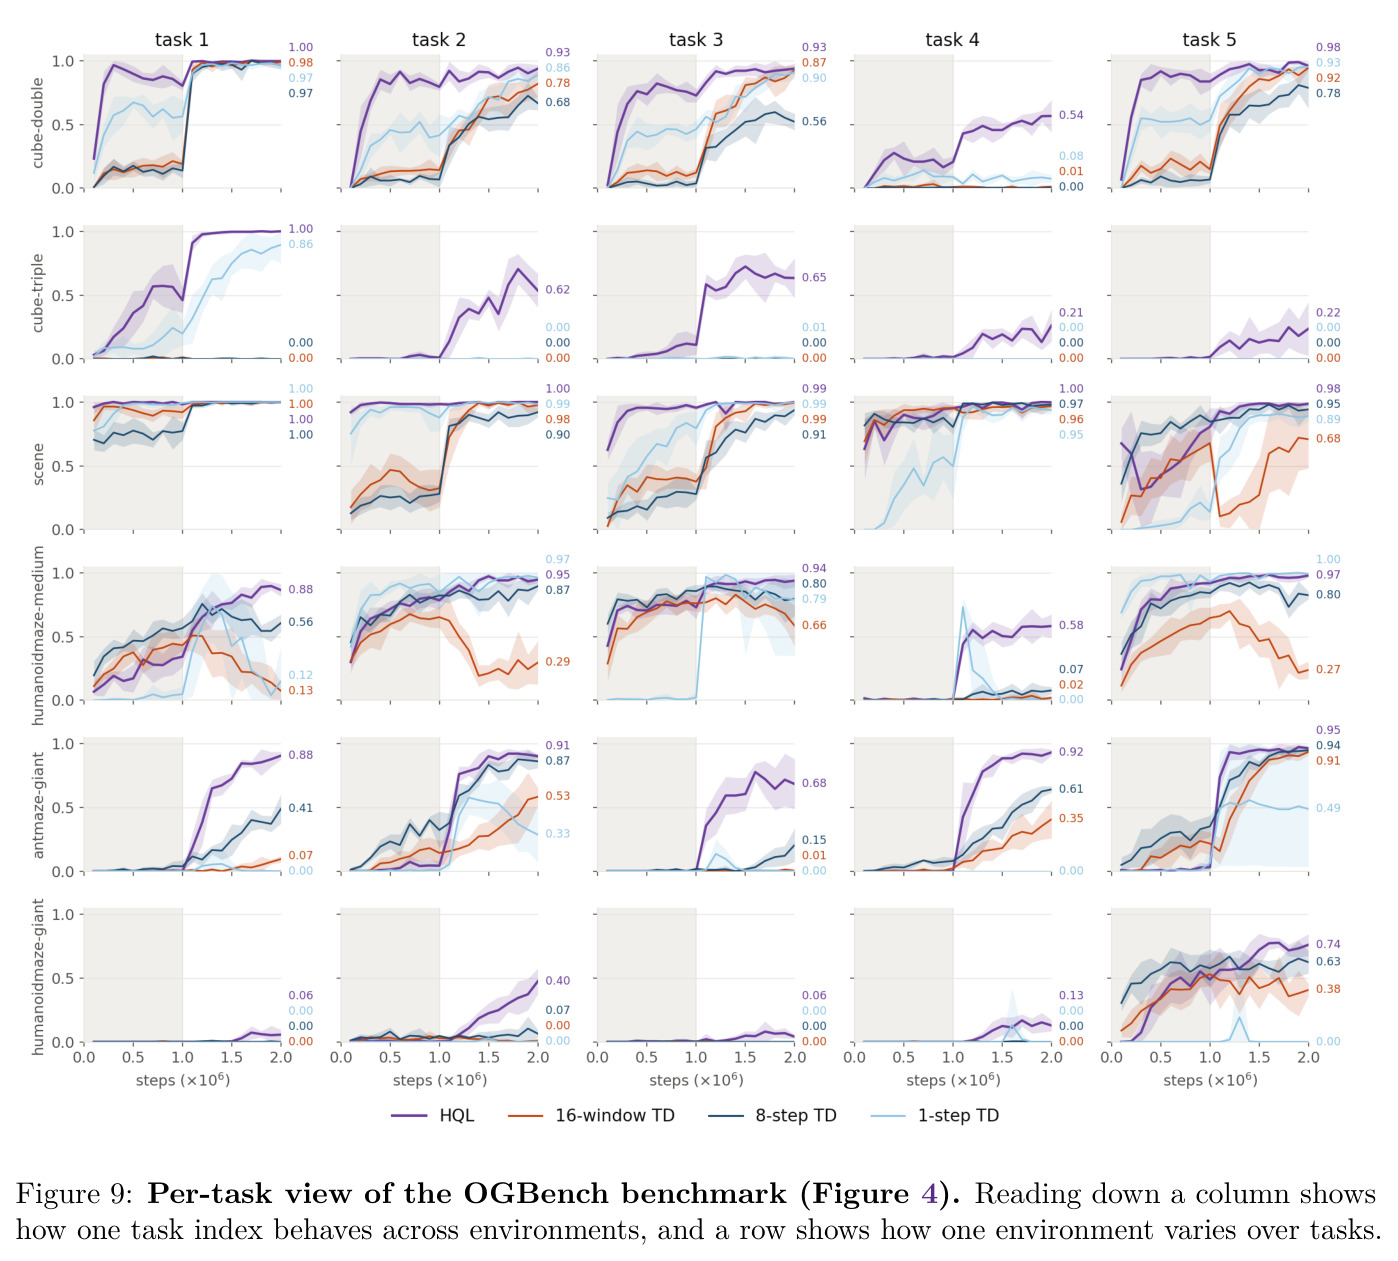
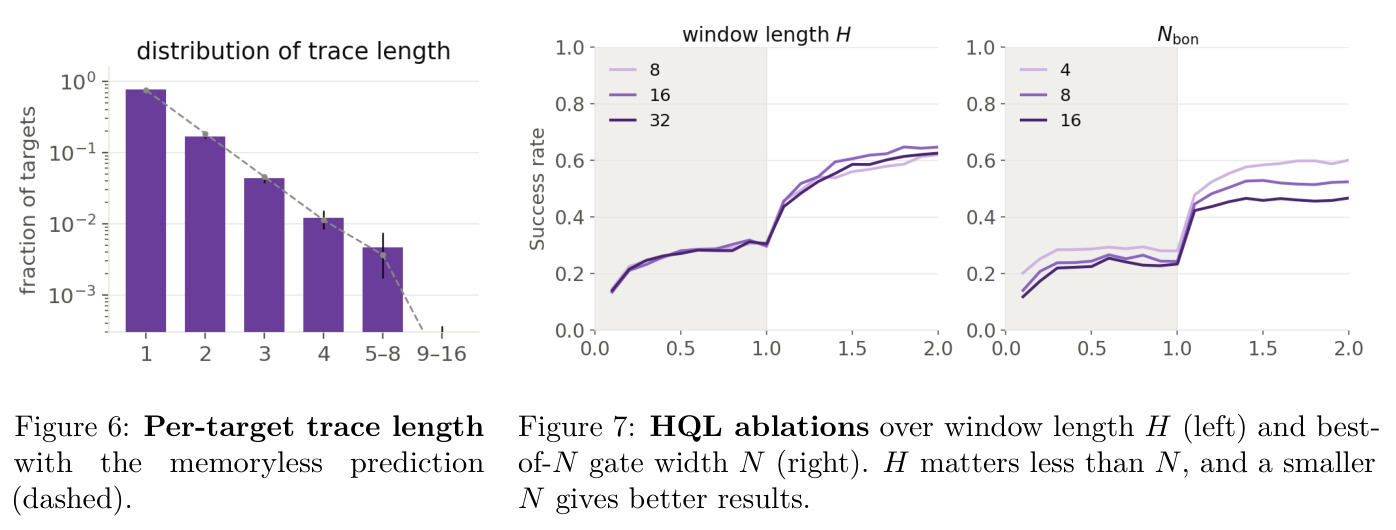
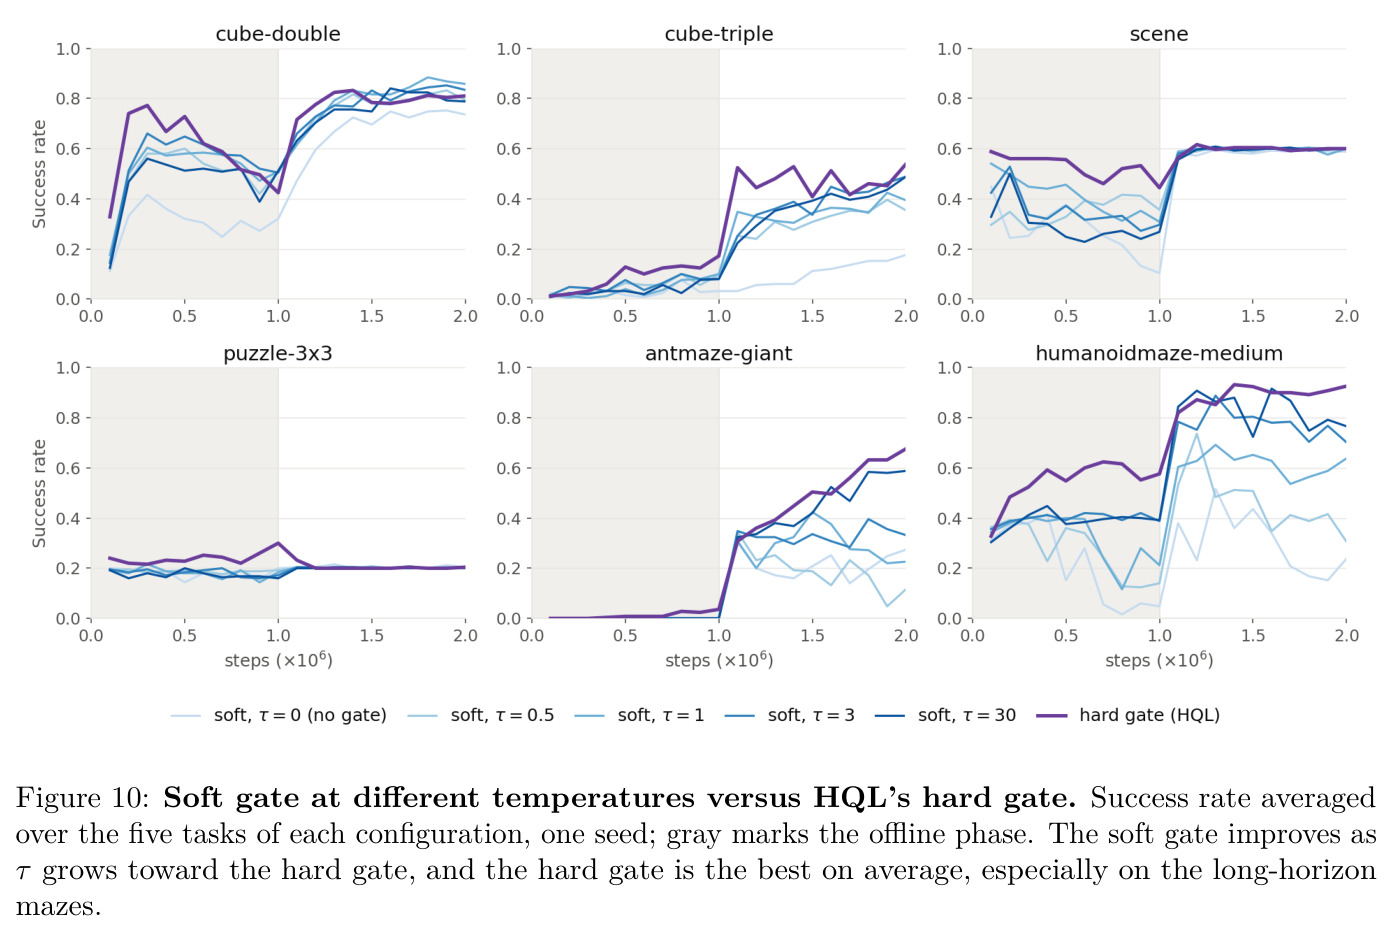
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 组合锁(H=512–4096,污染率 0–75%) | RMSE(Q_θ, Q*)(1M 次更新后,对数尺度) | 全部 20 个视界×污染组合中误差均为最低,且对污染不敏感 | 1-step TD 干净数据下误差随 H 增长三个数量级;64-step TD 一旦污染即发散 | 同时避免两类失败模式,跨视界稳定最低 |
| OGBench 六配置平均(5 seeds) | 在线平均成功率(离线→在线) | HQL 40→74%;Chunked-HQL 41→81% | 最佳 TD 基线 8-step TD 0.49;16-window TD 平均最弱 | 较最佳 TD 基线 +25 个百分点 |
| OGBench 对比 LQL / Q-chunking(匹配预算) | 在线平均成功率 | HQL 74% | LQL 62%,Q-chunking 45% | 较 LQL +12%,较 QC +29%;QC 在两个人形迷宫为 0%,HQL 为 28%/86% |
| OCBench 八个 50Hz 操作任务平均 | 2.5M 步平均成功率(1 seed) | Chunked-HQL 0.82 | 100-step TD 0.53;200-step TD 0.46 | +0.29 / +0.36,且长 n 基线在 7/8 任务上更差 |
| OCBench switch-3x3 / switch-4x4 / chamber-medium | 成功率 | 0.91 / 0.76 / 0.53 | n-step TD 0.15 / 0.17 / 0.12 | 最难的三个任务差距最大(+0.76 / +0.59 / +0.41) |
| OGBench cube-triple(QAM 策略提取) | 在线成功率 | HQL+QAM 0→80% | QAM 单独 1→1% | +79 个百分点,验证 HQL 可作即插即用 critic |
| OGBench antmaze-giant(VGF 策略提取) | 在线成功率 | HQL+VGF 0→90% | VGF 单独 1→28% | +62 个百分点 |
| 门宽 N 消融(H=8,1024 目标/更新) | 平均成功率(30 个环境-任务单元) | N=4:0.596 | N=8:0.521;N=16:0.461 | 更小的 N 更好,波动幅度约为窗口 H 消融的三倍 |
局限与改进
作者承认的局限:门控依赖 critic 自身的排序,训练早期 critic 不准时门会出错,且论文未给出函数逼近下的收敛保证,只把它列为未来工作。我自己的观察:其一,best-of-N 比较存在结构性保守偏差——与候选可交换的日志动作只有 $1/(N+1)$ 的概率通过,$N$ 越大门越紧、方法越退化为一步 TD,消融中 $N=16$ 掉到 0.461 即是证据;其二,评估强度不均,OCBench 与附录消融(软硬门、门宽)只用 1 个 seed(门宽消融 2 个),结论方差未知;其三,Chunked-HQL 中每个 $L=25$ 的块仍开环执行,门只能决定整块去留,块内错误无法修复;其四,消融中 $N$ 同时改变门宽与 best-of-N 执行宽度,两处效应耦合无法单独归因;其五,按目标数对齐预算后,每个目标的计算仍随 $N$ 增长(每转移 $N$ 次行为采样加 critic 前向)。
独立分析的弱点
独立分析四个弱点。(1) 门的自举循环依赖:门用当前含噪 critic 的排序决定信任谁,训练早期错误切断好动作会拖慢价值传播、错误放行坏动作会引入偏差;改进方向是先纯一步 TD 预热再开窗、用 critic ensemble 的分歧度给门加权(低置信时保守切断)、或对门做指数滑动平均平滑。(2) best-of-N 的接受偏差:可交换动作只有 $1/(N+1)$ 概率存活,门系统性地偏保守,长视界收益可能因此被低估;改进方向是用行为值分布的分位数校准阈值,或对通过率做重要性补偿而非简单 max 比较。(3) 决策粒度与偏差的耦合:Chunked-HQL 的 $L=25$ 块开环执行,在 hanoi 这类高接触比操作上块内漂移可能放大误差,可探索块内可中断的分层门控或更细的 $L$ 配合更大的 $H$。(4) 理论缺口:误差律建立在残差弱相关噪声模型与表格情形上,实际深度网络下的门控误差传播(门的错误率与 critic 误差的耦合)没有 bound,值得建立包含门错误率 $p_{\mathrm{err}}$ 的误差界。
未来方向
作者明确提出的方向是把 HQL 的门控应用到子目标层面的层次 RL,让"一个决策"变成一个子目标而非动作块,从而在更高抽象层缩短视界。基于论文成果可以延伸的方向:(1) 与准度量价值函数、子目标图搜索等 goal-conditioned 结构结合,利用其视界结构性同时保留免密度门控;(2) 在线 RL 的 replay buffer 中动态开关门控,刻画门通过率随训练进程的演化曲线,并据此自适应调节 $N$ 与窗口 $H$;(3) 为门控目标建立函数逼近下的收敛或误差界,说明 critic 估计误差与门错误率如何相互放大;(4) 与 model-based rollout 结合,在学到的世界模型生成的轨迹上延伸门控目标,进一步减少对数据覆盖的依赖;(5) 探索带不确定性的软门——用 ensemble 方差或分位数回归替代硬阈值,缓解早期排序不准;(6) 把门控思想迁移到偏好优化或 RLHF 中长序列的信用分配问题。
复现评估
复现条件较好但算力门槛高。论文提供了 Website 与 GitHub 链接,实现为统一 JAX 代码库:所有对比方法共享网络、优化器与行为流采样器,仅目标构造不同,超参在表 4/表 6 完整列出(critic 2-ensemble 取均值、宽度 512/深度 4、GELU、LayerNorm、Adam、学习率 $3 \times 10^{-4}$、目标网络更新率 $5 \times 10^{-3}$、OCBench 用 HL-Gauss 101 bins critic 与 $\gamma=0.9999$)。数据集公开:OGBench 六配置(1M-4M 转移)与 OCBench 八任务(50Hz 脚本策略数据)均可下载。算力方面,单次 2M 步运行在 8 卡 A100/H100 节点上约 150 iterations/s、4-6 小时,主实验为 6 配置 × 5 任务 × 5 seeds × 多基线,总量达数百 GPU 时;OCBench 单 run 需 2.5M 步与每 50K 步 500 episode 的评估。单配置复现一天内可在单节点完成 1-2 个 run,完整复现全部基线需要小集群;注意 OCBench 与附录实验只有单 seed 可对照。
论文图表