基于标量伴随匹配的Q学习 Q-Learning with Scalar Adjoint Matching
用闭式标量伴随免去逐步VJP,微调流策略做离线RL,OGBench最难域提升18-35点
前置知识
流匹配与流策略
流匹配训练一个速度场 $v_\theta(x, \tau)$,通过常微分方程 $dX_\tau = v_\theta(X_\tau, \tau) d\tau$ 把高斯噪声 $X_0$ 逐步输运成目标分布的样本 $X_1$,常用线性插值路径 $X_\tau = (1-\tau)X_0 + \tau X_1$。流策略把这个生成过程用在动作上:给定状态 $s$,从噪声出发积分速度场,终点 $X_1$ 就是动作。它能表达多模态的动作分布。
本文微调的对象就是流策略的速度场本身,SQAM 的所有设计(伴随、回归目标、信任域)都围绕这条去噪链展开,不懂流策略就无法理解为什么要向中间流步传播梯度。
伴随匹配
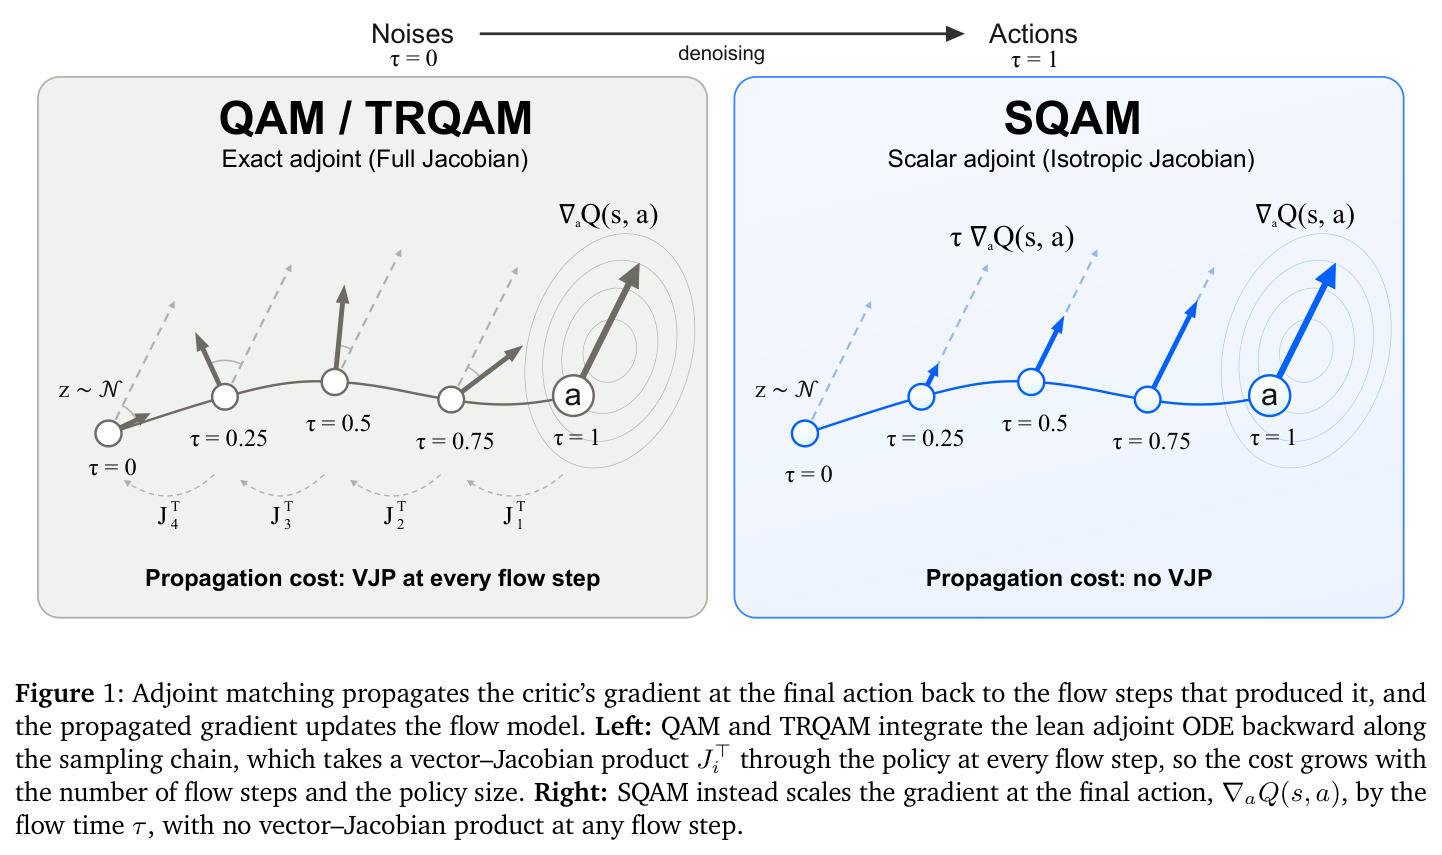
critic 只评估最终动作的好坏,而动作是经许多流步生成的,中间每步都需要知道往哪个方向推才能提高终点价值。伴随匹配从终点处的价值梯度 $-\nabla_{X_1} Q$ 出发,反向积分 lean adjoint ODE $d\tilde{a}_\tau = -\tilde{a}_\tau^\top \nabla_{X_\tau}(2v_{\text{base}} - \frac{1}{\tau}X_\tau) d\tau$,把价值信息送到每个流步,再让微调速度场去匹配这些方向。
SQAM 是伴随匹配家族(QAM、QAM-E、TRQAM)的直接改进,论文的动机、理论和实验对比全部建立在这个框架之上,核心创新就是把它的 ODE 积分换成闭式标量。
向量-雅可比积(VJP)
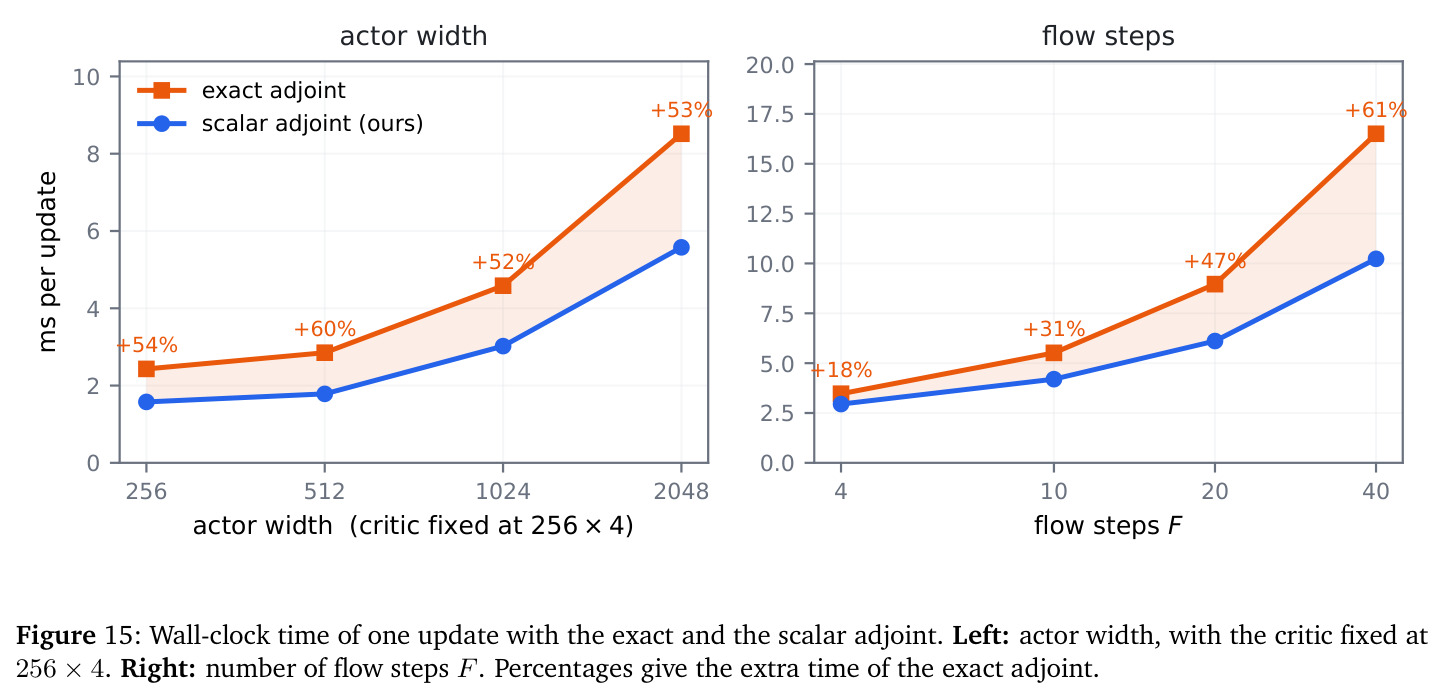
反向模式自动微分中的基本操作:给定一个向量和一个函数的雅可比矩阵,计算二者的乘积 $J^\top v$,等价于对函数做一次反向传播。伴随匹配在每个流步都要对策略网络做一次 VJP,因此单次参数更新的计算量随流步数和策略规模线性增长。
逐步 VJP 正是本文要消除的成本瓶颈,理解它的代价才能体会标量伴随把 $N$ 步 VJP 降为一次 critic 梯度的意义,尤其对大规模 VLA 策略这一优势是决定性的。
Actor-Critic 与 Q-learning
off-policy RL 的标准范式:critic 学习动作价值函数 $Q_\pi(s,a) = \mathbb{E}_\pi[\sum_{k\geq 0} \gamma^k r(s_{t+k}, a_{t+k})]$,用 TD 回归拟合;actor 则通过最大化 $Q$ 来改进策略。策略更新通常依赖 critic 在策略生成动作处的梯度 $\nabla_a Q$。
论文的核心论断是瓶颈在 critic 而非 actor:标量伴随直接消费 $\nabla_{X_1} Q$,所以 critic 在策略生成动作 $a_\pi$ 处的准确性决定成败,价值惩罚这一关键设计就源于此。
离线 RL 与 offline-to-online 微调
离线 RL 只用固定数据集训练策略,不允许与环境交互;offline-to-online 则先在离线数据上预训练,再用真实交互继续微调,主要难点是分布偏移导致价值函数高估和策略遗忘。本文设定是用行为克隆预训练的流策略出发,先离线微调 1M 步,再在线训练到 1.5M 步。
这是论文全部实验的评测设定(OGBench 50 任务 + 真实机器人),理解这个设定才能读懂表格中的 1M/1.5M 步数、成功率曲线以及价值惩罚对分布偏移的控制作用。
OGBench
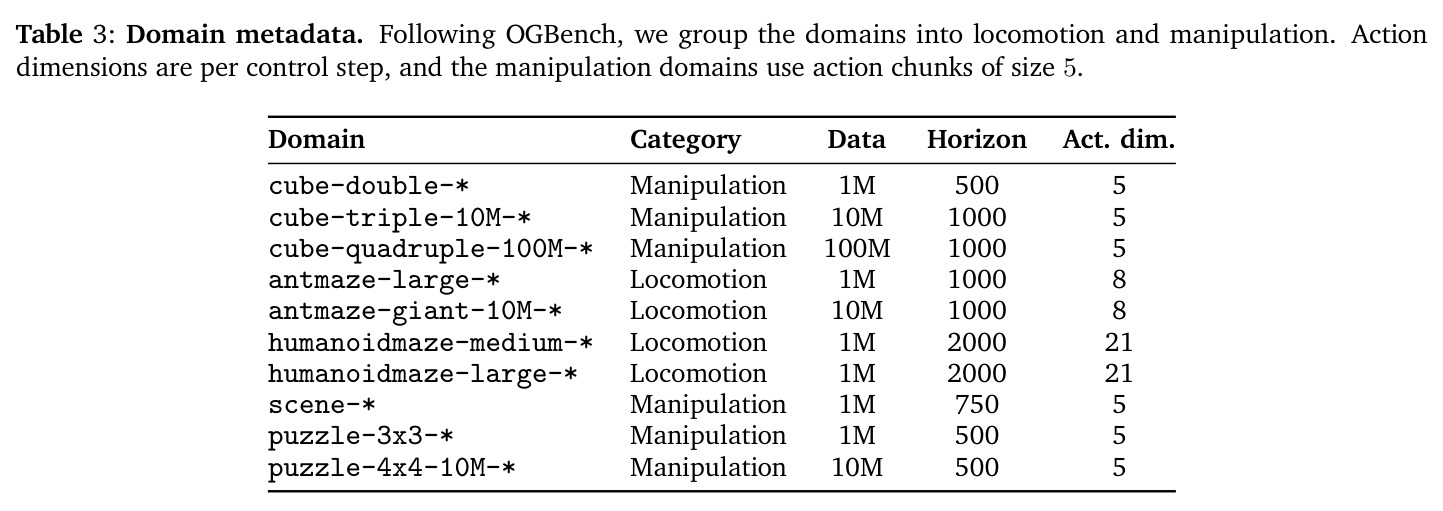
一个目标条件 RL 基准,含 locomotion(antmaze、humanoidmaze 等)和操作(cube、puzzle、scene 等)共 10 个域,每域 5 个任务。本文使用其基于奖励的单任务变体,操作域采用 chunk size 为 5 的动作分块策略,所有方法从同一行为克隆预训练流策略(300K 步)出发。
它是主实验的战场,论文反复引用其中四个最难域(antmaze-giant、humanoidmaze-large、cube-triple、cube-quadruple)上的 18~35 点提升来支撑结论。
研究动机
流策略已成为离线 RL 和大规模机器人预训练的主流策略类,它通过流匹配把噪声逐步去噪成动作,能表达丰富且多模态的动作分布。要在示范数据之外继续提升,就需要用 off-policy RL 对着学到的价值函数微调它。困难在于:critic 只告诉人们最终动作好不好,而动作是在许多流步中生成的,中间每一步都需要知道该把状态往哪个方向推。Adjoint matching(QAM、QAM-E、TRQAM)通过反向积分 lean adjoint ODE 把终点处的价值梯度逐级回传到每个流步,理论上有保证,但每一步都要做一次穿过策略网络的向量-雅可比积(VJP),单次更新的计算量随流步数和策略规模线性增长,这对 π0、RLDX-1 这类大规模预训练流策略几乎不可承受。另一个隐性问题在价值学习一侧:作者发现当使用廉价近似伴随(而非精确伴随)时,更新质量高度依赖 critic 的正则化方式,而常见方案如 IQL 式 in-sample critic 只在数据集动作上拟合、ReBRAC 只惩罚动作间距离,都没有控制 critic 在策略自身生成动作上的取值,导致标量伴随单独使用时在操作域上失效。
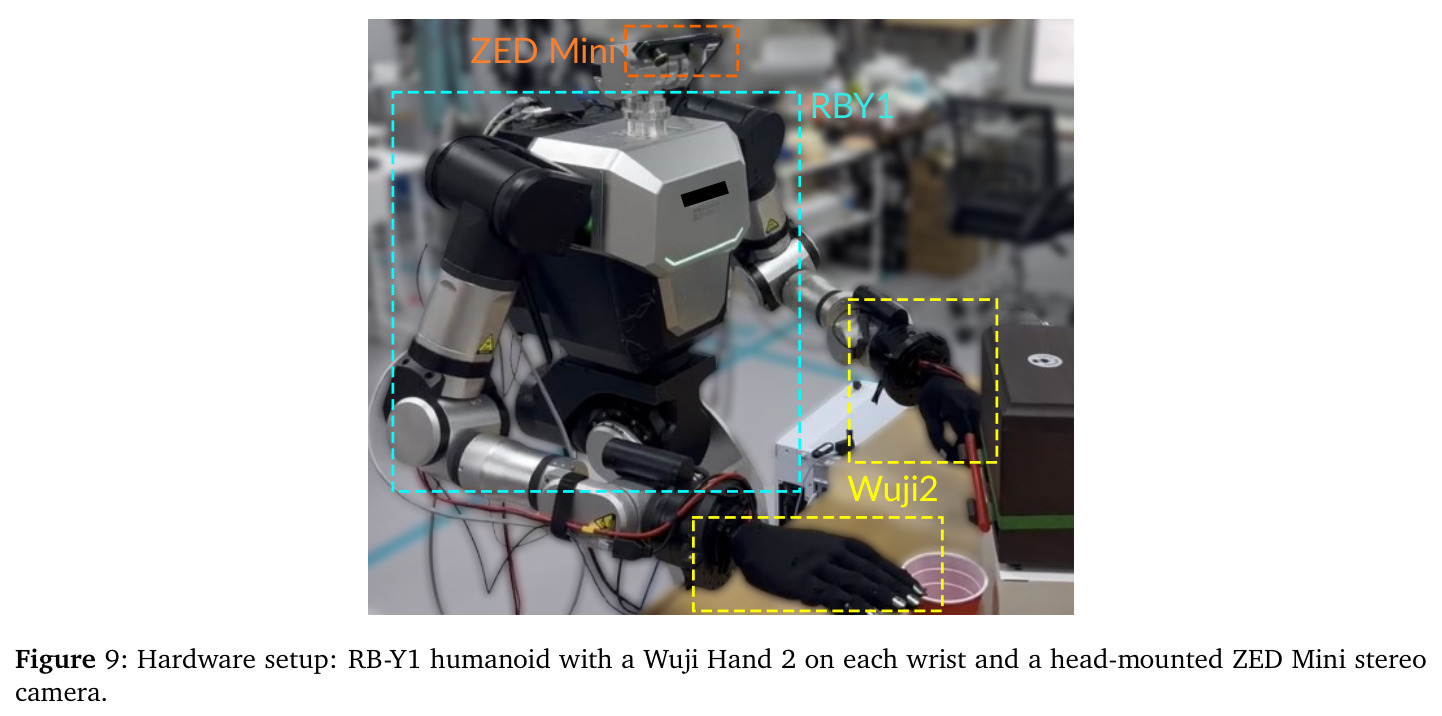
本文的目标是本文的目标可以拆成四点。第一,把伴随匹配的计算成本降到与流步数和策略规模基本无关:去掉每个流步的 VJP,用闭式解替代 lean adjoint ODE 的逐步积分,使方法能扩展到大型预训练策略。第二,系统回答使用标量伴随后价值学习该怎么设计:从多种 critic 正则化方案中找出真正起作用的机制,并给出可解释的理由。第三,在 OGBench 全部 10 个域 50 个任务上,于离线和 offline-to-online 两种设定下全面对比 FQL、CGQL-L、DSRL、IFQL、QAM、QAM-E、TRQAM 七个基线,目标是在总体和最难域上同时领先。第四,验证方法能否跨越 sim-to-real:在真实双臂机器人(双 20 自由度灵巧手)上微调预训练视觉-语言-动作(VLA)策略 RLDX-1,并压过监督微调(SFT)和残差微调(EXPO-FT)。
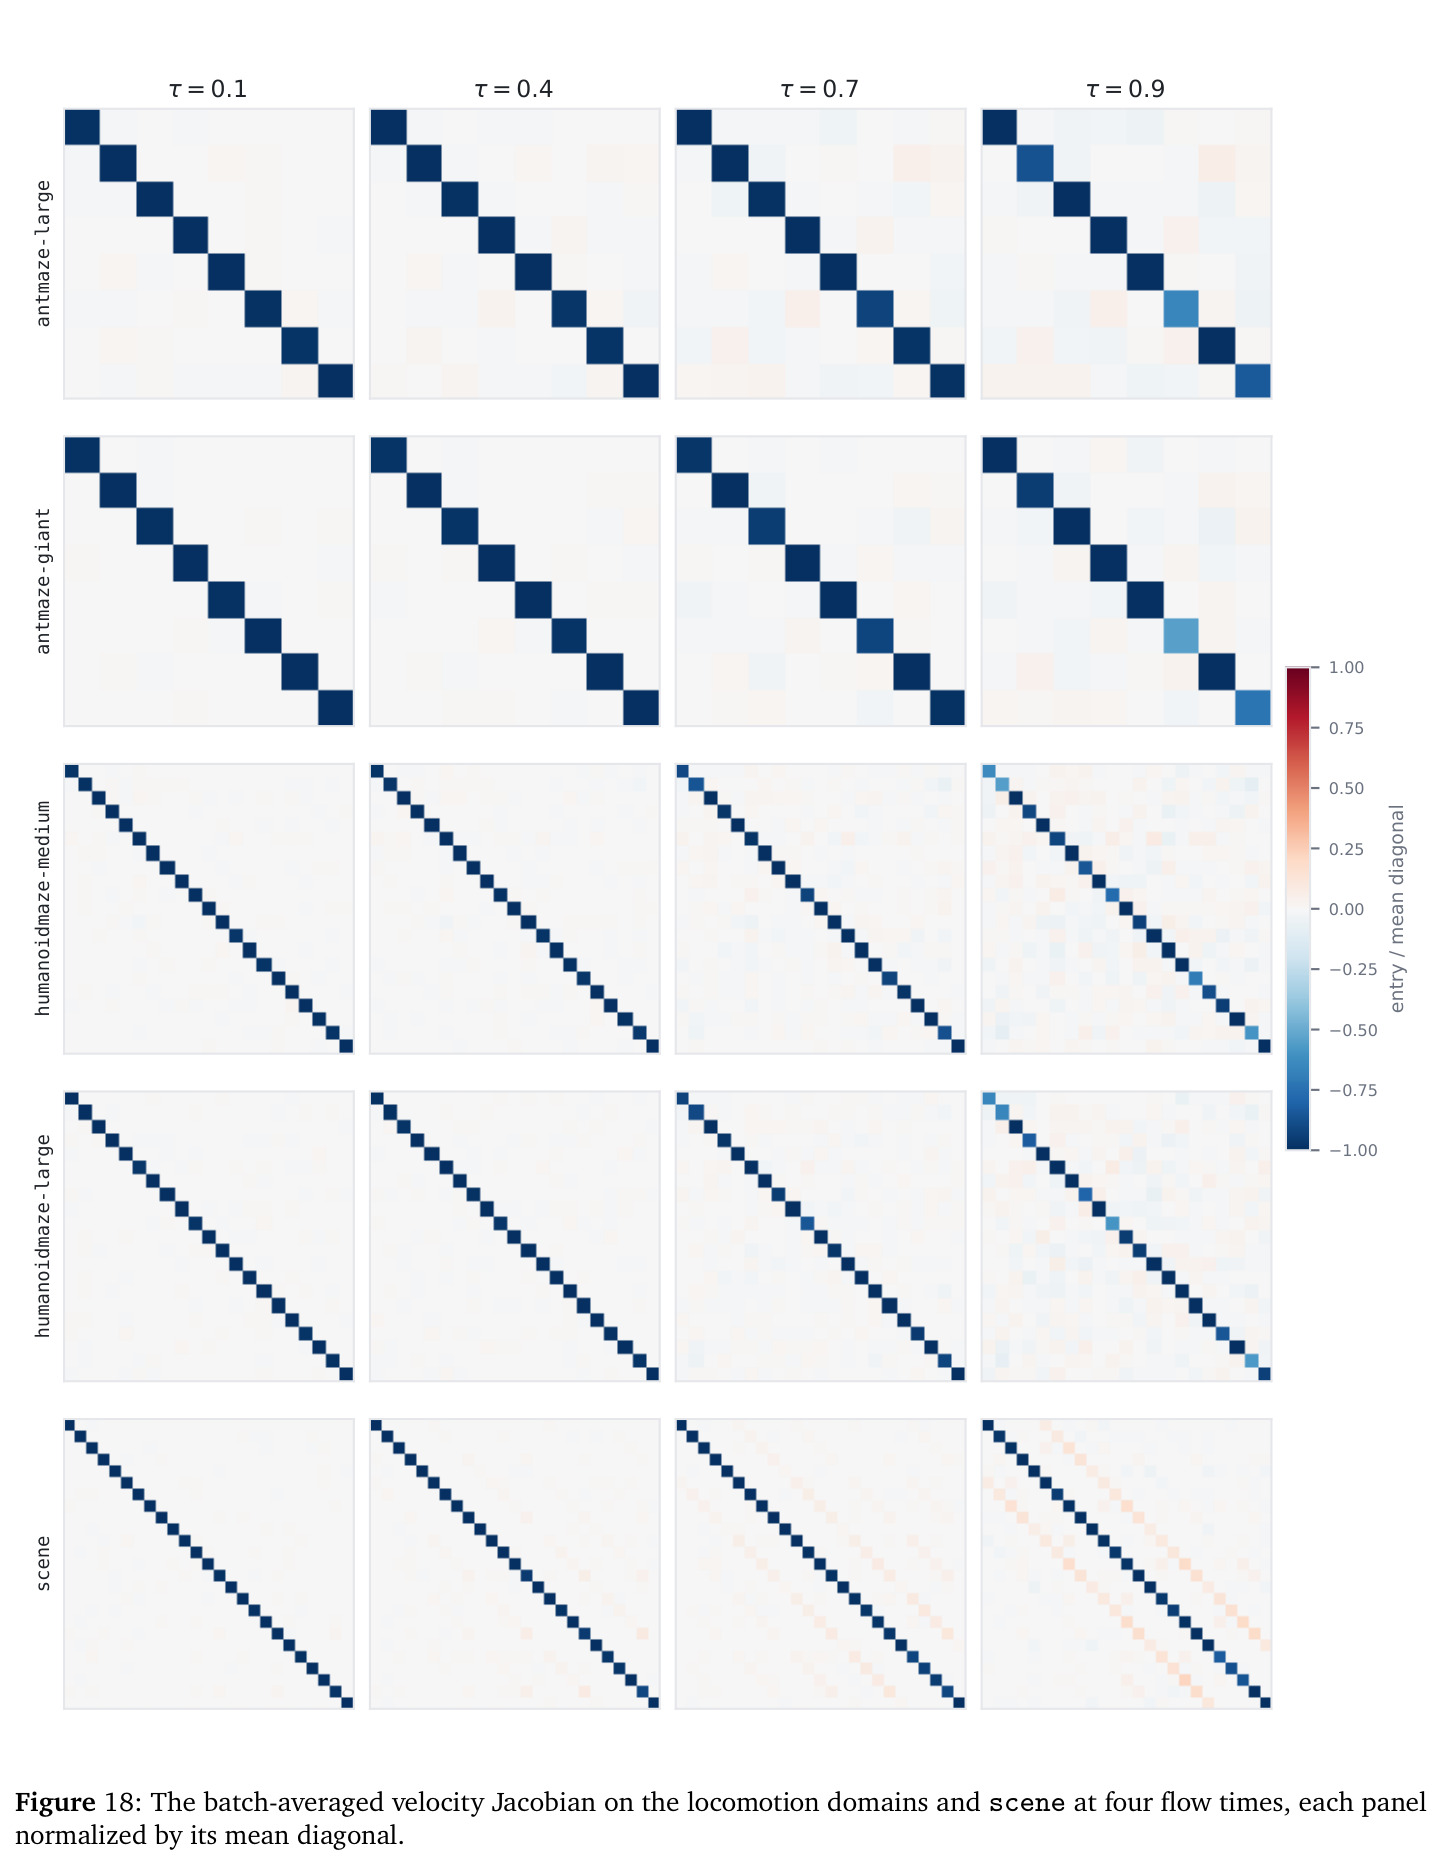
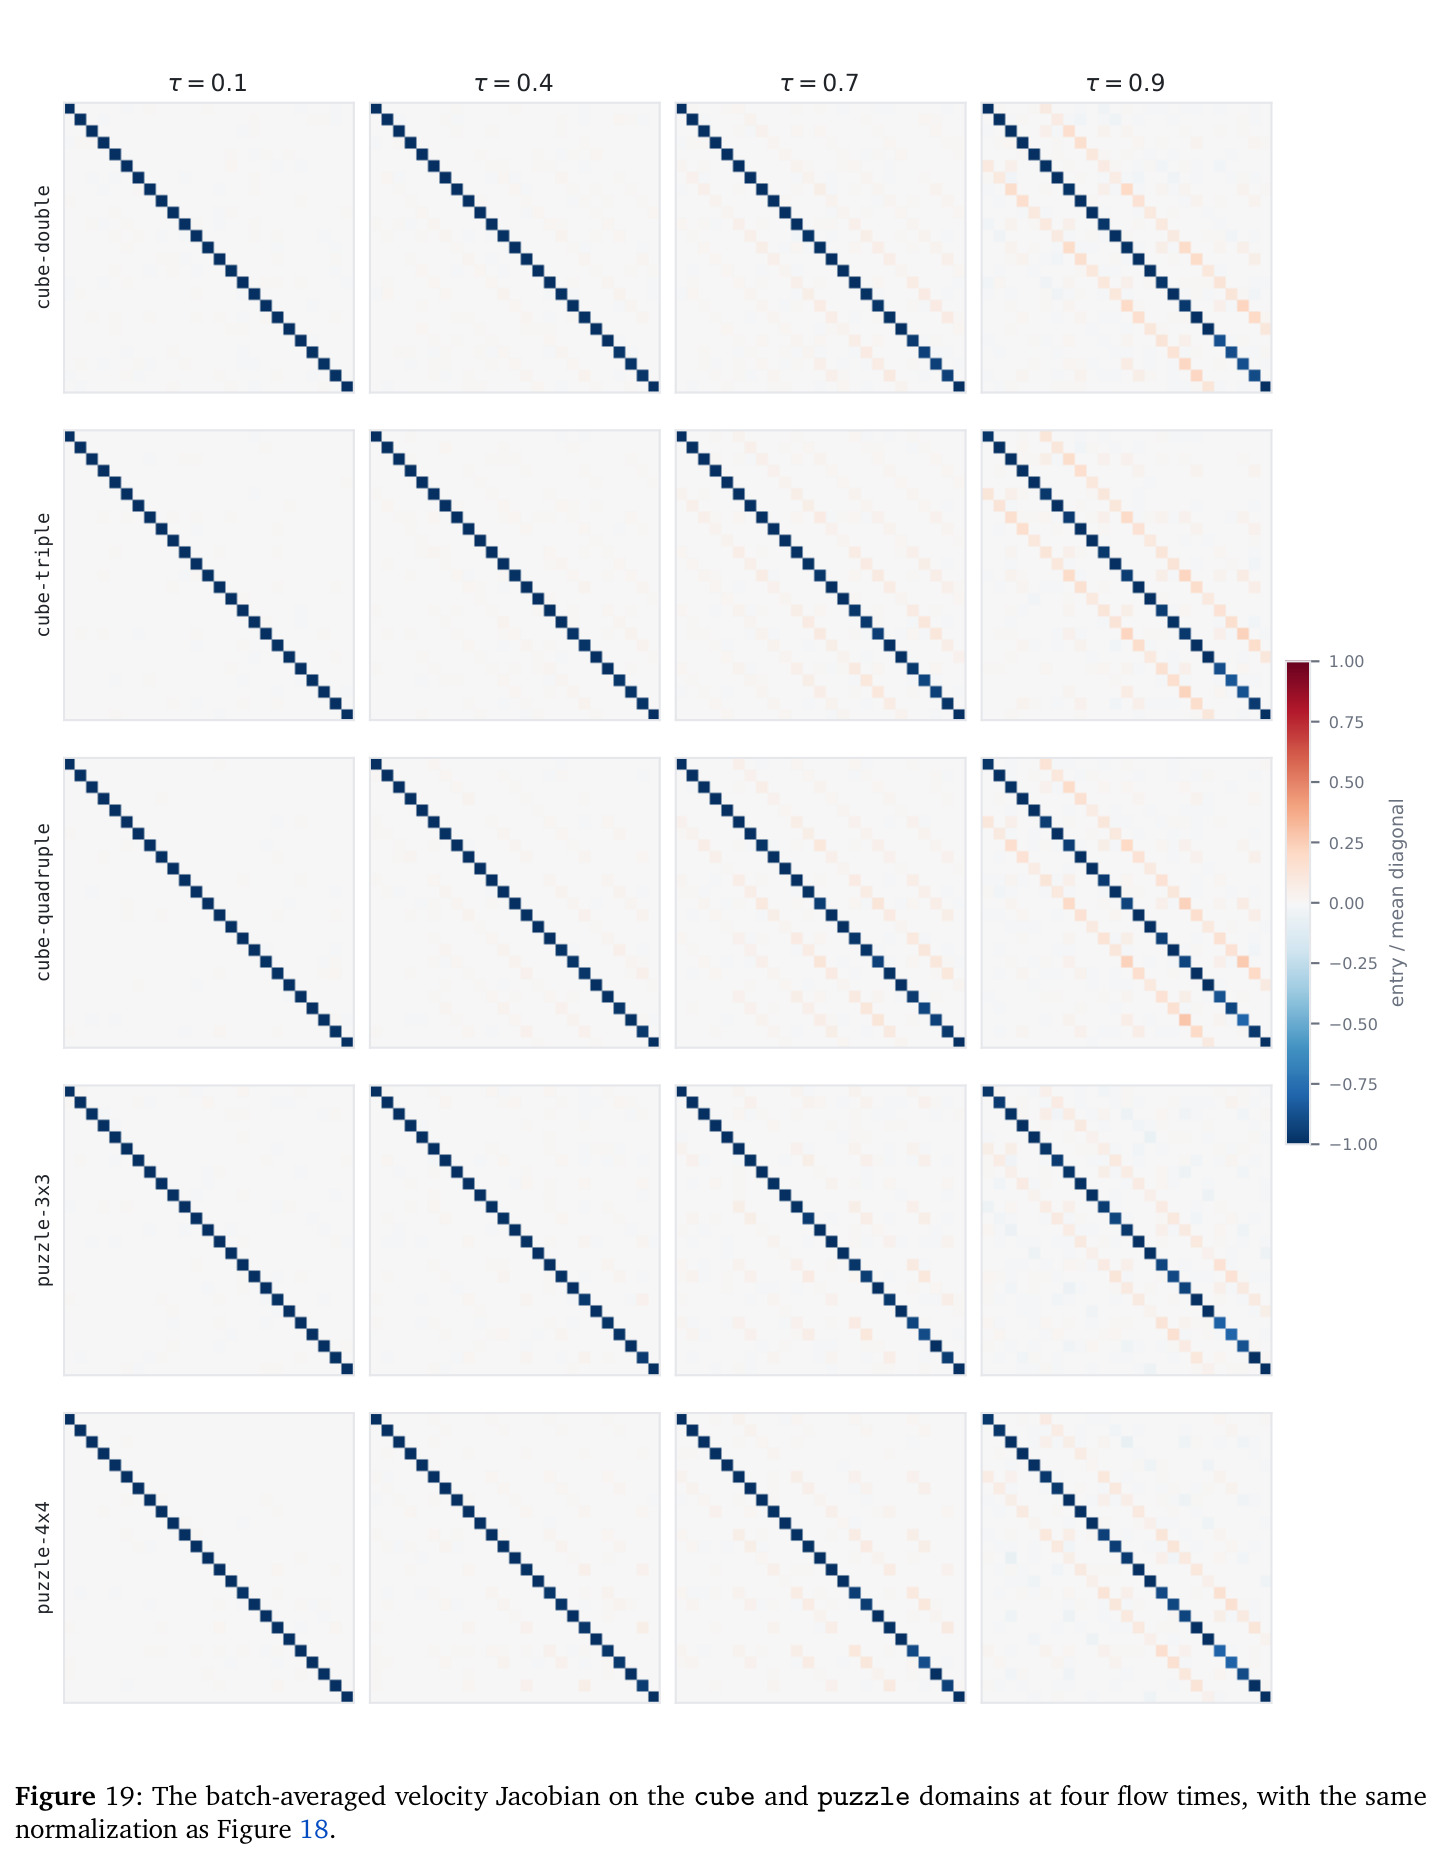
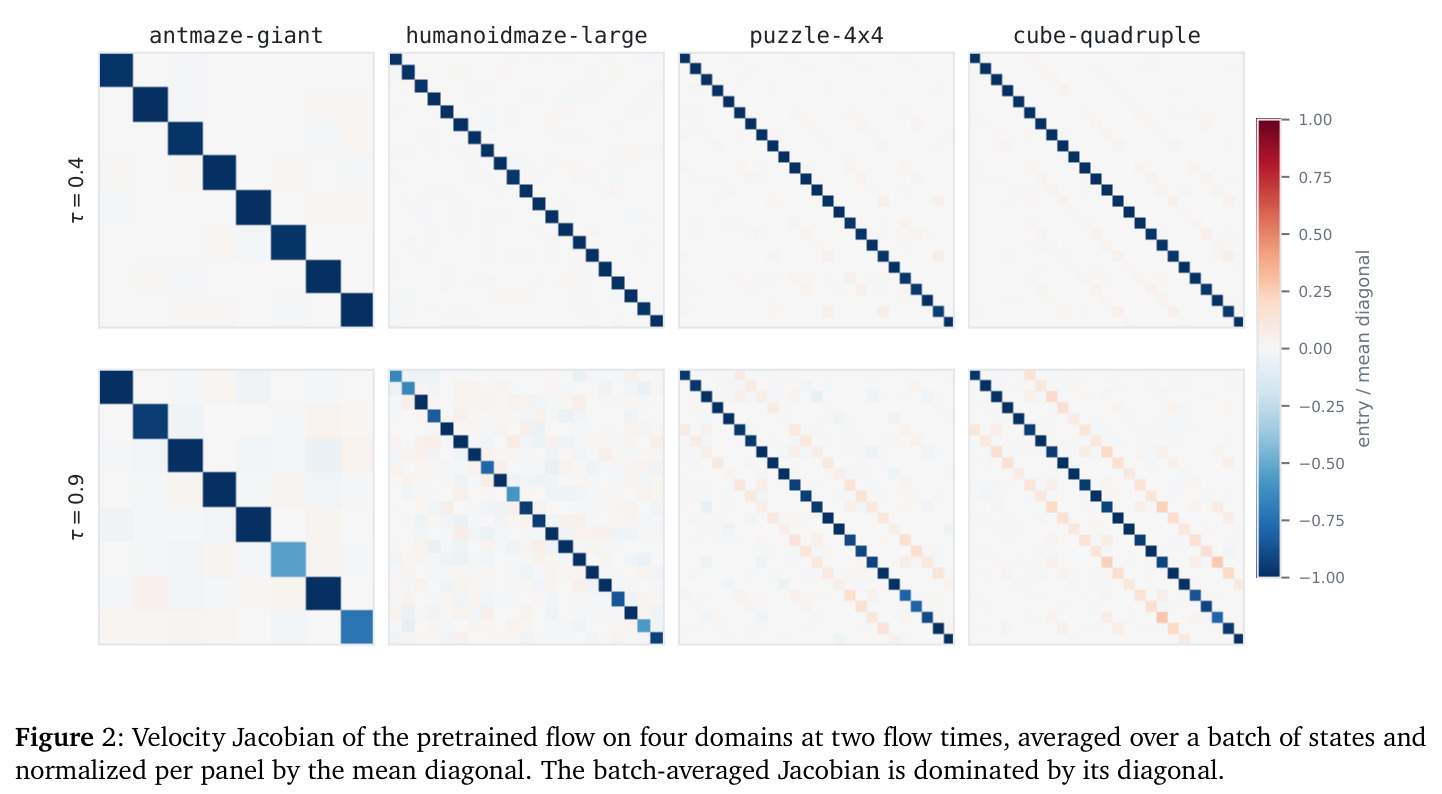
与已有工作不同的是,本文的独特切入点来自一个经验观察:预训练流策略的批量平均速度雅可比 $J_\tau$ 高度集中于对角线(Figure 2,覆盖全部十个域)。这暗示逐点精确的 VJP 可能是多余的。受各向同性后验协方差近似(Peng et al., 2024)启发,作者用标量倍数 $J_\tau = c_\tau I$ 替代整个雅可比,使 lean adjoint ODE 在每个坐标上解耦,得到闭式解——每个流步的伴随等于终点 critic 梯度乘以流时间 $\tau$ 和一个可整体丢弃的指数因子,把「沿链逐步回传」降维成「末端梯度 × 标量」。第二个角度是诊断式的:既然标量伴随每步都直接消费 critic 在策略生成动作 $a_\pi$ 处的梯度,更新质量就完全由 critic 在该点的准确度决定,由此设计出价值惩罚 $c\,[Q(s, a_\pi) - Q(s, a_{\text{data}})]$(对 $a_\pi$ 停止梯度),把正则化精确作用在策略更新真正消费的那一点上——不像 CQL 在 critic 损失内部另采样,也不像 ReBRAC 只约束动作距离而非价值。
核心方法
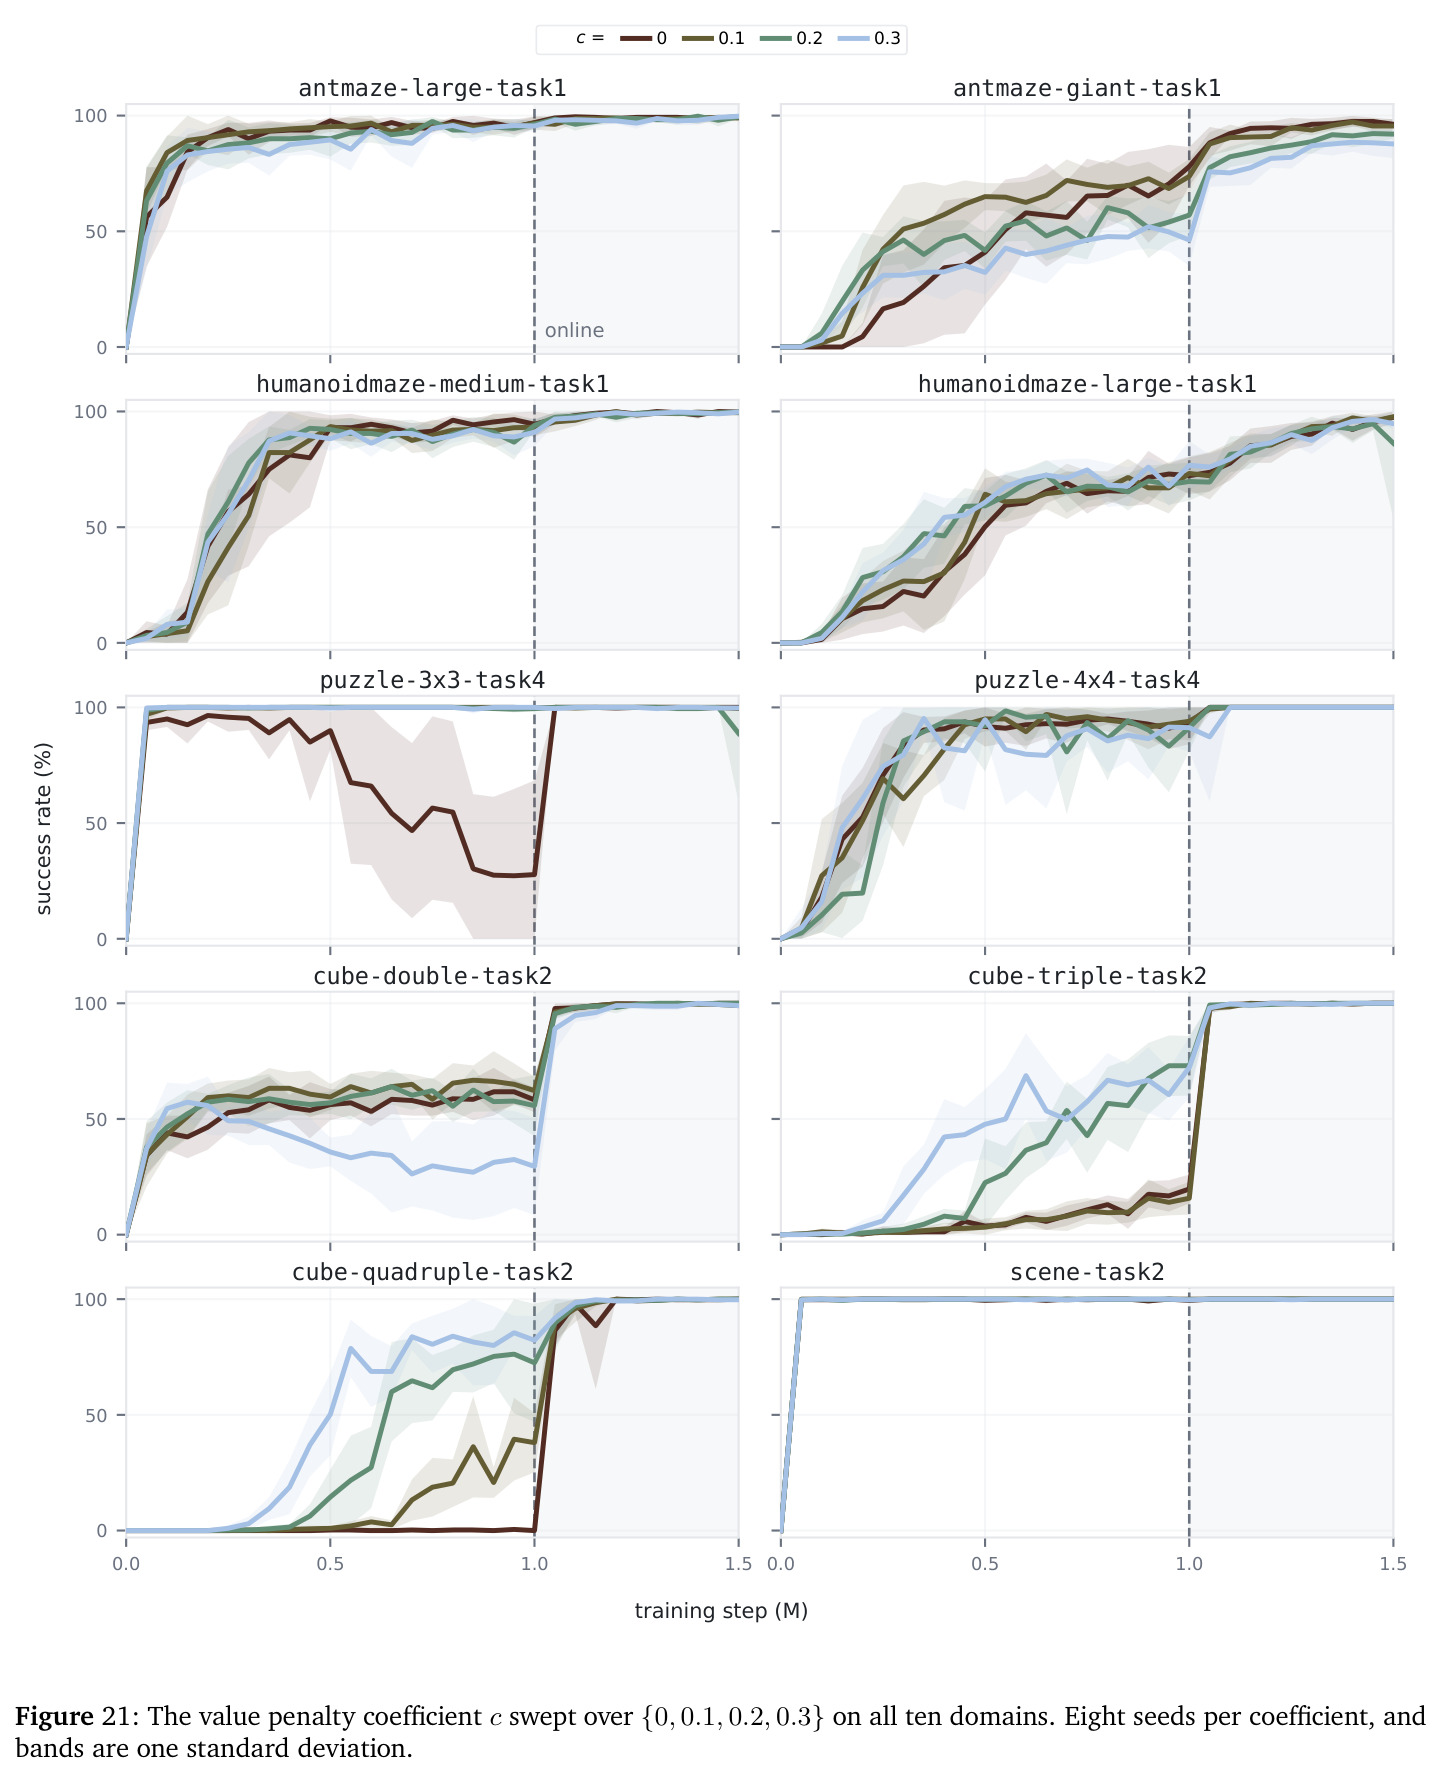
伴随匹配昂贵是因为要沿整条采样链反向积分 ODE,每步都穿过策略网络求雅可比。但预训练流策略的批量平均速度雅可比近似各向同性(Figure 2),替换为 $J_\tau = c_\tau I$ 后,lean adjoint ODE 在每个坐标上解耦,可直接积分得闭式解:伴随等于终点 critic 梯度乘以流时间 $\tau$ 和一个只改模长的指数因子,方向恒为 critic 动作梯度的负方向。丢弃指数因子即得标量伴随 $\hat{a}_\tau = -\tau \nabla_{X_1} Q_\pi$:整条链只需一次 critic 梯度,零次 VJP。技术上,SQAM 保持 adjoint matching 的回归损失,让微调速度场逼近 $v_{\text{base}}$ 加噪声加权的标量伴随,默认沿用 TRQAM 的 KL 信任域 $\varepsilon_{\text{KL}}$ 稳定训练;同时在 critic 损失中加入价值惩罚 $c\,[Q(s, a_\pi) - Q(s, a_{\text{data}})]$,在策略更新依赖的动作点上直接控制 critic 取值。
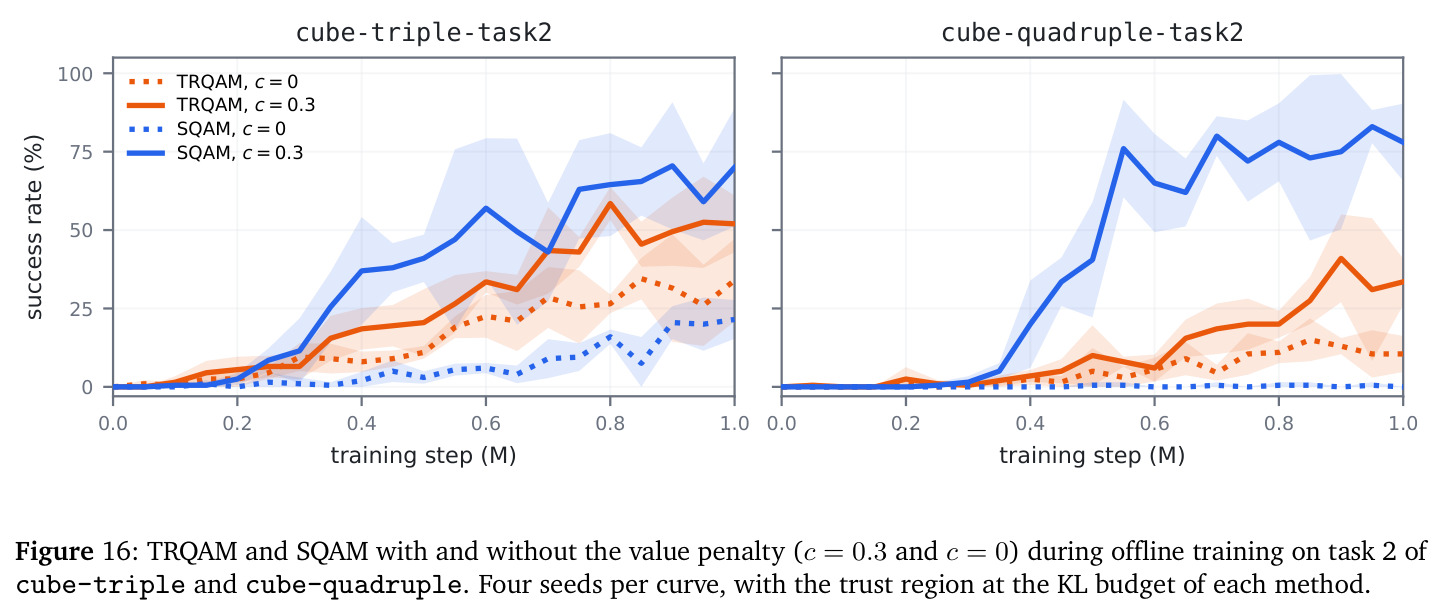
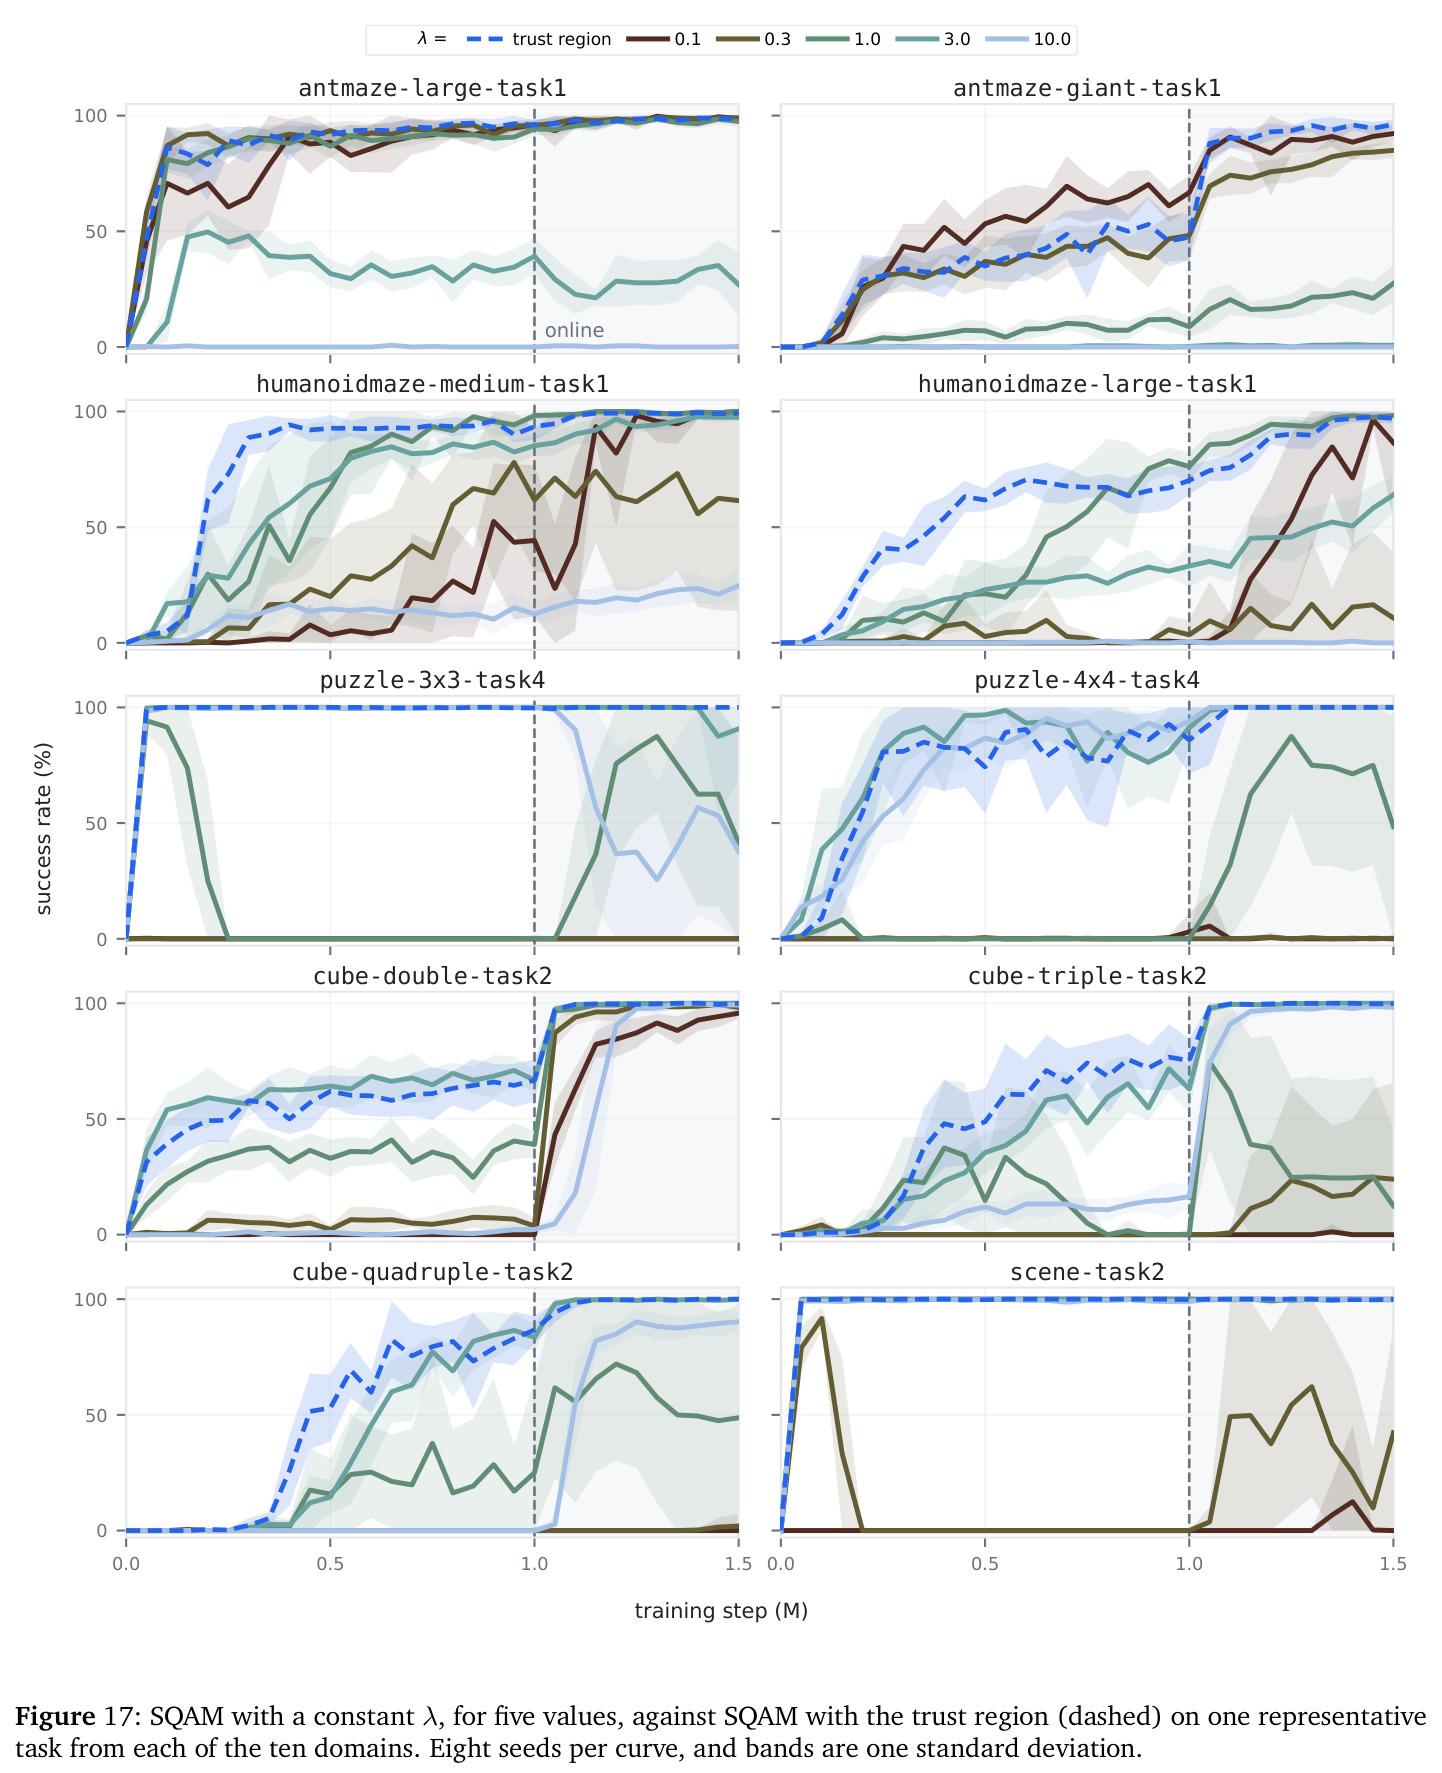
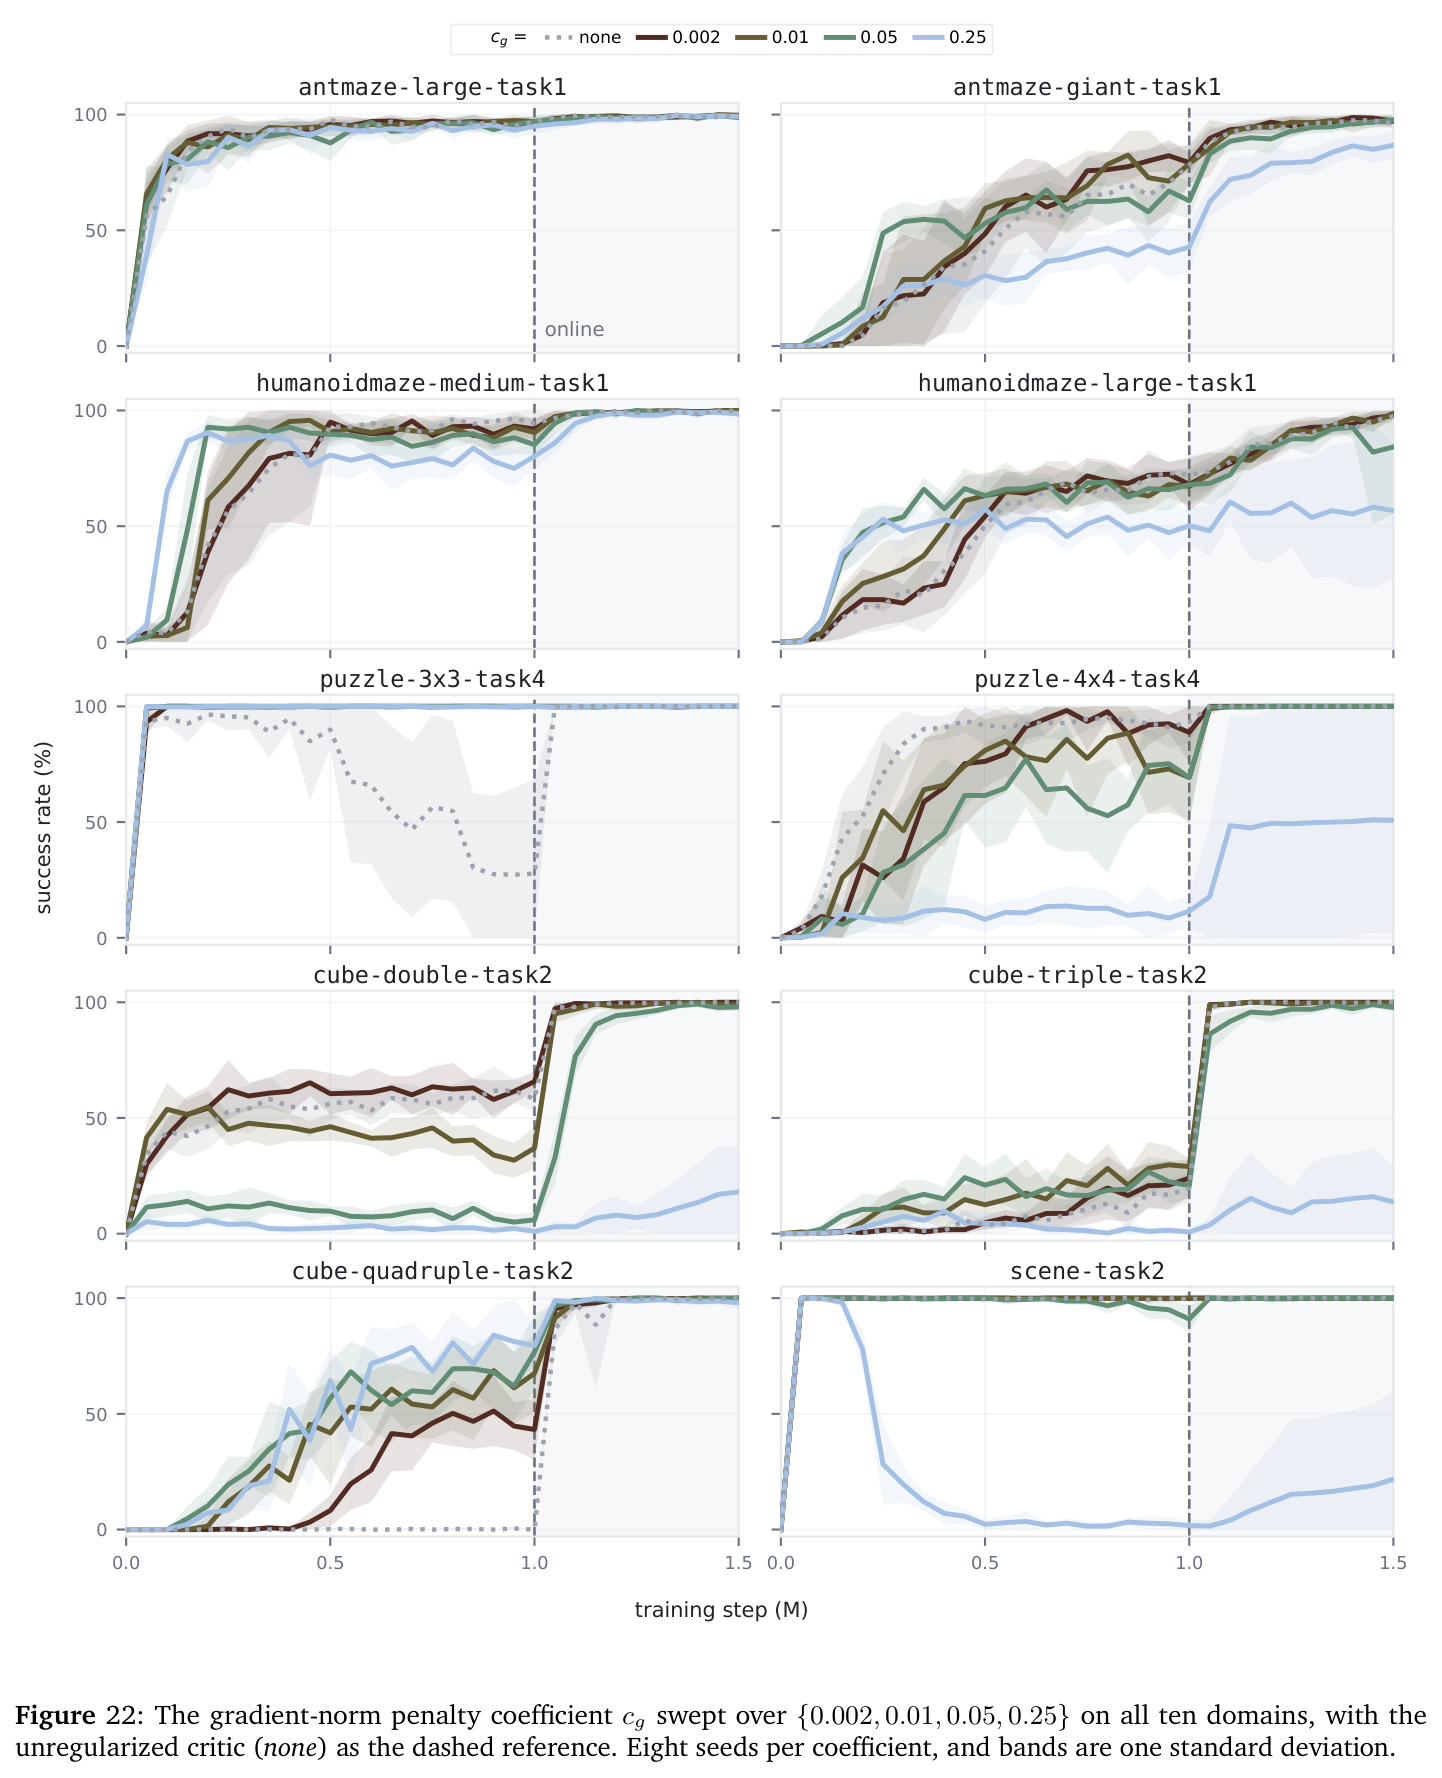
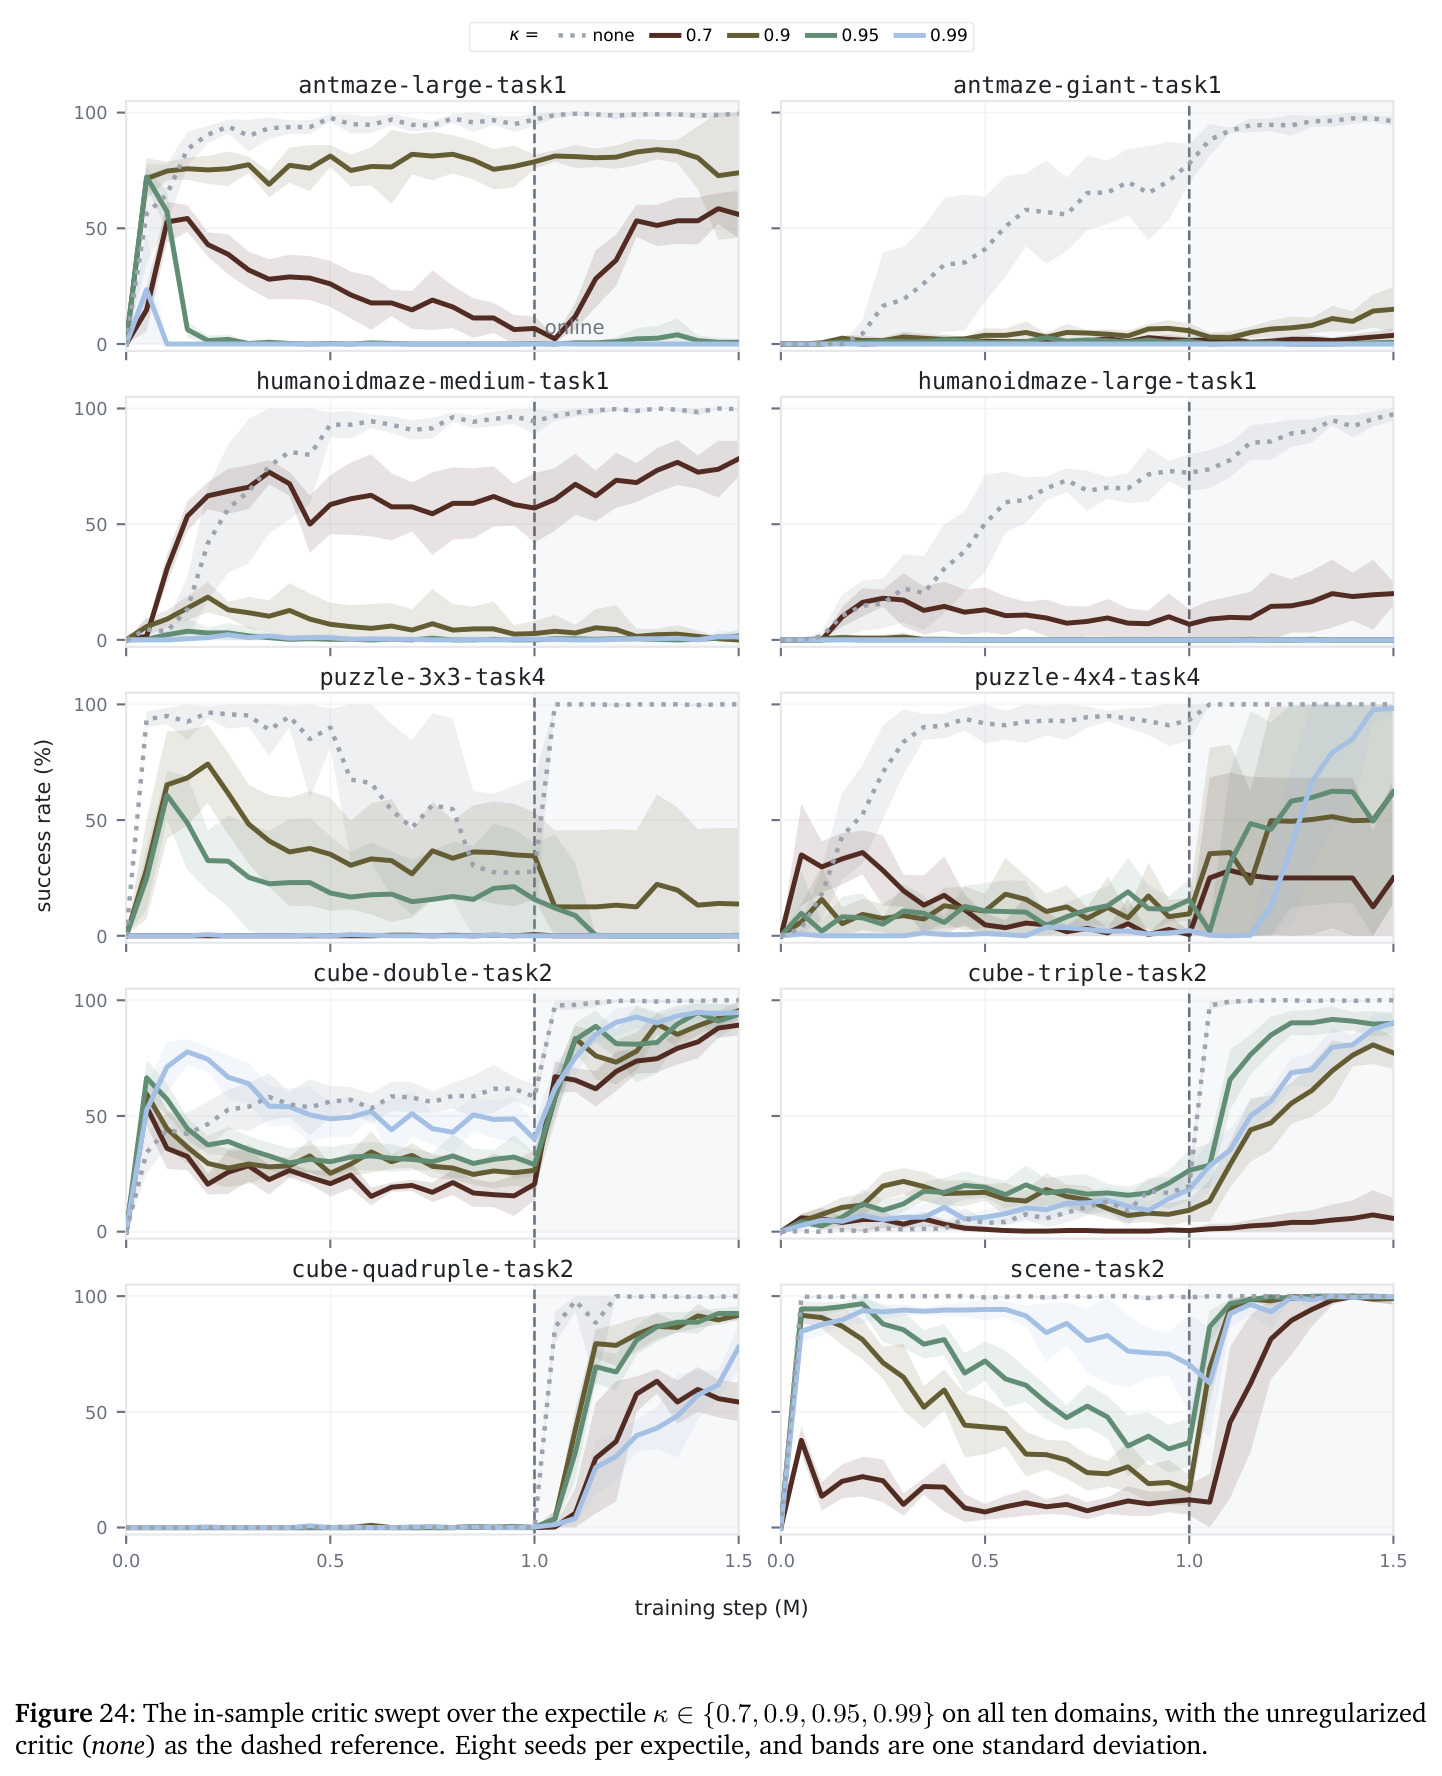
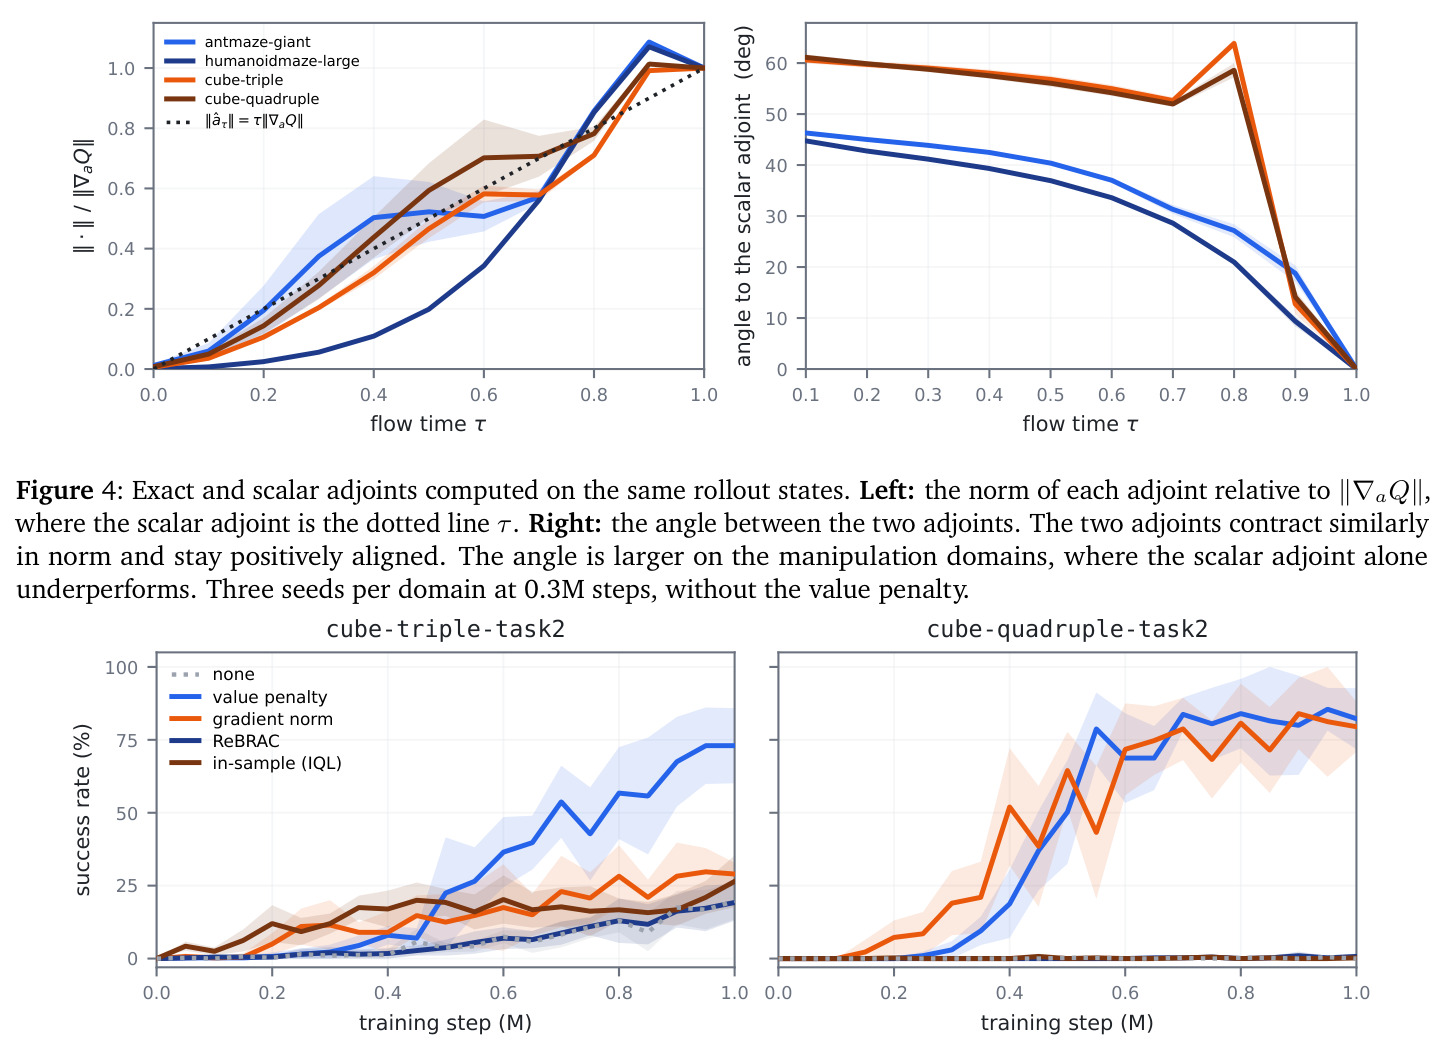
核心创新有两条,且相互咬合。第一条是标量伴随:用「批量平均速度雅可比对角占优」的经验事实,把精确伴随从每流步一次 VJP 降为全程一次 critic 梯度。Figure 4 证明该近似保留了更新依赖的两个性质——模长上,两种伴随都随 $\tau \to 0$ 同样收缩,使各步回归目标量级相近;方向上,始终与精确伴随正对齐——因此能替代精确伴随而不改变训练的定性趋势。与已有方法的本质区别:QAM、QAM-E、TRQAM 都要为精确回传支付逐步 VJP,FQL、DSRL 等则冻结流模型、在外部加残差或学噪声输入;SQAM 是第一个既直接更新流模型、又完全免去逐步 VJP 的方法。第二条是价值惩罚:作者论证标量伴随的瓶颈不在策略更新而在 critic,只有直接控制 critic 在策略生成动作 $a_\pi$ 处取值的正则化有效,而 IQL 式 in-sample critic(只在数据动作上训练)和 ReBRAC(只约束动作距离而非价值)几乎无效。与 CQL 的区别:CQL 在 critic 损失内对采样分布取期望做惩罚,价值惩罚作用于 actor 已采出的那个具体动作,不增加采样成本。
方法步骤详情
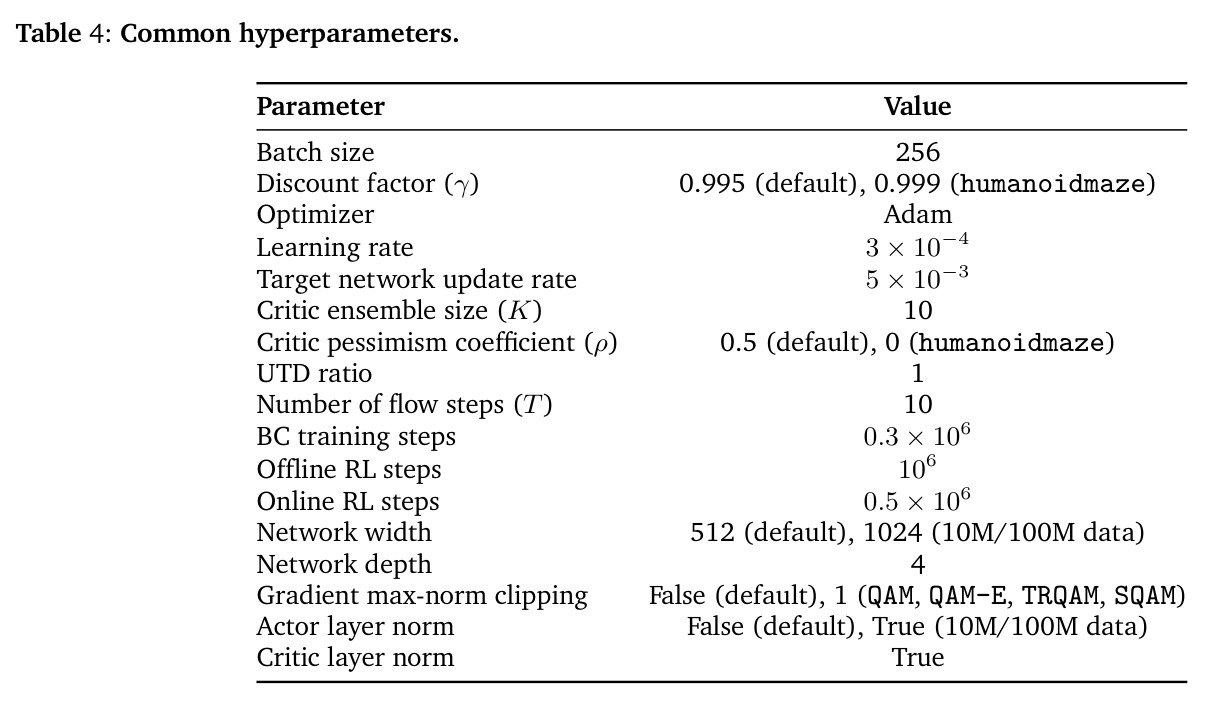
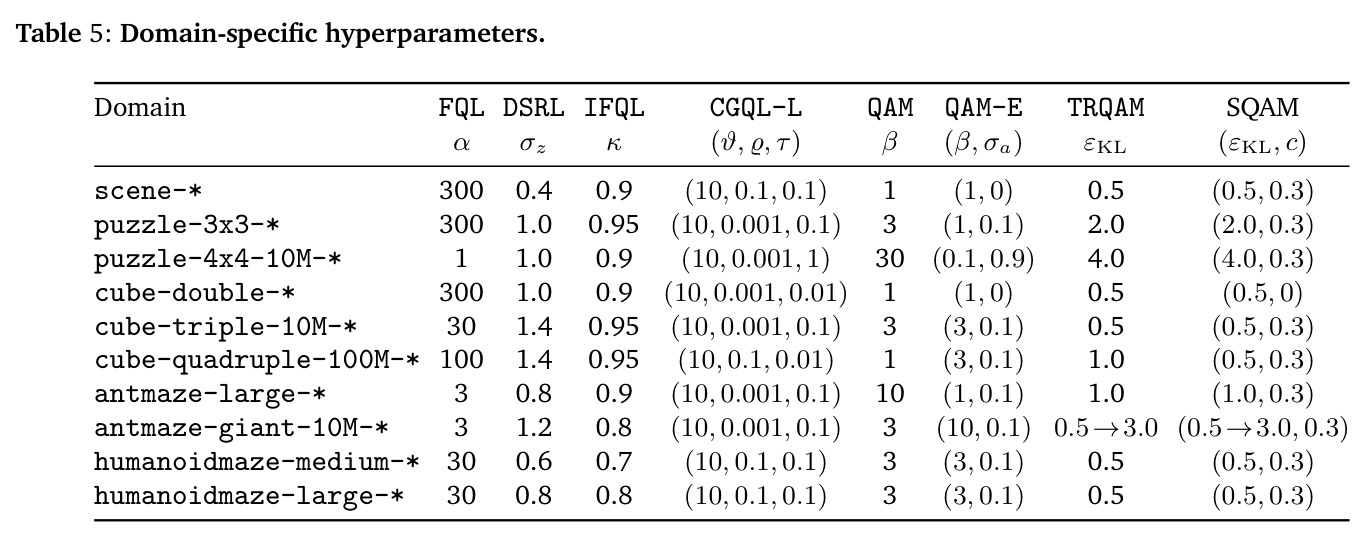
SQAM 每步:(1) 从 $v_{\text{base}}$ 初始化 $v^{\text{ft}}$。(2) 从噪声 $z\sim\mathcal{N}(0,I)$ 积分采样终点动作 $X_1$。(3) 构造中间点 $X_\tau = (1-\tau)\epsilon + \tau X_1$。(4) 计算标量伴随 $\hat{a}_\tau = -\tau \nabla_{X_1} Q_\pi$,全程只需一次 critic 反传。(5) 按 Eq.2 更新 $v^{\text{ft}}$:在 $X_\tau$ 处逼近 $v_{\text{base}} + \sigma(\tau)\hat{a}_\tau$,并维持 KL 信任域。(6) critic 做 TD 更新并叠加价值惩罚 $c\,[Q(s, a_\pi) - Q(s, a_{\text{data}})]$。输入为回放缓冲区,输出为微调后的流策略与 critic。配置:行为克隆 300K 步预训练,离线微调 1M 步、online 至 1.5M 步;操作域 chunk 5;$c = 0.3$(cube-double 除外)。
技术新颖性
新颖性有三。其一,闭式伴随:把「解微分方程」变成可证明的代数缩放问题。Proposition 1 严格证明,各向同性雅可比下伴随的闭式解为 $-\tau e^{\int_\tau^1 c_s ds/2} \nabla_{X_1} Q_\pi$,方向恒为 critic 梯度的负方向,丢弃指数因子只影响模长不影响更新方向,「近似后方向不变」是前人没有的。其二,诊断驱动的正则化设计:从「标量伴随直接消费 critic 在 $a_\pi$ 处的梯度」这一结构性事实出发设计价值惩罚,用一阶展开 $Q(s,a_\pi) - Q(s,a_{\text{data}}) \approx \nabla Q^\top (a_\pi - a_{\text{data}})$ 解释它与梯度范数惩罚的联系——给精确伴随的 TRQAM 加同样惩罚也有提升,但远小于对 SQAM 的提升。其三,实证规律:批量平均速度雅可比对角占优(Figure 2)为流策略 RL 的计算优化提供新规律,并与 test-time guidance 丢弃 Jacobian 更好的现象(Zhou et al. 2026)印证。
实验结果
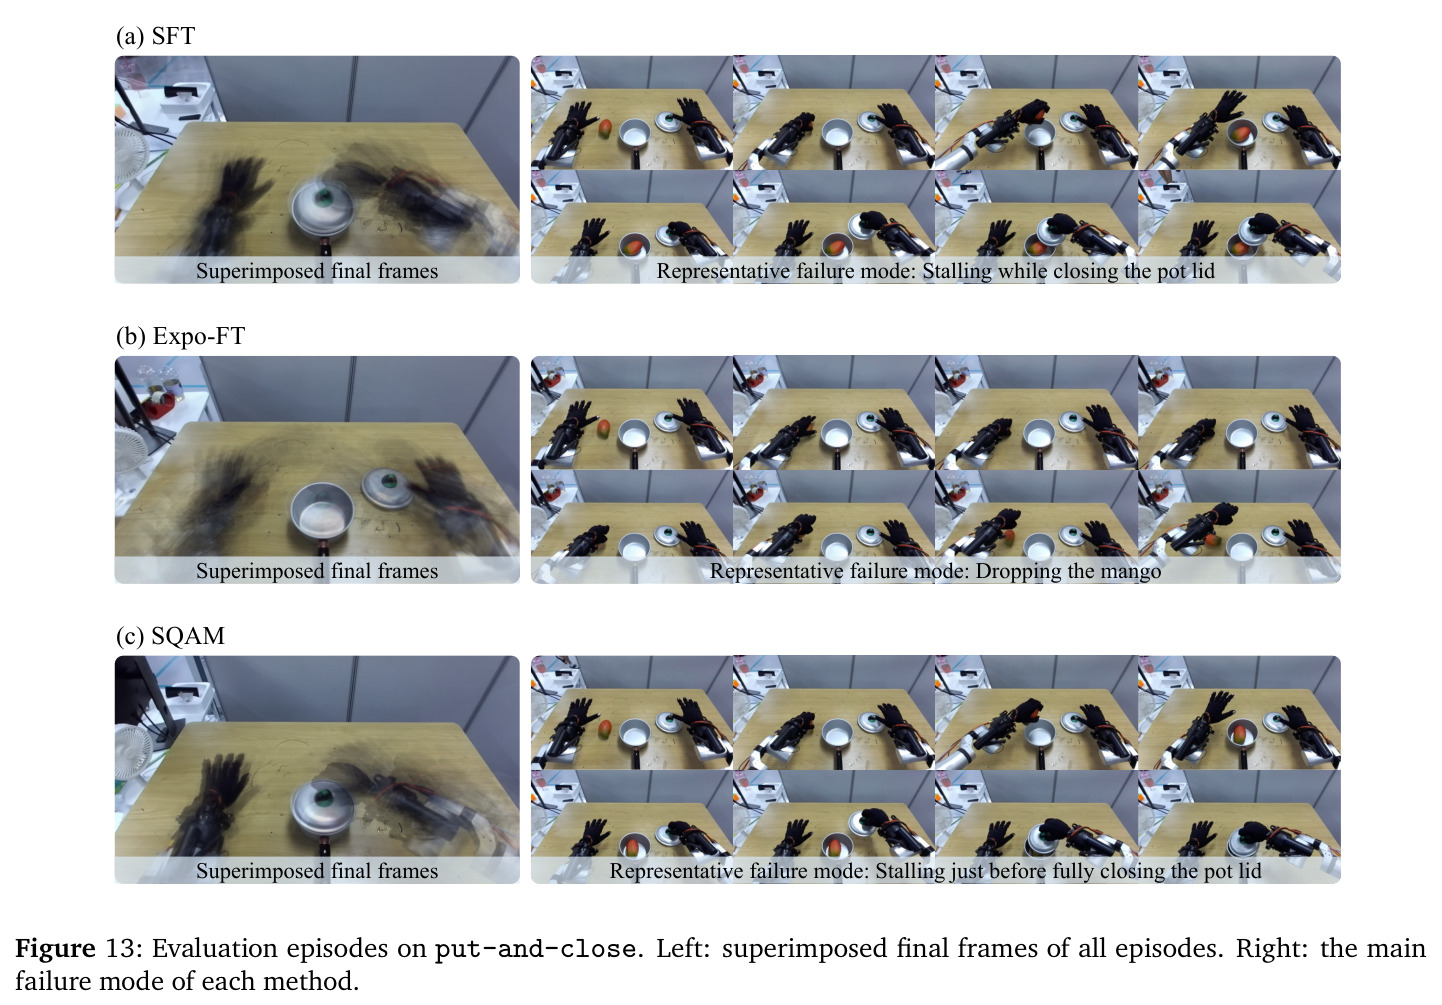
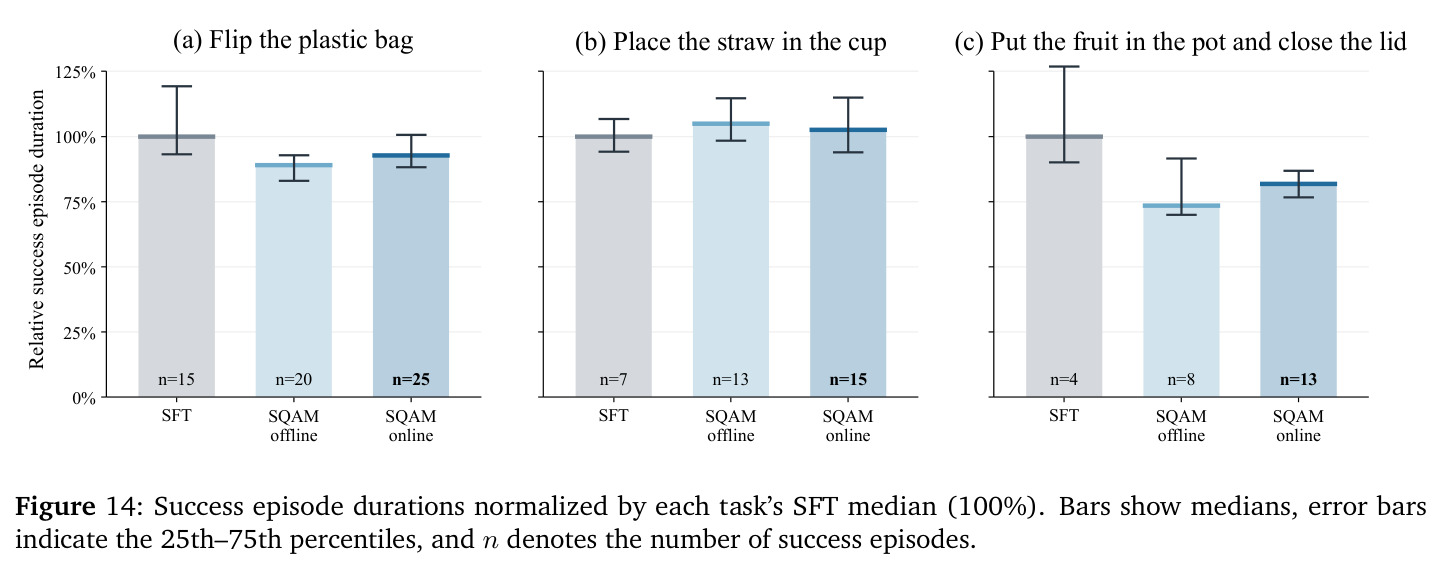
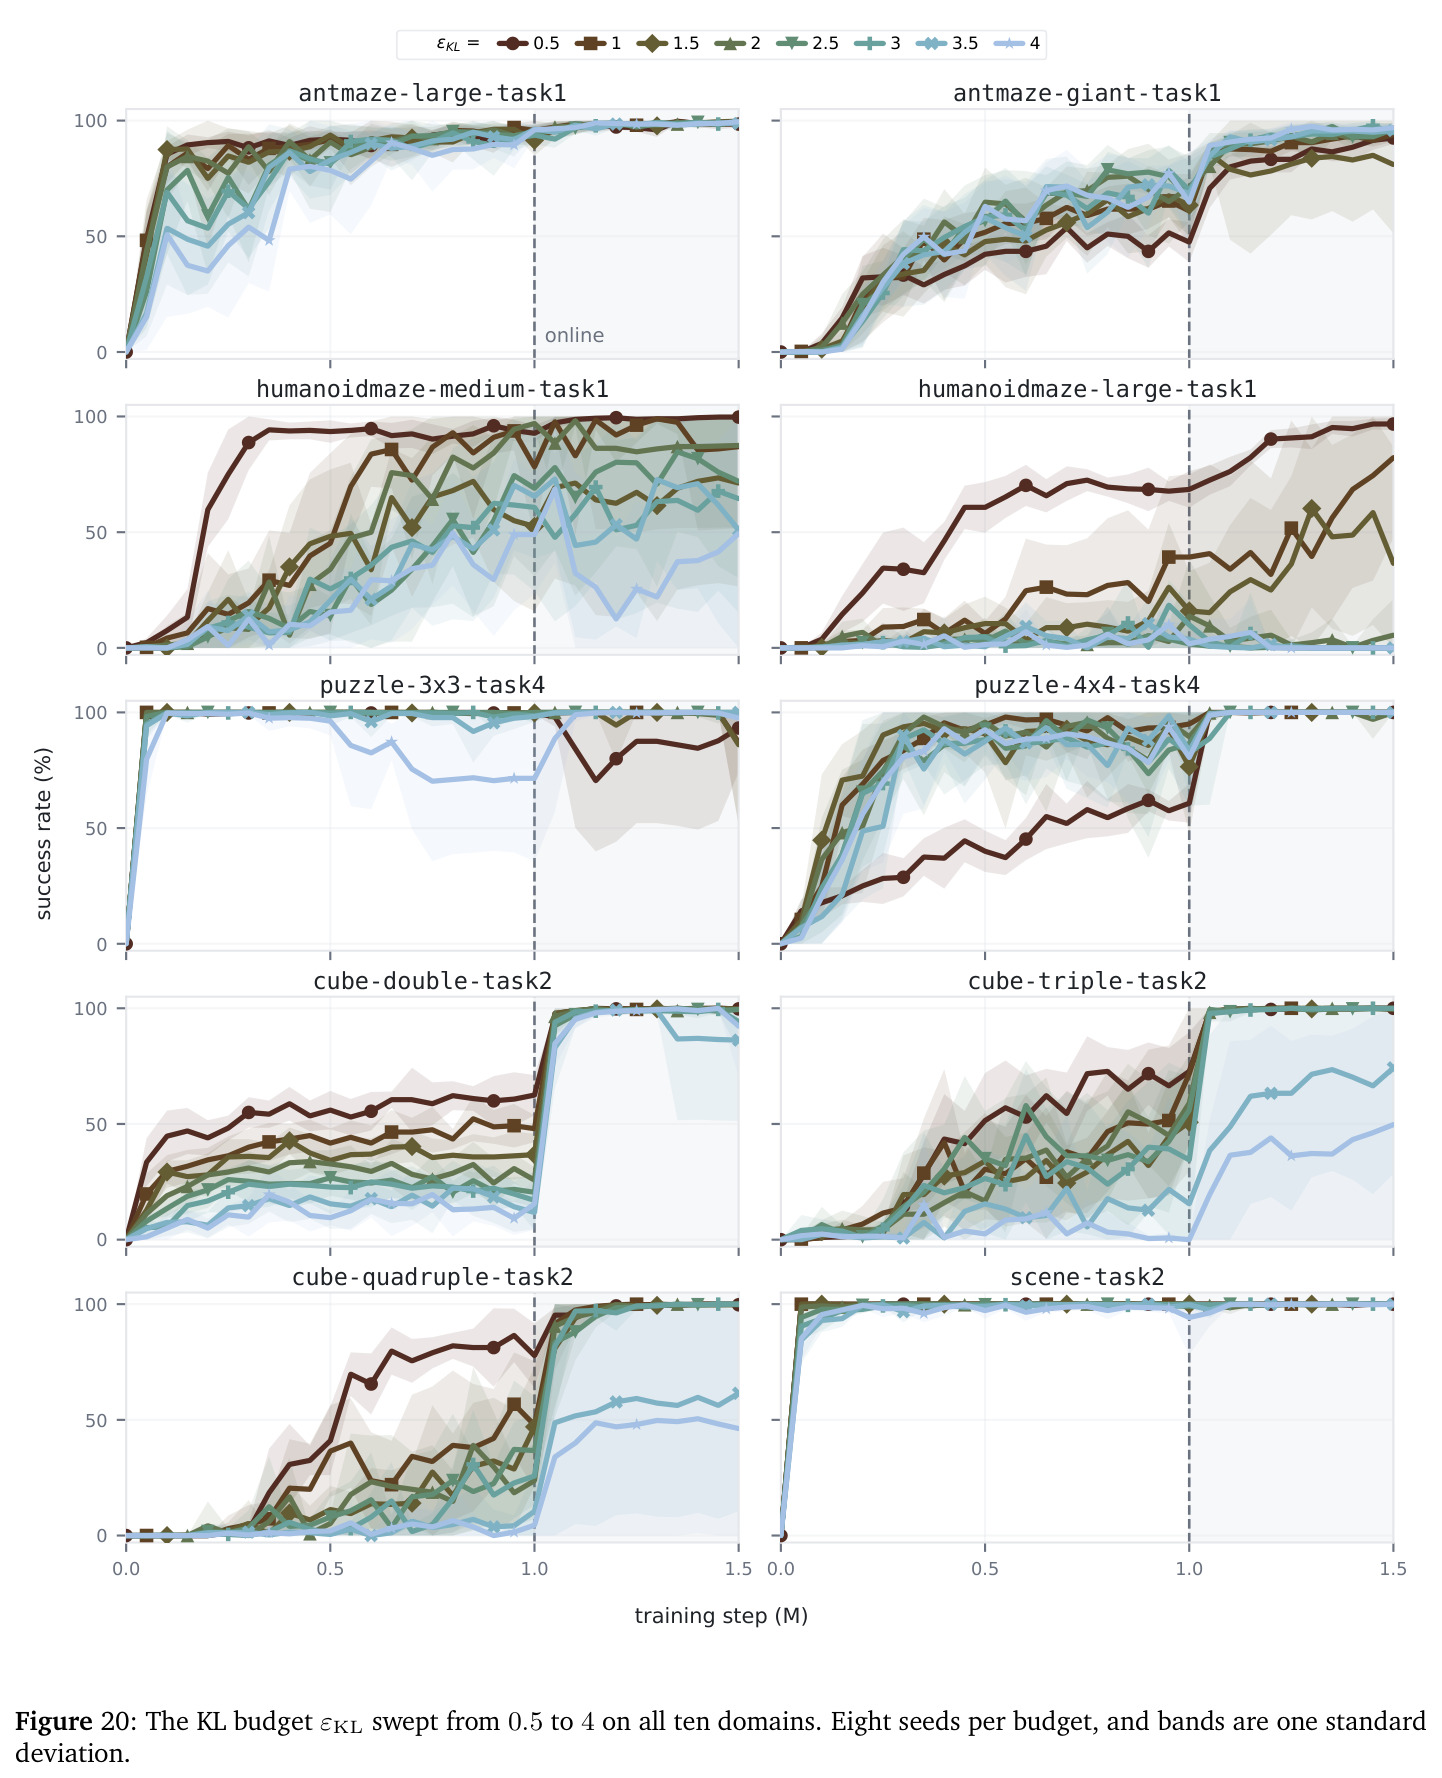
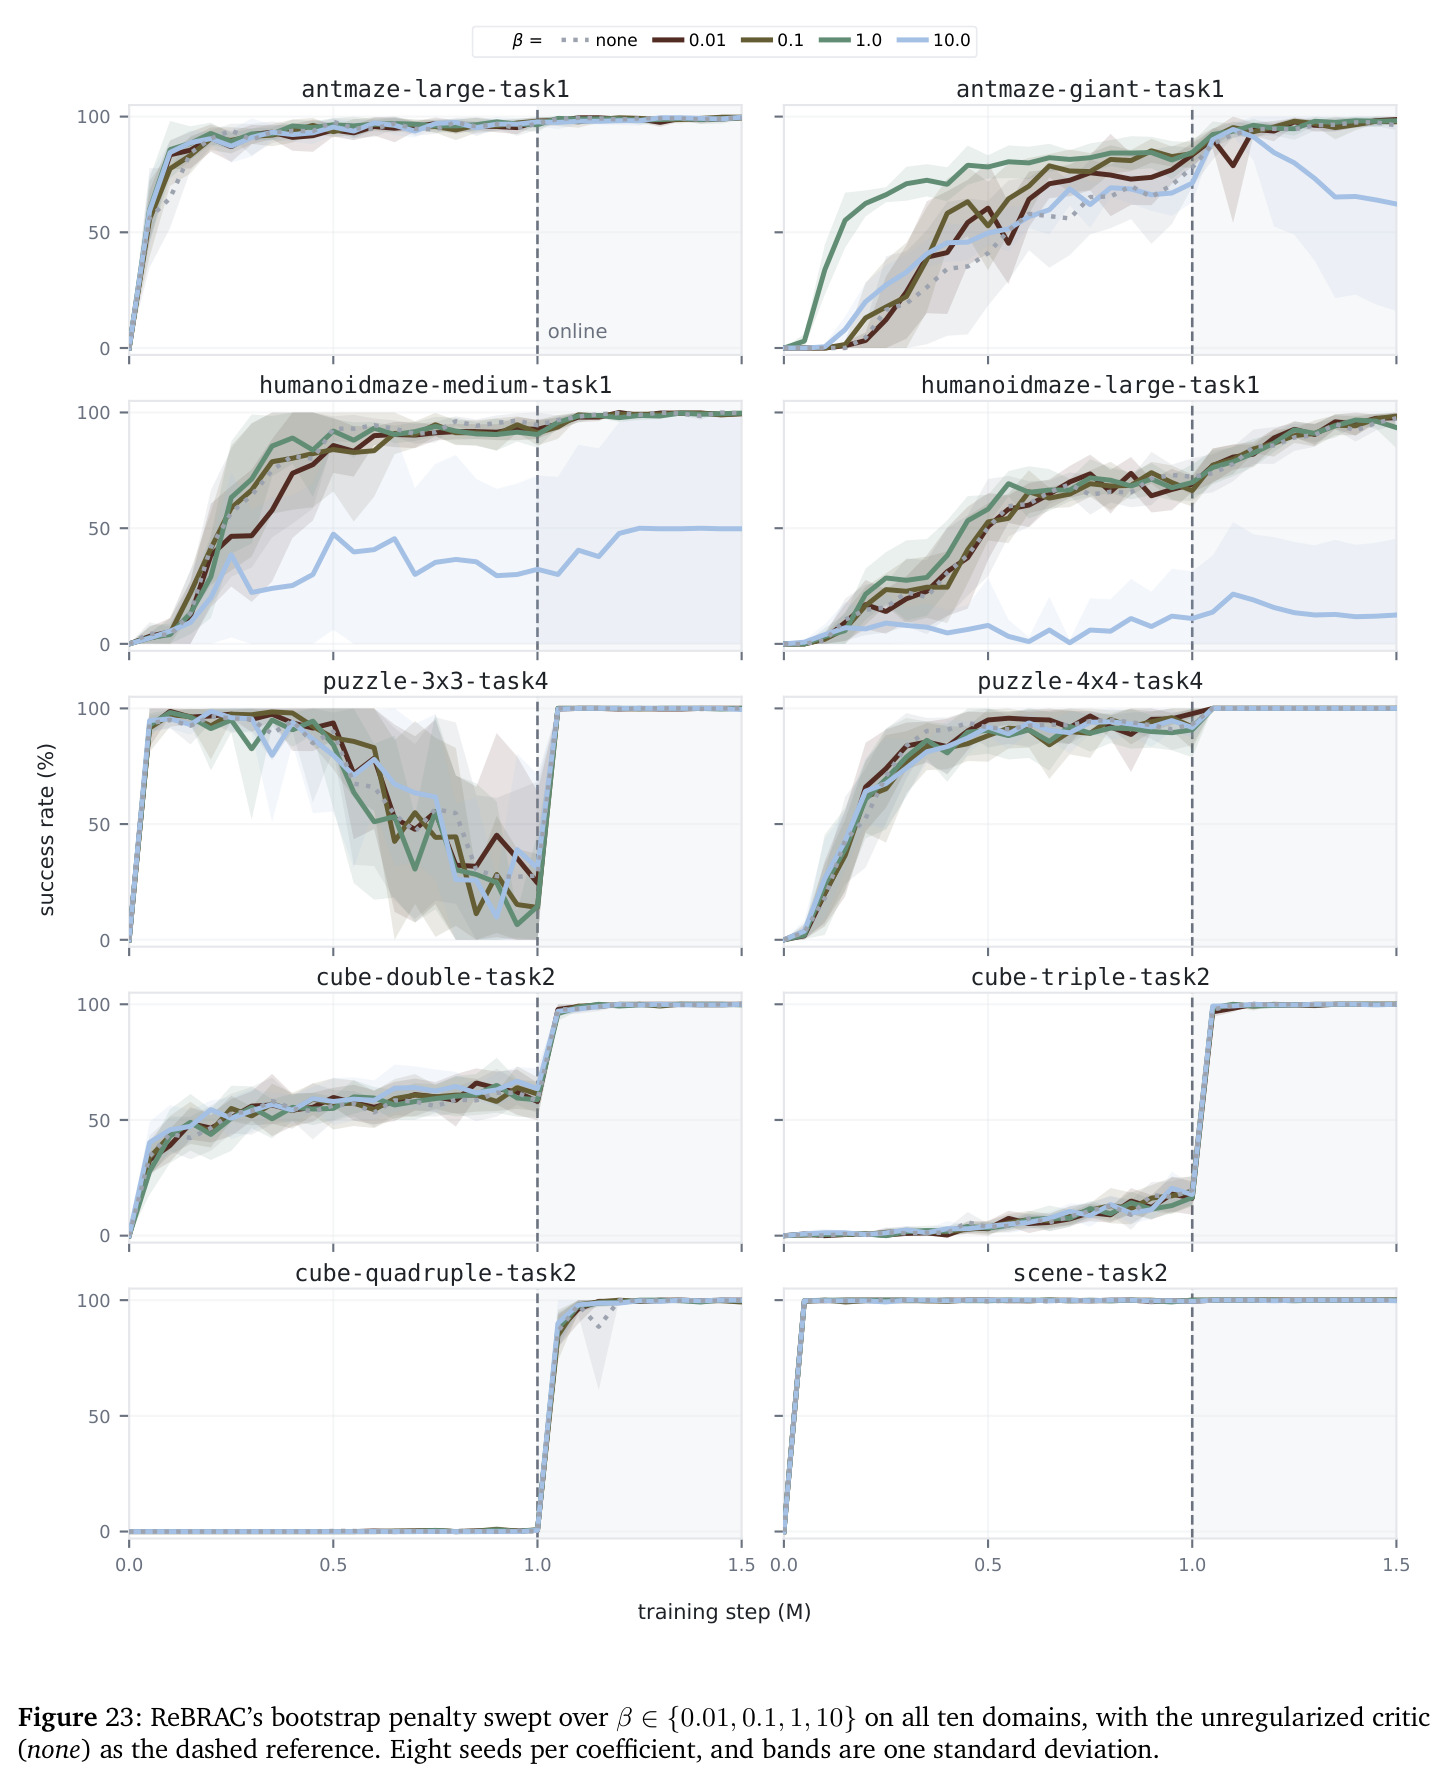
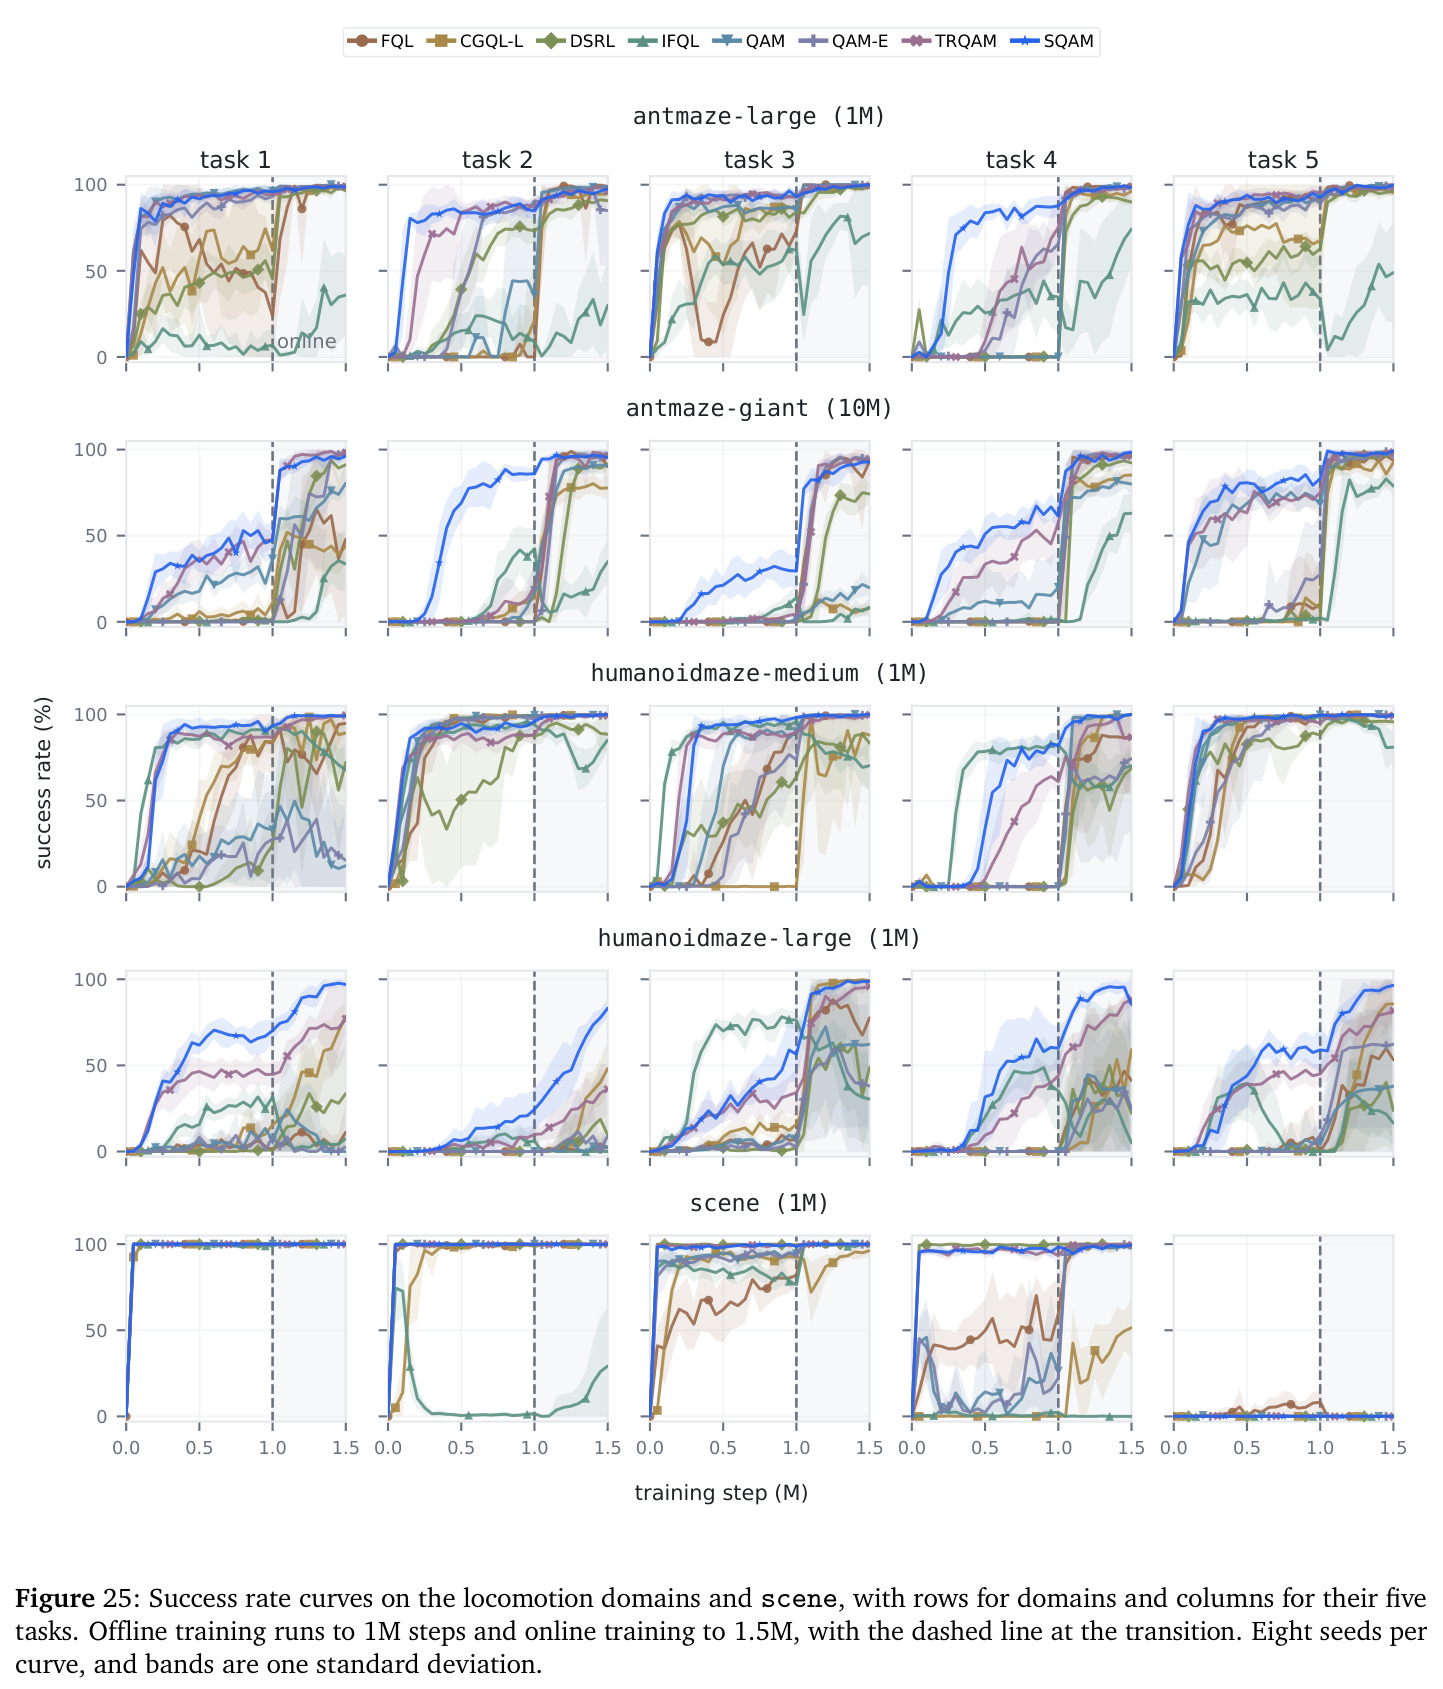
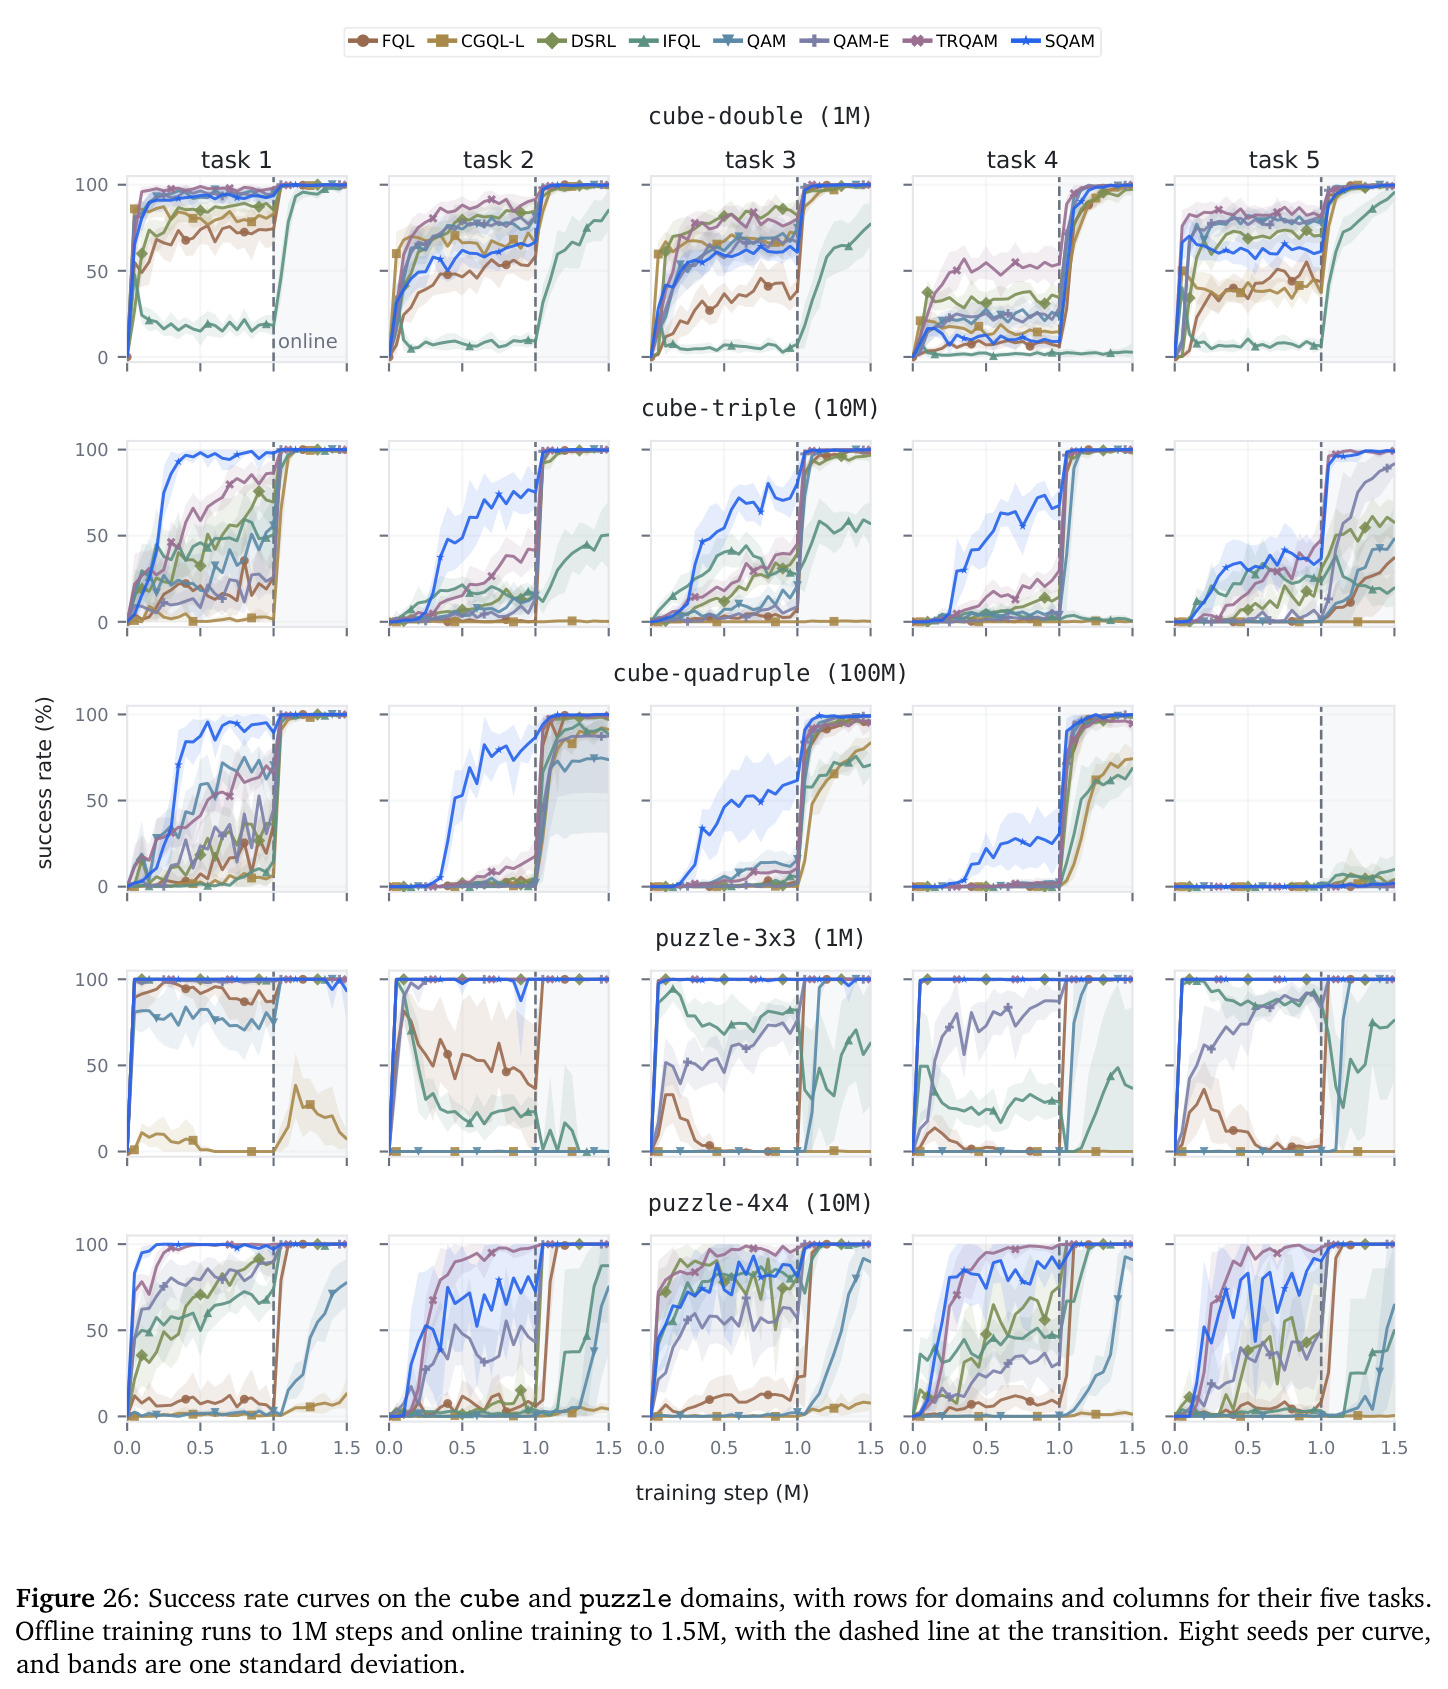
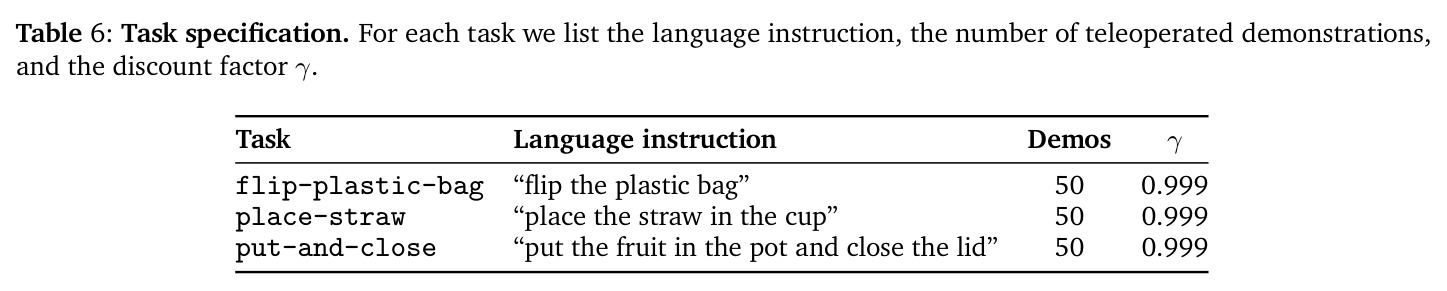
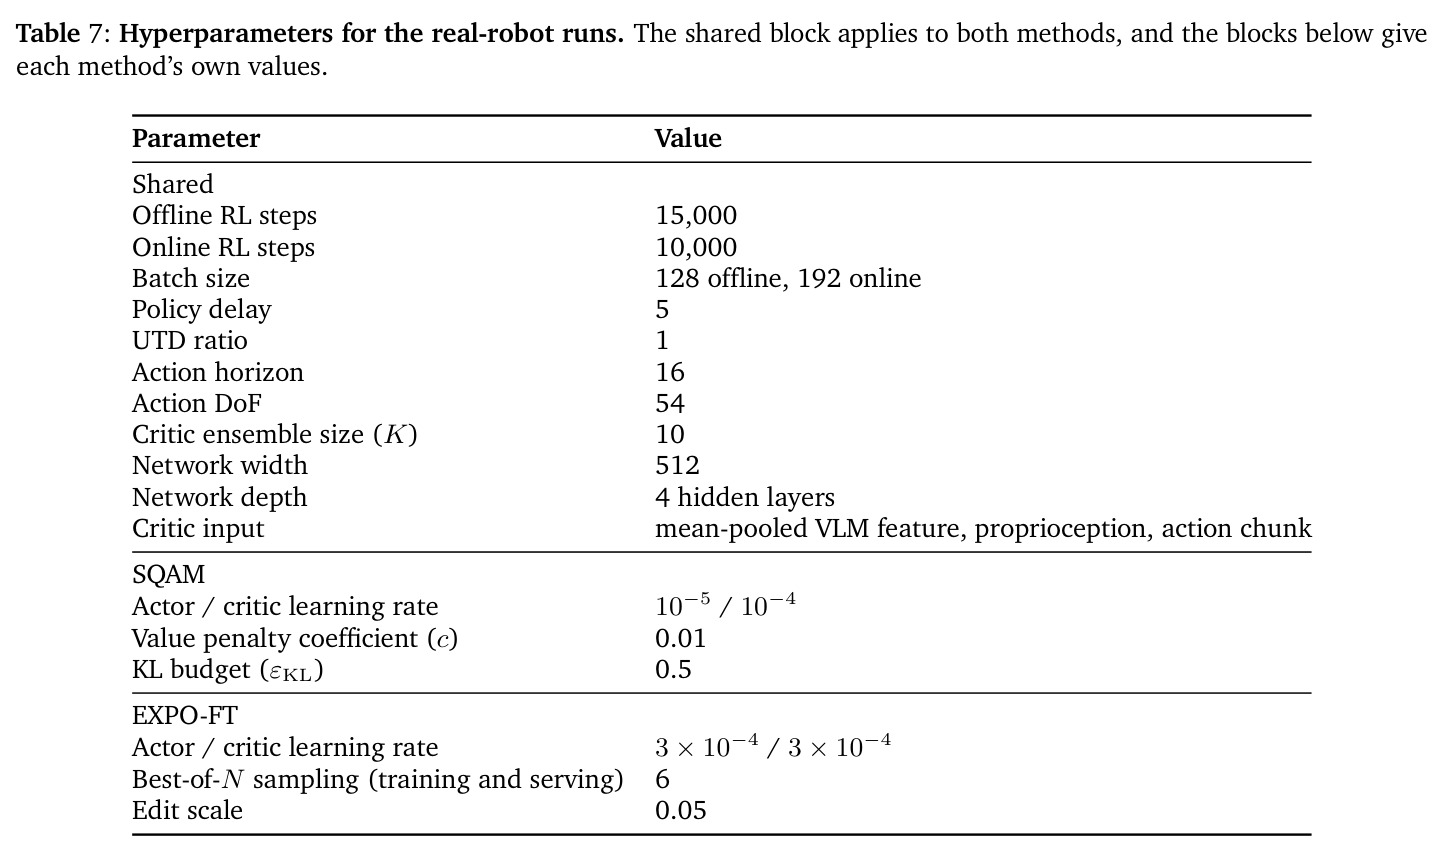
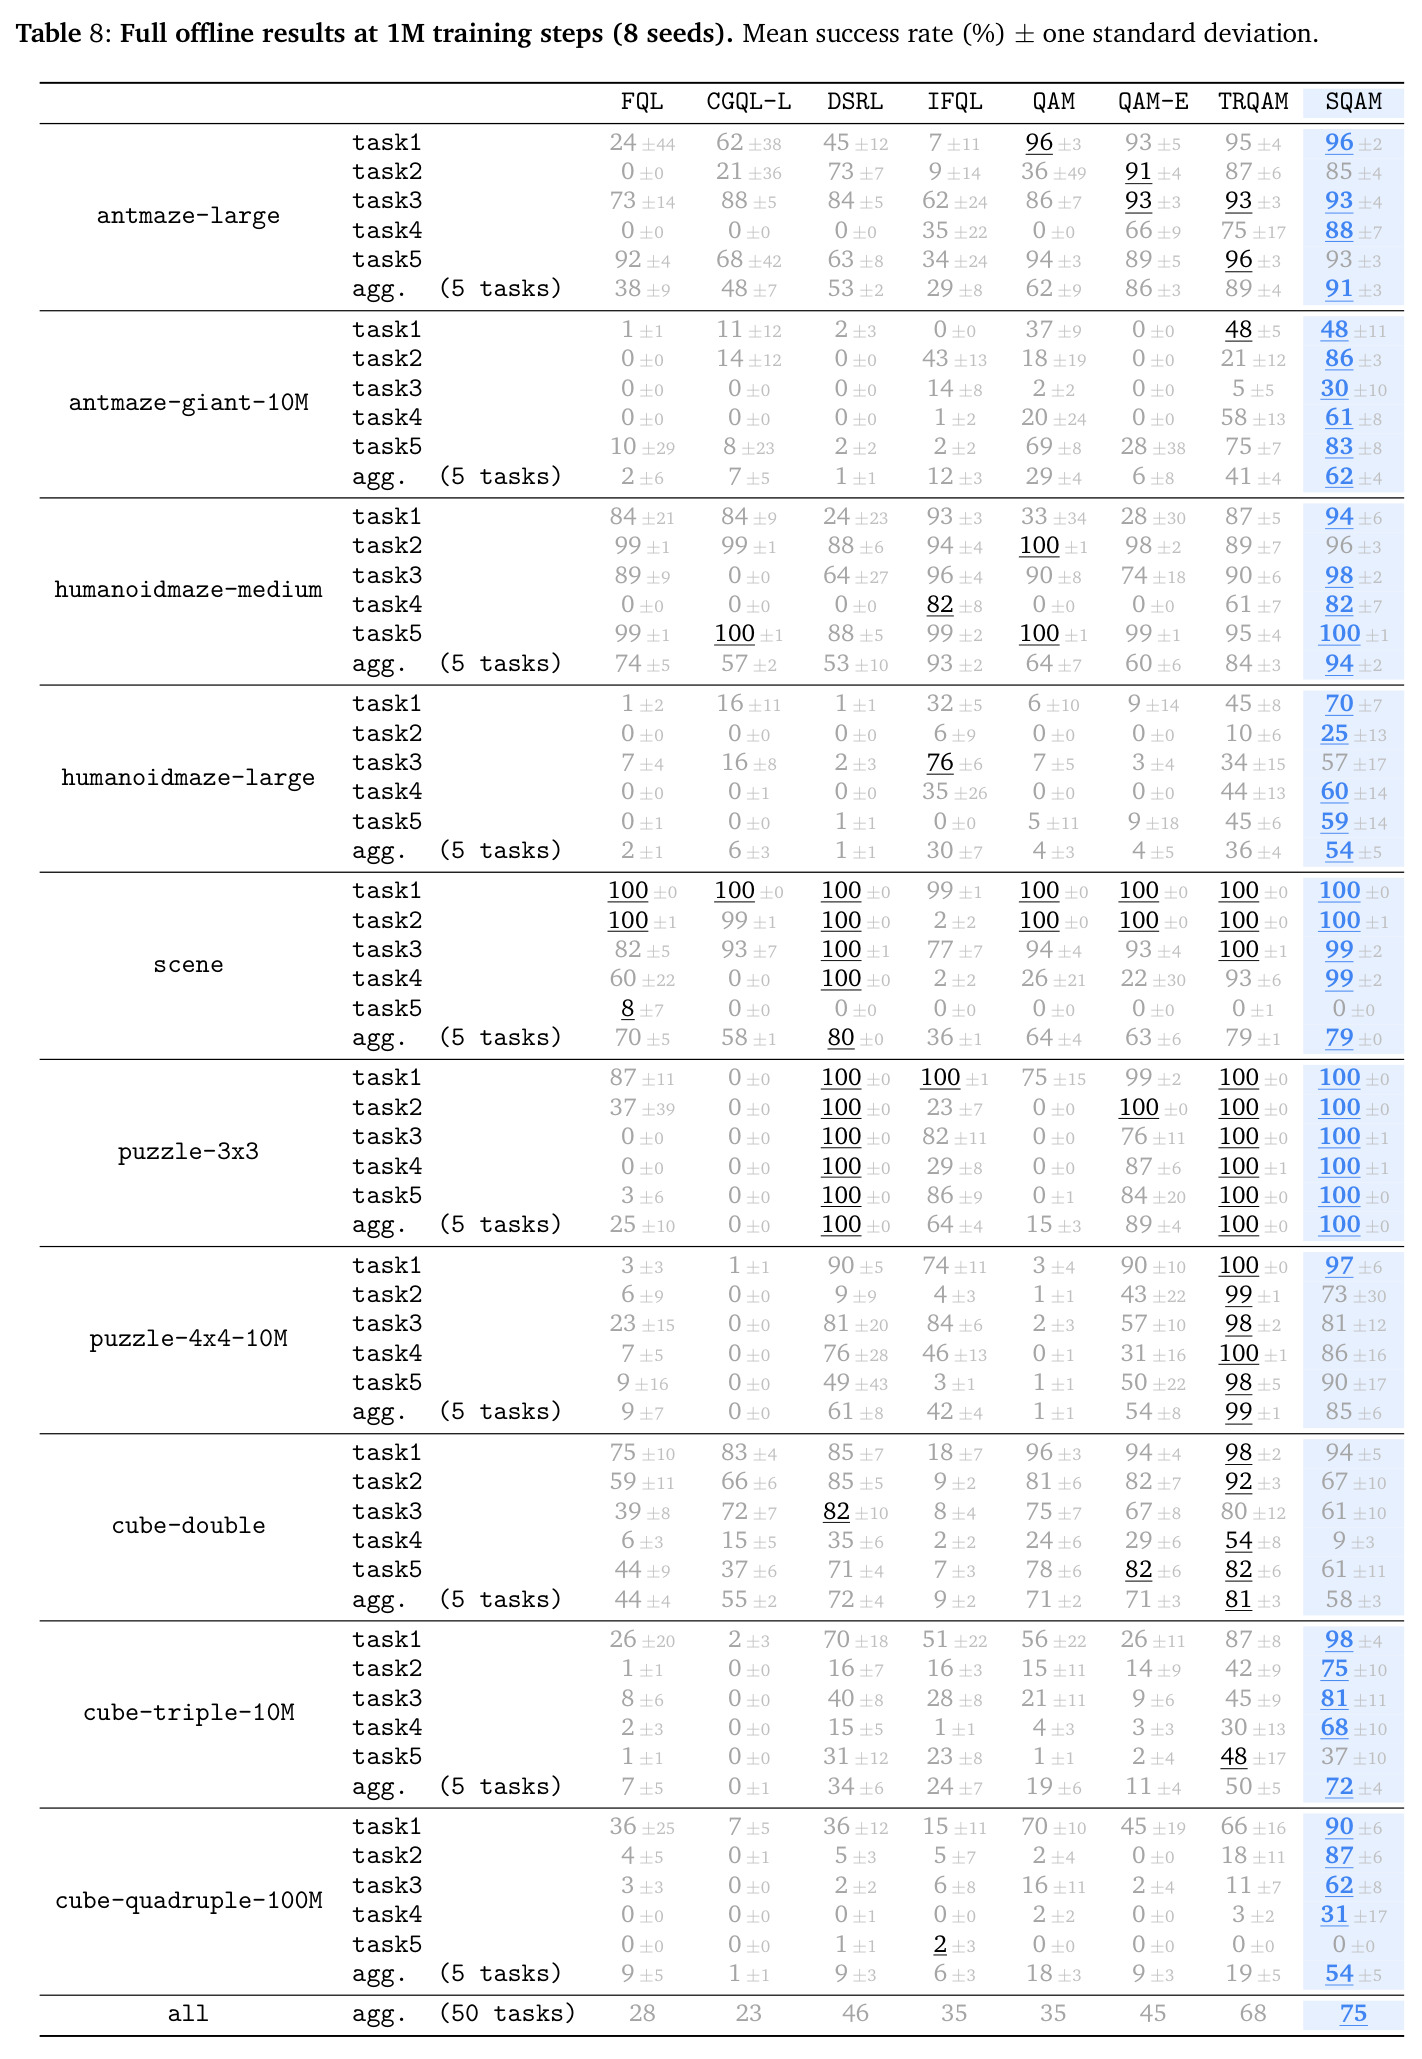
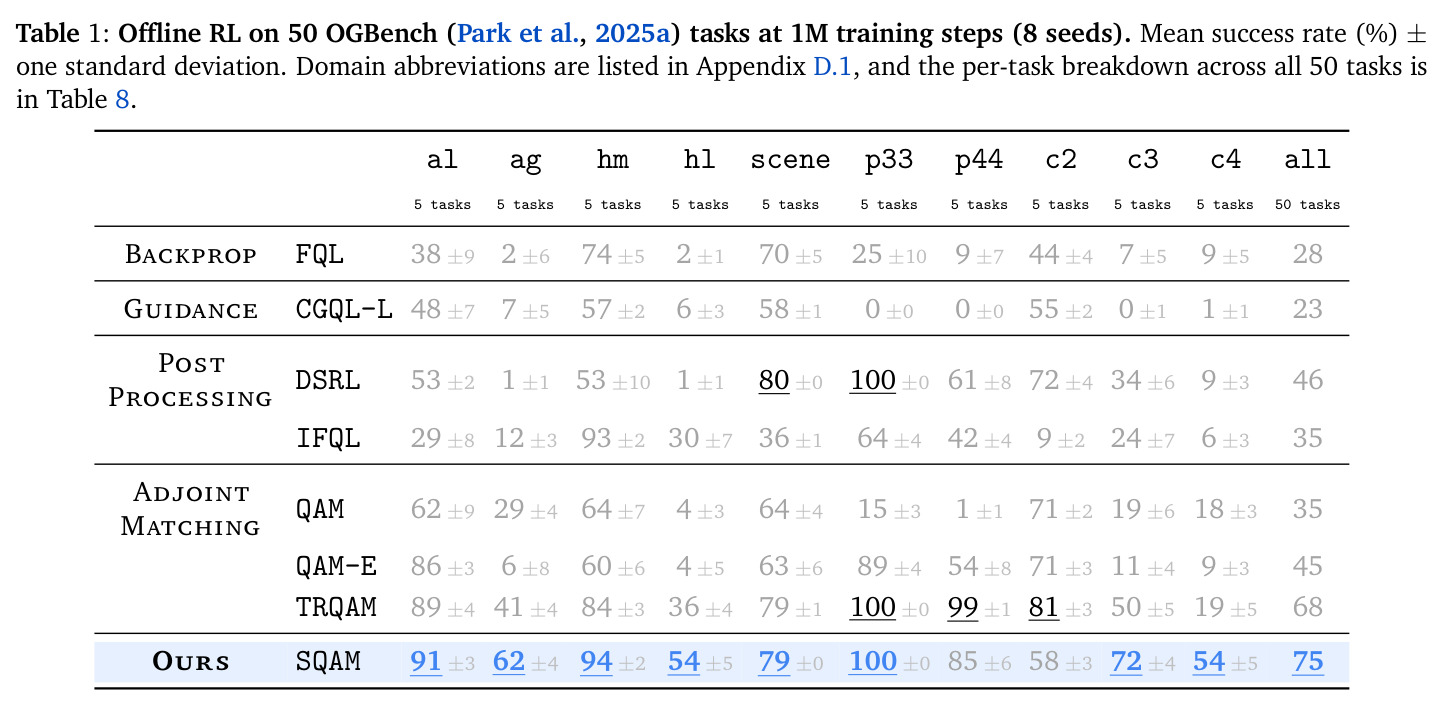
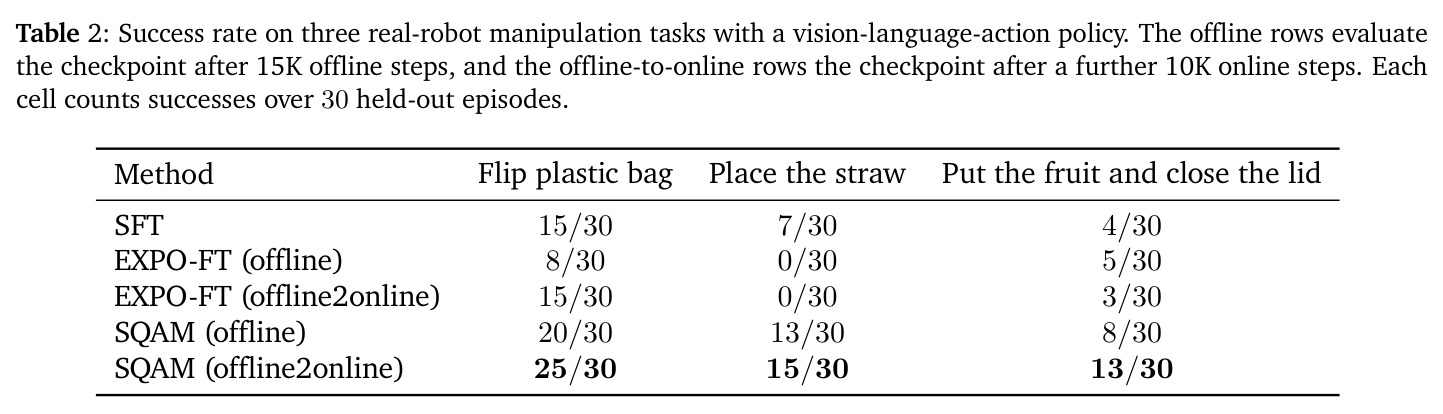
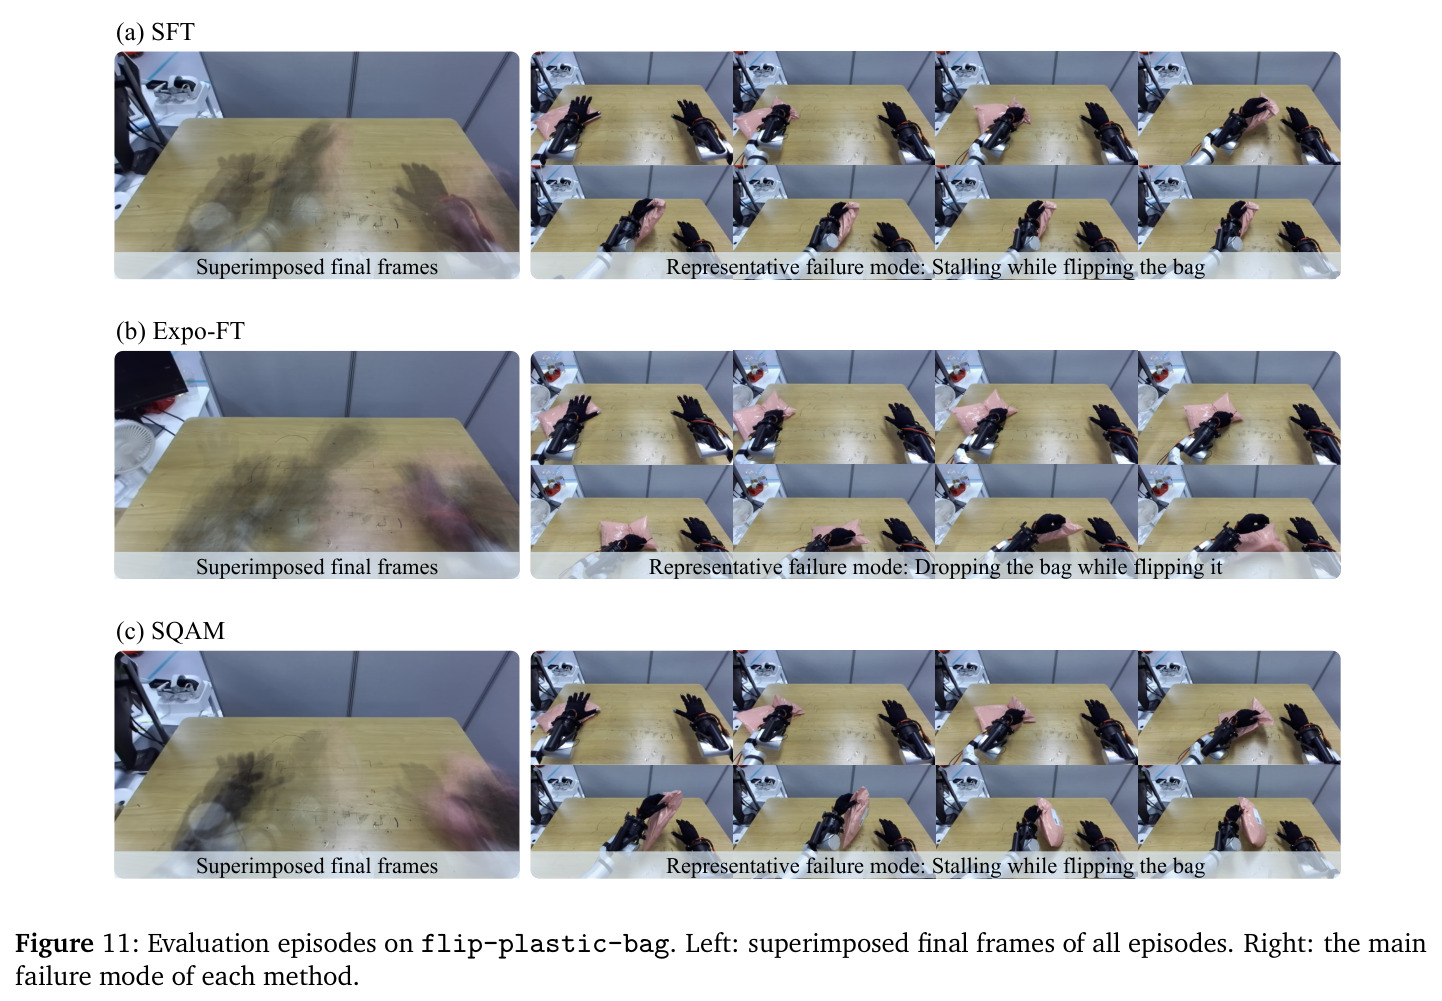
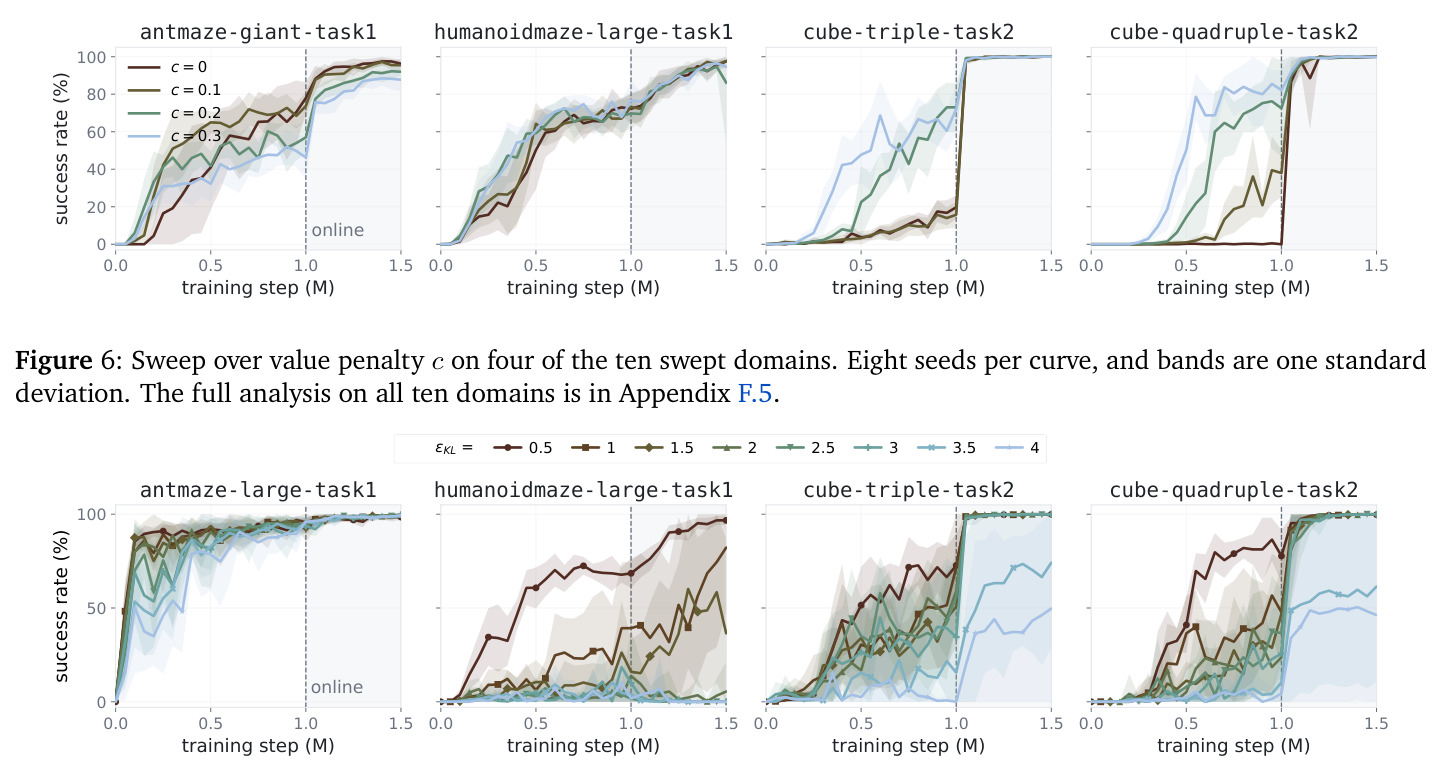
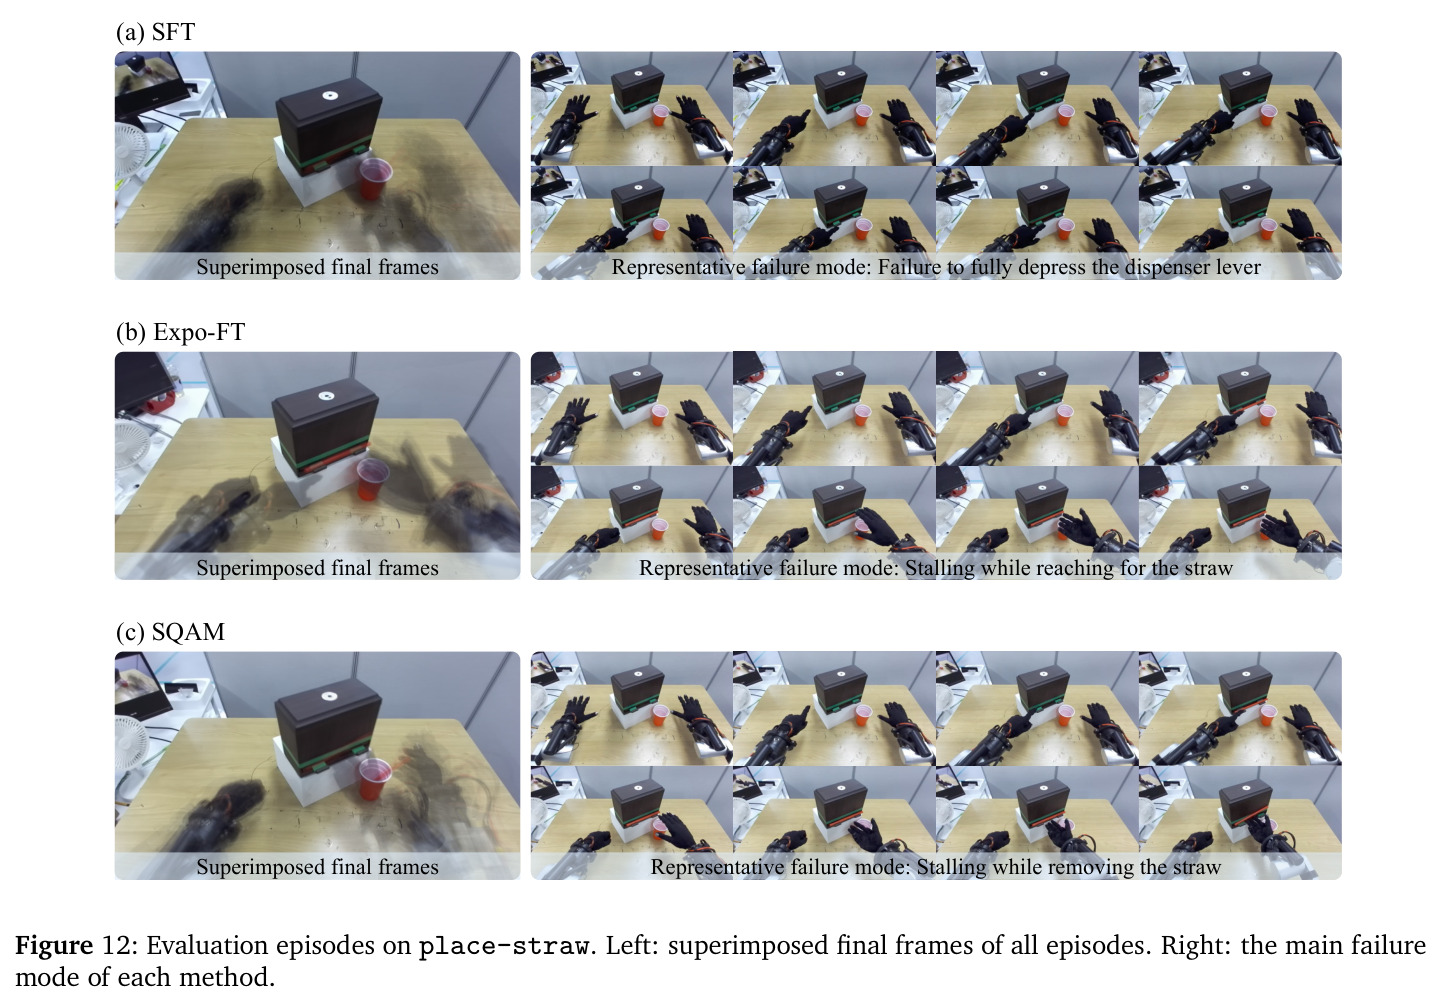
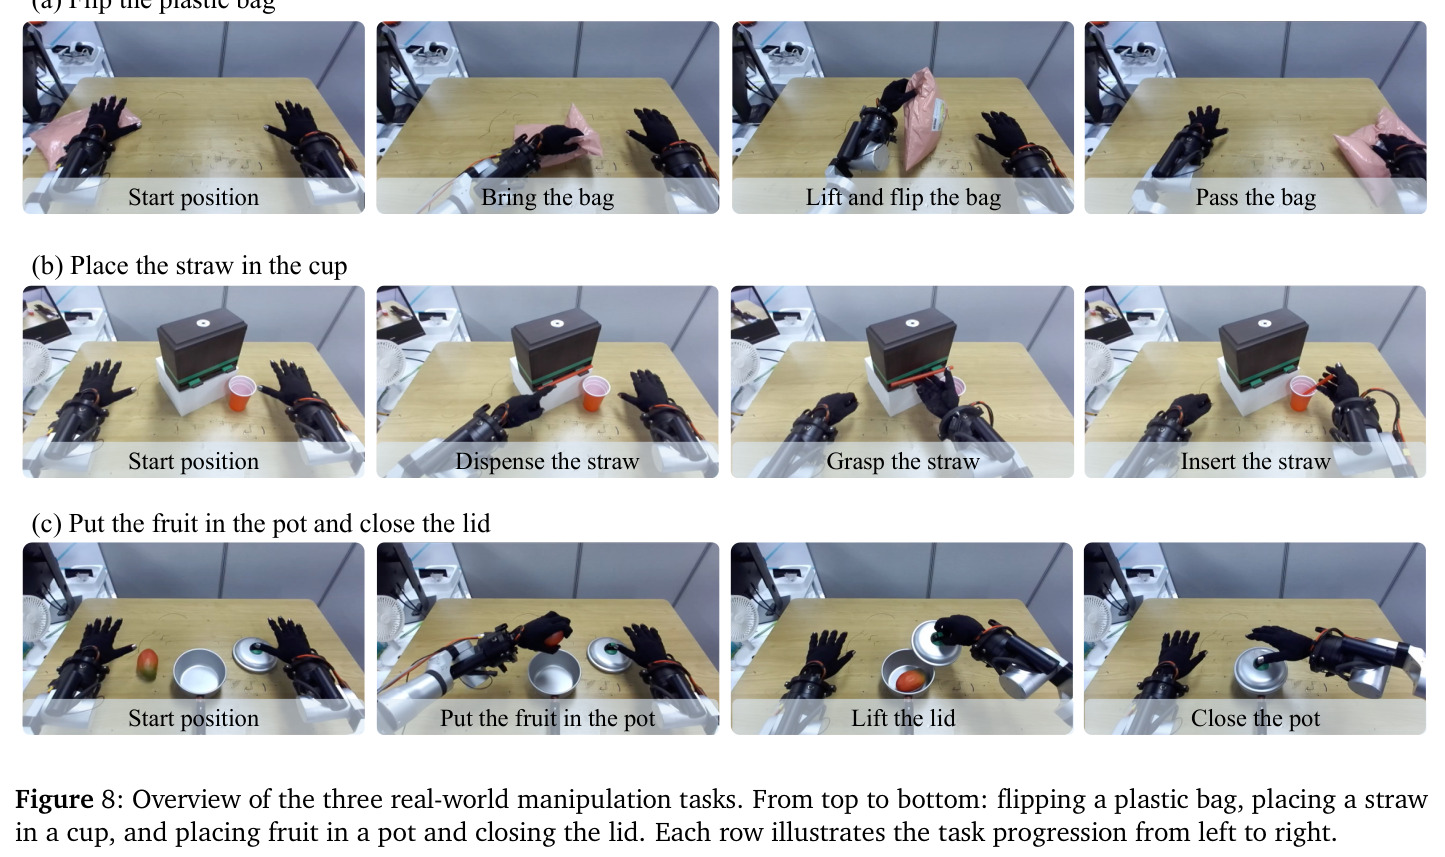
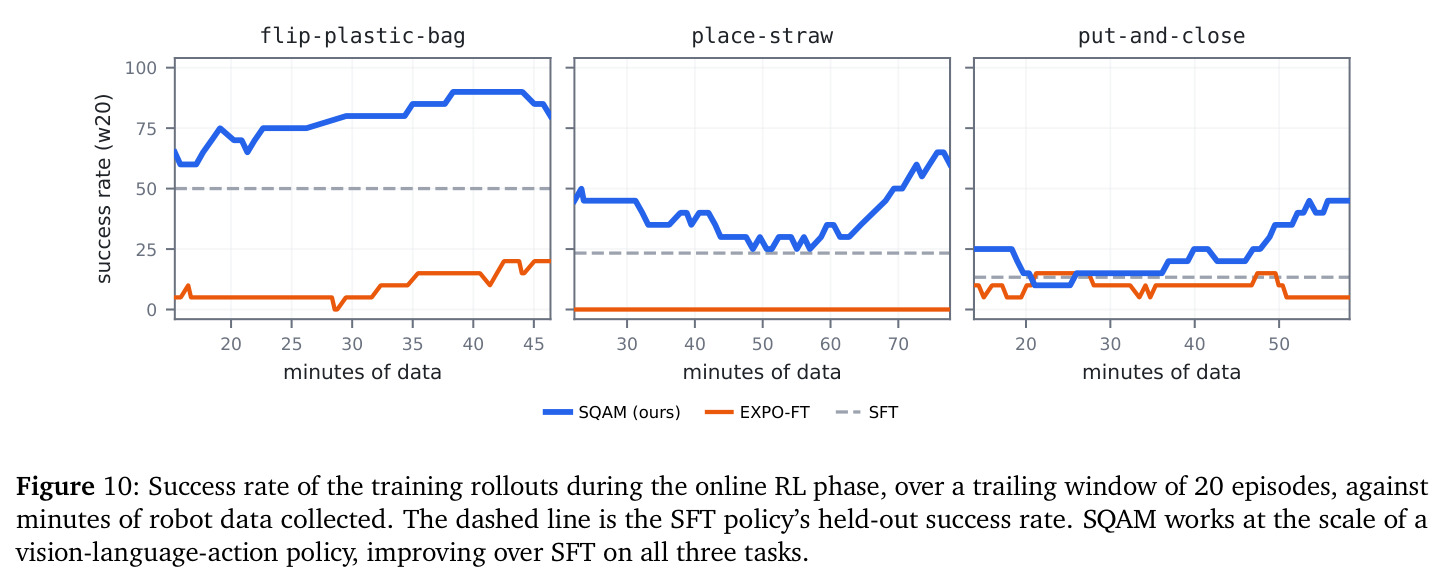
主实验:OGBench 50 任务、8 种子,BC 流策略离线微调 1M 步。SQAM 总体成功率 75%,超最强基线 TRQAM 的 68%;增益集中在最难四域:antmaze-giant 62 对 41(+21)、humanoidmaze-large 54 对 36(+18)、cube-triple 72 对 50(+22)、cube-quadruple 54 对 19(+35),在线亦然。Figure 4:两伴随模长收缩一致、方向正对齐;操作域夹角更大,即标量伴随单独失效处。Figure 5 消融:cube 域上价值惩罚最佳,梯度范数惩罚次之,IQL in-sample 与 ReBRAC 几乎无效;惩罚加到 TRQAM 提升远小。$c=0.3$ 时 cube 任务陡升;KL 预算增大时多数域持平或下降,puzzle-4x4 例外。真实机器人(Table 2):微调 VLA 策略 RLDX-1,3 任务各 30 次评估,SQAM online 达 25/30、15/30、13/30,超 SFT(15/30、7/30、4/30)与 EXPO-FT(15/30、0/30、3/30)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OGBench 50 任务离线 RL(总体) | 1M 步平均成功率(%),8 种子 | 75 | TRQAM 68(最强基线) | +7 个百分点 |
| OGBench antmaze-giant(离线 RL) | 平均成功率(%) | 62 | TRQAM 41 | +21 个百分点 |
| OGBench humanoidmaze-large(离线 RL) | 平均成功率(%) | 54 | TRQAM 36 | +18 个百分点 |
| OGBench cube-triple(离线 RL) | 平均成功率(%) | 72 | TRQAM 50 | +22 个百分点 |
| OGBench cube-quadruple(离线 RL) | 平均成功率(%) | 54 | TRQAM 19 | +35 个百分点 |
| 真实双臂机器人 3 任务(VLA 微调,offline-to-online) | 30 次 held-out 评估成功次数(翻塑料袋/放吸管入杯/水果入锅盖盖) | 25/30、15/30、13/30 | SFT 15/30、7/30、4/30;EXPO-FT 15/30、0/30、3/30 | 对 SFT 分别 +10/+8/+9 次成功,全任务领先 |
局限与改进
作者承认或呈现的局限:其一,SQAM 并非全面占优,在 puzzle-4x4 上为 85% 而 TRQAM 达 99%,cube-double 上 58% 对 81%,说明在部分中等难度或特定操作任务上,精确伴随携带的曲率信息仍有价值;其二,标量伴随单独使用在操作域效果差,必须搭配价值惩罚才能工作,对 critic 质量的依赖是被转移而非消除;其三,各向同性雅可比只是经验近似(仅 Figure 2、4 的实证支持),论文没有给出何时失效的理论刻画;其四,超参敏感——价值惩罚系数需逐域调节(cube-double 上必须关闭惩罚 $c$),KL 预算最优值在不同域间差异很大(puzzle-4x4 偏好大预算)。我自己的观察:真实机器人实验仅 3 个任务、每任务 30 次评估、15K 离线 + 10K 在线步数,样本量小,无标准差报告,结论的统计强度有限;EXPO-FT 在真实机器人上的惨败(吸管任务 0/30)可能部分源于协议或实现细节,公平性完全依赖附录 E 的描述;此外,免除 VJP 带来的实际加速比数字放在附录 F.1,正文未给出训练时间/显存的直接对比,读者难以立刻评估工程收益。
独立分析的弱点
独立分析出四个弱点。第一,「对角占优」依赖批量平均:批量很小或单样本时速度雅可比未必各向同性,标量伴随可能在低数据量微调或在线早期退化,改进方向是引入低秩或对角加低秩的近似,按方向自适应缩放而非纯标量。第二,价值惩罚把负担转嫁给 critic:critic 在分布外动作 $a_\pi$ 处的外推误差仍是失败的根源,可引入 Q-ensemble 不确定性惩罚或 Cal-QL 式校准来进一步控制。第三,在 puzzle-4x4(85 对 99)和 cube-double(58 对 81)上明显退化,暗示这些域需要精确伴随的曲率信息,可设计混合调度:训练早期或难域用稀疏化/低秩精确伴随,其余用标量伴随,按验证成功率自动切换。第四,超参敏感且逐域调参($c$、$\varepsilon_{\text{KL}}$)削弱了「免 VJP」带来的工程简洁性,改进方向是基于 critic 梯度范数或 KL 占用率的自适应 $c$ 与预算调度。第五,真实机器人评估规模偏小且无方差,应扩展任务数量与评估次数,报告多种子或多次部署的置信区间。
未来方向
作者指出的方向:off-policy RL with flow policies 的瓶颈「与其说在策略更新,不如说在 critic」,呼吁针对流策略研究更好的价值学习方法。可延伸方向:(1) 把标量伴随推广到扩散策略(SDE 采样)和多步动作 chunk 设定,检验各向同性近似的稳健性;(2) 刻画各向同性假设的失效边界——大模型、高维动作、少数据场景——并给出方向性修正的理论保证;(3) 将价值惩罚与 offline-to-online 的分布偏移处理结合,如在线阶段用参考策略校准 critic(Cal-QL 思路)防止价值崩塌;(4) 自适应超参:用 critic 梯度范数在线调节 $c$、用信任域占用率在线调节 $\varepsilon_{\text{KL}}$,消除逐域调参;(5) 在更多 VLA 骨干(含语言条件长程任务)上验证,弄清 EXPO-FT 失败是否源于残差策略从零学习的结构缺陷;(6) 推导丢弃指数因子 $e^{\int c_s ds/2}$ 的误差界及价值惩罚与收敛性的关系。
复现评估
开源与文档情况良好:正文给出代码仓库(github.com/yonghdong/sqam)并承诺发布实现,博客提供直觉解释。附录 A 给出完整伪代码,附录 B 描述全部七个基线(FQL、CGQL-L、DSRL、IFQL、QAM、QAM-E、TRQAM),附录 D 列出十个域、数据集与全部超参(含各域 $c$ 与 $\varepsilon_{\text{KL}}$),附录 E 详述真实机器人平台、观测/动作空间、训练与评估协议,Proposition 1 附完整证明。数据方面 OGBench 是公开基准,数据集在附录 D 有说明。算力需求:仿真部分为 50 任务 × 8 种子 × 1M~1.5M 梯度步,总量大但单任务标准 GPU 可承受;瓶颈在真实机器人部分——需要 Rainbow Robotics 双臂平台加两只 20 自由度 Wuji 灵巧手以及 RLDX-1 预训练权重,普通实验室无法复现。综合评估:仿真结果复现难度中等(等代码发布后按附录 D 配置即可),真实机器人复现难度很高,只能依赖作者发布的权重或视频佐证。
论文图表