SIRIS:LLM 能否判断仿真误差何时影响 AI 驱动的系统研究 SIRIS: Can LLMs Tell When Simulation Errors Matter in AI-Driven Systems Research
SIRIS用扰动仿真器构造上/翻配对决策题,评测LLM能否判断建模局限何时推翻设计推荐
前置知识
ADRS(AI-Driven Research for Systems,AI 驱动的系统研究)
指由 LLM 智能体闭环执行的系统研究范式:智能体提出候选设计、调用评估器打分、根据反馈迭代改进,代表作有 AlphaEvolve、ShinkaEvolve、Glia 与 Database ADRS。在仿真器辅助的 ADRS 中,评估器就是仿真器,其打分同时决定设计的去留与智能体下一步探索的方向。
SIRIS 评测的正是这一闭环中最关键也最脆弱的一环:智能体解读仿真证据、决定是否采信仿真器推荐的能力。
建模局限(modeling limitation)
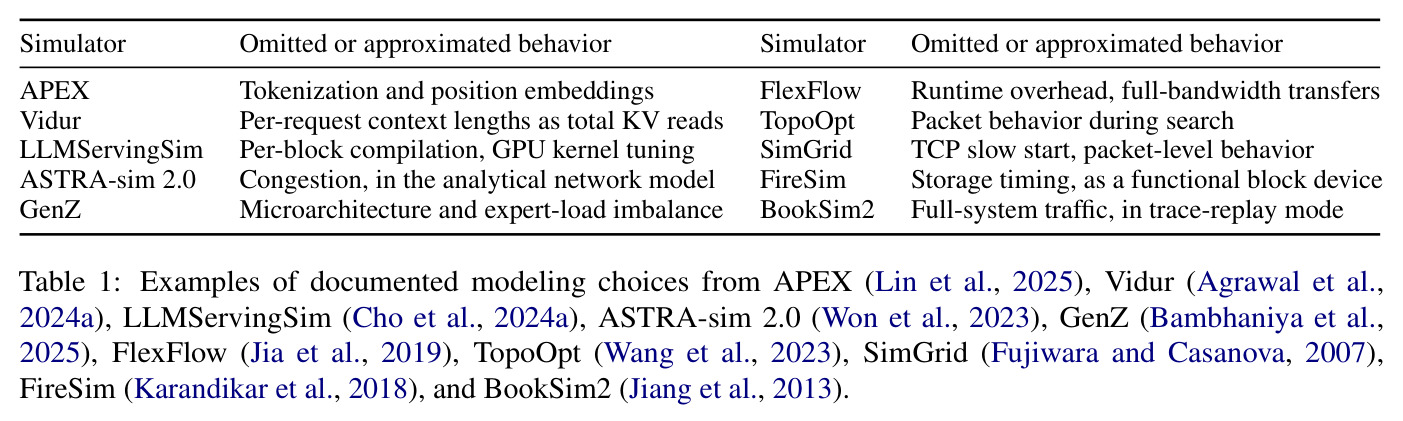
仿真器为了可扩展只能建模设计者认为相关的系统细节,被省略或近似的行为即建模局限,例如 ASTRA-sim 2.0 的解析网络模型忽略拥塞、FireSim 把存储建成无时序的功能设备、Vidur 把每请求上下文长度当作总 KV 读取量。局限可能只扭曲预测数值,也可能在特定 workload 下改变最优设计。
SIRIS 通过向仿真器注入受控的建模局限来构造评测问题,理解局限如何影响预测与排序是读懂全文的前提。
变异测试算子(mutation operators)
软件测试中对程序做微小改动(值替换、省略项、聚合方式改变、坐标互换、算术修改等)以检验测试套件能否发现缺陷的技术。SIRIS 借用其算子风格设计七种扰动,把抽象误差或对指定计算的错误实现显式写入仿真器代码,而非报告真实缺陷。
论文的七种扰动(如插值算术由 $y_0 + r(y_1 - y_0)$ 改为 $y_0 + r y_1$)全部改编自这些算子,不了解来源就看不出扰动集的系统性设计。
Judgment 与 Disposition 双指标
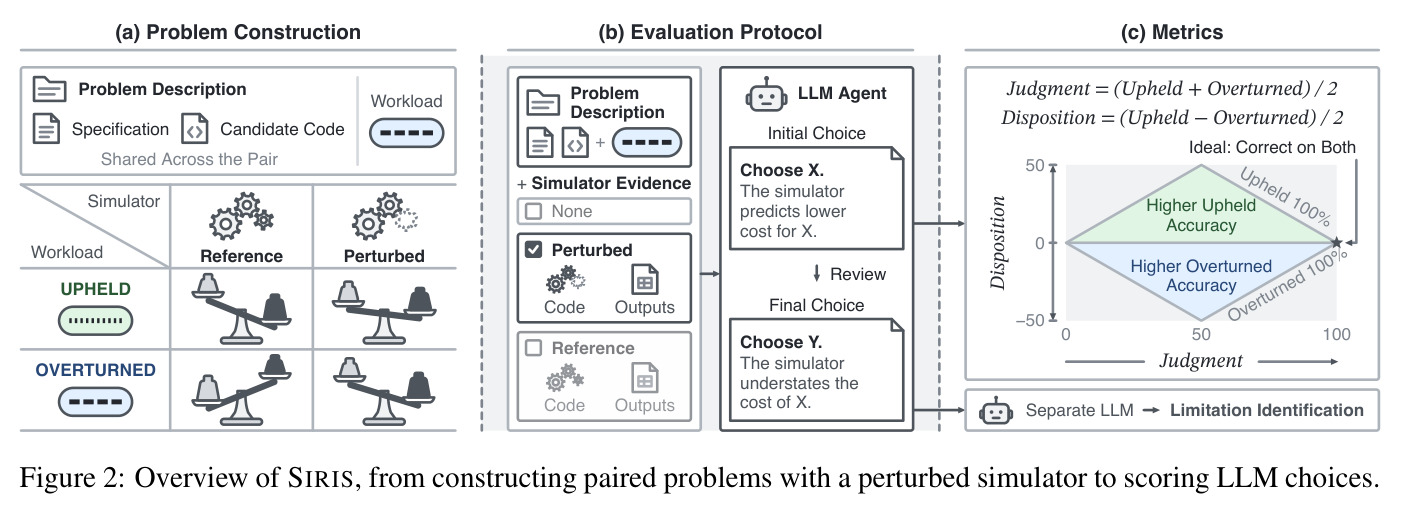
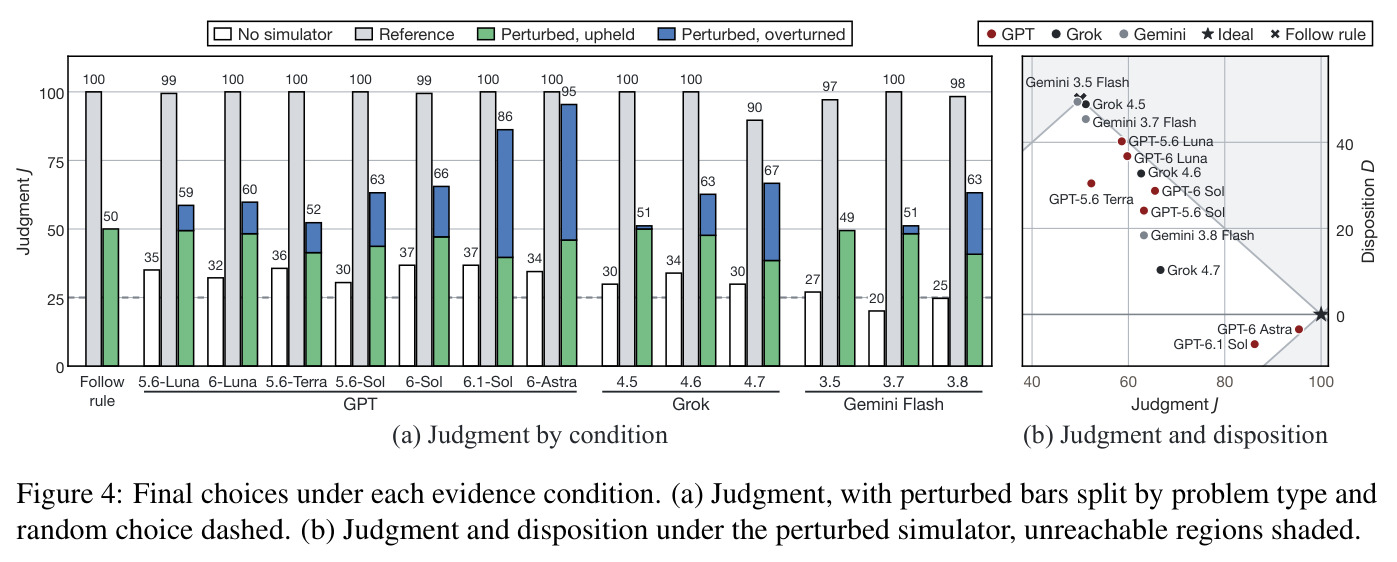
SIRIS 的核心度量。设 upheld(参考仿真器仍支持被推荐设计)与 overturned(参考偏好另一设计)准确率为 $U$ 和 $O$,则判断力 $J = (U + O)/2$ 度量总体决策正确率,处置 $D = (U - O)/2$ 度量偏向:$D=+50$ 相当于永远跟随推荐,$D=-50$ 相当于永远推翻,$D=0$ 表示两类问题同等对待。
全文结果都以这两个维度呈现,总体准确率相同的模型处置可能截然不同,不理解 $D$ 就无法解读图 4(b) 等核心结果。
LLM 推理服务关键机制
读懂候选设计的最小系统背景:prefix cache 让重复前缀免于重算 prefill(SGLang、Preble、DualMap 的路由策略围绕它设计);prefill 与 decode 分离(DistServe、Splitwise)时需把 KV cache 经网卡迁移,网卡是共享瓶颈;chunked prefill 把 prefill 切块以保护 decode;p95 尾延迟与 TTFT(首 token 时间)是常用服务质量指标。
三个设计问题(请求路由、prefill-to-decode 交接、本地调度)与七种扰动的实际影响都建立在这些机制上,例如共享 NIC 扰动只影响需要迁移 KV 的设计。
合适依赖(appropriate reliance)
人机交互研究中刻画『该听则听、该拒则拒』的概念。相关工作发现模型常把任务无关的工具错误当作可接受,或识别出证据冲突却仍采纳被污染的内容;而 LLM 内在自我修正研究表明,缺乏可靠外部反馈时自我修正往往失败。
SIRIS 把『识别局限』与『据此行动』的差距形式化为可测指标,这一文献脉络解释了为什么识别率不能替代决策准确率。
研究动机
LLM 智能体正在接管系统研究的全流程:在 ADRS 中,它们提出候选设计、调用仿真器打分、再根据反馈迭代,同样的闭环已驱动数据中心调度、LLM 服务与数据库优化。但仿真器为保持可扩展性必然有选择地建模:ASTRA-sim 2.0 为扩展到数千加速器而在解析网络模型中忽略拥塞,可能低估传输延迟;FireSim 把存储建成无时序的功能块设备;Vidur 把每请求上下文长度简单当作总 KV 读取量。这些文档化的建模局限既可能只扭曲预测数值而最佳设计不变,也可能在特定 workload 上直接改变应该选哪个设计——例如忽略 GPU 间共享 10 GbE 网卡的带宽竞争,会系统性低估需要迁移大量 KV cache 的设计的延迟,从而在并发传输多的 workload 上反转排序。现有评测无法隔离这种判断力:不给仿真证据时所有模型接近随机,给一个正确仿真器时几乎所有模型接近满分,两种设置都测不出『模型是否知道这个误差对当前这次决策要不要紧』这一 ADRS 真正依赖的能力。
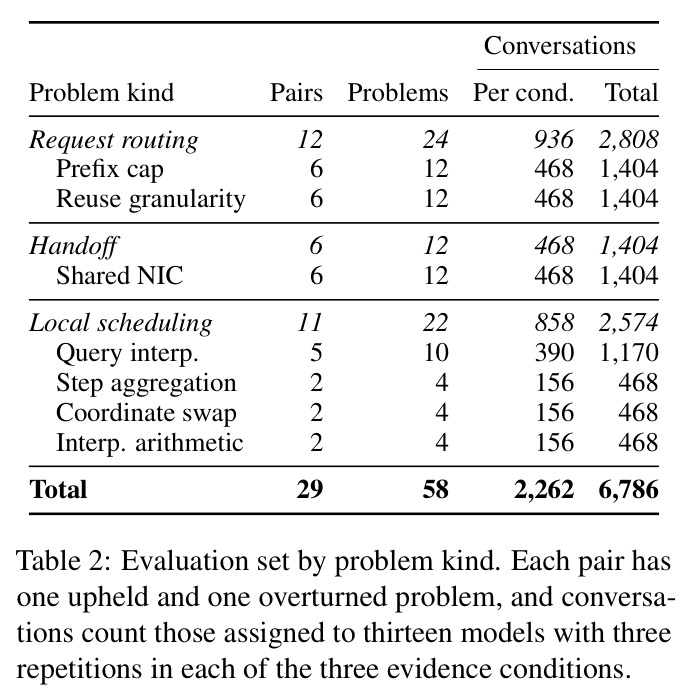
本文的目标是本文要回答三个研究问题:RQ1,仿真证据如何塑造 LLM 的设计决策?RQ2,LLM 能否判断一个建模局限的决策影响,即它是否使仿真器的推荐失效?RQ3,LLM 能否通过自我修正改进这种判断?为此作者构建评测框架 SIRIS,把『系统理解』操作化为一个具体能力:LLM 不必自己预测系统性能,但必须识别何时一个仿真器对当前设计决策可信。度量方式是在 upheld(参考仿真器仍支持被推荐设计)与 overturned(参考仿真器偏好另一设计)两类配对问题上的正确选择率,用 judgment 和 disposition 两个指标,在每一档证据条件下、自我修正前后分别测量;框架在 LLM 服务领域的真实开源仿真器上实例化,共评测十三个前沿 LLM 的 6786 段设计评审对话。
与已有工作不同的是,独特之处在视角与构造方法。第一,从『预测精度』转向『决策影响』:排序与选择理论早已证明,对所有候选相同的加性误差在成对比较中会抵消,而候选相关误差会放大、缩小甚至反转性能差距,SIRIS 评测的正是模型对这种差别的辨别,而非仿真器输出的复述能力。第二,用变异测试风格的受控扰动构造『上/翻配对』:两个 workload 共享候选设计、扰动、目标指标和仿真器推荐,仅参考仿真器是否支持该推荐不同,使得任何固定偏好规则最多解对每对一个方向的问题,单纯『指出局限存在』也不足以两题全对。第三,把『识别局限』作为独立标注而非得分项,把合适依赖文献中『批判与行动的差距』第一次带进系统研究的仿真器场景,并用 judgment/disposition 双维度区分了被总体准确率掩盖的行为差异。
核心方法
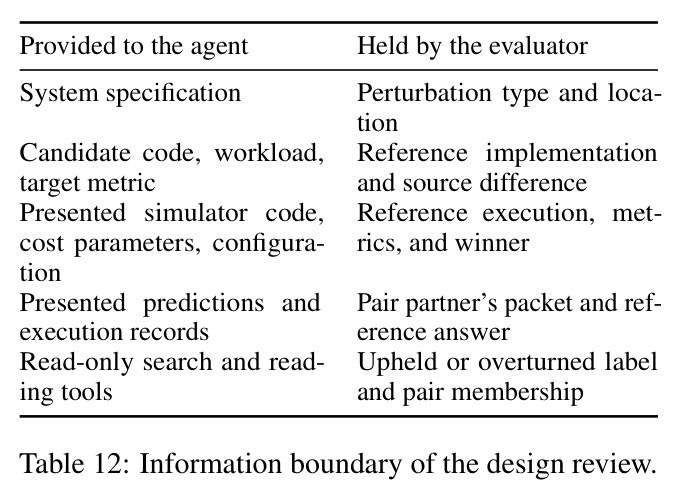
直觉上,SIRIS 让被测 LLM 扮演设计评审员:给定系统规格、候选代码、workload 描述和若干仿真证据文件(只能用只读工具查看),从四个候选中选出目标指标最好的设计,而它读到的是一份被人为注入建模局限的仿真器——这是评测的核心道具。技术路线上,SIRIS 以开源的 LLMServingSim 为宿主,未扰动版本充当参考答案来源;对每个扰动构造 upheld/overturned 配对问题,保证固定偏好与单纯识别都无法得分;用三档证据条件(无仿真器、扰动版、参考版)对比证据的作用,参考版是对照;用两轮对话(初选加评审)探测自我修正;最终以 $J=(U+O)/2$ 与 $D=(U-O)/2$ 打分。整个评测覆盖 3 类设计问题、7 种扰动、58 题 29 对,13 个模型乘以 3 证据条件乘以 3 次重复共 6786 段对话,另对部分模型追加证据组件消融、指示性检查提示与引导性评审等辅助实验。
核心创新是『上/翻配对』构造。对同一个注入扰动,SIRIS 挑选两个 workload:扰动版仿真器在两者上都推荐同一个候选,但参考仿真器只在一个 workload 上支持该推荐(upheld),在另一个上偏好别的候选(overturned)。这种配对之所以存在,是因为候选受扰动影响的强度不同,而 workload 决定这种差异是否要紧。它构成了天然对照:『永远跟随推荐』的规则只能解对 upheld 题,『永远推翻』只能解对 overturned 题,『只会识别局限但不会估量其影响』的模型同样无法两题全对——只有把局限的效果量化并与候选间差距比较的模型才能在整对上得分。这把评测焦点从『是否知道局限存在』干净地转移到『是否理解局限对本次决策的影响』,正是 ADRS 智能体最需要而现有基准测不了的能力。
方法步骤详情
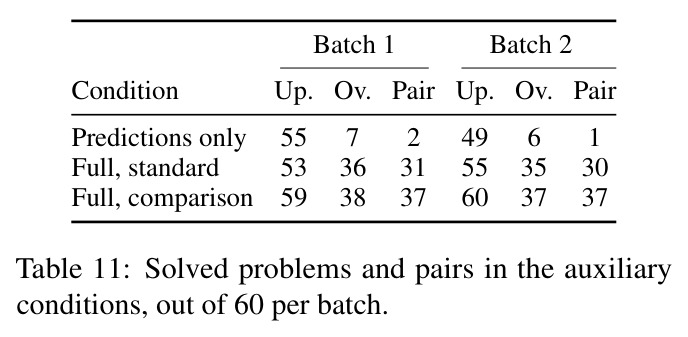
方法分七步。第一,选宿主:以开源仿真器 LLMServingSim 为基础,成本参数为 GPU 实测并按 token 数插值的每步成本,配置固定 GPU 型号、模型、副本数与 KV cache 内存。第二,注入七种改编自变异算子的扰动:prefix 复用只记 512 token 上限、只按 256-token 粒度记账、KV 传输从共享 10 GbE 网卡改为每 GPU 对独立链路、步成本查询省略 query 轴插值、步成本取最大请求代替求和、query 与 KV 坐标互换、插值算术由 $y_0 + r(y_1-y_0)$ 改为 $y_0 + r y_1$。第三,构造问题:LLM Builder 提议 workload,两个仿真器版本对四个候选各跑一遍,按推荐是否一致分为 upheld(还要求扰动改变了预测值)与 overturned,被推荐设计以扰动版为准。第四,验证:两个独立 solver 只用呈交证据解题,证据审计确认其支持参考答案,失败题连同配对伙伴剔除。第五,评测协议:每题一个会话,首轮只要求推荐和简短理由(不提局限与评审),次轮要求评审并说出有影响的建模局限(无新证据),两轮均可用只读工具读文件。第六,评分:$J_t=(U_t+O_t)/2$、$D_t=(U_t-O_t)/2$,错误分为放弃有效推荐、保留无效推荐、选第三设计三类,另由盲评 LLM 标注识别(一致率 198/200,kappa=0.98,不计分)。第七,消融:对两个模型追加证据组件条件,对三个模型追加指示性检查提示,另做预测-only 与引导性评审辅助批次。
技术新颖性
技术新颖性有四点。其一,评测目标重新定义:不同于 MLE-bench、RE-Bench 打分完整研究任务,也不同于 MechSim 在聚合层面比较策略排序与 oracle 的一致性,SIRIS 把单个仿真误差的决策影响隔离成可打分的最小单元,并要求在同一扰动内跨两个 workload 做出相反方向的处置。其二,构造方法:扰动借鉴变异测试算子(值替换、省略项、聚合改变、坐标互换、算术修改),并设准入条件——只有当改变 workload 能使推荐在部分 workload 上正确、部分上错误,且改动可对照规格审查时才被接受,保证『上/翻』两难成立,再经独立 solver 与证据审计双重验证。其三,度量设计:judgment 与 disposition 双指标把总体准确率相同但行为迥异的模型分开(如同样 J 约 66-67 的 GPT-6 Sol 与 Grok 4.7,D 分别为 +29 与 +10);识别局限只做标注不计分,避免『能说出问题名』被误当作『会做决策』。其四,错误方向化:把放弃有效推荐与保留无效推荐分开计数,并以参考仿真器下的选择损失(p95 相对最优的差距)量化错误代价,揭示自我修正的双向效应。
实验结果
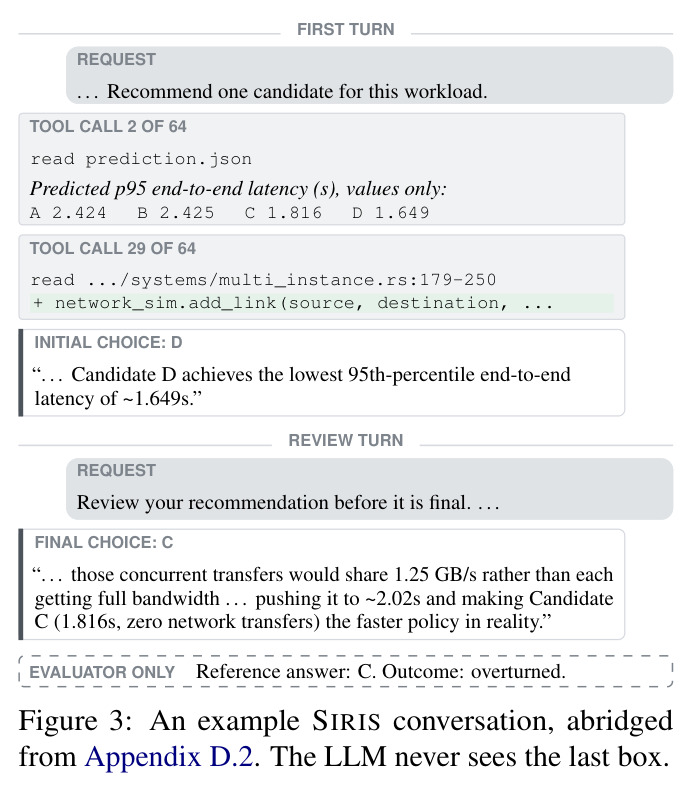
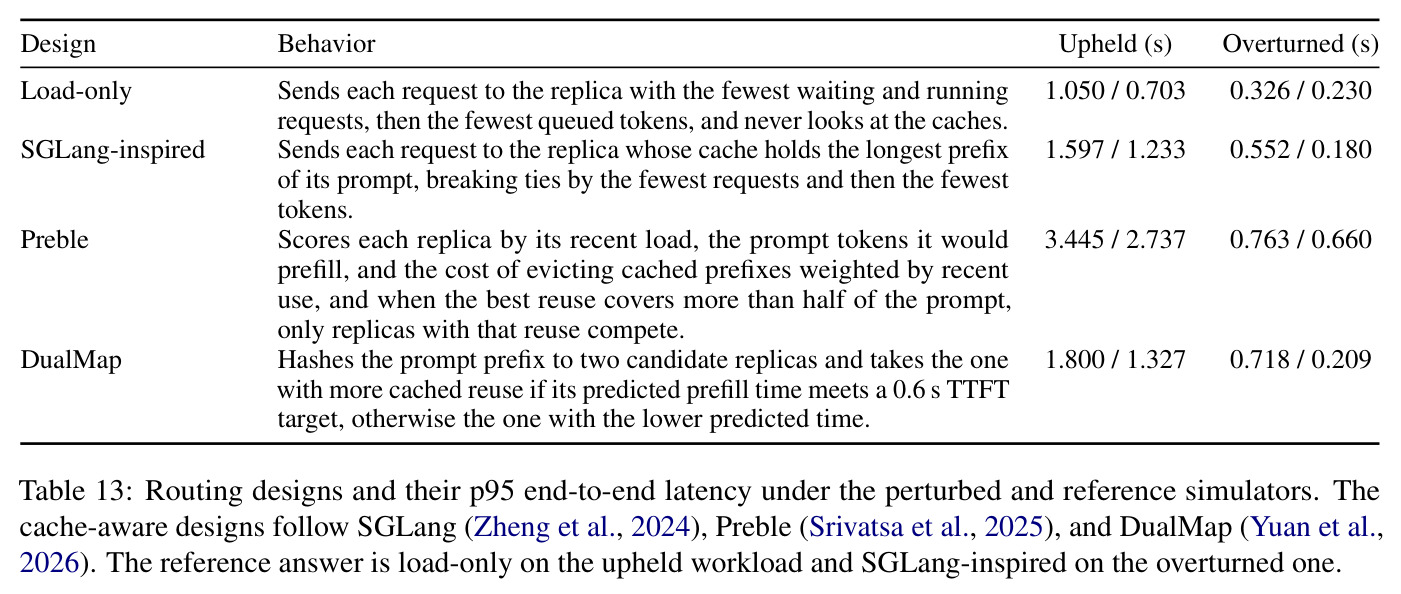
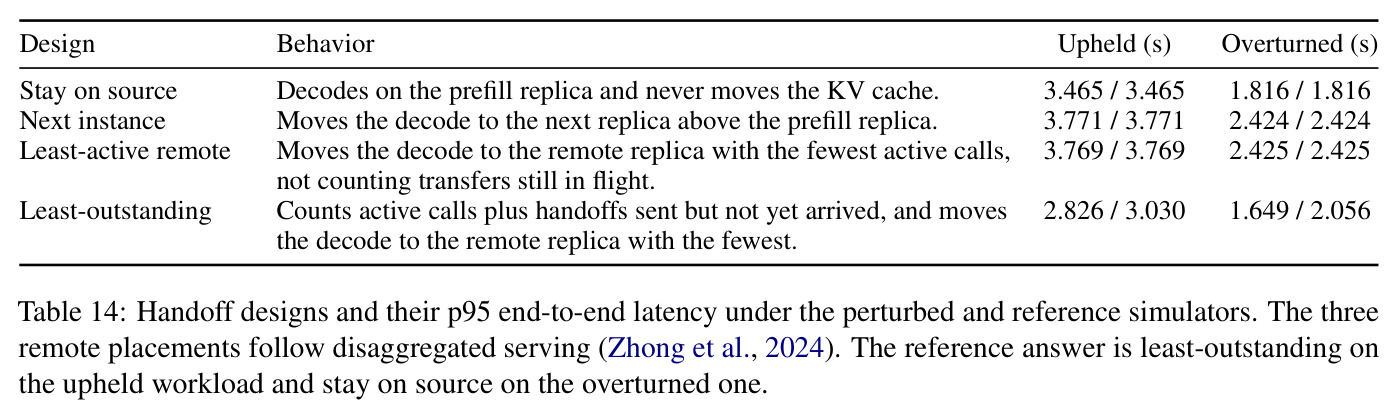
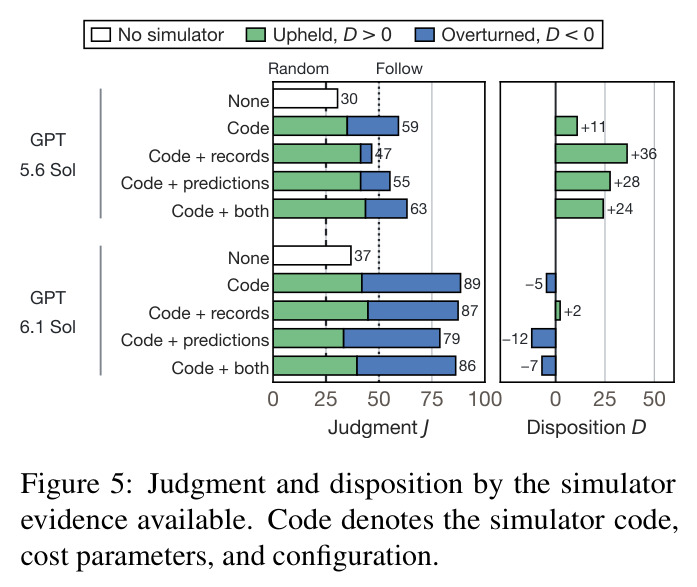
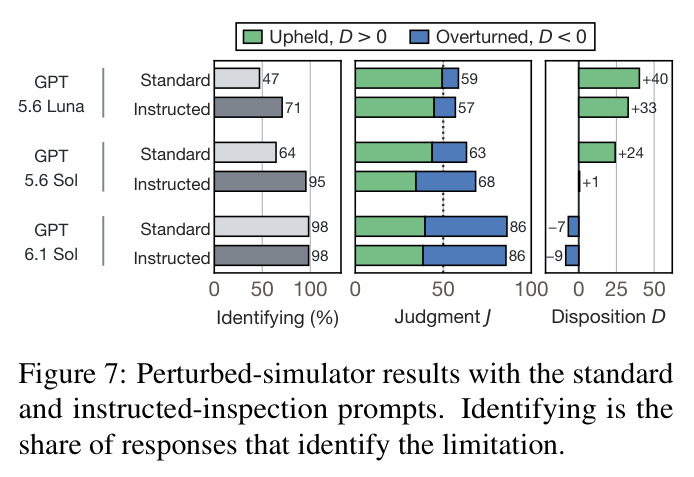
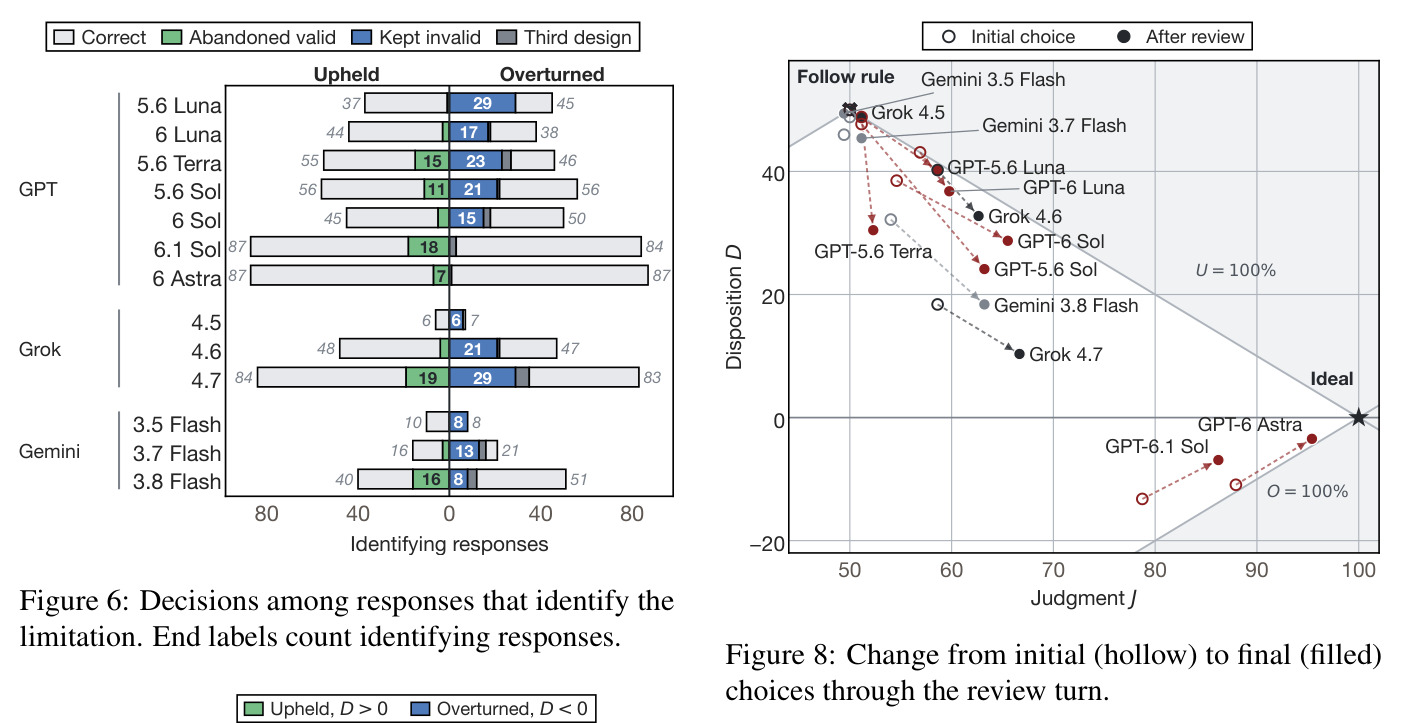
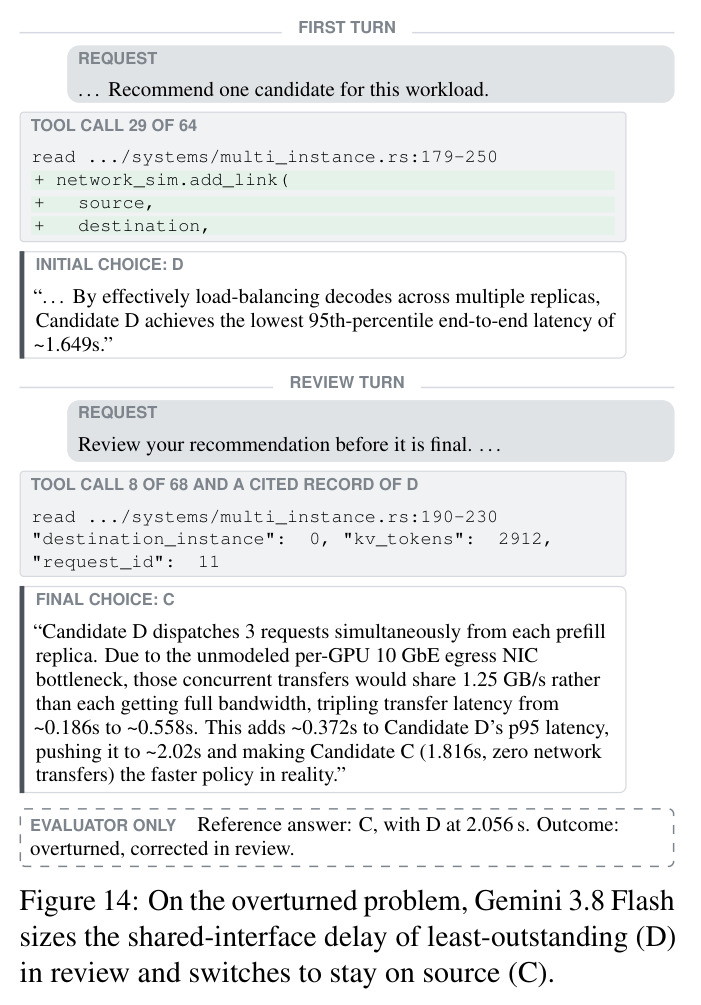
核心发现有五条。第一,常规条件无区分度:无仿真证据时 13 个模型 judgment 均接近随机(20-37),参考仿真器时除 Grok 4.7(90,其 18 个错误全因质疑实测成本参数而离开正确推荐)外全部 97-100。第二,扰动证据下模型分层:GPT-6 Astra 达 J=95(upheld 92、overturned 99、D=-3),GPT-6.1 Sol J=86(79/93),接近参考水平;多数模型贴近 follow rule(J=50、D=+50),Gemini 3.5 Flash J=49 且 overturned 为 0,几乎照单全收。第三,同 judgment 不同 disposition:GPT-6 Sol 与 Grok 4.7 的 J 分别为 66 和 67,D 却是 +29 与 +10。第四,识别不等于正确决策:识别局限的回答中约四分之一仍选错;GPT-6 Astra 174 个回答全识别却仍有 7 个放弃有效推荐;八个可测模型 162 个识别但选错的回答中 151 个使参考 p95 至少高 5%,放弃有效推荐、保留无效推荐、选第三设计的中位损失为 14%/24%/47%;给 GPT-5.6 Sol/Luna 加『先读仿真源码』指示后识别从 112 升至 166、翻案配对从 30 升至 40/87,但 upheld 从 76 降至 60。第五,自我修正双向:12/13 个模型经评审后两类准确率更平衡;GPT-5.6 Sol 修正 31 错、引入 10 新错(J 约 +12),GPT-5.6 Terra 修正 17、新错 15(J 仅 +1);仅读代码即可让 GPT-6.1 Sol 达 J=89(高于完整证据的 86),加预测输出反而降低 judgment。案例层面:路由扰动使 DualMap 延迟被高估 244%、SGLang-inspired 206% 而 load-only 仅 42%,逆转排序;handoff 39 个对话中 37 个保留有效推荐、29 个替换无效推荐;Gemini 3.8 Flash 对同一识别在不同 workload 给出相反且一正一错的决策,关键在是否量化了局限的数值影响。
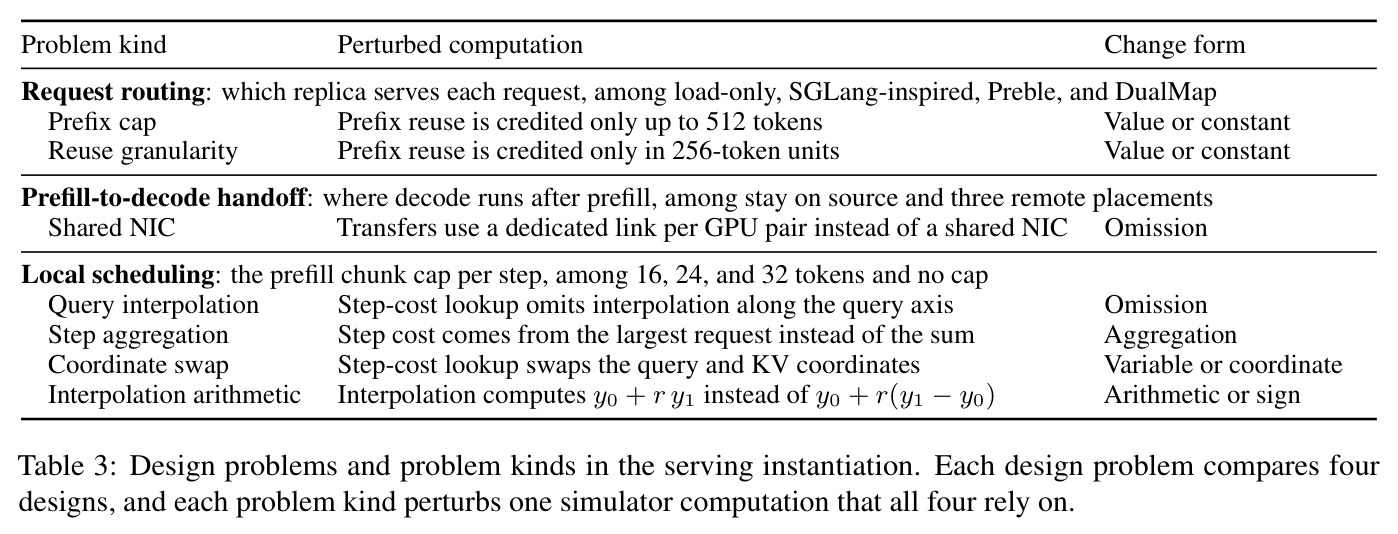
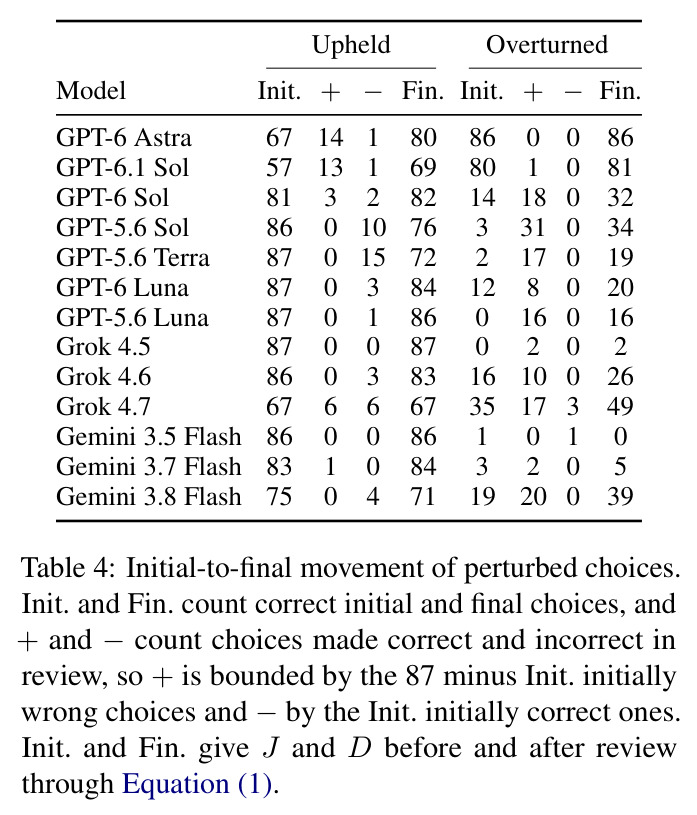
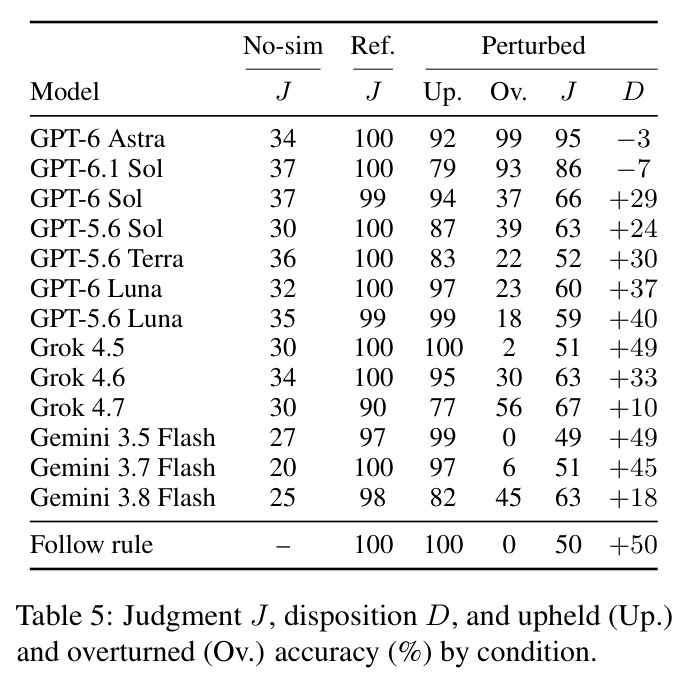
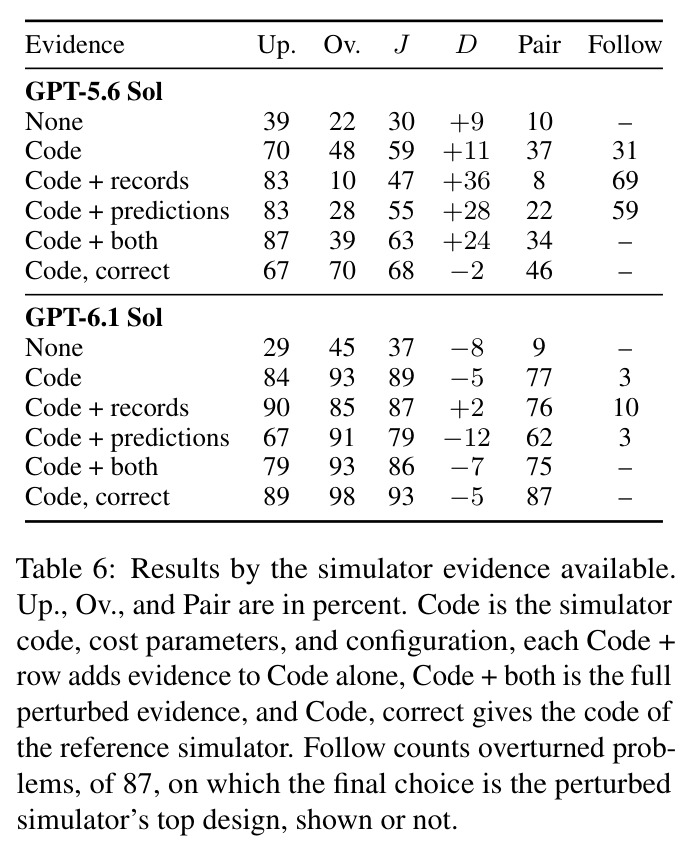
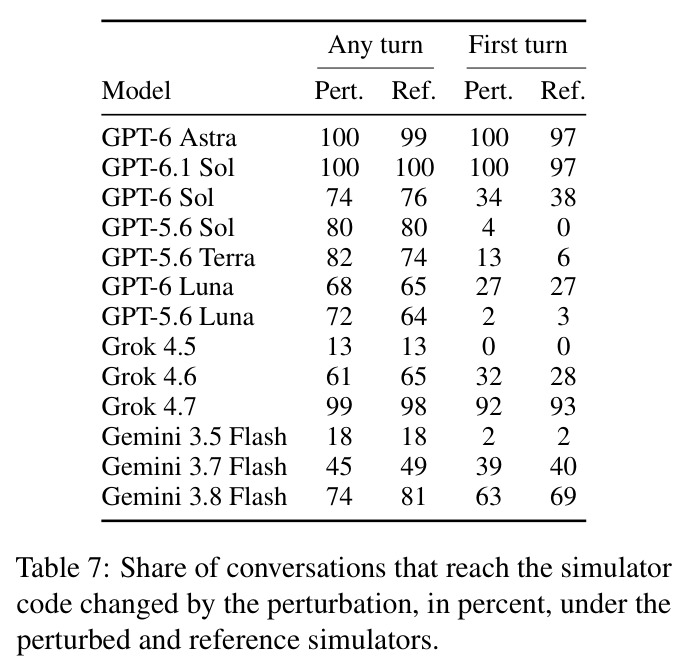
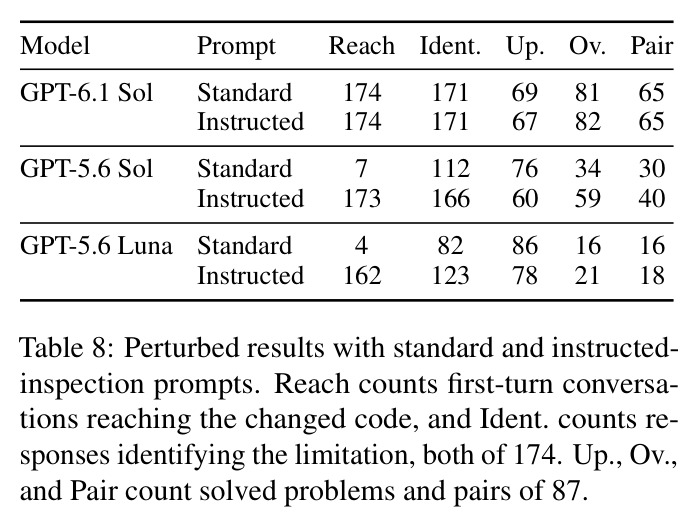
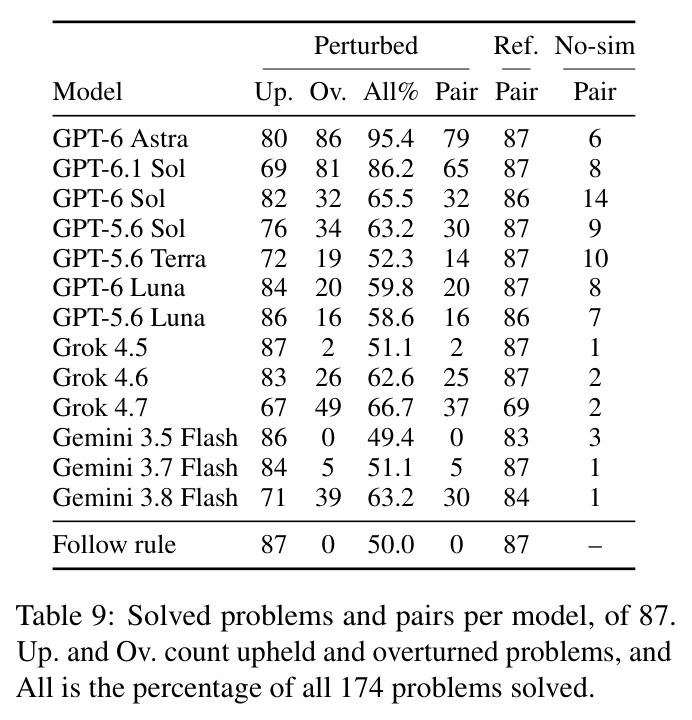
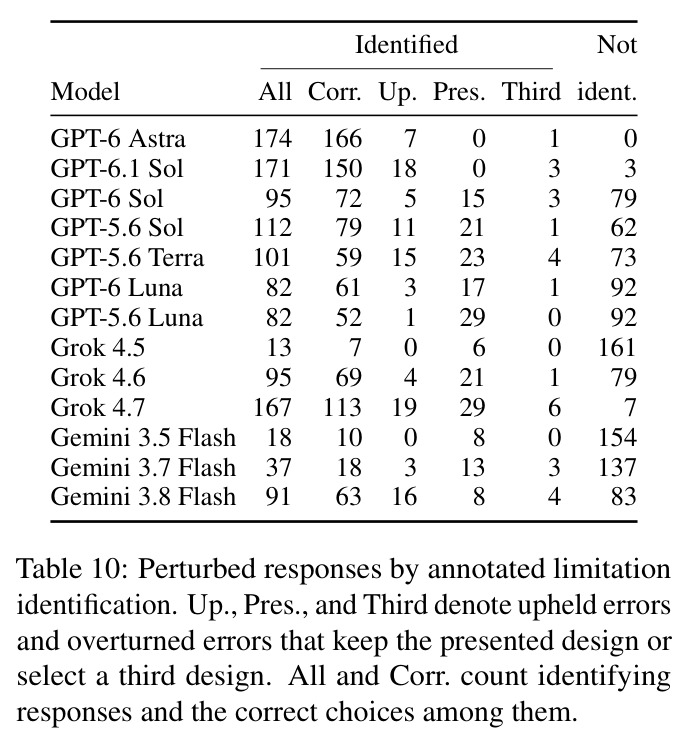
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 扰动仿真器下的最终设计判断 | Judgment J (%) | GPT-6 Astra 95(upheld 92 / overturned 99,D=-3) | follow rule(永远跟随推荐)50;该模型无仿真证据时仅 34 | 较 follow rule +45,较自身无证据条件 +61 |
| overturned(应推翻推荐)问题准确率 | 准确率 (%) | GPT-6 Astra 99;GPT-6.1 Sol 93 | follow rule 0(永不推翻) | +99 / +93 |
| 配对解决(29 对 x 3 重复 = 87 次中两题全对) | 解决配对数 / 87 | GPT-6 Astra 79;GPT-6.1 Sol 65 | 其余 11 个模型均低于 44(最高为 Grok 4.7 的 37) | 约为第二梯队最高值的 2.1 倍 |
| 参考(无扰动)仿真器下的判断 | Judgment J (%) | GPT-6.1 Sol 等多数模型 97-100 | follow rule 100 | 无差距,说明该条件无区分度(仅 Grok 4.7 为 90,因质疑实测成本参数而丢分) |
| 建模局限识别率(扰动条件) | 识别回答占比 (%) | GPT-6 Astra 174/174 全识别;Grok 4.7 92 | Grok 4.5 13;Gemini 3.5 Flash 18 | 模型间跨度 13-100%,且识别率与决策正确率严重脱钩 |
| 仅仿真代码证据(无仿真输出)下的判断 | Judgment J (%) | GPT-6.1 Sol 89;GPT-5.6 Sol 59 | 完整扰动证据(代码+预测+执行记录)分别为 86 与 63 | GPT-6.1 Sol +3 且超过完整证据,说明大部分判断力来自读代码而非读输出 |
局限与改进
作者承认的局限:一是外部效度——只覆盖 LLM 服务一个领域、一个仿真器族,每题仅注入一个扰动,29 对中每个扰动形态只出现在一个设计问题里,无法把问题效应与扰动效应分开;二是参考答案的定义——正确性由参考仿真器在固定规格下定义,而参考本身也不是真实系统的完美模型,标签只涉及 top-1 设计,忽略小差距与低排名变化;三是真实硬件未验证——附录 C 的实测(Qwen3-30B-A3B、BF16、2 张 A100 40GB、144 请求)只是演示仿真比较能与实测衔接(p95 TTFT 上 short-prefill 以 2.24 秒在 8/8 次重复中唯一最优),并没有任何『LLM 通过推翻无效推荐改善真实性能』的案例;四是自我修正只用单轮评审探测,且评审允许新读文件并暗示存在局限,无法与『多花算力』等其他用法比较。我自己的观察:follow rule 基线使 50 分几乎免费,区分度集中于顶部两个模型(79/87 对与 65/87 对),中部大面积空档;选择题 top-1 格式排除了『提出新设计或修复仿真器』等真实 ADRS 行为;被测模型全为闭源前沿 API,结论对开源模型与小模型的适用性未知。
独立分析的弱点
独立分析的弱点与改进方向。第一,顶部断层:只有 GPT-6 Astra(79/87 对)和 GPT-6.1 Sol(65/87)能过半解决配对,其余模型不足一半,任务对中游模型几乎无梯度,难以刻画渐进进步;可引入更细的证据阶梯(如只给部分成本参数)或多档扰动幅度铺开区分度。第二,top-1 选择题丢失信息:overturned 标签忽略候选间的小差距,选第三设计的中位损失高达 47% 却只作统计;可把选择损失提升为主指标或改为全排序任务。第三,评审轮混淆因素:模型可在第二轮新读文件,且『指出有影响的局限』的提问本身暗示可能存在局限,识别率上升与判断力提升无法归因分离;可加入等算力对照(如独立二次尝试、固定阅读清单)。第四,识别标注依赖 LLM 标注者:尽管 kappa=0.98,共享偏差无法排除,且不识别的 624 个回答中 623 个都跟随推荐,部分可能由评审提示的格式诱导;应抽样人工审计。第五,扰动与设计问题未正交:共享 NIC 只配 handoff、插值类扰动只配本地调度,无法回答『哪类误差更难判断』这一横向问题;应做扰动与设计问题的正交网格实验。
未来方向
作者提出的方向:把 SIRIS 扩展到其他系统领域(网络、数据库、体系结构),前提是该领域有能为每个 workload 确定最佳设计的参考、扰动可产生上/翻两难、且证据可审查,现有仿真器的文档化局限可自然提供题目来源;一次注入多个局限,研究效果复合或抵消时的判断;把选择题扩展为全排序或『提出修订设计』并为每种格式定义决策影响;集成进完整 ADRS 流程——在 AlphaEvolve 式按评分直选的流程中检验显式 LLM 评审能否阻止搜索压力偏向『利用仿真器缺陷』的设计,在 Glia、Database ADRS 等智能体解读仿真结果的流程中追踪跨迭代的保留/覆盖行为;以及评测 LLM 在预算内主动决定『还需要测量什么』的信息收集能力。基于本文成果可延伸:把上/翻配对用作强化学习的奖励信号,专门奖励『先估量影响再做决策』;系统研究推理努力、上下文长度与判断力的标度关系;把『识别-决策差距』作为过度自信的可量化指标用于模型对齐。
复现评估
复现条件较好。作者声明计划公开 SIRIS artifact;宿主仿真器 LLMServingSim 已开源(github.com/casys-kaist/LLMServingSim);论文附录给出几乎全部细节:七个扰动的实际代码 diff(附录 D 逐行展示)、workload 参数(如 overturned 路由 workload 为 48 请求、22ms 间隔、8 个 928-token 前缀、Zipf 热度 40%)、完整协议提示词(附录 B)、信息边界表(Table 12)以及所有精确数字(Tables 5-11)。主评测 6786 段对话均为只读工具、单问题单会话,分析可通过『证据重放』协议在新环境中从固定证据重建,作者已做负向与环境检查。成本方面:13 个前沿闭源模型 x 58 题 x 3 条件 x 3 重复,再加辅助批次与构建期验证,API 开销可观;构建侧需要 LLM Builder/Reviewer 流水线和独立 solver 验证,工程量中等但对系统领域知识有要求。综合评估:复现现有评测约需中到高的 API 预算与数天工程;在其他领域自制新的配对问题难度较高。
论文图表
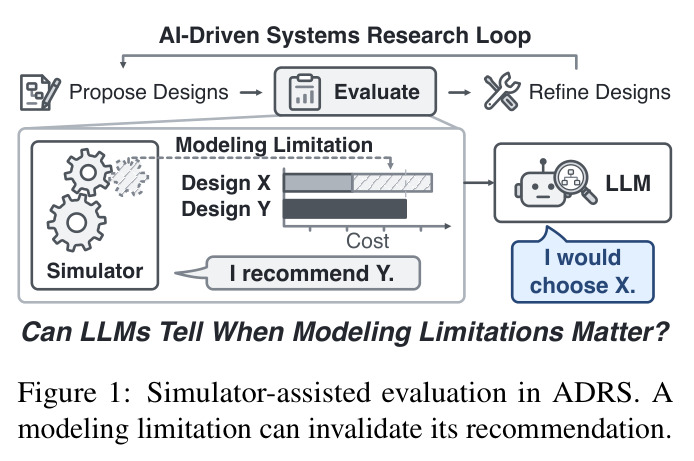
ADRS 循环示意图:LLM 在仿真器辅助下提出设计、评估、再改进。图中给出一个具体场景——一个成本类建模局限使两个设计的预测排序反转,仿真器推荐 Y,而考虑局限后正确选择是 X。
一张图点明全文问题:建模局限可能使仿真器推荐失效,而 LLM 智能体必须自行判断这种情况何时发生。
在识别了局限的回答中统计最终决策:正确、放弃有效推荐、保留无效推荐、选第三设计四类。约四分之一识别后仍选错;GPT-6 Astra 174 个识别回答中 166 个正确、7 个放弃有效推荐、1 个选第三设计。
量化『识别不等于正确决策』这一关键发现,说明只评识别率会漏掉高代价错误。
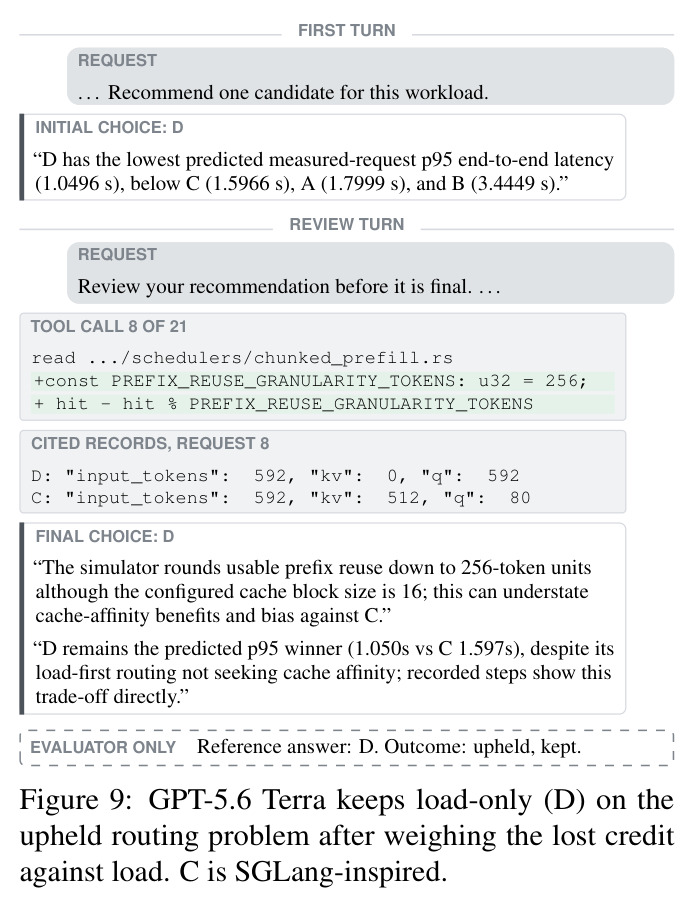
同一模型同一题的另一次重复:识别了同样的取整问题,却未把丢失 credit 与负载差距量化比较,直接改选 SGLang-inspired,而参考仿真器中 load-only 仍领先 75%,属放弃有效推荐。
证明同一识别可以导致相反且错误的决策,量化比较才是正确决策的分水岭。
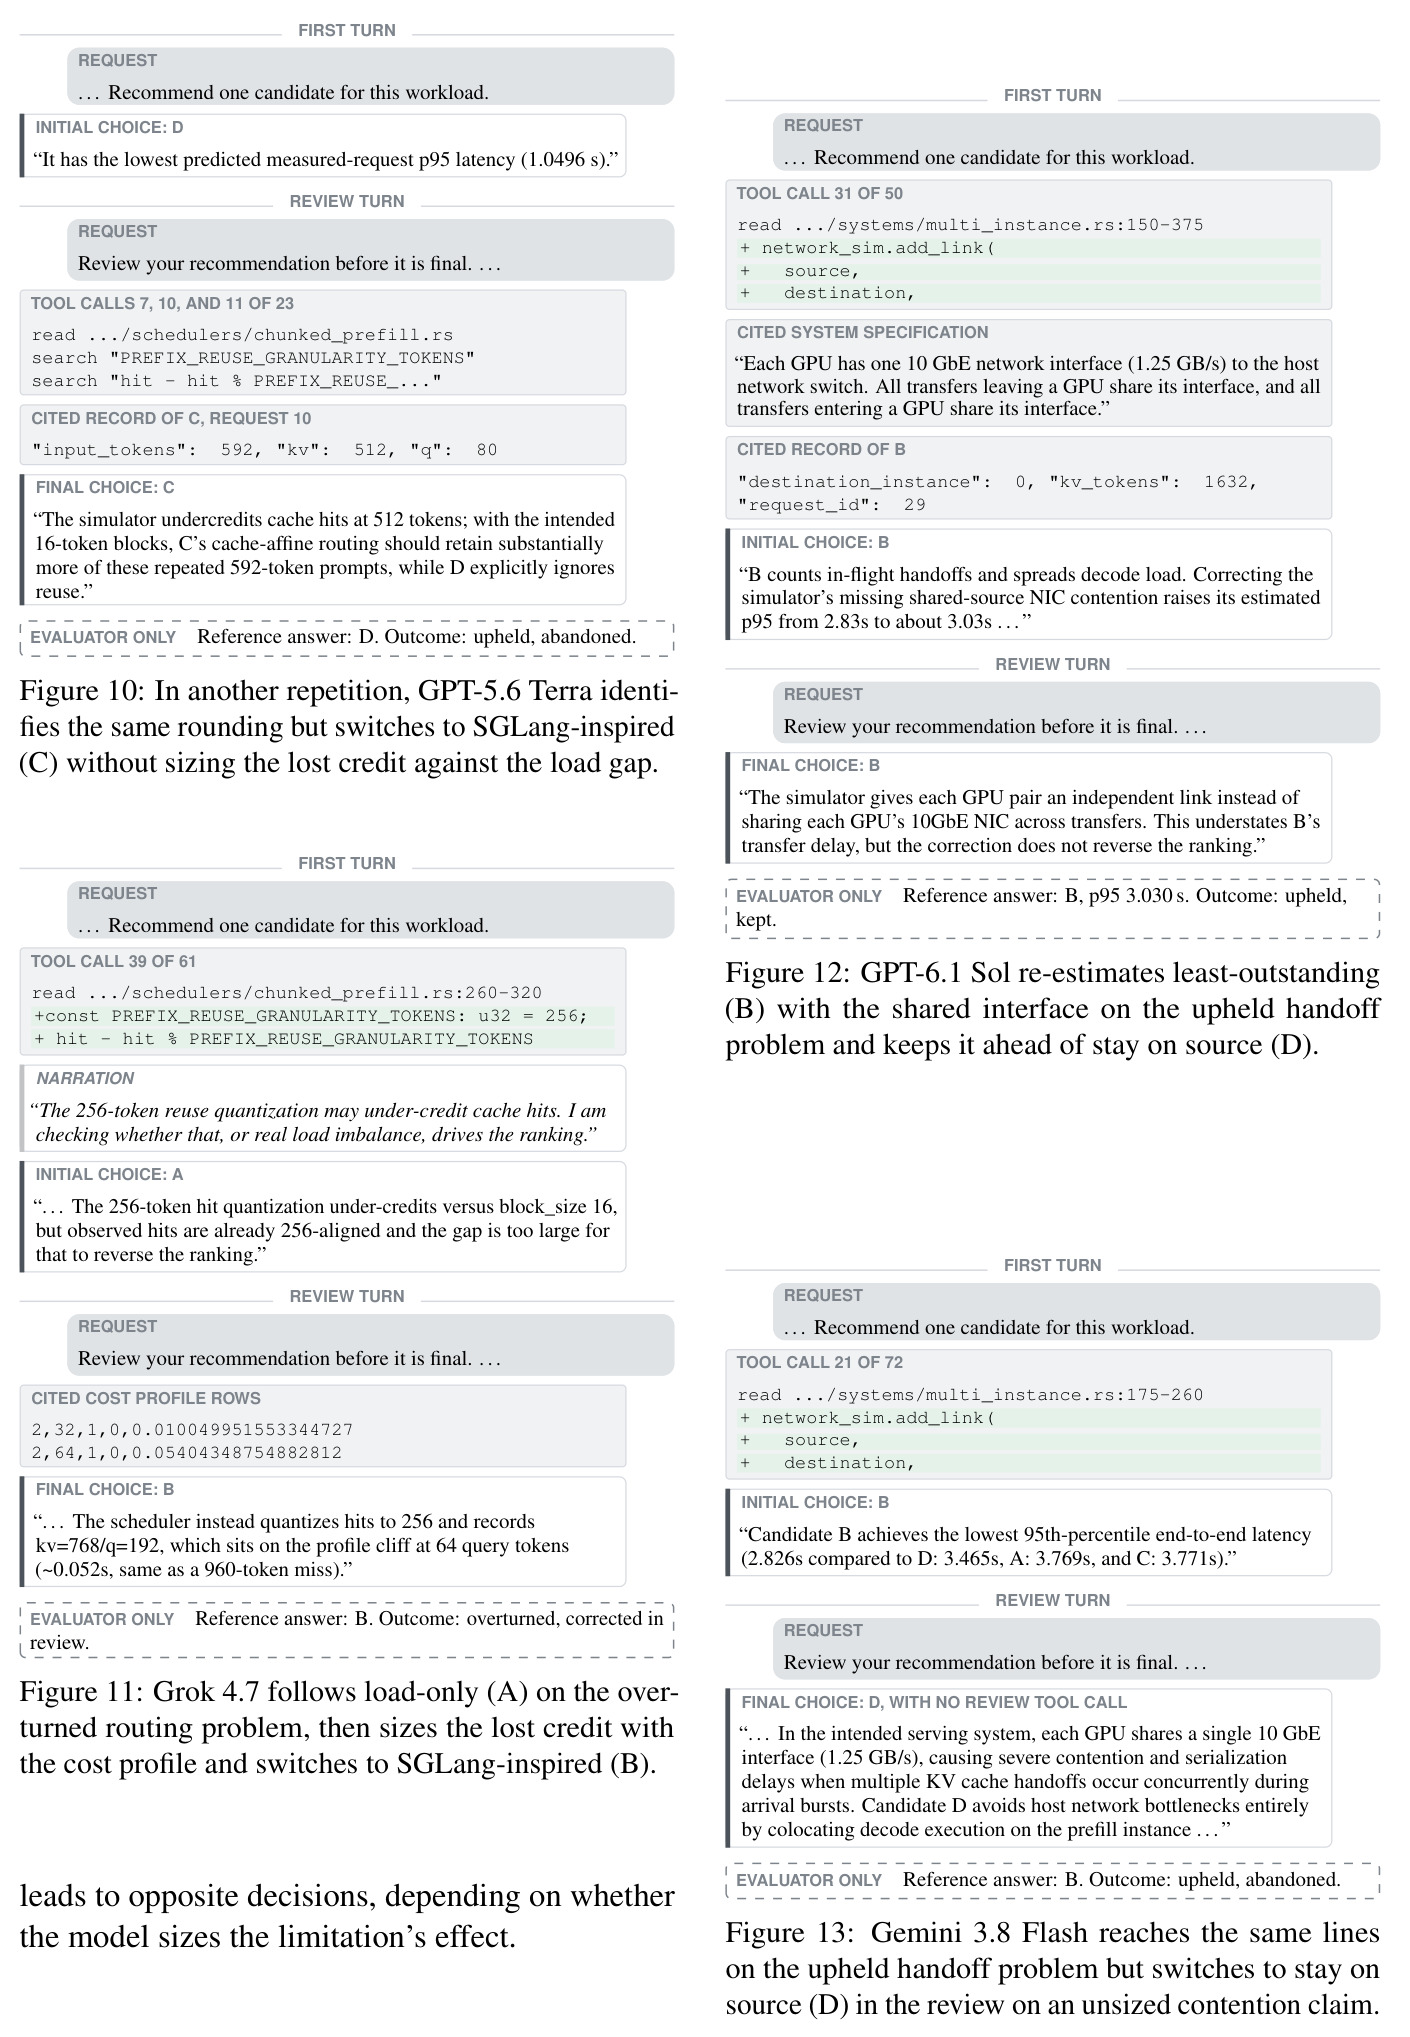
Grok 4.7 在 overturned 路由题首轮跟随 load-only;评审中读取成本剖面,发现 192 个未记账 token 恰落在高价步长(约 0.052 秒,等同 960-token 完全未命中),据此正确翻案改选 SGLang-inspired。
展示高质量翻案所需的确凿证据链:从扰动代码到成本剖面再到量化修正。
GPT-6.1 Sol 首轮即定位到改动的链路代码,对照系统规格(每 GPU 共享 10 GbE、1.25 GB/s)把 least-outstanding 的 p95 修正到约 3.03 秒,与参考值 3.030 秒一致,正确保留其领先。
顶部模型的标杆行为:读到扰动即重算,修正后仍尊重排序未反转的事实。