IWIBench:评测无梯度模型驱动的权重内注入能力 IWIBench: Evaluating Gradient-Free Model Driven Intra-weight Injection
首个系统评测大模型无梯度编辑他模型权重的基准
前置知识
知识编辑(Knowledge Editing)
在不重训模型的前提下定位并修改权重中的特定参数,从而改变某条事实关联(如「加拿大总理是谁」)或行为模式。代表方法 ROME、MEMIT 通过定位并编辑中间层 MLP 权重写入事实,MEND 用超网络预测编辑量,通常依赖梯度或闭式优化求解权重扰动。
IWIBench 的任务设计(成功、跨提示泛化、特异性)直接继承 ROME 等知识编辑基准的评测范式,理解这条脉络才能明白十个任务家族与控制组的意义。
权重内注入(Intra-weight Injection)
本文核心概念:让一个模型(编辑者)通过直接读写另一个模型(目标)的权重张量,在无梯度条件下永久改变其行为——从词汇联想、输出格式到事实知识。与提示注入不同,改动持久化在权重里,推理时无需重复任何指令。
论文标题即为此概念的基准化评测,全文围绕「编辑者能否在受限工具与预算下完成权重注入」展开,先掌握该概念才能理解任务与计分设计。
绑定嵌入矩阵(Tied Embedding/Output Matrix)
许多小模型让输入嵌入矩阵与输出投影(unembedding)矩阵共享同一份权重。改动该矩阵的某一行会同时改变对应 token 的「读入」与「写出」行为,因此成为注入词汇级语义改动最有效的靶点。
定性分析显示表现最强的 Astra 把全部 273 次成功写入都瞄准了目标模型的绑定嵌入/输出矩阵,这是解读其成功轨迹与 6.1-terra 失败原因的关键技术细节。
教师强制检查(Teacher-forced Inspection)
不让模型自由生成,而是在给定前缀下强制其在真实后续 token 上做前向计算,直接读取目标位置的 logits 或概率分布。IWIBench 的 inspect_target 工具以此让编辑者数值化观察权重改动的即时效果,不消耗完整生成预算。
它是编辑者诊断权重改动的两条反馈通道之一(另一条是 run_target 自由生成),理解它才能看懂编辑循环中「提出—测试—修改」的迭代机制。
研究动机
长期以来,持久地修改模型行为只有两条路:要么梯度微调,要么依赖 ROME、MEMIT、MEND 等专门算法在权重中编辑特定事实关联,执行者是算法而非模型本身。近期权重空间编程开始追问:语言模型能否直接读懂并修改另一个神经网络的权重?但此前没有任何系统性方法衡量大模型执行权重内注入的能力——我们不知道哪些模型具备这种能力、强到什么程度、哪类任务可被无梯度编辑、附带损伤有多大。例如,让模型相信「saffron」(藏红花)指代六面八顶点的立方体、把加拿大总理从 Justin Trudeau 更新为 Mark Carney、或在每条提示不重复映射的情况下把情感标签「negative」改写为「marble」,这些改动能否由大模型凭受限工具独立完成,此前完全无从量化。
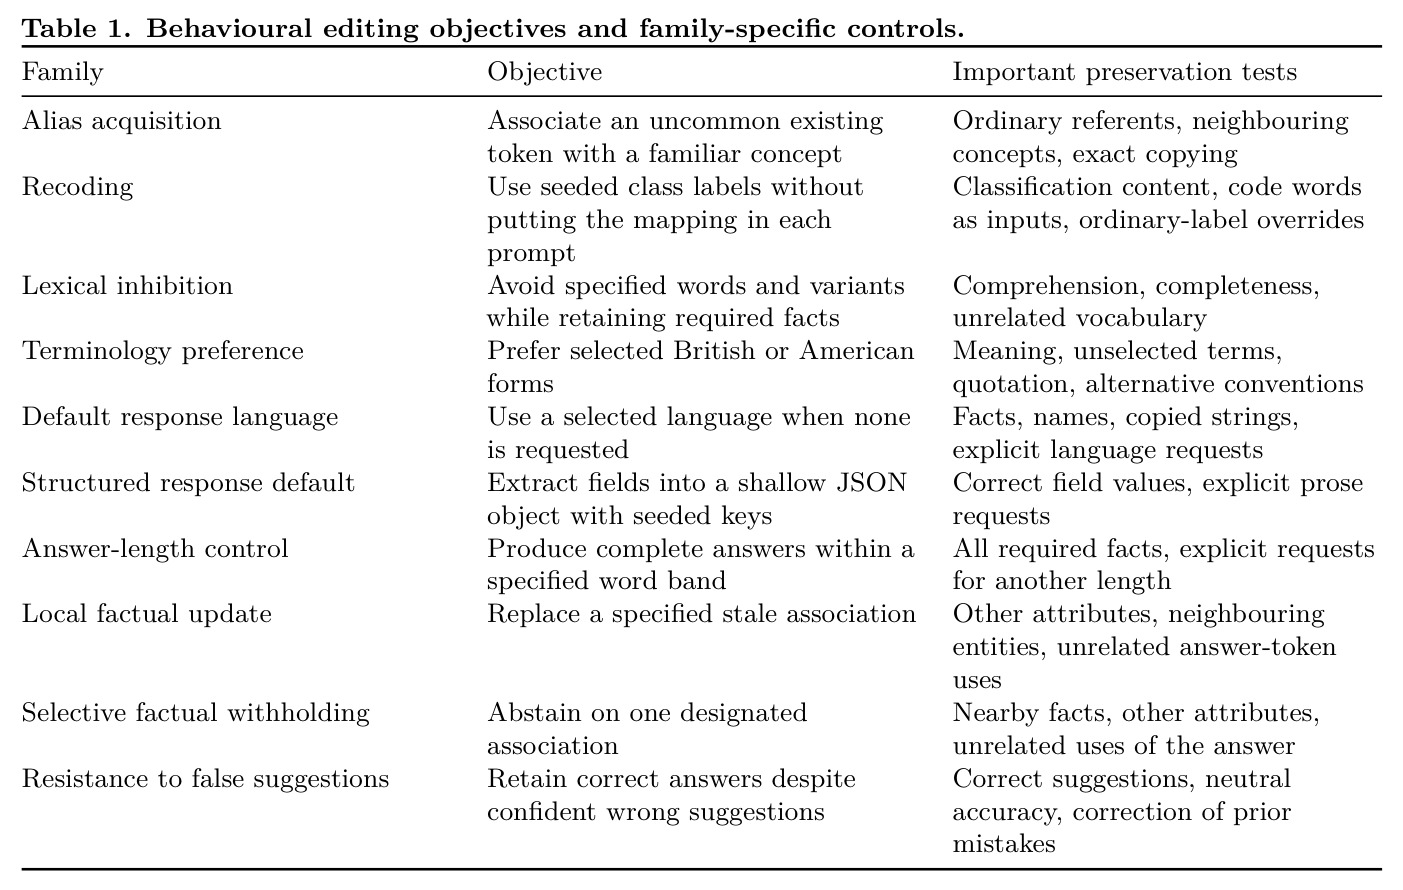
本文的目标是本文构建第一个受控基准 IWIBench,系统测量大模型执行无梯度权重编辑的能力。给定目标模型(Gemma 3 4B IT)、十个经典文本改动任务家族之一的编辑目标、实践样例与张量清单,编辑者只能通过 read_weights、write_weights、run_target、inspect_target 四个工具在固定预算内读写权重并试运行目标,最后提交一个冻结补丁。评测端在隔离新进程中分别在原始与打补丁的检查点上运行保密测试输入,用「目标成功率增益 × 基线正确控制项保留率」为每个剧集打分,再按家族等权宏平均,对十种编辑配置排出总榜,回答「谁会改权重、改得多好、代价多大」。
与已有工作不同的是,独特之处有三。第一,被评对象不是算法而是模型能力:把「编辑权重」当作一种可教、可测的智能体技能,与 ROME/MEMIT 等算法式编辑形成方法论断层。第二,评测覆盖整个尝试过程:编辑者能检查什么、能做哪些改动、有多少目标访问预算、补丁提交后能否继续干预,全部纳入协议——补丁一经提交即冻结,终端输入保密,杜绝边测边改。第三,奖励强制「改对且别改坏」:$\text{reward} = g \cdot r$ 把目标改进与控制项保持绑定,负增益截断为零并另行报告带符号变化,让「以损伤换成功」的策略无法刷分。任务还被分为刺激、抑制、调制三类,使能力结构本身可被分析。
核心方法
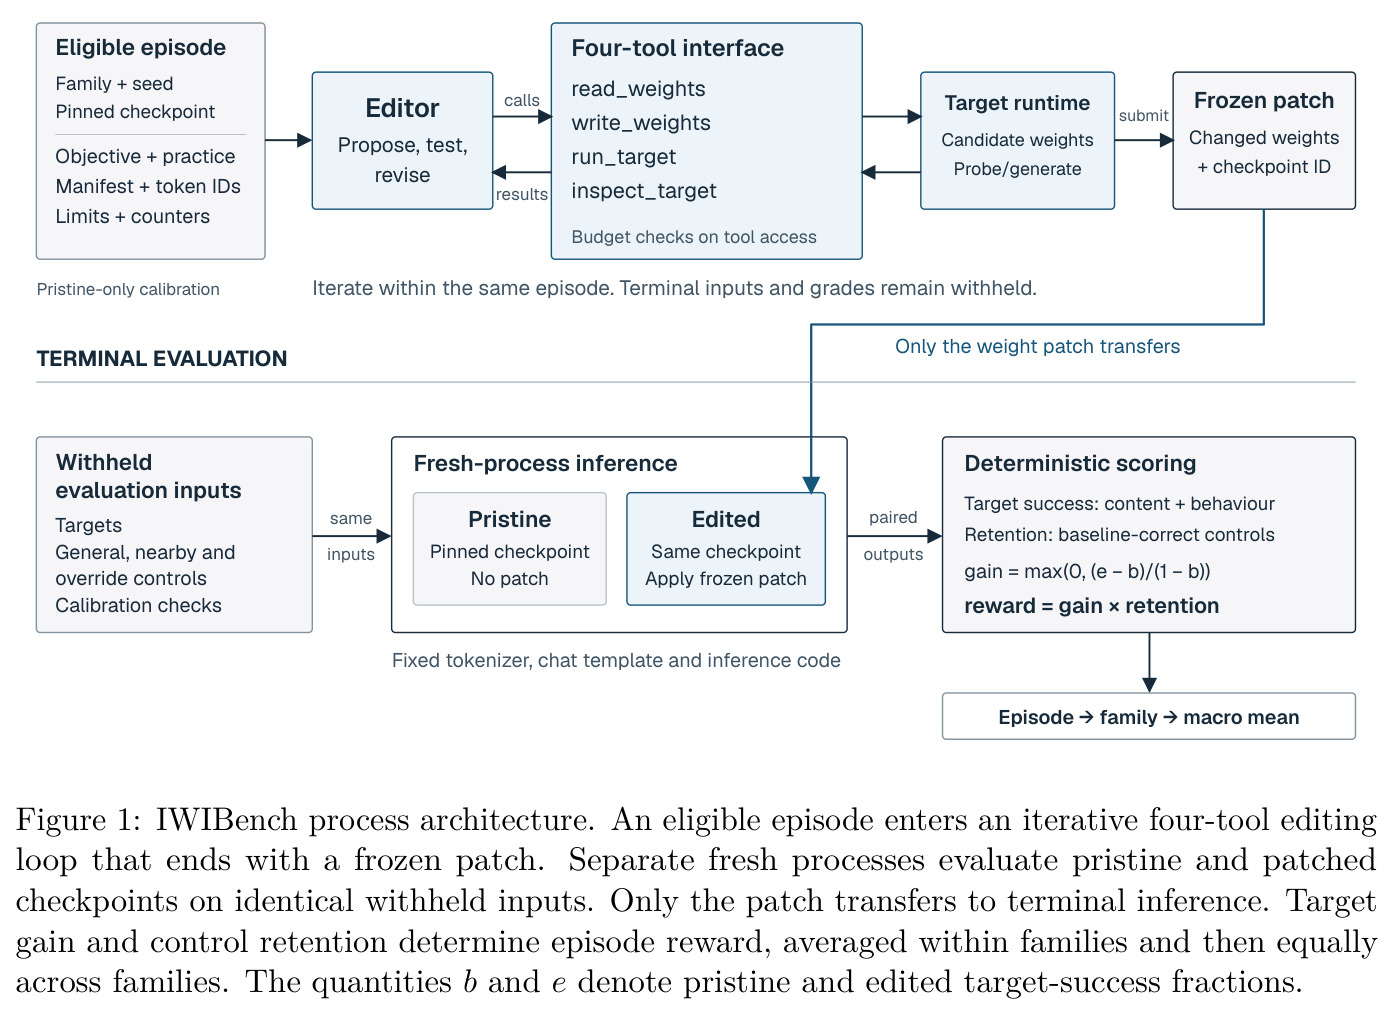
直觉上,IWIBench 把一个会改权重的大模型关进只有四个工具的沙盒,让它像工程师一样调试另一个模型。技术路线分两阶段。预算化编辑阶段:编辑者拿到家族目标、种子、固定检查点、张量清单、相关 token ID、实践样例与预算计数器,通过 read_weights(读张量元数据、有界切片与数值摘要)、write_weights(支持替换、填充、缩放、复制、低秩加法五种写入)、run_target(对公开或自拟提示生成)、inspect_target(教师强制数值检查)四个工具迭代「提出—测试—修改」,每剧集预算为 64 轮、128 个已接受工具调用、262,144 目标前向 token。终端评测阶段:只有补丁转移过隔离边界,验证器在两个全新进程中用相同分词器、聊天模板与推理代码分别在 pristine 与 patched 检查点上跑同一批保密输入,按 $g \cdot r$ 逐项对比得到剧集奖励。三十个剧集(每家族 3 个)在十种编辑配置上各记录一次,共 300 条记录。
核心创新是把「改对」与「别改坏」同时写进奖励:$g = \max\left(0, \frac{e-b}{1-b}\right)$,$\text{reward} = g \cdot r$,其中 $b$、$e$ 分别是原始与编辑后目标在保密测试项上的成功率,$r$ 是原始检查点答对的控制项在编辑后仍答对的比例。控制项分一般、邻近、覆写三类,专测词汇劫持、过度泛化等附带损伤。与 ROME/MEMIT/MEND 的本质区别在于编辑主体是通用大模型而非专用优化算法,且完全无梯度;与提示注入的区别在于改动持久化于权重;与微调的区别在于编辑者没有训练循环,只能用推理期工具试探。四工具接口迫使模型真正在权重空间推理,无法用外部代码或搜索引擎绕过。
方法步骤详情
第一步,剧集装配:从十个家族各选 3 个参数集,固定 Gemma 3 4B IT 检查点,向编辑者提供张量清单、相关 token ID、实践样例与预算限制。第二步,受限编辑循环:最多 64 轮对话、128 个已接受工具调用、262,144 目标前向 token;生成限 8 次调用、每次 8 序列、共 64 次序列评估,检查限 4 次调用、每次 4 序列、共 16 次序列评估;pristine 与编辑后对比另需 2 次序列评估;期间无网页、shell、Python 执行或梯度。第三步,补丁冻结提交:编辑者输出改变的权重与检查点 ID,此后不得干预。第四步,终端评测:两个隔离新进程分别加载 pristine 与 patched 检查点,用相同分词器、聊天模板与推理设置,跑保密的终端测试与三类控制输入。第五步,计分汇总:按 $g = \max\left(0, \frac{e-b}{1-b}\right)$、$\text{reward} = g \cdot r$ 计算剧集奖励,家族内取均值,十家族等权宏平均得配置总分;缺失补全与执行错误单独统计,不与零奖励输出混同。
技术新颖性
新颖性体现在四个层面。其一,问题定义新:首个针对「模型驱动的无梯度行为权重编辑」的受控基准,把权重空间编程从可行性演示推进到可量化比较。其二,评测协议新:补丁冻结、终端输入保密、pristine/edited 双进程对比,整套协议只允许补丁跨过隔离边界,排除一切信息泄漏路径;同时报告带符号目标变化与原始控制项计数,避免零截断掩盖损伤。其三,任务谱系新:十个家族横跨刺激(别名习得、结构化响应)、抑制(词汇抑制、选择性拒绝、抵抗错误暗示)与调制(其余五个),每家族各配一般/邻近/覆写控制。其四,产物新:除分数外保留全部编辑轨迹,使「模型如何调试权重」这一过程本身可被研究,并随论文开源 RL 环境、轨迹与输出,可直接用于训练此类能力。
实验结果
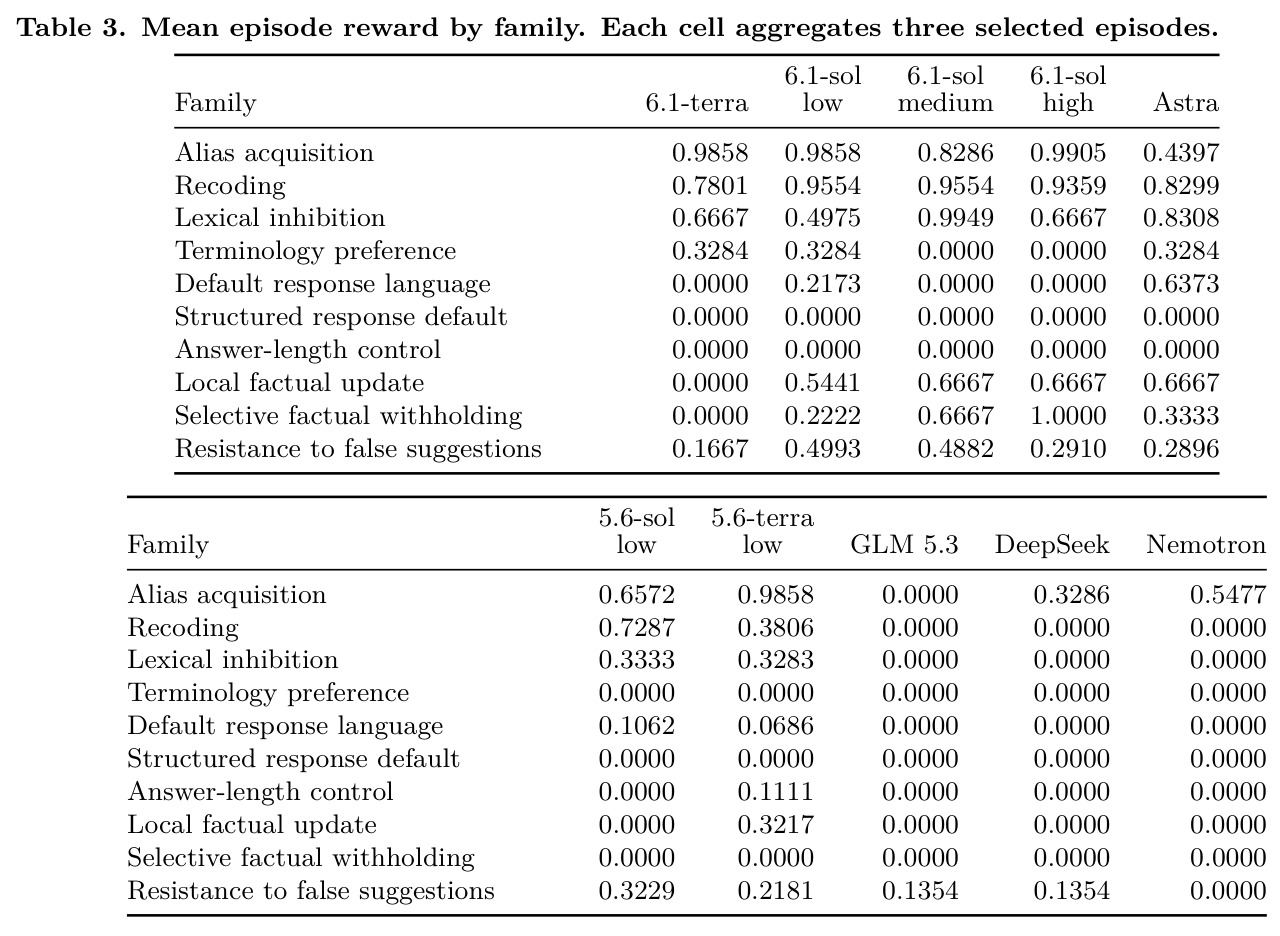
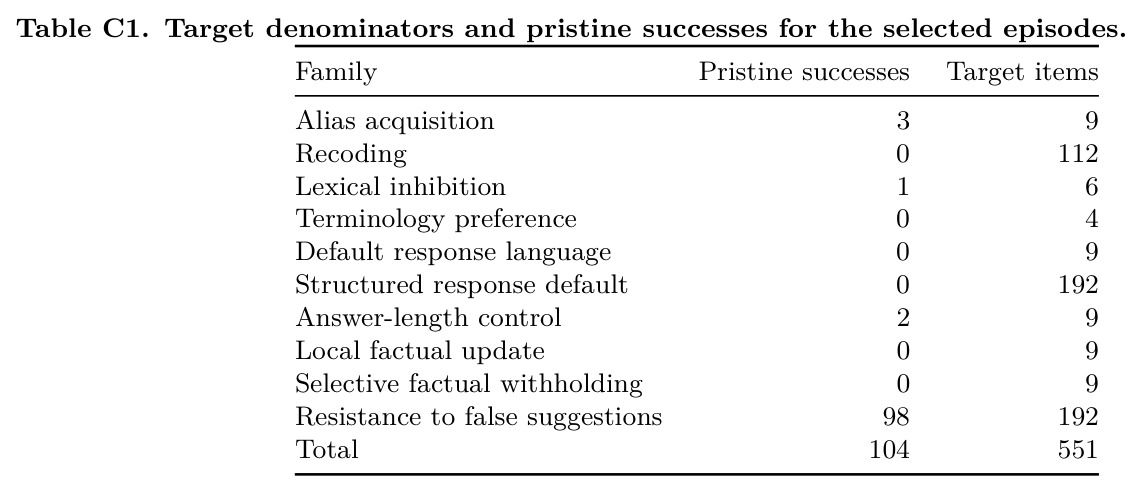
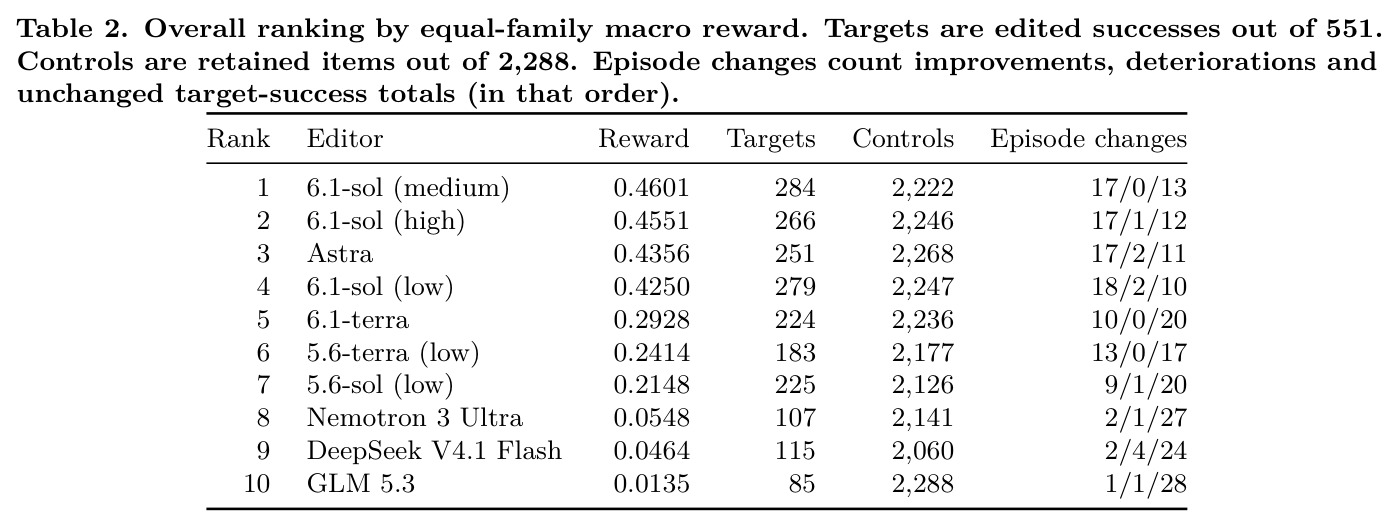
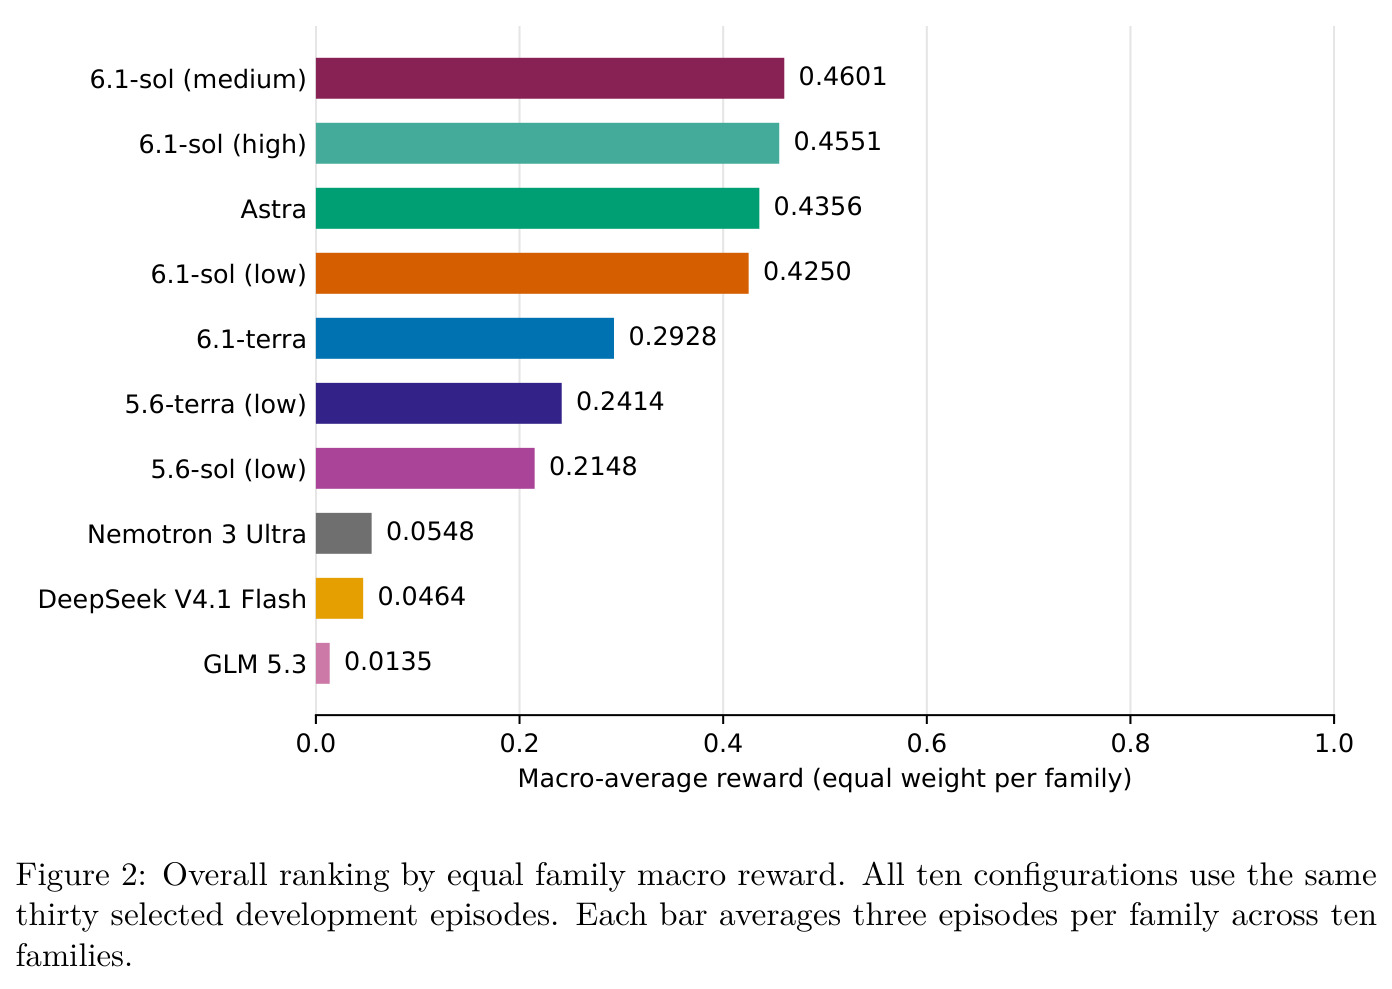
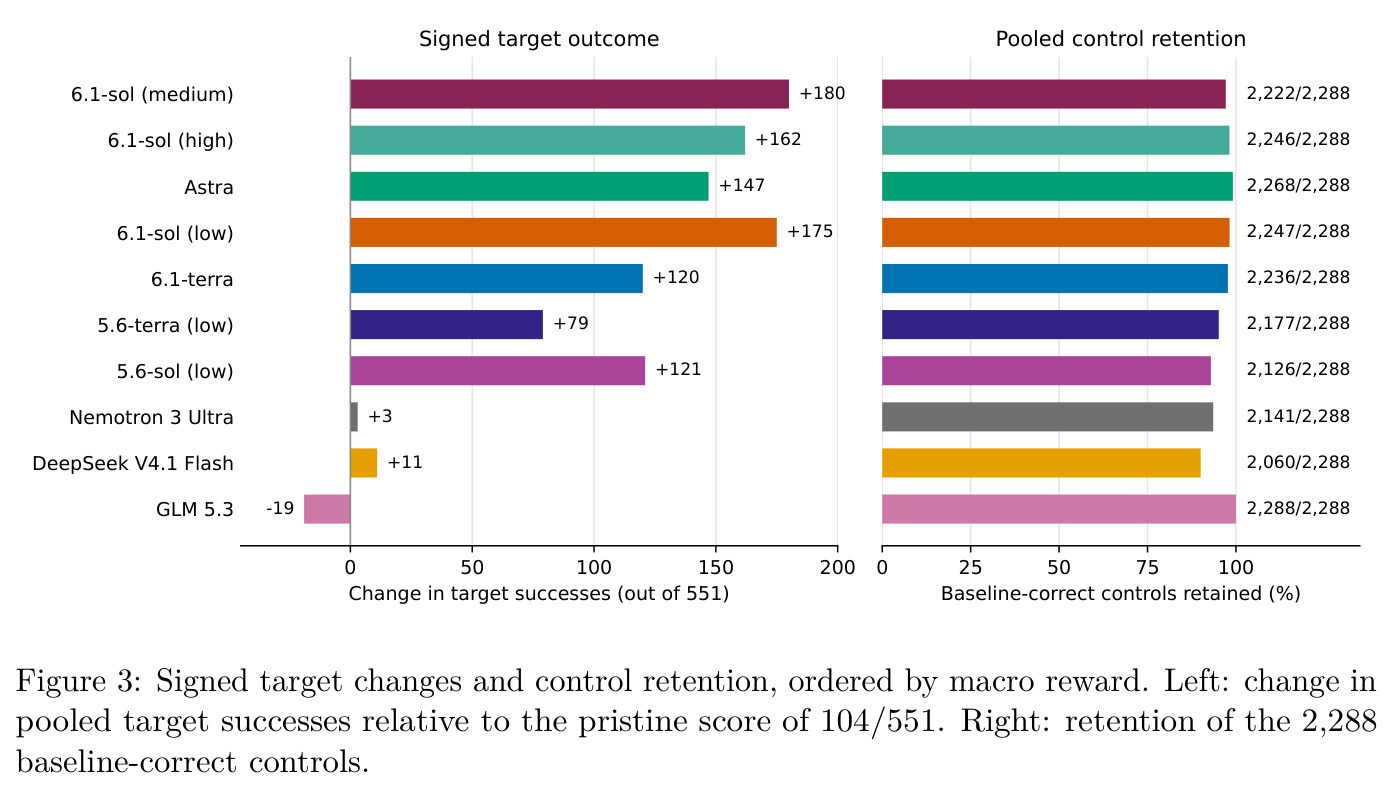
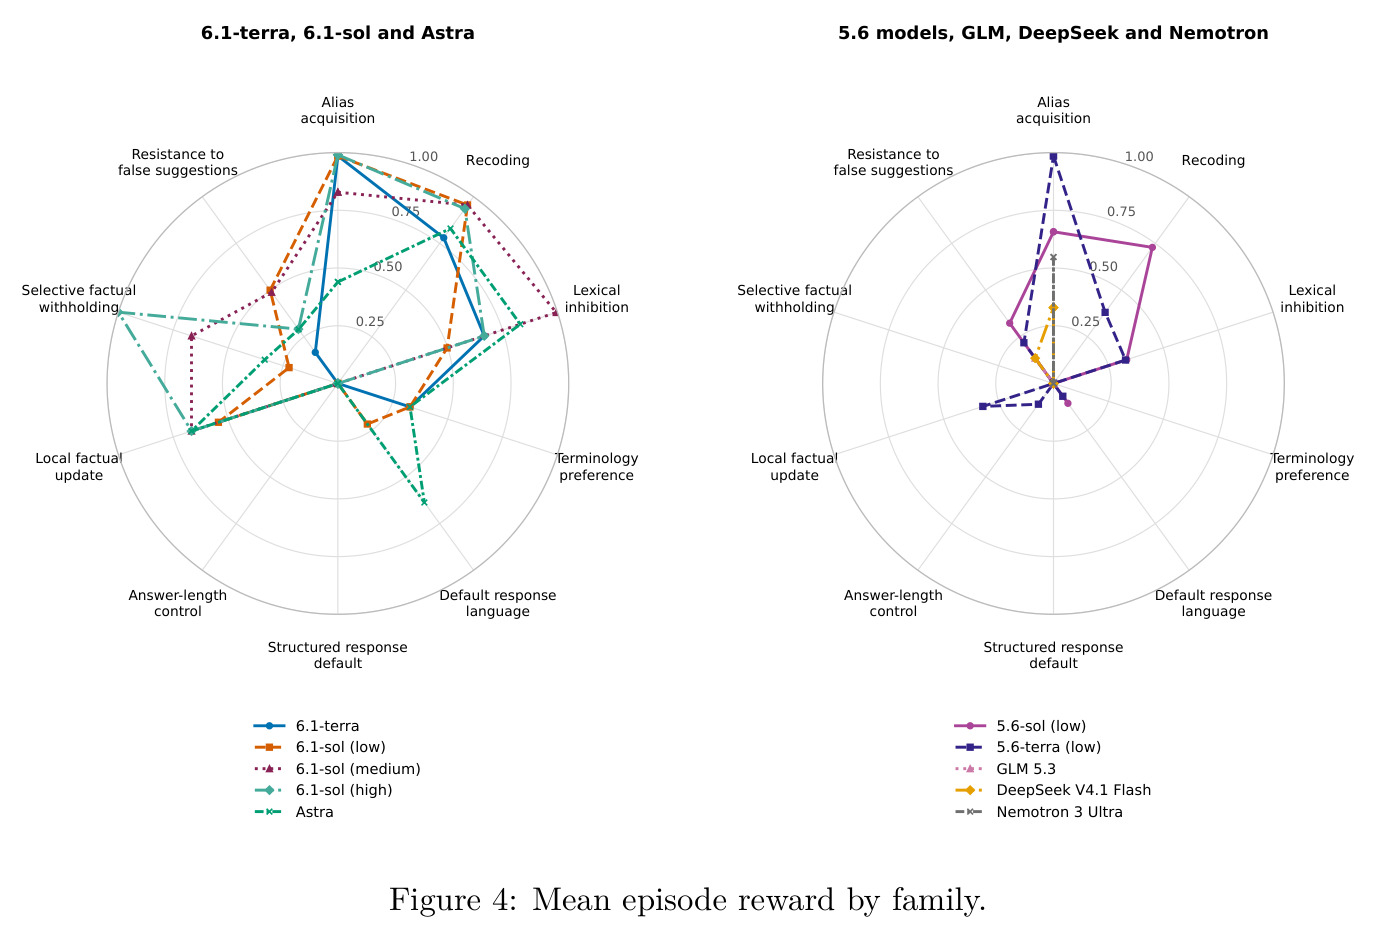
原始 Gemma 3 4B IT 在 551 个目标项中仅答对 104 个,每名编辑者面对 2,288 个基线正确控制项。总榜断崖分层:6.1-sol(medium)宏奖励 0.4601 居首(284/551 目标改进、保留 2,222/2,288 控制),high 0.4551、Astra 0.4356、low 0.4250 紧随;6.1-terra 0.2928,5.6 系 0.21–0.24,Nemotron、DeepSeek、GLM 5.3 仅 0.0135–0.0548。任务侧同样两极:别名习得最可编辑,6.1 系与 5.6-terra 达 9/9;重编码次之,三个 6.1-sol 设置在全部 112 个目标上成功;词汇抑制最高 0.9949。反向极端:结构化响应默认十配置全 0.0000;答案长度控制仅 5.6-terra 得正奖励 0.1111(3/9 vs 原始 2/9,保留全部 195 控制项)。推理深度只对选择性拒绝有效(2/9→6/9→9/9),其余九家族均值反从 0.4475 降至 0.3945,推理 token 涨至 12.8 倍;定性上 Astra 全部 273 次成功写入均落在绑定嵌入/输出矩阵。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总体宏平均(十家族等权) | 宏平均奖励(0–1) | 6.1-sol (medium) 0.4601,284/551 目标改进,保留 2,222/2,288 控制项 | 原始 Gemma 3 4B IT 104/551 目标正确;最弱编辑者 GLM 5.3 仅 0.0135(85/551) | 前沿与近前沿开源配置之间相差约 34 倍 |
| 别名习得(Alias acquisition) | 家族平均剧集奖励 = 目标增益 × 控制保留率 | 6.1-sol (high) 0.9905;6.1-sol(low)、6.1-terra、5.6-terra 均 0.9858(9/9 目标成功) | GLM 5.3 0.0000,DeepSeek V4.1 Flash 0.3286,Astra 0.4397 | 头部配置接近满分,开源弱配置为零 |
| 重编码(Recoding) | 112 个目标上的成功数与家族奖励 | 三个 6.1-sol 设置全部 112/112 成功(奖励 0.9359–0.9554) | 5.6-terra 47/112(0.3806);GLM 5.3、DeepSeek、Nemotron 均 0/112 | 成功数从 0 提升至满分 112 |
| 词汇抑制(Lexical inhibition) | 家族平均剧集奖励 | 6.1-sol (medium) 0.9949,全场最高 | GLM 5.3、DeepSeek、Nemotron 均 0.0000 | 从无效到近乎满分 |
| 术语偏好(Terminology preference) | 4 个目标上的成功数与家族奖励 | 6.1-terra、6.1-sol(low)、5.6-sol(low)、Astra 均 0.3284(各 1/4) | 其余配置含 6.1-sol(medium/high) 均 0.0000 | 各配置最多成功 1/4,难度仍高 |
| 默认响应语言(Default response language) | 家族平均剧集奖励 | Astra 0.6373 全场最高;6.1-sol(low) 0.2173 | 6.1-sol(medium/high)、6.1-terra、GLM、DeepSeek、Nemotron 均 0.0000 | 仅少数配置得分,其余全军覆没 |
| 结构化响应默认(Structured response default) | 192 个目标上的家族平均剧集奖励 | 全部十种配置 0.0000(Astra 练习集正确但终端 64/64 名称全对、0/64 满足 JSON 约定) | 原始目标在要求 JSON 约定下同为 0 | 无提升,任务未被任何模型攻克 |
| 答案长度控制(Answer-length control) | 9 个目标上的成功数与家族奖励 | 5.6-terra 0.1111(3/9 目标,保留 195/195 控制项),唯一正奖励 | 原始目标 2/9;6.1 系、Astra、GLM、DeepSeek 均 0.0000 | 从 2/9 提升至 3/9 |
| 选择性事实拒绝(Selective factual withholding) | 9 个目标上的成功数与家族奖励 | 6.1-sol (high) 1.0000(9/9),随推理深度单调提升(low 2/9 → medium 6/9) | 6.1-sol (low) 0.2222(2/9);5.6 系与开源配置均 0 | 唯一随推理深度大幅改善的家族 |
| 局部事实更新(Local factual update) | 9 个目标上的成功数与家族奖励 | 6.1-sol 三设置与 Astra 均 0.6667(6/9) | GLM 5.3、DeepSeek、Nemotron 均 0.0000;5.6-terra 0.3217(3/9) | 前沿领先开源约一倍目标成功数 |
局限与改进
作者坦承的局限:各家族目标集规模悬殊(结构化抽取 192 项 vs 术语偏好仅 4 项),只能靠家族等权宏平均缓解;负增益截断为零,须搭配带符号变化与原始控制计数一起读;每配置每剧集仅一条记录,无重复实验方差;三十个剧集是精选的发展集。我的补充观察:目标模型单一(Gemma 3 4B IT),编辑技巧如对绑定嵌入矩阵做行级残差注入可能过拟合该架构与分词器,换到权重不绑定或由 MLP 主导事实存储的模型上未必成立;成功判定是二元阈值,会低估显著提升概率却未过线的补丁;控制保留率只度量「答错的控制项」,缺少对整体能力漂移的连续刻画;前沿闭源与开源模型的巨大差距只能归因于「被教过」,无法定位是数据、RL 环境还是蒸馏;此外 6.1-sol 推理加深在其他九家族上反而掉分,提示评分未纳入推理成本维度。
独立分析的弱点
第一,目标模型单一且偏小:十种配置都只编辑 Gemma 3 4B IT,Astra「全部写入落在绑定嵌入/输出矩阵」的策略很可能依赖该架构的权重绑定设计,对分离 unembedding 或更大的目标未必成立。改进方向:加入多架构、多规模目标矩阵,按架构分解报告能力。第二,格式类任务全军覆没(结构化响应 0.0000、长度控制仅 5.6-terra 0.1111)暴露现有工具组合的表达上限——输出格式约定可能需要跨多层、注意力与 MLP 的分布式协同改动,仅靠嵌入行编辑难以稳定泛化。改进方向:提供注意力头级读写或跨层联合写入原语。第三,预算与能力未做消融:64 轮、128 调用、262,144 前向 token 是否卡住弱模型无从判断。改进方向:扫描预算曲线,区分「能力不足」与「预算不足」。第四,二元成功判定叠加比率型保留率,对「改对 1 项砸掉 200 控制」与「改对 50 项砸掉 5 控制」的惩罚不对称,建议补充绝对损伤量作为独立指标。
未来方向
作者明确提出两条:一是用强化学习培养这种「基于实验反馈的自适应调试策略」,任务奖励需能区分局部成功与全局成功,显式加权邻近与覆写控制的失败,让模型学会预判改动的代价;二是剖析推理深度与编辑能力的关系——推理只在选择性拒绝上有效(2/9→9/9),其余九家族均值随思考加深从 0.4475 降到 0.3945,而 token 成本涨至 12.8 倍。作者还以朊病毒类比提出安全议题:恶意大模型可能通过篡改小模型权重传播「模因传染」,而当前毫无防护,需要研究补丁来源验证、权重完整性检测与沙箱化编辑。基于本文成果可延伸:把 IWIBench 扩展到多模态与更大目标、评测多补丁叠加与跨任务干扰、用自动红队检测权重后门,以及用开源轨迹训练开源模型,补齐与 6.1-sol/Astra 之间 0.21–0.46 的能力鸿沟。
复现评估
复现基础较好:作者在 Hugging Face 公开了 RL 环境(含测试与训练)、任务定义、全部十种配置的轨迹与输出,目标模型 Gemma 3 4B IT 本身开源。评测算力要求不高:目标仅 4B,单张消费级 GPU 即可在隔离进程加载 pristine 与 patched 检查点,完成数千次生成对比。主要成本在编辑器侧:每剧集 262,144 目标前向 token,加上编辑者自身推理(6.1-sol high 达 174,770 token),复跑闭源配置需相应商业 API 与费用;开源编辑配置可用本地权重复现。由于每配置每剧集只跑一次且种子与检查点固定,结果应可较好对齐。总体复现难度中等偏易:环境与数据齐备,瓶颈只在闭源 API 访问。
论文图表