PhysioWave-T:面向生理信号的高效 Token 小波基础模型 PhysioWave-T: Token-Efficient Wavelet Foundation Models for Biosignals
动态尺度折叠压缩小波 token 序列,构建跨采集配置的生理信号基础模型并实现可靠性感知多模态融合
前置知识
小波多分辨率分解
小波变换用低通/高通滤波器对信号逐级滤波并二倍抽取,即 $a^{(\ell+1)}=\downarrow_2(a^{(\ell)}*k_{lo})$、$d^{(\ell+1)}=\downarrow_2(a^{(\ell)}*k_{hi})$。$J$ 级分解产出 $J$ 个细节子带 $d^{(1)},\dots,d^{(J)}$ 和一个近似 $a^{(J)}$,共 $J+1$ 个子带,各自覆盖不同频段且在时间上局部化,特别适合分析非平稳的生理信号。本文 EEG 用三级分解,故有 4 个子带。
本文的核心算子“动态尺度折叠”正是作用在这 $J+1$ 个子带上:理解折叠为什么能把 token 数从 $(J{+}1)CS$ 压到 $CS$、以及折叠权重 $?lpha_s$ 的物理含义,必须先明白分解到底产生了什么。
Transformer 注意力的二次代价
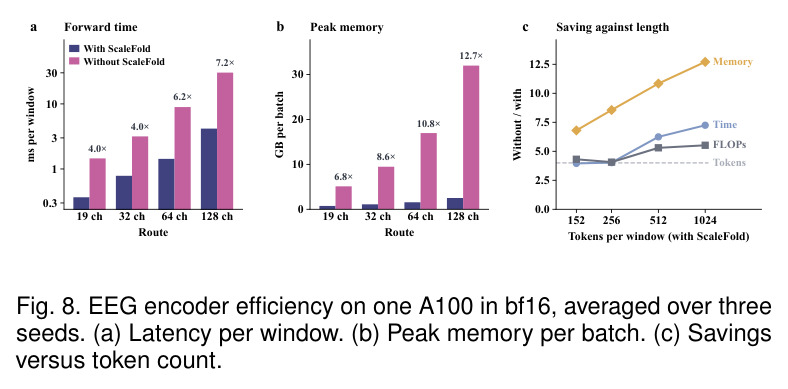
自注意力需计算所有 token 两两之间的注意力矩阵,计算量与激活显存随序列长度 $N$ 以 $O(N^2)$ 增长。生理信号的 token 数等于通道数×时间 patch 数($CS$),密集 EEG 阵列(128 通道)长窗口会直接撑爆显存——论文实测不折叠时 128 通道单 batch 峰值显存约 32 GB。
尺度折叠的核心卖点是把注意力的二次项按 $(J{+}1)^2$ 缩减,从而把显存压到 2.5 GB。读懂效率实验(Fig. 8)与消融实验的动机,前提是知道这笔代价从哪里来。
掩码重建自监督预训练(MAE 范式)
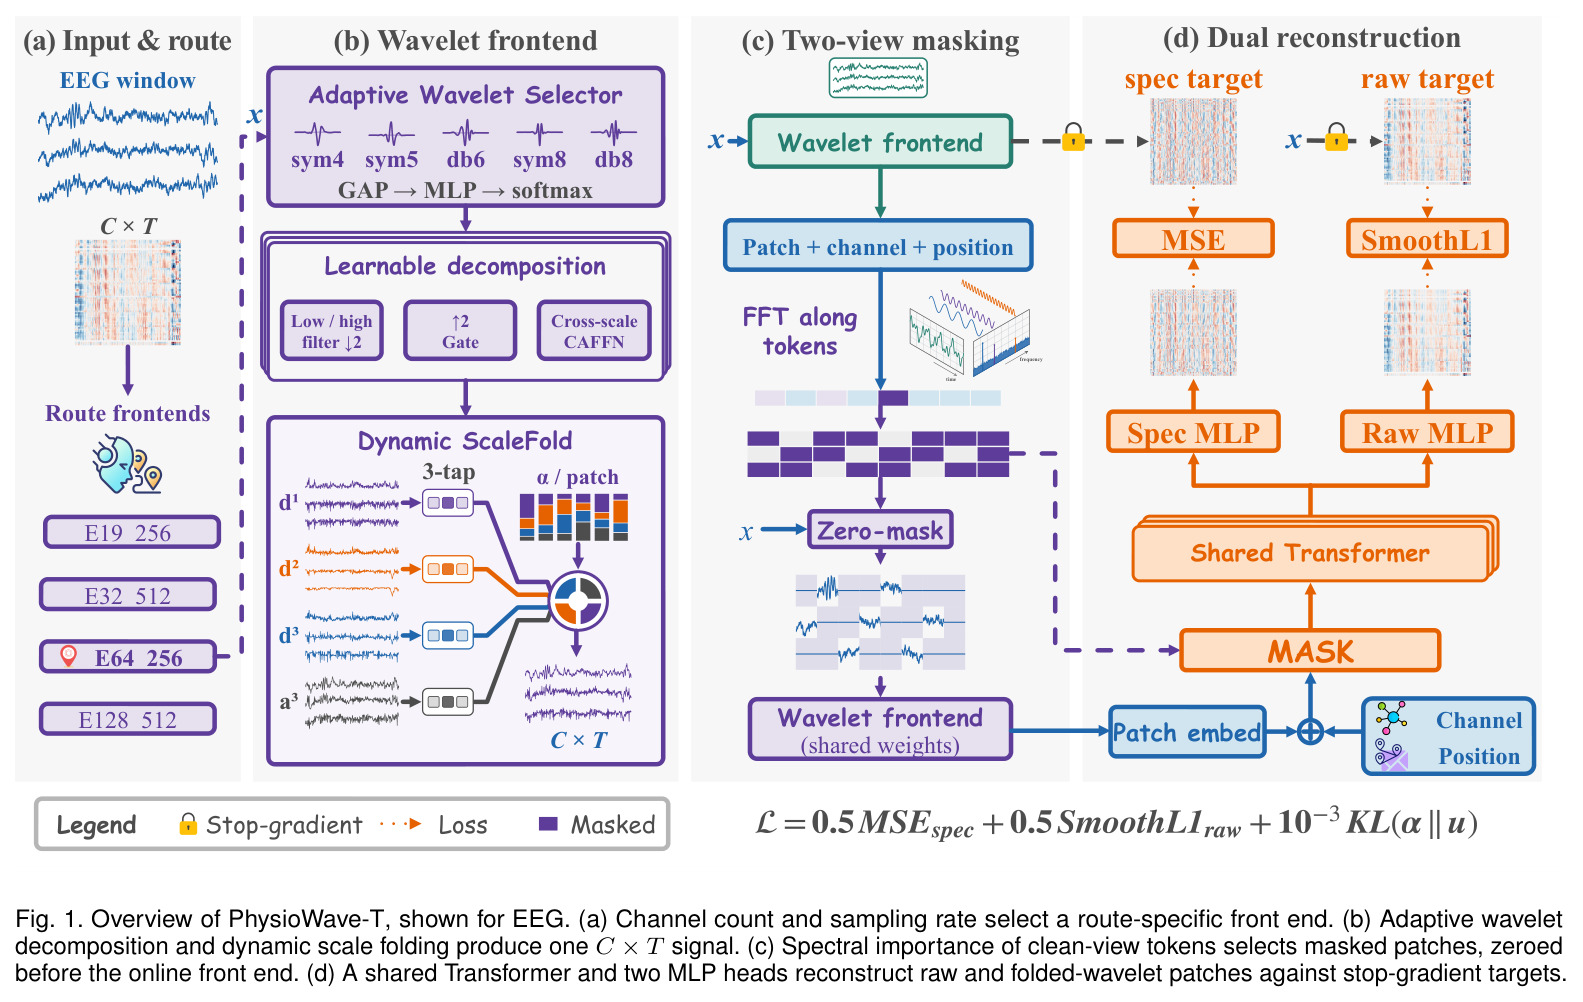
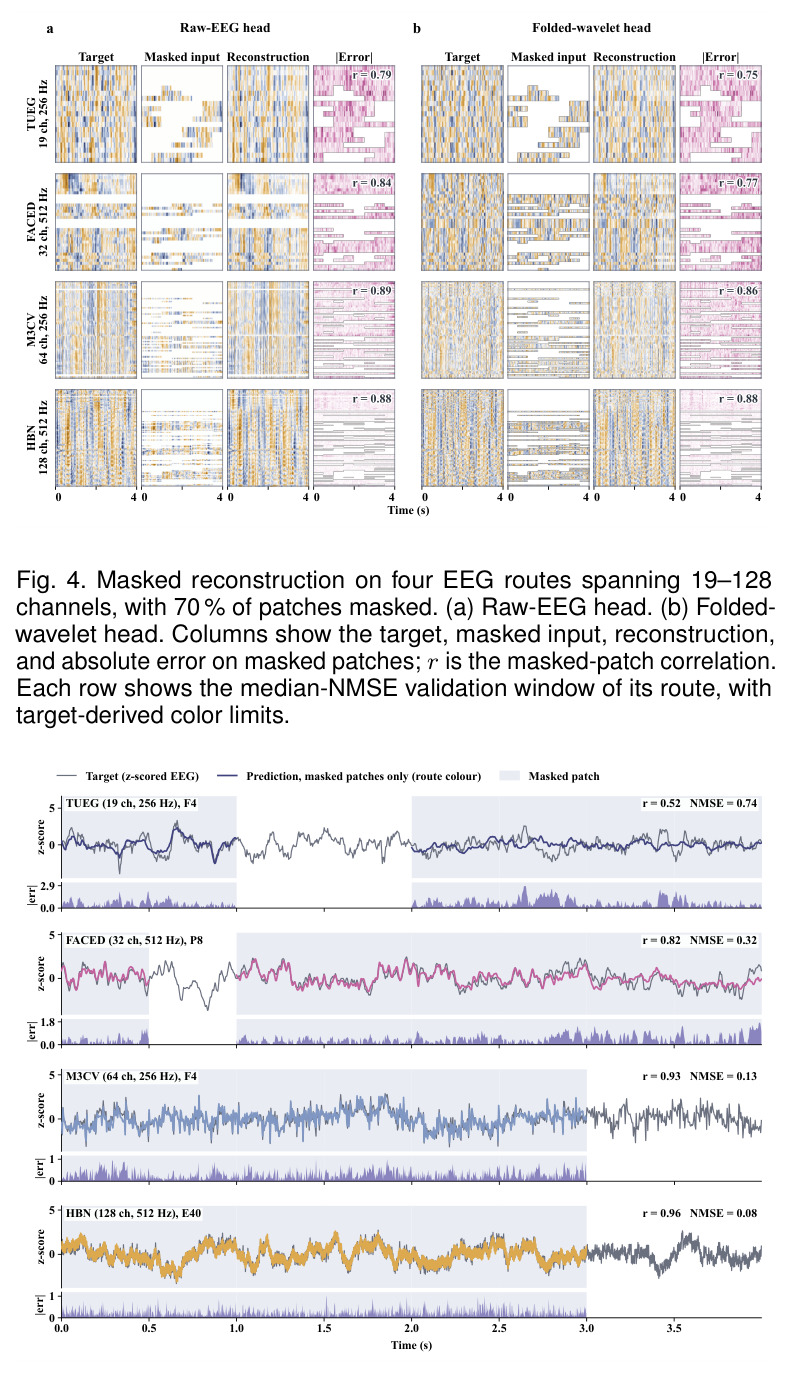
MAE 式预训练随机遮住大部分输入 patch(本文 70%),让编码器从剩余上下文重建被遮内容,从而学到可迁移表征。本文采用双视角设计:干净视角提供重建目标与频谱重要性得分(掩码得分 $s=0.6e+0.4z$,$e$ 为频谱重要性、$z$ 为均匀噪声),在线视角把选中 patch 在进入卷积前端之前就置零,防止前端把被遮信息泄漏给相邻 token;并由谱目标 MSE、原始目标 SmoothL1 与折叠正则三项组成损失。
这是 EEG/ECG/sEMG 三个编码器共同的预训练目标,Fig. 1(c)(d) 的流程图与 Fig. 4/5 的重建可视化全部围绕它展开,不理解它就看不懂预训练部分。
潜变量瓶颈多模态融合(Perceiver 式)
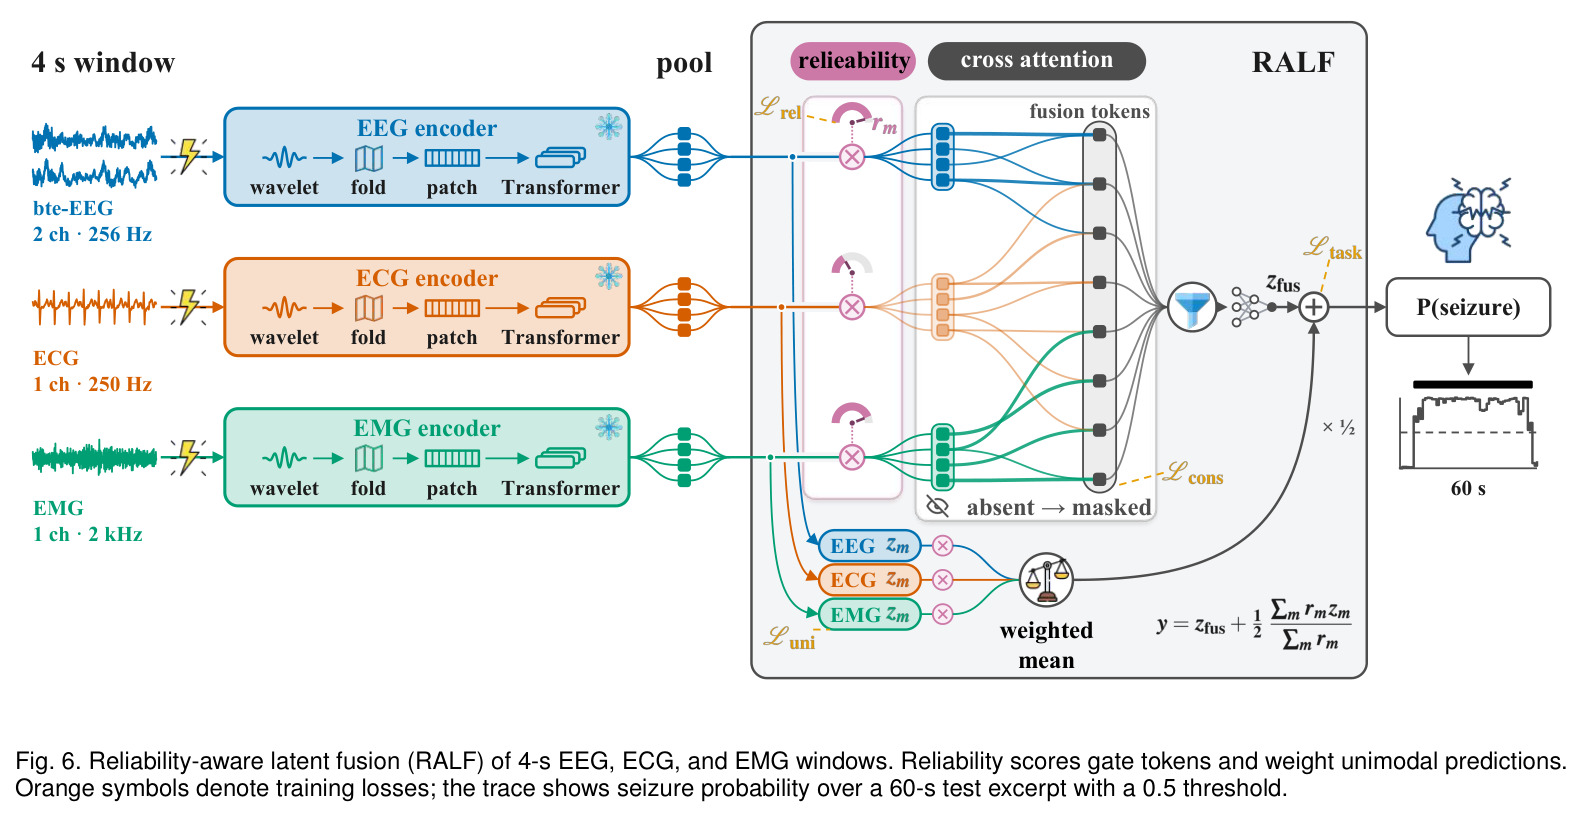
Perceiver 式融合把每个模态先用注意力池化压成极少量摘要 token,再用一组可学习的融合 token 通过交叉注意力读取它们,避免在全部单模态 token 上做注意力。融合模块每个模态只接收固定数量的 token,因此计算量与窗口长度、通道数无关,且天然支持模态缺失(用注意力掩码排除缺席模态)。
RALF(可靠性感知潜变量融合)就建立在这个范式之上,再额外加入逐样本可靠性门控;理解 Fig. 6 中“每模态 4 个摘要 token + 8 个融合 token”的设计意图,需要先懂瓶颈融合。
AUPRC 与 FA/h 临床操作点
AUPRC 是精确率-召回率曲线下面积,在类别极不平衡(如癫痫发作段在数千小时记录中极稀少)时比 AUROC 更严格、更有区分度。发作检测常用“事件级灵敏度 @ 每小时误报次数(FA/h)”作为临床操作点:本文以 ≤11 FA/h(SeizeIT2 数据集论文 SVM 基线的操作点)和 ≤2 FA/h 两个预算报告灵敏度。
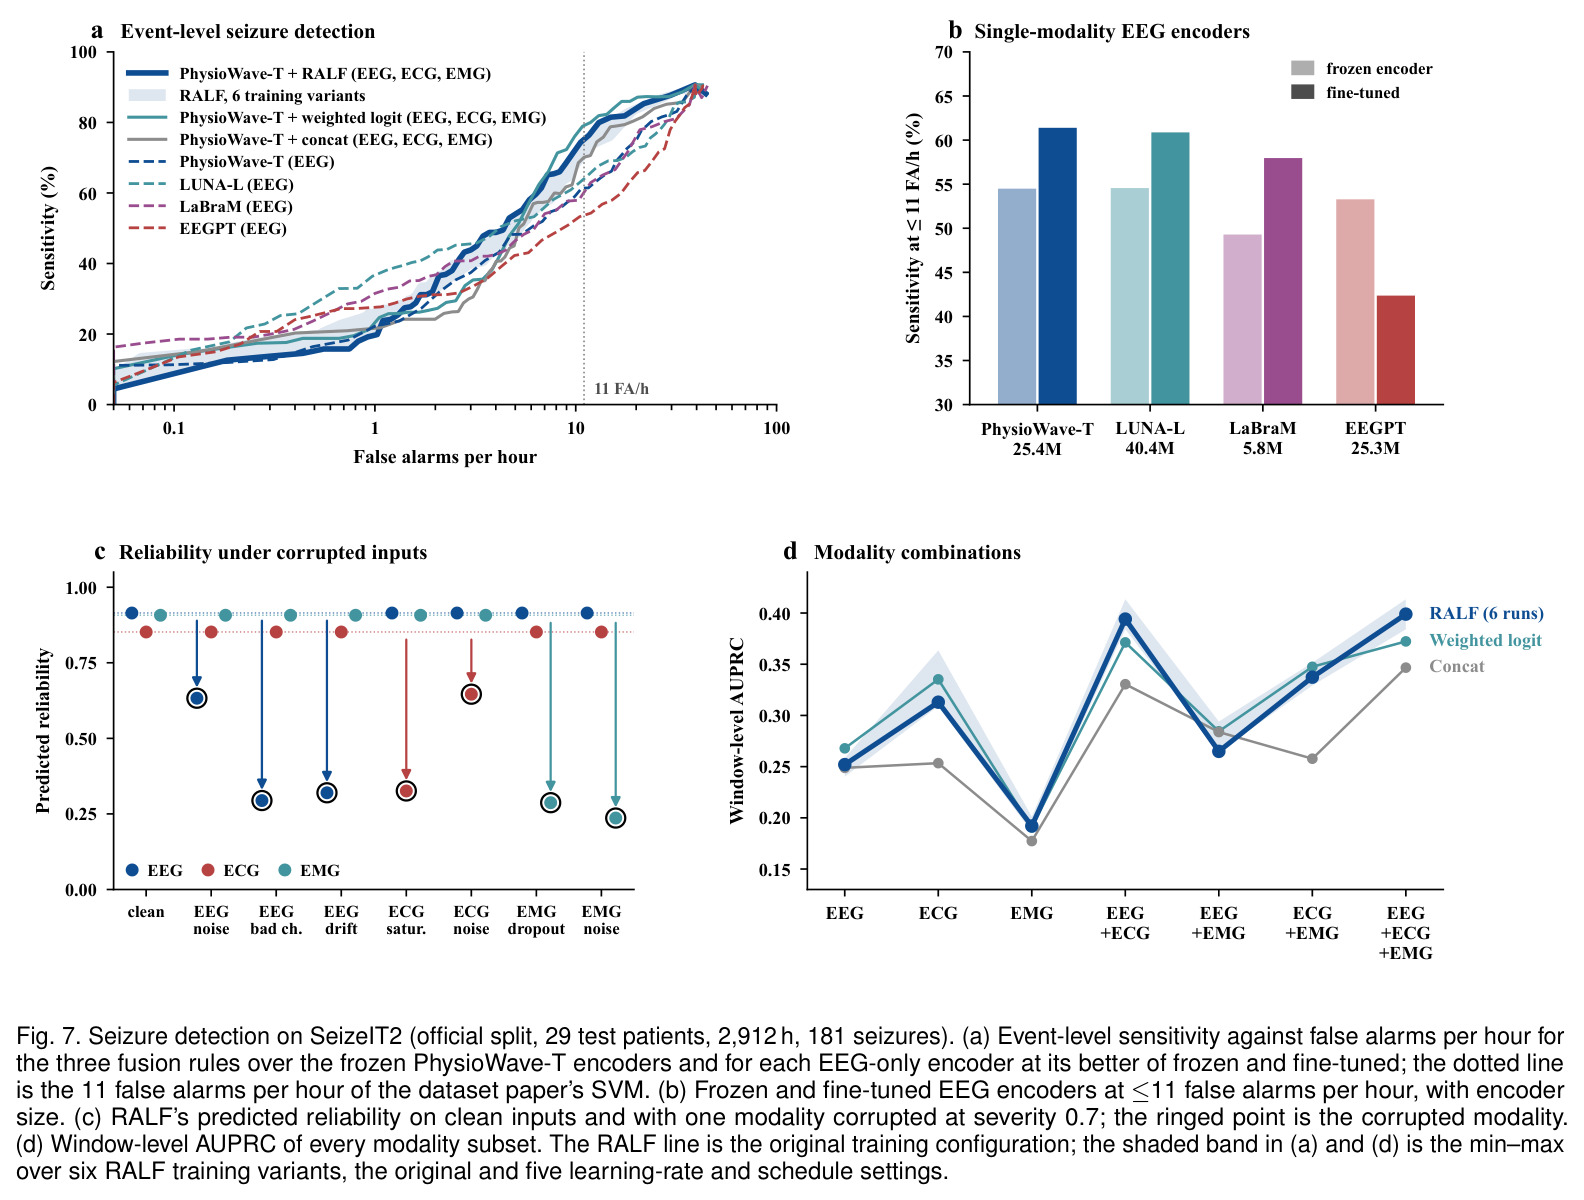
多模态融合实验的主要指标就是窗口级 AUPRC 和事件级灵敏度@FA/h;看懂 Fig. 7 的四张子图与 RALF 相对加权 logits/拼接融合的优势,需要这些指标定义。
研究动机
生理信号的采集硬件与协议高度不统一:EEG 从 2 通道可穿戴设备到 128 通道头皮阵列,ECG 从单导联贴片到临床 12 导联系统,sEMG 覆盖腕带、前臂阵列和高密度网格,各自的采样率与传感器几何都不同。作者前作 PhysioWave 用可学习小波为 ECG/sEMG 学多尺度表征,但三个设计选择限制了它向 EEG 扩展:其一,tokenizer 把每个小波尺度展开成独立的 token 行,$J$ 级分解、$C$ 通道、$S$ 个时间 patch 产生 $(J{+}1)CS$ 个 token,二次注意力使分解越深、通道越密、窗口越长就越贵;其二,每个编码器被绑死在单一固定输入配置上,无法覆盖 19–128 通道、256/512 Hz 的异构临床图谱;其三,多模态实验依赖外部预训练骨干加训练后固定的可学习模态权重,无法随单个样本的信号质量自适应。实测中不折叠的 128 通道 EEG 单 batch 峰值显存约 32 GB,无论临床还是可穿戴场景都难以承受。
本文的目标是本文要同时回答三个问题:第一,如何在不牺牲多尺度时频信息的前提下避免 token 数随分解深度线性膨胀——让更深的分解“丰富每个 token 的内容”而不是“拉长序列”;第二,如何用一套架构覆盖异构采集配置——同一个 30M 参数骨干能从 19–128 通道、256/512 Hz 的多种 EEG 语料中学习,并迁移到预训练时完全未见的配置(如 Sleep-EDFx 的 100 Hz 双导联、SeizeIT2 的耳后 2 通道可穿戴);第三,如何把独立预训练的 EEG/ECG/sEMG 编码器组合成多模态监测系统,且融合机制能感知每个样本中各模态的可靠性,在模态缺失或损坏时依然稳健。最终交付一个 token 高效、可扩展的生理信号基础模型家族及其多模态融合框架。
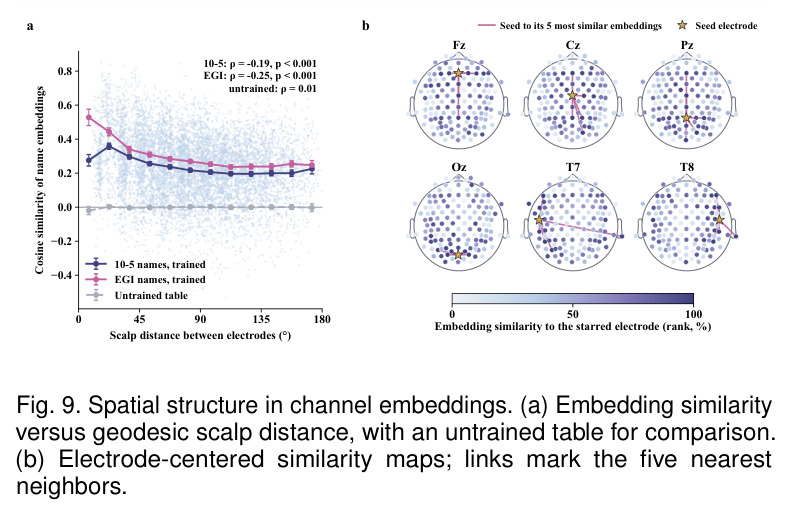
与已有工作不同的是,独特切入是把“依赖信号怎么采”的处理与“依赖信号内容”的学习在流水线上解耦:所有与采集相关的部分(通道数、采样率、传感器几何)在 tokenization 之前由路由专属小波前端消化,共享骨干只面对统一 token 空间。折叠算子先取子带均值 $?ar{b}$ 作参考、再用学到的残差修正,形式上把经典小波包最优基选择(离散树搜索、熵准则固定)推广为可学习、连续、数据相关的尺度混合;且折叠不含任何通道形状的参数,因此可跨图谱原样迁移。传感器身份不用电极坐标而用名字嵌入(可扩展词表)。多模态侧则用由“损坏严重度”直接监督的逐样本可靠性分数,替换 PhysioWave 的固定模态权重——这是与固定权重融合和一般瓶颈融合的本质差别。
核心方法
直觉:多尺度分析应当让 Transformer 里每个 token 看到的内容更丰富,而不是让 token 队列更长。技术路线(Fig. 1):输入窗口 $X\in\mathbb{R}^{C\times T}$ 先按元数据(通道数、采样率)选定路由 $r=(C_r,f_r)$ 专属的小波前端,做 $J$ 级可学习小波分解(自适应基选择+软门控+跨尺度融合),得到 $J+1$ 个子带;动态尺度折叠把子带重新组合回一个与输入同形的 $\tilde{X}\in\mathbb{R}^{C\times T}$;按物理时长 $\tau$ 切 patch、加通道名嵌入与位置编码后得到 $CS$ 个 token,送入每模态共享的 Transformer(RMSNorm、QK 归一化、门控 FFN、RoPE)。预训练采用双视角掩码重建:干净视角提供目标与掩码得分,在线视角先置零再进前端;两个浅解码头分别在折叠小波域与原始信号域重建。EEG/ECG/sEMG 各独立预训练一个编码器(30M/30M/12M 参数),最后由 RALF 以逐样本可靠性权重融合用于可穿戴癫痫检测。
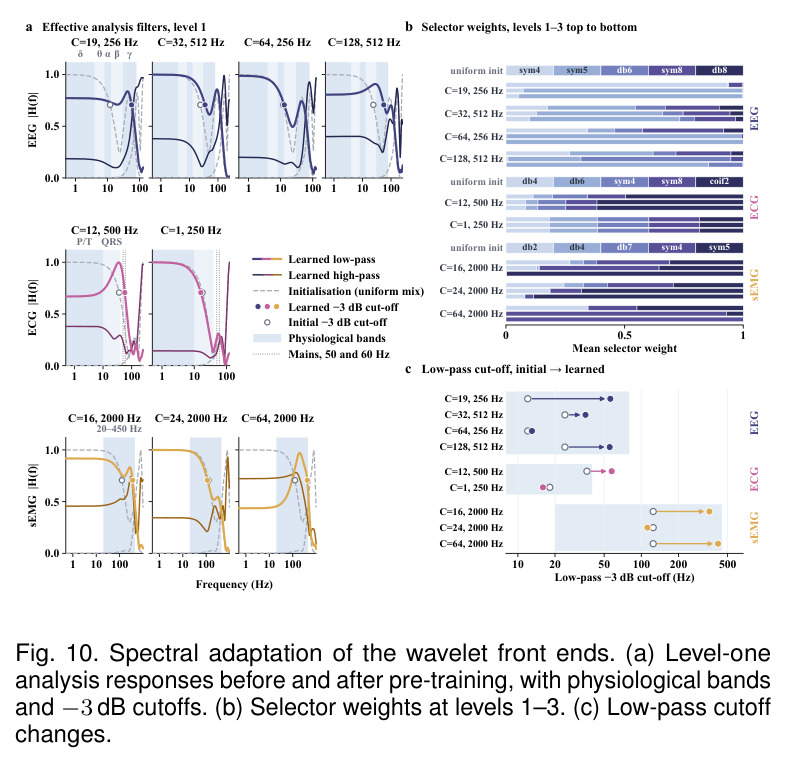
核心创新是动态尺度折叠:$\tilde{X}=\bar{b}+\gamma\sum_{s=1}^{J+1}\alpha_s\odot(g_s*b_s-\bar{b})$。其中 $\bar{b}$ 是子带均值,作中性参考;$g_s$ 是 delta 初始化的短深度合成滤波器;$\gamma$ 初始 0.1;权重 $\alpha_s\in[0,1]$、$\sum_s\alpha_s=1$ 由各子带统计量(对数 RMS、幅度熵、对数峰度)经共享 MLP 预测,并以 $10^{-3}$ 权重的 $KL(\alpha\|u)$ 惩罚防止塌缩到单一尺度。delta 初始化加均匀权重使初始折叠恰为子带平均,训练从\u201c中性\u201d出发学出尺度偏好。与 PhysioWave 的本质区别:后者把每个子带 token 化为独立序列行,分解深度直接乘长序列;折叠让深度只增加单个 token 的信息密度。与经典 best-basis selection 的区别:那里在离散小波包树中搜索且熵准则固定,这里是连续、可微、逐通道逐时间块自适应的准则学习。
方法步骤详情
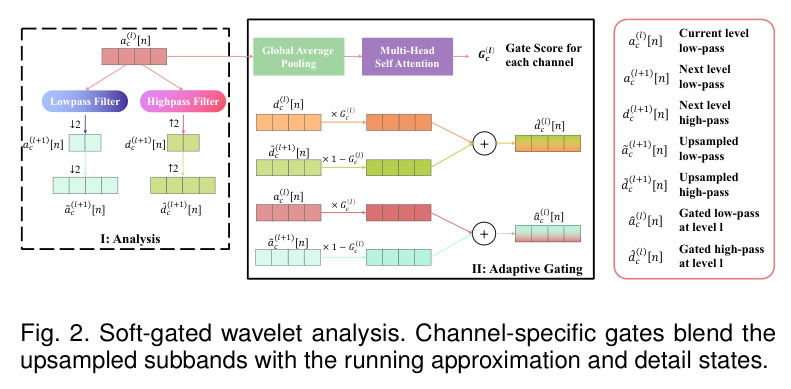
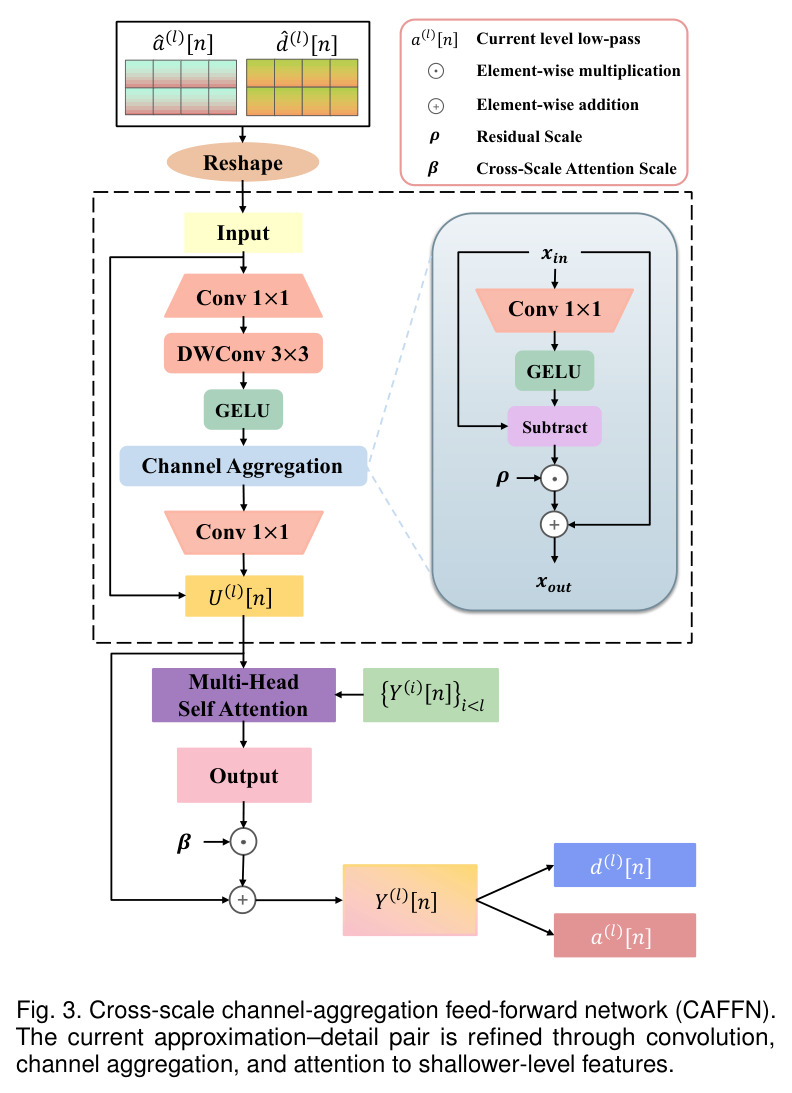
①路由划分:按元数据的通道数与采样率选专属前端;词表、位置码与 Transformer 跨路由共享。②可学习分解:每级由共享 MLP 预测权重混合命名小波初始化的滤波器对并二倍抽取;软门控逐通道融合本级与上级;CAFFN 融合浅层,得 $J{+}1$ 个子带。③折叠:$\tilde{X}=\bar{b}+\gamma\sum_s\alpha_s\odot(g_s*b_s-\bar{b})$ 叠回与输入同形的 $C\times T$。④token 化:按物理时长切 patch 得每通道 $S$ 个,加通道名嵌入与二维位置码,共 $CS$ 个 token。⑤预训练:干净视角按频谱得分 $s=0.6e+0.4z$ 选 70% 掩码,在线视角先置零再进前端;损失=谱 MSE+原始 SmoothL1+小权重 $KL$ 正则。⑥适配:微调、probe、scratch 三模式。⑦RALF:每模态池化 4 个摘要 token,8 个融合 token 经两层交叉注意力分类;可靠性 $r_m$ 门控键值并加权单模态残差;训练时随机损坏模态并监督可靠性 $r_m$,另加单模态 CE 与子集对称 KL。
技术新颖性
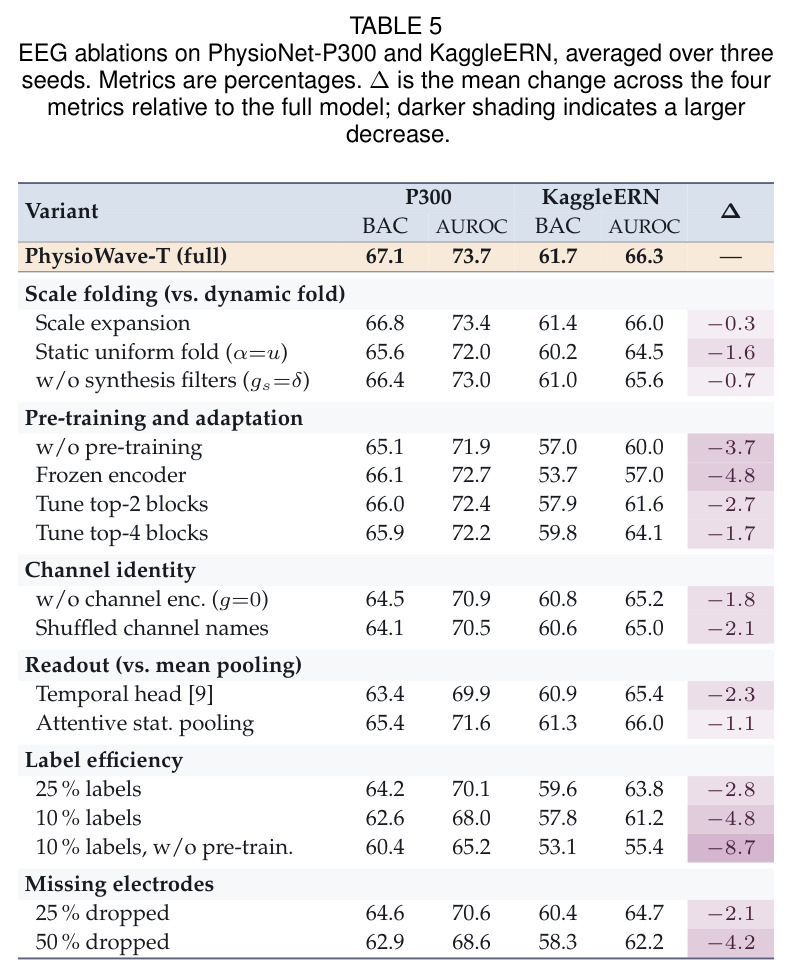
技术新颖性有四层。第一,折叠算子是对经典 best-basis selection 的可微推广:把离散小波包树搜索换成连续、由子带统计驱动的尺度混合,并引入可学习合成滤波器 $g_s$ 使混合不局限于逐点加权;消融显示合成滤波器贡献 0.7 点、数据相关权重 $\alpha$ 贡献 0.9 点,静态均匀折叠掉 1.6 点,两组件缺一不可。第二,折叠不含通道形状参数,是跨图谱可迁移的“即插即用”接口——分解深度只改变 token 内容不改变序列长度,注意力二次项按 $(J{+}1)^2$ 缩减,这在密集 EEG 阵列上收益最大。第三,前端由采集元数据确定性选择而非学习 token 级路由(对比 Perceiver/MoE),并把名字化通道身份从 EEG 电极扩展到 ECG 导联与 sEMG 电位点,未见配置只需挂新前端并在词表追加新行。第四,RALF 用合成损坏严重度直接监督可靠性估计,且同时作用于交叉注意力键值与单模态残差预测两条通路,是对固定权重融合与一般瓶颈融合的实质推进。
实验结果
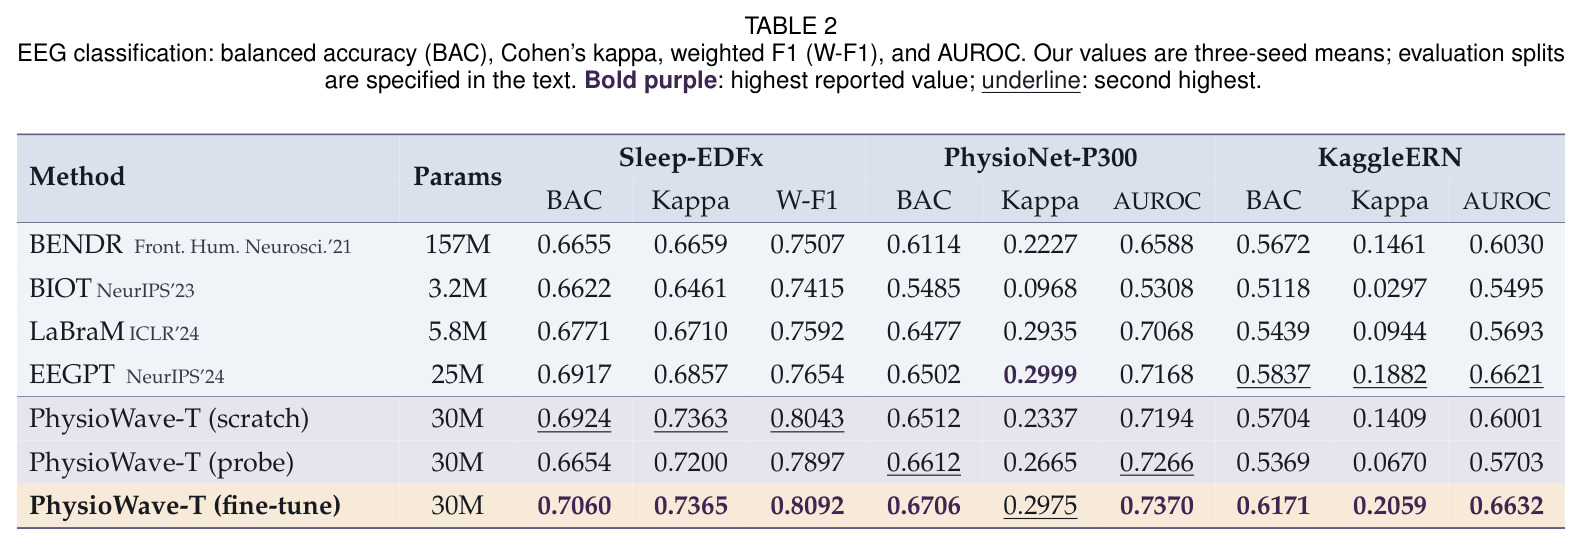
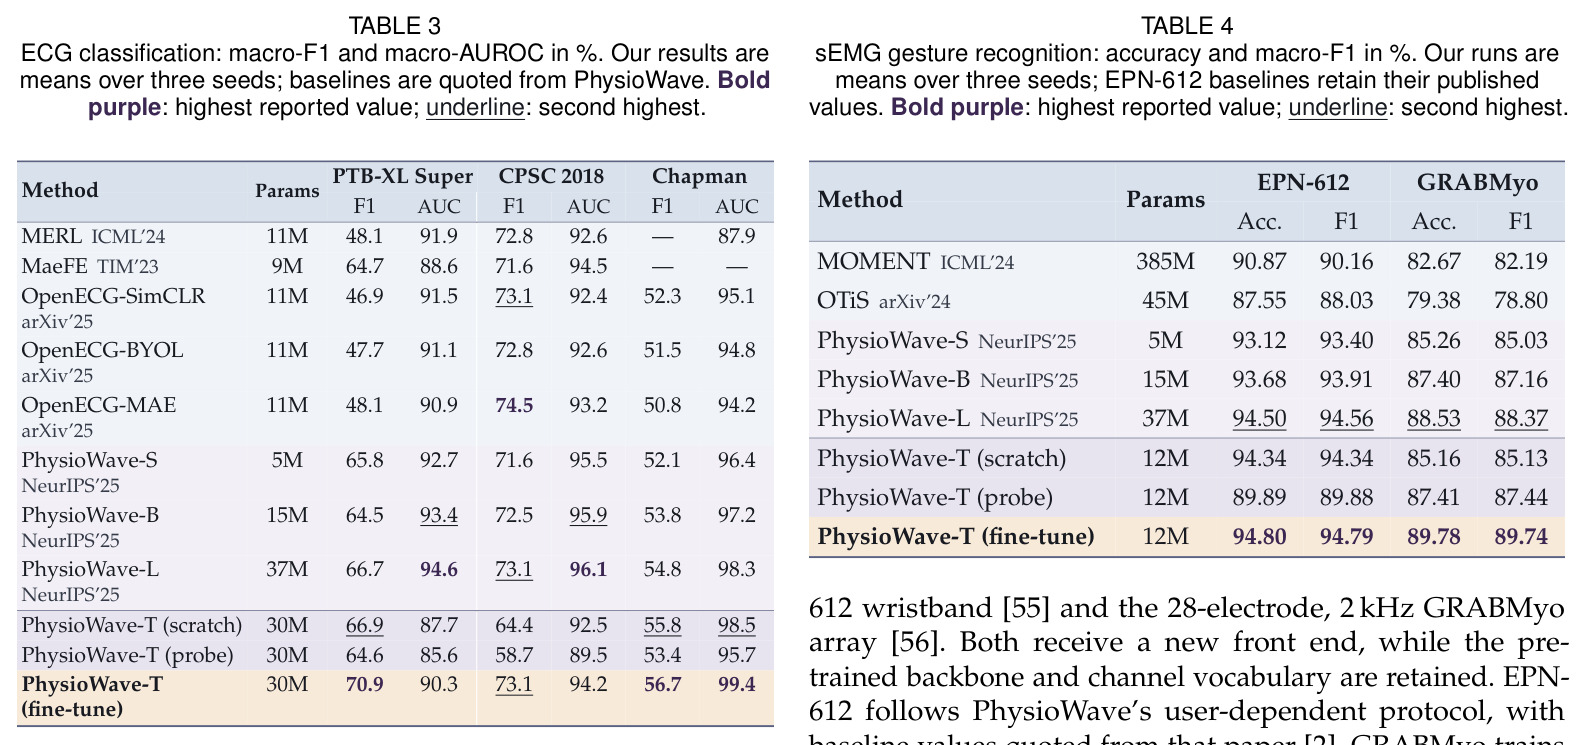
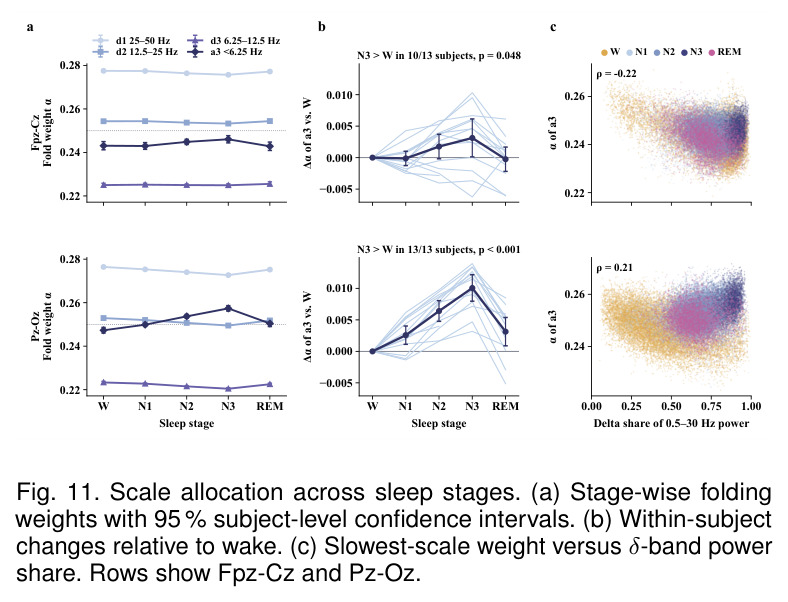
EEG:微调后在九项指标中八项领先——Sleep-EDFx kappa 0.686→0.737、加权 F1 76.5%→80.9%;P300 BAC/AUROC 各 +2.0、KaggleERN BAC +3.3。ECG:PTB-XL Super macro-F1 70.9%(超 PhysioWave-L 4.2)、Chapman F1 56.7%/AUROC 99.4% 最高。sEMG:EPN-612 94.80%、GRABMyo 89.78%(超 PhysioWave-L 1.25 点、参数仅 1/3)。融合:SeizeIT2 上单 EEG 61.4% 灵敏度@≤11 FA/h(LUNA-L 60.9%);RALF 把 AUPRC 从 0.321 提至 0.399,超加权 logits 0.372 与拼接 0.347,各损坏下 ≥0.33。效率:延迟降 4.0–7.2×、显存降 6.8–12.7×(128 通道 batch 32 GB→2.5 GB)。分析:通道嵌入无坐标监督恢复头皮拓扑;最慢尺度权重随觉醒→N3 上升(13/13 人);10% 标签即超全量 scratch。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 睡眠五分期(Sleep-EDFx,100 Hz 双导联,预训练未见配置) | Cohen's kappa | 0.7365(微调) | EEGPT 0.6857 | +0.0508 |
| 睡眠五分期(Sleep-EDFx) | 加权 F1 | 80.9% | EEGPT 76.5% | +4.4 个百分点 |
| P300 靶刺激检测(PhysioNet-P300) | 平衡准确率 | 67.06%(微调) | EEGPT 65.02% | +2.04 个百分点 |
| 错误相关 negativity 检测(KaggleERN) | 平衡准确率 | 61.71%(微调) | EEGPT 58.37% | +3.34 个百分点 |
| 心电五 superclass 诊断(PTB-XL Super) | macro-F1 | 70.9%(微调,30M 参数) | PhysioWave-L 66.7%(37M) | +4.2 个百分点 |
| 心电诊断(Chapman–Shaoxing) | macro-AUROC | 99.4% | PhysioWave-L 98.3% | +1.1 个百分点 |
| sEMG 手势识别(GRABMyo,跨 session 泛化) | 准确率 | 89.78%(微调,12M) | PhysioWave-L 88.53%(37M) | +1.25 个百分点,参数仅约 1/3 |
| 可穿戴癫痫发作检测(SeizeIT2,单模态 EEG) | 事件级灵敏度 @≤11 FA/h | 61.4%(微调,25.4M) | LUNA-L 60.9%(40.4M)/ EEGPT 42.4% | +0.5 点(参数少 37%)/ +19.0 点 |
| 多模态融合发作检测(SeizeIT2,EEG+ECG+EMG,冻结编码器) | 窗口级 AUPRC | 0.399(RALF) | 最佳单模态 EEG 0.321 / 加权 logits 0.372 / 拼接 0.347 | 较最佳单模态 +0.078,较两种融合规则 +0.027/+0.052 |
局限与改进
作者承认的局限:多模态实验中的模态损坏(噪声、坏导联、基线漂移、饱和、时间丢失,严重度 0.7)全部为合成注入,尚未在带真实传感器故障的前瞻性记录上验证;三个编码器仍独立预训练,未做联合多模态预训练;PPG 等其他模态未覆盖。我自己的观察:其一,CPSC 2018 macro-F1 落后 OpenECG-MAE 1.4 点,且 PTB-XL Super/CPSC 的 macro-AUROC 低于 PhysioWave-L(90.3 对 94.6),说明折叠+共享骨干在阈值级均衡决策更强、排序能力略有牺牲;其二,EPN-612 上 probe 比 scratch 低 4.45 点,源于 200 Hz 腕带内容(<100 Hz)与预训练前端强调的 100–200 Hz 频段错配,冻结迁移对采样率敏感;其三,KaggleERN 冻结编码器(53.7%)低于 scratch(57.0%),低幅短时事件仍需全骨干微调才能释放预训练价值;其四,可靠性头由合成严重度监督,真实伪迹统计不同时校准性存疑;其五,token 数仍随通道数线性增长,折叠只压缩尺度维,超高密度阵列依旧昂贵。
独立分析的弱点
独立分析的弱点与改进方向:(1)可靠性监督依赖合成损坏——训练时人为注入噪声/漂移/饱和并直接以严重度定义目标 $r_m\to1-\sigma_m$,但真实世界的电极接触不良、运动伪迹与合成损坏统计特性不同,改进方向是在前瞻性可穿戴数据上收集自然故障,用弱监督与保形预测等校准手段重训可靠性头。(2)三模态独立预训练学不到跨模态互补表征,融合只发生在 RALF 层;改进是联合多模态预训练(跨模态对比或共享掩码重建),让编码器在预训练阶段就见过“同一生理事件的 EEG+ECG”。(3)频谱错配导致低带宽配置迁移差(EPN-612 probe 掉 4.45 点),可引入多采样率混合预训练或前端频带分配的自适应切换。(4)折叠压缩的是分解深度而非通道数,128 通道路由仍需按 token 数反比缩放 batch,可探索通道维分组折叠或 token 合并。(5)30M 参数远小于通用基础模型,多任务容量可能成为瓶颈,值得做生理信号的规模律实验。(6)睡眠分析仅覆盖 14 名受试者、37,902 个窗口,尺度权重与病理(如癫痫、痴呆)的关联尚未检验。
未来方向
作者提出的方向:在带自然传感器故障的前瞻性记录上验证 RALF;联合多模态预训练;为 PPG 等新模态开辟新路由。基于本文成果可延伸:其一,把“路由-前端-词表”机制推广到 PPG、呼吸、连续血糖等信号,走向统一生理信号基础模型;其二,边缘部署——折叠带来的 6.8–12.7× 显存与 4.0–7.2× 延迟缩减天然适合可穿戴/植入设备,结合量化蒸馏做 on-device 微调值得探索;其三,临床工作流:RALF 在 ≤2 FA/h 预算下已达 32.0% 灵敏度,可结合发作类型条件化与长时程上下文建模;其四,可解释性延伸:折叠权重已能无监督追踪睡眠分期,可推广为癫痫、脑病频段动力学的 biomarker 发现工具;其五,词表允许下游追加电极名,可研究跨个体/跨设备嵌入对齐与持续学习。
复现评估
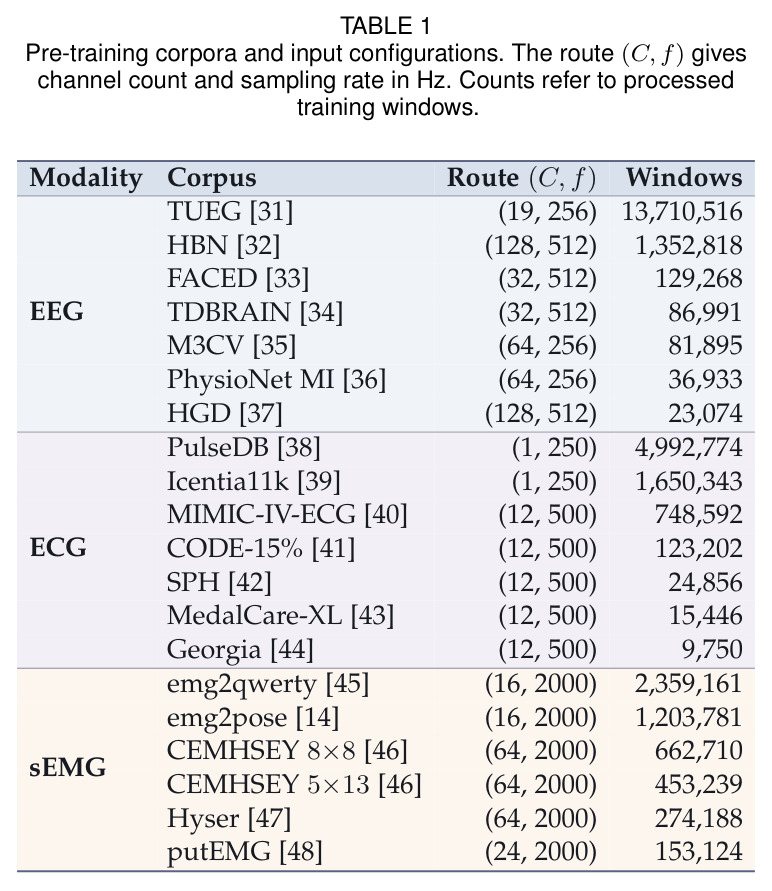
复现条件较好。代码与模型已在 GitHub 开源(ForeverBlue816/PhysioWave),超参数随配置文件发布。预训练语料全部公开:EEG 七个(TUEG/HBN/FACED/TDBRAIN/M3CV/PhysioNet MI/HGD,共 15.4M 个 4 秒窗口)、ECG 七个(PulseDB/Icentia11k/MIMIC-IV-ECG 等,7.6M 个 10 秒窗口)、sEMG 六个(emg2qwerty/emg2pose/CEMHSEY/Hyser/putEMG,5.1M 个 1 秒窗口);MIMIC-IV、TDBRAIN 需注册申请。算力:EEG/ECG 各 60 epoch、sEMG 40 epoch,单张 A100 bf16,峰值显存 26/19/16 GB(EEG/ECG/sEMG),参数 12–30M,学术实验室单机多卡可承担。评测协议透明:三种子均值、被试不重叠划分、沿用 EEGPT 与 PhysioWave 官方 split。难点在数据管线(路由分配、抗混叠重采样、通道名到词表槽位映射)与个别数据集访问审批,总体复现难度中等。
论文图表
睡眠分期上的尺度分配:最慢尺度 a3(<6.25 Hz)折叠权重从觉醒到 N3 稳步上升、REM 回落;受试者内 W→N3 增加在 Pz-Oz 13/13 人成立(Wilcoxon p=2.4×10⁻⁴)、Fpz-Cz 10/13(p=0.048);窗口级上 a3 权重与 δ 功率占比在 Pz-Oz 正相关(ρ=0.21)、在含眼电伪迹的 Fpz-Cz 负相关(ρ=−0.22)。
证明折叠权重不是黑盒:网络只看子带统计量、从未被告知分期标签,却无监督地追踪了睡眠电生理——这是“效率不牺牲生理意义”这一核心主张的最优雅证据。
两个预训练未见配置(EPN-612 8 电极 200 Hz 腕带、GRABMyo 28 电极 2 kHz 阵列)上对比 MOMENT(385M)/OTiS(45M)/PhysioWave-S/B/L:微调 PhysioWave-T(12M) 达 EPN-612 94.80%、GRABMyo 89.78%/F1 89.74% 全部最高;EPN-612 scratch 已 94.34% 而 probe 89.89%,GRABMyo scratch 85.16%、probe 87.41%、微调 89.78%。
两种协议(同用户 vs 跨 session)清晰划分了预训练的收益边界:分布偏移越大收益越大;probe 在 EPN-612 的失败还暴露了频谱错配问题,是理解迁移机制的关键表。