走向更深记忆:DEEPMEM 无损子带多尺度字节语言模型 Going Deeper With Memories
用可逆子带变换把语义压缩与字节保真分离,深层计算改在更短序列上进行
前置知识
字节级语言模型与 BPB 指标
字节级语言模型直接以 UTF-8 的 256 个字节值作为词表建模,不依赖 BPE/unigram 分词器,天然覆盖任意 Unicode 文本、代码和噪声字符,没有未知 token。评价指标 bits-per-byte(BPB)是把平均负对数似然除以 $\log 2$,衡量每个字节的平均编码代价,越低越好,可以在不同模型间公平比较。代价是序列长度:同样一篇文档的字节数远多于子词 token,全分辨率计算非常昂贵。
本文全部实验(如 FineWeb-Edu 1.0134 BPB)都以 BPB 为核心指标,而方法的根本动机正是解决字节序列过长带来的计算成本问题,不理解 BPB 和字节建模的成本结构就无法评估其贡献。
提升方案(Lifting Scheme)
提升方案是构造可逆小波变换的模块化方法:先把序列按奇偶位置分成两个子带,用预测器 $P$ 从偶子带预测奇子带得到细节系数 $\Delta = o - P(e)$,再用更新器 $U$ 修改偶子带得到粗略系数 $C = e + U(\Delta)$。只要 $P$、$U$ 固定,逆变换就是 $\hat{e} = C - U(\Delta)$、$\hat{o} = \Delta + P(\hat{e})$,在实数运算下精确重构原始信号。它把可逆性与可学习性解耦:$P$、$U$ 可以是任意可学习函数(如低秩 MLP)而变换仍保持精确代数逆。
DEEPMEM 的无损载体流完全建立在可学习提升步之上,这是它能把语义压缩与字节保真分离开的数学基础,方法部分的公式几乎都围绕它展开。
快速权重记忆(Fast Weight Memory)
把序列处理看作循环联想记忆:控制器在每个位置把键值关联写入一个快速变化的权重状态矩阵,读取时用查询检索存储内容的组合。典型形式是 $M_t = \gamma_t M_{t-1} + k_t v_t^\top$、$o_t = M_t^\top q_t$,其中数据相关的标量衰减 $\gamma_t \in (0,1]$ 控制遗忘。状态大小固定、不随序列长度增长,配合 chunk 并行(本文 chunk 为 64)可以高效全序列训练,是门控线性注意力类模型的核心机制。
DEEPMEM 的字节级初始块、整条分析路径和瓶颈精炼都用这种门控快速权重块做压缩计算,不掌握 $M_t$ 的状态更新语义就读不懂编码器的设计。
层级模型中的因果性
自回归要求位置 $t$ 的表示只依赖 $≤t$ 的输入。在 U-Net 式层级结构里这变得微妙:父位置 $j$ 概括了子位置 $2j$ 和 $2j+1$ 的信息,若把父表示直接复制给位置 $2j$,位置 $2j$ 就间接看到了位置 $2j+1$ 的内容,构成未来泄漏。因此下采样、上采样和 skip 连接都需要移位规则,例如右孩用父 $j$ 的提案、左孩改用父 $j-1$ 的提案,保证任何位置的表示的感受野都终结在该位置或之前。
这是本文区别于普通 hourglass/U-Net 分层语言模型的关键约束,超分辨率解码器的延迟父提案设计全部围绕它展开,也是论文声称的核心贡献之一。
U-Net 与多尺度编码-解码
U-Net 原是图像分割网络:一条收缩路径逐步下采样提取抽象特征,一条扩张路径逐步上采样恢复分辨率,并用 skip 连接把高分辨率细节直接送到解码端。字节领域的 MEGABYTE、AU-Net、Hourglass、Funnel Transformer 都借鉴了「深层计算放在短序列上、细节另外恢复」的思想,但它们的池化、删除、合并、分块操作通常是有损的,压缩态必须隐式记住被丢掉的细节。
DEEPMEM 的整体骨架正是编码器-瓶颈-解码器,理解 U-Net 才能看出它的差异所在:用可逆载体显式保真,而不是靠局部模块或事后重建来弥补损失。
研究动机
现代语言模型几乎都依赖 BPE 或 unigram 子词分词器:它们把序列大幅缩短、让 Transformer 训练变得现实,但代价是必须提前选定词表和切分方式。分词器会把稀有词、人名、代码和形态丰富的语言碎片化,对不同文字和脚本的压缩不均匀,对微小的字符扰动反应不连续。字节级模型只用 256 个符号就能表示任意 Unicode 文本和数字数据,ByT5、CANINE、Charformer 已证明其表征与鲁棒性,但核心障碍是序列长度:在 2,048 字节上下文里每个位置都要做全分辨率计算,成本远高于子词模型。MEGABYTE、SpaceByte、BLT、MrT5、AU-Net 等内部压缩方案虽然证明了 tokenizer-free 可行,但池化、删除、合并、熵分块都是有损的:压缩后的状态必须同时保住语义结构和精确字节身份,否则只能依赖独立的局部路径或事后重建,效率与保真之间存在根本张力。
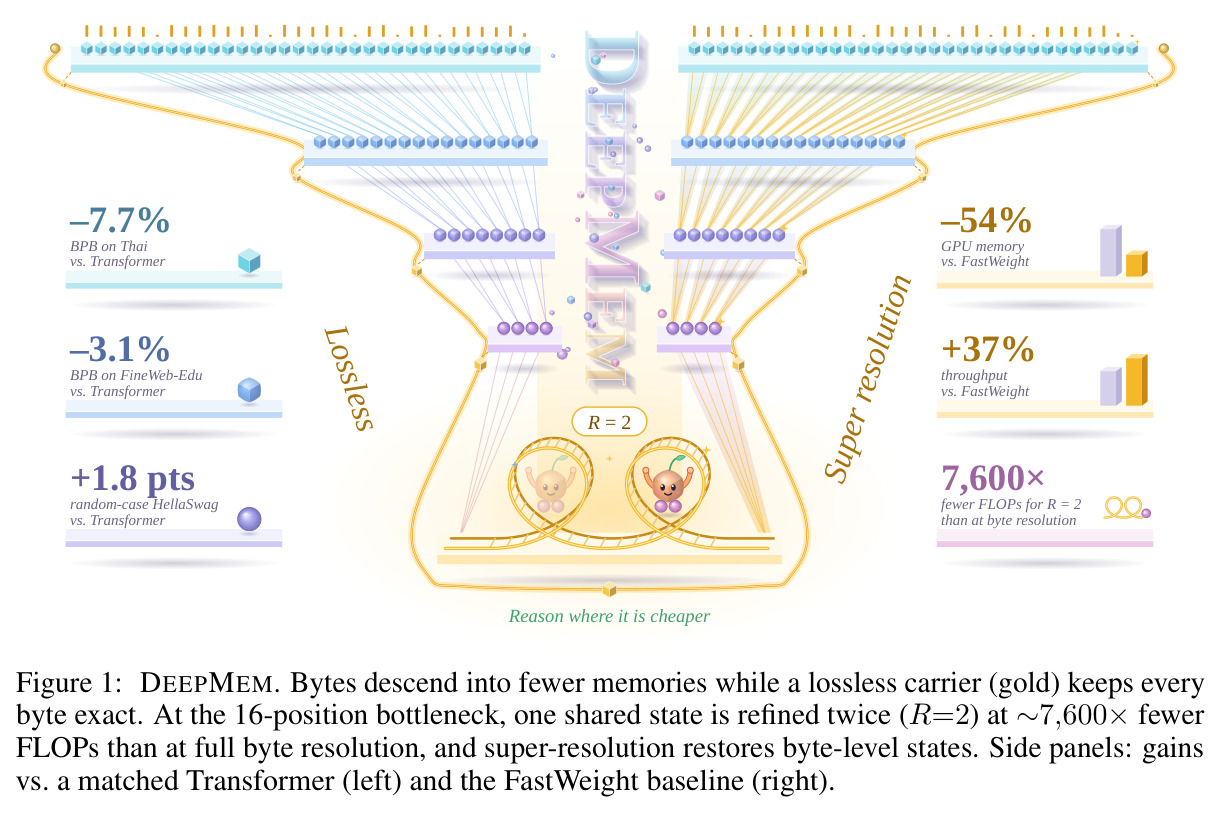
本文的目标是本文目标是构建一个无分词器的字节级自回归架构,把语义抽象与精确字节保留显式分离:语义流被逐级压缩到很短的序列(从 2,048 个位置压到 16 个),在其上做深层计算;同时用一条数学上可逆的无损载体流保存字节身份,使压缩不付出信息代价。可量化的目标包括:在约 1 亿参数、2,048 字节上下文、约 262 亿字节训练预算的统一设置下,BPB 全面优于同规模平铺字节 Transformer(其基线为 FineWeb-Edu 1.0457、PG19 1.4635、FLORES 宏平均 2.0082);瓶颈精炼的计算量比等价的全分辨率推理少约 7,600 倍 FLOPs;评测吞吐保持在 Transformer 的约 80%;并在零样本多选与字节扰动鲁棒性上不落后于基线。
与已有工作不同的是,本文的独特切入是把多速率信号处理系统地引入自回归建模:Laplacian 金字塔的「粗近似加残差带」、提升方案的精确代数逆、U-Net 的 skip 连接,三者被改写成满足严格因果约束的字节级架构。作者抓住的被忽视点是:压缩与保真的矛盾不必在同一个表示里解决——用固定 8 维双极位编码加可学习提升步构成载体层级,每级长度减半、宽度翻倍、系数总量恒为 $8T$,字节身份被显式保存而非隐式记忆,语义流因此可以自由做有损压缩。此外,已有分层模型很少讨论层级之间的因果性,本文用延迟父提案(右孩取父 $j$、左孩取父 $j-1$)把 U-Net 式上采样改造成自回归合法的操作,这是与 MEGABYTE、BLT、AU-Net 等分割或池化方法的本质区别。
核心方法
直觉上,DEEPMEM 像一套无损的图像金字塔编码:语义流是越往下越抽象的缩略图,负责长程语言学结构;载体流是精确的二进制底稿加各级残差细节,任何时刻都能精确还原原始字节。技术路线分四段。第一段把每个字节同时编码为学习嵌入 $S^{(0)}_t$(宽度 1024)和 8 维双极位载体 $K^{(0)}_t \in \{-1,+1\}^8$,后者是无参数的单射编码。第二段是 7 级分析路径:每级用可学习提升步对载体做无损奇偶分解,用门控快速权重块对语义做下采样,长度依次为 2048→1024→512→256→128→64→32→16,语义宽度从 1024 收敛到 128。第三段在 16×128 的瓶颈上用共享参数的快速权重混合器精炼两步。第四段是注意力超分辨率解码器,逐级用延迟父提案、编码 skip 和精确载体特征恢复字节分辨率表示,最后用注意力栈加 256 路softmax 预测下一个字节。参考模型总参数 100,158,582。
核心创新是三重分离,与已有方法的本质区别在于信息是被变换而不是被丢弃。其一,语义与保真分离:语义流有损、可学习、自由压缩;载体流用提升方案实现 $\Delta = o - P(e)$、$C = e + U(\Delta)$,其精确代数逆为 $\hat{e} = C - U(\Delta)$、$\hat{o} = \Delta + P(\hat{e})$,且 $P$、$U$ 的输出投影零初始化,使训练从恒等的惰性变换($\Delta = o$、$C = e$)平滑出发——字节身份从不被迫挤过窄瓶颈,这是 MEGABYTE、BLT 等分块方法做不到的,它们的压缩态必须隐式携带全部局部细节。其二,深度与分辨率分离:快速权重编码器在越来越短的序列上做深层循环记忆计算,瓶颈 16×128 上共享参数精炼两步,等价推理比全分辨率少约 7,600 倍 FLOPs。其三,因果超分辨率:解码用移位 unpacking($U^{(\ell)}_{2j+1} = p^R_j$、$U^{(\ell)}_{2j} = p^L_{j-1}$),父提案绝不把未来字节泄漏给更早位置。
方法步骤详情
第一步,输入字节序列 $x_t \in \{0,\dots,255\}$:语义侧查嵌入表得 $S^{(0)}_t$,载体侧取 8 比特双极编码 $K^{(0)}_t$。第二步,逐级分析:载体按奇偶分成 $e_j$、$o_j$,经 rank 64 低秩 MLP 预测器 $P_\ell$ 与更新器 $U_\ell$ 得到细节 $\Delta^{(\ell+1)}_j = o_j - P_\ell(e_j)$ 和粗略系数 $C^{(\ell+1)}_j = e_j + U_\ell(\Delta^{(\ell+1)}_j)$,拼接为下一级载体(长度减半、宽度翻倍,总量恒为 $8T$);语义侧拼接相邻向量经 $W_{pair}$ 投影,注入 $\alpha^{car}_\ell Q^{car}_\ell(K^{(\ell+1)}_j)$ 后过 2–4 层门控快速权重块 $M_t = \gamma_t M_{t-1} + k_t v_t^\top$、$o_t = M_t^\top q_t$(chunk 64 并行)。第三步,瓶颈精炼:$B = S^{(L)}$(16×128),$Z_0 = 0$,两步 $Z_{r+1} = Z_r + R_{bot}(\mathrm{RMSNorm}(B + Z_r))$,共享参数仅 69,280 个。第四步,解码上采样:$W_{up}$ 把父向量投影为左右子提案并按移位规则分配,与编码 skip 和载体经门控 $G = \sigma(W_g Z)$、$\tilde{Y} = \mathrm{RMSNorm}(S + G \odot W_m Z)$ 融合,再过 2–4 层 RoPE 因果自注意力细化。第五步,最终注意力栈投影到 256 字节词表,以下一字节 NLL 训练,除以 $\log 2$ 得 BPB。
技术新颖性
从技术谱系看,分块派(MEGABYTE、SpaceByte、BLT 的熵分块)不可逆,池化重建派(Hourglass、AU-Net、Funnel)有损,换骨干派(MambaByte)仍是全分辨率;DEEPMEM 属于变换派:用多速率信号处理把信息移动而非丢弃。具体新颖点有四个:其一,把提升方案的预测/更新函数实现为 rank 64、输出零初始化的低秩 MLP,可逆性与可学习性解耦,训练从惰性变换稳定出发;其二,载体宽度逐级翻倍使每级系数总量恒为 $8T$,无损性的存储代价可解析、不随深度膨胀;其三,共享状态瓶颈精炼只用一个 128 维快速权重混合器迭代两次、参数完全共享,仅 69,280 个参数即带来稳定增益且不引入迭代专属参数;其四,延迟父提案加门控 skip 融合把 U-Net 的上采样/skip 改写成满足自回归因果约束的形式,这在字节级层级语言模型文献中是首次被显式形式化,比单纯堆层更有概念贡献。
实验结果
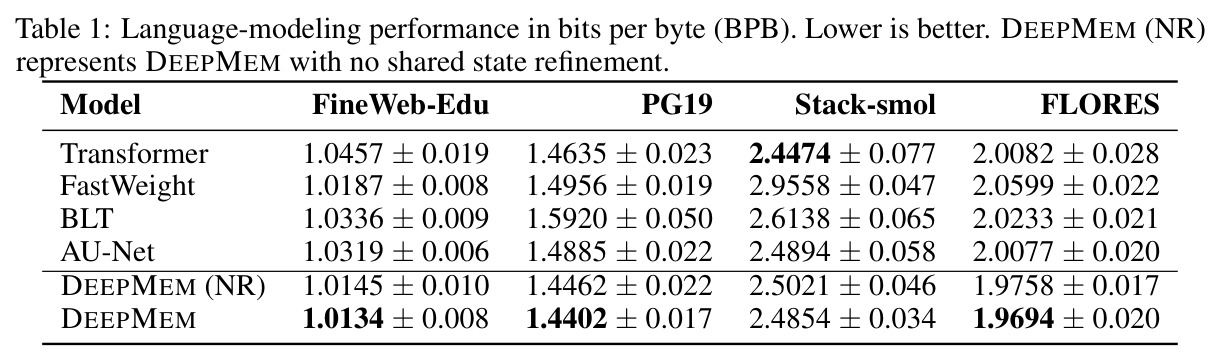
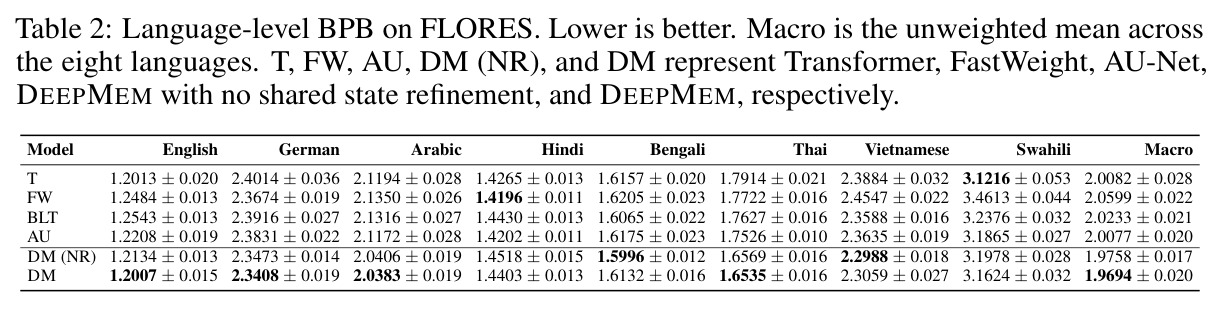
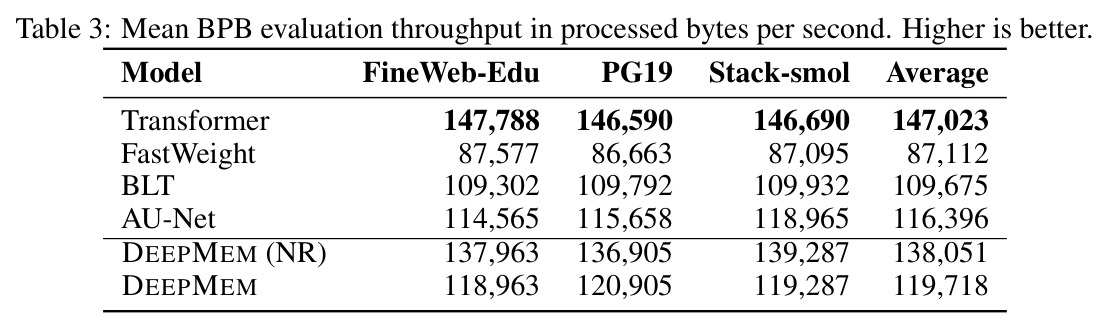
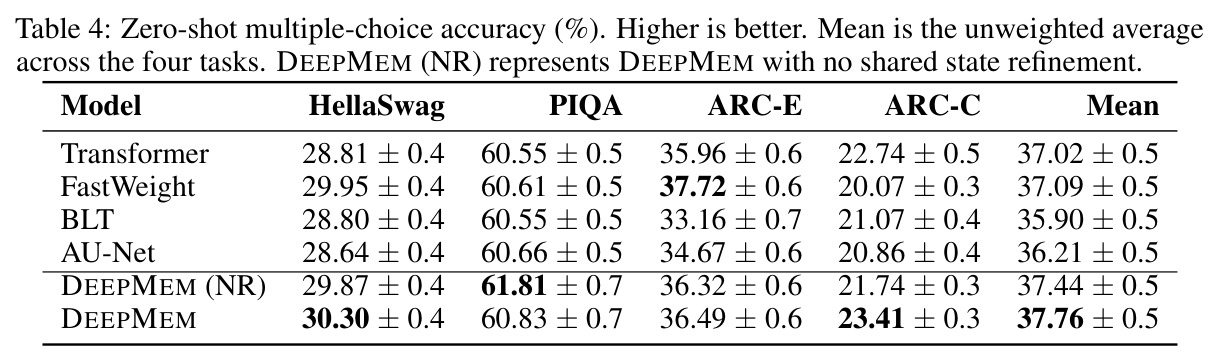
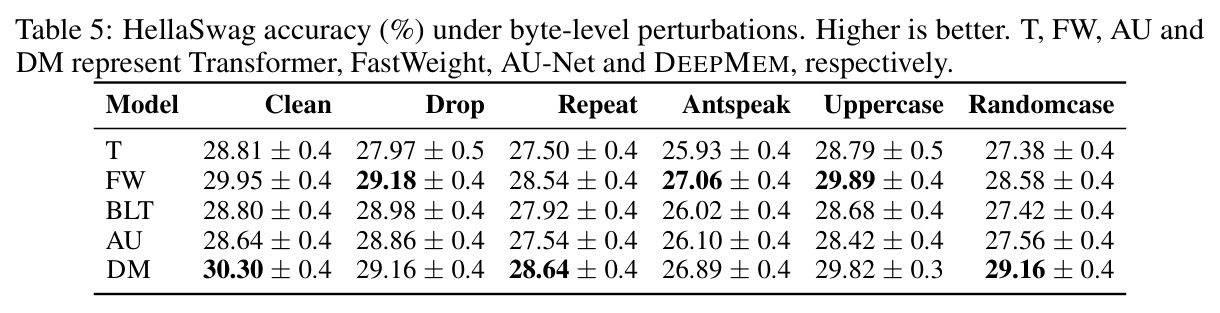
在约 1 亿参数、2,048 字节上下文、约 262 亿字节训练量、4 块 V100、每模型 3 个随机种子的统一设置下,DEEPMEM 语言建模质量全面领先:FineWeb-Edu 1.0134±0.008 BPB,优于 Transformer 的 1.0457(降约 3.1%)、FastWeight 1.0187、BLT 1.0336、AU-Net 1.0319;PG19 1.4402 对 Transformer 的 1.4635;FLORES 八语言宏平均 1.9694 对 2.0082,泰语 1.6535 对 1.7914 改善最大,英、德、阿、泰单语领先,唯斯瓦希里语 Transformer 更好(3.1216 对 3.1624)。代码建模是短板:Stack-smol 2.4854 落后 Transformer 的 2.4474。效率方面,评测吞吐 119,718 字节/秒,为 Transformer 的 81.4%,但高于 FastWeight 87,112、BLT 109,675、AU-Net 116,396。零样本多选均值 37.76% 最高:HellaSwag 30.30% 和 ARC-Challenge 23.41% 均最佳,PIQA 60.83% 略低于 NR 变体的 61.81%,ARC-Easy 36.49% 输给 FastWeight 的 37.72%。字节扰动鲁棒性六设置均值 29.00% 最高,随机大小写下 29.16 对 Transformer 的 27.38。消融显示去掉瓶颈精炼的 NR 变体 FineWeb 1.0145、吞吐升至 138,051 字节/秒,说明精炼模块以约 15% 吞吐换小幅质量提升;附录中全尺度融合配置把 Stack-smol 降到 2.4082,印证存在任务特定的架构取舍。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 通用域语言建模(FineWeb-Edu) | BPB(越低越好) | 1.0134 | Transformer 1.0457 / FastWeight 1.0187 / BLT 1.0336 / AU-Net 1.0319 | 相对最佳基线降低约 0.5%,相对 Transformer 降低约 3.1% |
| 长篇文本建模(PG19) | BPB(越低越好) | 1.4402 | Transformer 1.4635 | 降低约 1.6% |
| 多语言建模(FLORES 八语言宏平均) | BPB(越低越好) | 1.9694 | Transformer 2.0082 / AU-Net 2.0077 | 降低约 1.9%,泰语单语降低 7.7% |
| 代码建模(Stack-smol) | BPB(越低越好) | 2.4854 | Transformer 2.4474 | 落后约 1.6%,为本文唯一劣势项;仍优于 FastWeight 2.9558 和 BLT 2.6138 |
| 零样本多选(HellaSwag/PIQA/ARC-E/ARC-C 均值) | 准确率 %(越高越好) | 37.76% | Transformer 37.02% / FastWeight 37.09% | HellaSwag +1.35 个百分点、ARC-C +0.67 个百分点 |
| 字节扰动鲁棒性(HellaSwag 六设置均值) | 准确率 %(越高越好) | 29.00% | FastWeight 28.87% / Transformer 27.73% | 随机大小写下 +1.78 个百分点 |
| 评测吞吐 | 字节/秒(越高越好) | 119,718 | Transformer 147,023 / AU-Net 116,396 | 为 Transformer 的 81.4%,但超过全部三个层级/线性基线 |
| 瓶颈精炼计算开销 | FLOPs(对比字节分辨率等价推理) | 少约 7,600 倍 | 全分辨率推理 | 16 位置×宽度 128 的 R=2 精炼取代 2,048 位置全分辨率计算 |
局限与改进
作者承认的限制:实验只覆盖约 1 亿参数规模和单一训练预算,更大规模的结论未知;Stack-smol 代码建模落后平铺 Transformer(2.4854 对 2.4474);评测吞吐只有 Transformer 的 81.4%;精确可逆仅在实数运算下成立,有限精度会引入小的重构误差;固定 2 倍频层级不如可学习的变长分割灵活。我的补充观察:所有实验都在 V100/FP16 上完成,吞吐结论在现代硬件上未必迁移;多选任务的改进幅度(如 HellaSwag +1.35 个百分点)与 ±0.4–0.7 的种子波动量级接近,需谨慎解读;多语言收益可能部分来自字节模型对非拉丁文字的天然优势,尽管同设置对比仍然成立;论文未报告训练墙钟时间与显存占用;深层语义流宽度固定为 128,在更大模型上可能成为信息瓶颈,这与代码任务回退的现象一致。
独立分析的弱点
第一,无损的代价集中在解码端:合成路径要在全分辨率 2,048 上跑多层 RoPE 自注意力,上下文拉长时这部分会重新成为瓶颈,改进方向是把上采样细化换成滑窗注意力或线性记忆,或对载体注入做稀疏化。第二,固定二分切分与语义边界不对齐,多字节字符或词可能被拆进不同父节点,方向是引入 BLT 式熵引导的变长分析、同时用提升方案的变体保持可逆性。第三,可扩展性存疑:16×128 的瓶颈和宽度 128 的深层语义流在 1B+ 参数时可能限制容量,代码建模的回退已提示细粒度结构在瓶颈处受损,应让瓶颈宽度随模型规模缩放并重新消融。第四,实际成本被低估:训练时分析与合成路径都要跑,81.4% 只是评测侧数字,速度敏感场景可直接采用 NR 变体(138,051 字节/秒)作为默认配置。第五,鲁棒性评估只在 HellaSwag 上进行,对翻译、摘要等生成任务的字符噪声泛化性还未验证,且多选指标对 1 亿参数模型的区分度有限。
未来方向
作者提出的方向包括:放大到更大参数规模与更长训练预算验证结论、引入比固定二分更灵活的可学习变长分割、处理有限精度下的可逆性误差、按任务在「直接全尺度融合」与「瓶颈精炼」配置之间选择。基于其成果可延伸的方向:把无损载体思想嫁接到子词模型上作为字符级回退通道,兼顾分词效率与拼写鲁棒性;把共享状态精炼从固定两步推广为自适应迭代深度或提前退出;分析 lifting 步的移位语义与 RoPE 位置编码的交互;由于 256 字节词表天然覆盖任意数字数据,可扩展到原始音频、基因序列等多模态字节建模;与投机解码结合,用粗粒度语义流起草、载体流做精确校验。
复现评估
复现条件较好。代码已在 GitHub 开源(github.com/akhadangi/deepmem),数据集全部公开:FineWeb-Edu、PG19、Stack-smol、FLORES 以及 HellaSwag、PIQA、ARC 评测集。论文给出完整超参(AdamW β1=0.9、β2=0.95、权重衰减 0.1、梯度裁剪 1.0、学习率 3e-4 经 2,000 步预热余弦退火到 3e-5、FP16 混合精度、有效批 524,288 字节/步、50,000 步、3 seeds)和完整架构规格(各层长度/宽度/深度、rank 64、最多 16 头、chunk 64、RoPE base 10000、总参数 100,158,582)。算力需求为单节点 4 块 V100-SXM2 32GB、约 262 亿字节训练量,属中等规模、单机数天可完成。主要风险是 chunk 并行快速权重的实现细节与逆变换的数值精度需要读代码确认,复现 BLT、AU-Net 基线时也可能有版本差异。总体复现难度中等偏低。
论文图表