ReproBridge:将可复现性内建于机器学习研究工件 ReproBridge: Building Reproducibility into ML Research Artifacts
用智能体流水线把复现经验固化为四组件工件,复现成功率从76.4%升至92.6%
前置知识
计算可复现性(Computational Reproducibility)
按 ACM 术语,指用作者发布的工件(代码、数据、环境说明)独立地重新执行实验并得到数值兼容的结果,区别于从头重新实现方法或逐位复刻输出。可复现性危机的根源常在于论文与代码遗漏大量隐含执行细节:依赖版本、随机种子策略、多个输出的聚合方式、输出文件到表格条目的映射等。
本文将「复现」严格定义为对发布工件的独立重执行,全部基准设计与评分规则都围绕这一定义展开,不理解它就无法理解任务为何这样构造。
编码智能体(Coding Agent)
以 LLM 为核心、能在终端和文件系统中自主操作的软件系统:读论文与代码、安装依赖、修改脚本、运行实验、解析输出。评测时通常在「全新会话」中启动,不携带任何历史上下文,因此其表现完全取决于输入材料的质量与模型自身能力,这正是本文对照实验的基础。
ReproBridge 的工件构建与下游复现评测都以编码智能体为执行主体,理解会话隔离与信息边界才能看懂它的实验设计。
预测区间(Prediction Interval)
与刻画参数不确定性的置信区间不同,预测区间预测的是「下一次新观测」的取值范围。本文用每任务 5 次人工验证的参考执行估计某统计量的样本均值 $\bar{x}_j$ 与标准差 $s_j$,构造区间 $I_j^{(q)} = [\bar{x}_j - r_j^{(q)},\ \bar{x}_j + r_j^{(q)}]$,默认 $q=0.95$ 并设 1% 相对容差下限,复现值落入区间才算数值兼容。
区间规则是基准评分的数值判定核心,且在原始代码与精炼工件两种条件间保持固定,理解它才能理解「成功率」的统计含义。
系统偏差与随机误差分解
计量学将测量误差分为系统效应与随机效应。本文据此建模每次复现的测量 $Y = \mu + D + \varepsilon$:$\mu$ 是忠实执行指定实验时的期望值,$D$ 是执行选择偏离指定实验造成的系统性偏移,$\varepsilon$ 是条件零均值的随机波动。多次独立重做能缩小对 $\varepsilon$ 的不确定性,但无法消除持续的 $D$。
这一分解直接定义了论文的目标——通过保留执行知识来降低 $|D|$,是理解全文假设与结论解释框架的钥匙。
执行完整性审计(Execution-Integrity Audit)
「数字对了」不等于「实验做对了」,独立的 Auditor 会追查每个报告值到实际输出文件、生成脚本与执行记录的证据链,检测复制数值、替换测量对象、篡改操作数、按观测值挑选结果、计算错误统计量这五类违规。它采用 Finder 提出违规、Refuter 反驳、争议时交专家小组的对抗式结构,且在复现结束后运行、不给复现者反馈。
这是防止智能体「抄数字」作弊的关键机制,也是本文成功率指标可信度的基础;论文还用人工对照验证了审计本身的精确率与召回率。
研究动机
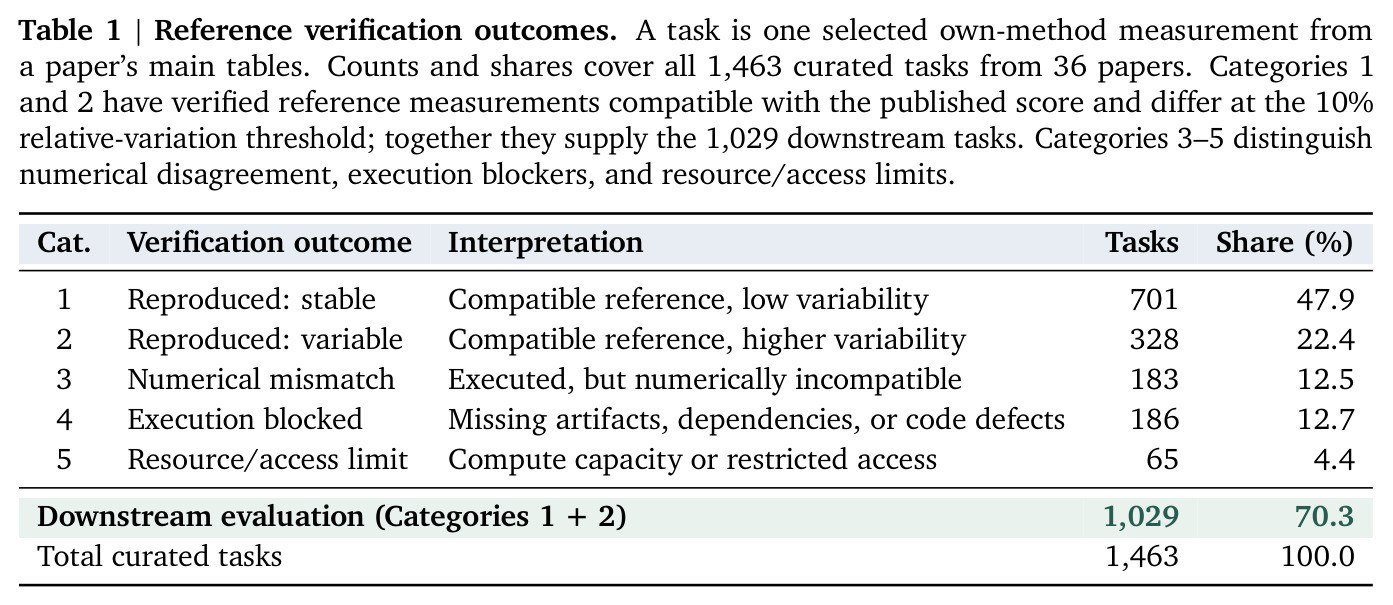
复现一个机器学习实验往往要打捞论文和代码里没写清的细节:解决依赖冲突、确定真实配置、修复数据加载器、弄清运行输出如何变成论文里的那个分数。本文的数据说明了这一负担的规模:从 742 篇 ICML 2026 Spotlight 论文出发,仅 241 篇提供官方代码且非纯理论,随机抽 50 篇后剔除工件缺失(6 篇)、算力要求过高(4 篇)、闭源模型依赖(4 篇),只剩 36 篇可测;在 1,463 个候选任务中,186 个因工件缺失、依赖或代码缺陷完全无法执行(类别 4),183 个执行了但数值对不上(类别 3)。对 coding agent 而言,这意味着复现成败很大程度上取决于智能体「自行补全缺失细节」的能力而非发布工件本身;更糟的是,一次成功复现所恢复的过程知识散落在对话记录和 shell 历史里,下一个复现者必须从零重复整个调查,PaperBench、CORE-Bench 等基准记录的失败大多正是这种重构负担。
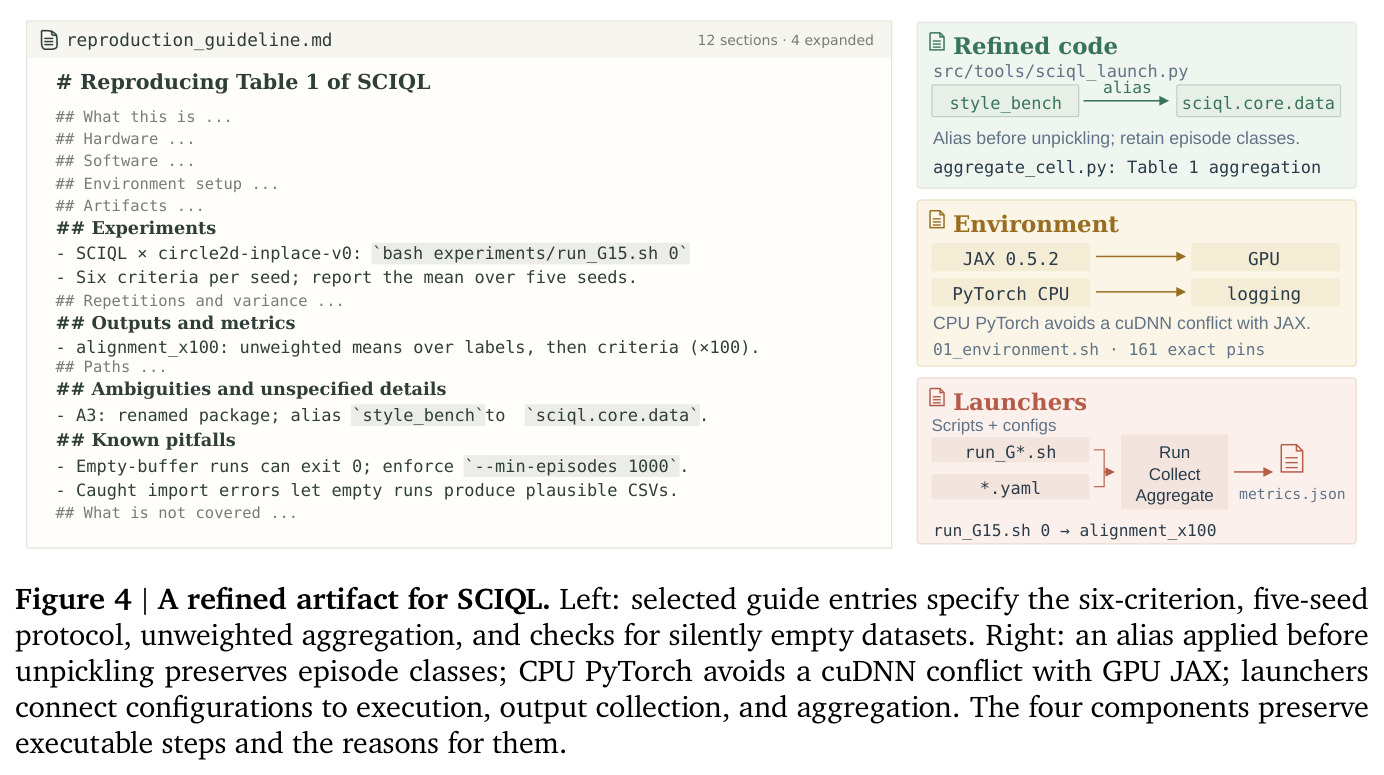
本文的目标是论文的假设是:把复现过程中恢复出来的程序与决策「固化」下来,能提升后续独立复现的成功率并降低成本。具体目标有三层。其一,定义标准化工件格式 RRA(refined reproducible artifact),包含精炼代码库、环境配置、实验启动器、复现指南四个组件,使「依赖解析」变成安装程序、「实验发现」变成启动器、「一次修复」变成带理由和影响范围的变更记录。其二,构造 ReproBridge 智能体工作流:输入论文和官方仓库,输出上述工件,由六个角色分工完成、独立评审把关。其三,建立 ReproBridge-Bench(36 篇论文、387 个实验、1,029 个任务、每任务 5 个人工验证参考分)量化工件价值:验证「给定充分执行信息后,原始代码成功率低的模型也能达到高成功率」,并用组件消融回答四组件各自的不可替代性。
与已有工作不同的是,已有工作的切入点都是「提升复现者能力」:PaperCoder 让智能体从论文规划并重建仓库,AutoReproduce 从引用论文中挖掘缺失细节,VERITAS 执行研究流程并产出修补代码与修复日志。它们回答的是「怎样让更聪明的智能体补全信息」。本文抓住的被忽视问题是「怎样让恢复的信息不丢失」——即使最强模型的一次成功复现,其发现的配置、修复、度量规则也随会话结束而蒸发,执行知识从未被制度化。因此本文把干预点从「复现者」移到「工件」:不追求单次复现更聪明,而是把执行知识整理成可移交的四组件格式,让任何后续会话直接受益。再用标准化工件协议、5 次人工验证参考分构造的预测区间、以及 Finder–Refuter 对抗式完整性审计构成可信闭环,这与先前复现基准依赖 rubric 或单一参考区间的评测思路本质不同。
核心方法
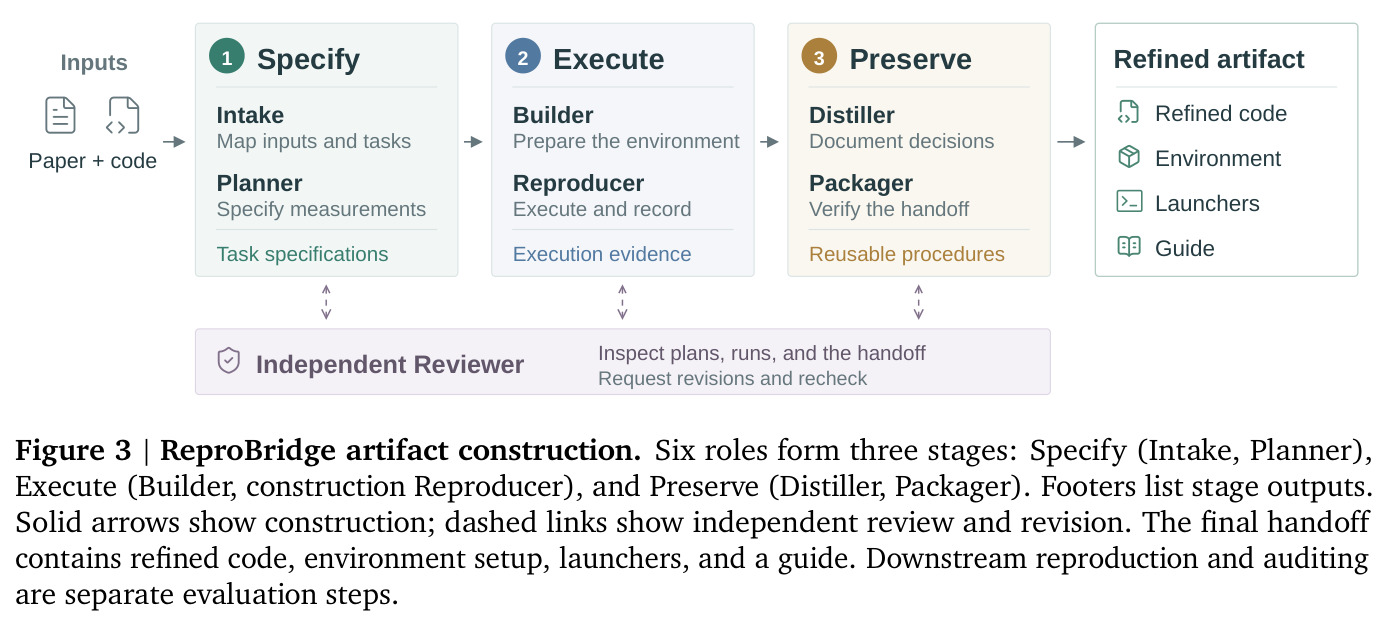
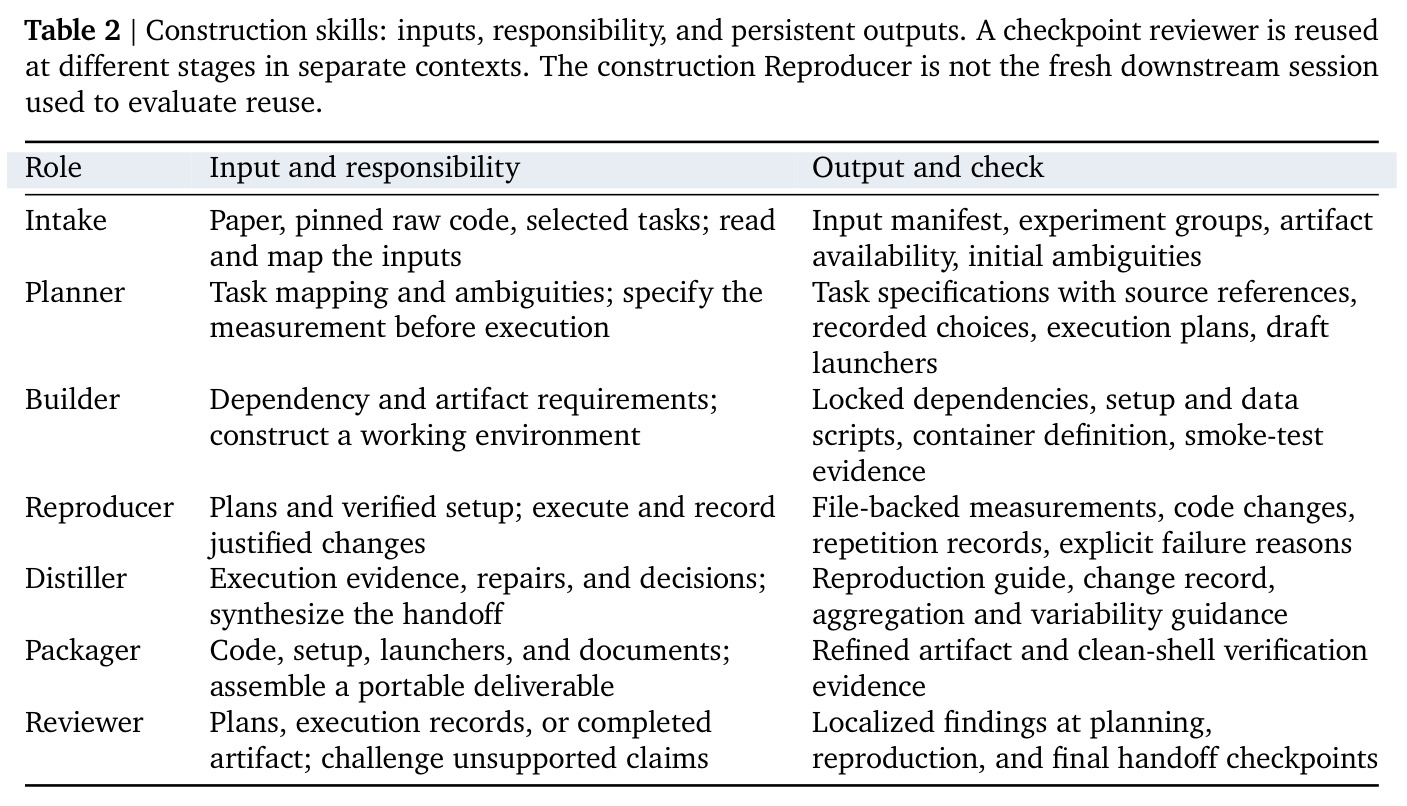
直觉上,ReproBridge 像一位离职前认真写交接文档的工程师:不只留下能跑的代码,还写清楚为什么这样配环境、哪个脚本对应论文哪张表、踩过哪些坑。技术上它是一条三阶段六角色的智能体流水线。Specify 阶段(Intake + Planner)在读到任何实验结果之前先梳理输入、把每个任务要测什么写成显式规格;Execute 阶段(Builder + 构建 Reproducer)锁定依赖、执行实验、记录带文件证据的测量与每一次修复;Preserve 阶段(Distiller + Packager)把过程证据合成为复现指南与变更记录,打包成可移植工件并通过清洁 shell 验证入口真实可用。独立 Reviewer 在各检查点挑战无依据的声明并要求返工。下游评测时,全新会话的 Reproducer 只拿到论文、任务清单和工件(对照条件只给原始代码),产出新测量与执行证据;任务成功由数值兼容与审计共同判定,即结果落入固定区间 $I_j^{(0.95)}$ 且未被 Auditor 确认违规。
核心创新是把「复现经验」当作一等公民工件来保存。与已有方法的本质区别在干预对象与评测假设:先前系统致力于让复现者更聪明,本文证明只要把执行知识——修复后的代码、锁定的依赖、从配置到输出再到取数的启动器链路、带理由的指南与变更记录——打包成 RRA,复现成功率就不再强依赖复现者的智能:原始成功率仅 67.6% 的 Gemini 3.8 Flash 用工件后达到 90.8%,跨模型差距从 21.6 个百分点缩到 3.9。第二个关键设计是评测闭环的可信性:每任务 5 个人工独立验证的参考观测刻画波动,兼容阈值 $r_j^{(q)} = \max(t_{(1+q)/2,4}\, s_j \sqrt{1+1/5},\ 0.01|\bar{x}_j|)$ 固定后跨条件不变;且数字匹配还不够,Codex Auditor 追查证据链并以对抗结构定罪。这使「工件有价值」的结论不被作弊或宽松评分稀释,也使论文能诚实地报告 136 个反转案例。
方法步骤详情
流程分构建与评测两段。构建段:Intake 读论文与 pinned 原始 commit,产出输入清单、实验分组与初始歧义;Planner 在见到任何结果前写出任务规格(数据、模型、流程、报告统计量、来源引用、未决选择),把执行决策显性化,避免「先看答案再定做法」;Builder 锁定依赖、写安装与数据脚本、容器定义并留存冒烟测试证据;构建 Reproducer 执行任务,每个测量必须链接到真实输出文件,失败留显式原因,诊断运行与计分运行分离、修正的重跑要记录替换理由;Distiller 合成十二节结构的复现指南(硬件、软件、环境、歧义及解决理由与敏感性、已知陷阱、未覆盖范围等)与变更记录(区分执行修复、正确性修复、便利改动);Packager 打包并做清洁 shell 验证,保证交付环境与构建测量时一致。评测段:每篇论文每模型每条件开一个全新会话,限时 24 小时(GPU 任务用 8 块 H100-80GB),Reproducer 提交新测量与执行证据;Codex Auditor 先机械筛查线索,Finder 定位违规,Refuter 尝试推翻,未驳倒且对测量有实质影响才判无效;成功 = 数值落入兼容区间且未被审计判废。
技术新颖性
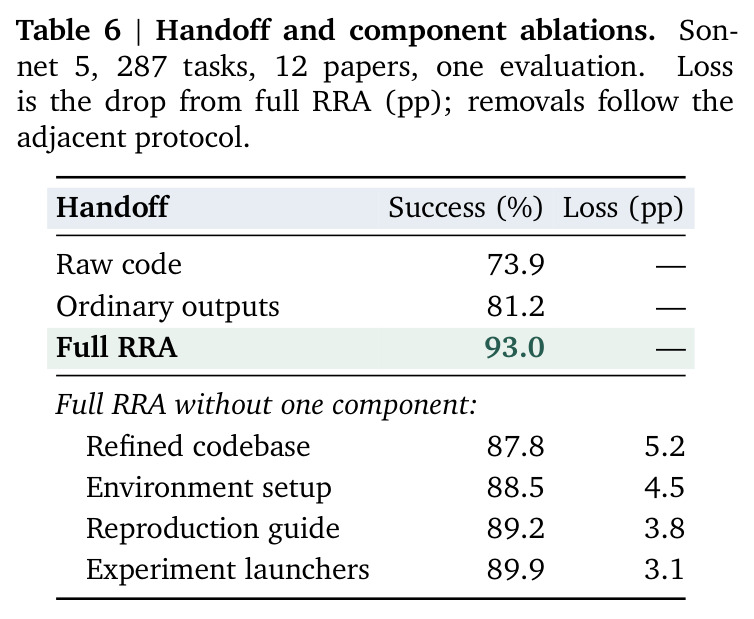
新颖性体现在四点。第一,工件协议标准化:先前系统(VERITAS 的修补代码+修复日志、ARA 的论文仓库+rubric)输出格式随意,本文定义四组件合同,并用移除实验证明每个组件都有不可替代的贡献(去精炼代码损失 5.2pp、环境 4.5pp、指南 3.8pp、启动器 3.1pp)。第二,参考真值的统计学:多数基准用单一参考值或专家 rubric,本文用 5 次人工验证执行构造预测区间,以变异度 $V_j = 100(\max_i x_{ji} - \min_i x_{ji})/|p_j|$ 区分稳定($V_j \le 10$)与高波动任务,并明确「论文分数只是 $\mu$ 的一次观测」。第三,反作弊审计制度化:Finder–Refuter–Panel 的对抗结构配上人工对照验证(Codex 精确率 88.6%、召回 79.5%,对 779 个有效结果仅误报 4 个)让成功指标有可量化的可信度。第四,「普通产物」对照设计:仅保留代码、脚本、日志的原始执行目录得 81.2%,完整工件 93.0%,说明增益来自标准化交接协议而非仅仅「跑过一遍」。
实验结果
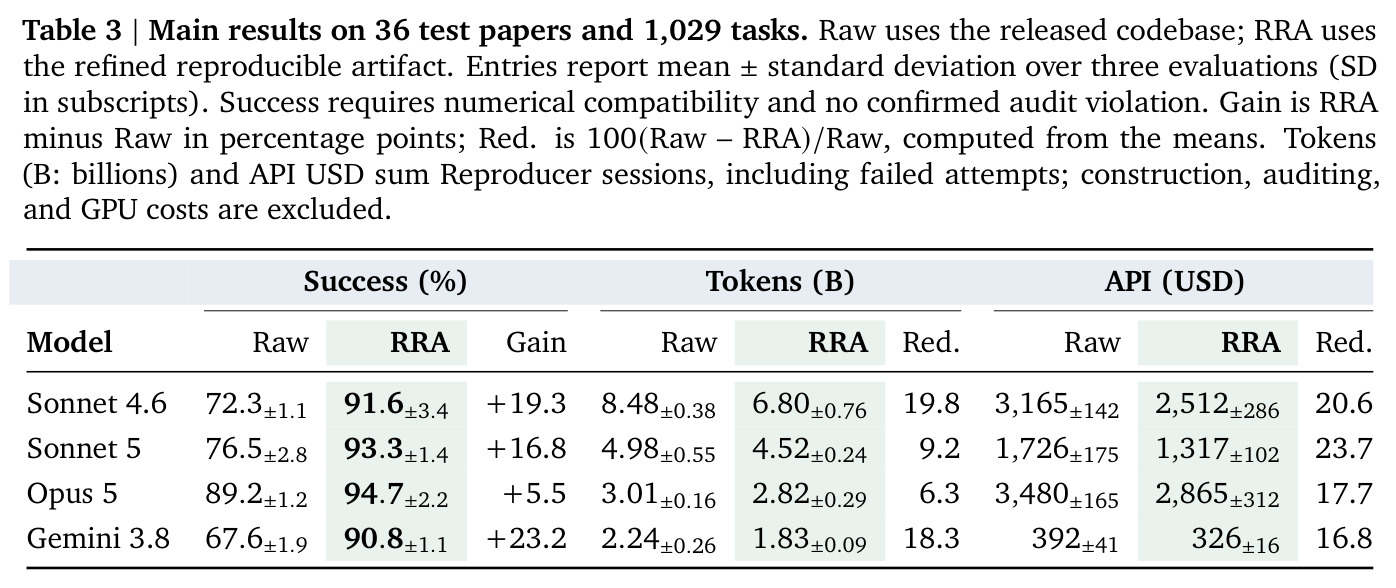
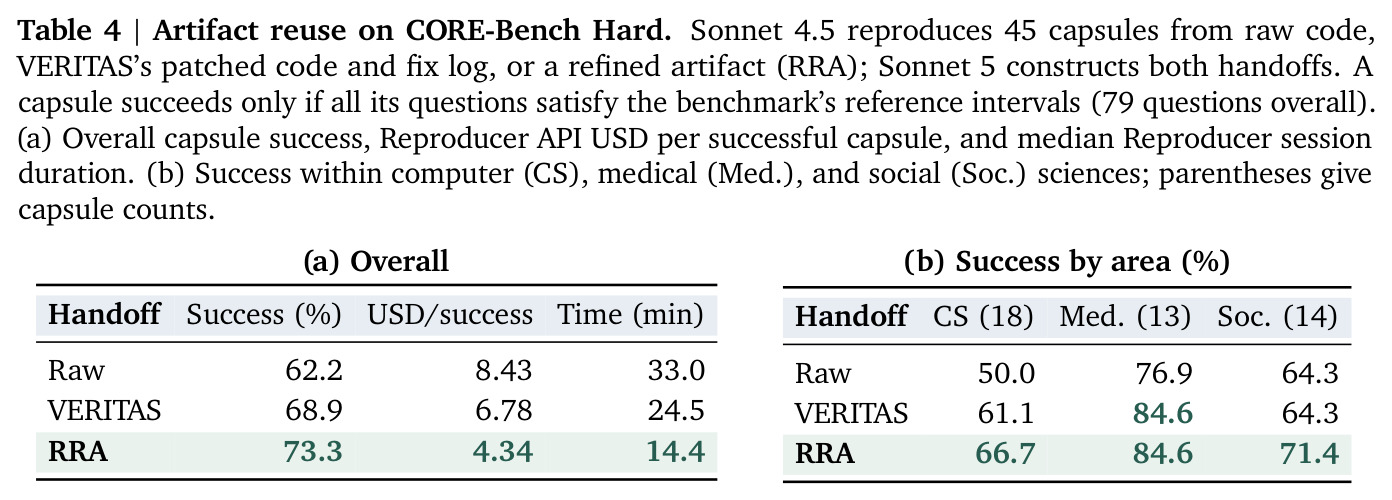
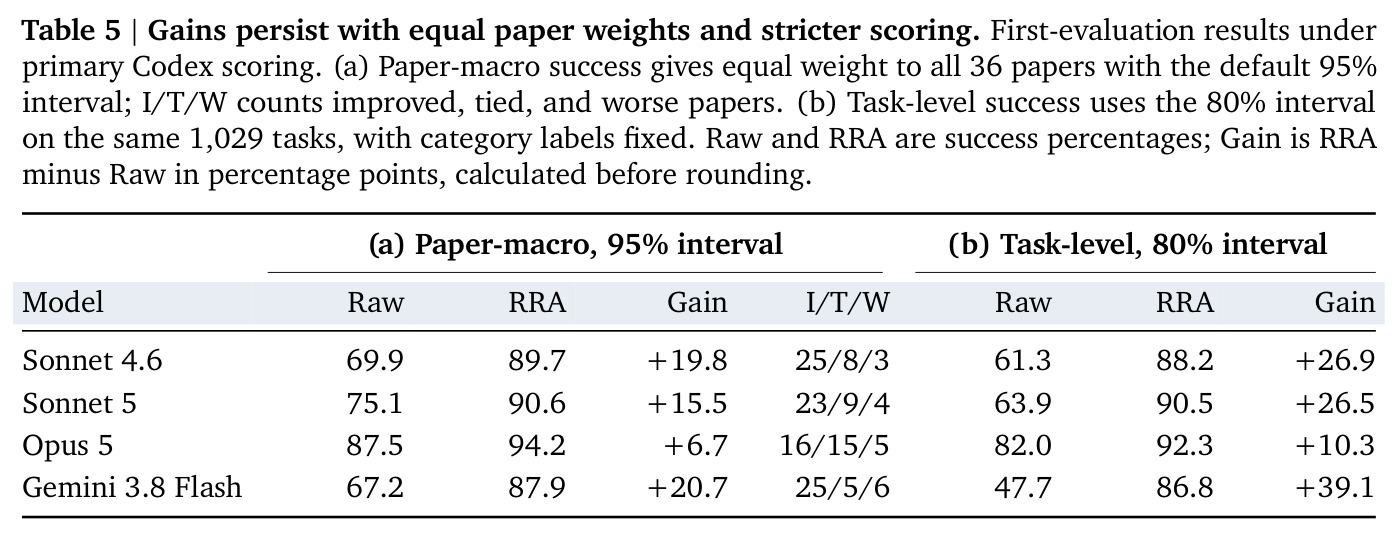
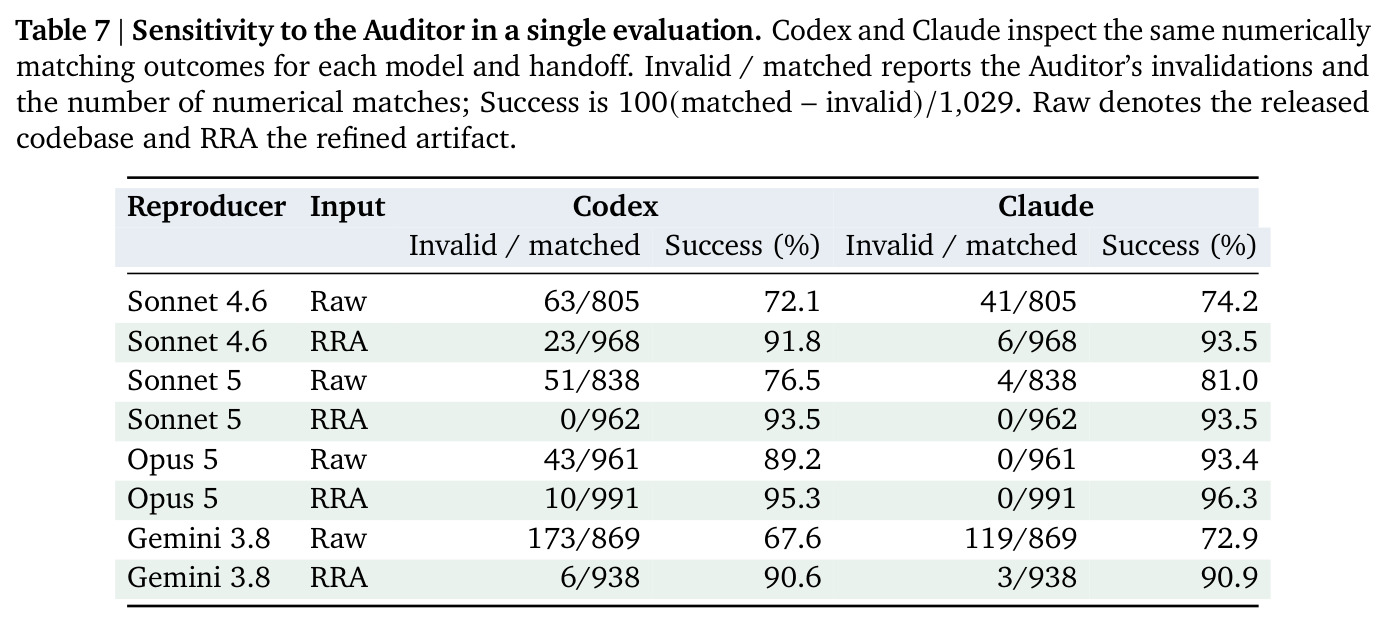
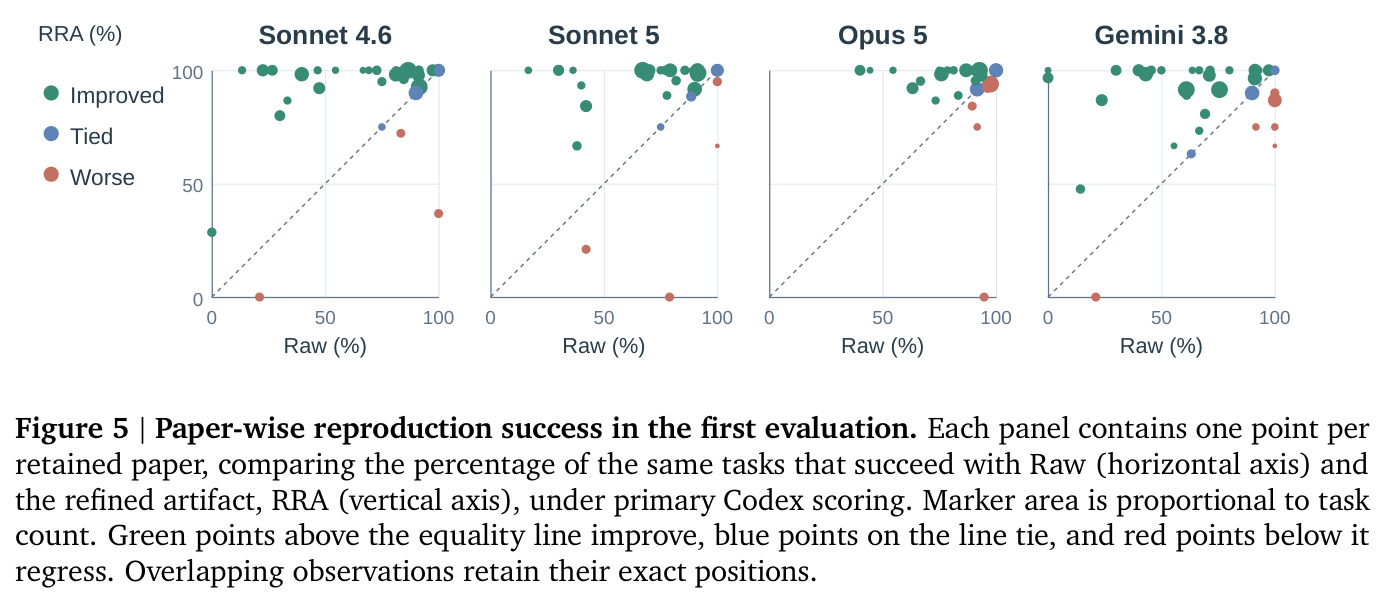
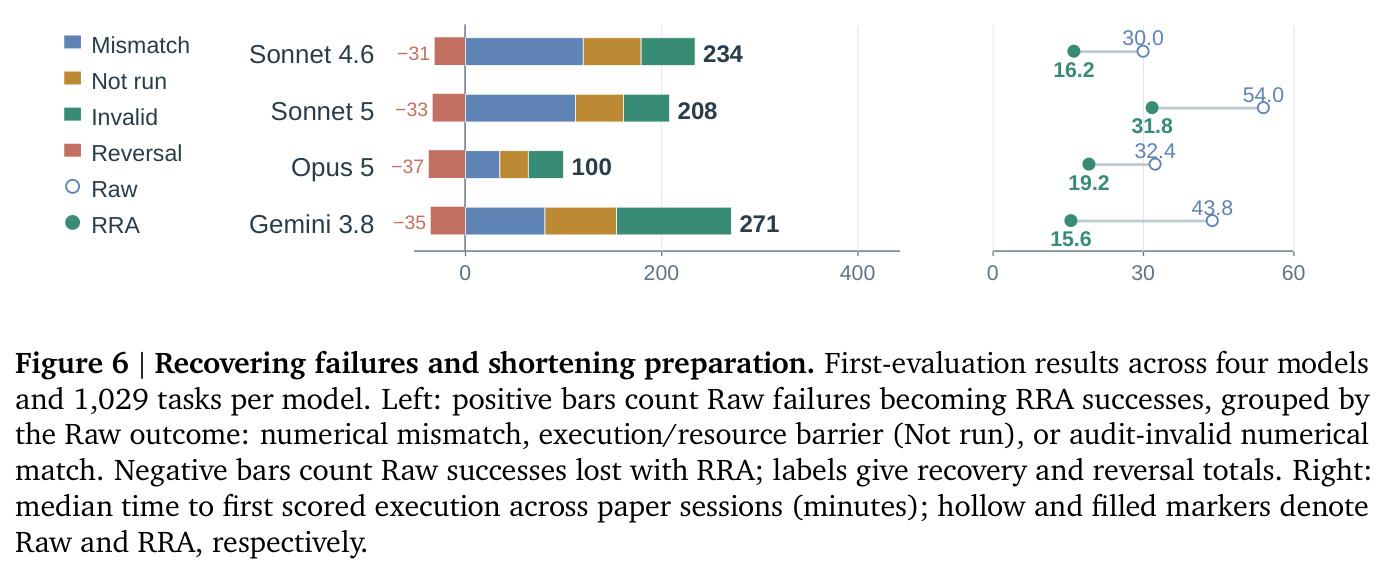
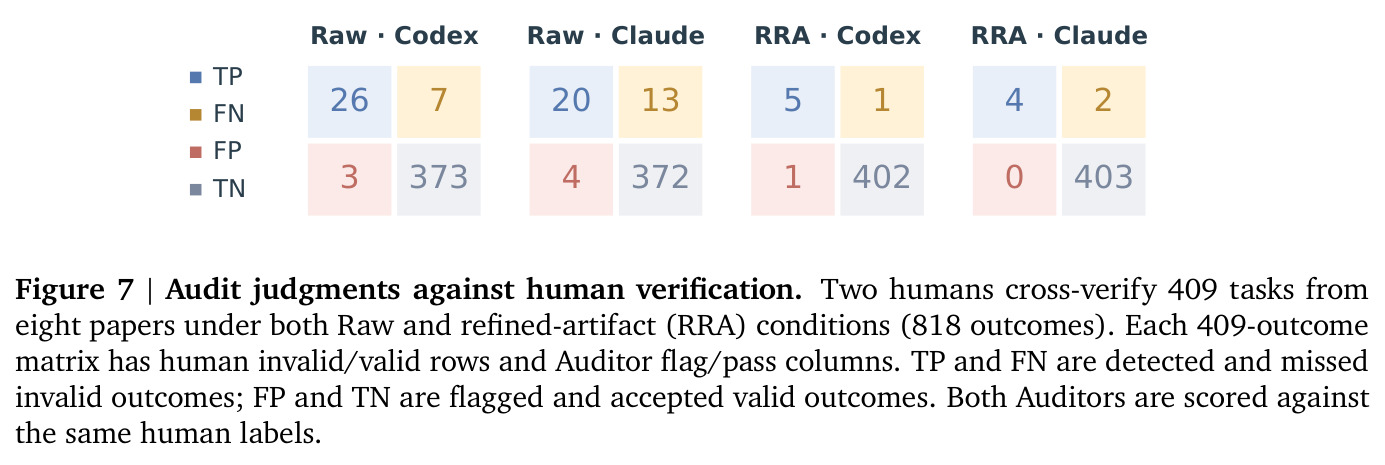
主实验(36 篇论文、1,029 任务、4 模型、3 次评测)显示精炼工件全面提升成功率并降低成本:Sonnet 4.6 从 72.3% 升到 91.6%(+19.3pp,API $3,165→$2,512);Sonnet 5 从 76.5% 到 93.3%(+16.8pp,$1,726→$1,317);Opus 5 从 89.2% 到 94.7%(+5.5pp,$3,480→$2,865);Gemini 3.8 Flash 从 67.6% 到 90.8%(+23.2pp,$392→$326)。平均成功率 76.4%→92.6%,API 平均省 19.7%,跨模型差距从 21.6 缩到 3.9pp,四个模型全部越过 90%。稳健性上:论文等权的 macro 口径增益 6.7–20.7pp;换更严的 80% 兼容区间增益 10.3–39.1pp(Gemini 47.7%→86.8%)。机制上,813 个原始失败被翻正(348 数值不匹配、210 未执行、255 审计判废)对仅 136 个反转;改代码的会话从 113/144 降到 54/144,首次计分执行中位时间全模型下降。外部验证:CORE-Bench Hard 45 个胶囊上 RRA 73.3% 胜过 VERITAS 68.9% 和 Raw 62.2%,每成功花费 $8.43→$4.34。消融(Sonnet 5,287 任务):完整 RRA 93.0%,去精炼代码 87.8%、去环境 88.5%、去指南 89.2%、去启动器 89.9%,普通产物 81.2%、原始代码 73.9%。审计质量:Codex 精确率 88.6%/召回 79.5%,Claude 85.7%/61.5%,对 779 个有效结果各误报 4 个。成本核算:构建 36 个工件花 $5,026($139.61/篇),按各模型节省速度,8/13/9 轮完整复用即可回本。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 1,029 个复现任务(36 篇 ICML 2026 Spotlight 论文,3 次评测) | 平均复现成功率(数值兼容且通过完整性审计) | RRA 工件:Sonnet 4.6 91.6% / Sonnet 5 93.3% / Opus 5 94.7% / Gemini 3.8 90.8%,均值 92.6% | 原始代码:72.3% / 76.5% / 89.2% / 67.6%,均值 76.4% | +5.5 到 +23.2 pp;跨模型成功率差距 21.6→3.9 pp |
| 复现任务的下游 API 成本(含失败尝试) | Reproducer API 花费(3 次评测均值) | $2,512 / $1,317 / $2,865 / $326 | 原始代码条件:$3,165 / $1,726 / $3,480 / $392 | 下降 16.8%–23.7%,四模型平均 19.7%;token 数同时减少 6.3%–19.8% |
| CORE-Bench Hard,45 个胶囊(外部基准,Sonnet 5 构建) | 胶囊成功率 / 每成功 API 花费 / 中位会话时长 | RRA:73.3% / $4.34 / 14.4 分钟 | Raw 62.2% / $8.43 / 33.0 分钟;VERITAS 68.9% / $6.78 / 24.5 分钟 | 成功率 +11.1 pp,花费近乎减半,时长缩短 56% |
| 组件消融(Sonnet 5 构建,12 篇论文 287 任务,单次评测) | 任务成功率 | 完整 RRA 93.0%;移除精炼代码 87.8%、环境 88.5%、指南 89.2%、启动器 89.9% | 普通产物(代码+脚本+日志)81.2%;原始代码 73.9% | 完整工件比普通产物 +11.8 pp;代码与环境移除损失最大 |
| 数值兼容严格化(同一批任务换用 80% 区间,首次评测) | 任务成功率 | RRA:88.2% / 90.5% / 92.3% / 86.8% | Raw:61.3% / 63.9% / 82.0% / 47.7% | +10.3 到 +39.1 pp;评分收紧后增益反而更大 |
局限与改进
作者承认的限制:评测以保留的 36 篇论文、固定参考区间和受测智能体为条件,不代表全会议的复现率;5 次参考执行是协议选择而非充分的方差估计保证;数值兼容不等于科学正确或对设定实验的完全忠实,精炼工件也可能固化错误假设;自动审计有漏检(人工确认的 39 个无效结果中 Codex 漏 8 个、Claude 漏 15 个);API 节省只计下游会话,不含构建、验证、GPU 与维护成本。我的补充观察:主实验的构建者与一个被测复现者同为 Opus 5,可能存在同族模型红利,尽管外部消融换用 Sonnet 5 构建后结论仍成立;「以论文为准」的冲突解决策略在论文本身有笔误时会系统性固化错误——反转案例集中于 AuxiliaryMCMC(50 个)与 LiME(14 个),合计占 136 个反转的 47.1%,恰说明此类任务对工件化最不友好;三份评测全部基于闭源商用模型与 8×H100 的算力设定,开源小模型和学术算力下的结论外推性未知;$5,026 的构建成本按「每轮全量复用」分摊,忽略了工件随代码库演化的维护折旧。
独立分析的弱点
弱点一:参考真值依赖每任务 5 次人工执行,成本极高、难以规模化——这正是 1,463 个任务只有 70.3% 进入评测的原因之一。改进方向:用多次智能体执行加方差校准近似参考分布,人工只复核边界案例,把参考构造的成本降一个数量级。弱点二:工件可能成为隐性偏置载体——指南记录的修复理由若来自构建模型的误判,下游会话会高置信度地继承错误,136 个反转中 84 个正是数值不匹配。改进方向:对高影响歧义条目做双模型交叉构建对照,或在指南中标注置信度与备选方案供下游选择。弱点三:任务定义只覆盖主表 own-method 测量,基线、独立消融、图和附录结果全部排除,而复现研究中这些部分恰恰最常出错。改进方向:扩展任务类型并按结果重要性分层报告。弱点四:跨模型比较因各家 harness 不同被作者自己承认只是描述性的,但摘要与图 1 仍以模型间对比呈现,读者容易过度解读绝对排名;改进方向是统一 harness 重跑关键对照。弱点五:成功判据是二值的区间落点,「差 0.5% 但趋势正确」与「差一个数量级」同样计 0 分,丢失梯度信息;可补充分级或加权评分作为次要指标。
未来方向
作者提出的方向:把 ReproBridge 用作论文投稿前的可复现性自检,让作者在发布前发现缺失细节、执行障碍与论文-代码不一致(配套静态分析已记录 238 处矛盾、涉及 669 个任务);评估人类研究者复用工件的效果与理解收益;完整核算构建、验证与维护的全生命周期成本。可延伸的方向:把四组件协议接入会议 artifact evaluation,作为标准化提交物;研究工件随代码库演化的增量更新机制——论文修正或依赖升级后如何低成本重蒸馏指南与变更记录;把「兼容区间 + 完整性审计」的评分思想迁移到 SWE-bench 类执行型基准,它们同样面临改数字作弊风险;探索跨论文工件库与语义检索,让复现知识成为可累积、可检索的社区资产;在开源模型上验证「执行知识补偿能力差距」的结论是否对更弱的模型同样成立,这关系到该结论对学术社区的实用价值。
复现评估
复现这篇论文本身难度很高。协议细节(任务定义、兼容区间公式、审计规则、指南十二节结构、验证与证据留存规程)在附录中有完整描述,项目页公开(wyyyb.github.io/reprobridge_website/),但正文未说明 36 篇论文的原始仓库快照、人工参考执行记录与构建产物是否全部开源。即便开源,完整复刻需要:每任务 5 次参考执行的多人与多服务器投入;Sonnet 4.6/5、Opus 5、Gemini 3.8 Flash 及 Codex/Claude 审计的商用 API 配额;GPU 任务的 8×H100 与每论文 24 小时时限(1,029 个任务中 730 个需 GPU);构建 36 个工件即花费约 $5,026 API 费,三次主评测的下游 API 花费合计数万美元。对普通研究者的现实路径是:不复制基准,而是借用其工件协议(四组件 + 变更记录格式)与「数值兼容 + 完整性审计」的评分思想,在自己关心的几篇论文上做小规模对照——一个中等模型加数百美元即可验证「固化执行知识」在自己的领域是否同样有效。
论文图表
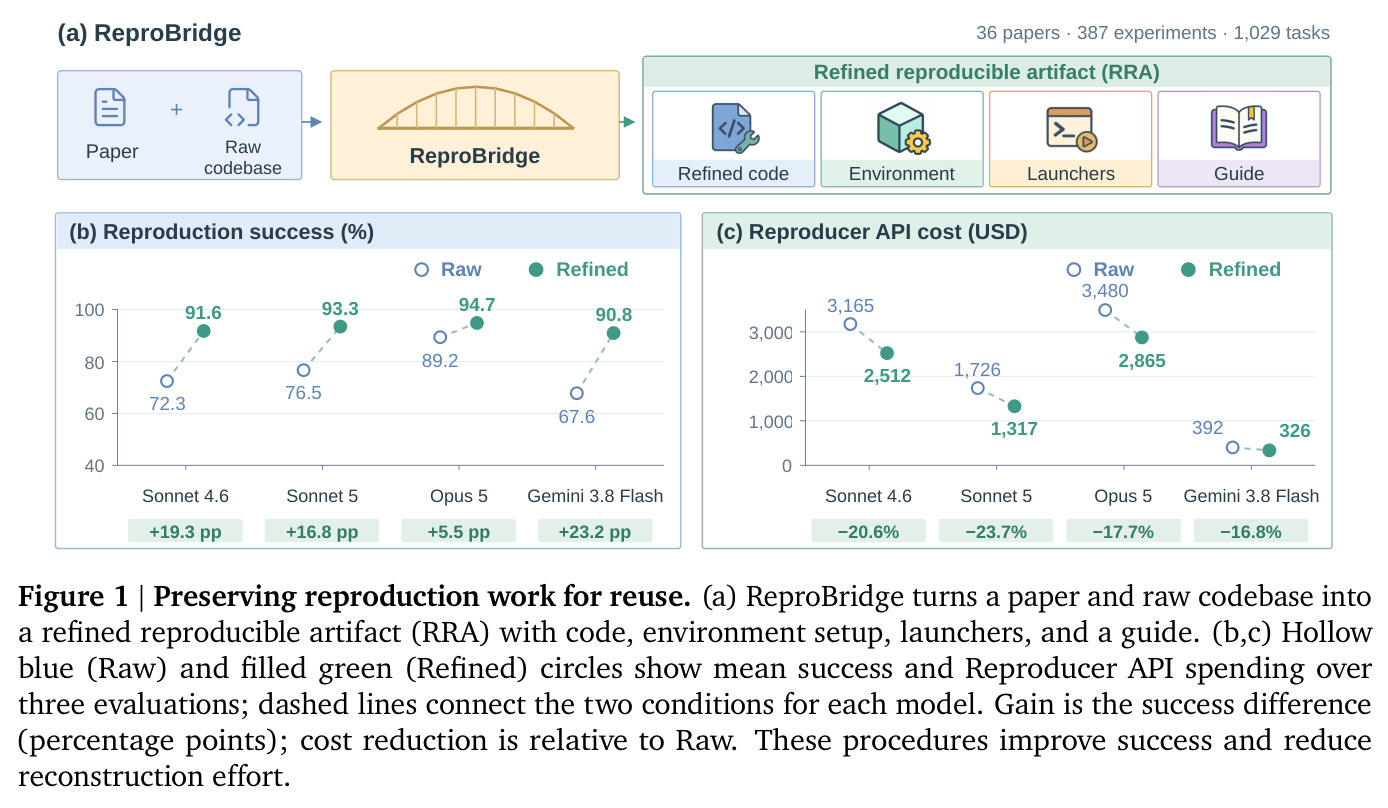
论文总览图。(a) 展示 ReproBridge 如何把论文+原始代码库转化为含精炼代码、环境配置、启动器、指南四组件的 RRA;(b) 四个模型在 Raw(空心蓝)与 Refined(实心绿)条件下的复现成功率(72.3→91.6、76.5→93.3、89.2→94.7、67.6→90.8);(c) 对应的 Reproducer API 花费对比与降幅(−16.8% 到 −23.7%)。
一张图讲清全文的问题设定、方法产出与两大核心结论(成功率提升 + 成本下降),是理解论文贡献的最快入口。
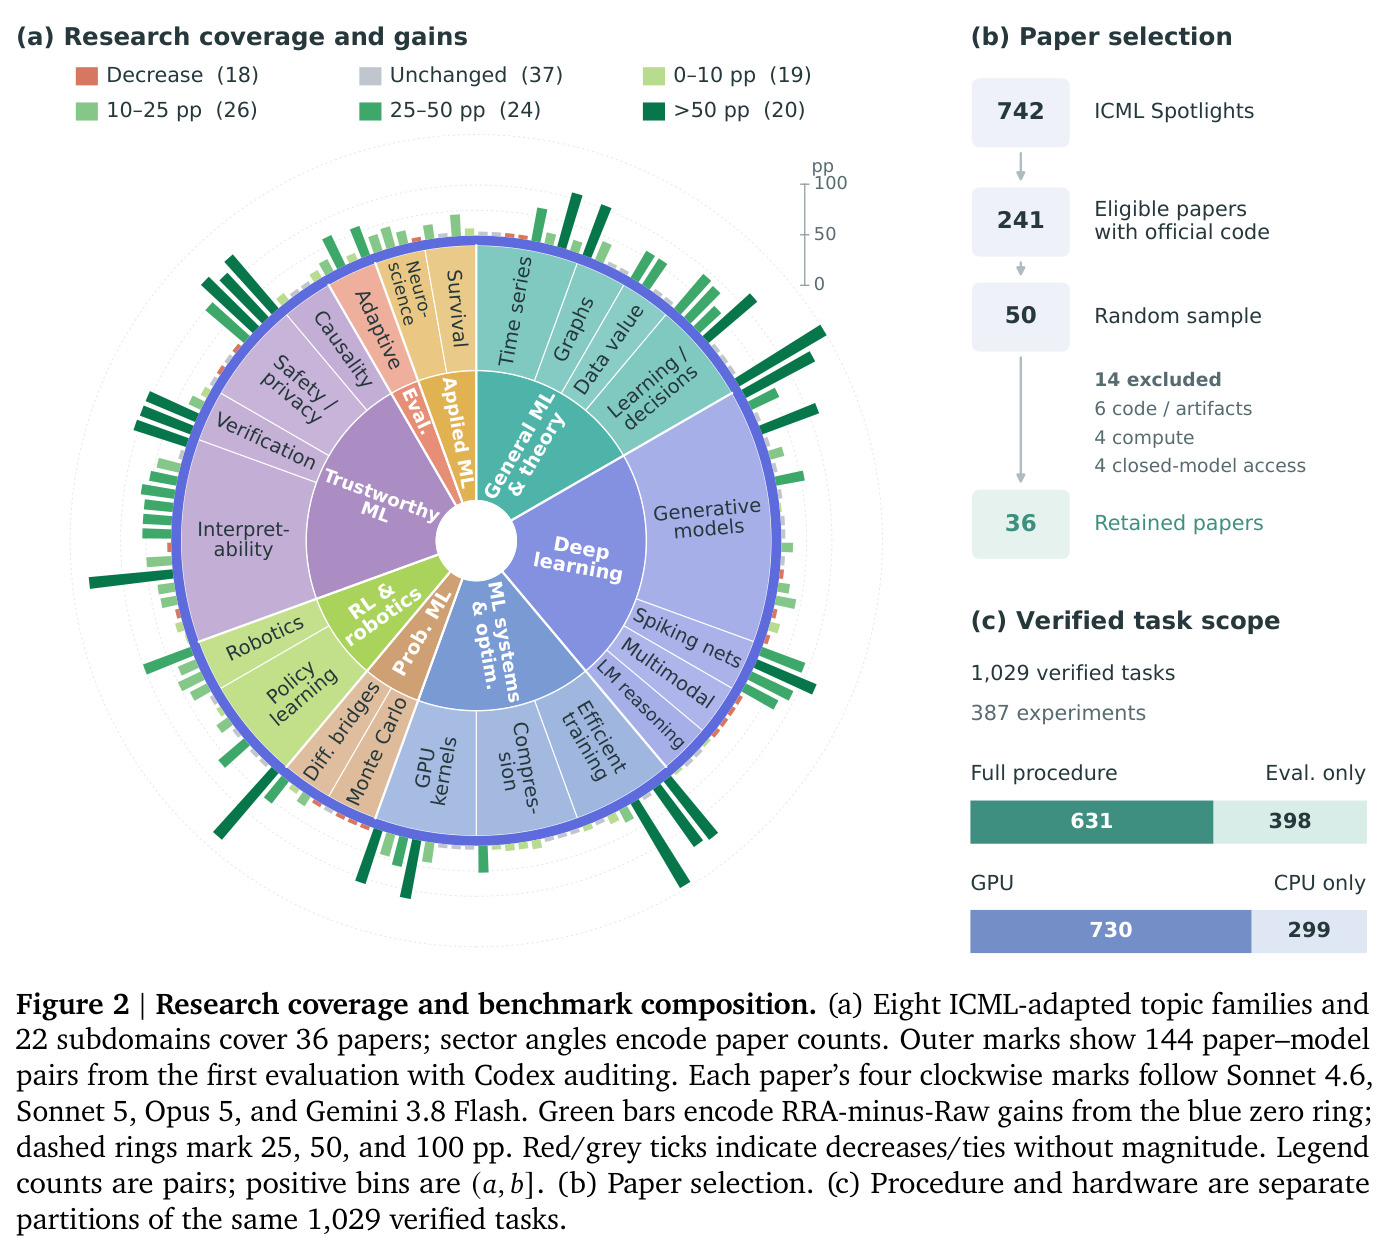
(a) 36 篇论文按八个 ICML 适配主题族与 22 个子域的研究覆盖,及 144 个论文-模型对的 RRA−Raw 增益分布;(b) 论文筛选漏斗:742 篇 ICML Spotlight → 241 篇有官方代码 → 随机 50 篇 → 剔除 14 篇后保留 36 篇;(c) 1,029 个验证任务的划分:631 全流程 vs 398 仅评测、730 GPU vs 299 CPU。
说明基准的代表性来源与构成,让读者判断结论的适用范围——哪些领域覆盖了、任务难度和算力需求如何分布。