NPCBench:面向鼻咽癌多模态诊疗路径推理的临床学徒式基准 NPCBench: A Clinical Apprenticeship Benchmark for Multimodal Care-Pathway Reasoning in Nasopharyngeal Carcinoma
模拟专科医师成长路径,揭示高单项分数难转化为患者级联合正确
前置知识
鼻咽癌(NPC)的诊疗路径
鼻咽癌(Nasopharyngeal Carcinoma)高发于华南与东南亚,诊断与分期必须整合组织病理、多序列 MRI 和血浆 EBV DNA 三类证据。临床管理遵循 NCCN 与 CSCO 两大指南,分期采用 AJCC/UICC 第九版 TNM 系统;治疗与随访中,肿瘤应答、治疗毒性和复发进展都会不断改变后续决策,使诊疗呈现典型的“多模态证据 + 时序决策链”结构。
NPCBench 全部任务都构建在这条证据密集、步序耦合的临床流水线上,理解 NPC 的诊疗路径才能理解任务设计与评分逻辑。
TNM 分期(T/N/M)
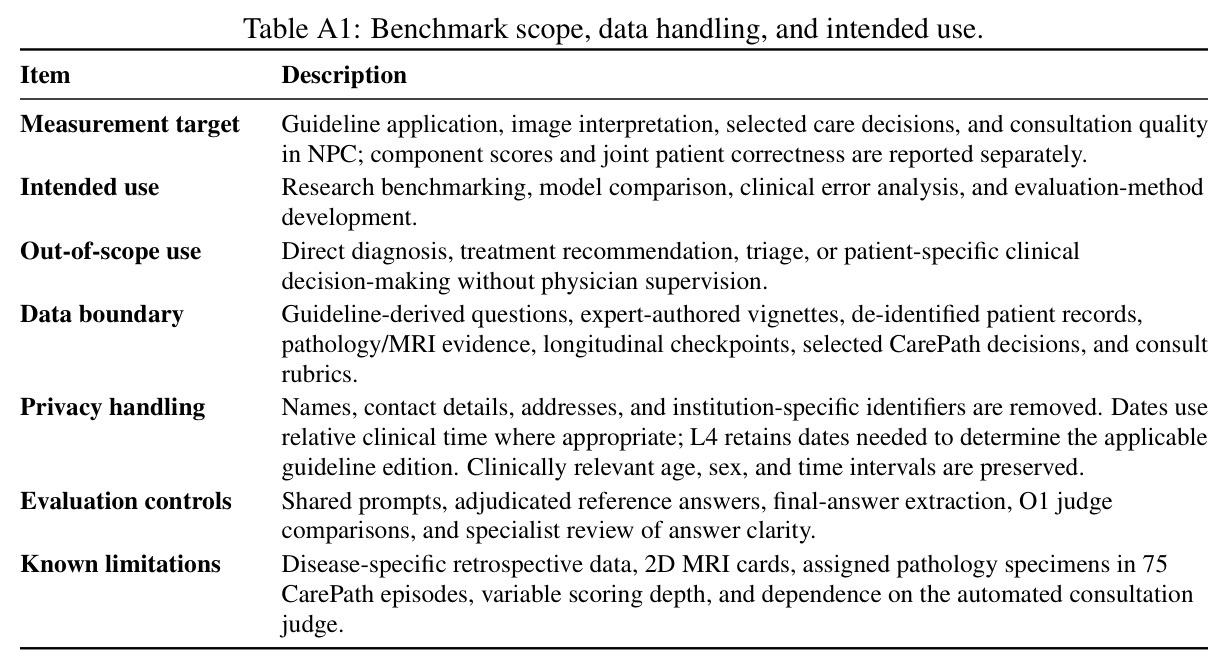
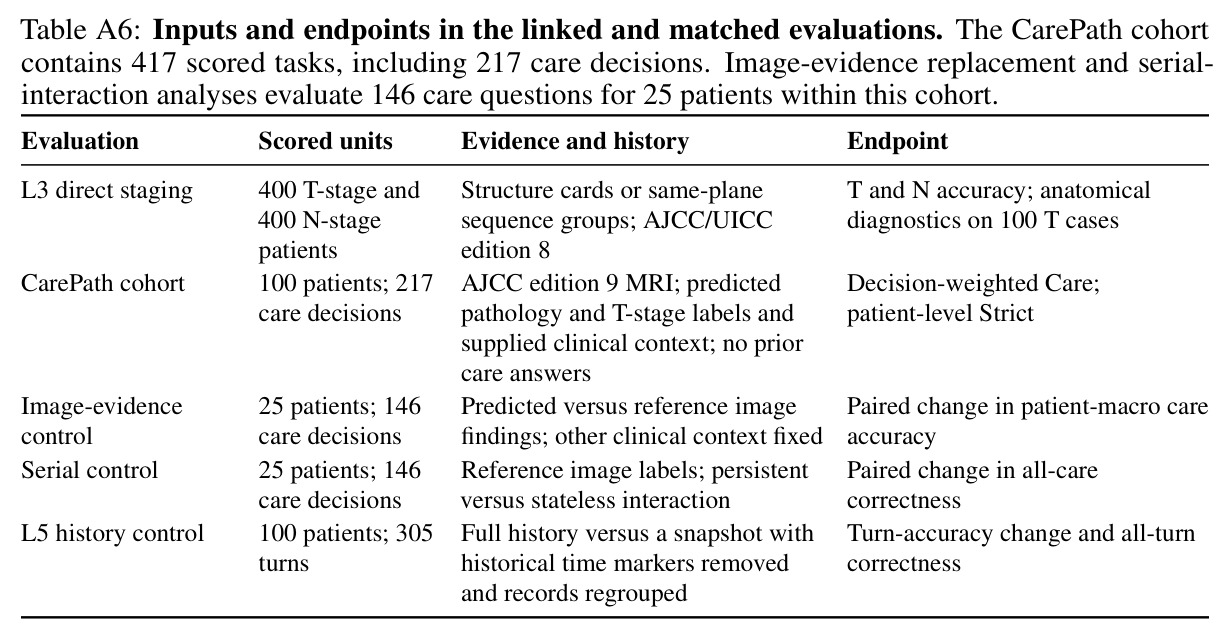
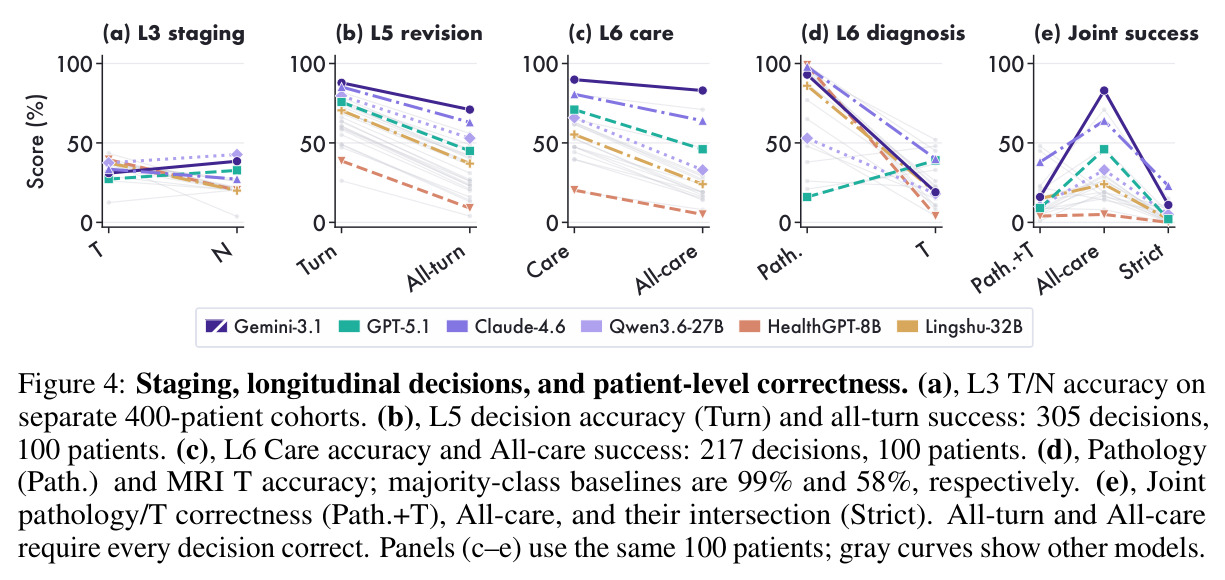
恶性肿瘤通用的分期语言:T 描述原发肿瘤侵犯范围,N 描述区域淋巴结转移,M 描述远处转移。NPC 的 T 分期依赖 MRI 判断肿瘤对咽旁间隙、颅底、海绵窦等约 18 类解剖结构的侵犯程度,N 分期依据颈部淋巴结影像特征,分期结论直接决定放疗剂量与化疗组合。本文的 T/N 分期评测分别采用互不重叠的 400 例患者队列。
L3 与 L6 的图像任务核心就是 T 分期与结构侵犯判断,“分期标签对但证据错”是本文最关键发现的载体。
患者级联合正确(episode-level 评估)
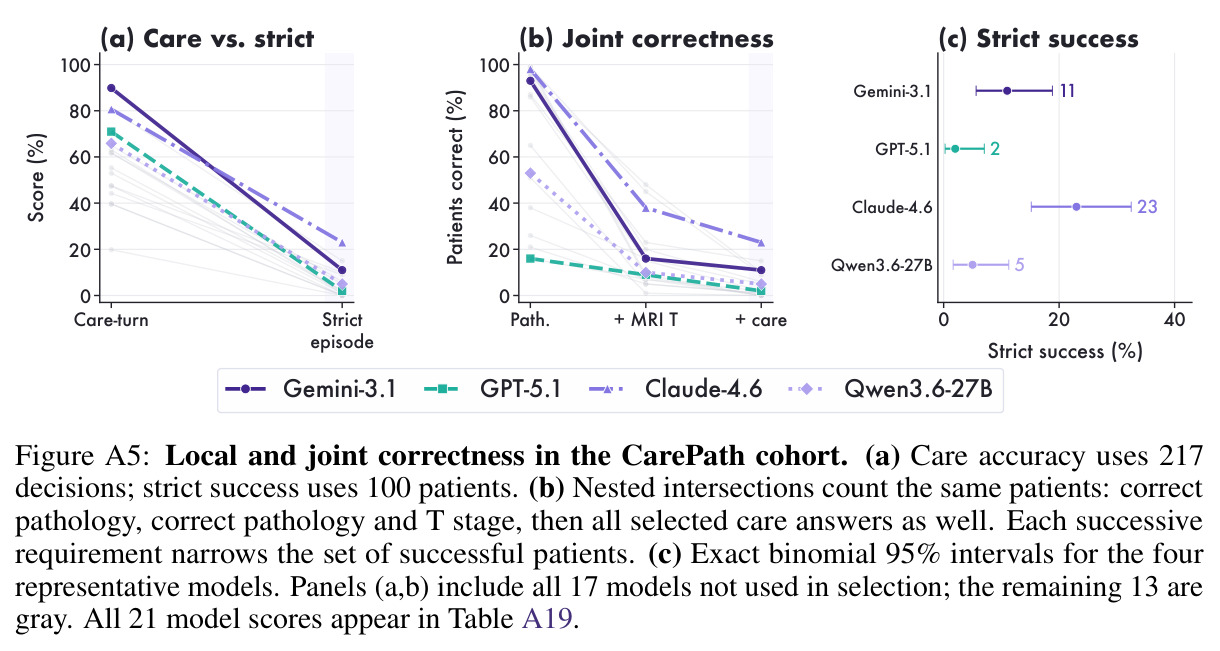
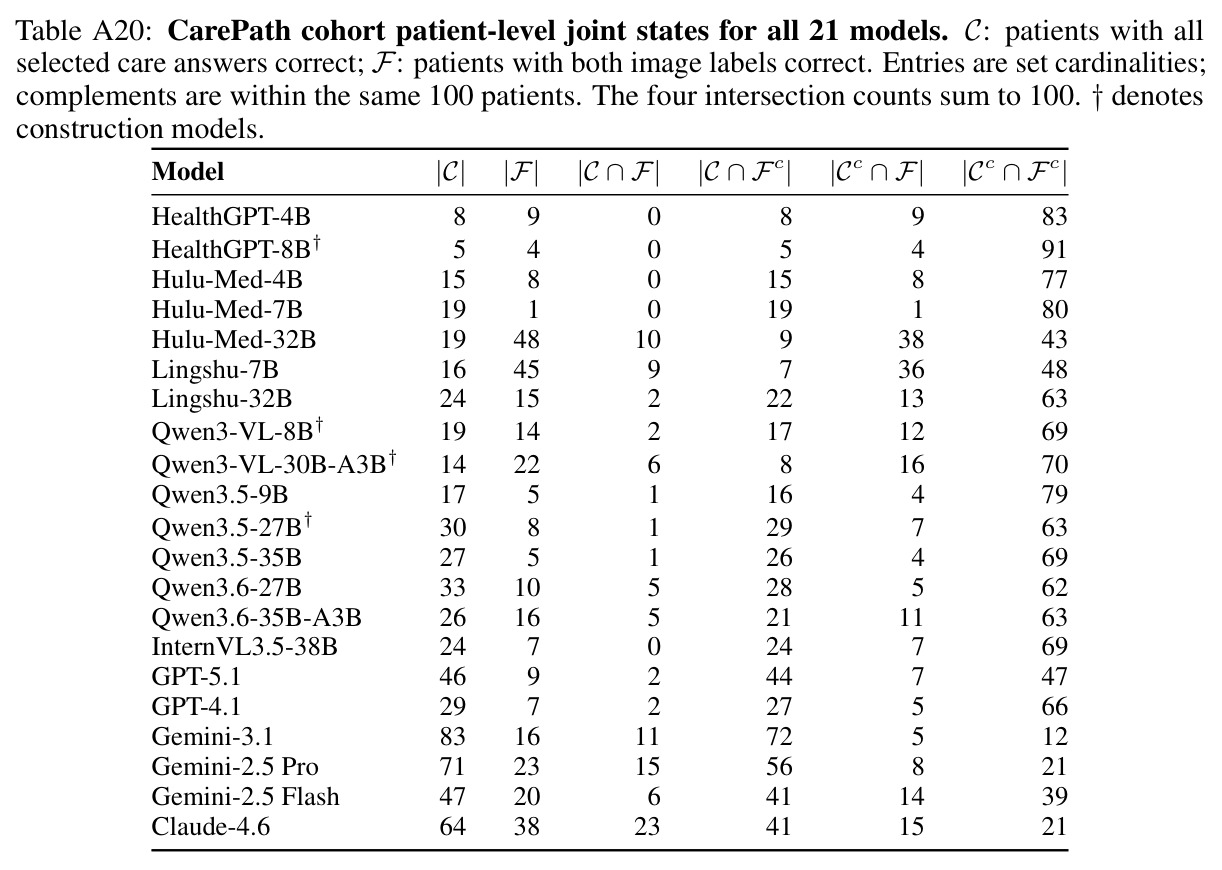
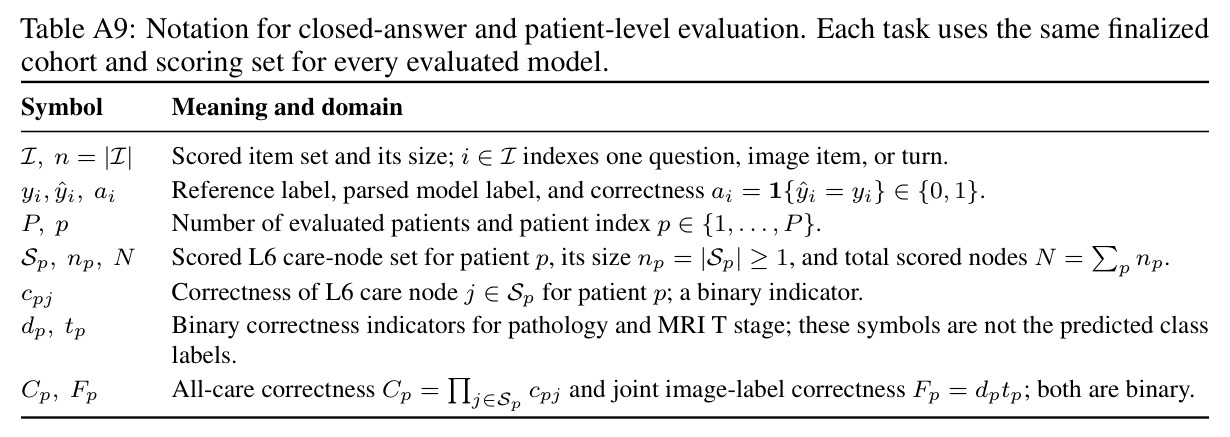
与按题计分不同,患者级评估要求同一名患者的全部评分决策都正确才算成功。若每步正确率为 $p$,$n$ 步全对的概率约为 $p^n$,错误沿决策链复合放大。NPCBench 的 Strict 指标要求病理、MRI T 分期和全部照护答案在同一患者上联合正确,而 Care 只统计单条决策的准确率,两者并列才能暴露分数塌缩。
这是全文的中心测量思想,“组合鸿沟”只有靠患者级指标才能被暴露出来。
LLM-as-Judge 与 Rubric 评分
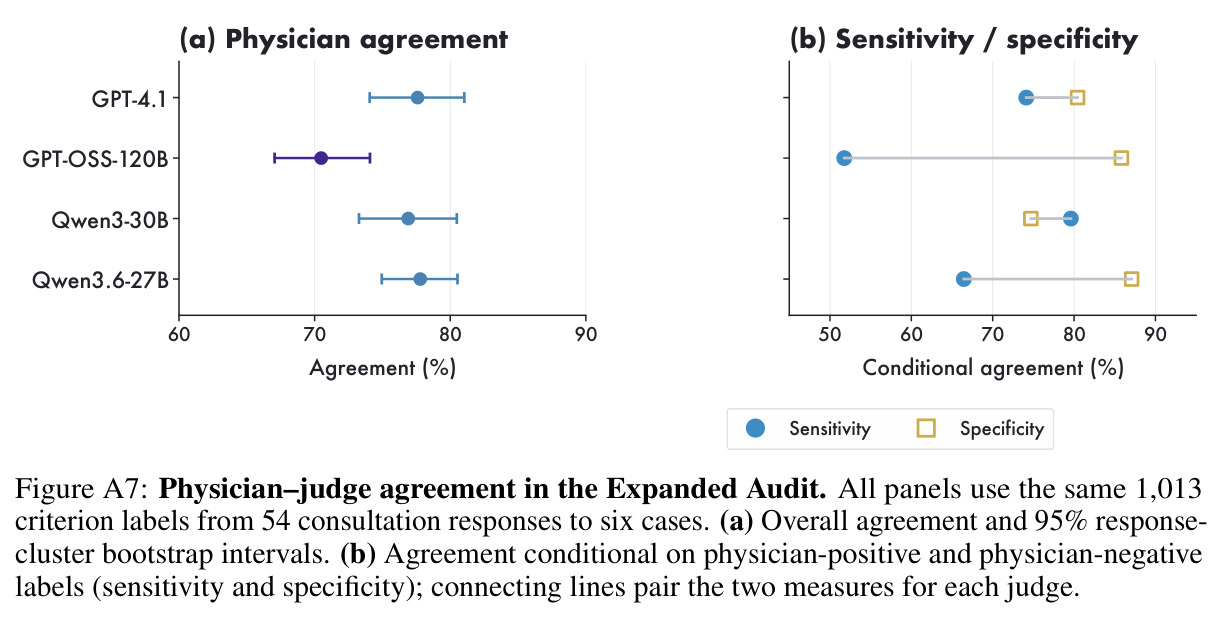
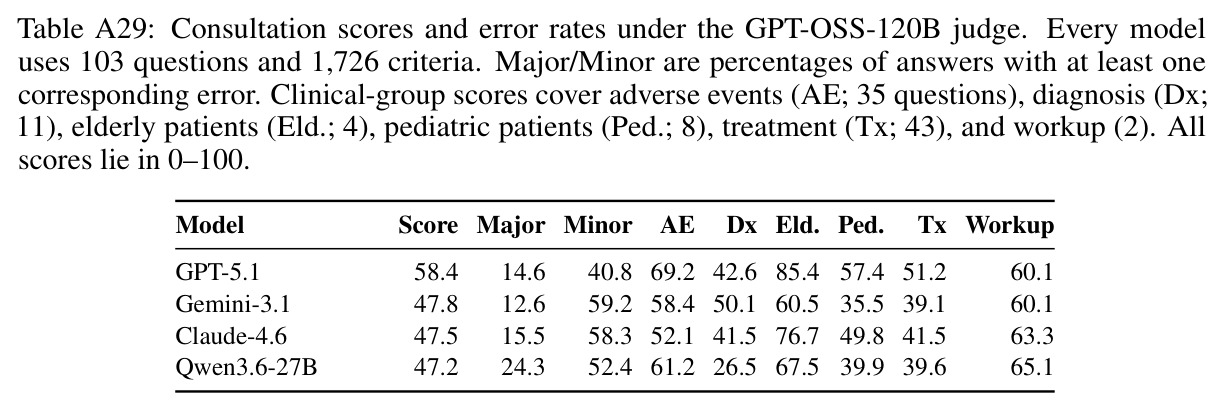
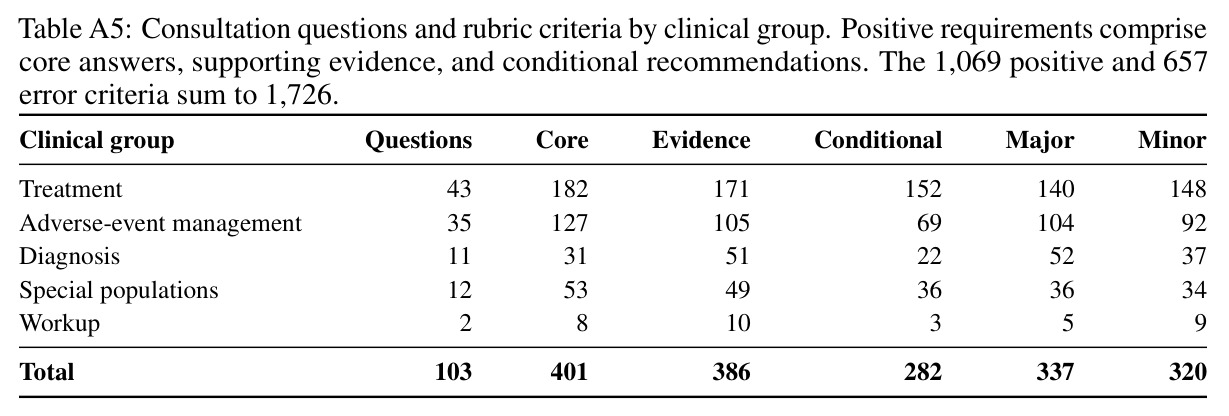
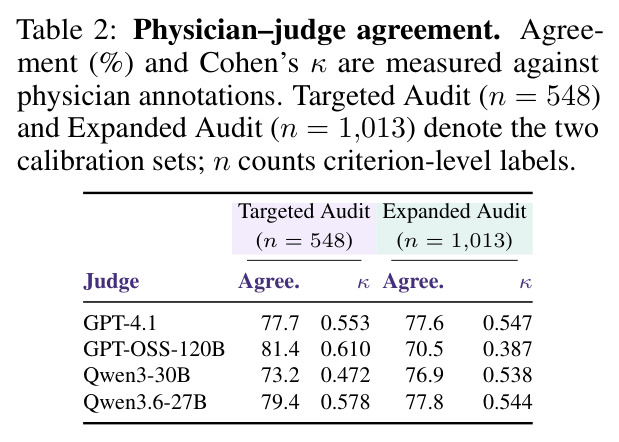
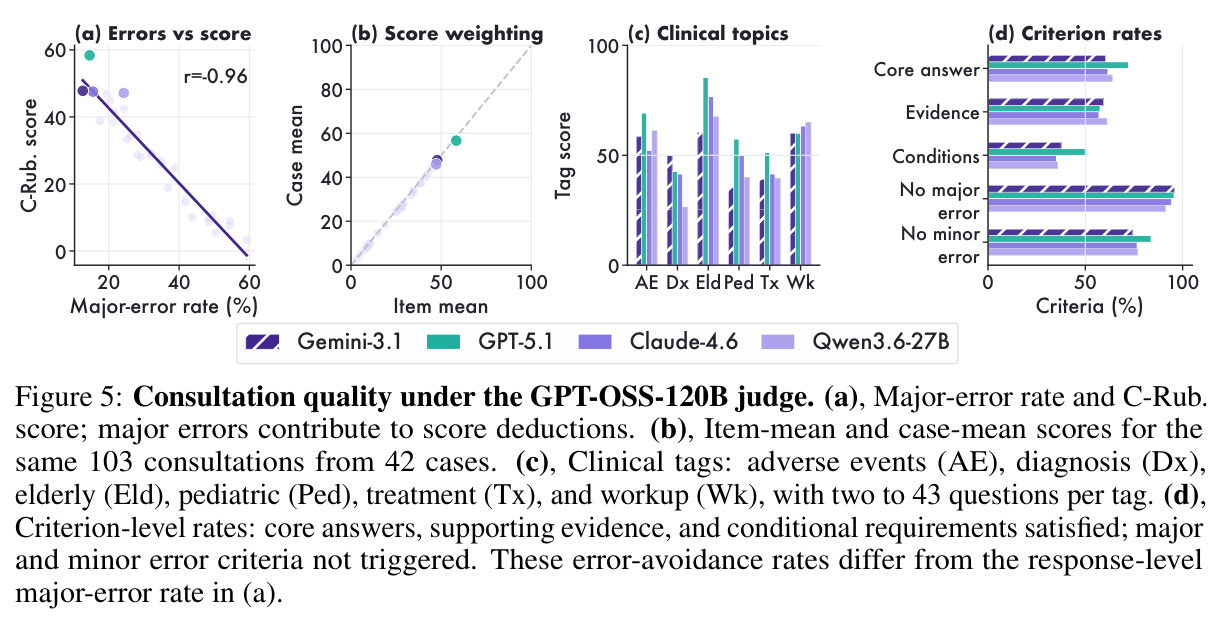
用强模型自动评判开放式文本回答:O1 套件为 103 次问诊制定了 1,726 条评分细则(1,069 条正面要求、657 条负面错误项),满足正面要求按权重加分,触发重大/轻微错误分别扣 2 分和 1 分,汇总后下限为零并归一化到 0–100。裁判可靠性通过与医师标注对照校准,报告一致率与 Cohen's κ,并区分敏感度(发现正确项)与特异度(不误判错误项)。
开放式问诊无法用选择题打分,理解 rubric 裁判机制及其偏差才能正确解读 O1 的分数与模型排名。
配对对照实验
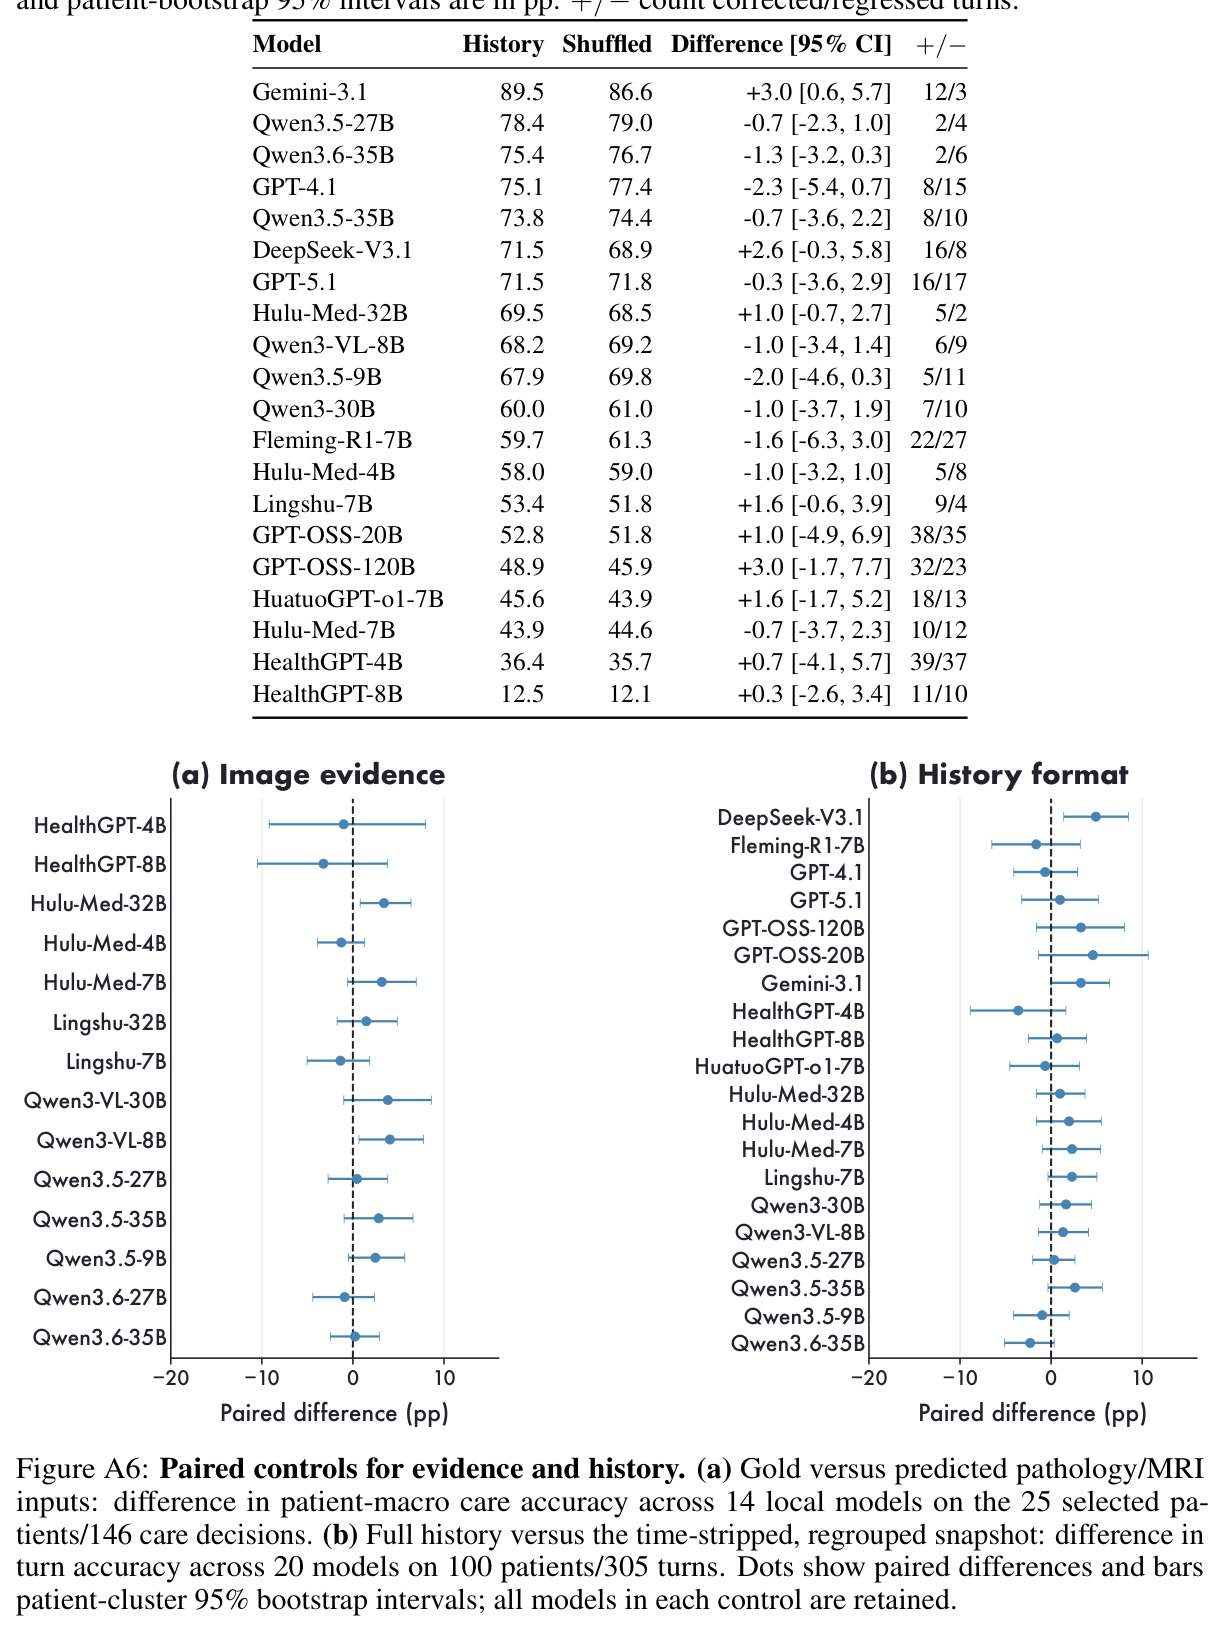
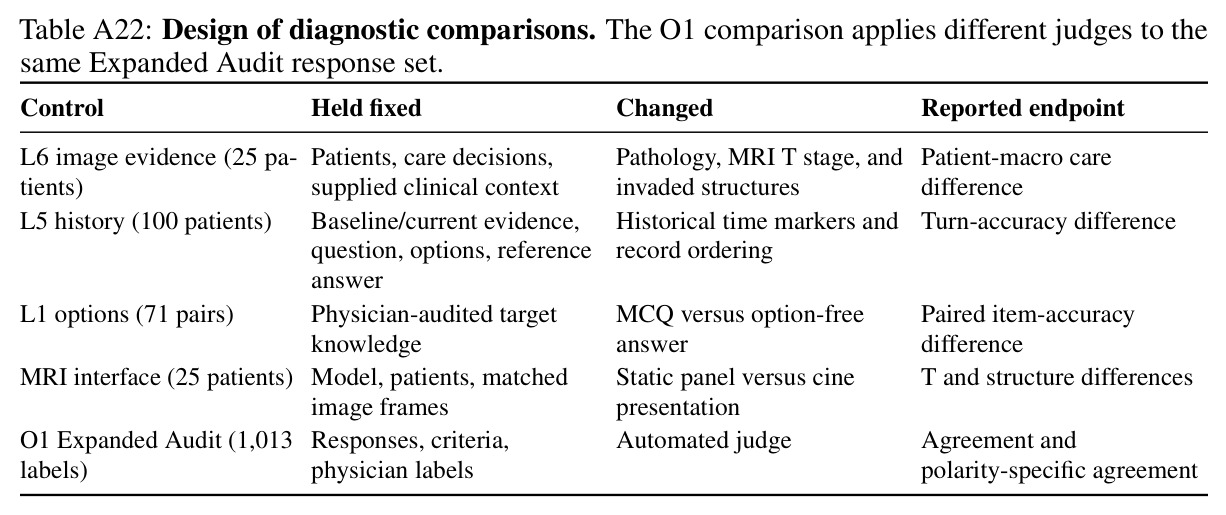
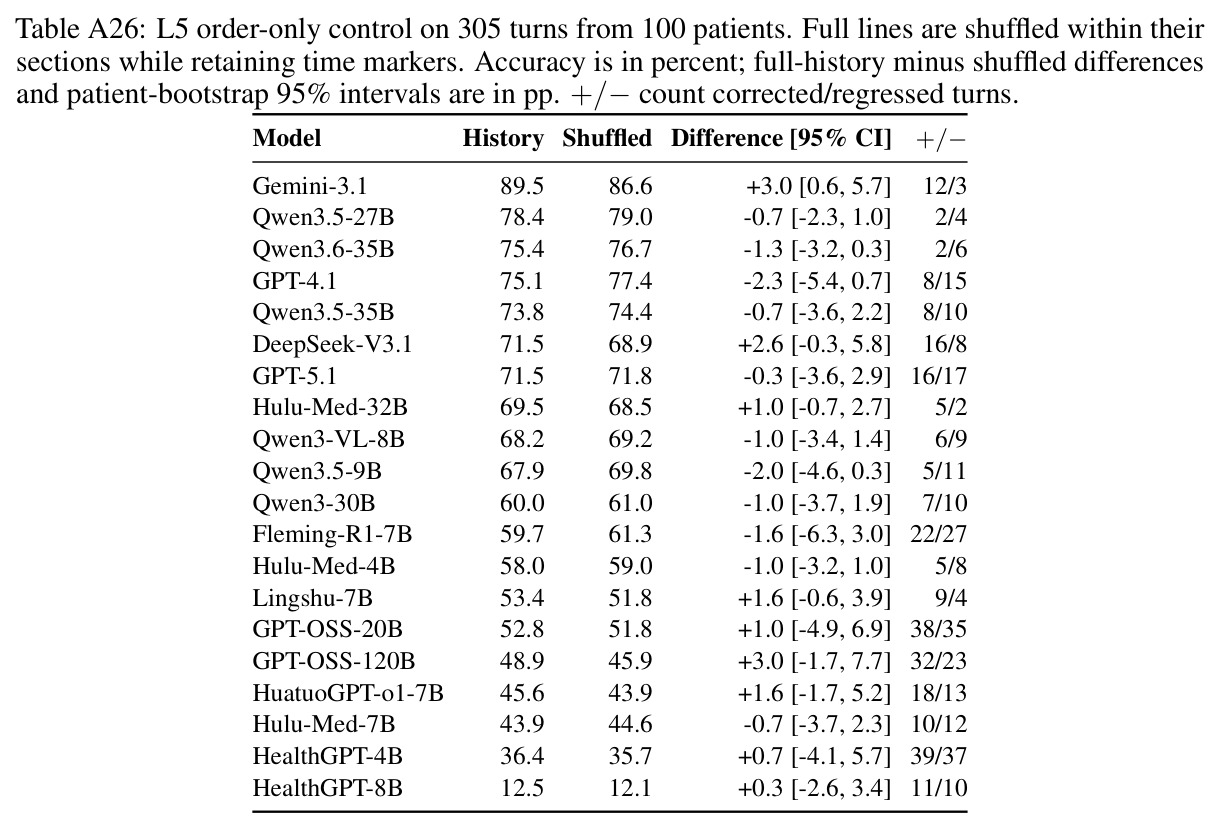
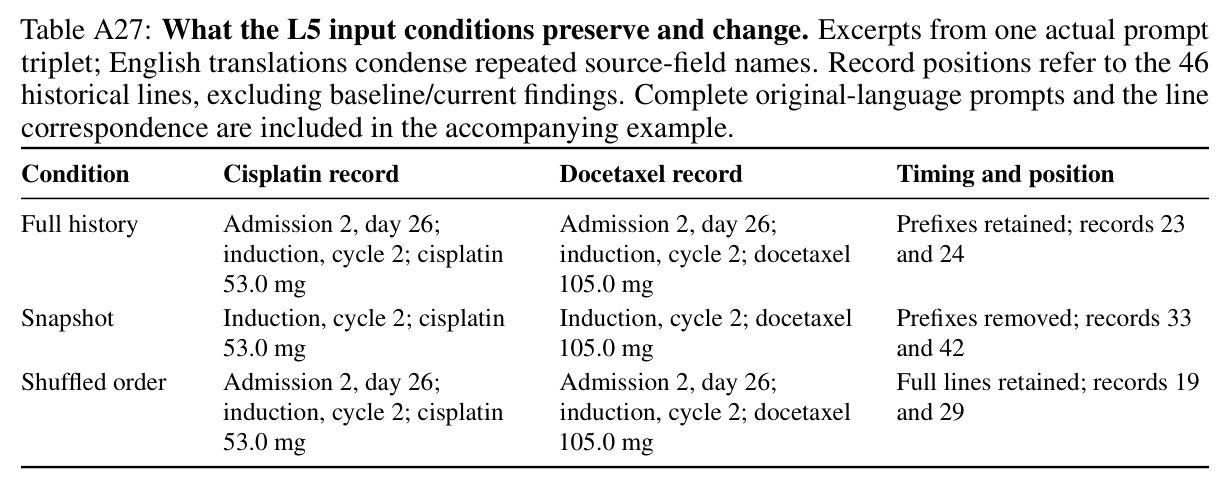
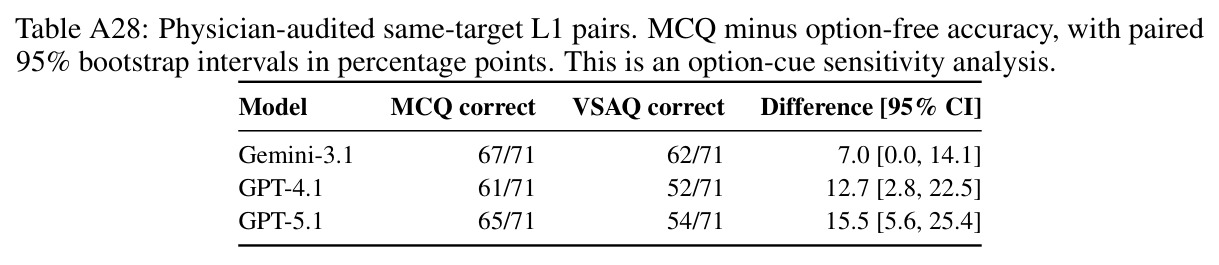
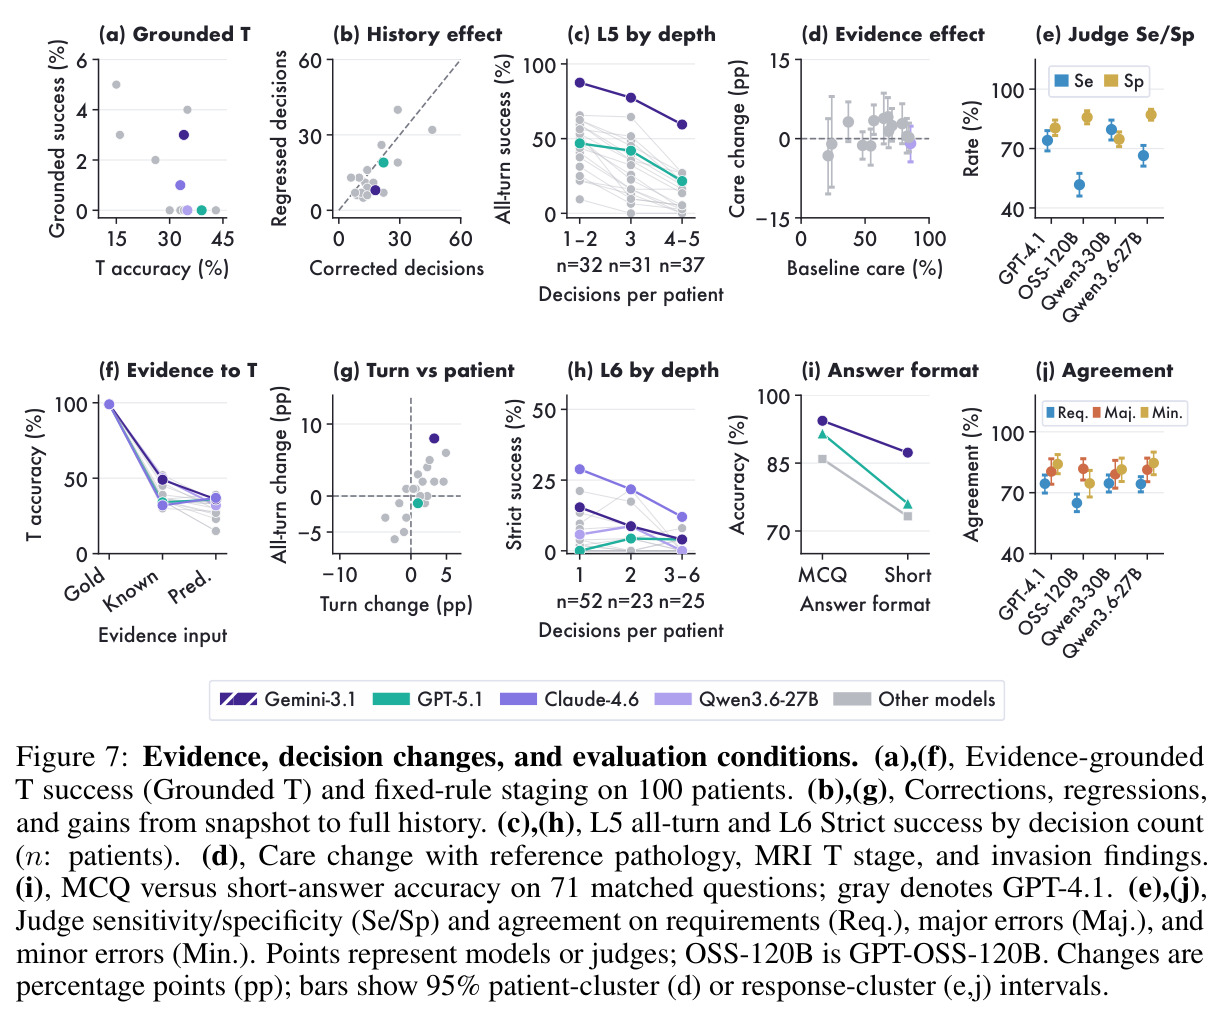
固定患者与问题不变,只改变一个实验条件(如去掉选择题选项、用参考影像替换模型预测、打乱记录顺序但保留时间戳),比较模型表现的系统性变化,从而把分数差异归因到具体因素。本文用它检验答案格式线索、时间信息价值和证据锚定,报告配对差值(pp)与患者聚类的 95% 置信区间。
论文不只是给分数,而是用对照实验做因果诊断,这是读懂 4.2–4.5 节大量 pp 级结论的前提。
研究动机
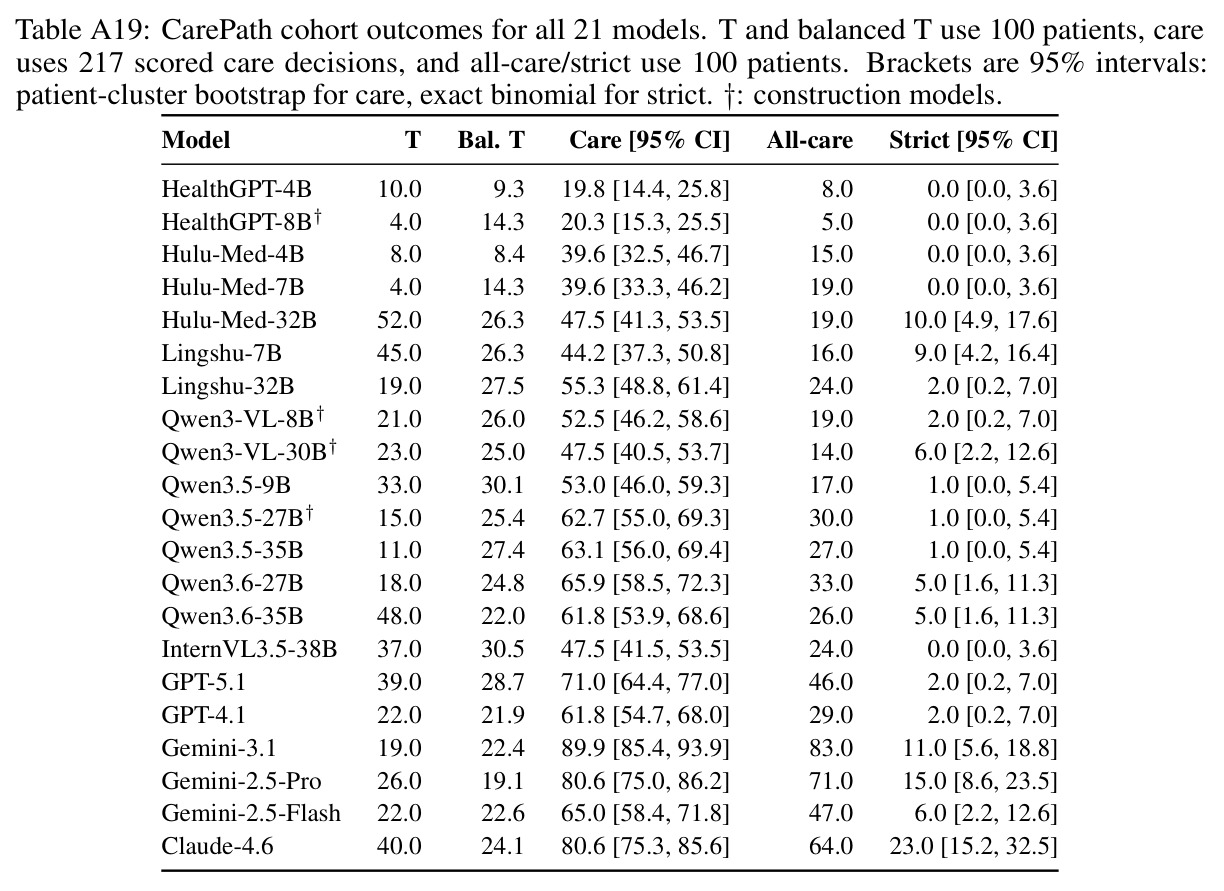
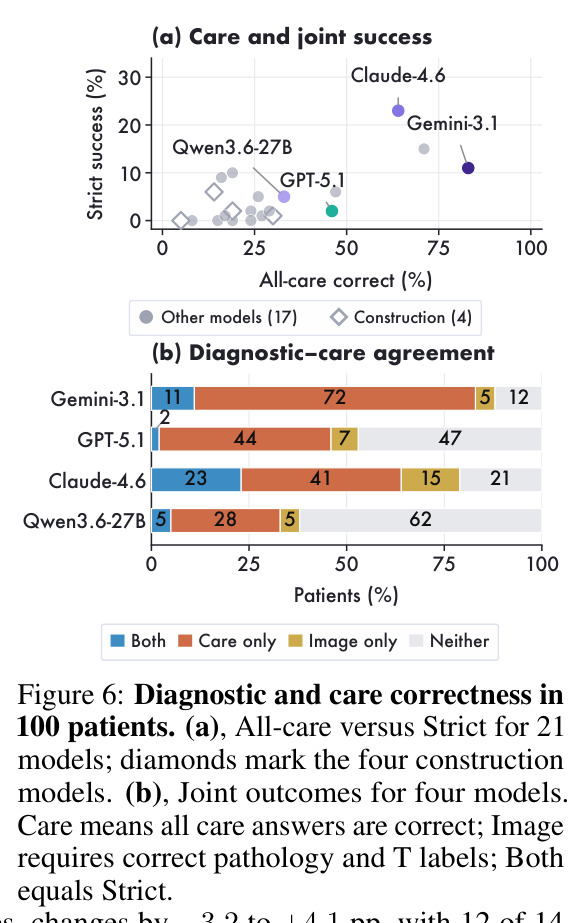
现有医学基准普遍把临床能力拆成孤立的考查点:MedQA、MedMCQA、PubMedQA 等考试式问答只测事实记忆,VQA-RAD、SLAKE 等只测单图理解,HealthBench、MedDialogRubrics 等静态病例或 rubric 评估无法跟踪病情演化。这些基准按题计分,回答不了专科诊疗的核心问题:模型能否把亚专科指南与多模态证据整合起来,并在整个诊疗过程中持续跟踪患者状态?本文用数据揭示了问题的严重性:指南记忆最高可达 94.0%(Gemini-3.1-Pro-Preview,L1),但同一模型在 CarePath 病例上的照护决策准确率 89.9%,严格患者级成功却只有 11.0%——100 名患者中有 72 人“全部照护决策都正确,却至少有一个病理或 MRI 分期标签错误”。也就是说,看似漂亮的答题分数可能建立在完全错误的视觉证据之上,按题计分的范式系统性地掩盖了这种“证据-决策脱节”。
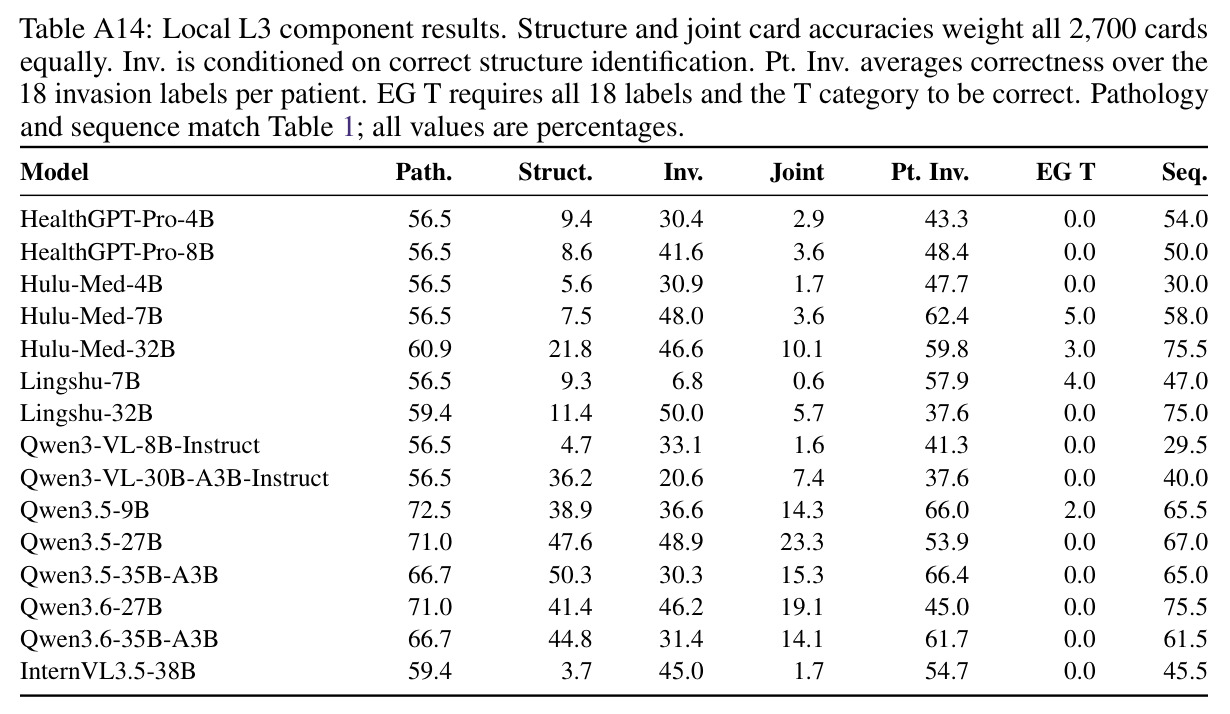
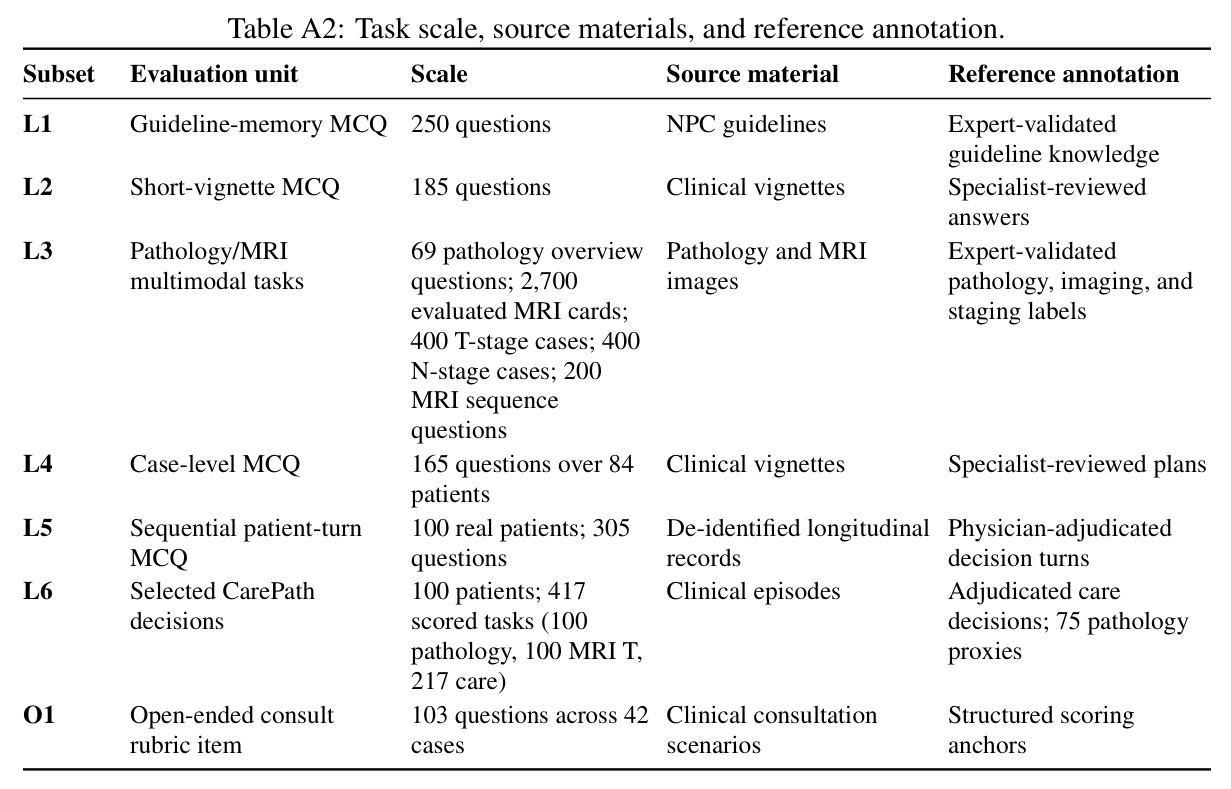
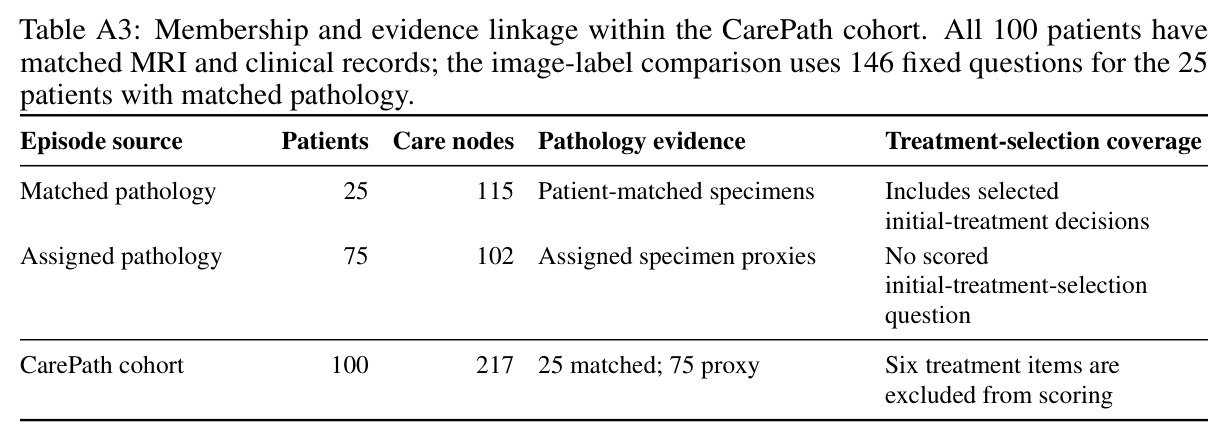
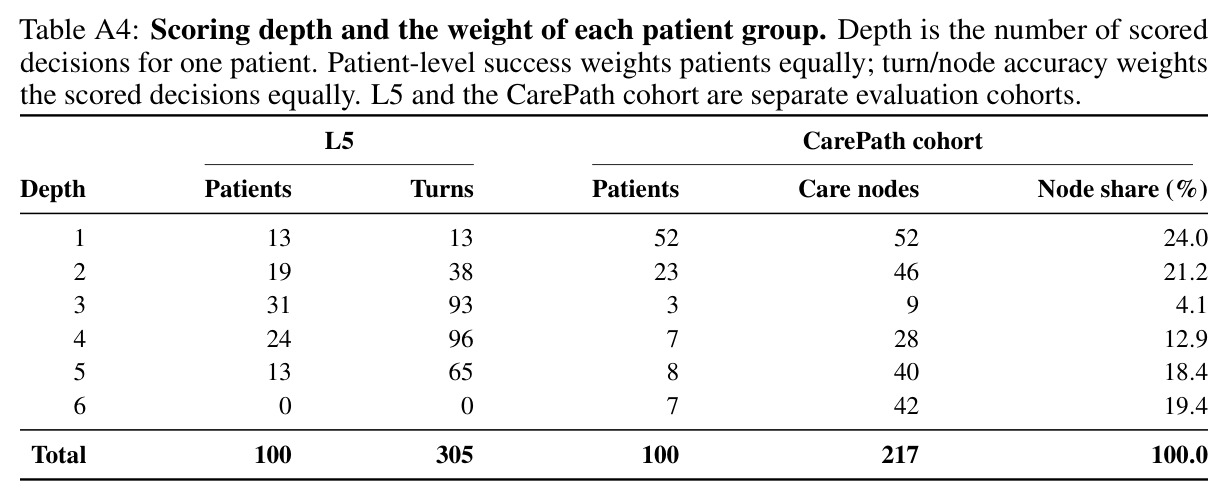
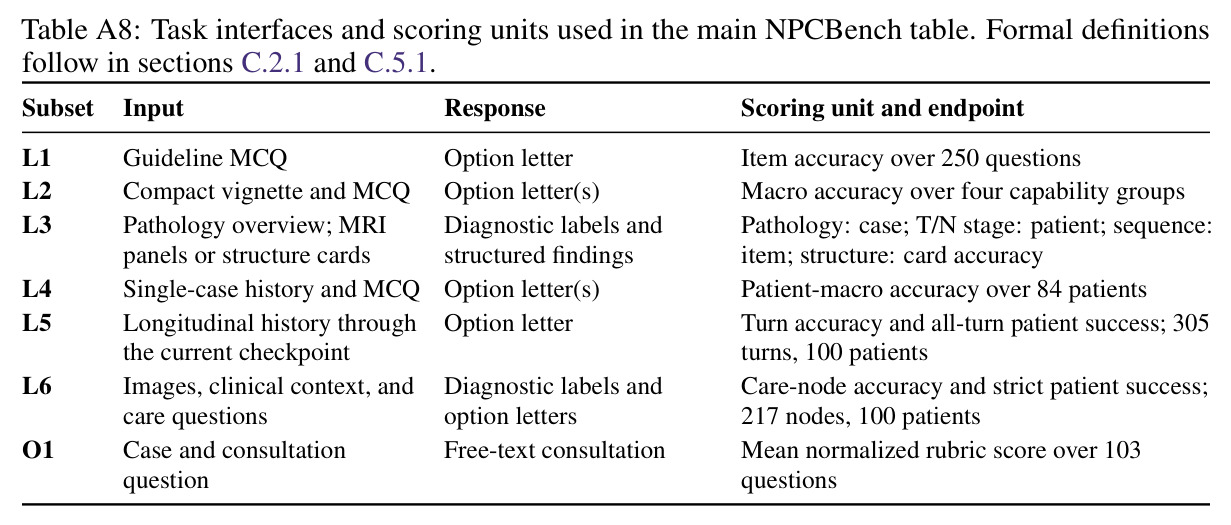
本文的目标是本文要构建一个模拟专科医师学徒式成长的疾病特异性基准 NPCBench,把医学 AI 评测从“答题”推进到“跟诊”。具体目标落在三层数据规模上:4,777 道组件与问诊条目(L1 指南记忆 250 题、L2 原子应用 185 题、L3 多模态锚定含病理 69 例与 MRI 约 1,000 例及 2,700 张结构卡片、L4 病例规划 165 题、L5 纵向修订 305 题、O1 问诊 103 项),以及一个 100 名患者的 CarePath 队列、含 417 个评分任务。测量上要回答四个研究问题:RQ1 指南知识能否转化为病例级规划;RQ2 分期预测是否建立在正确的视觉证据上;RQ3 模型能否随病史修订决策并达到患者级成功;RQ4 问诊是否安全、自动裁判是否可靠。共评测 30 个医学与通用模型(21 个多模态),并用配对对照与医师校准量化每个结论的置信区间。
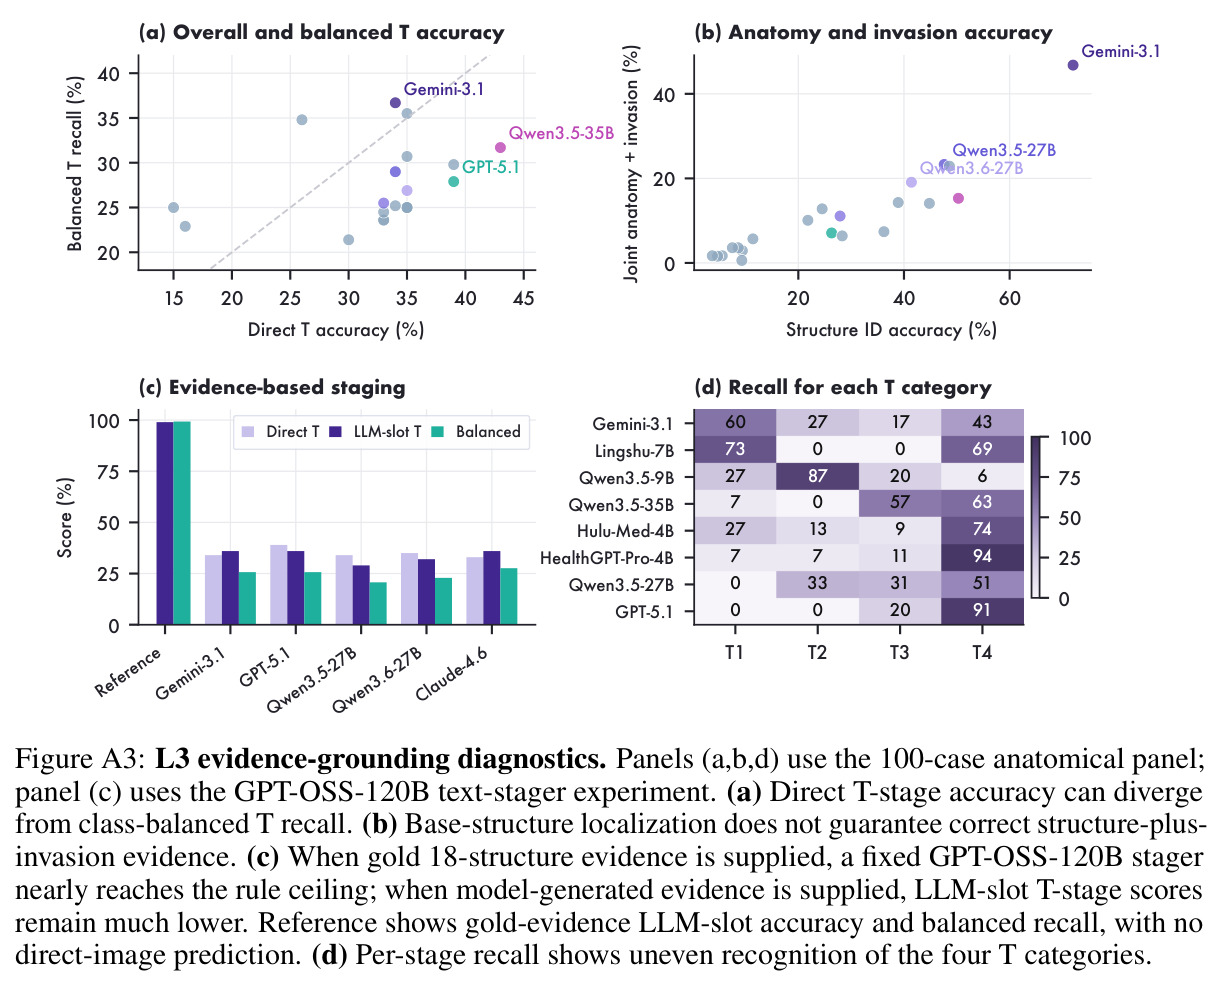
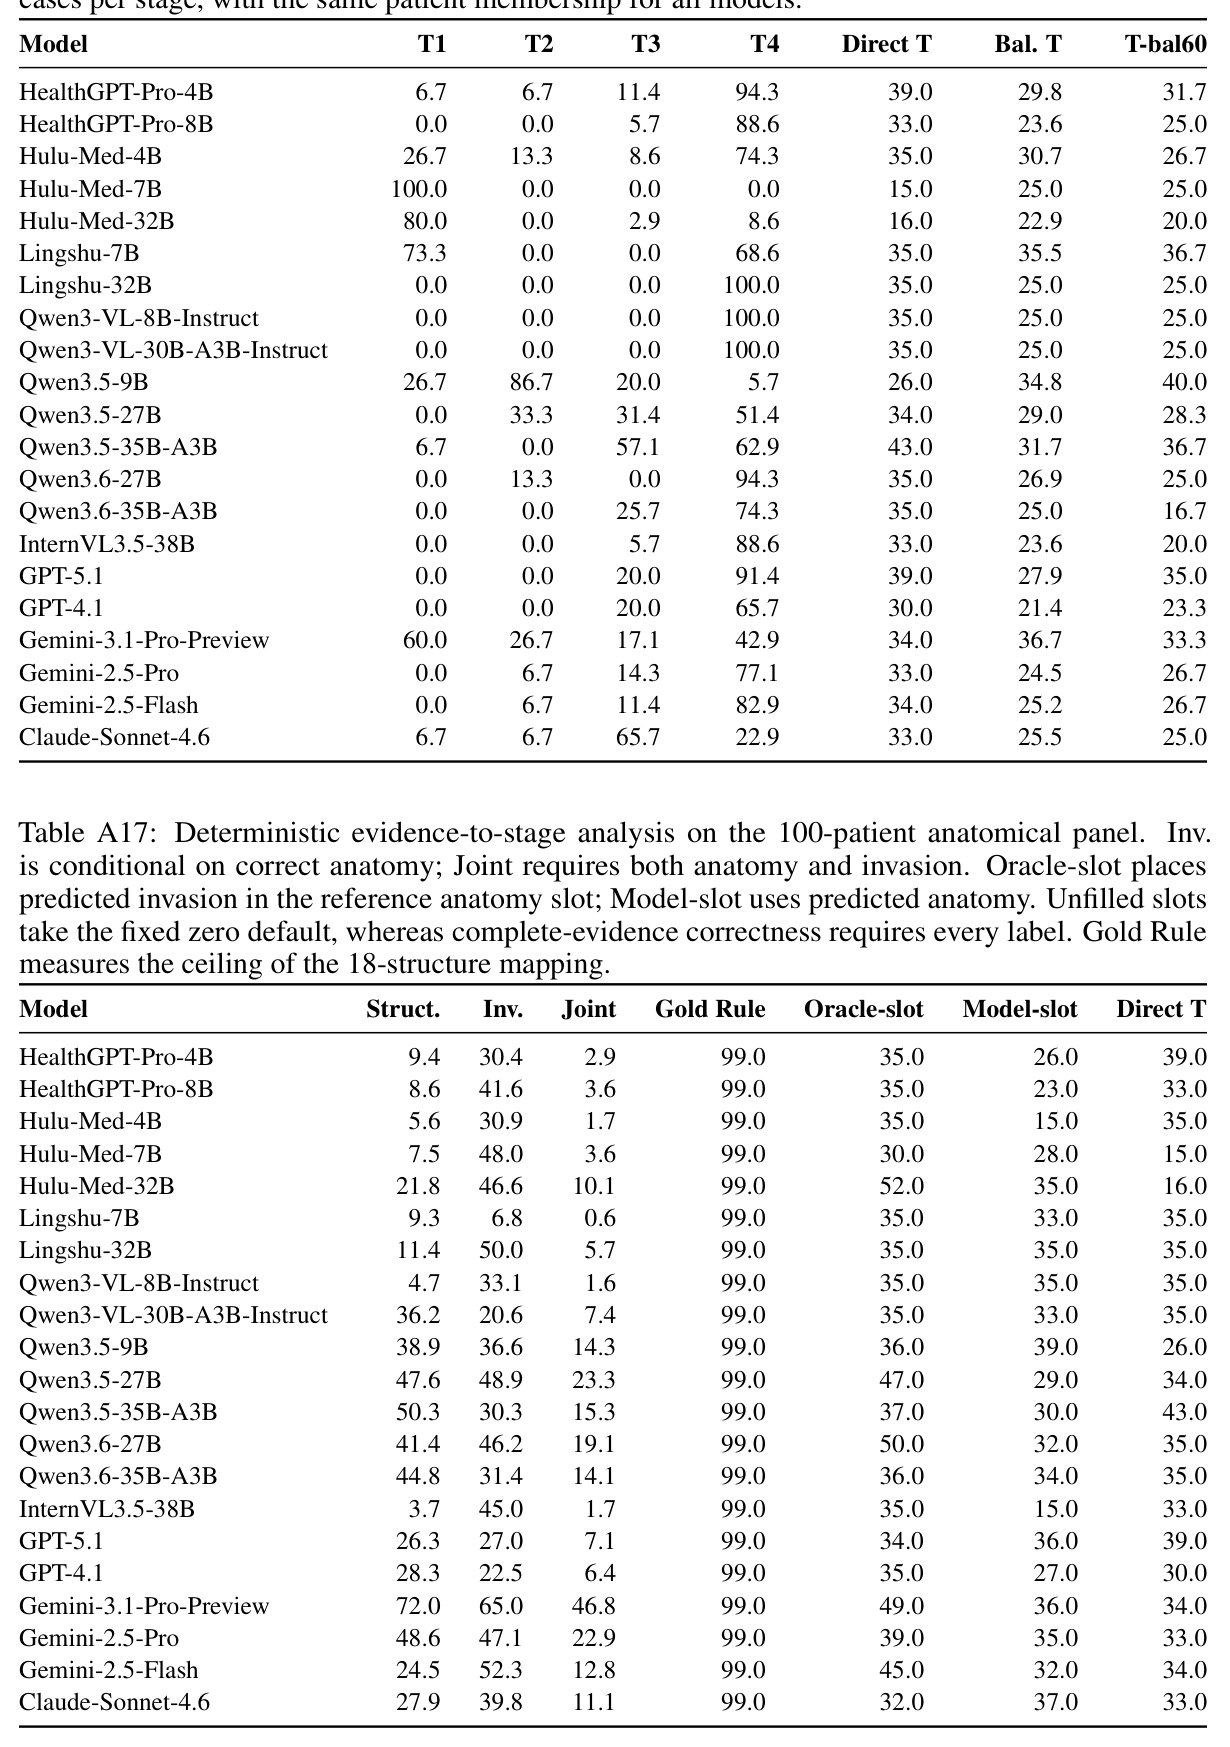
与已有工作不同的是,相关工作分三条线但从未在单一疾病内合流:静态考试 QA(MedQA、CMB、CMExam)缺纵向性;多模态/rubric 评估(HealthBench、MedDialogRubrics)缺疾病深度的证据锚定;工作流型基准(MedAgentBench、MTBBench)缺组件能力解剖。NPCBench 的独特切入是选中鼻咽癌这个“证据密集 + 时序耦合”的病种——诊断分期必须同时读病理切片、多序列 MRI 和 EBV DNA,后续决策同时依赖当前状态与前序事件,天然适合搭建能力阶梯。更重要的是,它第一个把“证据-决策一致性”作为中心评测目标:不只问答没答对,而是用证据分层干预(参考影像 99.0% → 预测影像 36.0%)和配对对照(MCQ vs 短答、完整病史 vs 快照、顺序打乱)诊断错在哪里,把医学评测做成可做因果归因的实验科学。
核心方法
直觉上,评测医学 AI 应该像带教专科住院医师:先考背指南(L1),再考在短病例上用指南(L2),然后看会不会读病理和 MRI(L3),接着考独立病例规划(L4)、随病程演变修订决策(L5),最后把整条诊疗链串起来——同一名患者从病理确诊、影像分期到 217 个照护决策一路走下来是否全部正确(L6),外加用专家 rubric 评开放问诊(O1)。技术上,患者级联合正确率定义为 $$Strict = \frac{100}{P}\sum_{p=1}^{P} d_p\, t_p \prod_{j \in S_p} c_{pj}$$ 其中 $c_{pj}$ 表示患者 $p$ 第 $j$ 条照护答案是否正确,$d_p$、$t_p$ 分别表示该患者病理与 MRI T 分期标签是否正确;决策级指标为 $Care = \frac{100}{N}\sum_{p=1}^{P}\sum_{j \in S_p} c_{pj}$。两者并列报告,正是为了让“单步高分”与“全程全对”之间的落差变得可见、可量化。
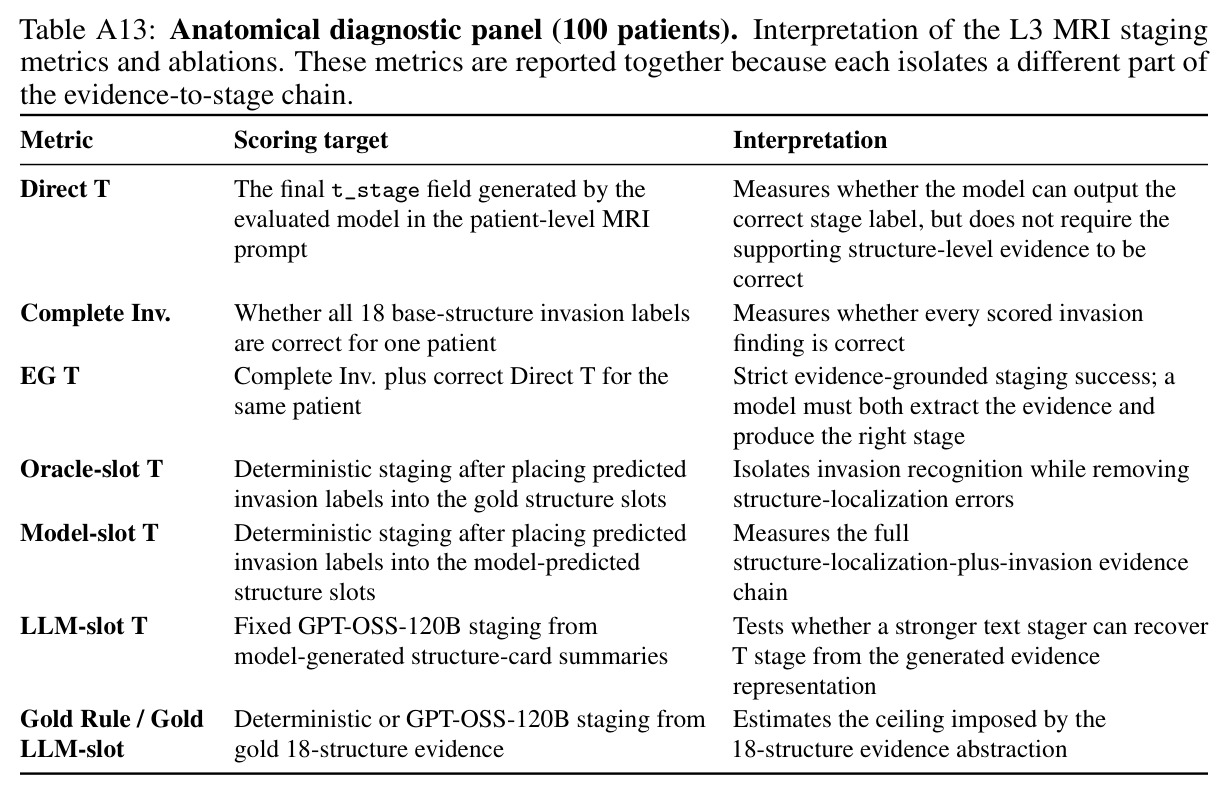
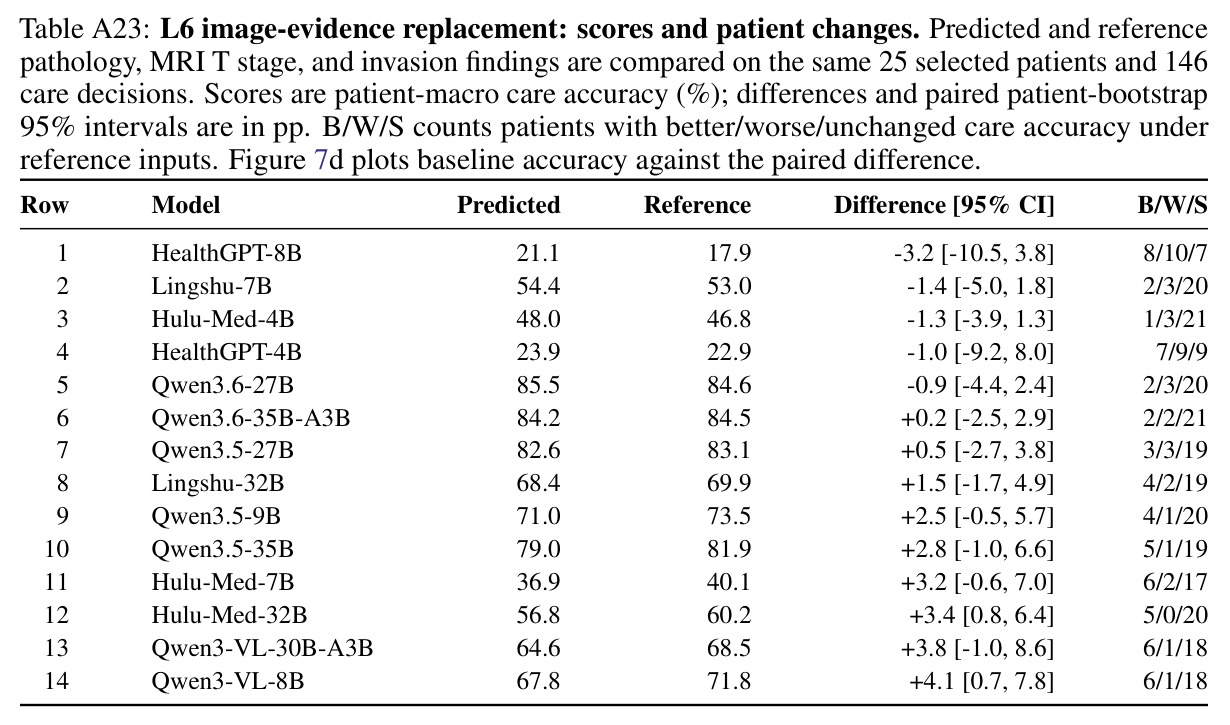
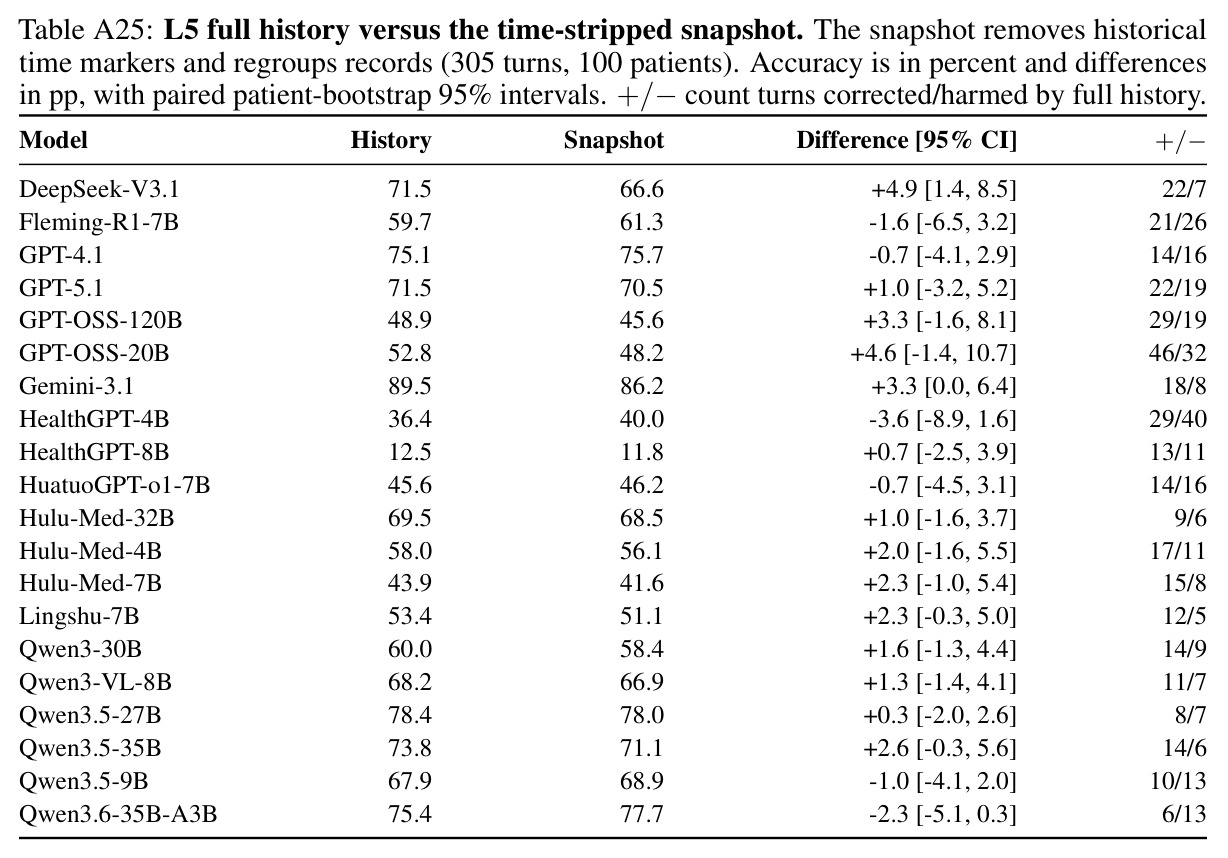
核心创新是 episode 级组合评测 + 对照实验诊断。传统基准回答“每题对不对”,NPCBench 把步骤任务绑定到患者诊疗轨迹上,要求病理、T 分期与全部照护答案在同一患者上联合正确,从而第一次系统量化了“组合鸿沟”(composition gap):单任务高分不保证患者级正确——Gemini-3.1 的 Care 决策准确率高达 89.9%,Strict 成功仅 11.0%,而 Care 只有 80.6% 的 Claude-Sonnet-4.6 反而以 23.0% 拿到最高 Strict。第二个创新是把测量做成实验:固定患者与问题,只动一个变量——去掉选择题选项(GPT-5.1 掉 15.5pp,证明选项是强线索)、完整病史换快照(19/20 模型置信区间跨零)、打乱记录顺序保留时间戳、用参考影像证据替换预测证据(care 准确率仅变化 -3.2~+4.1pp 且 12/14 区间含零)——据此逐一归因错误来源。这与“堆数据刷分”式的基准建设路线本质不同。
方法步骤详情
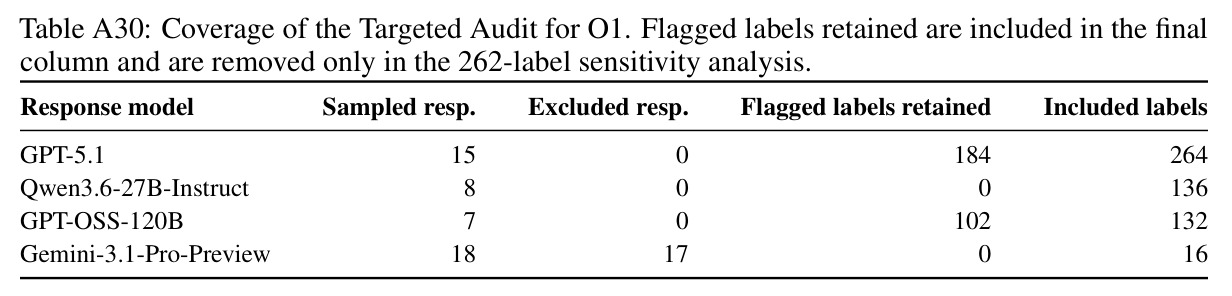
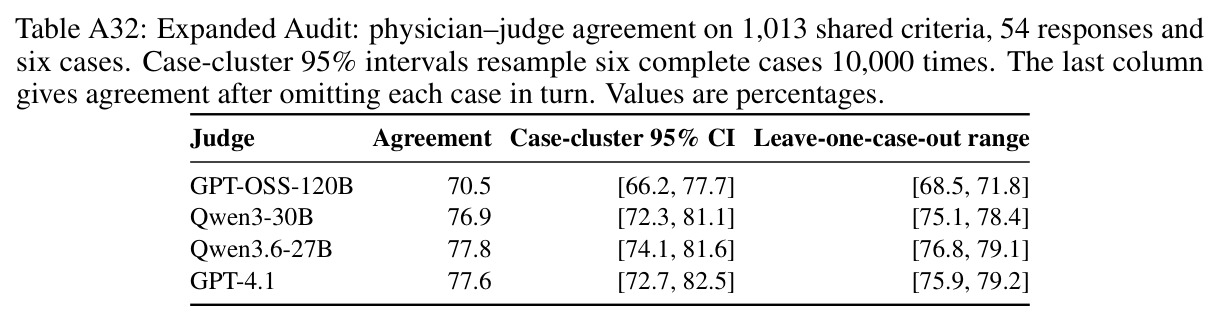
构建与评测分五步。①材料转化:专家临床材料转标准条目——L1/L2 从 CSCO、NCCN 指南构建规则 QA 与短病例决策题;L3 从病理切片与多序列 MRI 标注生成序列识别(200 题)、结构 ID(18 类、2,700 张卡片)、侵犯判断与 T/N 分期(各 400 例);L4–L6 与 O1 从去标识真实病历抽取临床快照和时间线决策点并给出参考答案。②专家验证:肿瘤、病理、影像多学科评审核查临床效度、证据充分性与答案确定性。③四条设计原则落地:能力隔离(每级测一个组件)、证据边界控制(在决策点冻结可用证据、删除未来信息防泄漏)、临床确定性(参考决策有指南支持)、可审计开放评分(O1 案例级 rubric,重大/轻微错误扣 2/1 分)。④评分:CarePath 用模型难度增强挑选 217 个照护决策,每题独立作答并附临床上下文与模型自己的病理/T 预测。⑤裁判校准:O1 以 GPT-OSS-120B 为主裁判,用 548 条 Targeted 与 1,013 条 Expanded 医师标注计算一致率与 Cohen's κ(0.387–0.610)。
技术新颖性
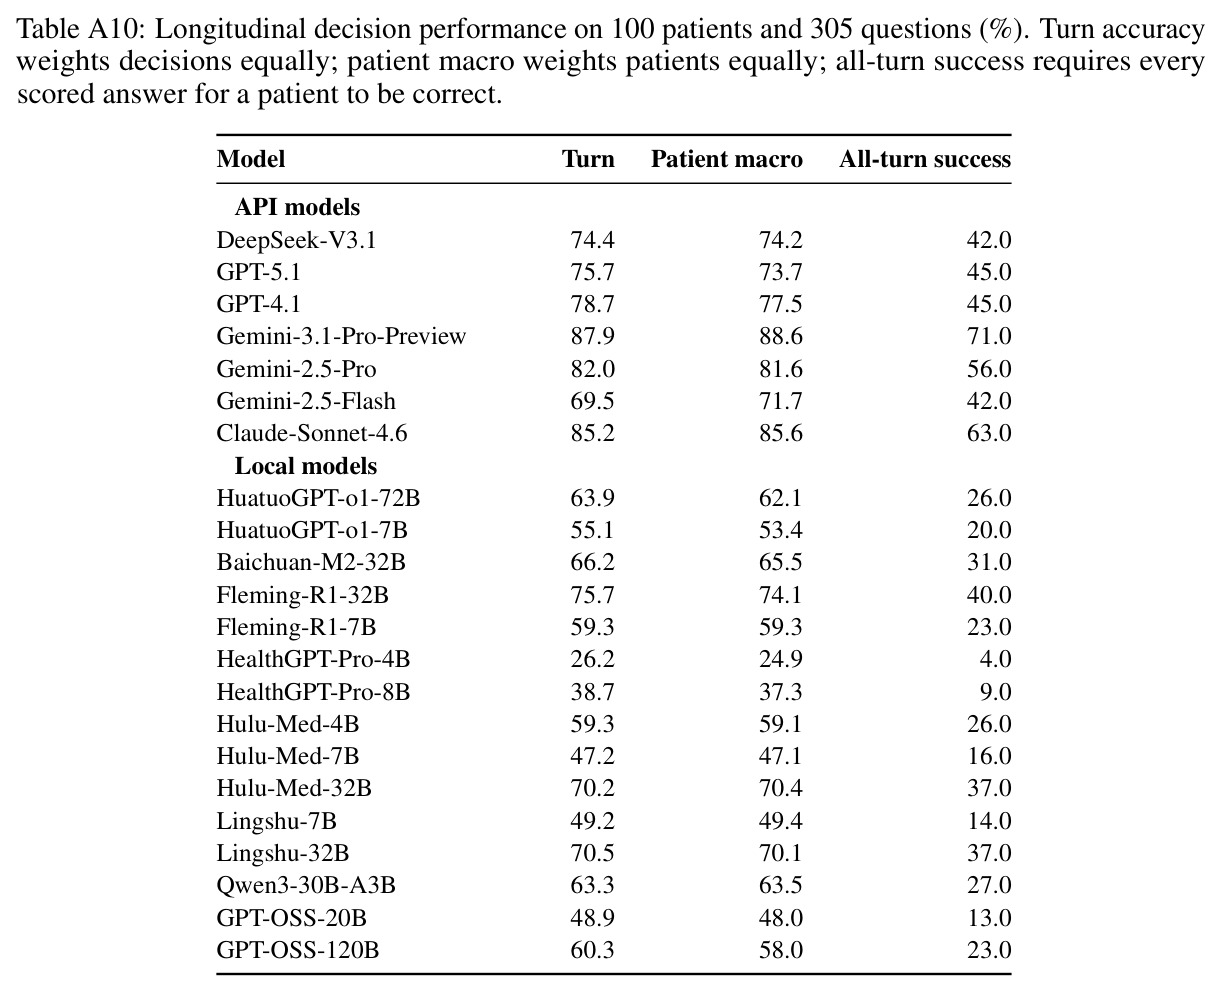
与已有技术的具体区别:①相对静态考试基准(MedQA、MedMCQA、CMExam),引入状态转移与患者级联合指标,任何单步错误使整个 episode 失败,错误复合效应首次被量化(turn 准确率 87.9% → all-turn 成功率 71.0%)。②相对单图 VQA 基准(VQA-RAD、SLAKE),L3 要求多序列 MRI 的序列识别、18 类结构 ID、侵犯判断与 T/N 分期联动,并用证据分层实验证明侵犯识别(而非分期规则)才是瓶颈——参考证据下固定规则分期可达 99.0%,预测证据下 Gemini-3.1 只剩 36.0%。③相对 rubric 类评估(HealthBench),把 rubric 绑定到具体病例并做医师校准审计,量化出裁判敏感度 51.8% 对特异度 85.8% 的失衡。④相对工作流基准(MedAgentBench、MTBBench),在同一疾病内完成“组件 → 纵向 → episode”全覆盖,并配套对照实验做因果归因,而不是只报告端到端成功率。
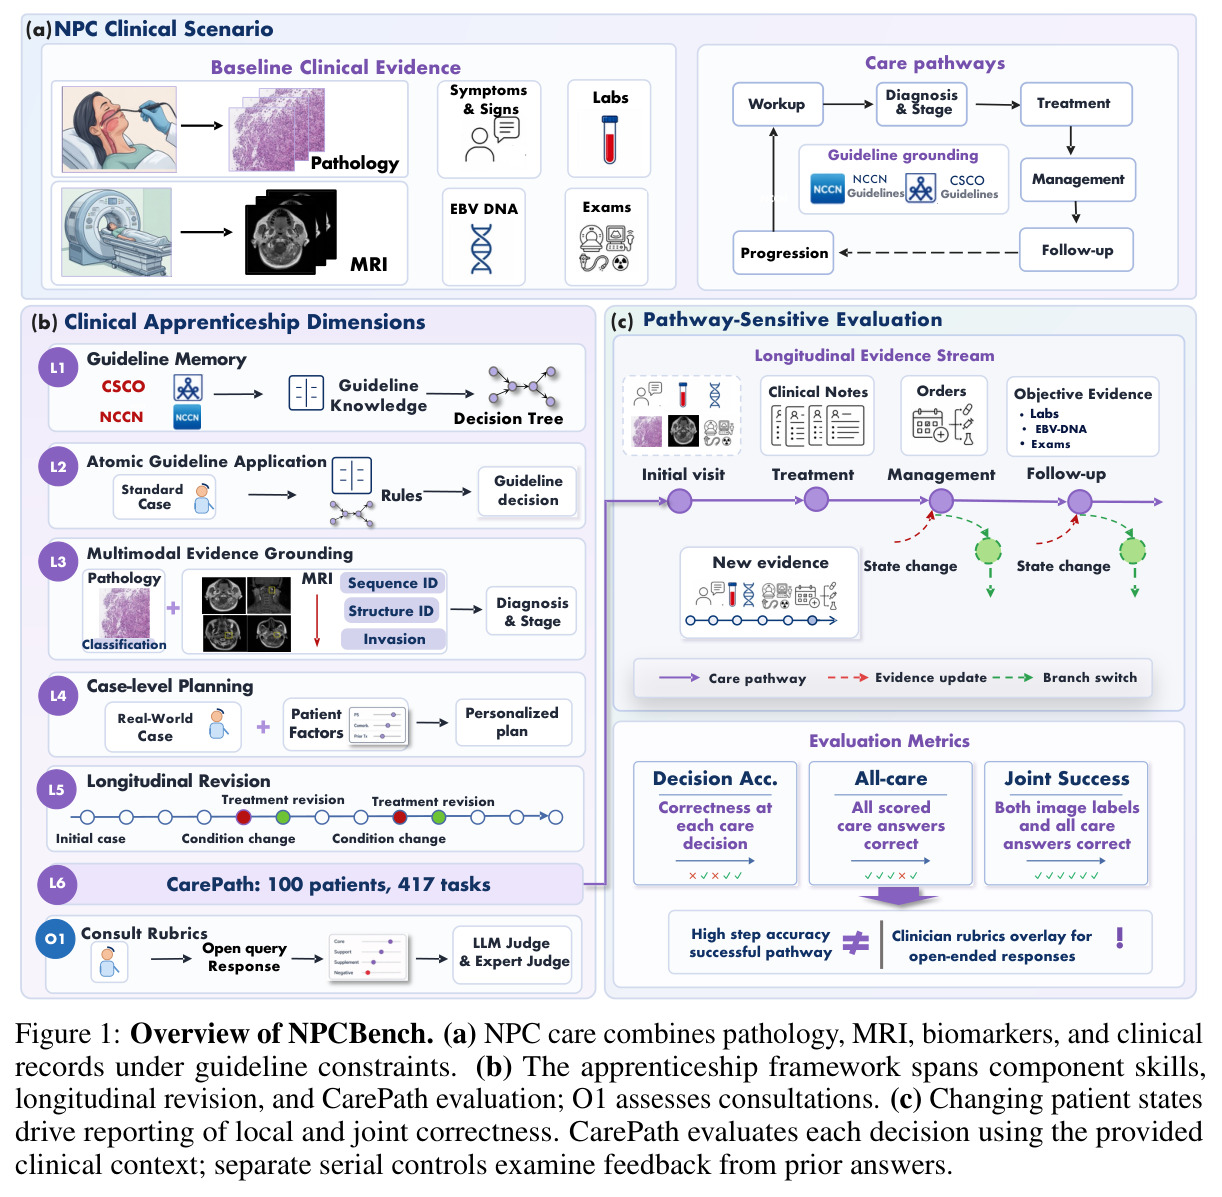
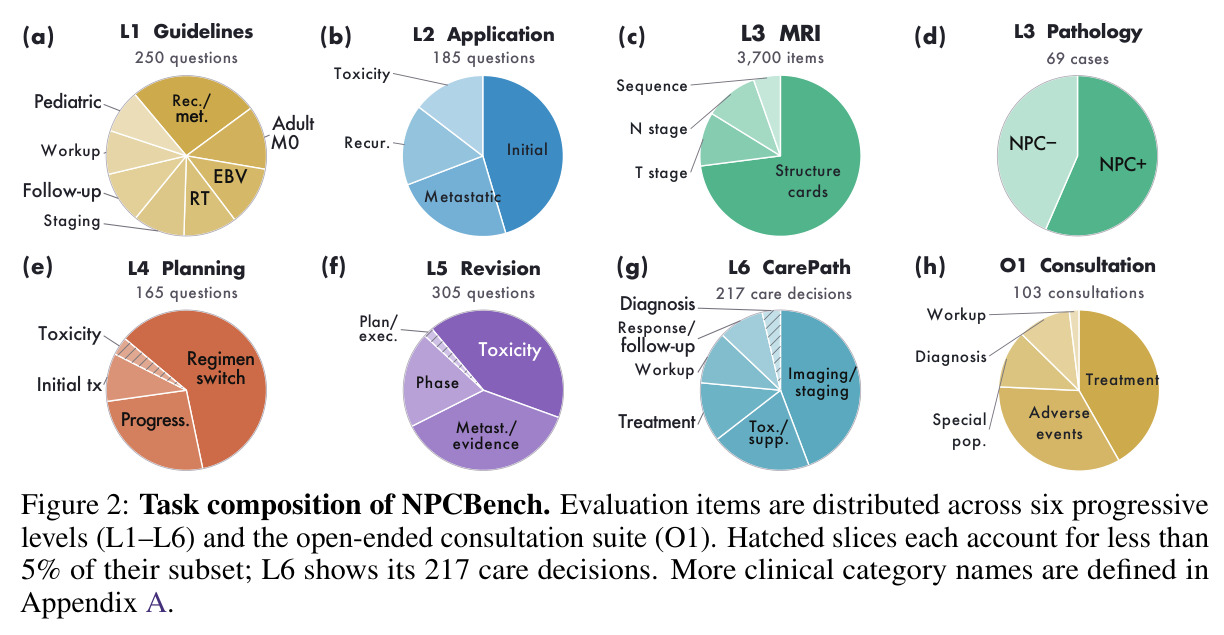
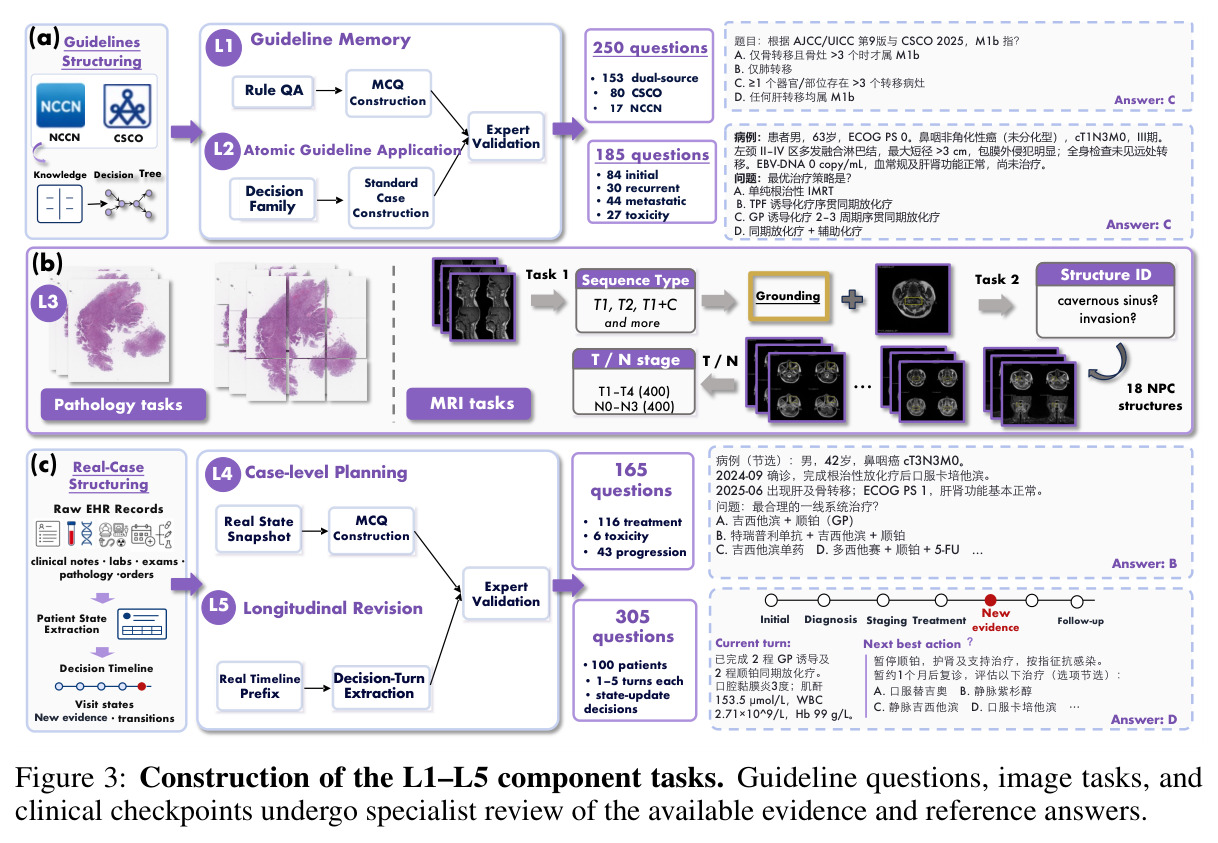
实验结果
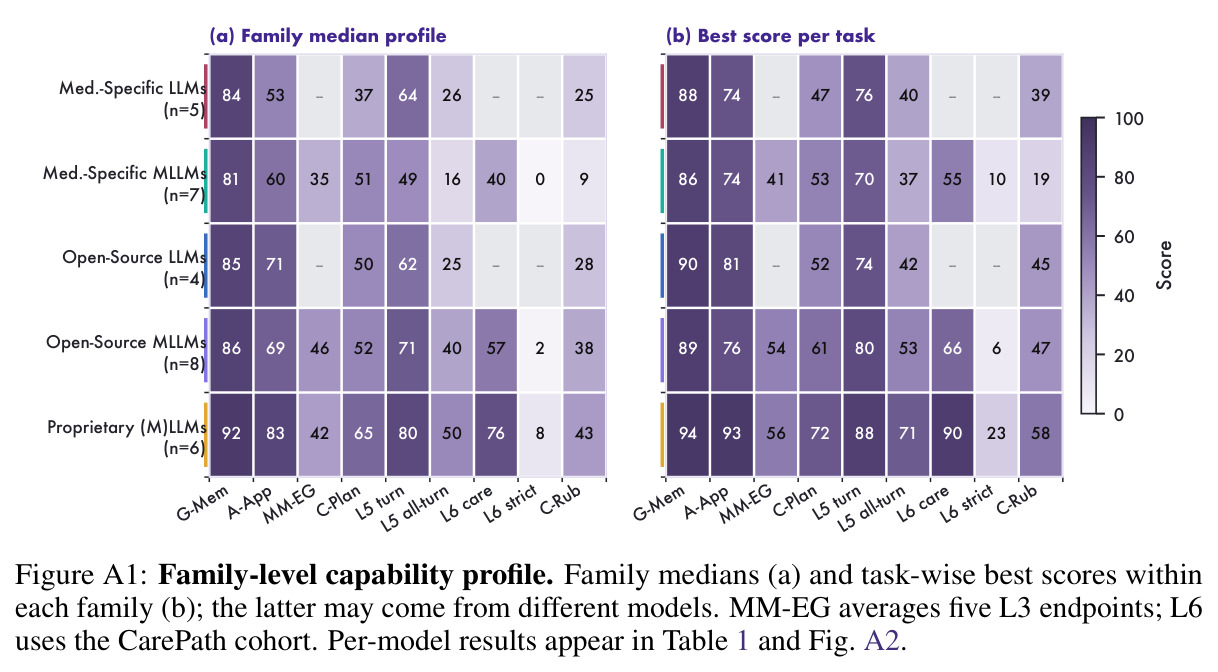
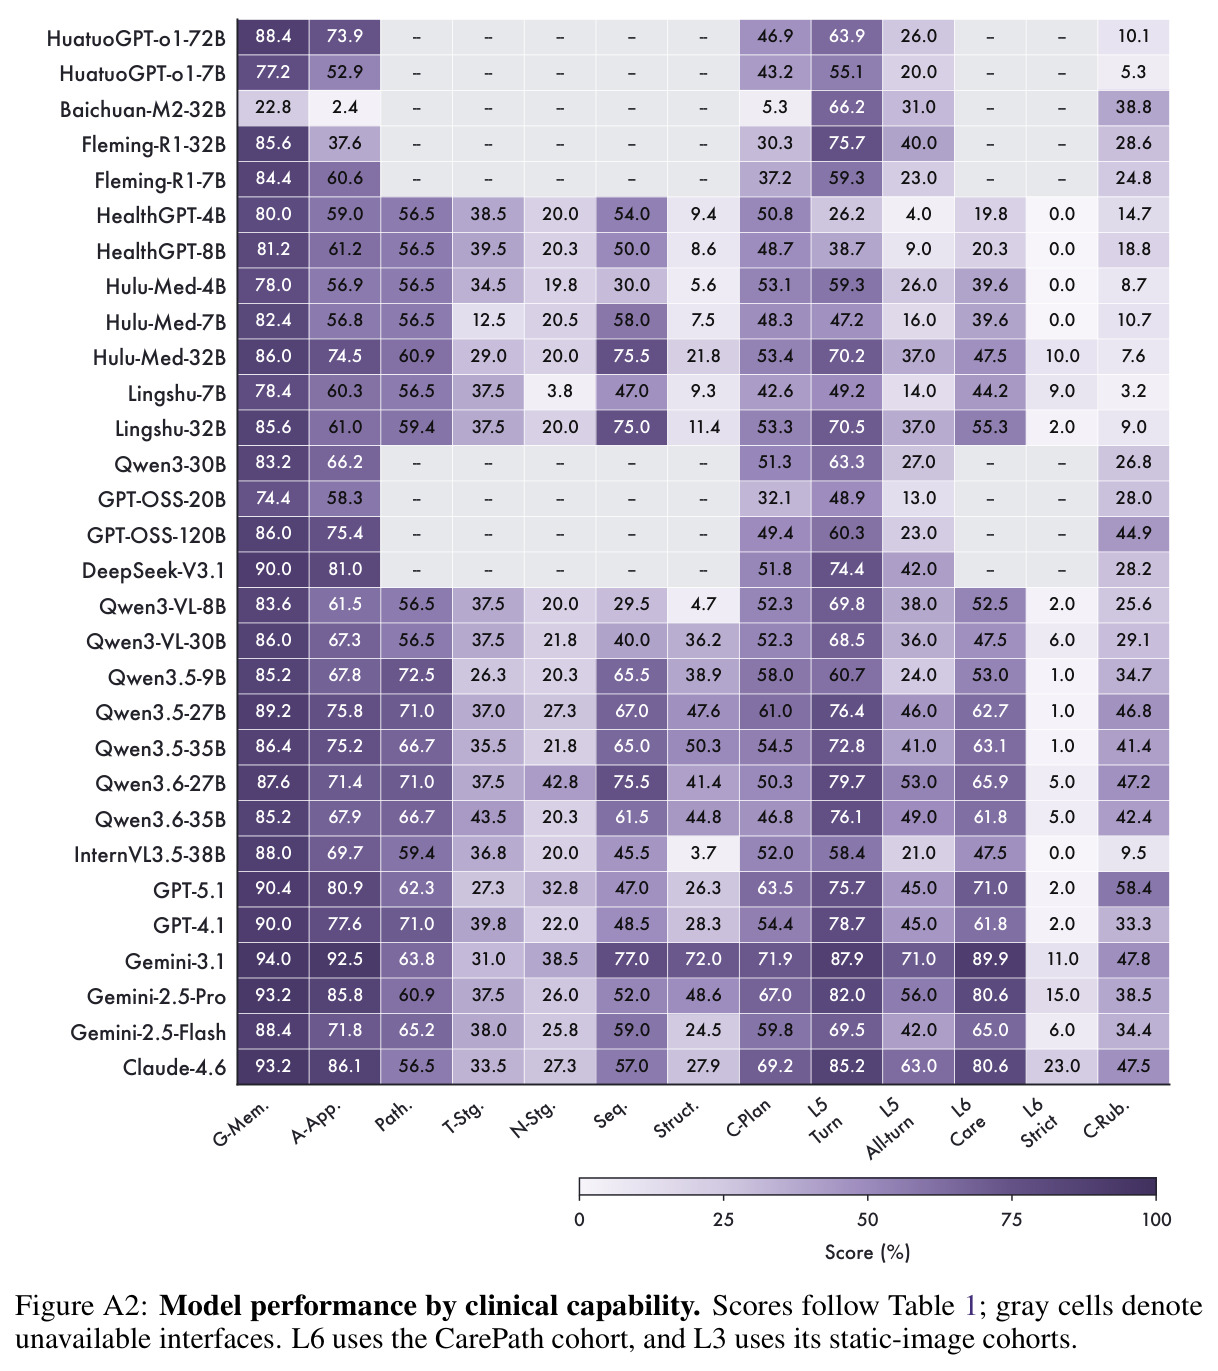
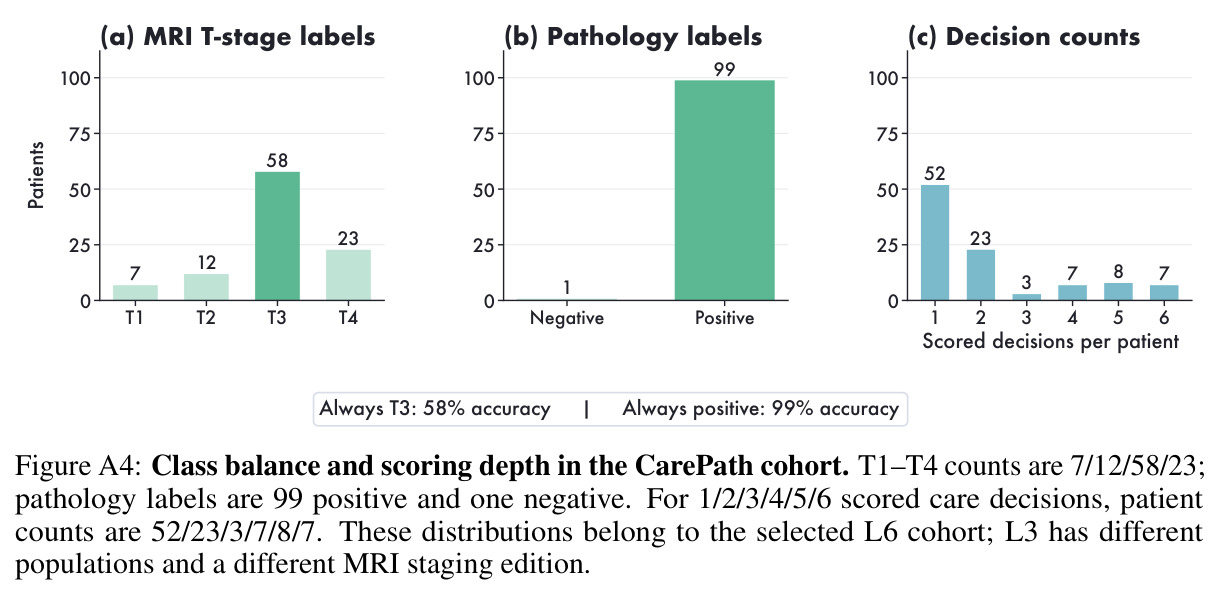
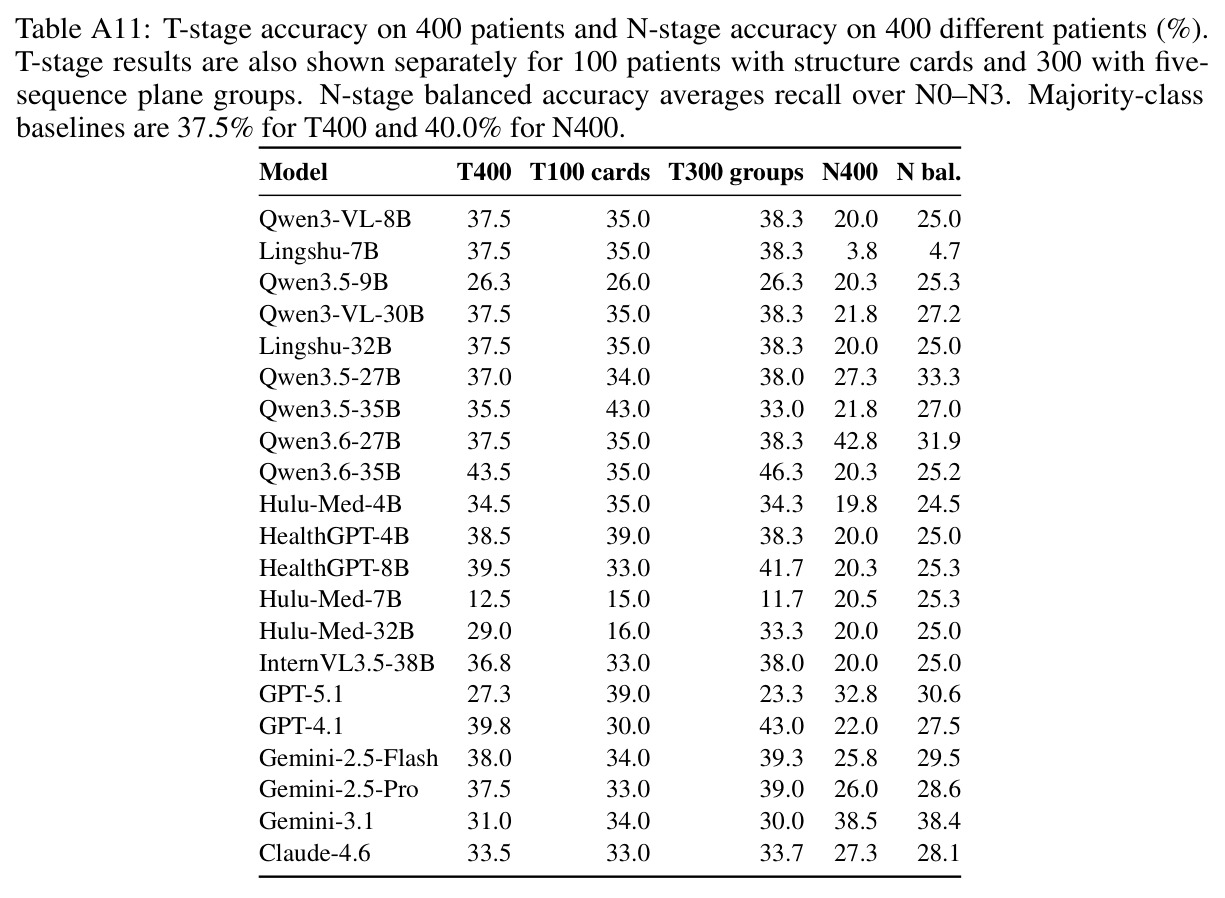
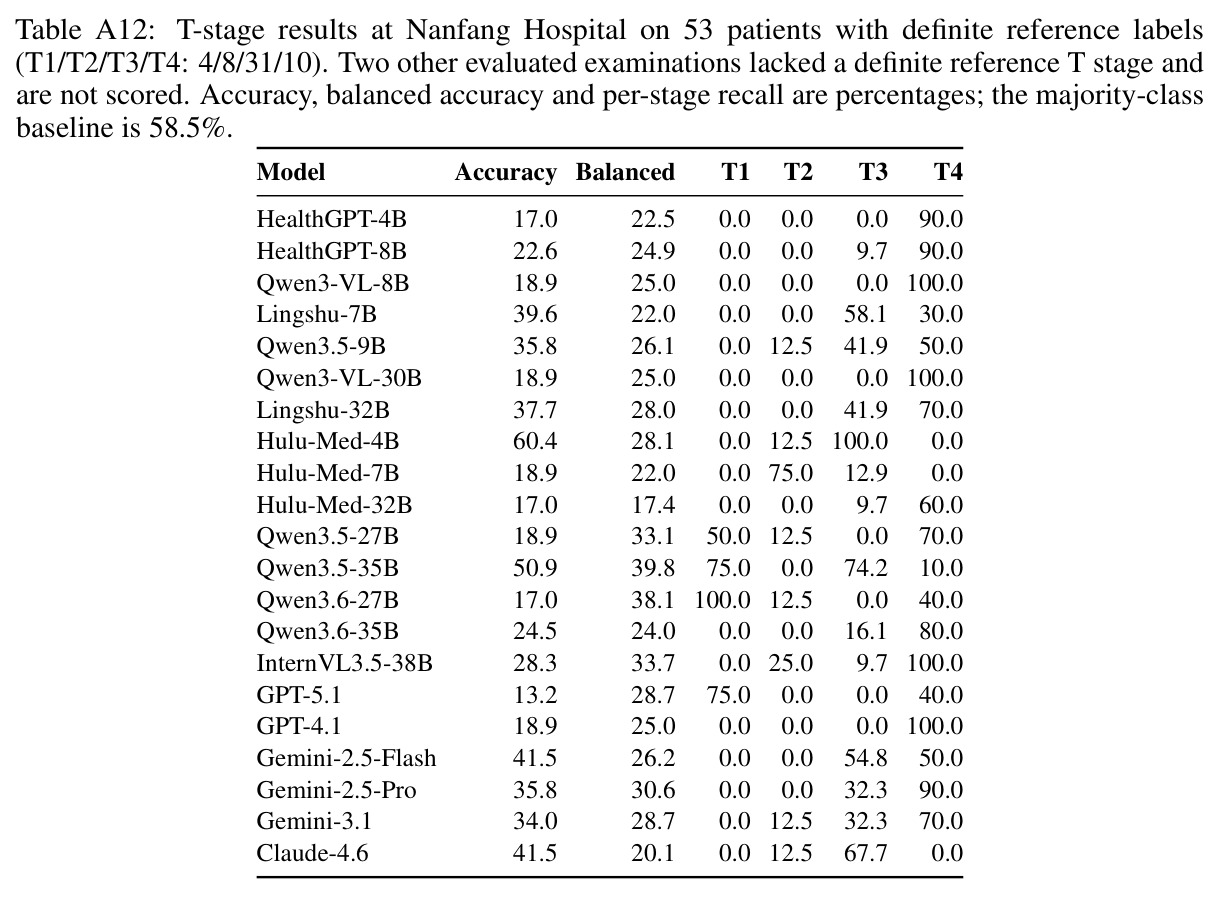
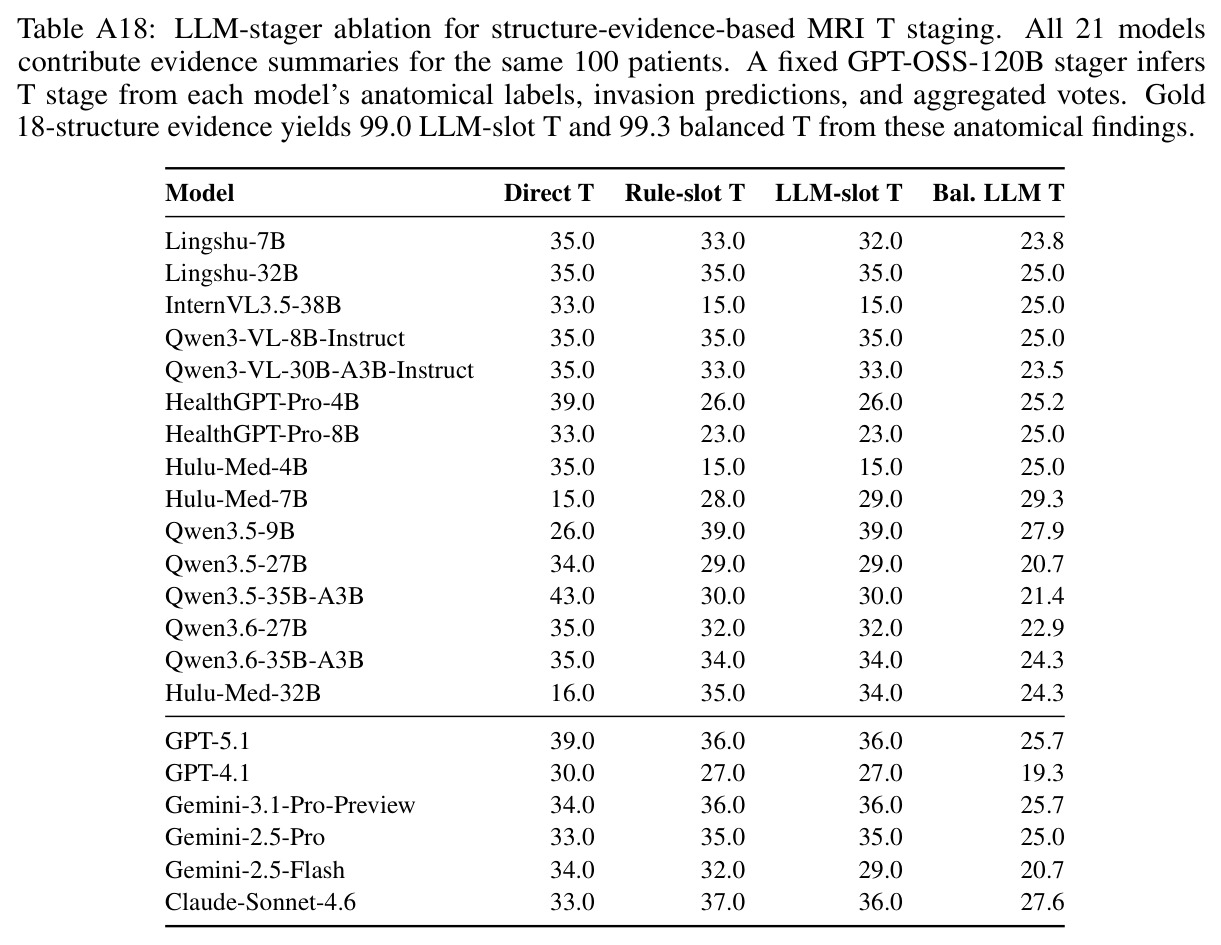
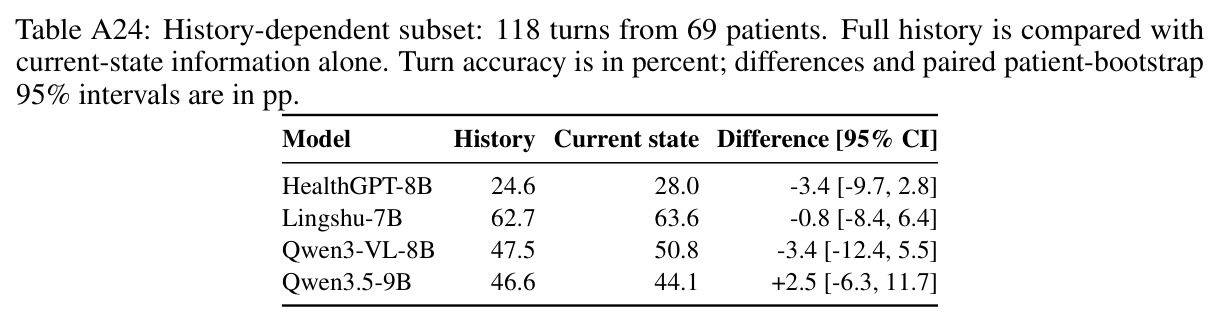
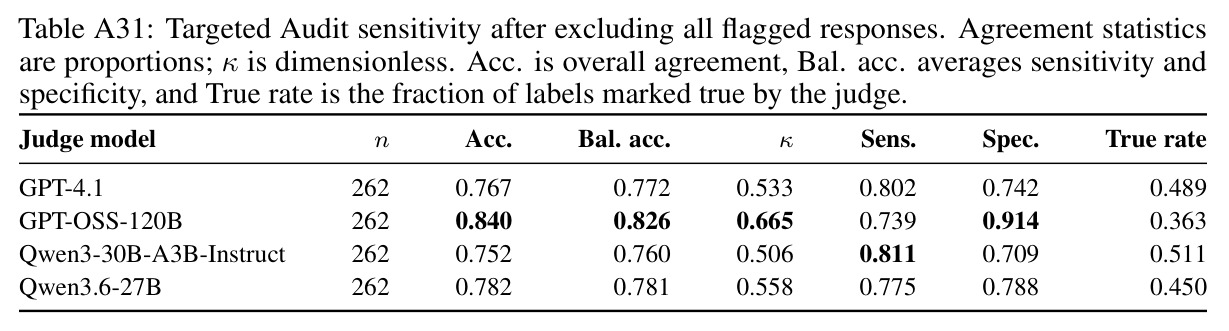
四个研究问题的核心数字:RQ1 知识-规划落差——L1 指南记忆最高 94.0%、L2 最高 92.5%(Gemini-3.1-Pro-Preview),L4 病例规划最高仅 71.9%;L1/L2 几乎相同的 GPT-5.1 与 DeepSeek-V3.1 在 L4 分化为 63.5% vs 51.8%;71 题 MCQ→短答对照显示选项线索价值(Gemini-3.1 -7.0pp、GPT-4.1 -12.7pp、GPT-5.1 -15.5pp)。RQ2 证据锚定崩溃——T 分期最高 43.5%(多数类基线 37.5%)、N 分期 42.8%(基线 40.0%),100 患者解剖面板上完整 18 结构侵犯正确率 ≤5.0%;参考证据下固定规则分期达 99.0%,而 Gemini-3.1 用预测证据仅 36.0%(已知解剖 49.0%),瓶颈在侵犯识别而非分期规则;常数 T3 预测 58% 高于最佳模型的 52%。RQ3 患者级塌缩——L5 中 Gemini-3.1 turn 87.9%/all-turn 71.0%;CarePath 中 Gemini-3.1 Care 89.9%(195/217)但 Strict 仅 11.0%,Care 80.6% 的 Claude-4.6 反以 23.0% 拿到最高 Strict(95% CI 15.2–32.5%);72/100 患者照护全对却至少一个诊断标签错误;病史 vs 快照 19/20 模型 CI 跨零;替换参考证据仅使 care 变化 -3.2~+4.1pp(12/14 CI 含零),照护决策几乎不依赖影像。RQ4 问诊与裁判——GPT-5.1 C-Rub 58.4 最高,但 14.6% 回答触发重大错误、40.8% 轻微错误;主裁判与医师一致率 70.5%(κ=0.387),敏感度 51.8% 对特异度 85.8%,换校准集会翻转裁判排名。
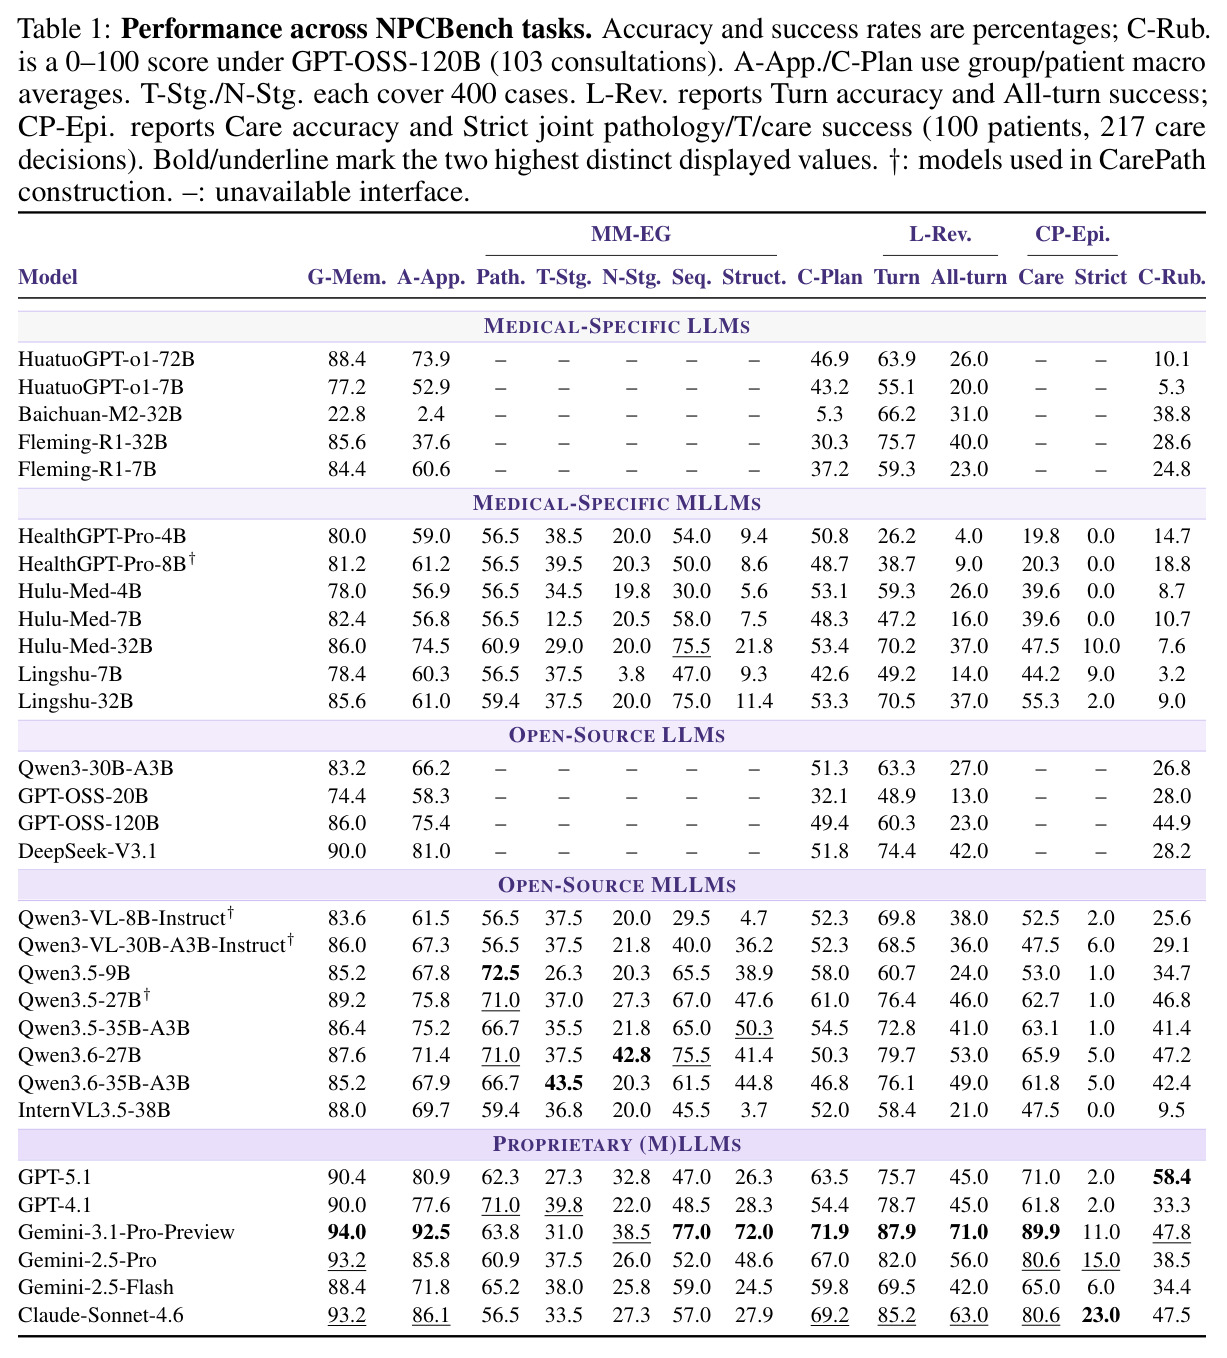
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| L1 指南记忆(250 题) | 准确率 | Gemini-3.1-Pro-Preview 94.0% | GPT-4.1 / DeepSeek-V3.1 90.0% | 最高分与 L4 规划 71.9% 相差 22pp,暴露知识-规划落差 |
| L3 MRI T 分期(400 例) | 准确率 / 平衡准确率 | Qwen3.6-35B-A3B 43.5% / 平衡最高 30.5% | 多数类基线 37.5% / 常数预测 25% | 绝对优势仅 6pp,且隐含类别失衡捷径 |
| L3 解剖面板侵犯判断(100 患者、2,700 结构卡) | 完整 18 结构侵犯正确率 | ≤5.0% | 直接 T 分期准确率 43.0% | 证据锚定缺口约 38pp,分期标签普遍缺乏完整解剖支撑 |
| L5 纵向修订(305 决策、100 患者) | turn 准确率 / all-turn 患者成功 | Gemini-3.1 87.9% / 71.0% | Claude-4.6 85.2% / 63.0% | 单步到全对衰减约 17pp,错误复合效应显著 |
| L6 CarePath 严格患者级成功(100 患者、417 任务) | Strict(病理 + T 分期 + 全部照护联合正确) | Claude-Sonnet-4.6 23.0%(21 个多模态模型中最高) | Gemini-3.1 11.0%(其 Care 决策准确率最高,89.9%) | Care 更低但 Strict 反超 12pp,证明决策准确率不指示患者级成功 |
| O1 开放问诊(103 项、1,726 条 rubric) | C-Rub 0–100(GPT-OSS-120B 裁判) | GPT-5.1 58.4 | Gemini-3.1 47.8 / Claude-4.6 47.5 | 最高分模型仍有 14.6% 回答触发重大安全错误 |
局限与改进
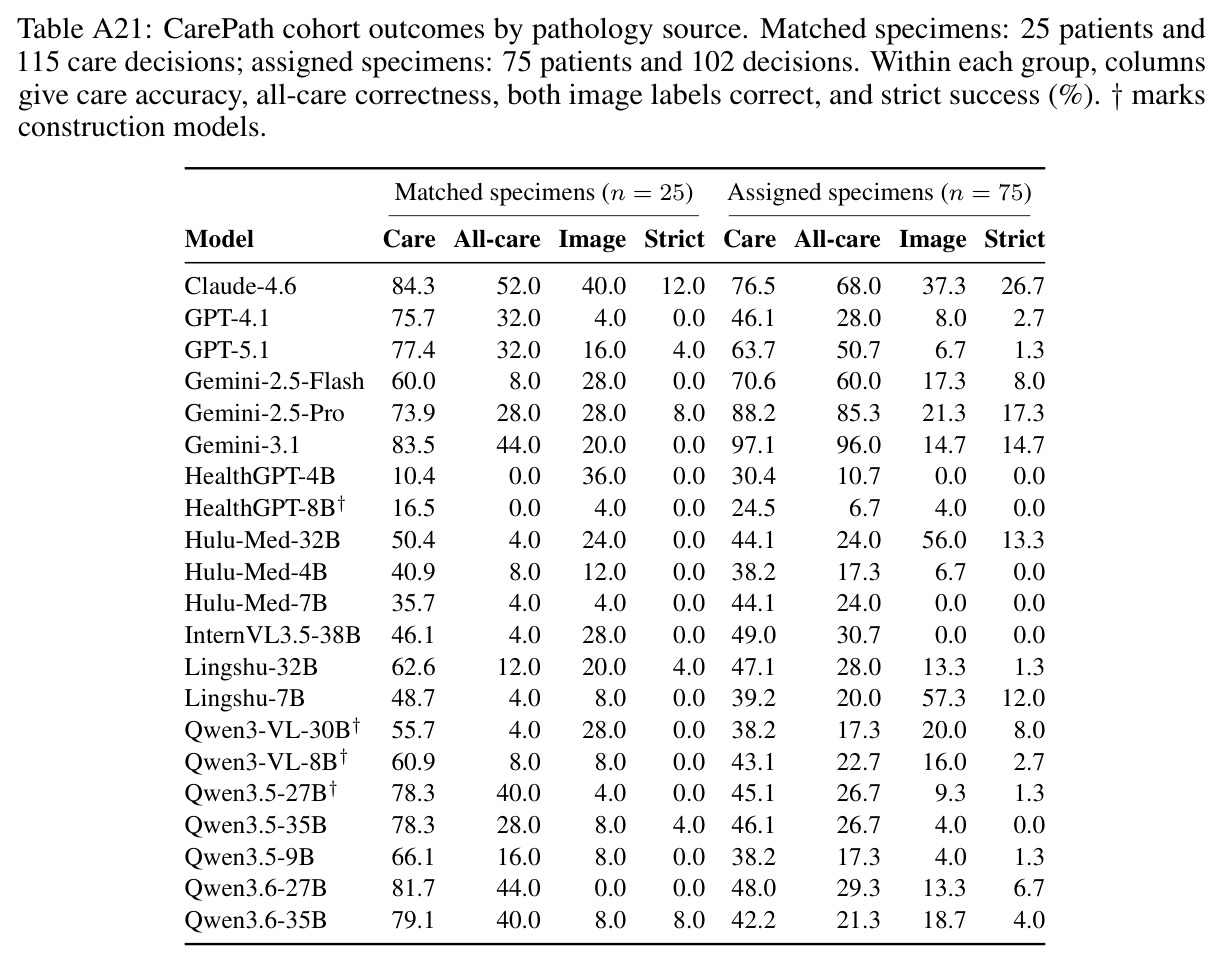
作者承认的局限:数据主要来自单中心;75 个模型选择的 CarePath episode 使用指派病理而非患者匹配(25 例匹配对照显示 Claude-4.6 两组 Care 为 76.5% vs 84.3%、All-care 为 68.0% vs 52.0%,差异本身说明结论对队列构成敏感);分数对类别平衡和 episode 长度敏感;Expanded Audit 仅覆盖 6 个病例 54 条回答,需要多中心、模态完全匹配与前瞻性研究。我的补充观察:Strict 指标基于 100 名患者,23.0% 与 15.0% 之间差异的置信区间很宽,中游模型排序并不稳固;NPC 指南(NCCN/CSCO)是公开文本,L1 高分可能部分来自预训练污染,论文用 MCQ→短答对照缓解但未做显式去污染检查;O1 主裁判自身敏感度只有 51.8%,意味着近半数满足的正面要求被漏判,58.4 vs 47.8 的分数差距可能混入裁判噪声;此外基准只覆盖单一癌种,学徒阶梯框架能否迁移到证据结构不同的疾病仍是开放问题。
独立分析的弱点
独立分析四个弱点。①证据依赖未被闭环:论文证明替换参考影像后 care 准确率只变化 -3.2~+4.1pp(12/14 CI 含零),说明模型主要靠临床文本先验答题,但基准没有测“证据与文本冲突”的场景——改进方向是加入反事实影像(故意篡改侵犯区域),检验决策是否随之改变,把证据使用变成可操纵变量。②类别失衡与格式偏差:常数 T3 预测 58% 高于最佳模型 52%,MCQ 选项提供强线索(去掉后掉 7~15.5pp)——改进方向是以平衡准确率和生成式作答为主指标(论文把平衡准确率放在附录),或对各期分层采样使患者分布均衡。③裁判可靠性瓶颈:主裁判 κ=0.387、敏感度 51.8%,且换校准集会翻转裁判排名(GPT-OSS-120B 在 Targeted 审计领先,Qwen3.6-27B 在 Expanded 领先)——改进方向是多裁判集成加医师仲裁子集,并按 rubric 条目估计裁判偏差做校正。④75 个 episode 的指派病理可能引入选择偏倚,模型难度增强挑选的 217 个决策也使绝对分数与其他数据集不可比——改进方向是全患者匹配设计并分层报告两组指标。
未来方向
作者提出的方向:扩展多中心队列、实现完全患者匹配的模态、开展前瞻性研究验证“基准增益能否转化为临床改进”。基于成果可延伸的方向:①把 CarePath 升级为交互环境,让模型主动决定申请哪些检查(序贯开单),评测信息获取策略而不仅是被动解读给定证据流;②引入反事实一致性测试,量化因果意义上的证据使用;③把 O1 的医师-rubric 校准流程(Targeted/Expanded 双审计)推广为 LLM 裁判去偏的标准方法论;④在乳腺癌、肺癌等证据结构不同的癌种上复制学徒阶梯,检验框架通用性;⑤反向使用这套维度(证据锚定率、纵向修订能力、组合鸿沟)作为训练对齐信号,做“证据接地”的医学后训练而不只是评测;⑥纵向追踪新版本模型,观察 composition gap 是否随规模与推理能力提升而缩小。
复现评估
复现条件较好。论文标注了 GitHub 代码与 Hugging Face 数据(2026)链接,承诺释放 4,777 条组件/问诊条目、100 患者 CarePath(417 任务)与全部问诊 rubric;评测协议完全标准化,附录 E 提供完整 prompt,附录 C 给出各模型的图像处理与生成设置。算力方面:21 个多模态模型需要 GPU 推理,本地模型在 4×A800-80GB 上运行(7B–120B 权重均可单机处理),O1 主裁判 GPT-OSS-120B 可本地部署;无 GPU 的团队也可以只复现文本任务(L1/L2/L4/L5/O1)。风险点:专有模型是 preview 版本(Gemini-3.1-Pro-Preview),API 漂移导致分数不可精确复现;医学影像去标识数据可能需要签署数据使用协议;专家评审环节无法重做,只能复用发布数据;三类配对对照实验(病史/顺序/证据)需严格按附录协议执行才能得到可比的 pp 差值。总体判断:数据如期开源的话,复现 Table 1 主表难度中等,复现全部对照实验难度中高。
论文图表