LowRAM:测试时低秩键与摊销值的可组合 KV 缓存压缩 LowRAM: Low-Rank Keys and Amortised Values for Composable KV Cache Compression at Test-Time
利用头内键值可预测性在测试时拟合值预测器,配合低秩键压缩,最高实现26.9倍近无损KV缓存压缩
前置知识
KV Cache(键值缓存)
自回归解码时,Transformer 把每个历史 token 的 key、value 投影缓存下来,避免每步重算全部前文注意力。它把解码复杂度从上下文长度的平方降到线性,但代价是内存占用随序列长度和 batch size 线性增长,在长上下文场景成为主要瓶颈,限制了批大小与吞吐量。
本文的全部工作都围绕压缩这个缓存展开,理解缓存的构成(key 矩阵、value 矩阵、按层/按头组织)是读懂压缩比计算和各组件作用的前提。
RoPE(旋转位置编码)
RoPE 通过对 query 和 key 向量按位置施加旋转变换来注入位置信息。旋转会破坏特征维度上的线性结构,使 key 向量的频谱变差、难以压缩。因此许多压缩方法先做"反旋转"得到 pre-RoPE 表示,压缩后再在注意力计算时重新施加旋转。
LowRAM 的预测器拟合、低秩分解和量化全部作用在 pre-RoPE 的 key 上,不理解 RoPE 就无法理解为何要做"反转 RoPE"这一预处理步骤。
GQA(分组查询注意力)
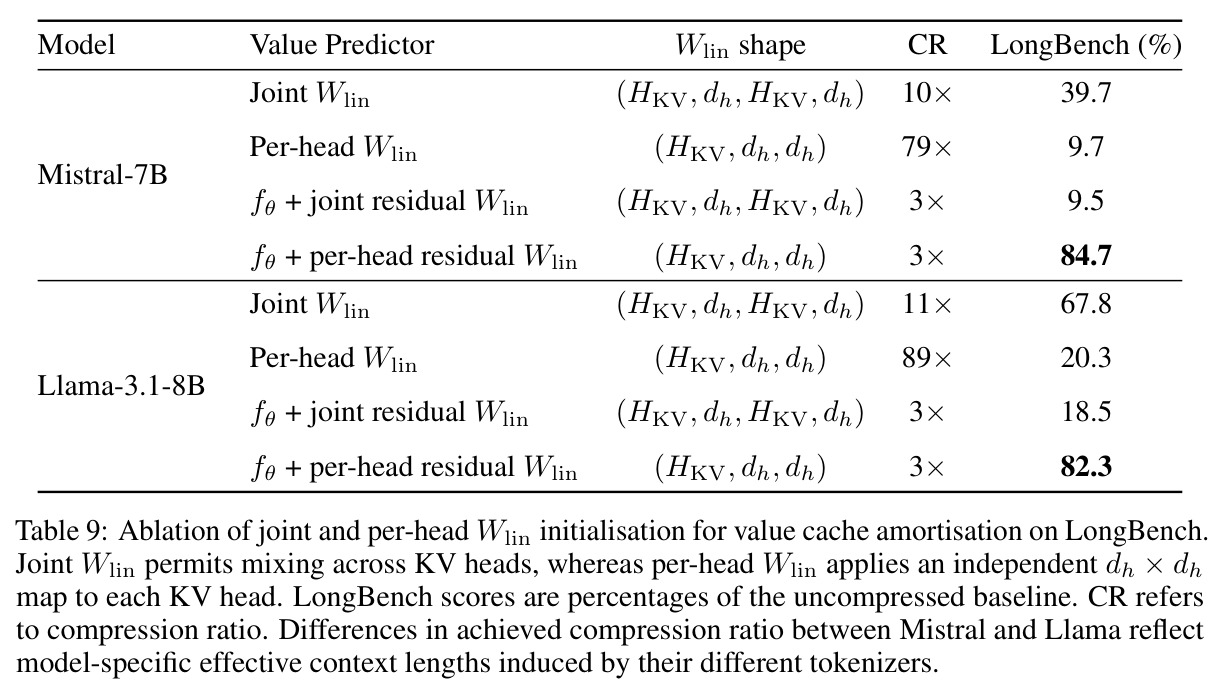
GQA 让多个 query 头共享同一组 key/value 头(如 Mistral-7B 有 8 个 KV 头),以减少缓存体积。副作用是 key 投影矩阵 $W_K$ 从方阵变成长方阵,不再可逆,因此无法像 MHA 那样用 $W_K^{-1}W_V$ 从 key 精确恢复 value,只能用 Moore-Penrose 伪逆求最佳线性近似。
GQA 是本文 Slim Attention 初始化和"值只能被近似预测、需要 MLP 非线性修正与残差"这一技术路线的直接原因,主流开源模型几乎都采用 GQA。
低秩分解与 SVD
把大矩阵 $M$ 近似为两个小矩阵之积 $M \approx AB$,其中 $A$ 由奇异值分解(SVD)得到的主奇异向量构成。KV 缓存的 key 能量集中在少数特征方向上,因此低秩近似误差小。xKV 进一步发现相邻层的 key 主子空间高度对齐,可以让一组层共享同一个低秩基 $A$,只有层特定矩阵 $B$ 不同。
LowRAM 的键压缩直接采用 xKV 的跨层共享低秩分解,这是"不对称设计"中处理 key 的一半;压缩比公式中的秩 $k$ 就是从目标压缩比反解出来的。
KV 缓存量化
把缓存的浮点数用更低比特(如 4-bit、2-bit)存储。难点在于 key/value 存在通道级离群值,会主导均匀量化网格,导致 4-bit 以下性能急剧退化。现代方法(如 TurboQuant)通过随机旋转消除离群值、按通道/按 token 非对称分配比特来缓解。
量化是 LowRAM 的可组合组件之一:LowRAM-Q 只量化低秩基 $A$(4-bit)和值残差(2-bit),理解量化才能看懂组合压缩比(如 6.4×)和精度协同增益的来源。
Test-Time Training 与 FOMAML 元学习
测试时训练指在推理阶段用当前输入的自身监督信号快速拟合小模型参数。FOMAML(一阶 MAML)离线学习一个初始化 $\phi$,使模型在新任务上仅需 $K$ 步内环梯度更新即可达到低损失,且忽略通过优化轨迹的二阶导数,训练成本近乎为零。本文的目标是"快速记忆"而非"快速泛化"。
值预测器逐上下文拟合需要 150-300 步梯度更新,造成高达 26-55 倍的 TTFT 开销;meta-learned 初始化将其压到 2 步、开销 1.3 倍,是本文效率贡献的核心机制。
Slim Attention 先验
Slim Attention 观察到在 MHA 模型中 value 可由 key 精确线性恢复:$V = X W_V = (X W_K) W_K^{-1} W_V$,即 key 到 value 存在一个由模型权重直接决定的线性映射。GQA 下该映射不可逆,用伪逆 $W_{lin} = W_K^+ W_V$ 可得最佳线性近似。
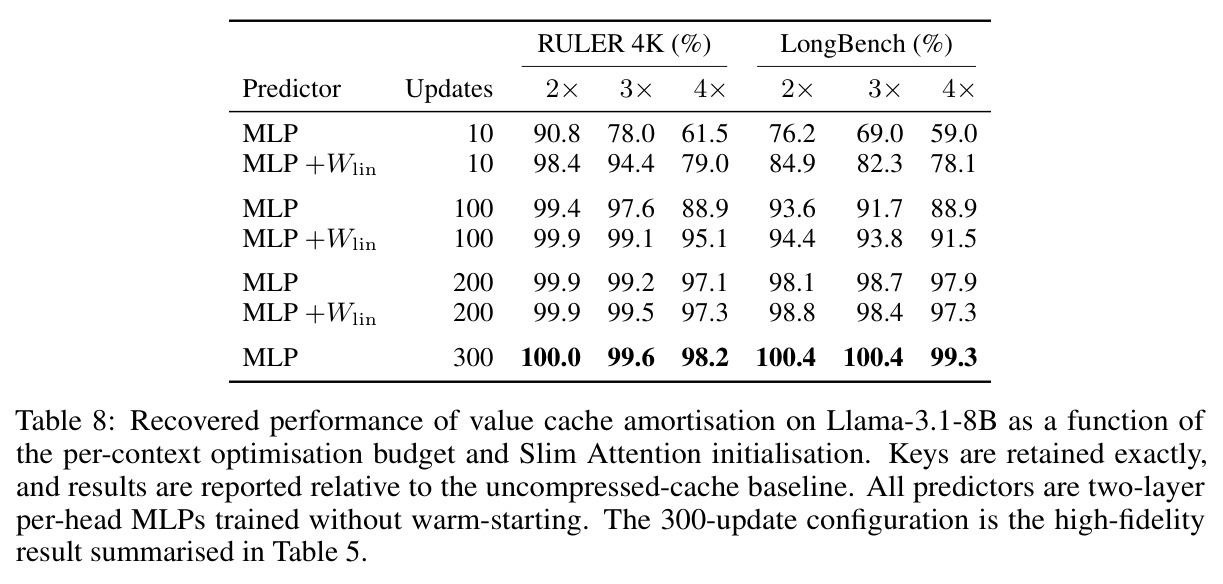
LowRAM 用它作为每头 MLP 的线性残差分支初始化,是整个"值摊销"能快速收敛的关键先验;消融显示它在小预算下能带来约 17-19 个百分点的提升。
研究动机
自回归解码依赖 KV 缓存,其内存占用随上下文长度和 batch size 线性增长,在长上下文场景成为推理的主要瓶颈:它同时限制了可服务的 batch 大小和峰值吞吐量。架构层面的方案(线性注意力、状态空间模型、GQA/MLA 等)需要预训练或大量微调,而当前主流开源模型(Mistral-7B、Llama-3.1-8B、Qwen 等)仍然是 GQA 加完整 KV 缓存。后训练压缩因此分成三大家族:驱逐(eviction)丢弃不重要 token、量化(quantisation)降低存储精度(但因通道级离群值,低于 4-bit 退化剧烈)、低秩分解(low-rank)对 KV 矩阵做因子化近似。这三类方法分别利用 token、数值精度和特征维度上的冗余,彼此大致正交,但它们共同留下了一个几乎未被探索的冗余轴:同一个注意力头内 key 与 value 之间的关系。key 和 value 由同一个隐状态经不同投影矩阵计算而来,共享的来源意味着 value 在很大程度上可以由 key 预测出来,这部分可预测性在传统方法中被完全浪费——每个 value 向量都被原样存储,尽管它几乎可以从旁边已保留的 key 向量中恢复。
本文的目标是本文的目标是在完全冻结的预训练模型上、不修改任何架构与注意力计算的前提下,将 KV 缓存压缩到激进程度同时保持接近无损的下游性能,并且能与既有压缩方法自由组合。具体目标分解为三步:第一,系统性地识别 KV 缓存中最佳的可预测结构——在多种源-目标组合中确认"当前层 key 预测当前层 value"在固定压缩预算下恢复的下游性能最高;第二,设计值缓存摊销机制,用一个测试时拟合的轻量预测器替代大部分 value 存储,仅对预测最差的 token 保留残差,实现 4 倍近无损的 value 压缩;第三,将值摊销与跨层低秩键压缩(xKV)配对组成 LowRAM 流水线,并通过元学习初始化和选择性重建把预填充与解码开销降到可用水平,最终与量化和驱逐组合在长上下文上达到 26.9 倍压缩、保留 94.5% 基线性能。
与已有工作不同的是,本文的独特切入角度有三层。其一,把"头内 key 到 value 的可预测性"确立为一个独立于 token、层、特征维度的第四冗余轴,并用受控的源-目标分析实验支撑:在统一的预测器加残差存储框架、统一 3 倍压缩预算下,比较 $K_{L-1}\to V_L$、$V_{L-1}\to V_L$、$V_L\to V_L$、$K_L\to V_L$ 等多种组合,发现同层 key 到 value 方向恢复的 LongBench 性能最高。其二,作者发现重建误差与下游性能仅弱相关——重建误差接近的配置可能给出显著不同的下游表现,key 与 value 的量纲差异也使绝对误差不可直接比较——因此全部设计决策以下游恢复性能而非代理误差为准,这修正了此前 AQUA-KV 等基于误差的分析结论。其三,采用不对称设计:value 走预测重建路线,而 key 因误差直接扰动注意力 logits、危害更大且不适合预测,改走其谱能量集中、天然适配的低秩分解路线。这种"按结构差异区别对待 key 与 value"的视角是本文与以往对称压缩方法的本质区别。
核心方法
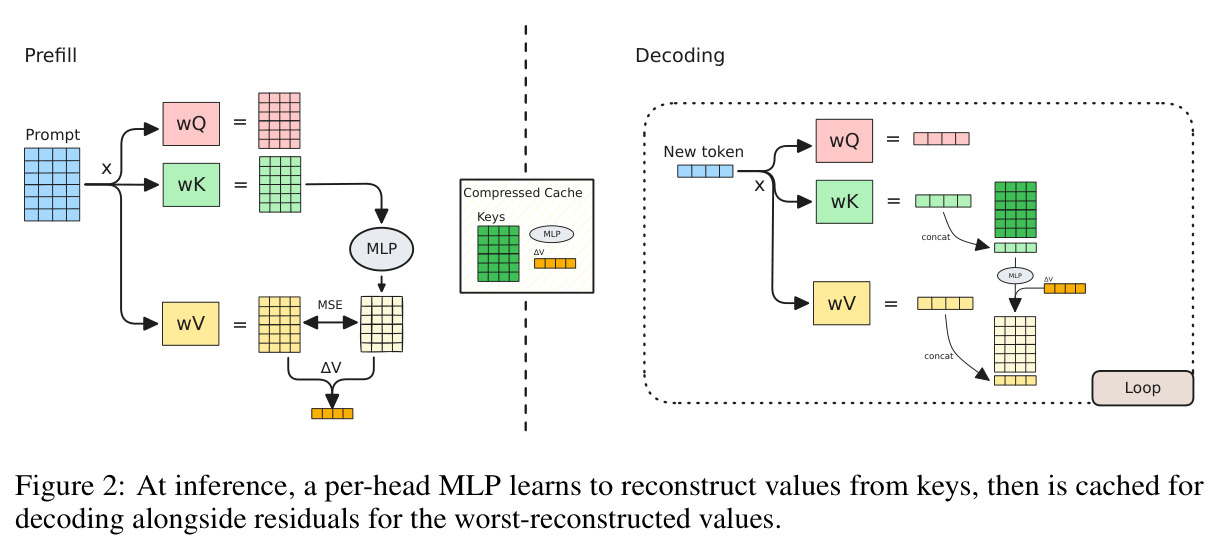
先说直觉:在每个注意力头内部,value 向量几乎是对应 key 向量的确定函数(两者来自同一隐状态的不同线性投影),所以与其存下所有 value,不如存一个"从 key 算出 value 的小网络",再只为网络猜得最不准的少数 token 存精确修正值。技术上 LowRAM 是一条不对称流水线。预填充阶段:先反转 RoPE 得到 pre-RoPE 表示(这类表示更可压缩,注意力时再重新施加旋转);键侧采用 xKV 的跨层低秩分解,把层组内各层的 key 拼接成大矩阵做 $M\approx AB$ 因子化,$A$ 为组内共享基、$B$ 为层特定矩阵,秩按目标压缩比反解;值侧为每个层、每个 KV 头拟合一个两层 MLP 加线性残差分支的预测器 $f_\theta$,以 Slim Attention 伪逆初始化,用 MSE 损失在当前上下文的 KV 对上过拟合,随后按逐 token 重建误差排序、只保留误差最大的 top-$p$ 比例 token 的残差 $\Delta V$,稠密 value 缓存即被"网络参数 + 稀疏残差"取代。解码阶段:每步用(压缩后的)key 前向一遍 MLP 重建 value 并加回残差,即 $\tilde{V}=f_\theta(K)+G\odot\Delta V$;生成中的新 token 的 KV 则原样精确存储。为控制开销,元学习初始化把逐上下文适应降到 2 步梯度更新;选择性重建借鉴 ShadowKV 的地标检索,每步只重建查询选中的 top-k 分块;键分解用随机化 Cholesky-QR 替代精确 SVD 获得 4 倍加速。
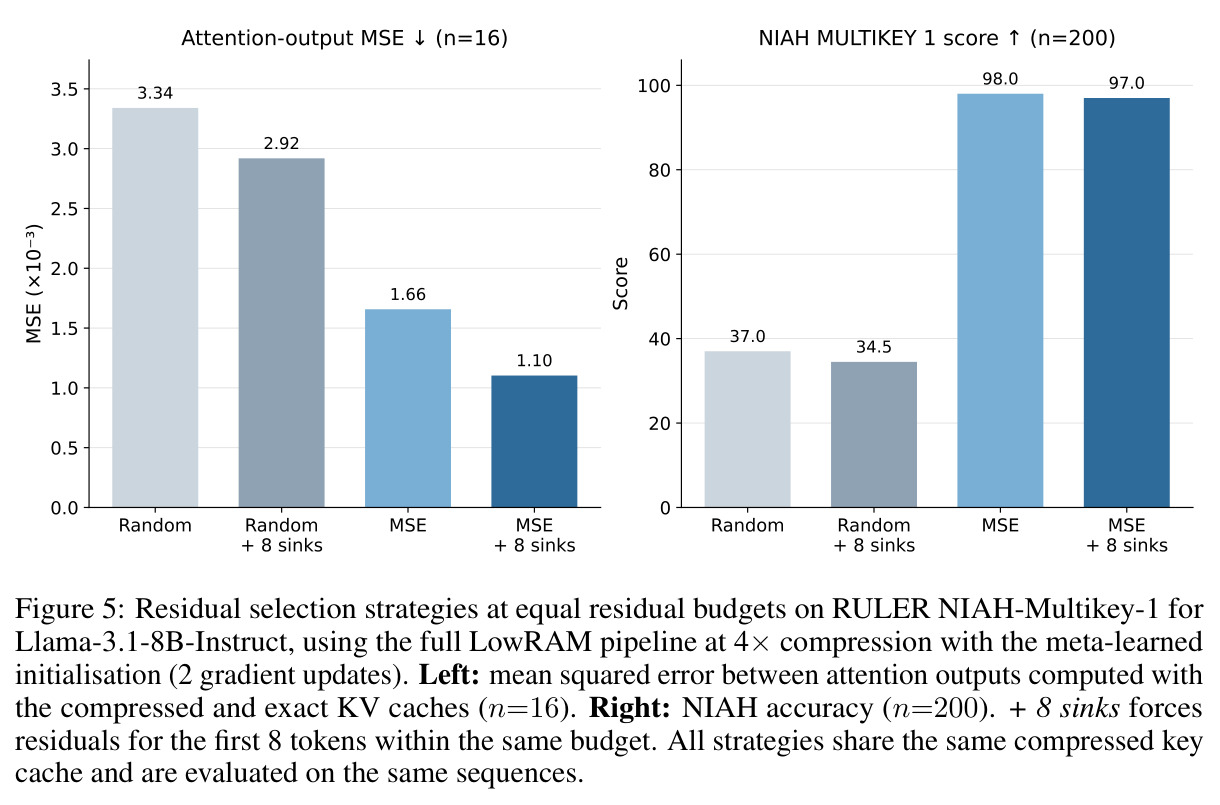
核心创新是"值缓存摊销"(value cache amortisation):把 value 缓存从"逐 token 存储向量"重新参数化为"一个上下文自适应的 key 到 value 预测器 + 只覆盖最难预测 token 的稀疏残差集"。与已有方法的本质区别有三点。第一,与 Slim Attention 相比:Slim 只能给出权重决定的固定线性映射,在 GQA 下不可逆、精度有限;LowRAM 在其上叠加测试时拟合的非线性 MLP 修正和误差排序残差,把"理论最优线性近似"升级为"逐上下文过拟合的非线性记忆"。第二,与 AQUA-KV 等预测式压缩相比:AQUA 用冻结的线性适配器跨层预测、残差策略固定,而 LowRAM 的预测器逐头独立、在当前上下文上主动过拟合、残差只给预测最差的 token(消融显示误差排序残差是命门——换成随机选择,NIAH 准确率从 98% 跌到 40% 以下)。第三,与把 key 和 value 对称处理的所有方法相比:本文用实验证明 value 更适合预测(其误差只作用于注意力权重固定后的加权求和,而 key 误差会改变注意力分布、伤害扩散),从而导出"值预测 + 键低秩"的不对称架构。此外,FOMAML 在此被用于一个非常规目标——不是跨任务泛化,而是让网络用 2 步梯度就"记住"当前上下文的 KV 对,这是快速记忆式元学习在推理系统中的新用法。
方法步骤详情
完整流程分预填充和解码两段。预填充步骤一:反转 RoPE,得到 pre-RoPE 的 key 与 value。步骤二(键压缩):将每 $G$ 个相邻注意力层的 key 沿特征维拼接为 $M\in\mathbb{R}^{m\times n}$,分解为 $M\approx AB$,秩 $k$ 由目标压缩比解 $k=\frac{mn}{r_K(m+n)}$ 得到,存储 $A$(随序列长度缩放)与 $B$(固定大小)。步骤三(值摊销拟合):逐层进行——当第 $\ell$ 层产生 KV 状态后立即拟合该层再前进,使稠密 value 目标和优化器状态任一时刻只驻留一层,峰值内存大幅降低。每个 KV 头的预测器为 $f_{\theta}^{\ell,h}(k)=\sigma(kW^{(1)}+b^{(1)})W^{(2)}+b^{(2)}+kW_{lin}$,两层 MLP(隐宽因子 $\gamma=1$、ReLU、Adam、学习率 $0.001$、150-300 步),$W_{lin}=W_K^+W_V$ 为 Slim 伪逆初始化;层内各头以头维作为批维并行训练。步骤四(warm-start):离线对 FineWeb-Edu 32 批 $\times$ 4096 token 序列预训练 25 步(单 GPU 不足 5 分钟,每模型一次),在线拟合以此为起点。步骤五(残差存储):计算 $e_i=\|f_\theta(k_i)-v_i\|_2^2$,取误差排名前 $p$ 比例的 token,存储 $\Delta v_i=v_i-f_\theta(k_i)$ 及其索引,丢弃稠密 value。解码步骤六:每步用压缩 key 重建 $\tilde{V}=f_\theta(K)+G\odot\Delta V$ 并执行标准注意力;新 token 的 KV 精确追加。可选加速:元学习初始化(FOMAML,$K=2$ 内环步、内环学习率 $10^{-3}$、外环 AdamW $3\times10^{-4}$、梯度累积 8 序列)把在线适应压到 2 步;选择性重建把前缀切成 8-token 分块并以均值 key 作地标,离群分块(48 块)与最近 32 token 窗口精确保留,其余按查询检索 top-k 分块(预算 2048 token)再重建,配持久缓冲复用相邻步的选择;键分解以随机化 Cholesky-QR 完成,加速 4 倍。组合时,驱逐先用 CNN 重要性预测器筛 token(保留 top-$\rho T$,强制前 8 个 sink 与最后 64 token 窗口),量化用 TurboQuant 只压低秩基 $A$(4-bit)与值残差(2-bit)。
技术新颖性
从技术新颖性看,本文的贡献不在于发明单个新组件,而在于冗余轴的识别与组件的系统性重组。第一,"头内 key 到 value 可预测性"作为压缩目标此前只有零星线索(Slim Attention 用于 MHA 无损减半、AQUA-KV 的跨层预测),本文第一次给出在预测器+残差框架下、以下游性能为准绳的系统源-目标对比(Figure 3),并揭示"重建误差与下游性能弱相关"这一反直觉事实。第二,测试时过拟合的思想源自 test-time training 和 fast weight programmers(Schmidhuber),但本文将其部署在完全不同的场景:不改模型、不改注意力,只在预填充后对冻结 Transformer 的缓存做一次性拟合,属于把"在线学习即记忆"的抽象嫁接到 KV 缓存压缩上。第三,误差排序残差与可学习预测器的组合是内容寻址记忆(associative memory)的标准套路,但"按重建误差分配精确存储"的稀疏化策略以及证明其必要性(随机残差使 NIAH 从 98% 崩到 40%)是本文的实证贡献。第四,工程层面的新颖性包括:Slim 伪逆作为 GQA 下的可学习初始化(Table 9 显示 per-head 伪逆加 MLP 修正是精度与压缩的正确折中)、FOMAML 用于快速记忆、随机化 Cholesky-QR 替代 SVD。局限在于各组件均有所本(xKV、TurboQuant、ShadowKV、Slim Attention),系统集成的贡献大于算法原理的贡献,且不对称设计的理论解释(key 误差扰动 logits、value 误差后置)仍停留在直观论证层面。
实验结果
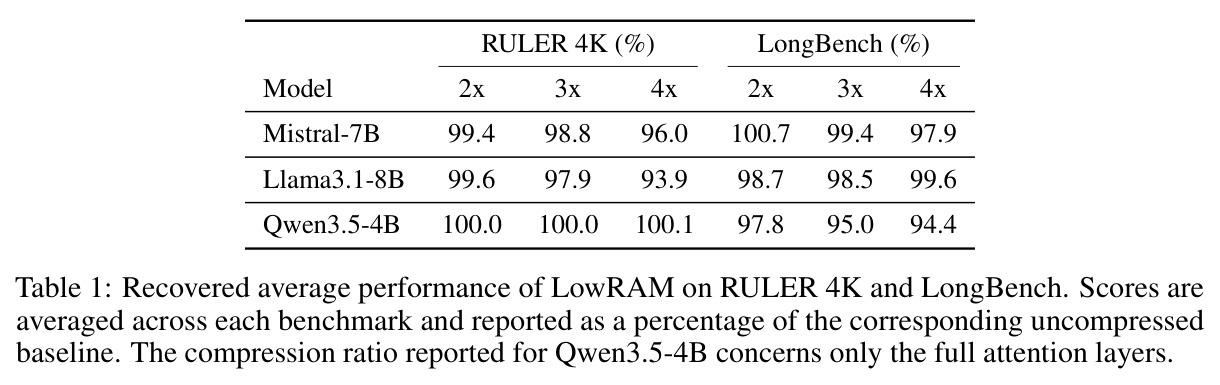
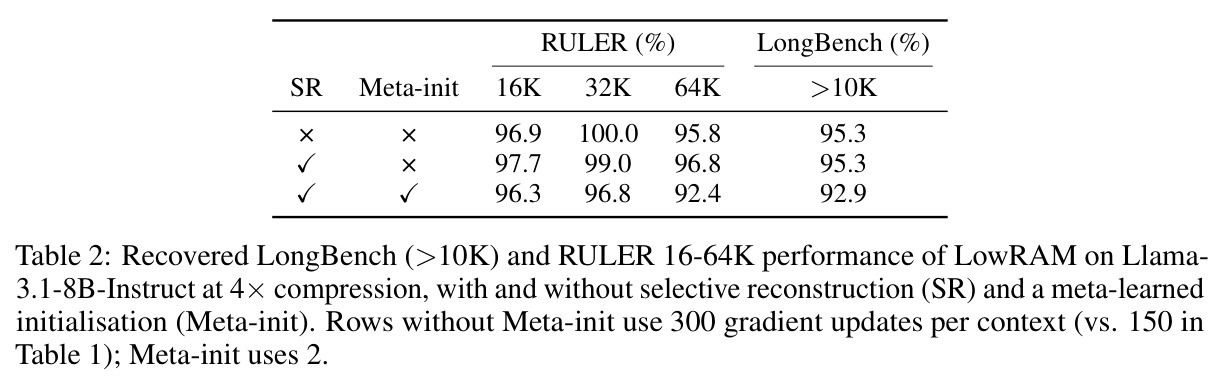
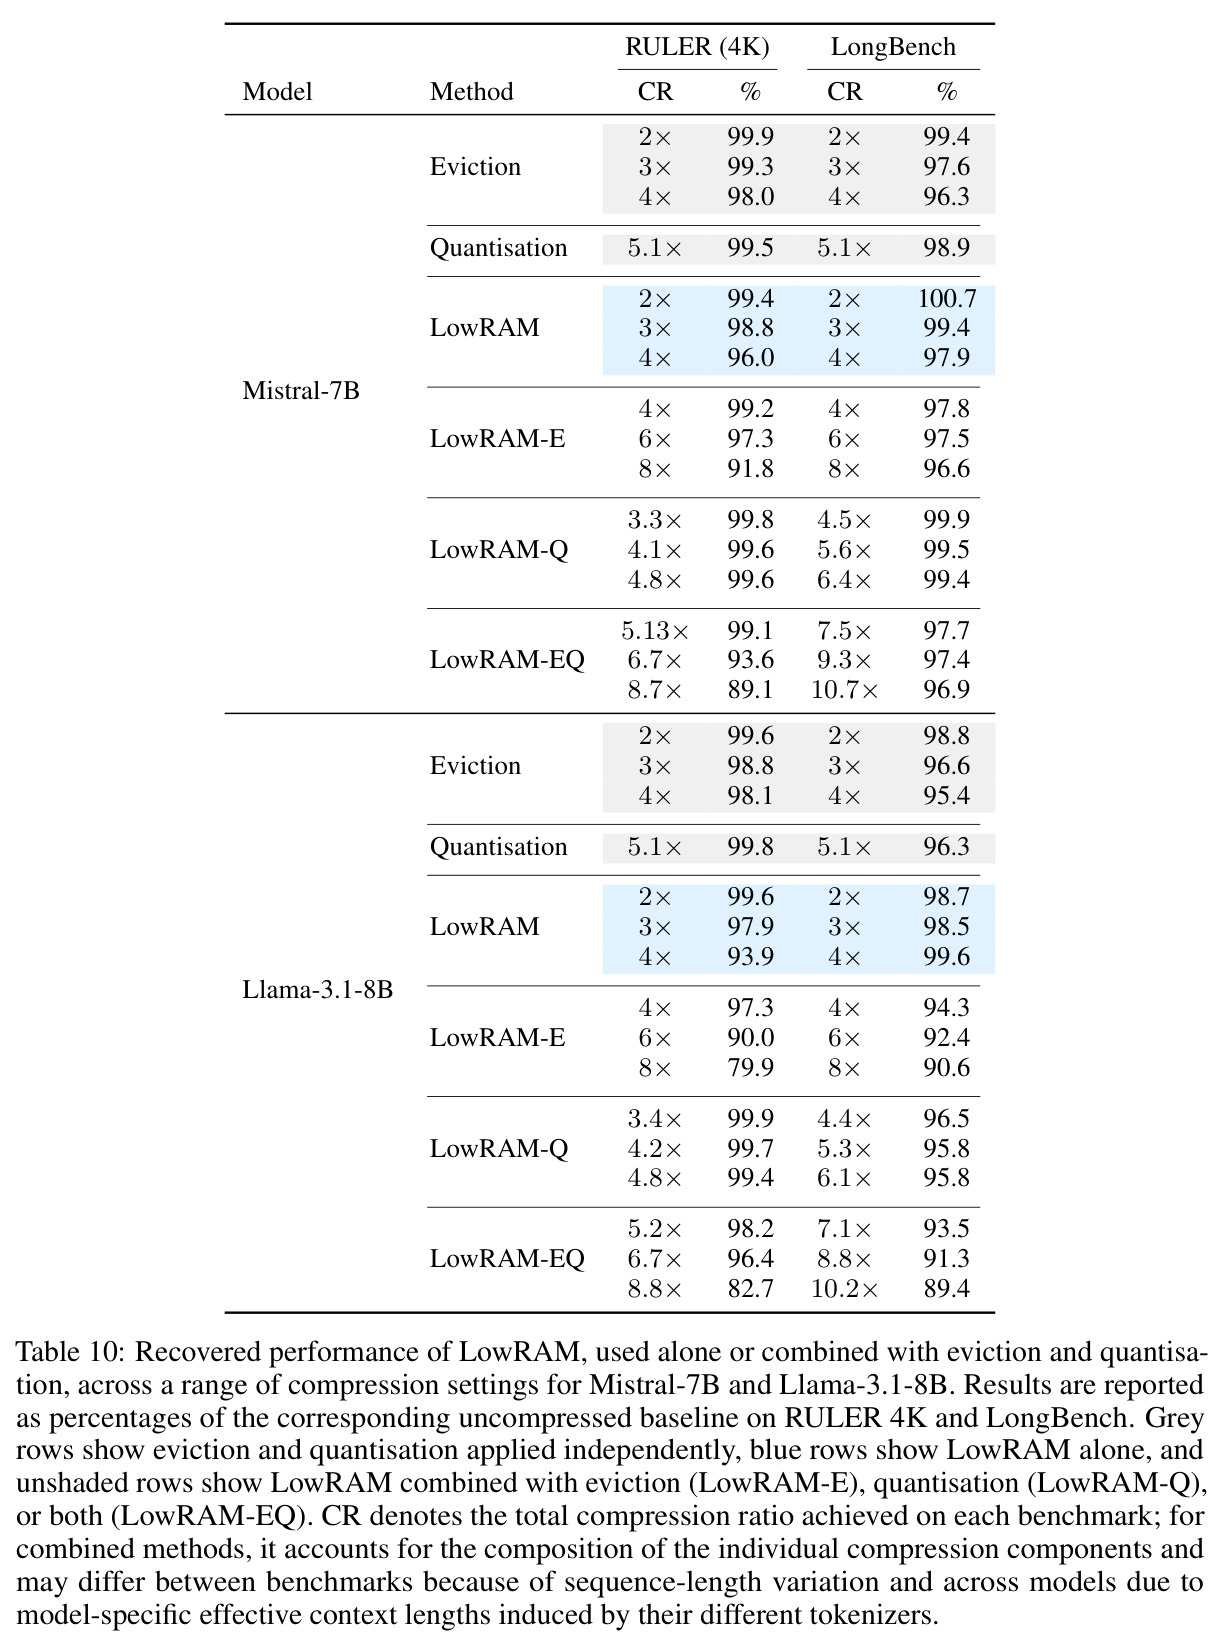
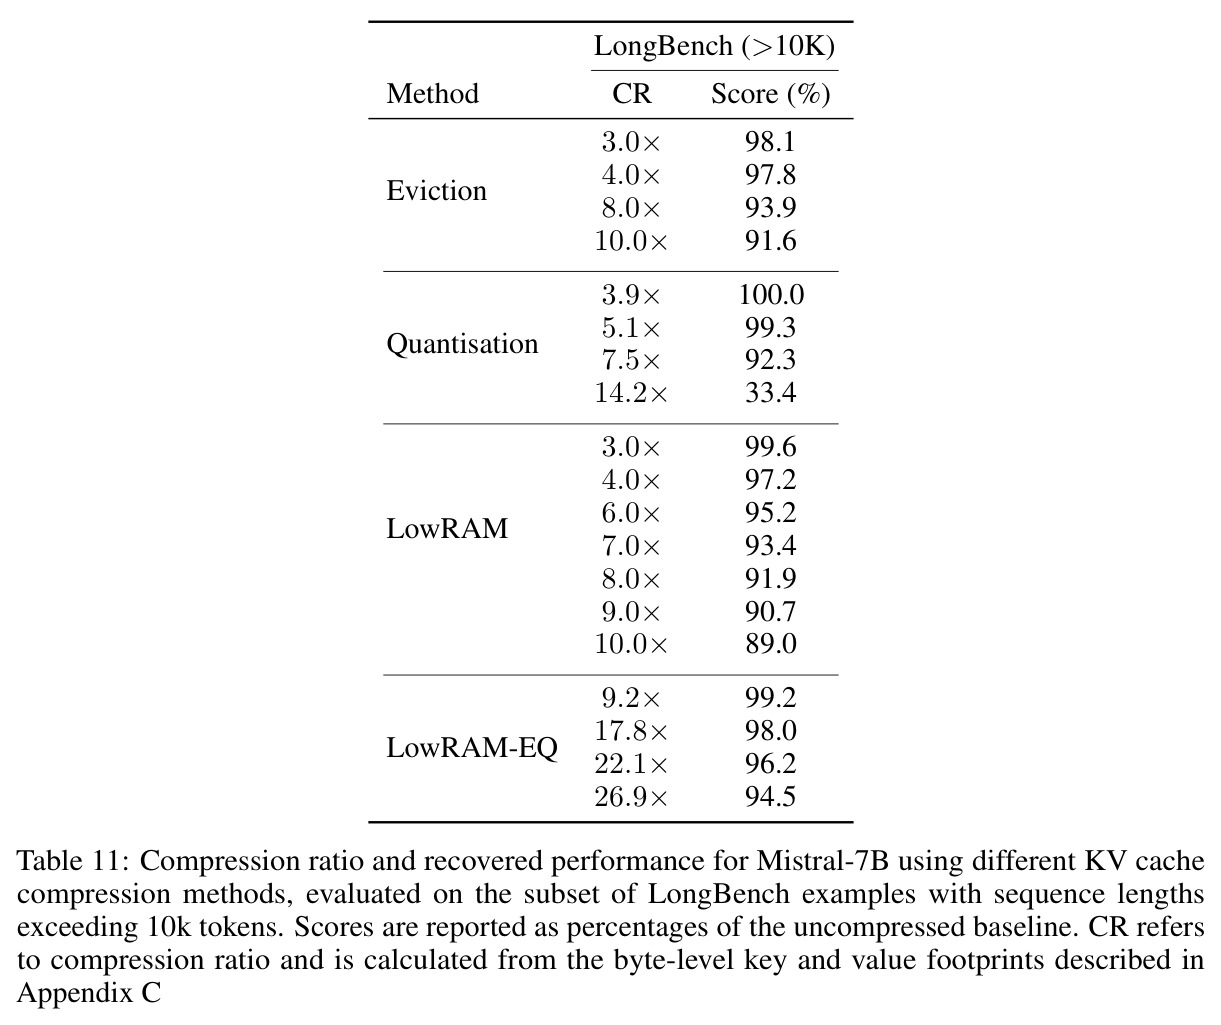
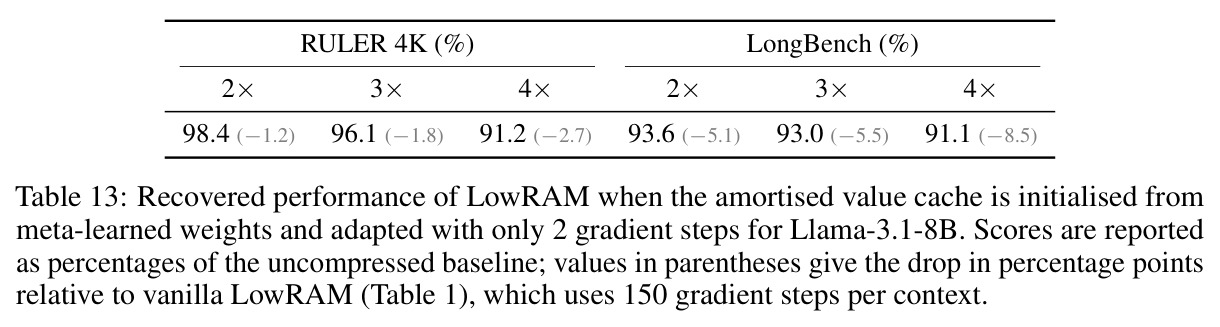
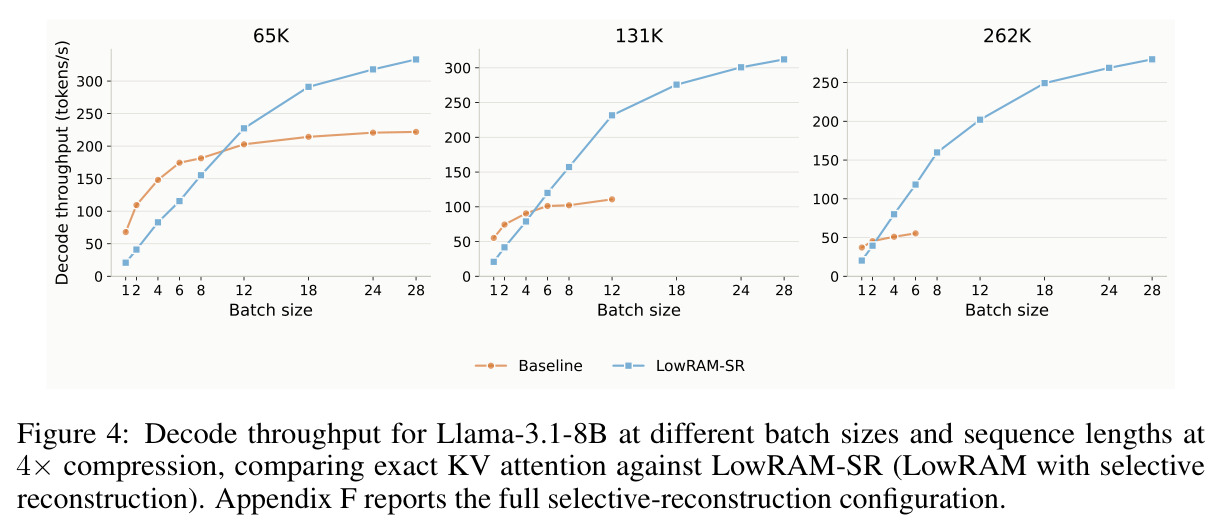
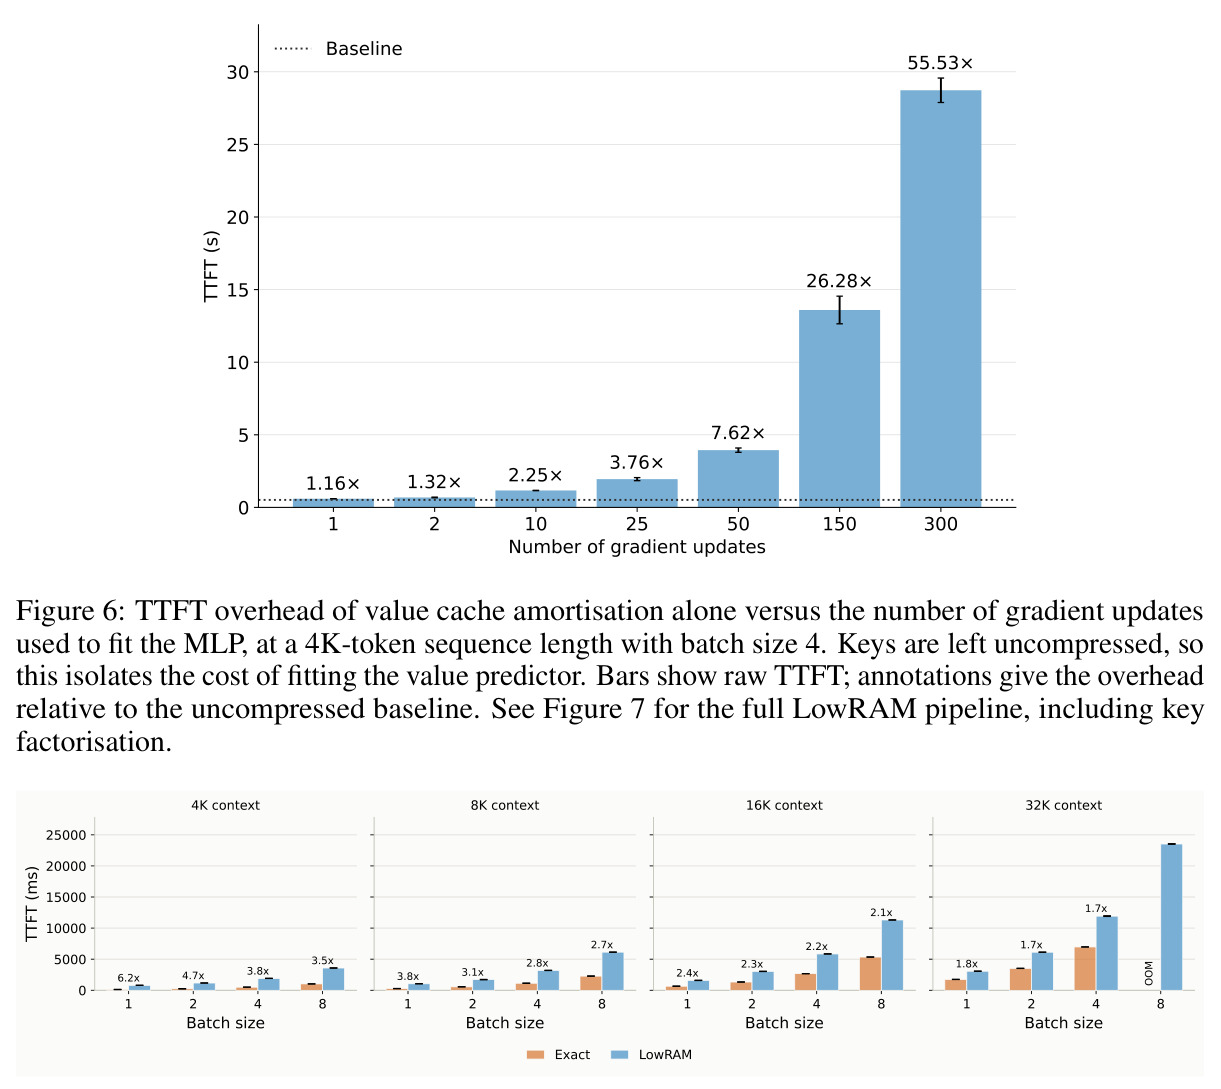
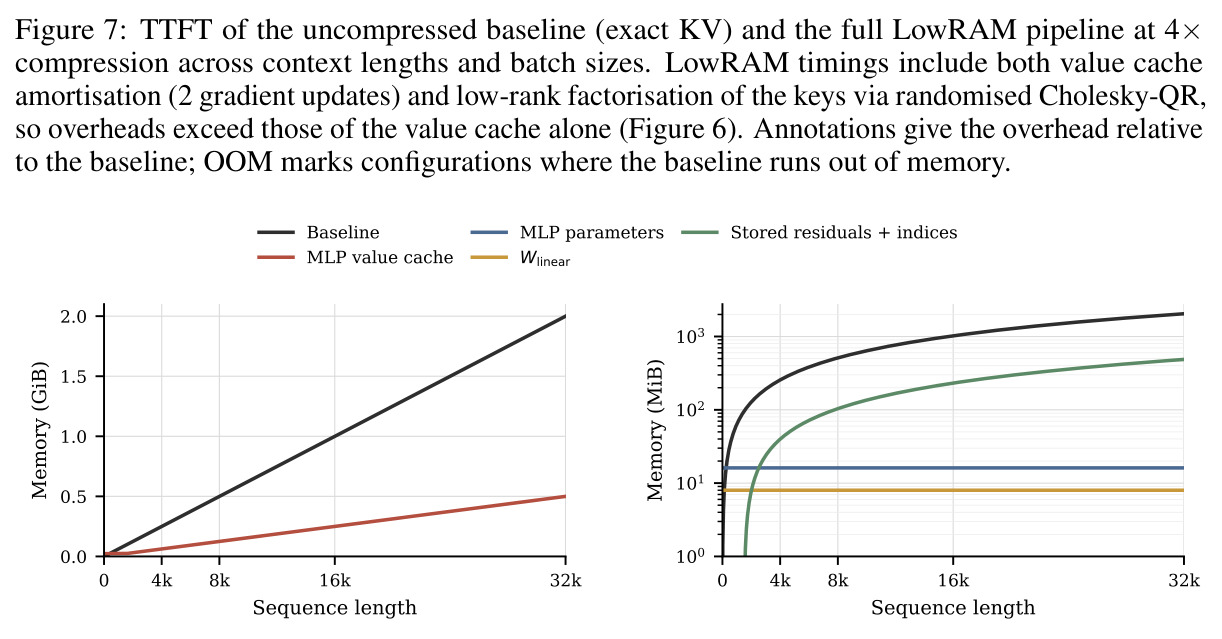
端到端压缩(Table 1):在三个模型家族上,Mistral-7B 与 Llama-3.1-8B 在 3 倍压缩下保留 97.9-99.4% 基线性能,4 倍下仍有 96.0-99.6%,唯一例外是 Llama 在 RULER 上跌到 93.9%(作者归因于残差预算缩减);Qwen3.5-4B(混合注意力架构,只压全注意力层)RULER 与基线持平(100.0-100.1%),LongBench 恢复 94.4-97.8%。效率(Table 2、Figure 4、Figure 6):元学习初始化把逐上下文适应从 150/300 步压到 2 步,值摊销的 TTFT 开销从基线的 26.3 倍/55.5 倍降到 1.3 倍;选择性重建(LowRAM-SR)精度几乎无损(LongBench >10K 与全重建持平、RULER 各长度差在 1 点内),解码吞吐在 4K/32K/262K 上下文、batch 28 下持续超越基线——基线在小 batch 更快但很快受内存限制趋于平台,LowRAM-SR 在 262K token 时达到约 5 倍基线峰值吞吐。两者同时开启时仍恢复 RULER 92.4-96.8%、LongBench >10K 92.9%。组合压缩(Table 3、Table 10):量化与 LowRAM 协同最强——Mistral LongBench 上 LowRAM-Q 达 6.4 倍压缩、恢复 99.4%(高于 LowRAM 单独的 4 倍 97.9%),Llama RULER 上从 93.9% 升到 99.4%;原因是残差以 2-bit 存储后同预算可留更多残差。驱逐组合则呈清晰权衡:Mistral 上 4 倍 LowRAM-E 优于单独驱逐(RULER 99.2% vs 98.0%),Llama 上不成立(8 倍 LowRAM-E RULER 仅 79.9%),因为驱逐缩短序列但网络固定成本不变。极限压缩(Table 4、Table 11):在 LongBench >10K 子集上,保持至少 90% 基线性能的最大压缩为——驱逐 10.0 倍(91.6%)、量化 7.5 倍(92.3%)、LowRAM 9.0 倍(90.7%)、LowRAM-EQ 26.9 倍(94.5%),全栈大幅领先。隔离实验(Table 5):只压 value 时,摊销在 4 倍下恢复 RULER 98.2%、LongBench 99.3%,xKV 值压缩为 99.3%/95.8%,验证值更适合摊销、键更适合低秩的不对称设计。消融(Table 7、Figure 5、Table 8):去掉残差存储损失 34.1 点(99.0%→64.9%)、线性预测器替代 MLP 损失 41.5 点(→57.5%)、每层共享 MLP 损失 19.5 点(→79.5%,说明映射强烈依赖头);残差按误差排序得 98% NIAH 准确率而随机选择不足 40%;优化预算从 10 步增到 300 步使 4 倍 RULER 恢复从 61.5% 升到 98.2%,Slim 先验仅在小预算(10 步)时价值大(+17.5/+19.1 点),200 步后优势消失。
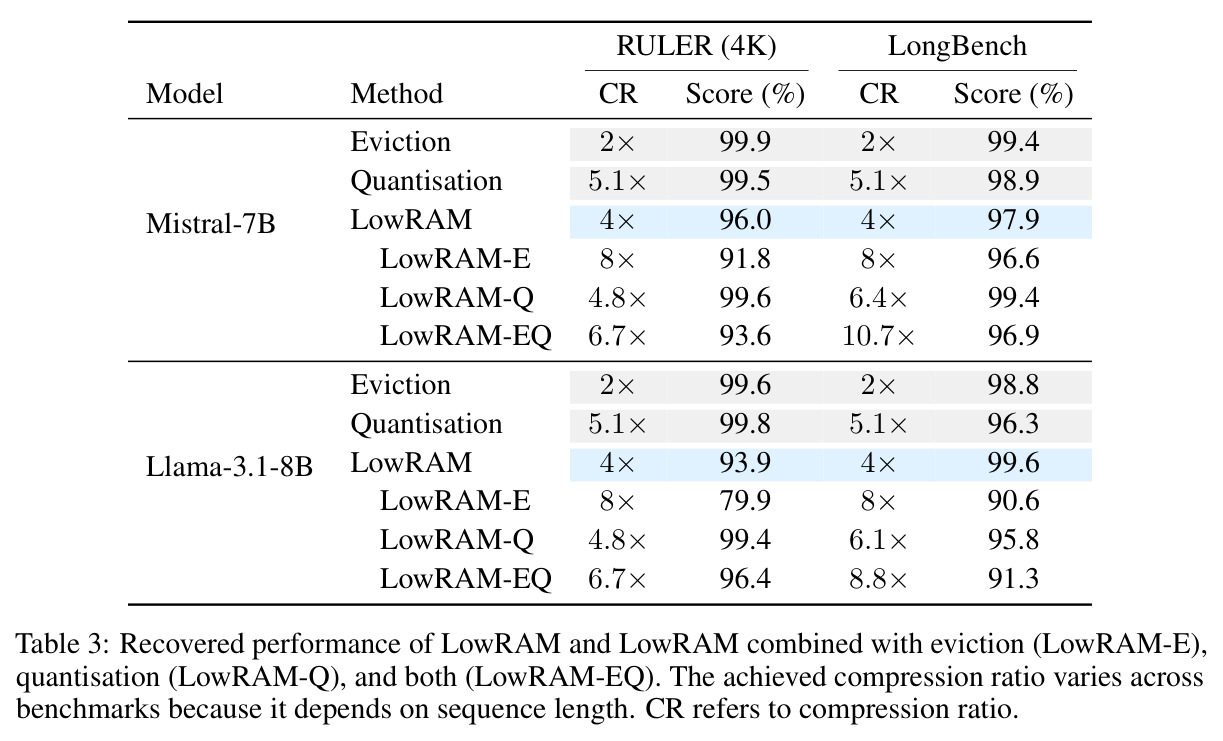
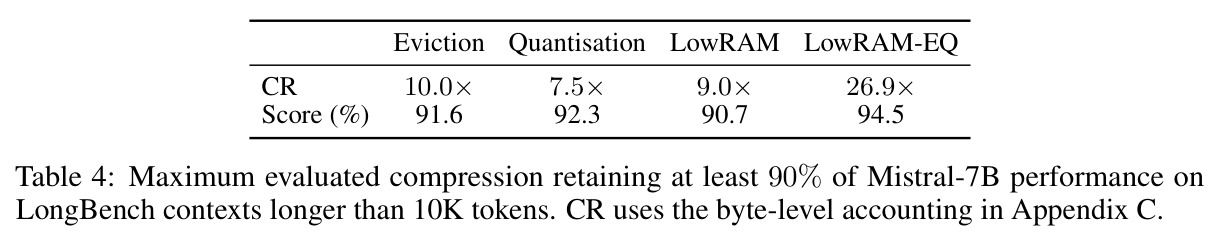
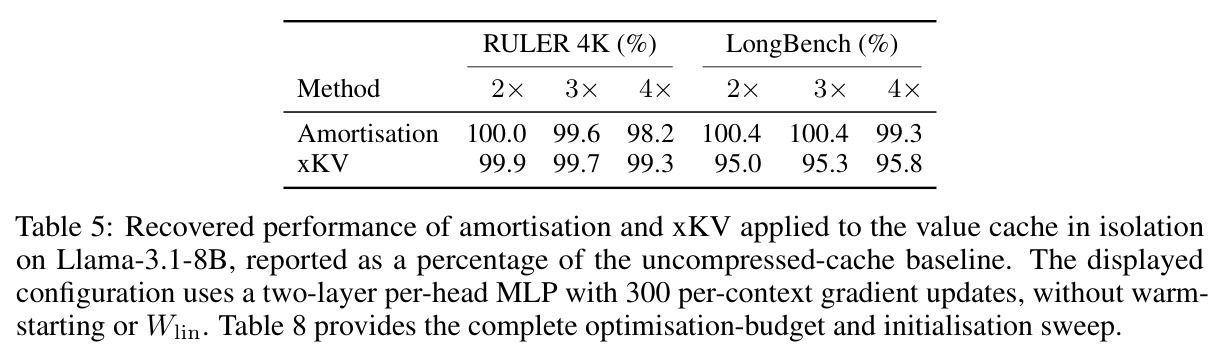
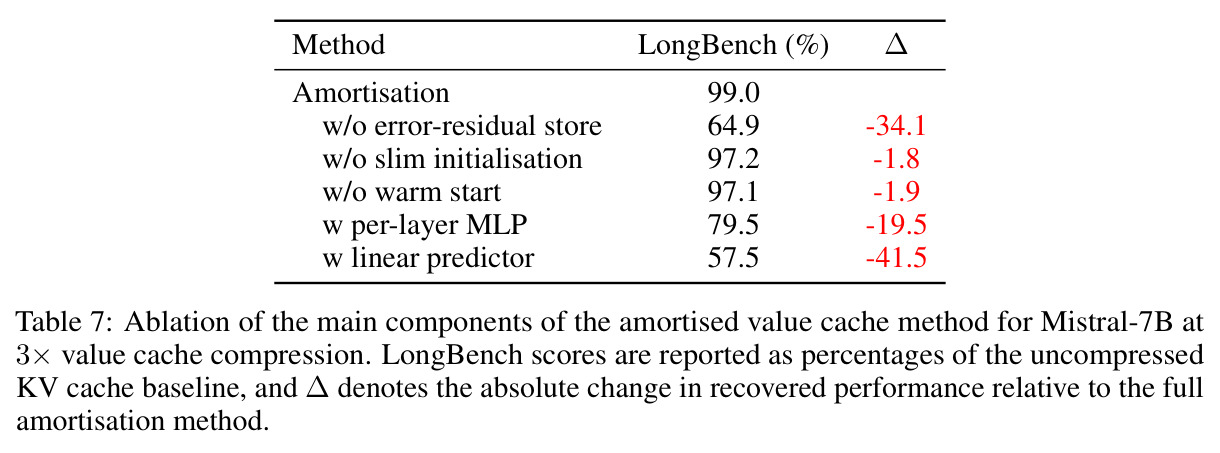
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RULER 4K 长上下文能力(Mistral-7B) | 相对未压缩基线的恢复性能 | LowRAM 3×: 98.8%,4×: 96.0% | 未压缩 KV 缓存(100%) | 3× 压缩近无损(损失 1.2 点);与单独量化 5.1×@99.5% 相比压缩比略低但同为近无损区间 |
| LongBench 长文本任务(Mistral-7B) | 相对基线的恢复性能 | LowRAM 4×: 97.9%;LowRAM-Q 6.4×: 99.4% | 未压缩 KV 缓存(100%) | 加量化后压缩比从 4× 提高到 6.4× 且恢复性能不降反升(+1.5 点) |
| RULER 4K(Llama-3.1-8B,量化协同) | 相对基线的恢复性能 | LowRAM-Q 4.8×: 99.4% | LowRAM 单独 4×: 93.9% | 压缩比更高(4.8× vs 4×)同时恢复性能提升 5.5 个百分点 |
| LongBench >10K 极限压缩(Mistral-7B) | 保持 ≥90% 基线性能的最大压缩比 | LowRAM-EQ 26.9× @ 94.5% | 驱逐 10.0× @ 91.6%;量化 7.5× @ 92.3%;LowRAM 9.0× @ 90.7% | 压缩比达最强单方法的 2.7 倍,且恢复性能反而更高(94.5% vs 90.7-92.3%) |
| 解码吞吐(Llama-3.1-8B,262K 上下文,4× 压缩) | 峰值 decode throughput | 约 5× 基线峰值吞吐,batch 28 可稳定服务 | 精确 KV 注意力(小 batch 更快但内存受限平台化并 OOM) | 长上下文大 batch 场景峰值吞吐提升约 4 倍 |
| 预填充时延(TTFT,4K 序列) | 相对未压缩基线的开销倍数 | Meta-init 2 步适应:1.3× | 完整适应 150 步:26.3×;300 步:55.5× | TTFT 开销降低约 20-43 倍,代价为 RULER 1.4-4.4 点、LongBench 2.4 点精度 |
局限与改进
作者明确承认的局限有三:其一,未评估长生成场景——当前流水线在预填充时一次性拟合,若生成内容很长,需要对新生成 token 的后缀做周期性压缩(如每 N 个 token 重拟合一次),这在论文中尚未实现;其二,学到的参数化有多少能跨上下文保留尚不清楚,warm-start 与 Slim 初始化的收益说明 key 到 value 映射存在共享成分,测试时适应的收益说明也存在上下文特定成分,二者的划分未被量化;其三,难以预测的 token 是否跨上下文稳定未知,若稳定则残差索引也可摊销。我自己的观察补充如下:固定网络参数成本使方法在短上下文上失效——Figure 8 显示摊销要到约 2-3K token 后才回本,这解释了 RULER 4K 上恢复率系统性低于 LongBench、以及 Table 13 中 2 步 meta-init 在 RULER 4K 上掉 1.2-8.5 点的现象;即便有元学习,TTFT 仍是基线的 1.3 倍,对延迟敏感的短查询交互不友好;SR+Meta 全开时 RULER 64K 掉到 92.4%,说明超长上下文下地标检索有真实损失;驱逐组合对 Llama 几乎不可用(8× 时 RULER 79.9%),组合性并非普适;Qwen3.5-4B 的 LongBench 4× 只剩 94.4%,混合架构上的表现弱于稠密模型;此外每头独立 MLP(共享掉 19.5 点)使固定成本与 KV 头数成正比,对多头大模型不友好;最后,整条流水线的工程复杂度相当高(逐层训练、地标检索内核、持久缓冲、元训练),论文未提供开源代码,复现门槛不低。
独立分析的弱点
弱点一:短上下文负收益。固定成本(每头 MLP 参数加 $W_{lin}$)在约 2-3K token 以下主导内存,RULER 4K 上 meta-init 版本恢复率仅 91.2-98.4%,甚至低于无摊销的量化基线。改进方向:按上下文长度自动门控——短序列直接走量化、超过阈值再启用摊销,或用极低秩头间共享参数(如对每头 MLP 的权重做跨头低秩约束)压缩固定成本本身。弱点二:长生成未被覆盖。预填充后拟合的映射对分布漂移的生成后缀会逐渐失配,且生成 token 的 KV 是精确存储的,长生成会把压缩收益稀释。改进方向:在线/增量摊销——以滑动窗口周期性重拟合或用 delta-rule 风格的在线更新(呼应 Titans/TTT 一线工作)持续吸收新 KV。弱点三:元学习初始化有精度税。Table 13 显示 2 步适应比 150 步在 RULER 4K 上最多掉 8.5 点、LongBench 掉 5.1 点。改进方向:更好的快速适应算法——把内环换成闭式解(如最小二乘/岭回归拟合线性分支、只对 MLP 残差做少量梯度步),或元学习时直接以"K=2 步后的重建误差"为外环目标并加大任务多样性。弱点四:残差选择依赖重建误差这一有缺陷的代理。Figure 3 与 Figure 5 都表明误差与下游性能脱钩(强制 sink 残差降注意力输出误差但不升准确率)。改进方向:用注意力输出扰动(如压缩与精确注意力输出之差)或查询感知的重要性作为选择准则,配合轻量校准。弱点五:压缩比的计算把精确存储的新生成 token、地标与离群块的额外持久状态计入了吗——选择性重建的开销虽被扣减进秩选择(Appendix F),但 TTFT 与解码的额外计算(每步 MLP 前向、检索打分)在小 batch 下反而慢于基线(Figure 4 左端),对低延迟单请求场景吸引力有限。改进方向:为小 batch 场景设计 fused kernel 或只在内存压力出现时切换到压缩路径。
未来方向
作者在第六节明确提出两个方向:其一,长生成支持——对新生成 token 的后缀做周期性压缩(每 N 个 token 重拟合一次)而非依赖单次预填充拟合,这实际上是把摊销从一次性操作变成流式操作;其二,理解可学习参数化的跨上下文持久性——warm-start 与 Slim 先验有效说明 key 到 value 关系有共享成分,测试时适应有效说明有上下文特定成分,搞清这个划分以及"难预测 token 是否跨上下文稳定",可以让内存和计算的分配更高效(例如残差索引缓存复用、按头自适应残差预算)。基于其成果可自然延伸的方向还有:第一,理论化不对称设计——形式化 key 误差经 softmax 放大、value 误差线性后置的伤害模型,推导最优的 key/value 压缩预算分配而不是靠网格搜索;第二,把摊销前移到预训练——若训练时就鼓励每个头的 value 是 key 的可预测函数(类似加一个辅助重建损失),推理时压缩会更无损,这是架构-压缩协同设计的思路;第三,与服务级正交技术组合——与投机解码、prefix caching、共享前缀服务(论文自己指出上下文复用场景下全量适应的精度-成本折中最优)以及 vLLM 类分页内存管理结合,评估真实服务负载下的 SLO 达标率;第四,扩展到多模态与视觉 token 缓存(VLM 的图像 token 冗余结构不同)以及 MLA/MOA 等潜空间注意力架构上的适配;第五,自动超参——按层、按头自适应地分配秩 $k$ 与残差比例 $p$(注意力汇聚层可能根本不需要残差),用可微或强化学习式的资源分配器替代手工配置。
复现评估
复现评估:论文未提供开源代码链接(文中无 GitHub 仓库或"code will be released"声明),但复现所需的细节披露得相当充分。附录 B 给出值重建网络完整配置(两层 MLP、隐宽因子 $\gamma=1$、ReLU、MSE、Adam、学习率 0.001)与逐层拟合流程;附录 E 给出元学习配置(FOMAML、$K=2$、内环 Adam $10^{-3}$、外环 AdamW $3\times10^{-4}$、梯度累积 8);附录 F 给出选择性重建配置(分块 8 token、预算 2048、局部窗口 32、离群 48 块)及内存核算方式;附录 C 给出精确到字节的压缩比公式(含量化与驱逐的复合计算);附录 G 给出基准逐任务统计。所有依赖组件均开源可得:xKV、TurboQuant、ShadowKV、Slim Attention、RULER、LongBench,三个实验模型(Mistral-7B-Instruct-v0.3、Llama-3.1-8B-Instruct、Qwen3.5-4B)均为公开权重。算力方面,warm-start 离线预训练单 GPU 不足 5 分钟、每模型一次,元训练为一次性的离线成本,逐层拟合保证峰值显存只多驻留一层的稠密 value;但吞吐实验(262K 上下文、batch 28)和 fused CUDA 内核(改编自 ShadowKV/xKV 的检索与 Cholesky-QR)需要 A100/H100 级设备与不小的工程投入。综合判断:精度实验(Table 1/3/5/7-11)在单张 80GB GPU 上复现是可行的,难度中等偏高,主要工作量在流水线工程;吞吐与时延数字(Figure 4/6/7)依赖内核优化质量,独立复现出相同绝对值较难,趋势可复现。
论文图表
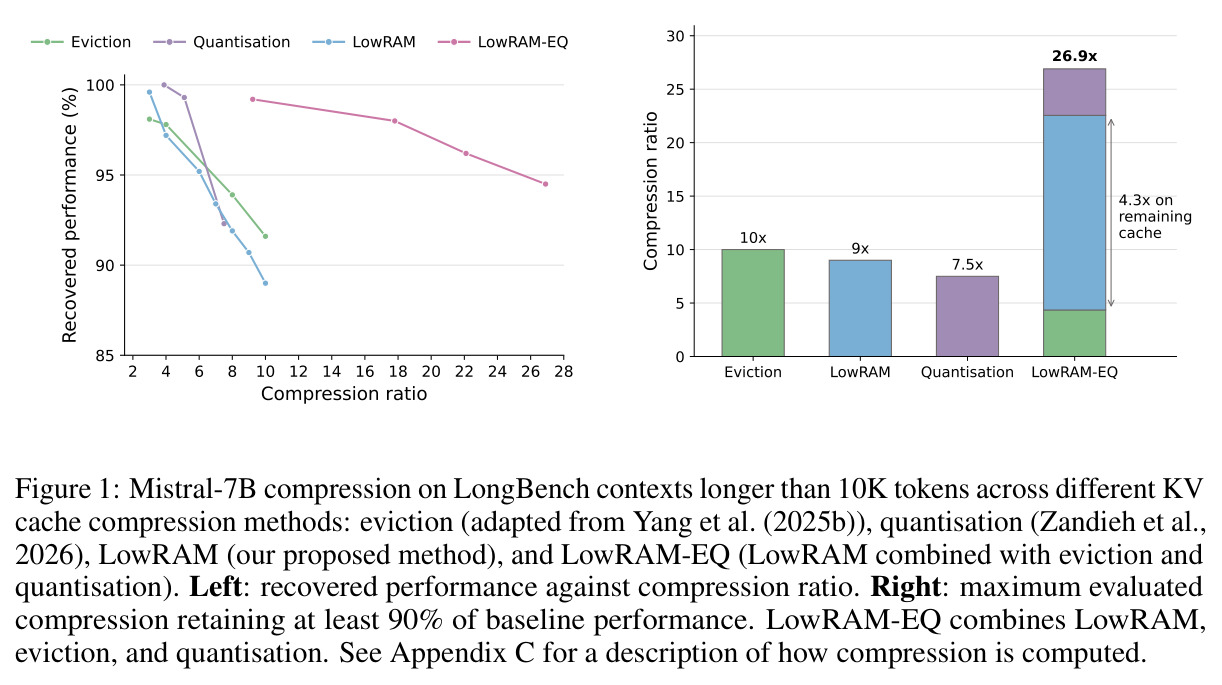
双面板对比图。左图为恢复性能对压缩比的曲线,比较驱逐(adapted from Yang et al. 2025b)、量化(TurboQuant)、LowRAM 与 LowRAM-EQ(三者组合)四条路线;右图为各方法在保持至少 90% 基线性能前提下的最大评估压缩比。LowRAM-EQ 在两个维度上都位于包络线最外侧,达到 26.9 倍压缩且保持 94.5% 性能。
这是全文的鸟瞰图:一图说清 LowRAM 及其组合在精度-压缩权衡上全面优于既有三大类方法的核心卖点,读论文前先看这张图就能抓住结论。
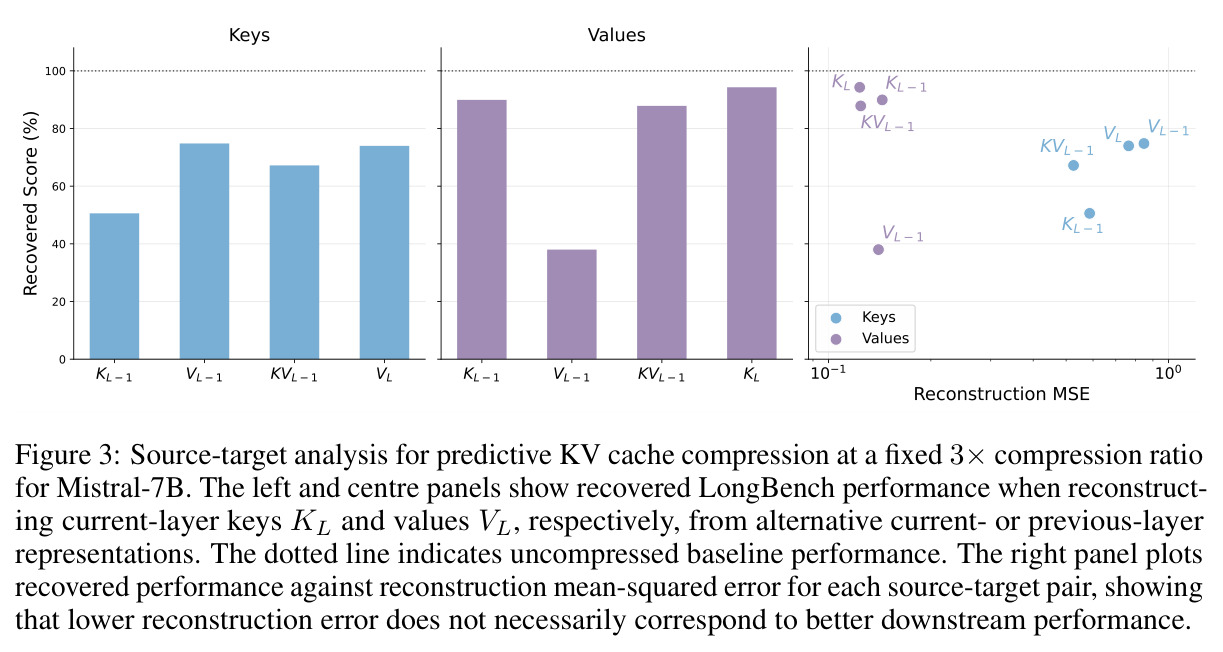
三面板图。左、中面板分别展示以不同源(前层 key $K_{L-1}$、前层 value $V_{L-1}$、拼接 $KV_{L-1}$、当前层 value、当前层 key)重建当前层 key 或 value 时恢复的 LongBench 性能;右面板画出每种源-目标对的重建 MSE 与恢复性能的散点关系。结论:$K_L\to V_L$ 下游恢复最高,且重建误差与下游性能相关性弱。
这是支撑整个方法设计选择的实验根基:为什么选"同层 key 预测 value"这个方向、为什么不按重建误差做设计决策,全部来自这张图的证据。
左图:未压缩基线与 4× 摊销的总 value 缓存内存随序列长度变化;右图:对数坐标下分解摊销方案的足迹组成——MLP 参数与 $W_{lin}$ 是与序列长度无关的常数,只有残差及其索引随 $T$ 增长。固定成本在约 2-3K token 以下占主导,之后被摊销。
解释了方法适用边界(为什么 RULER 4K 表现弱于长上下文、为什么与驱逐组合不佳),是理解论文局限性和"LowRAM 适合长上下文"这一结论的关键。