预填充到自回归跨模型迁移的机遇与挑战 On the Opportunities and Challenges of Prefill-to-Autoregressive Cross-Model Transfer
开源PLatour用RL训练大小模型间线性桥,PACT-Check揭示部分收益并非真正来自信息传递
前置知识
Prefill 与解码分离(Prefill–Decode Disaggregation)
LLM 推理分两阶段:prefill 阶段一次性并行处理整个输入 prompt 并生成 KV cache,计算密集但对 GPU 友好;decode 阶段逐 token 自回归生成,受内存带宽限制。Splitwise、DistServe 等系统将两阶段部署在不同机器上,是成熟的工业架构。PACT 借用这一思路:大模型只做 prefill,小模型做 decode。
PACT 的名字即“预填充到自回归迁移”,理解 prefill 与 decode 的分工才能明白 sender 为何只需处理 prompt、receiver 为何能独立生成,以及 Figure 3 中 TTFT 与解码时间的开销分析。
KV Cache 与 hidden states
Transformer 自回归生成时缓存每层的键值张量(KV cache)以避免重复计算;hidden states 是每层残差流中的隐向量序列,KV 由 hidden states 经预训练投影得到,是更上游的表示。既有跨模型通信方法(C2C、KV-Lingo 等)多直接对齐或翻译 KV cache,本文选择传递 hidden states。
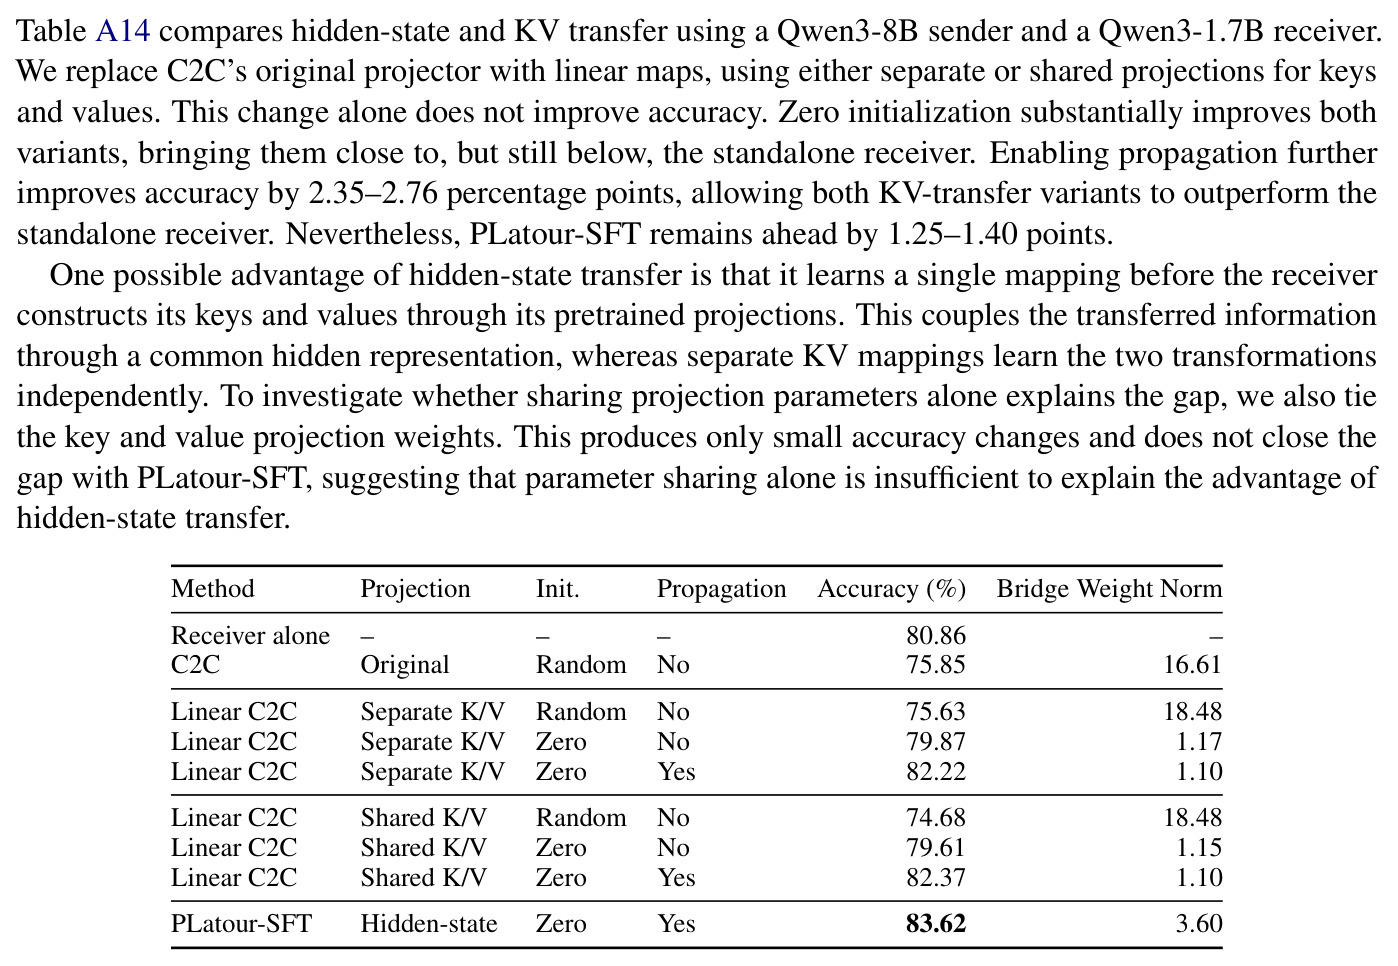
PLatour 与基线的核心分歧就在传 hidden states 还是 KV cache;理解二者关系才能看懂 Table A14 中隐状态传输反超 KV 传输(83.62 vs 82.37)的组件级证据链与机制解释。
GRPO(组相对策略优化)
DeepSeekMath 提出的 RL 算法:对每个问题采样一组回答(本文每题 8 个),用组内相对优势(减均值除以标准差)作为策略梯度信号,无需价值网络。本文用 verl 框架实现,clip 参数 0.2、学习率 $10^{-5}$,直接以任务奖励(答案正确/测试通过)训练。
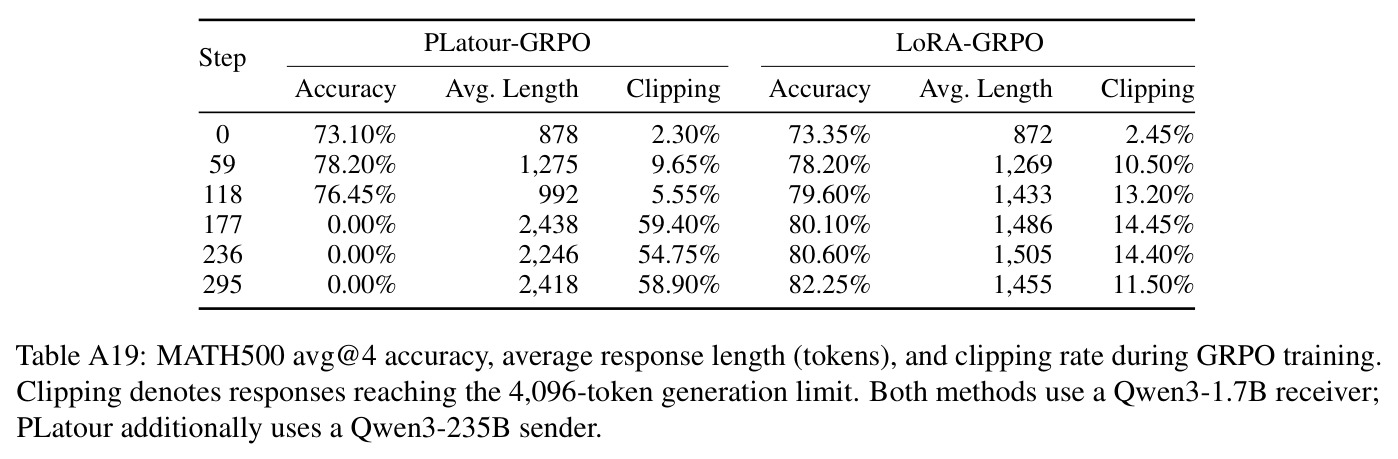
PLatour 的关键设计是绕过 SFT/蒸馏、直接用 GRPO 的奖励信号训练桥;训练不稳定性分析(clipping 尖峰、准确率崩溃)也围绕 GRPO 动态展开,读懂 Table A11、A19 与 Figure A1 都需要它。
参数高效微调(PEFT:Prefix Tuning / Adapter / LoRA)
PEFT 冻结预训练权重、只训练少量新增参数:prefix tuning 学习跨样本共享的连续前缀激活;adapter 在残差流上施加可训练残差变换(如 $\tilde{h} = h + Wh$);LoRA 用低秩矩阵更新权重。He et al. (2022) 的统一视角指出三者本质都是“学习到的隐状态修改”。
本文最重要的洞见:可训练桥在接收问题无关信号时退化为 prefix tuning,自通信(SC)退化为线性 residual adapter。PACT-Check 正是借助这层同构关系质疑“通信增益”可能只是“适配增益”。
柏拉图表示假说(Platonic Representation Hypothesis)
Huh et al. (2024) 提出足够强的模型无论架构与训练数据如何,都会收敛到相似的统计表示结构;OPRD 等工作发现不同模型的 hidden states 投影到共享低秩空间后余弦相似度很高。这暗示跨模型对齐可能只需简单线性映射。
这是 PLatour 敢用一个零初始化线性投影桥接 235B 与 1.7B 模型的理论基础;但作者强调结构相似只是设计起点,能否真正传递有用信息是必须实证检验的问题——这正是 PACT-Check 的出发点。
混合注意力架构(Hybrid Attention)
Qwen3.5 等新一代模型在层间混合使用全注意力与线性注意力层,线性注意力具有更强的局部性偏置且不维护常规形式的 KV cache,导致基于 KV cache 传输的跨模型方法无法兼容这类架构。
传递 hidden states 正是为了绕开这一限制;PLatour 还引入非对称配对约束——全注意力 receiver 层只能配全注意力 sender 层——这是它能把 PACT 扩展到 Qwen3.5、对标闭源 Mostik 的关键。
研究动机
大模型解码成本高、小模型能力不足是部署中的核心矛盾:Qwen3-1.7B 在 GSM8K 上只有 80.86%,而 Qwen3-235B sender 达 94.35%,但后者逐 token 解码的代价高得多。PACT 让大模型只在 prefill 阶段读题、小模型独立生成,理论上兼顾能力与效率。然而现有证据链薄弱:闭源系统 Mostik 声称用 753B sender 加 4B receiver 在数学与编码任务上缩小 47% 的性能差距,但代码与训练细节不公开,既无法复现也难以系统研究;开源方法(C2C、KV-Lingo 等)主要在 ARC-C、MMLU 等选择题任务上验证,在需要长链推理的生成任务上甚至低于不通信的 receiver alone——例如 KV-Lingo 在 235B→1.7B 的 GSM8K 上只有 17.06%。更根本的是,所有这些方法都只报告任务分数提升,从未回答:提升究竟来自 sender 传来的有用信息,还是仅仅因为给 receiver 加了可训练参数带来的适配收益。
本文的目标是本文要做两件事。其一,构建一个开源、简单、可扩展的 PACT 框架 PLatour:支持最长 16K token 的生成预算、超过 100:1 的 sender–receiver 参数比(235B→1.7B),并能兼容 Qwen3.5 这类全注意力与线性注意力混合的架构,从而在规模与架构覆盖上填补开源空白,并在共享基准上挑战闭源 Mostik 的报告结果。其二,建立严格的评估协议 PACT-Check:通过四种对照(Dummy Transfer、Irrelevant Transfer、Self-Communication、Trained Receiver)和 PACT-Score 指标,量化一个训练好的 PACT 系统的收益中到底有多少真正依赖 sender 在 prefill 时传入的、与当前问题相关的信息,从而把“性能更好”与“通信有效”这两个长期被混为一谈的命题区分开,为后续 PACT 研究提供可复用的审计工具。
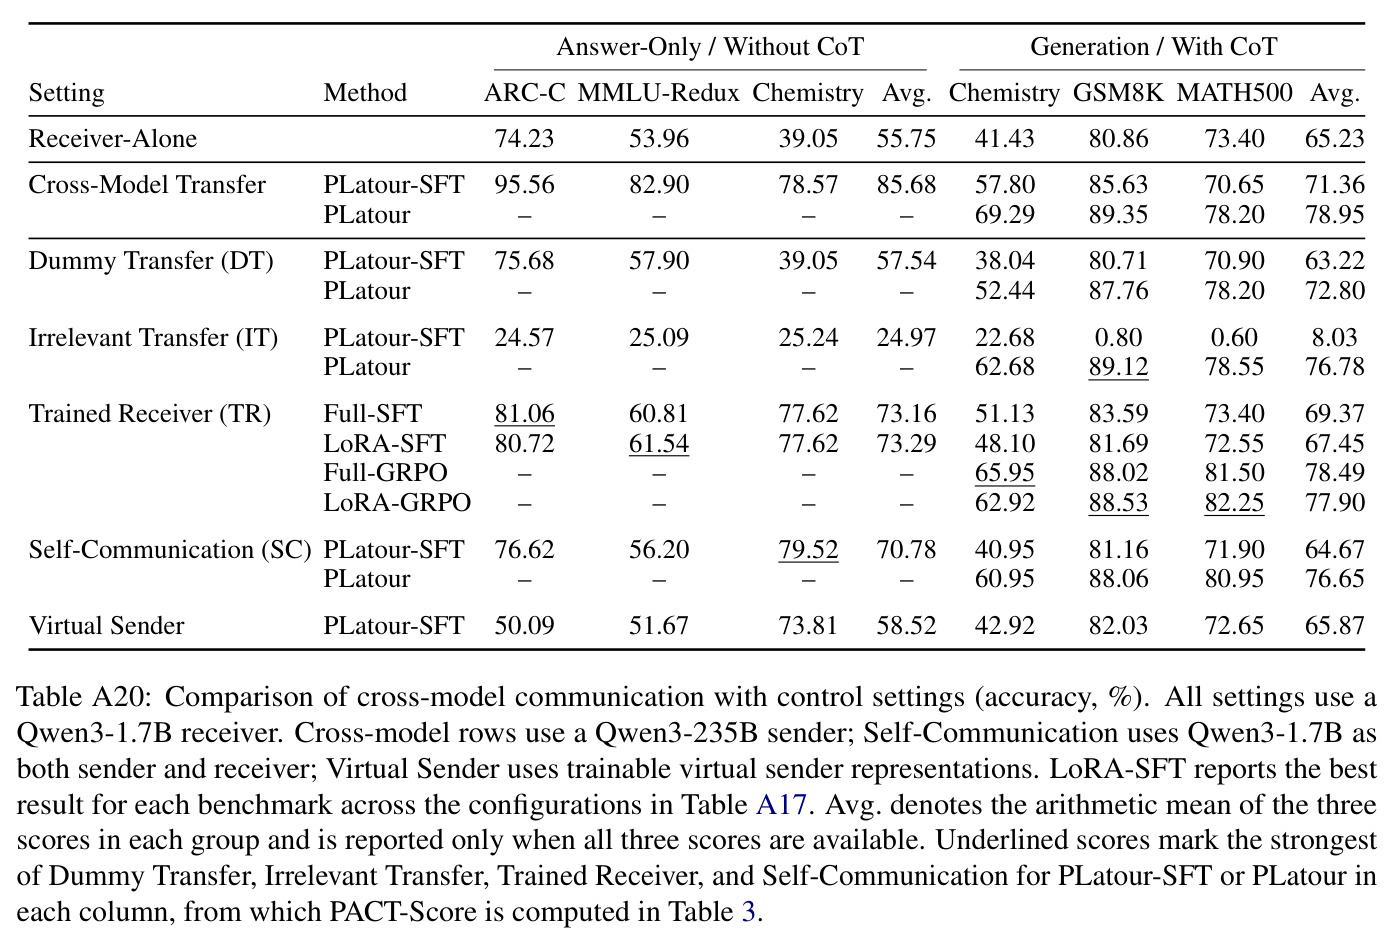
与已有工作不同的是,本文的独特切入有三点。第一,训练目标的转向:既有方法用 SFT 或蒸馏训练桥(模仿标注答案或 sender 的输出分布),作者反其道而行,把 sender 隐状态视为“潜在工具”,直接用 GRPO 最大化 receiver 的任务奖励——因为大容量差距下让小模型模仿大模型的输出分布本来就难(大到小 on-policy 蒸馏已知困难)。第二,评估视角的转向:作者注意到可训练桥与 prefix tuning、adapter 在数学形式上同构(He et al. 2022 的统一视角),意识到桥本身可能就是参数高效适配器,于是设计 PACT-Check 这套“证伪式”协议:换掉 sender 信息(DT/IT)、去掉 sender(SC/TR),看收益是否还在。第三,实证结论的转向:Chemistry 上 PLatour 确实优于所有对照(真实通信证据),而 GSM8K 上四种对照就能复现其收益——同一方法在不同任务上的“通信有效性”截然不同。
核心方法
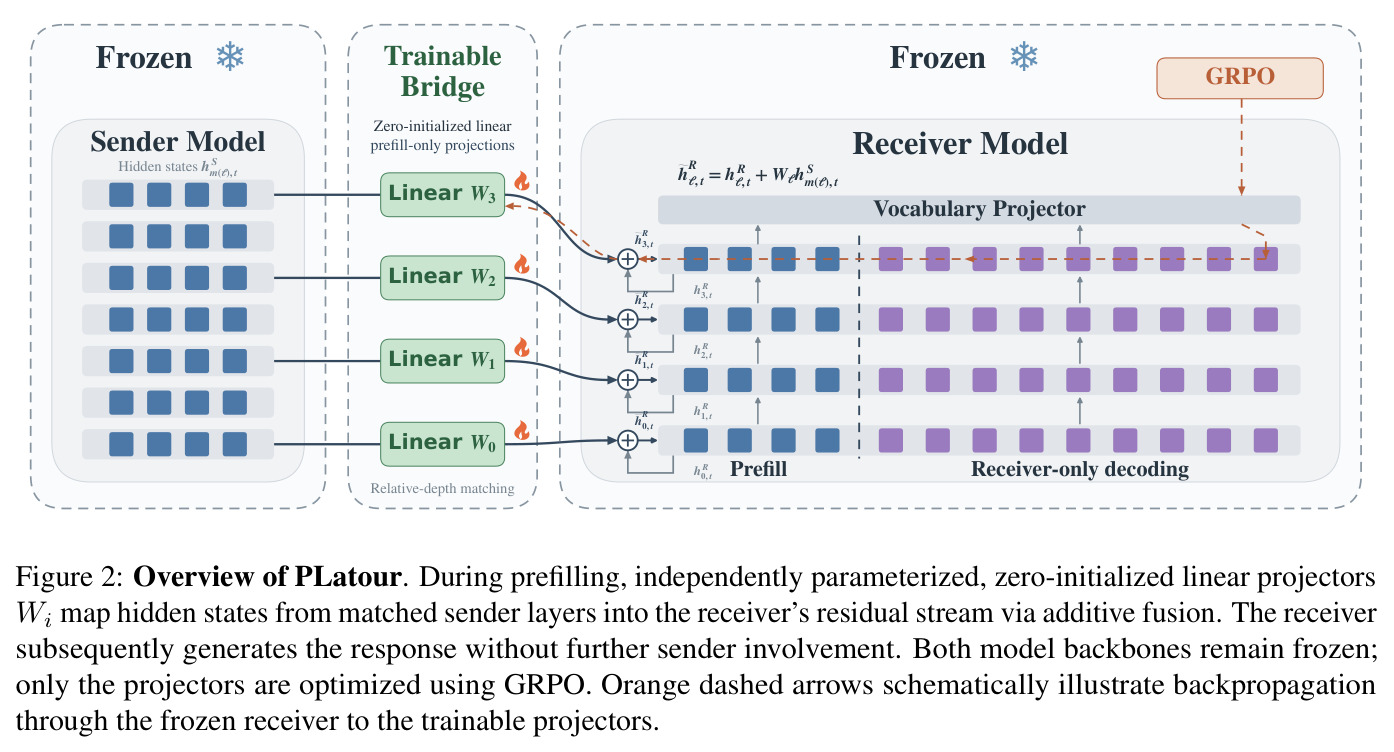
直觉上,PACT 是“大学者读题、小学生做题”:大的 sender 模型在 prefill 阶段读完整个 prompt,把内部 hidden states 经轻量桥传给小的 receiver;receiver 把这些信号当作“潜在工具”注入自己的残差流,然后完全独立地自回归生成答案,sender 不再参与。技术上,PLatour 在 receiver 每一层放一个独立的、无偏置的线性投影 $W_\ell \in \mathbb{R}^{d_R \times d_S}$($d_S$、$d_R$ 为两侧隐维度),把按相对深度匹配的 sender 层隐状态投影后以残差加法融入:$\tilde{h}^R_{\ell,t} = h^R_{\ell,t} + a_t W_\ell h^{S}_{m(\ell),t}$,其中掩码 $a_t$ 在除最后一个 prompt token 外的所有位置为 1,即通信被限制在 prefill 阶段。sender 与 receiver 权重全部冻结,仅用 GRPO 训练投影矩阵,直接优化 receiver 生成答案的任务奖励。
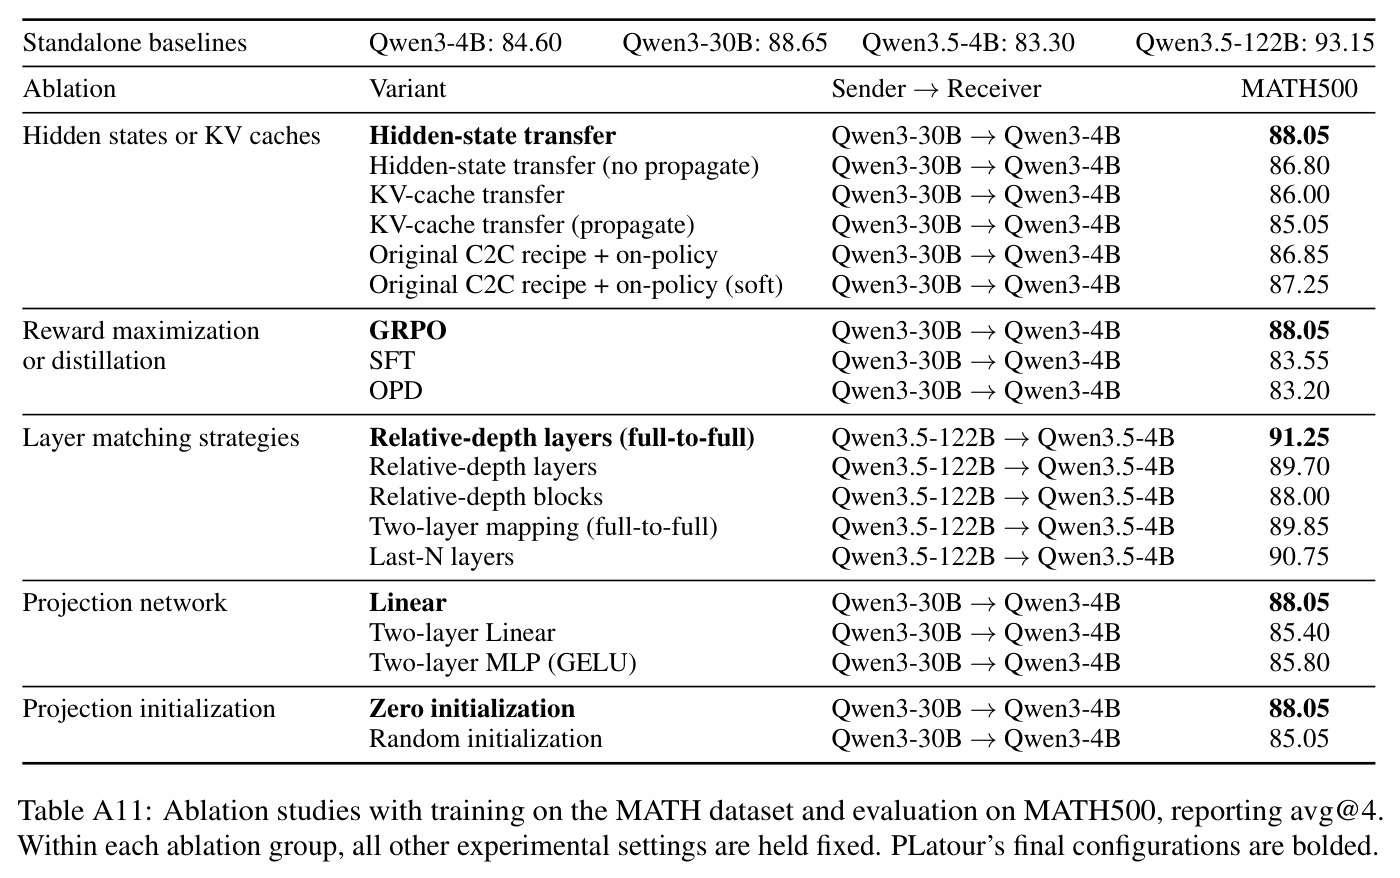
核心创新是与既有方法的三个本质区别。一是传 hidden states 而非 KV cache:KV 是隐状态的下游投影,直接传隐状态让 receiver 用自己预训练好的投影构造 key/value,接口更通用,也因此天然兼容线性注意力层(基于 KV 的方法无法处理混合架构);消融显示隐状态传输 88.05% 反超 KV 传输 86.00%(MATH500)。二是零初始化线性投影加残差加法:训练起点严格等价于 receiver alone(step 0 精度 84.7% vs 随机初始化 79.3%),且线性比两层 MLP(85.80%)更易在 RL 下优化。三是直接奖励最大化而非对齐/蒸馏:SFT 变体在长生成任务上反而低于裸 receiver(MATH500 上 83.55 vs 84.60),OPD 蒸馏 83.20 更差,唯有 GRPO(88.05%)稳定超越;作者的解释是小模型难以模仿大模型输出分布,但可以把大模型隐状态当工具用来拿更高奖励。
方法步骤详情
完整流程分五步。(1) Sender prefill:冻结的 sender 对 prompt 做一次前向,导出各层隐状态 $h^{S}_{m,t}$(超 100B 的模型用 FP8)。(2) 层匹配:按相对深度配对 $m_0(\ell) = \mathrm{round}\big(\ell (L_S-1)/(L_R-1)\big)$;混合架构下全注意力 receiver 层只配全注意力 sender 层,违反时取最近的全注意力层。(3) 注入:每层用零初始化的 $W_\ell$ 投影后在 receiver block 的 RMSNorm 前残差相加,仅限最后一个 prompt token 之前的位置($a_t$ 掩码),注入随网络向上层传播。(4) 解码:receiver 完全独立自回归生成;实现上 Hugging Face 做 prefill、vLLM 做解码,经 hybrid-cache 衔接,投影 FP32、加法前转 BF16。(5) 训练:verl 跑 GRPO,每题 8 个 rollout,Qwen3.5 上 batch 64 题、学习率 $10^{-5}$,DAPO 训 264 步、DeepCoder 训 295 步,梯度只更新桥参数。
技术新颖性
新颖性体现在三个层面。架构层面:与 C2C(门控 KV 融合模块 + SFT + Gumbel 门)、KV-Lingo(闭式线性回归初始化 + KL 蒸馏 + 直接替换 KV)相比,“每层一个零初始化线性映射”是能用 RL 端到端训练的最简桥;Table A14 逐步还原了这条设计路径——把 C2C 换成线性 KV 投影(75.85→75.63 不变)、加零初始化(→79.87)、开启传播(→82.22/82.37)、最后换成隐状态传输(→83.62),每个组件都有独立贡献。训练目标层面:直接 GRPO 训桥此前未见——最近的工作要么 SFT(C2C)要么闭式解加 KL(KV-Lingo),而本文证明蒸馏式目标(SFT 83.55、OPD 83.20)在 PACT 中系统性失败。评估方法论层面:PACT-Check 把 PEFT 统一视角变成可操作的证伪协议,PACT-Score $= A_{\mathrm{PACT}} - \max_{c \in C} A_c$ 把“比最强对照好多少”压缩成单一数字,这是对整个潜在通信领域的评估贡献。
实验结果
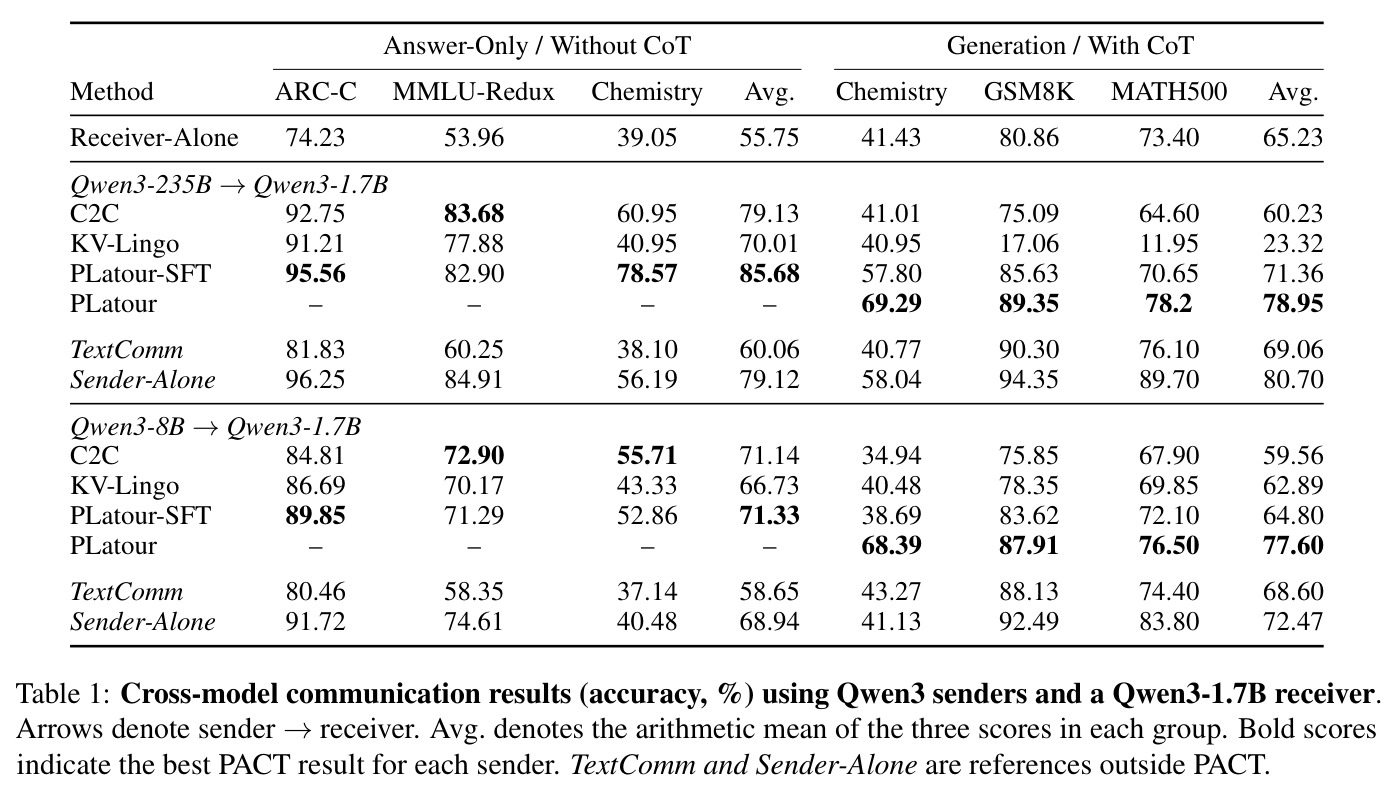
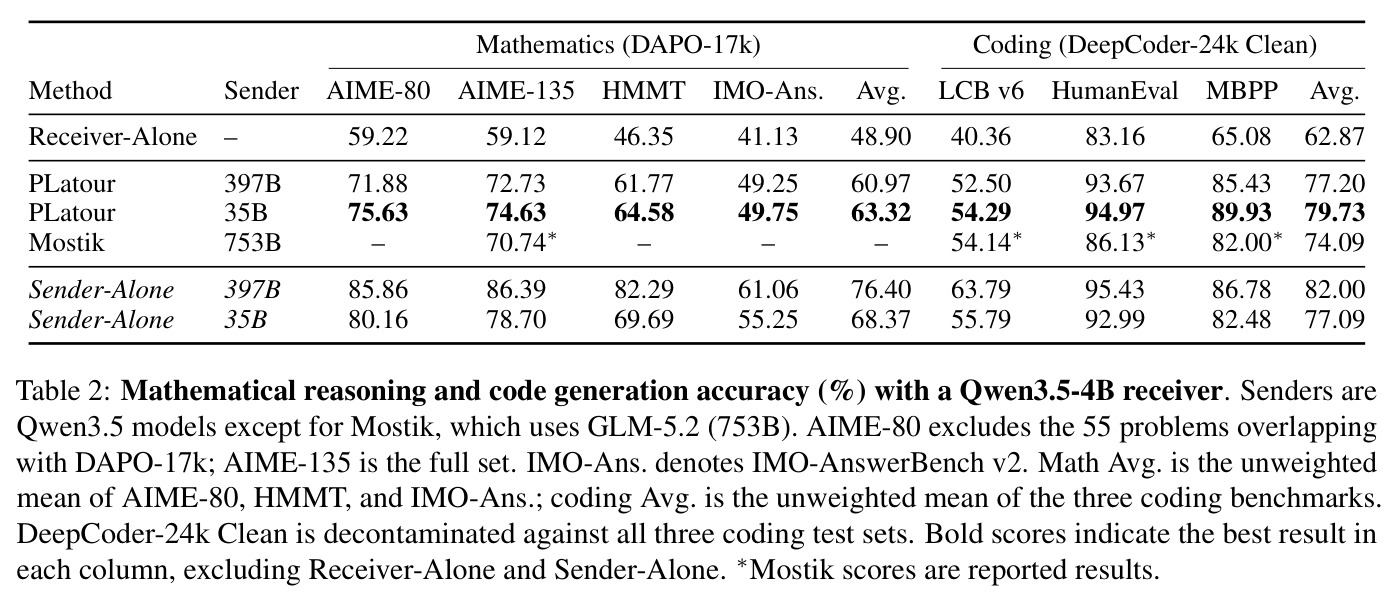
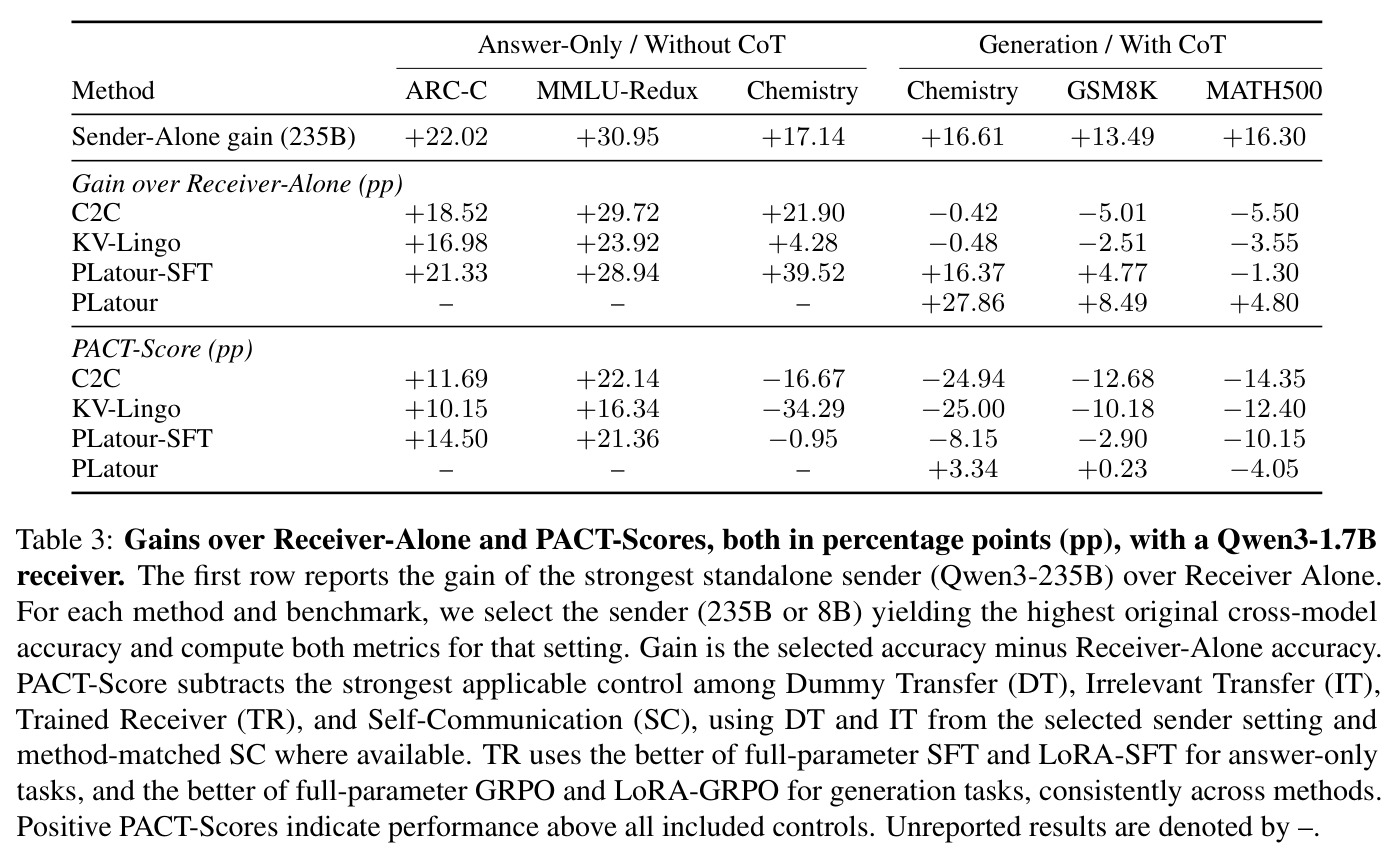
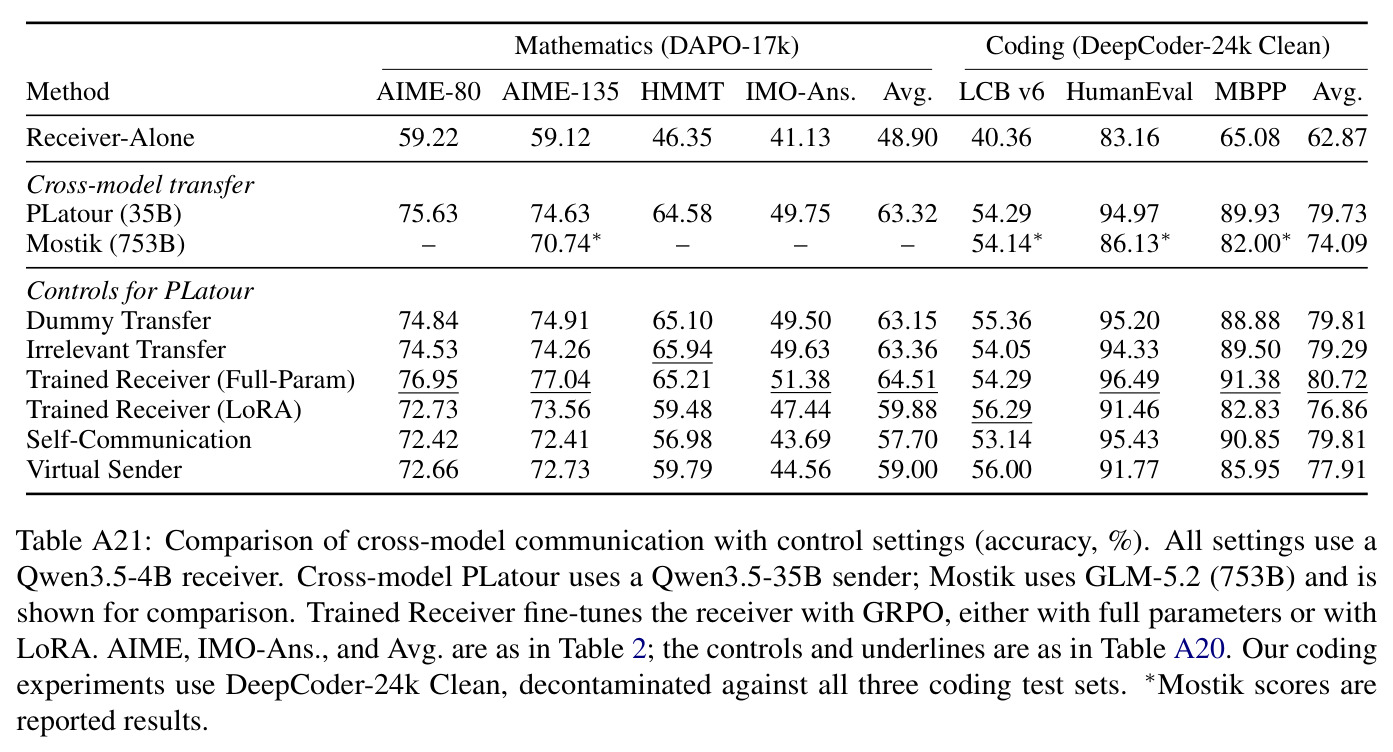
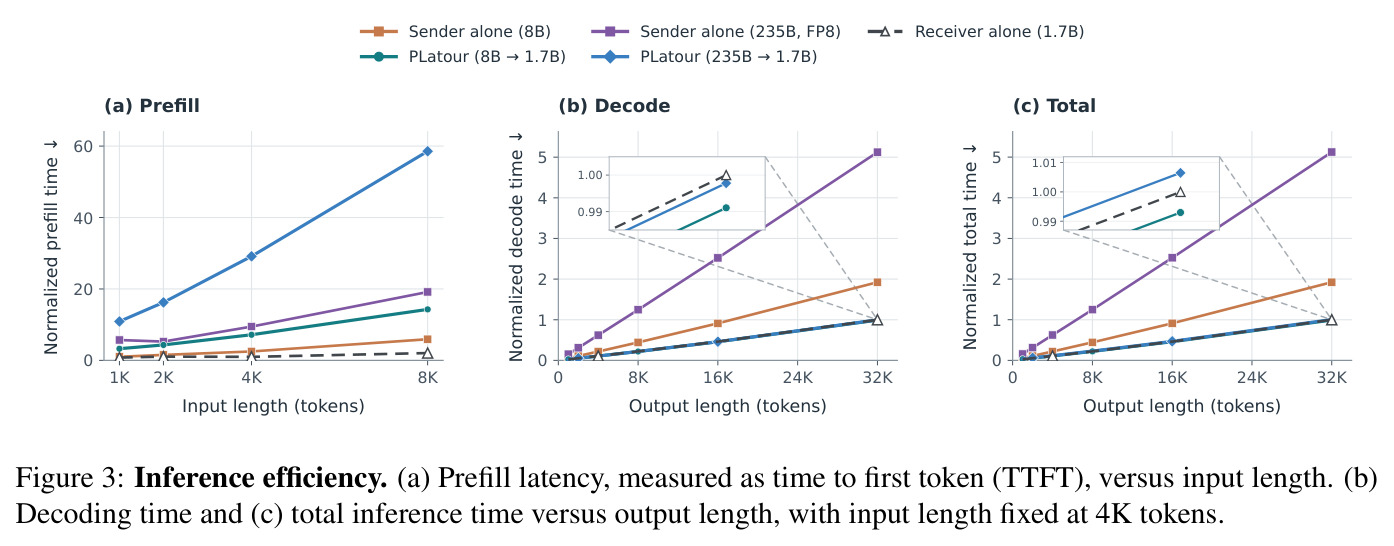
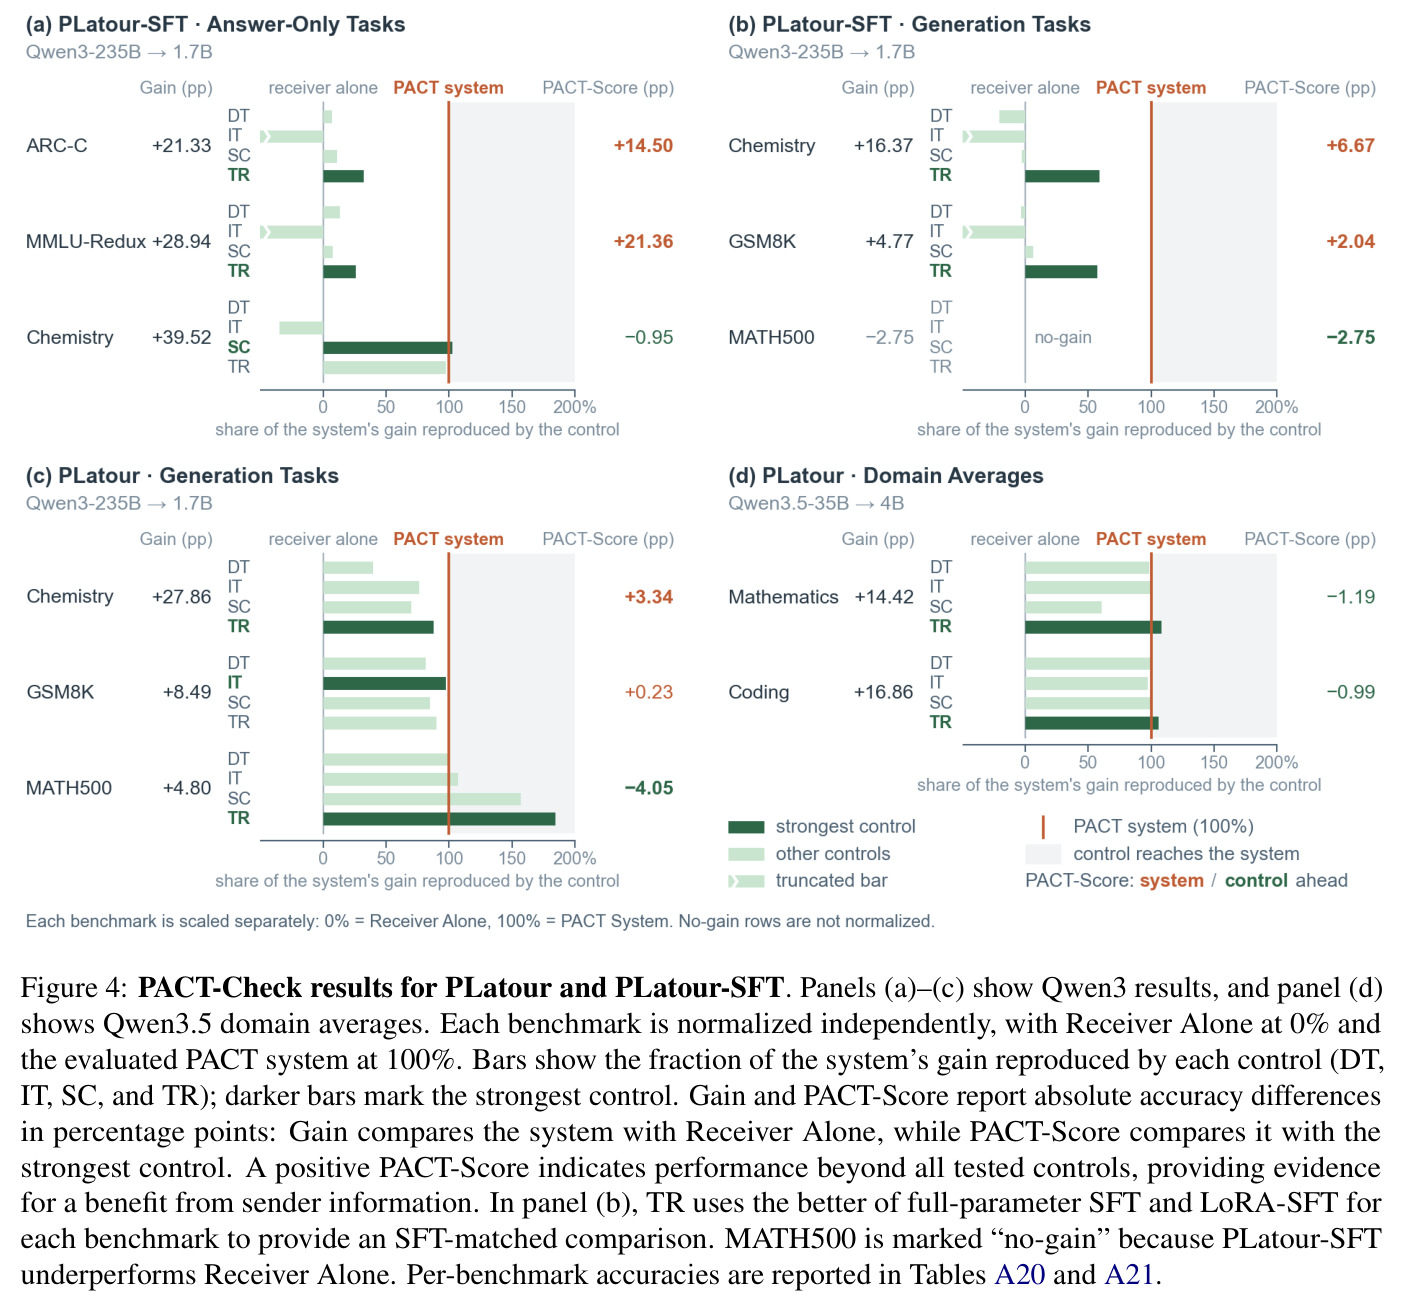
主实验分四块。(1) Qwen3 对比(Table 1):235B→1.7B 下 PLatour 生成任务全面超过裸 receiver——Chemistry 69.29(+27.86pp)、GSM8K 89.35(+8.49pp)、MATH500 78.20(+4.80pp),平均 78.95;C2C 仅 60.23、KV-Lingo 23.32,均低于裸 receiver 的 65.23;answer-only Chemistry 上 PLatour-SFT 78.57 反超 sender alone 的 56.19。(2) 对标 Mostik(Table 2):35B→4B 的 PLatour 数学平均 63.32、编码平均 79.73,超 Mostik(753B sender)报告的 74.09,AIME-135 上 74.63 vs 70.74 且 sender 小 20 余倍;397B 变体反而更差(60.97/77.20)。(3) PACT-Check(Table 3/A20/A21):Chemistry 保留 +3.34 正 PACT-Score,是真实通信证据;GSM8K 仅 +0.23、MATH500 为 −4.05(receiver-only GRPO 82.25 高于 PLatour 的 78.20);Qwen3.5 上 Full-GRPO 对照数学 64.51、编码 80.72 均超 PLatour。(4) 效率与消融:prefill 开销被长生成摊销,8B→1.7B 在 32K 输出下总时间仅为裸 receiver 的 1.01 倍(Figure 3);GRPO 88.05% 优于 SFT 83.55% 与 OPD 83.20%,零初始化比随机高 3 个百分点(Table A11)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GSM8K 数学应用题(Qwen3-235B→1.7B,生成) | avg@2 准确率 (%) | PLatour 89.35 | Receiver-Alone 80.86;C2C 75.09;KV-Lingo 17.06 | +8.49pp(超裸 receiver),对 C2C +14.26pp;但 PACT-Score 仅 +0.23,收益可被对照复现 |
| Chemistry CoT(Qwen3-235B→1.7B,生成) | avg@8 准确率 (%) | PLatour 69.29 | Receiver-Alone 41.43;C2C 41.01 | +27.86pp;PACT-Score +3.34,超过全部四种对照,是真实信息传递的证据 |
| MATH500(Qwen3-235B→1.7B,生成) | avg@4 准确率 (%) | PLatour 78.20 | Receiver-Alone 73.40;receiver-only LoRA-GRPO 82.25 | +4.80pp,但 PACT-Score −4.05:纯 receiver 训练反而更强 |
| AIME-135 数学竞赛(Qwen3.5-35B→4B) | avg@16 准确率 (%) | PLatour 74.63 | Receiver-Alone 59.12;Mostik(753B→4B)报告值 70.74 | +15.51pp;超 Mostik +3.89pp 且 sender 小 20 余倍 |
| LiveCodeBench v6(Qwen3.5-35B→4B) | avg@8 准确率 (%) | PLatour 54.29 | Receiver-Alone 40.36;Mostik 54.14 | +13.93pp;与 Mostik 基本持平(+0.15pp) |
| HumanEval(Qwen3.5-35B→4B) | avg@8 准确率 (%) | PLatour 94.97 | Receiver-Alone 83.16;Mostik 86.13 | +11.81pp;超 Mostik +8.84pp |
| MBPP(Qwen3.5-35B→4B) | avg@8 准确率 (%) | PLatour 89.93 | Receiver-Alone 65.08;Mostik 82.00 | +24.85pp;超 Mostik +7.93pp |
局限与改进
作者承认的局限:其一,PLatour 在多个长生成任务上 PACT-Score 很低,“许多收益可由不依赖 sender 信息的适配复现”,真实通信贡献只在部分任务(如 Chemistry +3.34)得到验证;其二,实验全在 Qwen 同族模型间进行,共享表示假说只是动机而未被检验;其三,训练不稳定:235B→1.7B 的 MATH 训练在第 177 步从 78.20% 崩溃到 0.00%(clipping 率 59.40%)且不恢复,397B sender 的 DAPO 训练在约 180 步出现裁剪尖峰、critic 从约 0.85 跌破 0.60,验证精度停在约 84%(35B 版约 87%);其四,与 Mostik 的对比不完全受控——对方训练数据未公开、桥是否跨域共享未知,而 PLatour 为数学和编码分别训练两个桥。我的补充:AIME-135 与训练集 DAPO-17k 有 55 题重叠(故另设去污染 AIME-80);sender 需对每请求完整 prefill,长系统提示的 agent 场景开销大;PACT-Score 依赖对照集合与 TR 配方的选择。
独立分析的弱点
独立分析四个弱点。(1) 桥退化为适配器:GSM8K 上 PACT-Score 仅 +0.23,Dummy Transfer(问题无关的模板均值信号)仍达 87.76%,说明奖励不区分“传了有用信息”与“桥学成 prefix tuning”——可加入信息消融式对抗目标或惩罚问题无关注入。(2) SFT 桥对输入错配极度脆弱:Irrelevant Transfer 使 PLatour-SFT 的 ARC-C 从 95.56% 崩到 24.57%、GSM8K 从 85.63% 到 0.80%,而 GRPO 桥几乎不受影响(89.35→89.12);附录 H 显示 SFT 桥的 $\sum_j\|W_j\|_F$ 是 GRPO 的 4.32–8.32 倍,学到了过大的输入依赖注入——可用范数约束或剪枝缓解。(3) 规模化的反直觉失败:397B sender 全面不如 35B(数学 60.97 vs 63.32),训练不稳定是直接原因——“更大 sender 更好”在 PACT 中不成立,需引入信任域、学习率退火等稳定性技术。(4) receiver 足够强时通信无增量:MATH500 上 receiver-only LoRA-GRPO 82.25% 高于 PLatour 78.20%,通信只在能力缺口大且自身提升受限的任务上划算——可设计自动判断何时调用 sender 的路由机制。
未来方向
作者提出的方向:(1) 跨模型家族泛化,在异构表示空间间检验共享结构假说,探索从不同家族选中间层、投影到共同表示空间的统一潜在接口;(2) 系统研究桥训练的 clipping 尖峰与崩溃机制;(3) 机制解释——弄清桥传输了什么、receiver 如何使用;(4) prefix-only 通信:把共享长系统提示(如 agent 场景数万 token 指令)的 sender 表示预计算、缓存并跨请求摊销,作者留下“是否保留问题相关收益”的开放问题;(5) 弱到强迁移:若两模型解题集 $A$、$B$ 互补,$B \setminus A$ 的题目即使 sender 总体更弱也可迁移,$A \cup B$ 是覆盖上界;(6) 把大模型 prefill 视为问题理解、小模型解码视为解搜索,两个维度独立扩展以推动能力–成本 Pareto 前沿。基于本文成果还可延伸:设计激励 receiver 实际使用 sender 信息的奖励(如 sender 信号 dropout 下的鲁棒性正则);用互信息或线性探针定量测量桥传输的信息量;把 PACT-Check 推广为潜在多智能体系统(LatentMAS、Interlat)的标准审计工具。
复现评估
复现条件较好但有算力门槛。开源:代码在 GitHub(zhenyi4/platour)公开,含 PLatour、C2C 复现、KV-Lingo 实现、全部控制实验与前向/生成伪代码(Listing 1),基于 Hugging Face prefill + vLLM 解码 + verl GRPO。数据全部公开:ARC-C、MMLU auxiliary(1 万题)、SciKnowEval Chemistry L3(1,890/210 划分)、GSM8K、MATH、DAPO-Math-17k(17,391 题)、DeepCoder-Preview(去污染后 18,873 题),划分与种子(42)在附录 A 详列。主要障碍是算力:sender 需加载 Qwen3-235B-A22B(FP8)或 Qwen3.5-35B/397B,receiver 1.7B/4B,GRPO 每题 8 个 rollout、生成上限最高 32K token,需多卡高端 GPU;小规模可用消融的 8B→1.7B 设置。方法本身简单(每层一个零初始化线性层,28 层共约 2.35 亿参数)、训练仅 264–295 步,工程难度中等;需遵循评估协议(avg@k 而非 pass@k、按验证集选 checkpoint、非思考模式采样)。Mostik 闭源,只能对比报告值。
论文图表
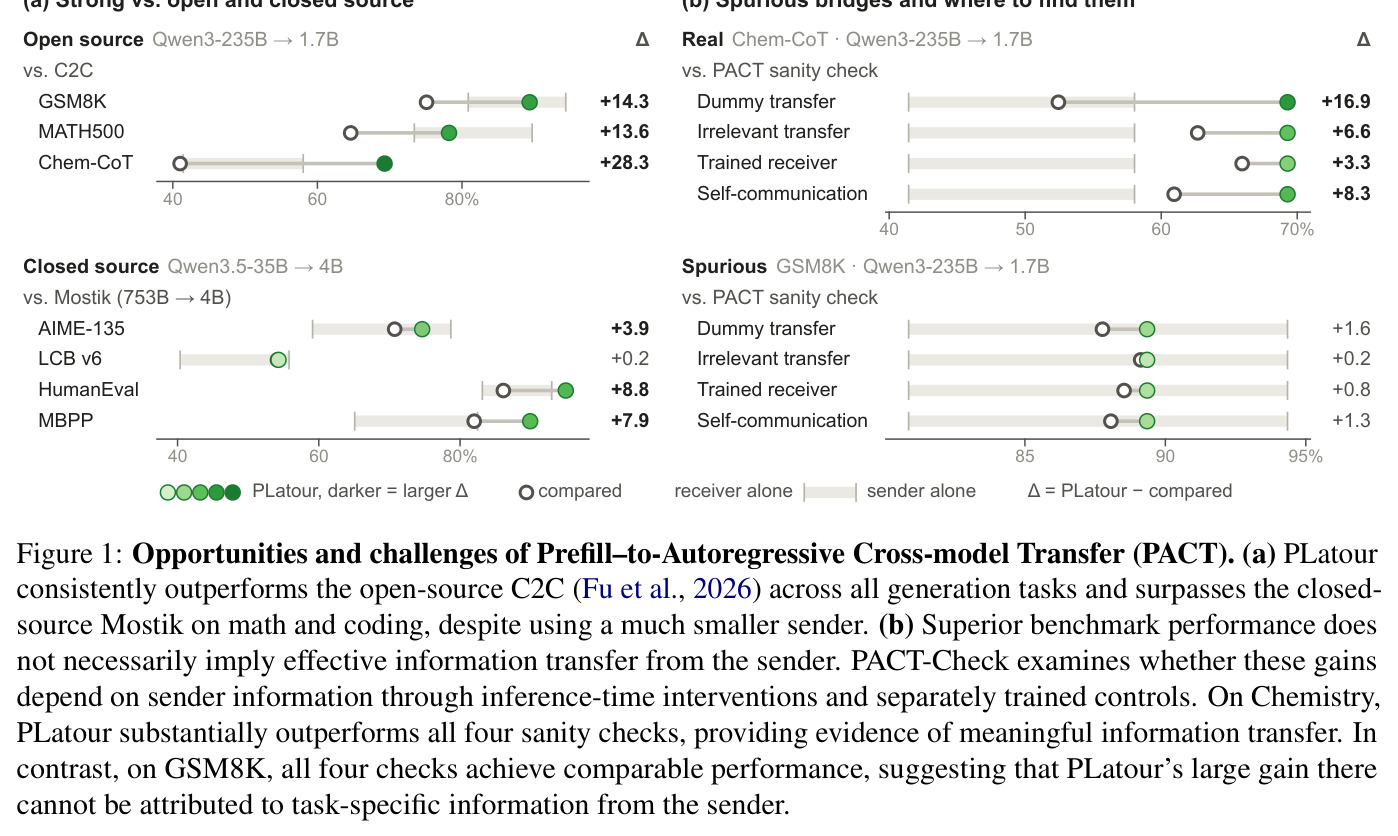
双面板柱状图。(a) 性能机会:PLatour 相对开源 C2C(235B→1.7B)在 GSM8K +14.3、MATH500 +13.6、Chemistry +28.3;相对闭源 Mostik(35B→4B vs 753B→4B)在 AIME-135 +3.9、LCB v6 +0.2、HumanEval +8.8、MBPP +7.9。(b) 挑战:Chemistry 上 PLatour 超过四种 sanity check(Dummy +16.9、Irrelevant +6.6、Trained receiver +3.3、Self-communication +8.3),而 GSM8K 上四种对照仅差 +1.6/+0.2/+0.8/+1.3,收益几乎可被复现。
一张图同时呈现论文的两大主张——机会(性能领先)与挑战(收益未必来自通信),是全文论证逻辑的缩影,读完全文回头看此图可检验是否理解到位。
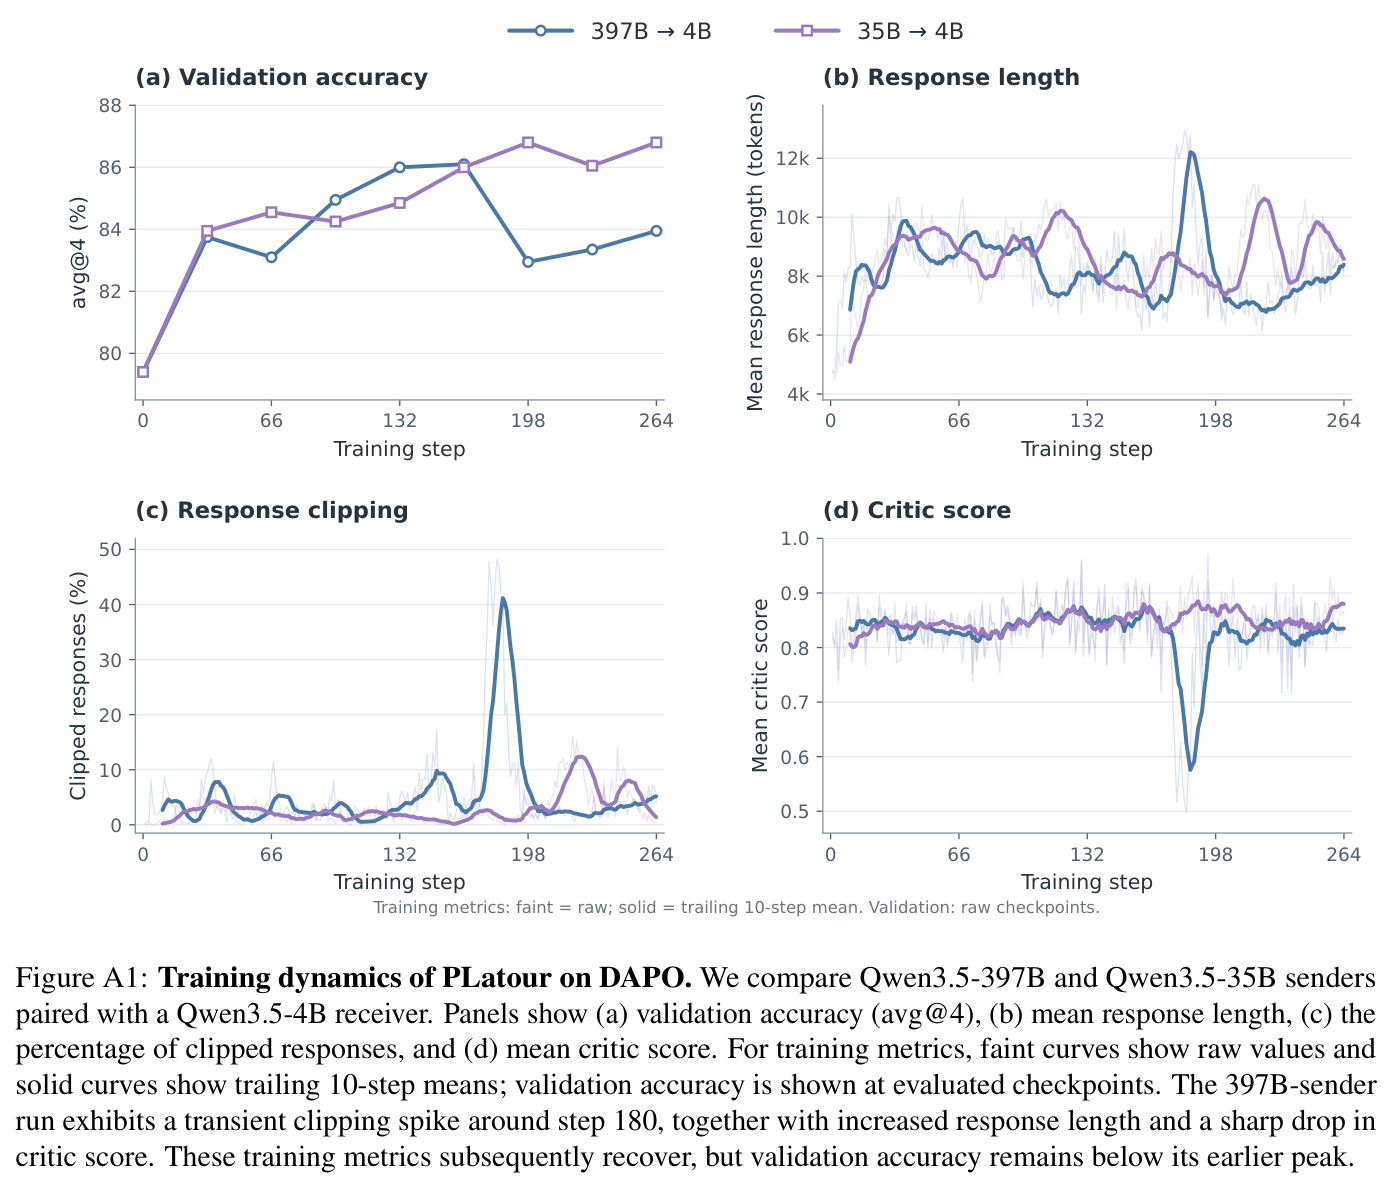
四面板训练曲线:(a) 验证精度(avg@4)、(b) 平均响应长度、(c) 响应裁剪率、(d) critic 分数。397B sender 版在约 180 步出现瞬时裁剪尖峰(平滑值约 40%)、响应长度骤增、critic 从约 0.85 跌破 0.60;训练指标随后恢复,但验证精度从约 86% 跌至 83% 后仅回升到约 84%,而 35B 版波动平缓、最终约 87%。
解释“更大的 sender 反而更差”这一反直觉结果:大 sender 下的桥训练不稳定是 PACT 规模化的真实瓶颈,也是作者承认的关键局限。