HeteroFold:面向异构多智能体LLM的无预填充跨家族KV缓存迁移 Prefill-Free Cross-Family KV Cache Transfer for Heterogeneous Multi-Agent LLMs
对齐分词器与网络深度,把发送方KV缓存映射到接收方空间,跨模型家族免预填充直接解码
前置知识
KV缓存与prefill/decode两阶段
Transformer自回归推理分两阶段:prefill阶段对全部输入token并行前向计算,缓存每层的Key/Value张量;decode阶段逐token生成,只计算新token并复用已有KV缓存。KV缓存显存占用大,prefill计算量随上下文长度线性增长,是多轮长上下文场景的主要延迟来源。
本文的全部目标就是让接收方跳过prefill、直接复用发送方现成的KV缓存,方法设计与延迟评估都围绕『缓存能否替代重算』展开。
异构多智能体LLM系统
多个LLM按角色分工协作(求解器、评估者、聚合器等),通过对话交换信息并投票达成共识。异构系统指成员来自不同家族或不同规模的模型(如Llama+Qwen+Ministral),可按能力与成本为每个角色分配合适的模型,如X-MAS框架。
异构智能体间传递共享上下文时,每个接收方都要重新prefill同一段文本,这正是本文要消除的冗余,也是HIDDENBENCH多智能体实验的场景。
分词器错位(tokenizer mismatch)
不同模型家族使用不同的BPE词表和合并规则,同一段文本会被切成长度和边界都不同的token序列。KV缓存按token位置索引,如果直接按『第i个token对应第i个token』配对,发送方与接收方的缓存会系统性错位,语义完全破坏。
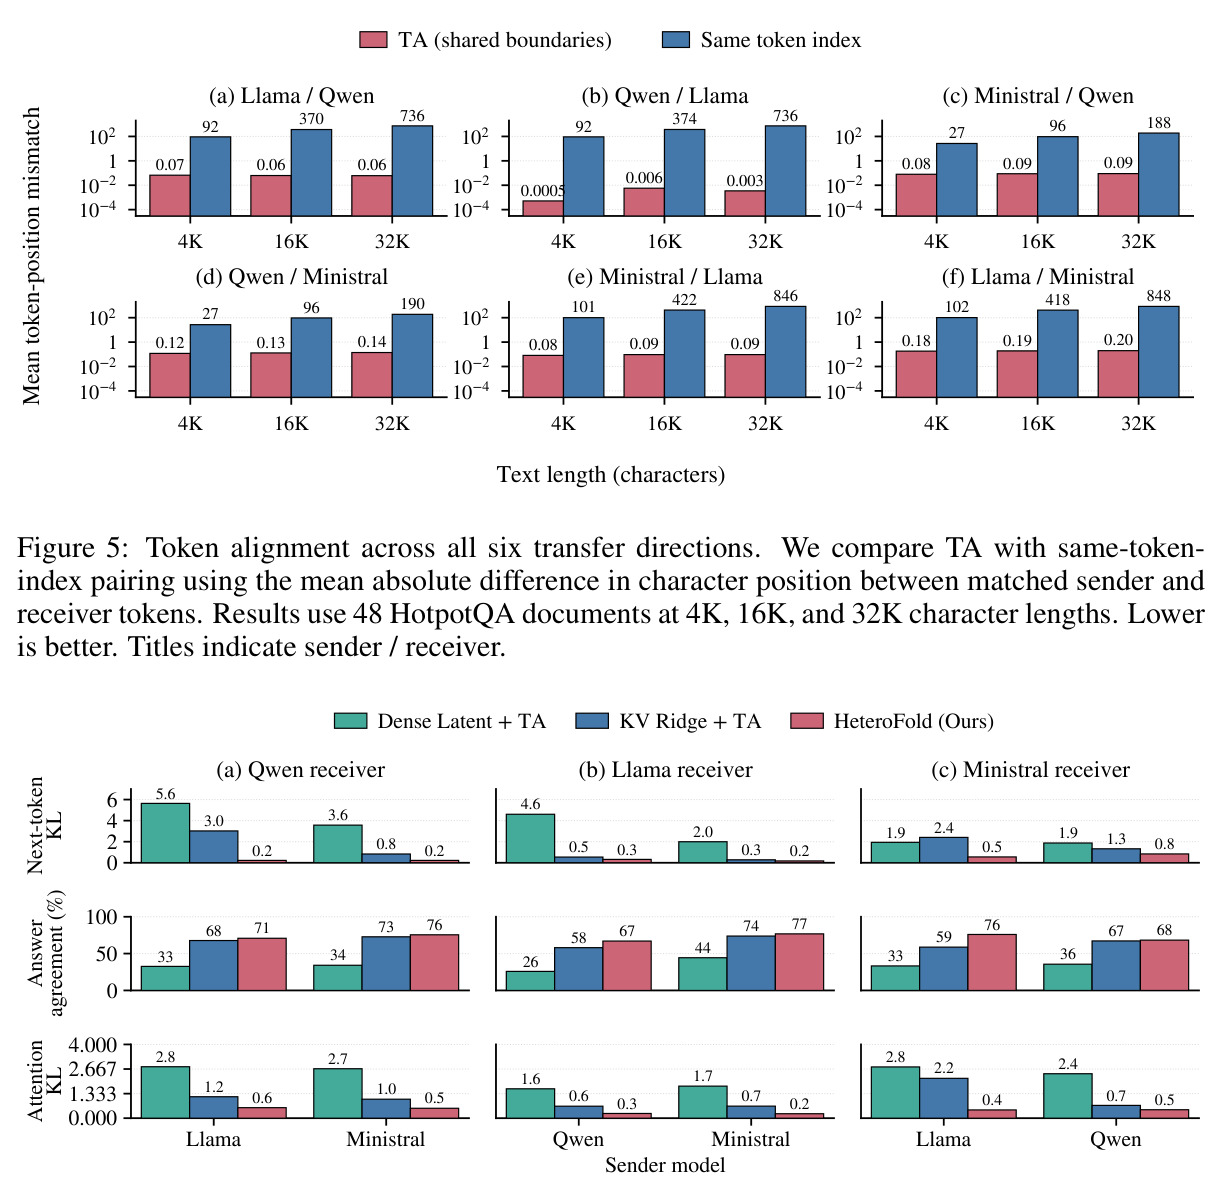
这是跨家族迁移区别于同家族迁移的第一道障碍。论文用Figure 5量化:32K文本下同索引配对平均错位数个字符,而错位直接导致下游任务崩溃(GSM8K准确率掉到个位数)。
RoPE与key normalization
RoPE(旋转位置编码)通过旋转矩阵把相对位置信息注入Query和Key;部分新模型(如Qwen3)还在注意力计算前对Key做归一化(QK-Norm)以稳定训练。两者都作用在Key上,决定注意力得分的计算方式。
HeteroFold刻意选择在key normalization和RoPE之前映射K、在value投影之后映射V,映射完由接收方施加自己原生的归一化与RoPE,避免位置编码被跨模型映射破坏,这是工程上极关键的设计决策。
GQA(分组查询注意力)
让多个Query头共享同一组KV头(如8个KV头服务32个Query头),以减少KV缓存体积。不同模型的KV头数和head维度通常不同,导致发送方与接收方的KV张量形状无法直接对齐。
HeteroFold把token的KV特征沿头维度展平拼接,让一个线性映射同时完成跨头混合,绕开头数不匹配问题;输出感知校准中key目标也需按g(h)找到Query头对应的共享KV头。
白化与Procrustes对齐
经典统计对齐方法:先分别对两个特征空间做白化(去除各自均值、尺度与相关性),再用SVD求最优旋转矩阵$R^\star = UQ^\top$使配对样本在两个空间中尽量重合,广泛用于跨语言词向量对齐。
HeteroFold的Recolor初始化正是『除以全局RMS + 白化 + Procrustes旋转 + 恢复接收方均值协方差』,理解这套流程才能看懂K/V映射的闭式构造(公式3-5)。
研究动机
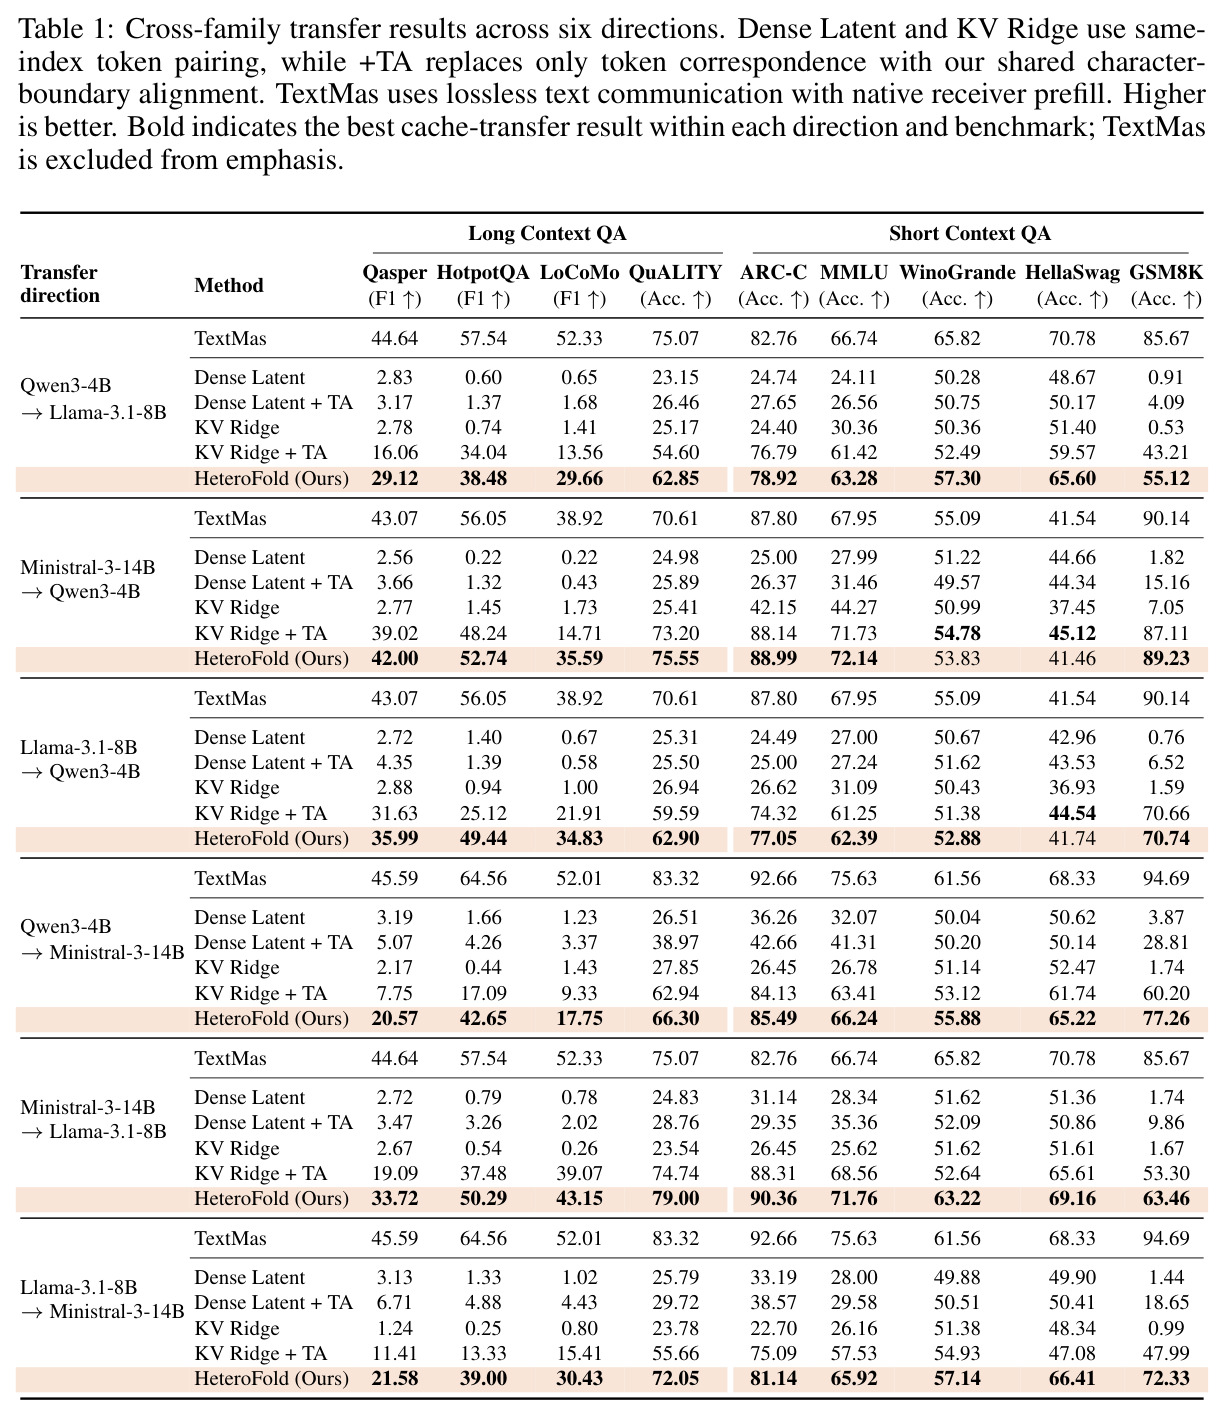
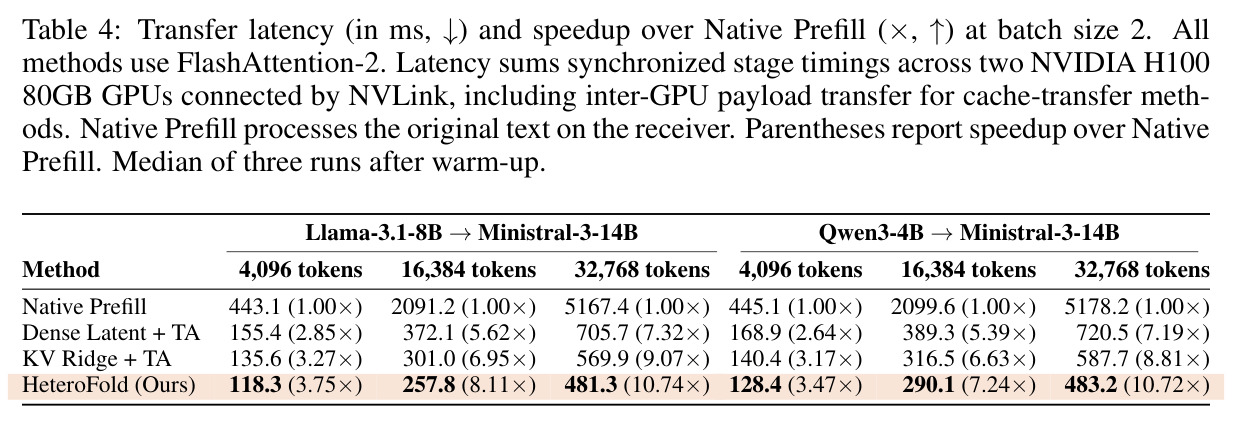
异构多智能体系统(如X-MAS用不同家族模型分别担任solver、evaluator、aggregator)中,智能体需要频繁共享同一段上下文。当前标准做法是基于文本的通信(TextMas):接收方必须对收到的文本重新prefill、重建自己的KV缓存,冗余计算随上下文变长线性增长——实测在32K token、batch 2、H100 GPU上,接收方一次Native Prefill需要5167.4毫秒。已有的免prefill缓存迁移方法Dense Latent和KV Ridge都假设同家族、同分词器,直接用于跨家族会彻底失效:表1显示Qwen3-4B到Llama-3.1-8B方向上Dense Latent在GSM8K准确率仅0.91%、KV Ridge仅0.53%,Qasper和HotpotQA的F1几乎归零,根源是token错位、网络深度不同、KV特征分布不同三重障碍叠加。
本文的目标是本文目标是构建首个接收方免prefill的跨家族KV缓存迁移方法HeteroFold:发送方模型$\mathcal{S}$与接收方模型$\mathcal{R}$全部保持冻结,把发送方缓存$C_{\mathcal{S}}(x)$直接映射为接收方可以直接开始解码的缓存$C_{\mathcal{R}}(x)$。具体需同时做到三件事:(1)解决分词器不同导致的token错位;(2)解决模型深度(层数)、KV头数与head维度、是否使用key normalization和RoPE等结构差异;(3)不只追求缓存数值重建误差低,而是保持接收方的注意力模式与输出分布不变。最终目标是在多个迁移方向上质量逼近文本通信,同时把32K上下文的接收侧延迟降低一个数量级(实测约10.7倍)。
与已有工作不同的是,独特切入角度有三点。其一,首次把分词器错位明确为跨家族缓存迁移的首要障碍,并提出Token Alignment(TA):利用任何分词器都会记录token字符结束位置这一公共坐标来建立对应关系;而此前Dense Latent和KV Ridge只在同家族、同分词器内评估过。其二,作者用Figure 2揭示『重建误差低不等于行为正确』:KV Ridge的K/V重建误差比HeteroFold更低,但其注意力KL散度和输出误差明显更高,因此把优化目标从『拟合缓存数值』改为『匹配接收方注意力与输出』,并把KV量化领域的output-aware校准思想(作者团队此前的INT2 KV量化工作)首次移植到跨模型缓存转换。其三,所有学习到的修正最终折叠进固定仿射映射,推理时零额外模块,发送和接收两个模型都不需要修改或微调。
核心方法
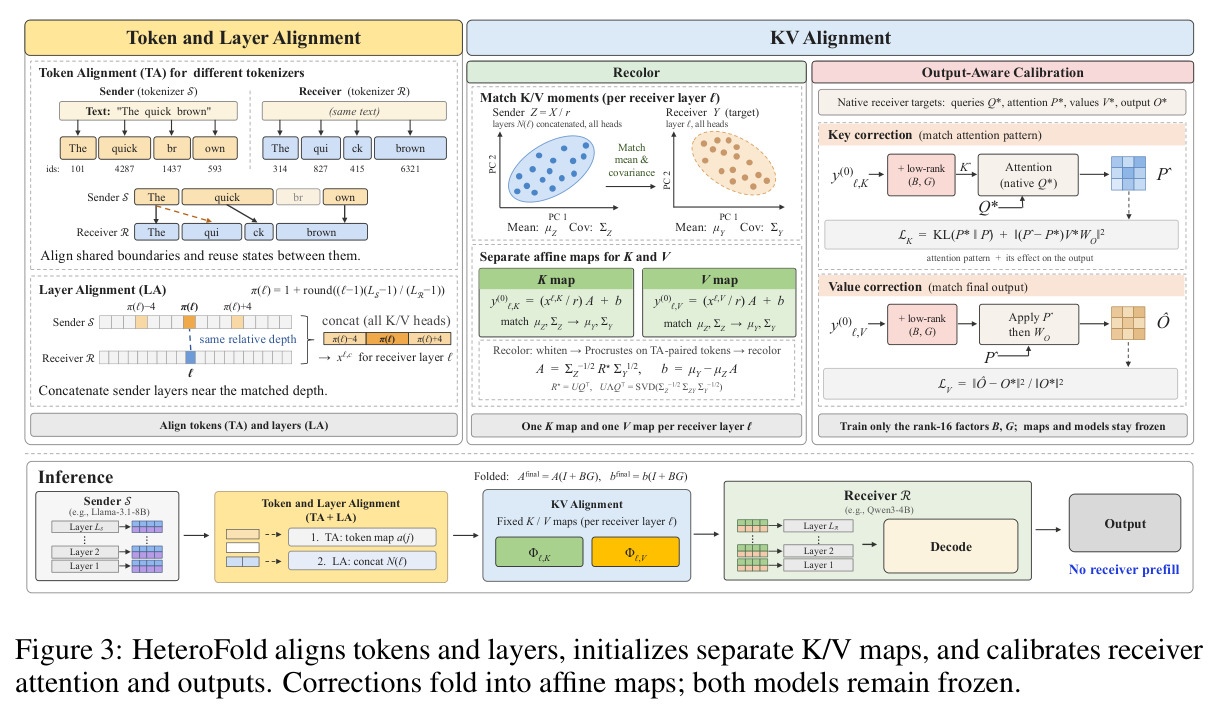
直觉上,把『翻译另一种模型的KV缓存』当成跨语言坐标变换:先对齐词(token),再对齐论述的深度位置(层),然后校正『颜色』(特征分布),最后按接收方的读法(注意力)微调。技术路线分三步。第一步Token与层对齐:TA用同一原始文本的字符结束边界建立发送/接收token一一对应,多对一时不取平均;层对齐(LA)按相对深度$\pi(\ell) = 1 + \mathrm{round}((\ell-1)(L_{\mathcal{S}}-1)/(L_{\mathcal{R}}-1))$为接收方第$\ell$层选取发送方$(-4,0,+4)$三个相邻层。第二步Recolor映射:把三层的发送特征沿头维度展平拼接(跨头混合),对每个接收层和K/V角色,先除以全局RMS标量$r$,再做白化与Procrustes旋转,恢复接收方均值与协方差,得到初始仿射映射$y^{(0)} = (x/r)A + b$。第三步输出感知校准:只训练秩16低秩修正$\tilde{y} = y^{(0)} + (y^{(0)}B)G$,K用注意力KL加key致输出误差,V用归一化输出Frobenius误差,4个epoch后折叠为$A_{final} = A(I+BG)$。整个流程在key normalization与RoPE之前映射K、投影之后映射V,接收方随后施加自己原生的归一化和RoPE。
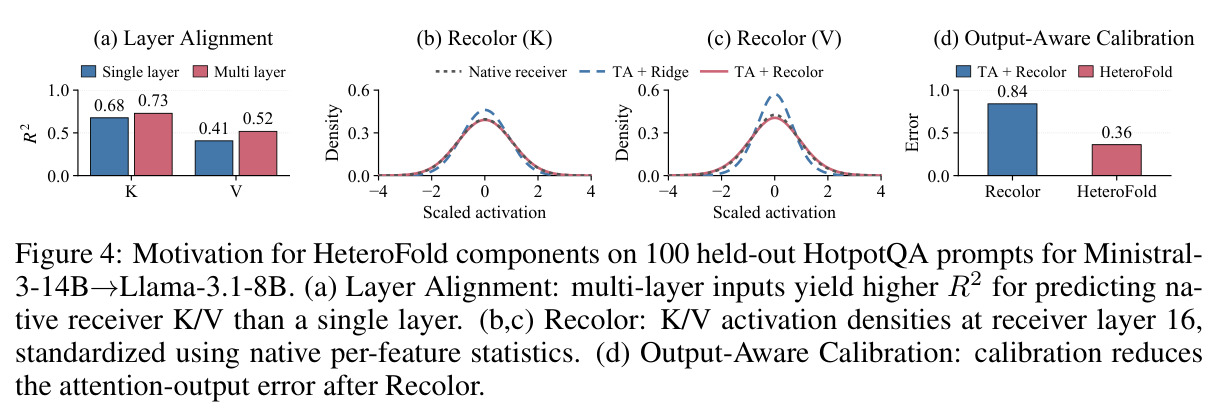
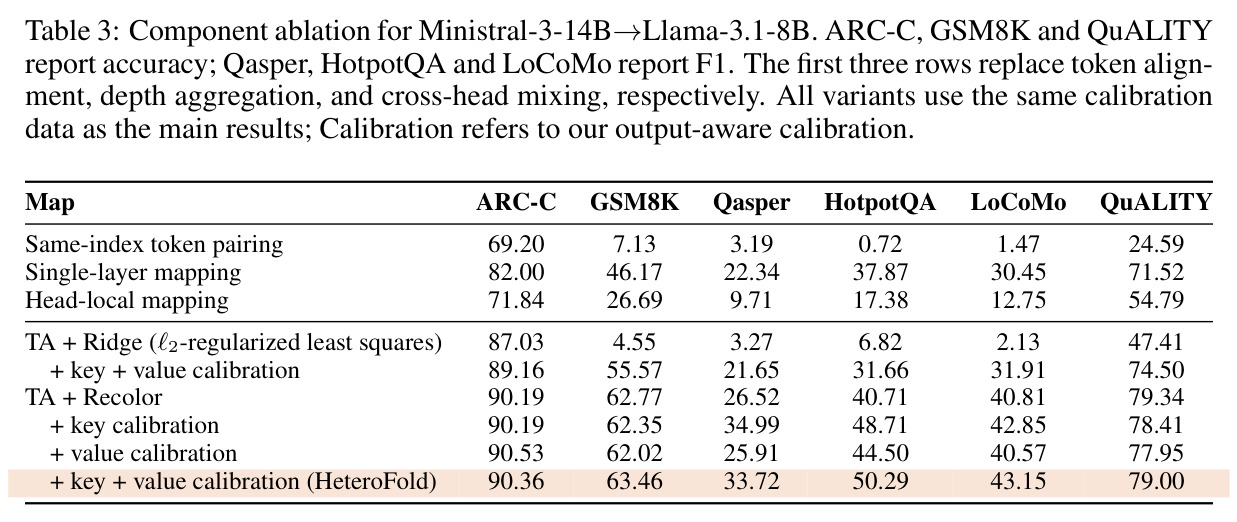
与已有方法的本质区别有三处。(1)显式跨分词器token对应:TA把『字符结束位置』当作分词器无关的公共锚点,接收方token若没有精确匹配的边界就复用发送方最近的前一个共享边界状态,首个匹配之前用第一个发送token,多对一情形不做状态平均;仅这一步就把KV Ridge在Qwen3-4B到Llama-3.1-8B方向的GSM8K准确率从0.53%拉到43.21%。(2)统计对齐取代逐点回归:KV Ridge做$\ell_2$岭回归,容易在保持低MSE的同时扭曲特征分布;Recolor通过白化加Procrustes显式匹配接收方K/V的均值与协方差,更好地复现原生激活分布(Figure 4b,c)。(3)接收方感知校准:把迁移前后的输出差分解为key致变化与value致变化(公式6),K目标是注意力分布KL加key致输出误差,V目标是固定注意力下的输出误差;校准只学秩16修正并最终折叠进仿射映射,推理时没有额外模块。这实质上是把KV量化的output-aware思想改造成跨模型域的自适应。
方法步骤详情
完整流水线如下。(1)数据准备:1600条校准prompt(800条Open-R1加800条HotpotQA训练集)加400条held-out,不含gold答案;收发双方各自分词并记录每个token的字符结束偏移。(2)TA配对:为每个接收token找结束字符位置相同的发送token,无精确匹配用最近前一个共享边界,首个匹配之前用第一个发送token。(3)LA选层与构造样本:接收层$\ell$对应发送层$\pi(\ell)$及其正负4的邻层$N(\ell)$,把三个发送层特征拼接$x^n_{\ell,c} = [c^{\mathcal{S},t_1}_{i_n} \Vert c^{\mathcal{S},t_2}_{i_n} \Vert c^{\mathcal{S},t_3}_{i_n}] \in \mathbb{R}^{3d_{KV}^{\mathcal{S}}}$,目标为$y^n_{\ell,c} = c^{\mathcal{R},\ell}_{j_n}$,按token对堆成矩阵$X, Y$。(4)Recolor闭式求解:按公式(3)算全局RMS得$Z = X/r$;计算加权均值、协方差与互协方差,SVD分解$\Sigma_Z^{-1/2}\Sigma_{ZY}\Sigma_Y^{-1/2} = U\Lambda Q^\top$,$R^\star = UQ^\top$,$A = \Sigma_Z^{-1/2}R^\star\Sigma_Y^{1/2}$,$b = \mu_Y - \mu_Z A$。(5)校准:冻结$A,b$,$B \sim \mathcal{N}(0, 0.02)$、$G = 0$,秩$\rho = 16$;在问题span的query位置用接收方原生$Q^\star, P^\star, V^\star, O^\star$为目标,联合优化$L_{\ell,K} = \mathrm{KL}(P^\star \Vert \hat{P}) + \|\Delta O^K\|^2/d_{model}$与$L_{\ell,V} = \|\hat{O} - O^\star\|^2_F/\max(\|O^\star\|^2_F, \epsilon)$,AdamW学习率$3\times10^{-4}$、权重衰减$10^{-4}$、梯度裁剪1,训练4个epoch,选held-out损失最低的checkpoint。(6)折叠与推理:$A_{final} = A(I+BG)$,$b_{final} = b(I+BG)$,每个接收层每角色一个仿射映射;K重排成接收方KV头后走原生key norm和RoPE。
技术新颖性
问题层面:这是首个接收方免prefill的跨家族KV缓存迁移方法。此前LatentMAS假设通信模型缓存兼容,C2C需要接收方先处理共享prompt生成缓存,RecursiveMAS传递隐表示但仍需接收方层处理,Dense Latent和KV Ridge的评估局限于同家族兼容分词器。技术层面:TA把字符边界当作分词器无关锚点,做法简单却极其有效(Figure 5显示32K长度下同索引配对错位达数个字符,TA始终低于0.2字符);白化加Procrustes的Recolor是经典统计对齐在KV缓存迁移中的首次应用,用闭式解代替迭代回归;输出感知校准借自作者此前的INT2 KV量化工作(Yun et al., 2026),被改造成跨模型域的K/V解耦目标。系统层面:每个迁移方向只需201到252M参数的仿射映射,比Dense Latent少约25%、比KV Ridge少约62%,构建一个方向约2个H100 GPU小时,推理时是单次矩阵乘加偏置,比KV Ridge(每层8个发送层的头级映射)和Dense Latent(两层MLP)都更快更省。
实验结果
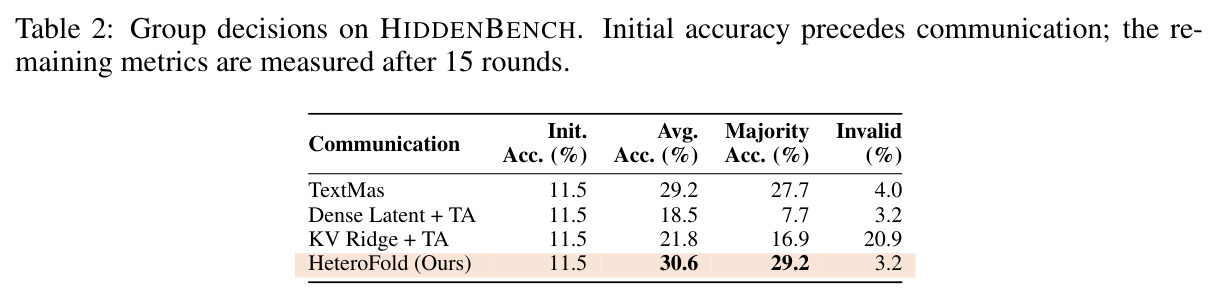
在Llama-3.1-8B、Qwen3-4B、Ministral-3-14B两两互传的六个方向上:(1)长文本QA(表1):HeteroFold在全部4个基准、全部6方向都是最佳缓存迁移方法,如Ministral到Llama方向Qasper F1为33.72(KV Ridge+TA为19.09,Dense Latent+TA为3.47,TextMas为44.64),HotpotQA 50.29,LoCoMo 43.15,QuALITY 79.00;部分设置甚至超过文本通信(Ministral到Qwen的QuALITY 75.55对70.61,Ministral到Llama的MMLU 71.76对66.74),但GSM8K等精确推理任务仍明显低于TextMas(63.46对85.67)。(2)HIDDENBENCH多智能体(65任务15轮通信,表2):平均准确率30.6%超过TextMas的29.2%,多数投票29.2%对27.7%,无效响应率3.2%远低于KV Ridge+TA的20.9%。(3)消融(表3):换成同索引配对后HotpotQA从50.29崩到0.72,单层映射37.87,头局部映射17.38;TA+Ridge仅6.82,加K/V校准恢复到31.66;TA+Recolor为40.71,加双重校准达50.29,key校准对长文本贡献最大(Qasper从26.52到34.99)。(4)延迟(表4):32K时Llama到Ministral为481.3毫秒,对Native Prefill 5167.4毫秒加速10.74倍,比KV Ridge+TA快1.18倍、比Dense Latent+TA快1.47倍。(5)行为保持(Figure 6)与文本重建(Table H):HeteroFold在QuALITY全部2086题上next-token KL和注意力KL最低,GSM8K题目重建有序重叠83.04%(KV Ridge+TA为76.68%,Dense+TA为39.74%)。(6)同家族Qwen3互传(Table G)长文本QA同样全面领先,说明增益不止来自分词器对齐。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长文本QA Qasper(Ministral-3-14B→Llama-3.1-8B) | Token F1 | 33.72 | KV Ridge + TA:19.09;Dense Latent + TA:3.47;TextMas(重prefill参考):44.64 | 较最强缓存迁移基线 +14.63,达到TextMas的75.6% |
| 长文本QA QuALITY(Ministral-3-14B→Llama-3.1-8B) | Accuracy | 79.00 | KV Ridge + TA:74.74;TextMas:83.32 | 较最强基线 +4.26,达到TextMas的94.8% |
| 数学推理 GSM8K(Qwen3-4B→Ministral-3-14B) | Accuracy(最终数字精确匹配) | 77.26 | KV Ridge + TA:60.20;Dense Latent + TA:28.81;TextMas:94.69 | 较最强基线 +17.06,但距TextMas仍差17.43 |
| 多智能体协作 HIDDENBENCH(65个hidden-profile任务,15轮通信) | 平均准确率(%) | 30.6(多数投票29.2,无效率3.2) | TextMas:29.2(27.7,4.0);KV Ridge + TA:21.8(16.9,20.9) | +1.4,免接收方prefill下首次追平文本通信 |
| 32K上下文迁移延迟(Llama-3.1-8B→Ministral-3-14B,batch 2,2×H100 NVLink) | 毫秒(越低越好) | 481.3 ms(对Native Prefill加速10.74×) | Native Prefill:5167.4 ms;KV Ridge + TA:569.9 ms;Dense Latent + TA:705.7 ms | 10.7×于重prefill,1.18–1.47×于SOTA免prefill基线 |
| 知识问答 MMLU(Ministral-3-14B→Llama-3.1-8B) | Accuracy | 71.76 | KV Ridge + TA:68.56;TextMas:66.74 | +3.20于最强基线,且超过有损对照TextMas +5.02 |
局限与改进
可识别的局限包括:(1)质量仍整体低于无损文本通信TextMas,例如Ministral到Llama方向Qasper 33.72对44.64、GSM8K 63.46对85.67,说明缓存映射仍丢失对精确推理关键的信息;(2)每个迁移方向需单独校准,消耗1600加400条prompt、约2个H100 GPU小时、0.40至0.50 GB映射参数,模型组合一多成本快速累积;(3)校准只用prompt侧问题span的query位置,虽然Figure B显示两个方向解码全程KL不发散,但自回归稳定性只在部分方向验证;(4)实验仅覆盖3个稠密BF16指令模型,未涉及MoE、更大规模、量化KV、滑动窗口注意力等组合;(5)发送方成本单列(Llama 32K发送侧prefill加捕获3381毫秒),系统总收益依赖发送方已处理过上下文这一前提;(6)作者在Figure D承认计入跨卡负载拷贝后,缓存迁移并不总能降低接收方峰值显存;(7)HIDDENBENCH只有65个任务,多智能体结论的统计功效有限。我自己的观察:两个基线均为作者重实现(无官方代码),尽管Table G提供了同家族合理性验证,仍可能低估基线;另外KV缓存共享天然带来隐私与提示泄露风险,论文未讨论。
独立分析的弱点
独立分析的弱点:(1)方向绑定的映射——仿射映射按具体的发送-接收模型对离线拟合,N个模型需要O(N^2)个映射,模型池扩大时不可扩展,改进方向是学习模型无关的中间KV空间,或用hyper-network从模型指纹直接预测映射参数;(2)精确生成损失大——GSM8K平均比TextMas低约20个点,因为校准目标只匹配单层注意力与输出,不保证多步推理链的一致性,可引入基于解码轨迹的序列级校准或束搜索蒸馏;(3)映射参数随模型规模平方增长——拼接三层后维度为$3d_{KV}^{\mathcal{S}} \times d_{KV}^{\mathcal{R}}$,70B级模型映射将达数GB,需要低秩化或分块映射结构;(4)TA假设双方共享同一段raw文本,而真实多智能体消息带各自chat模板和特殊token,鲁棒性只在特判模板的设定下测试,对格式化差异更大的场景(工具调用、代码上下文)未验证;(5)缺少服务系统集成评估——continuous batching、vLLM集成、KV逐出与INT8/INT4量化缓存叠加后的精度与延迟都未测;(6)Table H显示题目重建exact match仅16/100,说明对逐字引用敏感的任务(检索、引文、代码补全)缓存保真度可能不足。每个弱点都指向明确的改进方向,也是后续论文的机会点。
未来方向
作者提出的方向:把方法推广到更多模型家族与更大规模,构建跨家族的通用KV接口,让缓存像文本一样即插即用地在异构智能体间共享。基于本文成果可延伸的方向:(1)多发送方缓存融合——把多个异构agent对同一上下文的KV缓存融合成单一接收方缓存,类似Mixture-of-Agents的KV版本;(2)与KV量化稀疏化联合设计,传输前压缩payload以削减跨卡拷贝带宽;(3)在线增量校准——用极少量样本快速为新模型对构建映射,或将校准改成元学习以支持新模型即接即用;(4)理论分析——为何白化加Procrustes在层数、头数、归一化方式都不同时仍有效,其失效边界在哪里;(5)安全与隐私——KV缓存可能泄露发送方系统提示或私有上下文,需要访问控制、脱敏或加密缓存接口;(6)与分布式推理调度结合——跨异构硬件的缓存生命周期管理、共享缓存池与逐出策略;(7)把HeteroFold扩展到多模态模型的视觉token缓存迁移。
复现评估
复现条件较好。模型全部公开(meta-llama/Llama-3.1-8B-Instruct、Qwen/Qwen3-4B、mistralai/Ministral-3-14B-Instruct-2512-BF16),BF16冻结;校准数据公开(Open-R1与HotpotQA训练集,校准用HotpotQA与评测集不重叠;Qasper和HotpotQA评测用LongBench 200条子集);论文脚注给出GitHub链接,但Dense Latent与KV Ridge无官方实现,需按附录A.3的设置自行复现(作者另用Table G的同家族实验验证了基线实现正确性)。算力需求:2张H100 80GB(NVLink)用于延迟实验,构建一个迁移方向约2个GPU小时、映射0.40至0.50 GB,全部超参已给出(秩16、AdamW学习率$3\times10^{-4}$、4个epoch、梯度裁剪1)。附录质量很高:敏感性分析(表B到表E覆盖校准规模、秩、层数、语料)、延迟测量协议(表I、图C、图D)、行为度量定义(附录D)齐全。难点在工程细节:tokenizer字符偏移、chat模板特判、FlashAttention-2下注入KV、GQA头重排。总体属于中等偏高难度,有单机多卡经验的团队可以复现。
论文图表
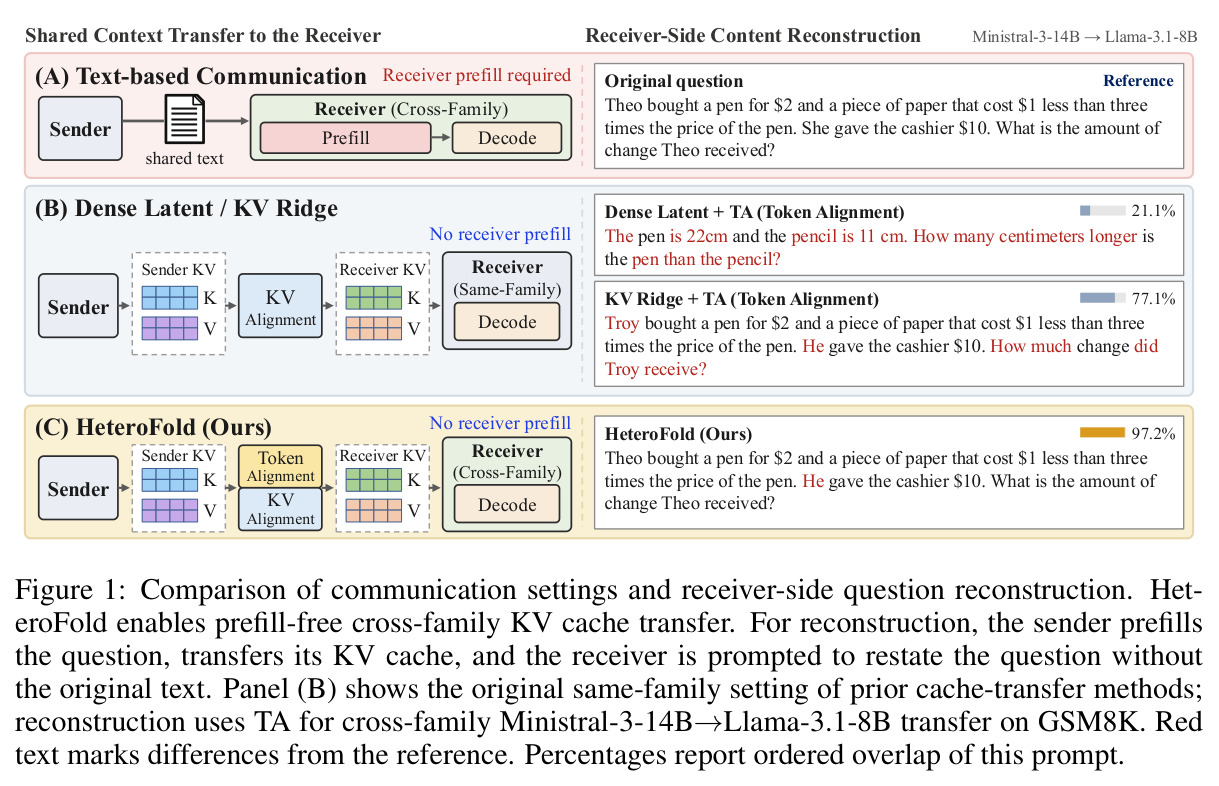
上半部分对比三种通信设定:(A)文本通信需要接收方prefill;(B)Dense Latent与KV Ridge的同家族缓存迁移;(C)HeteroFold的跨家族免prefill迁移。下半部分在GSM8K上做题目重建实验(Ministral-3-14B→Llama-3.1-8B):发送方prefill题目、迁移缓存后让接收方凭缓存复述问题,有序重叠率分别为21.1%(Dense Latent+TA)、77.1%(KV Ridge+TA)、97.2%(HeteroFold),红字标出与参考原文的差异。
直观展示跨家族迁移的核心失败模式——token错位导致的语义破坏,以及HeteroFold近乎无损恢复原文的能力,是理解论文动机的最佳入口。
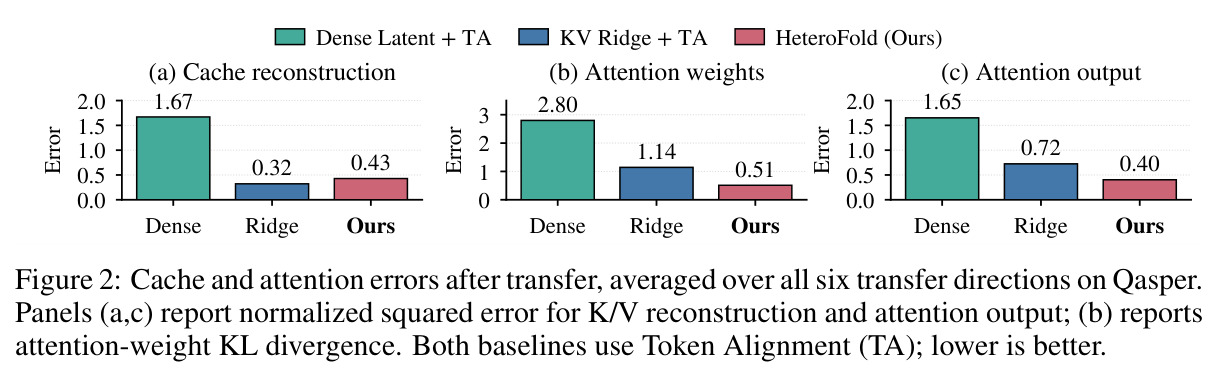
三组柱状图在Qasper上(六方向平均)分别比较K/V重建误差、注意力权重KL散度、注意力输出误差。KV Ridge的缓存重建误差低于HeteroFold(约0.43对0.72量级),但其注意力KL和输出误差更高;HeteroFold的注意力输出误差最低(约0.51,基线约1.14至2.80)。
支撑全文关键论点『重建误差低不等于接收方行为正确』,是方法目标从数值拟合转向行为匹配的直接实验证据。
在QuALITY全部2086道开发集问题上按接收方模型分组(Qwen/Llama/Ministral),比较各方法与原生接收方的next-token KL散度、A/B/C/D答案一致率、注意力KL。HeteroFold在所有六个迁移方向上next-token分布、注意力权重和答案选择都最接近原生接收方(如Ministral接收方答案一致率最高达76至77%)。
提供比任务准确率更细粒度的行为保真证据,直接验证输出感知校准目标的有效性。
列出全部评估集规模与指标:短文本ARC-Challenge 1172、MMLU 14042、WinoGrande 1267、HellaSwag 10042、GSM8K 1319(Accuracy);长文本Qasper与HotpotQA用LongBench 200条子集(Token F1)、LoCoMo类别1-4共1540、QuALITY开发集2086(Accuracy);HIDDENBENCH 65(Accuracy与invalid rate)。
评估规模与指标口径的权威说明,是判断结论可信度与复现评测设置的依据。
Llama-3.1-8B→Qwen3-4B方向把校准集从200/50扩大到1600/400(等比Open-R1与HotpotQA混合):ARC-C从72.87升至77.05,HotpotQA从26.40升至49.44,QuALITY从61.55升至62.90,长文本任务收益最大。
回答『需要多少校准数据』,直接影响复现成本估算,显示长文本QA对校准数据量最敏感。
低秩修正秩从0(纯Recolor)到64的敏感性:秩0时HotpotQA仅30.47,秩4已到47.60,秩16最佳为49.44,秩32/64略降至44.45/43.09;ARC-C与QuALITY在各秩间变化较小(QuALITY在秩0时反而最高65.10)。
说明低秩修正的性价比曲线,以及默认秩16的选择依据;也提示校准对短文本知识任务帮助有限。
发送层邻域取1/3/5层的对比:单层时ARC-C 66.89、HotpotQA 22.52、QuALITY 51.58;三层提升到77.05/49.44/62.90;五层与三层基本持平(76.96/48.44/64.43)。
证明跨层聚合的必要性,并支撑默认比例深度对齐加正负4偏移三层的设计选择。
800/200设置下对比校准语料:纯Open-R1为73.21/12.69/47.70(ARC-C/HotpotQA/QuALITY),纯HotpotQA为74.32/36.87/60.98,等比混合最佳为75.68/41.97/63.57,且对未参与校准的ARC-C和QuALITY同样有效。
揭示校准语料多样性(推理加长文本)的重要性,对如何为新模型对选择校准数据有直接指导意义。
六个方向的映射参数量对比:HeteroFold为201至252M(约0.40至0.50 GB BF16),比Dense Latent(270至337M)少约25%,比KV Ridge(537至671M,每接收层用8个发送层的头级映射)少约62%;构建一个方向约需2个H100 GPU小时。
量化方法的轻量性与部署成本,说明单次仿射映射设计在存储和构建时间上的系统优势。
四个Qwen3家族内互传方向(4B/8B/14B),基线使用其原始同家族设定:HeteroFold在长文本QA全面最佳,如4B→14B的Qasper 34.13对KV Ridge 29.02、Dense Latent 7.10,14B→4B的QuALITY 75.12对72.87;短文本上与KV Ridge互有胜负但GSM8K最优(90.98至92.19)。
双重作用:证明HeteroFold的增益不止来自分词器对齐,在同家族也有效;同时验证基线实现在其原始设定下的正确性,增强跨家族对比的可信度。
100条GSM8K题目重建实验(Ministral-3-14B→Llama-3.1-8B,词级最长公共子序列F1):原生接收方100.0,HeteroFold 83.04(16/100完全精确、8/100触及生成长度上限),KV Ridge+TA 76.68(7/100),Dense Latent+TA 39.74(0/100、17/100触限)。
用自然语言保真度直接量化缓存迁移的信息损失,把Figure 1的个例变成统计结论。
规定表4计时区间包含的操作:缓存迁移方法计入TA、K/V映射、H100间KV负载拷贝、缓存构建与首个输出token计算;Native Prefill则计入对原始文本的完整prefill;双方的发送方prefill、模型加载与离线拟合、后续解码均排除。
延迟对比公平性的关键协议说明,审慎解读速度结论时必须参照。
六个迁移方向的校准过程图:(a)注意力KL散度与 从Recolor初始化到校准后checkpoint显著下降;(c)仿射映射的相对变化幅度大约在0至20%之间,说明修正温和可控。
验证输出感知校准在held-out数据上稳定收敛、修正幅度有限,说明不是靠过拟合校准集取得提升。
对GSM8K贪心解轨迹逐token重放,比较原生与迁移缓存的全词表KL散度和top-1不一致率随解码步数分桶(1至4096步)的变化:Llama→Qwen与Ministral→Llama两个方向均无随长度增长的持续发散,后期差异反而更小。
回应『只用prompt侧token校准是否足以支撑长解码』的质疑,支撑免prefill下多步推理的可行性。
把表4的延迟分解为四个阶段:分词加TA、跨卡负载拷贝、K/V映射加缓存构建、接收侧首token处理,覆盖两个方向与4K/16K/32K。HeteroFold的优势主要来自更小的K/V映射与缓存构建阶段——单次仿射映射对比Dense Latent的两层MLP和KV Ridge的八层头级映射。
解释加速的具体来源,对系统优化和工程移植最有参考价值。
把延迟与显存对比扩展到全部六个方向、4K/16K/32K三档:所有方向所有长度的缓存迁移都快于Native Prefill(4K约1.59至3.75×,16K约3.39至8.11×,32K约5.16至10.74×),其中两个进入Ministral的方向加速最高;HeteroFold的延迟与额外峰值显存在每个配置下都低于KV Ridge,但计入负载拷贝后缓存迁移并不总比Native Prefill省接收方显存。
证明延迟结论的六方向普适性,同时诚实披露内存代价,是评估实际部署收益时必须看的图。