签名之下向量仍可被操纵:离线检索增强生成中文本-向量完整性差距的度量与弥合 Signed but Steerable: Measuring and Closing the Text-Vector Integrity Gap in Offline Retrieval-Augmented Generation
签名只证明来源不保证向量编码文本:边际定律量化劫持率,码级验证与规范化关闭差距
前置知识
RAG(检索增强生成)
把语料切块,用嵌入模型将每块映射为稠密向量存入索引;查询时将问题同样嵌入,按余弦相似度检索最近邻文档放入语言模型提示词中作答。答案的质量与安全性完全取决于检索返回哪些文本块,而这一排序决策完全在向量空间中完成。
本文攻击的目标正是'哪块文本进入上下文':理解检索如何由向量夹角决定,是理解向量劫持机制的前提。
余弦相似度与检索边际
归一化向量的语义接近度用夹角 $\theta=\arccos(q\cdot g)$ 度量。检索边际 $m(q)=\theta_c-\theta_g$ 是黄金块与其最近竞争者到查询夹角之差,决定排名第一能否被翻转;论文实测五语料中位边际仅 2.1–7.4°,ArguAna 上 5% 查询的边际低于 0.02°。
边际定律把'容差泄露多少查询'归约为边际经验分布,是全文的核心量与主线。
向量量化(SQ/PQ/二值编码)
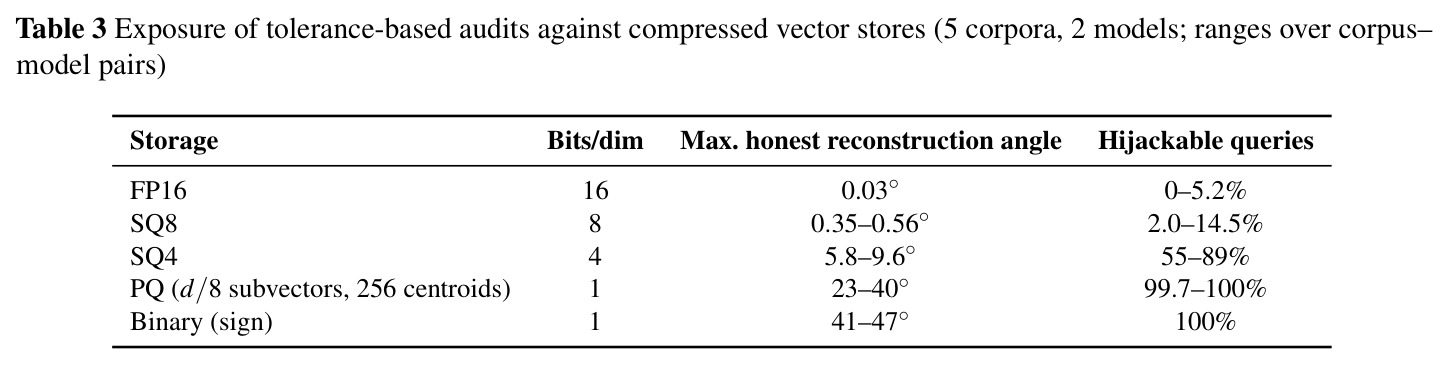
向量库为省内存不存全精度浮点而存压缩码:SQ8/SQ4 把每维映射到 $2^b$ 个级别;乘积量化 PQ 把向量切成子向量、每段只存最近质心的索引;二值码只保留各维符号。重建误差从 SQ8 的约 0.35–0.56° 到 PQ/二值的 23–47°。
压缩格式决定完整性审计必须容忍的重建误差,直接决定容差审计让渡给攻击者的预算。
数字签名与软件供应链安全
签名证明'谁发布了哪些字节',配合 TUF 式角色分离、Certificate Transparency 式透明日志与版本单调性可防密钥滥用、回滚与历史分叉;但它们认证的只是字节及其历史,不包含部件之间的语义一致性检查。
本文的核心论点是签名不绑定'向量是否真的编码其文本',而被攻陷的签名者或内部人恰是该绑定要防的对手。
浮点非结合性与推理确定性
浮点加法不满足结合律,求和结果依赖核函数、批大小、线程数与硬件;动态 INT8 量化还会随同批其他输入变化。论文实测:PyTorch 随批大小变化约 $10^{-7}$(GPU FP16 达 $10^{-4}$),ONNX Runtime 跨 x86/ARM 差 $1.9\times10^{-7}$,动态 INT8 达 0.03。
精确逐位验证要求发布方与设备共享位可复现的计算栈,论文证明常见流水线都不满足,这决定了可行防御的形态。
研究动机
在断网的边缘场景(野外、工业、国防),树莓派 5 这类设备通过带签名的版本化知识包更新本地 RAG 知识库。由于在 Pi 的 CPU 上嵌入 950 段文本需约 29 分钟,知识包通常随文本一起附带预计算向量。签名覆盖这些向量,但没有任何机制保证向量真的编码了所附文本:掌握发布流水线的攻击者或持有内容密钥的内部人,可以发布通过内容审核的良性文本,却配上故意旋转的向量,把选定文档推到检索第一名。向量数据库同样存在此缺口:常见完整性审计是'重算向量、在余弦容差内接受',而容差必须容纳浮点噪声(跨架构 0.04°)、推理量化误差或存储压缩误差(PQ/二值达几十度),这些误差往往远大于检索边际(中位仅几度)。OWASP 把嵌入弱点列为 LLM 应用主要风险并建议定期审计知识库,却未规定向量如何与文本绑定。作者此前的工作就已观察到:一个被有效签名但遭投毒的知识包通过了全部包级检查。
本文的目标是本文系统回答四个研究问题。RQ1:若验证器在余弦容差 $\tau$ 内接受附带向量,最优攻击者能劫持多少查询,能否不运行攻击就提前预测?RQ2:向量数据库常用压缩存储格式(FP16/SQ8/SQ4/PQ/二值)在同一攻击下暴露多少?RQ3:能否跨异构硬件(NVIDIA/Metal GPU、x86/ARM CPU)实现精确逐位验证,需要什么条件?RQ4:在与语言模型共享 CPU 的边缘设备上验证代价多大、端到端危害如何?最终目标是把'应定期审计知识库完整性'这类模糊建议,转化为可测量、可校准、可审计的具体流程,并在浮点流水线不可逐位复现的现实约束下,给出让发布方无残余选择权的验证方案(码级验证加规范化),同时在真实设备上量化攻击的实际危害与防御的算力代价。
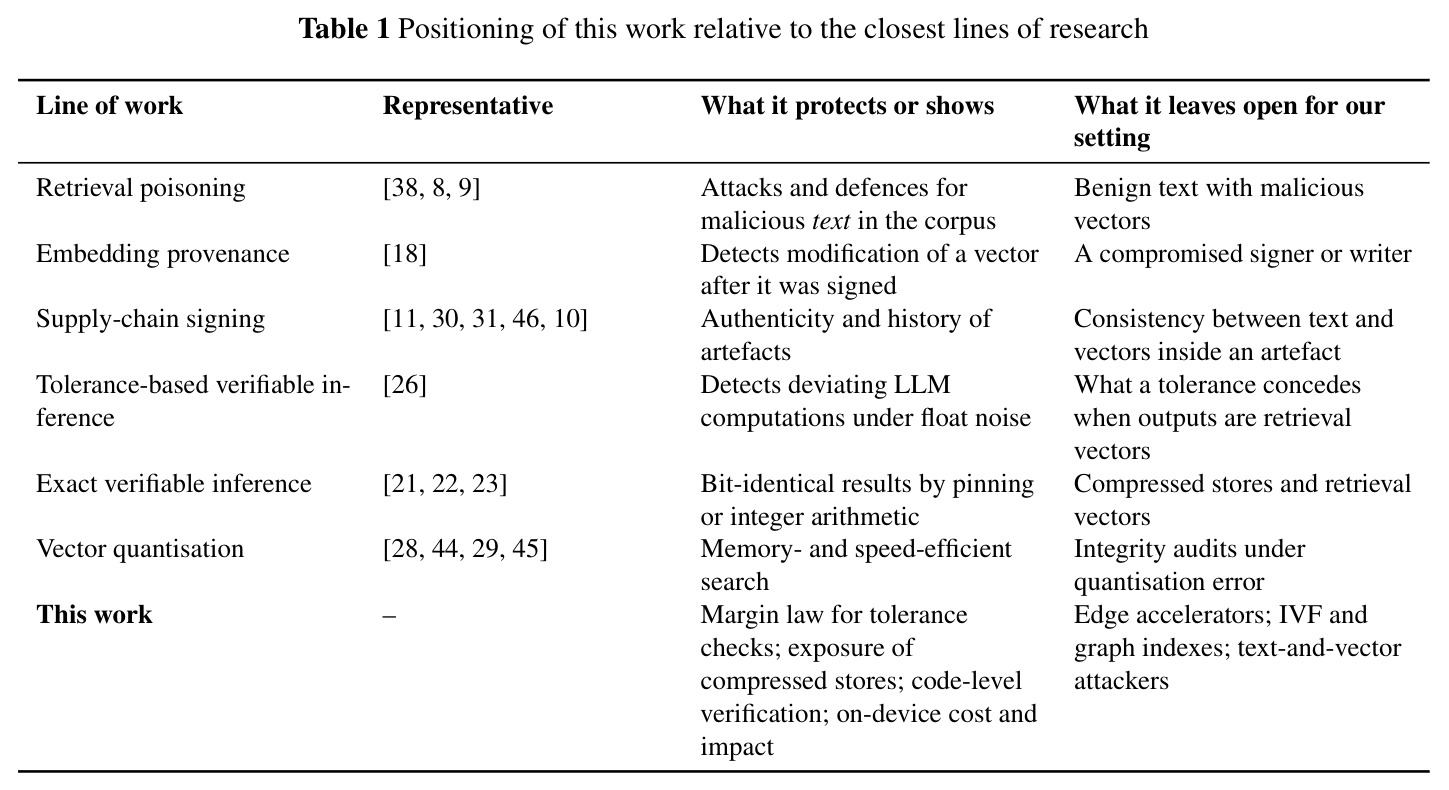
与已有工作不同的是,已有三条研究线都没覆盖这个缺口。检索投毒与间接提示注入类工作改变语料中的文本本身,防御靠内容审查、认证鲁棒聚合等文本层手段,看不见'文本固定、向量被换'的操作。VectorSmuggle/VectorPin 提出对每条嵌入与其源内容、模型一起签名以检测签名之后的篡改,但本文的对手恰恰是签名者本人或其产出被签名的存储写入者,来源控制与事后篡改检测均无能为力。可验证推理文献讨论容差式与精确式校验的权衡,但对象是生成文本或中间激活;本文首次把这一权衡搬到检索场景:证明容差就是攻击预算并给出其精确刻画(边际定律),同时发现让容差审计失效的粗糙量化单元反而使码级精确检查可跨平台移植。'良性文本+恶意向量'这一文本-向量完整性差距本身,此前从未被量化。
核心方法
论文先构建威胁模型:发布方分发知识包 $P=\{(t_i,v_i)\}$,文本与向量都带有效签名;对手能让验证器收到签名合法的包或向量库(被攻陷的发布方/构建流水线/内部人/写入者),所有文本都通过内容审核,但向量或压缩码由对手自由选择;目标是把指定块顶到目标查询 rank 1(劫持)或送入 top-3 上下文(载荷投递)。对比五种验证器 V0–V4:无验证、仅签名、容差重算、精确等值、码级验证。实验横跨树莓派 5(CPU 上跑 Qwen2.5-3B-Instruct Q4_K_M 与 ONNX Runtime 嵌入)、RTX 4090 桌面与 Apple M2 第三平台。数据包括 SQuAD 2.0 的 950 段语料与 300 题(另加全部 4,690 道可答开发题)、四个 BEIR 语料(FiQA 达 57,638 文档)与 1,000 条 MS MARCO 查询,嵌入模型为 BGE-M3 与 all-MiniLM-L6-v2。路线:推导并验证边际定律,据此量化容差审计暴露,对真实 FAISS PQ 索引执行攻击,设计并双向测量码级验证,最后在设备上做端到端攻击与 19 个更新用例测试。假设与判定门限预先登记,协议含 34 条偏差日志,并以 60/60 答案逐字复现作可复现性检查。
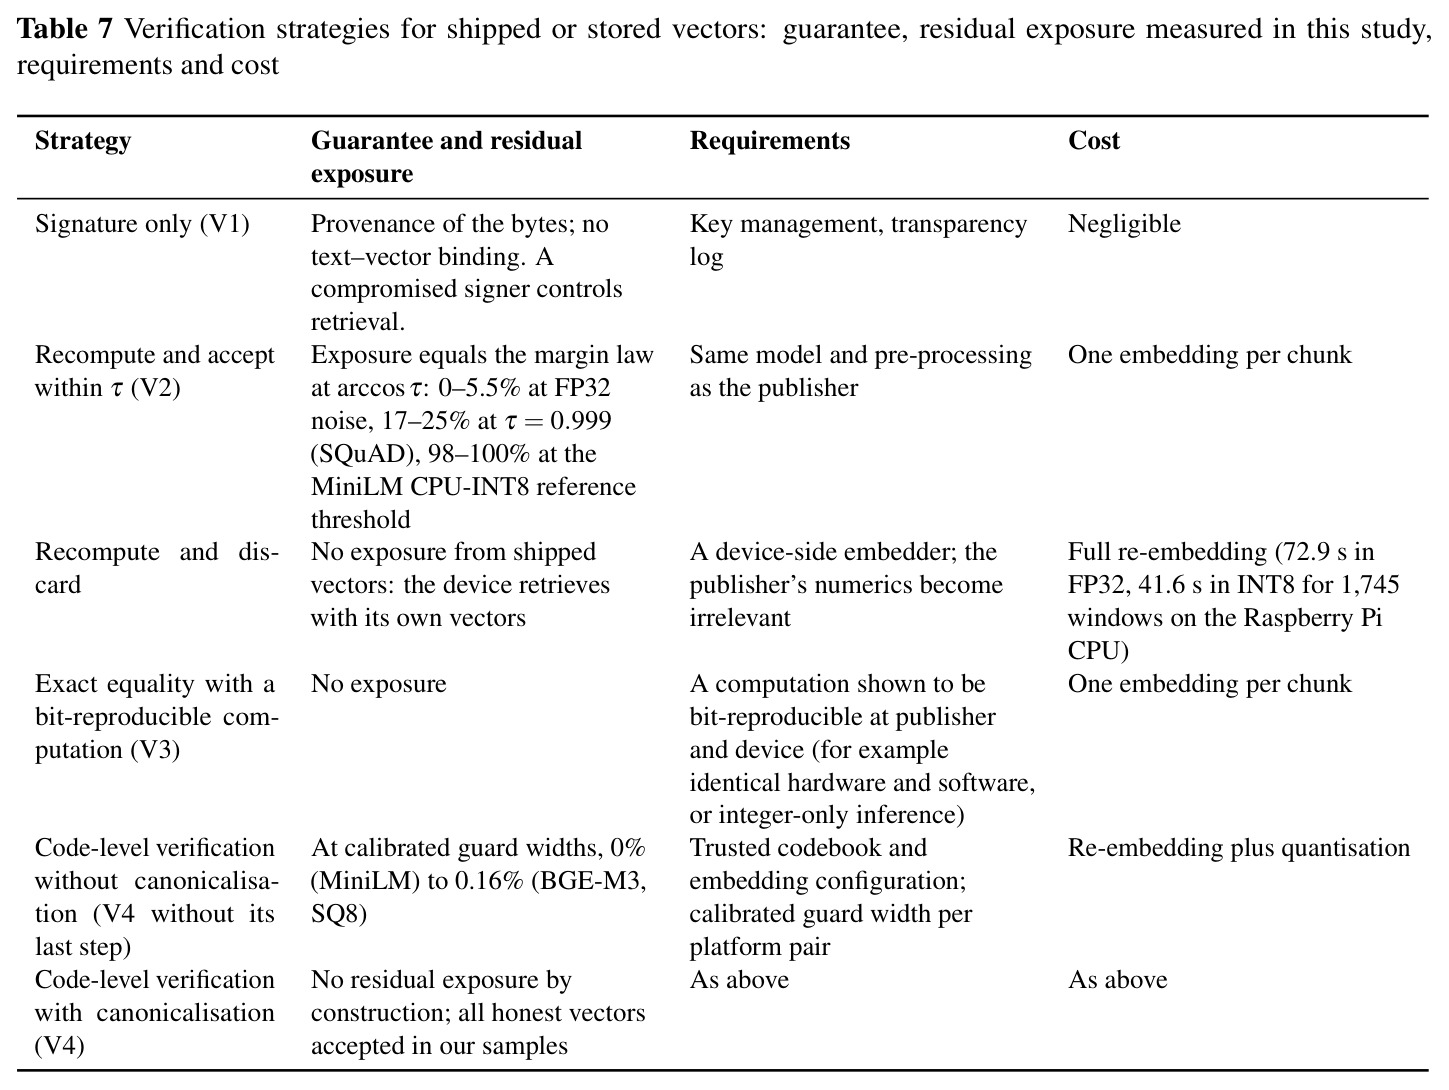
两个核心创新。其一是边际定律:设查询 $q$ 与黄金单元 $g$ 夹角 $\theta_g$、最近非相关竞争者夹角 $\theta_c$,检索边际 $m(q)=\theta_c-\theta_g$。V2 型验证器接受与真实向量夹角 $\le\alpha=\arccos\tau$ 的向量,最优攻击者把最近竞争向量向 $q$ 旋转 $\alpha$,可证当且仅当 $m(q)<\alpha$ 时 rank 1 被劫持,故劫持率 $HR(\tau)=\frac{1}{|Q|}\sum_{q\in Q}\mathbb{1}[m(q)<\arccos\tau]$ 恰为边际经验分布在 $\arccos\tau$ 处的取值——运维者用诚实向量与查询日志即可算出暴露面,无需发动任何攻击;预测与模拟攻击逐点一致(最大绝对差 0.0)。其二是码级验证:验证器只信自己的重算,用库的码本把重算嵌入量化为自己的码 $c$,仅当存储码等于 $c$,或等于验证器自己标记为模糊的相邻码 $a$(SQ 距舍入边界小于 $\varepsilon_{SQ}$、PQ 最近与次近质心平方距差小于 $\varepsilon_{PQ}$、二值 $|v|<\varepsilon_{bin}$)才接受,随后用验证器的码重写(规范化),使发布方对最终码无任何选择权。
方法步骤详情
第一步,边际测量:对每个可答且黄金排第一的查询(SQuAD 上 BGE-M3 3,648 条、MiniLM 128-token 窗口 3,301 条),用稳定公式 $2\arcsin(\|q-d\|/2)$ 在双精度下计算边际(数值稳定性改变不超过 $4\times10^{-5}$ 度)。第二步,容差校准:取 Pi CPU 上 1,745 个窗口的动态 INT8 与 FP32 余弦的 0.1% 分位数作参考阈值(0.9040,25.31°);压缩库取各自最大诚实重建角(SQ8 0.35–0.56°、SQ4 5.8–9.6°、PQ 23–40°、二值 41–47°)。第三步,暴露计算:按边际定律读出各容差劫持率并与模拟攻击对照。第四步,FAISS 执行攻击:在 FiQA 全量 57,638 文档上建 Flat/SQ8/PQ/Binary 索引,对 60 个随机目标贪心替换载体文档的码、回退增益最低的改动直到通过全局容差,再用码级验证复核。第五步,码级验证双向测量:三平台四后端扫描守卫宽度,统计诚实向量接受率、跨设备最大浮点偏差与发布方在模糊条目上的残余劫持预算,验证规范化归零。第六步,设备端与端到端:Pi CPU 并行编码测 LLM 解码损失;对 100 道可答题注入带固定指令文本的'编辑注记'块并按各容差配向量后跑完整 RAG;另测 19 个更新用例(12 结构攻击、3 合法更新、3 内容攻击、1 向量脱同步)。
技术新颖性
新颖性体现在四点。第一,边际定律是可免攻击预测暴露的紧刻画:论文证明最优攻击者的劫持率恰等于边际分布,并在 300 题集上与模拟完全吻合,把安全评估从'跑攻击'降为'算分布',且表明容差的安全性取决于语料与嵌入模型而非仅容差本身。第二,首次量化压缩向量库完整性审计的暴露面(SQ8 2–15%、SQ4 55–89%、PQ/二值约 100%),并给出真实 FAISS 索引上的可执行攻击存在性证明:60 个被篡改向量全部通过审计、载体对 25% 目标排第一。第三,一个反直觉的对偶:让容差审计失效的粗糙格式(PQ/二值)恰让码级精确审计最可移植——粗量化单元天然吸收浮点噪声,跨 NVIDIA/Metal GPU 与 x86/ARM CPU 都能以 $\le3\times10^{-7}$ 的守卫宽度接受全部诚实向量。第四,规范化把'检测不一致'升级为'修复不一致',使发布方残余选择权严格为零,而检测、日志与策略仍由签名与更新治理承担;论文还实证 FP32 与动态 INT8 流水线跨批大小、跨架构均非逐位可复现,为精确验证的前提给出测量基础。
实验结果
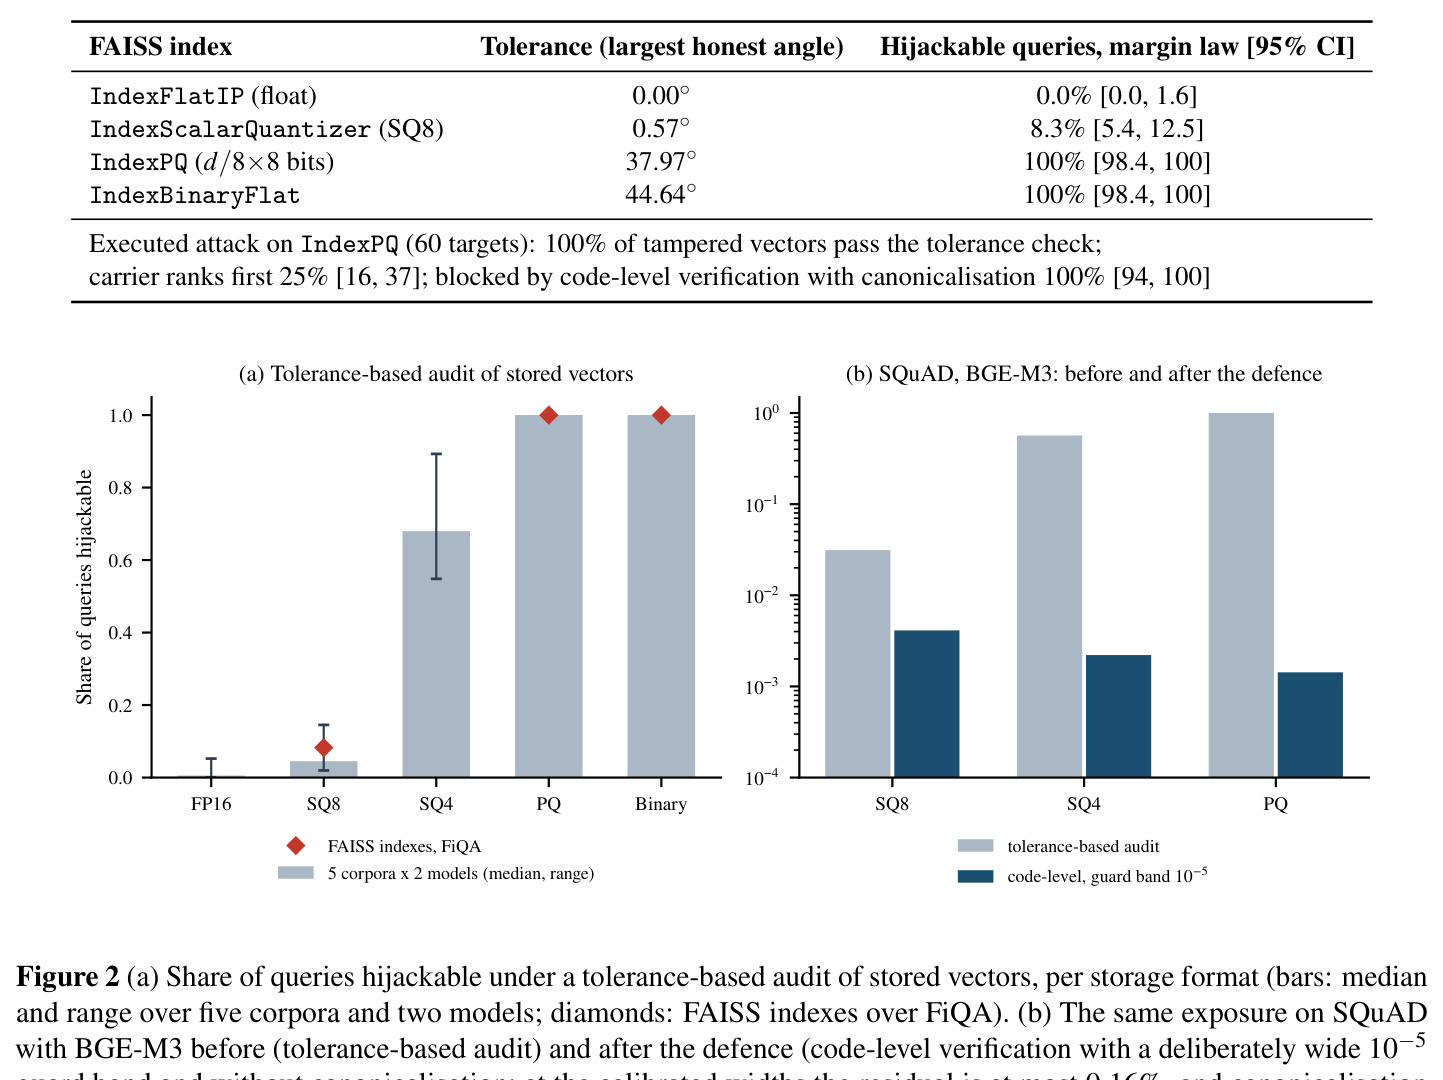
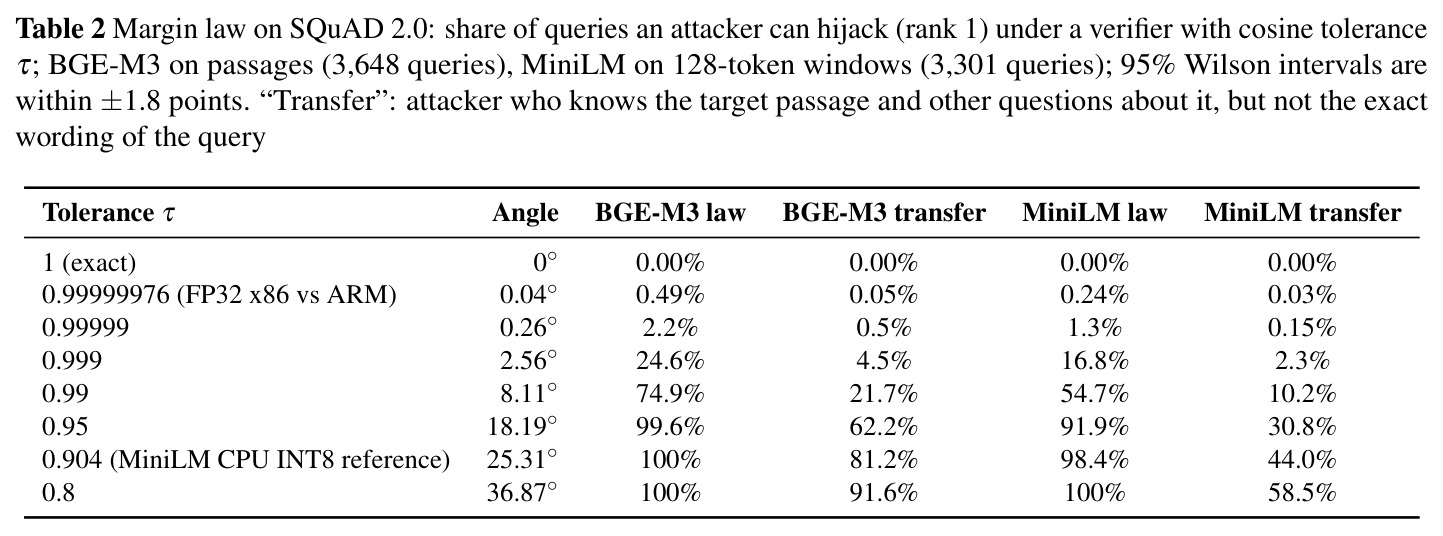
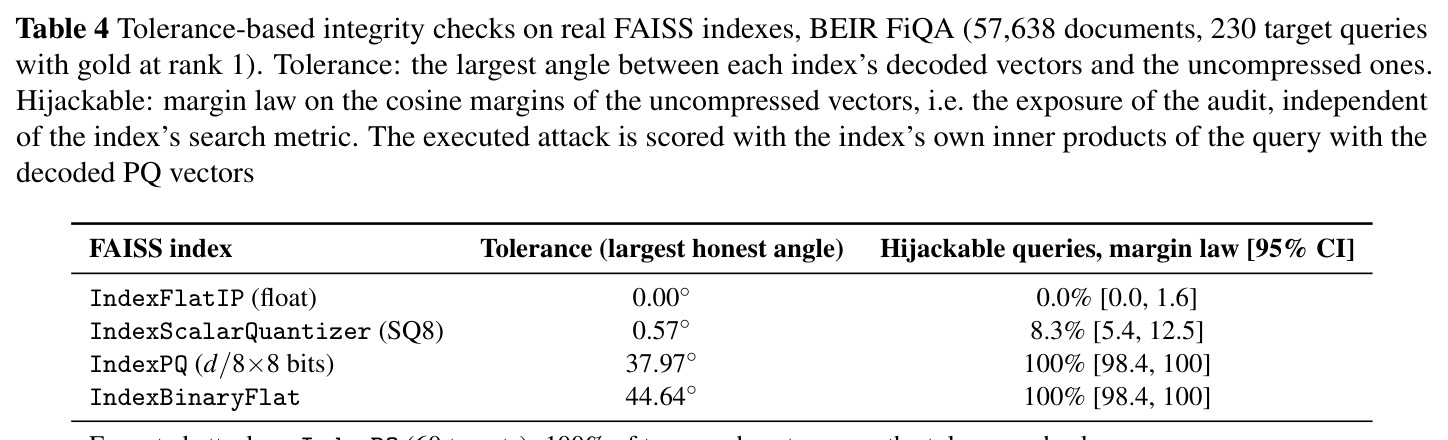
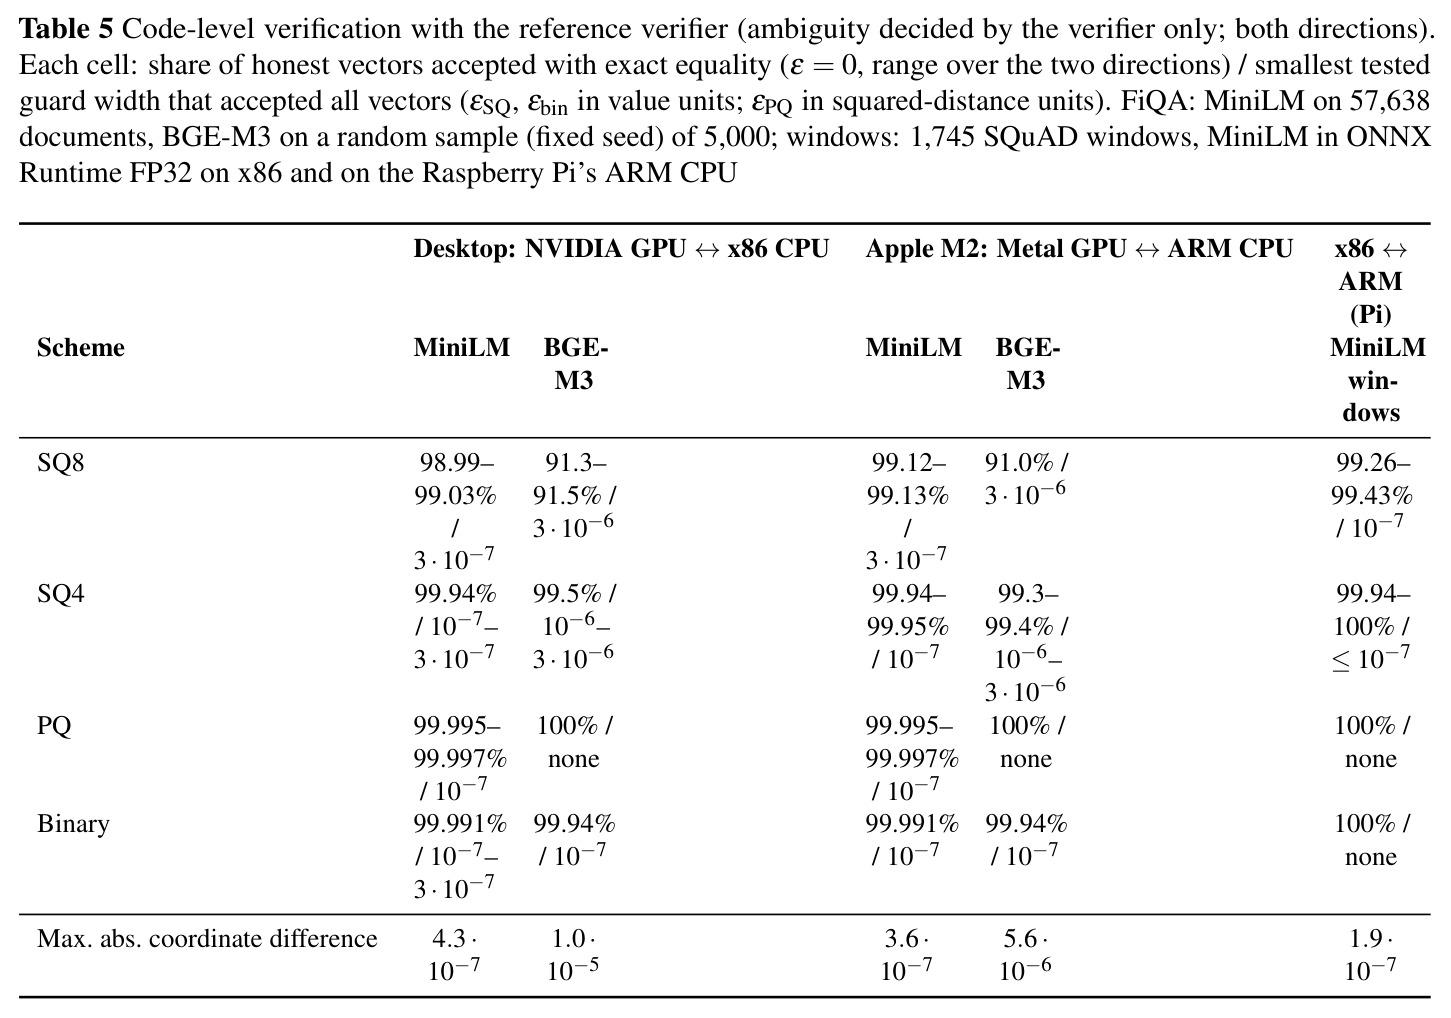
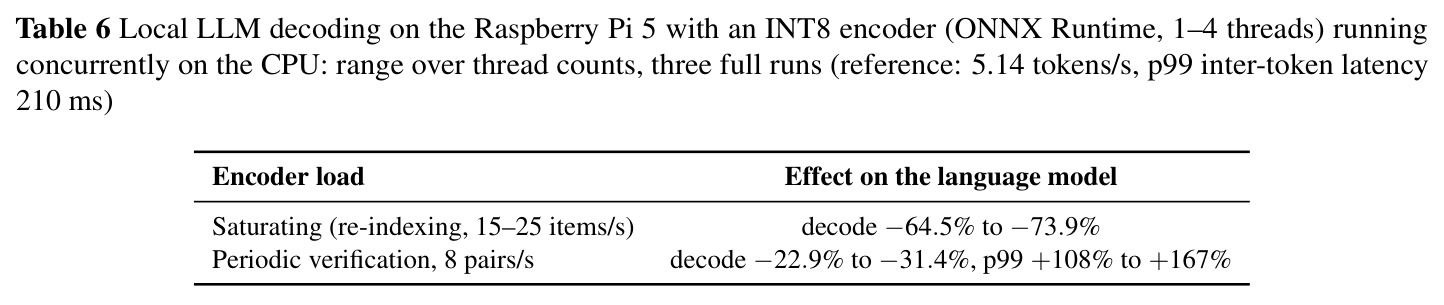
RQ1:边际定律与模拟攻击逐点一致(最大绝对差 0.0)。SQuAD 上 BGE-M3/MiniLM 中位边际 5.2°/7.4°,5% 查询低于 0.6°/0.8°;$\tau=0.999$(2.56°)时 24.6%/16.8% 可劫持,FP32 跨架构噪声(0.04°)留下 0.49%/0.24%,INT8 校准阈值(0.904,25.31°)留下 100%/98.4%,迁移攻击者亦达 81.2%/44.0%;五语料 FP32 噪声容差暴露 0–5.5%(剔除精确重复后 ≤1.2%),INT8 阈值 98.7–100%。RQ2:容差审计对 FP16/SQ8/SQ4/PQ/二值分别暴露 0–5.2%、2–14.5%、55–89%、99.7–100%、100%;FAISS FiQA(57,638 文档)实测 SQ8 8.3%、PQ/二值 100%,对 PQ 索引执行攻击时 60 个被篡改向量全部通过审计、载体对 25%[16,37] 目标排第一,码级验证 100%[94,100] 拦截。RQ3:码级验证在三平台四后端接受全部诚实向量(SQ8 守卫 $3\times10^{-7}$/$3\times10^{-6}$,PQ/二值 $\le3\times10^{-7}$ 或无需),校准宽度下残余 ≤0.16%,规范化后为 0。RQ4:Pi CPU 重嵌 1,745 窗口 FP32 72.9s/INT8 41.6s,8 对/秒验证使解码降 23–31%;端到端攻击在 INT8 阈值下把正确答案从 0.75 打到 0.39、拒答从 0.13 升至 0.50(载荷进 top-3 达 94%),$\tau=0.999$ 时几乎无影响(0.74,载荷 2%);分层验证拒绝全部 12 个结构攻击。三个预注册负面结果:弃答评分器跨数据集排序反转(SQuAD 最佳 QA 边际 0.86,MARCO 最佳交叉编码器 0.83);上下文剪枝时延 25.1s→8.6s 但正确率 0.75→0.44(错误率不变,弃答激增);NLI 事实篡改筛查 AUROC 仅 0.18。
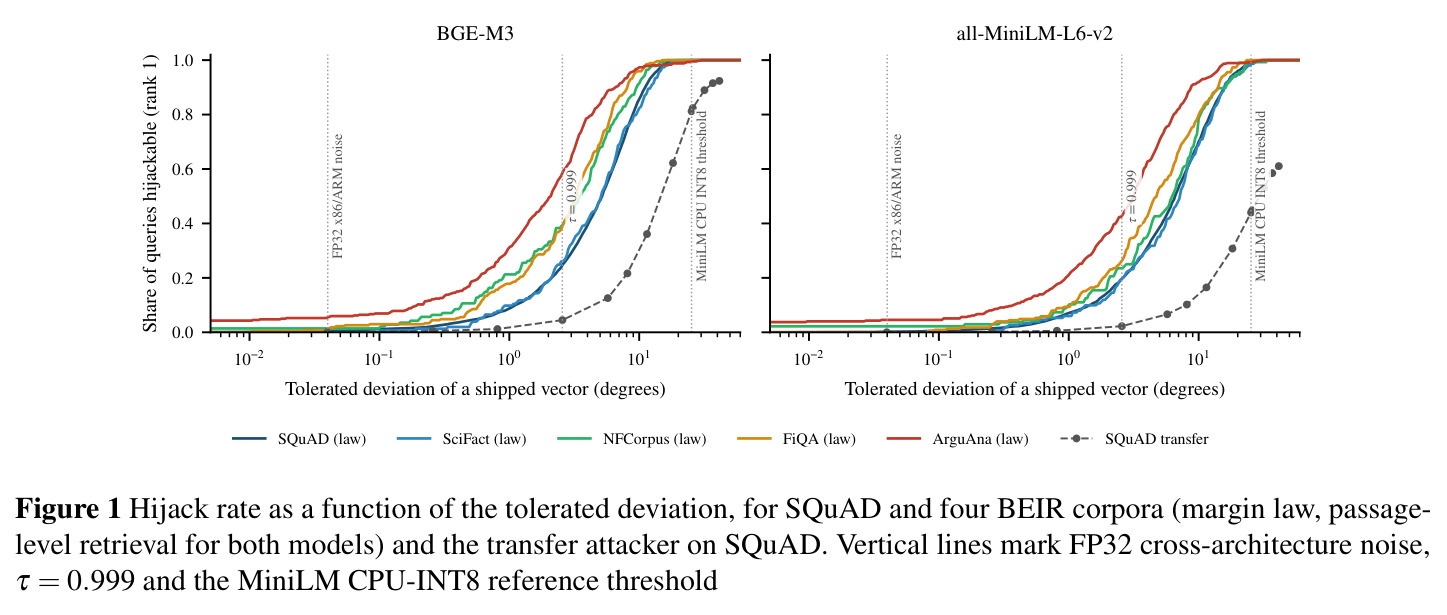
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 检索劫持率预测(SQuAD 2.0,BGE-M3 与 MiniLM) | 劫持率 @ τ=0.999(2.56°) | 边际定律预测 24.6%(BGE-M3)/ 16.8%(MiniLM) | 模拟攻击 24.6% / 16.8%(完全一致,最大绝对差 0.0) | 无需运行攻击即可精确预测暴露面,把安全评估变成对诚实向量的常规计算 |
| INT8 校准容差下的可劫持查询(SQuAD 与五语料) | 劫持率 @ τ=0.904(25.31°,INT8 余弦 0.1% 分位数) | SQuAD 上 100%/98.4%,迁移攻击者 81.2%/44.0%;五语料 98.7–100% | FP32 跨架构噪声容差(0.04°)仅 0.49%/0.24%,五语料 0–5.5%(剔除重复后 ≤1.2%) | 证明按诚实噪声校准的 INT8 阈值几乎让出全部查询,容差即攻击预算 |
| FAISS 乘积量化索引上的执行攻击(BEIR FiQA,57,638 文档,60 目标) | 载体文档在索引自身打分下排名第一的比例 | 25% [16,37];60/60 被篡改向量全部通过容差审计 | 无攻击时黄金文档排第一;PQ 容差审计边际定律暴露 100% | 码级验证+规范化拦截 100% [94,100],检测并重写全部被篡改码 |
| 设备端到端 RAG 攻击(树莓派 5 + Qwen2.5-3B,100 道可答题) | 正确答案率 / 拒答率 / 载体进入 top-3 比例 | 受攻击(INT8 参考阈值):0.39 / 0.50 / 94% | 无攻击 0.75 / 0.13;τ=0.999 时 0.74 / 0.13 / 2% | 量化真实危害:正确率近乎腰斩,且危害集中在宽容差区域 |
| 码级验证诚实向量接受率(3 平台 × 4 计算后端,双向) | 精确等值接受率 / 所需最小守卫宽度 | 100%(SQ8 需 3e-7 MiniLM / 3e-6 BGE-M3;PQ、二值 ≤3e-7 或无需守卫) | 容差审计暴露 2–15%(SQ8)至约 100%(PQ/二值) | 规范化后发布方残余劫持为 0(无规范化时 BGE-M3 SQ8 至多 0.16%) |
局限与改进
作者承认的外部效度限制:仅两个嵌入模型、英文语料(最大 57,638 文档)、FAISS 平坦索引(IVF 粗量化器与 HNSW 图边未覆盖)、一块开发板且推理在 CPU、一个本地 LLM;INT8 参考阈值是特定配置(动态量化随批大小变化)的产物,其他量化方案或加速器会有不同容差;守卫宽度是样本上的经验校准加网格搜索,不构成对其他模型/硬件的保证;更新场景为合成。构造效度上,危害被定义为黄金单元被挤出 rank 1、载荷为进入 top-3,其他定义下结论可能不同;边际定律是保守的单旋转上界(若攻击者还能旋转黄金向量,预算翻倍为 $2\alpha$)。我的补充观察:码级验证假定码本来自与码写入方分离的可信来源,若发布基础设施整体沦陷或码本哈希未严格入清单,粗量化单元反而给投毒码本更大操纵空间,文中未评估码本投毒;规范化后的存储保护(防再次写入)只是假设而非机制;验证与 LLM 抢占 CPU(解码降 23–31%)使部署调度成为未解问题;内容层的弃答与筛查全部失败,意味着'通过审核的文本本身就是注入载荷'的路径仍未设防。
独立分析的弱点
弱点一:动态 INT8 的诚实噪声本身就有 25° 量级,任何以 0.1% 分位数校准的容差都几乎让出全部查询(98–100%),改进方向是彻底把发布方向量移出信任基——设备重算后丢弃,或转向整数化、位可复现的推理栈,使精确等值验证成为现实。弱点二:码级验证依赖可信码本与嵌入配置的带外绑定,攻击者若能同时控制码本分发,粗量化单元会放大其操纵空间,应补充码本投毒攻击评估并设计码本透明日志。弱点三:迁移攻击者(不知用户措辞)仍达 44–81% 成功率,说明即使部署完美验证,检索层对'围绕同一段落的其他问题'仍敏感,可结合认证鲁棒聚合限制少数被污染块的影响。弱点四:内容层防线全面失守——弃答评分器跨域排序反转(SQuAD 最佳 QA 边际 0.86,MS MARCO 最佳交叉编码器 0.83)、NLI 筛查 AUROC 仅 0.18、近重复信号被复述击败,'通过审核的文本携带提示注入'的攻击路径未被覆盖,需要领域内校准的弃答门限与更强的语义变更检测。弱点五:验证与生成在 CPU 上直接争用(8 对/秒即损 23–31% 解码速度、p99 时延升 108–167%),验证时机与处理器分配缺乏系统方案,应实测 NPU 等专用加速器的确定性与共存代价。
未来方向
作者列出的方向:测量边缘加速器(NPU)的确定性以及与运行中 LLM 共存的验证代价;把码级验证扩展到 IVF 与基于图的索引及更大规模多语言语料;研究同时修改文本与向量的攻击者;从浮点误差模型推导守卫宽度而非纯测量;制定可跨系统共享的、签名的嵌入配置与码本规范表示。在此基础上可延伸:把边际定律做成运维工具,接入真实查询日志定期输出暴露曲线并告警;将规范化事件写入透明日志,形成不可抵赖的审计链;与整数化位可复现推理结合,实现跨设备精确等值验证;对'黄金向量也可旋转'的双旋转攻击者推导更紧的界并实测;把语料内精确重复文档的去重作为小容差下的免费加固;探索验证器参与码本生成或共同签署码本的协议设计,从根上消除码本的单点信任。
复现评估
复现条件良好。代码、数据、参考验证器与带 34 条偏差日志的预注册协议全部开源(GitHub: securagenai/signed-but-steerable;Zenodo 归档 v1.0.2,DOI 10.5281/zenodo.23948839)。数据集 SQuAD 2.0、BEIR、MS MARCO 公开;嵌入、重排、NLI、QA 模型均为开源权重且版本钉死(MiniLM 1110a243、BGE-M3 5617a9f6,M2 复现哈希一致);实现基于 llama.cpp、ONNX Runtime、sentence-transformers、FAISS。硬件需求:RTX 4090 桌面做规模实验,树莓派 5(16GB)做设备端,Apple M2 做第三平台;Qwen2.5-3B Q4_K_M 约 2GB 即可运行,Pi 实验也可在其他 Arm 板或普通 CPU 上近似复现。作者的可复现性检查严格:语料与早期发布字节一致、检索 top-5 一致、早期主配置 60/60 答案逐字复现,参考验证器有单元测试覆盖。难度中等:边际定律与 FAISS 部分单机 GPU 即可完成;Pi 端到端需开发板与耐心(重嵌 1,745 窗口 41.6–72.9 秒,LLM 解码 5.14 tokens/s,三个完整运行取均值并剔除 prompt 缓存命中)。
论文图表