多向量视觉文档索引的反演攻击 Inverting Multi-Vector Visual Document Indices
仅凭每页上千个patch向量构成的索引,攻击者可重建整页文档并98.4%命中来源页
前置知识
多向量视觉文档检索(ColPali与late interaction)
传统检索先OCR再建文本索引;ColPali把页面切成约32×32像素的patch,由VLM为每patch编码一个320维向量,一页约上千个。查询按late interaction打分 $S(q,d)=\sum_i \max_j q_i^\top d_j$:取最相似patch内积求和,检索在视觉层面完成,无需OCR。
论文攻击的对象正是这种每页上千个patch向量组成的索引;理解'每个向量对应一个固定空间位置、按光栅顺序存储'是理解'索引会泄露版面与文字'的前提。
流匹配(flow matching)与修正流(rectified flow)
生成建模方法:学习速度场 $v_\theta(x_t,t)$ 把噪声 $x_1$ 沿直线路径搬到数据 $x_0$,目标 $\mathcal{L}=\mathbb{E}\|v_\theta-(x_0-x_1)\|^2$;采样用欧拉法迭代数十步。比扩散模型路径更直、步数更少,Qwen-Image等文生图模型的基础。
论文的反演器就是一个以存储索引为条件的流匹配模型,'生成而非回归'的设计(避免条件均值把模糊字形糊掉)是攻击能画出锐利文字的关键。
MMDiT(多模态扩散Transformer)
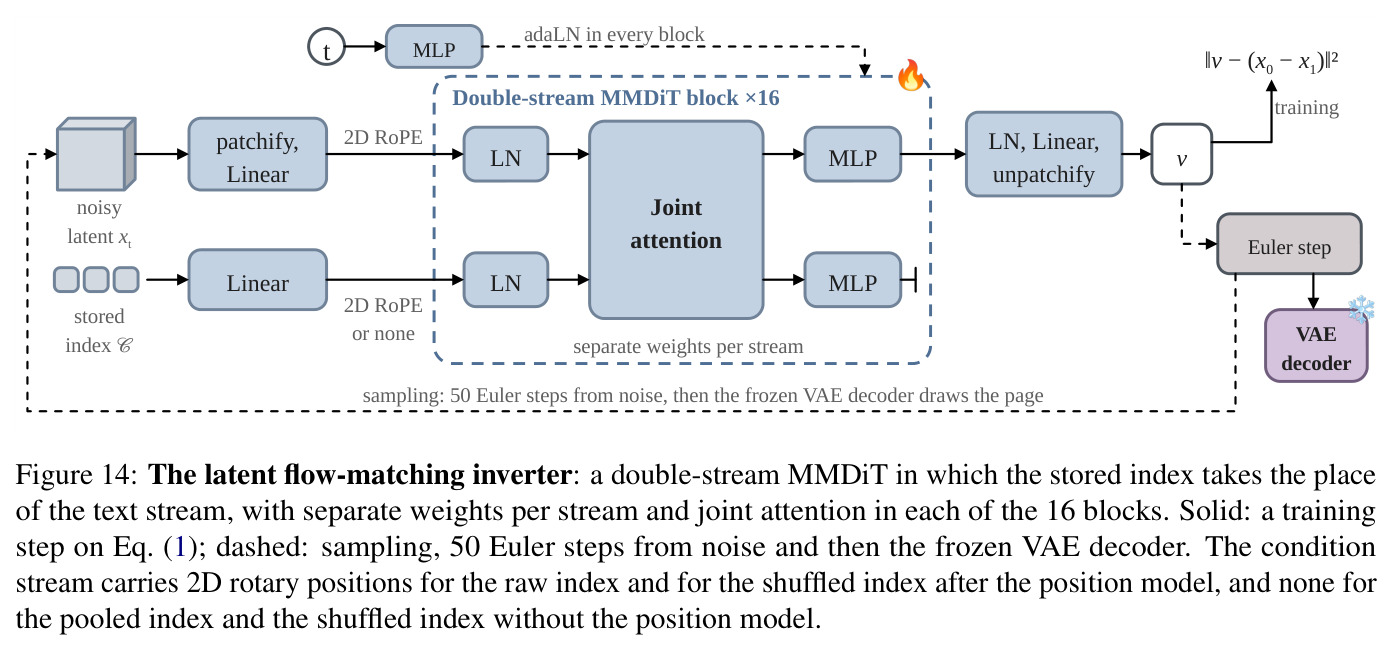
MMDiT是多模态文生图模型(如Stable Diffusion 3、Qwen-Image)的骨干:文本token与图像潜token各持一套参数(双流),每块内拼接做联合自注意力,位置由2D旋转位置编码注入,时间步经自适应层归一化注入。论文用它做反演器骨干。
作者直接把Qwen-Image的MMDiT改造成反演器——用存储索引替换文本流;理解这个架构才能看懂Figure 2/14,以及'一套权重服务任意页面形状'的设计。
VAE潜空间图像生成
现代文生图模型不在像素空间生成,而是先用冻结的变分自编码器(VAE)把图像压缩到1/8分辨率的潜张量(如16通道),在潜空间做扩散或流匹配,最后用VAE解码器还原像素。潜空间生成大幅降低计算量,同时VAE的重构质量决定了生成清晰度的上限。
论文中的页面在Qwen-Image冻结VAE的潜空间里生成,而'VAE重构'(源页过一遍VAE)恰好也是Table 1中攻击效果的理论上限参照。
Classifier-free guidance(CFG)
提升条件生成保真度的采样技巧:训练时以一定概率(本文10%)把条件替换为可学习的空token;采样时把无条件速度场 $v_u$ 与条件速度场 $v_c$ 按 $v_u+\gamma(v_c-v_u)$ 组合,$\gamma>1$ 时样本被推向更符合条件的方向,$\gamma=1$ 退化为纯条件场。
反演采样固定用 $\gamma=4$,消融显示guidance单独贡献了约一半的word recall;不看懂CFG就无法理解结果数字从哪来。
层次化token池化(token pooling)
多向量索引的省存储手段:把相邻patch向量按层次合并(近似取聚类质心),每页向量数从 $N$ 降到约 $N/f$(因子 $f=3$ 或 9),检索质量损失很小——本文测得nDCG@10仅降0.8%(×3)和2.2%(×9)——因为每个质心仍是多个patch信息的平均,查询仍能在粗糙粒度上匹配页面。
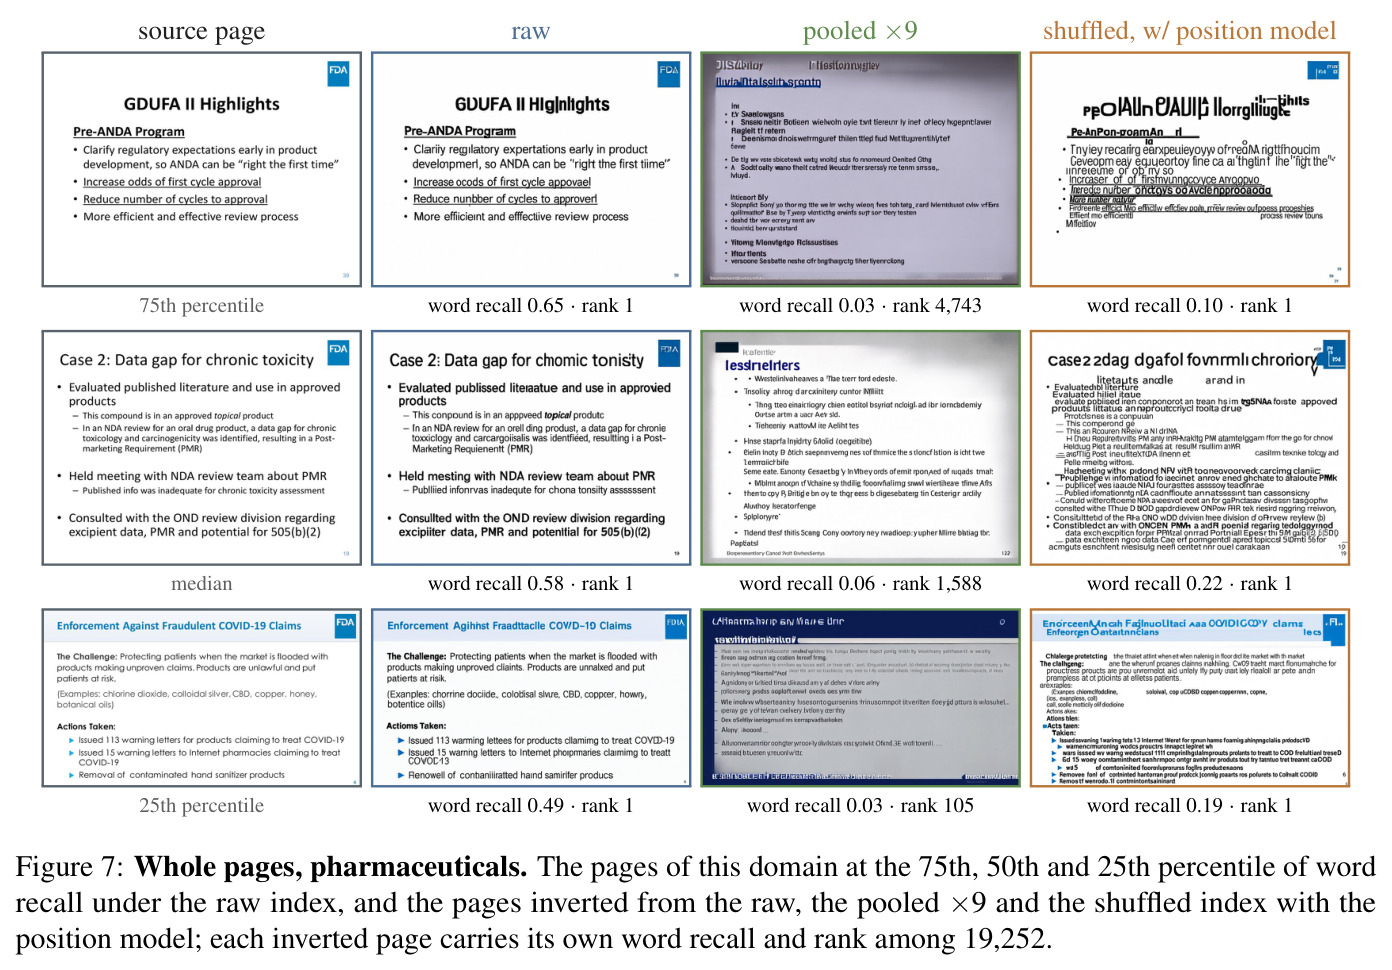
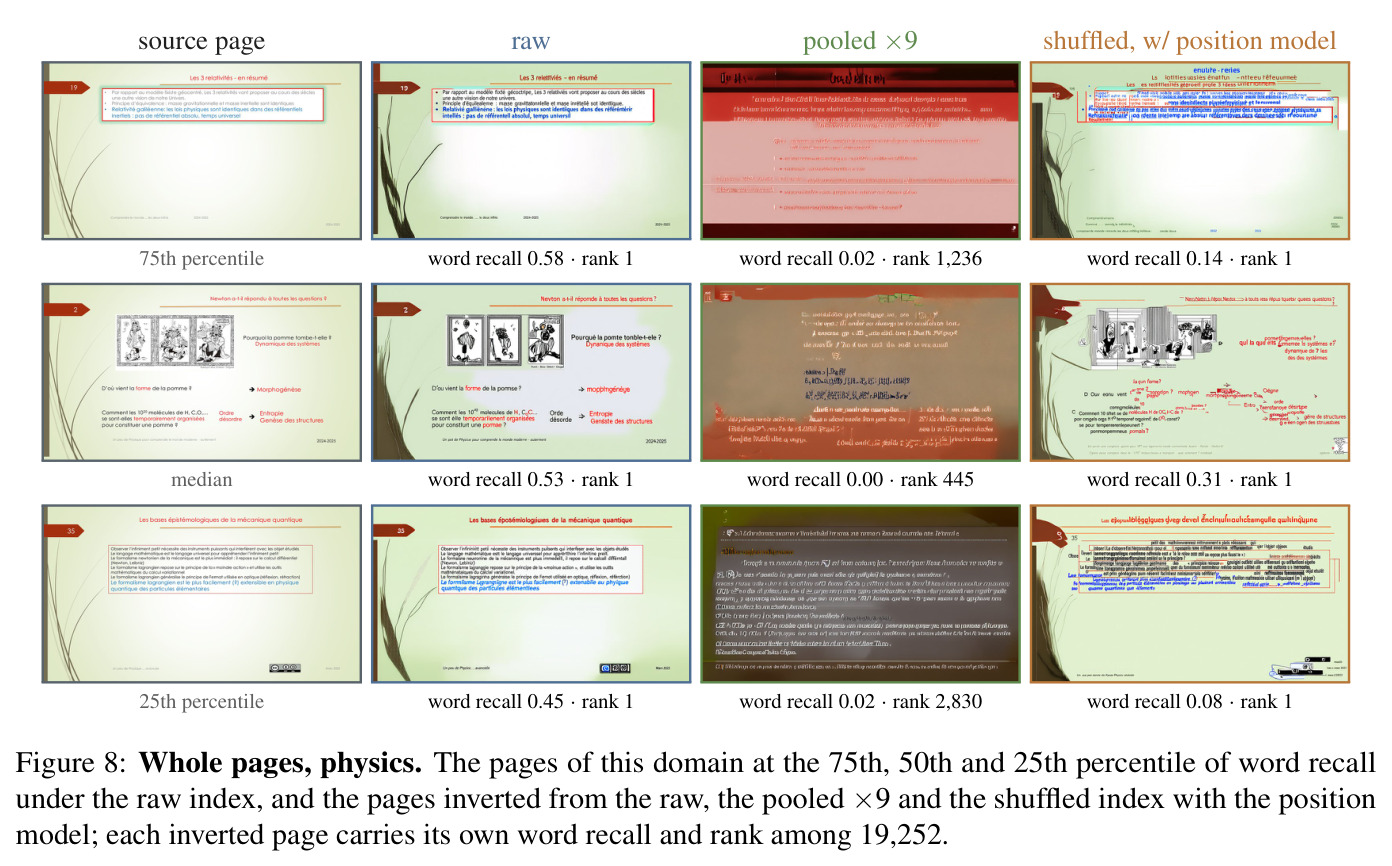
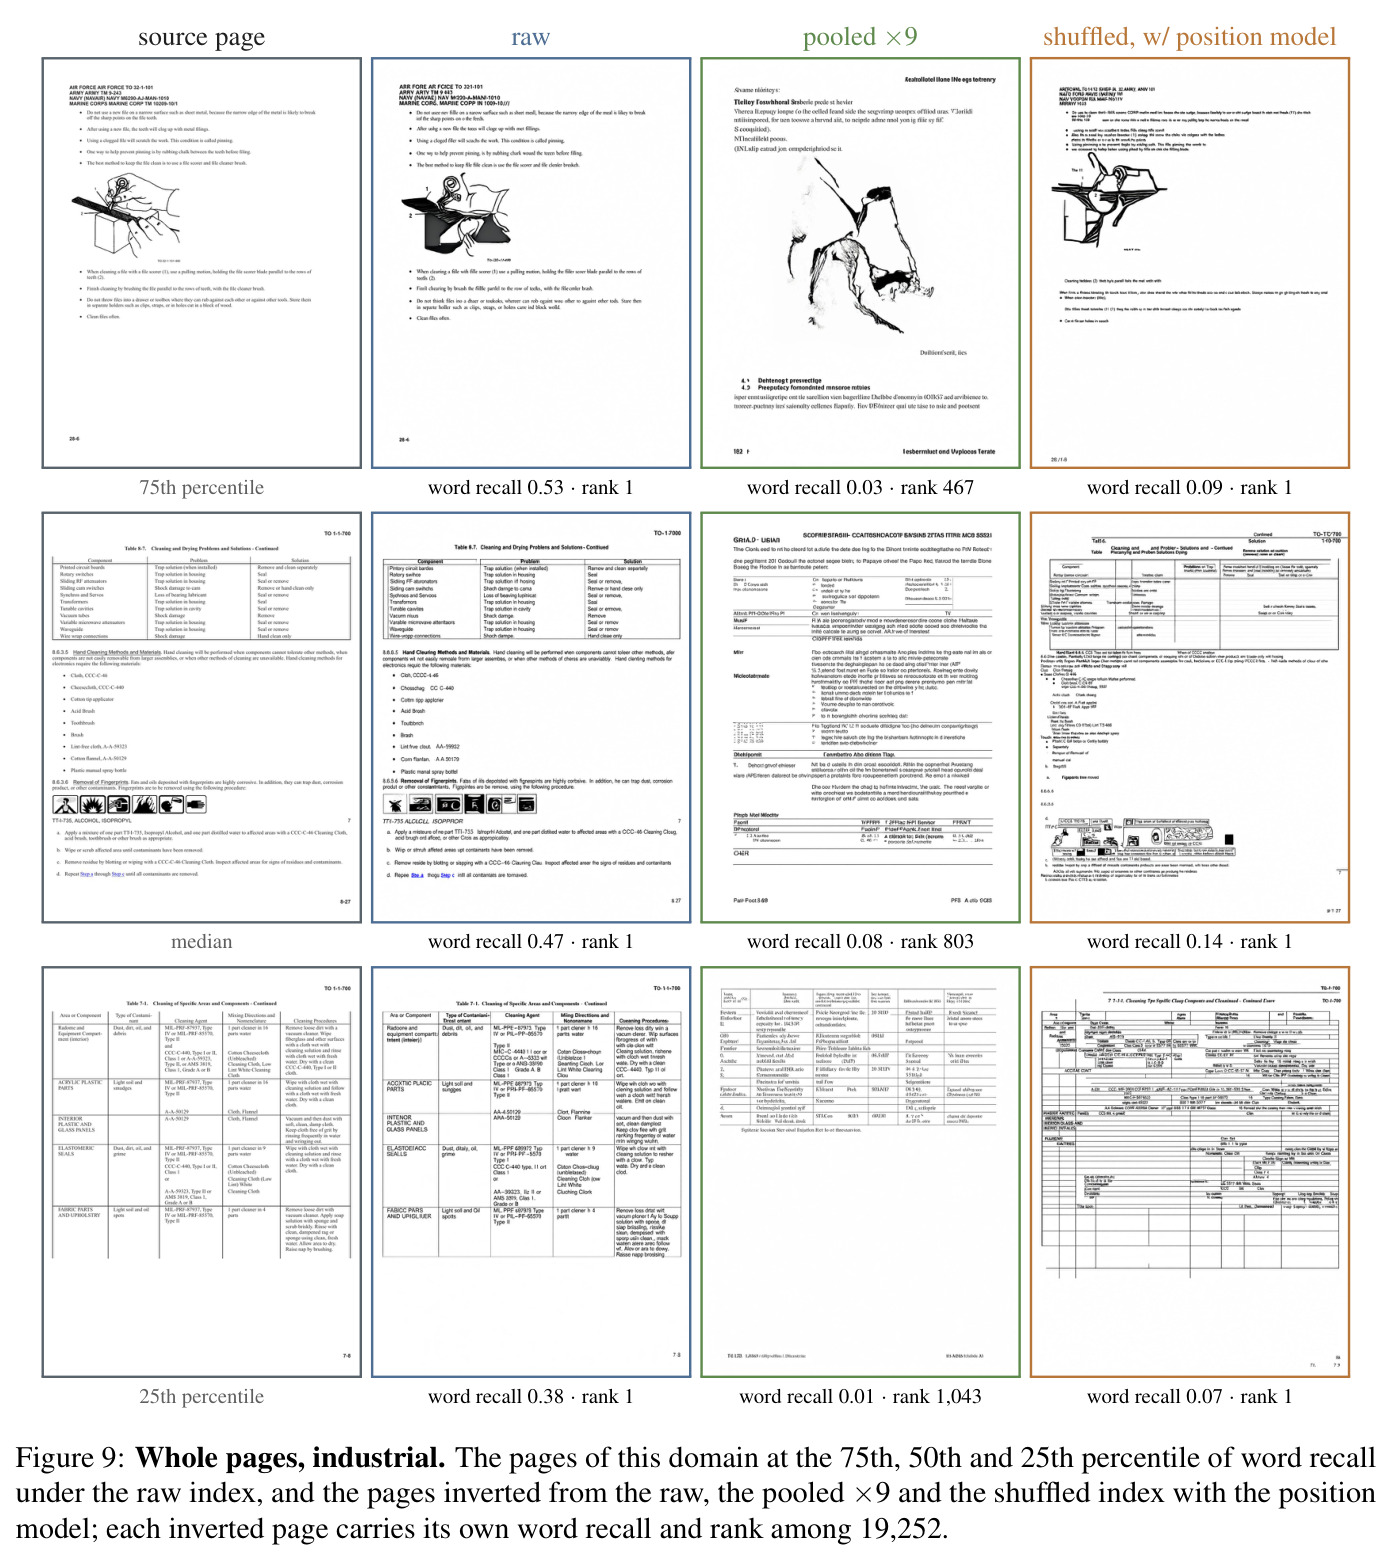
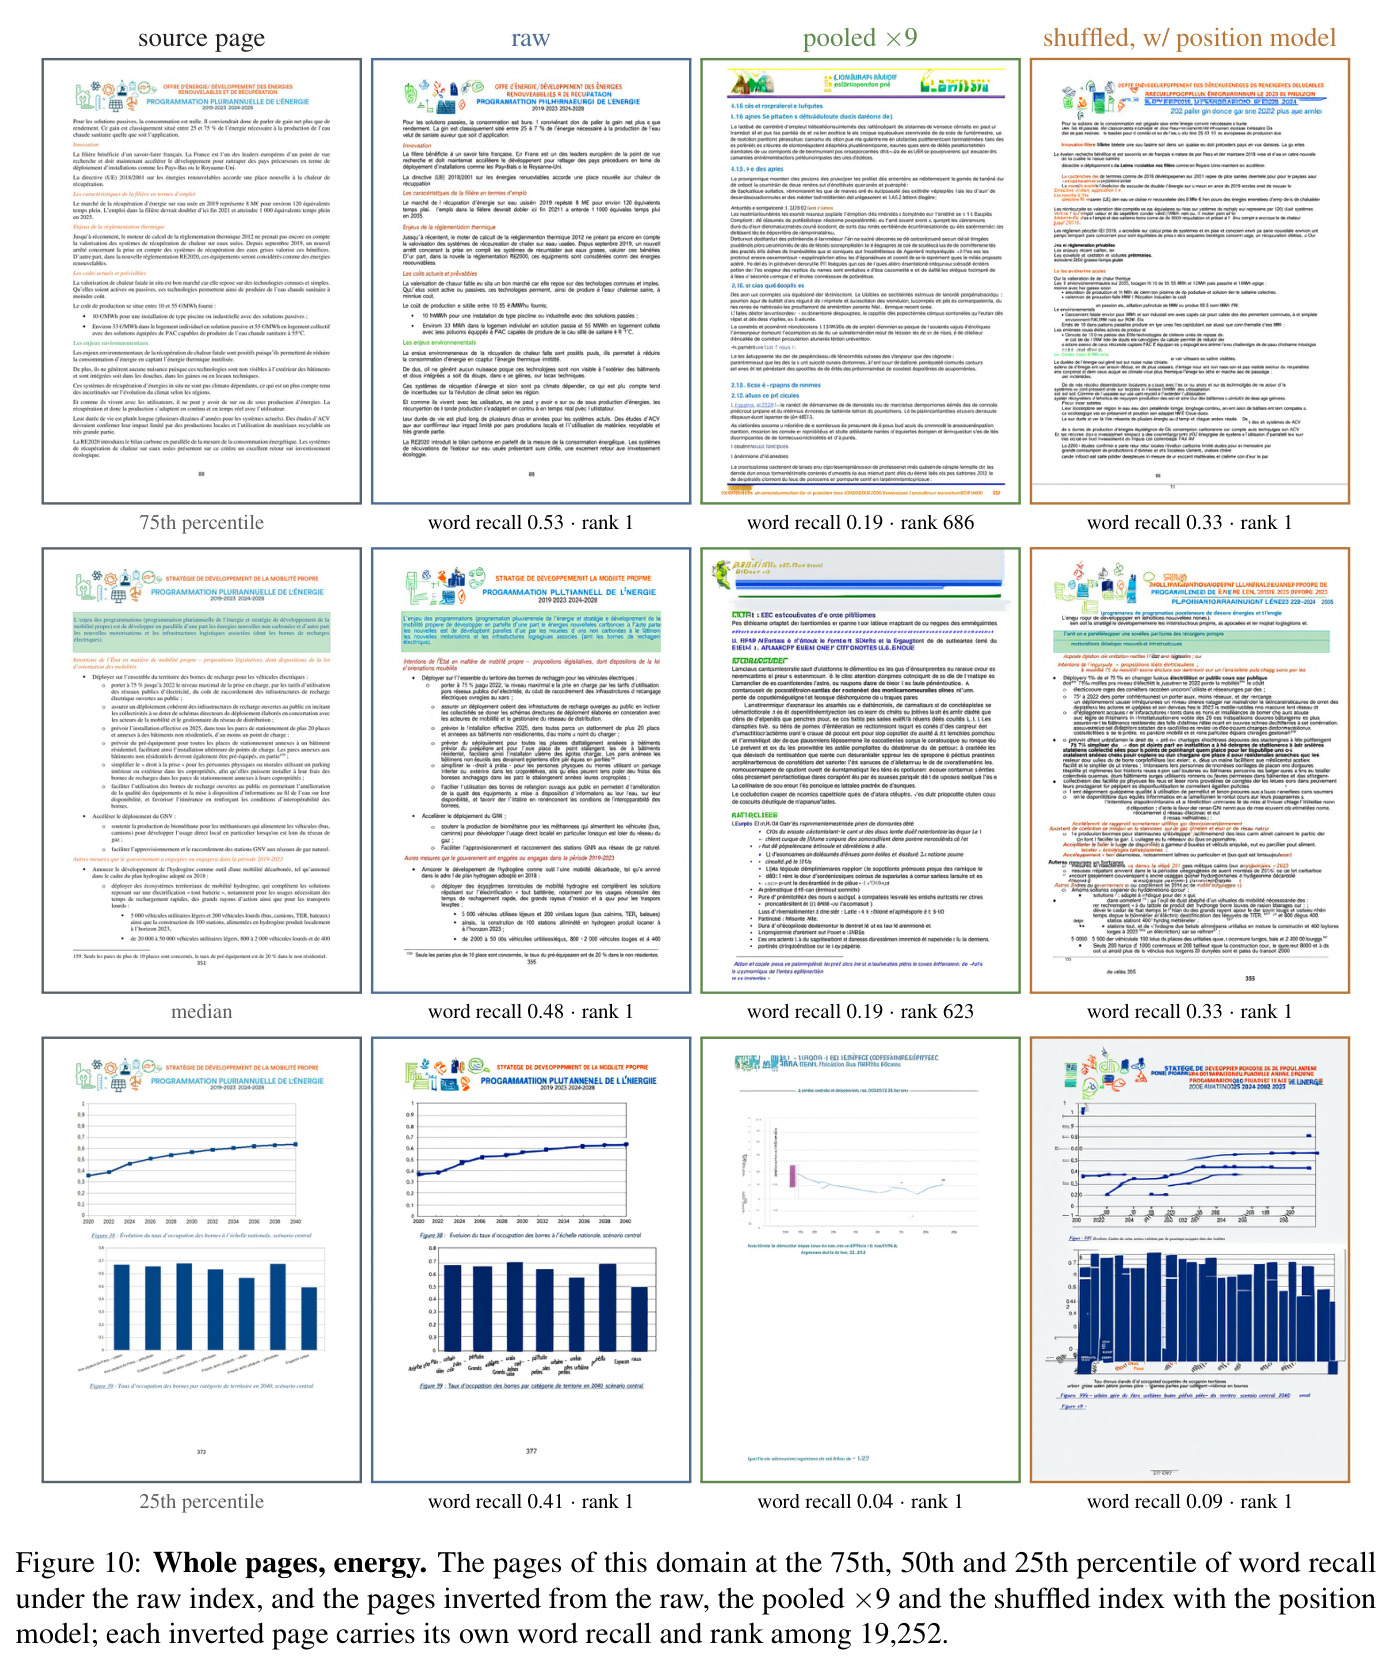
池化是论文评估的两种'保护'之一;理解'质心不再对应单一patch、也没有存储顺序'才能理解为什么它目前能抵抗反演攻击。
置换等变网络与匈牙利算法
不带位置编码的Transformer对输入集合是置换等变的:打乱输入顺序,输出做同样的打乱,天然适合处理'无序集合'(如Deep Sets思想)。匈牙利算法则在给定 $N\times N$ 代价矩阵时求一一指派的最优排列,使总代价最小,常用于分配问题。
位置模型正是用置换等变Transformer从乱序向量集合预测每个向量的行列坐标,再用匈牙利算法把它们一一放回页面网格——这是论文打破'乱序防御'的核心工具。
研究动机
视觉文档检索器(ColPali及其后续)是当前文档检索的最强方案:它们把每页文档图像切成约32×32像素的patch,由视觉语言模型为每个patch编码一个320维向量,一页产生约一千个向量——论文攻击的Tomoro-ColQwen3-8B平均每页1,241个向量。这些索引通常存放在向量数据库或专用检索引擎(如PLAID)中,且常常由第三方托管。由于没有人能直接从一串向量'读出'页面,运维者很自然地把索引当成比文档本体低一级的敏感数据:页面图片放进访问受控的存储,索引却交给外部向量库、进入快照与备份。文本embedding领域已经证明这种直觉靠不住——Song和Raghunathan (2020)能从句子embedding恢复50–70%的词,Morris等(2023a)对32 token输入能92%精确还原——但视觉文档索引是否同样可逆,此前无人检验。而这些页面恰恰是企业财报、药品审批文件、人力资源记录等敏感文档,一旦索引随第三方存储或备份泄露,后果完全未知。
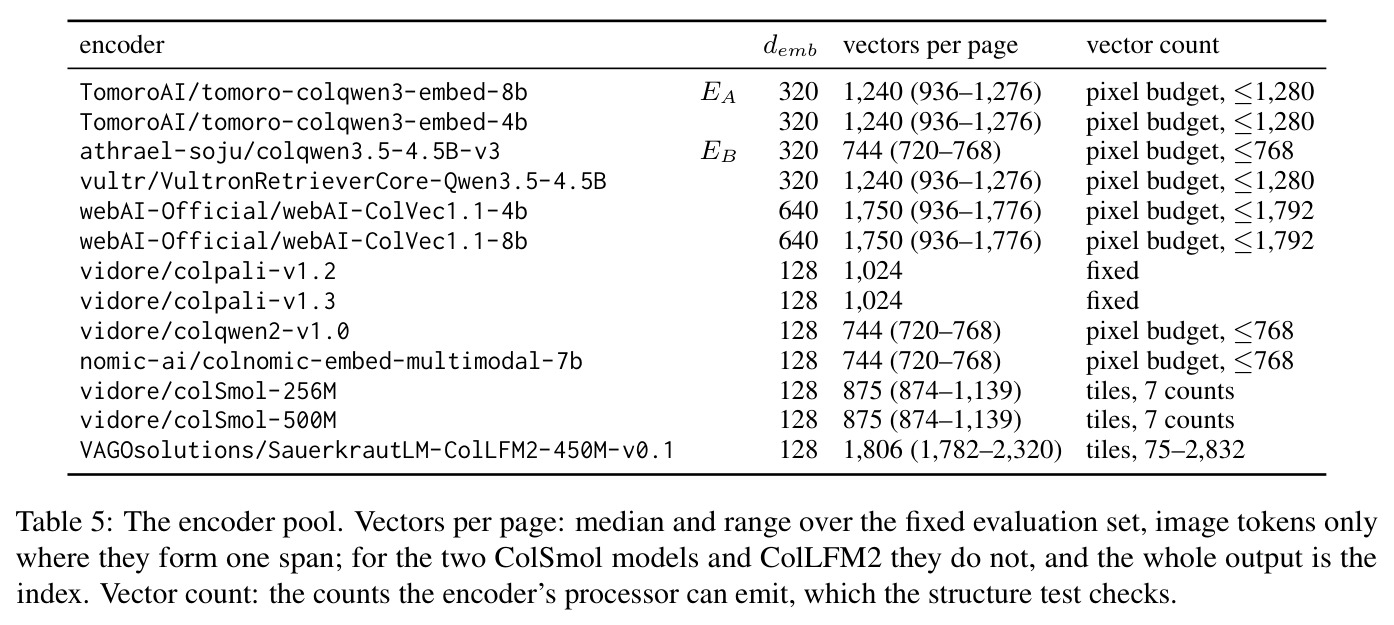
本文的目标是论文要检验一个具体假设:仅凭存储的多向量索引,在零侧信息条件下,攻击者能否重建出文字清晰、版面正确的原始页面。这个总目标被拆成三个攻击者必须解决、而存储方通常以为'藏在'索引里的子问题:第一,索引出自哪个编码器——攻击者只知道公开的候选池,不知道部署方用的是哪一个;第二,页面形状(网格行列数)——向量本身不带宽高信息;第三,当向量被随机乱序存储时,每个向量的原始位置。在回答这些问题的同时,论文还要定量评估两种现实中已有人使用的廉价'保护'——层次化token池化(把向量数压到1/3或1/9)和按随机置换乱序存储——到底能不能阻止反演;并给出内容泄漏(word recall与sensitive-token recall)和身份泄漏(重识别top-1)两条线的可复现测量,让从业者能在部署前判断哪种存储方式是安全的。
与已有工作不同的是,论文的独特切入有四点。其一,它是首个针对视觉late-interaction索引的反演研究:已有embedding反演都针对短文本或自然图像特征,而文档页面是'清晰文字按二维版面排布'的产物,普通文生图模型没有版面规划与OCR监督时渲染不好,需要专门设计。其二,零侧信息威胁模型:不假设知道编码器、页面形状或向量顺序,把这三者全部变成要从索引自身推断的对象,并给出可行的推断方法——这比'假设知道一切'的概念验证强得多,是更现实的威胁论证。其三,把反演建成条件文档图像生成而非回归:回归解码器的L2最优解是条件均值 $\mathbb{E}[I\mid C]$,会把任何字形歧义糊掉;流匹配学条件分布再迭代采样,才能画出锐利的字。其四,把防御与攻击放进同一框架量化:池化与乱序不是假想敌,而是多向量检索社区正在使用的真实降本手段(Faysse等2025年已把池化列入ColPali实践),论文第一次给出了'哪种防御有效'的直接证据。
核心方法
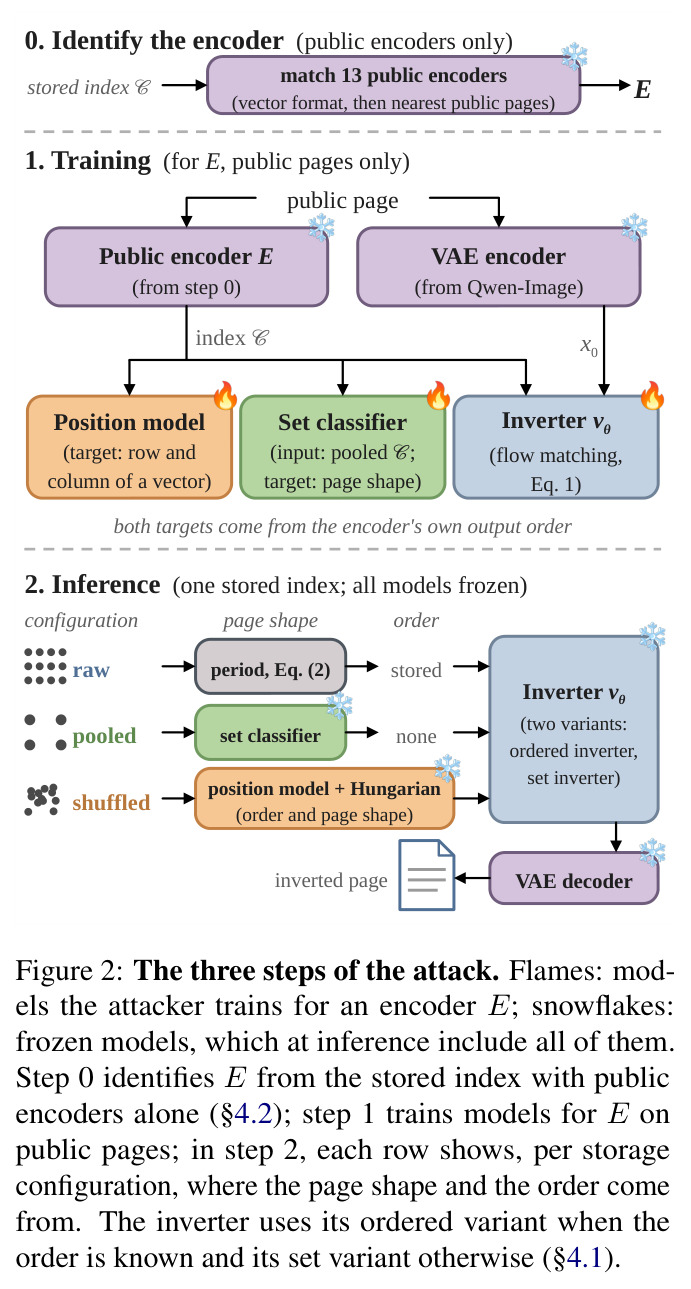
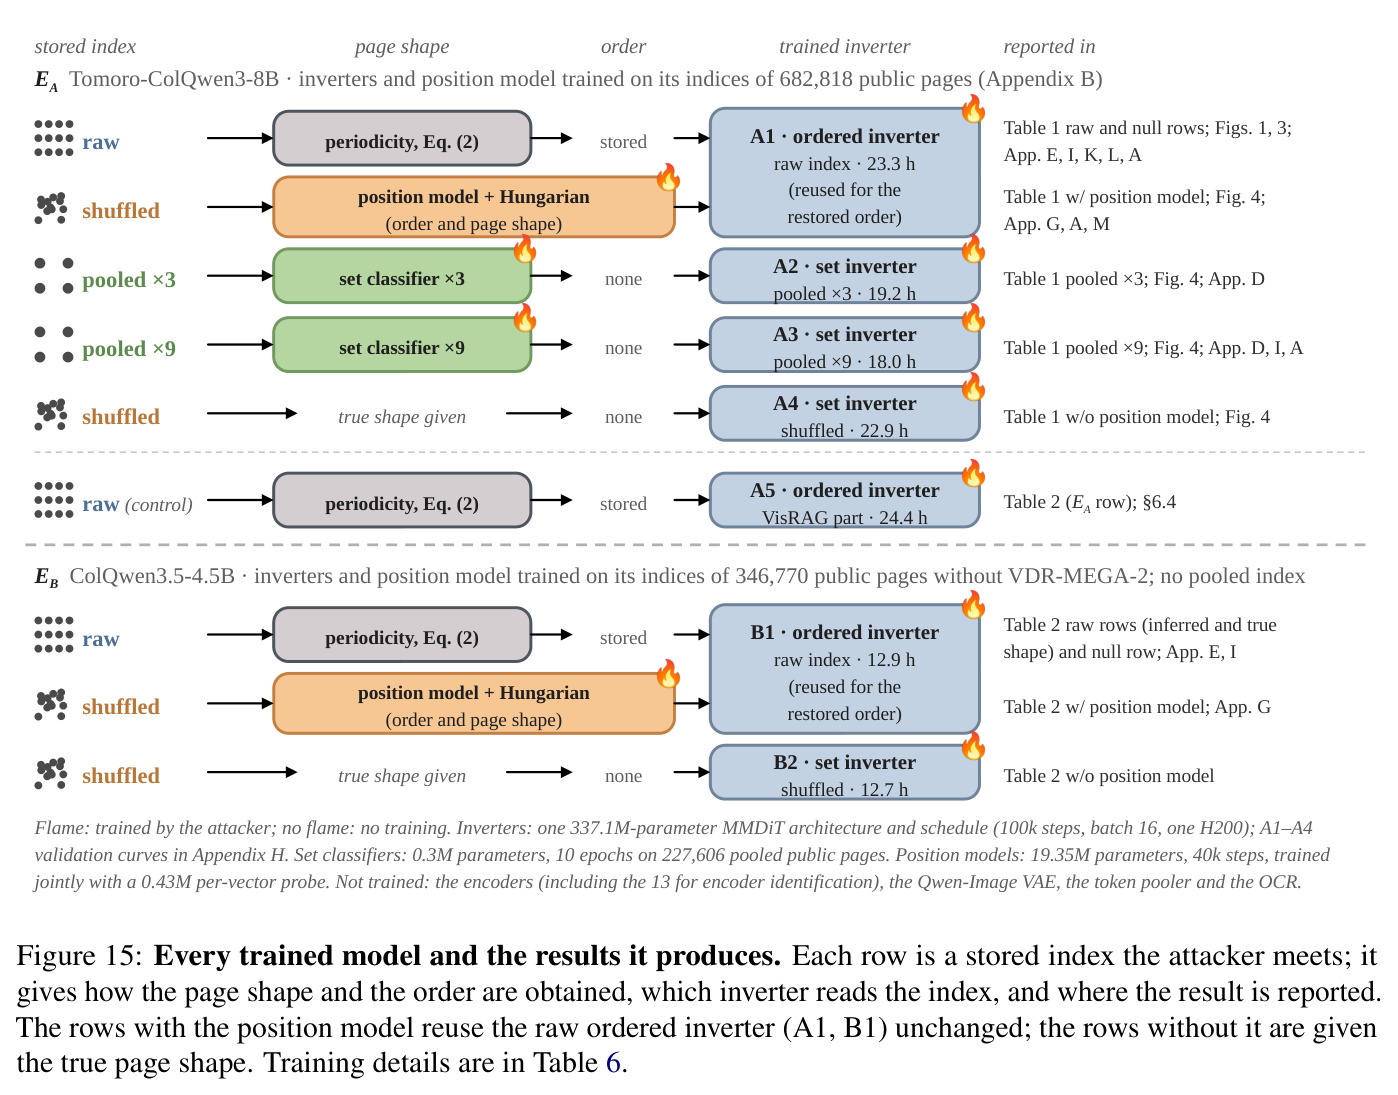
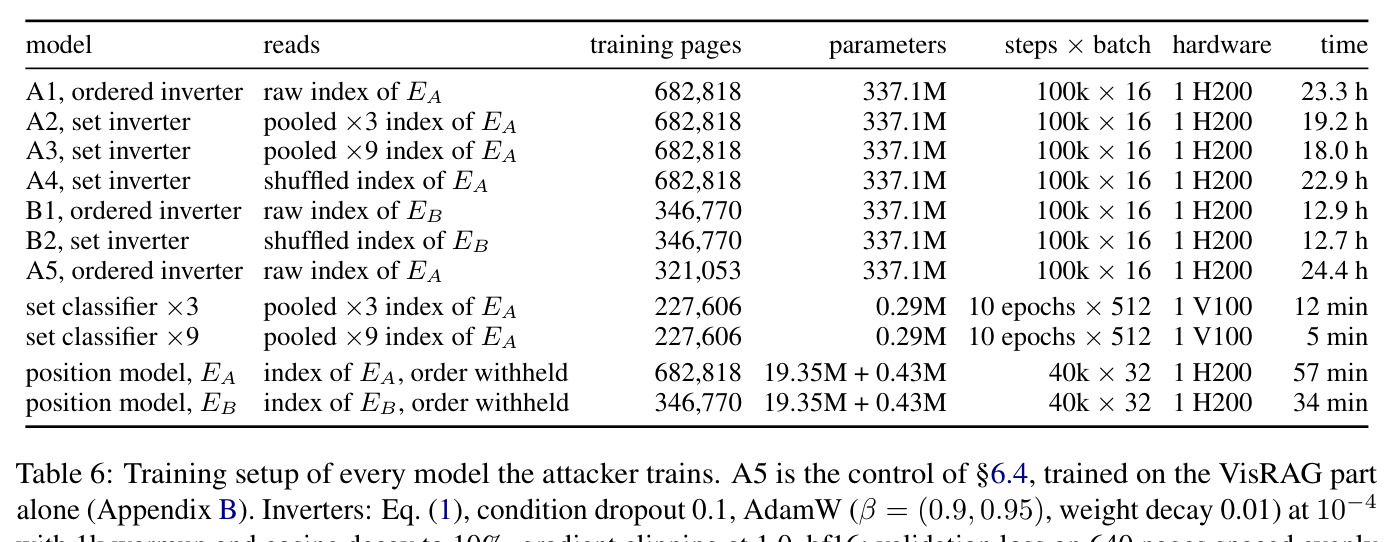
直觉上,索引泄漏有三个来源:每个patch恰好对应一个向量,且向量按行优先的光栅顺序存储,所以每个向量在页面上的位置是已知的;每个向量由在整个页面上下文中看过自己patch的VLM算出,既携带局部内容又携带全局版面信息;这些VLM在数千万OCR样本和数百万保留版面的PDF上预训练过,其向量'会读文档'。技术上,攻击分三步。第0步,编码器识别:用13个公共编码器先做结构测试(输出维度、单位范数、每页向量数是否兼容),平均留下2.77个候选,再用查询探针或参考云相似度锁定唯一编码器。第1步,在682,818页公开文档上训练三类模型:条件流匹配反演器(337.1M参数的双流MMDiT,以存储索引替换Qwen-Image的文本流)、页面形状推断器(raw索引用周期性检测,池化索引用0.29M参数的set分类器)、位置模型(19.35M参数的置换等变Transformer,预测每个向量的行列坐标)。第2步,推理:对每个存储索引先推断页面形状,乱序索引先恢复顺序,再由反演器从高斯噪声出发、以索引为条件跑50步Euler采样($\gamma=4$),最后经冻结VAE解码成页面图像。
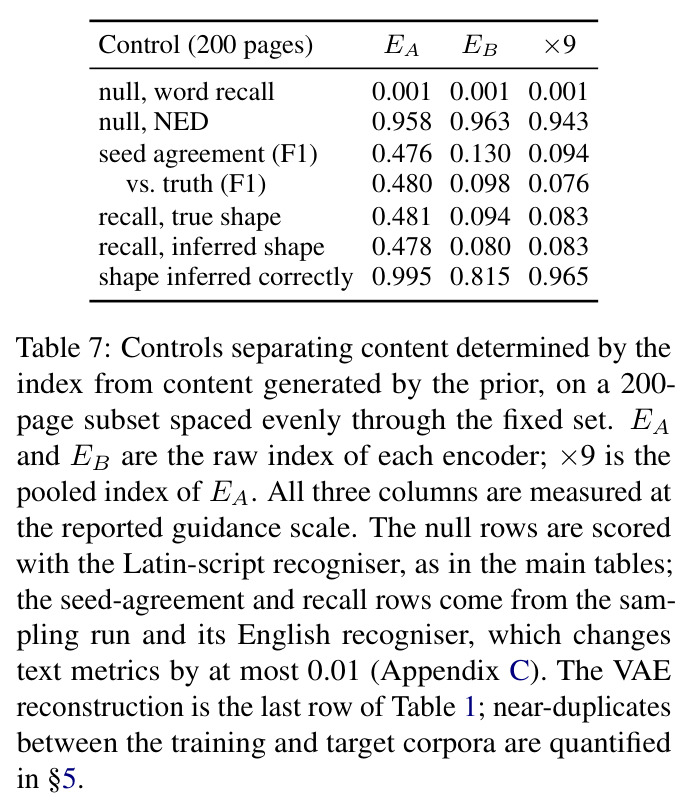
核心创新是把'存储索引'当作文档图像生成模型的文本条件,并让整个攻击在零侧信息下自举。与文本embedding反演靠语言模型把向量解码回词不同,这里借用文生图模型的生成先验直接'画'出页面,但换了三处关键设计:条件流从prompt换成存储的patch向量;位置只通过2D旋转位置编码注入,使一套权重服务任意页面形状;最重要的损失选择——不用回归。回归的最优解是条件均值 $\mathbb{E}[I\mid C]$,字形上有歧义处会取均值而模糊;流匹配损失 $\mathcal{L}=\mathbb{E}\|v_\theta(x_t,t,C)-(x_0-x_1)\|^2$ 虽也是平方误差,其条件期望只对给定 $x_t$ 后剩余的歧义取平均,迭代采样因此能生成锐利文字。配套两个反直觉决定:一是不加感知或对抗损失,因为每个额外目标自带先验,可能'写出'索引里没有的文字;二是保留10%条件dropout以支持classifier-free guidance,把样本推向条件方向。这些选择共同保证反演页上的字来自索引而非模型想象——两种子采样的相互一致度0.476,与各自和源页的一致度0.480相当。
方法步骤详情
第0步,编码器识别:结构测试按维度、单位范数、向量数过滤13个公共编码器,再用查询探针或参考云——候选编码器用其公共参考集与存储索引算相似度——锁定答案。第1步,训练:在公共页面及其索引上训练反演器、位置模型和set分类器,标签免费——编码器自身的输出顺序就是每个向量的真实行列。第2步,推理。raw索引:形状由周期性检测恢复,设 $s(w)$ 为滞后 $w$ 的平均余弦相似度,取 $\hat{n}_w=\arg\max s(W)$、$\hat{n}_h=N/\hat{n}_w$,正确率99.2%;池化索引改用Deep Sets分类器在向量数兼容的形状中选择;乱序索引用位置模型(无位置编码的Transformer)预测每个向量的行列,匈牙利算法一一指派到 $n_h\times n_w$ 个槽位,平均误差1.8行/4.5列。最后反演器从高斯噪声出发,按 $x_t=t\,x_0+(1-t)\,x_1$ 跑50步Euler采样,速度场 $v_u+\gamma(v_c-v_u)$,$\gamma=4$,经冻结VAE解码;顺序已知用有序反演器,否则用无位置编码的集合反演器。
技术新颖性
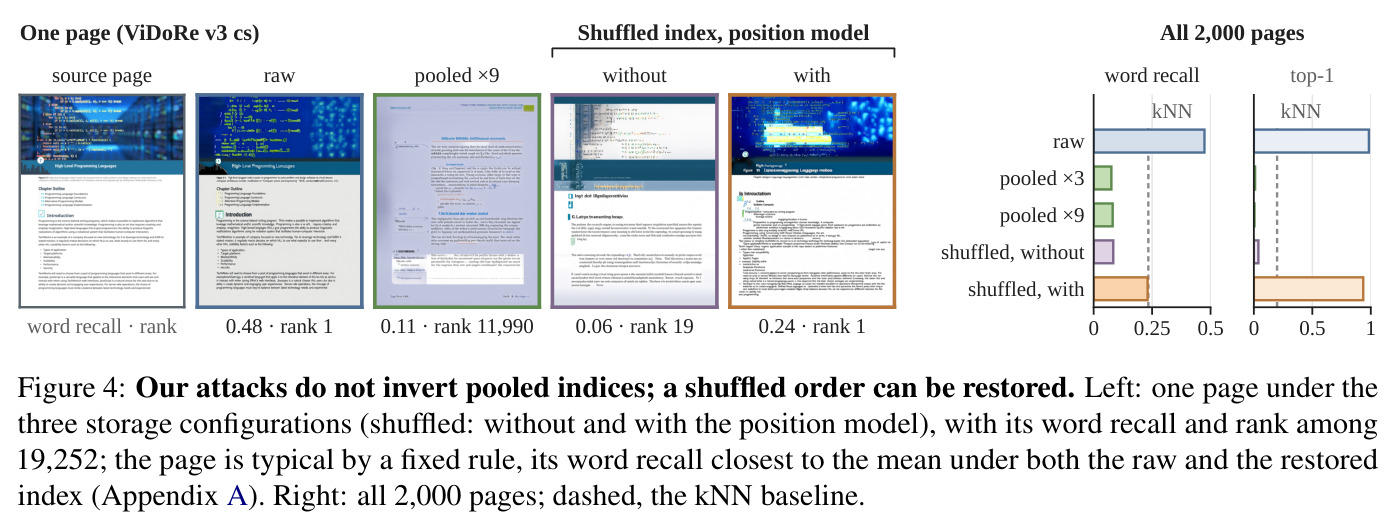
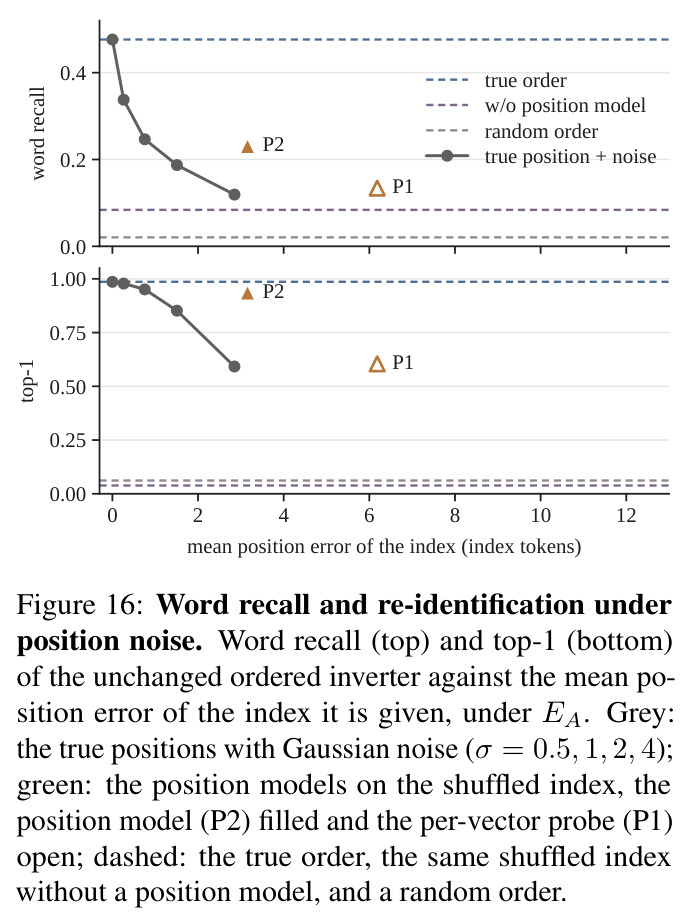
技术新颖性有五层。第一,问题本身是新的:多向量视觉索引的可逆性此前无人研究,论文把embedding反演风险从一维文本扩展到二维文档页面,并证明'索引不如页面敏感'的运维直觉不成立。第二,零侧信息框架:编码器识别(26,000次单页决策零错误)、形状恢复(raw 99.2%、乱序99.95%)、顺序恢复三个推断子问题全部只用公共资源从索引自身解决,使攻击的现实假设极弱。第三,生成式反演设计:以Qwen-Image的双流MMDiT为骨干、用索引替换文本流、坚持纯流匹配损失、拒绝感知/对抗辅助损失,这组设计让反演页的字形锐利且确实来自索引。第四,位置模型作为'反防御':它证明乱序不是保护——每个向量在全页上下文中算出,仍携带自己patch的位置信息,一个19.35M参数、57分钟训完的模型即可把重识别从3.8%拉回93.5%;进一步的噪声实验还揭示内容恢复比身份恢复对位置精度敏感得多。第五,把真实部署的两种降本手段(池化、乱序)放进同一攻击框架定量比较,并如实报告负结果(本文攻击无法反演池化索引),给出可直接执行的存储安全结论,同时明确声明这只是方法失败而非安全证明。
实验结果
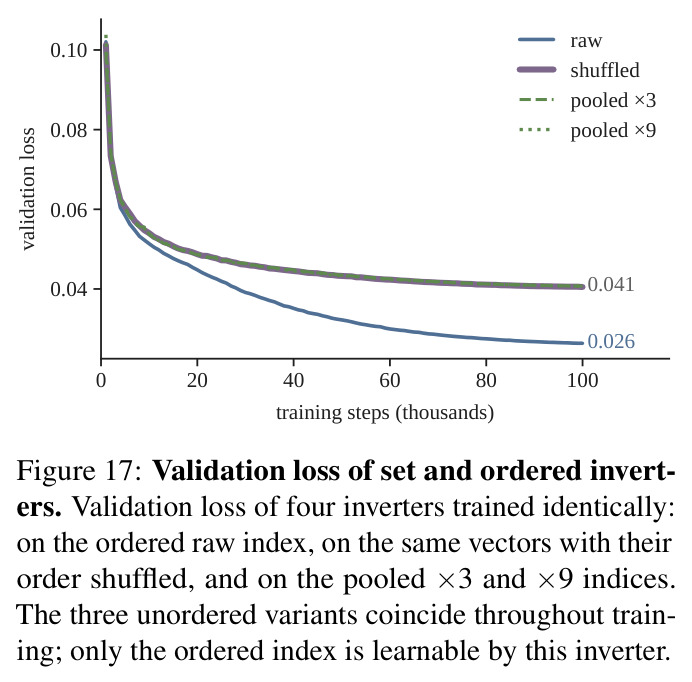
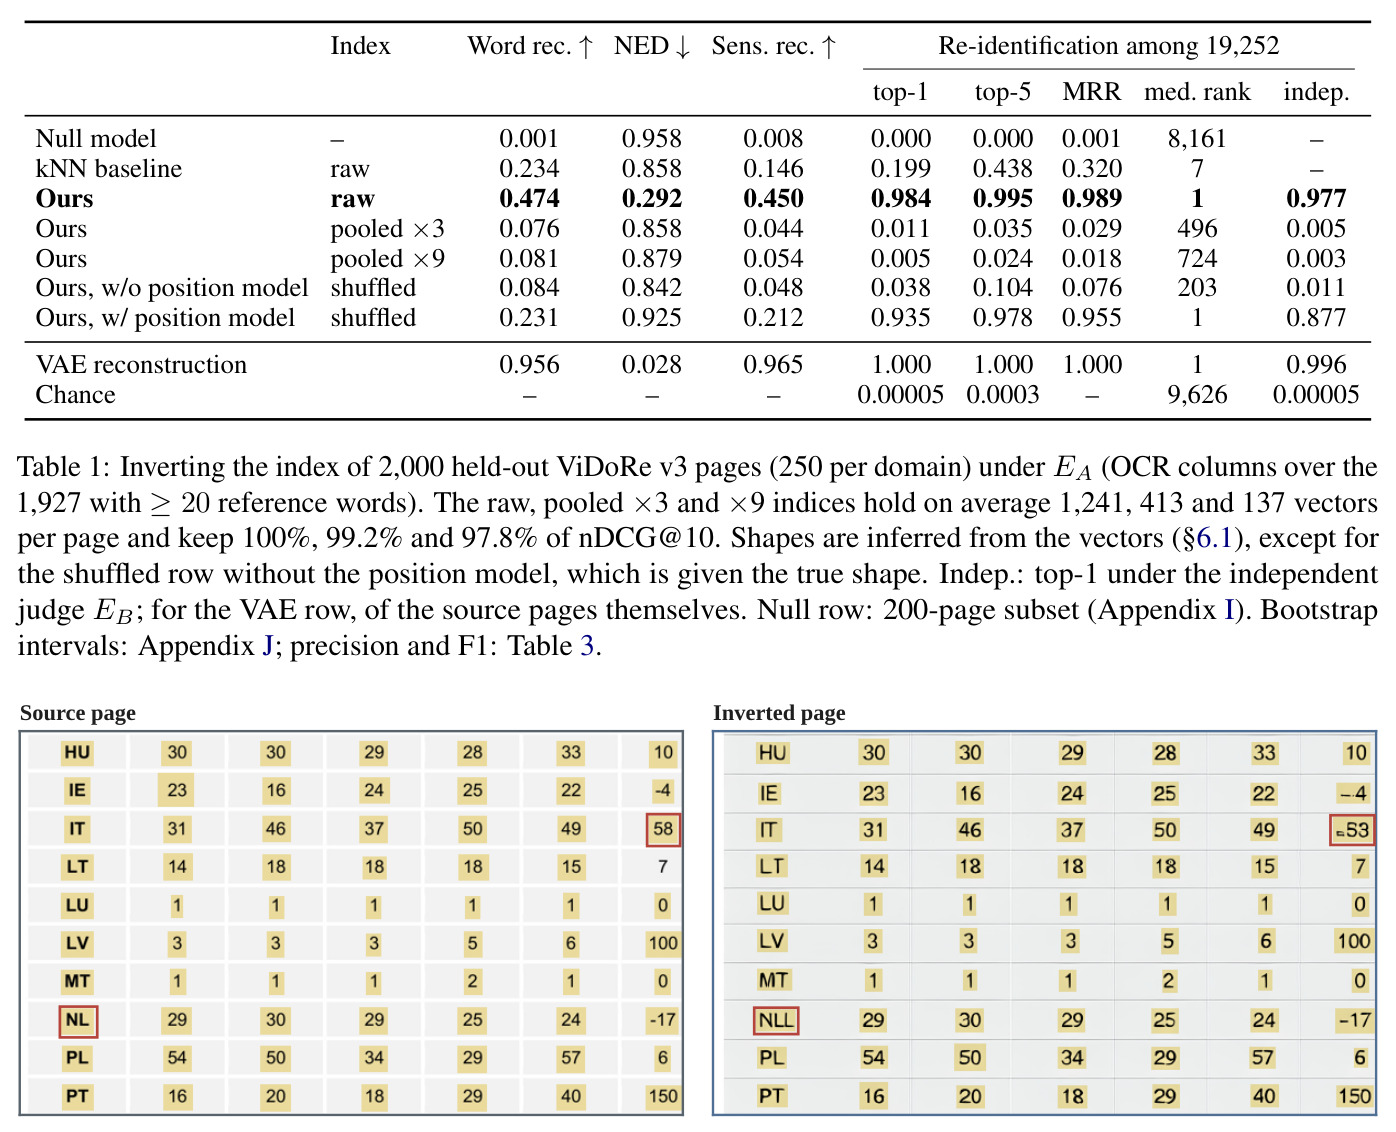
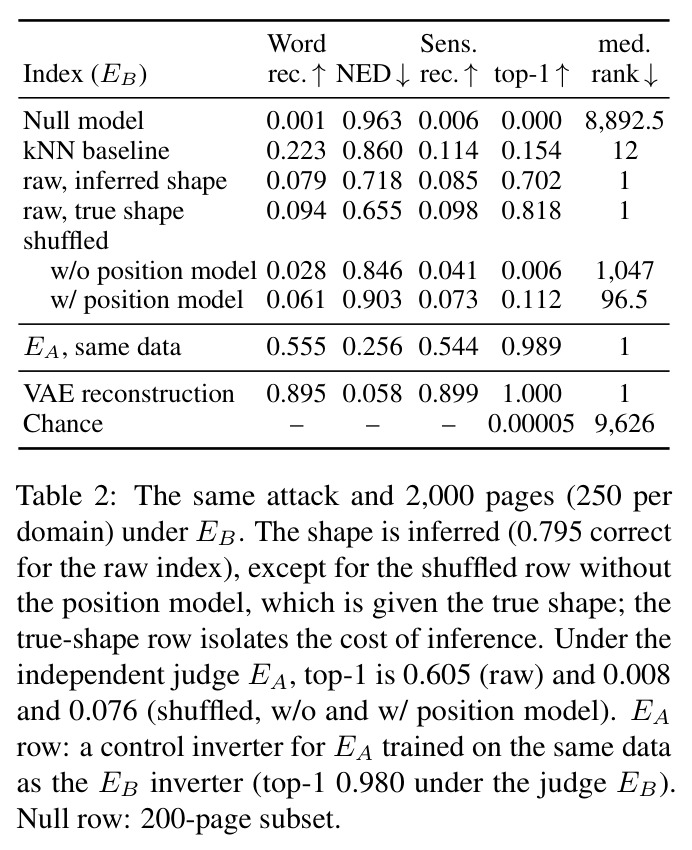
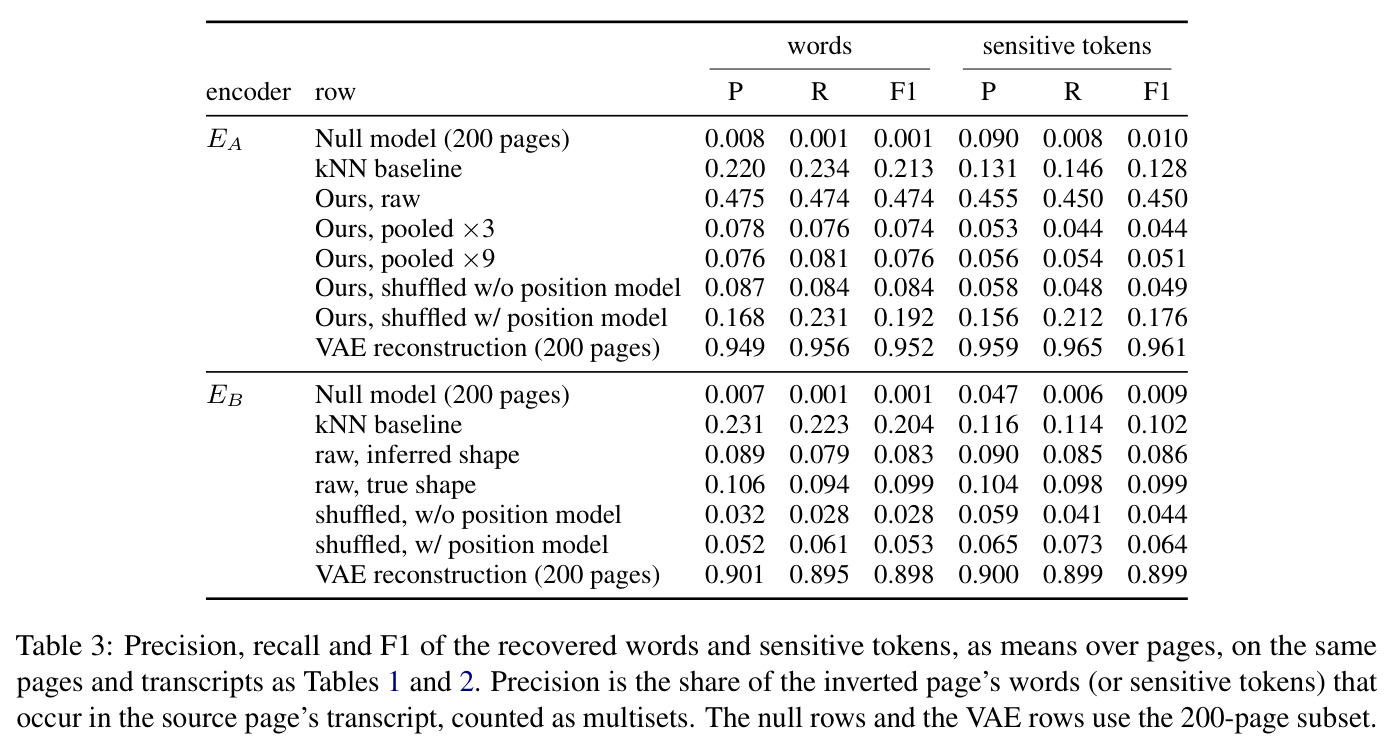
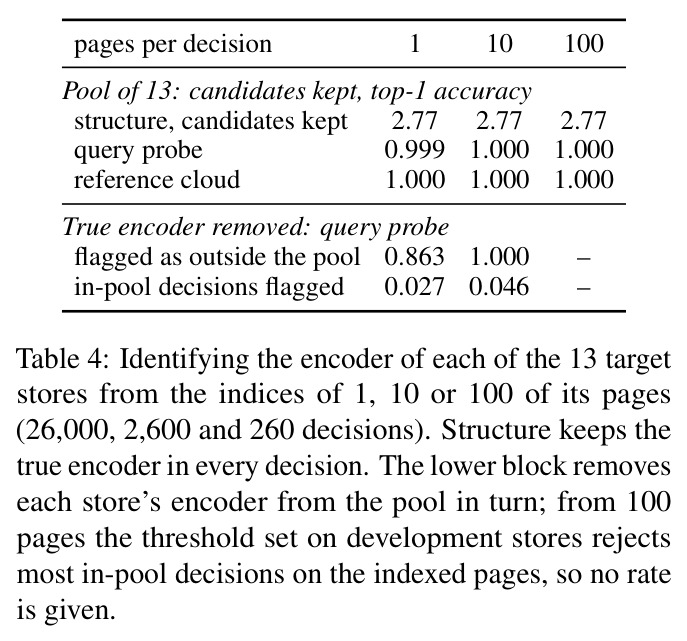
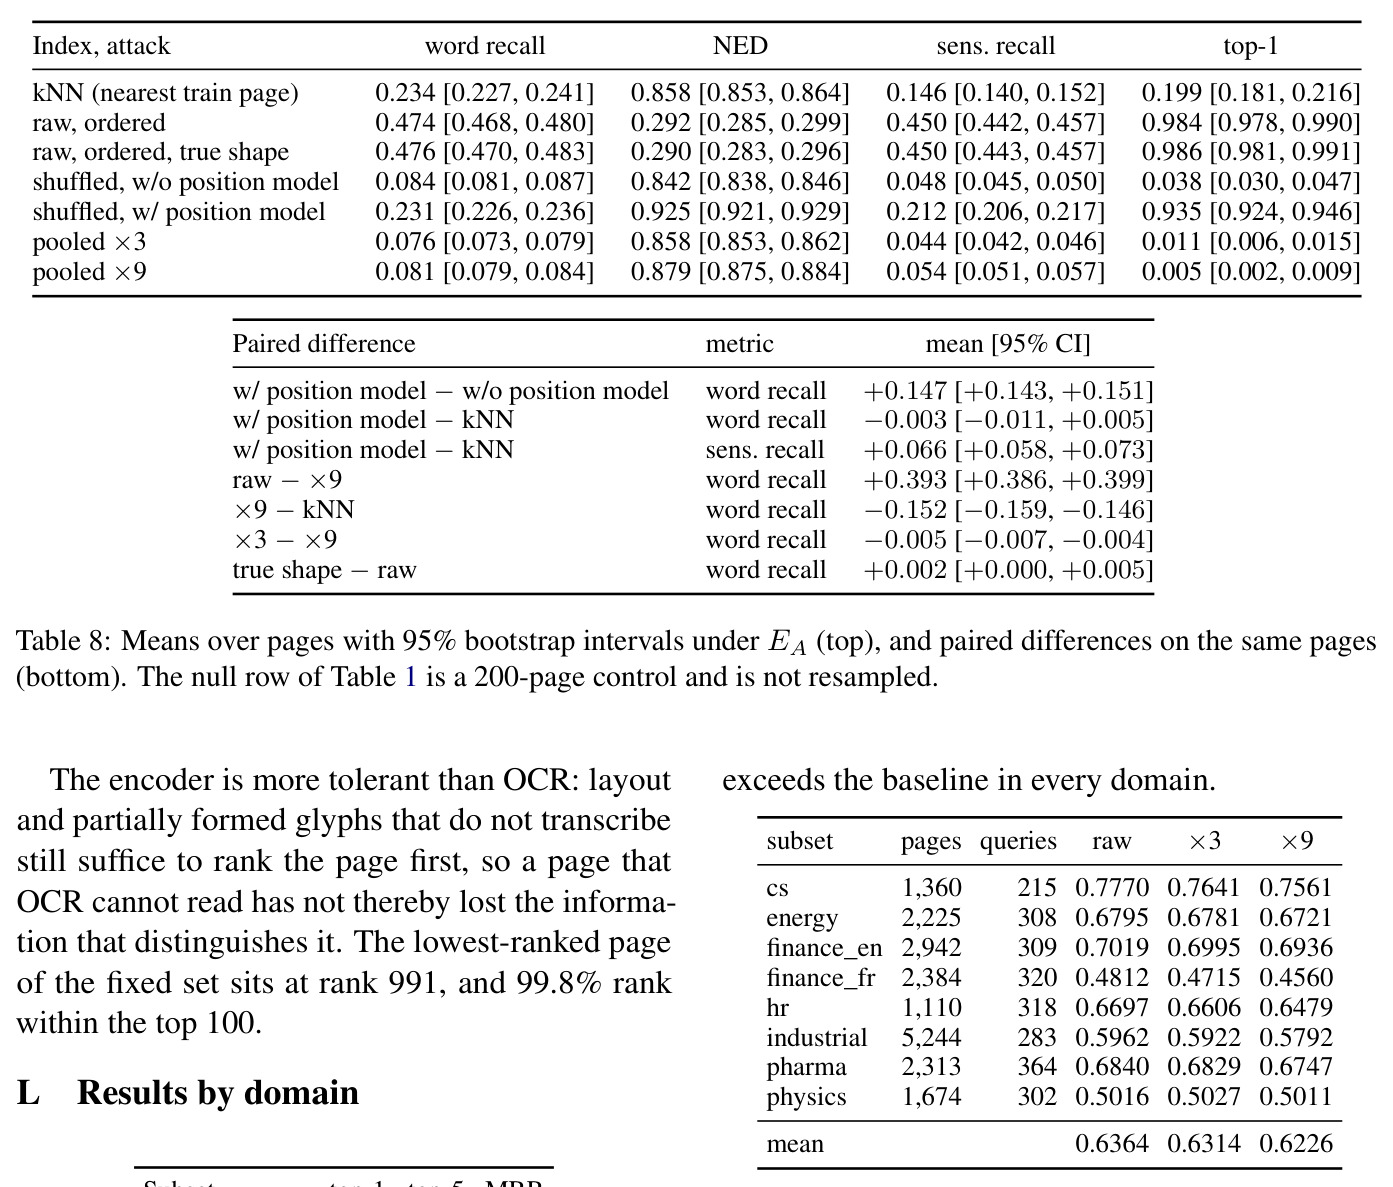
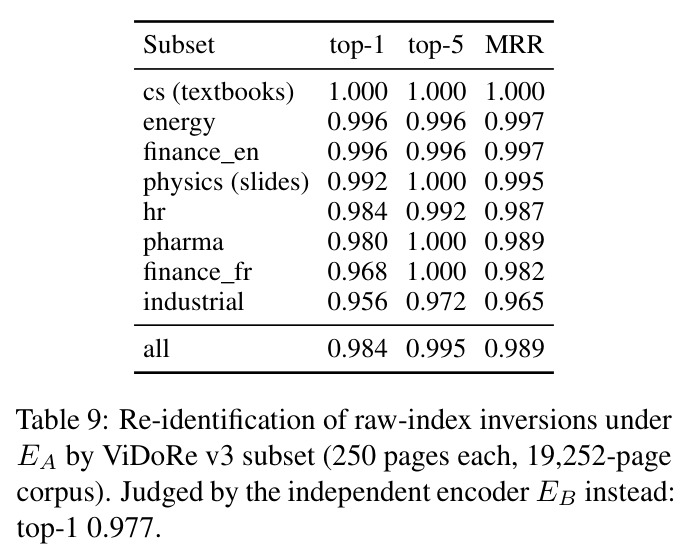
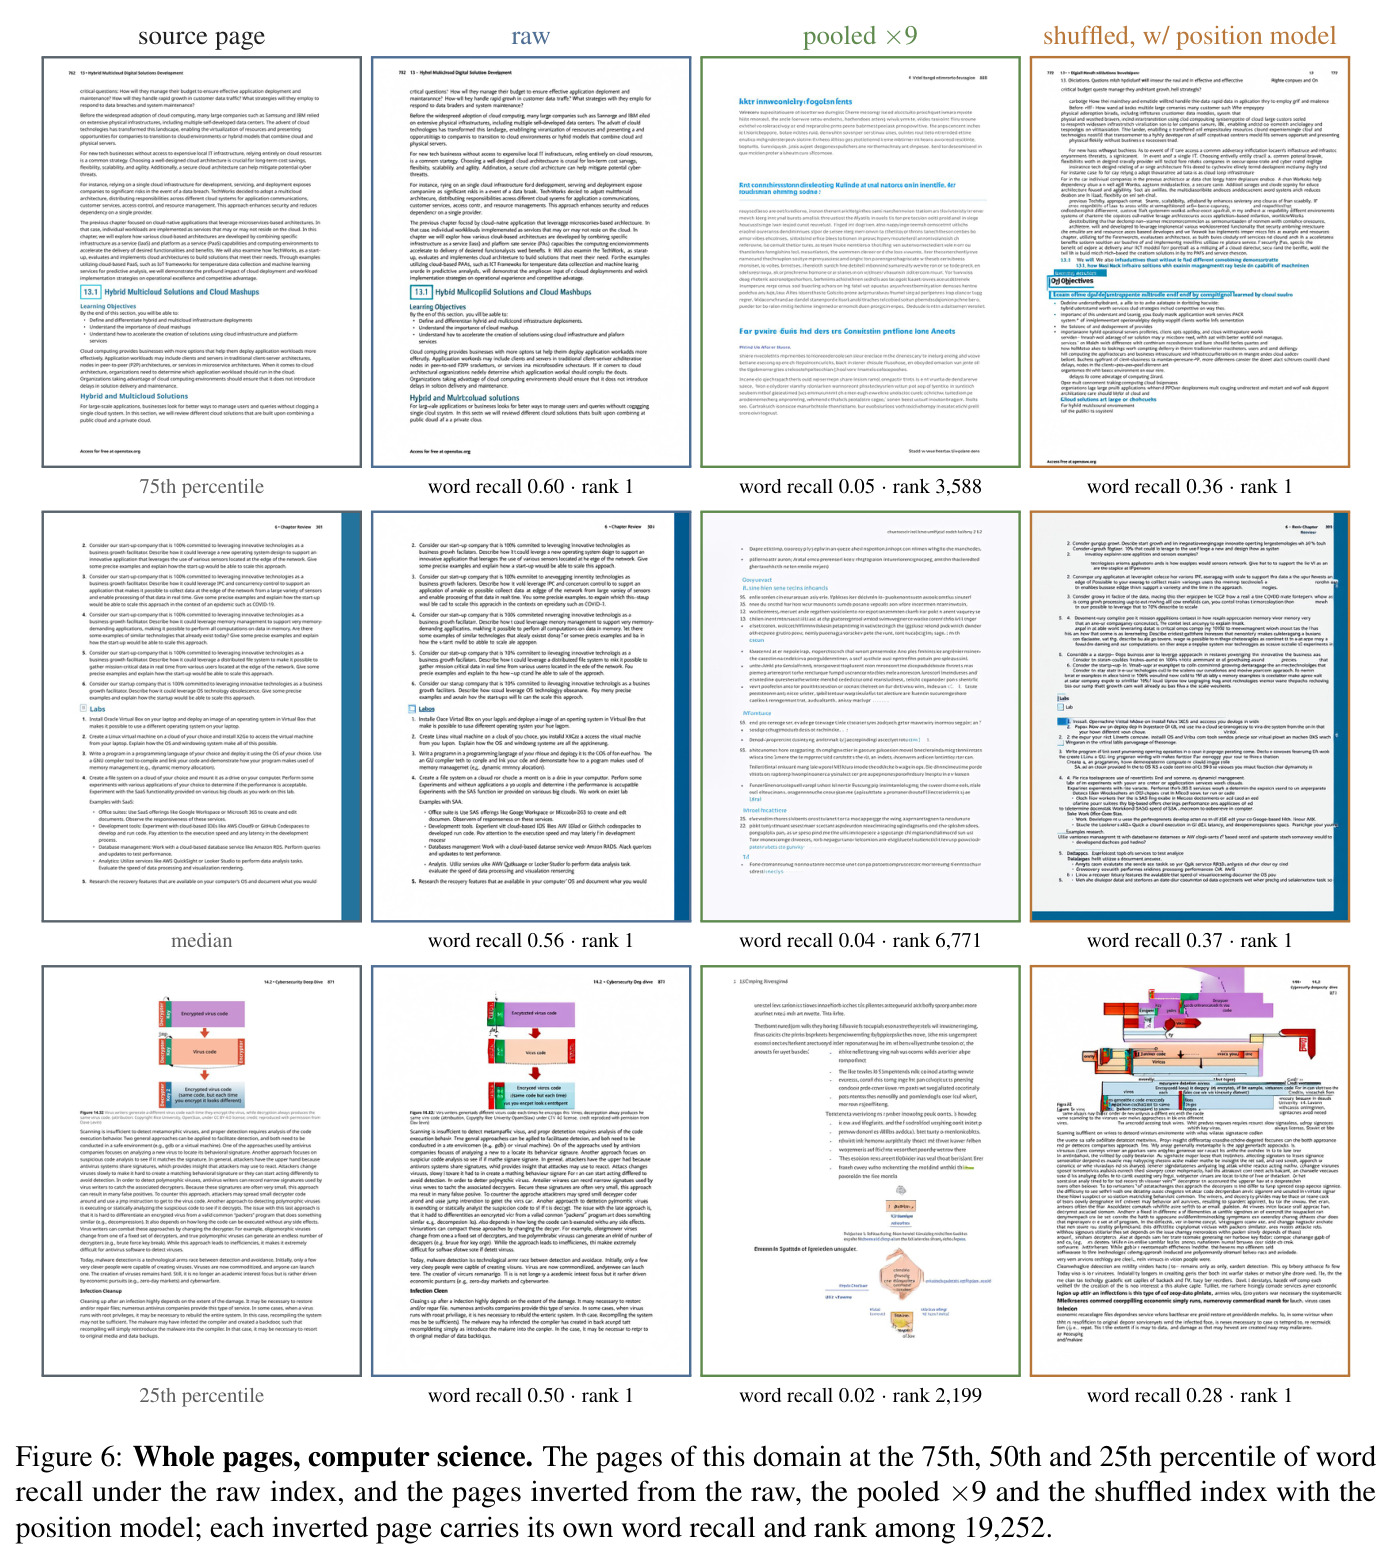
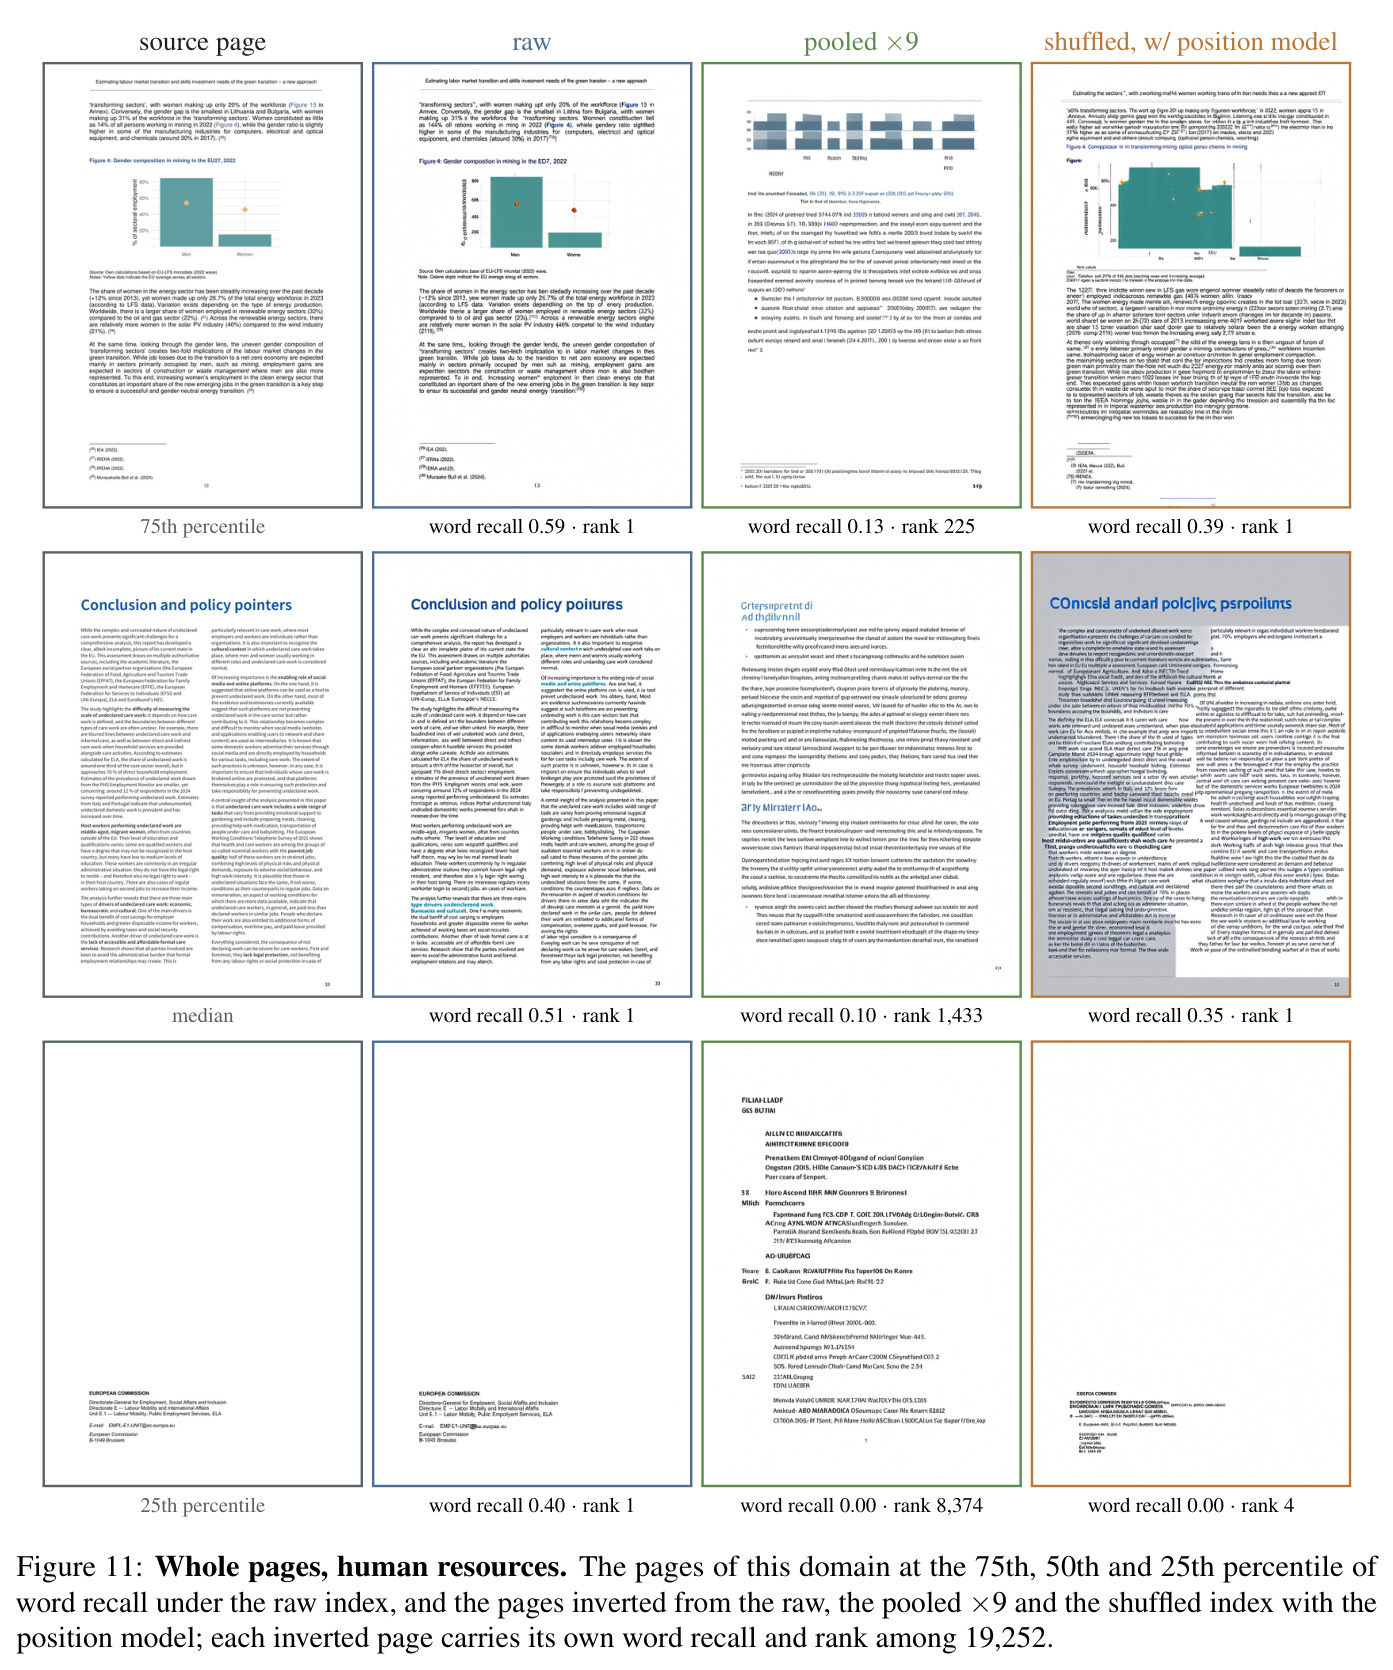
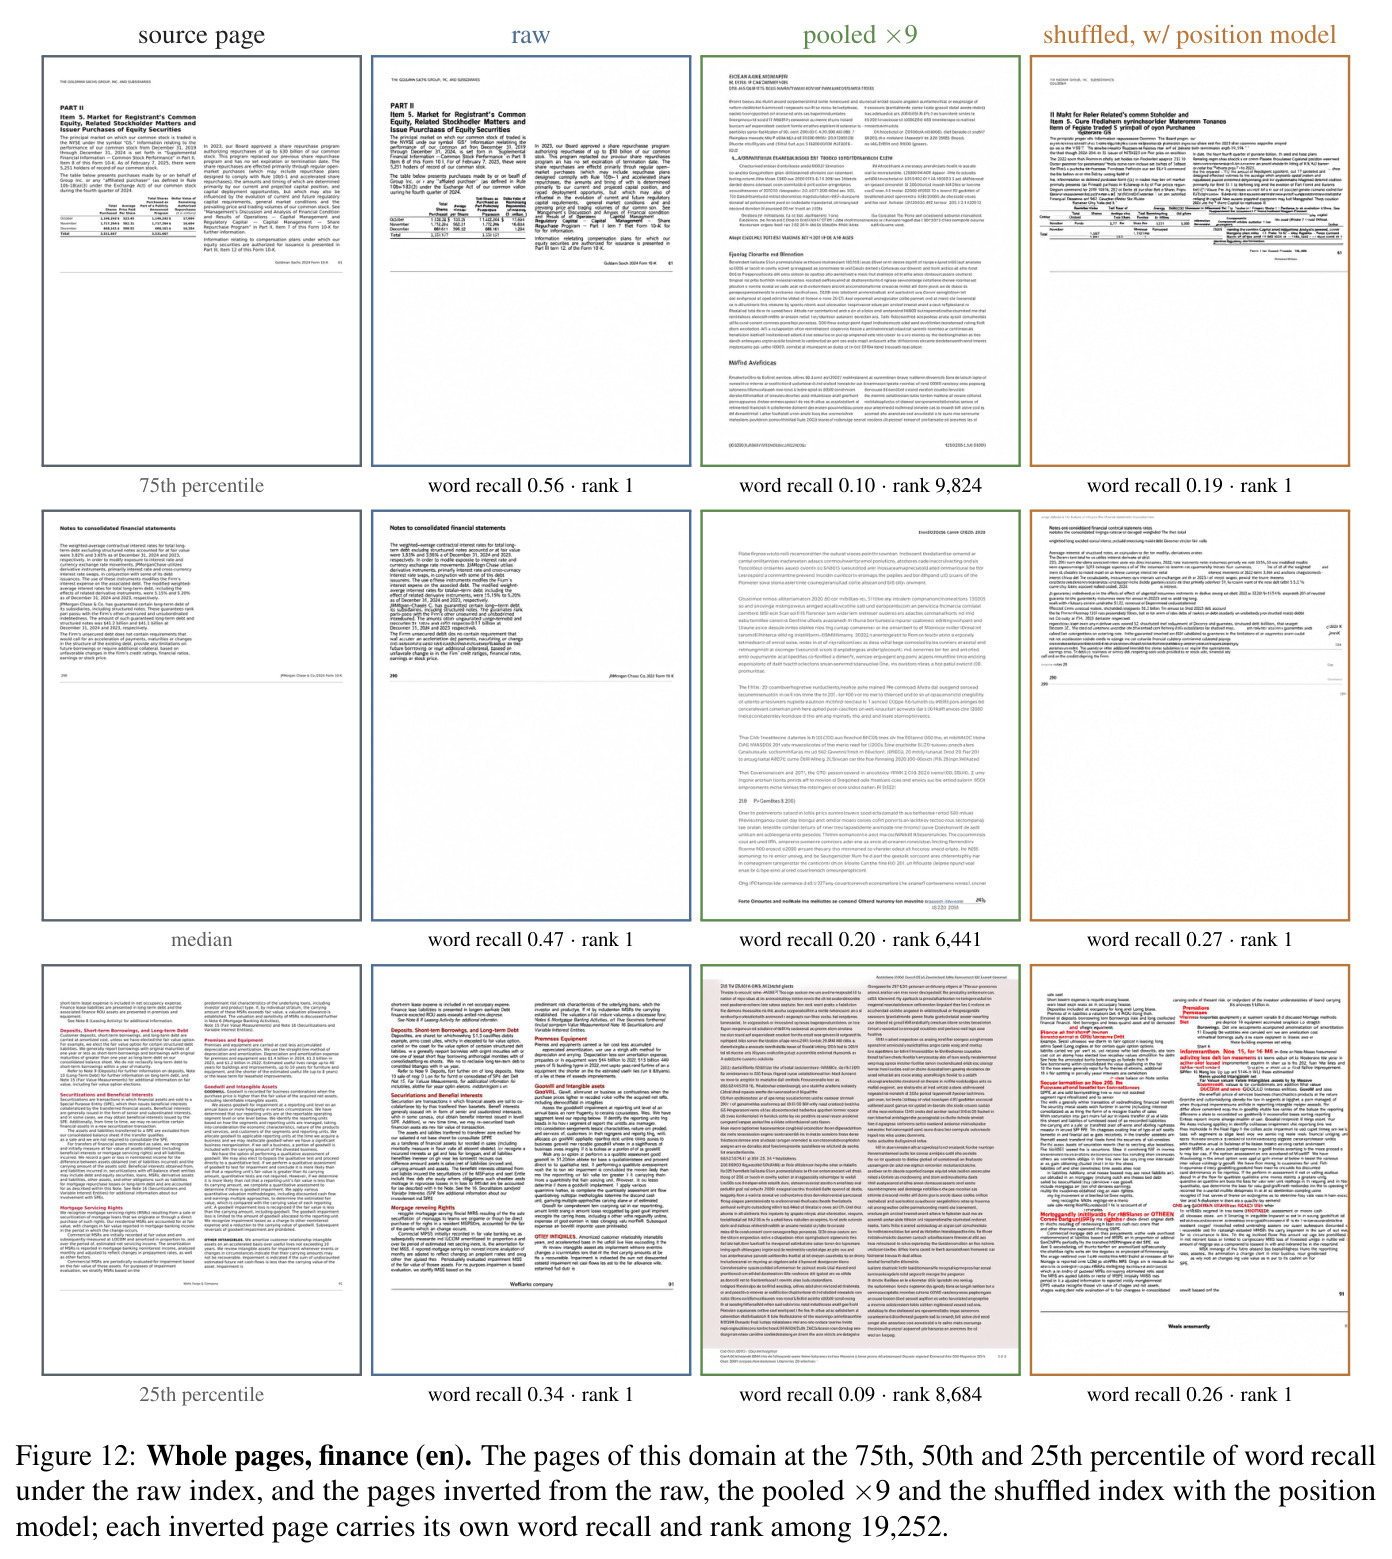
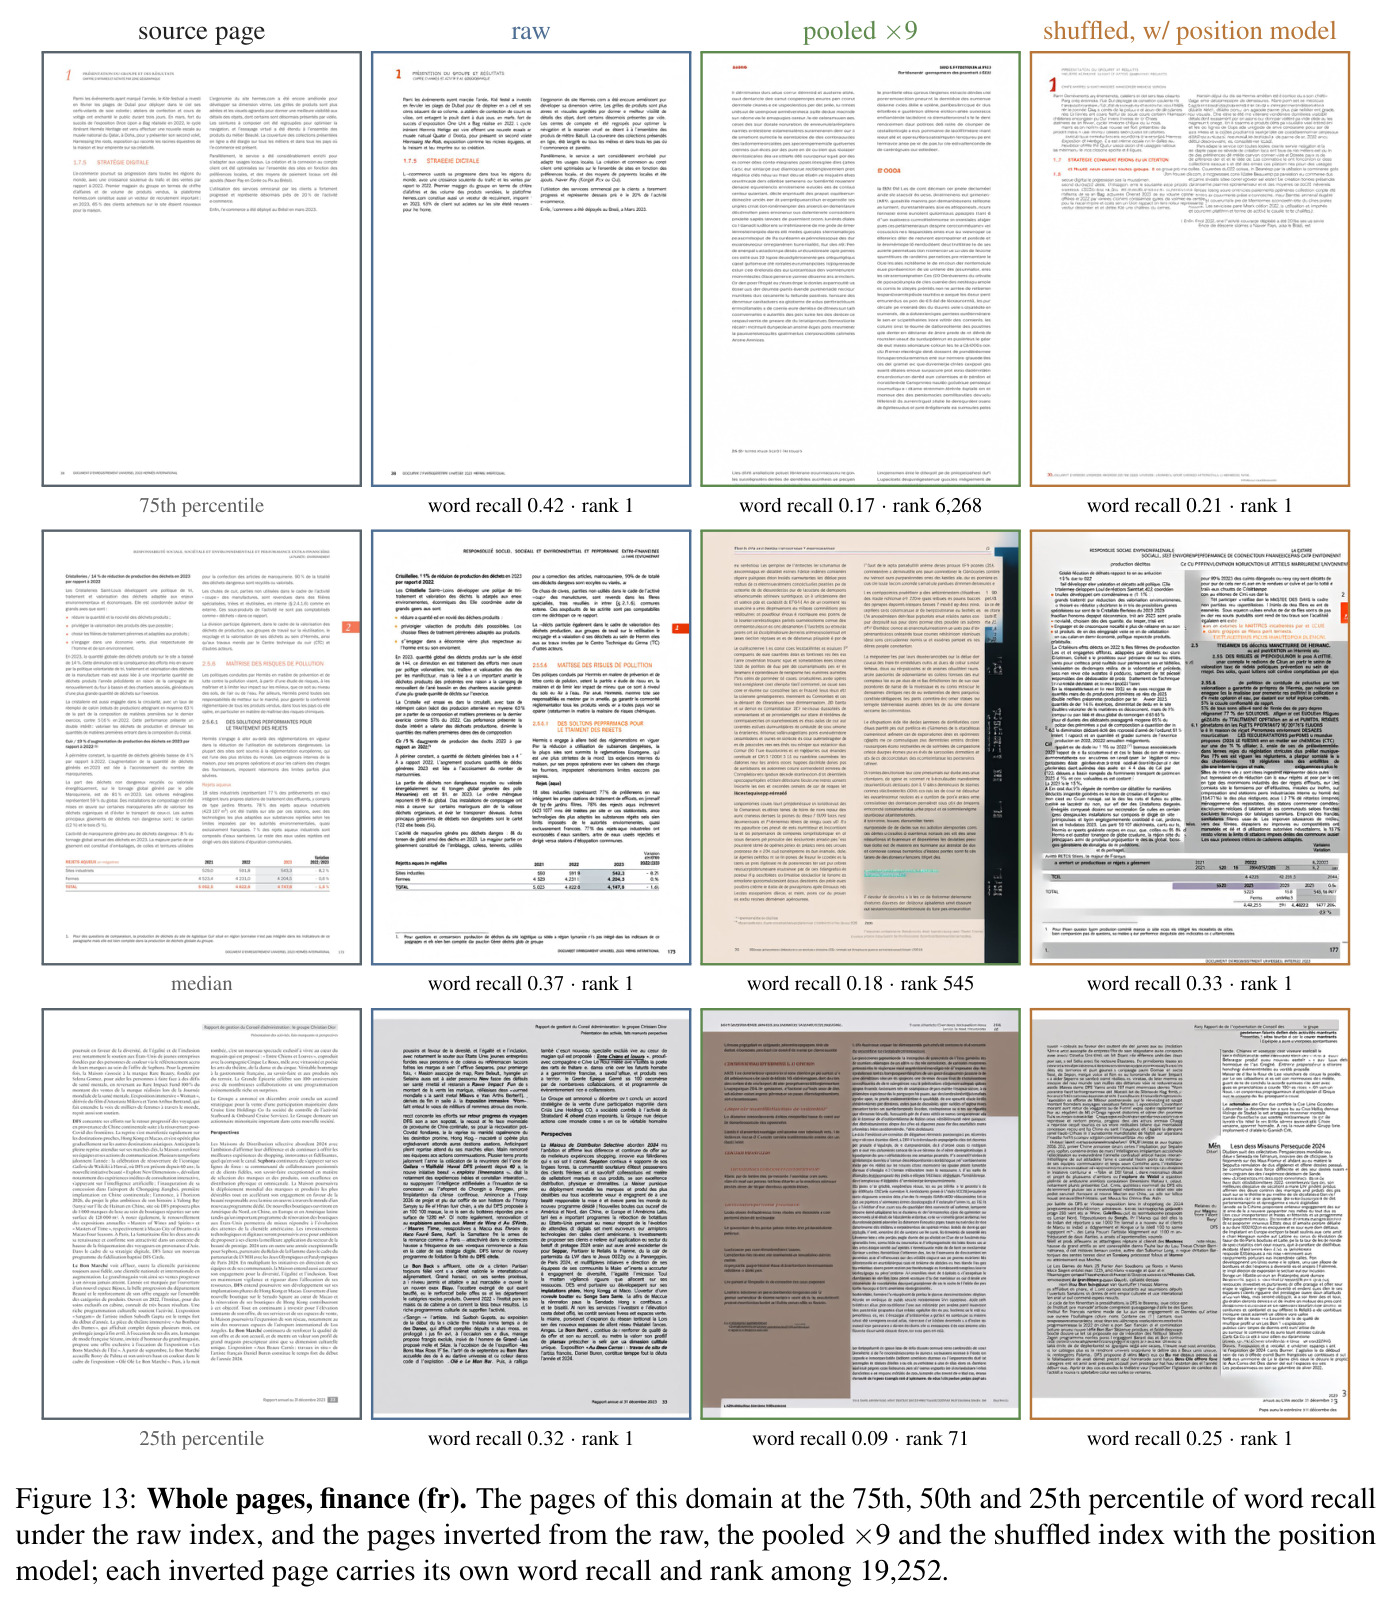
实验用ViDoRe v3固定的2,000页评估集,与训练语料无重叠。(1)编码器识别26,000次决策全对,形状恢复99%+。(2)raw索引(EA):反演页恢复47.4%的词和45.0%的敏感token;98.4%把源页排在19,252页首位,独立裁判97.7%;kNN(23.4%/0.146)与null(0.1%)基线排除先验解释。(3)池化:×3/×9的word recall降至7.6%/8.1%,top-1仅1.1%/0.5%,均低于kNN基线——本文攻击无法反演池化索引,检索代价仅0.8%/2.2% nDCG@10。(4)乱序:无位置模型时与池化同级(recall 8.4%、top-1 3.8%);位置模型把顺序误差压到1.8行/4.5列后,top-1升至93.5%,recall 23.1%——乱序不构成可靠保护。(5)泛化到EB:同一流水线下raw top-1 70.2%,但word recall仅7.9%,低于kNN的22.3%;同数据训EA反演器得55.5%/98.9%,证明差异在编码器;1行/列误差时recall从0.476掉到0.247而top-1仍0.951。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 从raw索引恢复页面文字(EA,Tomoro-ColQwen3-8B) | word recall(OCR词召回) | 0.474 | kNN基线0.234;null模型0.001 | 约为kNN基线的2倍,相对null模型从近零跃升 |
| 从raw索引恢复敏感信息(数字/大写词/缩写) | sensitive-token recall | 0.450 | kNN基线0.146 | +30.4个百分点(约3倍) |
| 从raw索引重识别来源页(19,252页库) | top-1命中率 | 0.984(独立裁判EB下0.977) | kNN基线0.199;随机0.00005 | +78.5个百分点,逼近源页自身上限0.996 |
| 从乱序索引重识别来源页(EA) | top-1命中率 | 0.935(加位置模型) | 无位置模型0.038 | +89.7个百分点,证明乱序不是可靠保护 |
| 从池化索引反演页面(EA,×9) | word recall | 0.081 | kNN基线0.234 | 负结果:低于基线0.153,本文攻击无法反演池化索引 |
| 同一攻击泛化到第二检索器(EB,ColQwen3.5-4.5B) | top-1命中率 | 0.702(独立裁判EA下0.605) | kNN基线0.154 | +54.8个百分点,攻击跨编码器成立但强度因编码器而异 |
局限与改进
作者承认四类限制。第一,两个被攻编码器同属ColPali风格、Qwen骨干,单一模型家族,对其他家族(LFM2、ColSmol等仅进识别池)未验证反演。第二,泄漏是保守下界:反演器100k步时验证损失仍在下降;仅换更匹配的训练集,word recall就从0.474升到0.555;guidance贡献约一半recall却只调了一次。第三,指标局限:OCR只认完全成形的字形,word recall低于0.1的页面中仍有75%重识别排第一,两者Spearman相关仅0.13,即OCR低估实际恢复;敏感token用正则启发式定义、未经人工研究;重识别只衡量忠实度;且无法验证反演页哪些部分正确——先验可能被误计为泄漏,作者用null模型、seed一致性、VAE上限三重控制缓解。第四,防护评估范围有限:没尝试恢复池化向量的位置,也没评估加噪、量化、密钥随机投影、加密检索或存储访问控制。我的补充观察:攻击假设存储配置全库统一且攻击者能拿到逐页索引;池化+乱序的组合防御未测;每次采样加重识别约1.7小时/2,000页,大规模攻击成本未讨论;论文不发布训练好的反演器,第三方独立验证需自担训练成本。
独立分析的弱点
独立分析有六个弱点。第一,池化'安全'只是本文攻击的失败而非安全证明——作者反复强调,并给出软位置预测、可微最优传输指派、更大容量骨干三条突破路径,防御者不应把敏感文档押注在一个被明确标为开放问题的手段上;改进方向是带密钥、攻击者无法用公共权重模拟的变换。第二,评估完全依赖OCR字级指标,系统性低估部分成形字形的泄漏(75%低recall页面仍排第一),需要像素级或embedding级的敏感度度量。第三,位置模型的误差强相关(平均3.2格误差却超过同等独立噪声曲线),提示防御若在池化或加噪时刻意破坏向量间空间相关性,可能同时恶化形状与顺序恢复。第四,乱序被攻破的根源是每向量仍携带位置信息;更强的保护或许要在编码后混合patch内容,但这必然损伤检索质量,该trade-off值得量化。第五,编码器识别依赖公共权重'指纹',对池外私有编码器只能标记(100页决策86.3–100%检出)而非反演,私有部署是现实缓解但牺牲开源生态。第六,缺少端到端隐私案例分析——'45%敏感token恢复'对具体企业意味着什么,需要更贴近业务的威胁叙事;本文是攻击测量而非防御设计,防御侧系统性研究仍是空白。
未来方向
作者提出的方向:池化索引反演是头号开放问题,三个起点——为每个池化质心预测页面槽位上的软位置分布(标签可由公共编码器在自身输出上免费产生);把向量-槽位匹配建成条件流内部可端到端学习的最优传输问题;用更大骨干或更长训练计划学习'从内容推版面'。此外建议:对同一索引多次采样、只保留共享内容,以分离高置信泄漏与先验噪声;研究区分'发明内容'与'恢复内容'的验证方法;以及私有多向量索引场景。基于成果可延伸的:防御侧系统研究——密钥化索引变换、空间感知池化、差分隐私扰动下'检索质量-泄漏'的Pareto前沿(池化×3只损0.8% nDCG@10,说明这条曲线值得细画);把反演泄漏作为'隐私审计'指标纳入ViDoRe等检索基准,给每个检索器标泄漏分;跨家族复验(LFM2、ColSmol、ColNomic已在识别池中,反演未做);解释EB与EA泄漏差异的编码器性质(EB平均739向量/0.757 Mpx对EA的1,198向量/1.227 Mpx,是分辨率、向量数还是训练数据?);把威胁模型扩展到RAG多模态datastore、索引快照与备份等真实泄露渠道。
复现评估
复现条件清晰且门槛可控。开源安排:代码、评估清单(2,000页固定manifest)与协议承诺发表后公开;出于伦理考虑,训练好的反演器不发布,复现者需按论文超参自行训练。数据全公开:训练集为四个公共集合去重后的682,818页(EB用其中VisRAG部分346,770页),评估用ViDoRe v3八个公共语料,被攻编码器与识别池13个编码器均为HuggingFace公开权重且版本号钉死;池化用illuin-tech/colpali的池化器字节级一致调用;OCR用PaddleOCR。算力:7个反演器共133.3 H200 GPU小时(单个12.7–24.4小时、337.1M参数),位置模型0.5–1小时,set分类器在V100上5–12分钟;单设置对2,000页采样加重识别约1.7小时——单张H200即可完整复现。随机性、种子、对齐检查(重编码余弦0.999–1.000)、语料重叠检查(0.4%近重复,去除后数字不变)与bootstrap区间全部写明。难度评价:中等——组件公开且超参齐全,但链路较长,主要风险在OCR版本与渲染差异带来的指标漂移;不发布反演器权重也提高了独立验证门槛。
论文图表
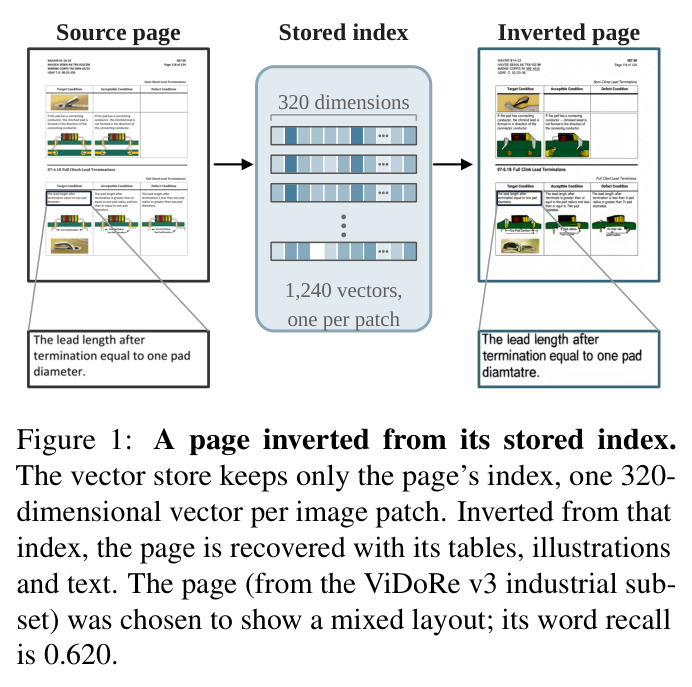
摘要展示图:ViDoRe v3工业子集的一页(含表格与插图)从其存储索引——每patch一个320维向量、共1,240个——被完整反演,表格、插图和文字均恢复,该页word recall为0.620。
这是论文核心主张的直观证据:一页文档真的可以从'没人能读懂'的向量索引中重建出来,一图奠定全文威胁叙事。
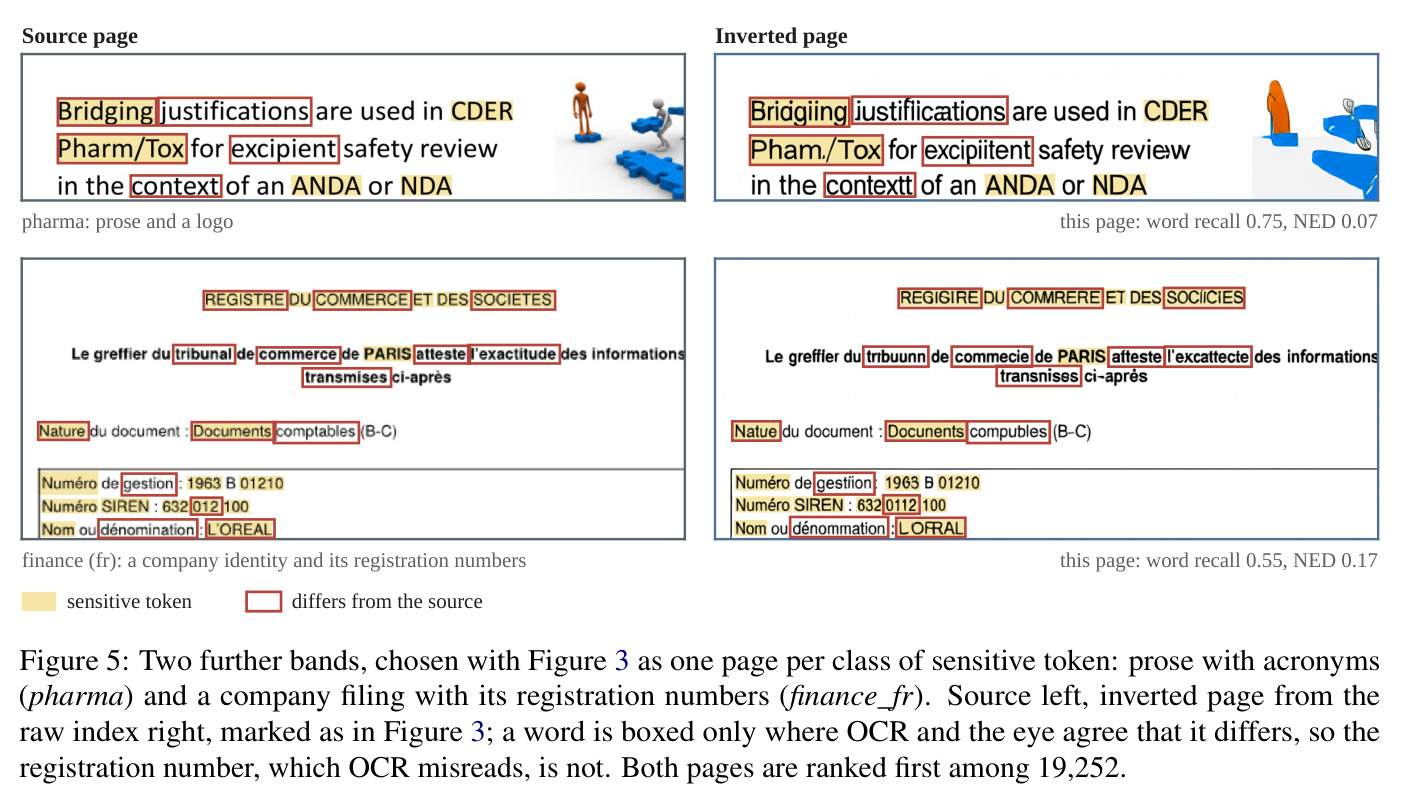
一张统计表格条带的源页与反演页对照:60个数字格中59个逐字恢复,仅一个数字格(58变53)和一个国家代码多出一个字母出错;黄色标记敏感token,朱红色标记差异token。
最能说明敏感信息泄漏严重性的证据:财务/统计表格中的数字—— breach 中最值钱的内容——几乎原样恢复,直接支撑sensitive-token recall 45%的抽象数字。
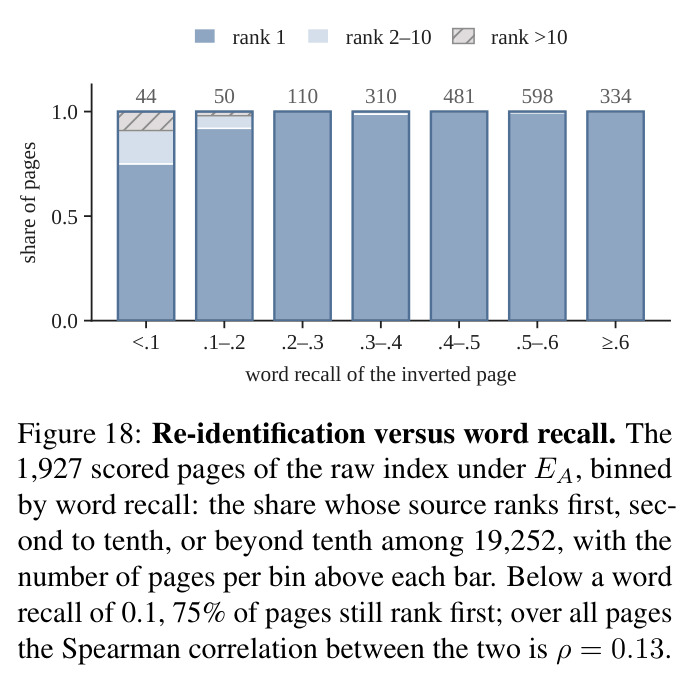
1,927个raw反演页按word recall分箱,每箱显示源页排名第一位/第2–10位/第10位以外的占比:word recall<0.1的44页中仍有75%排第一;全体Spearman相关仅ρ=0.13。
揭示OCR指标的保守性:编码器能识别OCR读不出的部分成形字形,内容泄漏比字面召回率显示的更严重,是解读所有数值的关键警示。
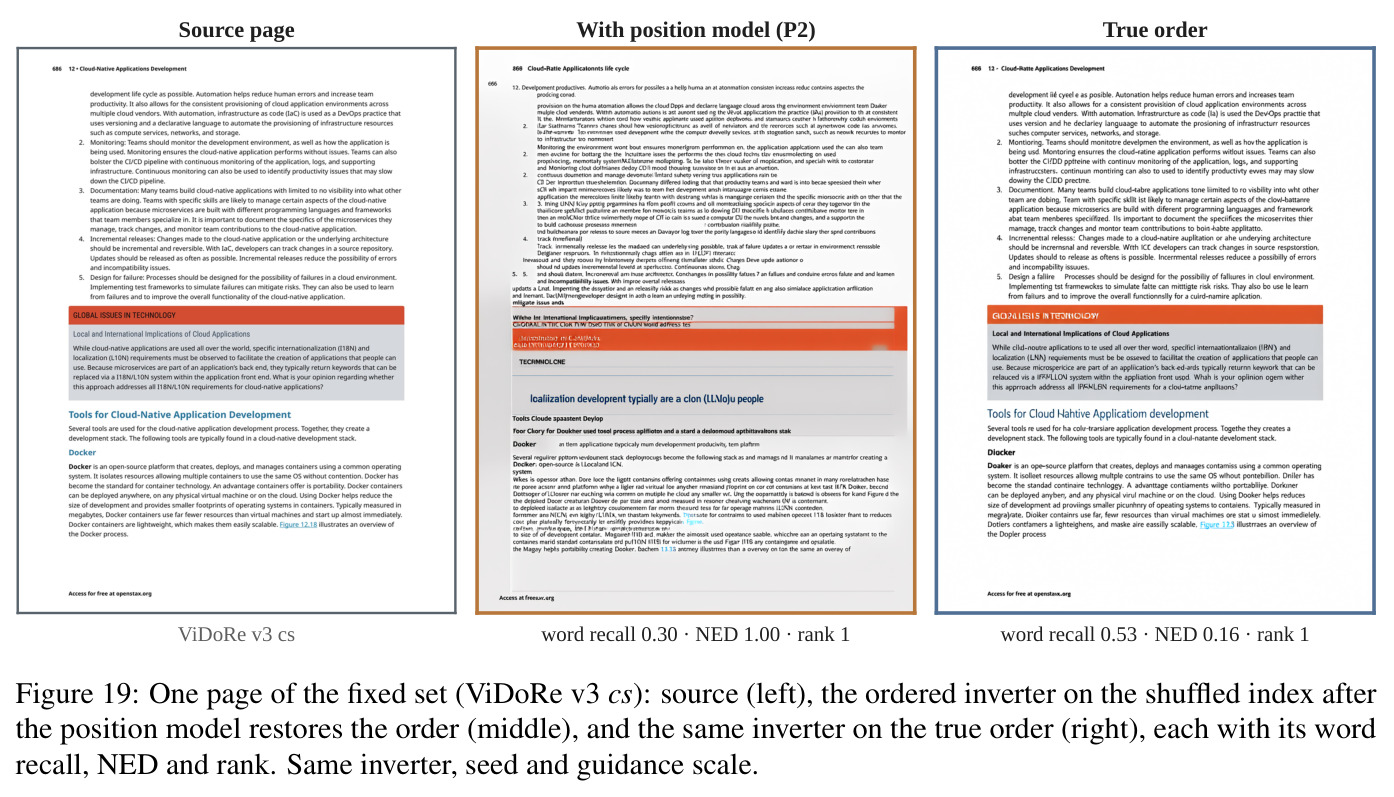
失败案例:同一反演器、同种子,真序下word recall 0.53/NED 0.16/rank 1;位置模型恢复顺序后单词、编号列表、标题横幅都回来了,但整行整块出现在错误的垂直位置,NED顶格1.00,OCR按错误顺序转写。
精确刻画'顺序恢复成功但位置不够准'的失败模式,解释了乱序+位置模型一栏NED 0.925很高而recall 23.1%的表面矛盾。
从存储索引恢复页面形状的伪代码:先归一化向量,构造宽高比窗口内N的因子候选集W;raw索引(f=1)对每个候选W计算滞后W的平均余弦相似度并取最大者为列宽;池化索引用Deep Sets分类器(均值+最大池化特征+log N,logits按向量数掩码)在兼容形状中选择;最后换算成像素单位。
零侧信息攻击中最'巧'的一步的实现细节:仅凭向量间相似度的周期性就能读出页面宽度,是把存储顺序信息反转为攻击武器的地方。