GaussianRenderFormer:基于 Transformer 的三维高斯泼溅神经渲染器 GaussianRenderFormer: Transformer-based Rendering of 3D Gaussian Splats
首个无需光栅化器、用Transformer直接渲染3D高斯的神经渲染器可行性研究
前置知识
3D Gaussian Splatting (3DGS)
一种显式三维场景表示:用 $N$ 个各向异性 3D 高斯拟合真实场景,每个高斯有中心 $\mu_i$、协方差 $\Sigma_i = R_i S_i S_i^\top R_i^\top$(由旋转四元数 $q_i$ 和逐轴尺度 $s_i$ 构成)、不透明度 $o_i$ 和颜色 $c_i$(通常存为随视角变化的球谐系数)。渲染时投影到 2D 高斯再逐像素混合,整个场景通过梯度下降对照片拟合得到。
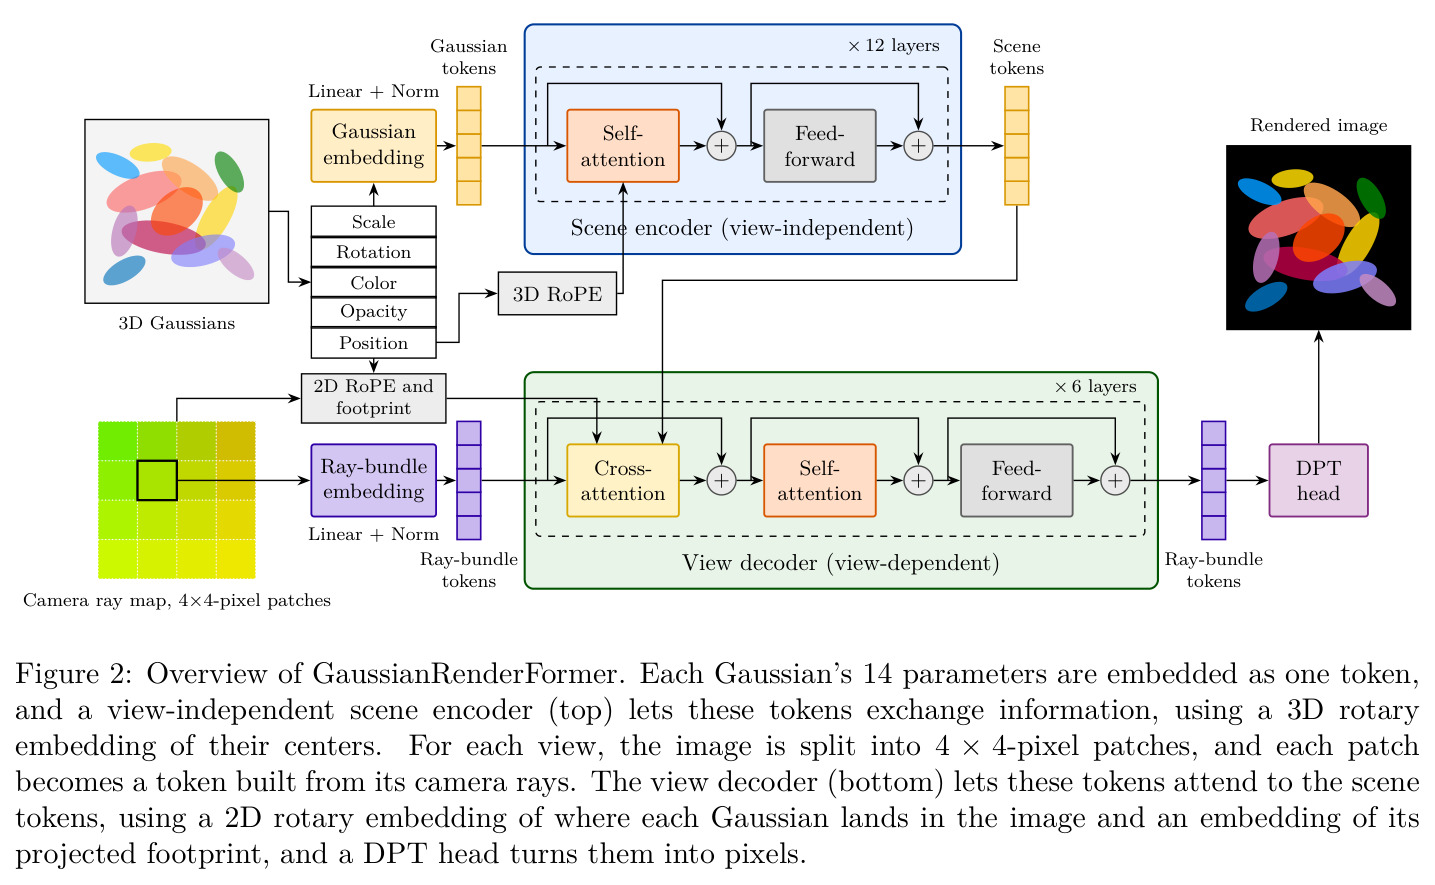
本文的输入就是这个表示,理解高斯的 14 个参数(中心3、尺度3、四元数4、颜色3、不透明度1)才能看懂模型如何把每个高斯编码成一个 token。
Alpha 混合与深度排序光栅化
3DGS 的标准渲染算法:把每个高斯投影成带协方差 $\Sigma'_i = JW\Sigma_iW^\top J^\top$ 的 2D 高斯,按深度排序后从前往后逐像素混合 $C(x) = \sum_i c_i\alpha_i(x)\prod_{j<i}(1-\alpha_j(x))$,其中 $\alpha_i(x)$ 是像素 $x$ 处的投影不透明度。排序避免半透明面片顺序错误,但也带来相机移动时的 popping 伪影。
这正是本文要用手写网络替换的手写算法;论文反复用『光栅化同一份输入』作为对比基线,理解它才能读懂 6 dB 差距的含义。
Transformer 注意力与 Rotary Position Embedding (RoPE)
自注意力让一组 token 两两交换信息,权重由 query 和 key 的相似度决定。RoPE 把位置信息以旋转形式注入注意力:将 query/key 的若干通道复数化后按位置旋转固定角度,使注意力得分自然依赖于两个位置的相对距离。2D RoPE 把该机制扩展到图像平面坐标 $(u,v)$。
本文解码器的三项改动中两项基于此:投影中心的 2D RoPE 让 patch 与高斯的注意力依赖它们在图像上的距离;footprint 则以加法形式修正 keys。
RenderFormer
Zeng 等人 2025 年提出的 mesh 神经渲染器:每个三角形一个 token,12 层自注意力的视角无关编码器建模全局光照,6 层视角相关解码器用 8×8 像素 patch 的光线束作为 query 做 cross-attention,DPT head 输出 HDR 像素。在最多 4096 个三角形的场景上训练,能用 transformer 学出含全局光照的渲染。
GaussianRenderFormer 直接沿用其双阶段架构并从预训练权重出发,全文的核心问题就是『这套 mesh 方案能否迁移到数万个半透明重叠的高斯上』。
PSNR 与 LPIPS
PSNR(峰值信噪比,dB)衡量逐像素误差,越高越好,是渲染论文的主指标;SSIM 衡量结构相似性;LPIPS 用预训练网络特征衡量感知差异,越低越好。本文的 PSNR 在围绕物体、12 像素边距的评估 crop 上计算,另有只算物体像素的 masked PSNR。
论文的全部结论都用这三个数字表达:38.08 对 44.02 dB 的差距、消融的 -5.2/-3.0/-1.7 dB 等,不熟悉指标就无法判断结果的好坏。
研究动机
3D 高斯泼溅(3DGS)已成为照片级场景重建的主流表示,但它的每一张图像都依赖一个手写光栅化器:把每个高斯投影到图像平面、按深度排序、再逐像素做 alpha 混合。学习式渲染在三角网格上已由 RenderFormer 证明可行(transformer 能学出含全局光照的渲染,但场景规模上限 4096 个三角形),而据作者所知,此前没有任何 learned renderer 能直接以高斯为输入。难点具体而现实:一个物体通常需要数万个高斯(本文 20000 个),且高斯没有表面和材质、半透明、彼此重度重叠,渲染器必须在每个像素判断哪些高斯可见、以什么顺序和权重混合——这些正是光栅化器用排序硬编码解决的。即便做高斯的重光照(relightable Gaussian 一系方法),最终成像仍依赖手写着色模型、间接光靠近似,都无法像 RenderFormer 那样从数据中学光传输。
本文的目标是本文的目标是一项可行性研究:能否训练一个神经网络,输入一组 3D 高斯和一台相机,直接输出图像,渲染路径中完全没有光栅化器、也不做逐场景优化?作者把它明确限定在物体级别:在 26820 个 Objaverse 物体上训练(每个剪枝到 20000 高斯),在 300 个从未见过的物体上,以 gsplat 光栅化完整 50000 高斯 splat 的渲染为参考,量化 learned renderer 与『光栅化同一份剪枝输入』的差距。同时回答三个子问题:mesh 渲染器的架构和预训练权重能否迁移到高斯、剩余差距来自泛化不足还是模型能力瓶颈、模型在训练相机配置之外(不同分辨率/距离/视场角、真实捕获)表现如何。
与已有工作不同的是,本文的独特切入有三点。其一,站在 RenderFormer 肩膀上:沿用其双阶段架构并从预训练权重出发,只把 token 从三角形换成高斯——这规避了从头训练的陷阱(作者实验中随机初始化会坍缩成纯黑图像,找不到可行的训练配方)。其二,评估设计上的先天优势:因为输入是显式高斯,可以把模型与『光栅化同一份剪枝输入』直接对比,把差距精确归因到渲染本身而非重建质量——这是 LVSM、SRT 等从图像出发的无光栅化器方法做不到的。其三,针对高斯半透明、重度重叠的特性提出三项视角解码器改动(投影位置 2D RoPE、投影 footprint 注入注意力 keys、更小的 4×4 patch),在 1000 物体中等规模 harness 和全尺度上双重消融,并系统诊断剩余差距的来源(解码器瓶颈 vs 欠训练)。
核心方法
直觉上,作者把渲染当作『结构化场景描述到图像』的翻译任务。每个高斯的 14 个参数 $g_i = (\mu_i, s_i, q_i, c_i, o_i)$ 经线性层加 RMSNorm 编码为一个 token(输入层是全新训练的唯一大改动);12 层自注意力的场景编码器是视角无关的、每物体只跑一次,用高斯中心的 3D RoPE 注入位置,另配 16 个 register token。视角解码器把图像切成 4×4 像素 patch,每个 patch 由其 64 条相机光线方向(上采样到 8×8 以复用预训练嵌入)生成 query token,经 6 层『cross-attention 查询场景 token + patch 间自注意力』,最后 DPT head 输出 512×512 像素。模型共 195M 参数(编码器 113M、解码器 82M),从 RenderFormer 预训练权重初始化,按四阶段课程训练,损失为 log-L1 加 LPIPS。关键设计原则:投影中心和 footprint 都是每个高斯的闭式坐标变换,无任何逐像素计算,哪些高斯覆盖像素、如何混合全交给网络学。
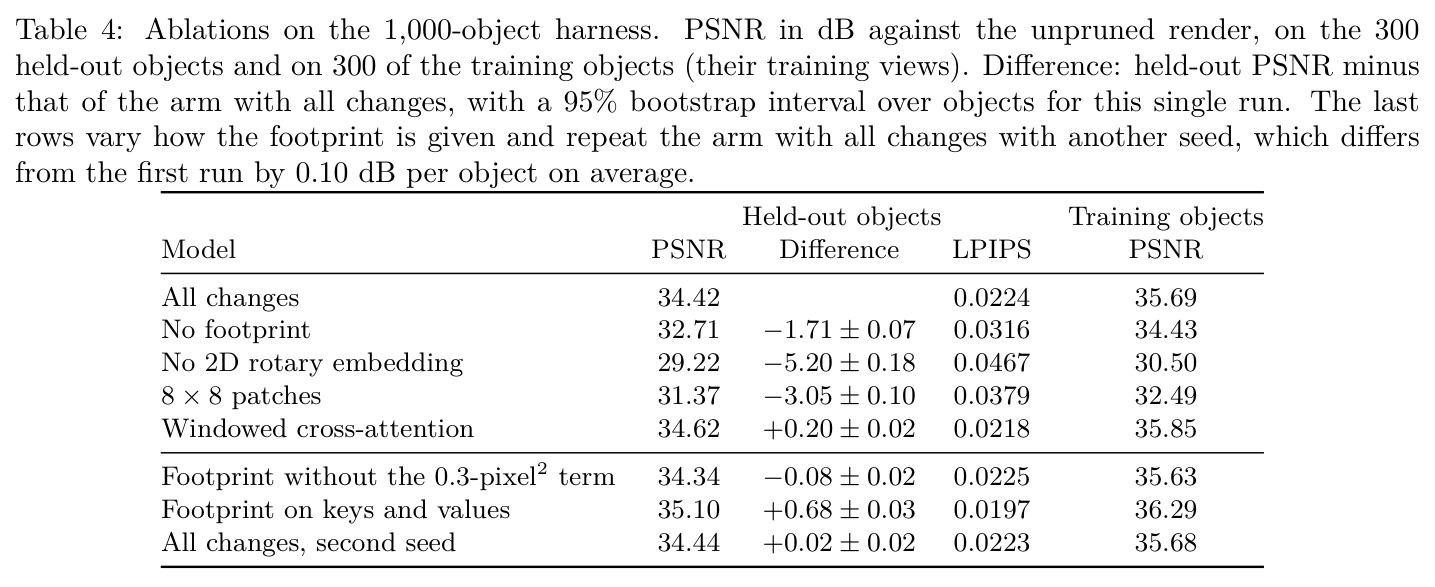
核心创新是三项把 mesh 解码器改造成高斯解码器的最小改动。其一,投影位置的 2D rotary embedding:把高斯中心按针孔模型投影到 patch 坐标 $(u_i, v_i)$,cross-attention 中高斯的 keys 按 2D RoPE 旋转、patch query 用同一嵌入旋转,使注意力得分直接依赖两者在图像上的距离——『高斯落在图上哪里』是 3D 位置编码给不了的。其二,投影 footprint:把高斯在相机系的协方差经 Jacobian 投影为 2×2 图像协方差 $\Sigma'_i = J_i\Sigma_i J_i^\top + 0.3I/p^2$,用两个标准差的对数与主轴角共 4 个数经每层零初始化线性层加到 keys——这个量本可由解码器自己推出,显式给出却在全尺度带来 1.4 dB,是『解码器是瓶颈』的最直接证据。其三,4×4 小 patch 替代 8×8,图像 token 数翻四倍以解析细节。与既有方法的本质区别:现有工作要么生产高斯再交给光栅化器,要么从图像隐式建模场景;本文第一次让显式高斯直接经网络变成像素。
方法步骤详情
数据与训练流程如下。数据:从 Objaverse_Splats 筛选 splat 质量好的物体(重建 PSNR≥32 dB、LPIPS≤0.06、恰好 50000 高斯、最大不透明度≥0.4),得 26820 训练 / 1806 验证物体,归一化到 $[-0.45, 0.45]^3$。输入构造:按 LightGaussian 式重要性分数保留 20000 高斯,再微调 1500 步弥补剪枝破洞;真值是 gsplat 渲染完整 splat 的 28 个视图(512×512、45° FOV、距离 1.15/1.7/2.45)。训练四阶段:Stage 1 只训新输入层 33.5k 步 @256(lr $10^{-3}$,其余冻结);Stage 2 全模型 402k 步 @256;Stage 3 开启三项解码器改动短恢复 3k 步 @256;Stage 4 全模型 385k 步 @512 加 LPIPS。损失为 log-L1(前景权重 1、背景 0.05)加 0.5×LPIPS(VGG);AdamW、lr $5\times10^{-5}$ 余弦衰减、8 卡各 1 视图;每样本对物体与相机施加同一随机旋转。
技术新颖性
技术新颖性有四层。第一,问题本身是新的:这是第一个渲染器内部不含光栅化器的高斯前馈渲染器——现有工作要么生产高斯再交给光栅化器(feed-forward 重建、精炼、生成式建模),要么把高斯当 token 做别的任务(预训练、场景理解),而本文高斯是输入、图像是输出。第二,『只做叠加』的改造策略:除输入层外所有新参数(footprint 线性层共 23040 个)零初始化,使模型起点严格等于改造前的函数;作者发现改动任何预训练部分代价极大(连把既有 position embedding 频率加倍都与替换它一样伤),而在预训练层之上加容量(9 层、287M 参数、8 倍宽 FFN)则毫无收益——这些负面结果对『如何改造预训练大模型』有普遍参考价值。第三,几何计算与学习内容切分清晰:footprint 只加在 keys(决定查哪些高斯),keys+values 变体虽在 harness 多 0.68 dB 但对密集输入更脆弱,作者选择守住边界。第四,光栅化式 tile 窗口注意力的对照仅 +0.2 dB,说明稠密注意力下网络自己学会了选择性。
实验结果
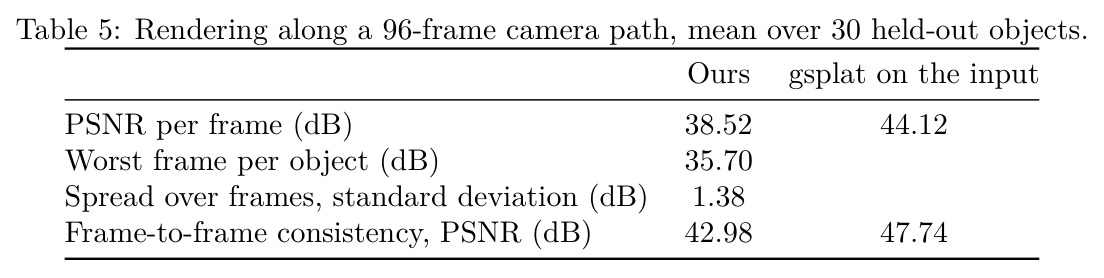
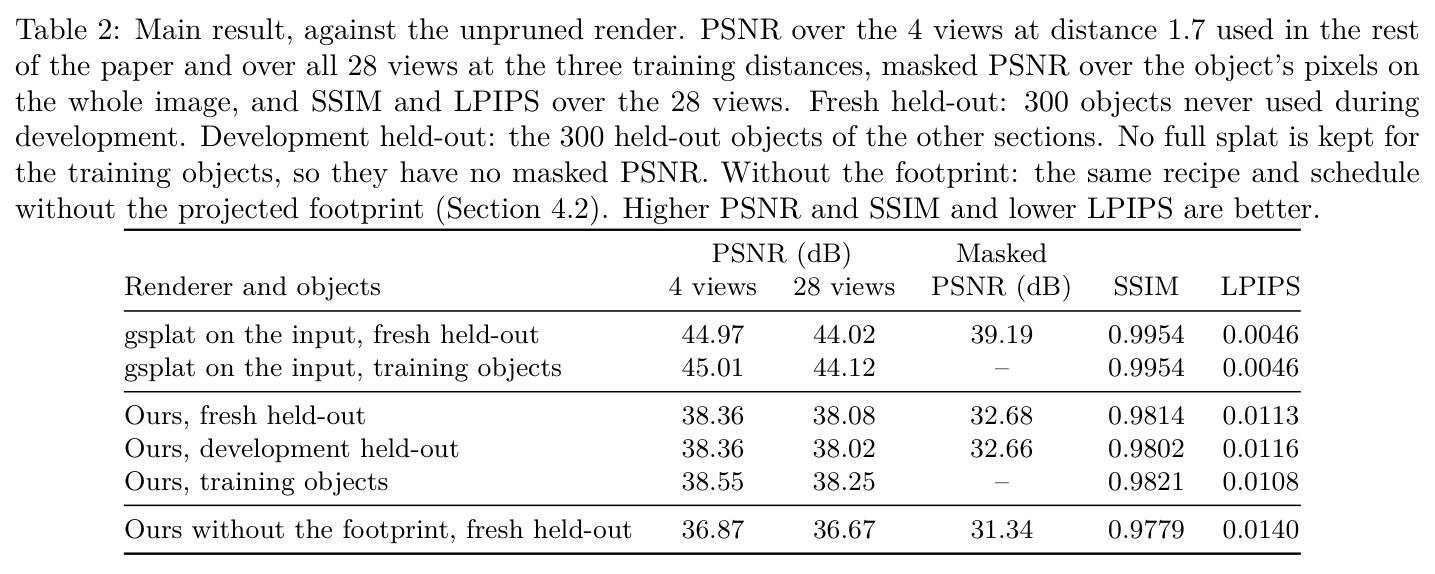
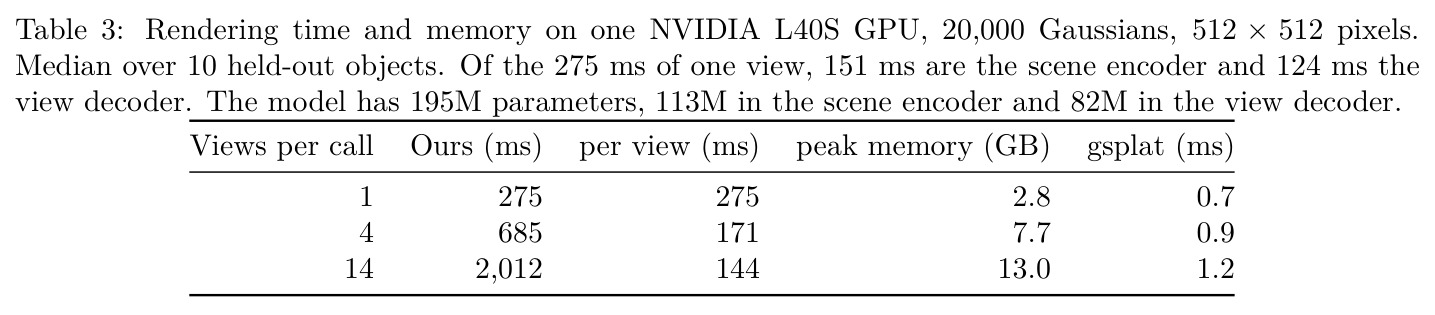
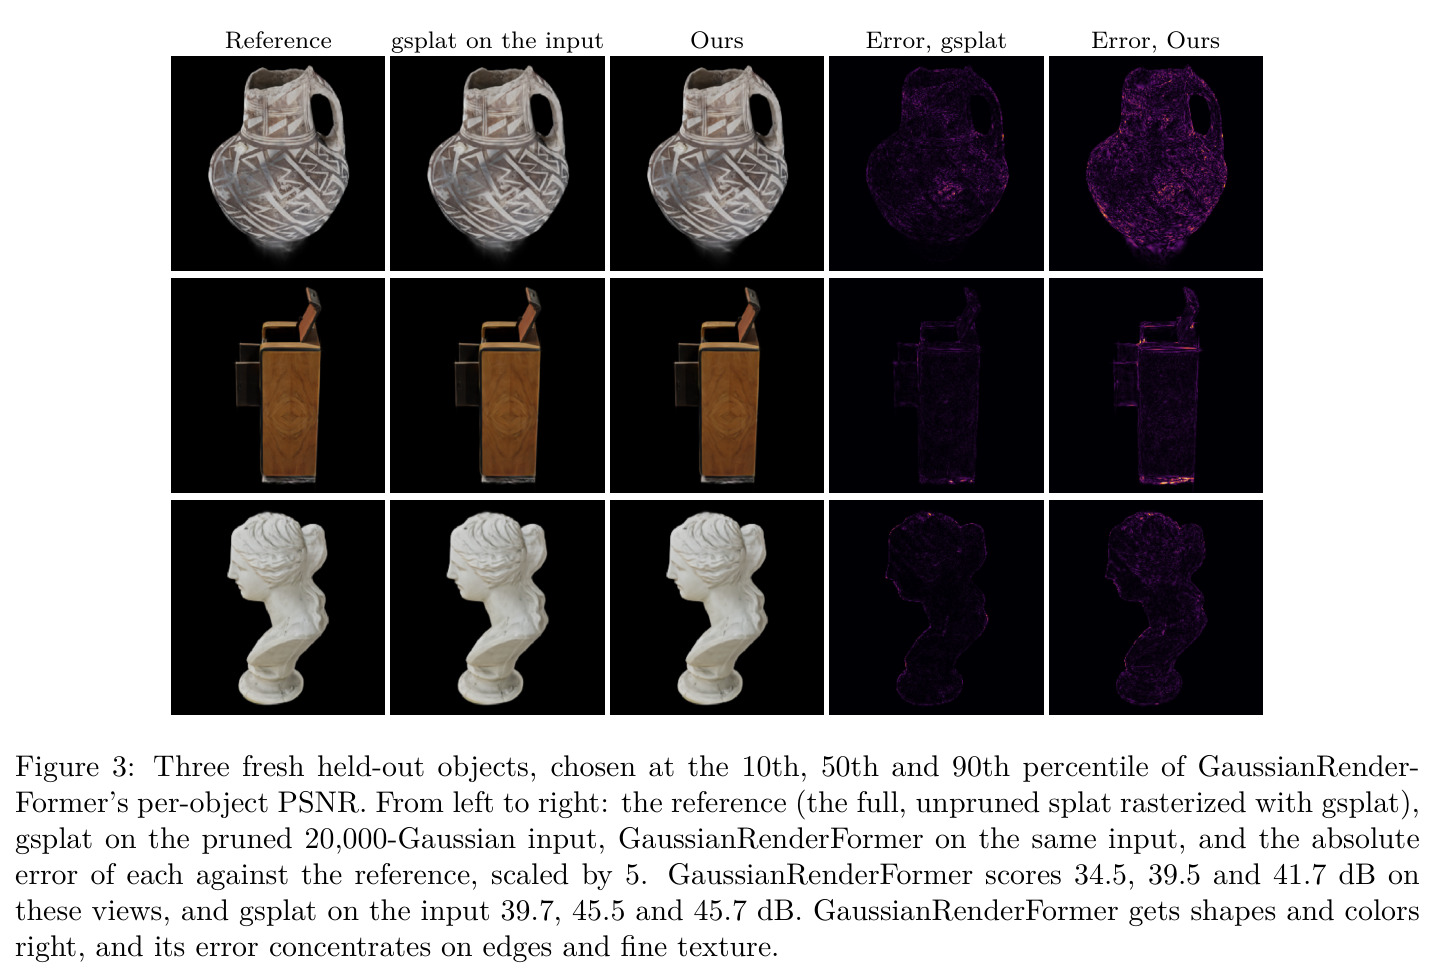
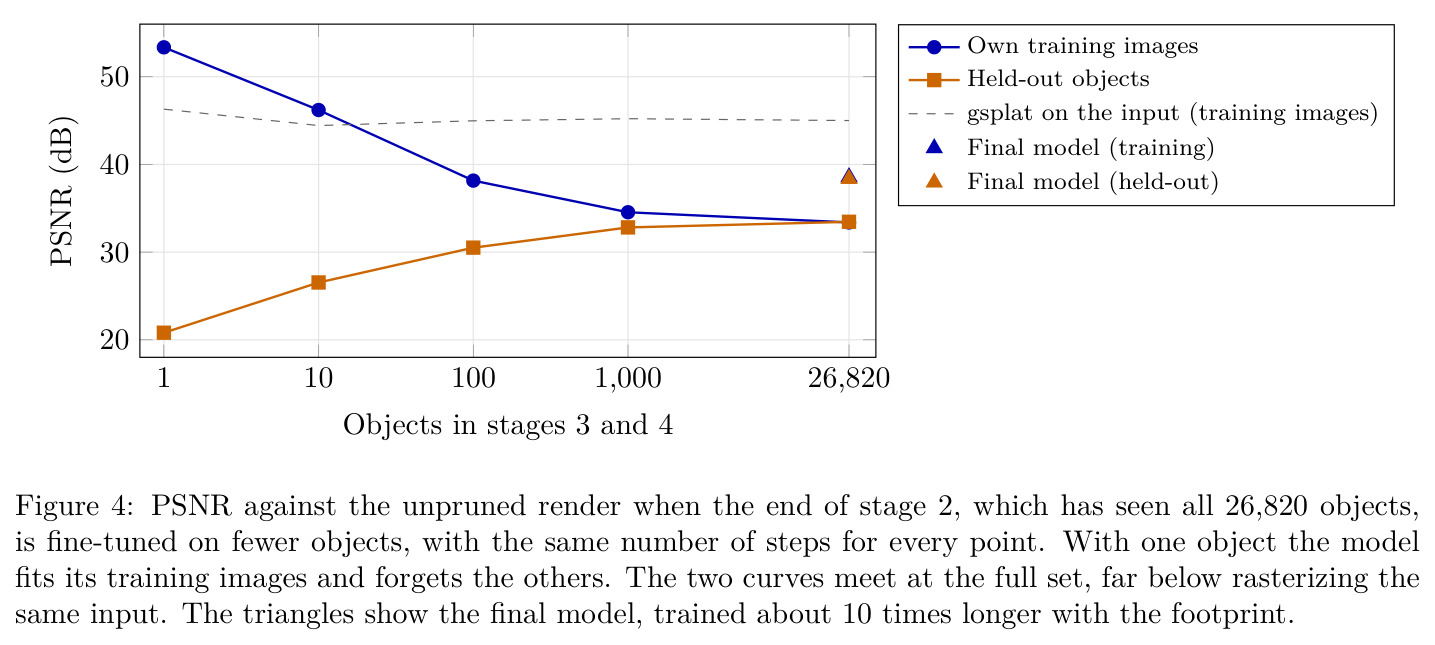
主结果:在 300 个 fresh held-out 物体、28 个训练视图上,模型对完整未剪枝 splat 渲染达 38.08 dB,光栅化同一份 20000 高斯输入达 44.02 dB,差距约 6 dB;masked PSNR 32.68 对 39.19,SSIM 0.9814 对 0.9954,LPIPS 0.0113 对 0.0046。差距不是泛化问题:开发集 38.02 几乎一致,训练物体仅 +0.17 dB,对自身输入也只 +0.3 dB。消融(1000 物体 harness):无 2D RoPE -5.20、8×8 patch -3.05、无 footprint -1.71 dB,全尺度复现 -4.3/-2.4/-1.4 dB。数据不稀缺:训练/测试曲线在全集汇合且仍低约 12 dB;步数每翻一倍仍 +0.9 dB,欠训练未排除。成本:L40S 单视图 275 ms 对 gsplat 0.7 ms;640000 高斯需 75 s、23.7 GB。配置之外:256/1024 分辨率约 33 dB、远相机 24.09 dB;真实 Mip-NeRF 360 区域低 1.6–4.7 dB;96 帧轨道 38.52 dB 无闪烁。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 剪枝输入的物体级渲染(fresh held-out 300 物体,28 视图,对未剪枝参考) | PSNR (dB) / SSIM / LPIPS | 38.08 / 0.9814 / 0.0113 | gsplat 光栅化同一剪枝输入:44.02 / 0.9954 / 0.0046 | 落后基线 5.94 dB(可行但未追平;masked PSNR 32.68 对 39.19) |
| 消融:投影位置 2D RoPE(1000 物体 harness) | PSNR (dB),对未剪枝参考 | 移除后 29.22 | 全部改动 34.42 | -5.20 dB(全尺度 -4.3 dB),是三项改动中最关键的 |
| 消融:patch 尺寸(1000 物体 harness) | PSNR (dB) | 改回 8×8 patch 后 31.37 | 全部改动(4×4 patch)34.42 | -3.05 dB(全尺度 -2.4 dB) |
| 消融:投影 footprint 注入 keys(1000 物体 harness) | PSNR (dB) | 移除后 32.71;加到 keys+values 35.10 | 全部改动(keys-only)34.42 | 移除 -1.71 dB(全尺度 -1.4 dB,300 物体全部变差);values 变体 +0.68 dB |
| 输入规模外推(40000 高斯输入) | PSNR (dB) 变化 | 模型 -3.1 dB | 光栅化 +4.6 dB | 训练规模外的密集输入反而伤害模型,佐证解码器瓶颈 |
| 训练配置外的相机(远相机 / 256 或 1024 分辨率) | PSNR (dB) | 24.09(远相机);约 33(分辨率变化) | 光栅化器几乎不受影响 | 模型只在单一训练配置内可靠 |
局限与改进
作者承认:质量仍差数 dB 且慢数百倍(275 ms 对 0.7 ms)、显存高;只覆盖从外部观察的单个物体,完整场景(相机在场景内)未解决,编码器全自注意力限制输入规模;只在单一相机配置(512×512、45° FOV、距离 1.15–2.45)内可靠,换配置就掉点而光栅化器不受影响;只用视角无关颜色,无法渲染球谐系数承载的视角相关效果、也不能重光照;输入准备(剪枝打分加 1500 步微调)本身仍用光栅化器,仅 20000 高斯以内的输入可跳过;绑死 RenderFormer 预训练权重、无法从头训练;训练耗 1327 GPU 小时。我的补充观察:误差分析显示 10% 强边缘像素承载 71% 平方误差,但非边缘区域落后光栅化更多(8.1 对 6.2 dB),说明低频结构也在丢失,指向解码器容量或训练时长问题;所有消融均为单次运行,仅用第二 seed 估计同配方方差 0.02 dB;评估 crop 以参考图亮度阈值定义,对比较有利;『解码器瓶颈』的诊断依赖短微调对照,更长训练后是否仍成立存疑。
独立分析的弱点
独立分析的弱点与改进方向:(1) 约 6 dB 质量差距加上数百倍时延,使模型当前没有实用价值——可尝试给解码器引入 tile 稀疏注意力并大幅延长训练,或用光栅化器输出做蒸馏;(2) 场景编码器全自注意力使时间随高斯数平方增长(640000 高斯需 75 秒、23.7 GB),限制了走向场景级——可用窗口注意力、线性注意力或分块编码;(3) 单一相机配置脆弱(远相机 24.09 dB、分辨率变化掉约 5 dB)——训练时随机化分辨率、FOV、距离应可修复,作者在三距离实验中已观察到类似改善;(4) keys+values footprint 明明更好(+0.68 dB)却因 40000 高斯输入下多掉 0.3 dB 被弃用——可对 footprint 特征做尺度归一化或在训练中加入密度增广;(5) 视角相关外观完全缺失——把球谐系数并入 token、仿照 RenderFormer-V2 加入光源 token,是实现重光照目标的前提;(6) 输入高斯数固定为 20000,更多高斯必须剪枝——可引入可变长度训练或 packing 机制。
未来方向
作者指出的方向:给每个高斯加材质参数并引入光源,让这类模型学习重光照与全局光照——这是引言里给出的最终动机;RenderFormer-V2/++ 已把 mesh、介质、光源统一进 learned renderer,高斯是下一块拼图;在训练中覆盖多分辨率、多 FOV、多距离配置;把 footprint 扩展到 values。基于本文成果可延伸:利用排序无关的神经渲染消除光栅化的 popping 伪影;利用渲染网络端到端可微做逆渲染与场景编辑;场景级渲染可借鉴分块场景 token 加局部解码器以绕开平方复杂度;以更大算力训练直接检验『欠训练 vs 解码器瓶颈』这一悬而未决的问题;与 feed-forward 高斯重建模型(GS-LRM、LVSM 类)串联,构成完全学习式、无手写渲染器的成像管线。
复现评估
复现条件较好但算力门槛高。代码、训练好的模型和演示视频已开源(项目页 svlwoof.github.io/gaussianrenderformer,GitHub 仓库 SVLwoof/gaussianformer);训练数据 Objaverse_Splats 公开在 HuggingFace,预处理规则(PSNR≥32 dB、LPIPS≤0.06、50000 高斯过滤;按 64 视图重要性分数剪枝到 20000 并微调 1500 步,每物体约 10 秒)描述明确;评估协议(crop 定义、28 视图、三指标、masked PSNR)与消融 harness(1000 物体、短版 Stage 3/4、各臂完整数字、同配方双 seed 方差 0.02 dB)交代充分。主要障碍是算力:最终模型训练 1327 GPU 小时、8 卡约 79 万步,单卡复现不现实;合理路径是先复现 1000 物体 harness 验证方向性结论,再决定是否投入全量训练;另一风险是作者明言改动 RenderFormer 预训练部分极易破坏,复现新改动时应坚持零初始化叠加。
论文图表
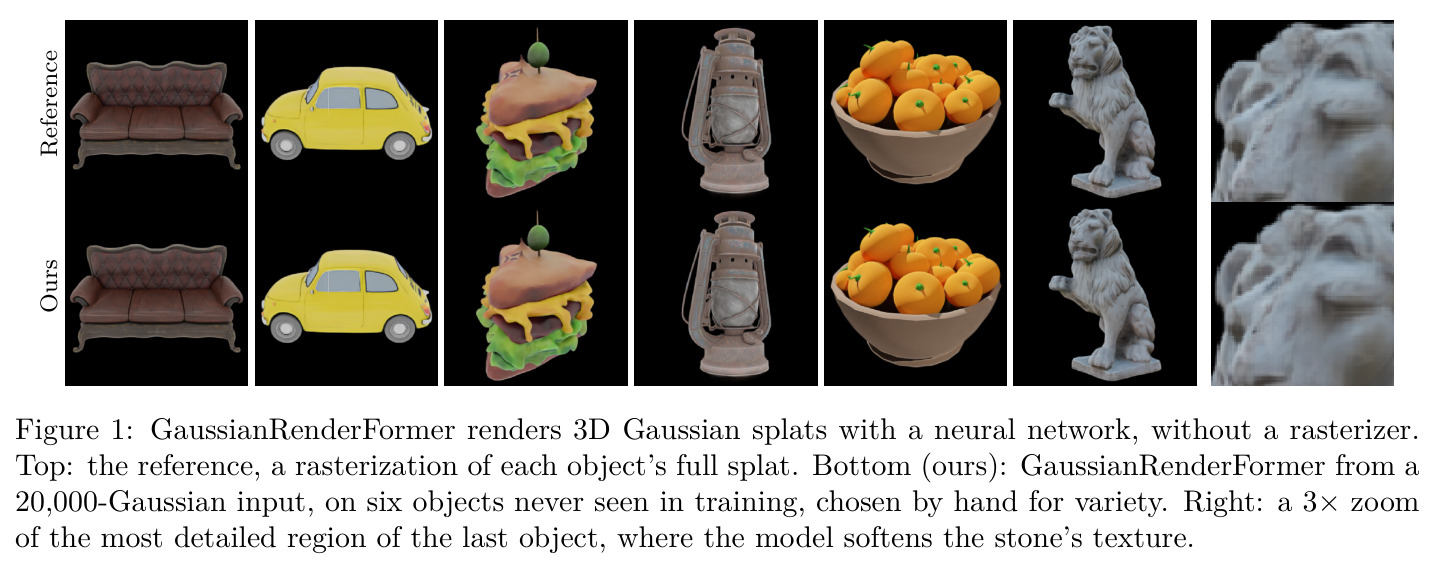
上排为参考图(每个物体完整 splat 的光栅化),下排为 GaussianRenderFormer 从 20000 高斯输入得到的渲染,覆盖六个训练中从未见过的物体;右侧是对最后一个物体最精细区域的 3 倍放大,可见模型把石头纹理变柔。
一眼建立对全文的直觉:网络确实能不靠光栅化器渲染高斯,也能立刻看到它在细纹理上的软化倾向,是理解『可行但有差距』结论的入口。