HERIT:缓解时间偏差,实现汉文史料的英译全球开放获取 HERIT: Enabling Global Access to Hanja-to-English Historical Translation by Mitigating Temporal Bias
用RAG伪标注汉韩语料并两阶段微调,缓解时间偏差,实现汉文史料大规模自动英译
前置知识
汉文(Hanja)史料
朝鲜王朝(14世纪末至20世纪初)官方文献以汉字文言书写,即汉文。单字语义密度高,且存在朝鲜半岛特有用法:人名、地名按韩语发音转写而非中文读音,部分汉字词义与中文分化(如"房子"在朝鲜语境指宫女)。《朝鲜王朝实录》(AJD)与《承政院日记》(JRS)是其中最重要的两部,跨越500余年。
全文的问题设定与方法设计都围绕汉文的字形、语义与专名音译特性展开;不理解汉文与中文的差异,就无法理解为何中英翻译模型不能直接套用。
检索增强生成(RAG)
推理时先用嵌入模型从外部知识库检索与输入相关的样本,拼入提示词作为少样本示范,从而注入模型预训练/微调时未见的领域知识。本文用Gemini-Embedding从汉韩英平行语料库检索最相似的三元组,作为Proposer与Fusor的动态示例。
RAG是伪标注管线和对比基线的核心组件,论文关于检索查询语言、few-shot数量的消融实验都围绕它展开。
上下文少样本学习(In-Context Learning)
LLM无需梯度更新,仅凭提示词中的输入-输出示例即可学会新任务。示例可以是固定选取的(static shots),也可按输入动态检索(dynamic shots),后者因示例更相关通常收益更大。示例数量存在性能-成本权衡。
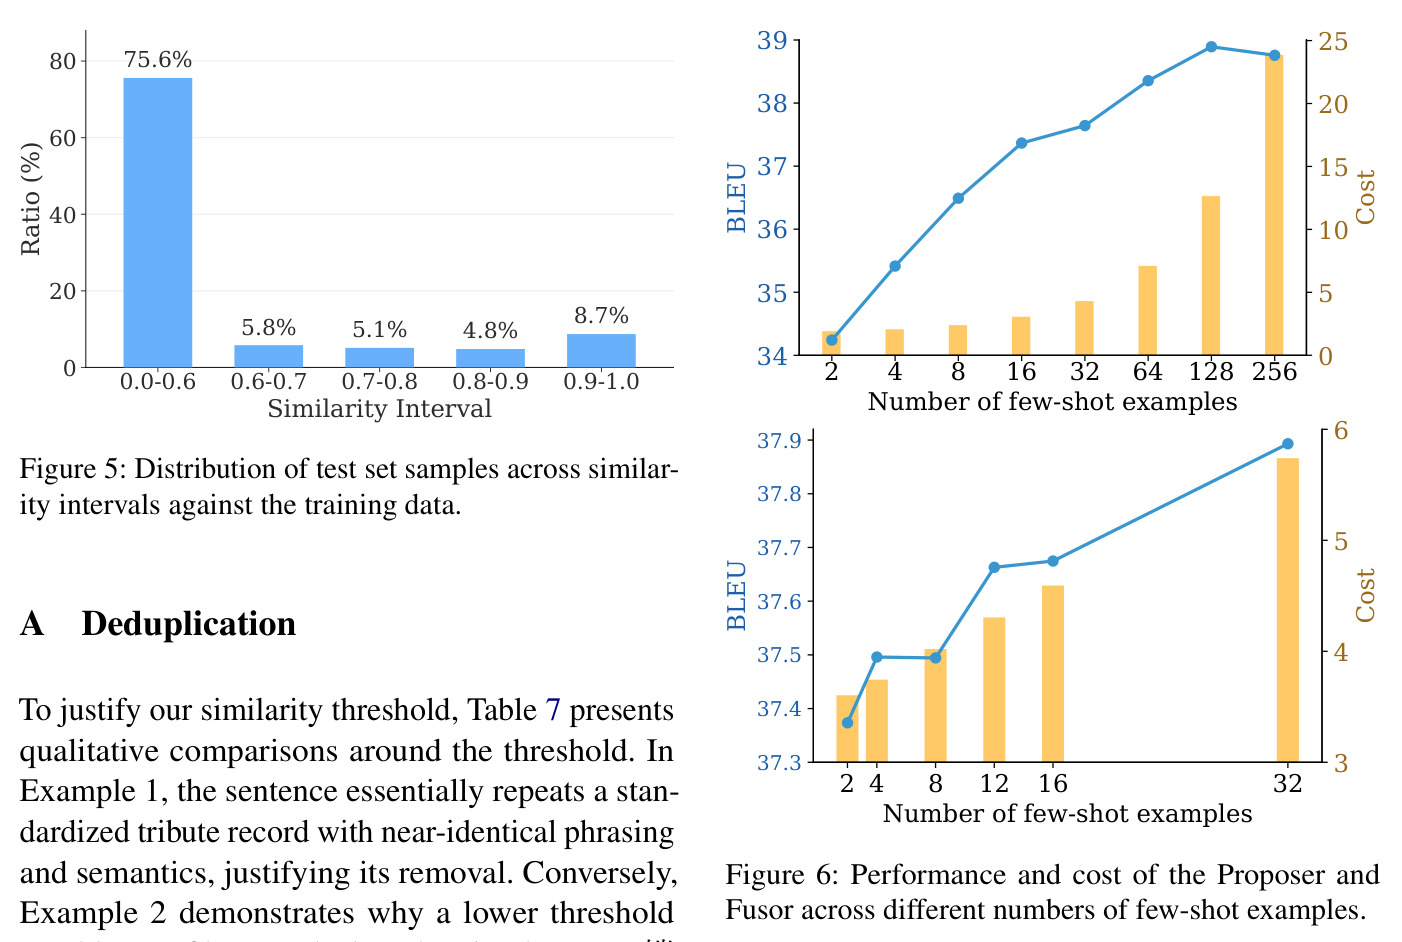
伪标签质量直接取决于给Proposer(64-shot)和Fusor(12-shot)的示例数量与相关性,Fig. 6的选型实验建立在对ICL的理解之上。
FusioN 与 Best-of-N(BoN)
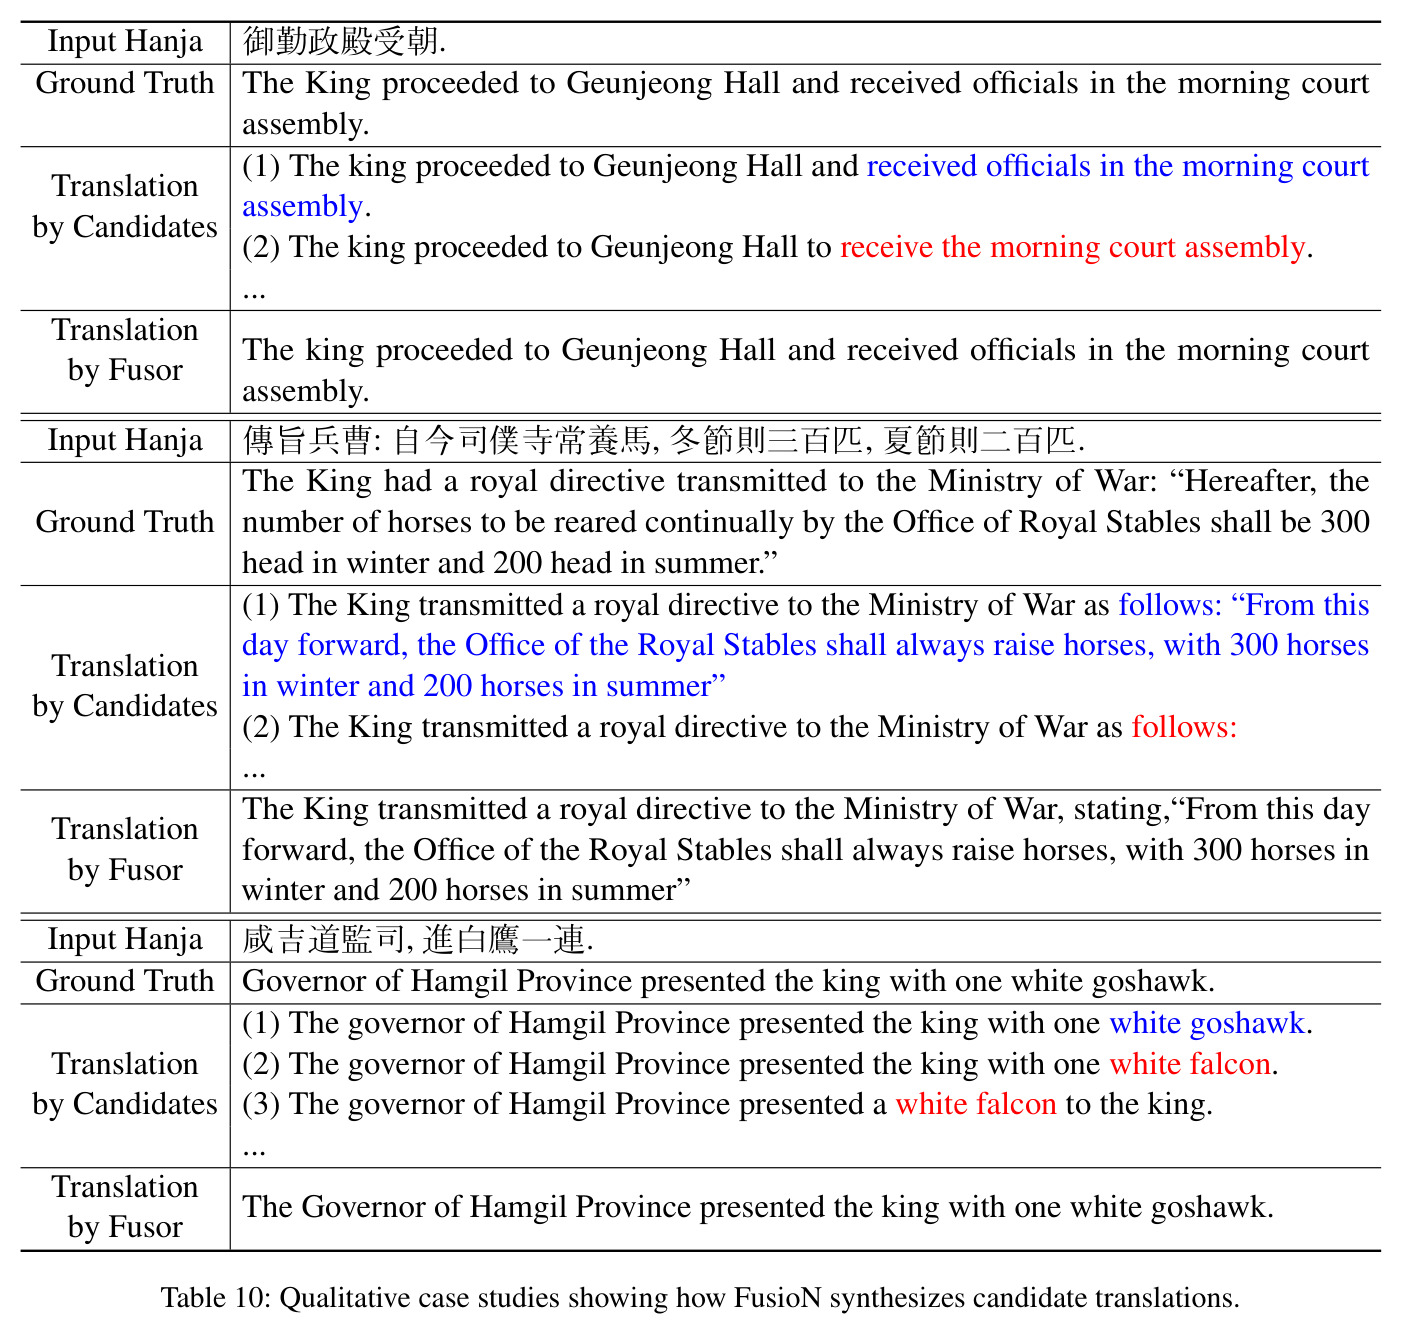
多候选聚合策略:BoN生成N个候选后只挑最好的一个;FusioN则由一个Fusor模型读取全部候选草稿,融合各草稿中正确的片段合成一个更优的最终输出。融合优于挑选,因为它能综合互补信息并过滤残缺候选的噪声。
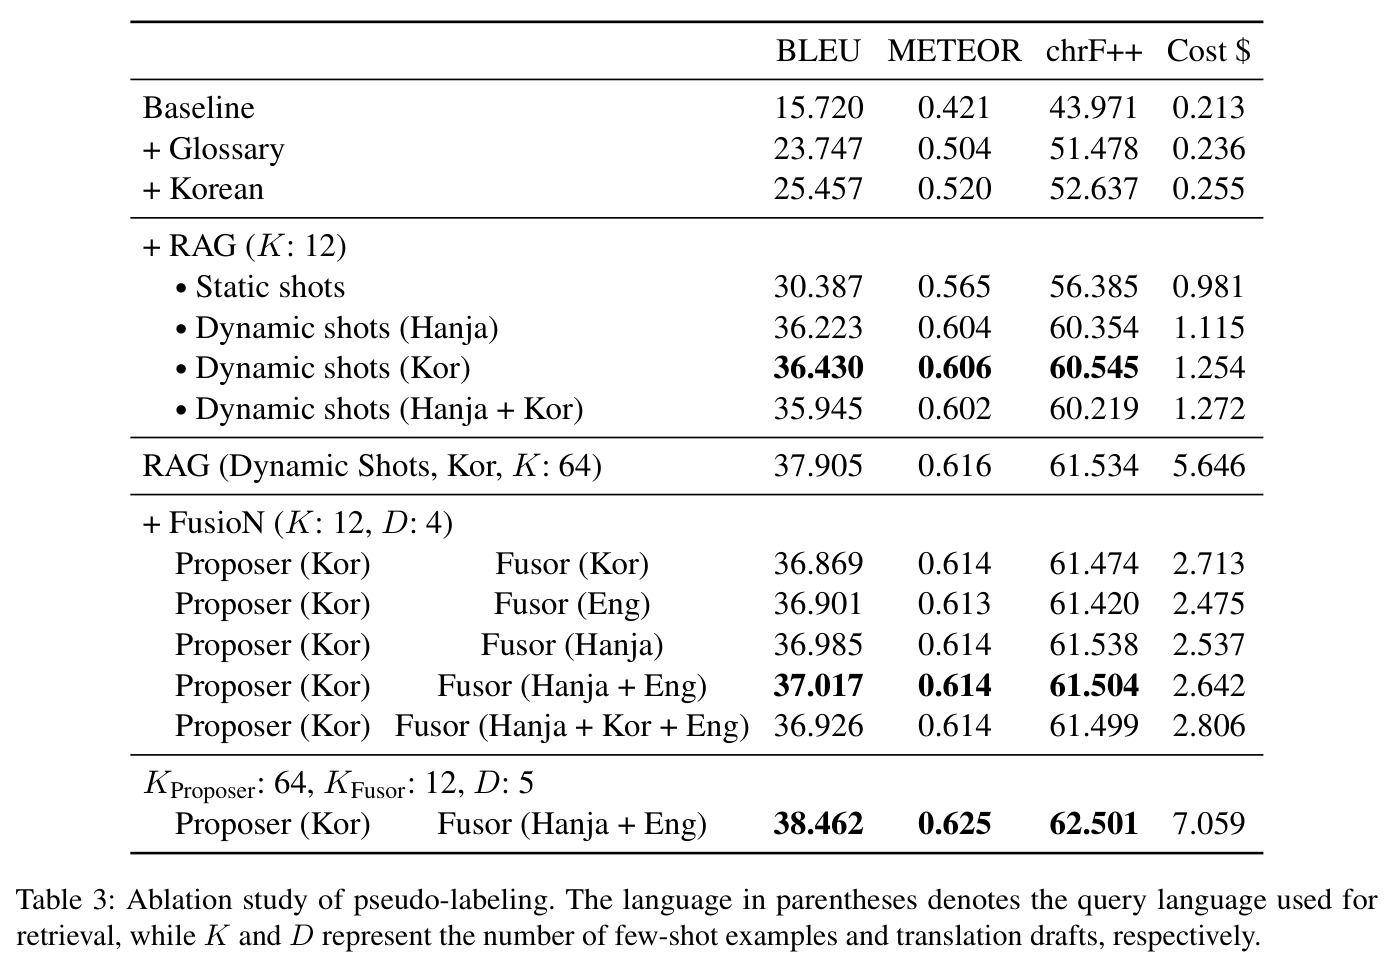
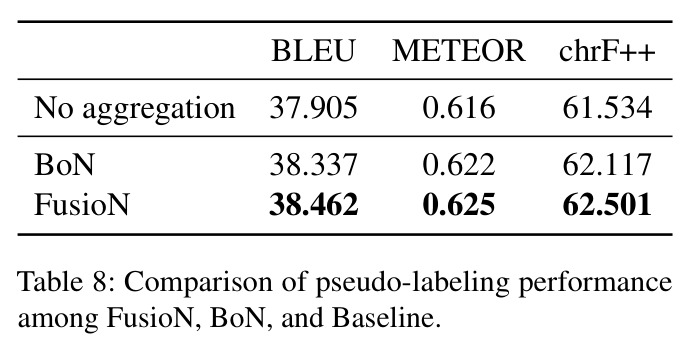
FusioN是本文伪标注管线的最后一环,直接决定伪标签质量(BLEU 38.462 vs BoN 38.337),是看懂消融实验的关键。
时间偏差/时间过拟合
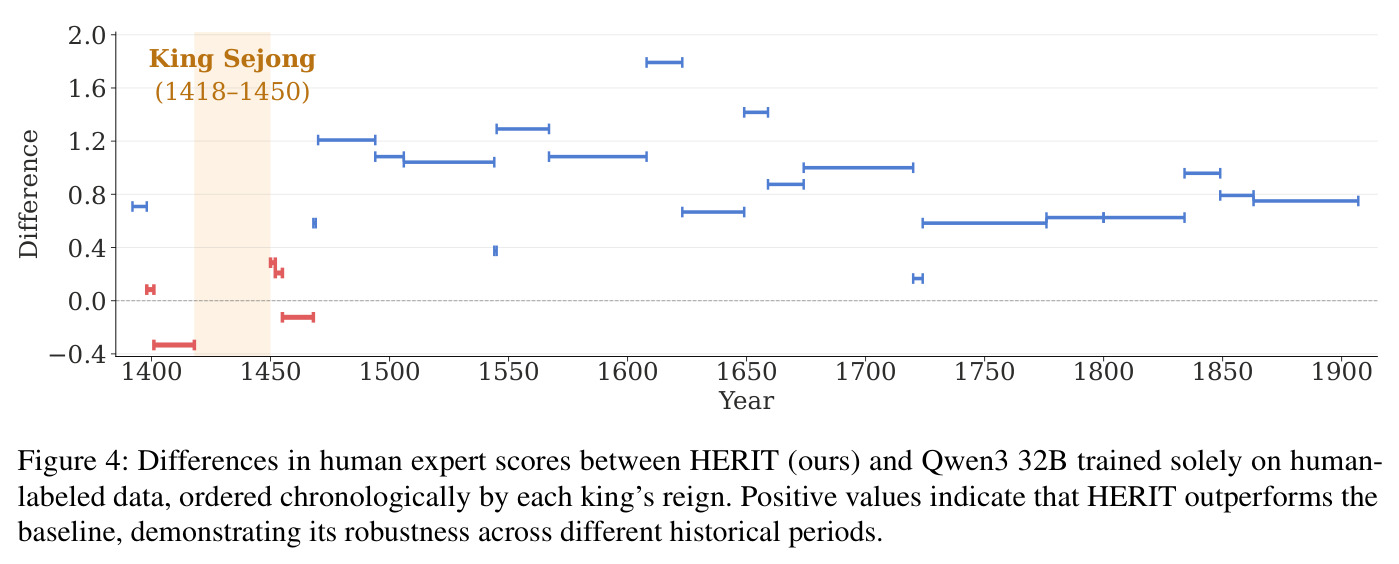
训练语料集中于个别历史时期(本文人工标注的汉英数据几乎全部来自世宗大王1418-1450年在位期间),导致模型只在该时期的文体、官职与事件模板上表现好,对其他朝代泛化能力差。这是历史文献机器翻译特有的分布偏移问题。
这是论文标题的核心问题:Fig. 4按朝代逐一展示HERIT相对基线的优势正来自缓解了该偏差,DtestNT测试集的构造也是为了检验它。
BLEU / METEOR / chrF++
机器翻译自动指标:BLEU衡量n-gram精确匹配率,对形态变化和短文本敏感;METEOR引入同义词与词干匹配;chrF++计算字符级n-gram的F值并加入词边界信息,对语序变化和拼写变体更稳健。本文三者并用。
所有主实验表都用这三个指标;汉英差异大使BLEU绝对值偏低,知道各指标大致范围才能正确解读38.462、62.525这类数字的含义。
两阶段微调
先在大量伪标签数据上训练第一阶段(学习领域知识与音译模式),再在少量人工标注数据上继续训练第二阶段(对齐人工翻译风格),每阶段单独设置学习率与epoch。相比混合训练,可避免大数据集淹没小数据集的失衡问题。
这是HERIT的最终训练方案($D_{aug} \to D_{train}$),Table 4/5证明它优于单数据集和混合训练,是理解主结果的钥匙。
LLM-as-a-Judge
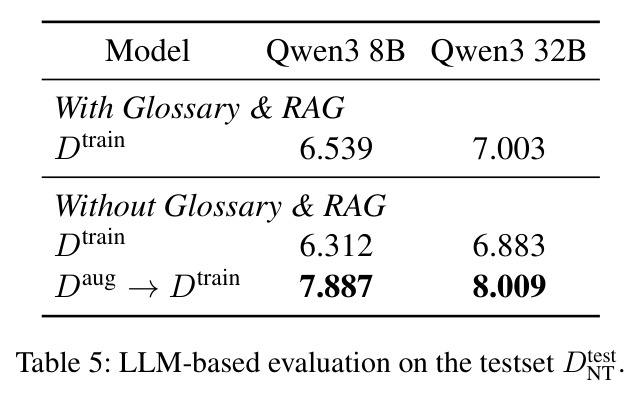
用强LLM按给定评分标准为模型输出打分或做成对偏好判断,替代昂贵的人工评估。本文用Sonnet-4.6在1-10分量表上评估未见朝代测试集DtestNT,并向评委提供人工韩文译文和术语表作参照以降低偏见。
DtestNT没有人工英文参考译文,只能依赖LLM评估;理解其评估协议才能判断Table 5结果的可靠性与局限。
研究动机
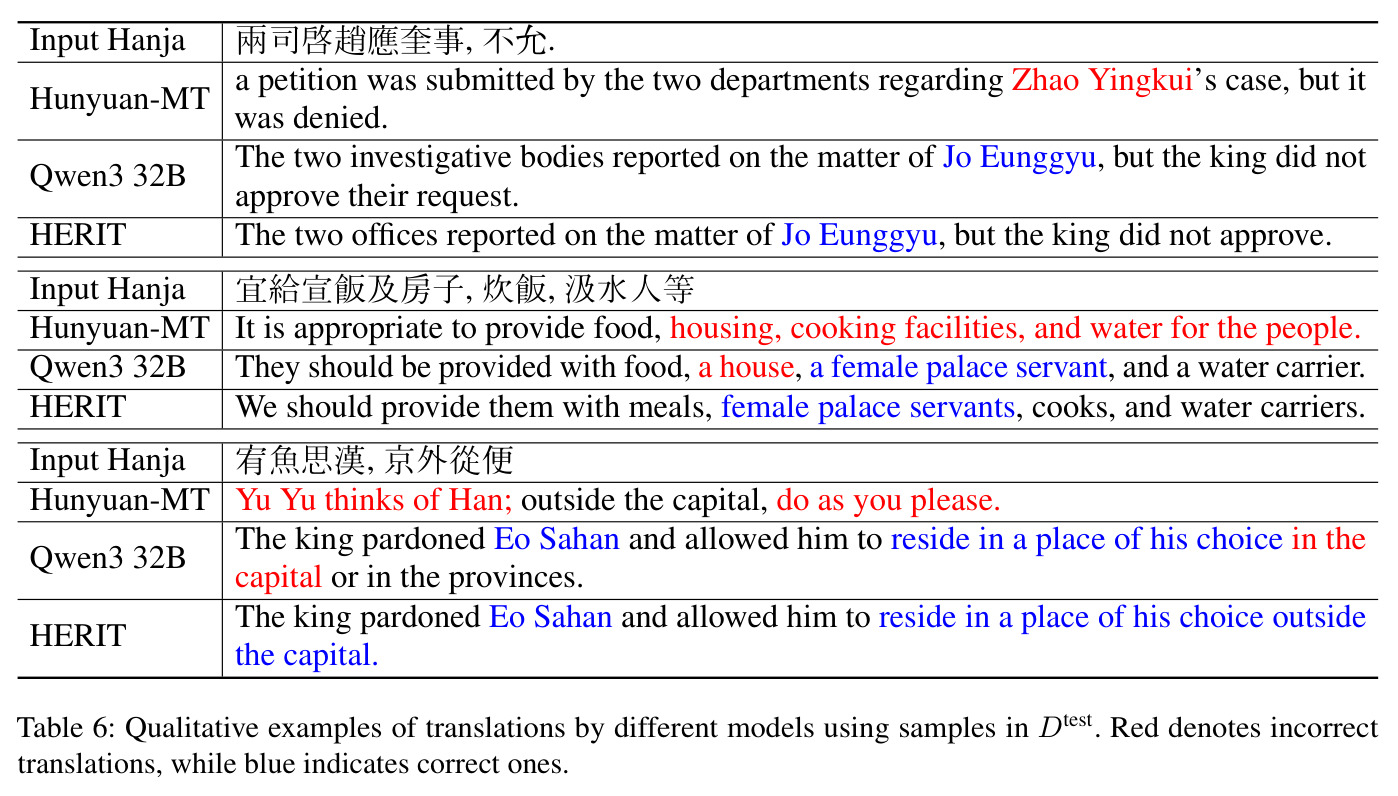
《朝鲜王朝实录》(AJD)与《承政院日记》(JRS)跨越500余年,记录政务、天象、地震、饥荒、疫病等,是全球社科与自然科学研究的重要史料,但以汉文写成,语言壁垒使其难以被国际学界利用。人工英译代价惊人:韩国国史编纂委员会的实录英译项目预计耗时22年、预算约2000万美元,目前仅完成世宗大王时期约2.5%的记录;而体量为实录5倍的承政院日记更加遥遥无期。因此现有人工汉英平行语料极度稀缺(仅1.77万条三元组)且严重偏向世宗年间。直接使用中英LLM也不可行:其一,中文模型用简体字,与韩式汉字(繁体)字形不兼容;其二,同形字语义分化,如"房子"在标准中文指房屋、在朝鲜语境指宫女;其三,汉字词序偏离标准中文语法;最致命的是专名音译按中文发音(如Zhao Yingkui)而非韩语发音(Jo Eunggyu),直接引入事实性错误。
本文的目标是本文要构建一套系统性的领域适配流水线,训练一个专门面向朝鲜王朝史料的汉文→英文端到端翻译模型,同时攻克两大难题:(1)人工标注汉英平行数据极度稀缺且昂贵;(2)数据时间分布不均导致的对特定朝代的过拟合。具体目标包括:为约31.7万条仅有汉韩对照的未翻译条目自动生成高质量英文伪标签;将伪标签与人工标注结合训练出超越旗舰LLM少样本表现的模型;最终用该模型翻译实录与承政院日记中剩余的209万条未翻译文档,以远低于人工的成本(对比22年/2000万美元)向全球研究者开放这些史料,并公开模型与译文语料。
与已有工作不同的是,本文的独特切入是不把汉英翻译当孤立问题,而是利用"汉→韩人工翻译已完成35万对"这一丰富中间资源:通过检索增强的in-context学习加FusioN候选融合,把汉韩对自动转化为汉英对,将稀缺的汉英监督信号放大约20倍(1.57万→31.5万)。与音译式pipeline(汉→韩→英)不同,伪标签直接监督汉→英目标,训练出的模型避免推理时的两级错误传播;与训练和推理都带RAG的方案不同,HERIT把外部知识蒸馏进模型参数,推理时无需检索、上下文不膨胀。此外,本文首次把"时间偏差"作为历史文献机器翻译的一等问题明确提出,专门构造了按朝代分层、每王80条、严格排除出训练的未见测试集DtestNT来度量泛化,而此前的Hanja翻译工作(如H2KE)均未考虑这一维度。
核心方法
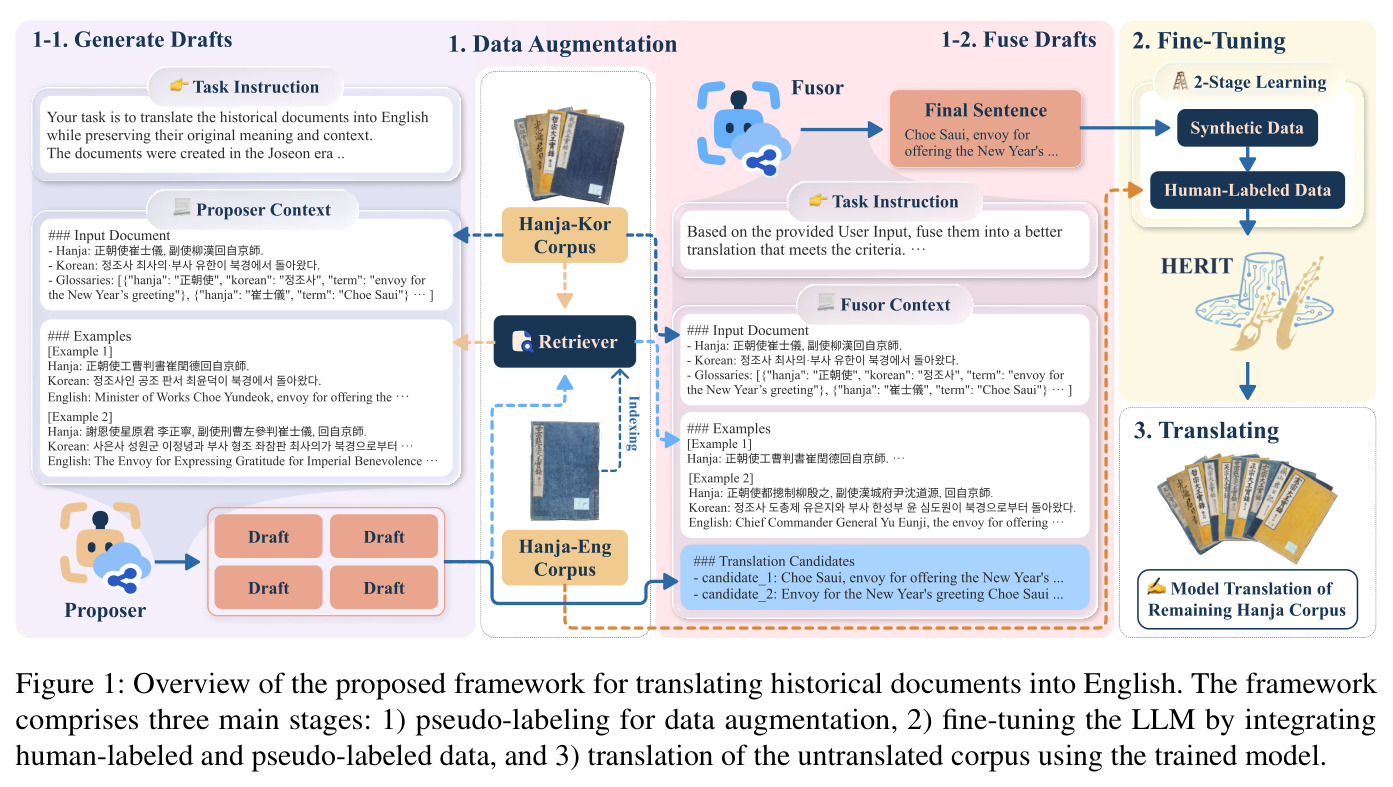
直觉上:既然汉→韩数据丰富而汉→英稀缺,就让LLM充当"翻译教师",借助韩文对照、术语表和检索到的相似例句,把35万条汉韩对"改写"成汉英对,再用这些伪标签加少量人工标注微调开源LLM。技术路线分三步(Fig. 1):第一步伪标注,Proposer以64个动态检索的汉韩英三元组为示范、输入汉文原文+韩文译文+命中的术语表、以温度0.3生成5个英文草稿;Fusor再以12个检索示例为参照,将草稿与原文融合为最终伪标签,全程约3000美元API成本,构建31.5万条伪标签集$D_{aug}$(剔除世宗时期数据)。第二步两阶段微调Qwen3-32B:先在$D_{aug}$上学习汉文语义与专名音译模式,再在人工标注的$D_{train}$上对齐人工翻译风格。第三步用训好的模型翻译剩余209万条未翻译的实录与承政院日记文档。
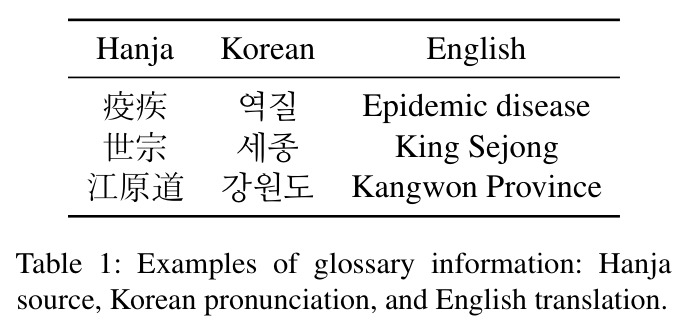
核心创新有三层。第一,Proposer-Fusor双角色伪标注架构:Proposer并行生成多个草稿,Fusor通读全部草稿、原文与术语表后做"融合"而非"挑选"(区别于Best-of-N),实验显示融合比挑选多0.125 BLEU、比无聚合多0.557 BLEU。第二,多重辅助信息增强:给LLM同时提供韩文译文(弥补其对汉文理解不足)、来自国史编纂委员会词库的2.5万条汉-韩-英术语表(保证专名按韩语发音英译)、检索到的相似三元组,消融显示术语表把BLEU从15.72拉到23.75,加韩文输入到25.46,RAG动态64-shot到37.91。第三,两阶段课程训练:先用31.5万伪标签学汉文语义与音译,再用1.57万人工标注对齐风格,缓解大小数据集失衡——混合训练反而降到36.85 BLEU。这一设计同时是缓解时间偏差的机制:伪标签覆盖除世宗外的所有朝代。
方法步骤详情
完整流程如下。(1)数据构建:从国史编纂委员会获取实录,整理35万汉韩对与1.77万汉韩英三元组;划分$D_{train}$ 1.57万、$D_{valid}$/$D_{test}$各1000条;另按每王80条采样2080条$D_{testNT}$并严格排除出伪标注与训练;用BM25+归一化Levenshtein相似度阈值0.9防泄漏去重;整理2.5万条术语表。(2)骨干选型:在$D_{test}$上以BLEU/chrF++和API成本评估各LLM,Gemini-2.5-Flash性价比最优,任Proposer与Fusor。(3)伪标注:Gemini-Embedding检索,Proposer用韩文查询(嵌入模型韩语语料更多),Fusor用汉文+英文草稿联合查询。(4)训练:Qwen3-32B两阶段各1 epoch,学习率$1\times10^{-5}$到$5\times10^{-6}$,batch 64到16,PagedAdamW 8-bit加FSDP,8×H200共16.3小时;序列上限2048 token/800汉字。(5)推理:翻译209万条未翻译文档,94.6小时完成。
技术新颖性
新颖性体现在四个层面。问题层面:首次将"时间偏差"提升为历史文献机器翻译的一等公民问题,设计按朝代分层的评估协议(每王80条的$D_{testNT}$与按年代排序的Fig. 4逐王差异图),此前的Hanja翻译研究(Son et al. 2022的H2KE等多语模型)只报告整体指标。方法层面:将FusioN从通用生成任务迁移到低资源历史翻译的伪标注场景,并系统研究检索查询语言(韩文查询优于汉文查询,因嵌入模型见过的韩语语料更多)、草稿数量、few-shot数量等设计维度,给出可复用的配置结论。工程层面:实证表明"蒸馏进参数"优于"训练+推理都带RAG"——后者上下文膨胀到8K token以上(输入提示长度的13-14倍)、训练算力9倍,而HERIT无检索推理且性能更高。经济层面:约3000美元API成本换取31.5万伪标签,使8×H200上16小时的微调在$D_{test}$上超过GPT-5.1、Gemini-2.5-Pro等旗舰模型的相关配置。
实验结果
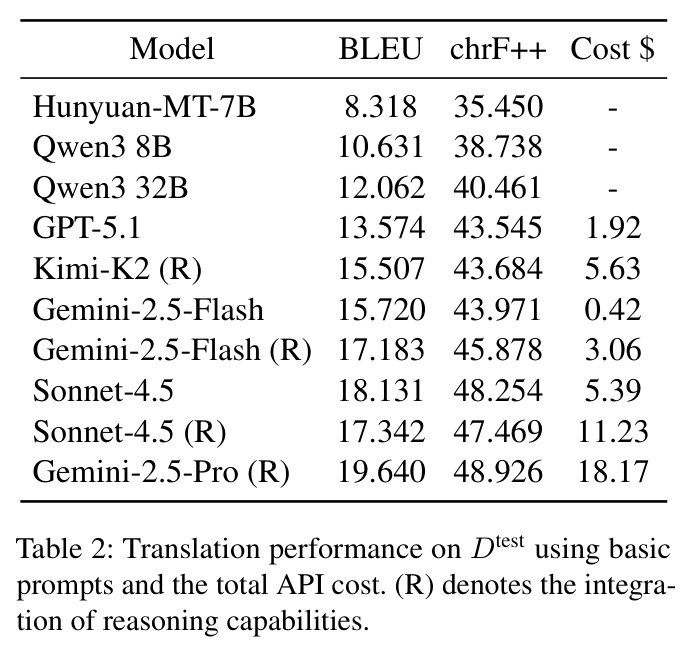
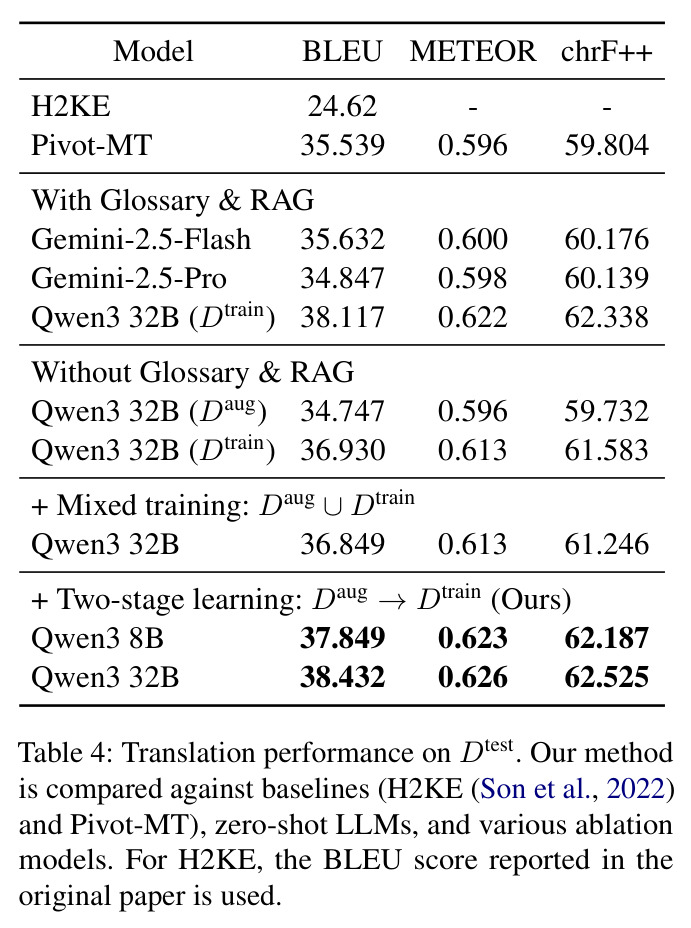
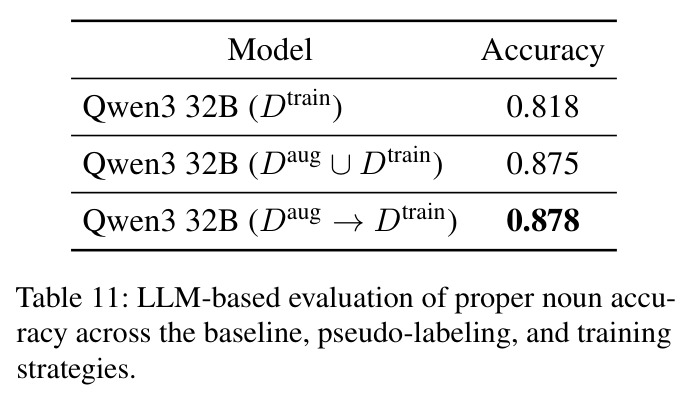
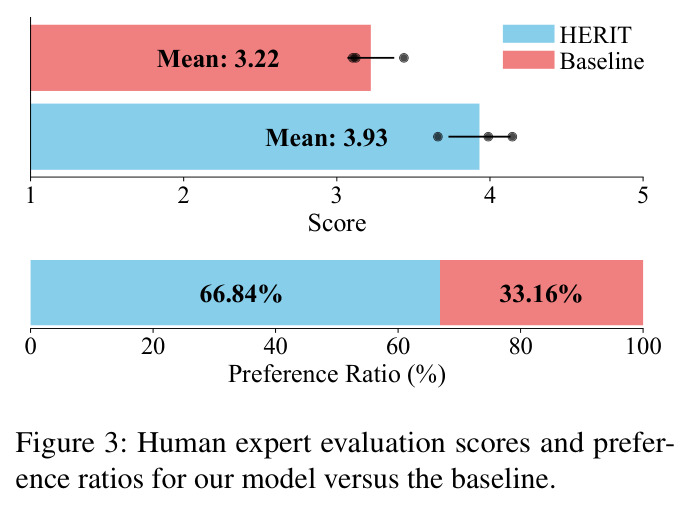
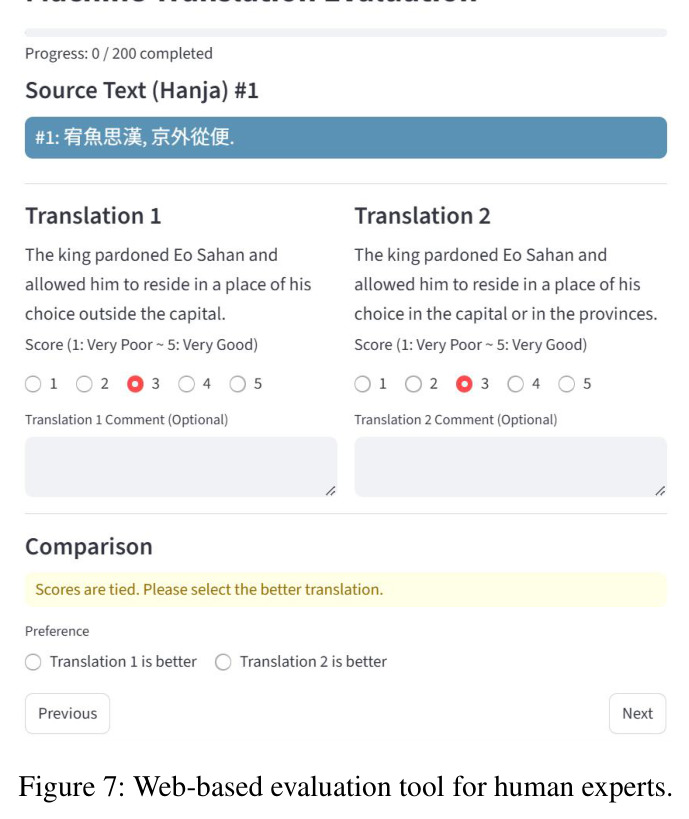
逐实验看:(1)骨干选型(Table 2):中文MT强模型Hunyuan-MT-7B仅8.318 BLEU,中文能力不可迁移;选性价比最优的Gemini-2.5-Flash(15.720 BLEU)做伪标注骨干。(2)伪标注消融(Table 3):术语表把BLEU从15.720提到23.747,加韩文输入到25.457,RAG动态shot到37.905,最终FusioN达38.462 BLEU/62.501 chrF++;BoN(38.337)劣于FusioN,五旗舰混做Proposer反更差更贵。(3)主结果(Table 4):HERIT达38.432 BLEU/62.525 chrF++,超Pivot-MT(35.539)2.89、超H2KE(24.62)13.8、超带RAG的Gemini-2.5-Flash(35.632);混合训练掉到36.849,验证两阶段必要性。(4)未见朝代泛化(Table 5):两阶段32B得8.009对7.003(1-10分),带RAG推理仍不及且需8K+上下文、9倍算力。(5)人工评估(Fig. 3):均分3.93对3.22,偏好66.84%对33.16%。(6)专名准确率(Table 11):0.878对0.818。(7)Fig. 4:基线仅世宗年间持平,其余朝代全面落后。(8)209万条94.6小时译完;Table 6显示HERIT纠正音译、"房子=宫女"等典型错误。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 汉文→英文翻译(实录测试集 Dtest) | BLEU | 38.432 | Pivot-MT 35.539 | +2.893(约+8.1%) |
| 汉文→英文翻译(Dtest) | chrF++ | 62.525 | Pivot-MT 59.804 | +2.721 |
| 对比已有Hanja多语模型(Dtest) | BLEU | 38.432 | H2KE(Son et al., 2022)24.62 | +13.81 |
| 零样本LLM+术语表+RAG(Dtest) | BLEU | 38.432 | Gemini-2.5-Flash 35.632 / Gemini-2.5-Pro 34.847 | +2.80 / +3.59 |
| 未见朝代泛化(DtestNT,LLM 1-10评分) | LLM评分 | 8.009(Qwen3-32B两阶段) | 仅人工数据训练 7.003 | +1.006(约+14.4%) |
| 专家人工评估(200条,1-5分,双盲) | 平均分 | 3.93 | 3.22(Qwen3-32B仅Dtrain) | +0.71(约+22%) |
| 专家成对偏好选择 | 偏好率 | 66.84% | 33.16% | 超过基线2倍 |
| 专有名词音译准确率(Dtest,LLM评估) | Accuracy | 0.878 | 0.818(仅Dtrain) | +0.060(约+7.3%) |
局限与改进
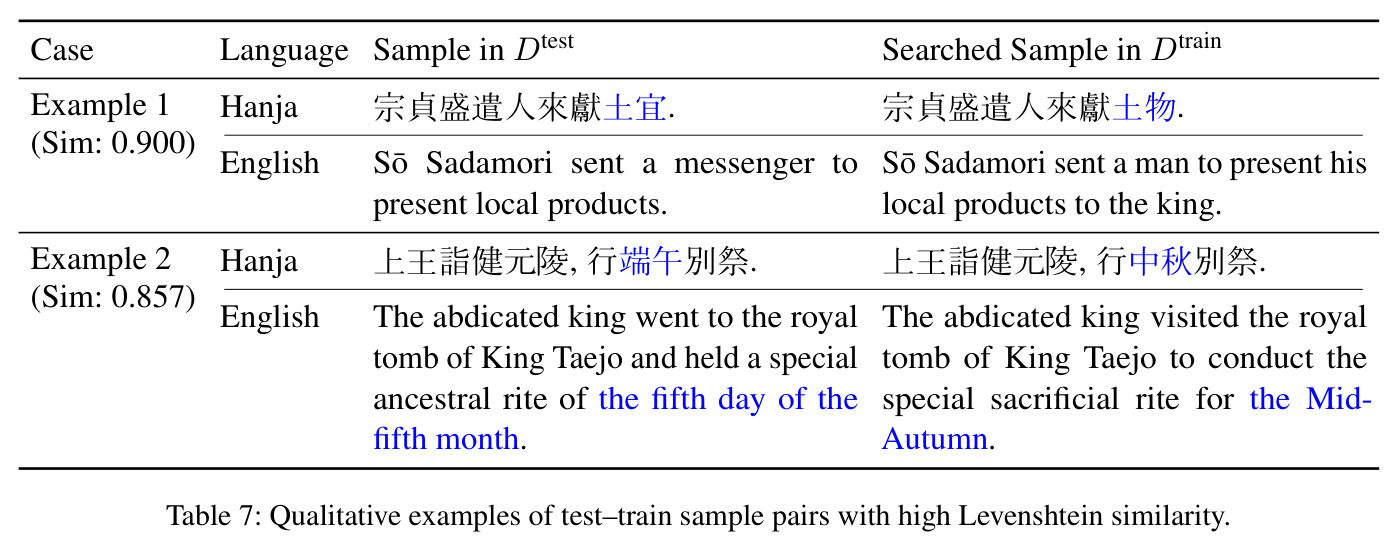
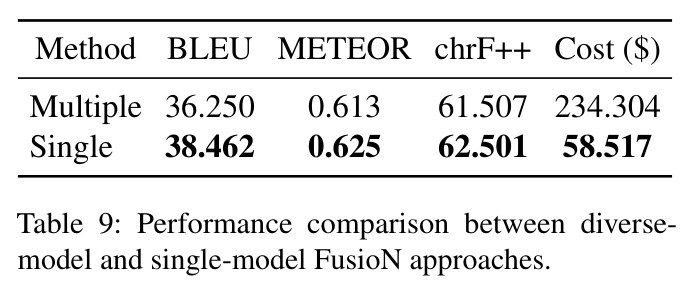
作者承认的局限:(1)预算限制使Proposer/Fusor只用Gemini-2.5-Flash单模型,未探索多样化LLM增加草稿多样性;(2)伪标注仅覆盖AJD文档,未把JRS纳入伪标注目标;(3)硬件限制序列长度2048 token/800汉字,约6.7%训练数据被过滤,超长文档推理需分块。我自己的观察:(4)所有定量评估都限于实录(AJD),模型虽被用于翻译承政院日记,但对JRS译文没有任何人工或自动评估,跨档案泛化是未验证的主张;(5)$D_{testNT}$评估完全依赖Sonnet-4.6打分,评委会偏见只靠提供韩文参照部分缓解,缺少人工金标校准,也未报告评分方差;(6)伪标签质量上限受Gemini-2.5-Flash自身汉文能力制约,其系统性错误会写入$D_{aug}$并在蒸馏中被继承,文中未估计伪标签噪声率;(7)按条目独立翻译且800字截断,破坏跨条目的指代与叙事连续性;(8)BLEU型指标只覆盖有人工参考的世宗时期,其他朝代的泛化主张主要靠LLM评分与少量专家样本支撑。
独立分析的弱点
(1)伪标注单骨干依赖:31.5万伪标签全部出自同一模型,系统性错误会被蒸馏放大;改进方向是对伪标签做一致性投票或置信度过滤,只保留高质量样本,或仅对困难样本调用多模型融合以控制成本。(2)篇章级翻译缺失:逐条翻译、800字截断,无法解析跨条目指代、保证全书专名译名统一;改进方向是引入滑动窗口上下文或翻译记忆机制,并在解码层强制术语表一致性。(3)评估覆盖不完整:JRS译文零评估、BLEU仅覆盖世宗时期;改进方向是对JRS抽样建立小型金标,组织多朝代分层的人工评估。(4)时间偏差只在AJD内部验证:对更早期(高丽)或更晚期(19世纪开化期)文体的适应性未知;改进方向是构造跨朝代/跨档案的对抗测试集并报告逐时代指标。(5)去重阈值0.9为人工选定,虽有Table 7案例辩护,但依赖"行政公文高度模板化"这一AJD特有性质,迁移到其他档案未必成立;改进方向是补充语义相似度与实体级匹配。(6)两阶段学习率与1 epoch设置未做敏感性分析,$D_{aug}$可能欠训练;改进方向是扫描学习率与epoch组合并报告训练动态。每个弱点都指向明确的可控实验,适合后续工作逐项补齐。
未来方向
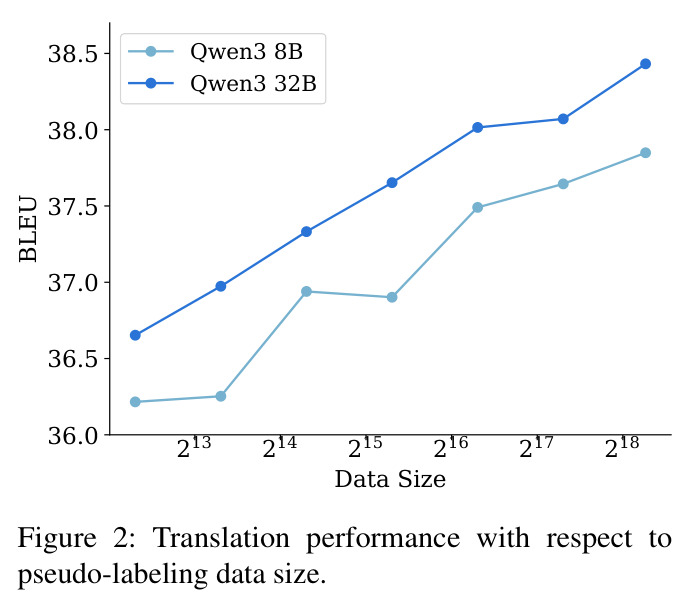
作者提出的方向:(1)用更多样的LLM担任Proposer以提升伪标签多样性;(2)把JRS文档纳入伪标注目标;(3)扩展最大输入长度以减少截断损失。基于本文成果可延伸的方向:(1)将该流水线推广到其他拥有丰富"古典语→现代语"平行语料但缺古典语→英语直接翻译的古典语言,如文言文、拉丁文、古典日文等——作者在结论中明确点了这一愿景;(2)构建朝代感知的检索器与风格自适应生成,按在位时期切换few-shot池,进一步压缩时间偏差;(3)用已翻译的209万条语料做自我训练迭代:高置信译文再经人工校对后回流训练集,形成数据飞轮;(4)研究伪标签质量自动评估(如用LLM为伪标签打分筛选),替代当前全量接受策略;(5)8B模型已达37.849 BLEU,可进一步蒸馏到更小规模并做量化,服务地方研究者与边缘设备;(6)与实体链接、事件抽取、时间线构建等下游数字人文任务打通,让全球研究者直接消费结构化历史数据,而不只是译文。这些方向都不需要新的根本性技术,属于清晰可执行的增量研究。
复现评估
复现条件总体友好:模型与数据已在GitHub开源(dandamdandam/HERIT),实录语料可从国史编纂委员会官网获取,附录E完整公开三类提示模板,附录B给出全部训练超参(学习率$1\times10^{-5}$/$5\times10^{-6}$、batch 64/16、PagedAdamW 8-bit、FSDP、各1 epoch)。算力与成本:伪标注API约3000美元(Gemini-2.5-Flash批量API),训练在8×H200上约16.3小时,209万条推理94.6小时——中等规模实验室均可负担。难点:(1)2.5万条术语表依赖NIKH词库,迁移到其他领域需自建等价资源;(2)去重与$D_{testNT}$划分的随机细节未完全说明,指标可能小幅波动;(3)H200不易获得,换A100需等比拉长时间;(4)LLM评估协议(Sonnet-4.6、1-10分)需自行实现且方差未报告。总体难度中等偏高:工程链路长(数据清洗、检索索引、两阶段训练、批量推理),但每一步都有公开可替换的组件,复现主结果可信度较高。
论文图表
直方图:$D_{test}$与$D_{train}$间最大Levenshtein相似度的分布,75.6%的测试样本相似度不超过0.6,0.9边界附近无明显聚集,说明测试集与训练集隔离良好。
为去重阈值0.9的合理性和"性能提升非模板记忆"提供数据支撑,是评估可信度的基础。
基线模型使用的提示词模板全文:系统提示定义任务(翻译朝鲜时代汉文文献)、指南与JSON输出格式;用户提示包含few-shot示例、汉文输入与命中的术语表。
保证零样本LLM基线可比性与结果可复现性,也是理解RAG基线输入构成的参考。
Proposer提示模板全文:与基础提示的区别是输入文档同时包含汉文原文、人工韩文译文和术语表,few-shot示例为(汉、韩、英)三元组。
展示"韩文桥梁+术语表"两大增强信息如何实际进入提示词,是复现伪标注的关键材料。
Fusor提示模板全文:系统提示定义草稿融合任务,用户输入包含示例、原文、韩文、术语表、翻译指令(继承自Proposer)和多个翻译候选(Translation Candidates),并给出三步融合流程。
完整公开FusioN融合环节的实现细节,与Figure 9配对构成伪标注管线的全部提示词。