视频生成背后的多模态理解:来自可灵(Kling)的观察与洞见 Behind Video Generation: Observations and Insights on Multimodal Understanding from Kling
视频生成质量是多模态理解沿数据-条件-对齐-评估全链路的投影,可灵分享全栈工程经验
前置知识
DiT(Diffusion Transformer,扩散Transformer)
当前视频生成的主流架构:先用 VAE 把视频压缩到潜空间并切分为 token 序列,再用 Transformer 通过去噪目标学习从随机噪声到视频的逆向映射;文本等条件通常经注意力机制注入各层。其训练样本量远小于语言模型预训练,因此每条训练视频携带多少监督信息至关重要。
全文的"生成器"就是 DiT,caption、PE、TE、RM 所有模块的设计都以"DiT 能消费什么条件、对什么分布敏感"为出发点;"描述密度决定数据效率"这一核心论断直接源于 DiT 训练数据远少于 LLM 的事实。
MLLM(多模态大语言模型)
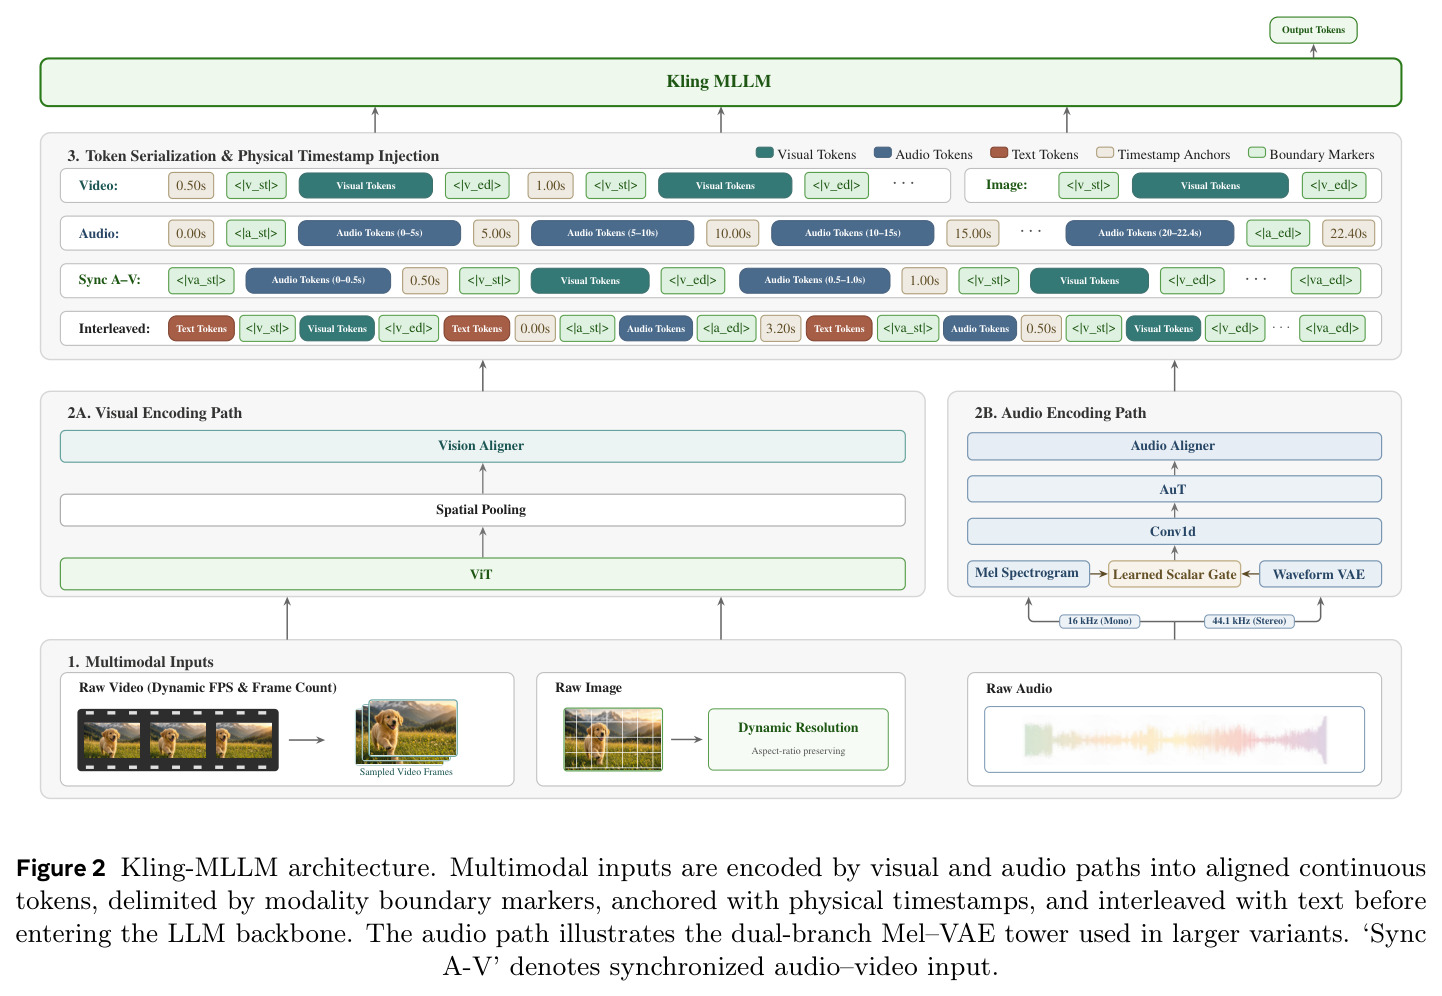
把文本、图像、视频、音频乃至音视频同步流统一编码为 token 序列,交给同一个自回归 LLM 骨干处理,从而用单一模型完成描述、问答、推理等任务的模型。Kling-MLLM 提供 27B 稠密与 35B-A3B、397B-A17B 两个 MoE 规格(总参数量-每token激活量),从 Qwen3.5–Qwen3.8 家族初始化。
本文的 captioner、RGC、PE、文本编码器、奖励模型与评估器全部由同一个 Kling-MLLM 基座后训练而来,"一基座多专家"是理解全文架构的前提。
文本条件接口(TE 与 prefill 隐藏态)
文本编码器 $\Phi_\theta$ 只对 prompt 做一次 prefill 前向,输出逐 token 隐藏态序列 $H_{\text{cond}}$,DiT 全程只通过注意力消费该序列($H_{\text{cond}} = \Phi_\theta(c)$,$b_v = G_\phi(H_{\text{cond}}, \epsilon)$),从不"读"文本本身。因此 QA 基准(测自回归解码)与检索指标(测池化单向量)都与 DiT 的实际用法结构性错配。
第六章的核心论点——好的 TE 要靠序列级探针评估、感知适配与多层稳定融合——全部建立在对这个接口的正确理解之上。
GRPO(组相对策略优化)
一种免价值网络的策略梯度强化学习算法:对同一 prompt 采样一组(如 G=8 个)rollout,用组内奖励的相对优势作为每个动作的优势估计,从而降低梯度方差。广泛用于 LLM 对齐(如 DeepSeek-R1),本文将其用于文本级 RL、DiT-in-the-loop RL 与奖励模型训练。
PE 的后两个训练阶段和 GRM 的可验证奖励 RL 都基于 GRPO,理解它才能看懂"组相对优势"如何被套用到文本打分与视频级奖励上。
奖励模型与成对偏好(pairwise preference)
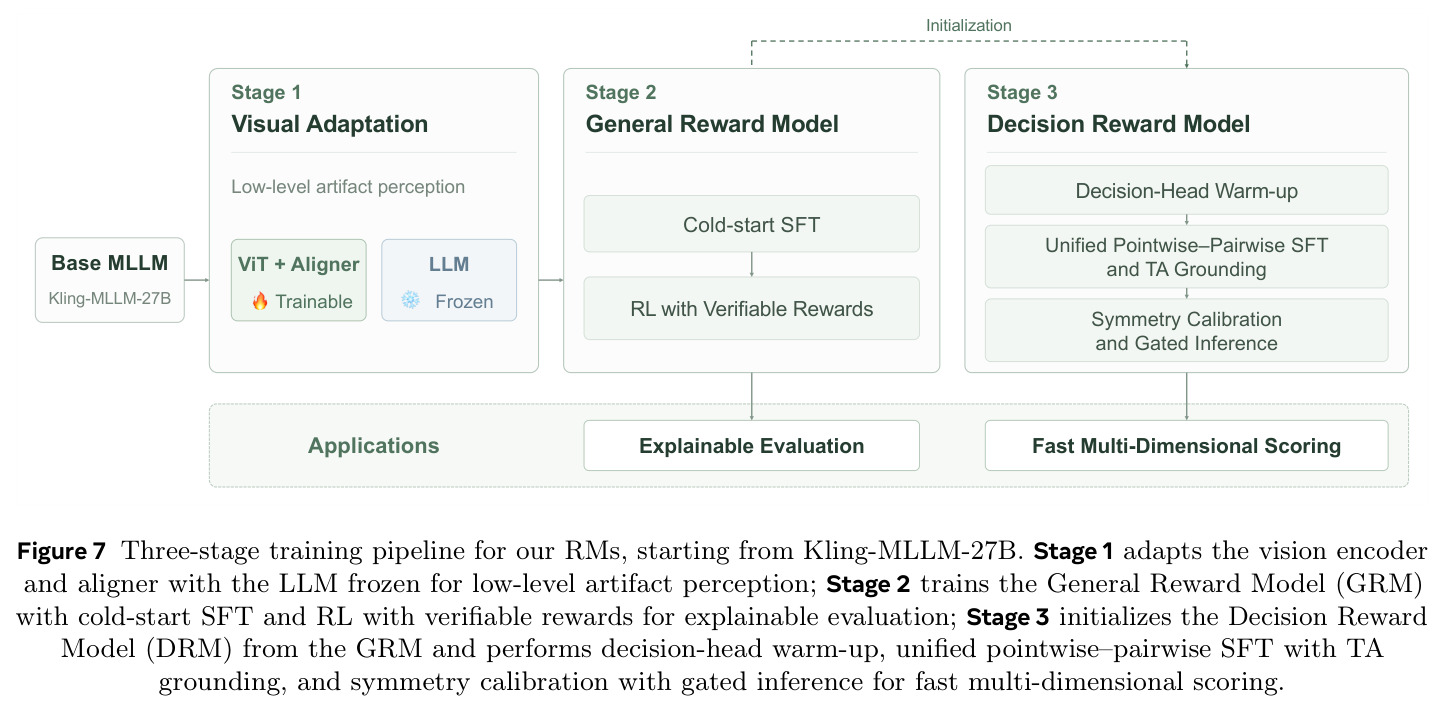
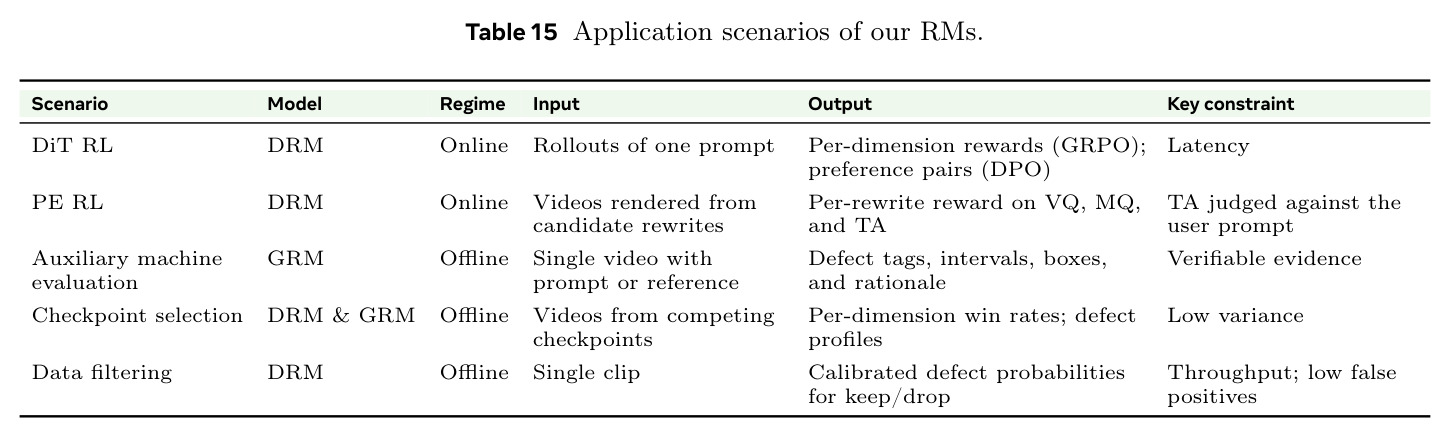
人类难以给出绝对分数,却容易判断两个视频哪个更好;奖励模型从成对/点级标注中学出可执行的打分函数,为 DiT 的 RL(GRPO/DPO)、PE 优化、checkpoint 选择和数据过滤提供信号。本文进一步区分产出可解释定位批评的 GRM 与单次 prefill 快速多维打分的 DRM。
第七章是全文"对齐"环节的主体,且 DiT-in-the-loop RL 的视频级奖励全部来自决策奖励模型的分类学字段,是理解 PE 训练与评估溯源的关键。
SFT 与后训练课程(curriculum)
监督微调在预训练后用高质量指令-答案对继续训练;课程式训练则按阶段调整数据配比、序列长度与可训练参数(如先冻结视觉塔只训音频塔,最后只更新 LLM),以渐进方式注入新模态与新能力并缓解灾难性遗忘。
Kling-MLLM 的四阶段课程与 captioner/RGC/PE 的多阶段后训练是全文方法叙述的骨架,不懂课程设计就看不懂各阶段的数据配比与冻结策略取舍。
研究动机
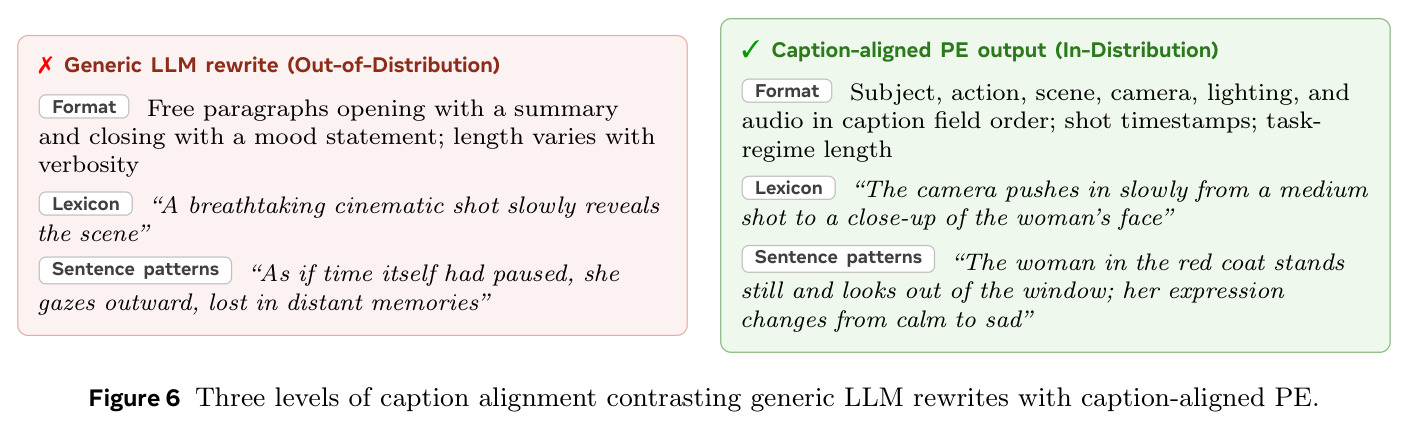
2023–2026 年视频生成从孤立片段走到可用的多镜头视听序列,评价单位从帧、片段、镜头扩展到完整序列,瓶颈随之从"渲染得像不像"转向"语义控不控得住":视觉保真度的提升并不能自动带来正确的动作、镜头语言、参考绑定与叙事连续性。通用 MLLM 基准的高分与此严重脱节——VQA 高分不保证模型理解镜头语言、左右方位、构图、光照、镜头边界、身份绑定与密集时序变化,而这些恰恰决定生成结果可控与否。作为训练监督的 caption 问题更隐蔽:论文展示了一段 17.7 秒片段的"流畅"描述,它把硬切误标为淡入淡出、遗漏标题出现时机、漏掉画外对白、不转写画面文字,7 个关键事实中 3 个缺失、3 个部分、1 个矛盾。同时 DiT 的训练样本量远小于语言模型,训练吞吐与可用视频供给都无法靠 scaling 弥补,每条视频的描述密度成为数据效率核心;用户 prompt(越来越多由 AI 生成,长而流畅但内部矛盾)与训练 caption 分布脱节,含空间矛盾或无物理因果交互的文本会让生成器即兴发挥,产生身份漂移、穿模、手不接触等伪影。
本文的目标是本文的目标是把"多模态理解"建设成可控视频生成背后完整、可部署、可诊断的工程栈,而非追逐某个单一基准的 SOTA。具体包括:以共享基座 Kling-MLLM(27B 稠密、35B-A3B 与 397B-A17B 两个 MoE 规格,统一接收图像、视频、音频、音视频同步与交错输入)为感知与推理骨干;将其专门化为五类下游模块——面向生成的 caption 与参考绑定 caption RGC(数据环节)、prompt 增强 PE 与文本编码器 TE(条件环节)、GRM+DRM 双奖励模型(对齐环节)、按任务定制的自动评估协议(评估环节);并让每个生成失败都能沿链路溯源到具体的上游模块(caption 遗漏、条件表示丢时序、奖励偏好静止或评估器没测被要求的事件)。作者希望这些来自 Kling 1.0–4.0、AI Avatar 与 Motion Control 四年生产迭代的经验,能为构建可控视频生成的理解栈提供可迁移的实践指南。
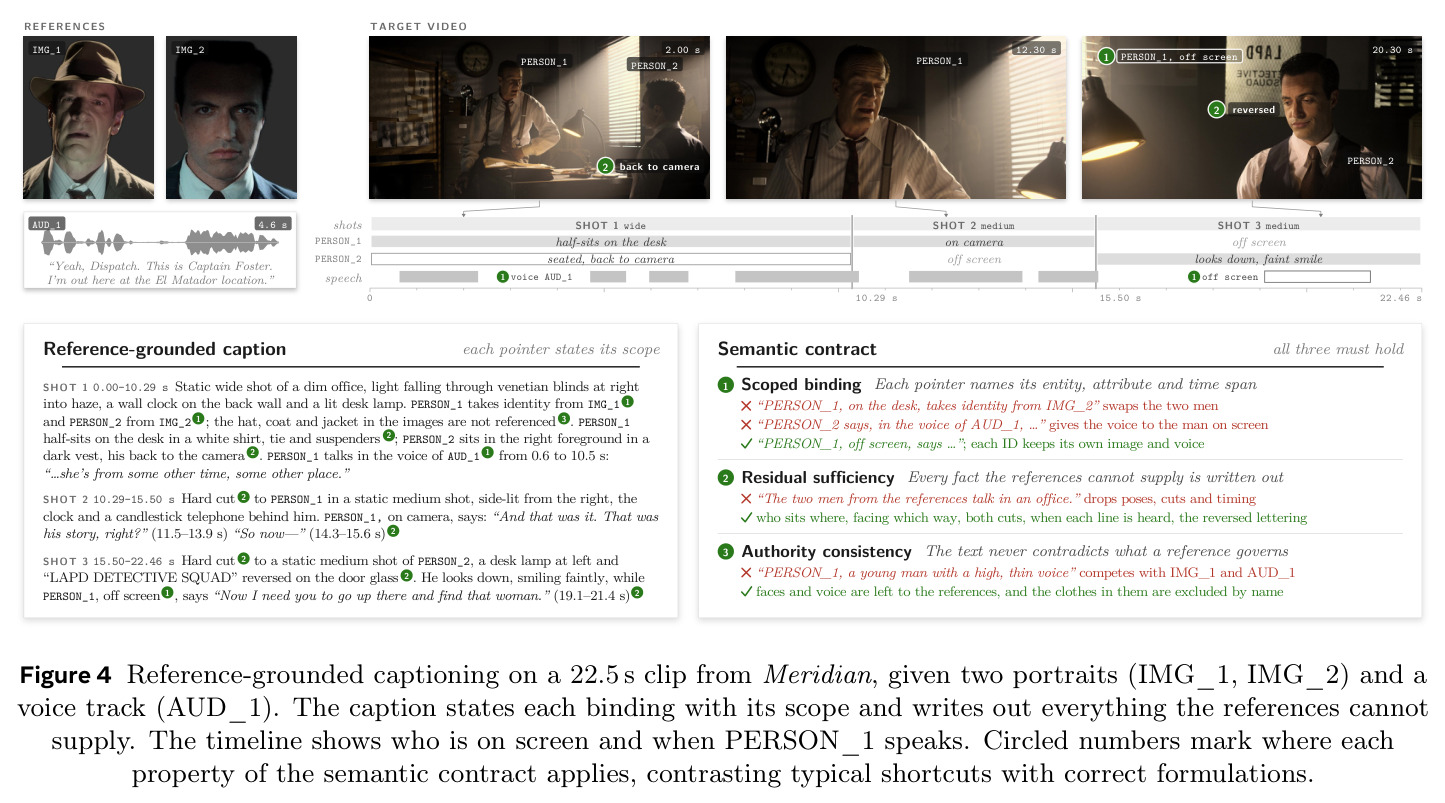
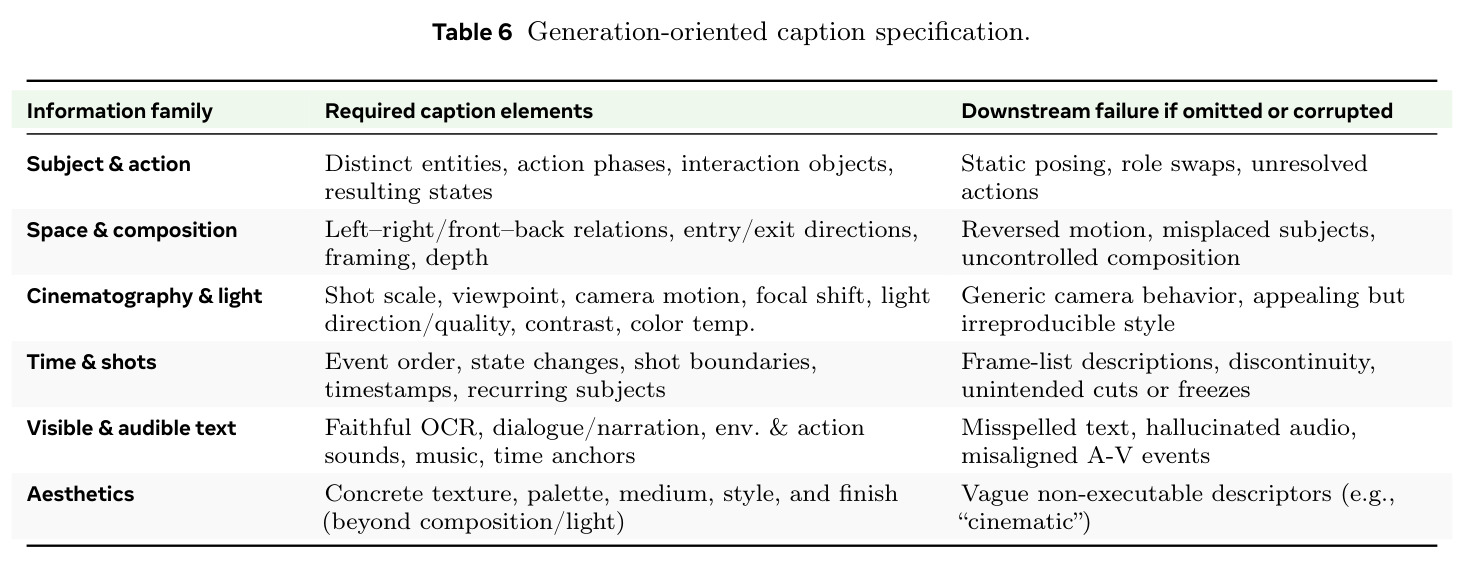
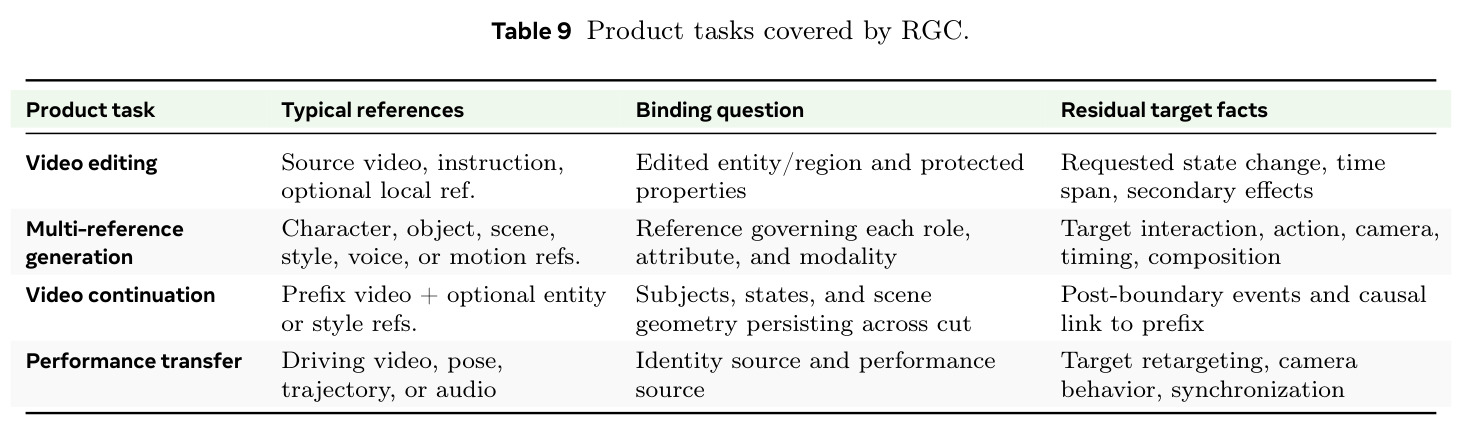
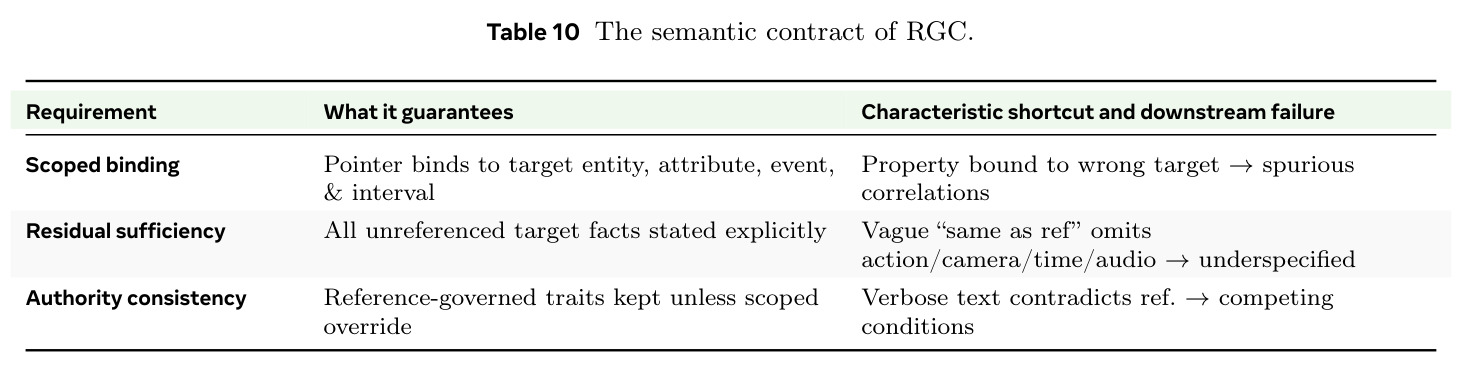
与已有工作不同的是,独特切入在于把生成质量定义为"多模态理解沿数据–条件–对齐–评估全链路的投影":理解是链路属性而非附加在单个模型上的分数。与学术论文不同,本文的论断全部来自四代 Kling 生产系统的一线观察,围绕四个主张组织:瓶颈正从渲染转向语义控制;数据效率取决于描述密度(DiT 样本少,每条视频须承载尽可能多的监督);成熟的 DiT 存在"甜点区",agentic 方法帮助到达;评估应跟随任务并暴露打分捷径。贯穿全文的统一抽象是"语义契约"(semantic contract)——caption 是视觉证据与生成监督之间的接口契约:第 3 章定义绝对描述契约(六类信息+四条书写约定),第 4 章扩展为参考绑定契约(范围化绑定、残差充分性、权威一致性),第 5 章把 PE 定义为"把用户意图翻译进 caption 分布",第 6–8 章则保证契约经文本编码、奖励信号与评估协议真正到达生成器并可被验证。
核心方法
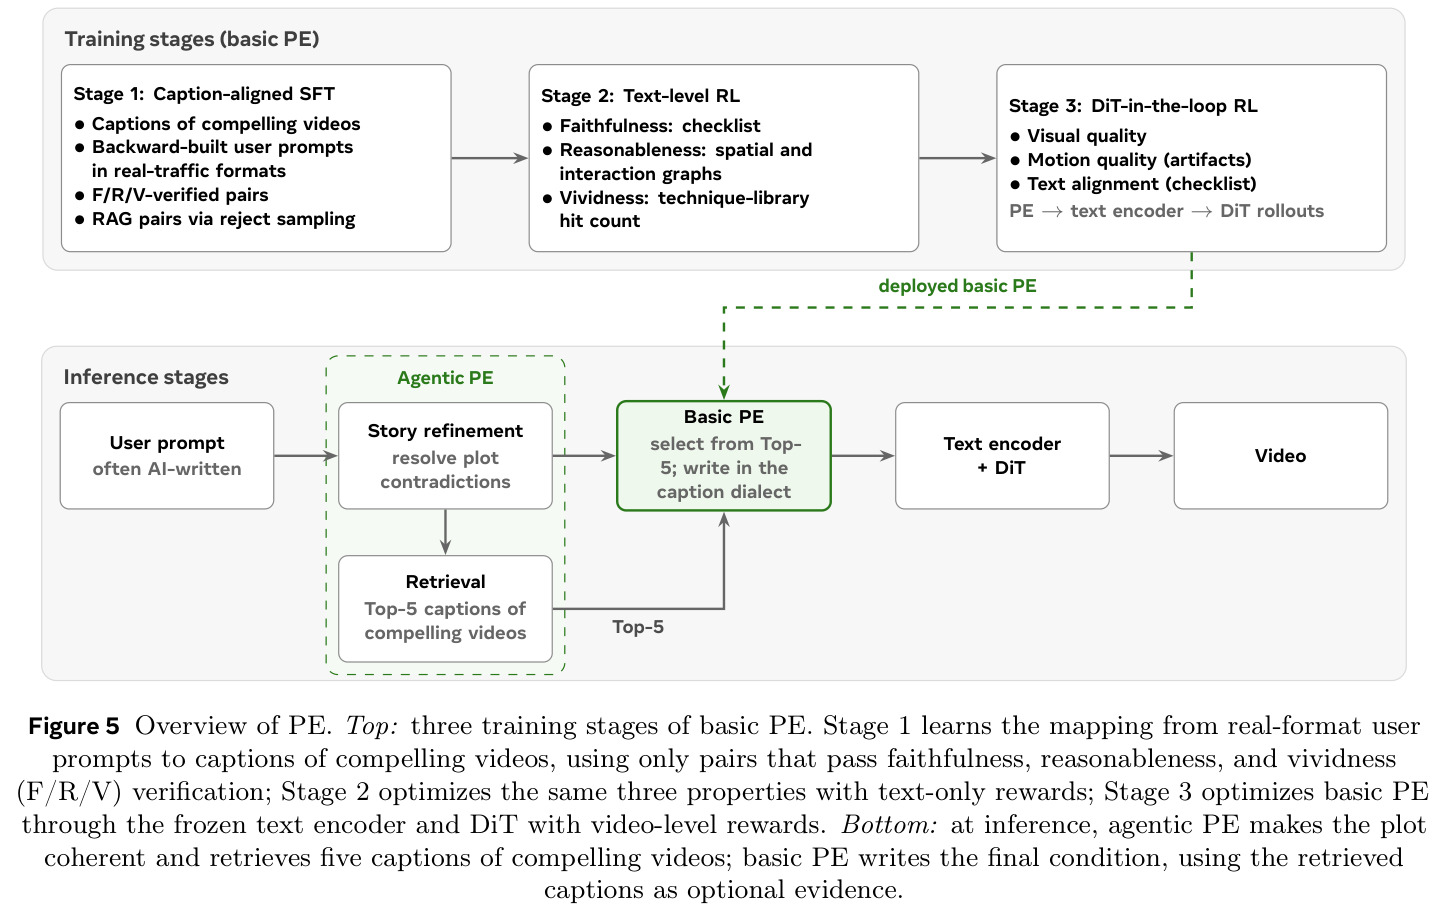
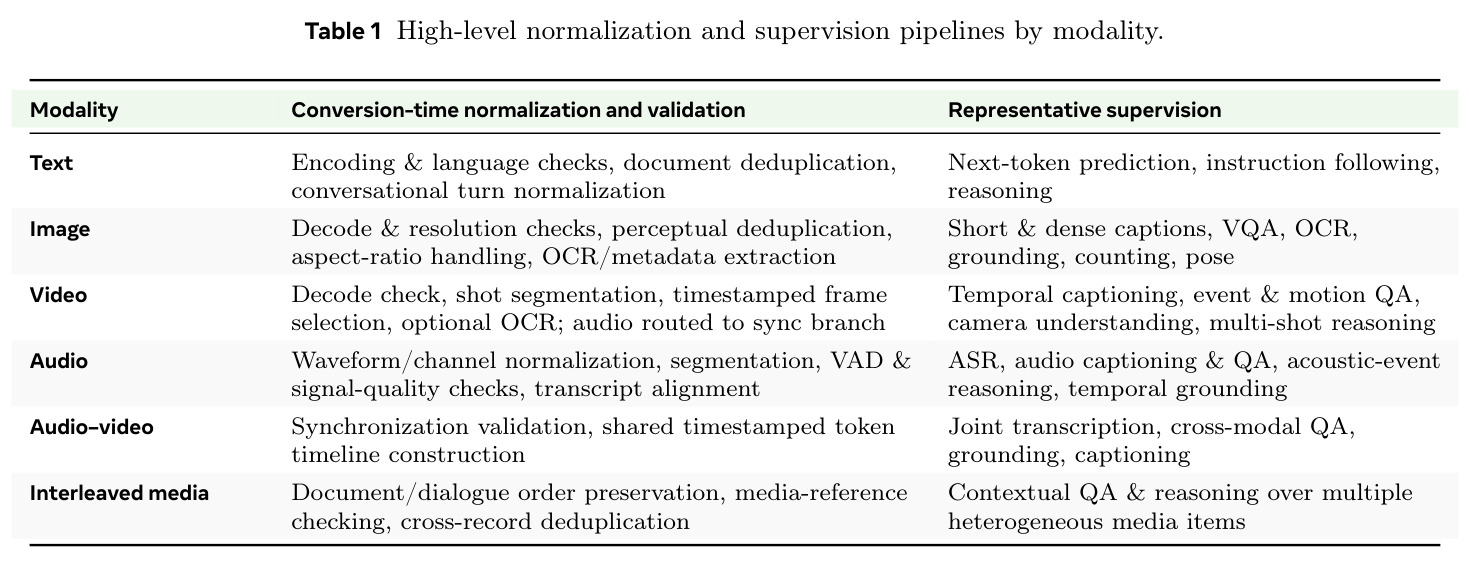
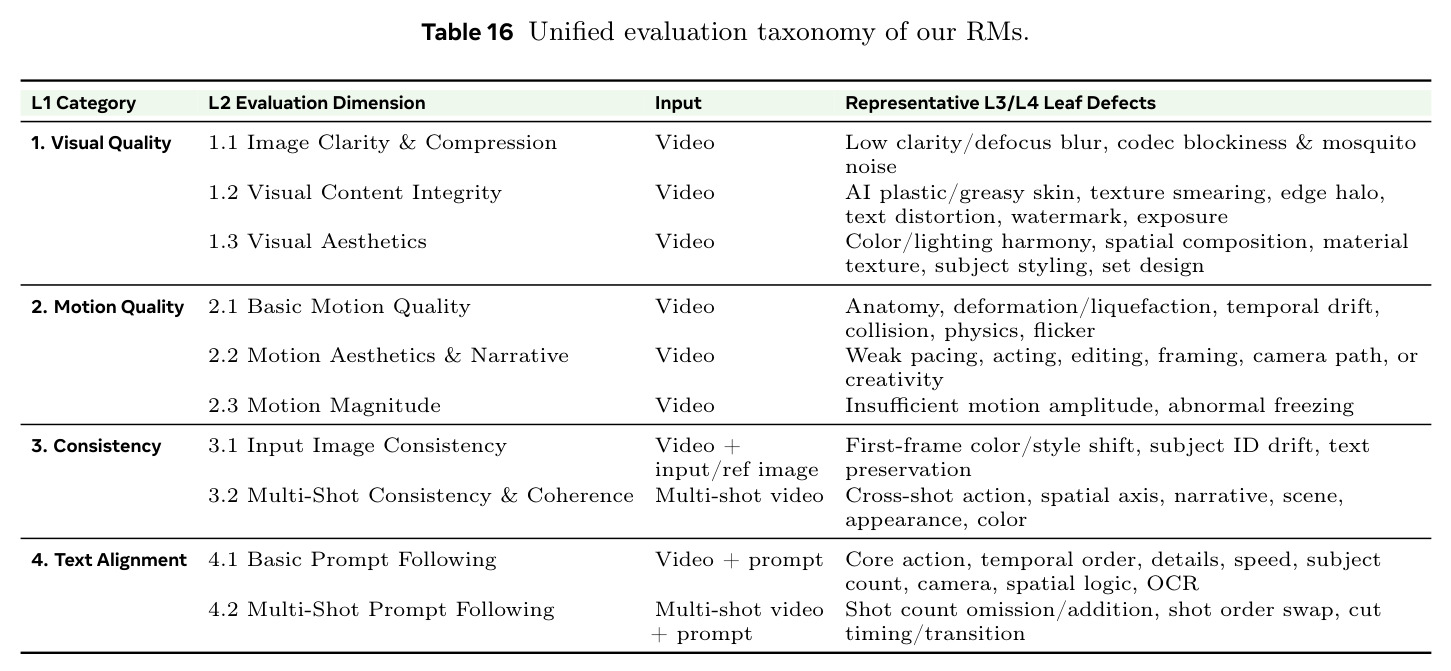
直觉上,作者把"视频生成不好"当作全链路诊断问题:与其只在生成器上堆算力,不如让每一环都由最强的多模态基座专门化而来。技术路线分五段。第一段基座:Kling-MLLM 从 Qwen3.5–Qwen3.8 初始化,视觉路径为 ViT+空间池化+对齐器,音频路径按规模采用 13 token/秒或双分支塔(Mel 谱经 Conv1d 到 25 token/秒,波形 VAE 经学习标量门残差融合);所有模态用边界标记分隔、注入物理时间戳(音频每 5 秒一个绝对锚点),同步音视频按时间线交错序列化;经四阶段课程训练。第二段数据:多专家 caption 流水线产出稠密描述并蒸馏为单次前向学生模型;RGC 把参考绑定显式化并用任意相似视频对做关系监督。第三段条件:basic PE 三阶段训练(caption 对齐 SFT→文本级 RL→DiT-in-the-loop RL)把用户意图译入 caption 分布,agentic PE 做故事修正与 Top-5 检索;TE 经感知适配、多层多粒度聚合与稳定融合。第四段对齐:GRM 产出带时间区间与逐帧框的可解释批评,DRM 单次 prefill 回答 K 个维度问题。第五段评估:按任务分类学路由工具、暴露打分捷径、支持失败溯源。
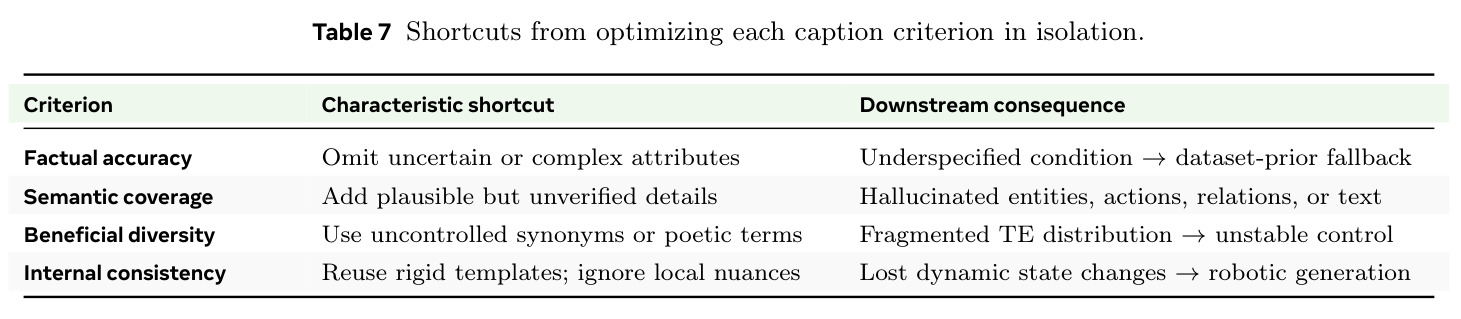
核心创新是"语义契约"的系统性工程化。已有工作把 caption 当作描述任务、把 PE 当作改写任务、把 RM 当作打分任务;本文把它们统一为同一契约在不同环节的投影:caption 定义"生成器应该从每条视频学到什么",遗漏的细节使控制因子欠定、迫使生成器回退到数据先验,错误的陈述则注入冲突监督;RGC 把契约扩展为三条款——范围化绑定(指针必须写明实体、属性与时间范围)、残差充分性(参考无法提供的事实必须写全)、权威一致性(已授权给参考的属性文本不得再另行赋值);PE 的职责被定义为"把用户意图翻译进 caption 分布",并用"从精彩视频 caption 反向构造用户 prompt"的 backward construction 一次解决分布对齐与创造上限两个问题。另一个关键区分是"复杂发现"与"高效部署"分离:多专家流水线离线产出可靠监督,再蒸馏为单次前向学生模型。文本编码器与奖励模型同样遵循"先解决能在文本/感知上验证的问题":TE 用最小对比描述的序列级探针在端到端训练前筛选候选,RM 把感知带宽当作一等设计参数——先训视觉编码器真正看见伪影,再训练判断。
方法步骤详情
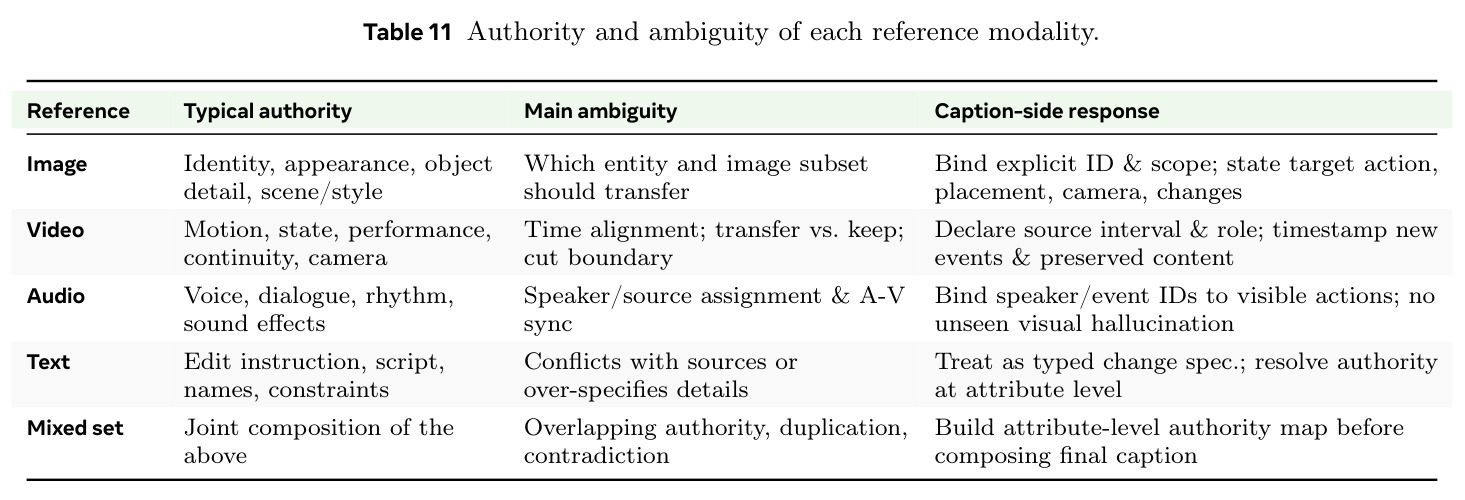
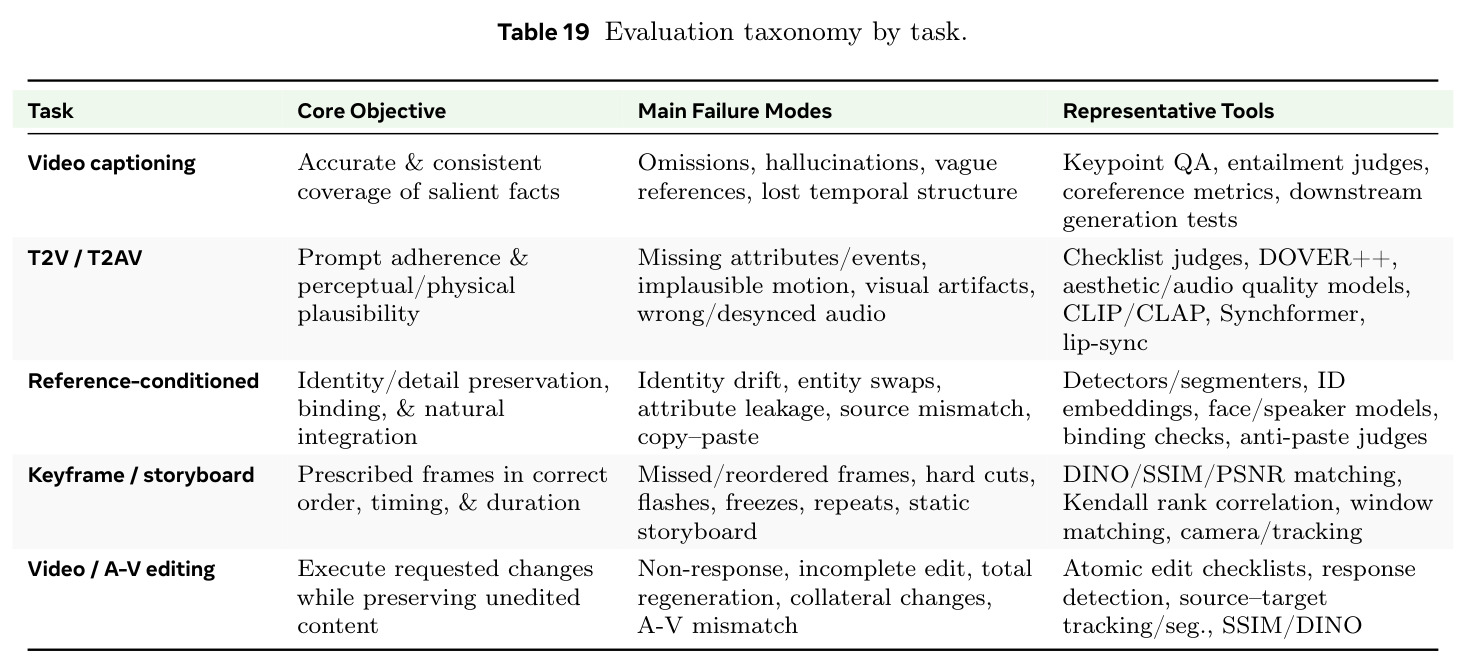
(1) 基座:Kling-MLLM 四阶段课程——先冻结视觉塔与 LLM 只训音频塔,再全解冻、以音视频同步数据为主联合训练,随后转长序列强化细粒度时序感知,最后冻结双塔只更新 LLM;Stage 1 与 Stage 4 checkpoint 合并优于任一单独。(2) Caption 生产:视频按类型/时长/运动/镜头密度/音频可用性路由,经感知证据保全(OCR/ASR 等)、多专家分维抽取(主体、相机运动、空间关系、光照、镜头边界)、冲突消解与实体统一命名,过"准确×覆盖×多样×一致"连击验收后蒸馏为单次前向学生模型。(3) RGC:先给参考分型授权(图像管身份外观、视频管运动与连续性、音频管音色台词、文本为变更说明),独立描述目标与参考,用检测/跟踪/OCR/ASR 提出并验证绑定,构建"实体-属性-时间"权威地图,一次性写成带作用域指针的统一格式,再过指针有效性与文参冲突门;任意相似视频对皆可作参考-目标训练对。(4) PE:从精彩视频 caption 反写用户 prompt(按真实流量采样长度、语种、typo 率、省略槽位)构造 SFT 对并全过忠实/合理/生动三验证器;文本级 GRPO 优化三属性奖励;DiT-in-the-loop RL 连接冻结 TE+DiT 渲染、由决策 RM 出视频级奖励;推理时 agentic PE 先按最小编辑规则做故事修正,再检索 Top-5 精彩 caption 作为可选证据。(5) TE:序列级最小对比探针筛选→感知适配→多层多粒度聚合→稳定融合,冻结 DiT 对照训练加人类 GSB 偏好评估。(6) RM:Stage 1 冻结 LLM 只训视觉编码器(VAE 重建判别+缺陷探针,保留 20% replay);Stage 2 GRM 冷启动 SFT(视觉:LLM 学习率 1:10)+GRPO(G=8,奖励含评级校准、tag F1、时空 mIoU,漏报受罚);Stage 3 DRM 决策头预热、点对-成对统一 SFT、对称校准+低置信门控。(7) 评估:属性路由到最简可靠工具,用反抄袭系数与乘法编辑意图公式封堵捷径,按冒烟/回归/发布三档运行。
技术新颖性
单点技术之外,新颖性在方法论层面。其一,"描述密度"被提出为 DiT 数据效率的第一性度量,并据此推出"语义契约+多专家蒸馏"的 caption 生产范式,与学术界追逐 caption 基准分数的视角根本不同。其二,RGC 的关系监督把"任意两个足够相似的视频对"变成 DiT 训练样本——不需要真实编辑结果对,一个目标视频可与共享主体或共享运动的不同参考多次配对,数据供给随视频库组合式增长,巧妙绕开编辑配对数据稀缺问题。其三,PE 的 backward construction 反向构造训练分布,把"输出分布对齐"转化为"输入分布构造",同时用精彩视频源设定创造上限;仅换数据源就让生动性均分从 3.72 升到 4.03。其四,F/R/V 三验证器(清单式忠实性、空间+交互图合理性、技术库命中生动性)证明大部分质量问题可在不渲染一帧的情况下解决。其五,DRM 的"在 prefix 里决策"机制——把 K 个问题答案槽固定在 prompt 中、对选项字母 logits 归一化——一次 prefill 完成多维打分,占位符互不可见从而消除顺序捷径,配合对称 KL 与跨序 Bradley–Terry 校准 M-RoPE 位置偏差。其六,评估协议显式针对打分捷径设计,如反抄袭系数 $EF_{\text{final}} = EF_{\text{base}} / P^{\text{paste}}$ 与乘法编辑意图 $EI^{(c)}_M = IF^{(c)}_M \times FP^{(c)}_M$。
实验结果
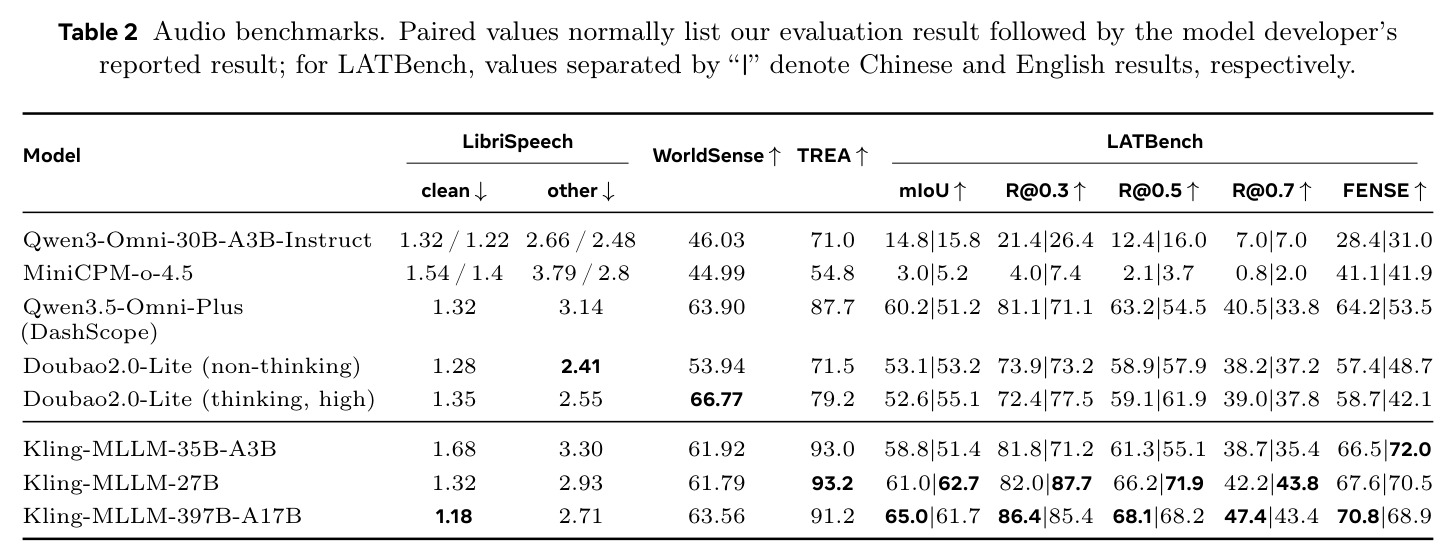
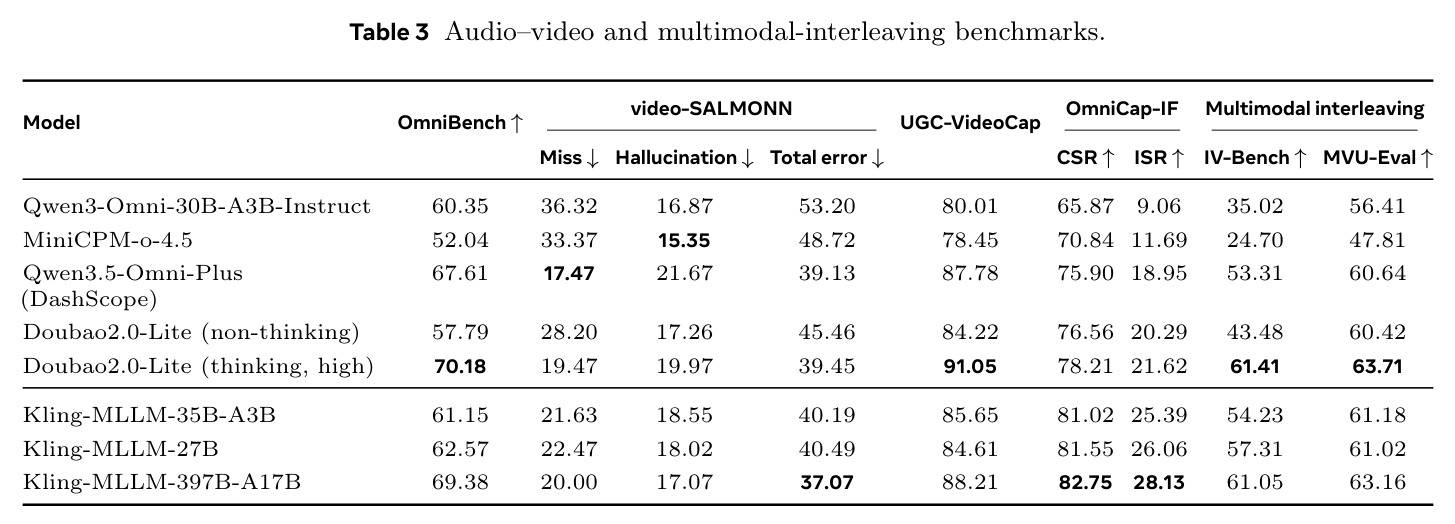
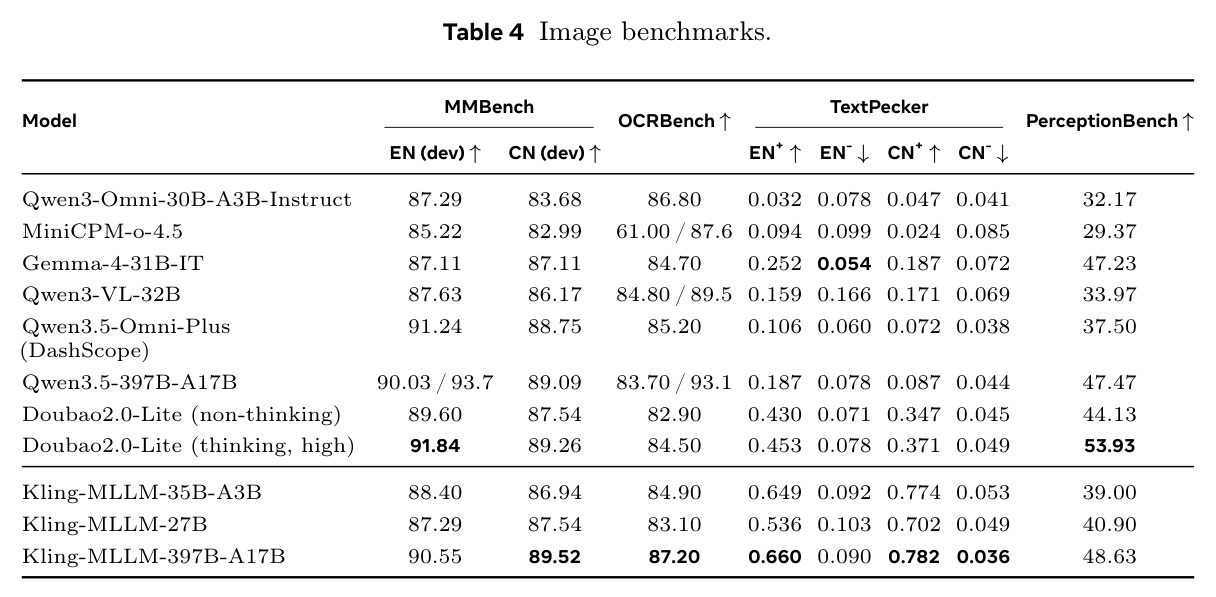
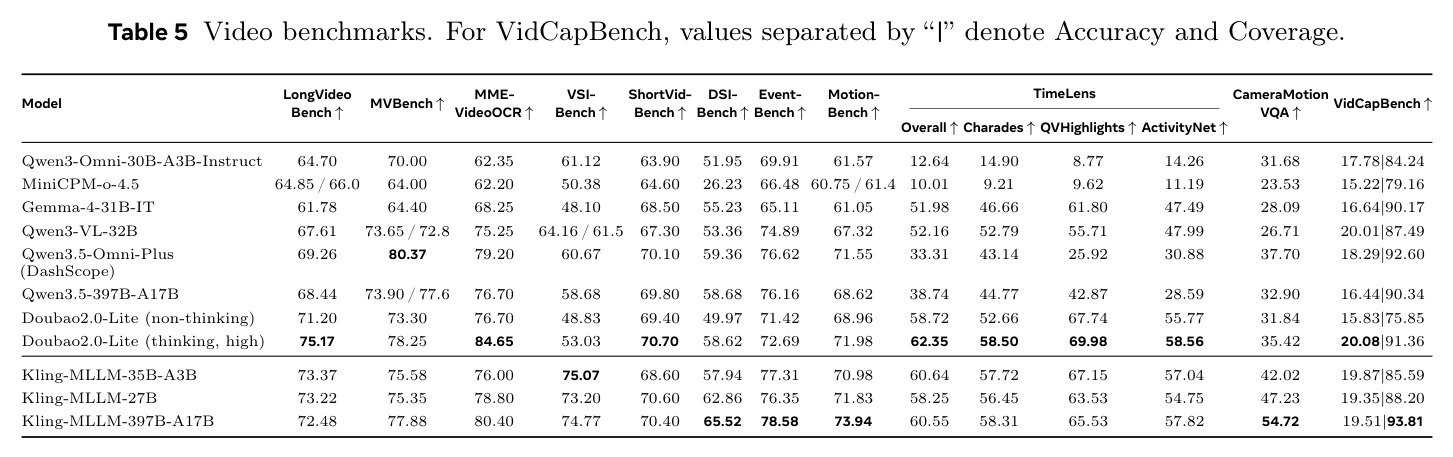
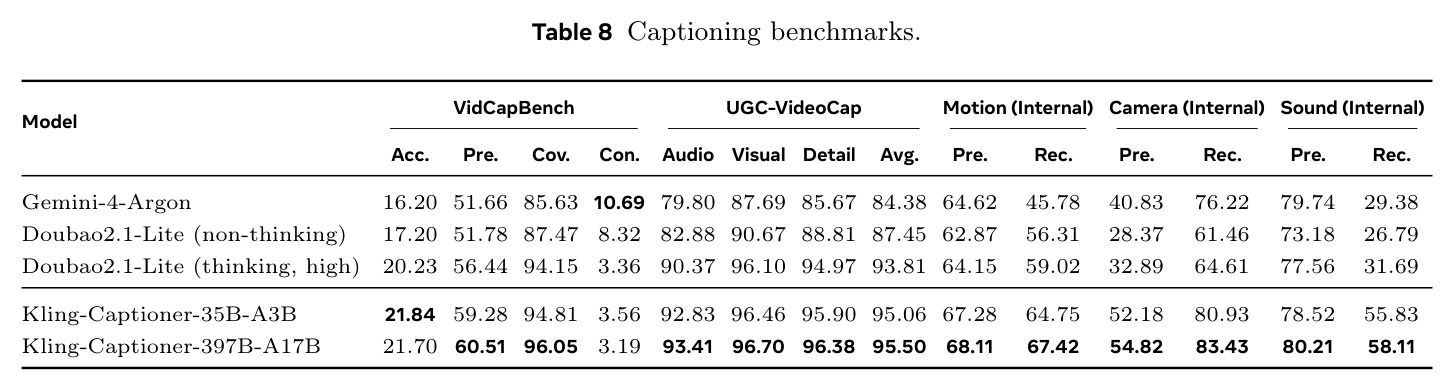
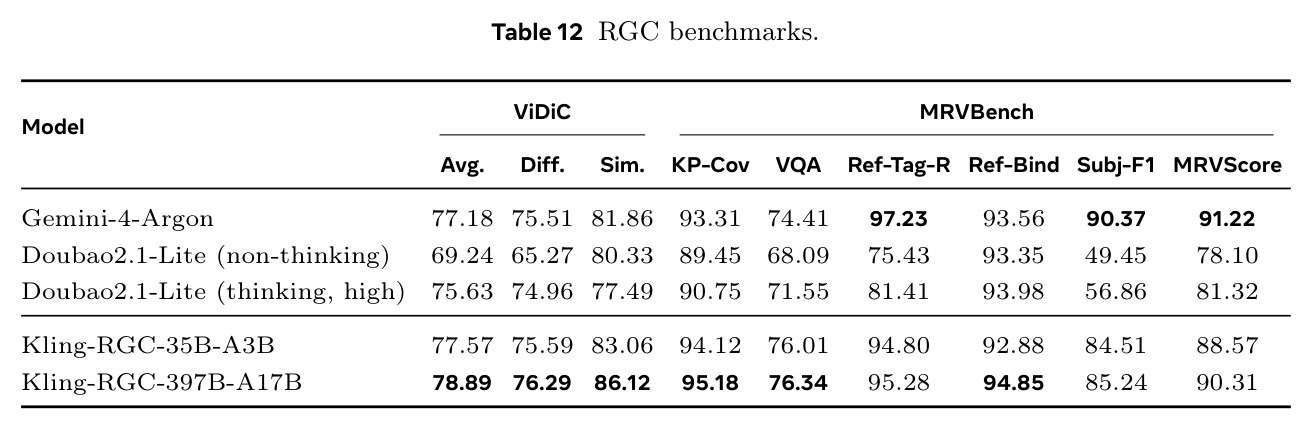
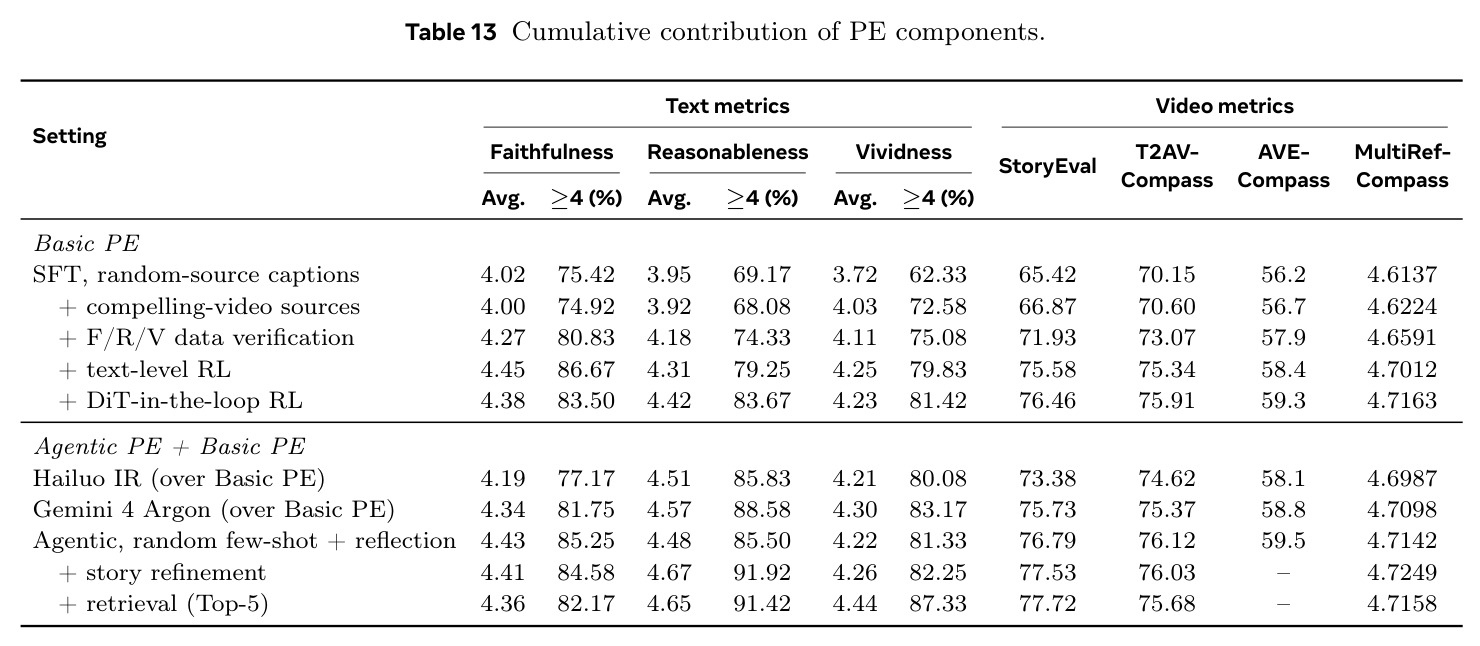
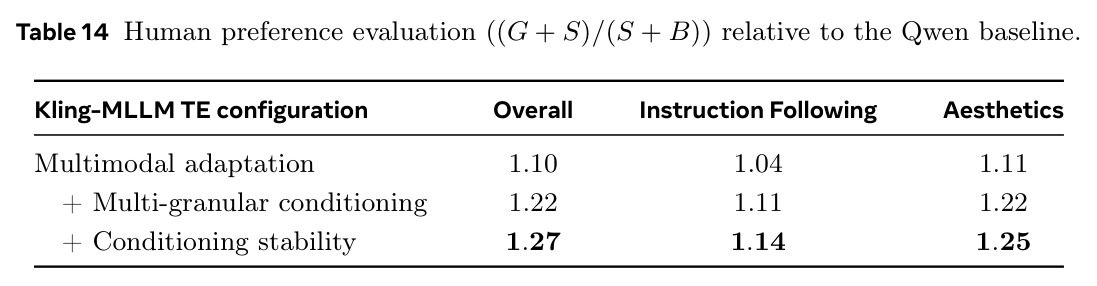
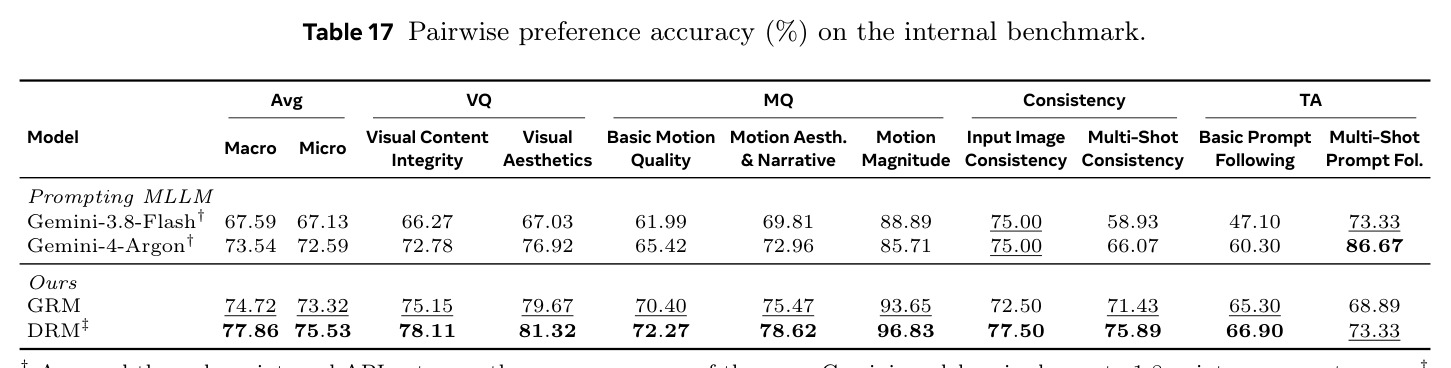
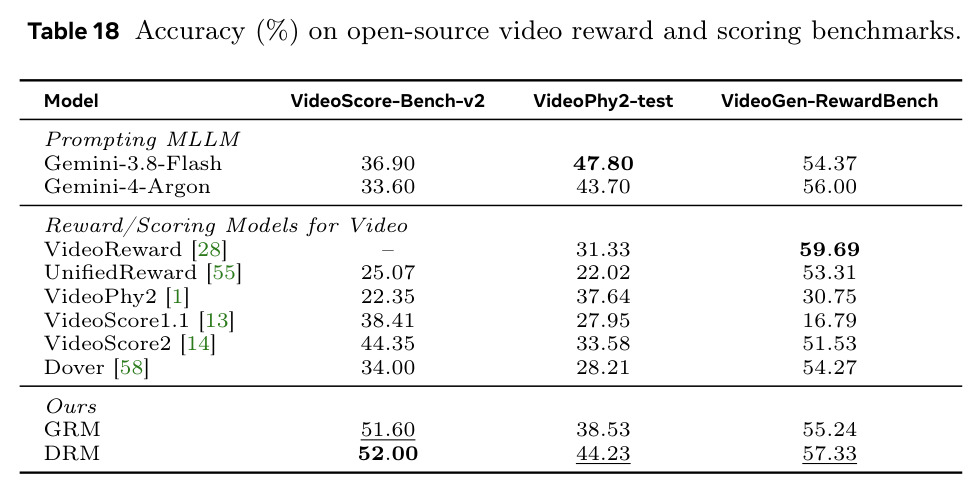
基座(Tables 2–5):Kling-MLLM-397B-A17B 的优势集中在视频感知与时序理解——DSI-Bench 65.52、Event-Bench 78.58、MotionBench 73.94、Camera Motion VQA 54.72(超最强对手 37.70 约 17 分)、VidCapBench 覆盖率 93.81 五项第一,35B-A3B 以 75.07 拿下 VSI-Bench;音频侧 LibriSpeech clean WER 1.18 全场最低、TREA 91.2、中文 LATBench mIoU 65.0;OmniCap-IF 双指标第一(82.75/28.13),IV-Bench 与 MVU-Eval 距最佳仅 0.36/0.55;图像与语音识别与对手互有胜负。Caption(Table 8):Kling-Captioner-397B 在 VidCapBench Acc 21.70/Pre 60.51/Cov 96.05 全面超 Gemini-4-Argon(16.20/51.66/85.63),UGC-VideoCap 均值 95.50 超 Doubao2.1 的 93.81。RGC(Table 12):ViDiC 平均 78.89 超 Gemini 77.18,Ref-Bind 94.85 最高,但 MRVScore 90.31 略低于 Gemini 91.22。PE(Table 13):组件累积使 StoryEval 从 65.42(随机源 SFT)升至 77.72(agentic+检索),+12.3 分;生动性≥4 占比 62.33%→87.33%;DiT-in-the-loop RL 把合理性推至 4.42(≥4 占 83.67%)但压低峰值生动性。TE(Table 14):相对 Qwen 基线偏好比 (G+S)/(S+B) 从 1.10→1.22→1.27 单调提升。RM(Tables 17–18):内部成对基准 DRM 宏平均 77.86% 超 GRM 74.72% 与 Gemini-4-Argon 73.54%,9 维中 8 维第一;公开基准 VideoScore-Bench-v2 52.00、VideoPhy2 44.23、VideoGen-RewardBench 57.33,大幅领先开源 RM(VideoScore2 44.35/33.58/51.53)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频描述生成(VidCapBench) | Accuracy / Precision / Coverage | 21.70 / 60.51 / 96.05(Kling-Captioner-397B) | Gemini-4-Argon 16.20 / 51.66 / 85.63 | +5.50 / +8.85 / +10.42 |
| 视频描述生成(UGC-VideoCap) | Audio/Visual/Detail 平均 | 95.50(Kling-Captioner-397B) | Doubao2.1-Lite (thinking) 93.81 | +1.69 |
| 参考绑定视频描述(ViDiC) | 平均分 | 78.89(Kling-RGC-397B) | Gemini-4-Argon 77.18 | +1.71 |
| 多参考视频描述(MRVBench) | Ref-Bind 参考绑定精度 | 94.85(Kling-RGC-397B) | Gemini-4-Argon 93.56 | +1.29 |
| 提示词增强(端到端) | StoryEval(七项均值) | 77.72(agentic+Top-5 检索完整流水线) | 65.42(随机源 caption 的 SFT basic PE) | +12.30 |
| 提示词增强 | Vividness ≥4 分占比 | 87.33%(+Top-5 检索) | 62.33%(随机源 SFT) | +25.00 个百分点 |
| 文本编码器替换(冻结 DiT 对照) | 人类偏好比 (G+S)/(S+B)·Overall | 1.27(感知适配+多层多粒度+稳定融合) | 1.00(Qwen TE 基线) | +27% |
| 视频奖励模型(内部成对基准) | 宏平均偏好准确率 | 77.86%(DRM) | Gemini-4-Argon 73.54% | +4.32 个百分点 |
| 视频奖励模型(VideoScore-Bench-v2) | Accuracy | 52.00(DRM) | VideoScore2 44.35(最佳开源 RM) | +7.65 |
| 基座视频理解(MotionBench) | 准确率 | 73.94(Kling-MLLM-397B-A17B) | Doubao2.0-Lite (thinking) 71.98 | +1.96 |
| 基座视频理解(Camera Motion VQA) | 准确率 | 54.72(Kling-MLLM-397B-A17B) | Qwen3.5-Omni-Plus 37.70(最佳非 Kling) | +17.02 |
| 物理常识(VideoPhy2-test) | Accuracy | 44.23(DRM) | VideoPhy2 37.64(最佳开源 RM) | +6.59(但仍低于 Gemini-3.8-Flash 的 47.80) |
局限与改进
作者承认的限制:DiT-in-the-loop RL"抬高下限、压低上限"——PE 学会回避复杂运镜与密集交互这类高伪影风险描述,而三个视频级奖励都不度量"是否精彩",如何在不重新引入伪影的前提下奖励"雄心"是开放问题;caption 的时空保真与上下文容量权衡、长视频的长度-密度权衡与长程指代一致性、音画对齐与说话人关联仍未解决;agentic PE 的工具调用、低分辨率预览与生成后校验受延迟与成本制约。我自己的观察:大量关键数字来自内部基准与内部评审,外部不可复核;Table 18 中 DRM 在 VideoPhy2-test(44.23 对 Gemini-3.8-Flash 47.80)与 VideoGen-RewardBench(57.33 对 VideoReward 59.69)并非第一,与正文"全面领先"表述有出入;MRVScore、MME-VideoOCR、LongVideoBench 等项也落后于外部模型,"自研链路全面占优"并不成立;评估器与被评估模型同出 Kling-MLLM 系,存在循环性风险;报告未披露训练算力、数据规模与多数超参数,工程结论难以定量复验。
独立分析的弱点
独立分析的弱点:其一,"描述密度决定数据效率"是全文第一主张,但缺少受控剂量实验——论文引用 VidCapBench 与下游质量 0.89–0.92 的相关性佐证,却未在同一 DiT 上扫描 caption 密度梯度与最终控制精度的因果曲线,改进方向是发布密度可控的数据集与训练曲线。其二,生动性用"技术库命中数"度量,虽有去重、上限与合理性门控,仍可能被堆砌术语局部游戏,且技术库绑定特定影视文化语汇;改进是引入人类偏好校准的生动性判据。其三,奖励模型的分类学与标注语料完全内部化,外部无法复刻 DRM 的维度设计;应开源 taxonomy 并释放部分脱敏标注。其四,文本级筛选(TE 探针、PE 三验证器)与最终视频质量的传递性只在自家架构验证,跨架构排序稳定性未知,应在不同规模 DiT 上复验。其五,backward construction 依赖真实流量统计(长度、typo 率、槽位省略分布),复现者拿不到这些分布,应公开合成 prompt 采样配方。其六,"精彩视频"由美学与运动分筛选,可能把 PE 的创造上限锚定在特定风格分布上,存在多样性塌缩隐患,需要显式的多样性度量。
未来方向
作者明确提出:设计能奖励"雄心但可执行"内容的目标函数(在端到端目标中保留生动性奖励、向文本级 RL checkpoint 做策略正则、按上限指标而不只是下限指标选 checkpoint);agentic PE 与 basic PE 针对共享验证器联合训练;agentic PE 调用工具编辑用户的图像/视频/音频参考或补充请求缺失的信息;低分辨率预览提前暴露构图与运动、3D 预演固定布局与相机路径、生成后校验核对输出并触发修订(主要瓶颈是延迟与成本);RGC 支持区域、草图、轨迹等更多参考形式,多参考联合指定同一目标,以及更细粒度的时间绑定用于精确同步与转场;caption 加强音画对齐与说话人-话语关联。基于其成果可延伸:把"描述密度"形式化为信息论度量并纳入数据配方的自动优化;对"实体-属性-时间"权威地图做形式化建模与冲突推理;用红队式自动搜索发现评估协议的捷径;对理解链各模块做因果贡献分解(以固定生成器做单变量替换实验);把"捷径暴露"测试抽象为可跨任务复用的评估套件。
复现评估
本文是纯技术报告,未开源模型权重、代码、数据或评测器;Kling-MLLM 三个规格(27B 稠密、35B-A3B、397B-A17B MoE)的基座训练需要大规模算力与内部数据,普通实验室无法复现基座本身。但方法论层面可部分复现:评估所用公开基准(VidCapBench、ViDiC、MRVBench、OmniBench、MotionBench、VideoScore-Bench-v2、VideoPhy2、VideoGen-RewardBench 等)均可获取,可据此对齐评估;多专家 caption 流水线、backward construction、F/R/V 三验证器、RGC 七步流水线、GRM 三阶段训练与 DRM 的 prefix 决策机制都有较详细的文字配方,论文披露了少数关键超参数(视觉:LLM 学习率 1:10、GRPO 组大小 G=8、20% replay、Top-5 检索、每 5 秒音频时间锚点)。关键缺口是内部 benchmark、内部标注语料、真实 prompt 流量分布与完整训练配置。总体判断:思路级复现难度中等(可在 7B–30B 级开源 MLLM 上小规模重实现),数字级复现几乎不可行。
论文图表
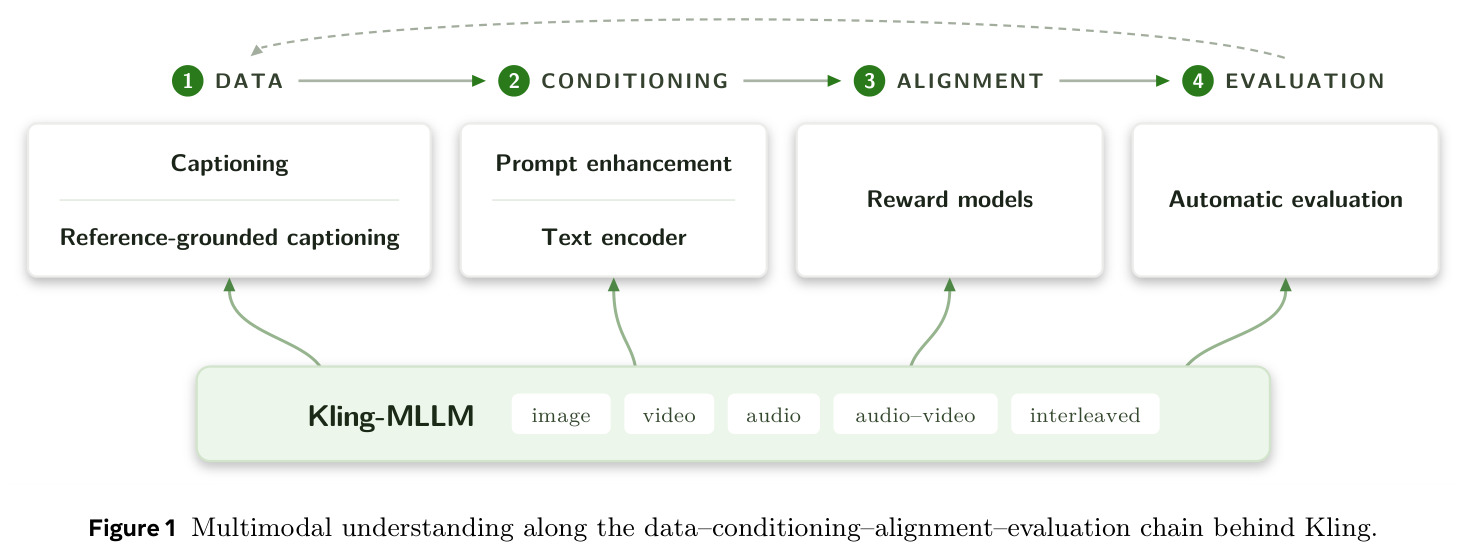
全文总览图:底部是共享基座 Kling-MLLM(统一接收图像、视频、音频、音视频同步与交错输入),上层沿四个环节展开——数据环节(Captioning、Reference-grounded captioning)、条件环节(Prompt enhancement、Text encoder)、对齐环节(Reward models)、评估环节(Automatic evaluation),展示理解能力如何逐环投影为生成质量。
一图概括全文结构与各章的对应关系,是理解"链路投影"这一中心论点的最佳入口。
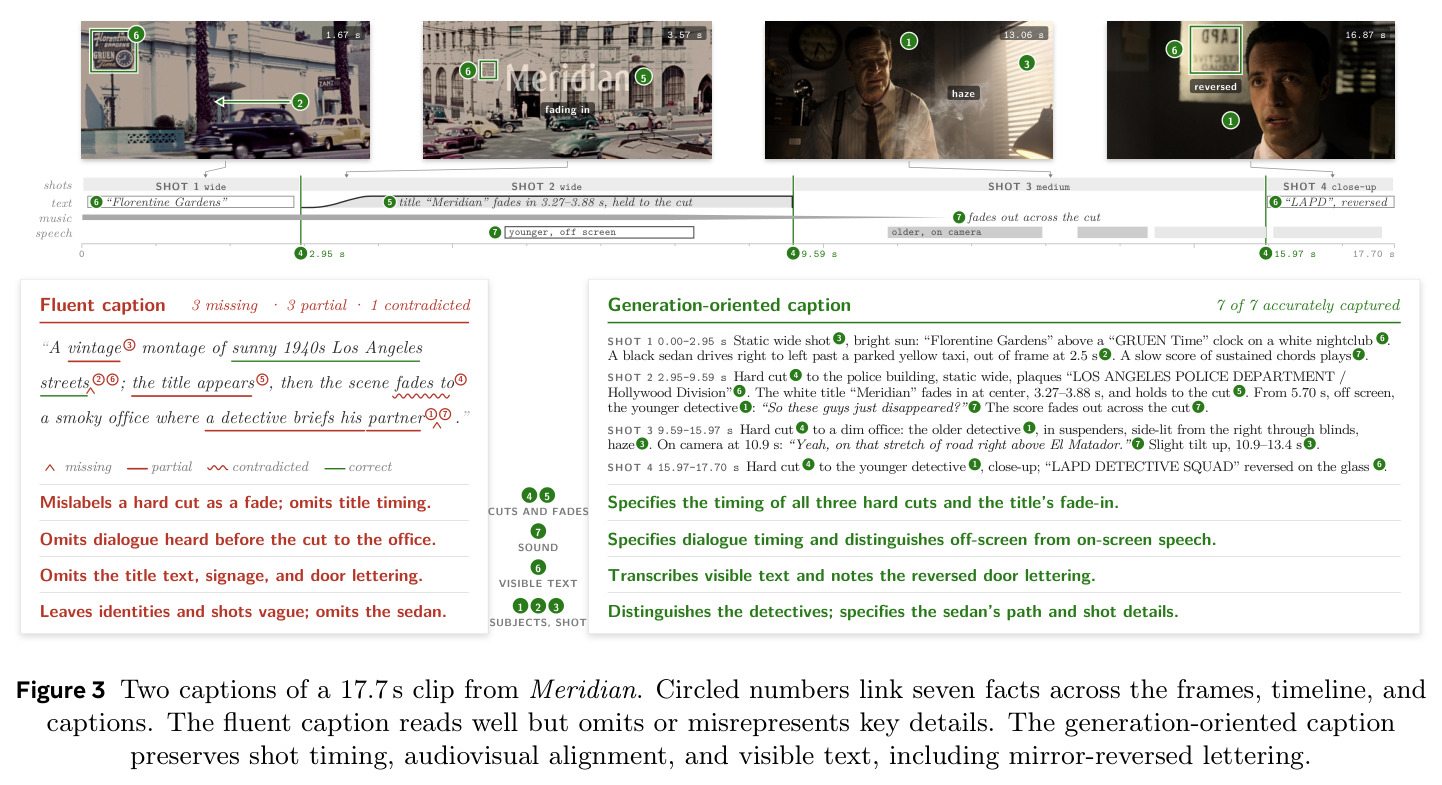
同一 17.7 秒片段两版 caption 对照:流畅版把硬切误标为淡入、漏标题时机、漏画外对白、不转写画面文字(7 个关键事实中 3 缺失、3 部分、1 矛盾);生成导向版精确给出三个硬切与标题淡入的时间戳、区分画内/画外说话、转写镜像反转的门上字母并标注轿车行驶方向。
最直观地说明"语言流畅≠监督合格",是语义契约论点与原子化评估主张的核心证据。