VidUEU-Agent:面向多模态理解、编辑与统一任务的数据策划智能体 VidUEU-Agent: A Data-Curation Agent for Multimodal Understanding, Editing, and Unified Tasks
智能体四阶段流水线把原始视频自动转化为10万条理解、编辑与统一任务指令数据,并按训练反馈自迭代
前置知识
统一多模态模型(UMM)
统一多模态模型指在同一套参数里同时支持图像/文本理解与图像生成的模型,典型代表是 Bagel、Janus-Pro、OmniGen2。它们通常用自回归路径处理理解、用扩散或离散 token 路径处理生成,通过共享的 LLM 骨干桥接两条能力,从而支持交错图文推理与可控编辑。
本文的数据集就是为 UMM 定制的:理解、编辑、统一三类样本分别对应 UMM 的三种工作模式,读懂实验部分必须知道 Bagel 这类模型能同时吃理解与生成监督。
指令微调数据(Instruction Tuning Data)
指令微调数据是形如(指令、多模态输入、目标回答)的训练样本,用于把预训练模型对齐到听从人类指令的范式。样本质量、多样性与分布平衡直接决定微调后的能力上限与泛化性,因此自动合成时的质量控制至关重要。
本文的核心产出 VidUEU-100K 就是一个 10 万条规模的指令微调数据集,全文的 Gate 质控、证据引用、分布自迭代都围绕'如何造出高质量指令数据'展开。
LLM 智能体与工具调用(Agent & Tool Use)
LLM 智能体指以大模型为控制器,通过规划(把复杂目标拆成步骤)与工具调用(OCR、检测器、光流等外部能力)完成多步任务的系统。工具输出作为外部证据回流给 LLM,使其决策有据可依,而非纯粹依赖参数记忆生成。
VidUEU-Agent 正是这样一个数据策划智能体:它规划在哪个章节/镜头调用哪几个感知工具,并把工具信号语义化后用于打分与出题,理解流水线必须理解这套规划-调用-证据机制。
加权设施选址问题(Weighted Facility Location)
设施选址是组合优化经典问题:在预算 $k$ 内选一个子集使候选点被覆盖程度最大。贪心目标 $F(S)=\sum_i r_i \max_{j\in S}\mathrm{sim}(i,j)$,每轮加入边际增益 $\Delta(j)$ 最大的候选,具有子模性带来的近似保证。
论文用它做关键帧选择:权重 $r_i$ 是 VLM 打的语义价值分,相似度由图像+字幕嵌入的余弦给出,保证选出的关键帧既高质量又不冗余,是 Stage 2 的数学核心。
LoRA 参数高效微调
LoRA 冻结原模型权重,只训练注入的低秩矩阵 $\Delta W = BA$(秩 $r \ll d$),大幅降低显存与算力需求。例如 Bagel 实验对 LLM 骨干用 $r=16, \alpha=32$ 的 LoRA,仅微调极小比例参数即可完成 10 万样本的训练。
论文所有实验均用 LoRA 微调 InternVL3-8B 与 Bagel-7B-MoT(2×或 8×A100-40G),理解实验设置、算力成本与复现门槛都需要这一背景。
VLM-as-a-Judge 自动评测
VLM-as-a-Judge 指用一个强多模态模型(如 GPT-4o、GPT-4.1)按评分标准给被测模型输出打分,替代昂贵的人工评估。它成本低、可扩展,但存在判官偏差与运行间方差,需报告多次运行的稳定性。
本文的理解/编辑/统一评测几乎全部依赖判官模型(LLaVA-Bench 用 Qwen3.5-35B、GEdit 用 GPT-4.1、WEAVE 用 GPT-4o),附录还专门报告了判官三次运行的标准差。
研究动机
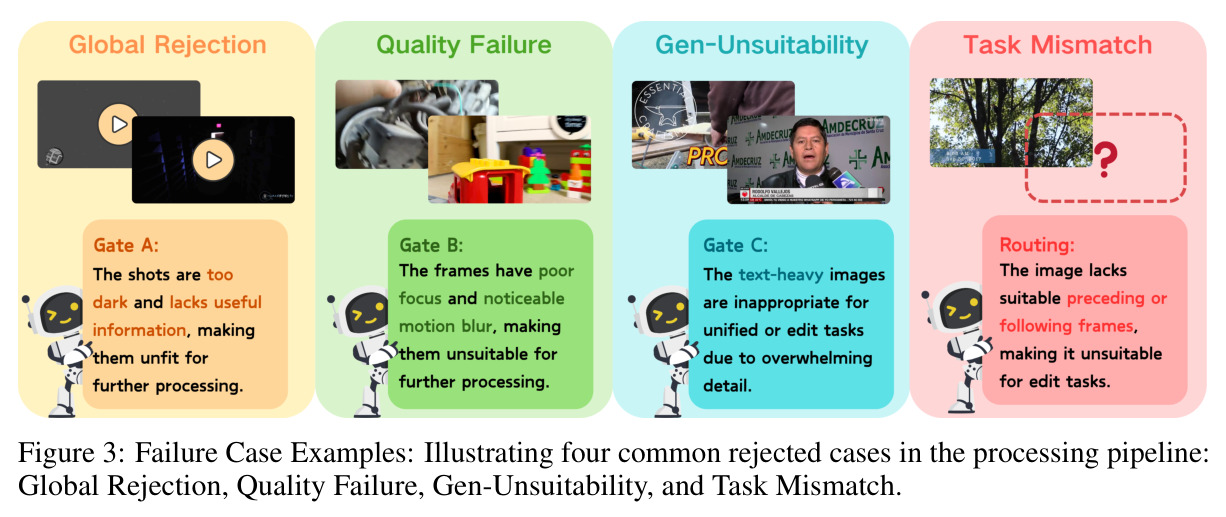
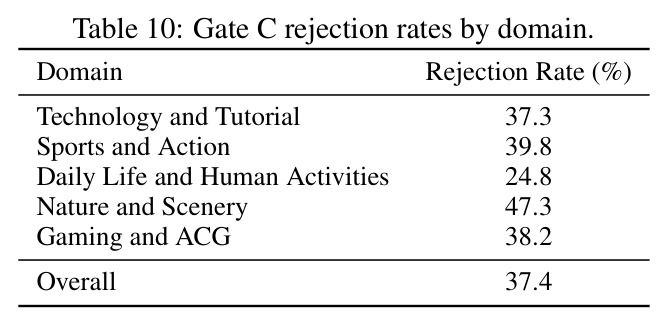
高质量多模态指令数据是 MLLM 与统一多模态模型(UMM)进步的核心瓶颈:人工标注一条理解或编辑样本需要逐帧核对视觉内容,成本极高,而 UMM 同时需要理解、编辑、统一(交错图文生成)三类监督,现有数据生产难以兼顾。论文指出,当前图文数据集主要源自静态图像,天然缺乏真实世界的时序动态与因果交互;视频虽然是最丰富的多模态知识来源(OpenVid-1M、Panda-70M 等语料达百万级),却冗余、嘈杂、非结构化,无法直接作为任务导向的指令数据。已有自动化方案要么直接让强 LLM 生成问答对——缺乏可验证的外部证据,可靠性与可控性存疑;要么像 LLaVA-Video 只从采样帧合成视频理解 QA,覆盖不了编辑与统一任务。一个直观的量化证据是:本文最终只从 8,268 条原始视频(约 224.2 小时)出发产出 10 万条样本,而仅 Gate C 一层就拒绝了 37.4% 的元数据(自然风景类高达 47.3%),说明原始视频到可用指令数据的转化链条极长,必须依赖系统化的质量筛选与结构化处理。
本文的目标是本文的目标是构建一个可扩展、可复现、全自动的数据策划智能体 VidUEU-Agent,把原始视频系统转化为同时支持理解(Understanding)、编辑(Editing)与统一(Unified)三类任务的指令微调数据。具体包括四点:其一,设计四阶段流水线(全局感知、关键帧挖掘、元数据构建、指令数据构建),内嵌 Gate A/B/C 三道质量门,自动剔除低质量镜头、帧与元数据;其二,让每条样本绑定可追溯的工具证据(OCR、ASR、检测、光流、GUI 解析的信号 ID),抑制幻觉;其三,引入自主数据迭代机制——每轮用 3 万样本微调模型、把下游基准成绩反馈给智能体、由其更新能力/领域/任务类型三维目标分布;其四,把流水线规模化成 VidUEU-100K(4 万理解 + 3 万编辑 + 3 万统一样本、约 2 万条细粒度元数据、9 类任务、5 大领域),并在 InternVL3-8B 与 Bagel-7B-MoT 上微调验证数据的有效性与跨模型家族的泛化性。
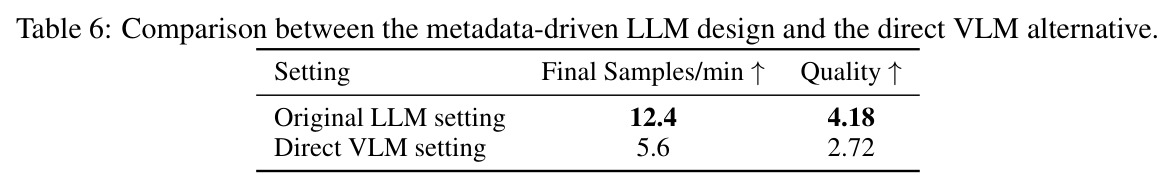
与已有工作不同的是,本文的独特切入角度有三点。第一,用'元数据驱动的 LLM 智能体'替代'直接 VLM 生成':VLM 只负责感知与打分,任务路由和指令合成由拿到结构化元数据(三级摘要、关键帧、工具信号、状态转移)的 LLM 完成,附录 A.5 的对照实验显示该设计在效率(12.4 对 5.6 条/分钟)和质量(GPT-4o 五分制 4.18 对 2.72)上都显著优于直接 VLM 方案。第二,把视频的时序结构当作编辑与统一任务的天然监督源:相邻关键帧共享大部分场景但只在少数对象/属性/状态上不同,恰好匹配'编辑并保持其余不变'的指令编辑本质,也构成可推理的状态转移链,这是静态图文数据集给不了的结构。第三,数据分布不是一次性定死,而是由下游训练成绩反馈驱动的自迭代闭环——能力维度从第 1 轮的理解 50%/编辑 25%/统一 25% 一路调整到第 4 轮的 40%/30%/30%,把'数据配方'本身变成智能体可规划、可优化的对象,这是与'先造数据、后训练'静态范式的根本差异。
核心方法
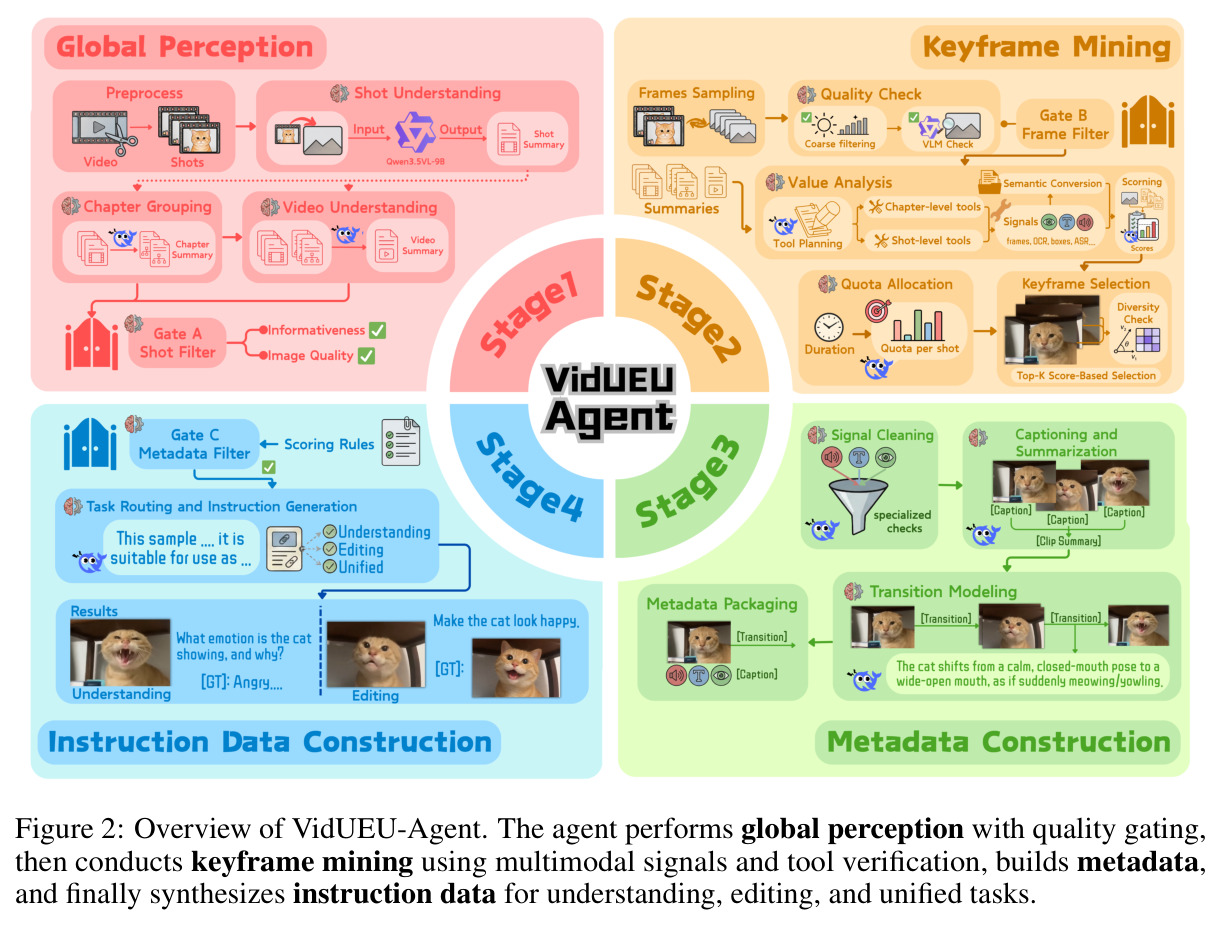
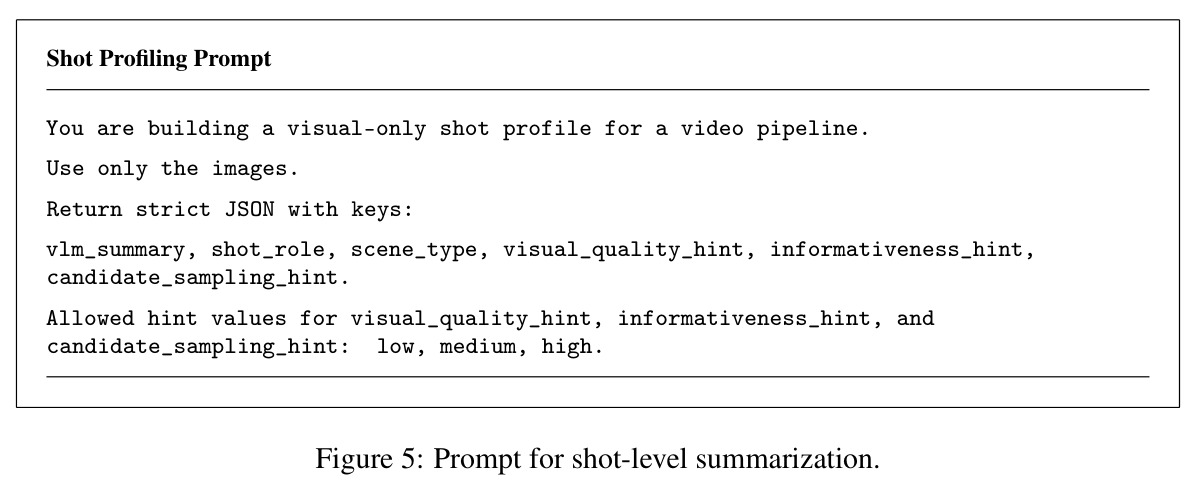
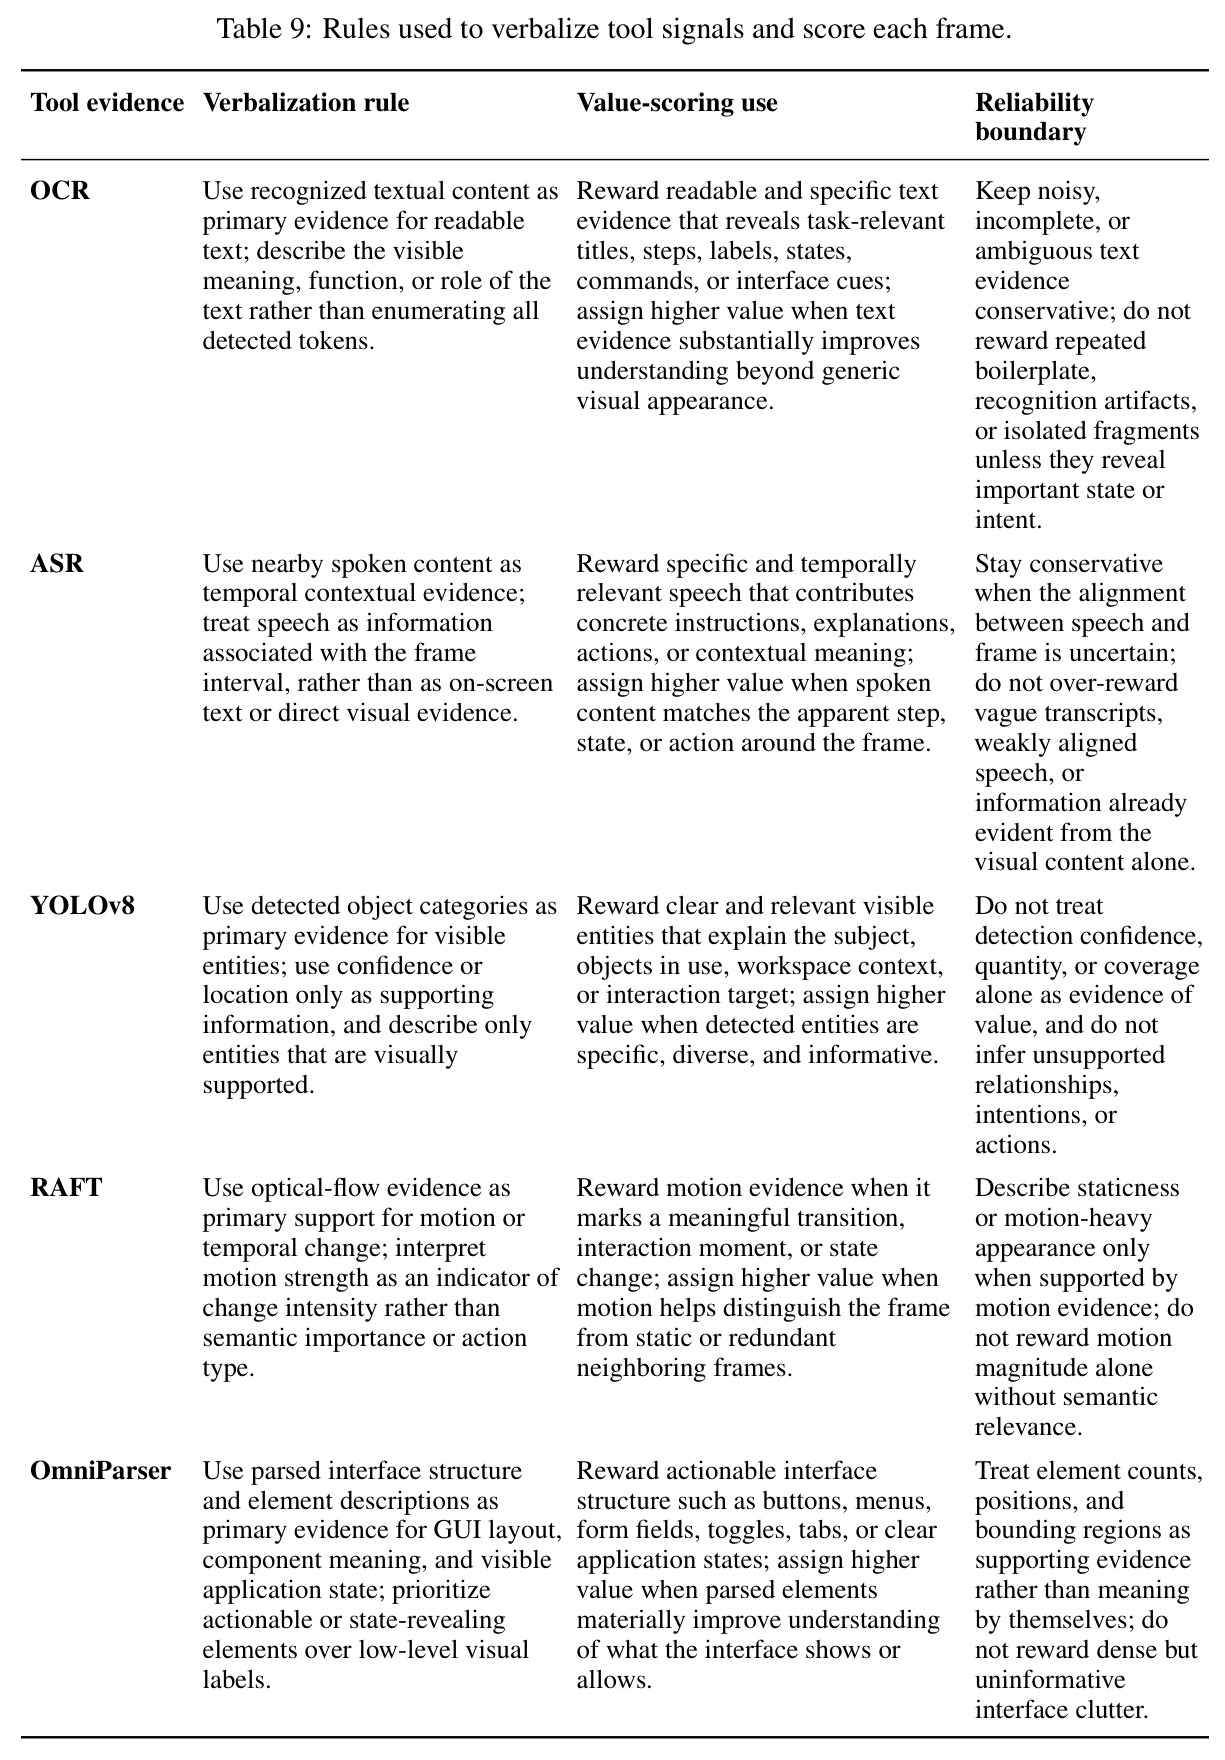
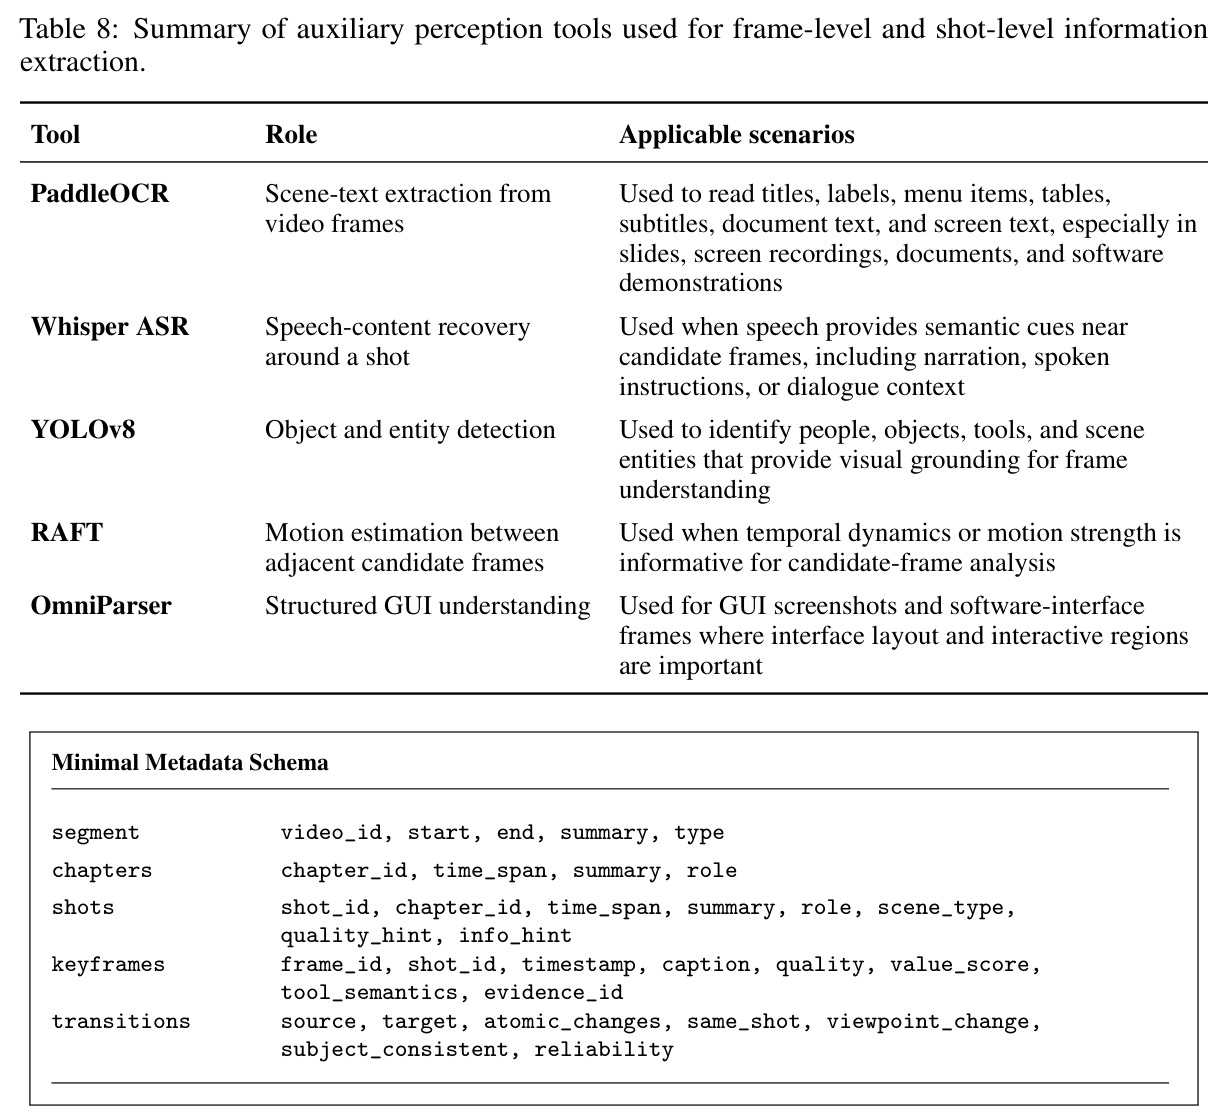
直觉上,论文把'从视频造数据'拆成'先看懂、再选帧、后结构化、终成指令'四步,每步都有质量闸门与证据留存。技术上:Stage 1 全局感知先用 PySceneDetect 切分镜头,VLM 为每个镜头生成摘要,相邻镜头聚成章节并生成章节摘要,再汇总成视频级摘要,Gate A 按信息量与画质淘汰低价值镜头;Stage 2 关键帧挖掘对过审镜头固定间隔采样,Gate B 先用拉普拉斯方差、亮度等 OpenCV 统计量粗筛再用 VLM 九维质检,随后智能体做层级工具规划,从 PaddleOCR、Whisper ASR、YOLOv8、RAFT 光流、OmniParser 五工具池调用并把输出语义化成证据,对每帧打 0–1 价值分,按时长与摘要分配配额,用加权设施选址贪心选出高质量且不冗余的关键帧;Stage 3 过滤不可靠信号,生成相邻关键帧间的原子状态转移与片段摘要并校验事实性,绑成元数据;Stage 4 用 Gate C 过滤元数据(实测拒绝 37.4%)、路由到 9 类任务、生成引用证据 ID 的指令样本;训练成绩再反馈给智能体调整下一轮分布。
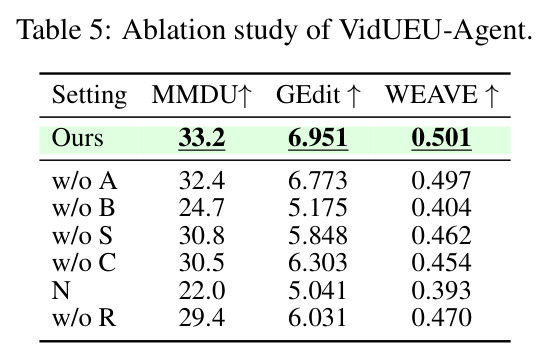
核心创新是把'数据质量'从一次性启发式变成贯穿全程、可审计的证据链系统,并把数据分布交给智能体闭环优化。与已有方法的本质区别:LLaVA-Video 等直接从采样帧合成 QA,既无三级结构也无工具证据;本文要求每条指令必须引用所用信号 ID(如 $[\mathrm{F00\_CAP}]$),这条硬规则强制样本只能基于真实证据生成——消融显示去掉它 MMDU 从 33.2 跌到 29.4。另一关键设计是加权设施选址关键帧选择:$F(S)=\sum_i r_i \max_{j\in S}\mathrm{sim}(i,j)$,权重 $r_i$ 即智能体的语义价值分,$\mathrm{sim}(i,j)=\cos(z_i,z_j)$ 由归一化图像嵌入与字幕嵌入拼接计算,贪心维护覆盖度 $c_i$、每轮加入边际增益最大者,保证关键帧'信息量高且互不冗余';去掉它编辑 G_O 从 6.951 掉到 5.848,说明编辑最依赖非冗余帧对。最后,自迭代机制让训练成绩直接塑造数据配方(每轮 3 万样本、三维分布随反馈调整),是数据合成工作里少见的训练-数据联合优化。
方法步骤详情
Step 1 全局感知:PySceneDetect 切分镜头;VLM 逐镜头产出摘要与画质/信息量提示;镜头聚成章节并逐级生成章节与视频摘要;Gate A 综合三级信息决定每个镜头 accept/reject。Step 2 关键帧挖掘:对保留镜头固定间隔采样;Gate B 先用清晰度/亮度/熵等统计量筛帧,再由 VLM 做九维质检;层级工具规划为章节配 2 个工具、镜头级增删;工具输出被语义化为帧级证据;VLM 按 0–1 打价值分;配额规划器把全局预算分到镜头;加权设施选址贪心在配额内选出关键帧。Step 3 元数据构建:按规则过滤工具信号,为相邻关键帧生成限定于 13 个原子动词的状态转移与片段摘要并校验事实性;绑成含 segment、chapters、shots、keyframes、transitions 的元数据。Step 4 指令构建:Gate C 按信息量、连贯性、整体质量打分拒收;任务路由决定适合 9 类任务中哪几类;模板生成时强制引用证据 ID。Step 5 自迭代:每轮 3 万样本微调 Bagel,评测后反馈智能体更新分布,最终按第 4 轮分布放大到 10 万。
技术新颖性
技术新颖性有四层。其一,证据链式数据合成:工具输出先被'语义化'——把 OCR 文本、检测框、光流强度翻译成对帧的语义描述并明确可靠性边界(如检测置信度本身不算价值),再进入打分与生成,最后样本强制引用信号 ID,形成可追溯闭环。其二,关键帧选择把语义价值评分与设施选址多样性结合:$F(S)=\sum_i r_i\max_{j\in S}\mathrm{sim}(i,j)$,$r_i$ 来自 VLM 的 0–1 价值分,嵌入由图像与字幕拼接,兼顾质量与覆盖。其三,三层 Gate(镜头 A/帧 B/元数据 C)加信号过滤与帧对审查的分级质控,Gate C 实测拒绝 37.4%(Nature & Scenery 最高 47.3%)。其四,自迭代数据分布:智能体接收训练损失、基准分、当前分布与历史反馈,优先调能力维度(最终 40/30/30),领域与任务类型偏差约束在 1 个百分点内。需指出本文属于系统与工程创新而非单点算法创新——切分、OCR、光流、选址、LoRA 均为成熟技术,创新在于组织方式、质控体系与'元数据驱动 LLM 优于直接 VLM'(质量 4.18 对 2.72)的实证结论。
实验结果
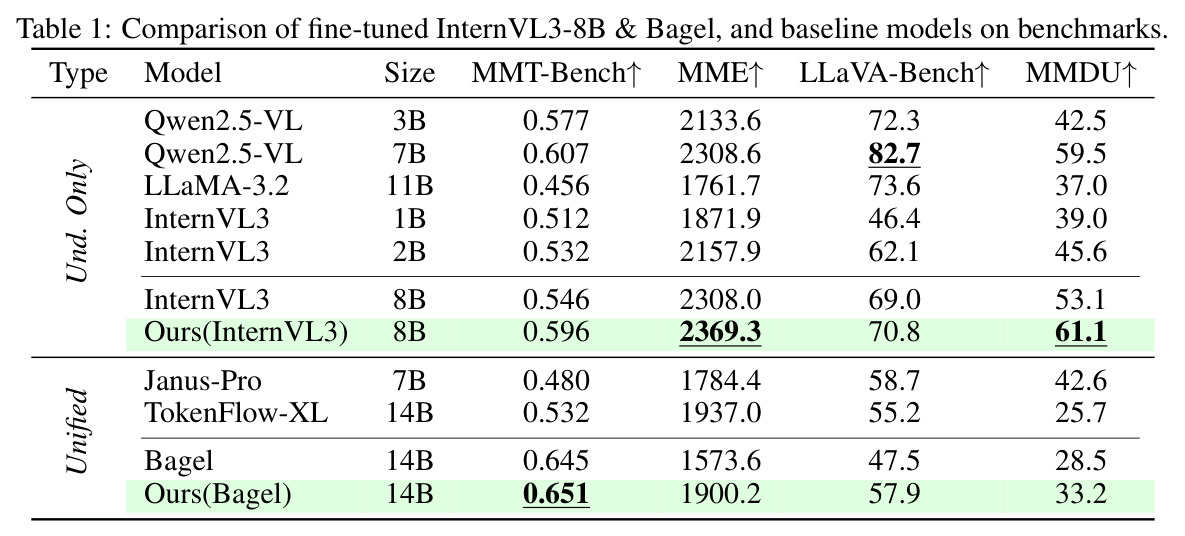
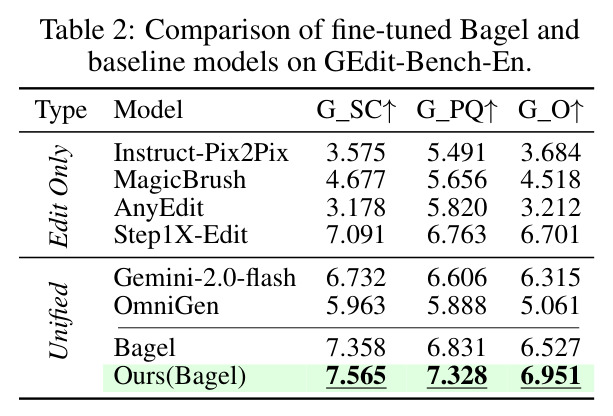
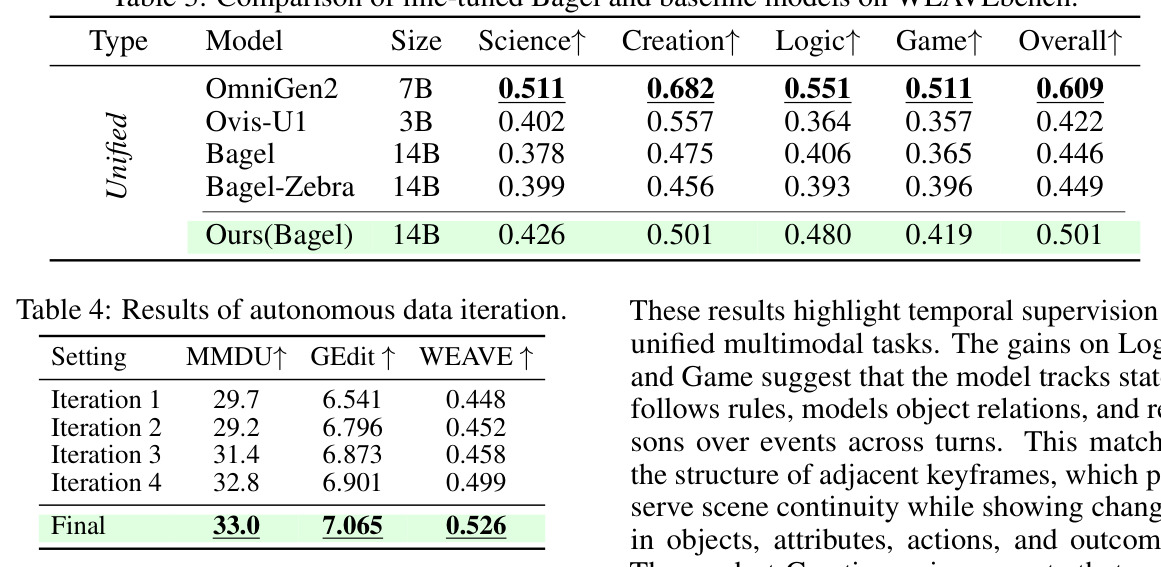
核心结果分五块。理解:InternVL3-8B 微调后 MME 2308.0→2369.3、MMDU 53.1→61.1(+8.0,超过 Qwen2.5-VL-7B 的 59.5);Bagel 微调后 MME 1573.6→1900.2(+326.6)。编辑:Bagel 在 GEdit-Bench-En 上 G_SC 7.358→7.565、G_PQ 6.831→7.328、G_O 6.527→6.951,均超 Step1X-Edit 与 Gemini-2.0-flash;G_PQ 增幅最大,印证状态转移监督利于保真。统一:WEAVEbench Overall 0.446→0.501,超 Bagel-Zebra 的 0.449,但低于 OmniGen2 的 0.609。自迭代:四轮反馈后 MMDU 29.7→33.0、GEdit 6.541→7.065、WEAVE 0.448→0.526。消融:去 Gate B 损失最重(MMDU 24.7、G_O 5.175),无智能体变体仅 22.0。人工审计 800 条,四维 3.99–4.25 分。与三个任务专属基线数据集同设定对比全面占优。
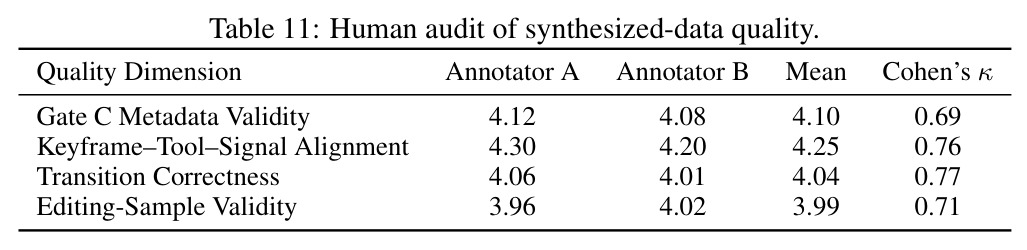
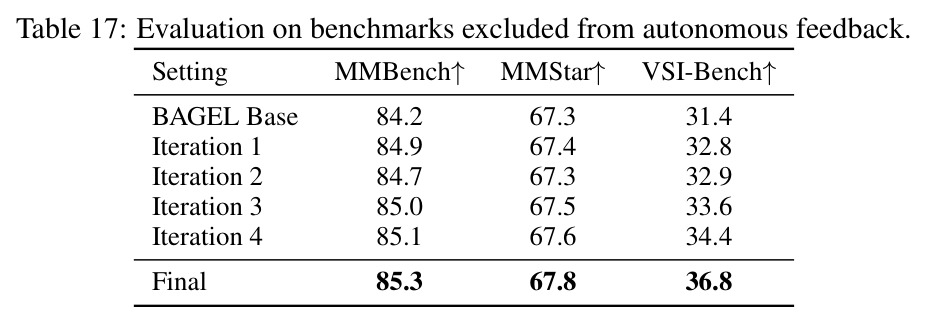
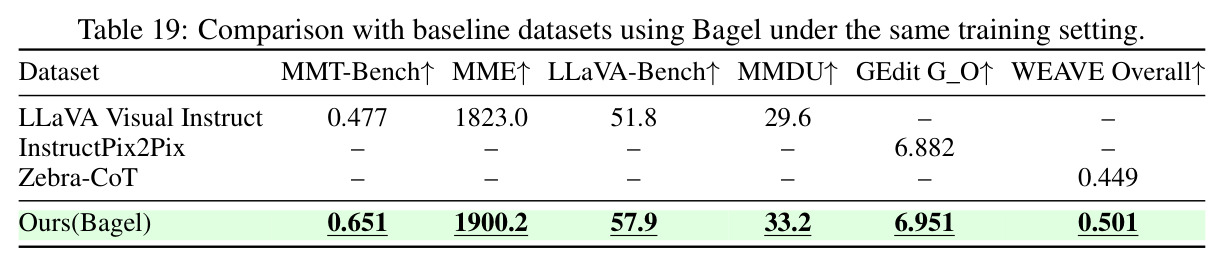
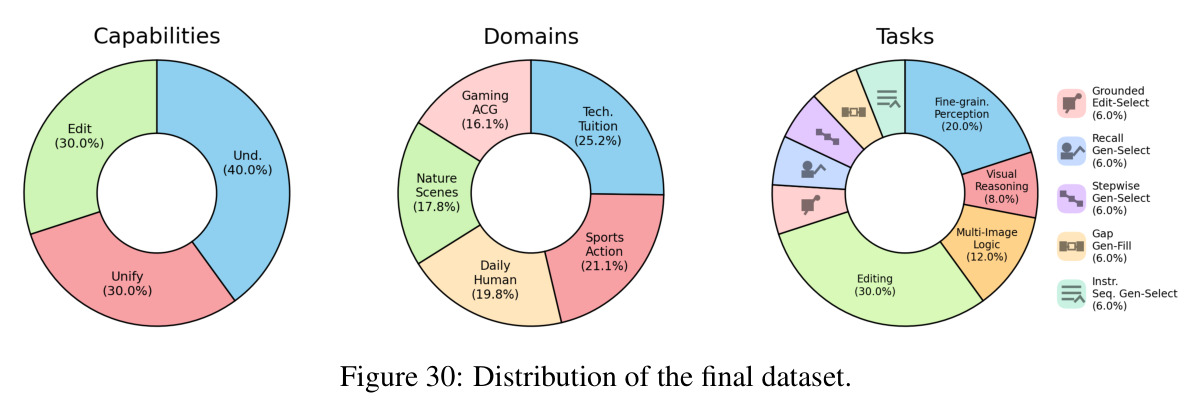
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态理解(InternVL3-8B 微调) | MMDU(多图多轮推理) | 61.1 | 53.1(InternVL3-8B 原始);Qwen2.5-VL-7B 59.5 | +8.0,为全部对比模型最佳 |
| 多模态理解(InternVL3-8B 微调) | MME | 2369.3 | 2308.0(原始);Qwen2.5-VL-7B 2308.6 | +61.3,为全部对比模型最佳 |
| 统一模型理解(Bagel 微调) | MME | 1900.2 | 1573.6(Bagel 原始) | +326.6 |
| 指令图像编辑(Bagel 微调) | GEdit-Bench-En G_SC(语义一致性) | 7.565 | 7.358(Bagel 原始);Step1X-Edit 7.091 | +0.207,超过所有对比编辑模型 |
| 指令图像编辑(Bagel 微调) | GEdit-Bench-En G_PQ(感知质量) | 7.328 | 6.831(Bagel 原始) | +0.497,三项指标中增益最大 |
| 指令图像编辑(Bagel 微调) | GEdit-Bench-En G_O(总体) | 6.951 | 6.527(Bagel 原始);InstructPix2Pix 数据训练 6.882 | +0.424 |
| 统一交错图文任务(Bagel 微调) | WEAVEbench Overall | 0.501(Logic 0.480 / Game 0.419) | 0.446(Bagel 原始);Bagel-Zebra 0.449 | +0.055,但仍低于 OmniGen2 的 0.609 |
| 自主数据迭代(30K/轮联合微调 Bagel,Final 100K) | MMDU / GEdit G_O / WEAVE Overall | 33.0 / 7.065 / 0.526(Final) | 29.7 / 6.541 / 0.448(Iteration 1) | 四轮反馈迭代后分别 +3.3 / +0.524 / +0.078 |
| 无反馈泛化评测(Bagel) | VSI-Bench(空间推理) | 36.8(Final) | 31.4(BAGEL Base) | +5.4;MMBench 84.2→85.3,MMStar 67.3→67.8 |
局限与改进
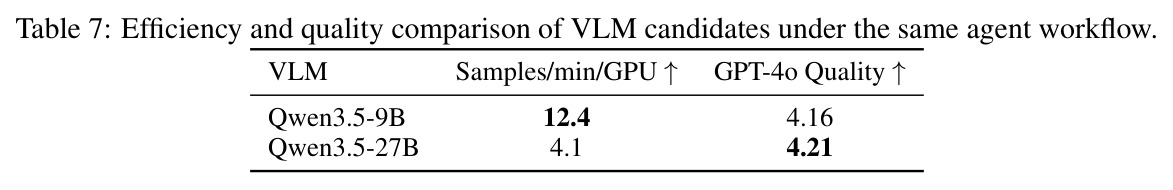
作者承认两点:一是不构造纯文本到图像(T2I)生成数据,因为视频的优势在时序连续性与状态转移,对孤立文图对齐任务直接策展图像更划算;二是受算力与标注资源限制,10 万条规模相对网络级语料仍偏小,更大规模可改善多样性与长尾覆盖。我的补充观察:第一,案例研究显示微调后模型早期轮次表现更好,但长程交错图文链仍易误差传播,说明单条样本交错深度有限;第二,编辑数据被限制为'最多 1–2 个原子编辑'的同镜头小编辑对,难以覆盖复杂多对象或跨视角编辑;第三,自迭代反馈基准(MMDU/GEdit/WEAVE)与最终报告基准重合,无反馈对照中 MMBench 仅 84.2→85.3、MMStar 67.3→67.8,泛化性证据偏弱,不能排除对反馈基准的隐性过拟合;第四,质量上限受 Qwen3.5-9B(为效率放弃 27B:质量 4.16 对 4.21)与 DeepSeek-V3 限制,VLM 幻觉可能沿流水线传播,人工审计仅 800 条、抽样覆盖率低;第五,评测依赖 GPT-4.1/GPT-4o 判官,作者只报告判官三次运行的方差(如 WEAVE 约 0.013)而非人机一致性,判官偏差未被校准。
独立分析的弱点
独立分析几个弱点。第一,反馈基准与评测基准耦合:自迭代用 MMDU/GEdit/WEAVE 指导分布,最终也主打这三个基准,无反馈对照中 MMBench/MMStar 提升不足 1.5 分,分布优化对泛化的实际贡献存疑——应固定 held-out 探针并扩容。第二,视频信息被压缩为关键帧加原子转移,音频只剩 ASR 邻近文本、时序只到时间戳粒度,动作连续性与因果结构表达有限,这可解释统一任务中 Creation 增益最小(0.475→0.501)而 Logic(0.480)增益大——可引入密集时序采样或音视频联合信号。第三,编辑对仅限同镜头相邻关键帧、1–2 个原子编辑且需预审,系统性排除大视角变化与场景切换类编辑;可用跨镜头配对或扩散模型合成复杂编辑对。第四,Gate B 质检与价值打分依赖单一 Qwen3.5-9B,误判会沿链传播;可用双 VLM 交叉验证或不确定性估计。第五,自迭代每轮要在 8×A100 上重训 3 万样本的 Bagel,且第 2 轮 MMDU 回退(29.7→29.2),分布更新仍偏启发式试错——可引入数据估值或影响函数,用小探针训练估计各类数据的边际贡献。
未来方向
作者提出的方向:把数据规模从 10 万向更大规模扩展,以提升多样性、长尾覆盖与训练稳定性;为纯 T2I 生成任务补充专门的图像策展管线(而非强行用视频源);在更充分资源下继续降低人工审查比例。基于本文成果可以延伸的方向:其一,把自迭代从启发式分布调整升级为可优化的数据选择问题——训练损失与学习曲线已反馈给智能体,可以进一步用影响函数或数据估值给每条样本定边际贡献;其二,把管线扩展到视频生成与长视频理解,元数据中的状态转移链天然是时序一致性监督,可构造视频级生成任务;其三,跨架构验证:目前只在 InternVL3(纯理解)与 Bagel(统一)两个基座上微调,Janus-Pro、TokenFlow 等其他 UMM 上的迁移值得检验;其四,把证据引用机制(signal ID citation)从数据侧推广为训练时的 grounding 正则,让模型在推理时也学会引用视觉证据,可能缓解幻觉;其五,结合主动学习闭环:Gate C 的域级拒绝率差异(Nature & Scenery 47.3% 对 Daily Life 24.8%)本身就是信号,可反哺视频采集策略,从源头提高有效转化率。
复现评估
复现评估:代码在 GitHub 开源(github.com/LRuca/VidUEU-Agent),附录 A–E 公开几乎全部 prompt(三级摘要、三道 Gate、工具规划、信号语义化、打分、配额、转移生成、任务路由、9 类任务模板),并给出元数据 schema 与选址算法的数学定义,透明度很高。算力:合成侧用 Qwen3.5-9B 作 VLM(单张 H20 上 12.4 条/分钟)加 DeepSeek-V3 作规划 LLM(API),五个工具均开源可部署;训练侧 InternVL3-8B LoRA 只需 2×A100-40G,Bagel 需 8×A100-40GB(LoRA $r=16,\alpha=32$)。数据源 OpenVid-1M、Panda-70M、FineGym、BDD100K 等公开可得,但 VidUEU-100K 本体是否随仓库发布需到 GitHub 确认。评测需 GPT-4.1/GPT-4o 判官,有 API 成本;完整复现自迭代需 4 轮×3 万样本重训。总体难度中等偏上:单阶段复现容易,全流水线加自迭代需可观预算,且依赖较新的模型版本。
论文图表
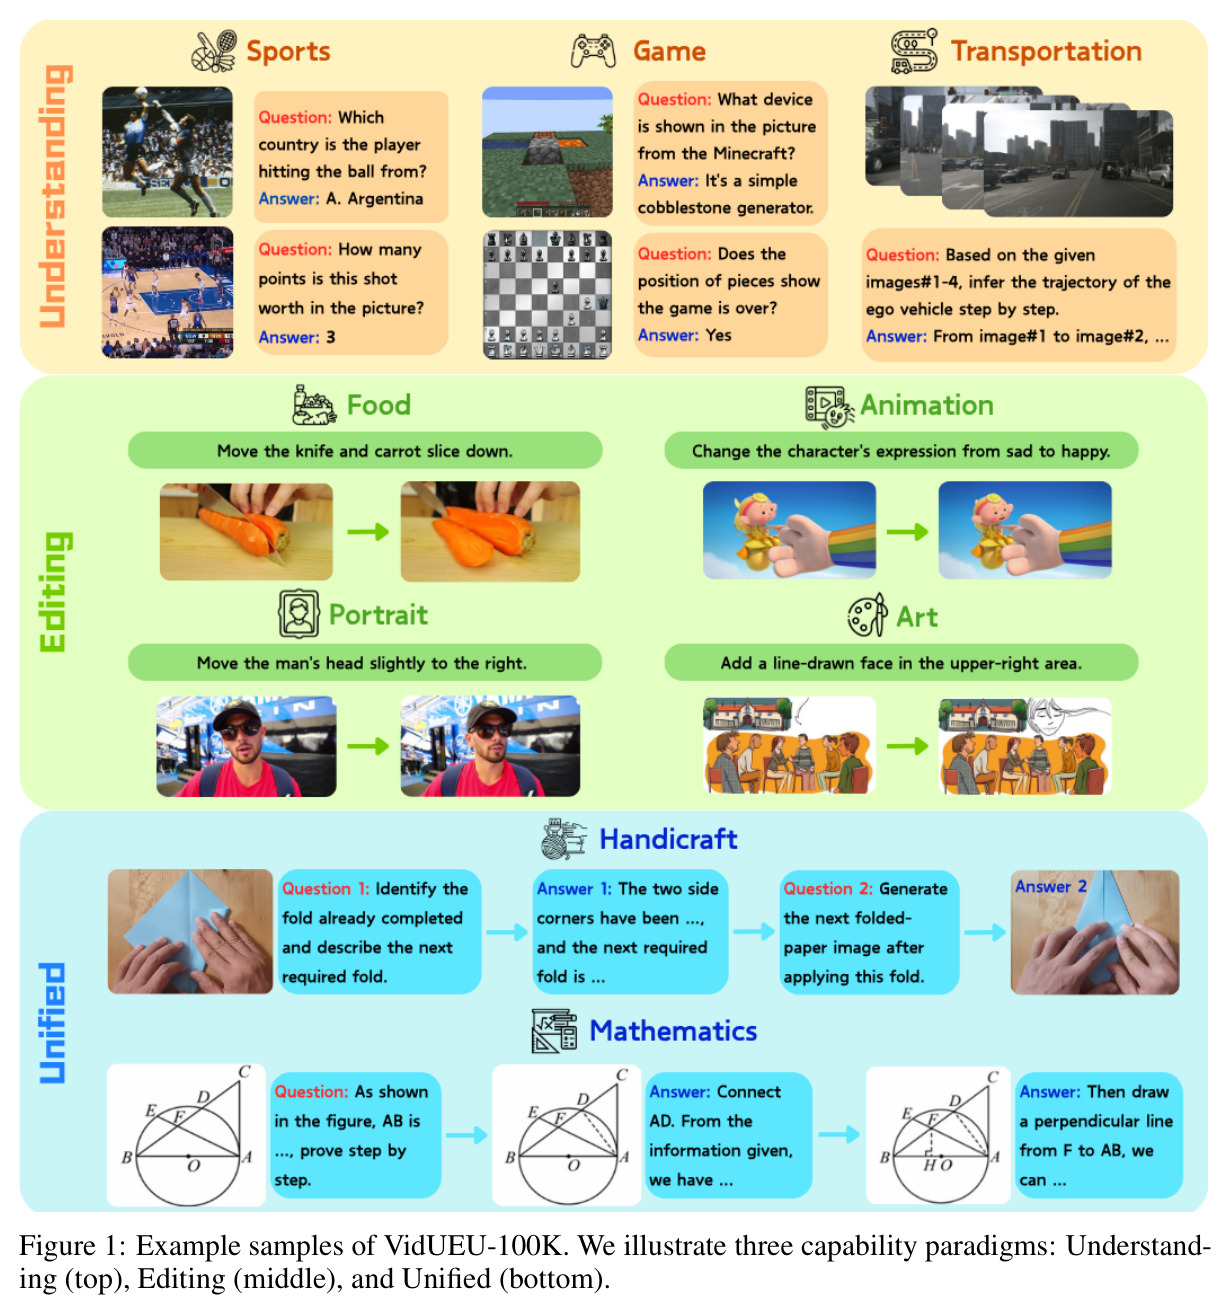
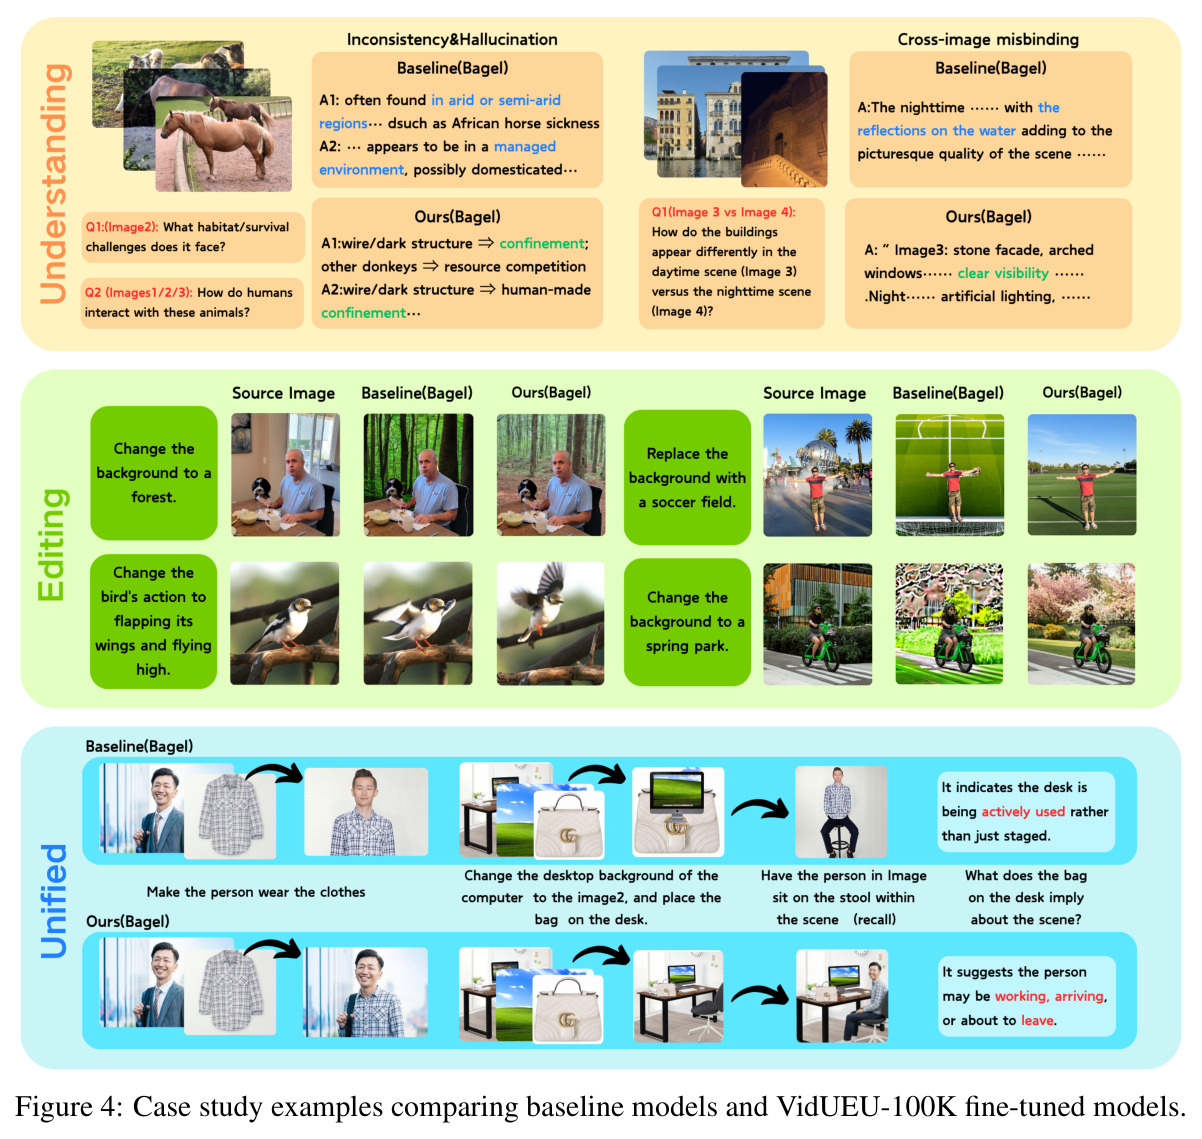
展示 VidUEU-100K 中三类能力范式的真实样本:上方为理解类问答样本,中间为指令图像编辑样本(源图+编辑指令+目标图),下方为统一类交错图文样本(理解、生成、选择多轮组合)。
让读者直观看到数据长什么样:三类样本的结构、回合数与视觉输入输出形态,是理解数据集设计与后续任务模板的基础。