SphereFlow:基于超球面几何传输的缺失模态补全 SphereFlow: Missing Modality Imputation via Geometric Transport on Hypersphere
把缺失模态补全重构为共享超球面上的短程几何传输,化解流匹配的两大几何冲突
前置知识
流匹配
一类生成建模范式:学习由速度场 $v_\theta(z_\tau, \tau)$ 定义的常微分方程,把源分布连续传输到目标分布。标准设定源为高斯噪声 $\epsilon \sim \mathcal{N}(0, I)$,插值 $z_\tau = \tau z_1 + (1-\tau) \epsilon$,训练目标为回归条件速度 $u_\tau = z_1 - z_0$,推理只需少量步数的数值积分。
本文方法主干就是在球面 latent 之间学速度场,不懂插值与速度记号就看不懂式 (2)(5)(6),以及两个几何冲突从何而来。
缺失模态补全
同一对象部分模态已观测(如脑 MRI 的 T1、T2),要求合成未观测模态(如 T1c、FLAIR)的任务。临床中扫描时间、费用或禁忌症常导致模态缺失,补全可让依赖完整模态的下游模型照常工作。本文覆盖 BraTS 四种 MRI 模态的 12 个 1-to-1 方向与 14 种 N-to-N 输入组合。
这是论文要解决的任务本身,所有实验设计(1-to-1、N-to-N、下游分割)都围绕缺失场景展开。
DINOv2
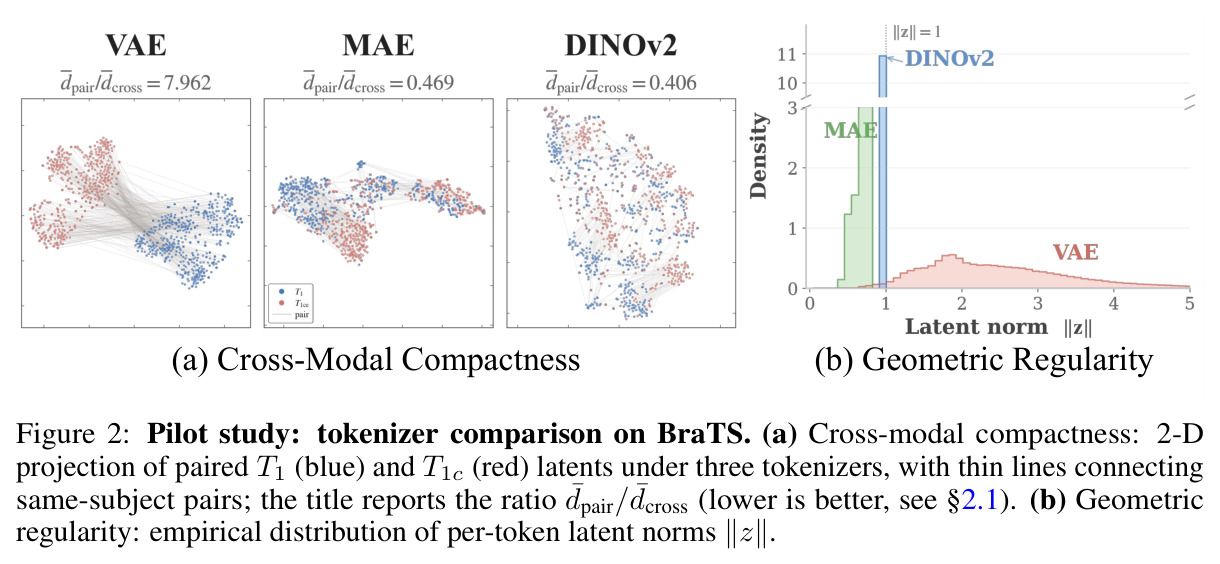
Meta 的自监督视觉基础模型,通过对比式自蒸馏训练 ViT,特征以语义(主体身份)为主而非像素统计;其输出层带 LayerNorm,使 token 范数恒约为 1,天然集中在超球面 $S^{d-1}$ 上。本文实测其配对 T1/T1c 距离比 $d_{cross}/d_{intra} = 0.41$ 且范数变异系数近零。
整个方法建立在 pilot study 的结论之上:DINOv2 是唯一同时满足跨模态紧凑性与几何规整性的 tokenizer。
表征自编码器(RAE)
Zheng et al. 2025 提出的架构:不做 VAE 式概率压缩,而是冻结 DINOv2 作编码器、训练强解码器直接从其表征重建图像,兼得语义表征与高保真解码。本文扩展为每个模态一个 ViT-G/14 解码器 $D_\phi^{(m)}$,共享同一球面 latent 空间。
SphereFlow 的 tokenizer 就是 RAE;而『解码器只在球面上训练过』这一性质正是 Conflict II(离流形盲区)的根源。
超球面几何
$S^{d-1} = \{z \in \mathbb{R}^d : \|z\| = 1\}$,点间关系由夹角 $\alpha$(即余弦相似度)刻画。球面上两点的线性插值中点范数 $\|z_\tau\| < 1$,必然落进球内部,最大偏离量为 $1 - \cos(\alpha/2)$,这是全文偏差分析的核心几何事实。
两个几何冲突、命题 1 的维度无关界、解码器扩展损失,全都由『线性插值离开球面』这一事实推出。
Diffusion Transformer(DiT)
把 ViT 架构用于扩散/流模型的速度场预测,输入噪声 latent、时间步与条件,是当前主流图像生成骨干(如 SD3)。本文用 DiT 作为跨模态速度场主干,输入 $z_\tau$、时间 $\tau$ 与目标模态指示符 $c$,单个模型即可覆盖所有补全方向。
它是 Stage 2 训练的对象,论文的实现细节与算力需求评估都绕不开这个骨干网络的规模。
BraTS 与 SynthRAD2023
BraTS 是多模态脑肿瘤分割基准,提供配对的 T1、T1c、T2、FLAIR 四种 MRI;SynthRAD2023(脑部 track)提供配对 CT 与 T1 加权 MRI。本文取轴向 $256 \times 256$ 切片、去颅骨、按 volume 归一化并沿用官方划分。
两个数据集分别覆盖『同物理模态间补全』与『跨成像物理翻译』两种难度,是主实验和消融的载体。
研究动机
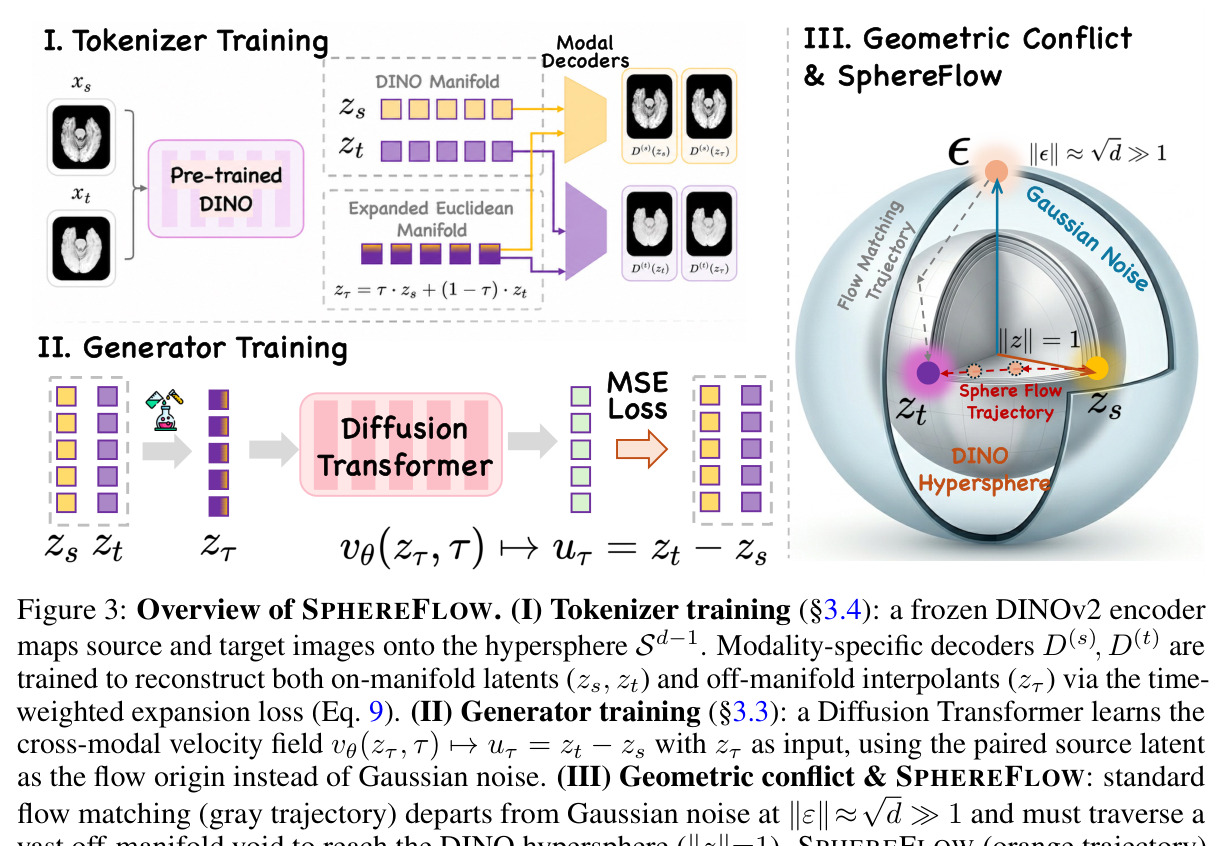
现有缺失模态补全方法(GAN 系如 MMSyn、MMGAN,扩散/流系如 MMT、M2DN、ModImp、CodeBrain、Zhang)都把补全当作一般条件生成,隐含假设每个模态各自 living 在独立的 latent 流形上:像素空间或 VAE 空间由外观统计主导,同一大脑的 MRI 与 CT 因像素分布完全不同而落在不相干区域,模型必须为每一对 source-target 学一层外观级映射,模态数增多时组合爆炸、扩展性差。更根本的是,标准 flow matching 以高斯噪声 $\epsilon \sim \mathcal{N}(0, I)$ 为源,$\|\epsilon\| \approx \sqrt{d}$($d = 768$ 时约 27.7),而数据位于单位球面 $\|z\| = 1$,插值轨迹必须横跨巨大的离流形空腔,速度场被迫同时学径向收缩、方向旋转与模态位移三件纠缠的事,其中只有最后一件与跨模态任务相关,且观测模态本身这个现成的语义起点被白白丢弃。
本文的目标是本文目标是把缺失模态补全重新表述为共享超球面 $S^{d-1}$ 上的短程几何传输。具体分三步:先通过 pilot study 确立跨模态 latent 空间必须满足的两条性质——跨模态紧凑性(同 subject 不同模态的距离远小于同模态不同 subject)与几何规整性(latent 集中在已知几何的流形上),并选定 DINOv2-RAE 作为载体;再解决把流匹配搬到球面上暴露的两个几何冲突——源分布失配与离流形解码盲区;最终在 BraTS 多对比度 MRI 补全(12 个 1-to-1 方向、14 种 N-to-N 组合)与 SynthRAD2023 CT–MRI 翻译上达到生成保真度 SOTA,并让用补全数据做的脑肿瘤分割接近全模态 oracle——论文的目标线是关闭约 80% 的 Dice 缺失差距。
与已有工作不同的是,独特之处在于把瓶颈从『生成』挪到『表征』,并用可控实验支撑:论文定量比较 VAE、MAE、DINOv2 三种 tokenizer,VAE 的 $d_{cross}/d_{intra} \approx 7.96$(模态天各一方),MAE 靠表征塌缩把比值降到 0.47 但抹掉了 subject 身份,只有 DINOv2 以 0.41 同时保持紧凑与可分。生成侧则提出 data-as-source:用观测模态的 latent $z_s$ 取代高斯噪声作流起点,并证明这使最坏离流形偏差从随维度增长的 $\Theta(\sqrt{d})$ 降到仅由模态间夹角决定的 $1 - \cos(\alpha/2)$,与维度无关;配套的时间加权解码器扩展损失把解码器定义域覆盖到流经过的近表面区域。与 Riemannian flow matching(SLERP 路径但起点仍是噪声)和 LV-RAE(扩解码器但无几何结构)不同,本文是第一个同时处理两个几何冲突的方法。
核心方法
直觉是:同一解剖结构的不同模态共享同一语义、只差外观,若把它们投进一个按语义组织、几何规则的空间,补全就从『长距离凭空生成』退化为『近邻点间的短程搬运』。技术路线分两阶段:Stage 1 训练 tokenizer——冻结 DINOv2-B/14 作共享编码器把所有模态映到 $S^{d-1}$,为每个模态配一个 ViT-G/14 RAE 解码器,按三步训练(单模态重建 warm-up、跨模态插值点上的流形扩展、编码器对齐微调),使解码器既能在球面上重建,也能在流经过的弦区域重建;Stage 2 训练 DiT 速度场——在冻结 tokenizer 下以跨模态流匹配损失 $\mathcal{L}_{CMFM}$ 学习 $z_s \to z_t$ 的位移场,训练最多 400 epochs 并用 logit-normal 时间采样。推理时从 $z_s$ 积分 ODE(BraTS 用 2 步、SynthRAD 用 4 步 Euler),再用目标模态解码器出图;N-to-N 场景把多个可用源 latent 平均成单个 $z_s$。
核心是两个几何感知改动。其一,源分布替换:不做从噪声 $\epsilon$($\|\epsilon\| \approx \sqrt{d}$)到 $z_t$ 的生成,而以同 subject 观测模态的 latent $z_s \in S^{d-1}$ 作流起点,插值 $z_\tau = \tau z_t + (1-\tau) z_s$、目标速度 $u_\tau = z_t - z_s$,速度场只学模态特异位移;由命题 1,最大离面偏差 $\Delta = 1 - \cos(\alpha/2)$ 仅由模态间夹角决定、与维度无关,而高斯源是 $\Theta(\sqrt{d})$。其二,解码器域扩展:线性插值必使 $\|z_\tau\| < 1$ 落入球内,而 RAE 解码器只在球面上训练过;式 9 以 $\tau$ 与 $(1-\tau)$ 分别加权目标、源解码器,使二者都能从弦上任意点重建,权重与 latent 混合比例一致、避免梯度冲突。区别于起点仍为噪声的 Riemannian FM 和无几何结构的 LV-RAE,这是首个同时化解两个冲突的方案。
方法步骤详情
流程:BraTS/SynthRAD 取轴向 $256 \times 256$ 切片、去颅骨、归一化、官方划分。Stage 1a warm-up:解码器 $D_\phi^{(m)}$ 从 $z = E_{DINO}(x)$ 重建本模态,损失为 L1 + LPIPS + GAN(式 1)。Stage 1b 流形扩展:对跨模态对的插值点 $z_\tau = \tau z_t + (1-\tau) z_s$,按式 9 的 $(1-\tau)/\tau$ 加权同时训练两个解码器。Stage 1c 对齐:解冻编码器 $E_\psi$,以 token 级余弦加 GAP 的 MSE 锚向冻结副本 $E^0$(式 11),随后冻结。Stage 2:DiT 用 logit-normal 时间采样训练至多 400 epochs,学式 6 的 $\mathcal{L}_{CMFM}$($c$ 为目标模态指示符)。推理从 $z_s$ Euler 积分 2 步(BraTS)或 4 步(SynthRAD)得 $\hat{z}_t$ 再解码;N-to-N 时把源 latent 平均成 $z_s$。
技术新颖性
新颖性有三层。理论上,命题 1 给出线性插值最大离流形偏差 $\Delta = 1 - \cos(\alpha/2)$ 的解析界,并把高斯源情形刻画为期望偏差 $\Theta(\sqrt{d})$——首次把『data-as-source 为什么好』从经验直觉变成维度无关的定量结论。实证上,pilot study 用 $d_{cross}/d_{intra}$(VAE 7.96、MAE 0.47、DINOv2 0.41)和范数变异系数 $\mathrm{CV}_r$ 系统量化『什么样的 latent 空间适合做传输』,这组指标可被后续工作直接复用。工程上,两阶段解耦设计使 tokenizer(编码器 + 全模态解码器)只训一次,DiT 可按模态对单独训练或微调而无需动解码器;Stage-wise 消融(Table 5)进一步显示 Step 3 编码器对齐是决定性的:on-manifold PSNR 从 33.83 跳到 44.06,chord 与 on-manifold 的 rFID gap 从 13.4 收敛到 0.3,说明对齐后流轨迹几乎与数据流形重合。
实验结果
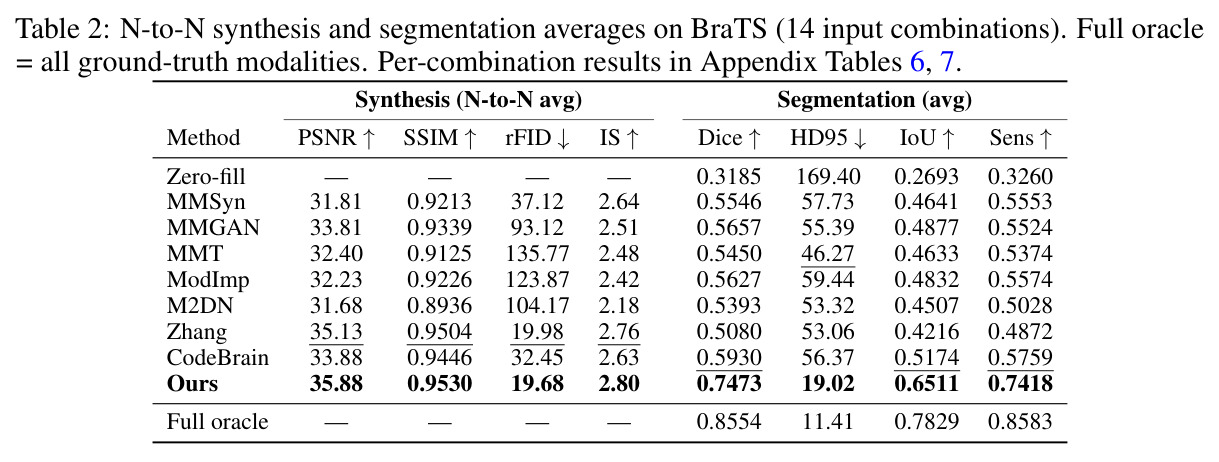
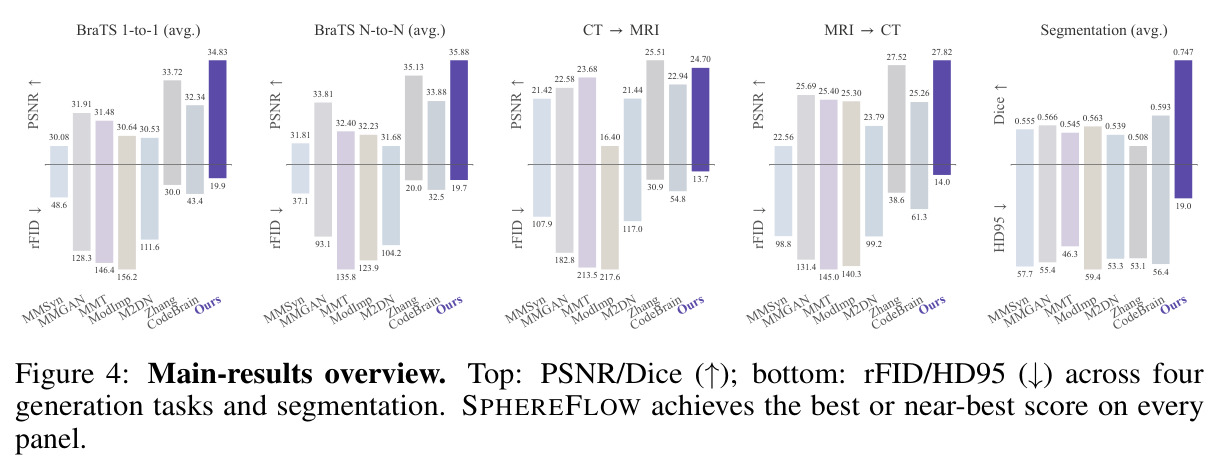
主实验全面领先。BraTS 1-to-1(12 方向平均):PSNR 34.83 dB(次优 Zhang 33.72),rFID 19.93 较 Zhang 29.99 降 33.6%,SSIM 0.9466,最难 T2→T1c 领先 1.24 dB。N-to-N(14 组合):PSNR 35.88、SSIM 0.9530、rFID 19.68。CT–MRI:MRI→CT 全面最佳(27.82 dB、rFID 13.99);CT→MRI PSNR 24.70 略低于 Zhang,但 rFID 13.65 不到对方 30.91 的一半。下游分割:平均 Dice 0.7473(次优 CodeBrain 0.5930),HD95 46.27→19.02,距全模态 oracle 0.8554 仅差 0.108,关闭约 80% 差距;单源输入 baseline 崩到 Dice 0.10–0.20,本文仍 >0.45。消融:DINOv2 较 MedMAE 让出 0.66 dB PSNR 但 iFID 好 3.6 倍(40.64 vs 144.45);对齐使 chord rFID 41.66→16.28。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BraTS 1-to-1 多对比度 MRI 合成(12 方向平均) | PSNR (dB) | 34.83 | Zhang 33.72(其余 MMSyn 30.08、MMGAN 31.91、MMT 31.48、ModImp 30.64、M2DN 30.53、CodeBrain 32.34) | +1.11 dB,且 12 个方向全部第一 |
| BraTS 1-to-1 多对比度 MRI 合成(平均) | rFID | 19.93 | Zhang 29.99 | 下降 33.6% |
| BraTS N-to-N 合成(14 种输入组合平均) | PSNR / SSIM / rFID | 35.88 / 0.9530 / 19.68 | Zhang 35.13 / 0.9504 / 19.98 | PSNR +0.75 dB,rFID 再降 1.5% |
| BraTS 缺模态下游脑肿瘤分割(平均) | Dice / HD95 | 0.7473 / 19.02 | CodeBrain 0.5930 / 56.37;全模态 oracle 0.8554 / 11.41 | Dice +15.4 个百分点,HD95 相对最优 baseline 降 59%,关闭约 80% 的 oracle 差距 |
| SynthRAD2023 MRI→CT 翻译 | PSNR / SSIM / rFID | 27.82 / 0.9084 / 13.99 | Zhang 27.52 / 0.8944 / 38.61 | 全面领先,rFID 下降 63.8% |
| SynthRAD2023 CT→MRI 翻译 | rFID | 13.65 | Zhang 30.91(其 PSNR 25.51、SSIM 0.8635 略高于本文 24.70 / 0.8452) | rFID 下降 55.8%(PSNR/SSIM 略低于 Zhang) |
局限与改进
作者承认的局限:方法依赖 DINOv2 提供的跨模态紧凑性,文本与影像这类没有共享视觉语义的模态无法直接套用,需要领域适配编码器或跨模态预训练阶段。我的补充观察:(1) Stage 1 的扩展与对齐都建立在大规模配对多模态数据上,而临床中完全配对的队列稀缺;(2) 每模态一个 ViT-G/14 解码器,成本随模态数线性增长,扩展到十几个模态不现实;(3) 处理单元是 2D 轴向切片,忽略 3D 上下文与层间连续性,rFID/HD95 也按切片计算;(4) CT→MRI 上 PSNR/SSIM 仍落后 Zhang(24.70 vs 25.51),说明像素保真与分布级保真之间存在权衡;(5) N-to-N 的多源融合只是把源 latent 取平均,未探索加权或学习式聚合;(6) 理论界只约束轨迹的最大离面偏差,不保证路径最短或解码最优,也未讨论源-目标不对称时的误差差异。
独立分析的弱点
独立分析的弱点:(1) 配对数据依赖——Stage 1b/1c 都建立在成对 $(x_s, x_t)$ 上,遇到只有部分配对的临床队列如何半监督训练没有讨论,改进方向是把对齐目标改为循环一致性或用跨 subject 伪对。(2) 线性弦并非球面最短路——作者选欧式 ODE 以换取推理简洁,但弦恰恰离开球面;可在解码器扩展之外尝试测地线(SLERP)插值或对速度场加切向投影约束,把离流形区域压得更小。(3) 评测偏 2D——$256 \times 256$ 切片级 rFID 对临床关心的 3D 一致性不敏感,建议补充 3D 体积指标与层间抖动度量。(4) N-to-N 等权平均——不同源模态对目标的可靠性差异大(如 T2→T1c 远难于 T1→T1c),可按估计夹角 $\alpha$ 或源质量自适应加权。(5) 分割对照不完整——比较的是『补全输入』而非『补全 + 缺失感知训练』的组合,缺少与 modality-dropout 训练这类强 baseline 的对照,0.108 的 oracle 差距未必都归因于补全质量。每个弱点都指向一个可检验的改进实验,适合作为后续工作切入点。
未来方向
作者提出的方向:把『latent 几何对齐任务结构』的原则推广到其他有配对源数据的条件生成,例如图像引导的语音合成、卫星多光谱融合。可延伸的研究:(1) 为无共享视觉语义的模态(文本–影像、基因–影像)设计领域适配或跨模态预训练编码器,论文已在 Limitation 中点名;(2) 把 2D 切片方案升级为 3D 体 tokenizer,检验球面传输在体积数据上是否保持维度无关的偏差界;(3) 与 Riemannian flow matching 结合,保留 data-as-source 的同时用 SLERP/测地线路径把离流形偏差压到接近零,并对比 2 步推理下的速度-质量权衡;(4) 研究连续模态谱(不同扫描协议、不同厂商参数)之间的插值,把夹角 $\alpha$ 变成可估计的量,据此自适应选择积分步数;(5) 用学习式聚合替代 N-to-N 平均,并考察速度场对源数量的泛化能力;(6) 把补全数据与缺失感知训练结合,检验能否进一步缩小与全模态 oracle 剩余 0.108 的 Dice 差距。
复现评估
复现条件中等偏上。有利因素:代码已开源(github.com/WTHH031230/SphereFlow);两个数据集公开(BraTS 2021、SynthRAD2023 brain track);关键实现细节齐全——DINOv2-B/14 编码器、每模态 ViT-G/14 RAE 解码器、DiT 主干 + logit-normal 时间采样、至多 400 epochs、推理 2/4 步 Euler、N-to-N 用 latent 平均,Stage 1 三步损失(式 1、9、11)均有公式。不利因素:ViT-G/14 解码器与 DiT 的训练量大,论文未公布 GPU 数量与时长,单张消费级显卡难以完整复现,RAE 解码器还需参考 Zheng et al. 2025 的预训练初始化;pilot study 统计脚本与 12 个方向各自是否独立训练 DiT 未明确说明。建议路径:先用 ViT-B 级解码器 + 小型 DiT 在 BraTS 单方向(如 T1→T1c)跑通两阶段流程,核对 Table 5 的消融趋势(对齐带来约 10 dB 跳升),再扩展到全方向与 CT–MRI。
论文图表
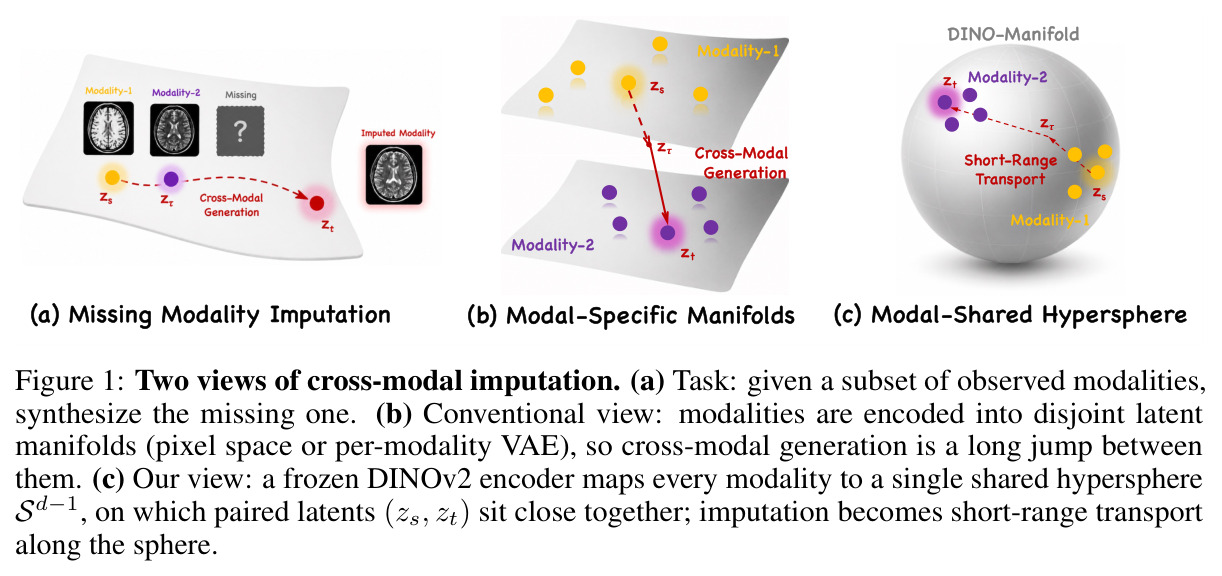
三联图:(a) 任务示意——给定部分观测模态,合成缺失模态;(b) 传统观点——各模态被编码到互不相交的 latent 流形(像素空间或每模态 VAE),跨模态生成是流形之间的长跳跃;(c) 本文观点——冻结 DINOv2 把所有模态映到同一个超球面 $S^{d-1}$,同 subject 的配对 latent $z_s$、$z_t$ 彼此靠近,补全变成球面上的短程传输。
一张图讲清论文的核心视角转变:从『模态专属流形间的长跳』到『共享球面上的短程搬运』,是理解全文动机与方法设计的入口。
T1、T1c、T2、Tf(FLAIR) 四种模态全部 12 个 translation 方向上,8 个方法(MMSyn、MMGAN、MMT、ModImp、M2DN、Zhang、CodeBrain、Ours)的 PSNR、SSIM、rFID、IS。Ours 平均 PSNR 34.83 / SSIM 0.9466 / rFID 19.93 / IS 2.81;每个方向的 PSNR 均第一,rFID 除 T2→T1(25.88 略高于 Zhang 20.78)外基本最优。
核心主表:验证『短程传输』在所有配对方向上一致有效,且最难方向(T2→T1c,+1.24 dB)收益最大,支撑几何优势的主张。
跨成像物理的 CT→MRI 与 MRI→CT 双向翻译。MRI→CT 方向 Ours 全面最佳:PSNR 27.82、SSIM 0.9084、rFID 13.99;CT→MRI 方向 Ours PSNR 24.70 / SSIM 0.8452 略低于 Zhang(25.51 / 0.8635),但 rFID 13.65 远优于 Zhang 的 30.91,IS 2.71 居中。
检验方法在模态物理差异极大时是否仍成立:分布级指标(rFID)大幅领先、像素级略逊,恰好暴露像素保真与感知保真的权衡,是客观评价方法边界的关键证据。
Stage-1 重建任务上比较 MedSAM、MedMAE、DINOv2 三种编码器:MedMAE PSNR 最高(31.23 / SSIM 0.8907)但 rFID 43.17、iFID 高达 144.45;DINOv2 为 30.57 / 0.8824,rFID 35.29、iFID 40.64,分布级指标全面最优;MedSAM 各项偏弱(iFID 48.58)。
支撑『几何规整性比像素保真更重要』的设计判断:0.66 dB 的 PSNR 让位于 3.6 倍的 iFID 优势,说明 tokenizer 选择由传输需求而非重建保真驱动。
逐步启用 Stage-1 三步并分别在 on-manifold($z = E_{DINO}(x_t)$)与 chord($z_{1/2} = (z_s + z_t)/2$)上评测:Step 1 warm-up 为 PSNR 33.14/32.04、chord rFID 41.66;加 Step 2 流形扩展后 on-manifold PSNR 33.83、chord 33.29(+1.25 dB)但 on-manifold rFID 反而升到 30.92;加 Step 3 编码器对齐后 on-manifold PSNR 跳到 44.06、chord rFID 16.28,chord 与 on-manifold 的 rFID gap 从 13.4 收敛到 0.3。
定位训练管线的真正功臣:流形扩展只是铺垫,编码器对齐才让流轨迹几乎重合于数据流形,对理解 Stage 1 各步的必要性与复现调参至关重要。