Dory1.0-4B:循环归一化 GPT Dory1.0-4B: A Looped Normalized-GPT
单检查点可变循环数的4B循环语言模型,以潜空间重复计算以小搏大。
前置知识
循环(潜空间递归)语言模型
在标准 Transformer 之外引入一个权重共享的"循环块",对每个 token 的隐状态反复应用同一组层 $k$ 次,即 $s_t = F(s_{t-1})$。相当于不增加参数而增加每个 token 的串行计算深度,把额外算力花在潜空间(latent space)而非生成更多 token 上。代表工作有 Universal Transformer(Dehghani et al., 2019)等。
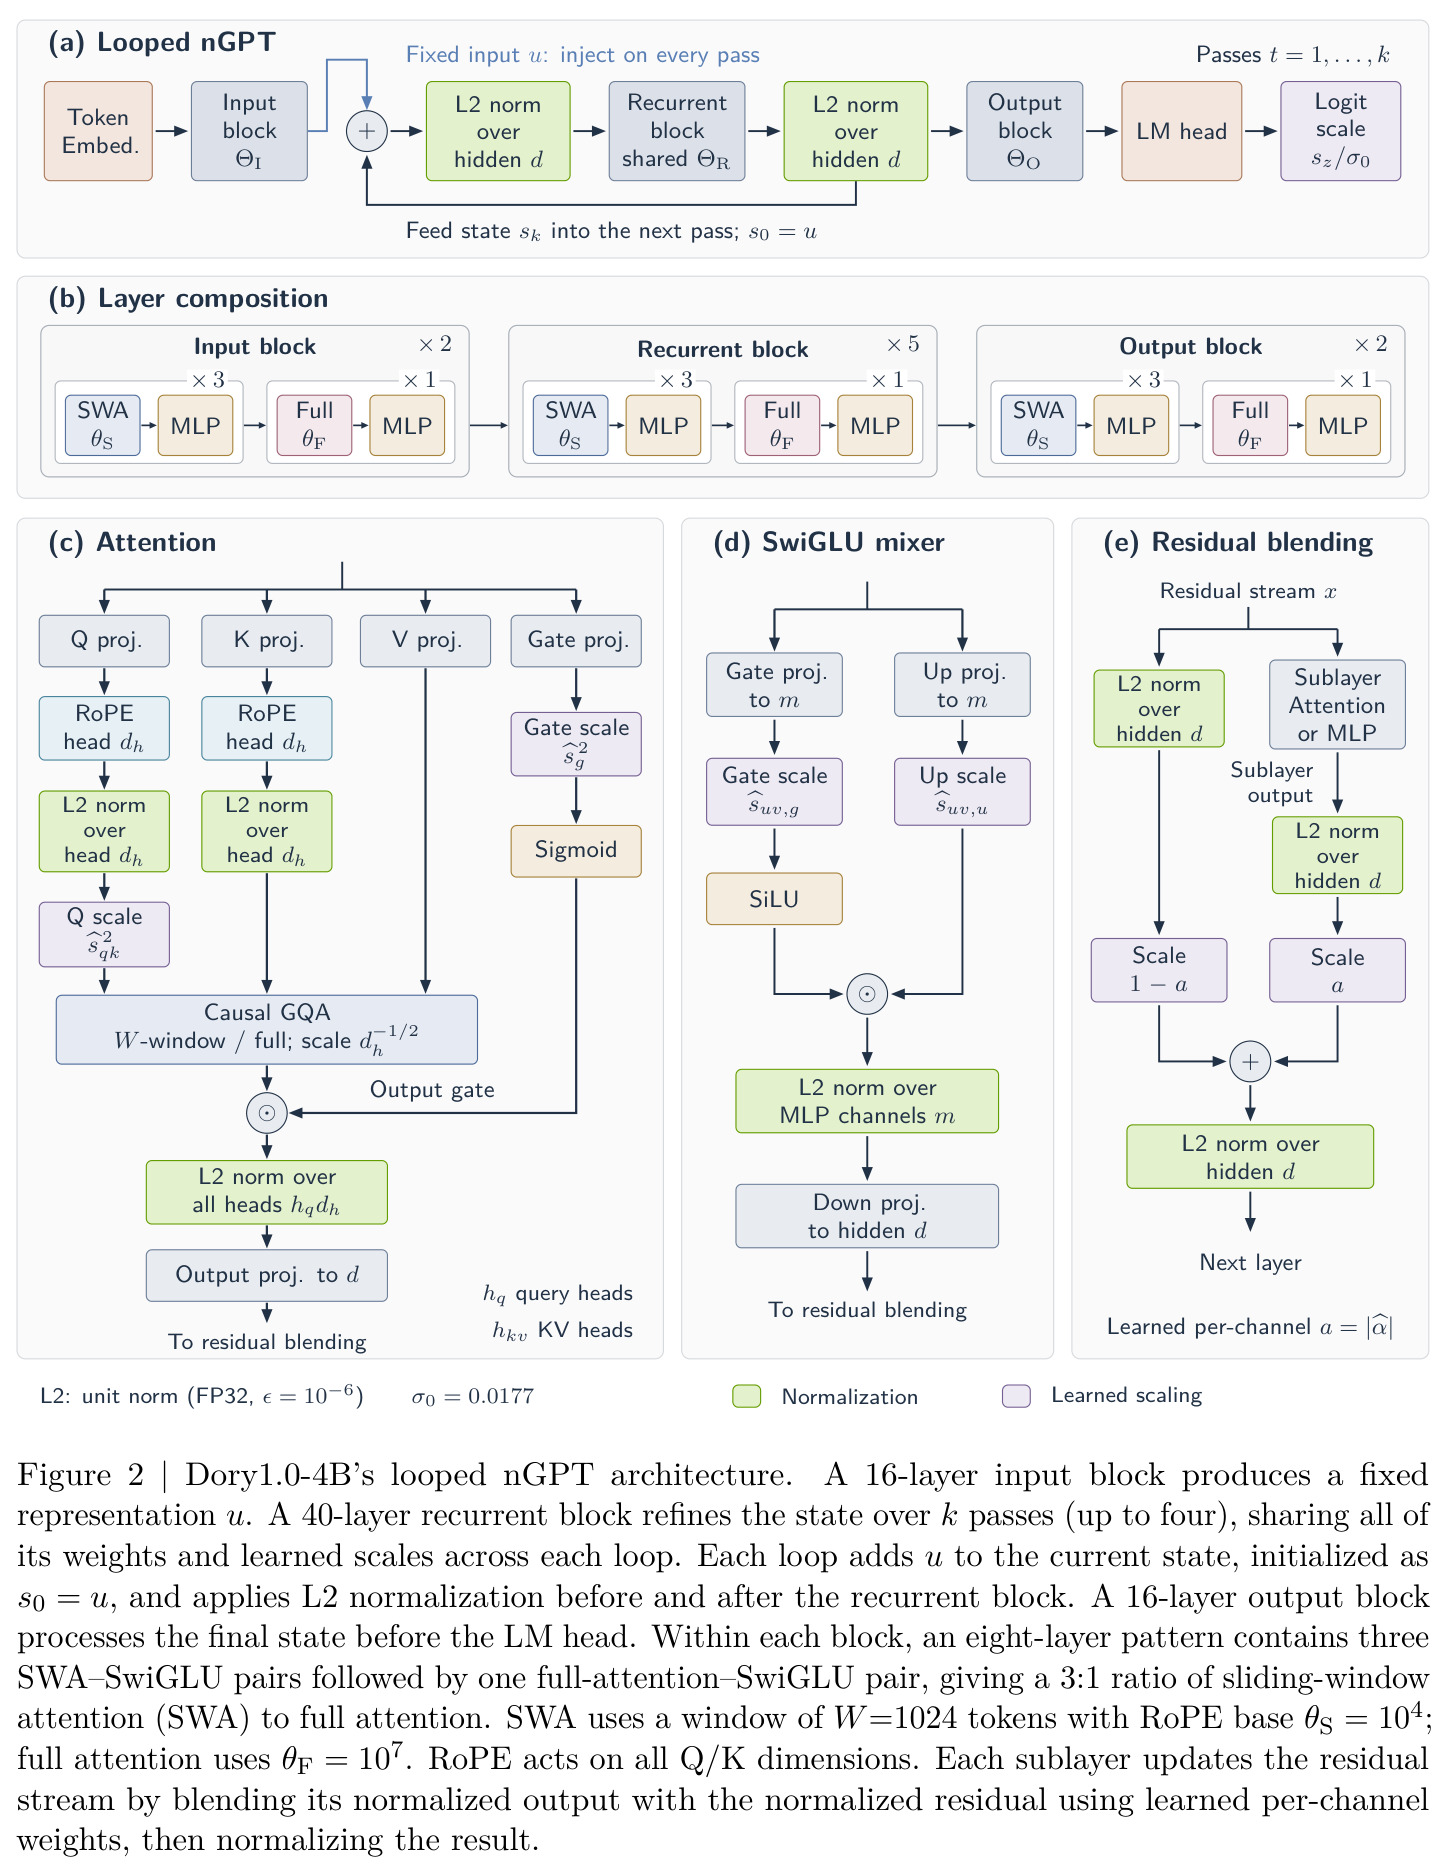
本文的核心结构正是如此:Dory1.0-4B 通过重复应用共享的 40 层循环块实现"弹性深度",推理时只需改变循环次数 $k$ 就能调整算力-精度权衡,不理解循环结构就无法理解全文。
nGPT(归一化 Transformer)
Loshchilov 等人提出的架构变体:把残差流和所有中间表示都 L2 归一化到单位超球面上,用学习到的逐通道残差率控制每层更新幅度,例如 $\hat{s} = N((1-\alpha)\hat{s} + \alpha \cdot \mathrm{sublayer}(\hat{s}))$。训练更稳定,对权重共享的循环结构尤其友好。
Dory1.0-4B 的骨干就是 nGPT,循环边界处的 L2 归一化 $s_t = N(F_\theta(u_t))$ 是循环深度可变时训练稳定的关键,论文的残差更新规则完全继承自 nGPT。
测试时计算扩展
不改变模型权重,通过在推理阶段投入更多计算来提升答案质量。主流做法是让模型生成更长的思维链(token 空间),代价是延迟与 KV 缓存随输出长度线性增长;潜空间循环是与之互补的另一条扩展轴。
本文动机正是把测试时计算从 token 空间挪到潜空间:循环次数 $k$ 就是推理算力旋钮,实测 $k=2$ 时每 token 计算只增至 1.03–1.25 倍即可拿回大部分收益。
RLVR 与 GRPO
RLVR(可验证奖励强化学习)用规则或判分器给出可验证奖励做强化学习;GRPO 对同一提示采样一组回答,以组内相对优势替代价值网络来估计策略梯度。本文用异步 GRPO,每步 384 个提示、每条提示 16 个回答,共 6144 个 rollout。
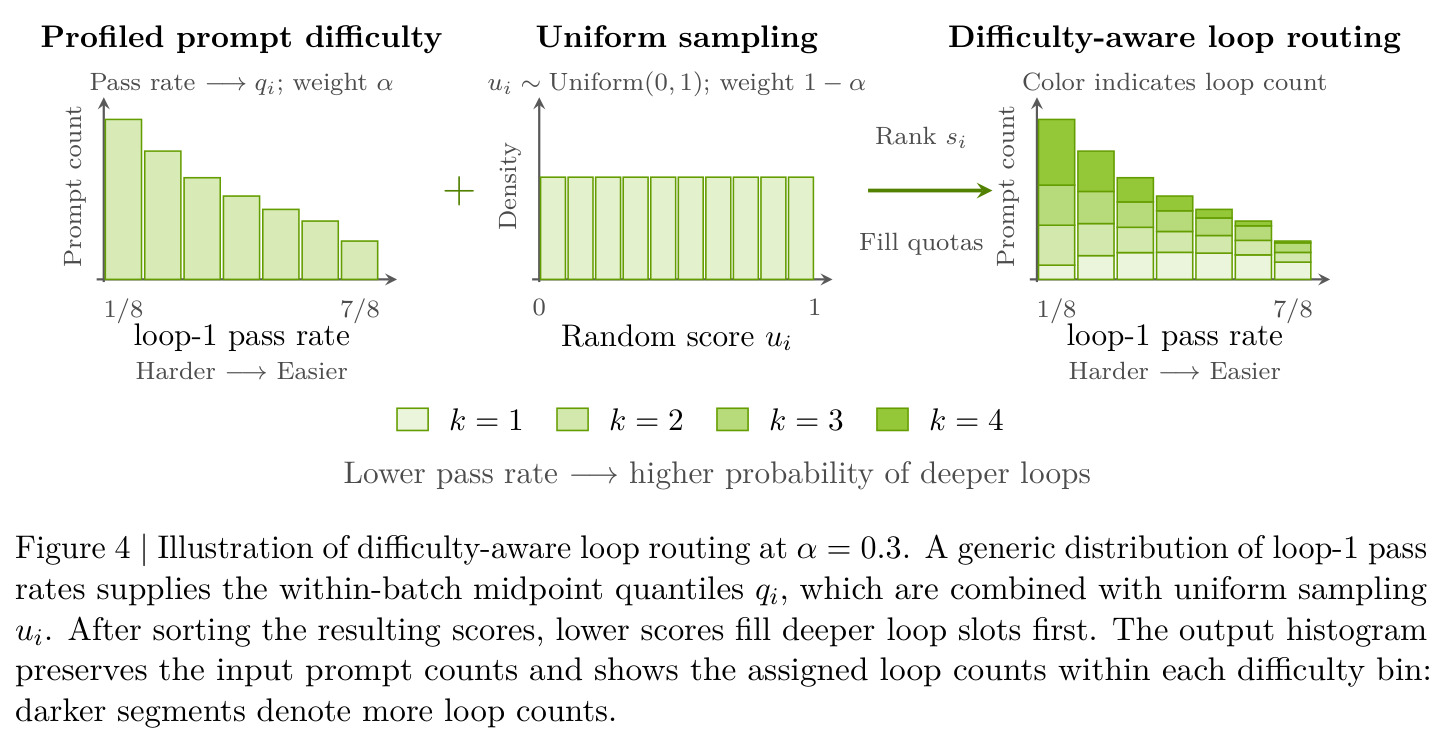
后训练阶段最重要的技巧"难度感知循环课程"就是在 GRPO 框架内实现的:按提示 one-loop 通过率把难题路由到更深循环的 rollout worker。
TBPTL(截断循环反传)
类比 Truncated BPTT:反向传播只保留最后一次循环调用的计算图,之前的循环调用不追踪梯度;输入块的输出仍通过最终调用的残差连接收到梯度。这大幅降低多循环训练的显存与计算开销,代价是早期循环得不到直接的学习信号。
Dory 在预训练、长上下文扩展、SFT 中全部使用深度为 1 的 TBPTL,且只在最终循环后算交叉熵、无任何中间辅助损失,这是它能低成本训练多循环混合模型的关键工程取舍。
NVFP4 量化与 QAD
NVFP4 是 NVIDIA 的 4 位块缩放格式(E2M1 操作数配 E4M3 缩放因子),用于预训练可端到端提速约 20%;QAD(量化感知蒸馏)以原始 BF16 模型为教师、PTQ 后的低精度模型为学生,最小化全词表前向 KL 散度 $\mathcal{L}_{KD}$,让低精度权重恢复精度。
论文同时开源 BF16、MXFP8、NVFP4、GGUF 四种检查点,预训练前 4.5T token 用 NVFP4 完成,量化部分的具体数字直接决定部署成本与结论的可信度。
研究动机
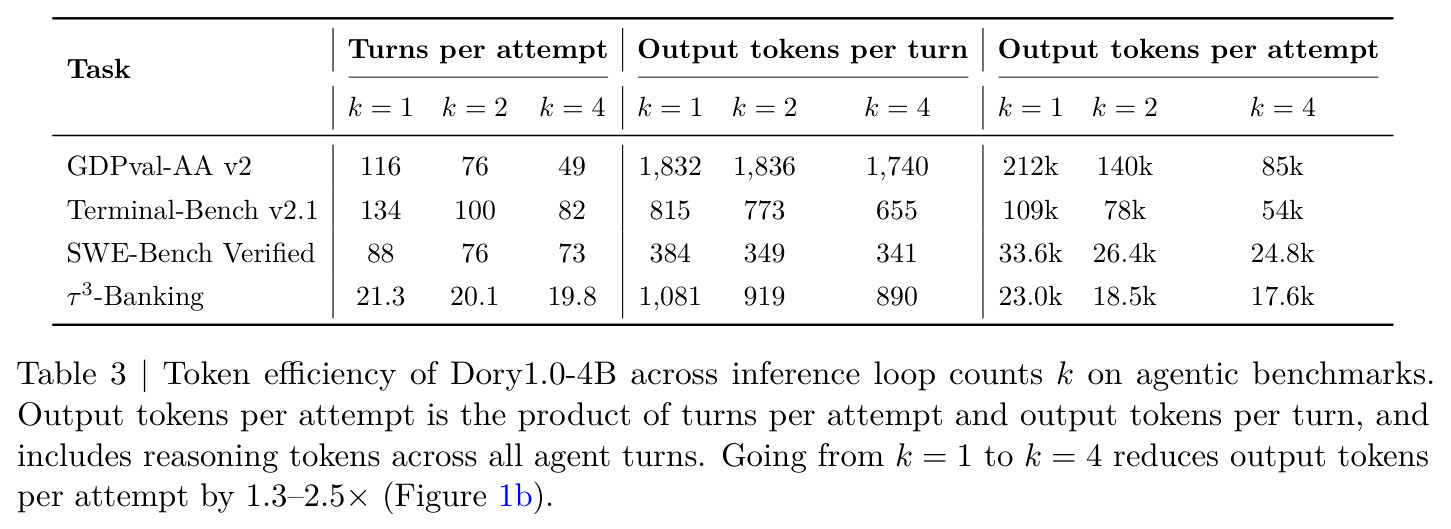
LLM 能力扩张的主要轴之一是测试时计算,但现有做法几乎把算力全花在 token 空间:模型生成更长的思维链,而延迟、KV 缓存占用和服务成本随每个生成 token 线性上涨。智能体任务上问题尤其尖锐——论文测得循环模型在 $k=1$ 时完成一次 GDPval-AA v2 任务平均要 116 轮交互、输出约 212K token,Terminal-Bench v2.1 上是 134 轮、约 109K token。另一条互补路线是循环(潜空间递归)模型:重复应用共享层,在不加参数的前提下给每个 token 更多串行计算(Dehghani et al. 2019 的 Universal Transformer、Saunshi 2025、Geiping 2025 等)。但这些先前工作大多停留在预训练研究原型阶段,没有经过完整的 SFT + RLVR 后训练,不面向推理与智能体场景;而且朴素的逐循环 KV 缓存使显存随循环数线性增长,工程上难以部署。
本文的目标是本文的目标是训练首个开源、完整后训练的循环语言模型 Dory1.0-4B:4B 参数、带"弹性深度"的单一检查点,推理时可将共享循环块应用任意次数 $k$,按请求在算力与精度之间权衡,无需重训练也无需换模型。可检验的子目标包括:(1) 在 12 个基准等权平均上,$k\ge 2$ 即超过 Qwen3.5-9B、Gemma 4 12B、Gemma 4 26B-A4B 等更大模型,并逼近总参数量约 9 倍的 Qwen3.6-35B-A3B;(2) 加深循环能降低而非增加智能体任务的输出量——4 循环比 1 循环少生成 1.3–2.5 倍 token;(3) last-loop KV 缓存使任意循环数下的注意力 KV 显存与非循环模型相同;(4) 开源 BF16、MXFP8、NVFP4、GGUF 全部检查点。
与已有工作不同的是,独特切入角度有三。第一是服务视角的弹性深度:不在训练时固定循环深度,而是在预训练后段按 $\{1,2,3,4\}$ 等概率采样循环数(另设 10% 副本强制单循环),使一个检查点同时服务所有深度,把 $k$ 变成免训练的推理旋钮——这是与以往固定深度循环模型的根本差异。第二是训练效率取舍:用深度为 1 的截断循环反传(TBPTL),只在最终循环后计算交叉熵、无中间辅助损失,使多循环训练成本几乎与单循环相同;RLVR 阶段再以难度感知课程 $s_i=\alpha q_i+(1-\alpha)u_i$ 把低通过率难题路由到深循环 rollout worker。第三是骨干选择 nGPT:残差流恒在单位球面上,循环边界的 L2 归一化 $s_t=N(F_\theta(u_t))$ 让不同深度的隐状态范数天然对齐,绕开了循环模型常见的训练不稳定问题,也为 last-loop 缓存等推理优化提供数值一致性基础。
核心方法
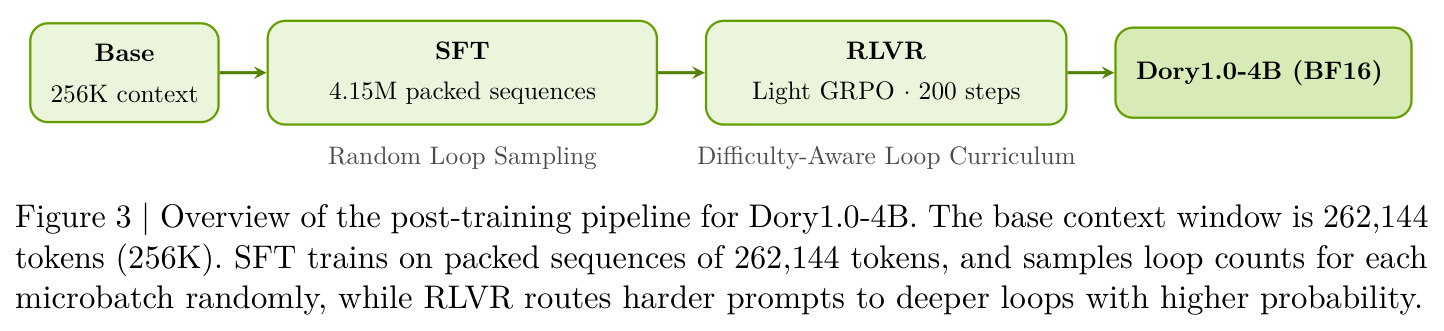
直觉:让同一个 40 层"大脑"对每个 token 反复思考 $k$ 次。结构上 72 层切成 16 层输入块、40 层共享循环块、16 层输出块,前后块只跑一次,循环块跑 $k$ 次,每次之前把输入块输出 $x$ 重注入状态并做 L2 归一化:$$s_0=x,\qquad u_t=N(s_{t-1}+x),\qquad s_t=N(F_\theta(u_t)),\quad t=1,\dots,k$$有效前向深度为 $32+40k$($k=1$ 时 72 层,$k=4$ 时 192 层),循环块内所有参数(含 nGPT 残差率)跨循环共享。训练路线分四段:先在约 4.5T token 上以 $k=1$ 用 NVFP4 混合精度做标准预训练(端到端比 BF16 提速 20%);再以 BF16 续训约 1.465T token,逐步确定性采样 $k\in\{1,2,3,4\}$ 并引入循环;随后用约 300B token 把上下文从 32K 扩到 256K(全注意力 RoPE 基频 5e5 提到 1e7);最后做 9 epoch SFT(4.15M 条 256K 打包序列)加 200 步异步 GRPO,并配难度感知循环课程。
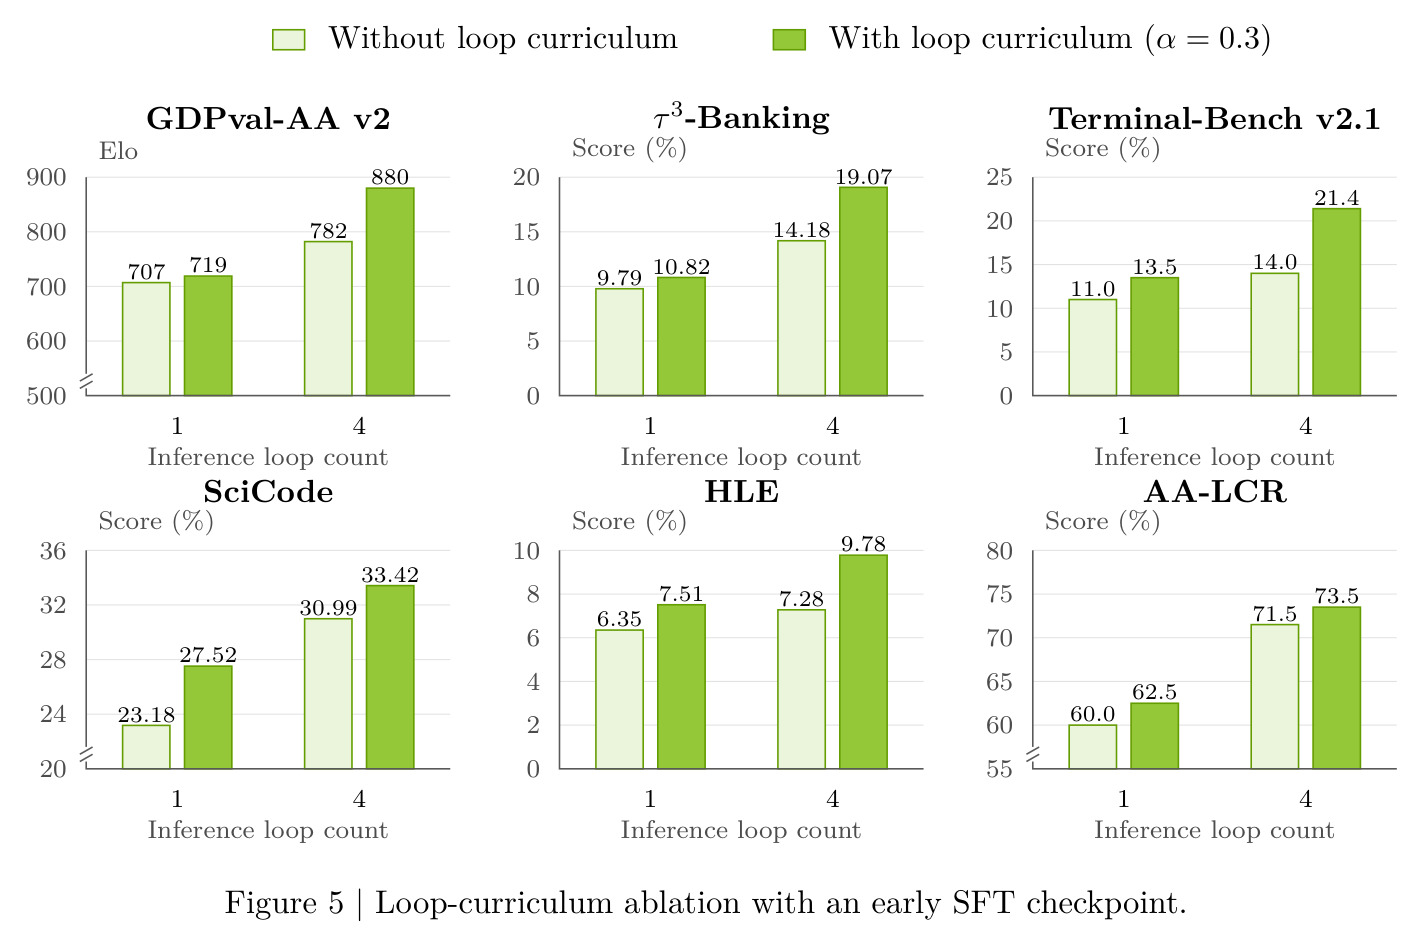
核心创新是"一个检查点、任意深度"。与 Universal Transformer 等固定深度循环模型不同,Dory 在训练时就见过所有 $k\in\{1,2,3,4\}$,推理时 $k$ 是免训练旋钮。与已有工作还有三点本质区别。一是确定性循环采样:循环数由优化器步数与 microbatch 索引决定,并在全部 192 个数据并行副本间共享而非各自独立采样;另有 10%(19 个)副本轮转强制跑 $k=1$,保证浅深度持续收到梯度信号。二是损失设计:只在最终采样循环之后计算下一 token 交叉熵,没有早退或中间循环辅助损失,配合 TBPTL 把多循环训练开销压到最低。三是难度感知循环课程:rollout worker 固定单一 $k$(配额 4:1:1:1),按 one-loop 通过率的中点分位 $q_i$ 与均匀随机数 $u_i$ 插值 $s_i=\alpha q_i+(1-\alpha)u_i$($\alpha=0.3$),分数低的提示优先填深循环槽位,使难题更可能得到深执行。消融显示该课程在 $k=4$ 时把 Terminal-Bench v2.1 从 14.0% 提到 21.4%、GDPval-AA v2 提升 98 Elo。
方法步骤详情
第 1 步 NVFP4 预训练:先以 8192 序列长度训约 3T phase-1 数据,转 phase-2 后序列加到 32768、全局 batch 768→192,lr 3.2e-4 恒定至约 4.5T。第 2 步循环化 BF16 续训:切 16/40/16 三块,$k\in\{1,2,3,4\}$ 等概率采样,192 卡中 19 卡强制 $k=1$,TBPTL 深度 1,再训 1.465T,lr 负平方根衰减至 1e-5。第 3 步长上下文扩展:序列 262144,RoPE 基频 5e5→1e7,24 路数据并行 + 8 路上下文并行,约 300B token。第 4 步 SFT:256K 打包序列、batch 128、9 epoch,仅 assistant token 计损失。第 5 步 RLVR:先在 $k=1$ 下每提示采 8 条回答画像难度(保留均值奖励在 0 与 1 之间),再跑 200 步异步 GRPO(384 提示 × 16 回答,lr 4e-6),worker 按 4:1:1:1 固定 $k$,以 $s_i=\alpha q_i+(1-\alpha)u_i$ 排序,低分先入深循环。
技术新颖性
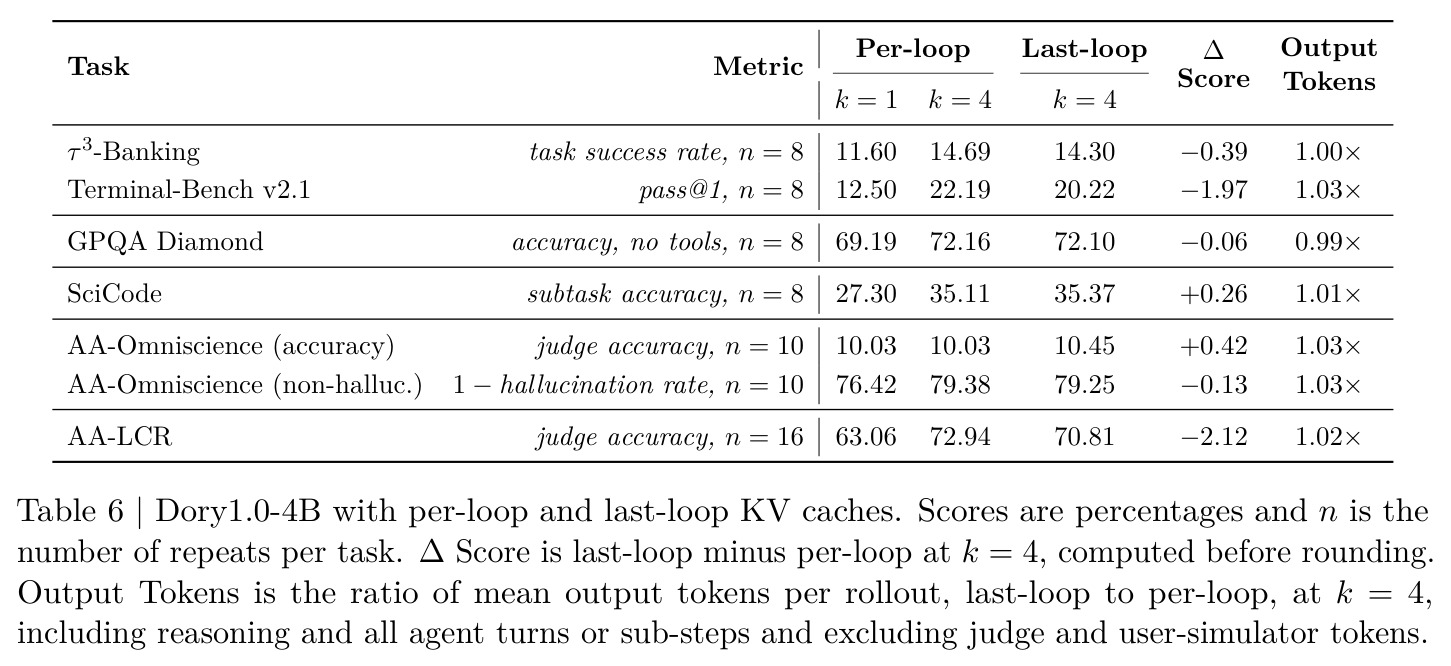
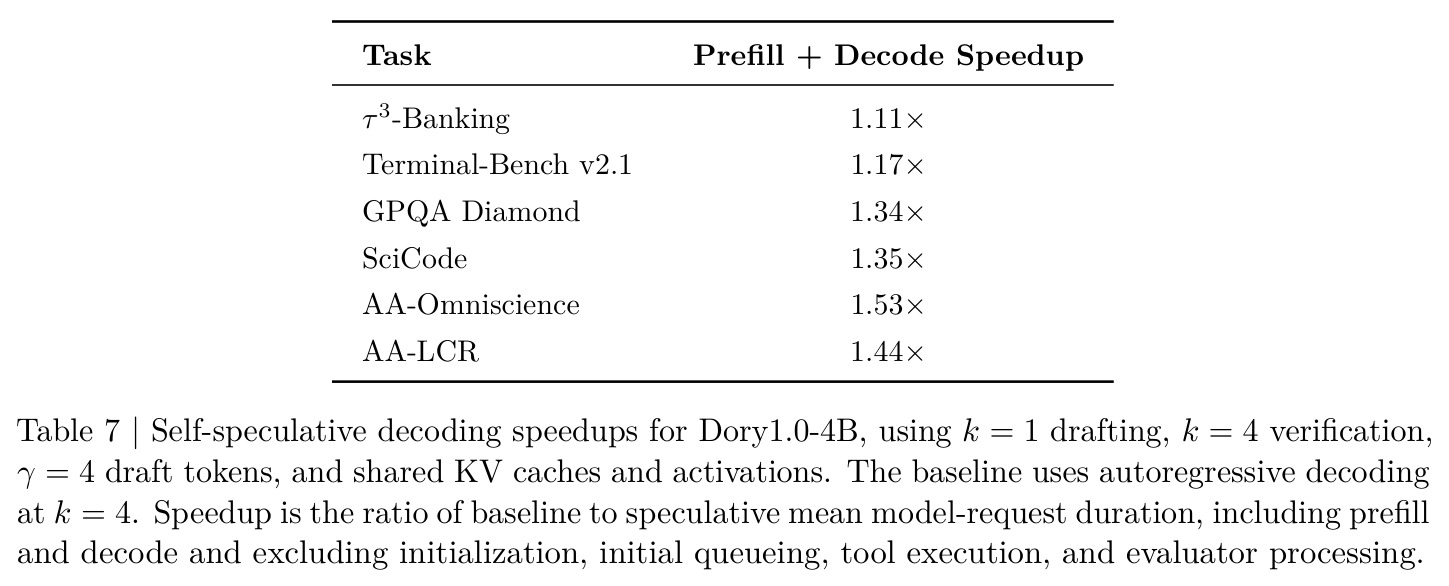
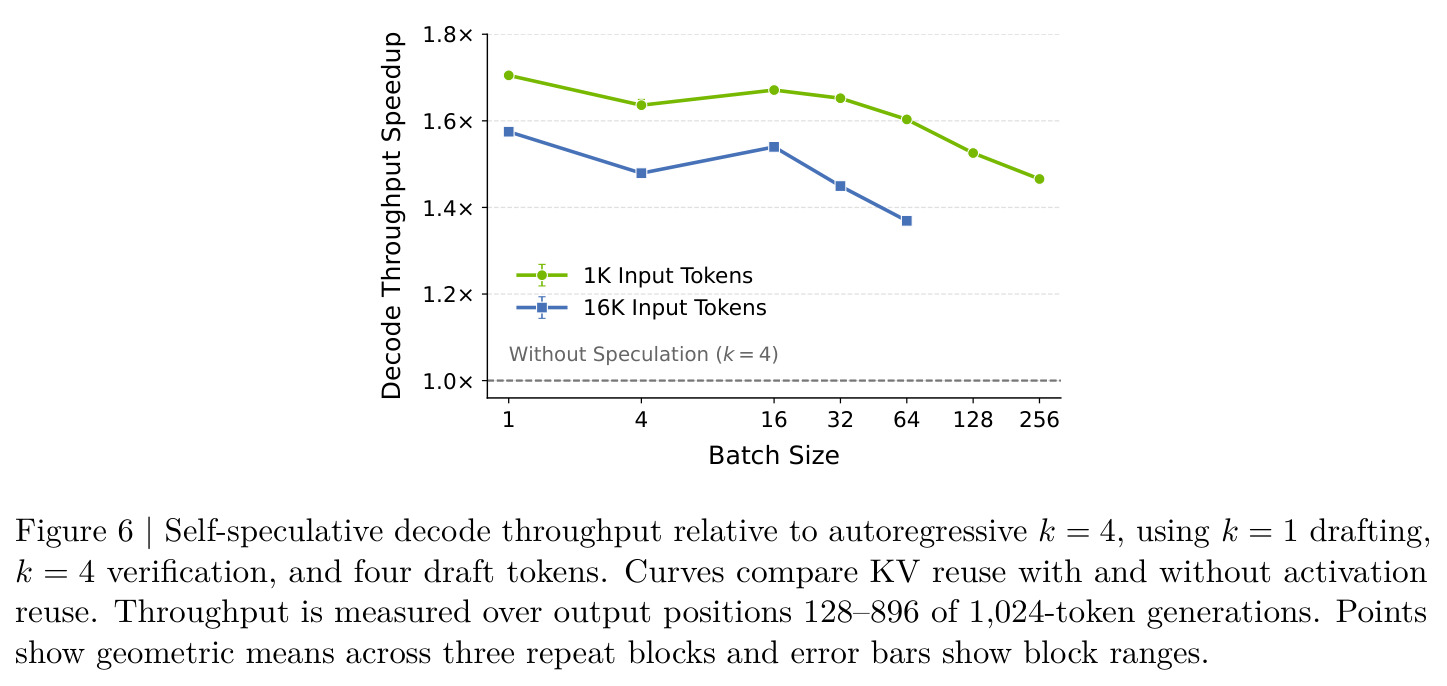
新颖性体现在四个层面。架构:在 nGPT 基础上,对拼接门控后的注意力输出和 SwiGLU 激活、在下投影之前额外做 L2 归一化(用融合 Triton 内核实现),并以 3:1 比例交错滑窗注意力($W=1024$、RoPE 基频 1e4)与全注意力(RoPE 基频 1e7),配 16 查询头 / 4 KV 组的 GQA 和输入依赖的 sigmoid 注意力输出门——这些单位化设计是循环深度可变时数值稳定的根基。训练:"多循环混合 + 确定性采样 + 10% 单循环覆盖 + TBPTL 深度 1"的组合让单检查点服务任意 $k$,论文首次将其用于完整后训练的开放模型。后训练:难度感知循环课程把"哪个提示该用多深"变成显式路由问题,$\alpha=0.3$ 的插值在保留随机性的同时偏向难题,是 RLVR 与循环架构结合的已知首例。推理:last-loop KV 缓存(每循环覆写缓存项,KV 显存恒为单循环大小,$k=4$ 时分数仅变化 −2.12 到 +0.42)与自推测解码(同一检查点 $k=1$ 起草、$k=4$ 验证、每次起草 $\gamma=4$ 个 token,解码吞吐 1.37–1.71 倍)都把弹性深度本身当作可调度的推理资源。
实验结果
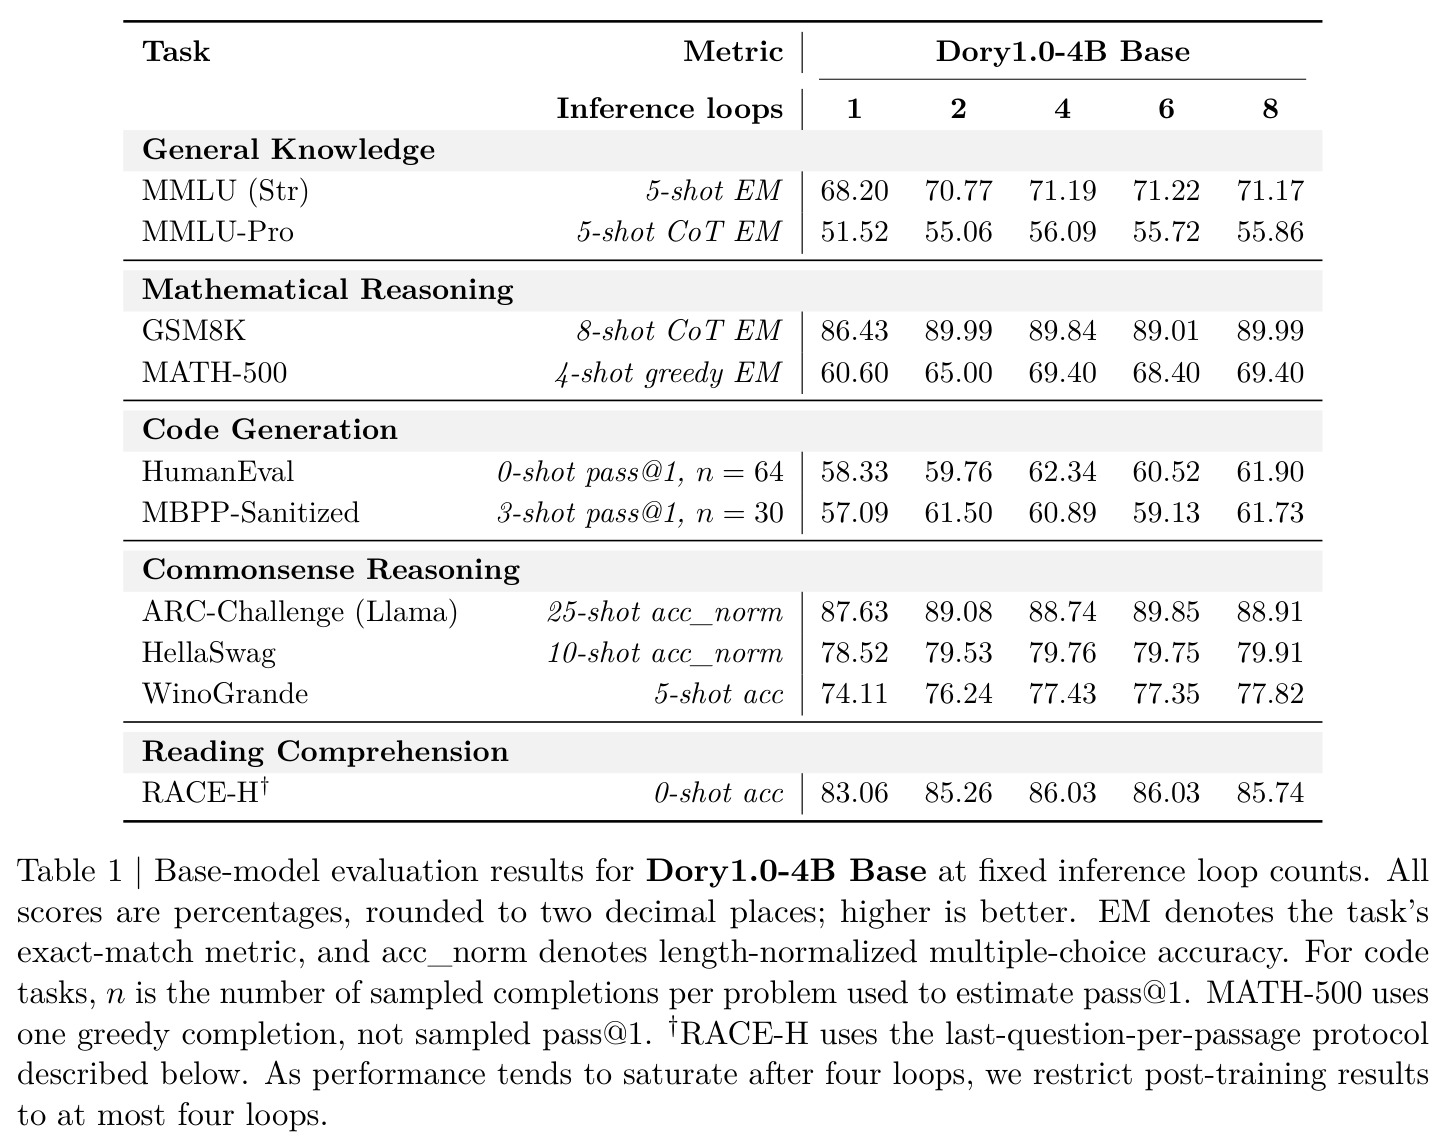
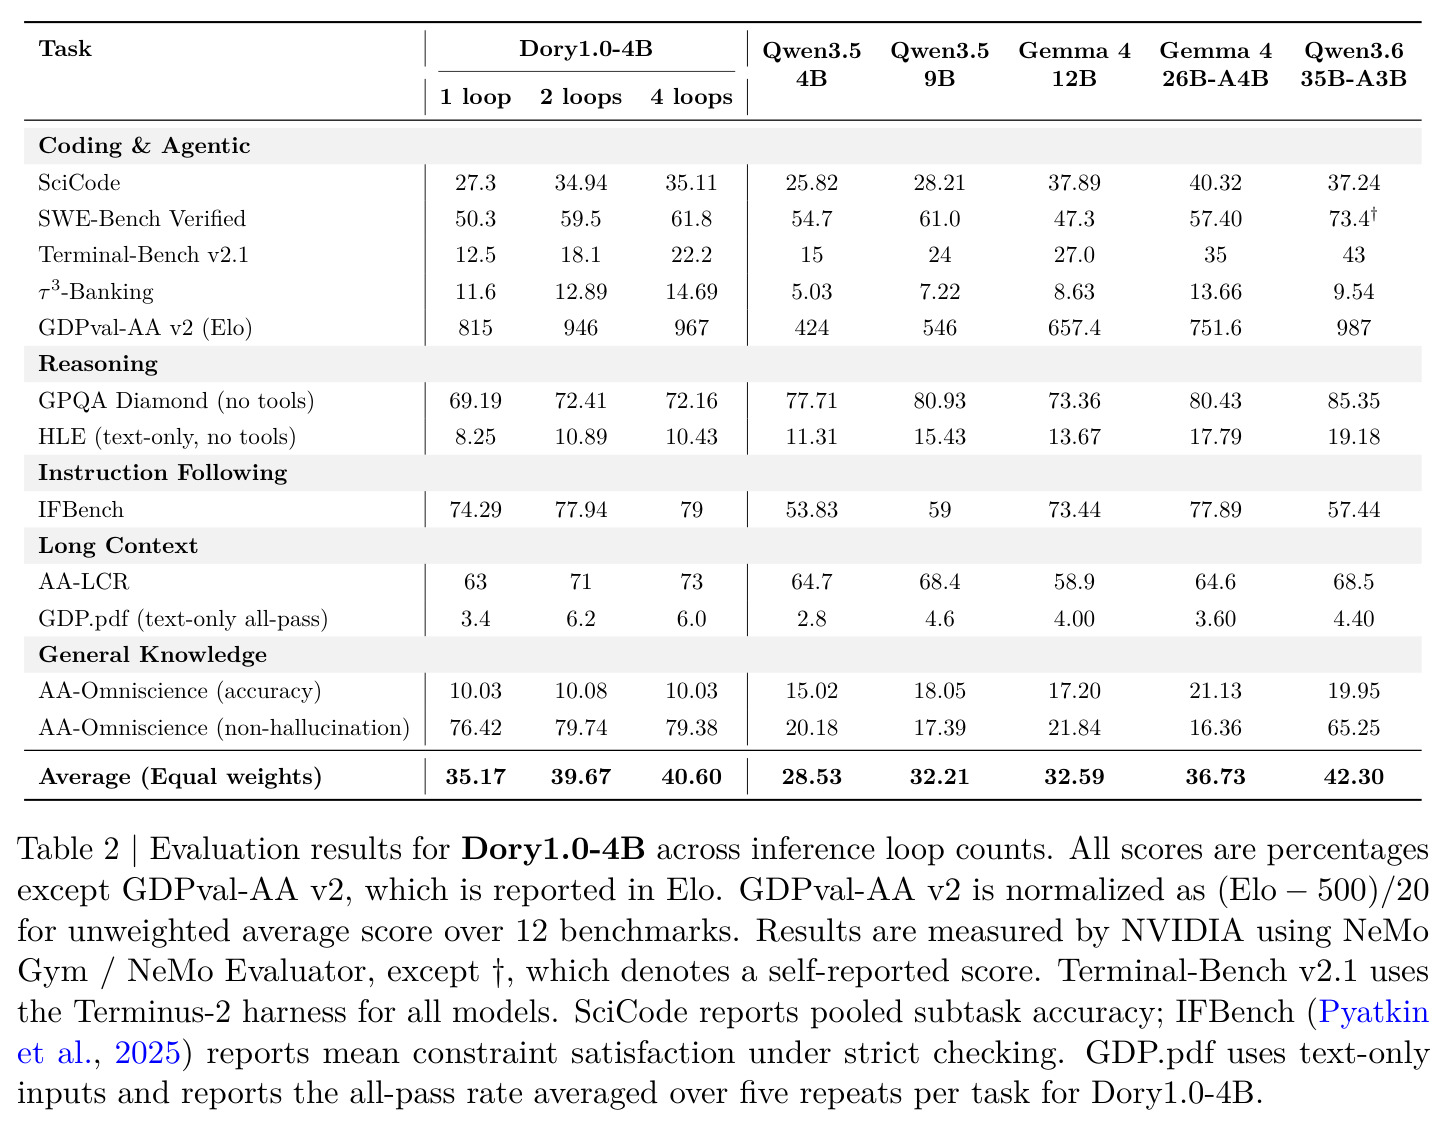
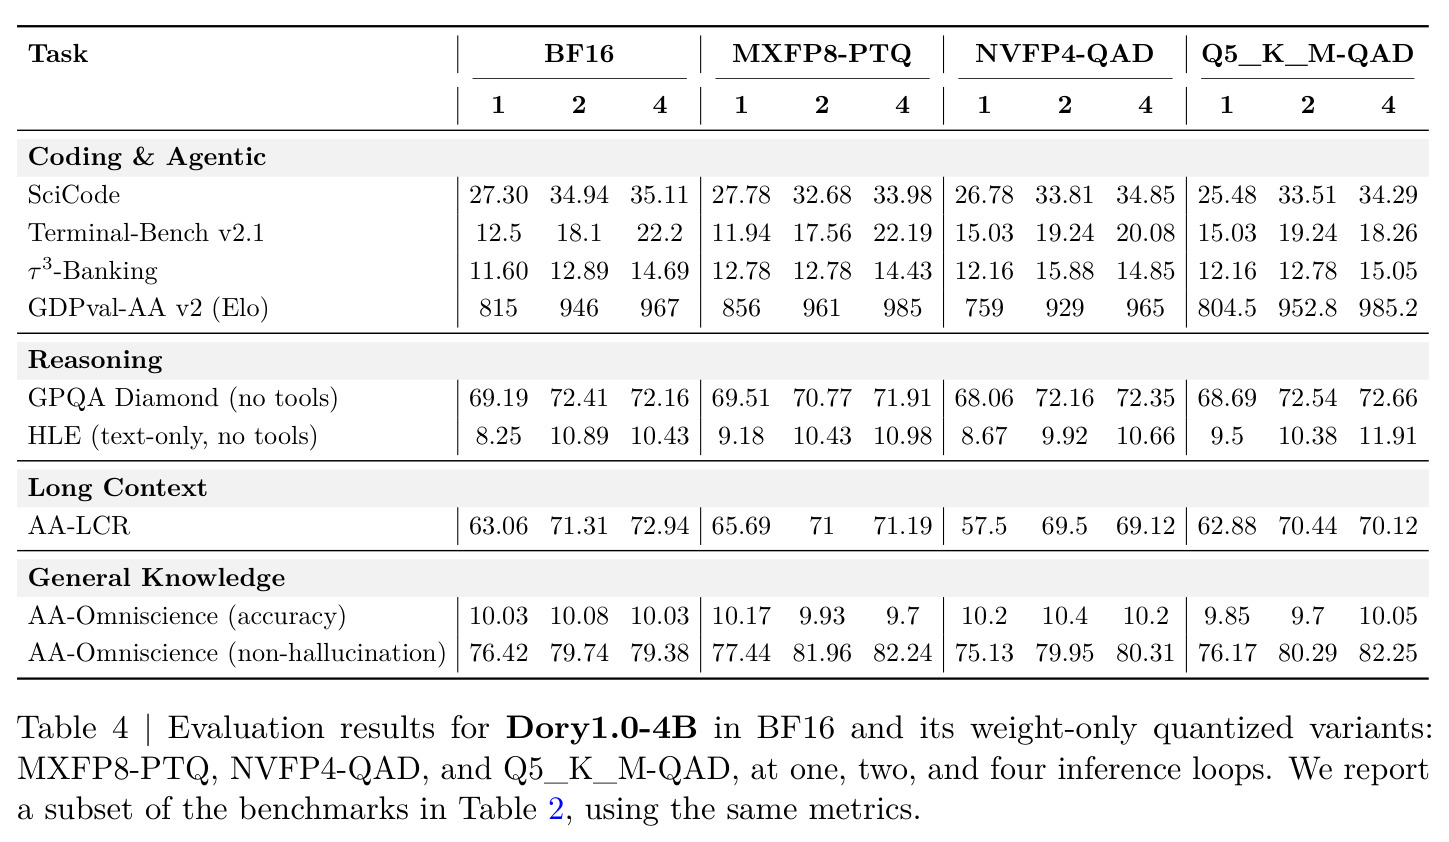
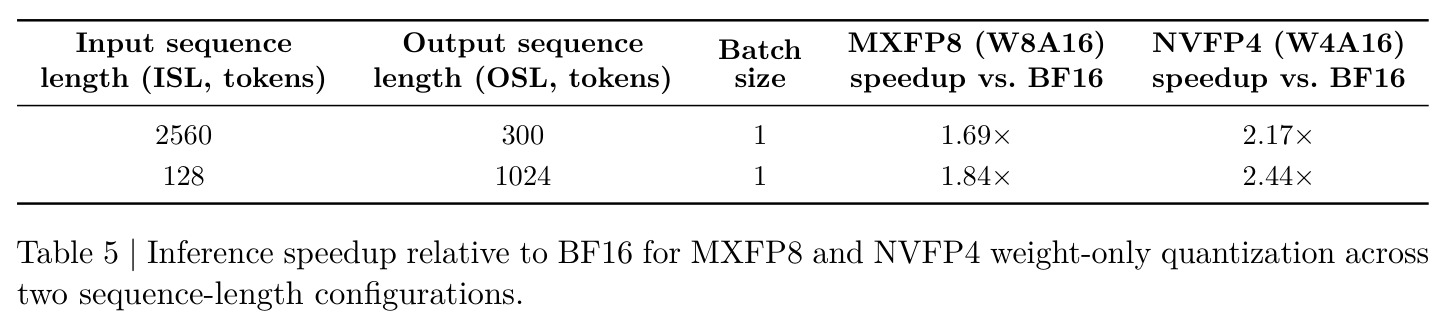
基座(Table 1):各基准随 $k$ 单调上升(MMLU 68.20→71.19),4 循环后饱和。主结果(Table 2):12 基准等权平均 $k=1/2/4$ 为 35.17/39.67/40.60,超过 Qwen3.5-9B、Gemma 4 12B 与 26B-A4B(32.21/32.59/36.73),距 9 倍参数的 Qwen3.6-35B-A3B 仅 1.7 分;GDPval-AA v2 815→967 Elo、SWE-Bench 50.3%→61.8%、Terminal-Bench 12.5%→22.2%,均领先更大基线;唯 AA-Omniscience 准确率恒约 10.03。Token 效率(Table 3):$k=4$ 少生成 1.3–2.5 倍,$k=2$ 仅 1.03–1.25 倍算力拿回 42–86% 收益。推理与量化(Table 4–7):NVFP4 提速 2.44 倍,last-loop 缓存分数仅 −2.12~+0.42,自推测解码吞吐 1.37–1.71 倍。课程消融(Figure 5):$k=4$ 下 GDPval +98 Elo、Terminal-Bench +7.4。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 12 基准等权平均 | 平均分 | 35.17(k=1)/ 39.67(k=2)/ 40.60(k=4) | Qwen3.5-9B: 32.21;Gemma 4 12B: 32.59;Gemma 4 26B-A4B: 36.73;Qwen3.6-35B-A3B: 42.30 | k≥2 即超过 9B/12B/26B-A4B 全部基线,距 35B-A3B 仅 1.7 分 |
| SWE-Bench Verified | pass@1 (%) | 61.8(k=4),50.3(k=1) | Gemma 4 26B-A4B: 57.4 | 较 26B 基线 +4.4 分,较自身 k=1 +11.5 分 |
| GDPval-AA v2 | Elo | 967(k=4),815(k=1) | Gemma 4 26B-A4B: 752;Qwen3.6-35B-A3B: 987 | 较 26B 基线 +215 Elo,逼近参数量 9 倍的 35B 模型 |
| SciCode | pooled subtask accuracy (%) | 35.11(k=4),27.30(k=1) | Qwen3.5-9B: 28.21 | +6.9 分 |
| IFBench / AA-LCR / GDP.pdf | 约束满足率 / judge 准确率 / all-pass 率 (%) | 79 / 73 / 6.0(k=4) | 全部对比基线(最高分别为 77.89 / 68.5 / 4.6) | 三项均为对比模型中最佳 |
| 智能体任务 token 效率 | 每次尝试输出 token 数 | k=4 较 k=1:GDPval 212K→85K,Terminal-Bench 109K→54K | 自身 k=1 | 减少 1.3–2.5 倍;k=2 算力仅 1.03–1.25 倍即回收 42–86% 精度收益 |
| 推理加速与量化 | 吞吐 / 时延加速倍数 | NVFP4 推理 2.17–2.44 倍;自推测解码吞吐 1.37–1.71 倍 | BF16 自回归解码 | 量化 + 自推测叠加后部署成本大幅下降,精度损失可控 |
局限与改进
作者承认的局限:一是收益任务相关——AA-Omniscience 准确率在所有循环数下几乎不变(10.03/10.08/10.03),潜空间计算无助于知识性错误;二是基座模型 4 循环后性能饱和(Table 1),论文因此把后训练评估限制在最多 4 循环;三是 last-loop KV 缓存有精度代价,AA-LCR 下降 2.12 分、Terminal-Bench 下降 1.97 分;四是所有分数用 NVIDIA 自有评测协议测得,可能与 Artificial Analysis 公布值不同。我自己的观察:GPQA Diamond(72.16 vs Qwen3.6-35B-A3B 的 85.35)和 HLE(10.43 vs 19.18)这类知识密集推理仍明显落后于大模型,说明循环换来的主要是过程性能力而非知识容量;难度画像用 one-loop pass rate 做难度代理,策略更新后通过率会漂移,画像可能失真;RLVR 仅 200 步且在 65K 窗口内进行,与 256K 上下文的宣称不完全对齐;6/8 循环外推只在基座上验证过,后训练模型未见相应报告。
独立分析的弱点
独立分析几个弱点。其一,知识型任务无收益:AA-Omniscience 准确率恒定约 10 分,非幻觉率虽从 76.42 升到 79.74 但准确率不动,说明循环深化无法弥补参数量决定的知识容量,改进方向是与检索增强(RAG)结合,让深循环用于整合外部证据而非回忆参数化知识。其二,深循环延迟是纯串行的:$k=4$ 时每 token 前向 192 层,对延迟敏感的交互场景(如 τ³-Banking 多轮对话)即使省 token 也可能不划算,改进方向是训练 early-exit 头做自适应逐 token 深度分配,让简单 token 走 1 循环。其三,难度课程依赖离线 one-loop 画像:每提示要采 8 条回答打分,且通过率随策略更新漂移,改进方向是训练中周期性重画像或在线估计难度。其四,last-loop 缓存在长上下文推理任务上代价不小(AA-LCR −2.12),说明跨循环的注意力模式存在本质差异,改进方向是训练时混合两种缓存策略或引入可学习的缓存融合。其五,全部对比基线由 NVIDIA 用统一协议自测,缺少第三方复现。
未来方向
作者方向隐含在结论中:更广地部署量化检查点、在 Nemotron 家族中推广循环架构。基于成果可延伸的方向:一是自适应深度——目前 $k$ 是请求级超参,可做 token 级或步骤级的 early-exit / 深度预测器,把"难题深思考"从课程层面下沉到推理层面;二是系统研究潜空间循环与显式思维链两种测试时计算的替代曲线——本文已显示潜计算能省 1.3–2.5 倍输出 token,值得给出两者等效交换率;三是训练时混入更深循环(如 $k\in\{1..8\}$)或对后训练模型做深度外推微调,突破 Table 1 观察到的 4 循环饱和;四是 last-loop 缓存的精度损失提示跨循环 KV 含有可用信息,可探索层级化/混合缓存以零显存代价逼近 per-loop 精度;五是把难度感知课程思想迁移到 MoE 路由或深度可变模型的训练;六是联合调度自推测解码的草稿深度 $\gamma$ 与验证深度,进一步压低时延。
复现评估
复现评估:模型完全开源(OpenMDW-1.1 协议),HuggingFace 的 nvidia/nemotron-labs-dory 集合提供 BF16、MXFP8、NVFP4 和 GGUF Q5_K_M 检查点,推理复现门槛低——4B 模型单卡可跑,改 $k$ 即可验证弹性深度、last-loop 缓存等核心结论。但训练复现非常困难:预训练 6.3T token 用 192 张 GPU(48 节点 GB300),依赖 Megatron-LM + Transformer Engine 私有配方;SFT 用 128 张 GB300 训 9 epoch;RLVR 需要 23 个环境、Qwen3-235B-A22B 打分器和 NeMo RL 栈;QAD 虽只需 12 小时但仍要 128 张 GB300。数据方面预训练混合继承 Nemotron 3 Ultra(细节未完全公开),SFT 混合与 Nemotron 3.5 Super 相同。综合判断:推理、量化、缓存与解码优化的结论单卡即可复现;完整训练只有大厂级算力可行,但论文超参报告异常详尽(学习率、batch、并行拓扑、循环采样细节全给出),透明度属同类报告最高档。
论文图表
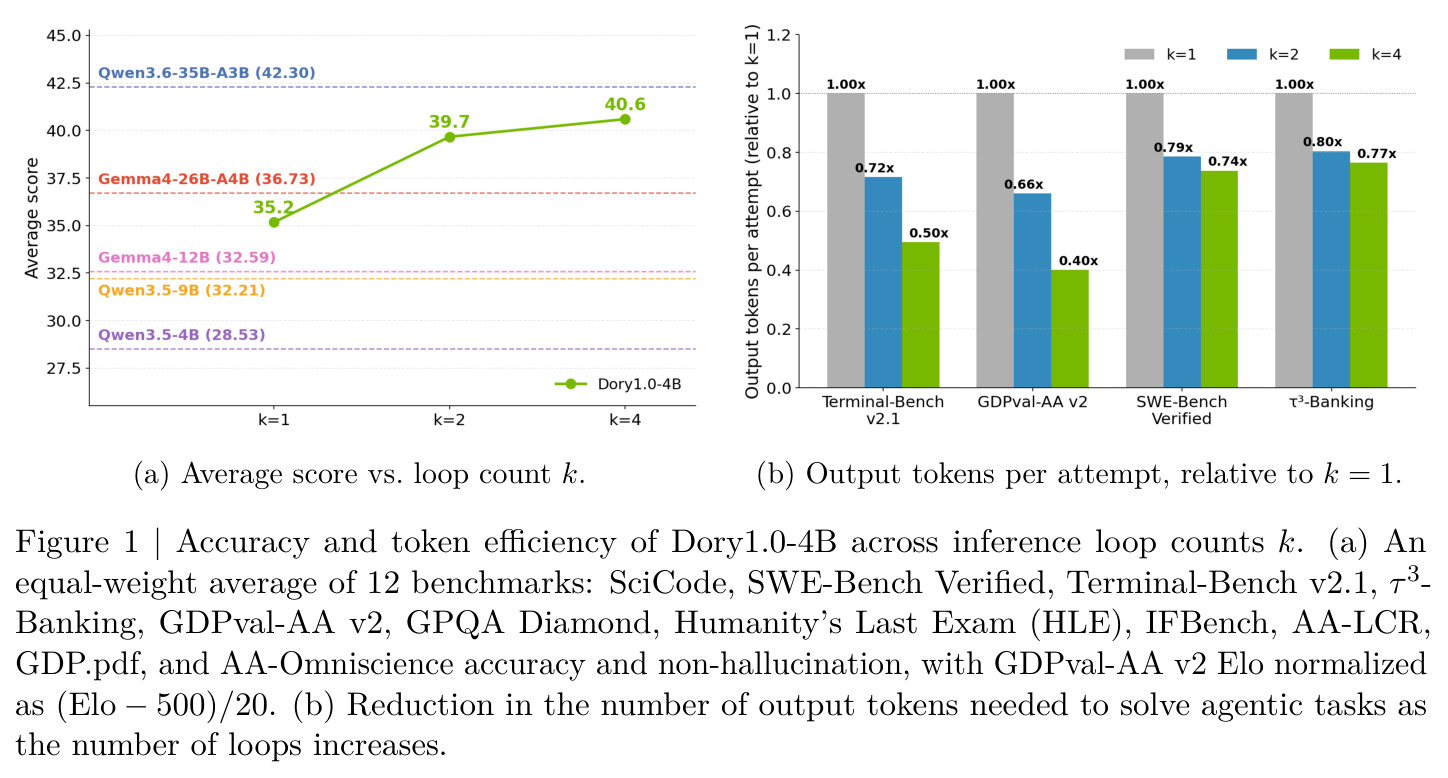
(a) 显示 12 基准等权平均分随循环数变化:k=1/2/4 分别为 35.17/39.67/40.60,并标注各基线模型的水平线;(b) 显示四个智能体基准上输出 token 相对 k=1 的缩减,k=4 时降至 0.4–0.77 倍。
这是全文核心结论的一图总览:加深循环既提分又省 token,两个子图分别支撑"精度可买"与"token 反而更省"两大卖点,引言即用它定调。