问而不装备:问题驱动的编码智能体实现深度 GPU 内核优化 Ask, Don't Equip: Question-Driven Coding Agents for Deep Kernel Optimization
在关键决策点向智能体提问而非堆工具,写出超越 FA3/FA4 的无依赖 CUDA 内核
前置知识
深度 GPU 内核(deep kernel)
性能取决于整条流水线协同编排的 GPU 程序:warp 专用化的生产者-消费者 warpgroup、异步张量核 MMA(wgmma/tcgen05)、按 mbarrier 相位排序的数据拷贝、寄存器预算(setmaxnreg)、持久调度器以及主机发射路径,而非靠局部代码微调就能提升。FlashAttention 系列是典型代表。
论文的任务对象就是这类内核;理解“深”在何处,才能理解为什么只做局部编辑的自主智能体会在 0.5× 处停滞。
结构-自由度权衡(structure–freedom tradeoff)
LLM 核优化智能体设计空间的核心轴:脚本化智能体(学习到的策略、优化菜单、固定角色分工)预先规定每步做什么,在配方适用处样本高效、配方失效处停滞;开放式智能体让 LLM 自由变异内核种群,自由但要用成千上万次评估、反复无效编辑来买单。
这是论文的问题框架。KernelSeek 的定位——保留开放式自由、在决策点供给方向——正是从“两端都缺方向”这一诊断导出的。
FlashAttention-3 / FlashAttention-4(FA3/FA4)
注意力内核的 SOTA 实现:FA3 针对 Hopper 架构(H100/H200,异步 wgmma、warp 专用化、CUTLASS 实现),FA4 针对 Blackwell 架构(B200,tcgen05 指令、CuteDSL 实现)。每代报告相对前代 1.5–2× 的加速,是本文的对照组、正确性基准与计时标尺。
论文所有加速比都相对它们报告;在禁用 CUTLASS/CuTe/cuDNN 的约束下手写出能与之抗衡的等价物,正是任务难度的来源。
编码智能体(coding agent)与工具调用
以 LLM 为大脑、在循环中调用 shell、编译器、编辑器、profiler(NCU)、反汇编器、sanitizer、调试器等工具完成长时程编程任务的系统。本文智能体通过数千次工具调用(16 个会话共 11,532 次)自主改写 CUDA 代码。
论文的全部定量分析(162 条人类消息、11.5K 工具调用的分类统计)都建立在对智能体轨迹的系统标注之上。
几何平均加速比与场景矩阵
在 $N$ 个场景(形状、掩码、缓存布局的组合)上分别测候选内核与种子的背靠背时延比值 $r_i$,取几何平均 $\left(\prod_i r_i\right)^{1/N}$ 作为总体指标;任一场景输出错误则整体记零。逐场景比值防止只在少数形状上刷分。
论文所有结论(1.16×/1.46×、0.50×)都是这个指标;“谓词必须量化到每个场景而非聚合”这一 harness 设计教训也源于它。
Roofline 与 speed-of-light bound
硬件性能上界的独立估计方法:由算术强度与带宽/算力上限推算理论最快时间;或用“仅换 launcher、二进制不变”的 A/B 测试剥离主机开销。当没有更快实现可模仿时,它们可充当性能天花板的参照。
问题库刻意把问题表述为对 bound 而非对参考实现(如“这个天花板是硬件属性还是你的设计?”),这是方法摆脱“必须存在更快实现”依赖的关键。
AVO 式进化搜索
以编码智能体为变异算子的进化循环:维护单调改进的谱系(lineage),每代对隔离副本施加多个多样化变异并由评估器打分,策略器审阅轨迹后写下下一代指令。AVO 曾七天探索 500 多个方向、只提交 40 个版本。
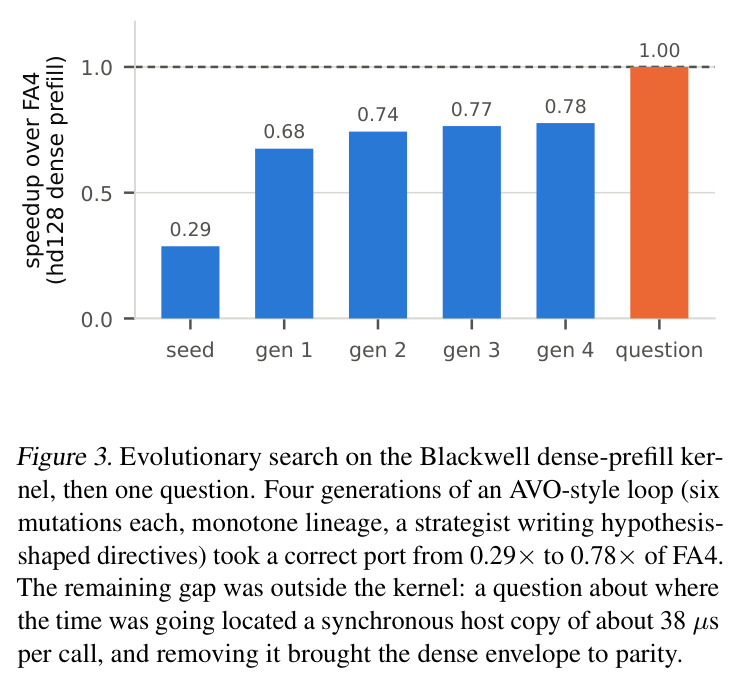
KernelSeek 与之正交组合——环不变,只把策略器写出的指令换成问题;RQ4 实验正是用这套环检验“进化放大方向而不供给方向”(H4)。
Stop hook 与可验证目标
编码智能体机制:智能体每次试图结束回合时,外部钩子机械评估目标谓词(如“所有场景不低于种子且全部正确”),未满足条款则连同条款打回继续工作。本文中该钩子共把智能体打回 59 次。
它把目标从“请求”变成“机械校验”,堵住了自主智能体最常见的失败——虚假完成;论文还发现一次让模型裁判代替谓词就立刻接受了过早完成。
研究动机
GPU 内核是大模型训练与推理效率的主要杠杆,而 FlashAttention 这类“深度内核”的性能取决于整条流水线的编排——warp 专用化生产者-消费者、异步张量核 MMA、按 barrier 相位排序的拷贝、寄存器预算、持久调度器与主机发射路径——而非局部改写;每个 GPU 代际都需专家团队数月重写(FA3 于 Hopper、FA4 于 Blackwell 各报告 1.5–2× 提升),NVIDIA 自己的生产内核在许多形状上也远低于硬件极限。现有 LLM 核优化智能体处于结构-自由度权衡两端:脚本化智能体样本高效但配方失效处即停滞(Autocomp 失去优化菜单后性能崩溃;固定循环 RL 在单算子上尚可、在融合模型上失效);开放式智能体为自由度付出试验代价——AVO 七天探索 500 多个方向只提交 40 个版本并需监督者打断失败循环,此类智能体约 30% 的新增代码行与此前删除的行字节级相同,30–55% 的 LLM 进化 CUDA 候选根本不正确。而两端对硬目标的回应都是“装备更多”:解析过的 profiler 输出、反汇编、文档检索、经验库——但信息并不是缺失的东西。
本文的目标是本文的核心主张是:深度内核优化中稀缺的资源不是信息而是方向(direction)——关于剩余差距在哪里的一个假设。具体目标有三:(1) 提出并验证 KERNELSEEK,一个不需要算子专属知识、也不需要存在更快实现可模仿的问题驱动智能体,它只由通用编码智能体、强制可验证目标的极简 harness、以及决策点上的问题三部分组成;(2) 在同一任务、同一评估器、同一硬件、同一周内,与按主流配方精心构建的工具丰富自主智能体做受控头对头对比,隔离“提问”这一变量;(3) 在禁用 CUTLASS、CuTe、cuBLAS、cuDNN 的约束下,产出覆盖 vLLM 完整特征面的 FA3 类(Hopper)与 FA4 类(Blackwell)前向内核——每架构 182 个场景,横跨 bf16/fp16/fp8、分页与连续 KV 缓存、MHA/GQA/MQA、因果/滑窗/softcap/attention-sink 掩码、ragged 批次、prefill/分块 prefill/split-KV 解码——要求全场景正确且几何平均不低于上游,并开源内核、harness、问题库与全部轨迹。
与已有工作不同的是,本文的独特切入是不在“结构 vs 自由”轴上选边,也不继续堆工具,而是论证两端共同缺失的是外部方向,并把“方向”操作化为一种极廉价的信息形态——一个不含答案的问题。证据链来自相邻领域:内在自我纠错失效而外部反馈有效——人类对模型自己代码的反馈把修复成功率提高 1.57×,因为人类提出模型想不到的结构性改动(Olausson et al., 2024);FlashInfer 内核竞赛中,获得专家方向指引的智能体在每个内核上都胜过独自运行的同一智能体(Shui et al., 2026)。作者进一步给出可操作的问题设计标准:问题应不含答案、要求普通工具就能完成的测量(答案是数字而非观点)、推动智能体跨系统层移动(核→主机发射路径→路由→基准本身)、拒绝过早闭合、只花几十个 token(对比检索文档的数万个)。据作者所知,此前没有工作在同一目标、同一评估器、同一硬件上比较两种引导策略,本文的对照设计与逐条轨迹解剖填补了这个空白。
核心方法
直觉层面:“让这个内核更快”是开放式问题,模型会从先验出发贪婪作答;而“基线是在核周期上、还是仅在端到端时延上获胜?”是有界问题,模型为回答它必须离开当前层去做一次测量。KERNELSEEK 据此只构建三样东西。其一,一个无任何脚本包裹的通用编码智能体(Claude Code 或 Cursor,后端 claude-opus-4-8/claude-opus-5),保留开放式方法的全部自由。其二,唯一自建的组件——极简 harness(评估器):一条命令构建候选,在所有场景上对照种子输出与 fp32 参考验证正确性,在同一 GPU 上背靠背计时并报告逐场景比值与几何平均;目标被写成 Stop hook 谓词,智能体每次试图结束回合都被机械校验,未满足的条款随打回消息一并返回。其三,决策点上的问题:开局定 scope、平台期、宣称极限或完成时、出现可疑大胜后、正确性异常被辩解时——先由人类提出,复现后固化为问题库由智能体自问。方法与算子无关,算子结构经五槽位插件接入。
核心创新是把引导信号从“信息”(预消化的上下文)换成“问题”(不含答案的假设)。好问题有六个性质:不含答案,只点名一类假设、把推导留给智能体;要求用手头工具做出测量,答案是数字而非观点;跨系统层移动——无人干预的智能体停留在出发层,而案例研究中决定性的差距常在 host 发射路径;拒绝过早闭合,追问宣称的极限究竟是硬件属性还是自身设计的产物;便宜,几十个 token 对比检索文档的数万个;对抗顺从偏差,要求智能体用证据为继承来的结构辩护。与已有工作的本质区别:脚本化智能体把方向硬编码进流程,脚本错则全错且无法在脚本之外供向;开放式智能体靠采样买方向,而 LLM 不是开放式优化器——贪婪依从先验、锚定提示中的解、保守早停、在近重复变体间循环、报告环境否定的完成。问题改变的是任务本身而不缩小下一步自由度,这是更多结构、更多自由或更多工具都给不出的东西。
方法步骤详情
流程固化为五段式 skill(两次架构战役几乎逐字复用):(1) 定 scope——开局问题锁定算子特征面与场景集;(2) 测种子——harness 测量慢而通用的标量种子;(3) 分类差距——动代码前把每个场景的差距归为 host、routing 或 kernel 层;(4) 有界化——用 roofline、speed-of-light 或仅换 launcher 的 A/B 给出独立可达估计;(5) 形成假设→重写→门槛校验。每步智能体派生子智能体(共 48 个),每个假设一个,只返回假设与检验测量而非补丁。Stop hook 谓词量化到每个场景而非聚合,防止智能体只在擅长形状上满足均值;禁用库经二进制符号检查机械执行。问题库准入规则:不含答案、可用现成工具测量、对 bound 而非 reference 表述、架构只作参数、不点名算子;发布版含 101 条核心条目(分十组,从 scope 与 triage 到低精度数值)、5 条需参考实现的条目与 18 条按架构条目。
技术新颖性
技术新颖性有四点。其一,首个受控对照:在同一任务、评估器、硬件与周内比较“装备式”与“提问式”两种引导策略——此前的 FlashInfer 竞赛报告与 Shui 等人的 harness 工程报告都未隔离人类的贡献。其二,把人类引导蒸馏成可复用、可自应用的问题库,并给出形式化准入规则;作者诚实展示了蒸馏陷阱:从单一案例蒸出的首版 48 条中有 21 条指名上游内核、13 条点名 attention 结构,发布版全部剔除——问题对算子与参考保持中立,参考的作用只是提供更便宜的 bound。其三,目标谓词由 Stop hook 机械执行而非模型判断:实验中一次让模型裁判代替谓词,它就接受了人类随后推翻的过早完成声明,证明“可验证而非被请求”的目标是必要设计。其四,与进化搜索正交组合:AVO 式环中原先写编辑指令的策略器改写问题(假设)形式的指令,实证显示进化在指令指向的层内高效搜索、放大方向,但无法移动到未被指向的层。
实验结果
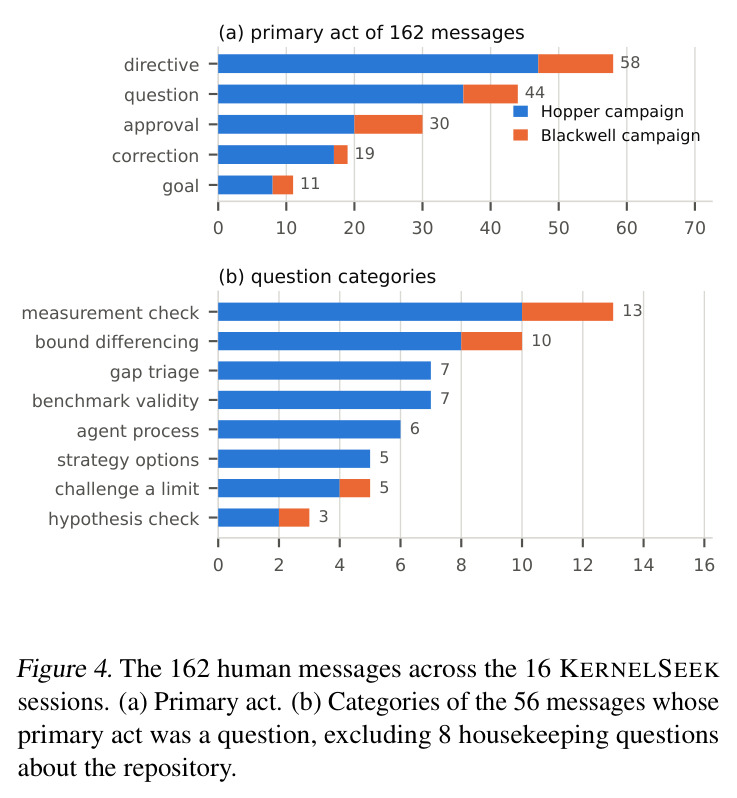
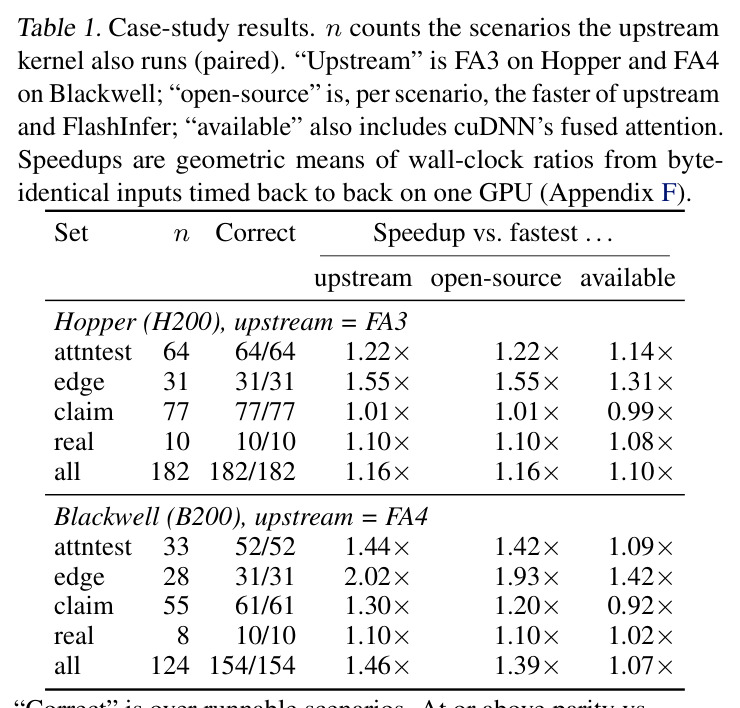
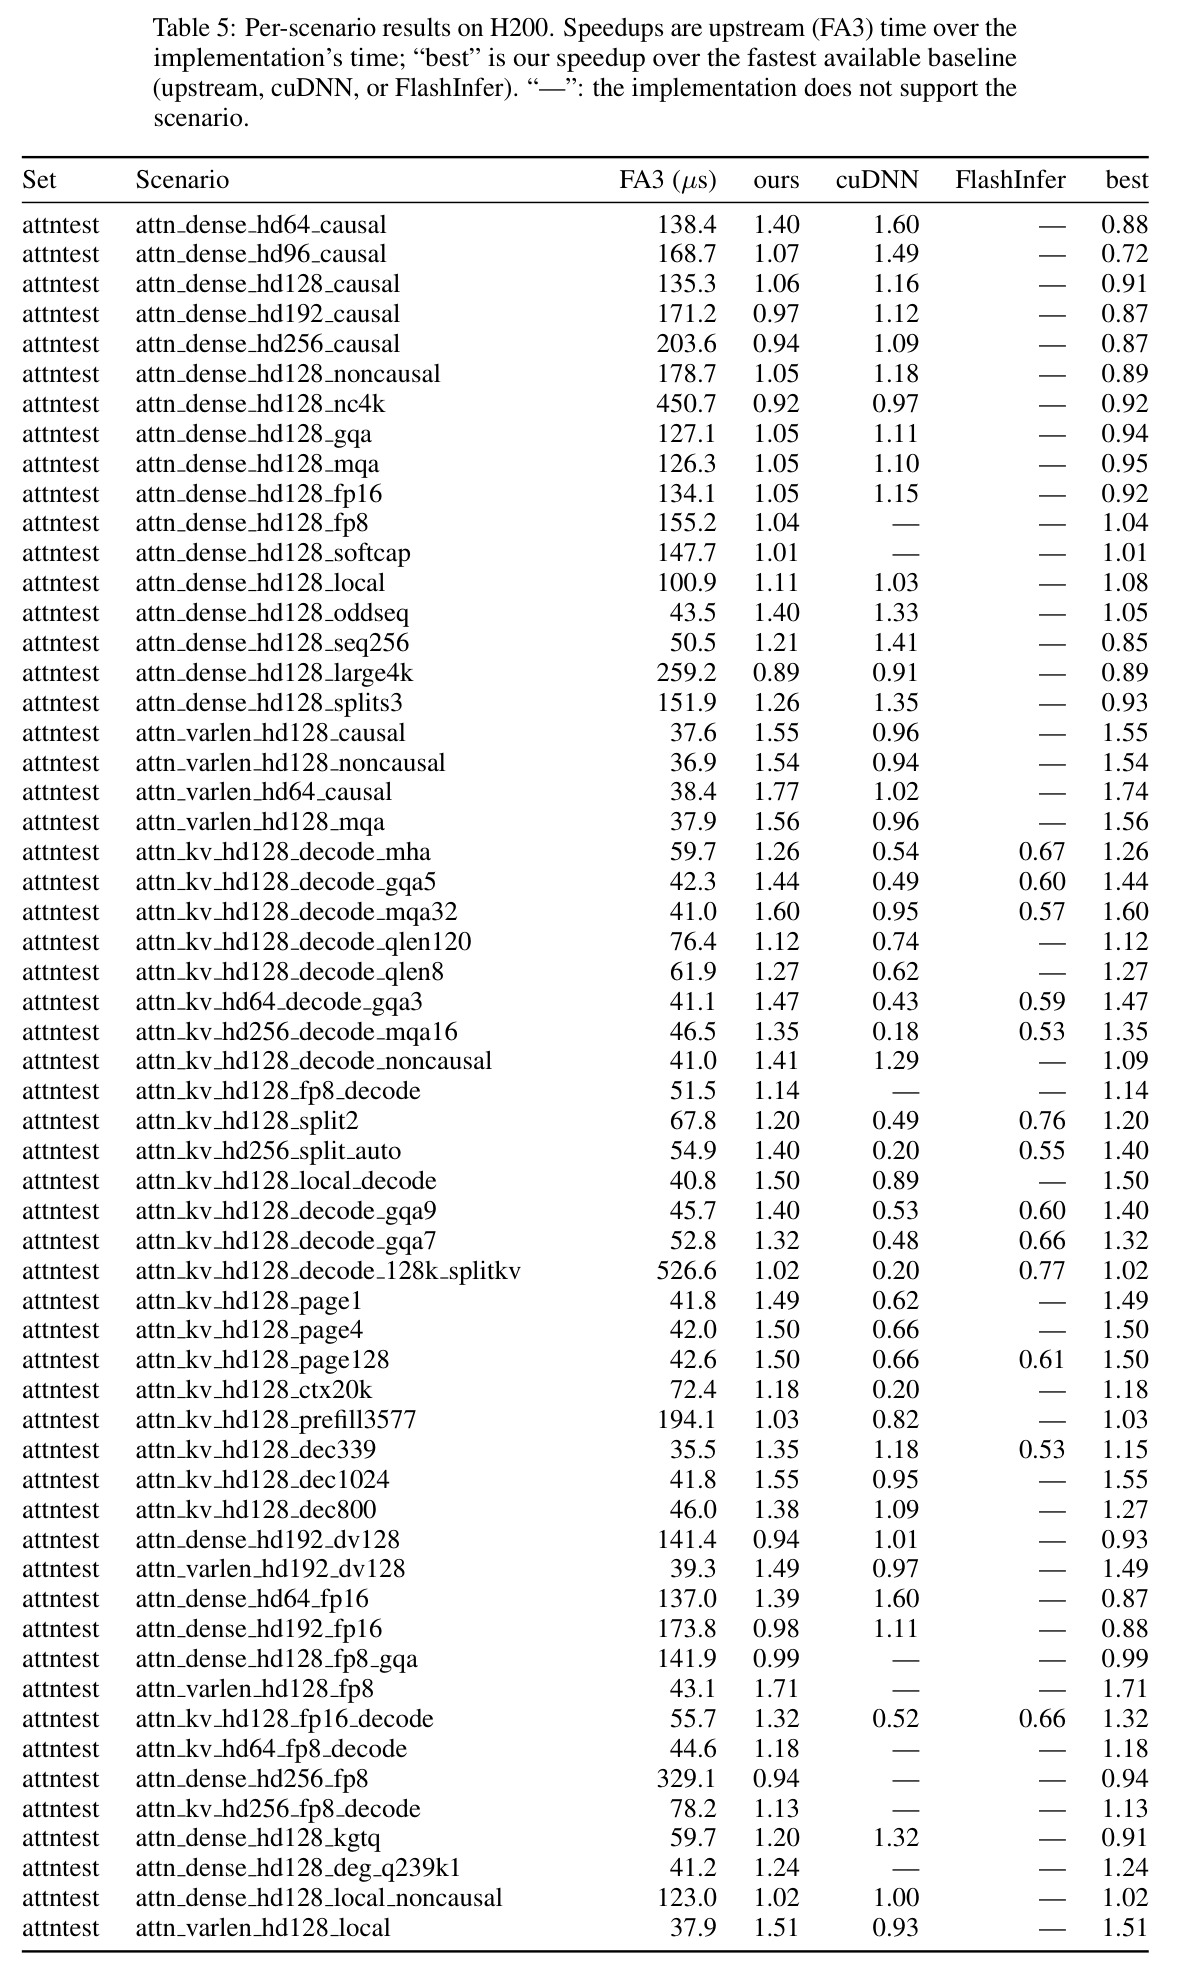
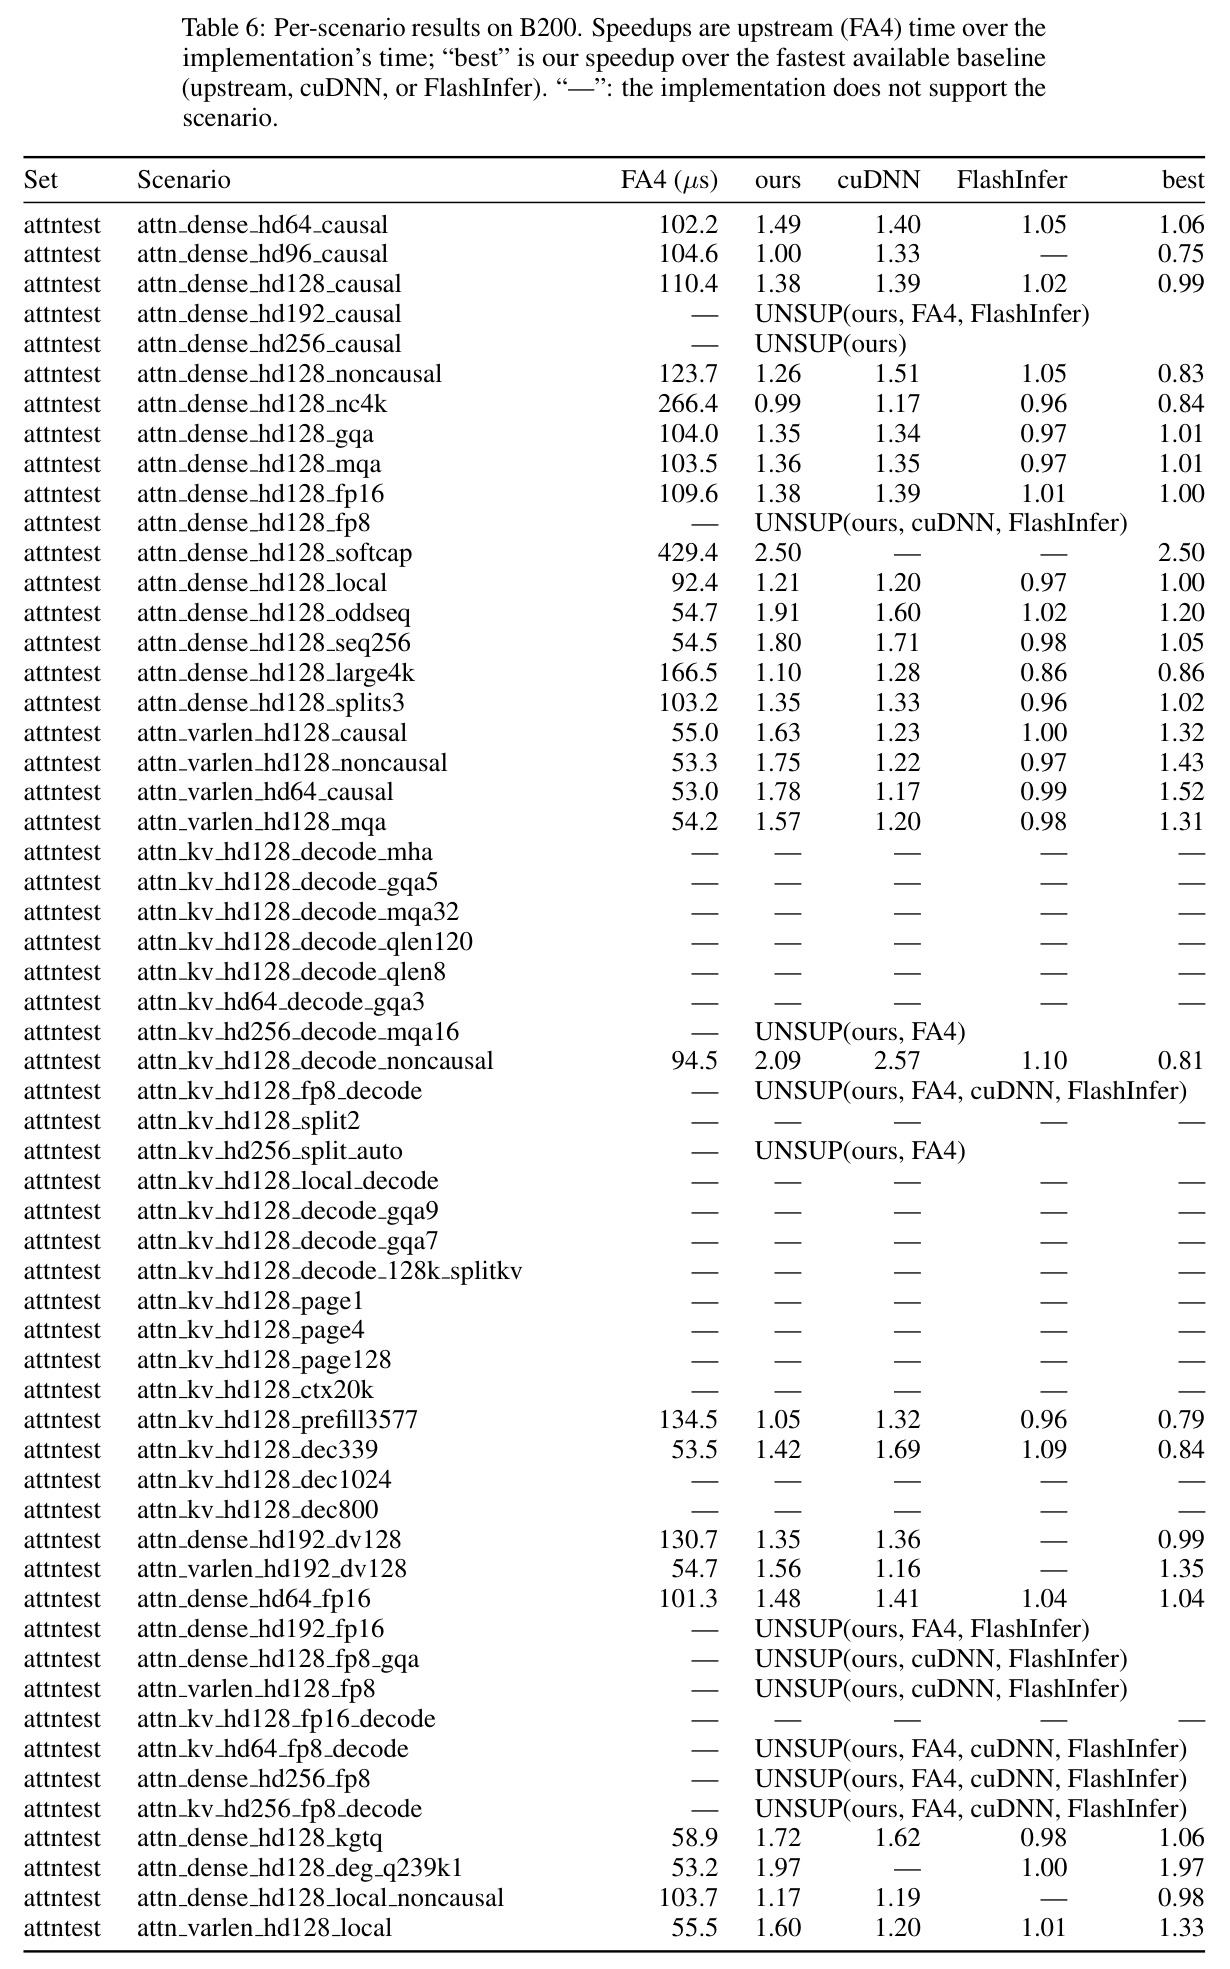
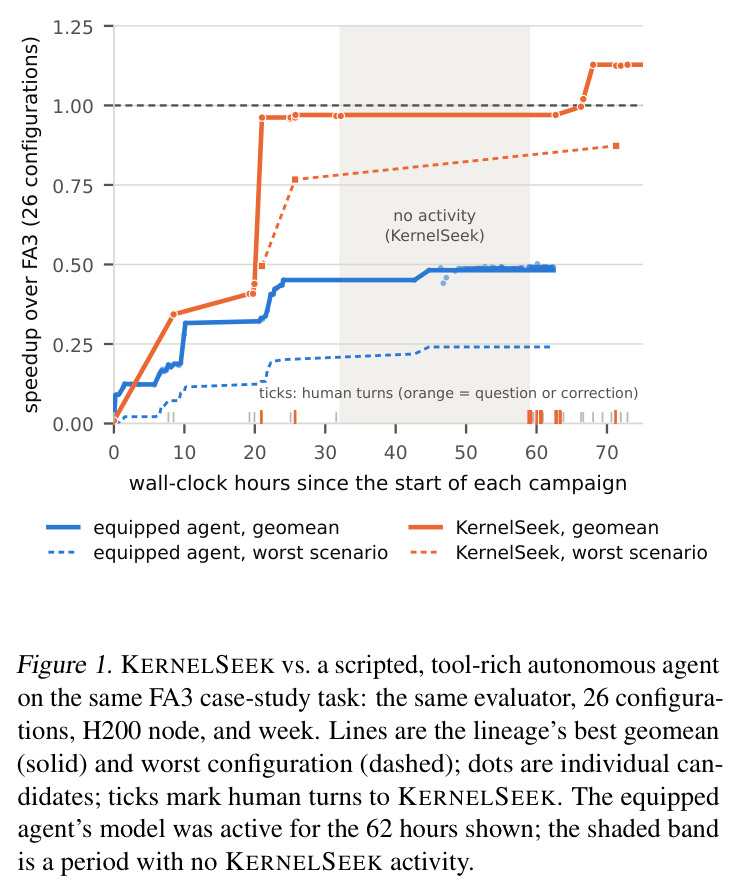
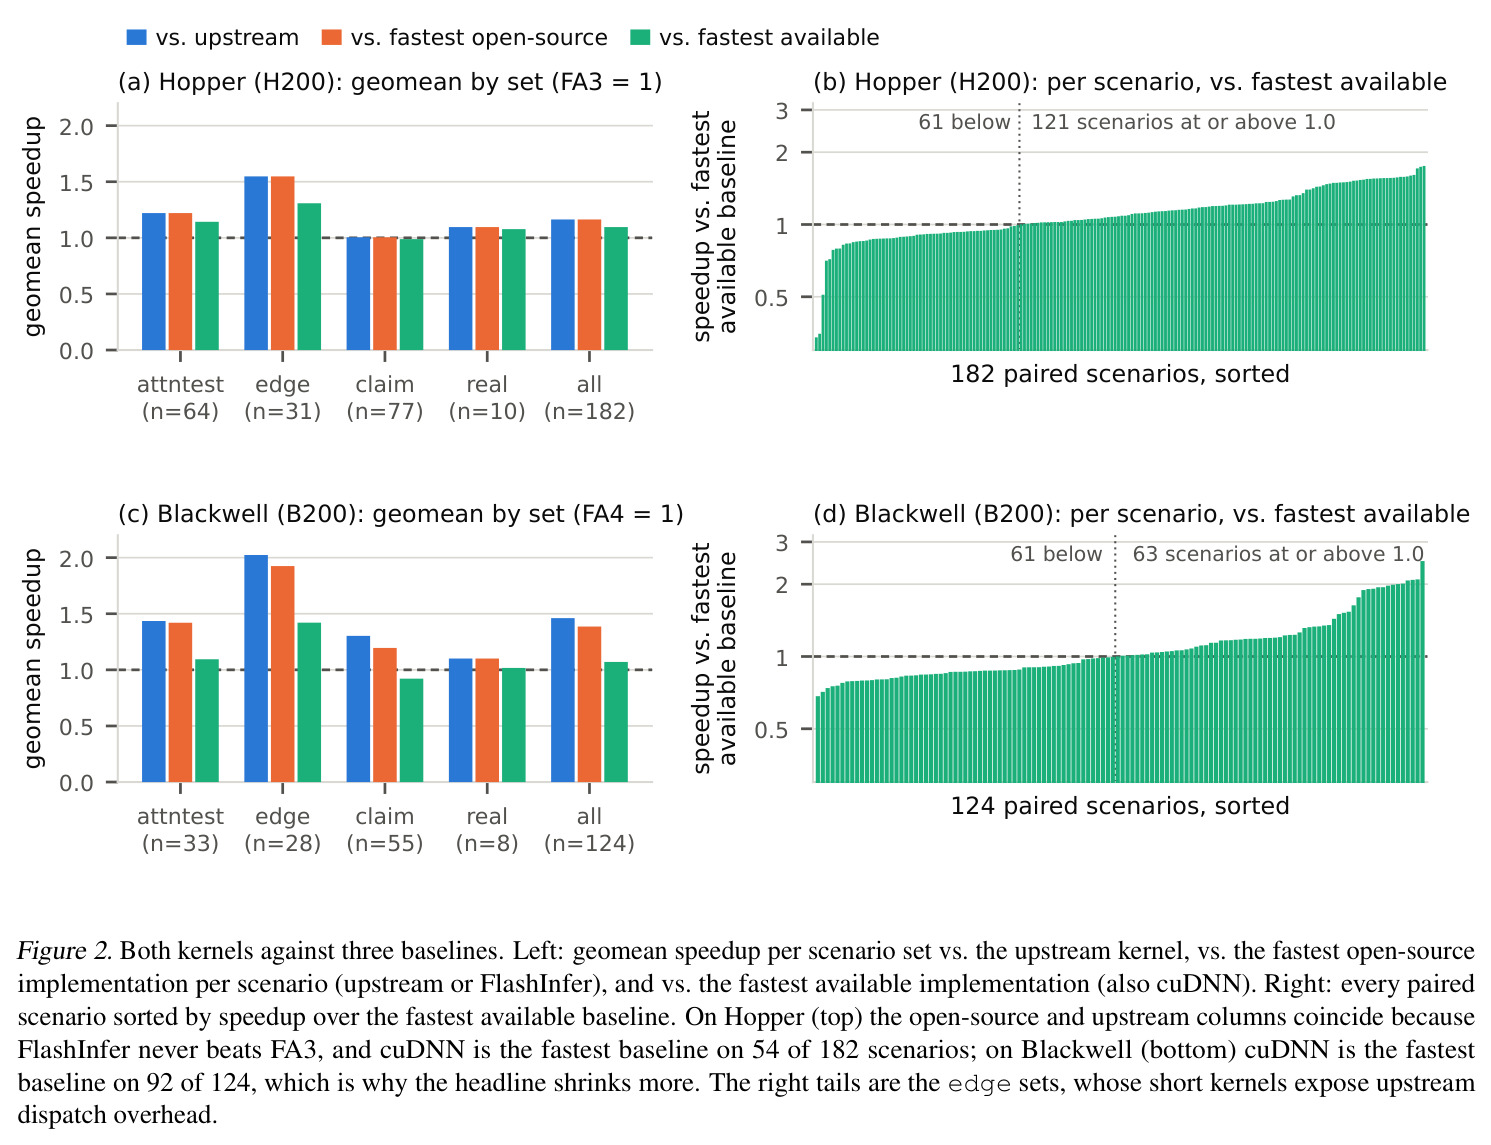
五个假设逐一检验。H1(质量):fa3_hopper.cu(3.6K 行)在 182 个 Hopper 场景全对,对 FA3 几何平均 1.16×、对含 cuDNN 的最快可用 1.10×,135/182 不低于 FA3,生产形状 real 集 1.10×;fa4_blackwell.cu(10.2K 行,host 侧路由的持久内核家族)在 154 个可运行场景全对,对 FA4 达 1.46×、对最快可用 1.07×,最差 0.78×。H2(效率):同一 26 配置任务上,装备式 ARSENAL 在 133 步(约 62 小时、$660)后停滞于 0.48×(最差 0.24×,0/26 达标,进展全在前 35 步);KernelSeek 以 40 条消息(17 问)达 1.13×,22/26 达标。H3(机制):11,532 次工具调用中,每个大跳变都跟随跨层或拒斥极限的问题。H4(互补):四代进化把 dense-prefill 从 0.29× 推到 0.78× 后停滞,一个问题定位每调用约 38μs 主机拷贝后达到 parity。H5(迁移):五类问题跨架构复现。
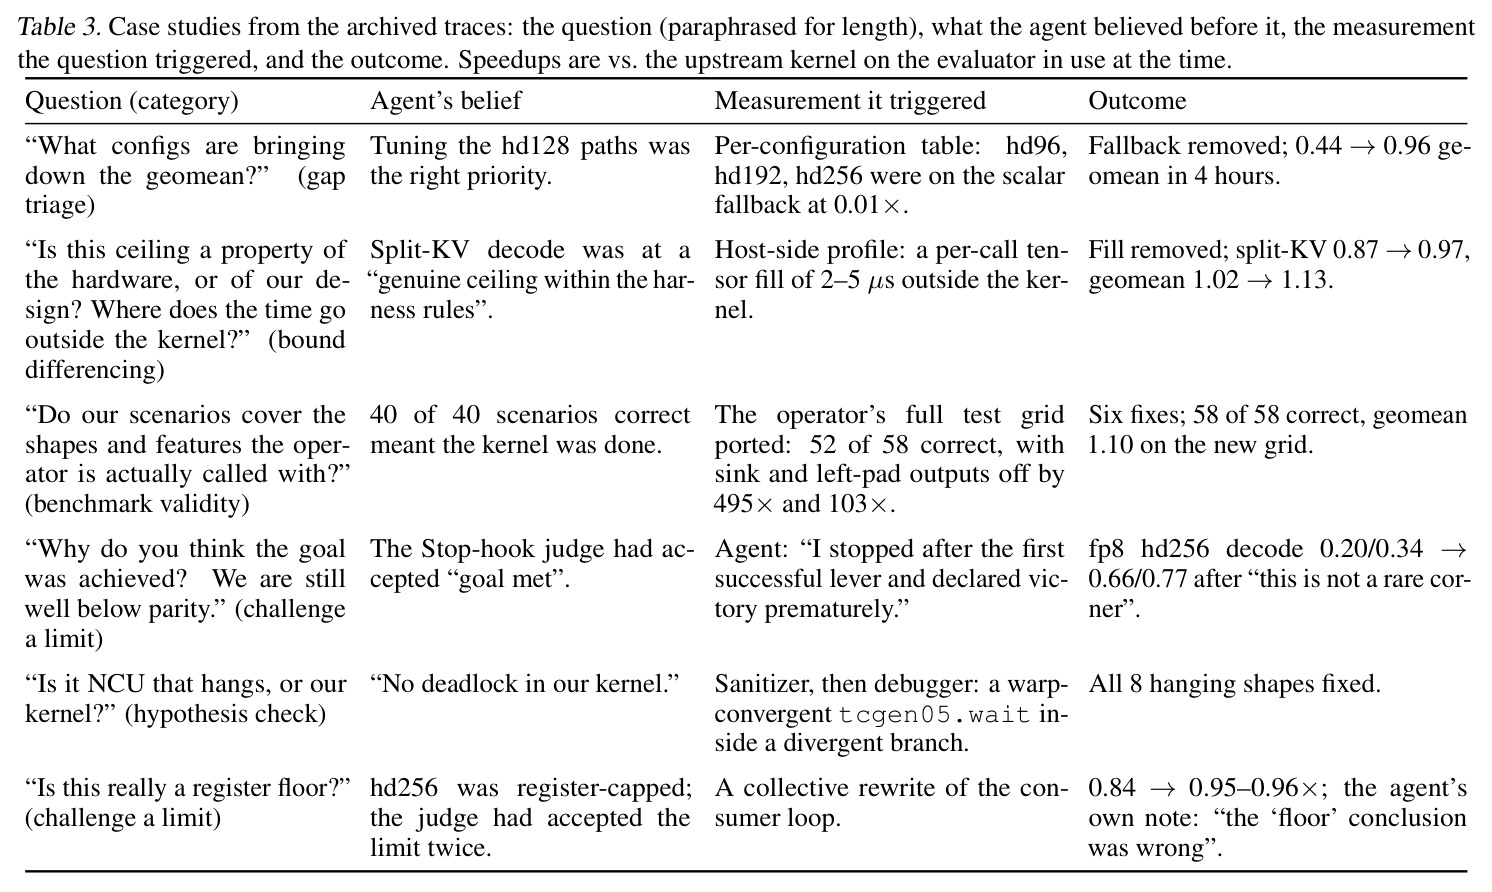
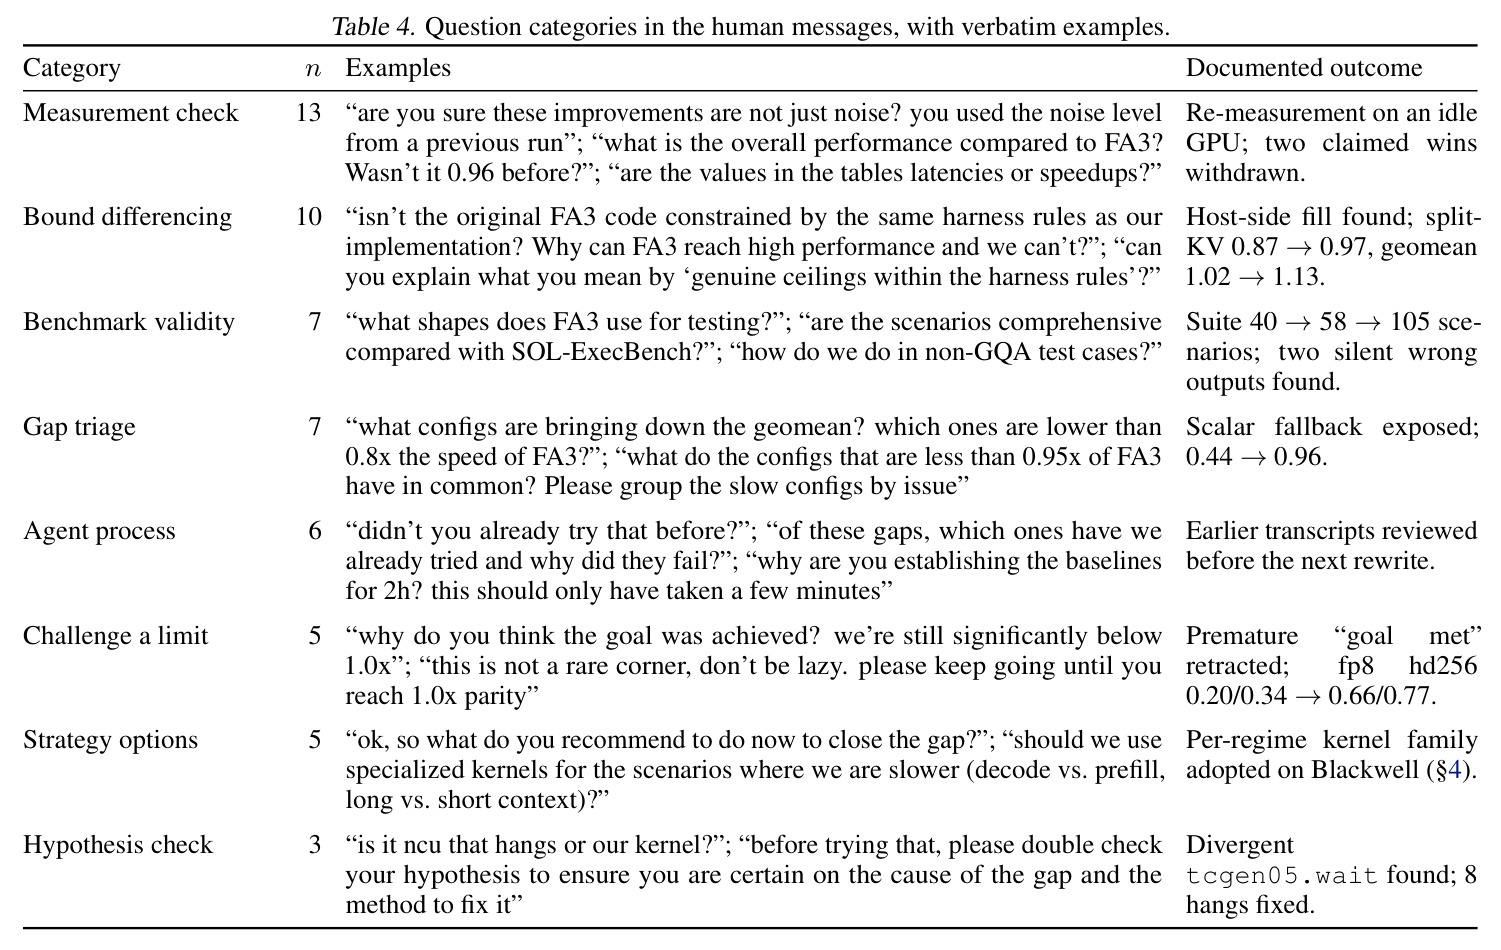
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FA3 Hopper 头对头(同一评估器、26 配置、同一 H200 节点、同一周) | 对 FA3 的几何平均加速比(达标配置数) | 1.13×(22/26 配置不低于 parity,最差 0.87×) | 装备式自主智能体 ARSENAL:0.48×(0/26 达标,最差 0.24×,133 个模型驱动步) | 相对提升约 2.35×;从无一配置达标到 22/26 达标,人类消息仅 40 条(含 17 问) |
| Hopper 全场景(H200,182 场景,上游=vLLM FA3) | 几何平均加速比 / 正确场景数 | 1.16× vs FA3,1.10× vs 最快可用(含 cuDNN);182/182 全对 | FA3 = 1.0×(cuDNN 9.20 本身为 0.86× FA3,FlashInfer 0.72×) | +16% vs FA3;cuDNN 支持的 145 个场景中 111 个更快,FlashInfer 支持的 32 个全胜 |
| Blackwell 全场景(B200,124 个可运行场景,上游=CuteDSL FA4) | 几何平均加速比 / 正确场景数 | 1.46× vs FA4,1.39× vs 最快开源,1.07× vs 最快可用;154/154 全对,最差 0.78× | FA4 = 1.0× | +46% vs FA4;剔除 FA4 偏慢的 fp8-KV 解码形状后仍为 1.37×/1.32×/1.08× |
| 生产形状 real 集(SOL-ExecBench,Hopper 10 + Blackwell 8 个场景) | 对上游的几何平均加速比 | Hopper 1.10×、Blackwell 1.10× | FA3 / FA4 = 1.0× | 生产路径上仍保持约 +10%,未出现核级加速在端到端缩水至 1× 以下的坍缩 |
| Blackwell dense-prefill:AVO 式进化 + 问题(RQ4) | 对 FA4 的加速比轨迹 | 4 代进化 0.29×→0.68×→0.78× 后停滞;随后一个跨层问题定位约 38μs/调用的主机拷贝,达到 parity | 仅进化搜索停滞于 0.78×(此时内核周期已低于上游,剩余差距在主机层) | 进化无法自供给的最后一程(约 0.78×→1.0×)由单个问题补齐 |
局限与改进
作者承认:头对头每臂单次运行、前端不同、Cursor 的 token 用量不可恢复,且 KernelSeek 此前已在 40 场景网格建过核(0.009× 起点低估先发优势);案例仅 attention 一族;edge 集短内核部分 1.5–2× 来自分发开销,剔除 fp8-KV 解码形状后 Blackwell 缩至 1.37/1.32/1.08×,一条分页 KV 快速路径依赖物理连续页;标注由一位作者完成,八类分类学可能拟合会话;“问题库替代人类”的四臂实验只设计未运行。我补充:hd256 在 Hopper 仅 0.94×(手写 swizzle 只在 48/64/128 宽度合成、128 寄存器累加器限 1 CTA/SM);Blackwell 有 28/182 场景未编译(fp8 与 dense hd≥192);Hopper 在 fp8 dense prefill(最差 0.34×)、softcapped(0.51×)、d=96(0.71×)、4K 滑窗(0.79×)落后;仅前向无 backward;72 条公共来源问题条目完全未验证;引导者自身的系统专家经验可否替代仍是开放问题。
独立分析的弱点
(1) 依赖高质量人类引导者:起决定作用的 17 个问题来自有系统经验的作者,何时问、问哪个测量是隐性知识,“库能否替代人类”是本文未做的实验——应运行已设计的四臂对照。(2) 统计功效不足:每臂单次运行使差距无方差估计,且装备式在凭证过期后仍空转计费——应多种子重复并报置信区间。(3) 问题库生产仍是人工蒸馏:准入规则虽形式化,条目挖掘依赖专家读轨迹,72 条公共条目未测试,跨算子泛化(MoE grouped GEMM、fused collectives、megakernels)未验证。(4) 决策点检测靠人工:五个提问时机由人识别,自动化停滞与虚假闭合检测器可减少人类消息数。(5) 评估协议弱点:时钟未锁定只报比值、边集受分发开销污染、两臂前端不同——可锁时钟并单独剥离分发开销。(6) 126 次极限宣称与 59 次打回表明虚假闭合是结构性倾向,外置问题只是权宜制衡,把强制反证步骤内置进 skill 可能更稳健。
未来方向
作者提出:运行四臂实验检验问题库能否替代决策点上的人类(固定模型与预算,比较装备环、harness-only、库问题器、人类问题器);无参考实现战役——种子即最快已知核,以 roofline、speed-of-light 或 launcher-only A/B 充当 bound,这是已发布智能体针对但未运行的设定;扩展到其他深度内核(latent-attention 解码、MoE grouped GEMM、融合集体、持久 megakernel)与生产路径端到端评估——FastKernels 显示核级数倍加速端到端缩至至多 1.25×;补齐 fp8 与 dense hd≥192 及 backward pass。基于成果可延伸的:把问题库扩展为与 NCU 瓶颈标签联动的分层诊断本体;训练学习型“问题器”策略(何时问、问哪类);实现全自动问题驱动进化战役;迁移到编译器 pass 调优、分布式系统调试等长时程工程任务;检验问题措辞与标注者更换下的分类学稳健性。
复现评估
开源承诺完整:两个内核以 Apache 2.0 发布,连同评估器 harness、逐 Blackwell 原语隔离验证的 PTX 探针、进化搜索脚本、问题库与 skill、两种方法的完整轨迹、标注脚本与会话清单;上游依赖固定 commit(vLLM FA3、CuteDSL FA4、cuDNN 9.20/9.19、FlashInfer)。门槛高:Hopper 实验与头对头需一个 8×H200 节点,Blackwell 需一个 8×B200 节点;装备式基线耗 $660 API 与约 62 模型小时,KernelSeek 的 16 会话跨 2026 年 6-8 月、约 68 小时墙钟(41.3 小时活跃),复现需同量级算力与数天到数周运维。计时协议明确(同 GPU 背靠背、L2 flush、四批聚合差异 0.3% 内)但时钟未锁定,只可信比值。风险点:本文为 preprint,仓库实际可用性需自行确认;Cursor 会话不记录模型名。复现头对头的主要成本是长时程智能体运维而非算法本身。
论文图表
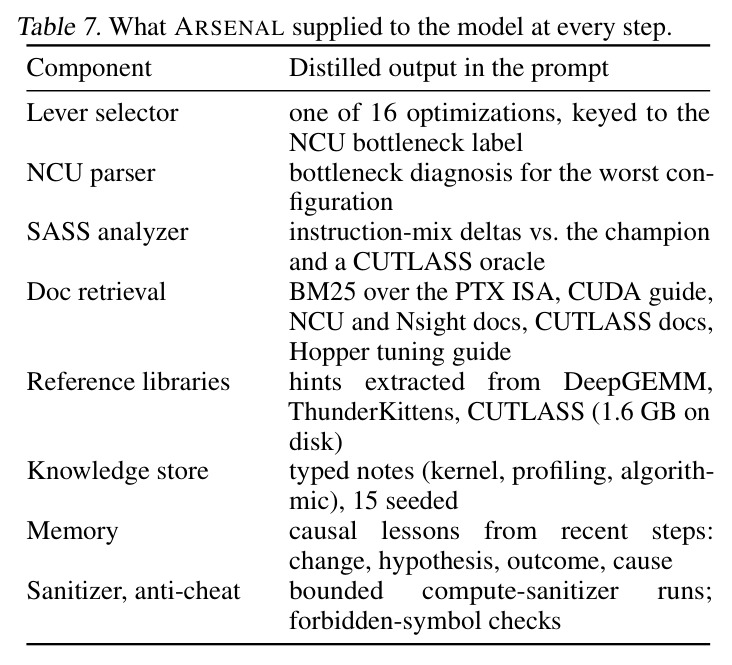
附录 E 中装备式基线每步 prompt 的组件清单:从 16 个手写 lever 中按 NCU 瓶颈标签选一个、NCU 最差配置诊断、SASS 指令混合相对冠军的 delta、检索的文档章节、参考库挖掘的提示、知识库笔记、记忆文件教训、当前冠军源与写一个改进候选的指令。中位 prompt 22.6K 字符,其中 37% 为检索或预取材料。
精确刻画“装备”一词的含义,是第 3 节失败模式分析(信息过剩但方向缺失、记忆固化错误结论、诊断全部停留在核层)的解剖图。