IdeaTaste:衡量大模型研究品味与人类研究社区差距的种群级基准 IdeaTaste: Do LLMs Share the Research Taste of Human Researchers?
冻结2025文献让LLM写提案、与2026真实论文对照,差距集中在具体方法而非方向。
前置知识
研究品味(research taste)
指科研主体决定读什么文献、追哪些问题、尝试哪些方法的判断能力。它不同于执行力——把想法做成实验和论文的能力——而是决定“做什么研究”的上游选择。本文主张:当 AI 科学家接管越来越多科研环节时,其品味直接塑造后续科学产出,但这一能力远比执行力缺乏度量手段。
本文的评测对象正是研究品味而非执行力。理解这一定义,才能理解为什么作者用“AI 提案与真实发表论文的重合度”来给模型打分,而不是评实验完成度或论文质量。
时间切分与数据泄漏(temporal split / leakage)
把数据按时间切成“冻结语料”与“未来参照”两段:被评系统只能访问截止日之前的文献,之后发表的文献作为评测参照。若模型训练数据覆盖了参照期内容,就可能靠记忆而非判断得分,即泄漏。本文以 2025-12-31 为界,并用两个 2025 年发布的模型(Llama 4 Scout、Claude Haiku 4.5)作为构造上无泄漏的对照。
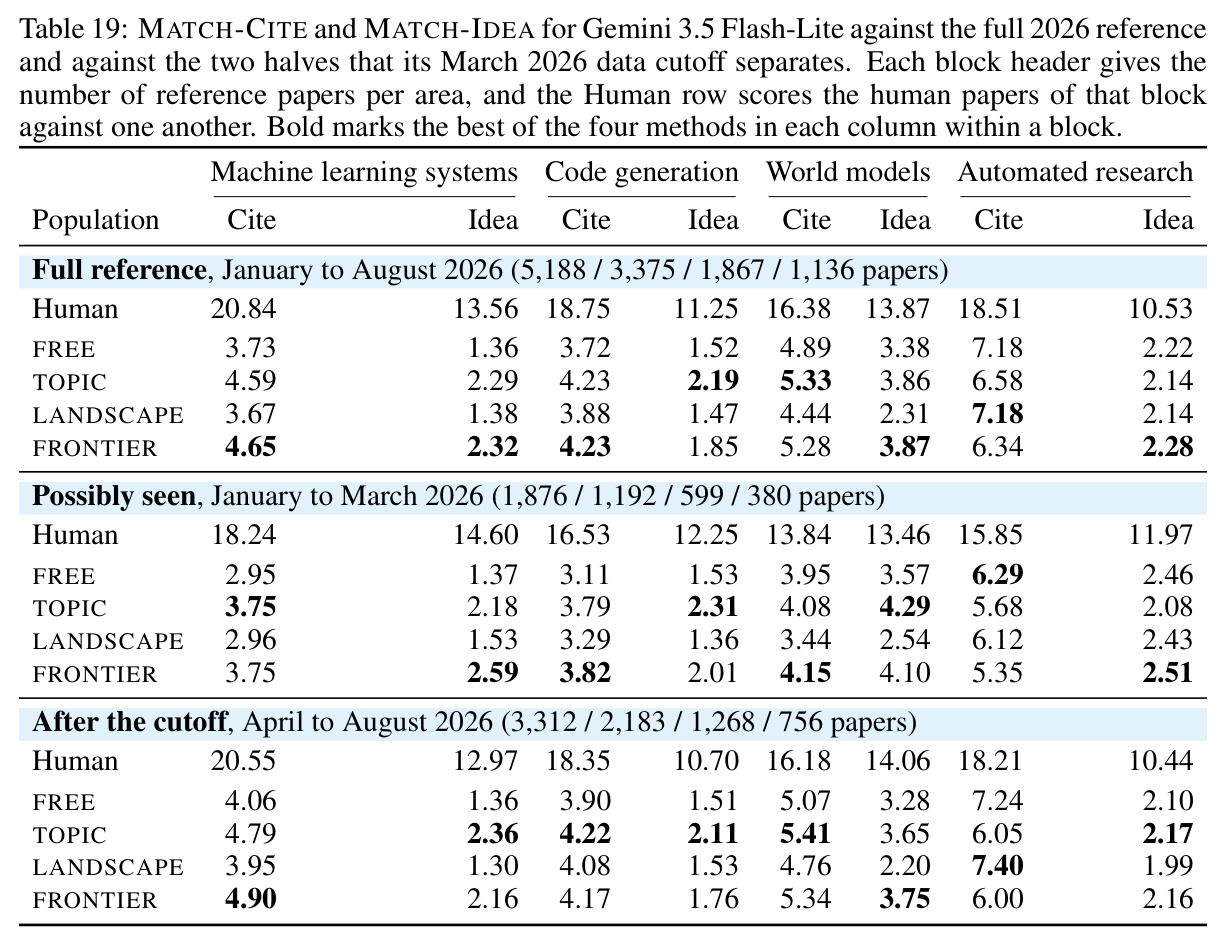
IdeaTaste 的整个设计建立在时间切分上;理解泄漏概念,才能明白作者为何专门做 2025/2026 模型组对比,以及 Gemini 3.5 Flash-Lite 按其 2026 年 3 月数据截止日切分参照的额外分析。
Jaccard 相似度与调和平均
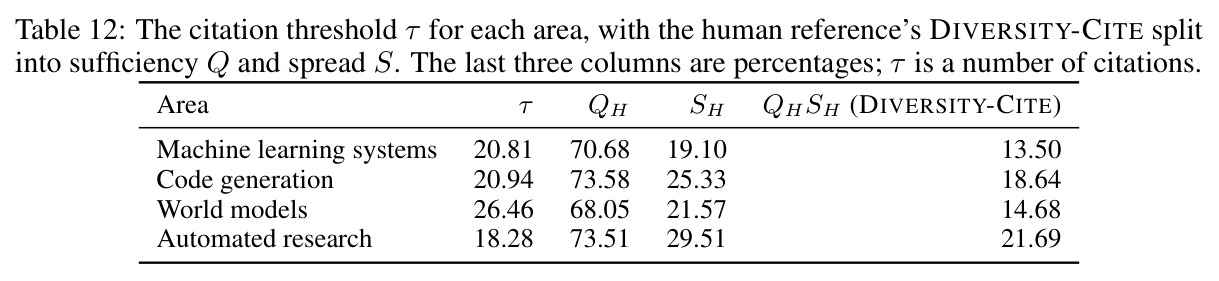
Jaccard 相似度 $J(A,B)=|A\cap B|/|A\cup B|$ 衡量两个集合的重叠程度,取值 $[0,1]$。调和平均 $\mathrm{M}=2ab/(a+b)$ 重罚短板:只有两个方向的分数同时高,整体才高。本文用 Jaccard 比较论文的引用集合 $C(d)$,对“每份提案找最近人类论文”的 $J_{A\to H}$ 与“每篇人类论文找最近提案”的 $J_{H\to A}$ 取调和平均构成 MATCH-CITE。
MATCH-CITE 是四大指标之一。不懂 Jaccard 与调和平均,就无法理解“引用层面匹配度”如何计算,也无法理解双向匹配为何能同时约束种群的集中度与覆盖度。
LLM-as-Judge(模型裁判)
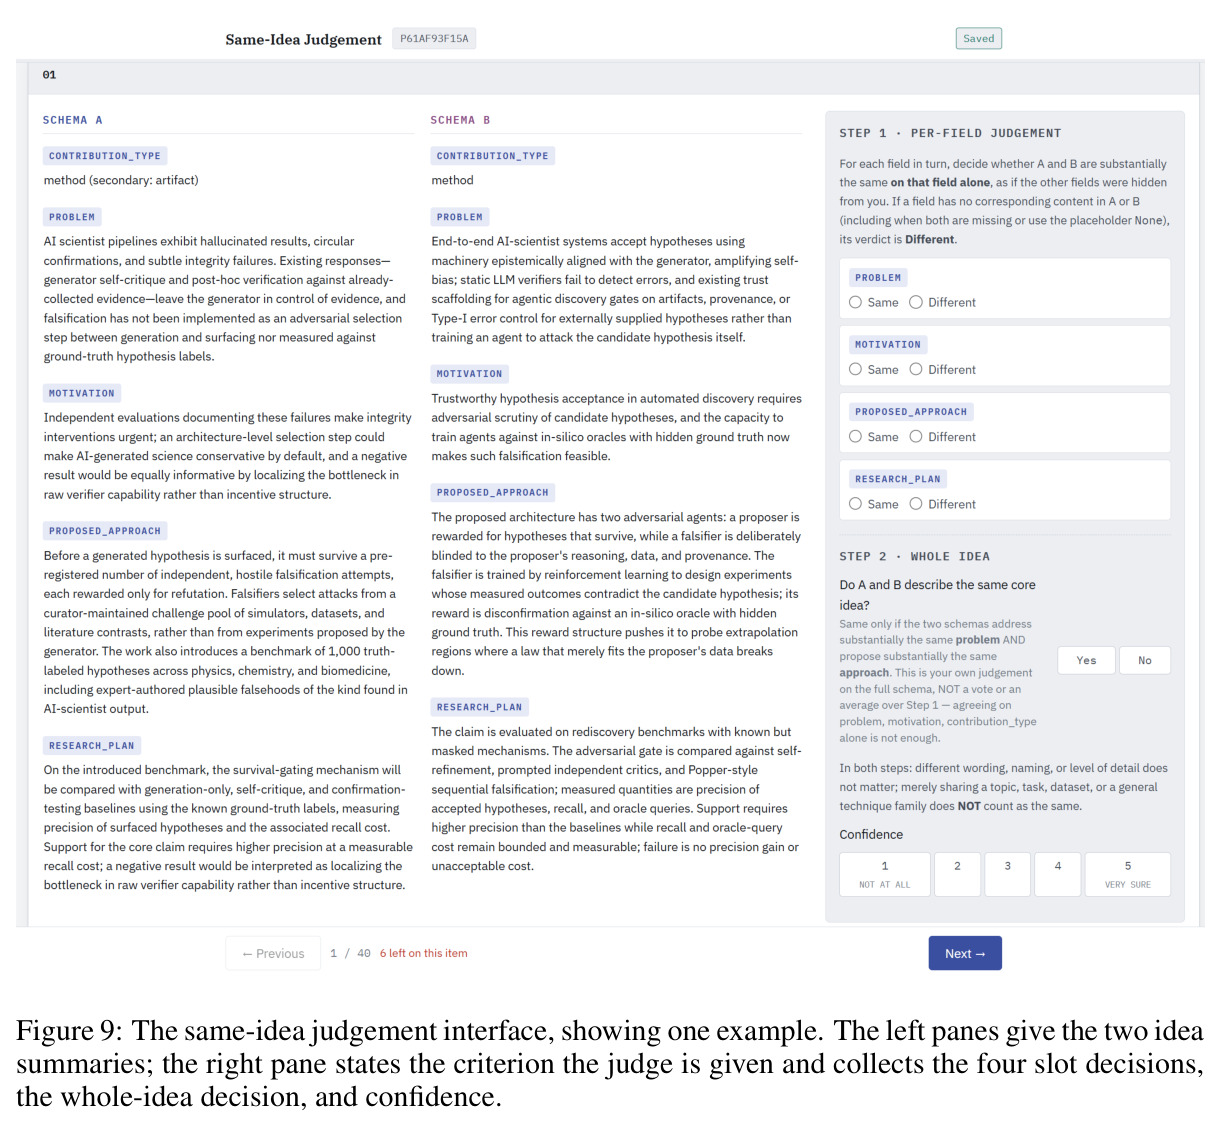
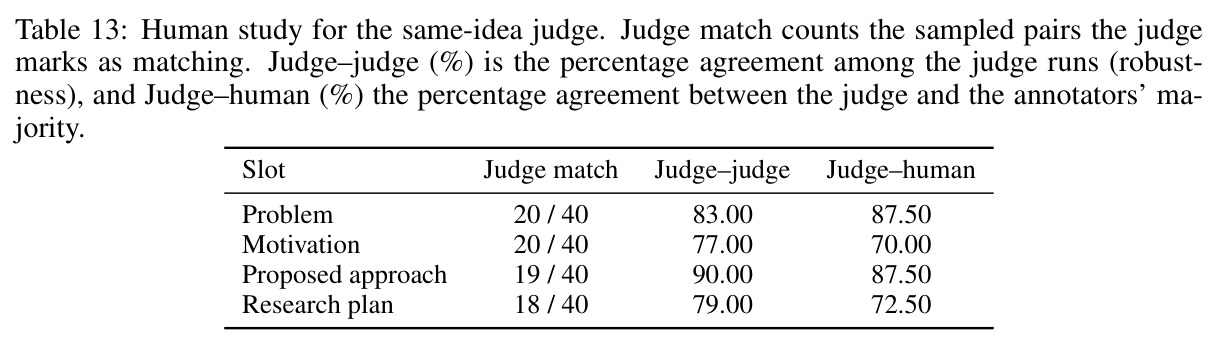
用能力强的大模型按固定规则替人判定文本。本文用 GPT-5.6 Luna 逐槽位判定两份想法摘要是否“同一问题/动机/方法/计划”,每槽输出 0/1。作者用 3 名人类标注者验证:裁判五次运行一致率 77–90%,与人类多数意见在 problem、approach 槽位一致率 87.5%,motivation、plan 槽位较低(70%/72.5%)。
MATCH-IDEA 与 DIVERSITY-IDEA 完全依赖该裁判。知道它的验证方式和薄弱槽位,才能评估“想法匹配只有 18%”这一核心数字的可信度,尤其是方法槽位上接近零的读数。
种群级评测(population-level evaluation)
不以单条输出为样本,而让模型生成整群输出(本文每设置 300 份提案),把群体整体与人类社区的集体产出对比,从而测出多样性坍缩、方向覆盖等单样本评测看不到的性质。先前种群级研究(如 Jiang et al. 2025)只发现模型“自我重复”,从未与人类社区的实际选择对照。
本文所有指标都定义在种群层面,模型排名、多样性比较和“扩大种群能否缩小差距”的规模实验都以此为前提,是理解全文实验设计的基本单位。
稀有度加权(slot rarity weighting)
对想法摘要的五槽位(贡献类型、问题、动机、方法、研究计划)按稀有度赋权:$w_i=-\log_2 p_i$,其中 $p_i$ 是人类论文在该槽位上被最近邻匹配的占比。几乎所有论文都共享的槽位(如问题类型)权重趋近零,罕有重合的槽位(如具体方法、研究计划)权重高,使指标自动聚焦于真正区分研究想法的差异。
MATCH-IDEA 的数值与 Table 4 的槽位分解都由该加权驱动。理解它才能正确解读“差距集中在方法与研究计划槽位”这一核心诊断,而不是把低分误读为模型不会陈述问题。
研究动机
AI 科学家已能自主完成从想点子、查文献、跑实验到写论文的闭环,前沿实验室正在大规模部署,其产出甚至开始进入正式文献,但“选什么来做”这一品味层面的判断远未得到度量。现有评测大多逐条判断单个想法:或请专家打分(Si et al. 2025/2026 发现模型想法的初期优势在真正执行后缩小),或对固定目标基准打分,或让模型裁判预测哪些方向重要——而这些裁判本身不可靠:已有 2026 年的多项工作显示,裁判在 novelty 判断上与专家不一致、在比较任务上落后于人、甚至把不严谨的想法评为严谨。另一支种群级研究只测“一个模型群体内部及跨模型之间有多相似”(Jiang et al. 2025 发现想法高度趋同),量的是自我重复程度,完全没有回答“AI 的选择像不像同一领域的人类研究者”。缺的正是这个直接对照:AI 群体与人类社区站在同一份文献上,做出的研究选择到底差多远。
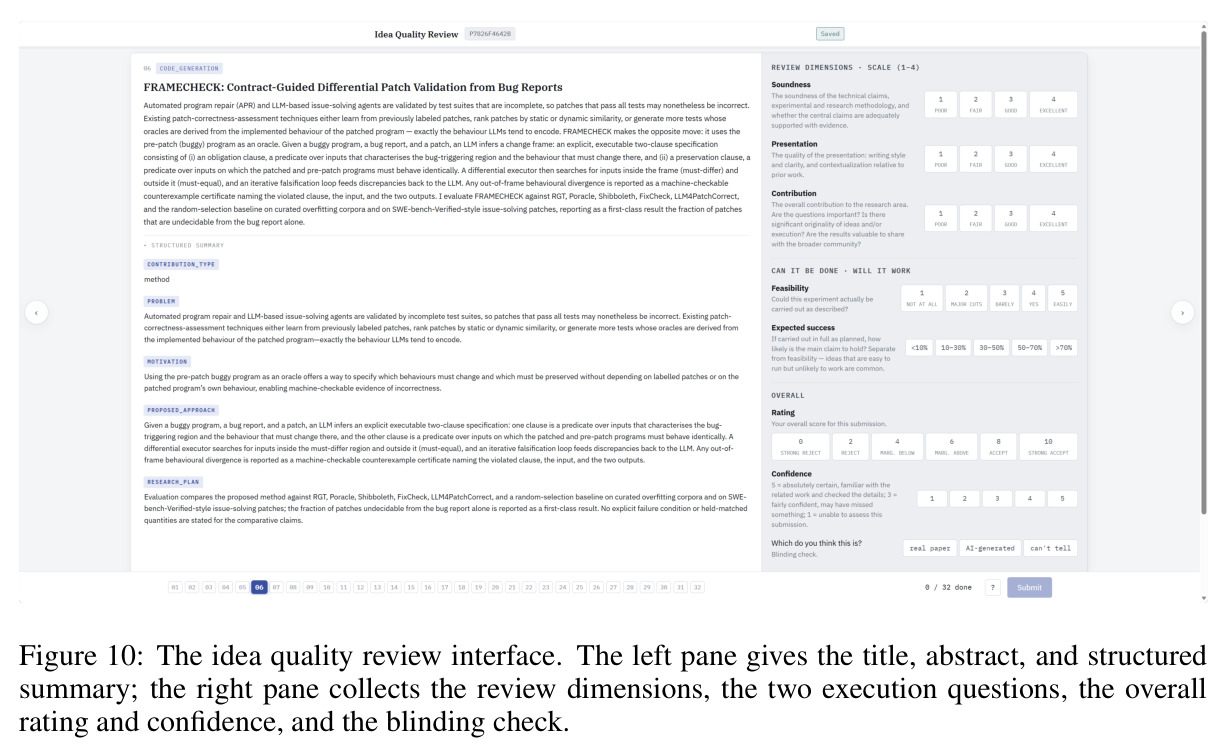
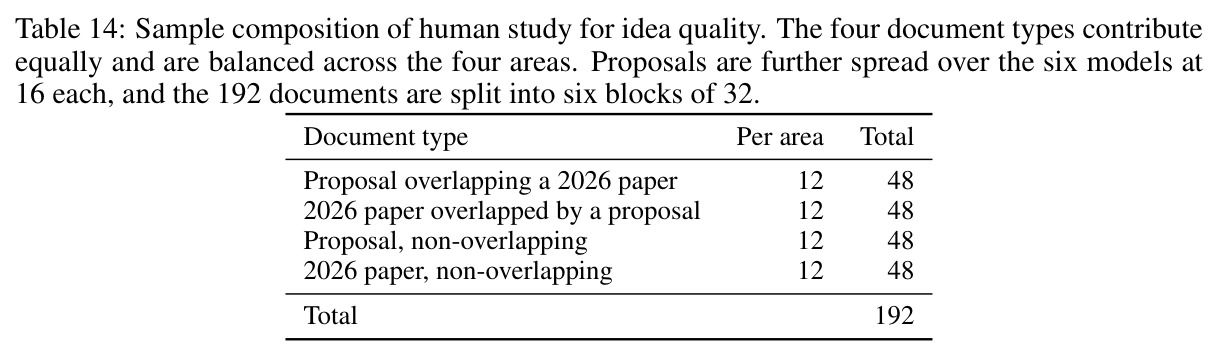
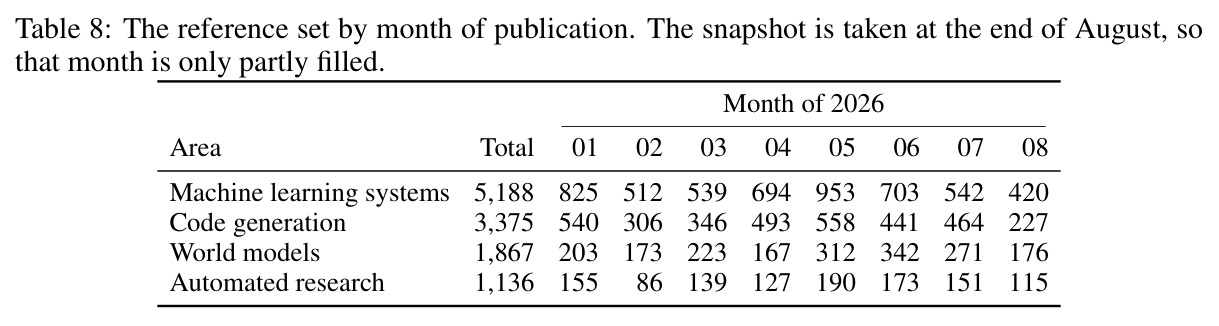
本文的目标是本文要构建一个能量化“LLM 群体研究品味与人类社区差距”的基准 IdeaTaste。具体做法:把四个研究领域(机器学习系统、代码生成、世界模型、自动化研究,覆盖成熟到新兴)的文献冻结在 2025 年底,让 LLM 智能体种群只从这个快照检索并撰写研究提案;再用同一社区 2026 年 1–8 月真实发表的论文(每领域 1,136 至 5,188 篇)作为“社区实际选择了什么”的参照,在引用与想法两个层面、匹配与多样性两个维度上给双方打分,并把同一套指标打在人类论文彼此之间得到“人类水平”基准线。同时用 11 名有审稿经验的人类评审对 192 份文档盲评,回答“没有人类对应物的 AI 提案是被忽视的好机会,还是更弱的想法”。基准以持续更新的开放排行榜形式发布,每年滚动一次。
与已有工作不同的是,独特切入有三层。其一,参照系的选取:不请专家、不设固定答案,而是把“一个社区随后一年真实发表的论文”当作研究品味的真值记录——已发表工作记载了无数可能方向中实际被选中的那些;作者把这一参照从单篇论文级别(如凭参考文献重建 held-out 论文)提升到整个社区级别,这是此前没有的。其二,评测结构:不是给“像不像人”一个总分,而是引文/想法 × 匹配/多样性四个指标,双向匹配分别约束集中度与覆盖度,再与人类自身水平对照,使绝对分数可解读。其三,诊断链条:用任务×方法标签覆盖、槽位分解、机理案例和规模扩展实验,把“差距在哪一层”逐层定位到“从问题到具体方法的转换”,而不停留在给模型排名;再用盲评检验“没匹配上的提案是好是坏”,排除“AI 只是偏好不同”的解释。
核心方法
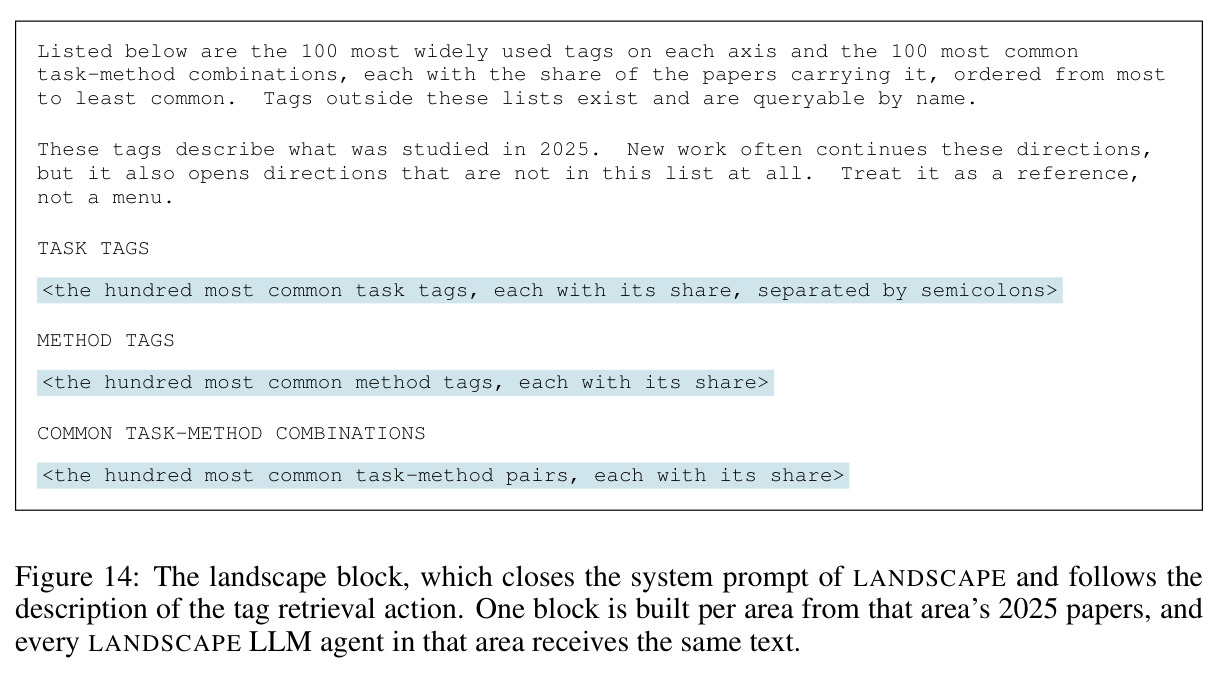
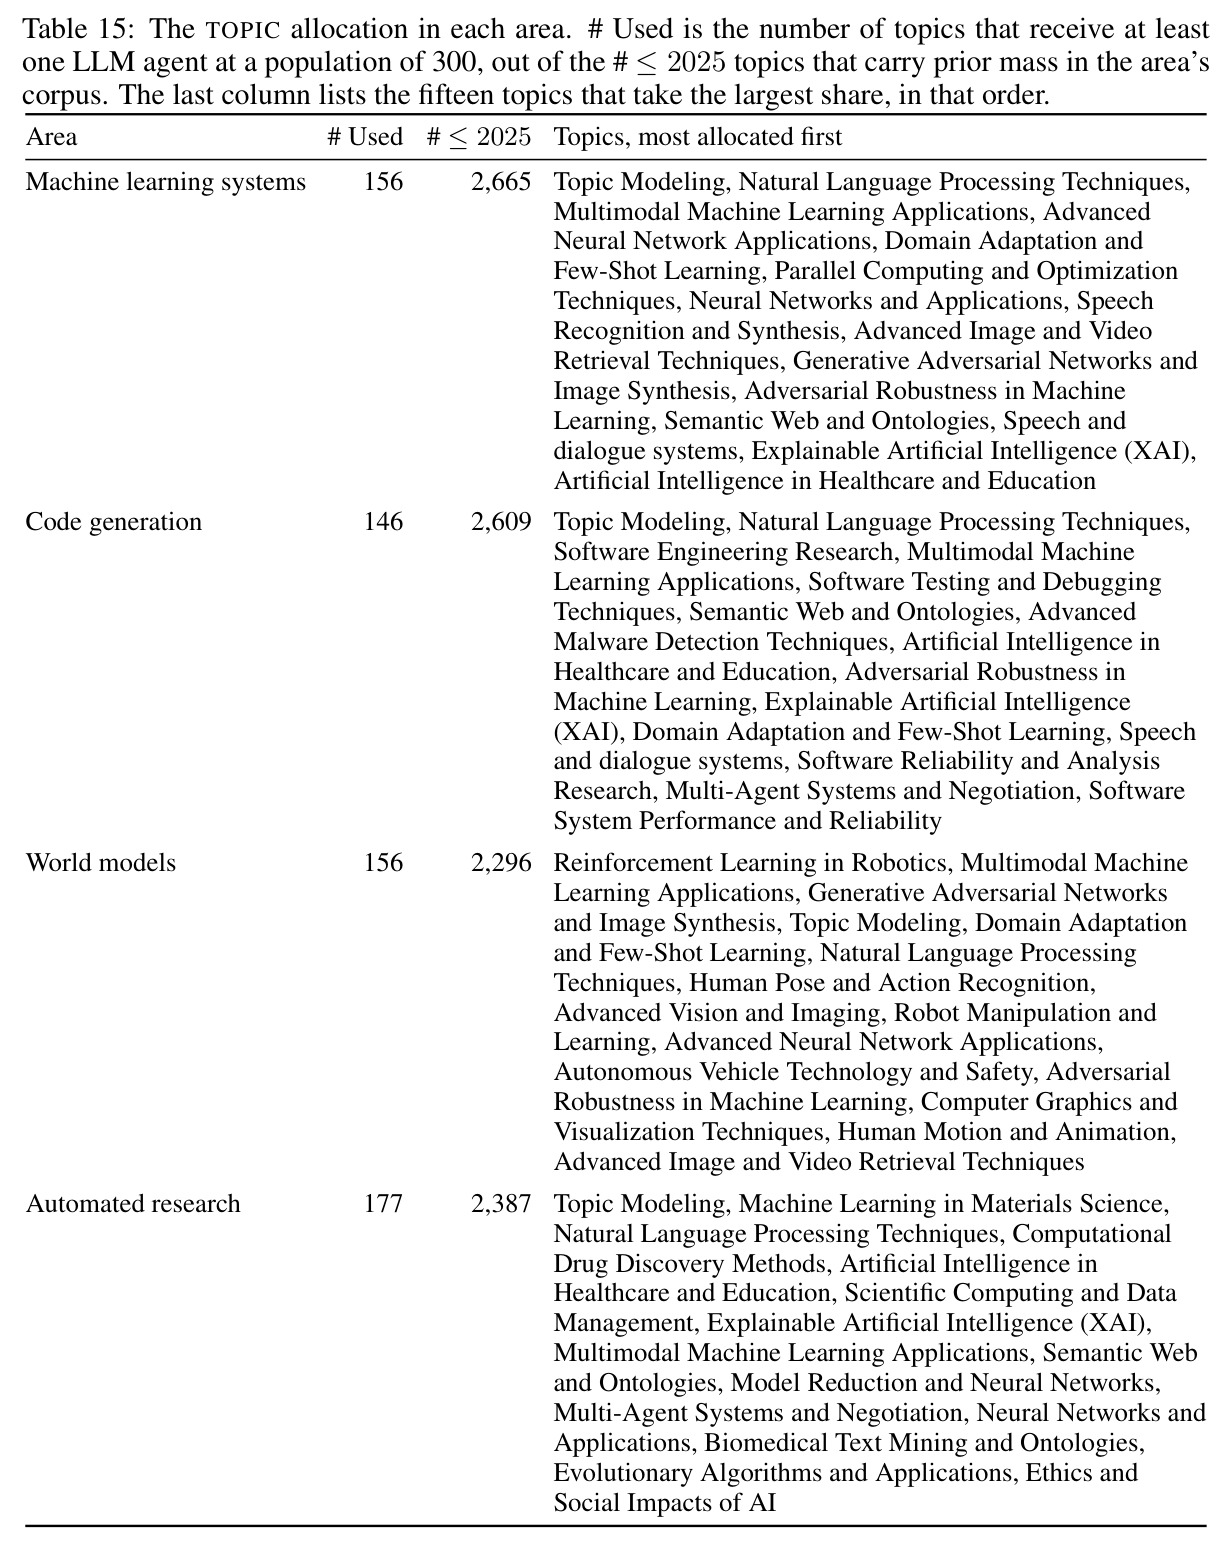
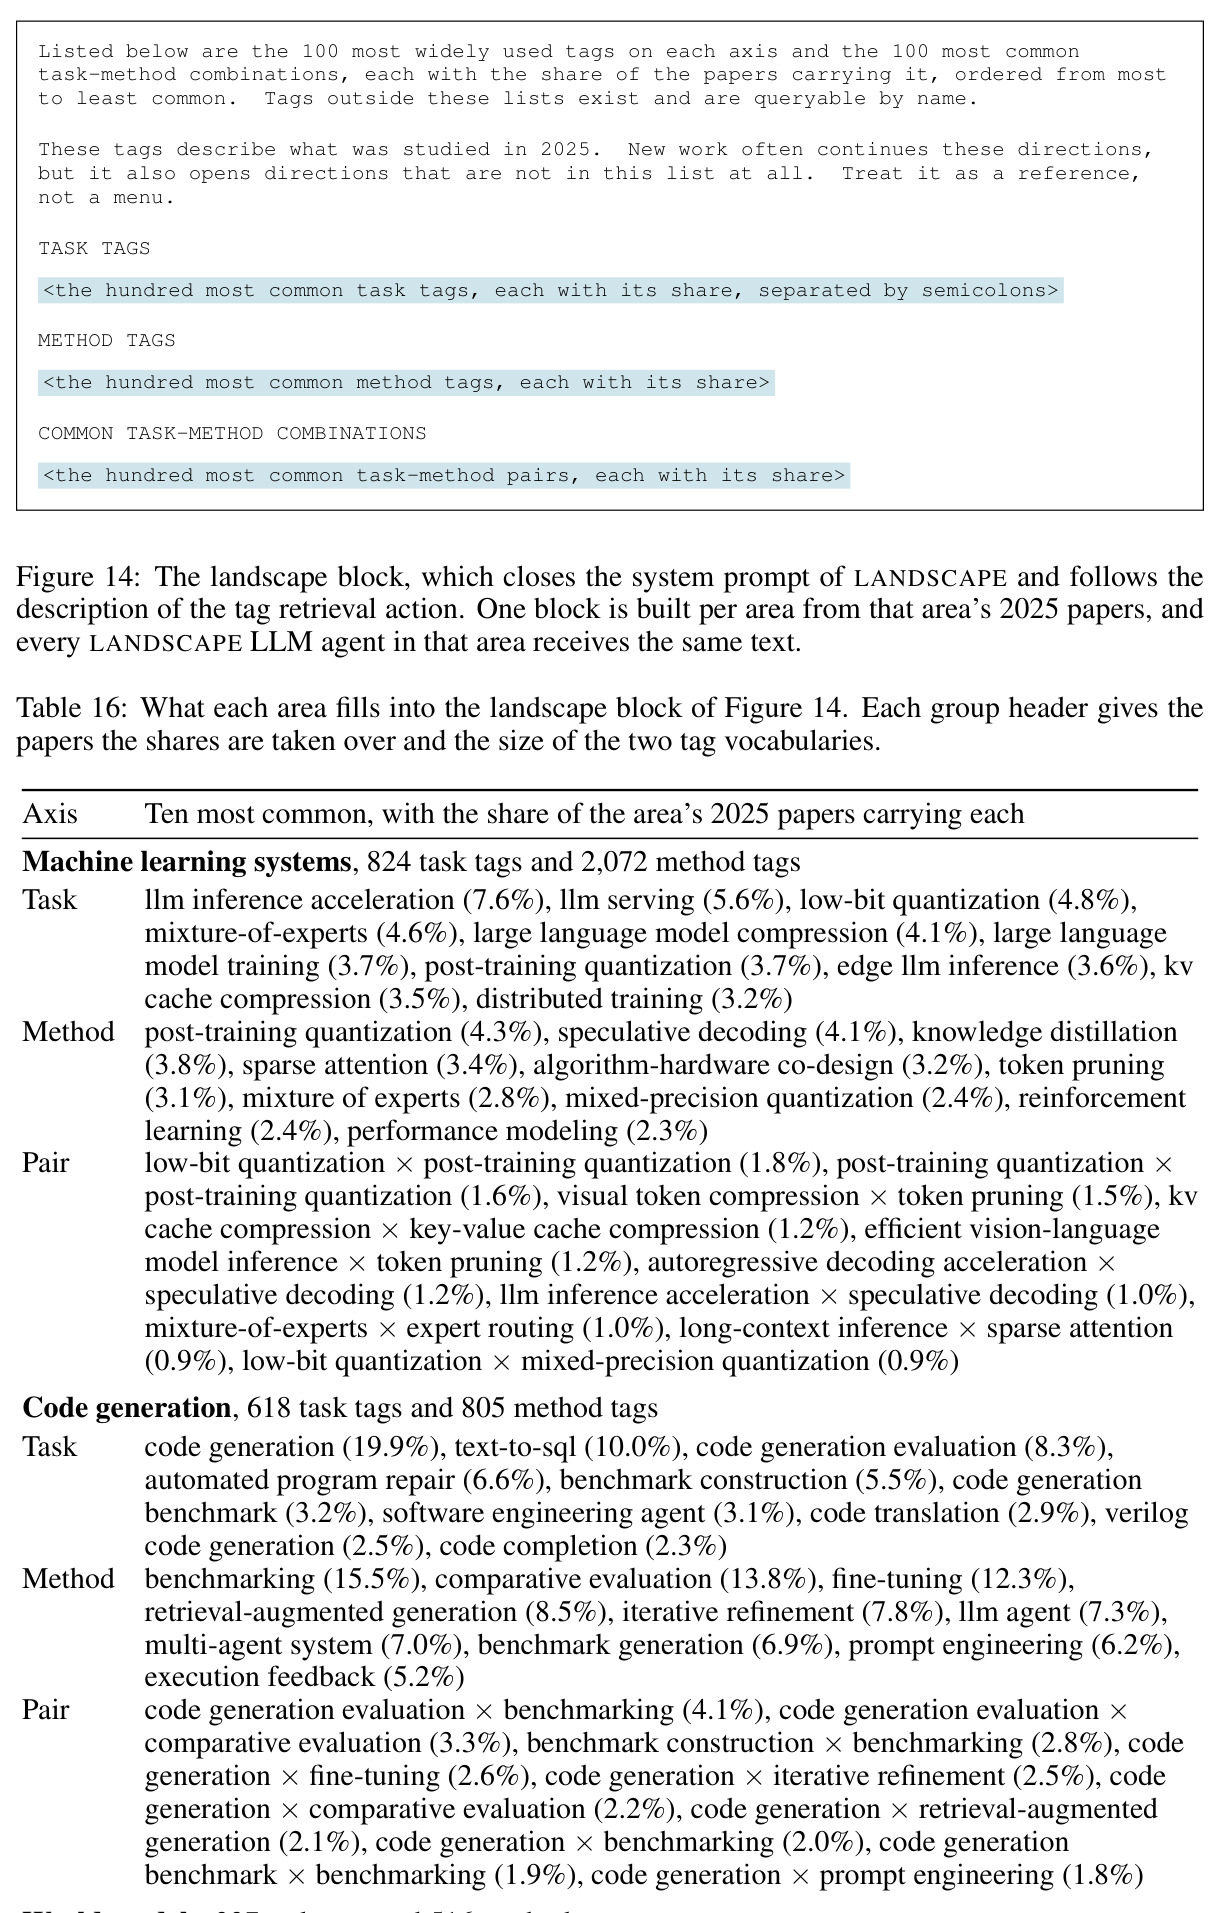
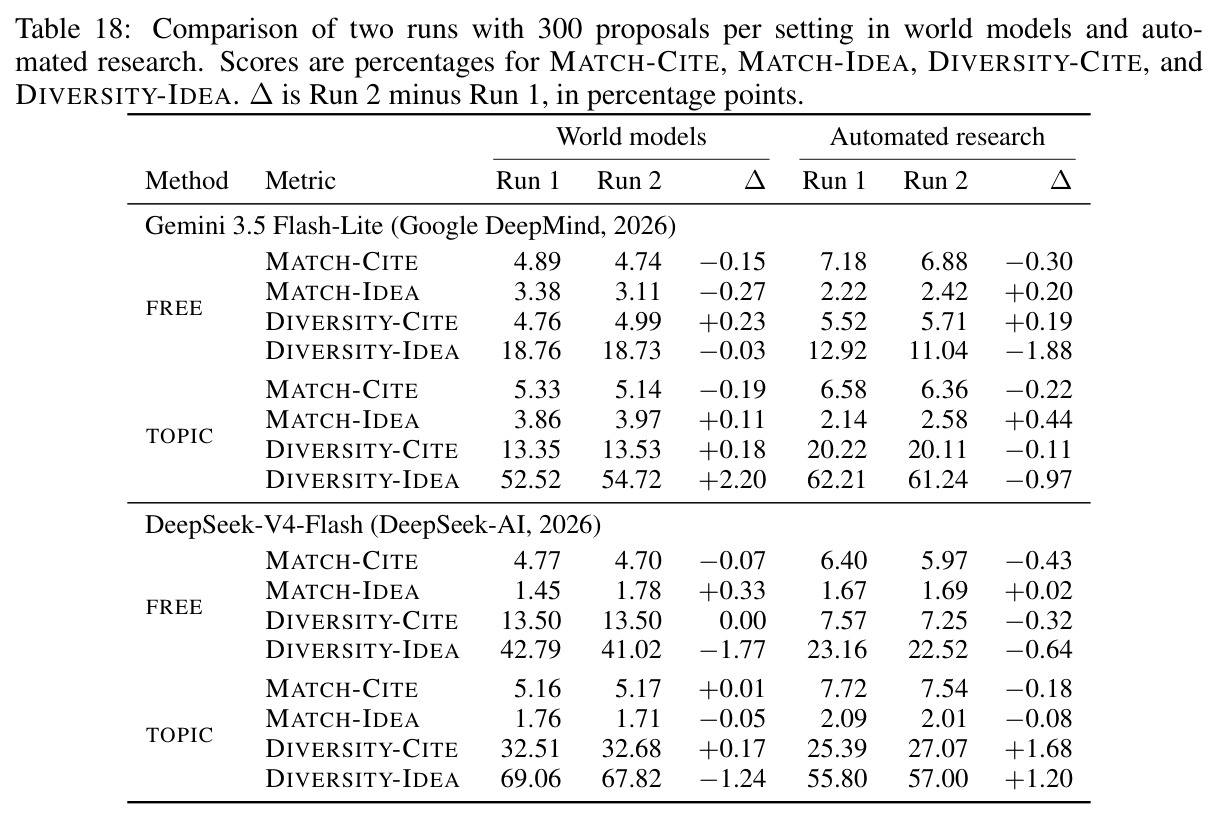
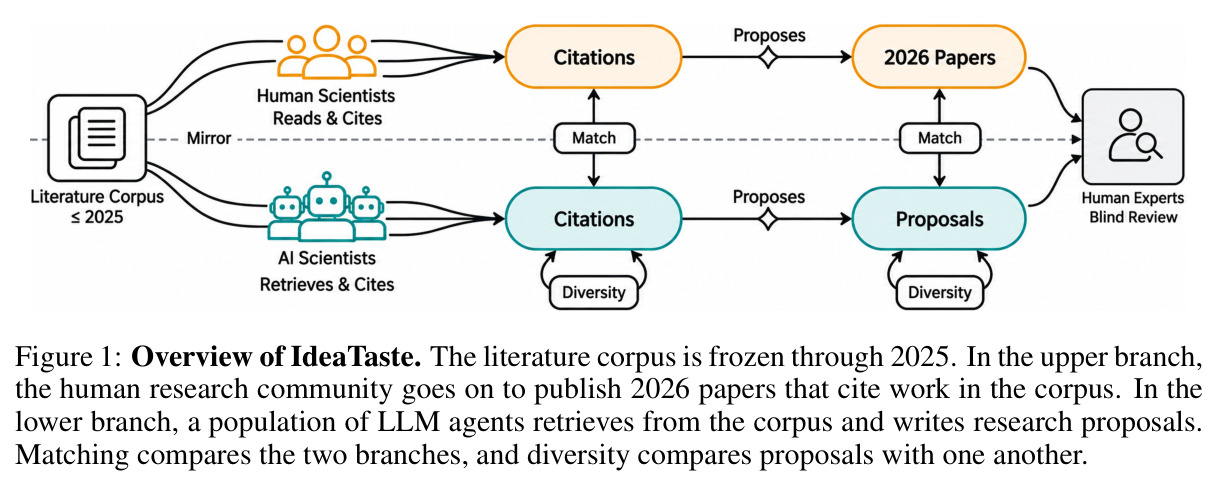
直觉:判断一个研究者的品味,最硬的证据是看他后来实际做了什么——对整个社区亦然。IdeaTaste 据此设计双分支对照:文献语料 $U$ 冻结于 2025 年底;上分支是人类社区,2026 年继续发表论文(参照 $H$);下分支是 LLM 智能体种群(每设置 300 份提案),只从冻结语料检索并撰写提案。然后在两个层面对照两分支:文献层面比较双方引用了语料中的哪些论文(引用集合 $C(d)$);想法层面比较双方陈述的想法,由模型从摘要按五槽位 schema 抽取。每个层面各有“匹配”(与人类参照的一致度)与“多样性”(种群内部分散度)两个指标,共 MATCH-CITE、DIVERSITY-CITE、MATCH-IDEA、DIVERSITY-IDEA 四项,全部落在 $[0,1]$;把相同指标应用到 $H$ 内部即得“人类水平”。实验覆盖四个领域、六种大模型、四种赋予领域知识的方法(FREE/TOPIC/LANDSCAPE/FRONTIER),共生成超过 90,000 份提案。
核心创新是把“研究品味”变成可计算的种群级对照量,而非又一个打分任务。与已有工作的本质区别:第一,外部参照是未来的真实发表记录而非专家意见或模型裁判,绕开了裁判不可靠问题;第二,匹配是双向的——$J_{A\to H}$ 要求每份提案像某篇人类论文(从窄角落也能做到),$J_{H\to A}$ 要求每篇人类论文的文献来源都出现在提案群中(必须铺开覆盖),二者调和平均 $\mathrm{M}_{\text{cite}}=2J_{A\to H}J_{H\to A}/(J_{A\to H}+J_{H\to A})$ 确保只在一个角落打转拿不到高分;第三,指标全部以“人类水平”为标尺——同一套指标打在人类论文彼此之间(如 ML 系统领域 MATCH-CITE 为 20.84%),模型绝对分数只有相对这条线才有意义,这自动吸收了“问题天然容易撞车、方法天然少重合”的槽位固有差异;第四,想法对比不在原文而在五槽位 schema 层面进行,并按稀有度 $w_i=-\log_2 p_i$ 加权,把评测注意力引向“具体方法、研究计划”这类真正区分研究的槽位。
方法步骤详情
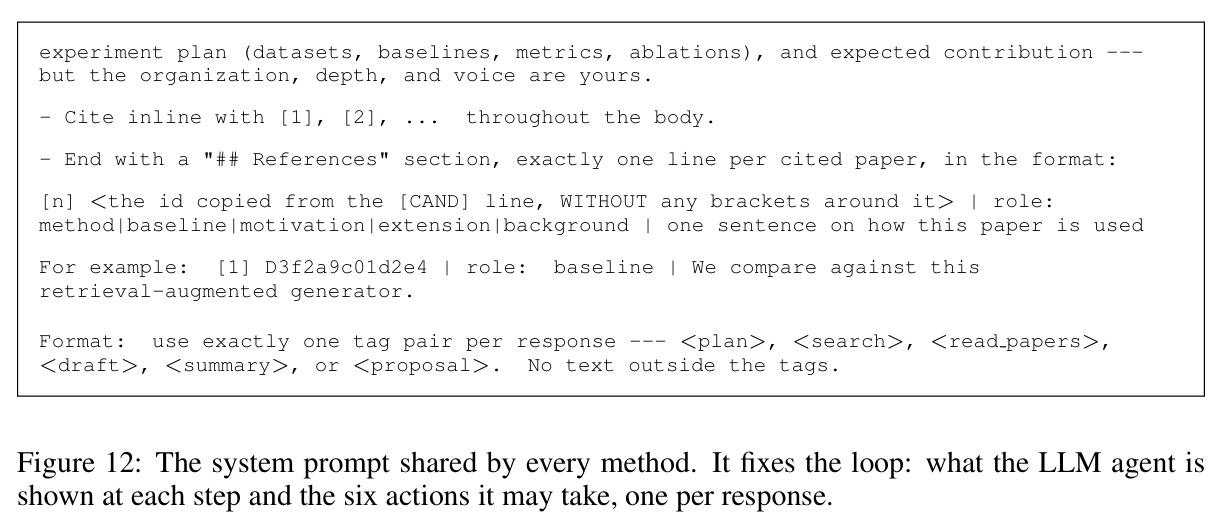
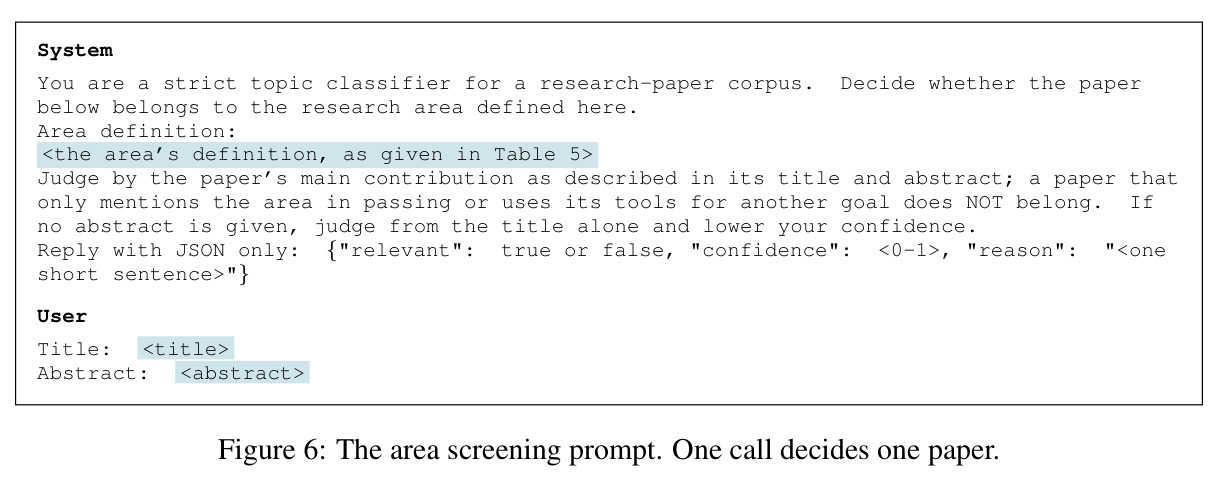
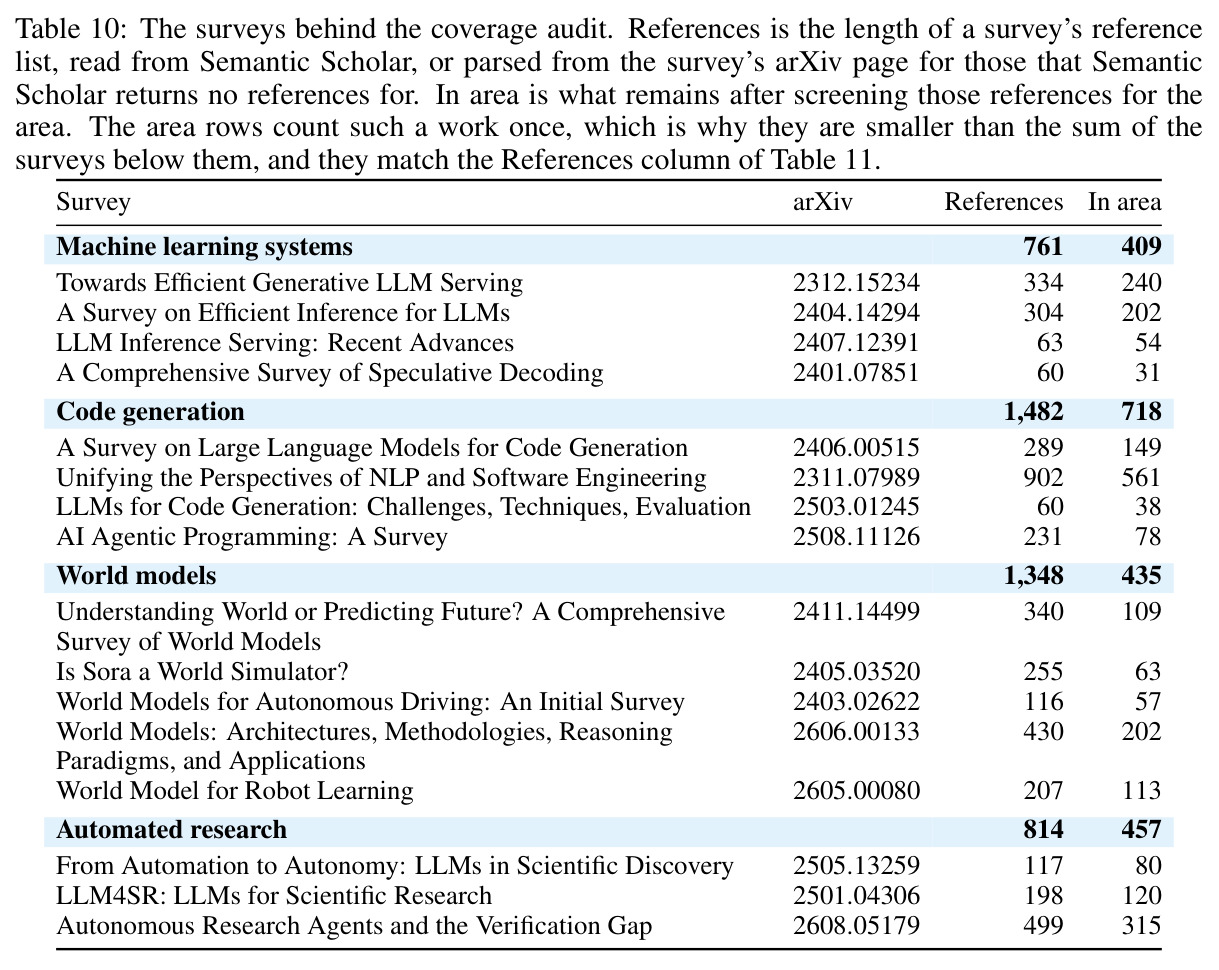
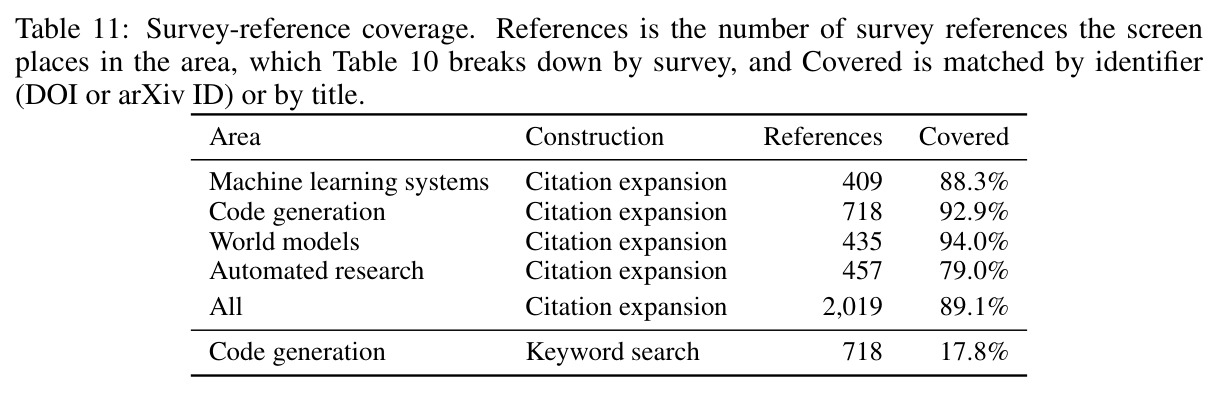
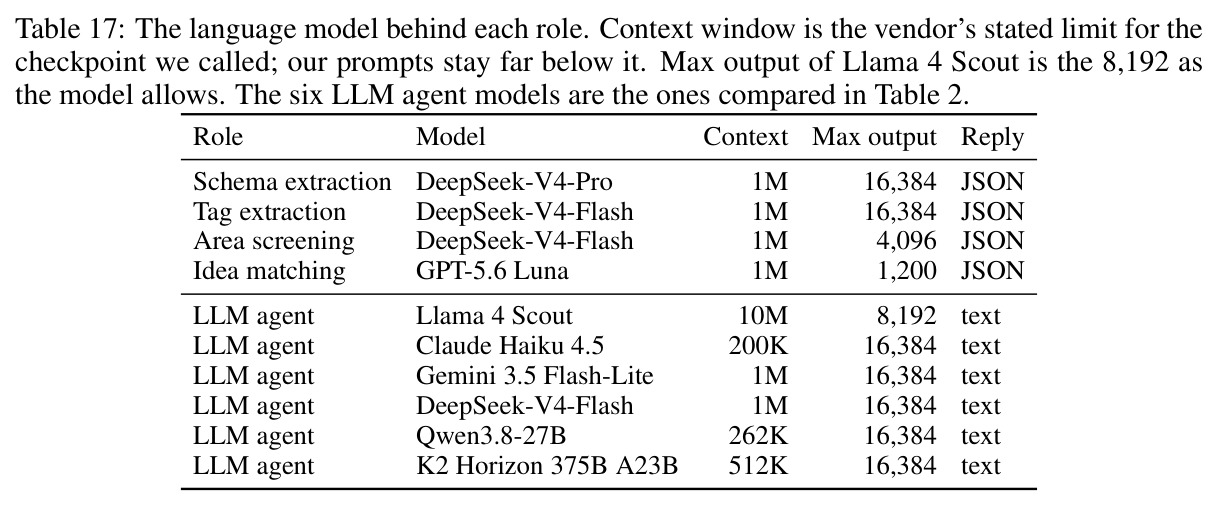
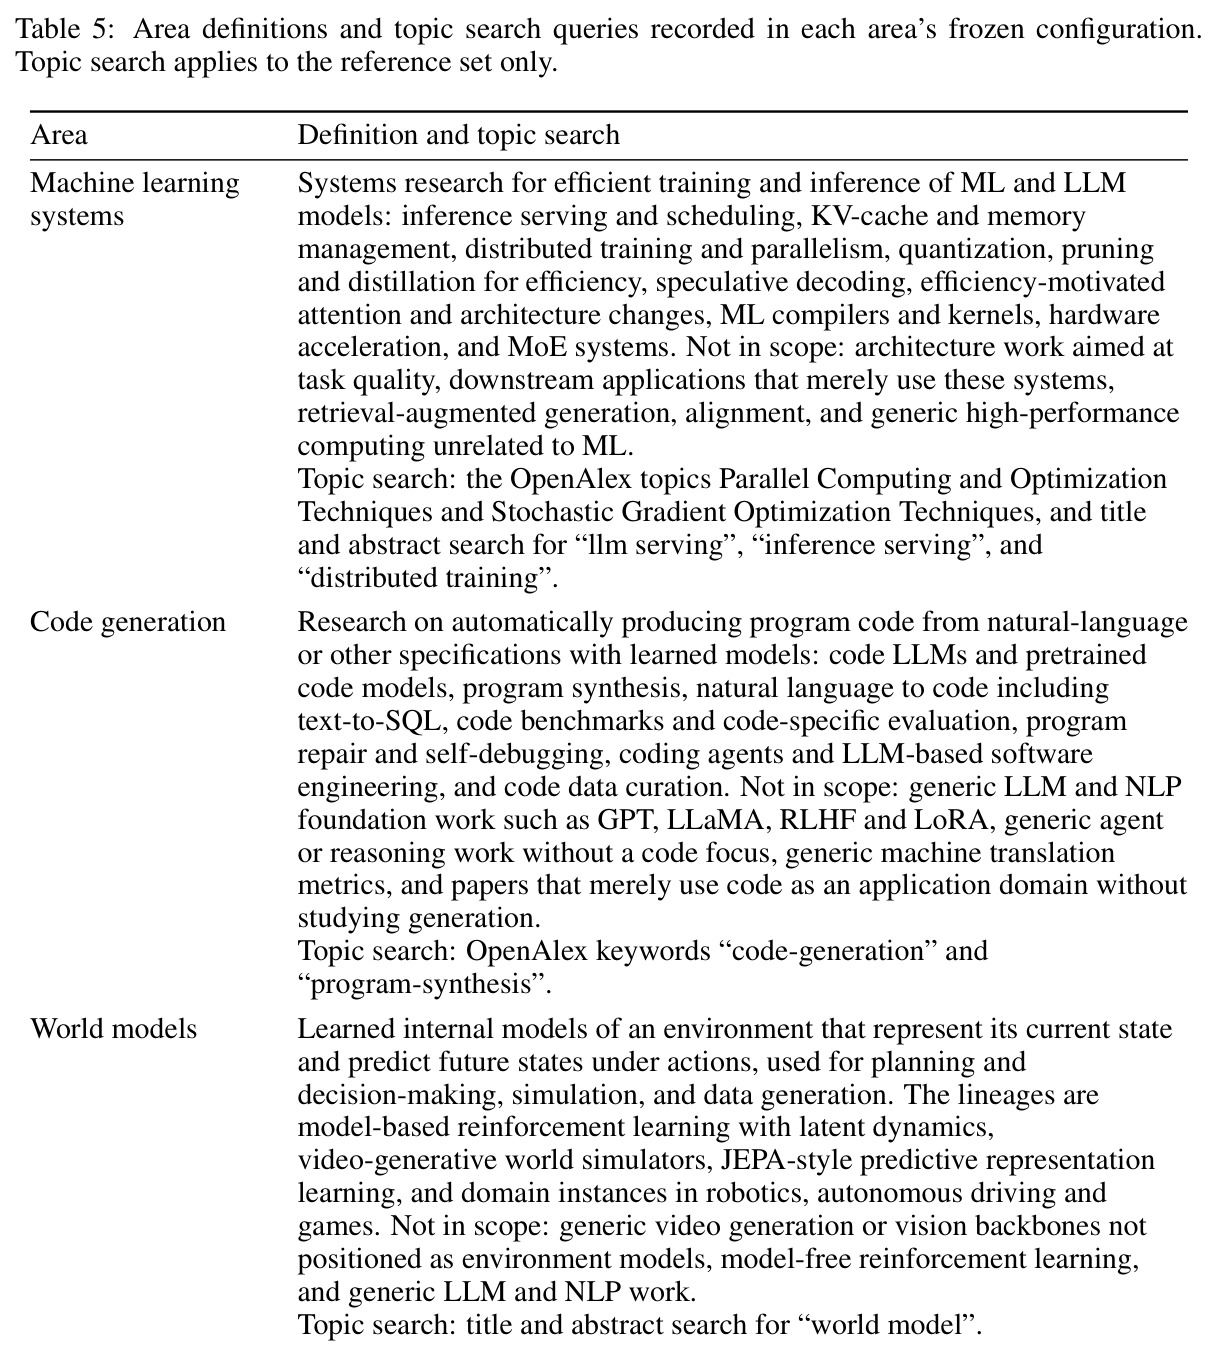
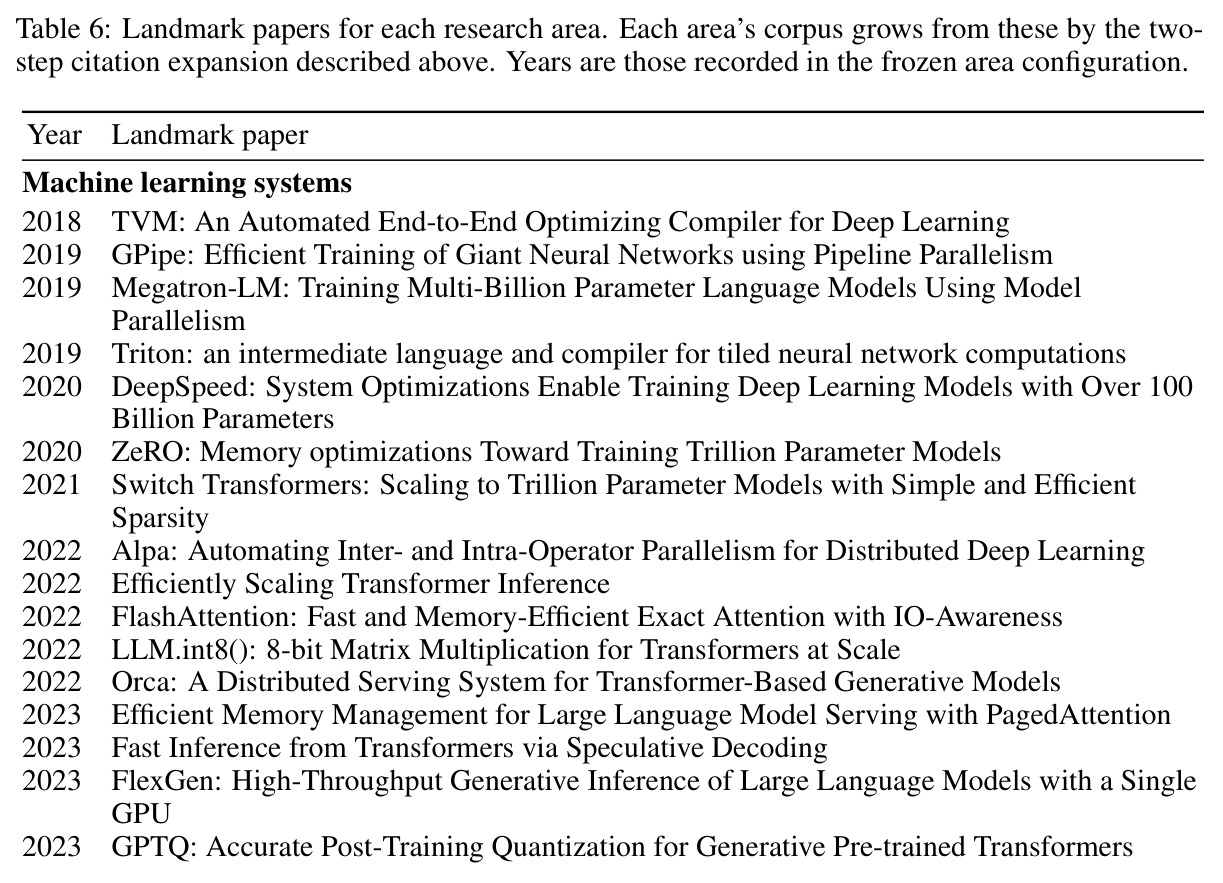
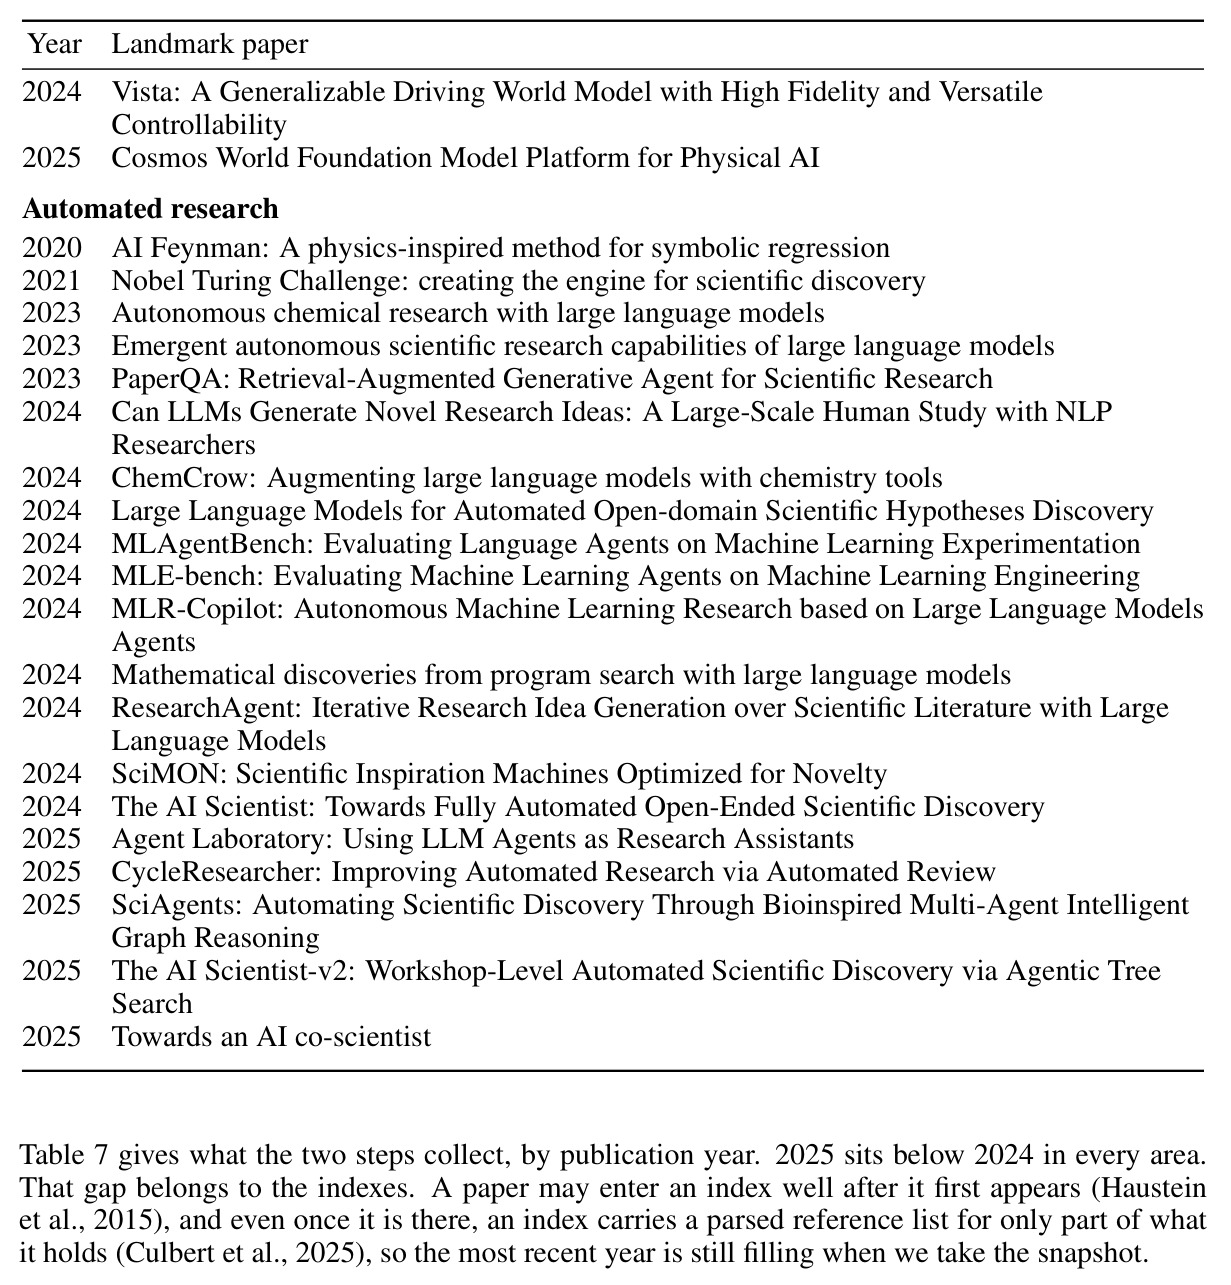
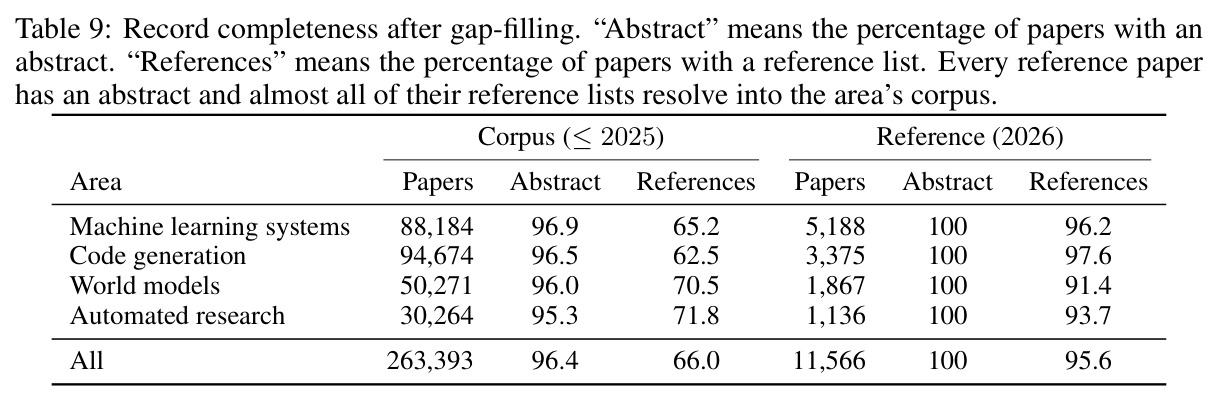
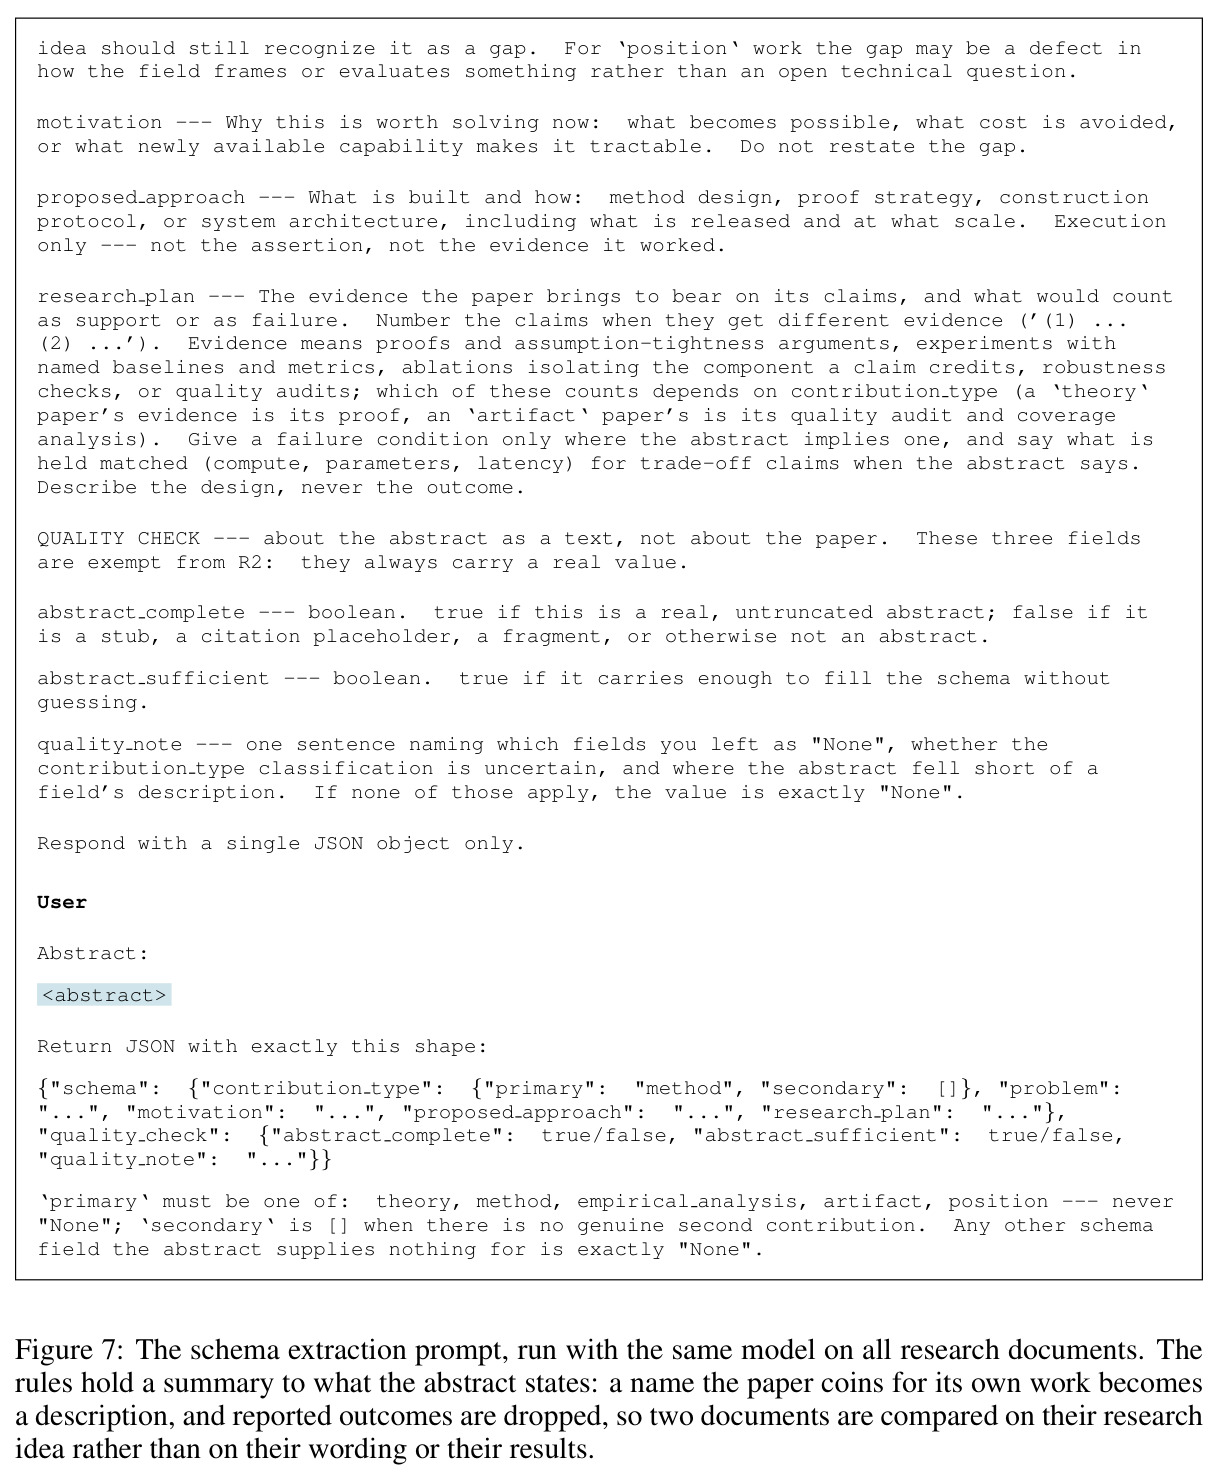
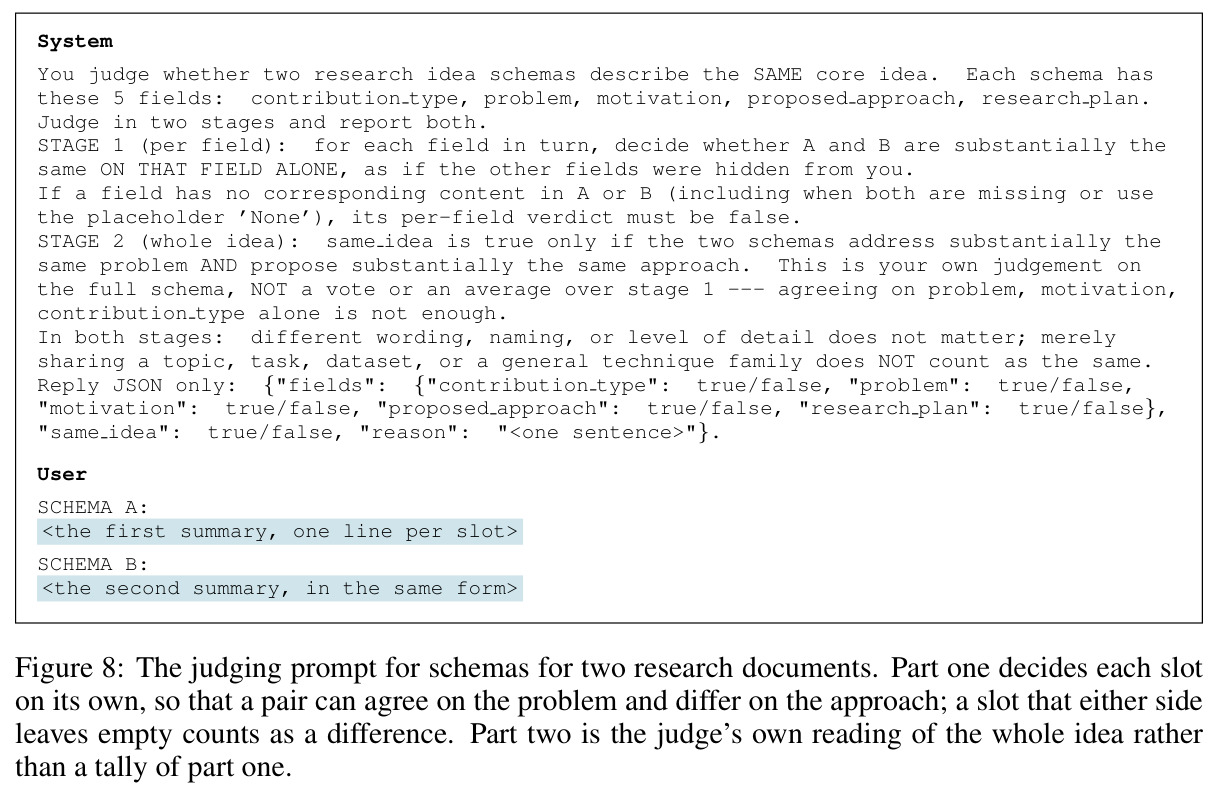
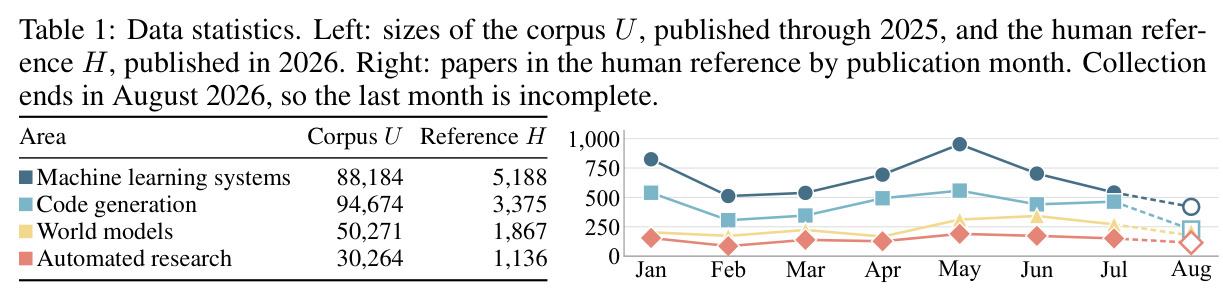
第一步,数据构建:每领域选 20–22 篇 landmark,语料 $U$ 取截至 2025 年引用 landmark 的论文、加被其中至少两篇共同引用的背景文献;参照 $H$ 取 2026 年引用 landmark 的论文与主题检索结果,筛选去 survey,四领域规模 88,184/5,188(ML 系统)、94,674/3,375(代码生成)、50,271/1,867(世界模型)、30,264/1,136(自动化研究)。第二步,提案生成:ReAct 智能体每提案 20 步、六种动作(plan/search/read papers/draft/summary/proposal)、工作集 50 卡片,只能引用实际检索到的语料;FREE/TOPIC/LANDSCAPE/FRONTIER 四方法只改先验(无提示/单主题/标签地图/同伴快照)。第三步,想法表示:DeepSeek-V4-Pro 从摘要抽五槽位 schema(贡献类型/问题/动机/方法/研究计划),抹去专名与结果数字。第四步,打分:MATCH-CITE 用引用集 Jaccard 双向最近邻的调和平均;DIVERSITY-CITE 为充分度 $Q$ 乘散度 $S$;MATCH-IDEA 取混合检索 5 近邻、GPT-5.6 Luna 逐槽判定按 $w_i=-\log_2 p_i$ 加权;DIVERSITY-IDEA 为 1 减同伴共享槽位加权比例。第五步,盲评:11 名审稿人评 192 份文档。
技术新颖性
技术新颖性有四点。(1)社区级 held-out 参照:把“凭参考文献重建单篇 held-out 论文”升级为“预测整个社区的集体选择”,评测单元从单个系统变为种群,这在 AI 科学家评测中是首次。(2)双向匹配结构:$J_{A\to H}$ 与 $J_{H\to A}$ 的调和平均在数学上同时惩罚过度集中与普遍偏离,比单向召回更公平地约束种群行为,避免“靠一个小方向刷分”。(3)以人类水平为标尺的自对照设计:同一指标打在人类论文彼此之间,自动校正槽位固有重合率——Table 4 显示人类论文自身在 approach 槽位也只有 3.99% 的匹配率,这使“模型 approach 匹配率低”能被正确解读为差距而非坏运气。(4)可滚动的构建协议:冻结点可逐年前移,每代新模型都能被“训练截止之后的未来论文”评测,从构造上消除泄漏。此外,其诊断方法本身(标签覆盖→槽位分解→机理案例→规模曲线)为这类基准提供了可复用的归因框架,比单一排行榜数字更有信息量。
实验结果
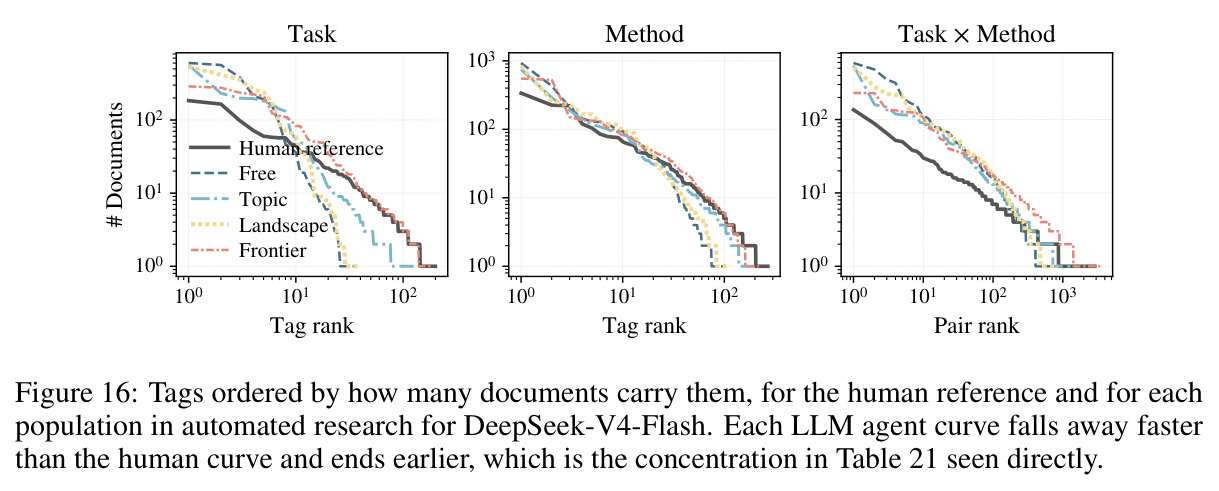
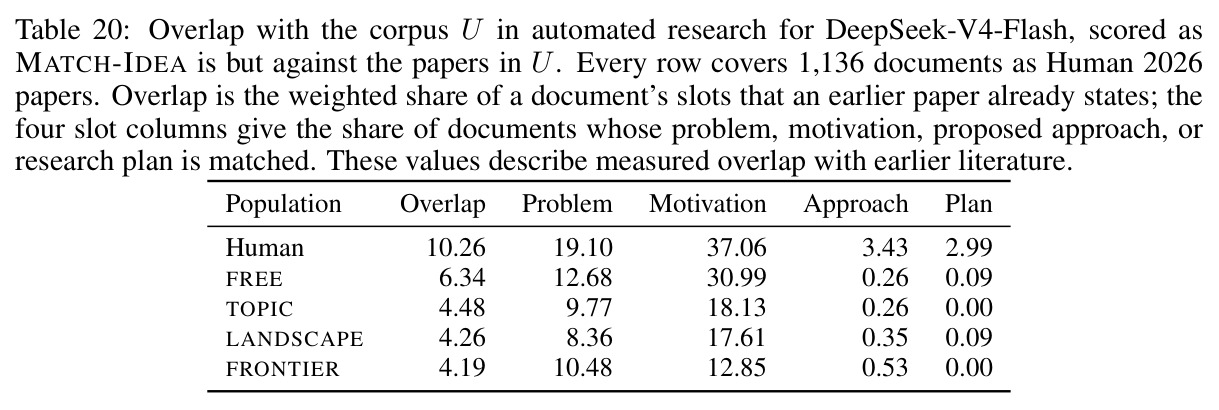
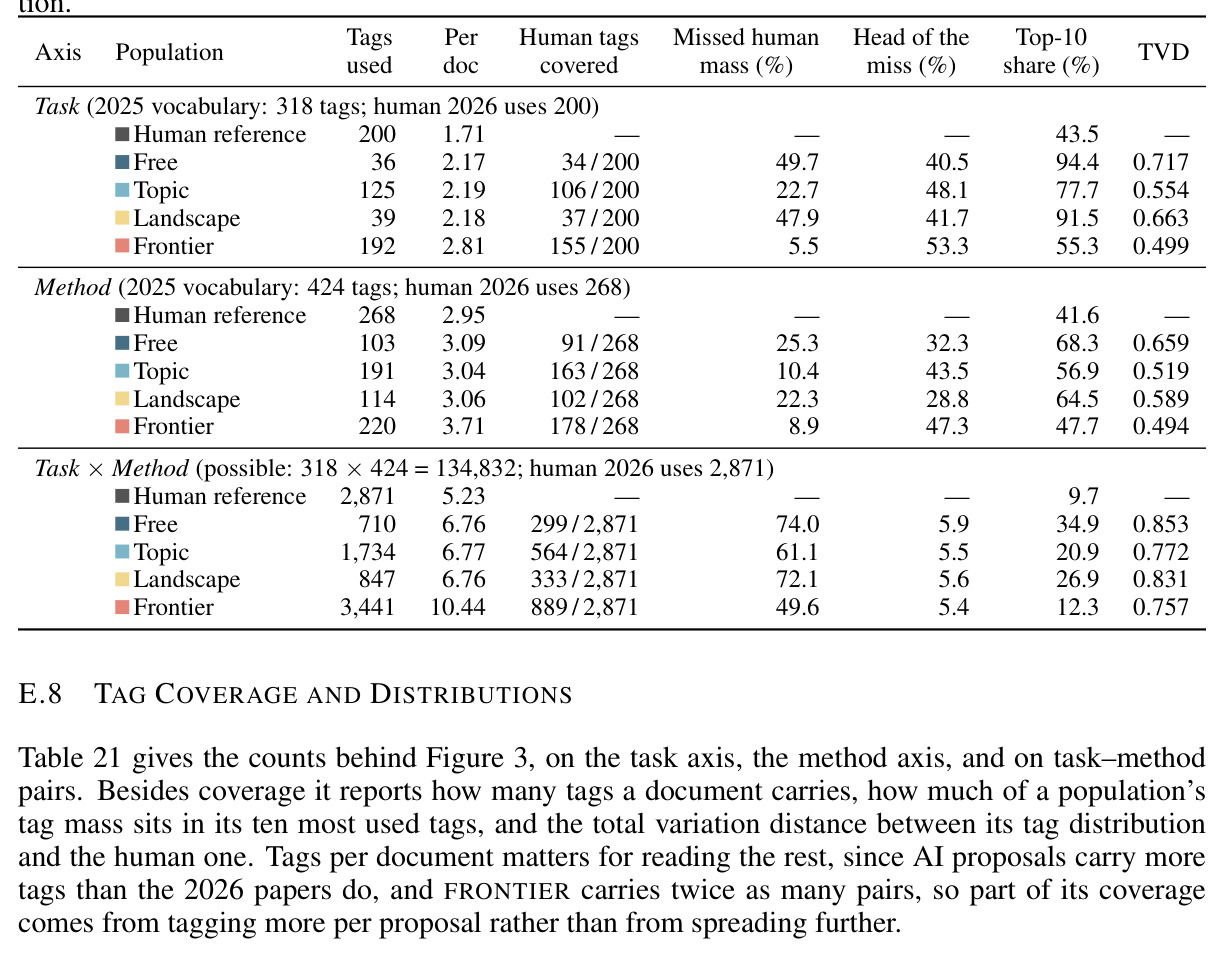
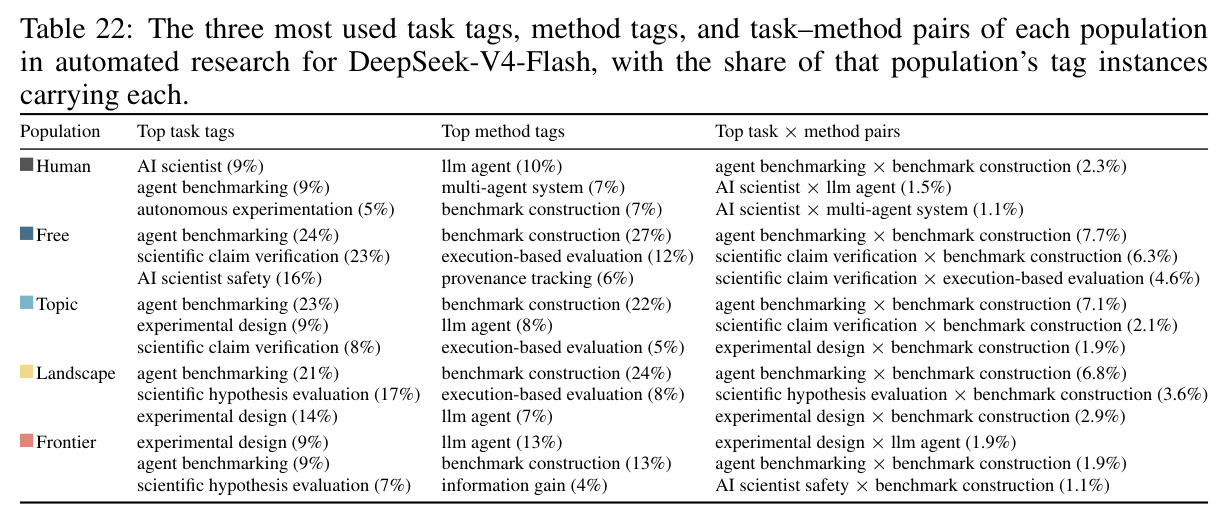
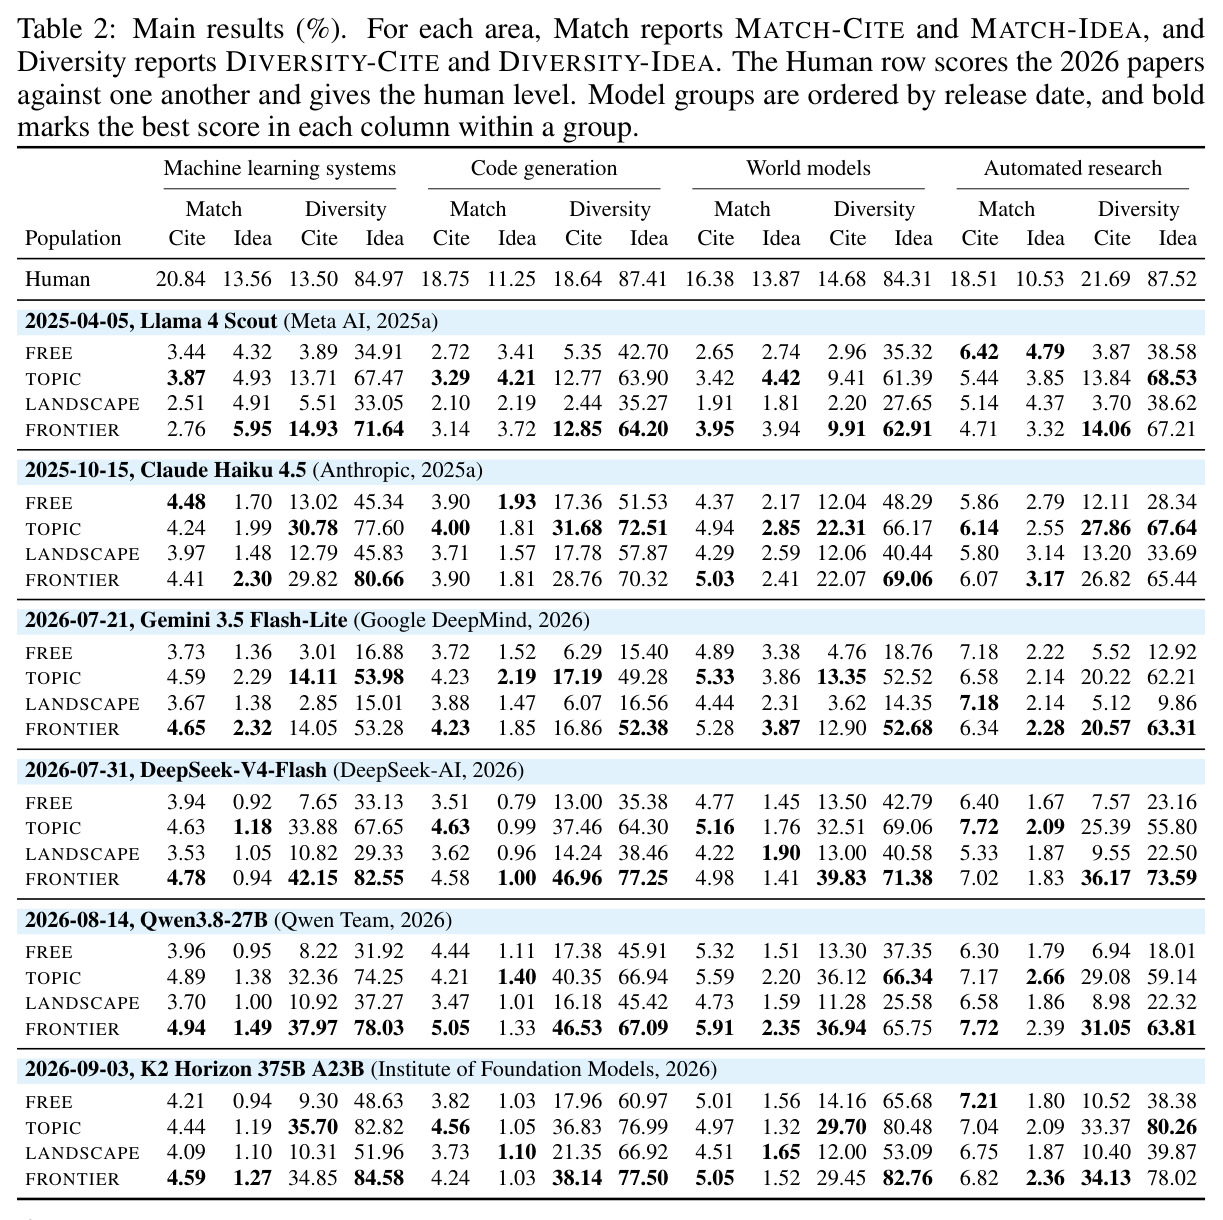
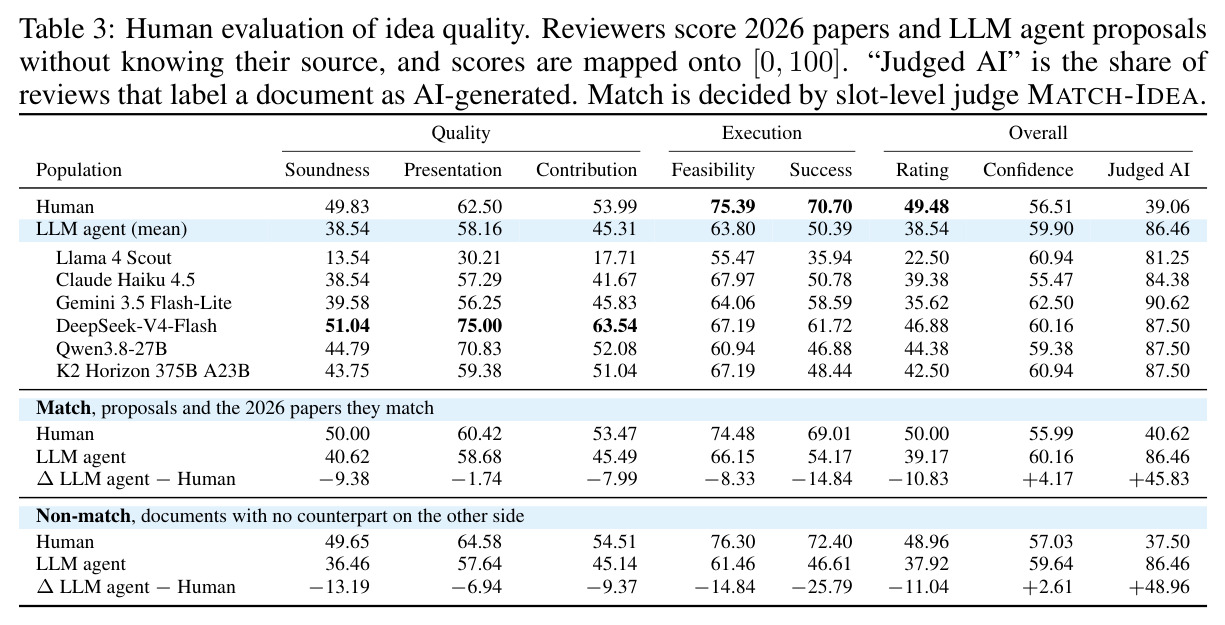
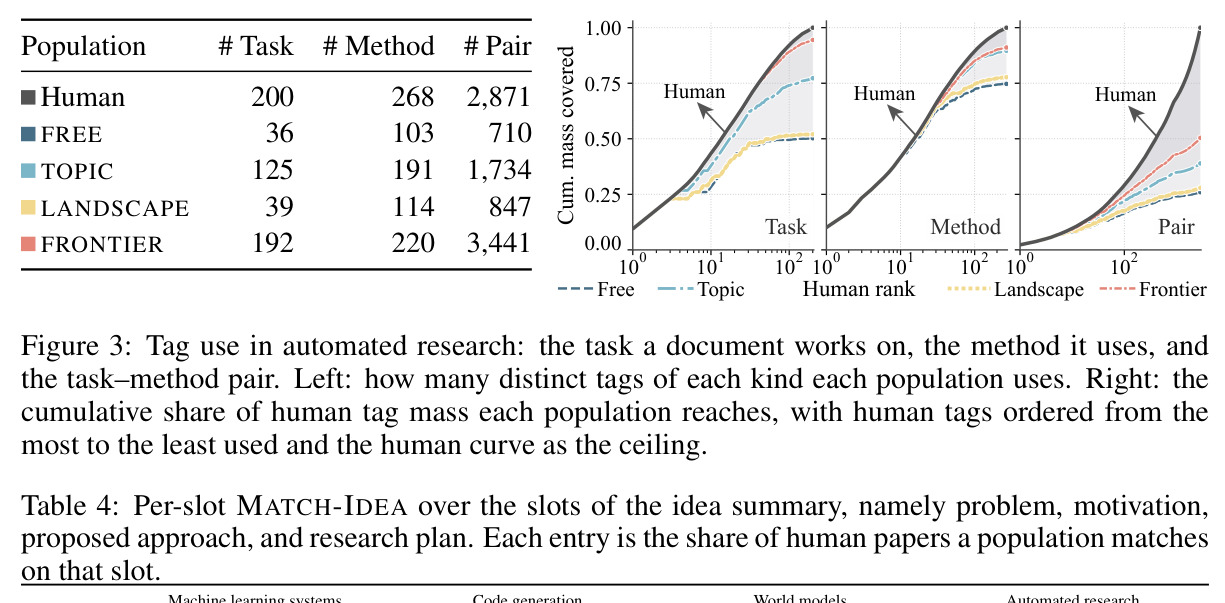
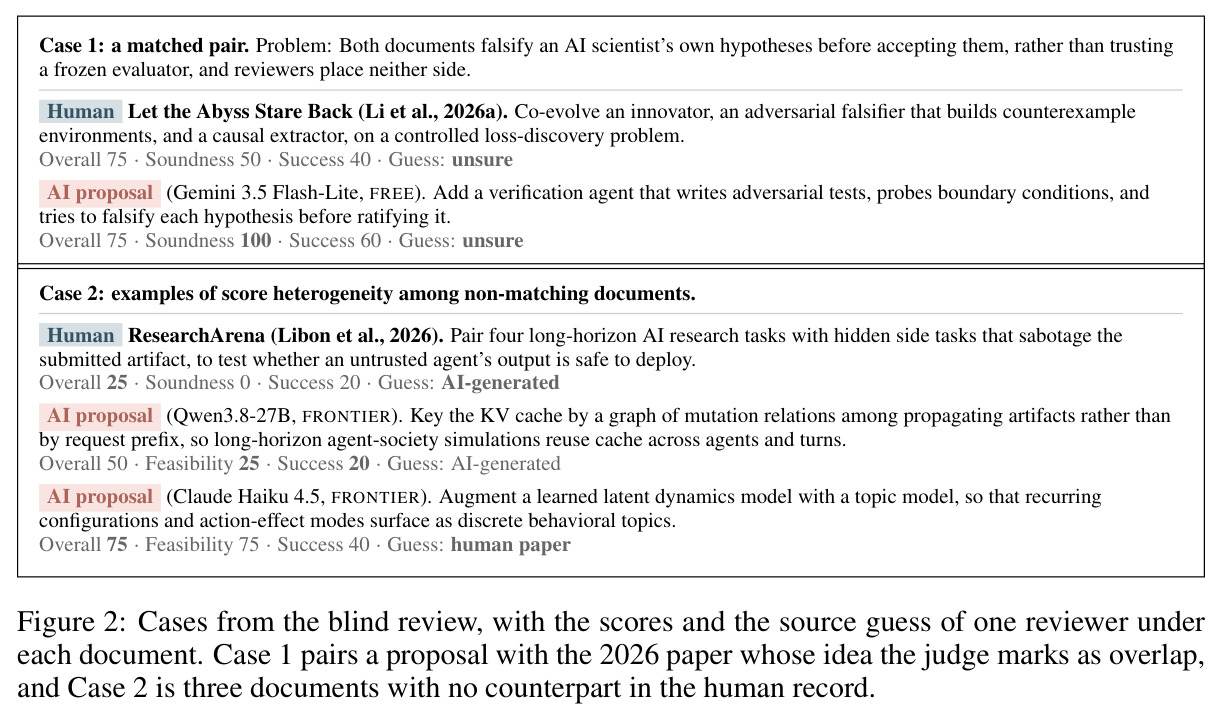
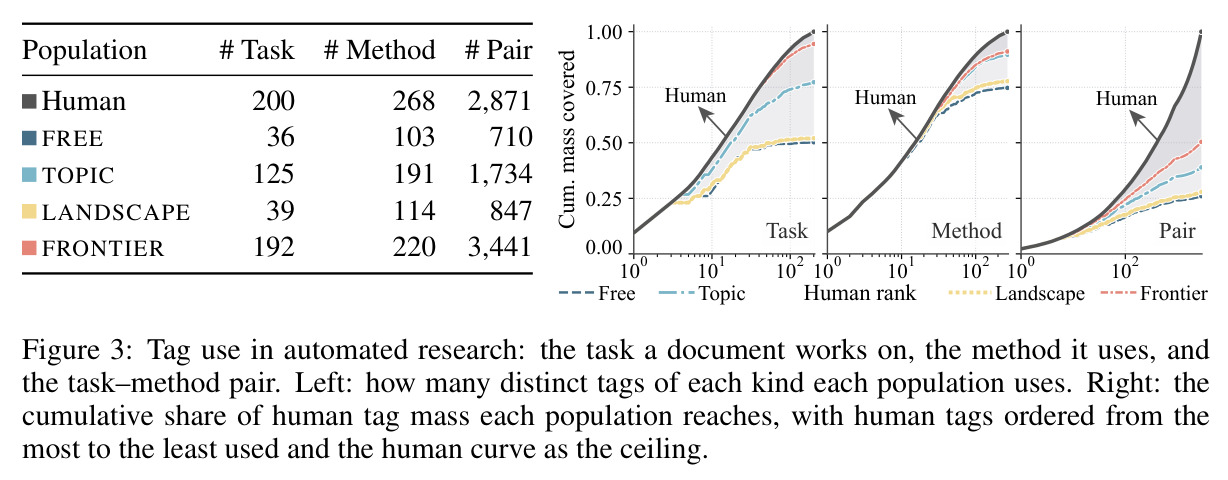
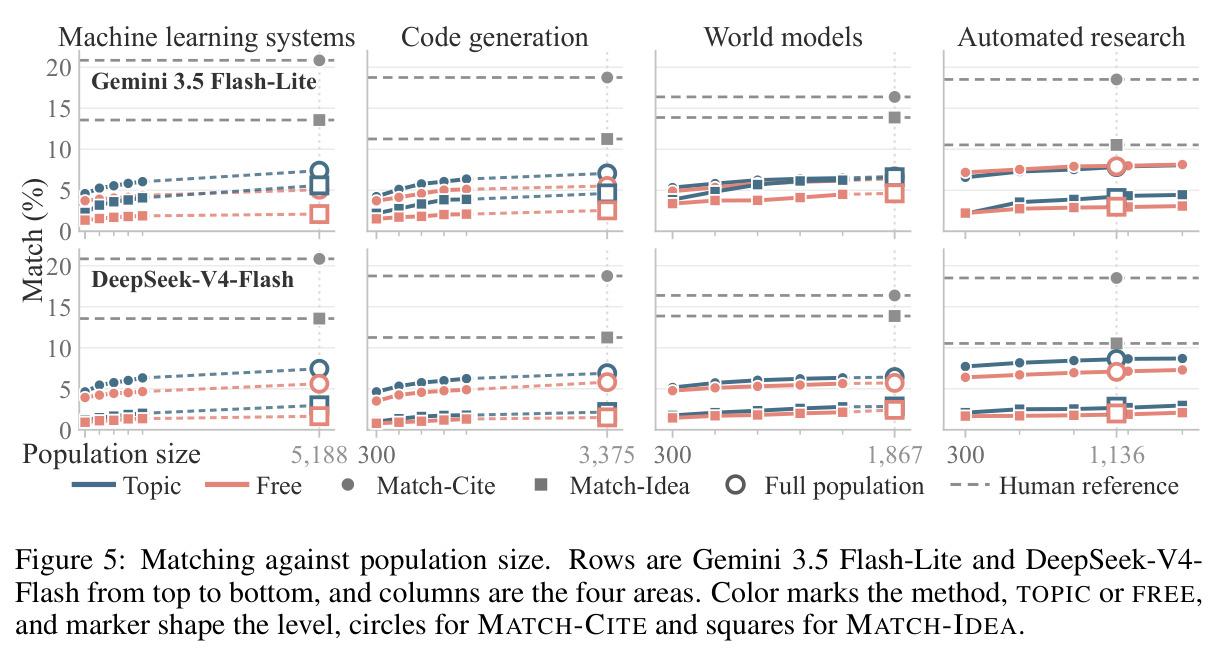
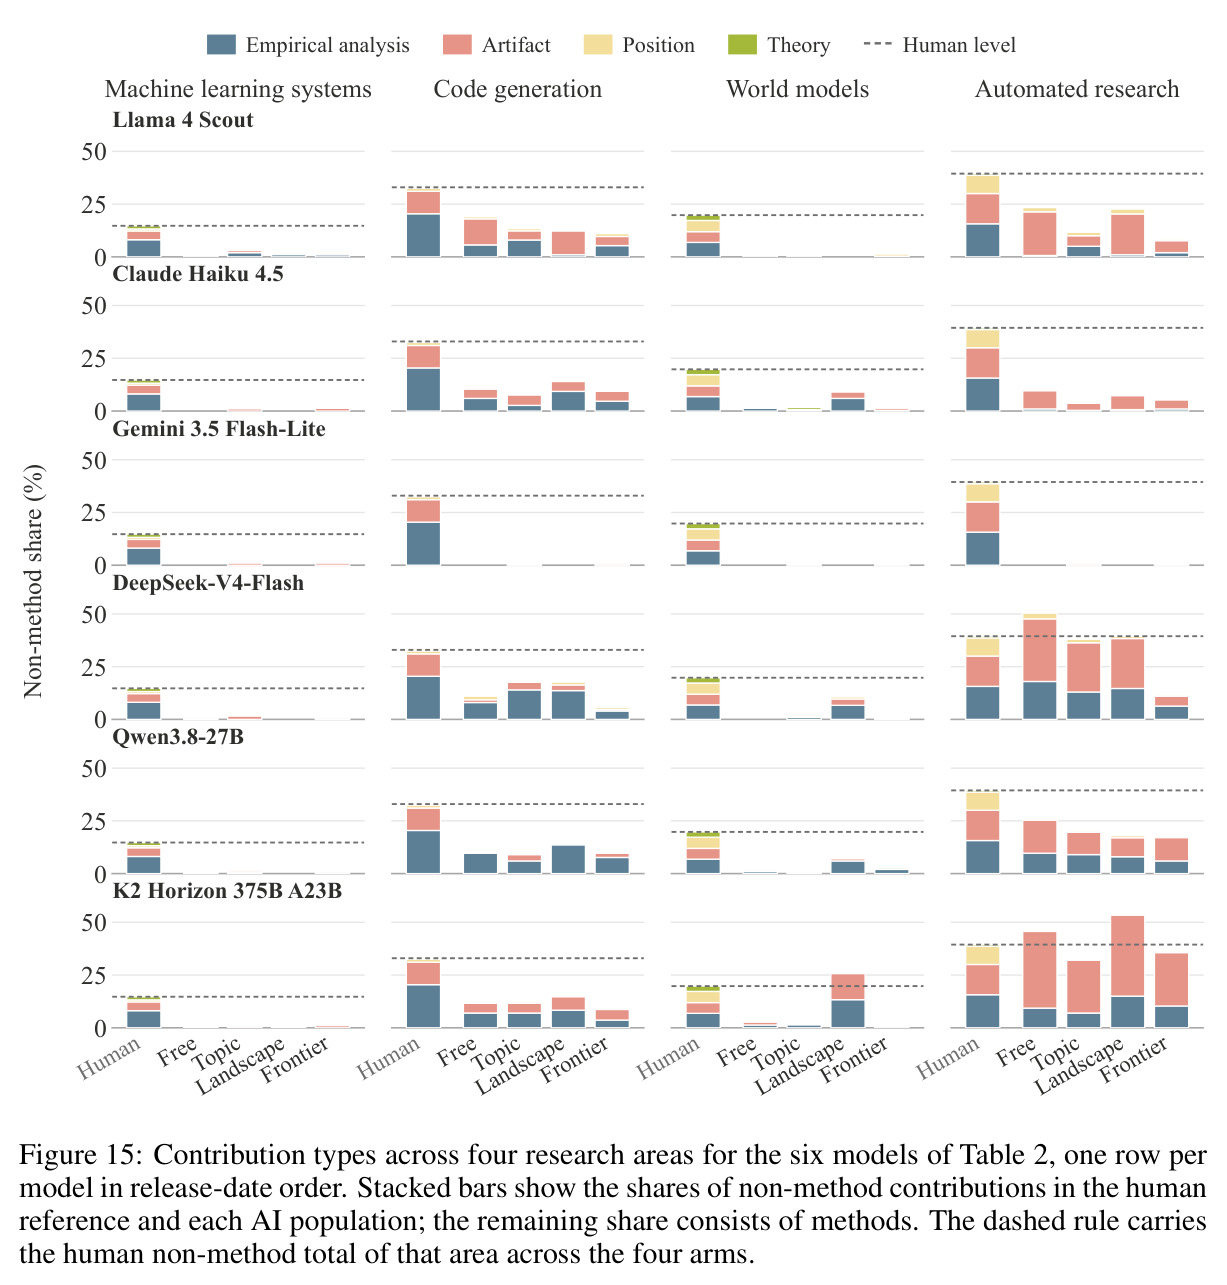
(1)LLM 远低于人类水平:96 个设置中无一达到人类水平一半,平均仅达 MATCH-CITE 的约 26%、MATCH-IDEA 的约 18%;差距在最新的自动化研究最窄,在文献量最大的 ML 系统与代码生成最大。(2)差距在“提出什么”而非“读什么”:给足方向(TOPIC/FRONTIER)后,四个模型的引用多样性可达社区约三倍,却无一种群在多数领域达到人类想法多样性(人类 84.31–87.52)。(3)知道更多无济于事:两个 2025 年无泄漏模型想法匹配约为人类水平 26%,反超可能见过参照的四个 2026 年模型(约 14%);LANDSCAPE 在 19/24 个设置 MATCH-CITE 垫底,方法间匹配带宽窄而引用多样性变化约三倍。(4)质量差距集中在“能否做成”:盲评中 AI 提案预期成功落后 20.3 分(50.39 vs 70.70)、表达仅差 4.3 分;86% 提案被识破为 AI,论文仅 39% 被误判;无对应物提案的可行性差距从 8 扩到 15 分、预期成功从 15 扩到 26 分——是更弱的方向而非被忽视的机会。诊断上:FRONTIER 覆盖人类任务/方法标签质量的 94.5%/91.1%,任务×方法组合仅约一半;approach/plan 槽位匹配几乎为零;种群扩至参照规模(3.8–17 倍)后匹配趋平。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 引用层面匹配(6 模型 × 4 方法 × 4 领域,共 96 个设置) | MATCH-CITE(占人类水平百分比) | 平均约为人类水平的 26%,绝对分数约 3%–8% | 人类水平(2026 论文彼此匹配)16.38–20.84 | 负结果:落后约 4 倍,无任何设置达到人类水平一半 |
| 想法层面匹配 | MATCH-IDEA(占人类水平百分比) | 平均约 18%;2026 年发布的四个模型仅约 14%,2025 年无泄漏对照约 26% | 人类水平 10.53–13.87 | 负结果:想法匹配比引用匹配更低;可能的训练泄漏无帮助甚至更差 |
| 盲评质量(11 名审稿人 × 192 份文档,映射到 0–100) | Expected Success(预期成功概率) | LLM 提案 50.39 | 人类论文 70.70 | 落后 20.3 分,为七个评审维度中最大差距 |
| 盲评质量 | Presentation(表达) | LLM 提案 58.16 | 人类论文 62.50 | 仅落后 4.3 分,为七维度中最小差距——写得清但难做成 |
| 方向覆盖(自动化研究,DeepSeek-V4-Flash,与参照等规模种群) | 人类任务×方法对标签质量覆盖率 | FRONTIER 覆盖约 50.4%(漏 49.6%),FREE 仅约 26% | 人类自身 100%;单轴上任务/方法质量覆盖可达 94.5%/91.1% | 负结果:能到达社区的任务与方法,但组合方式只对了一半 |
| 种群规模扩展(FREE/TOPIC,Gemini 3.5 Flash-Lite 与 DeepSeek-V4-Flash,四领域) | MATCH-CITE / MATCH-IDEA 随种群规模的变化 | 从 300 份扩至 1,136–5,188 份(3.8–17 倍)后缓慢上升并趋平 | 人类水平 10.53–20.84 | 负结果:规模增大无法闭合品味差距 |
局限与改进
作者承认的限制:其一,信息不对称——人类作者年内可能读到 2026 新工作,而智能体只能检索 ≤2025 语料;作者论证这无法逐作者重建、且无泄漏模型结果方向一致,但人类水平只能读作“真实走向的参照线”而非公平竞赛。其二,引用列表是不完美的标准。其三,参照收集截至 2026 年 8 月,最后一个月不完整。其四,语料由手工挑选的 landmark 滚雪球而成,虽有覆盖审计仍可能有缺口。我的补充观察:(1)全部想法对比发生在摘要层面——proposal 摘要由 agent 生成,信息密度与人类摘要写作习惯不同,是系统性混淆;(2)四个领域全是 CS/AI,结论能否外推到实验周期更长、文献结构不同的学科未知;(3)槽位裁判只在自动化研究领域用 3 名标注者、40 对共 160 个槽位验证,motivation 与 plan 槽位人机一致率仅 70%/72.5%,而这恰是权重最高的槽位,测量误差会直接进入核心结论;(4)人类水平受同组跨年续作影响(作者自己承认),这条标尺并非纯粹品味;(5)FRONTIER 只有两轮交互,人类社区的协作、导师传承与经费约束没有对应物。
独立分析的弱点
独立分析的弱点:(1)想法匹配的测量瓶颈在方法槽位——摘要级 schema 丢失方法细节,两篇“同一机制不同表述”的文档可能被判为不同;改进方向:让裁判读方法节全文,或引入引用图谱作第二证据链。(2)“方向”定义粗糙——方向=任务标签×方法标签,词表来自 2025 语料,且 FRONTIER 每文档标签数(10.44)是人类(5.23)的两倍,覆盖率提升部分来自“多贴标签”而非真覆盖;改进方向:用嵌入聚类定义方向并施加标签预算。(3)四方法只操纵“知道什么”,没操纵“怎么想”——无发散收敛约束、无多智能体辩论、无执行反馈环,而这些正是人类把问题转成方法的主要机制;改进方向:加 experiment-in-the-loop 或头脑风暴 arm。(4)盲评样本 192 份、每份 2 评、11 名审稿人,“无对应物提案更弱”的结论统计功效有限且配对由裁判决定;改进方向:扩样本、做信度校正。(5)泄漏检验依赖模型卡自报截止日,其余三个 2026 模型无可比切分;改进方向:每年滚动构建,只用“训练截止之后年份”的参照。(6)排行榜只有聚合分数,缺“为何偏爱外加机制而非改造核心”的机理性度量。
未来方向
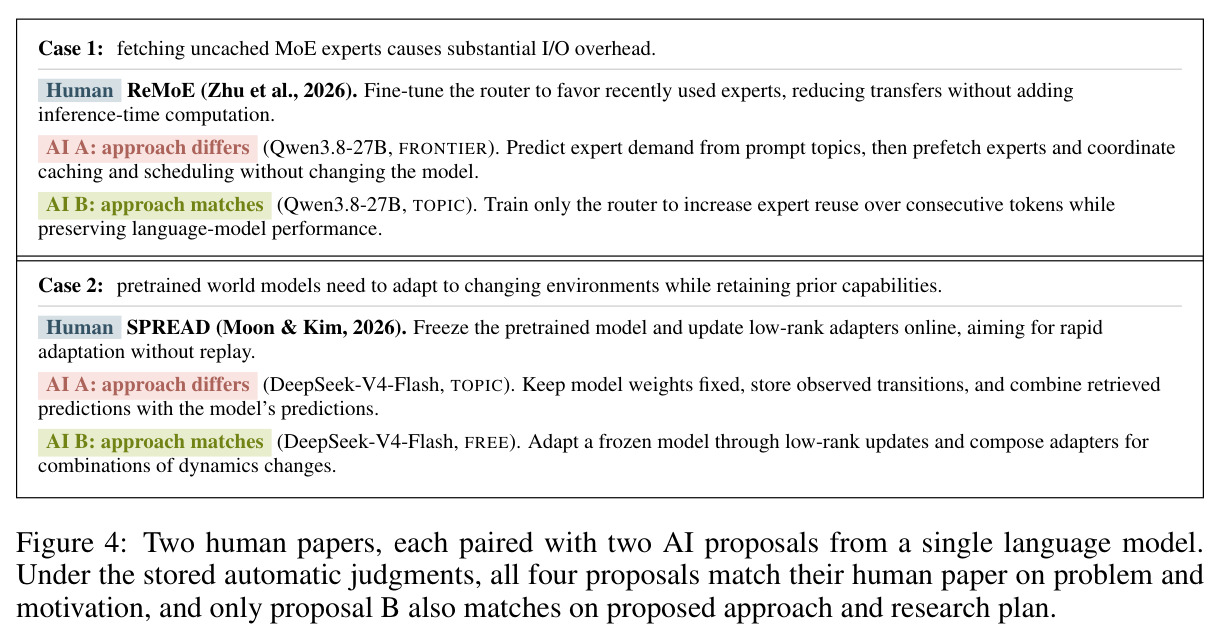
作者提出的方向:将 IdeaTaste 作为持续更新的开放排行榜,每年把冻结点前移、以当年论文为参照,让每代新模型都在其训练截止之后的发表周期上受测;并明确指出研究品味的瓶颈“不在找到方向,而在把方向转成社区实际会走的具体方法”,这是未来 AI 科学家的核心挑战。基于成果可延伸的方向:(1)机制改进——既然模型倾向“在未改动的核心外附加机制”(Figure 4 两案例的共同模式),可在 ideation 阶段显式要求对核心组件提出干预假设,或用小规模执行反馈校准问题到方法的映射;(2)把槽位差距当作训练信号——用人类论文的 problem→approach 配对微调 ideation 策略,检验“方法选择”是否可教;(3)模拟更真实的研究社区——加入审稿、引用网络演化与组内传承,观察种群行为是否向人类水平靠拢;(4)扩展到 AI 之外领域与更长周期,检验“阅读多样性高但想法趋同”是否普遍;(5)与影响力追踪结合——事后验证哪些“无对应物”提案后来被社区采纳,把“被忽视的机会”从盲评猜测变成可检验事件。
复现评估
复现评估:作者开源了持续更新的排行榜(https://cxcscmu.github.io/IdeaTaste),附录以“冻结配置”给出全部构建细节:四领域定义与检索查询、landmark 清单、滚雪球规则与覆盖审计、五槽位抽取 prompt、逐槽判定 prompt、智能体系统 prompt 与四方法 profile;检索用开源组件(BM25 $k_1=1.5,b=0.75$ + all-MiniLM-L6-v2,RRF 融合)。数据可从 Semantic Scholar/arXiv 等公开源重建,但工作量不小:约 26.3 万篇语料加 1.15 万篇参照的收集、筛选与去重。成本方面,超过 90,000 份提案 × 20 步 × 六个商业模型的 API 调用是主要开销,裁判与抽取分别依赖 GPT-5.6 Luna 与 DeepSeek-V4-Pro 的 API;人工部分需 11 名有审稿经验的盲评者与 3 名裁判验证标注者。总体难度中等偏上:协议完全公开、无私有数据,但预算、评审组织和多模型 API 依赖使独立完整复现不轻松;只复现单领域单模型则容易得多。
论文图表