rTaste:研究智能体有“品味”吗?评估早期研究判断力 rTaste: Do Research Agents Have Taste? Evaluating Early Stage Research Judgment
让6个前沿模型从新论文自提小实验、预测结果并排序,检验其研究品味
前置知识
MVE 与注册事件(registered event)
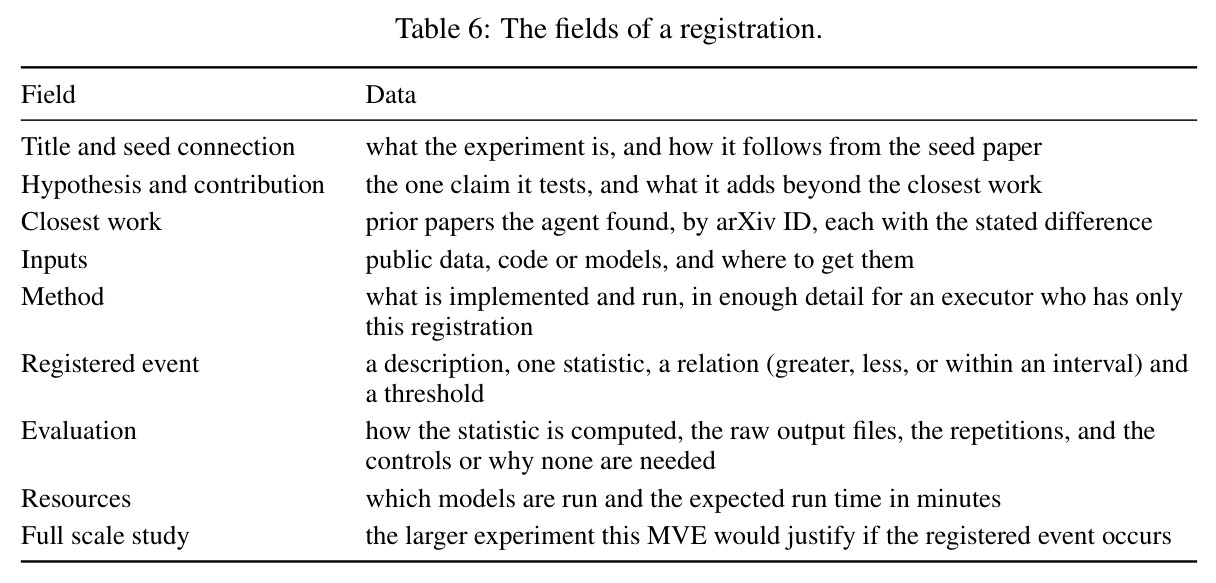
MVE(minimum viable experiment,最小可行实验)是研究者用来廉价试探一个方向是否值得投入的小实验,其价值前提是结果不显而易见。本文借鉴临床试验预注册思想,要求每个 MVE 在运行前写下“注册事件”:一个统计量、一个关系(大于/小于/落在区间)、一个预设阈值,例如“某差值 > 5 个百分点”。事件是否发生由独立重跑的评估输出唯一判定,从而使“预测结果”有客观真值可校验。
整个研究的因变量都建立在注册事件上:agent 的预测用事件是否发生打分,排序用审计价值排名打分,不理解注册事件就无法理解评估闭环。
Brier 分数
评估概率预测准确性的标准指标,定义为 $\text{Brier} = \frac{1}{N}\sum_{i=1}^{N}(p_i - o_i)^2$,其中 $p_i$ 是预测概率,$o_i \in \{0,1\}$ 是事件实际是否发生。取值 0 到 1,越低越好:永远预测 0.5 得 0.25,完全准确得 0。它同时惩罚过度自信、不自信和系统性偏差。
论文用它比较“设计实验的 agent”与“只读论文的同模型 judge”谁的预测更准,是“agent 的额外调研是否带来信息优势”这一核心问题的量化工具。
LLM-as-Judge 与多数票/中位数聚合
用大模型给其他模型的行为打分。为降低单 judge 的偏差,本文对二元判断(是否忠实、是否有效)取三个审计员的多数票,对 0-3 的研究价值分取中位数,并对评审员的问题取“至少两人一致”的答案。judge 是否可靠需要用 Cohen's $\kappa$(一致性系数,扣除随机一致后的一致程度)来检验。
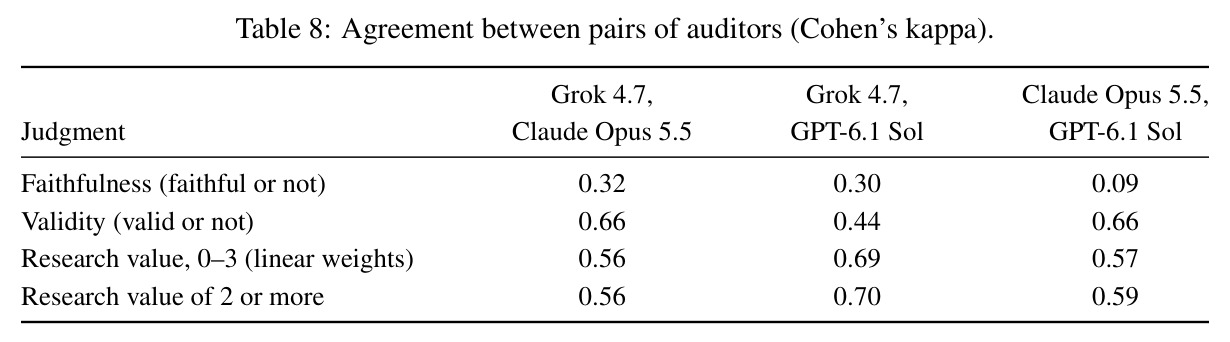
本文所有标签(sound、valuable、new、obvious)都来自模型 judge,理解其聚合规则与一致性水平(如 faithfulness 上 $\kappa$ 仅 0.09-0.32)是判断结论可信度的前提。
研究自动化智能体(research agent)
以 LLM 为核心、能执行文献检索、代码实现、实验运行与报告撰写的自动化系统,代表工作有 AI Scientist、Agent Laboratory、RE-Bench 等。现有评估多分为两类:执行类基准给定任务测完成度;想法类评估在执行前给研究提案打分,但打分结论可能随执行结果反转。
本文的定位是填补两类评估之间的空白:测的不是“按指令完成实验”也不是“评审别人的想法”,而是“自己提出实验并预判结果”的早期判断力。
研究动机
研究智能体已经能覆盖实证研究流程的大部分环节:文献检索、代码实现、跑实验、写报告,前沿实验室也报告智能体写出了大量内部代码、支撑着越来越多的实验。然而 METR 在 2026 年对四个前沿实验室的风险评估发现,没有任何一家让智能体设定研究议程或做预算决策——被人类保留的这一步,正是研究者所说的“品味”(taste):在结果未知之前,判断哪些问题和实验值得追求(这一概念可追溯到 Hamming 1986 年的著名演讲)。实践中品味往往通过小实验行使:研究者廉价试探一个方向,让结果决定是否投入更大研究;这样的实验只有在其结果不显而易见、且研究者对结果的预期足够准确以指导行动时才有用。一个提出结果可预测的实验、或对自己实验将显示什么“自信地错误”的智能体,即使把每个实验都跑对,也在浪费有限预算。已有评估各管一段:执行类基准(RE-Bench、MLE-bench、EXP-Bench)给定任务测完成度;想法类评估在执行前打分,但那些判断会随执行反转——LLM 想法曾被人类评委评为比人类更新颖,实际执行后优势消失了;结果预测类工作只预测别人给定的实验,不测 agent 自己选择测什么。
本文的目标是本文要量化智能体的早期研究判断力,具体回答三个问题:给定一篇刚发表、带公开代码的 NLP 种子论文,前沿模型(1)能提出多少“可靠且有价值且新颖”的最小可行实验(MVE)——即忠实于注册、证据有效、且与 2026 年 8-9 月为止的文献不重复的实验;(2)能否在运行前准确预测自己注册的事件是否发生,用 Brier 分数量化,并与只读论文和注册的同模型 judge 对比;(3)其排序能否识别出最值得做的实验——首选是否为审计员事后最看重的 MVE,且是否优于“它写的第一个 MVE”这一朴素基线。附带目标包括:比较单一研究员(SR)与研究团队(RT)两种组织方式、六个前沿模型的风格差异、每条件美元成本与每 100 美元的达标产出,并公开全部 415 个 MVE 的数据集供后续研究。
与已有工作不同的是,本文的独特切入是“提出—注册—预测—全执行—盲审计”的完整闭环,以及三个此前没人同时满足的设计选择。第一,实验问题由 agent 自己选择:执行类基准把问题交给 agent,而这里 agent 读一篇新论文自己决定测什么,因此测的是“发现值得问的问题”而非解题能力。第二,判断与执行结果硬挂钩:先前对研究想法的评审不执行、或只执行被选中的最优假设(未被选中的假设其预期永远得不到检验),本文让每个 MVE——包括 agent 排名最后的——都在统一资源限制下被独立执行器运行,预测经 Brier 分数校验、排序经审计价值排名校验,评审意见不再是空对空。第三,也是最巧的一步:引入“同模型 judge”对照——一个只看到种子论文和五份注册、不能搜索、不知道 agent 推理过程的新实例做同样的预测,直接检验“agent 的阅读、检索与推理是否带来了超出其注册文本的信息优势”。这个基线设计把“上下文信息量”和“模型判断力”两个混淆因素干净地分开了。
核心方法
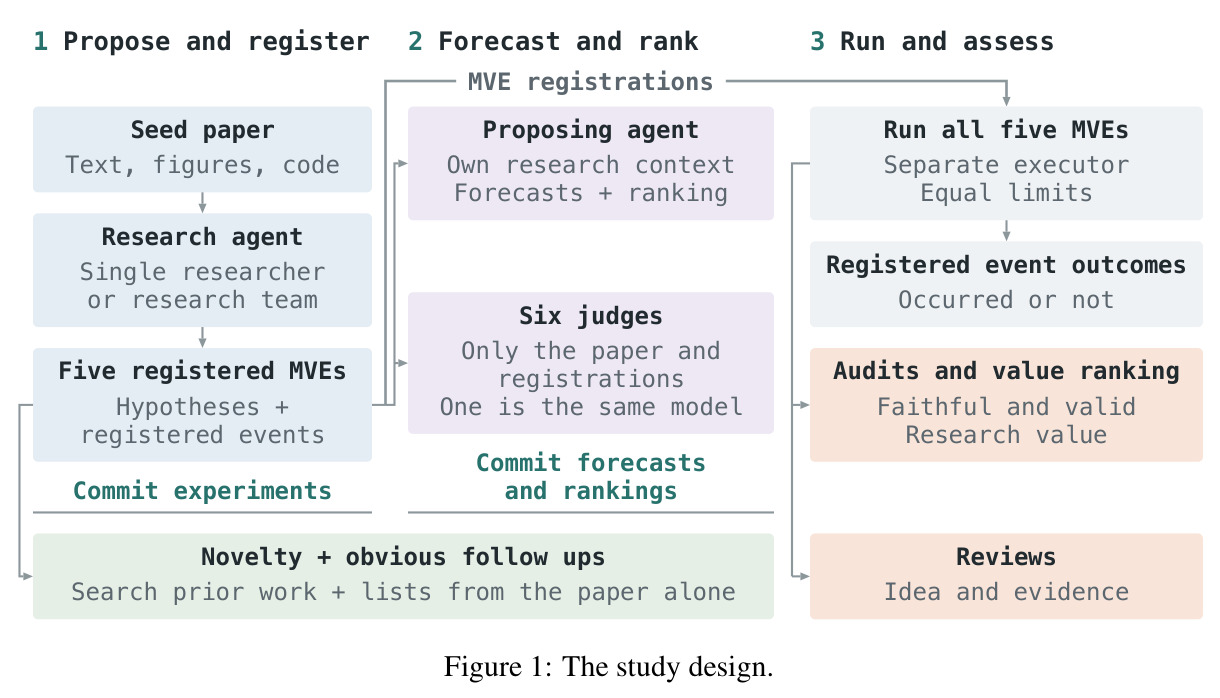
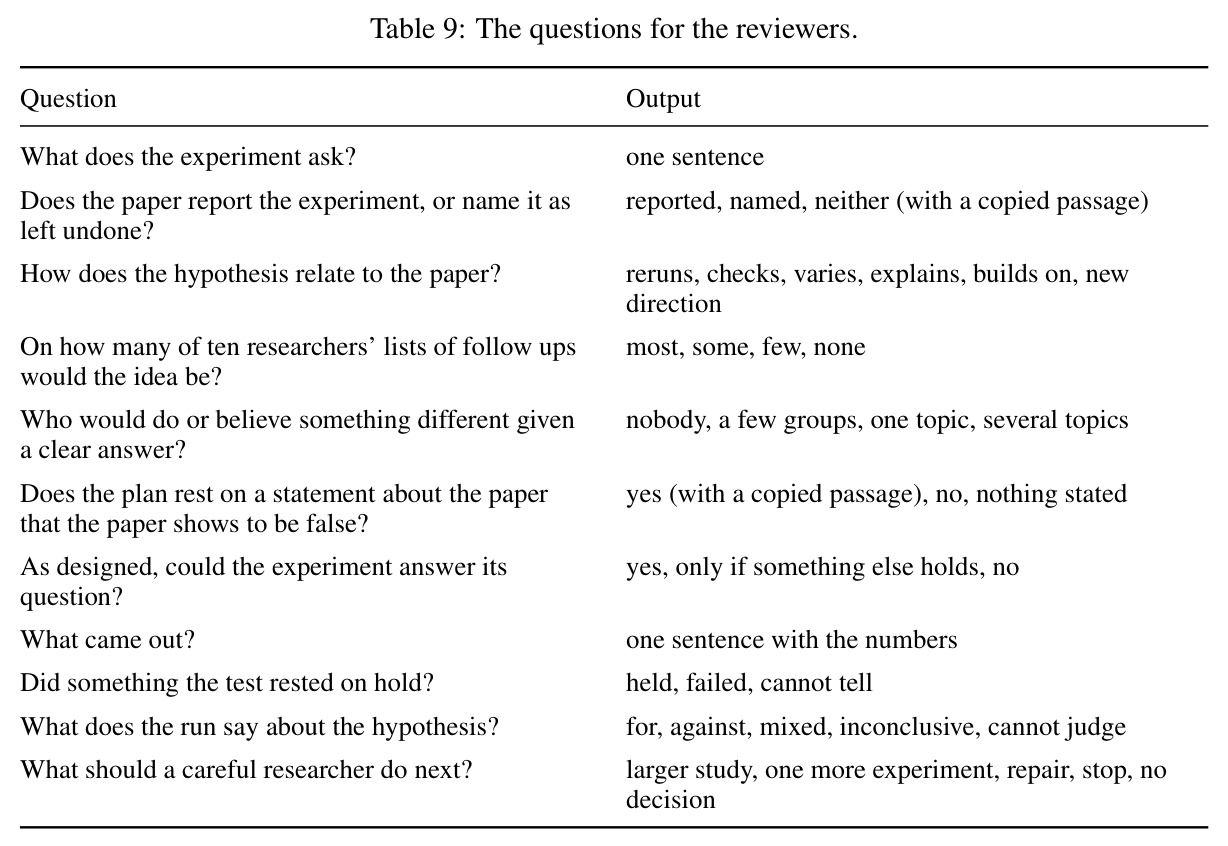
直觉上,论文把“品味”这个模糊概念拆成三个可测的问题:你能想到什么好实验?你能否预判它的结果?你知不知道哪个最值得做?技术路线是一个五阶段流水线。阶段一“提出与注册”:六个前沿模型各自以单一研究员(SR)或研究团队(RT)两种身份读种子论文(全文文本、每页图像、代码库读权限),用 arXiv 工具检索文献后,输出恰好五个 MVE 注册(JSON 格式),每个注册包含假设、最近先行工作、输入、方法、注册事件(统计量+关系+阈值)、评估方案、资源需求与后续大规模研究设想。阶段二“预测与排序”:提交后 agent 立即给每个 MVE 一个事件发生概率和 1-5 排名;同时六个模型作为 judge 在全新上下文中只看论文和注册做同样的预测。阶段三“执行”:两个统一执行器(Claude Opus 5.5 和 GPT-6.1 Sol)在盲条件下实现每个 MVE——不论排名——每台机器一块 A100、最多 45 分钟、只允许 ≤8B 开源模型。阶段四“受保护重评”:删除执行器自带的结果文件,在它从未用过的全新机器上重跑评估命令,由重跑输出判定注册事件是否发生。阶段五“审计与评审”:三个审计员盲判忠实性、有效性与 0-3 研究价值,两个新颖性 judge 搜 arXiv 判断与已有工作是否重复,三个评审员回答固定的十一个问题。
核心创新是把“研究品味”操作化为一个可审计的对照实验协议,与已有工作的本质区别有三。第一,问题由 agent 自选:以往工作要么给定任务测执行,要么让 agent 评审静态的想法清单,本文让 agent 从一篇太新、几乎没有后续文献的种子论文出发自己决定测什么,直接瞄准“提出问题”的判断力。第二,所有判断都被执行检验:想法评审类工作在执行前打分,而执行会反转结论(LLM 想法被评为更新颖,执行后优势消失);本文让全部 415 个 MVE 无一例外地被运行,agent 的预测有客观真值(重跑输出 vs 注册阈值),其排序有事后金标准(审计员中位价值排名),不存在“只跑看好的假设导致预期永远无法证伪”的问题。第三,“同模型 judge”对照是全文最锋利的设计:如果 agent 的深度阅读和文献检索真带来了信息优势,它的 Brier 分数应显著低于只看注册文本的复制品;实测差异仅 $-0.006$(95% CI $-0.021$ 到 $0.009$),跨越零点——agent 的额外工作没有让它更懂自己的实验。这个反直觉的否定结果说明:agent 写下注册的那一刻,它所知道的已经全部写在纸面上了。
方法步骤详情
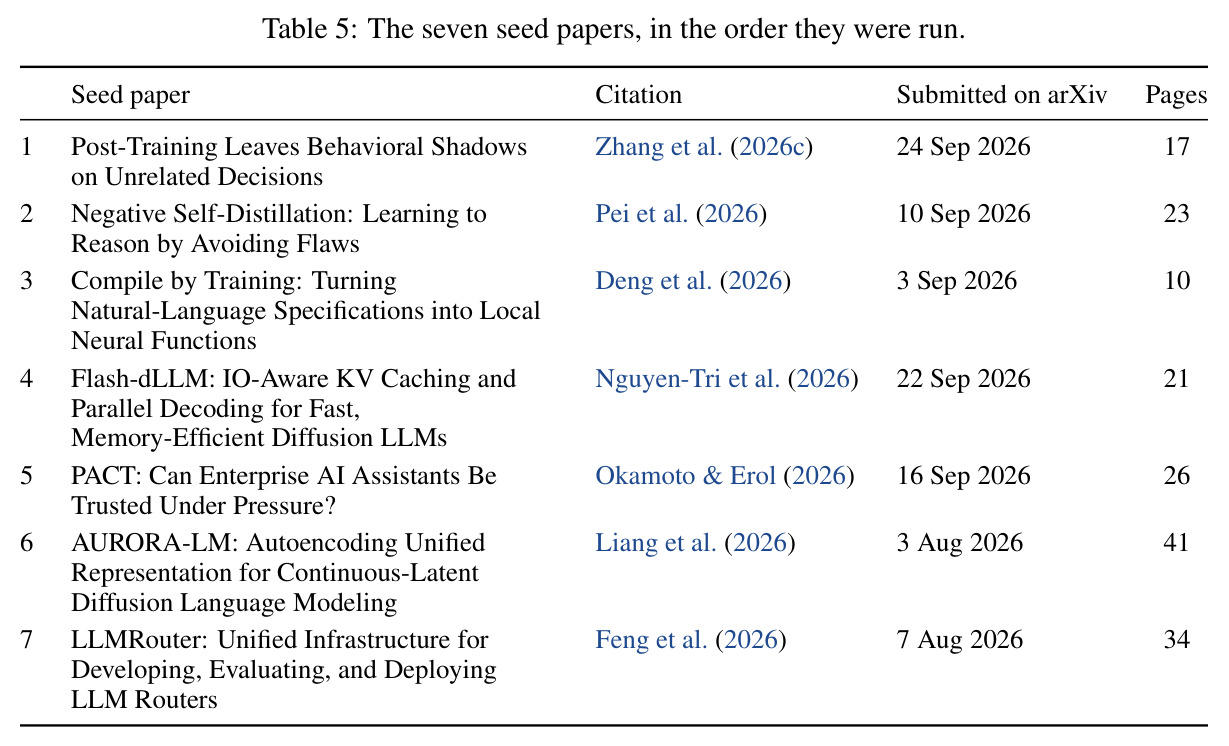
第一步,选种子论文:7 篇 2026 年 8 月 3 日至 9 月 24 日发布的 arXiv cs.CL 论文(如 Flash-dLLM、AURORA-LM、LLMRouter),要求来自 HF Daily Papers、有公开代码、能在单 GPU 45 分钟内做出有信息量的后续实验、排除需要 8B 以上模型的训练。第二步,提出注册:SR 条件下单上下文 agent 先写下对论文的理解和候选方向,再检索 arXiv 与代码库,输出 5 份注册;RT 条件下两个 proposer 独立起草,critic(无工具)审查科学性与可行性,lead(无工具)保留/修改/合并为 5 份。第三步,双重承诺:所有 12 个条件(6 模型 × 2 组织)注册完毕且给出概率与排名之前,任何实验不得运行。第四步,新颖性标注:Claude Opus 5.5 与 GPT-6.1 Sol 用同一 arXiv 工具把每个 MVE 标为 equivalent / close variant / distinct;同时六个模型各列 10 个“明显后续实验”,由 judge 核对 MVE 是否命中清单以判定 obvious。第五步,执行:每篇论文的 60 个 MVE 交替分给两个执行器,A100、45 分钟、60 次模型调用、6 美元上限、仅 ≤8B 开源模型;失败时另一执行器独立重试一次,397/415 首次即交付。第六步,受保护重评:删除提交结果,在新机器重跑评估命令,重跑值唯一决定事件是否发生(407 个有对照值的 MVE 中 335 个重跑值与执行器自报值完全一致)。第七步,审计与评审:三个审计员(含不参与研究的 Grok 4.7)盲判 faithful/valid 并给 0-3 研究价值,取多数票与中位数,并给每条件 5 个 MVE 按价值排名;事后补充的评审环节让三个评审员盲答十一个固定问题。第八步,分析:所有比较在种子论文内部配对进行,报告跨 7 篇论文的均值与 95% CI。
技术新颖性
技术新颖性在于评估协议而非模型本身。其一,“注册事件”机制把临床试验预注册移植到 AI 研究评估:统计量、关系、阈值在运行前固定(415 个 MVE 中 384 个用 greater、31 个用 less),使“预测”有明确的真值目标,这是结果预测类工作用别人实验做不到的自洽设计。其二,全执行设计:不同于“先试点、只全量跑最有把握假设”的流程——那会让落选假设的预期永远得不到检验——本文所有提案都被运行,排名只表达优先级而不自我实现。其三,多层盲化:执行器不知道提案者与排名,审计员看不到种子论文与提案者身份,评审员看不到预测、排名、审计与新颖性标签,抑制了标签间的信息泄漏。其四,对照测量创新:同模型 judge 基线分离了“上下文信息”与“固有判断力”。其五,对评估者本身的校准:用未参与研究的 Claude Sonnet 5.5 向 10 个交付 MVE 的副本植入已知缺陷再盲审,多数票抓住 8/10、10 个原件零误报,这种“考官也要考试”的质量控制在此类研究中少见。弱点是 faithfulness 判断上审计员间 $\kappa$ 仅 0.09-0.32,两个新颖性 judge 的 $\kappa$ 也只有 0.27,标签噪声不可忽略。
实验结果
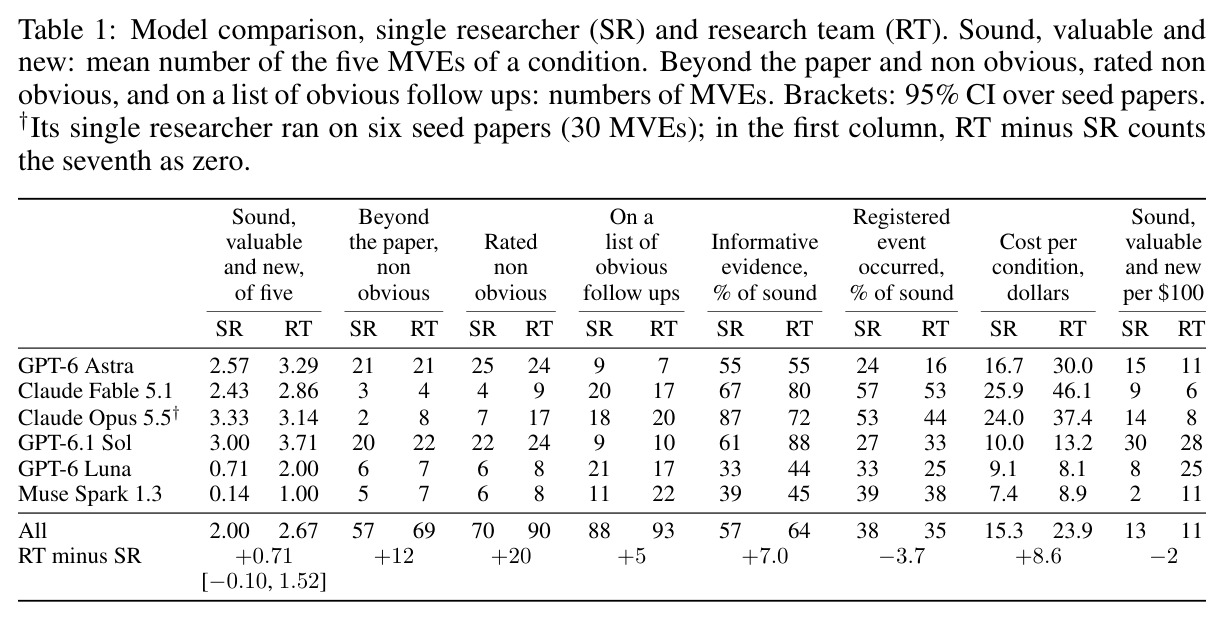
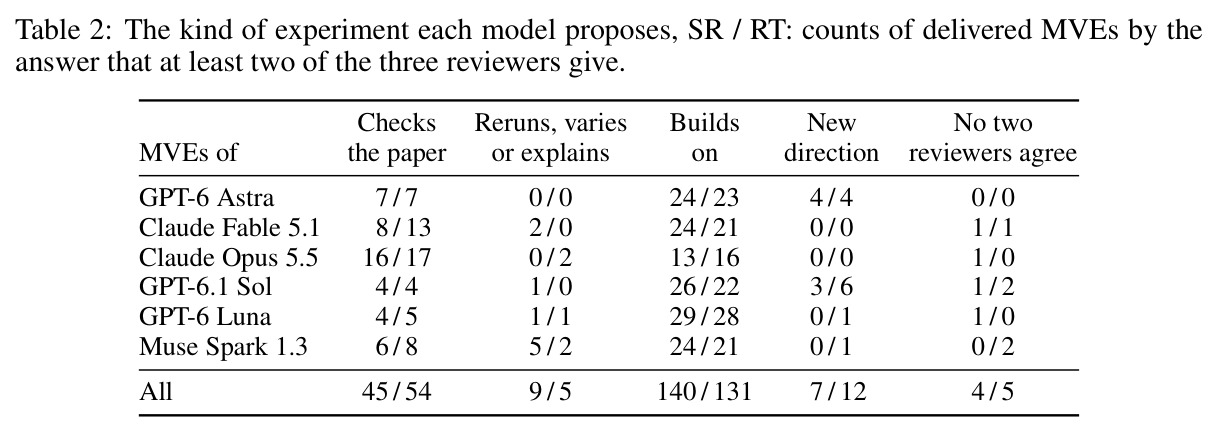
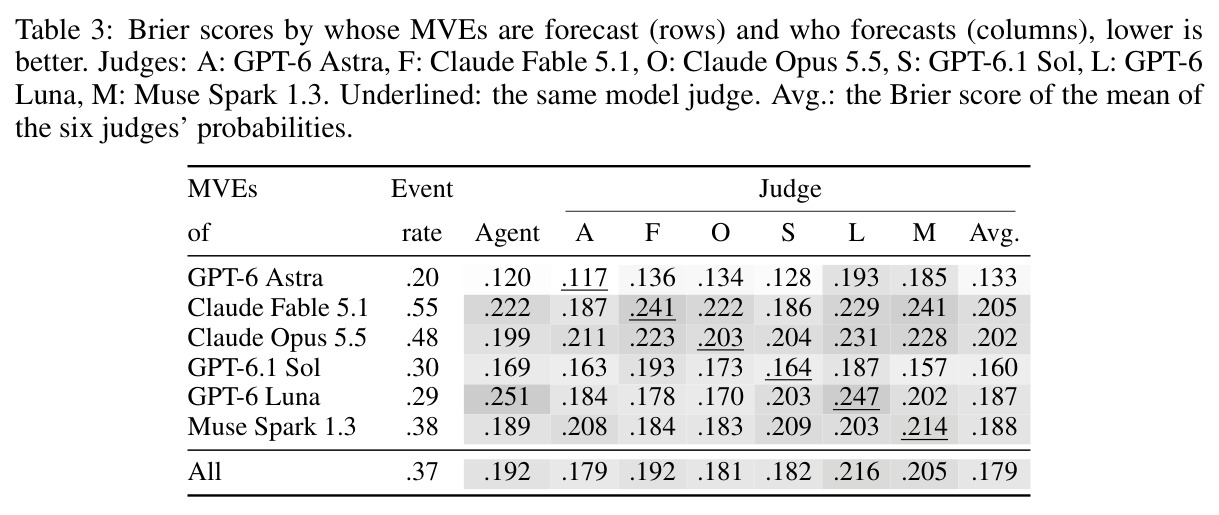
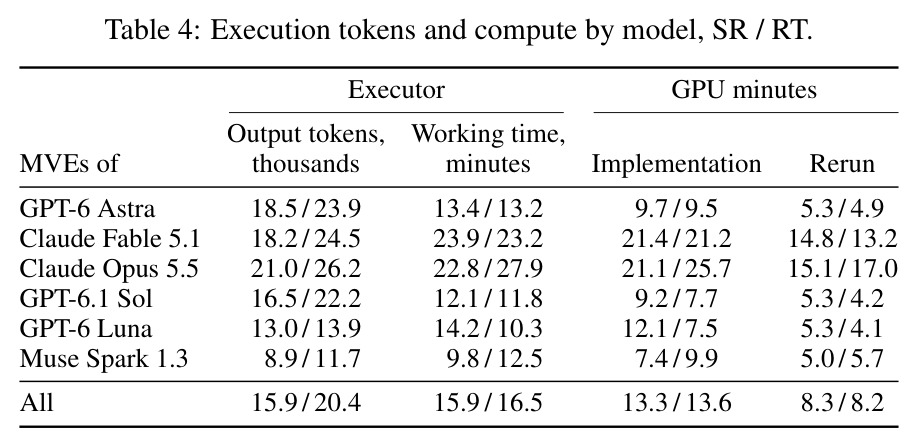
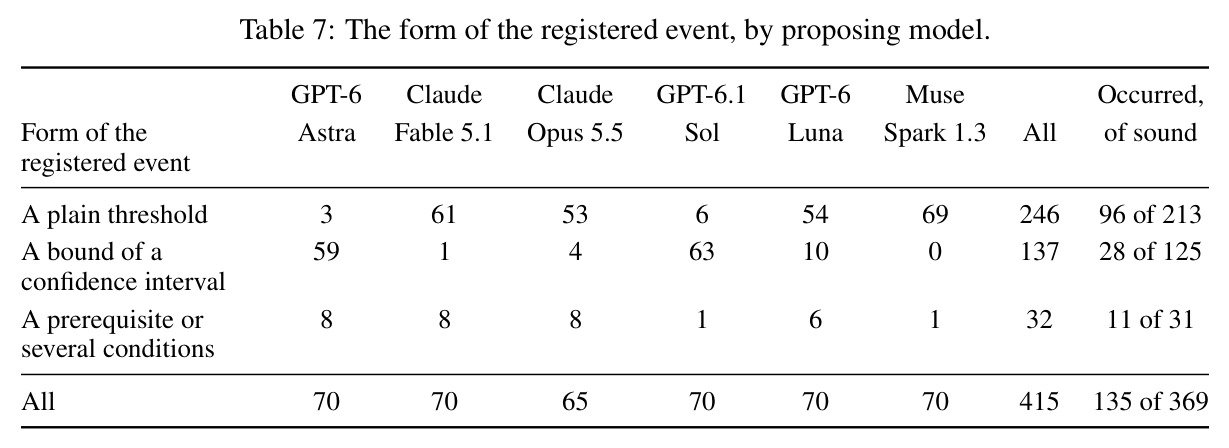
产出数量:415 个 MVE 中 397 个首次执行即交付;194 个被判 sound + valuable + new。四个较大模型 SR 条件每 5 个中达标数为 GPT-6 Astra 2.57、Claude Fable 5.1 2.43、Claude Opus 5.5 3.33、GPT-6.1 Sol 3.00,两个较小模型 GPT-6 Luna 0.71、Muse Spark 1.3 仅 0.14。但 194 个达标 MVE 中只有 73 个(37.6%)同时“超越种子论文且非显而易见”。实验类型上,66% 的 MVE 是在论文之上构建(build on)、24% 检查论文声明、仅 5% 开辟论文仅暗示的新方向;44% 命中“明显后续实验”清单;在 Flash-dLLM 这篇种子论文上,四个大模型的全部 8 个条件都把同一个附录正确性论证检查写在第一位——趋同惊人。GPT-6 Astra 与 GPT-6.1 Sol 贡献了约三分之二的“超越论文且非显而易见”MVE( respectively 42 与 25 个级别),在种子论文内配对比较中其份额比两款 Claude 高 48 个百分点(95% CI 29 至 66),且在全部 7 篇种子论文上都更高。预测准确性:agent 的 Brier 分数 0.192,同模型 judge 0.179,差 $-0.006$(CI $-0.021$ 至 $0.009$)不显著;两者都优于给每个 MVE 其余六篇论文事件率的 base rate(0.240);六个 judge 概率的均值最优(0.179)。事件发生率被定义方式左右:用置信区间界限对比阈值的 GPT-6 Astra/Sol(137 个注册中 125 个如此)事件发生率仅 25%,用点估计的 Claude 两款为 52%。排序:agent 首选是审计员最看重 MVE 的比例 38%(随机 20%),但比“它写的第一个 MVE”仅高 3 个百分点(CI $-8$ 至 $15$);第一个写的 MVE 有 61% 在明显清单上(第五个仅 35%),47% 的条件首选就是第一个写的;首选事件发生率 47%,末选 29%。团队效应:RT 比 SR 每 5 个多 0.71 个达标 MVE(CI $-0.10$ 至 $1.52$)不显著,成本 $23.93 对 $15.31。成本效益:每 100 美元 SR 产出 13 个、RT 11 个达标 MVE,GPT-6.1 Sol 最高(SR 30 个);GPT-6 Luna 团队若不要求新颖性可匹敌 GPT-6.1 Sol,但“超越论文且非显而易见”产出只有其约一半。执行器质量影响显著:Opus 5.5 执行器实现的 MVE 有 18% 不 sound,GPT-6.1 Sol 执行器仅 3%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 提出可靠、有价值且新颖的 MVE | 每条件(5 个中)sound+valuable+new 的平均数 | 较大模型约 3/5:Claude Opus 5.5 SR 3.33、GPT-6.1 Sol SR 3.00 | 较小模型约 1/5:GPT-6 Luna SR 0.71、Muse Spark 1.3 SR 0.14 | 大模型约为小模型的 3 倍以上 |
| 预测注册事件是否发生 | Brier 分数(越低越好) | agent 0.192;六个 judge 概率均值 0.179(最优) | base rate(其余六篇论文的事件率)0.240;同模型 judge 0.179 | agent 优于 base rate 0.048,但与同模型 judge 无显著差异(−0.006,CI 跨零) |
| 识别最值得做的实验(首选实验质量) | 首选为审计员最看重 MVE 的条件比例 | 38% | 随机挑选 20%;“写的第一个 MVE”约 35% | 比随机高 18 个百分点,但相对第一个写的 MVE 仅 +3 pp(CI −8 至 15),不显著 |
| 研究团队 vs 单一研究员 | 每条件达标 MVE 数之差(RT − SR) | +0.71(RT 2.67 vs SR 2.00) | 同一模型的单一研究员 | 不显著(95% CI −0.10 至 1.52),每条件成本增加约 8.6 美元 |
| 每美元研究产出 | 每 100 美元产出的 sound+valuable+new MVE 数 | GPT-6.1 Sol SR 最高,30 个 | Muse Spark 1.3 SR 最低,2 个;全体 SR 平均 13 个 | 最高与最低相差一个数量级以上 |
局限与改进
作者承认的局限:(1)所有标签(sound、valuable、new、obvious、informative)都来自模型,整个研究缺乏人类基线,无法判断这些比例对人类研究者是高是低;(2)三个审计员中两个(Claude Opus 5.5、GPT-6.1 Sol)既是被评估模型又担任执行器,存在既当运动员又当裁判的循环;(3)每个 MVE 无论排名如何都被运行,排名不决定运行什么,真实预算约束下的“品味决策”未被测试;(4)注册必须完整到独立执行器可实现,部分预测信息可能已被内建于事件定义——例如把阈值设为置信区间界限本身就压低了事件发生率;(5)每个条件只运行一次,无法测量结果的重跑方差。我的补充观察:审计员在 faithfulness 上 $\kappa$ 只有 0.09-0.32,“sound”这一承重标签本身噪声很大,而 194 这个核心数字及执行器差异等结论都建立在它之上;两个新颖性 judge 的 $\kappa$ 仅 0.27(一个判 387/415 distinct,另一个判 298 distinct),new 标签的模型间分歧明显;7 篇种子论文是极小样本,几乎所有 CI 都很宽,许多“无显著差异”的结论更可能是统计功效不足而非真无差异;实验空间被限制在 NLP、≤8B 开源模型、单卡 45 分钟,“品味”的高价值场景(如判断是否值得启动大规模训练)无法体现;non-obvious 的判定依赖“10 个研究者清单”的思想实验,操作化定义可争议;评估在 2026 年 10 月 6-8 日进行,所用前沿模型版本会迅速过时。
独立分析的弱点
(1)没有人类对照是最大缺陷:我们不知道人类 NLP 研究者面对同样 7 篇论文、同样算力限制,能提出多少达标且 non-obvious 的 MVE、其 Brier 分数是多少。如果人类在同样约束下也只有约 37% 的 non-obvious 率和 0.19 的 Brier 分数,那么“agent 品味有限”的结论就不成立,甚至说明 agent 已达到人类水平。改进方向:招募 10-20 名相关方向研究者运行同一协议的最小版本,报告人机配对结果。(2)审计循环污染:Opus 5.5 和 GPT-6.1 Sol 既当裁判又当运动员,且执行器质量差异巨大(18% vs 3% 不 sound),会把以 Opus 5.5 为执行器的条件系统性拉低,跨模型比较因此混入了执行器身份这一混杂变量。改进:审计与执行全部使用第三方模型,或引入人类审计员对一定比例的样本双重盲审。(3)事件定义自由度太大:用点估计还是 CI 界限完全由 agent 自定,25% 与 52% 的发生率差异更多反映阈值风格而非实验质量,也使跨模型 Brier 比较失真——预测“难发生的事件”天然不同。改进:统一规定统计检验形式(如必须报告 CI 且事件定义为 CI 排除零效应),或显式把阈值策略作为被测变量分析。(4)单次运行无方差估计:小实验噪声大,单次的 Brier 分数可能大部分反映运气而非判断力,±0.006 量级的差异尤其如此。改进:对每个 MVE 用多个随机种子重复运行,报告预测的期望 Brier 及其方差。(5)7 篇种子论文的功效不足使团队效应、排序优势等关键问题无法判定。改进:扩展到 30 篇以上种子论文,并跨领域采样。
未来方向
作者明确提出的方向:给 agent 一笔固定研究预算,让它自己决定把钱分配给哪些 MVE、并允许根据首批结果调整,然后检验预算是否最终流向被证明 sound、valuable 且 non-obvious 的实验;再把同样的预算给人类研究者作对照——把评估从“提出与预测”推进到“分配有限预算”,那正是研究者真正行使品味的地方。基于本文成果可延伸的方向:(1)把“同模型 judge”做成通用诊断工具,用于定位 agent 自我评估的失效点,例如在 agent 系统上线前自动检验其元认知是否有真实信息含量;(2)研究 GPT-6 Astra 与 GPT-6.1 Sol 为何更能提出 non-obvious 实验——是预训练数据、后训练目标还是推理时策略,并尝试把这种能力蒸馏到廉价小模型;(3)把低事件发生率本身作为研究对象:阈值更严格的模型恰恰也是最有品味的模型,“难通过注册”可能正是高价值方向的信号;(4)把协议迁移到 NLP 之外的领域与更大算力空间(多卡、更大模型、更长周期实验),检验品味结论的领域迁移性;(5)利用公开的 415 个带审计结果的 MVE 数据集,训练或校准专门的研究价值预测器,形成可复用的“品味评分模型”。
复现评估
开源情况良好:评估 harness 与全部 415 个 MVE 的注册、预测、执行结果与审计标签都发布在 github.com/ArtKanke/rTaste,附录 D 给出了所有角色的原文 prompt(agent、judge、新颖性 judge、执行器、审计员、评审员),附录 A 给出了执行环境与限制的全部细节,协议透明度在同类研究中属于最高档。算力需求中等:提案、预测、审计均为 API 调用;执行器每条件约 15-25 分钟 GPU 时间(A100 80GB 一块),论文报告每条件成本 SR 平均 15.31 美元、RT 平均 23.93 美元,84 个条件的总成本估计约 1500-2000 美元(含 API 与 GPU),一个有适度预算的实验室或个人可以承担。时间上完整评估在 2-3 天内完成。复现难度中等偏高,难点不在算力而在:(1)结果依赖 2026 年 10 月的特定前沿模型版本(GPT-6 Astra、Claude Fable 5.1 等),模型迭代后无法精确复现数字,只能复现协议与结论方向;(2)协议阶段多、工程细节多(受保护重评、失败重试规则、植入缺陷校准),实现工作量不小;(3)LLM judge 的随机性会使标签层出现波动。若目标是复用方法论而非精确数字,这套 harness 是直接可用的,其植入缺陷校准的做法也值得任何做 LLM-as-judge 评估的人借鉴。
论文图表