Solv3R:作为多视图求解器的 3D 循环 Transformer Solv3R: 3D Looped Transformer as a Multi-view Solver
把多视图重建改成可继续求解的平稳迭代过程,一个模型统一离线、增量、重定位与流式
前置知识
Structure-from-Motion (SfM)
经典多视图重建流程:先做特征匹配建立跨视图对应,再通过捆绑调整(bundle adjustment)迭代优化相机内外参与三维点,使重投影误差最小。它天然支持增量式建图:新图像加入后与已有地图匹配、只需局部优化即可并入。
Solv3R 的全部动机就是把 SfM 的三条能力——迭代细化、增量扩展、误差修正——搬进学习式模型,理解 SfM 才能理解全文的『求解器』隐喻。
几何基础模型 (GFM)
前馈神经网络直接从多张图像一次性回归相机位姿、深度或点图的模型家族,代表有 DUSt3R/MASt3R(成对点图回归)、VGGT(1.26B 参数堆叠 Transformer)、$\pi^3$、Depth Anything 3 (DA3)。特点是推理快,但一次前向输出全部几何,难以增量扩展。
本文的对比基线(VGGT、$\pi^3$、DA3 等)和模型初始化来源(DéjàView)都是 GFM,其『中间状态与层深度绑定』的缺陷正是立论起点。
点图 / 射线图 (point map / ray map)
点图是每个像素对应的三维坐标场,射线图是每像素相机光线的方向与原点场。二者与相机位姿、深度可互相导出,是现代 GFM 统一的几何输出表示,避免了显式匹配。
Solv3R 从状态解码的就是相机位姿、射线图和深度图,训练损失 $\mathcal{L}_{\text{geo}}$ 直接作用在这三类量上。
循环 Transformer (looped transformer)
用同一个共享权重的 Transformer 块反复作用于隐状态,替代参数各异的堆叠层:参数量小、推理计算量可在运行时伸缩。DéjàView 首次将其用于多视图重建,但其共享块以迭代步数 $\tau_k$ 为条件,每步执行不同变换。
Solv3R 直接建立在 DéjàView 的循环骨架上,核心改动(去掉步数条件化)必须对照理解循环 Transformer 才有意义。
平稳迭代法与不动点 (stationary iteration)
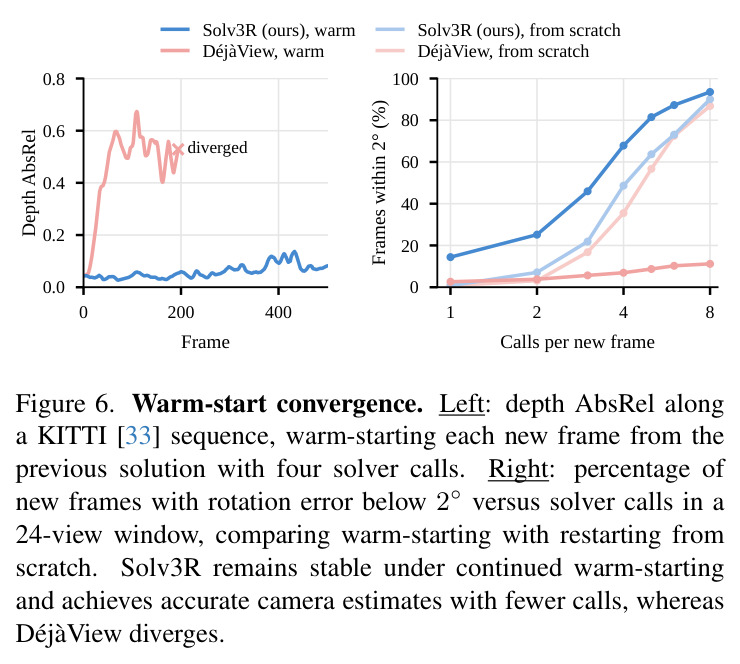
Jacobi 等经典迭代法求解 $Ax=b$ 时更新形式为 $x^{k+1}=\Phi(x^k; A, b)$,不依赖迭代次数 k。收敛时精确解 $x^*$ 是不动点(再迭代不变),受扰动的状态会收敛回 $x^*$,新增变量可从旧解热启动继续求解。
论文把这三条性质形式化为 P1 稳定、P2 纠错、P3 延续,并作为显式训练目标,是全文的理论骨架。
KV 缓存 (key-value caching)
Transformer 推理时缓存已计算过的 key/value 张量,使后续计算无需重复编码同样的上下文。常规堆叠模型每个注意力层都要存一份缓存;若算子平稳(权重与阶段无关),一份缓存即可跨所有调用复用。
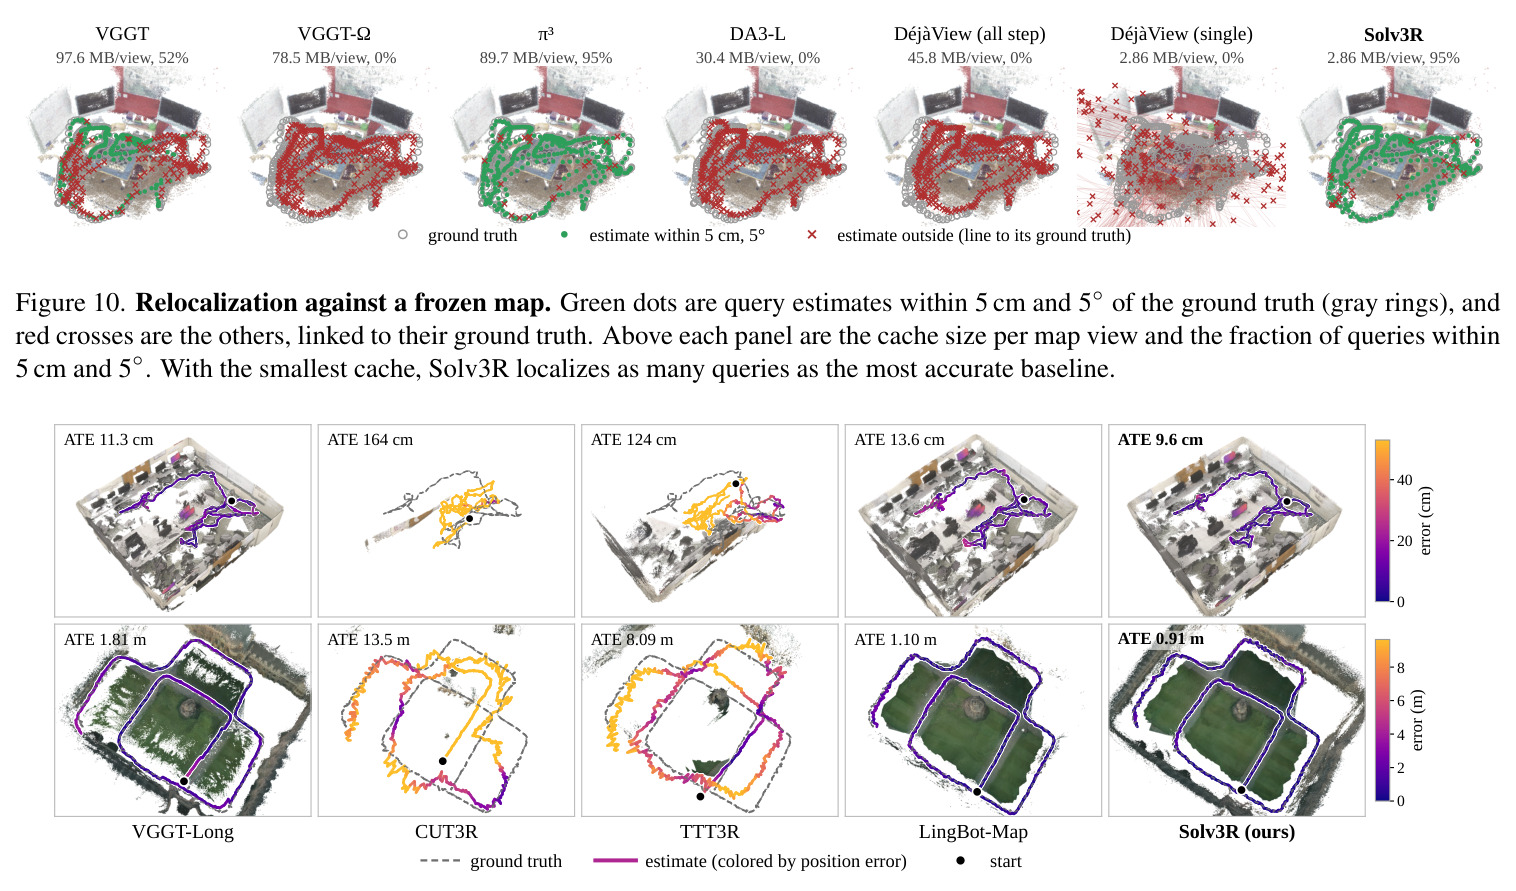
重定位实验的核心收益来自冻结地图视角的 KV 缓存被所有 solver call 复用(仅 2.86 MB/view),这是平稳性最直接的工程红利。
位姿 AUC 与 ATE 评测指标
位姿 AUC@3/@30 是相对位姿误差曲线在 3°/30° 阈值下的曲线下面积(越高越好);ATE(绝对轨迹误差)是估计轨迹与真值经 Sim(3) 对齐后的误差,流式与 SLAM 评测标准;深度用 AbsRel 与 $\delta_{1.25}$,重建用 Chamfer 距离与法向一致性。
Table 1–3 的所有数字都用这些指标,不熟悉就无法判断 85.5 vs 35.4 或 ATE 0.015m 的含义。
研究动机
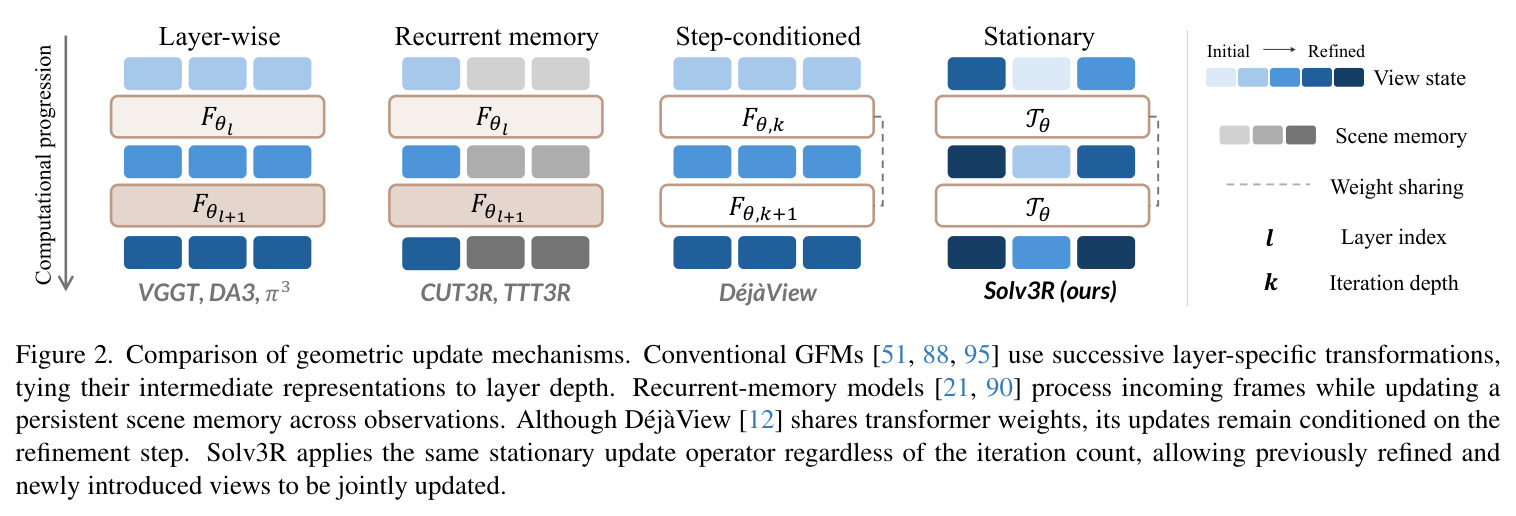
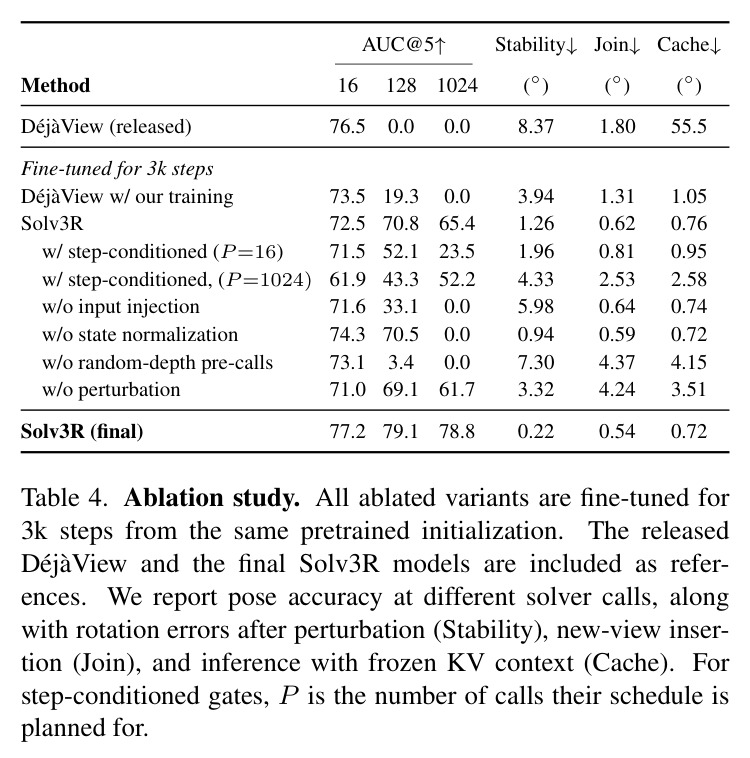
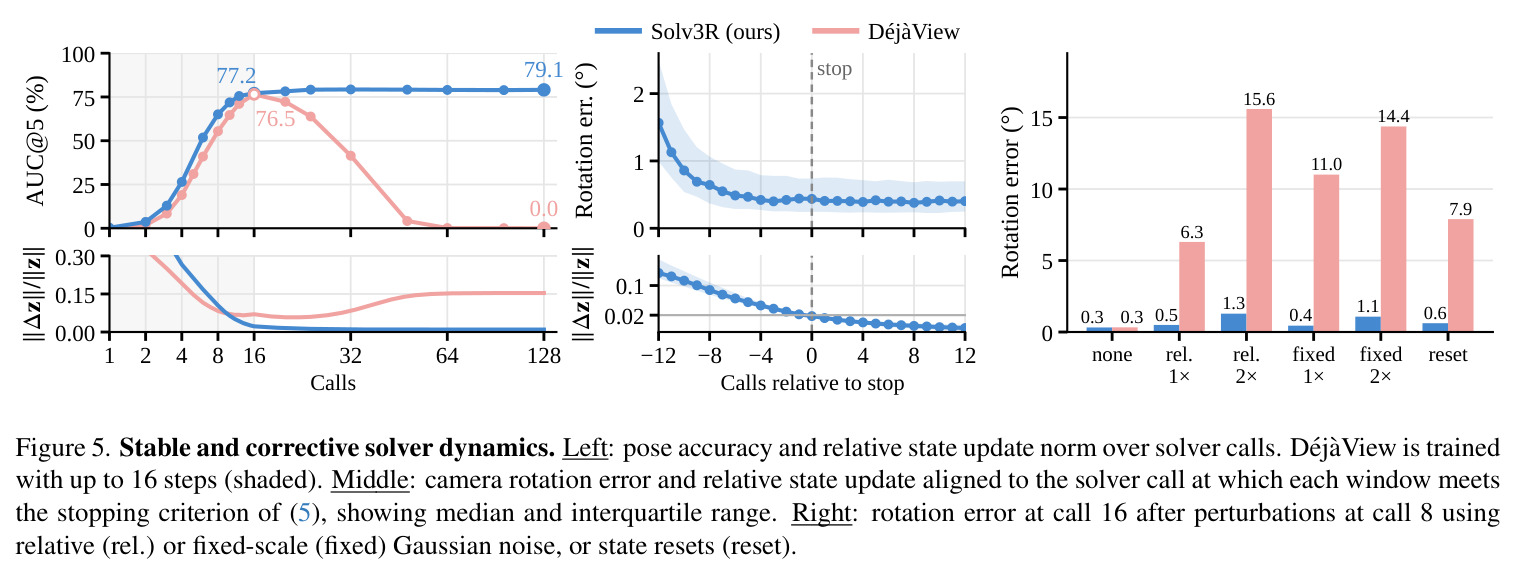
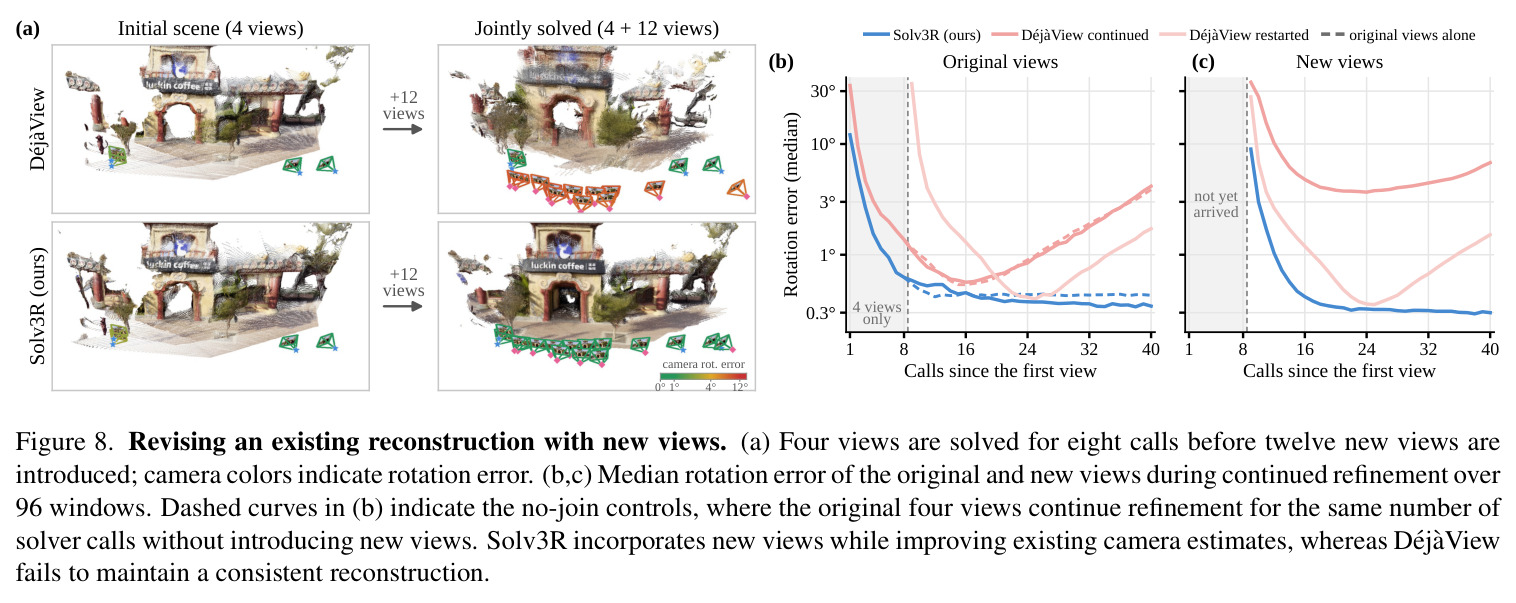
当前几何基础模型以一次前向传播输出全部几何:VGGT 用 1.26B 参数的堆叠 Transformer 直接预测相机位姿与点图,$\pi^3$、Depth Anything 3 等遵循同样范式。这在固定的小规模图像集上有效,但大规模重建超出其能力边界:当图像数量超过输入容量,或重建完成后又来了新视角(后续视频帧、另一段同一场景的拍摄),只能把新旧图像合并后整体重算一遍,无法复用已有计算。流式方法(CUT3R、TTT3R、Spann3R)逐帧更新循环状态避免重算,却只能处理严格按时间顺序到达的视角,无法乱序合并新图像,也不能回头修正已有估计。经典 SfM 本就靠迭代优化支持增量合并与持续细化,而学习式模型缺少一个可以在『任意中间状态』上继续求解的表示:VGGT 的中间 token 与层深度绑定,DéjàView 虽然共享权重做循环精化,但更新算子 $z^{k+1}=F_\theta(z^k; \tau_k)$ 以迭代步数 $\tau_k$ 为条件,状态与『它在第几步算出』绑定——一旦迭代超出训练的 16 步,AUC@5 从 76.5 崩到 0.0(Table 4),且无法在同一个求解调用里联合更新收到不同迭代次数的视角:Figure 3 中 4 个已解视角加 12 个新视角时,DéjàView 的旋转误差高达 3.67°。
本文的目标是本文要把多视图重建从『一次前向预测』重构为一个学习式的持续求解过程(solver):给定任意当前状态,同一个更新算子可以继续迭代直到收敛;收敛后继续迭代不再改变结果;状态被噪声扰动后,迭代能把解拉回来;新增视角时,旧视角从已解状态热启动、新视角从初始编码出发,所有视角在一次调用中被联合更新。作者的最终目标是让一个仅 117M 参数的模型、无需任何任务特定训练模块,统一覆盖四种重建模式——离线重建(一次看全部)、增量重建(成批加入新视角)、地图级重定位(冻结地图作上下文、只解查询帧)、流式重建(视频逐帧到达)——并在标准基准上与各领域的专用方法打平或更优,同时用更少的计算量和缓存完成这些任务。
与已有工作不同的是,独特切入点是把经典数值迭代求解器的『平稳性』(stationarity)同时当作架构约束和训练目标:Jacobi 法求解 $Ax=b$ 的更新 $x^{k+1}=\Phi(x^k; A, b)$ 不依赖迭代次数,因此天然具备不动点、纠错、延续三条性质。作者敏锐地指出:DéjàView 只共享权重是不够的——它的门控由步数 $\tau_k$ 计算,等于告诉网络『现在是第几步』,破坏了平稳性,所以权重共享本身给不了求解器性质(消融 Table 4 证实:给 DéjàView 换上同样训练方案仍会在 128 次调用时归零)。Solv3R 把步数条件门控替换为常数门控,使共享块成为真正的平稳算子 $\mathcal{T}_\theta$,再通过异构状态训练、扰动训练、随机监督深度把三条性质显式『灌』进网络。『几何基础模型应该是多视图求解器』这一视角,及其推论『状态可携带任意混合的计算历史』(由此直接导出 KV 缓存复用、warm-start、流水线吞吐 16×),是与所有已有工作的本质区别。
核心方法
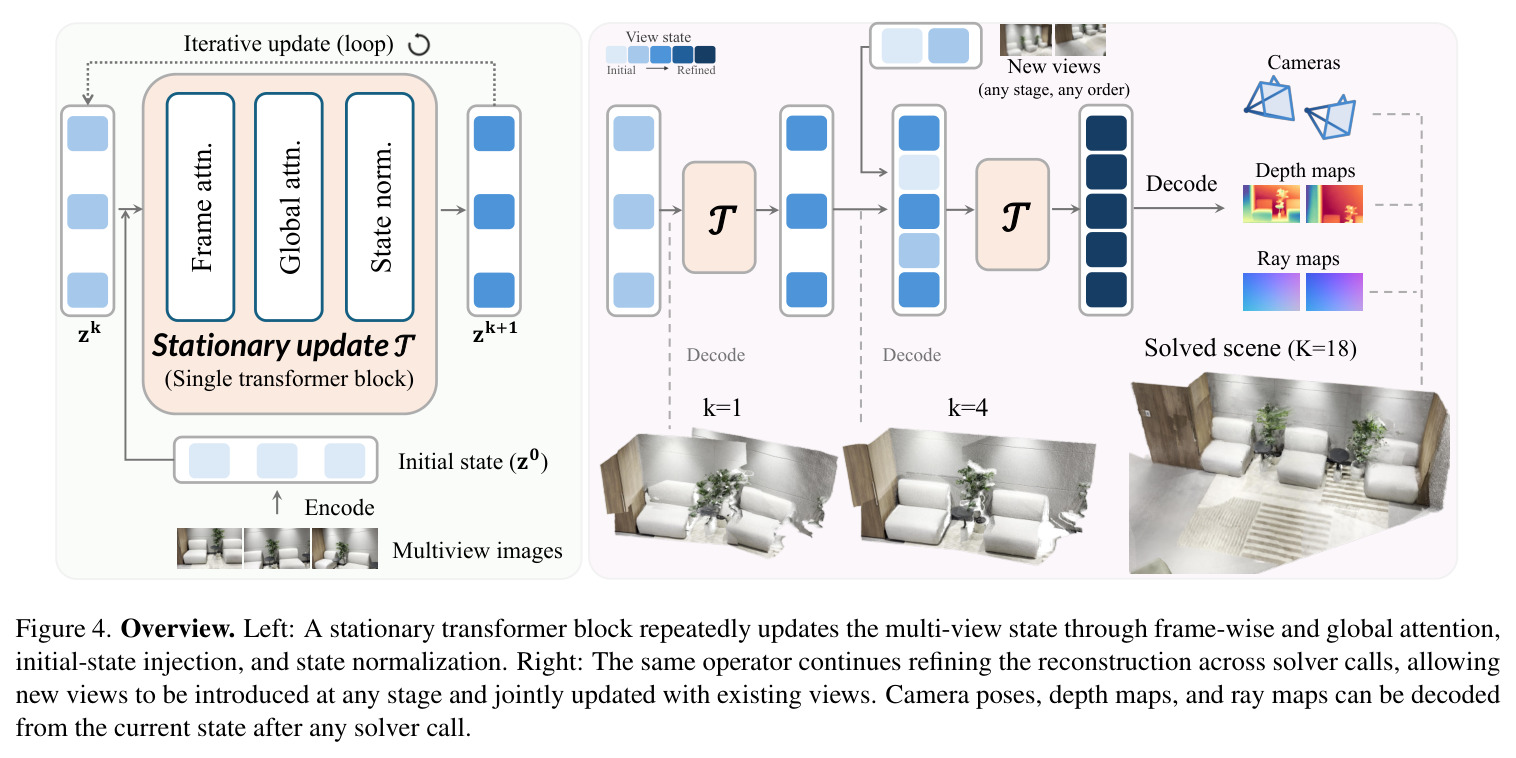
直觉上,多视图重建与 Jacobi 迭代求解线性方程组 $Ax=b$ 同构:输入图像是约束(对应 $A$ 与 $b$),多视图状态 $z$ 是当前解的估计,从状态解码出的相机位姿与深度图就是解。技术路线完全建立在 DéjàView 的循环 Transformer 骨架之上:冻结的图像编码器把 $N$ 张图(长边 504px)编码为初始状态 $z^0=E(I)$,之后反复调用同一个共享 Transformer 块(含帧内注意力与全局注意力)。Solv3R 对更新规则做两处关键修改:其一,去掉步数条件门控、换成可学习常数门控(初始化为 DéjàView 16 步门控的均值),使算子平稳、与调用次数无关;其二,每次调用都注入层归一化后的初始状态 $u=U_\theta(z^k + W\bar{z}^0)$,并把更新后的状态整体重标定到固定 RMS 标度 $z^{k+1}=\rho\, u/\lVert u\rVert_{\text{RMS}}$($\rho\approx 0.85$,训练前测量一次后固定)。前者让每次调用都能『看见』图像约束、防止误差跨调用累积,后者防止多次迭代后状态幅度漂移。整体训练目标为 $\mathcal{L}=\mathcal{L}_{\text{geo}}+\lambda_{\text{dist}}\mathcal{L}_{\text{dist}}$($\lambda_{\text{dist}}=0.5$),其中蒸馏项对齐 DéjàView 的 16 步预测以保留其几何先验。
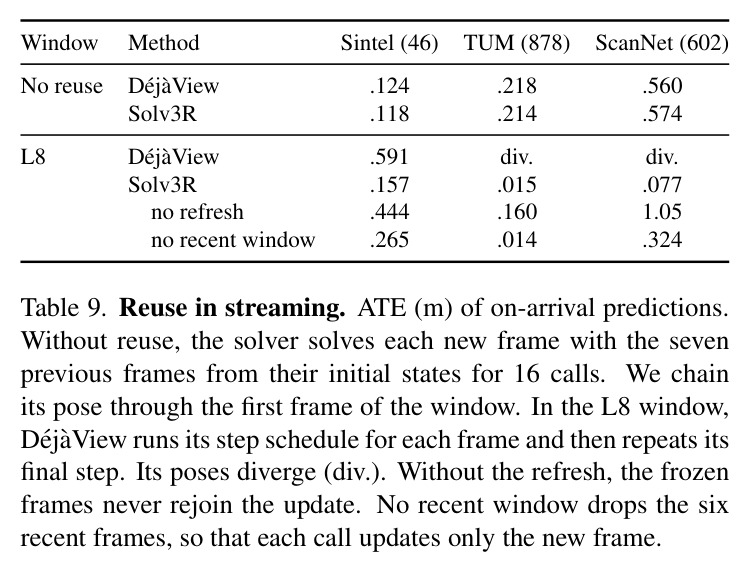
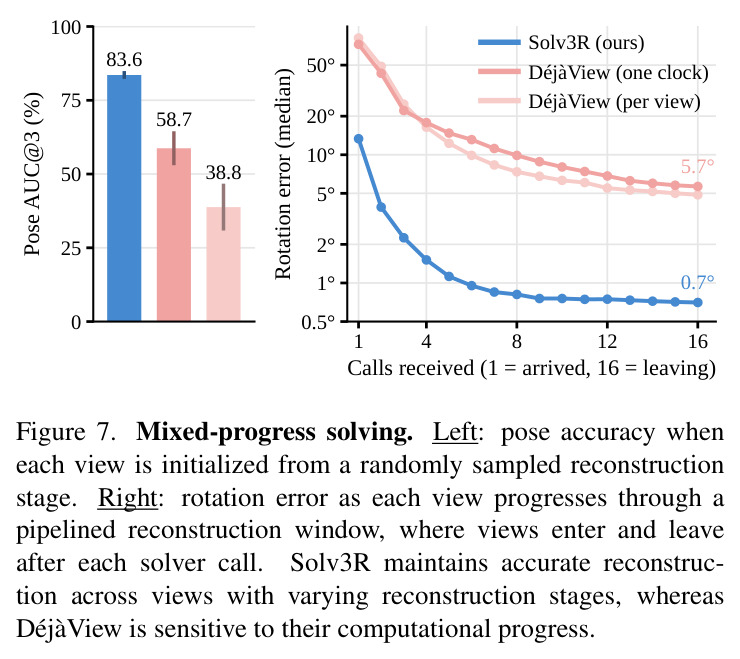
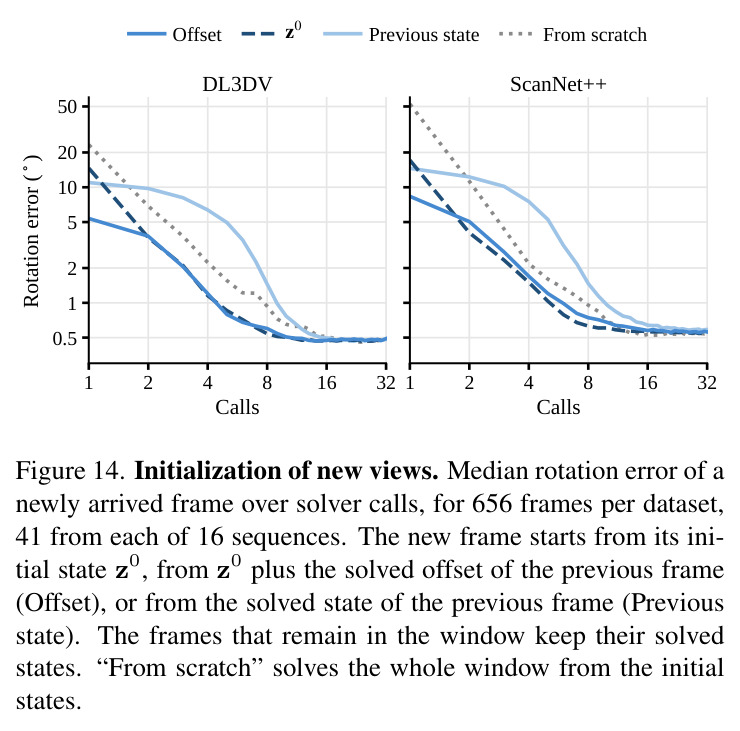
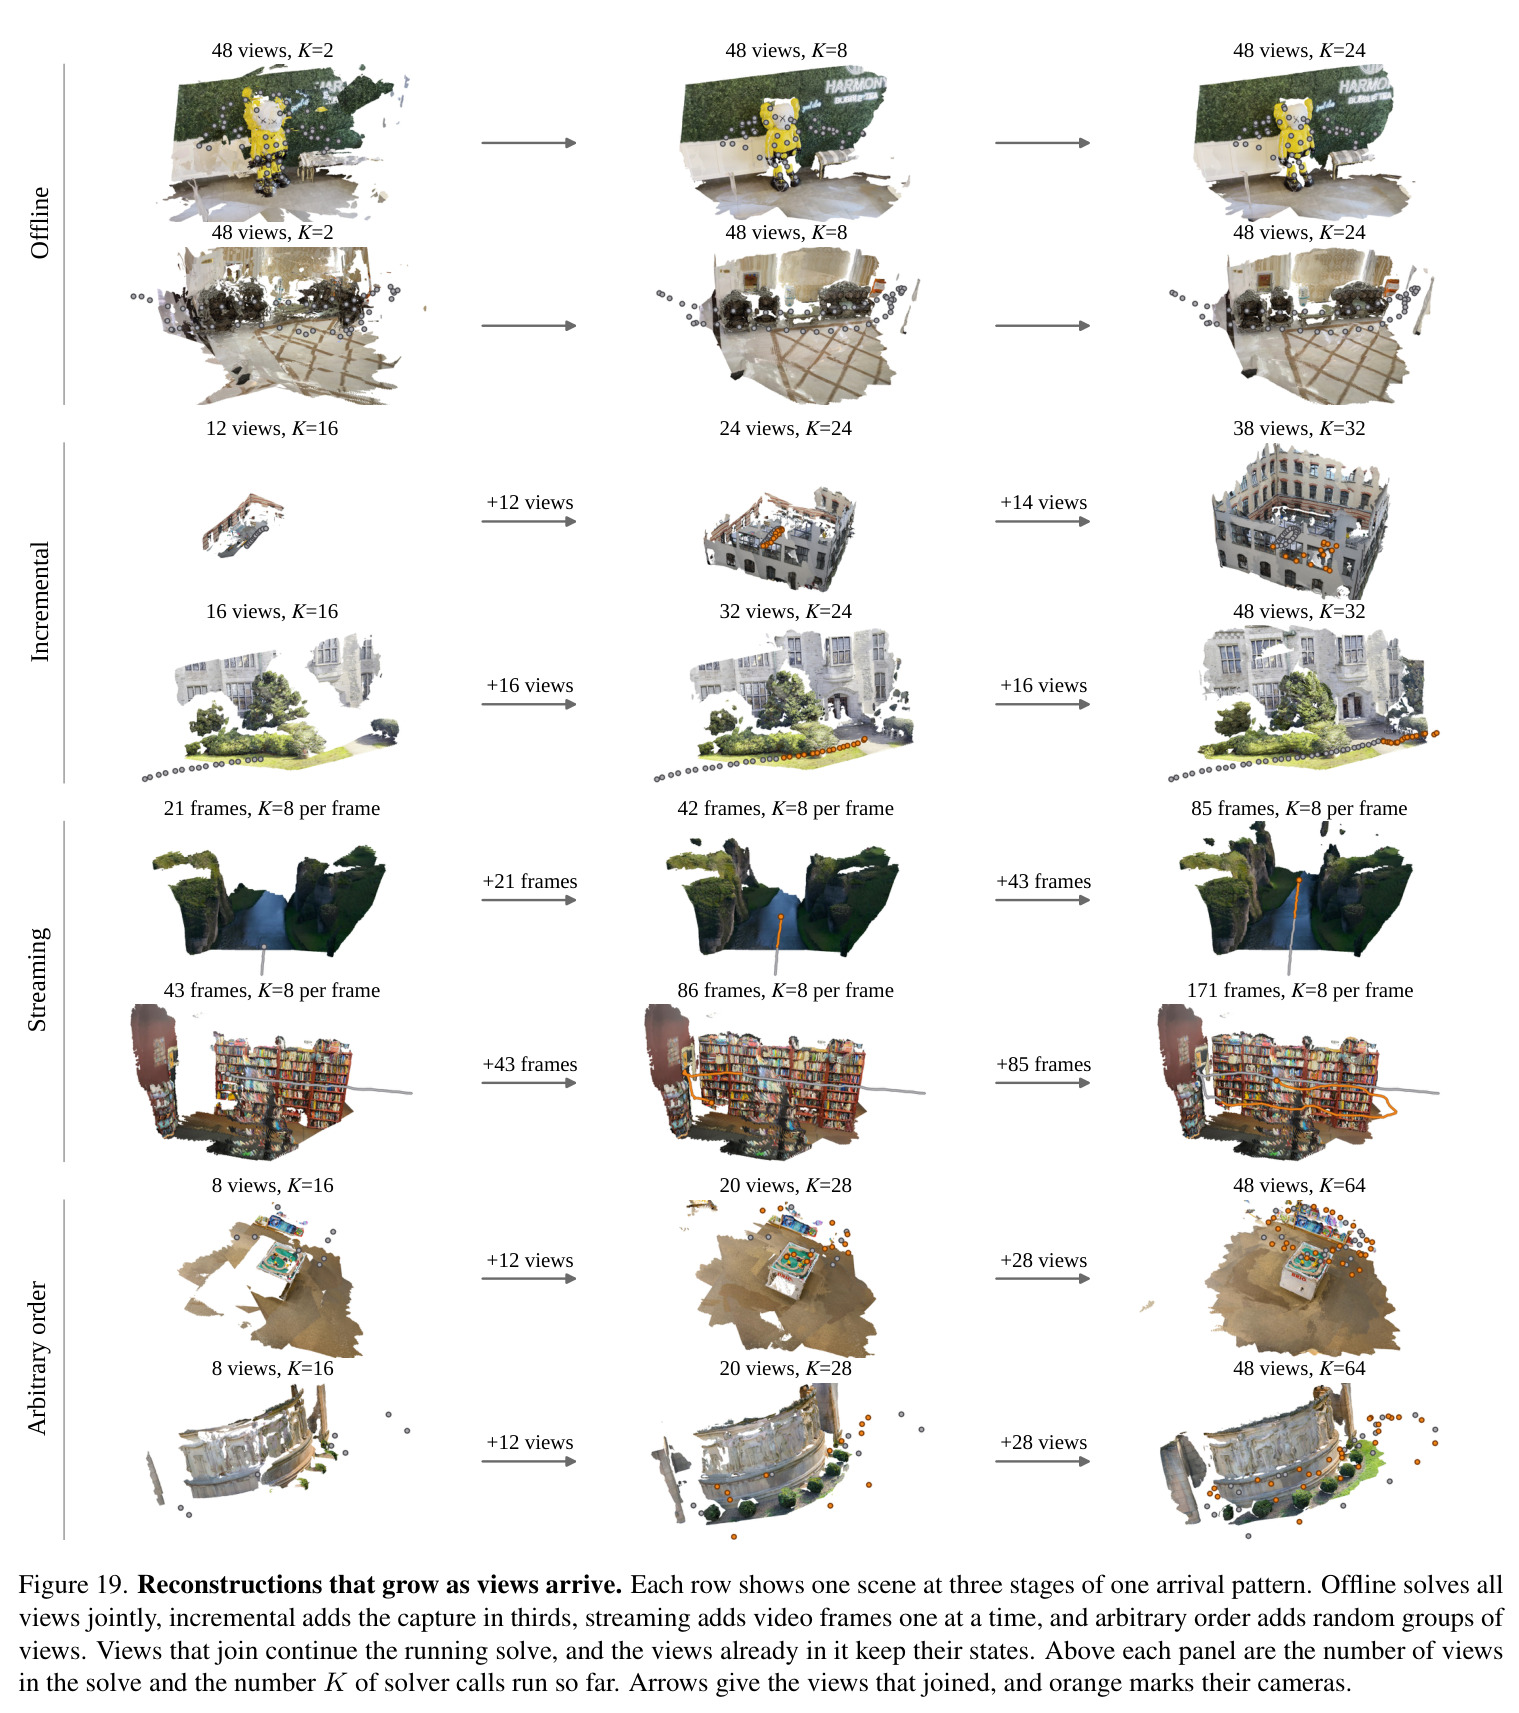
核心创新是『平稳更新算子 + 为求解器性质而设计的训练方案』的组合。与 DéjàView 的 $z^{k+1}=F_\theta(z^k; \tau_k)$ 不同,Solv3R 的 $\mathcal{T}_\theta$ 完全不知道自己处于第几次调用,因此状态 $z^k=(z_1^{[h_1]},\ldots,z_N^{[h_N]})$ 可以同时容纳收到 $h_i$ 次调用、处于任意精化阶段的视角,并被一次调用联合更新。论文特意证明这不是简单的权重共享:给 DéjàView 换上 Solv3R 的训练方案后,16/128 次调用的 AUC@5 为 73.5/19.3,128 次仍近归零,而平稳化 + 完整训练方案缺一不可。平稳性进一步转化为三项系统能力:(P1 稳定) 已解视角可冻结,其 KV 对只算一次、跨所有调用复用,缓存比逐层缓存小 16×;(P2 纠错) 流式模式下每 4 帧检查冻结视角是否与新观测矛盾,矛盾则重新激活并联合精化;(P3 延续) 新视角热启动,滑动窗口可以每次调用就推进一次(流水线式),吞吐较 DéjàView 提升 16×(端到端 10×)。
方法步骤详情
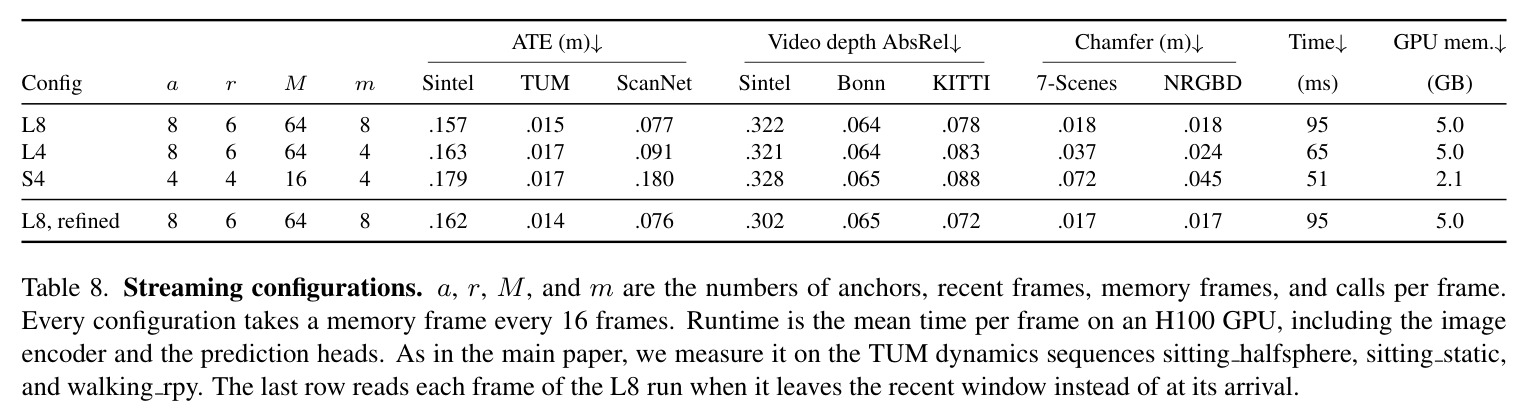
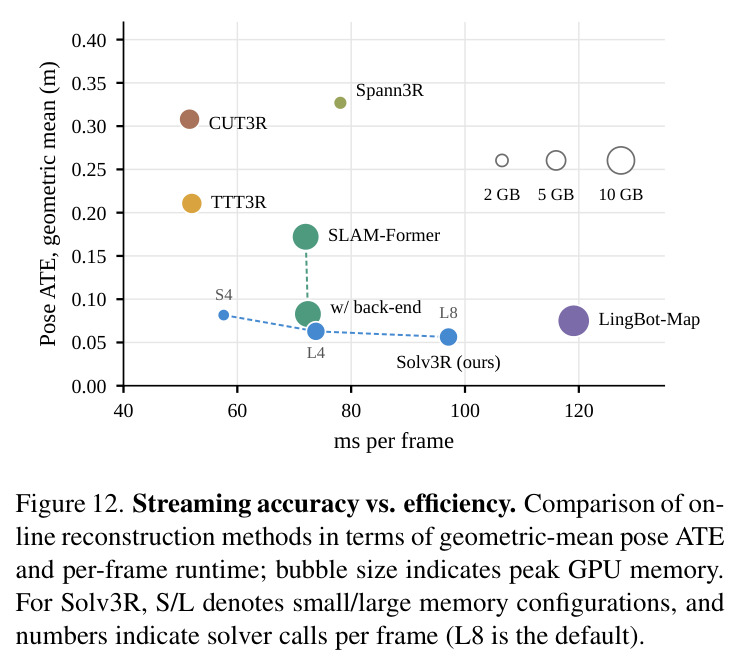
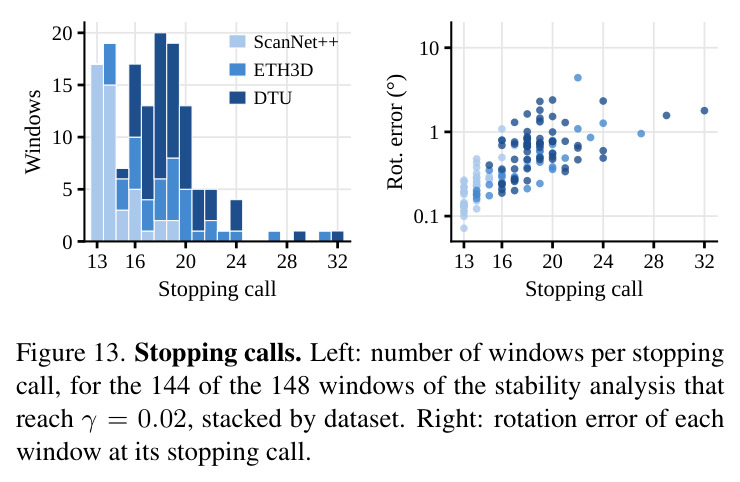
训练与推理的完整流程如下。(1) 初始化:图像经冻结编码器得到 $z^0=E(I)$。(2) 训练采样:每个窗口从 4–16、24–32、48–64 视角三档中抽取(概率 0.4/0.3/0.3);从 $z^0$ 出发先做 16–40 次无梯度调用,再做 8 次可微调用。(3) 扰动:以 0.15 概率在可微调用前扰动状态——加标准差 $\sigma\lVert z\rVert_{\text{RMS}}$($\sigma\sim U[0,0.5]$)的高斯噪声,或把至多一半视角重置回 $z^0$,分别模拟偏离解的状态和新旧视角混合。(4) 监督:在 rollout 的第 24–48 次调用之间随机选一步,从该步状态解码射线图、相机与深度并施加重建损失(射线方向/原点 L1、相机旋转测地损失、尺度对齐 log-L1 深度损失、多尺度深度梯度损失,另加两个尺度一致性项,权重各 1.5)。(5) 优化:只微调共享块、门控与投影 $W$,编码器和解码头冻结;AdamW,两阶段约 70k(batch 8)+20k(batch 32)迭代,8×H100 约一周。(6) 推理:自适应停止——每次调用后计算相对状态更新 $r_k=\lVert z^{k+1}-z^k\rVert_2/\lVert z^k\rVert_2$,当 $r_k<\gamma=0.02$(最少 4 次、至多 64 次)即停止;流式默认配置 L8 为 8 锚定帧 + 6 最近帧 + 64 记忆帧、每帧 8 次调用,95ms/帧。
技术新颖性
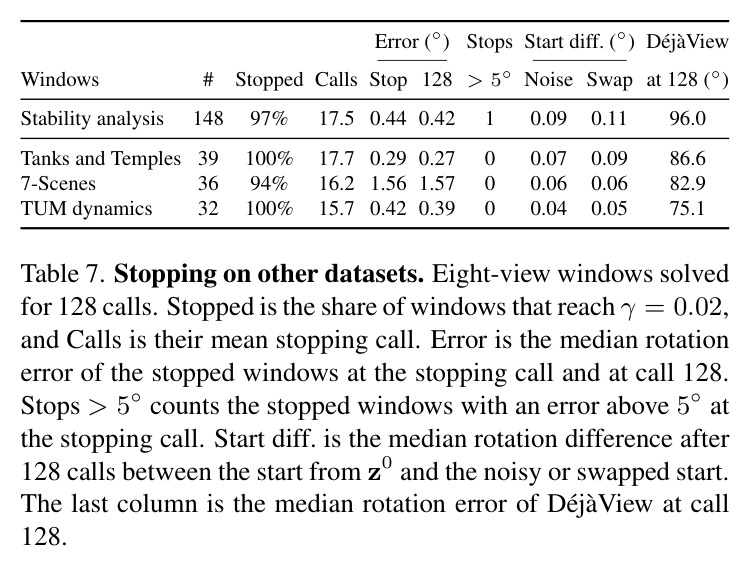
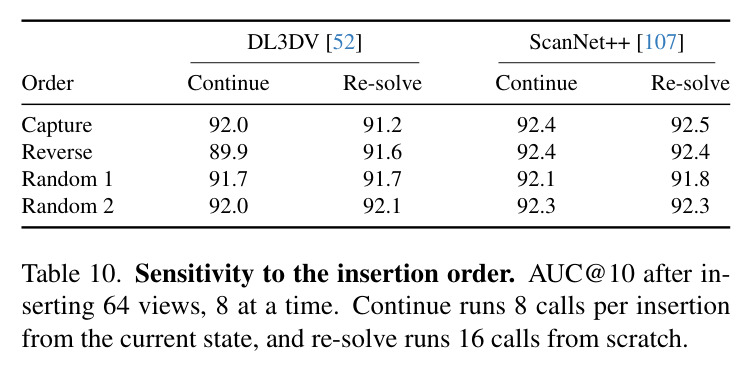
技术新颖性体现在四个层面。第一,把『求解器性质』作为可训练目标而非架构副产品:文献中的循环精化(RAFT、扩散模型、DéjàView)都隐式假设迭代次数固定,本文第一次显式要求不动点、纠错、延续三条性质,并在数据层面(异构状态 + 扰动训练)促成它们,这一点类似 denoising/Diffusion Forcing 的思想但服务于几何收敛。第二,状态与计算历史解耦:一般循环模型的状态隐含『我处于第 k 步』的信息,Solv3R 通过平稳化使状态成为无时间戳的解估计,这是 KV 缓存复用(16× 节省)、乱序视角插入鲁棒(Table 10 中 AUC@10 波动小于 2 分)、随机计算历史一致性(相机旋转平均仅差 0.08°)的共同根源。第三,效率结构:解算子平稳使『冻结上下文 + 只更新查询』成为合法操作,重定位与流式的 51ms 延迟、2.86 MB/view 缓存都源于此,而 DéjàView 单缓存复用直接失败(召回 0%)。第四,工程化的收敛控制:用状态变化量 $r_k$ 作为免费的收敛信号做自适应停止,平均 17.5 次调用即达到与固定 64 次相同的精度(中位旋转误差 0.44° vs 0.43°),把『何时停止』从超参变成了运行时量。
实验结果
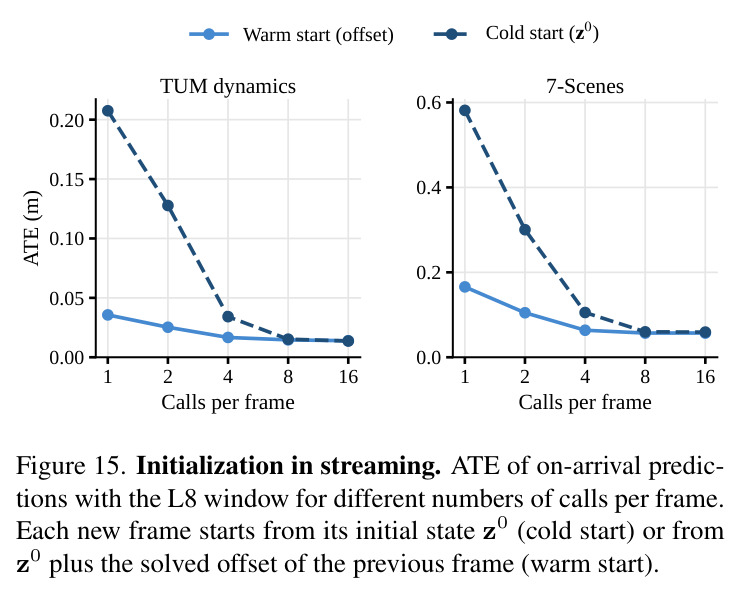
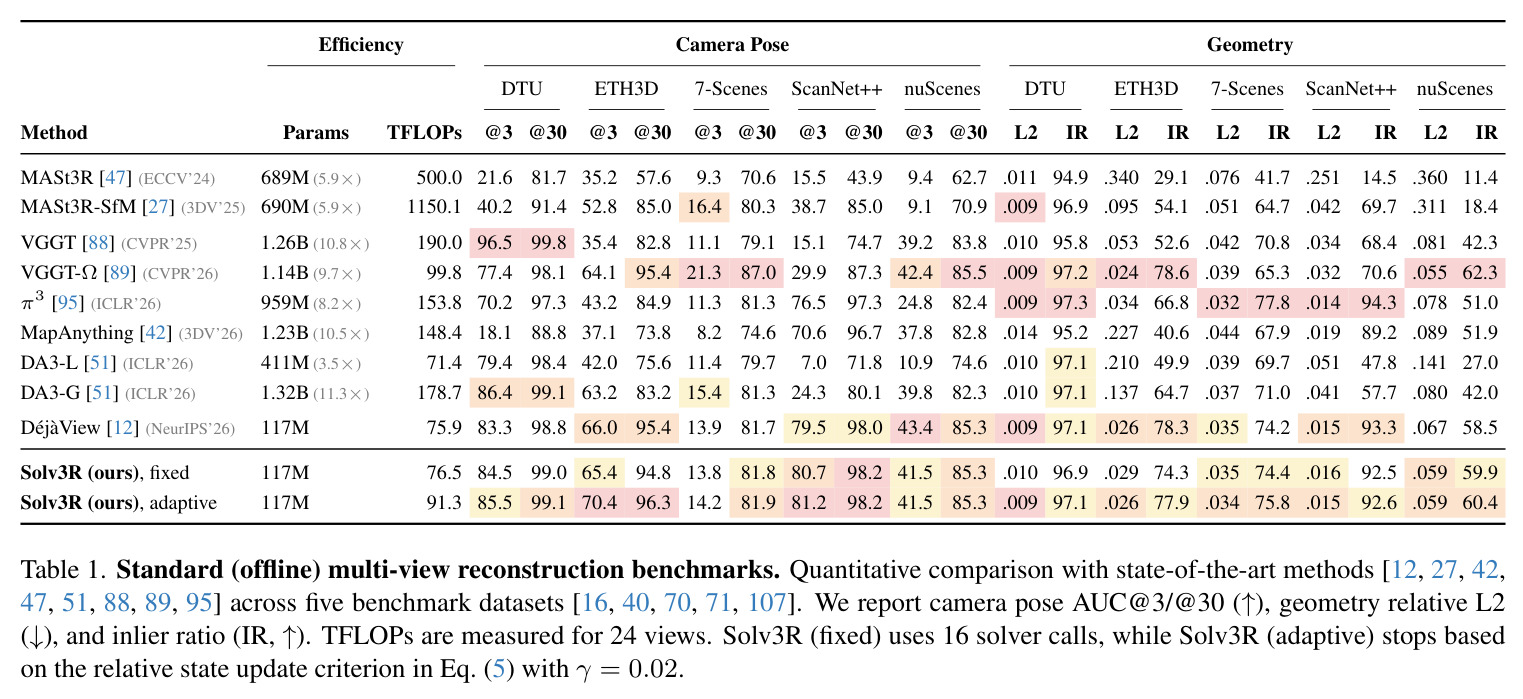
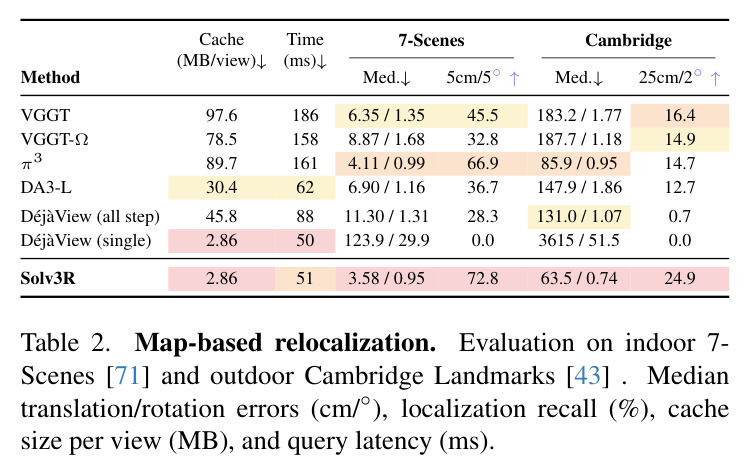
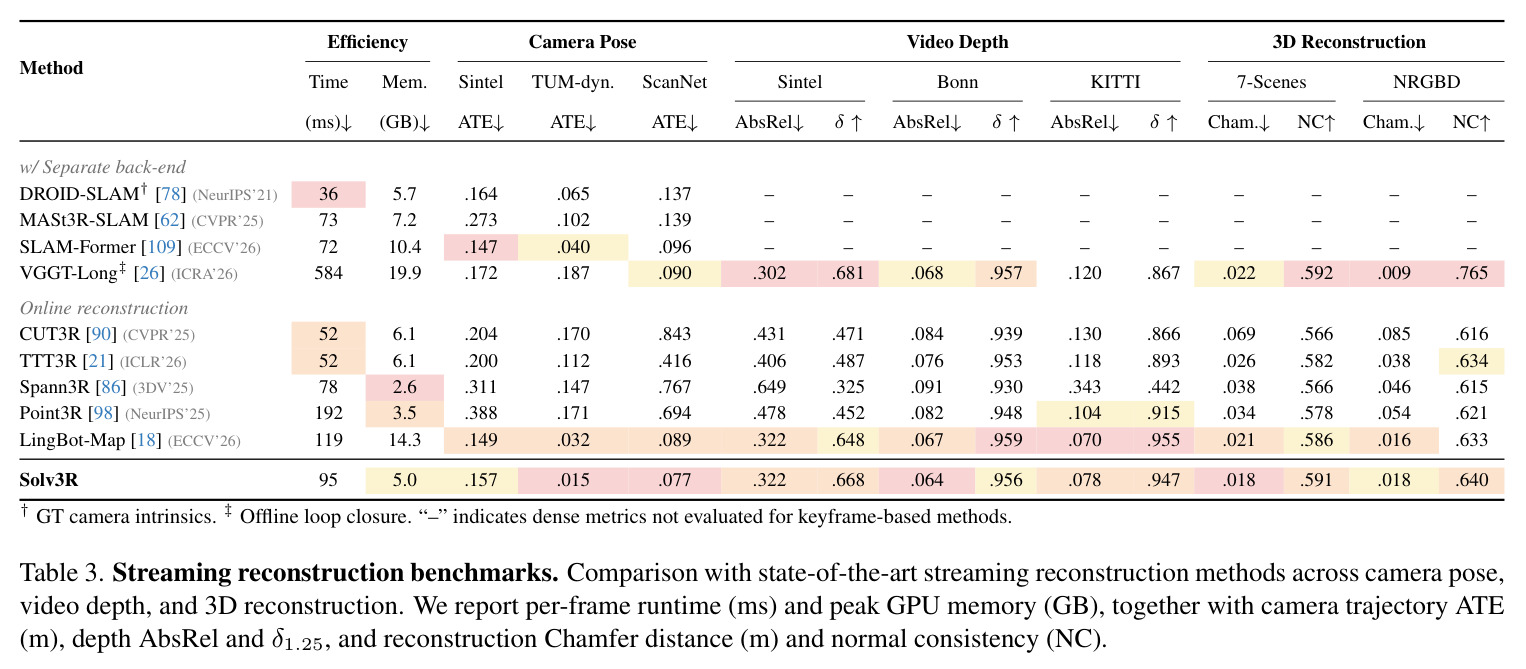
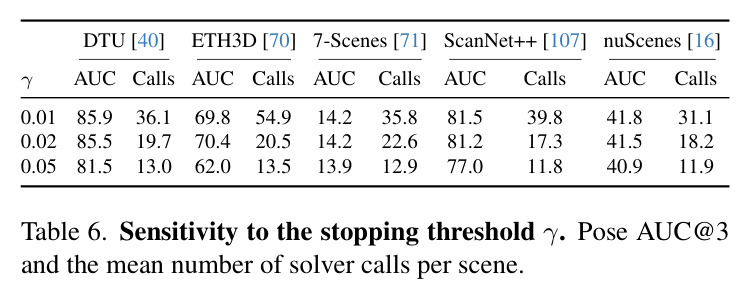
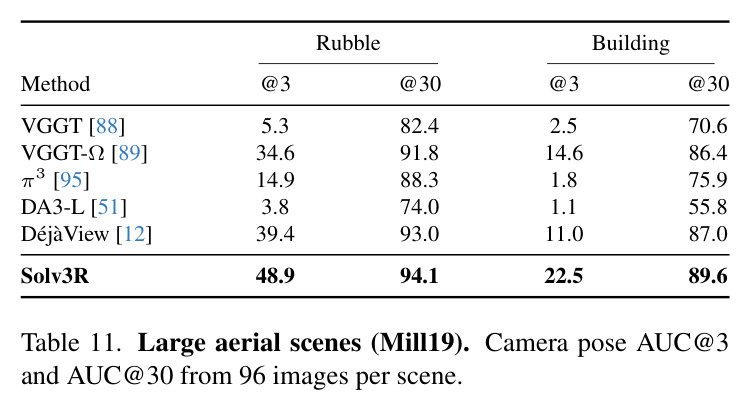
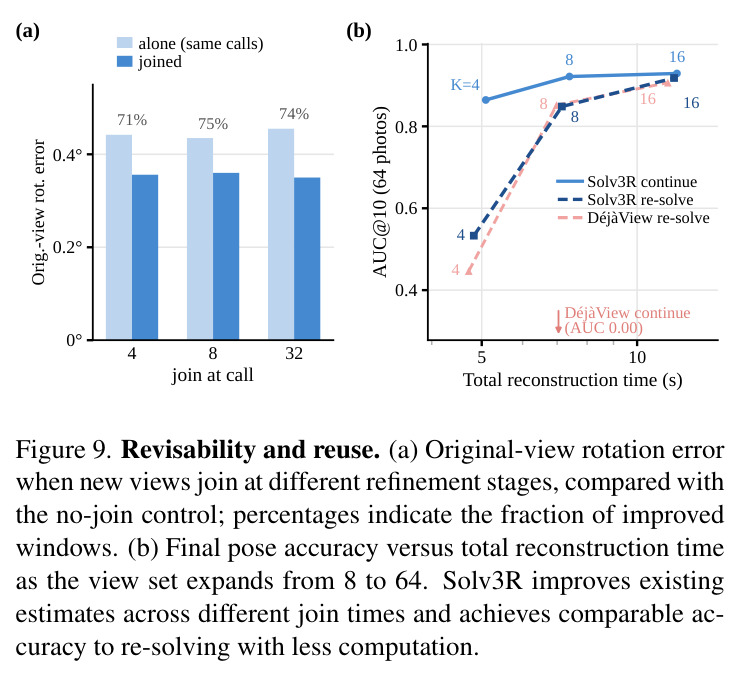
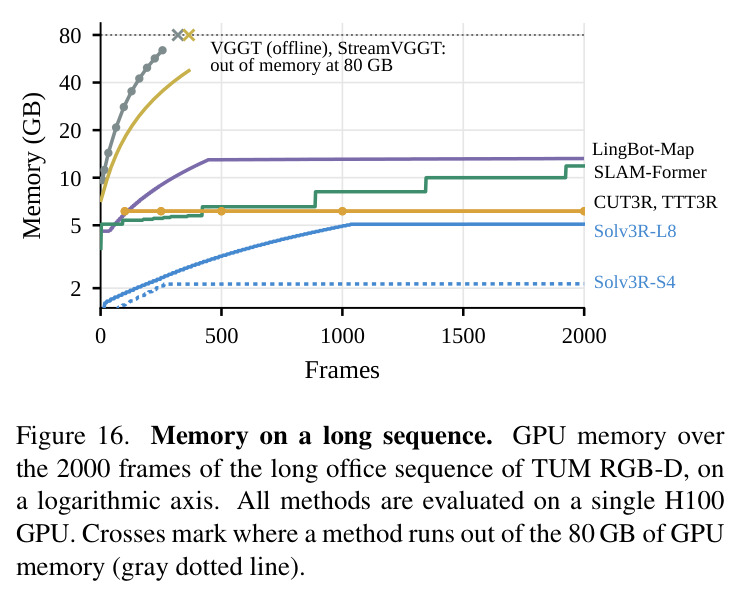
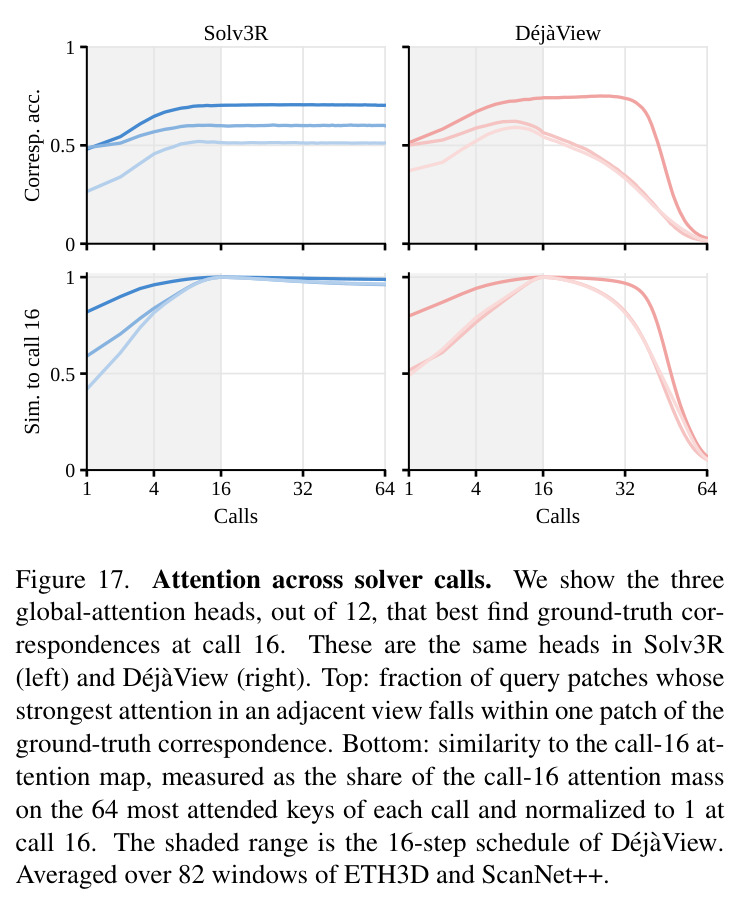
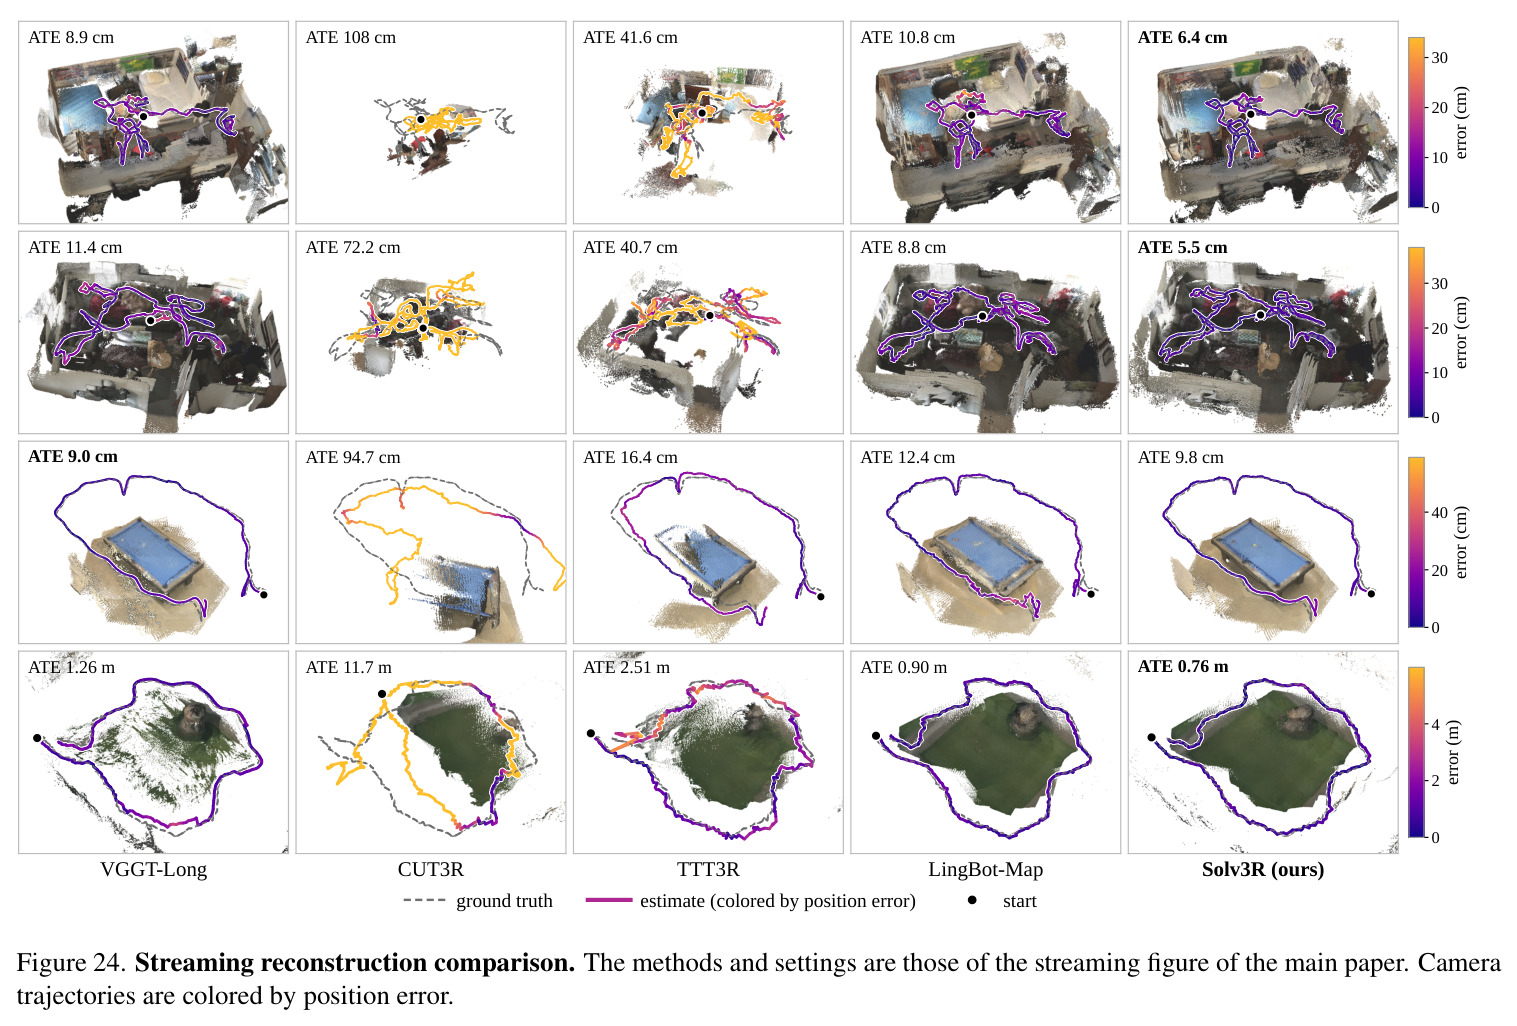
实验可分五组看。(1) 离线重建(Table 1):117M 参数的 Solv3R(自适应停止)位姿 AUC@3 为 DTU 85.5、ETH3D 70.4、7-Scenes 14.2、ScanNet++ 81.2、nuScenes 41.5;与 10.8× 参数的 VGGT 相比,ETH3D 高 35.0 分、ScanNet++ 高 6.5 分,DTU 低 11.0 分;同预算(16 次调用)下与 DéjàView 相当或略优(DTU 84.5 vs 83.3),几何上 nuScenes 相对 L2 0.059、内点率 60.4%,优于 DéjàView 的 0.067/58.5%。(2) 求解器动力学(Figures 5–7):148 个八视角窗口中 144 个在 64 次内到达停止准则(平均 17.5 次),其中 143 个(99.3%)旋转误差低于 5°;噪声/重置扰动后 8 次调用内恢复而 DéjàView 不能(Figure 5 右:Solv3R 0.3–0.5° vs DéjàView 6–15°);混合进度求解在不同初始化下相机旋转平均仅差 0.08°;流水线式推理使每秒处理帧数提升 16×(端到端 10×)。(3) 增量重建(Figures 8–9):4 视角解 8 次后加入 12 新视角,原视角误差继续下降,no-join 对照证明是新观测在纠错而非单纯多算;从 8 视角扩到 64 视角、每次插入 8 次调用的延续式求解 AUC@10 达 92.2,与每次 16 次调用的从头求解(91.8)相当但省一半计算。(4) 重定位(Table 2):7-Scenes 5cm/5° 召回 72.8%(中位 3.58cm/0.95°)、Cambridge 25cm/2° 召回 24.9%,均最高,缓存仅 2.86 MB/view;只复用单步缓存的 DéjàView 召回 0%。补充的 Mill19 航拍(Table 11)上 Rubble AUC@3 48.9 全面领先(DéjàView 39.4、VGGT 5.3)。(5) 流式(Table 3):TUM dynamics ATE 0.015m、ScanNet 0.077m、Sintel 0.157m,KITTI 深度 AbsRel 0.078,7-Scenes 重建 Chamfer 0.018m,95ms/帧、5.0GB 显存,且无任何流式专门训练;长序列中状态复用带来 7×(ScanNet)到 >10×(TUM)的 ATE 改善,显存约 1030 帧后封顶,而 VGGT 在 320 帧、80GB 时 OOM。消融(Table 4):最终模型在 16/128/1024 次调用的 AUC@5 为 77.2/79.1/78.8,扰动后误差 0.22°,输入注入、状态归一化、随机深度预调用任一去掉都会在 1024 次调用时归零。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 离线多视图重建·相机位姿(ETH3D) | 位姿 AUC@3 (↑) | 70.4(Solv3R 自适应,117M 参数) | VGGT 35.4(1.26B)/ MASt3R-SfM 52.8 / DéjàView 66.0 | 较 VGGT +35.0,较同规模 DéjàView +4.4 |
| 离线重建·相机位姿(DTU) | 位姿 AUC@3 (↑) | 85.5(自适应)/ 84.5(固定 16 次调用) | VGGT 96.5 / DéjàView 83.3 | 同预算较 DéjàView +1.2,参数量仅 VGGT 的 1/11;但纹理丰富的 DTU 上仍落后 VGGT 11 分 |
| 地图级重定位(7-Scenes) | 5cm/5° 召回率 (↑) | 72.8%,缓存 2.86 MB/view,51ms/查询 | $\pi^3$ 66.9%(89.7 MB/view)/ VGGT 45.5% / 单步缓存 DéjàView 0% | 较最强基线 +5.9 分,缓存缩小约 31× |
| 流式重建·相机轨迹(TUM dynamics) | ATE (m, ↓) | 0.015 | TTT3R 0.112 / LingBot-Map 0.032 / VGGT-Long 0.187 | 较 TTT3R 好 7.5×、较 LingBot-Map 好 2.1×,显存 5.0GB vs 14.3GB |
| 增量重建(8→64 视角) | 位姿 AUC@10 (↑) | 92.2(延续式,每次插入 8 次调用) | 从头重解 84.8(同样 8 次)/ 91.8(16 次) | +7.4,或以一半计算量达到相当精度 |
| 大规模航拍(Mill19 Rubble,96 图单窗口) | 位姿 AUC@3 / AUC@30 (↑) | 48.9 / 94.1 | DéjàView 39.4 / 93.0;VGGT 5.3 / 82.4 | +9.5 AUC@3,大幅领先所有基线 |
| 长航时流式内存效率 | 峰值 GPU 显存 (GB) | 5.0(L8,约 1030 帧后封顶) | VGGT 80GB 下 320 帧 OOM;StreamVGGT 365 帧 OOM;LingBot-Map 显存为 Solv3R 两倍以上 | 有界显存下无限长序列流式 |
局限与改进
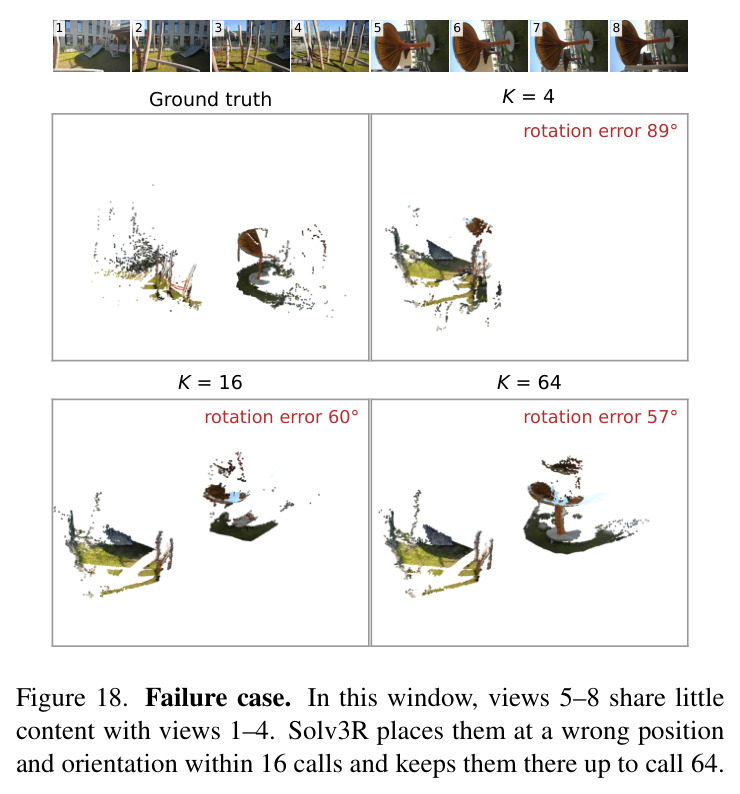
作者承认的局限:求解器可能停在次优不动点——失败案例(Figure 18)中两个内容重叠很少的视角组被放到错误的位置和朝向,16 次调用时旋转误差 89°,迭代到 64 次仍有 57°,说明纠错性质对『约束不足』的问题无能为力;停止准则基于状态变化而非几何误差,148 个窗口中有 1 个在满足准则的情况下误差仍超过 5°(不过 143/144 都低于 5°);阈值 $\gamma=0.02$ 靠经验选择,Table 6 显示收紧到 0.01 需要 1.6–2.7 倍调用数、放松到 0.05 损失 4–8 个 AUC 点。我自己的观察:其一,模型容量和输入分辨率(117M、长边 504px)限制了精度上限,DTU 上 AUC@3 落后 VGGT 11 分,7-Scenes 的 AUC@3 只有 14.2,小基线、纹理丰富场景仍有差距;其二,整个方法依赖 DéjàView 预训练权重初始化和蒸馏损失,『平稳求解器能否从头训练』这个问题没有回答(Figure 6 的 from scratch 指冷启动推理,而非从头训练模型);其三,训练数据以室内外常规场景为主,跨域泛化(医学影像、水下、非刚体场景)未评估,动态场景被显式排除在假设之外;其四,流式的锚定/记忆/刷新机制($a=8$、$r=6$、$M=64$、每 4 帧检查一次)有多个手工超参,剧烈场景切换或大比例地图增长时的行为未充分讨论。
独立分析的弱点
(1) 错误不动点问题:当视角组之间内容重叠不足时,约束结构实际上是断开的,平稳算子会『忠实』地停留在错误解上(Figure 18:误差 89°→57° 持续不收敛)。改进方向:推理时监测跨视角组注意力/对应置信度,检测到约束断裂时触发额外视角检索、匹配式重初始化或多假设随机重启。(2) 停止信号与几何误差脱钩:$r_k$ 小不代表误差小(失败窗口停在了 >5° 的解上)。改进方向:用多次轻量扰动的状态方差、或解码几何的自一致性作为更可靠的停止与置信度信号。(3) 容量与分辨率瓶颈:117M 参数、504px 输入在小基线/纹理丰富场景(DTU、7-Scenes)落后大模型。改进方向:验证平稳训练范式在 1B 级参数和高分辨率下是否仍成立,研究『平稳性 vs 模型规模』的 scaling 行为。(4) 手工流式机制:锚定帧数、记忆帧保留间隔 $s=16$、每 4 帧的刷新检查都是固定超参,遇到剧烈场景切换、长走廊等退化结构可能失效。改进方向:引入可学习的记忆写入/淘汰策略,让模型自己决定何时冻结、何时激活。(5) 训练依赖教师:蒸馏损失 $\lambda_{\text{dist}}=0.5$ 与 DéjàView 初始化意味着方法继承教师的偏差与局限,纯从头训练的平稳求解器尚未验证,也未探索与经典优化后端(如 BA)的混合。
未来方向
作者提出的展望:这种『维护并持续修订演化状态』的范式可推广到视觉-语言模型、机器人和世界模型——那里同样需要能在任意状态下继续求解的表示。基于论文成果可自然延伸的方向:(1) 理论层面把收敛性分析(算子作为收缩映射的谱性质)引入学习式求解器,解释哪些训练配方能产生真正的收缩,并给出收敛速度保证;(2) 把 Solv3R 作为大场景/终身 SLAM 的几何后端,结合回环检测修正全局漂移,这正好补足其长程一致性的短板;(3) 与可微渲染或高斯泼溅结合,把渲染残差作为新的约束项反馈进求解器,实现观测驱动的闭环纠错;(4) 探索平稳算子与非平稳可学习调度的混合——平稳性保证可延续性,步数信息或许能加速初期收敛;(5) 扩展到动态场景:把时间作为状态的新维度,使『演化状态求解』能处理运动物体;(6) 用同一范式统一更广的几何任务族,如位姿图优化、多传感器(LiDAR/IMU/事件相机)融合的联合求解,以及把 KV 缓存复用思想推广到可复用的任务级记忆。
复现评估
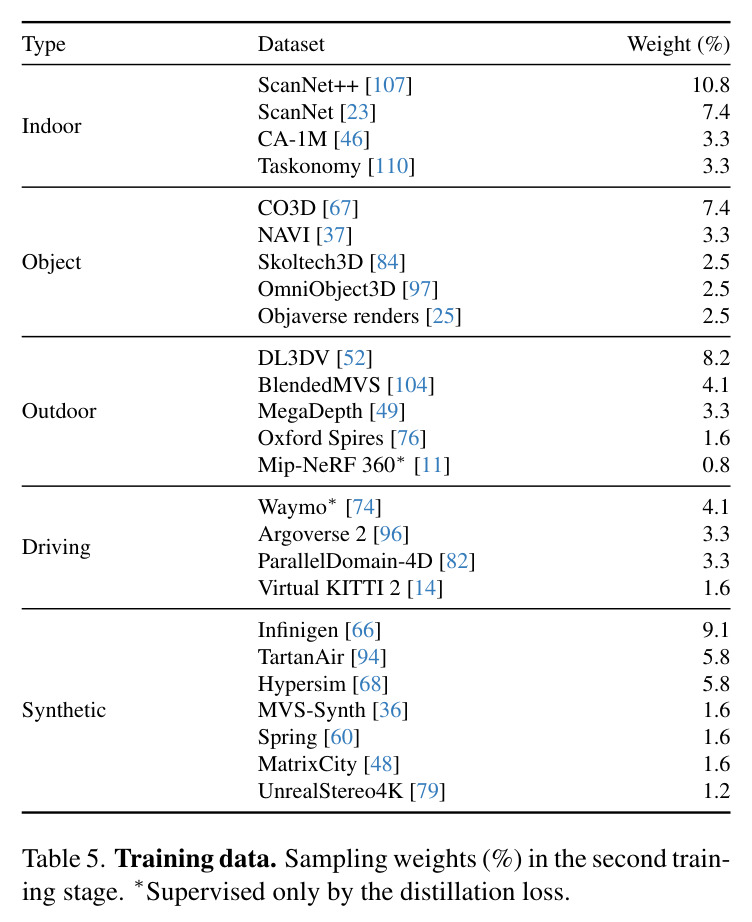
复现条件总体较好。论文承诺开源代码与模型(ubc-vision.github.io/solv3r),补充材料给出了训练与评估的几乎全部细节:117M 参数、输入长边 504px、从公开的 DéjàView 预训练权重出发只微调共享块/门控/投影、两阶段训练(约 70k 迭代 batch 8 + 约 20k 迭代 batch 32)、AdamW 学习率 $2\times10^{-5}$(共享块与投影)和 $2\times10^{-4}$(门控)、EMA 衰减 0.999、扰动概率 0.15、$\lambda_{\text{dist}}=0.5$、目标 RMS $\rho\approx0.85$,以及覆盖室内/物体/室外/驾驶/合成约 25 个数据集的采样权重表(Table 5)。算力门槛中等偏高:完整训练约需 8×H100 一周;但若拿到开源权重,所有评测(各 benchmark 的窗口划分、指标定义、流式配置 L8 = a8/r6/M64/m8 都写明了)在单张 H100 上即可完成,流式推理 95ms/帧。主要风险点:依赖 DéjàView 权重作为初始化和蒸馏教师;训练数据包含 ScanNet++、DL3DV 等需申请的数据集,数据准备成本不低;148 个求解器分析窗口的挑选等评估细节需要仔细对照协议。总体属于『给出权重即可较容易复现推理结果,从头训练需中等规模算力』的档位。
论文图表
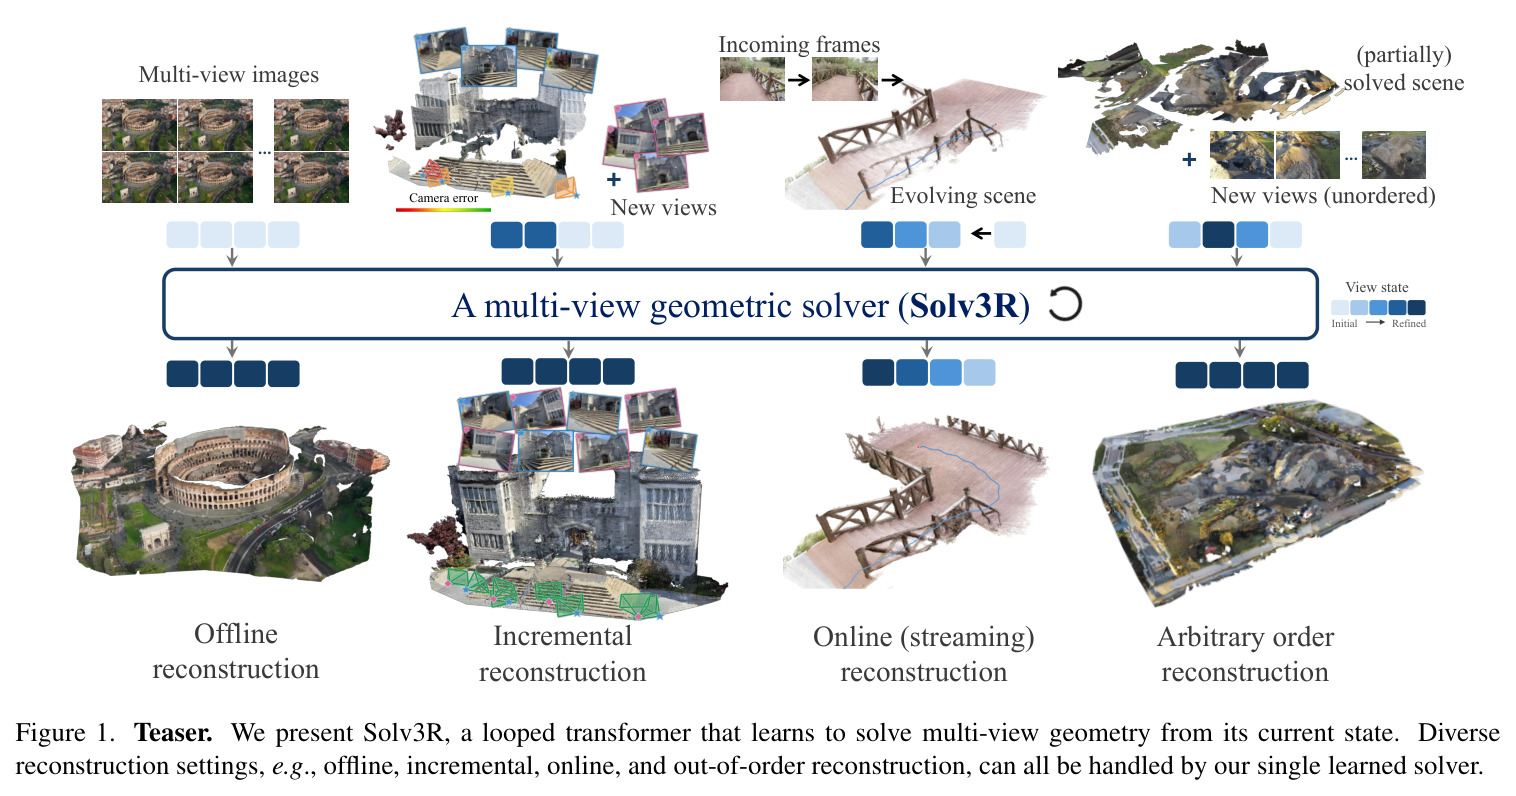
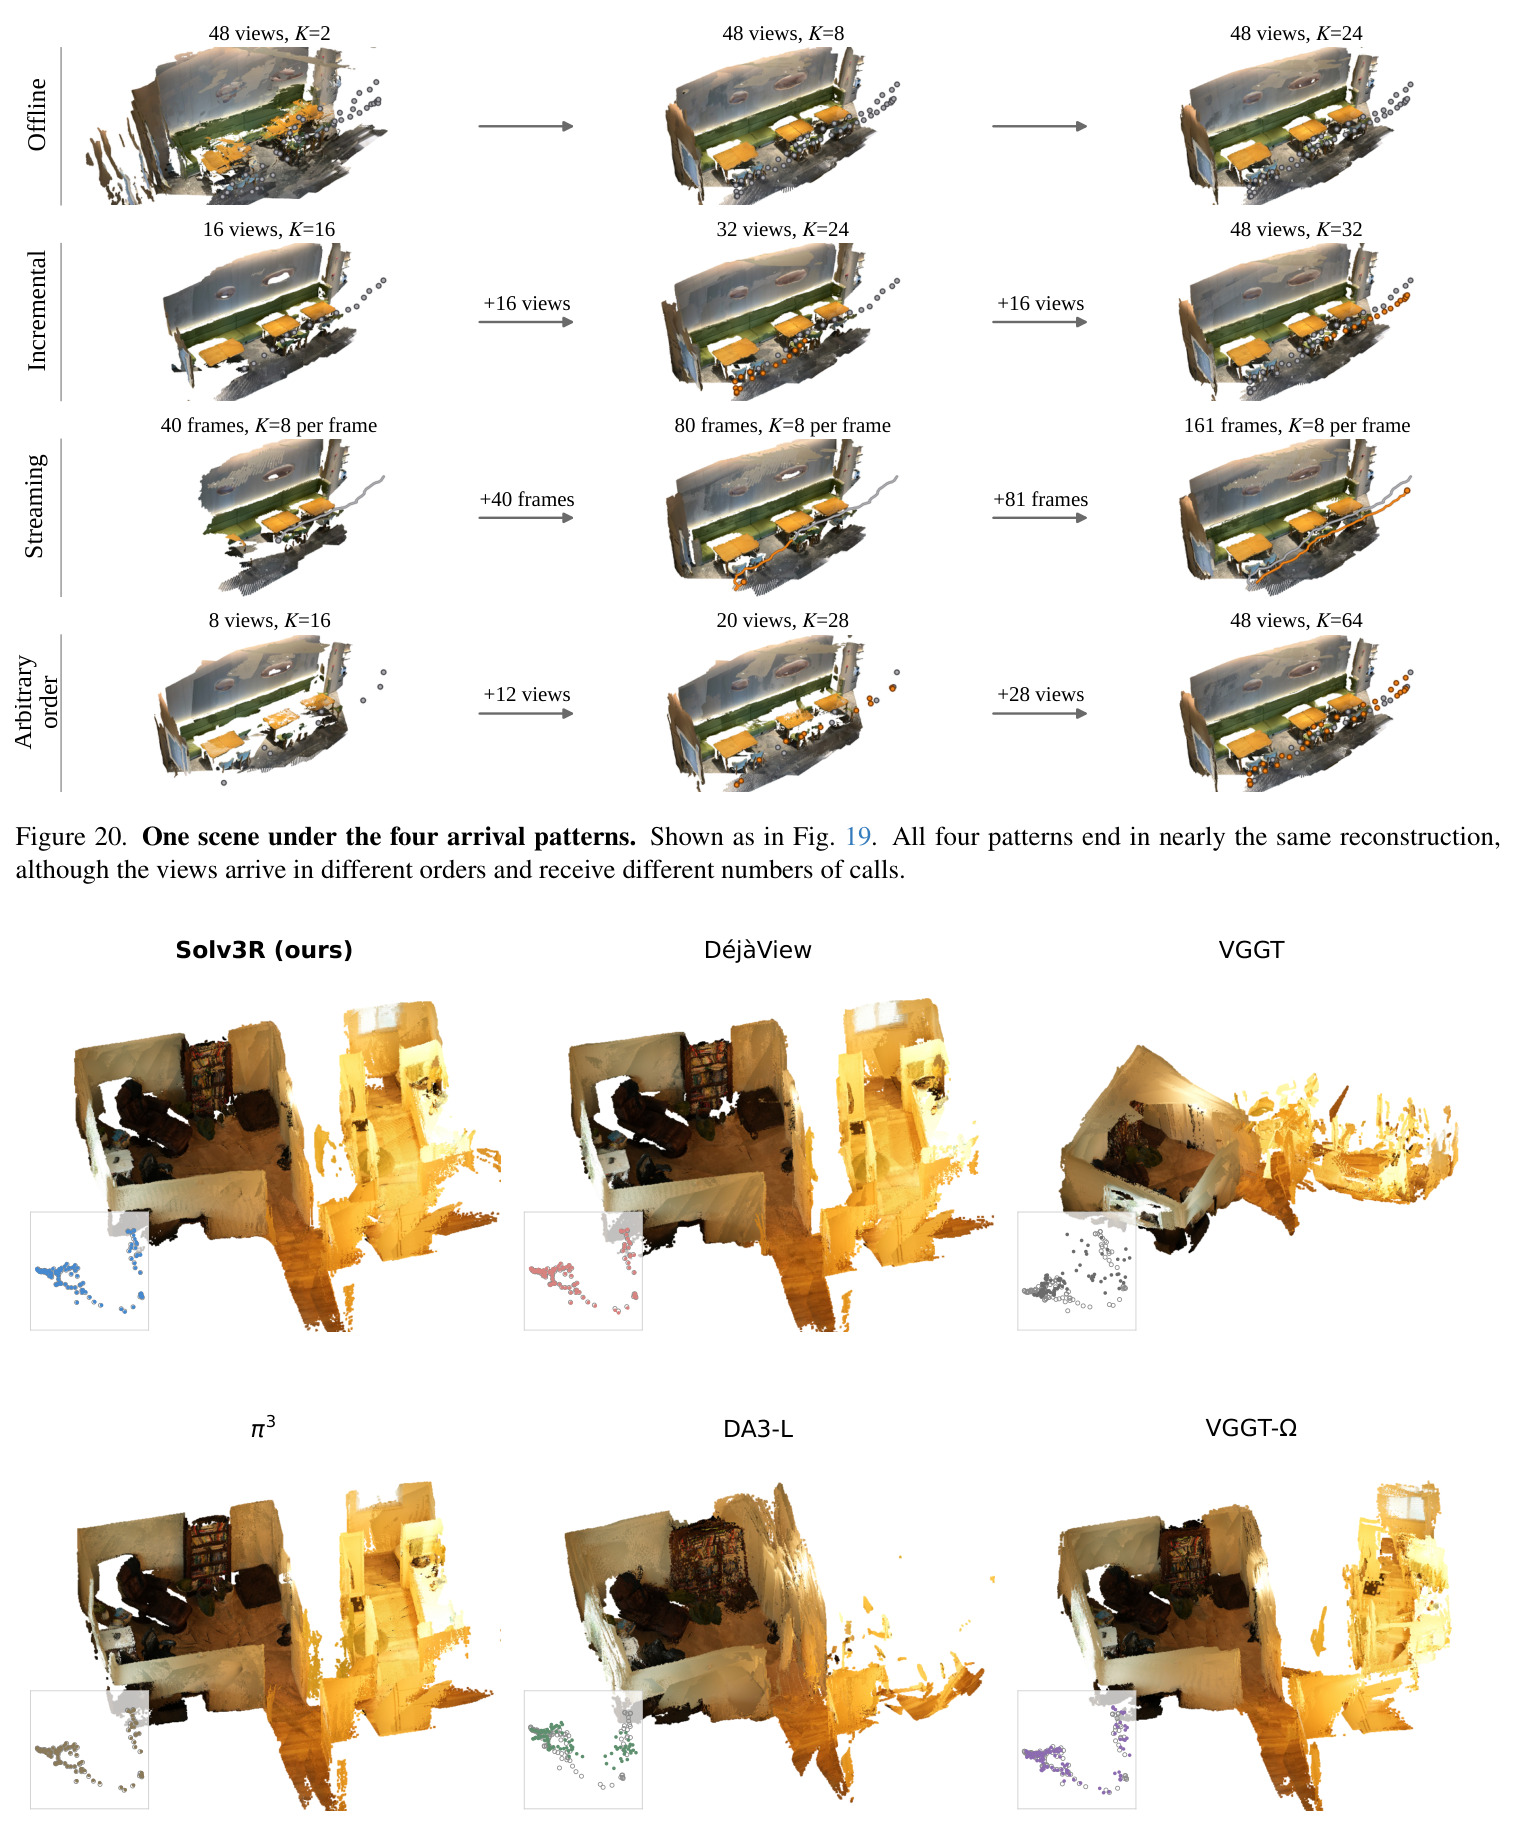
多视角图像输入 Solv3R 后得到部分求解的场景(相机误差标注),新视角可随时加入并与演化中的场景被(部分地)联合求解;底部一排示意同一求解器支持 offline / incremental / online streaming / arbitrary order reconstruction。
一图定位论文卖点:不是又一个前馈重建模型,而是可复用的几何求解器,四种模式无需任务特定训练或模块。
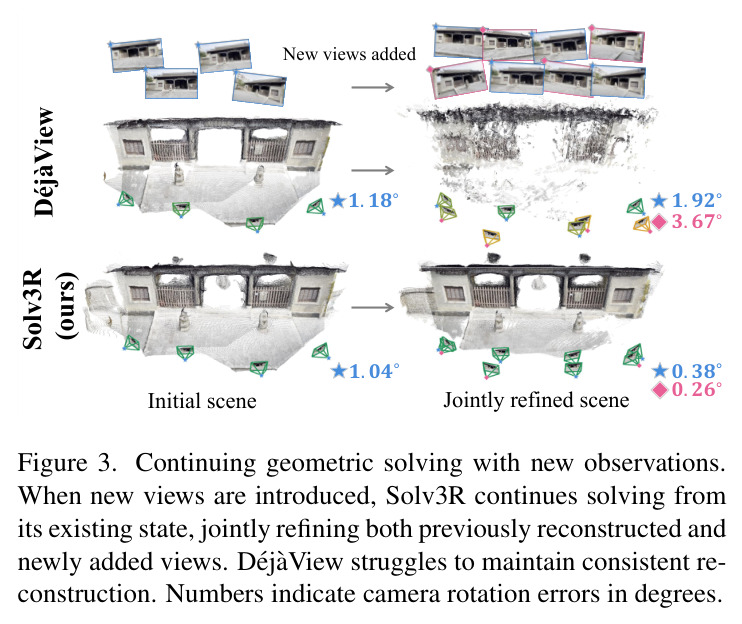
4 个已解视角加入 12 个新视角后联合精化:DéjàView 的相机旋转误差为 3.67°/1.18°/1.92°,Solv3R 为 1.04°/0.38°/0.26°,初始场景与联合精化后场景的相机着色对比。
用最直观的数字展示『步数条件』导致无法联合更新不同精化阶段的视角,以及平稳算子的直接收益。
两个内容重叠极少的视角组:Solv3R 在 16 次调用内把第二组放到错误的位置与朝向(4 次时旋转误差 89°、64 次仍 57°),迭代不收敛到正确解。
作者主动展示的错误不动点案例,是理解方法边界(约束不足时纠错失效)的最直接材料。
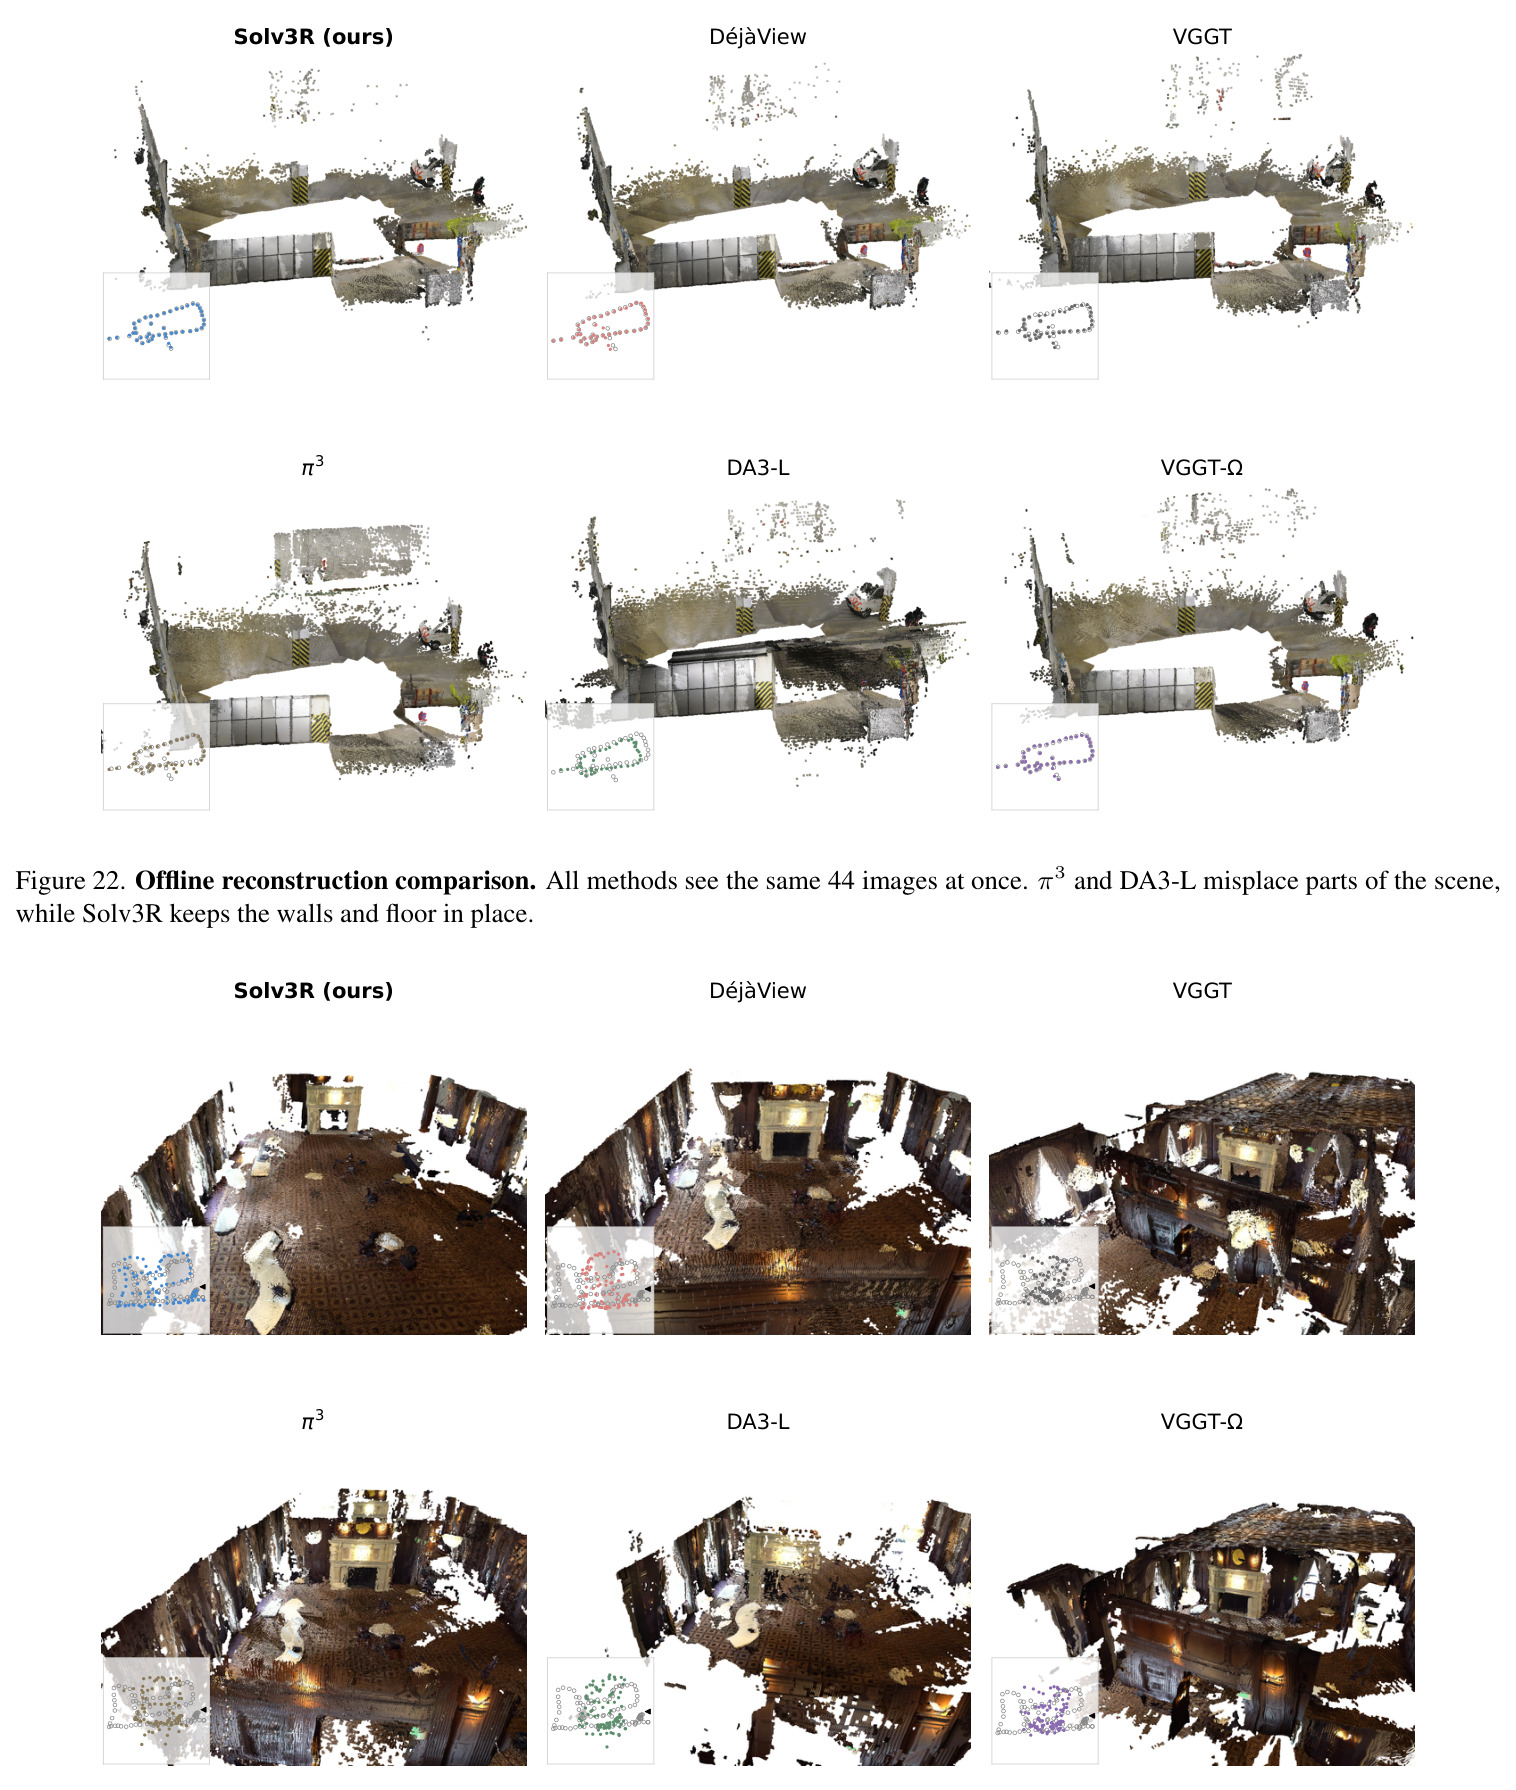
44 图场景:$\pi^3$ 与 DA3-L 错放部分结构,Solv3R 保持墙面与地面位置正确。
补充定性证据,说明基线在中等规模窗口也会失败。
100 图场景(去掉天花板俯视显示):图中给出预测相机(彩色)与参考相机(灰色)对比,Solv3R 相机最贴近参考位姿,VGGT 与 VGGT-$\Omega$ 出现『折叠』房间现象。
相机位姿层面的定性对比,直观测度大窗口下的位姿质量。
四条更长序列的流式轨迹对比(设置同 Figure 11):Solv3R 的 ATE 分别为 6.4cm、5.5cm、9.8cm 与 0.76m,全部优于 VGGT-Long、CUT3R、TTT3R 与 LingBot-Map。
补充更多序列证明流式精度优势的普遍性。