GigaSpeech 3:基于弱标注数据扩展多方言阿拉伯语语音识别 GigaSpeech 3: Scaling Multi-Dialect Arabic Speech Recognition with Weakly Labeled Data
39,000小时弱标注语料驱动五方言阿拉伯语ASR,宏平均WER 23.86%超越最强商用系统
前置知识
ASR 偏置自监督学习(ASR-biased SSL,VietASR 路线)
传统 HuBERT 式自监督先对声学特征做纯声学聚类得到伪标签,再用掩码预测学习表示;ASR 偏置版本改为用一个已在少量标注数据上训练过的 ASR 编码器来生成聚类目标,使离散目标天然带有音素-文本对齐信息。VietASR 进一步使用 Fbank 输入和多速率 Zipformer,从仅 50 小时标注数据训出 68M 参数即达到行业级水平的越南语模型。
本文整条语料构建管线的基础就是 VietASR 四阶段流程:先用每方言约 60 小时人工标注训练标注模型,再自动转写网络音频。不理解 ASR 偏置目标如何注入监督信息,就无法理解为什么几十小时标注能撬动上万小时弱标注数据。
弱标注数据(weakly labeled data)与伪标签
由模型自动生成的音频-文本配对,而非人工核对的参考转录。迭代伪标签/noisy-student 一系工作表明:识别器对自己的转写假设可以作为无标注语音的监督,且随模型改进不断刷新标签能持续降低错误率。其有效性取决于解码、数据增广和错误控制。
本文的全部主张围绕一个核心命题:弱标注不只是工程手段,而是可以发布、可复用的语料资源。判断其价值的关键实验设计——独立初始化的下游模型能否超过生成标签的老师——正是针对'伪标签是否只对生成它的模型有用'这一质疑。
Noisy Student Training(NST,噪声学生训练)
一种迭代自训练范式:教师模型为无标注数据生成标签,学生在(含噪声增广的)标注数据上训练后成为新教师,循环数轮。每一轮包含筛选当前音频-文本对、在选出的弱监督上训练下一个识别器、重新生成解码假设三个动作。语音识别中 GigaSpeech 2 已将其整合进语料构建管线。
SAU 和 SYR 两个方言的发布数据就是四轮 NST 过滤后的产物(r4-filtered),对应最终识别器 r4。论文把 Iter0/Iter1(标注模型编号)与 r0–r4(细化链编号)严格分开,专门量化细化带来的 7.7% 和 4.7% 相对 WER 降低。
Zipformer transducer(RNN-T 转导架构)
Zipformer 是面向 ASR 的高效编码器,多速率结构在不同层以不同时间分辨率处理特征;与无状态预测器(stateless predictor)和 joiner 组成 RNN-T 式 transducer,支持流式与非流式解码,训练目标是转导损失。icefall 工具包提供标准实现。
本文所有主要识别器(Iter0/Iter1 标注模型、方言专属模型、多方言模型)都是基于 Zipformer2 transducer 的,多方言模型的方言 token 也是拼接在转导输出序列上学习的。理解 transducer 才能理解方言条件化为何无需单独的 LID 分类头。
词错误率(WER)与阿拉伯语正字法变体
WER 是语音识别标准指标,将假设与参考按词对齐后计算替换、插入、删除之和占参考词数的比例。阿拉伯语存在大量合法拼写变体(词内 ي/ى、定冠词写法、方言借词拼写、标点),同一发音可有多种书写,归一化方案的选择会显著改变 WER 数值。
作者明确把'WER 混淆识别错误与合法拼写变体'列为局限,并把归一化器、测试清单和解码条件作为实验协议的一部分固定下来——不同归一化协议下的数字不可直接比较,读懂这一点才能正确解读论文中的所有 WER 表格。
研究动机
阿拉伯语 ASR 本质上是多变体识别问题而非单语言问题:现代标准语(MSA)主导教育、新闻和正式场合,但日常口语由地方变体构成,在发音、词汇、形态和拼写上差异巨大,通常粗分为马格里布、埃及、黎凡特、海湾、伊拉克五大组。现有资源严重两极分化。一端是高质量人工标注方言语料:Casablanca 48 小时(八国)、CARDAMOM 40 小时(六国 21 个次国家级微方言)、Hamsa 约 12 小时(阿联酋),规模只有几十小时,主要用于评测、适配和语言学研究,无法支撑数据密集型训练。另一端是广播和网络规模集合:QASR 2,000 小时、SADA 668 小时,但分别被半岛电视台和沙特电视节目主导,国家级覆盖不均衡;YODAS v3 在 110 万小时多语言语料中约含 25,000 小时阿拉伯语,但其 locale_lang 元数据大量缺失,按字幕轨道语言组织目录,提供的是宽泛的'阿拉伯语'分区而非可靠的国家级方言标签。结果是在阿尔及利亚、埃及、伊拉克、沙特、叙利亚五个目标方言上,每方言只有 51.1–63.2 小时人工转写可用,而方言匹配的无标注网络音频多达每方言 12,183–20,135 小时。缺口不在于阿拉伯语语音数据的可得性,而在于缺乏大规模、带可靠方言标签的训练监督——池化的'阿拉伯语'标签会掩盖系统性的声学与词汇差异,使方言专属监督成为真正的瓶颈。
本文的目标是本文的目标是构建并验证一个大规模、方言可分辨的弱标注训练语料。具体量化目标分为三层。第一层是语料本身:从每方言约 60 小时人工转写出发(总计 292.7 小时),利用 ASR 偏置自监督学习训练五个方言专属标注模型,自动转写方言匹配的网络音频,经数据筛选和(针对 SAU/SYR 的)四轮 noisy-student 细化,产出总计 39,028 小时、约 1,000 万段的五方言弱标注语料,每方言 4,361–11,461 小时。第二层是验证标准,设计得非常严格:用一个独立初始化的下游 Zipformer(不继承标注模型的任何预训练参数,预测器和 joiner 也从零学习)仅在这些弱标注对上训练,要求它超过生成这些标签的标注模型——只有这样才能证明音频-文本对本身含有超出标注模型权重的有用训练信息。第三层是应用验证:方言专属模型在 GigaSpeechBench 五方言宏平均 WER 上要显著优于覆盖全部五方言的最强第三方系统;多方言统一模型要在预测方言 ID 条件下保持竞争力并覆盖 MSA;跨模型家族(Qwen3-ASR-1.7B 微调)和跨语料域(MASC、Casablanca、SADA 八个条件)均需一致改进。最终交付物包括语料、构建与训练配方、在线演示和社区校对平台。
与已有工作不同的是,本文的切入角度在四个层面区别于已有工作。其一,把覆盖单元从'语言'下移到'方言':GigaSpeech 系列中,原版 GigaSpeech 用人工转录扩展英语(10k 小时),GigaSpeech 2 用精炼弱标签覆盖泰语、印尼语、越南语三种低资源语言(30k 小时),本作首次以国家级方言(DZA、EGY、IRQ、SAU、SYR)为单位构建语料,坚持通过元数据筛选保留国家级方言标签而非像 YODAS v3 那样提供宽泛阿拉伯语分区。其二,实验设计上把'标注模型准确'与'弱标签语料可复用'两个容易混淆的命题严格分离:核心测试是从随机初始化训练的下游模型能否改进于标注模型,这一约束使增益只能归因于数据本身而非预训练权重——这是弱标注文献中少见的严格验证。其三,把初始弱标注语料的增益与筛选/迭代细化的增益分开测量,区分 Iter0、Iter1 与 r0–r4 两套编号,量化 NST 的边际贡献(SAU 7.7%、SYR 4.7% 相对降低),并诚实报告 SAU 的 r0(13.13)其实略差于 Iter1(12.98)。其四,评测上不回避工程现实:多方言模型的主结果使用自动预测 LID 路由,并用配对诊断单独度量路由错误的 WER 代价(宏平均从 23.62 升至 25.51),而不是只展示理想化的 ground-truth 条件;方言识别本身的改进被明确划出贡献范围之外。
核心方法
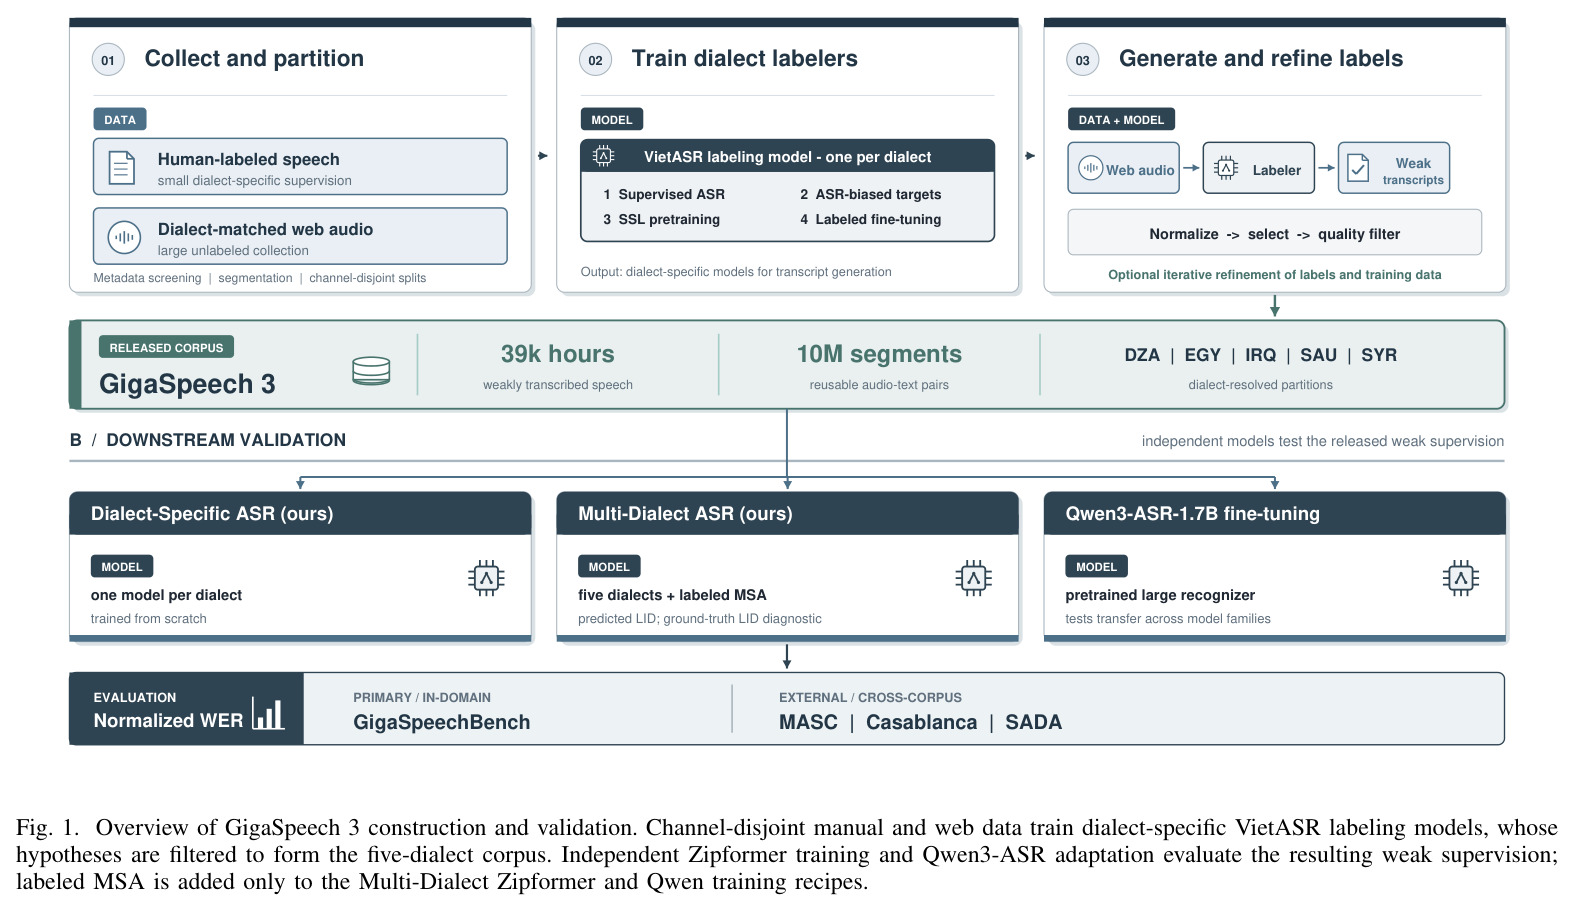
直觉上,这篇论文做的事是:方言 ASR 缺的不是音频而是转录,那就先让一个'懂该方言'的小模型用几十小时人工标注学会听,再让它给海量方言匹配的网络音频打标签,最后扔掉老师、只拿打完标签的数据从头训一个新模型——如果学生超过老师,就证明这批数据本身有价值,可以作为可复用语料发布。技术路线对应 Fig. 1 的三个板块。第一是语料构建:从公共网络频道收集方言匹配音频,用频道 ID、URL、标题元数据、发布日期和时长做源级筛选,切成话语级片段,并保证人工标注集、无标注池、GigaSpeechBench 评测数据三个集合在频道级互斥(比段级更强的隔离,防止重复说话人和频道声学条件跨集合泄漏);然后用 VietASR 四阶段流程为每个方言训练标注模型,其假设经规范化后按时长、识别分数、重复、文本质量四类标准筛选,形成初始弱标注库。第二是细化:沙特(SAU)和叙利亚(SYR)两个方言额外经历四轮 noisy-student 训练,最终发布的正是第四轮过滤后的数据(4,512 和 4,361 小时),对应最终识别器 r4。第三是下游验证,包括三条独立路径:每方言一个从零训练的方言专属 Zipformer;一个池化五方言加 MGB-2 MSA 数据、用方言 token 条件化并用自动预测 LID 解码的多方言 Zipformer;以及对预训练 Qwen3-ASR-1.7B 的微调。评测覆盖 GigaSpeechBench 主基准和 MASC、Casablanca、SADA 三个外部语料的八个条件。
核心创新是:用 ASR 偏置 SSL 把每方言约 60 小时人工标注放大成数千至上万小时的可复用弱监督,并用'学生超过老师'的独立初始化实验证明其作为数据的价值。与已有方法的本质区别有三点。第一,与 wav2vec 2.0/XLS-R 式通用多语言预训练不同——多语言预训练能共享统计强度,但不会为某个方言生成方言分辨的转录文本;本文用方言匹配的小标注集训练方言专属标注模型,再把无标注语音转成带方言标签的音频-文本对,直接产出可训练紧凑识别器的监督。第二,与常规伪标签/自训练把增益留在模型内部不同,本文的核心主张是语料的可发布性和可复用性:下游 Zipformer 从随机初始化训练,其转导预测器和 joiner 与编码器一起从零学习,既不消耗人工转录,也不继承 Iter1 的 SSL 适配参数——复现者只需要音频-文本对,不需要标注模型检查点。第三,方言条件化被设计成转导接口而非独立模块:多方言模型在每条转录前拼接 ground-truth 方言 token,用同一个 transducer 目标联合学习方言识别与 ASR,无需单独的 LID 分类头或 LID 损失;推理时用自动预测的 ID 路由,其代价被配对诊断单独量化。此外,NST 细化只应用于标注模型足够准确的两个方言(SAU/SYR),且初始弱监督增益与细化增益被分开报告,避免了把两者混为一谈。
方法步骤详情
第一步,数据收集与划分:从公共网络频道收集方言匹配音频,按频道 ID/URL、标题元数据、发布日期、时长筛选无关素材,切成话语级片段并通过基础音质检查;小部分送专业人工转录构成人工标注集(每方言 51.1–63.2 小时),其余构成方言专属无标注池(每方言 12,183–20,135 小时);人工标注集、无标注池与评测集在频道级互斥。第二步,训练 Iter0:仅用该方言人工转录训练 labeled-only Zipformer transducer,其编码器已学到语音-文本对齐线索。第三步,生成 ASR 偏置目标:用 Iter0 编码器在该方言语音上聚类隐藏表示得到离散 codebook。第四步,SSL 预训练:在无标注池上预训练全新编码器,对连续 Fbank 特征片段做掩码,预测被掩码帧的聚类身份,目标为掩码交叉熵 $\mathcal{L}_{SSL} = -\sum_{t\in\tilde{M}} \log p(c_t\,|\,\tilde{X})$。第五步,微调出 Iter1 标注模型:接上转导预测器与 joiner,在同一人工标注集上微调。第六步,弱标签生成与筛选:每个 Iter1 只解码方言匹配的、排除在人工与评测频道之外的网络音频,假设规范化到下游书写空间后按时长、识别分数、重复、文本质量筛选,得到方言 $d$ 的弱标注集 $\tilde{D}_d=\{(x_i,\hat{y}_i)\}$。第七步,NST 细化(仅 SAU/SYR):r0 为初始弱标签训练的识别器,每轮筛掉当前音频-文本对中不可靠者、在选出的弱监督上训练下一个识别器、重新生成假设,四轮后得 r4;发布的 SAU/SYR 数据即 r4 过滤后的 4,512/4,361 小时。第八步,下游验证:方言专属 Zipformer(各 500 BPE 词表)从零训练;多方言 Zipformer(共享 1,500 BPE)池化五方言与 MGB-2 MSA,训练时转录前拼接 ground-truth 方言 token,推理用预测 LID;Qwen3-ASR-1.7B 用五方言弱转录加人工 MGB-2 MSA 微调。
技术新颖性
需要诚实定位的是:ASR 偏置 SSL 本身并非本文发明——从 PBERT/CTC 聚类的监督引导 codebook,到 Chen 等用 ASR 编码器绕过 HuBERT 首轮声学聚类、ASBERT/Biased SSL/CTCBERT 等一系列工作已把监督注入目标生成的各个环节,VietASR 则把该配方适配到 Fbank+多速率 Zipformer 的紧凑识别器上;作者明确说明 VietASR 配方是基础而非本文主张的创新。本文的新颖性在于系统工程与实验方法论层面。其一,把它变成'方言分辨的语料工厂':标注模型是五个方言专属的紧凑 VietASR 模型而非通用大模型,覆盖单元首次下沉到国家级方言,这是 GigaSpeech 系列定位的自然但重要的演进(英语人工标注 10k → 三语言精炼弱标签 30k → 五方言精炼弱标签 39k)。其二,验证协议的新颖性:区分'初始弱语料增益'与'筛选+迭代细化增益',两套模型编号(Iter0/Iter1 vs r0–r4)防止混淆,独立初始化的从零训练作为可复用性的判决性实验。其三,评测协议贡献:归一化器、测试清单、解码条件作为协议固定;按 corpus-variety 对报告而非池化(避免 SADA 和 MASC-SYR 大子集淹没小条件);用同一 checkpoint 做有/无 ground-truth LID 的配对诊断以隔离路由错误代价;不事后挑选基线,直接采用 GigaSpeechBench v3 公开表中的最强完整第三方系统作为主要外部参照。
实验结果
核心发现可以按五组实验梳理。(1)ASR-biased SSL 的增益(Table V,RQ1):固定人工标注量,SSL 预训练加微调(Iter1)在所有方言上超过 labeled-only 的 Iter0,相对 WER 降低为 DZA 28.1%(53.47→38.47)、IRQ 26.2%(42.50→31.35)、EGY 27.6%(43.92→31.81)、SYR 高达 74.3%(58.88→15.11),而 SAU 仅 1.4%(13.17→12.98)——因为 SAU 的 Iter0 起点就非常强,说明 SSL 在几十小时监督仍然薄弱时价值最大。(2)语料可复用性(RQ2):从随机初始化、仅用弱标签训练的方言专属 Zipformer 在全部五个方言上超过 Iter1:DZA 33.64(相对降 12.6%)、IRQ 29.99(4.3%)、EGY 29.32(7.8%);SAU 与 SYR 经四轮 NST 后达 12.12(6.6%)与 14.25(5.7%)。(3)与第三方比较(Table VI):最强完整第三方 Qwen3.5-Omni-Plus 宏平均 28.62,方言专属模型 23.86,相对降低 16.6%;在 DZA、SAU、EGY 上分别好于最强第三方值 23.9%、26.8%、21.0%;但 IRQ 和 SYR 上 Qwen3.5-Omni-Plus(28.54/13.76)仍强于自动路由的多方言模型(28.85/16.33),ground-truth LID 引导可把差距缩小到 27.84/13.18,说明路由错误占了剩余差距的一部分。(4)多方言模型(RQ3):预测 LID 下宏平均 25.51,同时支持 MSA(10.83);带 ground-truth LID 的配对诊断降到 23.62,量化出路由代价 1.89 个 WER 点,其中 EGY 和 SYR 受害最重(+3.64/+3.15),SAU 几乎不受影响(+0.19)。(5)跨语料与跨家族(Table VII/XI,RQ4/RQ5):在 MASC、Casablanca、SADA 的八个条件上,GigaSpeech 3 训练的 Zipformer 每个条件都是六模型最低 WER,多方言模型宏平均 31.95 最优、方言专属 34.39 次之;Qwen3-ASR-1.7B 微调后宏平均从 38.42 降到 28.28(26.4% 相对),带 LID 进一步降到 24.10(37.3%)。NST 细化(Table X)为 SAU 带来 13.13→12.12(7.7% 相对)、SYR 14.95→14.25(4.7% 相对)的逐轮下降,但 SAU 的 r0(13.13)略高于 Iter1(12.98),提示弱标签训练起点未必单调改进。LID 诊断(Table VIII/IX)显示 MSA 几乎完美(98.8%)而方言仅 58.3–73.8%,大量方言语音被误路由到 MSA(DZA 30%、EGY 31%、SAU 30%),短语音尤其严重——SAU 三秒以下 LID 准确率仅 8.4%,69.3% 的短 SAU 语句被判为 MSA。
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GigaSpeechBench 五方言 ASR(方言专属模型) | 宏平均 WER (%) | 23.86 | Qwen3.5-Omni-Plus 28.62(最强完整第三方) | 相对降低 16.6% |
| 阿尔及利亚语(DZA)ASR | WER (%) | 33.64 | 最强第三方 47.11 | 相对好 23.9% |
| 沙特阿拉伯语(SAU)ASR | WER (%) | 12.12 | 最强第三方 16.56 | 相对好 26.8% |
| 埃及语(EGY)ASR | WER (%) | 29.32 | 最强第三方 37.12 | 相对好 21.0% |
| 多方言 ASR(预测 LID,含 MSA 支持) | 五方言宏平均 WER (%) | 25.51(MSA 10.83) | Qwen3.5-Omni-Plus 28.62 | 相对降低 10.9% |
| 外部八条件跨语料 ASR(MASC/Casablanca/SADA) | 宏平均 WER (%) | Multi-Dialect 31.95(八条件全部六模型最低) | Whisper-CS 53.64 / Qwen3-ASR-1.7B base 47.10 | 比最强基线相对降低约 40% |
| Qwen3-ASR-1.7B 语料适配(GigaSpeechBench 六方言) | 宏平均 WER (%) | 28.28(无 LID)/ 24.10(带 LID) | Qwen3-ASR-1.7B base 38.42 | 相对降低 26.4% / 37.3% |
| SAU/SYR 噪声学生细化 | WER (%) 相对降低 | SAU 13.13→12.12;SYR 14.95→14.25 | 各自 r0 初始弱标签模型 | 7.7% / 4.7% 相对降低 |
| SSL 对标注模型的增益 | WER (%) 相对降低 | Iter1 vs Iter0:DZA 28.1%、IRQ 26.2%、EGY 27.6%、SYR 74.3%、SAU 1.4% | labeled-only Iter0(每方言约 60 小时人工标注) | 监督越薄弱增益越大 |
局限与改进
作者明确承认四条局限:其一,自动方言路由错误拖累多方言 ASR——预测 LID 使宏平均从 23.62 升到 25.51,EGY 和 SYR 的路由代价最大;其二,WER 把识别错误与合法拼写变体混为一谈,阿拉伯语方言的正字法选择会扭曲评分;其三,弱标签的数量、置信度和来源多样性未被独立控制,无法分离各自贡献;其四,网络数据可能继承人口统计、主题、说话人和转录偏见,且数值表达式和 code-switching 的覆盖有限。我自己的观察补充如下:绝对 WER 仍然很高——DZA 达 33.64%,即便最简单的 SAU 也要 12.12%,距离实用尚远,马格里布方言受柏柏尔语和法语接触影响,可能是 code-switching 需求最强而当前覆盖最弱的方言;NST 的收益递减明显(第四轮 SAU 只降 0.20 个点),且 r0 可能不如 Iter1,说明细化链的起点质量是脆弱的;LID 时长分析是跨话语的关联而非配对控制实验,无法精确定位路由错误的识别代价机制(作者自己也指出需要分桶的有/无 LID 配对 WER);评测主要依赖 GigaSpeechBench v3 的第三方数字转录自公开表格,六模型固定协议下明确声明非 SOTA 主张;语料为研究专用许可(non-commercial),网络音频的来源平台条款也约束了商用路径;频道级隔离虽强于段级,但同一说话人跨频道出现导致说话人重叠的风险仍未完全排除。
独立分析的弱点
弱点一,方言路由是最大的实用瓶颈:MSA 类话语识别准确率 98.8%,但方言话语只有 58.3–73.8%,约 30% 的 DZA/EGY/SAU 方言语音被路由到 MSA;三秒以下短语音几乎失效(SAU 8.4%、SYR 24.4%)。改进方向:接入独立的方言识别前端(如 ADI 类分类器)、为方言 token 引入置信度阈值回退机制、或对短语音在解码时校准方言 token 的先验概率。弱点二,弱标签质量因子纠缠:SAU 无标注池最大(20,135 小时)但细化后保留率最低(4,512 小时,约 22%),SYR 池不小却保留最少之一,数量、置信度、多样性谁是主因无从得知;改进方向是设计质量分层的控制实验和按来源/说话人多样性的消融。弱点三,绝对精度不足且方言间不均衡:DZA 33.64% 的 WER 意味着约三分之一词错误,马格里布方言的法语/柏柏尔语 code-switching 建模明显欠覆盖(作者承认数值表达式与语码转换有限);改进方向是针对性补充含外语片段的数据并在评测中单独报告外语内容保留率。弱点四,NST 只覆盖两个方言,DZA/IRQ/EGY 的发布标签未经迭代细化,若其 Iter1 准确率不均衡(SSL 增益 1.4%–74.3% 的巨大方差正是证据),三者的标签噪声水平可能系统性更高;改进方向是为每个方言建立标签置信度元数据供下游按需过滤。弱点五,下游验证集中于 Zipformer 与 Qwen3-ASR 两个家族,Whisper 等主流架构的语料适配证据缺失;改进方向是增加 Whisper/Seamless 类模型的微调对照。弱点六,评测可能残余领域匹配红利:GigaSpeechBench 与网络音频同源性强,尽管有八个外部条件缓解,Casablanca-DZA 子集仅约 3 分钟,证据薄弱(作者也如此承认)。
未来方向
作者提出的方向包括:运营在线校对平台,让社区志愿者审听已发布片段并提交转录修正,支撑未来语料版本的人工验证与质量提升;增加针对性数据与评测,把识别错误与格式/拼写错误解耦,并检查外语内容的保留。基于其成果可自然延伸的方向有:(1)方言识别本身——论文反复指出自动路由是剩余挑战却刻意不将其作为贡献,一个可靠的方言/LID 模块(含短语音和 code-switching 场景)是显然的后续工作;(2)多任务扩展——39k 小时带方言标签的音频-文本对可直接服务于方言 TTS、方言语音翻译、方言口语理解等任务的预训练;(3)MSA-方言 code-switching 的显式建模,方言口语中大量嵌入 MSA 片段,当前管线将其视为噪声源;(4)质量分层与课程式训练——利用标签置信度元数据研究数量-质量-多样性的独立贡献(作者明确指出需要此类控制实验);(5)用 CARDAMOM/Casablanca/Hamsa 等几十小时黄金语料做质量锚点,例如以偏好优化方式校正弱标签;(6)方言版图扩展——Casablanca 已覆盖摩洛哥、也门等国但规模仅 48 小时,同样的管线可低成本复制;(7)跨架构规模化——把 Qwen 适配从 1.7B 推向更大的多语识别器,检验弱监督红利是否随模型规模持续。
复现评估
开源情况相当好:构建与训练配方代码在 GitHub(Antares-97/GigaSpeech3),语料在 HuggingFace(speechcolab/gigaspeech3)以研究专用许可发布,包含音频、弱转录、方言标签和段级元数据,另有 HuggingFace Space 在线演示和社区校对平台。复现的资源需求分层评估:人工标注环节需要每方言约 60 小时的专业转录(论文由付费标注公司完成,总计 292.7 小时);SSL 预训练采用 Fbank 输入而非原始波形,参考 VietASR 68M 参数、50 小时标注即可行业级的历史,标注模型训练的算力门槛是学术实验室可承受的;四轮 NST 意味着每个方言要串行训练约五个识别器再反复解码 1.5 万–2 万小时音频,计算与时间成本主要消耗在这里;下游 Zipformer 训练和 Qwen3-ASR-1.7B 微调均属中等规模。真正的复现难点不在训练而在数据:80,566 小时无标注池依赖公共网络频道的实时可得性,平台下架、元数据漂移和地区差异都会使精确复现数据收集变得困难,尽管发布语料本身缓解了这一问题;评测协议(归一化器、清单、GigaSpeechBench v3 表格)已完整公开。总体判断:拿到发布语料后复现下游结果难度中等;完整复现从零到语的管线难度中高,主要受数据时效性制约。
论文图表
三行对比表:原版 GigaSpeech 为英语 10k 小时、人工提供转录;GigaSpeech 2 为泰语/印尼语/越南语 30k 小时、精炼弱标签;GigaSpeech 3(本文)为阿拉伯语五个方言(DZA、IRQ、SAU、SYR、EGY)39k 小时、精炼弱标签。
这张表把本文放进 GigaSpeech 系列的演进脉络中,直观显示本作的定位变化:覆盖单元从语言下沉到方言,监督类型维持精炼弱标签但监督来源变为方言专属标注模型。理解系列的演进逻辑有助于把握论文的长期目标——可扩展的公开网络语音语料方法论。
按方言列出三类数据的时长:人工标注、无标注、精炼弱标注。DZA 61.1/17,812/11,461;IRQ 63.2/15,531/10,162;SAU 58.3/20,135/4,512;SYR 59.0/14,905/4,361;EGY 51.1/12,183/8,533;总计 292.7/80,566/39,028 小时。
这张表量化了论文的核心不对称性:每方言只有约 60 小时人工标注,而无标注池多达 1.2–2 万小时。它还揭示了放大倍数的方言差异(SAU 保留率仅约 22%,DZA 达约 63%),是讨论'数量-质量-多样性纠缠'这一局限的数据基础。
对比五个资源:Casablanca 八国 48 小时人工标注;CARDAMOM 六国 40 小时人工标注;Hamsa 阿联酋 12 小时人工标注;YODAS v3 国家未指定 25k 小时弱标签;GigaSpeech 3(本文)五国 39k 小时精炼弱标签。
这张表清晰呈现了阿拉伯语语音资源的'规模-标签质量'两难:人工标注语料只有几十小时,网络规模语料缺方言标签。GigaSpeech 3 占据的生态位——既有近千倍于黄金语料的规模、又保留国家级方言标签——正是论文动机的最直接证据。
列出主基准与三个外部语料的分方言评测时长:GigaSpeechBench 每方言约 20 小时(总计约 101.4 小时);MASC 中 DZA 仅 0.1 小时、SYR 6.6 小时;Casablanca 只有 DZA 1.9 和 EGY 2.0 小时;SADA 只有 SAU 19.9 小时。
解读跨语料实验(Table VII)时必须知道各条件的评测支撑量:MASC-DZA 只有约 3 分钟,作者明确声明不将其视为独立强证据。这张表帮助读者判断哪些外部结论可靠、哪些应当保留怀疑。
四行核心对比:labeled-only(Iter0)在 DZA/IRQ/SAU/SYR/EGY 上为 53.47/42.50/13.17/58.88/43.92;SSL+微调(Iter1)为 38.47/31.35/12.98/15.11/31.81;方言专属最终模型为 33.64/29.99/12.12/14.25/29.32;多方言模型为 36.78/28.85/12.81/16.33/32.80,MSA 10.83。
这是全文最重要的证据链表:第一行到第二行证明 ASR 偏置 SSL 的增益(RQ1),第二行到第三行证明弱标注语料的可复用性——从零训练的学生超过老师(RQ2),第三、四行给出方言专属与多方言两条路线的基线数字。没有这张表,论文的中心主张无从验证。
17 个系统的五方言 WER 全景:从 Dolphin Base(平均 63.85)到最强完整第三方 Qwen3.5-Omni-Plus(28.62),中间包括 GPT-4o Transcribe、Whisper Large v3、Deepgram Nova 3、Chirp 3、Gemini 3.0 Flash 等商用与开源系统。本文三个系统:方言专属 23.86、多方言无 LID 25.51、多方言带 LID 23.62。
这是论文的主要对比声明来源:23.86 对 28.62 的 16.6% 相对降低是核心卖点。它同时诚实地暴露了弱点——Qwen3.5-Omni-Plus 在 IRQ(28.54)和 SYR(13.76)上仍强于本文自动路由系统(28.85/16.33),只有加 ground-truth LID 才能反超,展示路由错误的实际代价。
六模型在八个 corpus-variety 条件上的 WER:Whisper-CS 平均 53.64、QwenCleo 51.76、Qwen3-ASR-1.7B base 47.10、Qwen FT 37.78、方言专属 34.39、多方言无 LID 31.95(最优)、多方言带 LID 32.63。多方言版本在 5 个 MASC 子集中的 4 个最强,方言专属在 MASC-SAU、两个 Casablanca 子集和 SADA 最强。
这回答'结论是否只在 GigaSpeechBench 域内成立':GigaSpeech 3 训练的 Zipformer 在全部八个条件下都是六模型最低,排除了单基准领域匹配红利的质疑。两种 Zipformer 配置在不同语料上的互补排序也说明池化训练的收益依赖语料与变体,是诚实的细粒度分析范例。
六类(五方言+MSA)混淆矩阵:MSA 准确率 98.8%,方言话语为 DZA 64.3%、IRQ 73.8%、SAU 58.3%、SYR 59.9%、EGY 63.4%。主要错误模式是方言被路由到 MSA(DZA 30%、SAU 30%、EGY 31%),SYR 与 IRQ 混淆达 11%。
这张表把'路由瓶颈'从 WER 差值上升到误差结构层面:方言间可分性远低于方言-MSA 的可分性,且混淆高度不对称。它解释了 Table VI 中多方言模型为何在 EGY/SYR 上受损最大(路由代价 +3.64/+3.15),是理解多方言系统实用边界的必读表格。
按时长分桶的 LID 准确率:三秒以下 DZA 39.8%、IRQ 51.5%、SAU 仅 8.4%、SYR 24.4%、EGY 65.6%;3–10 秒桶普遍升至 61–85%;10 秒以上 DZA/IRQ 达 96–99% 但 SAU 回落至 64.4%,EGY 反而降至 54.1%,SYR 停在 61.4%。
短语音路由失效是文中揭示的最具体工程风险:SAU 短语音 69.3% 被判为 MSA。这张表还打破'更长语音更易分辨'的直觉——EGY 和 SAU 的长桶准确率不升反降,说明方言混淆不能单靠时长解释。对要在真实流式场景部署多方言 ASR 的读者,这是关键的可行性数据。
两条 NST 细化链的逐轮 WER:SAU 从 r0 的 13.13 经 12.96、12.42、12.32 降至 r4 的 12.12(相对降 7.7%),最大单轮增益在 r1→r2;SYR 从 14.95 经 14.69、14.51、14.29 降至 14.25(4.7%),最大增益在 r0→r1。
这张表把细化收益与初始弱监督收益分开量化,是论文实验方法论严谨性的直接体现。它还诚实暴露了一个微妙事实:SAU 的 r0(13.13)略差于 Iter1(12.98),即弱标签训练的起点不一定超过老师,提醒读者'学生超过老师'的结论只对最终模型成立,不能推广到链条上任意一点。
Qwen3-ASR-1.7B 三个解码条件的六方言 WER:base 平均 38.42;GigaSpeech 3 微调后无 LID 为 28.28(相对降 26.4%,各方言降幅 13.9–38.3%);带 ground-truth LID 为 24.10(37.3%,各方言降幅 25.3–44.4%,DZA/EGY 绝对降幅最大)。对照 QwenCleo 42.85 与 Whisper-CS 46.24。
这是跨模型家族的迁移证据:同一个语料既改进从零训练的紧凑 Zipformer,也改进预训练大模型,说明弱监督的价值不绑定于单一架构或优化配方。带 LID 与无 LID 的差距(28.28 vs 24.10)再次确认路由错误是适配后大模型的持续瓶颈。注意 MSA 的改进含人工 MGB-2 数据,不能作为纯弱标签 MSA 训练的证据。