仅用排序信号的在策略蒸馏(O3PD) Order-Only On-Policy Distillation
蒸馏只需模仿教师top-K token的排序,无需拟合其概率值,全面超越传统在策略蒸馏
前置知识
知识蒸馏(Knowledge Distillation, KD)
让小模型(学生)学习大模型(教师)行为的技术。Hinton 等人 2015 年指出,教师的完整输出分布比单个硬标签蕴含更多结构信息——各候选之间的相对关系是硬标签无法表达的。因此「分布匹配」成为蒸馏的默认配方:学生不仅学教师偏好哪个输出,还要复现教师给每个备选分配的确切概率。
本文正是对这一默认配方的挑战:作者论证分布匹配中真正需要转移的只是排序信息,理解这个背景才能看懂论文的问题意识。
在策略蒸馏(On-Policy Distillation, OPD)
序列级蒸馏在教师生成的前缀上监督学生,但推理时学生条件于自己的生成,造成训练-推理错配。OPD 反其道而行:学生按当前策略采样回答,教师在学生实际访问的每个前缀状态上提供预测分布(如最小化 JS 散度,式 (2)),代表工作有 MiniLLM(Gu et al., 2024)与 GKD(Agarwal et al., 2024),已成为蒸馏推理模型的标准做法。
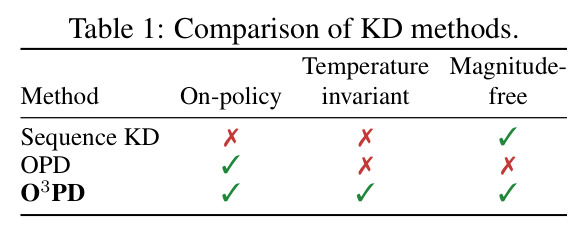
O3PD 保留 OPD 的「在学生自己的轨迹上训练」这一设定,只替换每一步的监督目标,是本文的直接基线与对照。
分布匹配目标(KL/JS 散度)
KL 散度 $\mathrm{KL}(p\Vert q)$ 与 JS 散度度量两个分布的差异。分布匹配损失对教师概率的每一次偏离都施加惩罚,其 logit 梯度为 $p^S-p^T$,只有当学生精确复现教师概率时才为零。KL 仅对 logit 平移不变;Logit Standardization 与 DIST 放宽到仿射不变,但仍消耗连续分数值。
理解分布匹配的梯度性质,才能明白为什么「拟合概率值」会让学生把容量浪费在达不到的置信轮廓上,这正是 O3PD 要绕开的约束。
温度缩放(Temperature Scaling)
将 logit 除以温度 $T>0$ 再做 softmax:$T$ 越大分布越平缓、越低越尖锐。关键性质是正温度缩放不改变 logit 的大小次序,只改变概率数值。传统蒸馏中教师温度是重要超参,OPD 的最优温度还会随师生对变化。
排序对任意严格单调变换(含温度缩放)不变,这是 O3PD 天然免疫教师温度选择问题的数学根据,也是论文动机的核心观察。
Bradley–Terry 模型与 logistic 排序损失
Bradley–Terry 模型把两两偏好建模为概率:$r_{i}=\sigma(\Delta_{i})=\sigma(z_i-z_j)$,即更高分者胜出的概率只依赖 logit 差。对应的负对数似然损失 $-\log\sigma(\Delta)$ 梯度为 $-\sigma(-\Delta)$,在偏好次序被满足后自动衰减到零,但不为 margin 设定目标值。ListMLE/Plackett–Luce 是其列表级推广。
O3PD 的默认损失就是相邻对上的 Bradley–Terry 损失,且论文证明任何纯排序目标(全对 logistic、ListMLE 等)效果相近,说明增益来自序监督原则本身。
研究动机
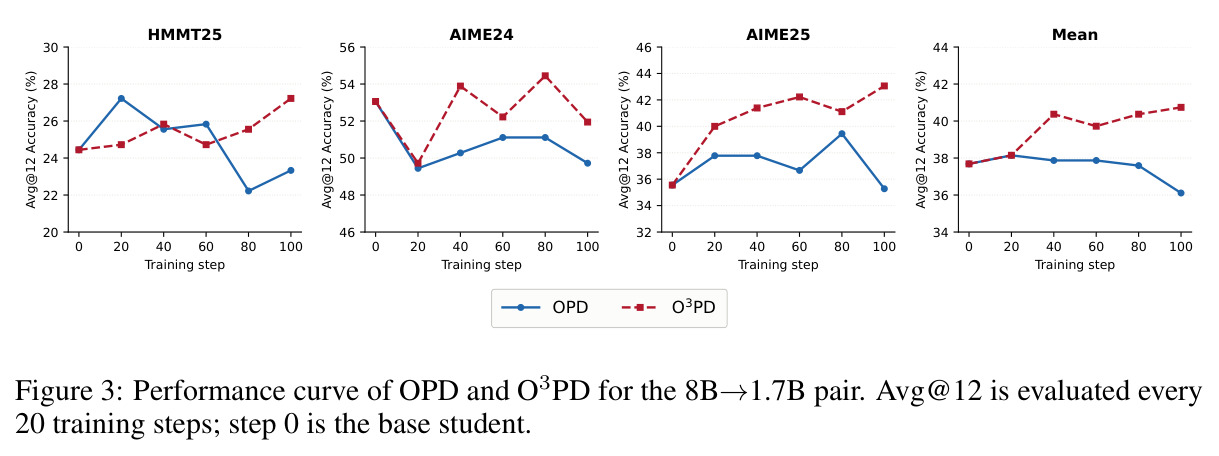
在策略蒸馏(OPD)让学生在自己的生成轨迹上匹配教师的 token 概率分布,但教师概率把两种信息纠缠在一起:偏好哪些 token(排序),以及对偏好的置信强度。后者反映教师自身的容量与校准,小得多的学生根本无法复现(Cho & Hariharan 2019 等早已指出此问题)。实践中恶果有二。其一是对教师温度极度敏感:最优温度随师生对漂移——从 8B→1.7B 的 $T=0.25$ 到 14B→8B 和 4B→1.7B 的 $T=2$;仅 3 步训练,温度选择就能让 HMMT25 准确率摆动 6.4 分(8B→4B:$T=1$ 时 44.7 vs $T=8$ 时 38.3);学生越小越敏感,0.6B 学生在高温度下直接崩溃,14B→0.6B 从 $T=1$ 的 11.94 跌至 $T=8$ 的 1.11。其二是训练不稳定:8B→1.7B 上 OPD 在第 20 步冲到峰值 38.1 后持续下滑,甚至跌破 37.7 的基座学生水平——概率匹配在把学生拖向它够不着的教师置信轮廓。
本文的目标是论文要回答一个根本问题:在策略蒸馏到底需不需要教师的概率值,还是只要候选 token 的排序就够了?具体目标有三:第一,构造一个只通过教师 top-K 排序访问教师的蒸馏目标,使其对教师温度构造性不变、对学生概率幅度不做任何规定;第二,在六个 Qwen3 师生配置(1.7B/4B/8B 学生分别配更大教师)与三个竞赛数学基准(HMMT25、AIME24、AIME25,Avg@12 协议)上与 OPD 逐对对比;第三,用 token 级一致性分析(JSD@Top-8、Kendall's τ、top-8 重叠、top-1 一致、学生熵)回答收益从何而来,并检验多种排序损失(Adjacent、全对 Logistic、Top-Weighted、ListMLE)以证明收益来自序监督本身。
与已有工作不同的是,作者的独特切入是把教师监督拆成三层嵌套信息:token 选择(采样暴露一个选择)、token 排序(top-K 列表及其顺序)、token 概率(额外固定每个 token 的数值置信度)。现有目标占据两端——Sequence KD 只模仿实现的 token,logit KD(含 OPD)匹配完整分布——而中间层从未被单独用作在策略蒸馏的信号。排序监督虽在分类蒸馏与 learning-to-rank 中有研究,但 RKKD 的 Kendall τ 只是 KL 的辅助项、PLD 按教师置信度加权每个选择、OPKD 面向有 ground-truth 标签的固定标签集、BiLD 仍匹配成对差值(编码偏好强度);没有工作把「纯排序、无幅度」应用于自回归模型在策略蒸馏这一候选集逐前缀重建、无 ground-truth token 的场景。
核心方法
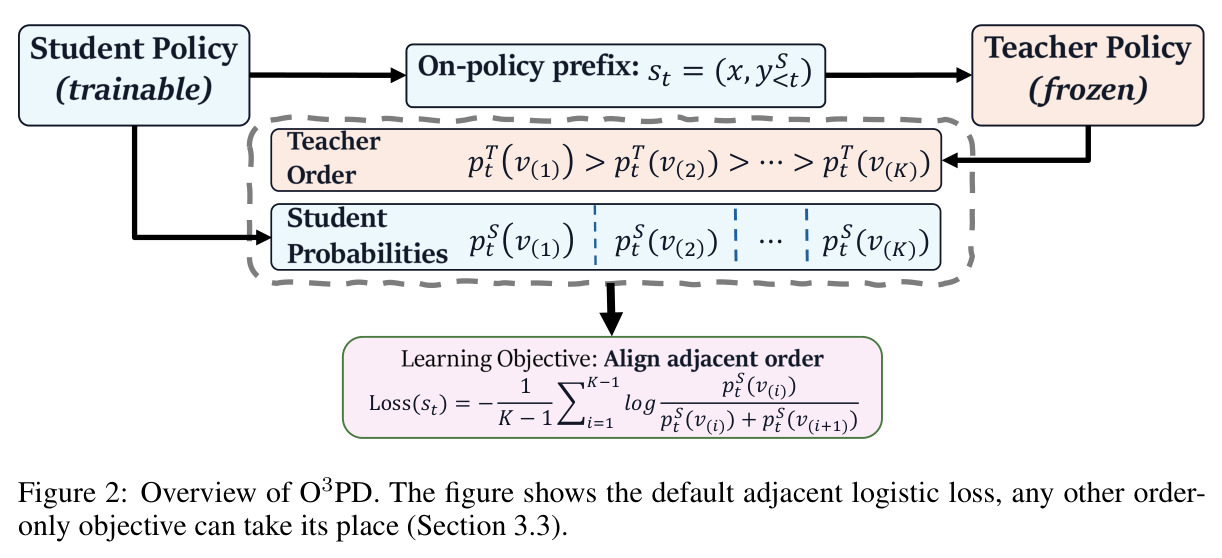
直觉上像师徒制:师傅教徒弟,关键不是师傅每个决策「有多笃定」——那是师傅个人功力与校准的体现,徒弟未必学得来——而是「在备选动作里他排出的优先次序」。O3PD 就只学这个次序。技术路线分四步:学生按当前策略对每个 prompt 采样完整回答,得到 on-policy 轨迹;冻结教师在学生实际生成的每个前缀 $s_t=(x, y_{<t})$ 上计算分布,取出 top-8 候选并按概率降序排列;学生在教师排序的相邻对上训练 logistic 排序损失 $\ell_{t,i}=-\log\sigma(z^S(v_{(i)})-z^S(v_{(i+1)}))$;对位置与相邻对取平均后更新学生。由于 softmax 归一化因子在成对概率比中相消,损失只依赖学生的相邻 logit 差 $\Delta^S_{t,i}$,教师概率值完全不进入目标。训练用 LoRA(r=64, α=128),共 100 步,有效批大小 32。
核心创新是「order-only」原则:损失函数访问教师的唯一途径是其 top-K 候选的恒等与顺序,对学生分数差距不做任何规定。与 OPD 的本质区别在监督信号蕴含的约束量上:分布匹配的 logit 梯度 $p^S-p^T$ 只有在学生精确复现教师概率时才归零,等于强迫学生把容量花在一个无法企及的置信轮廓上;排序损失梯度 $-\sigma(-\Delta)$ 在次序建立后就衰减,允许学生自由重塑自己的分布。两个结构性优点随之而来:其一,由传递性,$K-1$ 个相邻不等式唯一确定完整排序,是相对全对目标 $K(K-1)/2$ 个约束的极小描述;其二,目标对教师分数的任意严格递增变换不变(温度缩放只是特例),温度敏感性从数学上被消除,无需任何调温。作者强调这是关于「教师提供什么」的原则,相邻 logistic 只是其实例之一。
方法步骤详情
按 Algorithm 1,一次迭代:(1) 从 OpenThoughts 数学子集采样 minibatch(有效批 32);(2) 学生(非思考模式)对每个 $x$ 采样 on-policy 回答 $y^S$,rollout 上限 1024 token;(3) 在每个前缀 $s_t$ 查询思考模式的冻结教师,取其 top-8 候选 $(v_{(1)},\dots,v_{(K)})$ 及降序排序;(4) 计算相邻排序损失 $\ell(x)=\frac{1}{|y^S|(K-1)}\sum_t\sum_{i=1}^{K-1}-\log\frac{p^S(v_{(i)})}{p^S(v_{(i)})+p^S(v_{(i+1)})}$,即要求学生给每个排名靠前的候选比紧随其后者更高的成对分数;(5) 批内平均得 $L_{adj}$,用 LoRA(r=64, α=128, lr 5e-6)更新学生;采样与教师排序在优化中固定。每 20 步在三个基准上评测(Avg@12,种子 41/42/43 各 4 样本),报告 Average 最高的 checkpoint;OPD 基线共享全部配置,仅换成教师 top-8 上的 JSD($T=1$)。
技术新颖性
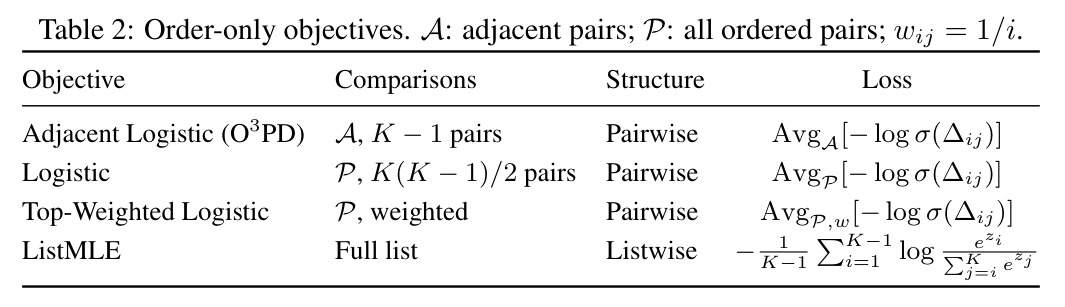
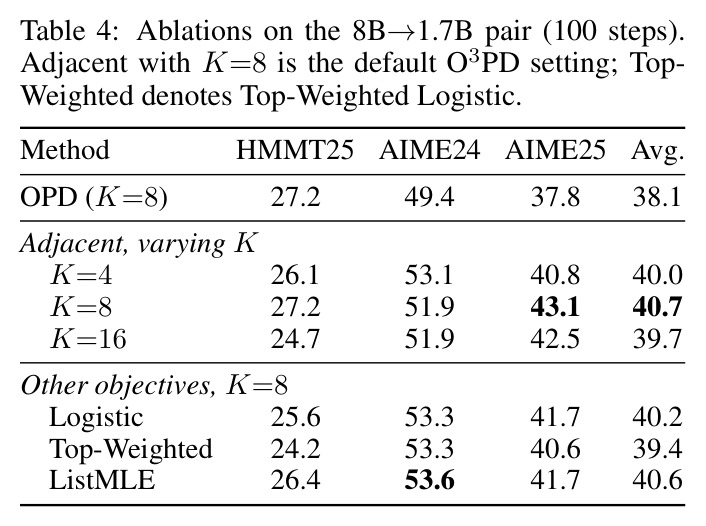
与已有排序蒸馏的区别需在「信号纯度」和「应用场景」两个维度上同时成立。信号侧:RKKD 只把 Kendall τ 损失当 KL 的辅助项,教师概率仍在目标里;PLD 的 Plackett–Luce 损失按教师置信度给每个排序选择加权;BiLD 限定教师 top-K 但匹配成对 logit 差,只平移不变、尺度上仍编码偏好强度;Logit Standardization 与 DIST 仅做到仿射不变,一次非线性但保序的重打分就会改变其目标。场景侧:OPKD 的成对排序、RKKD、PLD 都设计用于有 ground-truth 标签的固定标签集分类,RankDistil/DGR 面向固定条目池排序;而自回归解码态的候选集逐前缀变化、无 ground-truth token,是它们从未覆盖的设定。O3PD 同时满足两个条件,且消融证明相邻、全对、ListMLE 等不同排序损失增益相近(40.7/40.2/40.6 vs OPD 38.1),说明贡献来自序监督原则而非某个具体损失形式。
实验结果
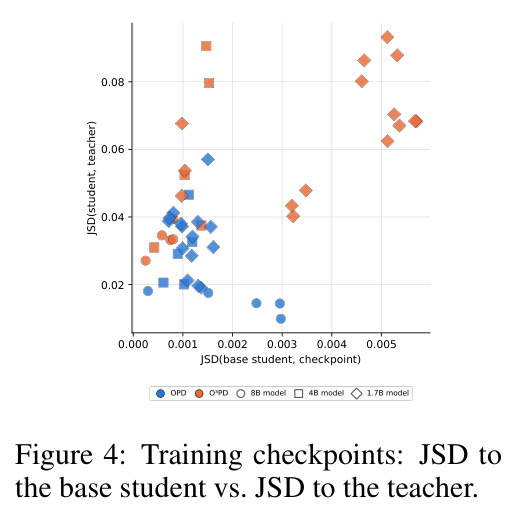
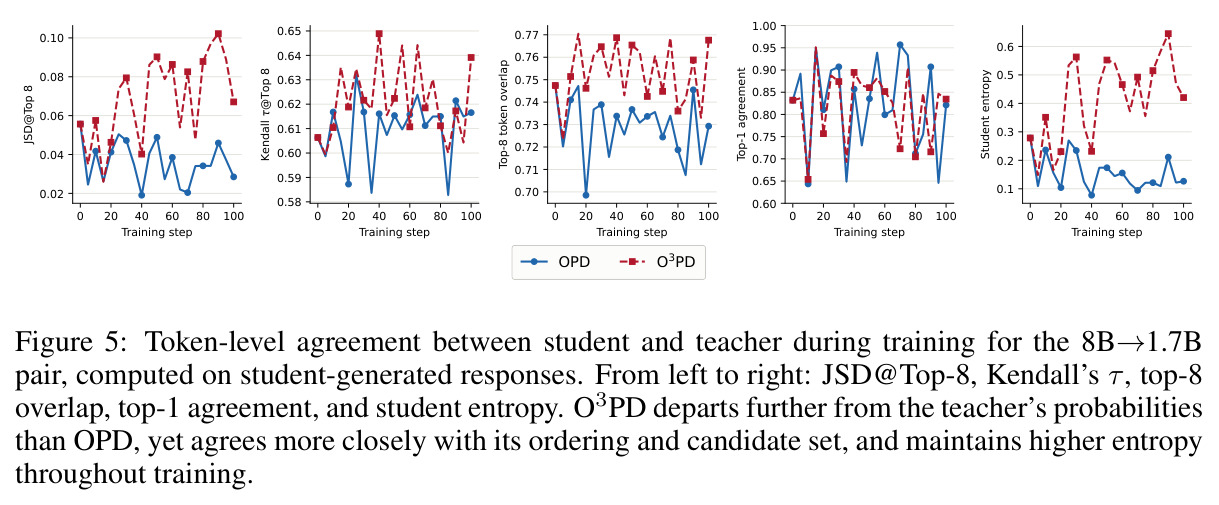
主实验(Table 3,Avg@12)覆盖六个 Qwen3 师生对,O3PD 在全部六对上三基准平均超过 OPD:8B 学生(14B 教师)64.6 vs 64.0(+0.6);4B 学生 63.2 vs 60.9(14B 教师,+2.3)、63.2 vs 61.3(8B 教师,+1.9);1.7B 学生 39.4 vs 39.1(14B 教师,+0.3)、40.7 vs 38.1(8B 教师,+2.6)、40.9 vs 38.0(4B 教师,+2.9)。增益集中在 AIME:AIME25 六对全胜,平均 +3.4、最高 +5.6(4B→1.7B:42.8 vs 37.2);单点最大增益是 4B→1.7B 的 AIME24 +6.4(55.3 vs 48.9)。O3PD 在所有规模上超过基座、SFT 与 GRPO:1.7B 学生 40.9,对比 GRPO 37.7、SFT 35.8、基座 37.7(SFT 在所有规模都低于基座,凸显在策略监督的价值)。训练动态(Figure 3,8B→1.7B):OPD 第 20 步冲到峰值 38.1 后跌破基座,O3PD 一路升到终点步的 40.7;AIME25 上 O3PD 从 35.6 爬到 43.1。小教师够用:O3PD 配 4B 教师(40.9)胜过 OPD 配 14B 教师(39.1)。消融(Table 4):所有序变体胜 OPD 1.3–2.6 分——Adjacent K=8 最优 40.7,K=4/K=16 为 40.0/39.7;全对 Logistic 40.2、Top-Weighted 39.4、ListMLE 40.6,相邻只用 7 个约束就与 28 对的 Logistic 持平。机理分析(Figure 5):O3PD 对教师概率值的 JSD 更高,但 Kendall's τ 与 top-8 重叠更忠实复现教师的排序与候选集,学生熵全程更高;Figure 4 显示 O3PD 让 1.7B 学生远离初始化数倍于 OPD。
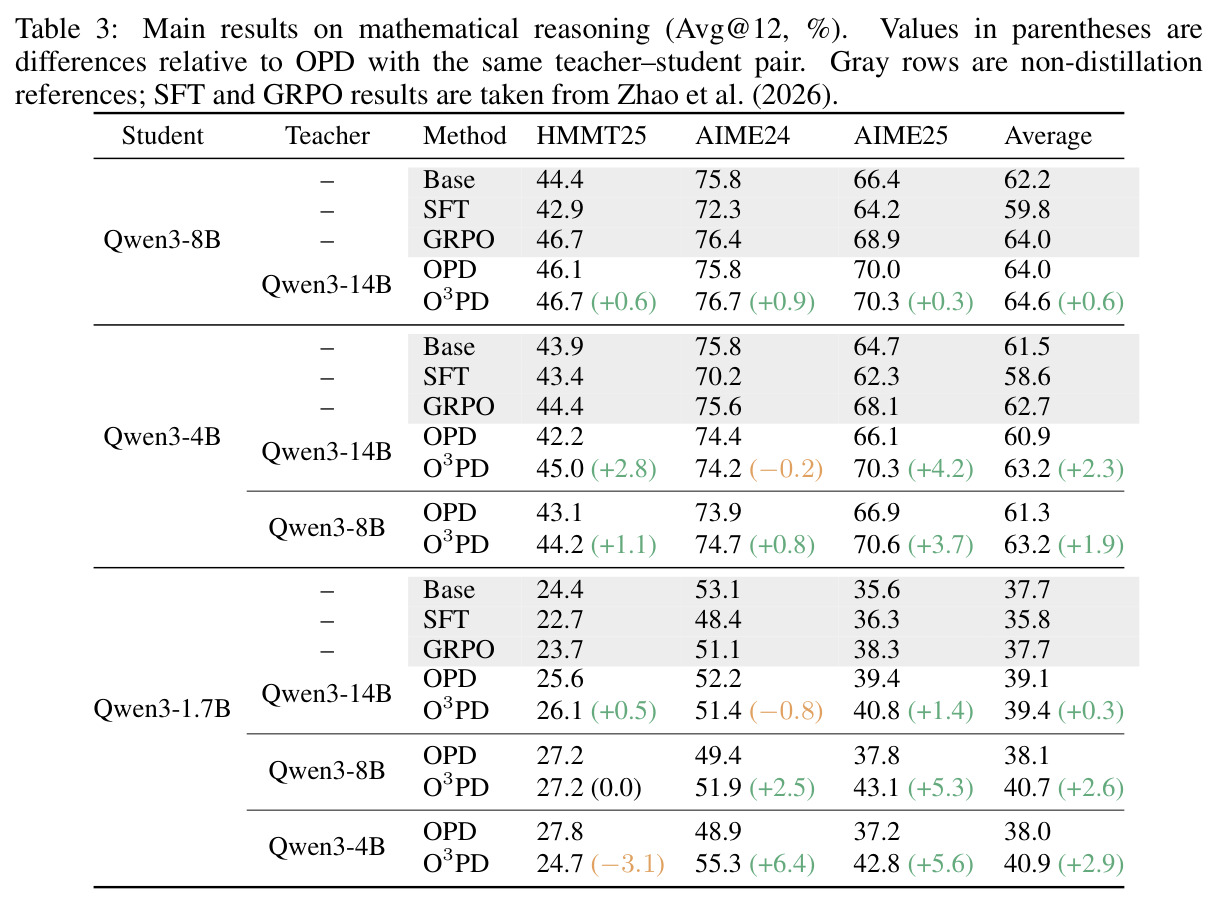
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 竞赛数学三基准平均(HMMT25/AIME24/AIME25,Qwen3-4B→1.7B) | Avg@12 (%) | O3PD 40.9 | OPD 38.0;GRPO 37.7;SFT 35.8;基座 37.7 | 较 OPD +2.9,较 GRPO +3.2,较基座 +3.2 |
| AIME25(Qwen3-4B→1.7B) | Avg@12 (%) | O3PD 42.8 | OPD 37.2 | +5.6(AIME25 六对全胜,平均 +3.4) |
| AIME24(Qwen3-4B→1.7B) | Avg@12 (%) | O3PD 55.3 | OPD 48.9 | +6.4(全表最大单点增益) |
| 三基准平均(Qwen3-8B→Qwen3-1.7B,终点步对比) | Avg@12 (%) | O3PD 训练终点 40.7 | OPD 峰值 38.1(第 20 步),终点跌破基座 37.7 | 终点对比差距超过 2.6,且 O3PD 无需选点 |
| 跨教师对比(1.7B 学生) | 三基准平均 Avg@12 (%) | O3PD + 4B 教师 40.9 | OPD + 14B 教师 39.1 | +1.8,且教师成本低一个量级 |
局限与改进
作者承认的局限:评测仅限数学推理,伦理声明明确表示未评估序蒸馏对安全对齐与开放式生成的影响;只在 Qwen3 家族内验证;容量差最大的 14B→1.7B 增益缩水到 +0.3,说明当师生差距过大时连教师的排序都难以复现。我自己的观察:三个基准都是答案可用 \boxed{} 自动判定的竞赛题,「排序即知识」这一结论对开放式生成、代码、工具调用等无唯一正确答案的任务是否成立未经验证;主表对 OPD 与 O3PD 都采用每 20 步选最优 checkpoint 的协议(作者论证该选点只会偏向会退化的方法,终点对比差距更大,但 O3PD 同样受益于选点);训练用 LoRA r=64 而非全参微调,方法的容的上限可能未探尽;教师在思考模式、学生在非思考模式的这种不对称设定未做消融;K=8 的最优性只在 8B→1.7B 一对上验证,其他配对与更小学如 0.6B 未系统扫 K。
独立分析的弱点
第一,丢弃置信度信息可能有代价:当教师对某个关键推理 token 极度笃定时,纯排序不区分「必须选」与「仅仅略优」,学生在高风险位置可能犯错。改进方向是引入自适应置信度加权——但注意论文的 Top-Weighted 变体(按排名倒数加权,39.4)反而是最差的序变体,说明简单的头部加权未必有效,需要更精细的机制。第二,容量鸿沟场景近乎失效:14B→1.7B 只 +0.3,因为教师 top-K 列表对小学生本身就是难以整体复现的目标。改进可用教师助手、渐进式蒸馏,或按前缀难度动态调整 K。第三,任务域过窄:数学题的 token 排序与最终答案高度相关,而在对话或代码生成中,局部排序是否承载任务级知识存疑,应在多域基准上复验。第四,计算成本与 OPD 相同且随 rollout 长度线性增长——每个前缀都要教师前向取 top-K,长思维链任务上开销可观;可探索仅在学生-教师分歧大的前缀查询教师的稀疏化策略。
未来方向
作者方向上:order-only 原则与正交改进组合,如 SKD 的教师轨迹干预、SKD 式的 top-K 过滤(其排序已用于选 token 但目标仍是分布匹配,换成序损失是自然延伸)、难度感知采样与课程;把排序蒸馏引入 thinking-mode 学生与更大规模。基于其成果可延伸:理论上解释为何序监督能让 1.7B 学生大幅远离初始化而不崩(Figure 4 的现象值得形式化);把候选集从纯教师 top-K 扩展为「教师 top-K ∪ 学生 top-K」以保留学生知道而教师不熟的 token;多教师场景下的排序聚合(rank aggregation)蒸馏;将序目标作为 GRPO 等强化学习目标的正则项,检验两者是否互补;以及在教学域之外(代码、agentic 任务)验证排序信号的可迁移性。
复现评估
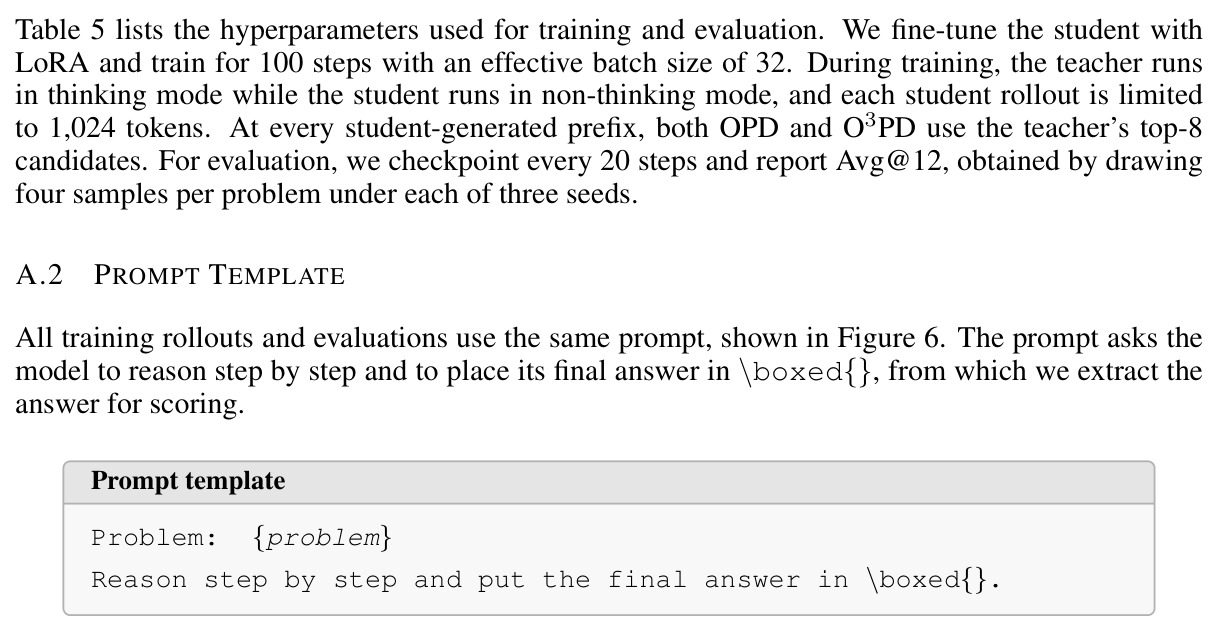
复现门槛中低。目标函数完全给定(式 (3)(4) 与 Algorithm 1 伪代码),Table 5 列出全部超参:LoRA r=64/α=128、学习率 5e-6、100 步、有效批 32、rollout 1024 token、K=8、训练种子 42;评测种子 41/42/43、每问题 4 样本、采样温度 1.0、max new tokens 38912、max model length 40960,prompt 模板(Figure 6)也给出。所有模型(Qwen3 全家)、训练数据(OpenThoughts 数学子集)、基准(HMMT25/AIME24/AIME25)公开。论文未提及发布训练代码,但实现只需 Transformers + vLLM(作者用 H100):8B→1.7B 或 4B→1.7B 规模单张 H100 即可承担;主要工程量在逐前缀查询教师并缓存其 top-K 排序,OPD 基线共享同一套基建。总体属于几天内可在单机复现核心表格(8B→1.7B 行 + Table 4 消融)的工作。
论文图表
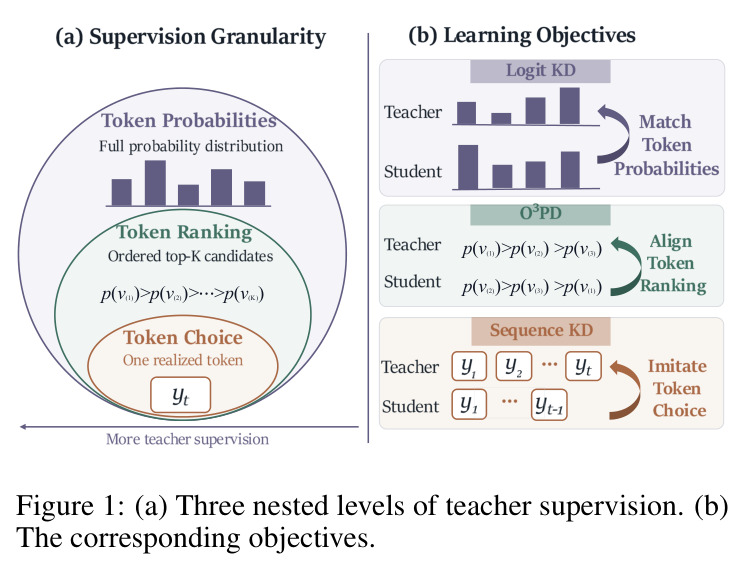
把教师监督分为三层嵌套:(a) 从内到外是 token 选择(采样一个 token)、token 排序(top-K 候选的先后,如 $p(v^{(1)})>p(v^{(2)})>p(v^{(3)})$)、完整概率分布;(b) 把 Sequence KD、O3PD、Logit KD、TokenAlign/Ranking 等目标按其消耗的监督层级排布。
这张图是全文的概念骨架:一句话讲清「排序是介于选择与分布之间的中间层」,读者据此立刻理解 O3PD 在方法版图中的位置以及它与两端方法的差异。
训练 rollout 与评测共用的 prompt 模板:问题陈述加一句「Reason step by step and put the final answer in \boxed{}」,答案从 \boxed{} 中提取判分。
保证训练与评测条件一致、结果可复现的关键细节,复现时必须原样采用。
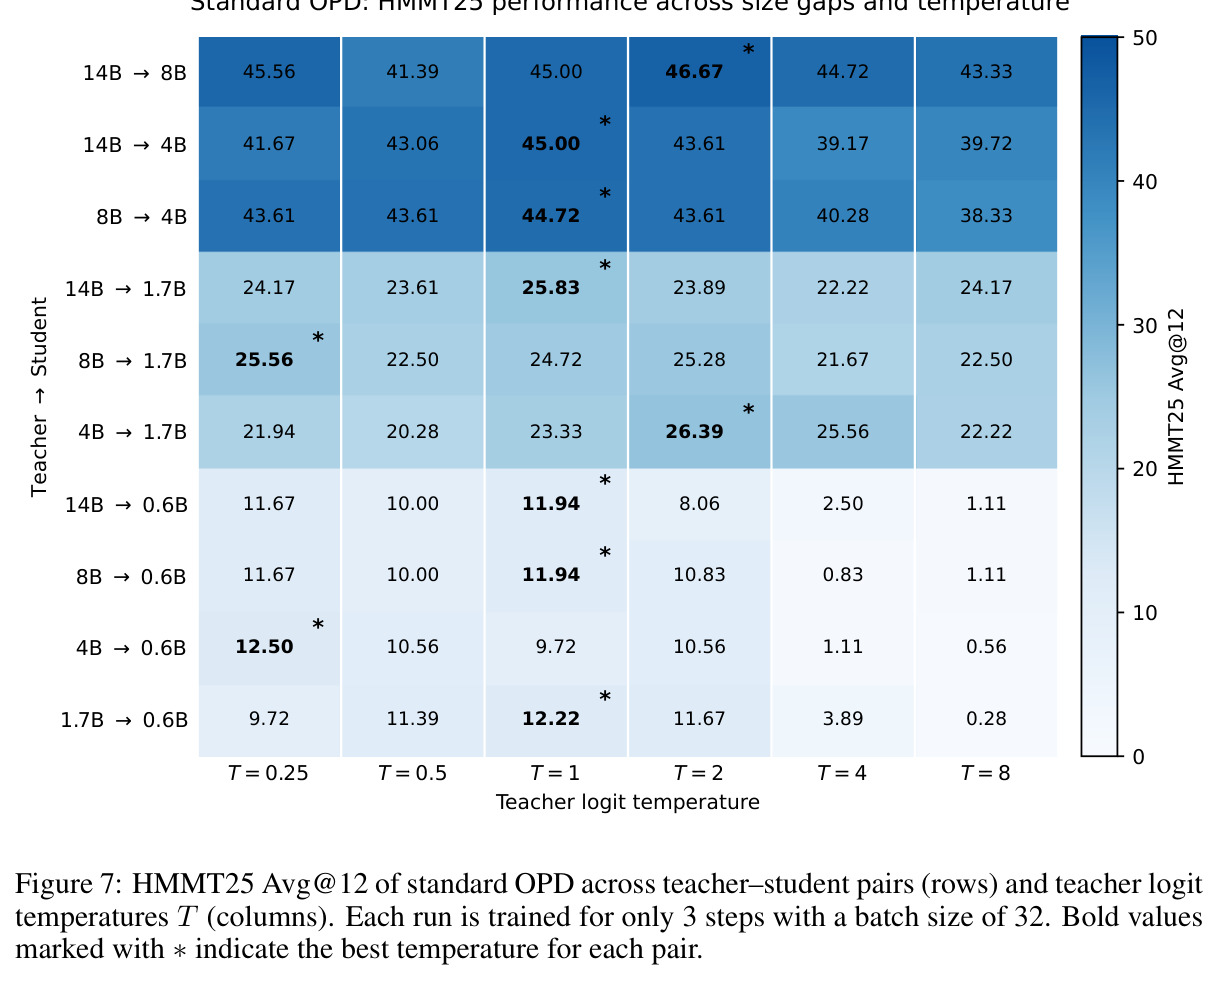
九个师生对(含 0.6B 学生)在 $T\in\{0.25,0.5,1,2,4,8\}$ 下的 OPD 短训(3 步)成绩矩阵:最优温度从 0.25 到 2 不等,0.6B 学生高温崩溃(14B→0.6B 从 11.94 跌至 1.11)。
OPD 温度敏感性问题的完整证据,说明「没有万能温度」且学生越小越敏感——这正是 O3PD 构造性免疫温度的价值所在。