TAC-CoT:通过交错显式标记实现工具赋能的自适应隐式思维链 TAC-CoT: Tool-Empowered Implicit Chain-of-Thought via Interleaving Explicit Tokens
让模型在潜空间思考、只在工具调用和答案处显式输出,智能体推理更快更准。
前置知识
显式思维链(Explicit CoT)
在最终答案之前让模型用自然语言逐字生成中间推理步骤的范式。中间步骤是人类可读的离散 token,与自回归生成天然兼容,便于监督训练和结果解释,但每一步都要经过完整的词表投影和解码,推理轨迹越长,前向计算与延迟开销越大,且长轨迹中某一步的小错误会在后续步骤中不断被放大(过思/over-thinking 现象)。
TAC-CoT 要对比和超越的基线正是显式 CoT 智能体,论文的全部动机(成本高、误差累积)都建立在显式 CoT 的这两个缺陷上,理解它才能理解改进点。
隐式思维链与连续思维 token(Implicit CoT / Continuous Thought Tokens)
用少量连续向量(latent embedding)替代自然语言 token 承载中间推理的范式,代表工作有 Coconut、CODI、SIM-CoT 等。典型做法是把某层隐状态经一个小投影层变换后通过 inputs_embeds 直接反馈回模型,完全绕过词表 softmax,从而在潜空间完成多步推理,大幅压缩推理长度。代价是推理不可读,且现有方法把固定数量的隐 token 在一个连续块中一次消耗完。
TAC-CoT 的推理骨架就是隐式 CoT,连续思维 token 的生成、投影与反馈机制完全沿用这一路线,是理解方法设计的地基。
ReAct 式工具调用智能体
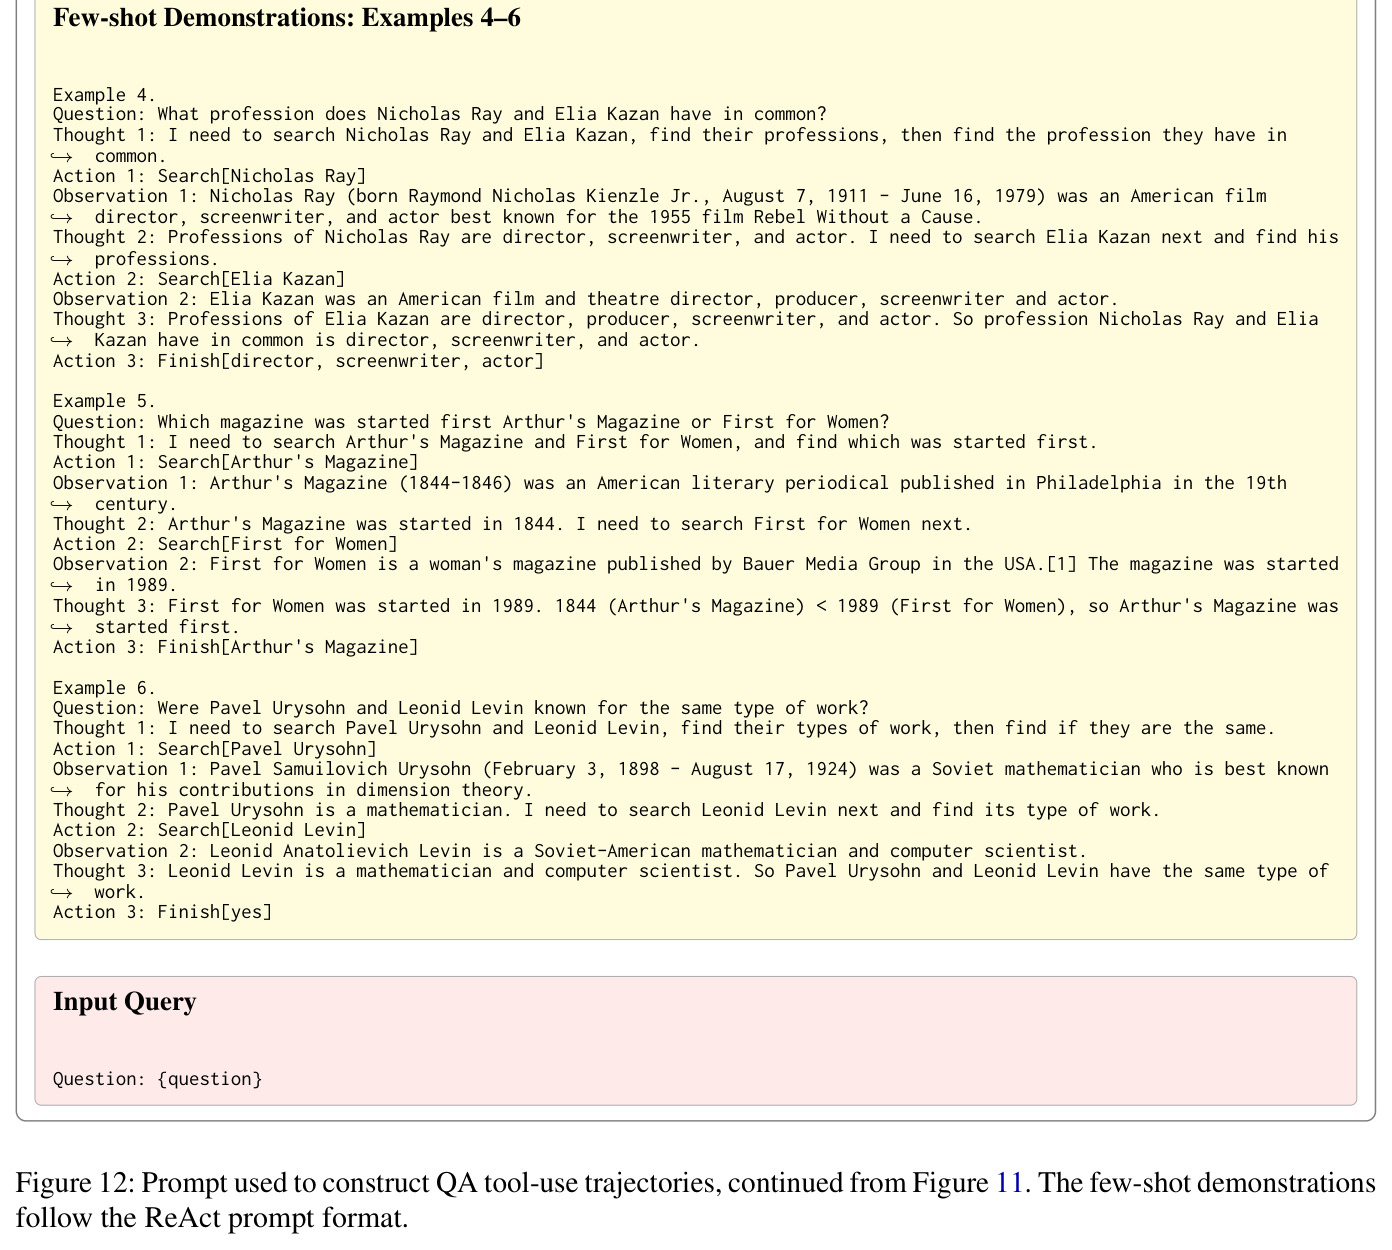
LLM 智能体的标准工作循环:模型生成"思考-行动"文本,行动部分(如 Search[实体] 或计算器表达式 «10*40=400»)交给外部环境解析执行,返回的观察(Observation)拼回上下文,模型继续生成,直到给出最终答案。关键约束是:工具调用必须是离散的、可执行的自然语言片段,环境才能处理。
论文要解决的核心矛盾是隐式 CoT 没有任何显式中间输出点,无法插入工具调用;只有理解 ReAct 循环,才能明白 TAC-CoT 的"交错"设计如何保留可执行接口。
自蒸馏(Self-Distillation)
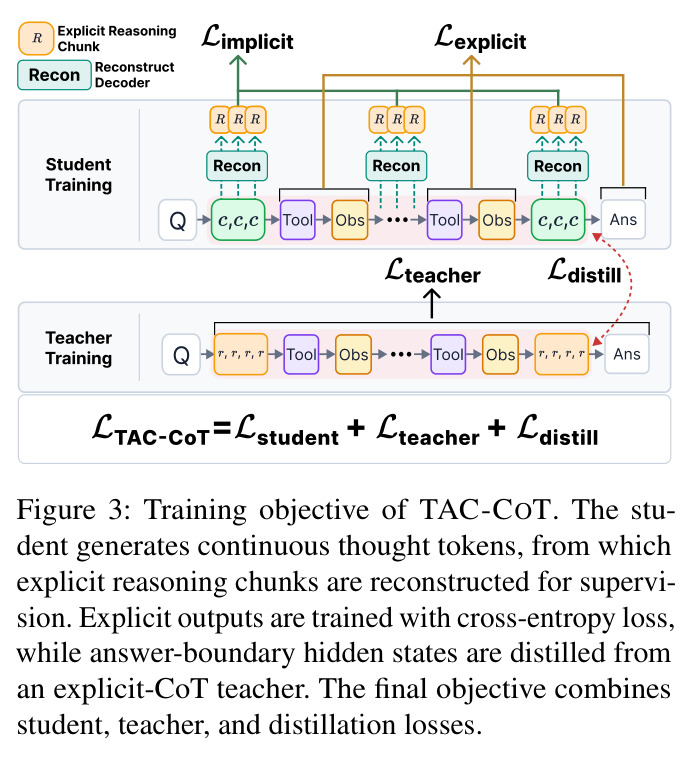
同一个骨干模型同时充当学生和教师:教师用显式推理轨迹以标准交叉熵训练,学生用隐式轨迹训练,再用一个辅助重建解码器从连续 token 重建被隐去的推理文本,并在答案边界处用逐层 L2 损失对齐师生的隐状态(教师侧加 stop-gradient)。CODI 首先提出这一方案,SIM-CoT 进一步加入步级重建监督。
TAC-CoT 的总损失 $\mathcal{L}_{\text{TAC-CoT}} = \mathcal{L}_{\text{student}} + \mathcal{L}_{\text{teacher}} + \mathcal{L}_{\text{distill}}$ 直接继承这一框架,不懂自蒸馏就无法理解训练部分如何让连续 token 编码推理内容。
前向传播次数(# Fwd)
衡量推理开销的指标:平均每个问题需要多少次模型前向传播。KV cache 下每次解码一个 token 即一次前向;显式 CoT 推理越长 # Fwd 越大,隐式方法的每个连续 token 同样各需一次前向。它独立于硬件速度和外部 API 延迟,是论文用来公平比较效率的主要口径。
论文的核心效率主张(前向次数最高降低 6.8 倍)全部以 # Fwd 报告,所有主表都是"精度 + # Fwd"并列呈现,不懂这个指标就看不懂实验。
研究动机
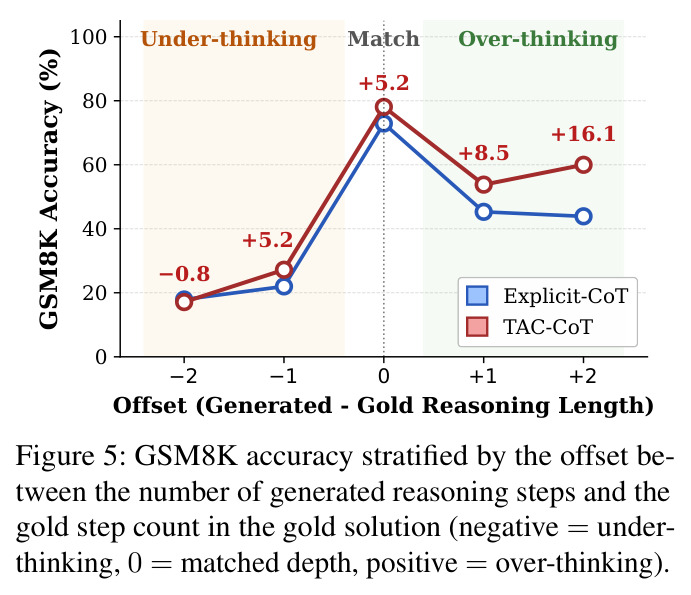
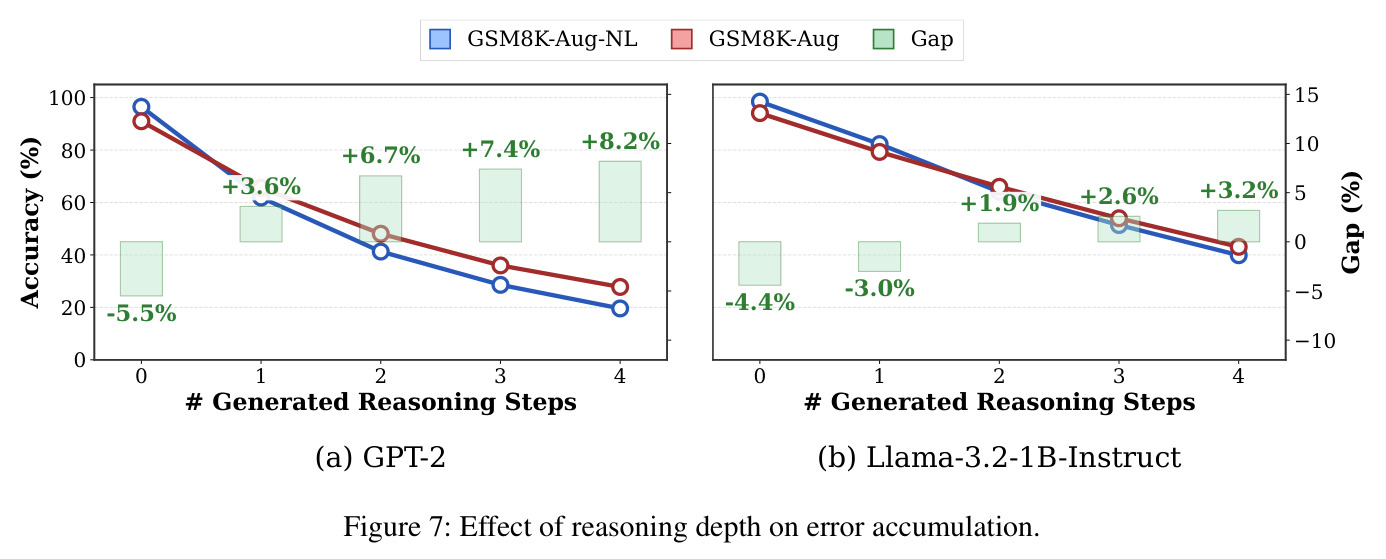
LLM 智能体(ReAct 式的数学解题与检索问答)普遍采用显式 CoT,每一步交互都要逐字生成推理文本,由此产生两个具体问题。其一是推理成本随轨迹长度暴涨:论文实测 Qwen2.5-0.5B 在 HotpotQA 上平均每个问题消耗 951 次前向传播,Qwen3-4B 更高达 1496 次,其中大部分 token 是冗长的中间推理而非工具调用本身;对应墙钟延迟在 QA 上平均每样本 7654 毫秒。其二是误差累积:附录 Figure 7 显示 GPT-2 在 GSM8K-Aug-NL 上,使用生成推理相对金标推理的精度差距随推理深度从 +3.6% 扩大到 +8.2%,即"想得越多反而错得越多"。作为替代的隐式 CoT(Coconut、CODI、PCCoT、SIM-CoT 等)虽把推理压缩进连续向量,但它们把固定数量的隐 token 在单个连续块中一次性耗尽后直接输出答案:轨迹中不存在任何可以发出工具调用或接收观察的显式位置,工具使用在结构上不可行;而且同样的 token 预算不加区分地用于所有问题,简单问题浪费预算、难题又严重欠分配。
本文的目标是本文的目标是把隐式 CoT 从"答案前一次性静态推理"改造成"可迭代的智能体推理骨架",具体分解为三点。第一,让隐式推理与外部工具兼容:模型在潜空间思考若干步后,能显式发出工具调用(计算器、Wikipedia 检索),接收观察后继续隐式推理,最终输出答案,形成完整的推理-行动循环。第二,让隐式推理预算随问题难度自适应:简单问题一段隐式推理即可作答,难题自动展开多段推理与多次工具交互,而非对所有问题使用同一预算。第三,在实现上述目标的同时显著降低推理开销并提高准确率,论文的量化目标是全面超越显式 CoT 智能体——最终实现最高 8.8 点的精度提升和最高 6.8 倍的前向次数缩减。
与已有工作不同的是,已有两条研究线互不打通。显式 CoT 压缩方向(TokenSkip 按 importance 剪枝 token、Sketch-of-Thought 草稿式推理等)仍在词表空间内逐 token 解码,压缩有限;隐式 CoT 方向(Coconut、CODI、PCCoT 的 Jacobi 并行、SIM-CoT 的步级监督、KAVA 的 KV-cache 蒸馏)专注于把推理搬进潜空间并稳定训练,但都隐含"推理在答案前一次性完成"的假设,从不与环境交互。论文的独特切入是诊断出:隐式 CoT 的限制不在于潜空间推理本身,而在于"单一连续块"的轨迹结构。只要在隐式段之间保留显式的工具调用、观察和答案 token,就能同时维持智能体必需的可执行接口,并让隐式预算按需分段展开。据作者所知,此前没有工作把隐式推理嵌入迭代式推理-行动工作流,也没有工作实现过查询自适应的连续思维预算;本文还额外发现隐式推理本身能缓解误差累积(替换深度实验中精度单调上升),为隐式方法在智能体场景的价值提供了新证据。
核心方法
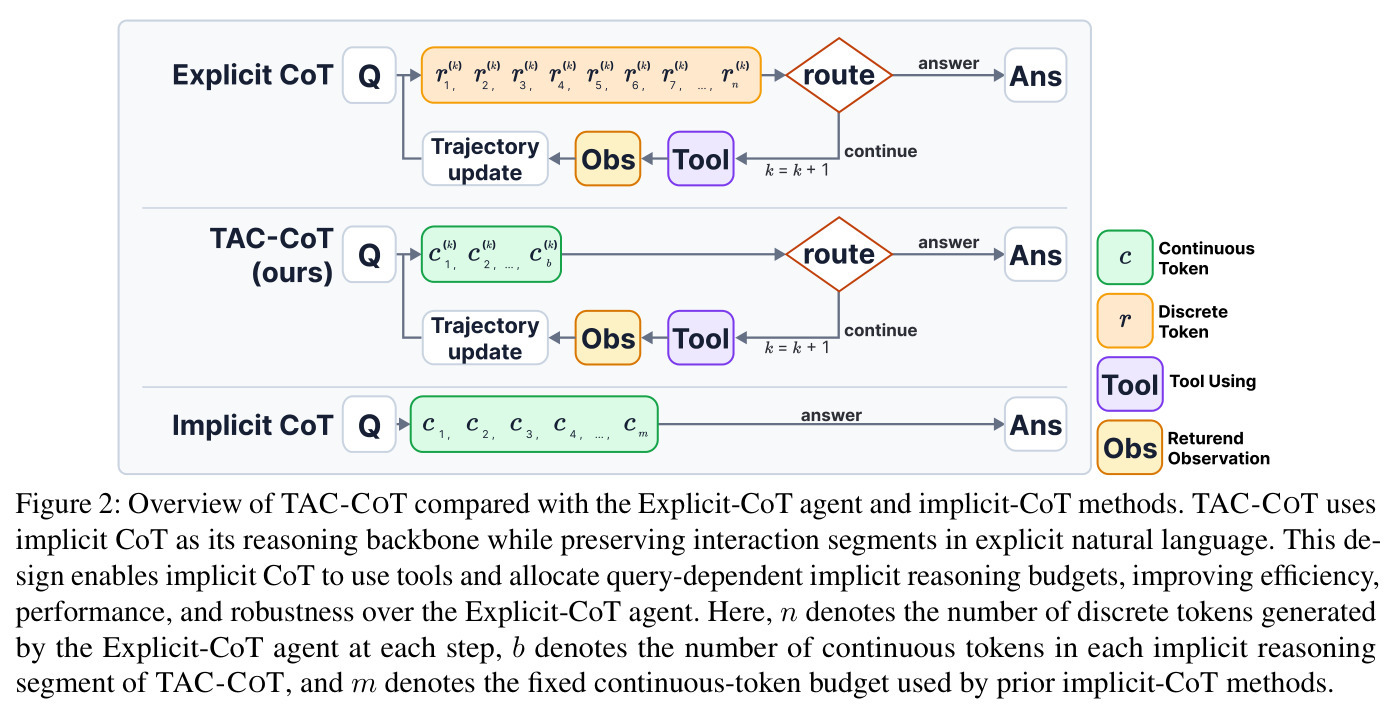
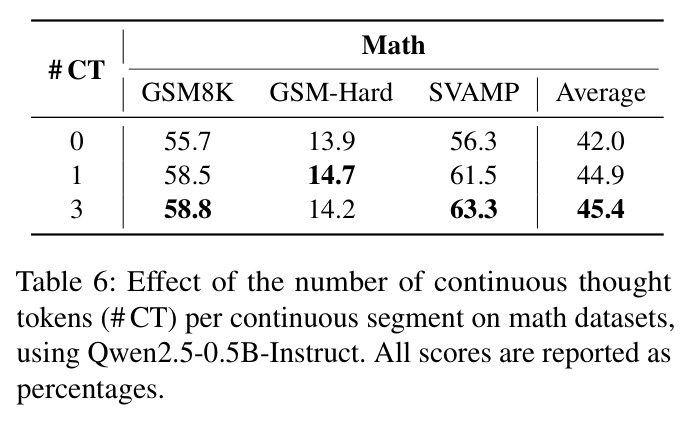
直觉上,TAC-CoT 让模型"心里想、嘴上只说必要的话":中间推理在潜空间用少量连续向量完成,只有必须与外部世界交互的内容——工具调用、观察、最终答案——才用自然语言显式写出。技术上,给定显式工具使用轨迹 $\tau_E = [R^{(1)}, u^{(1)}, o^{(1)}, \ldots, R^{(k)}, a]$,其中 $R^{(i)}$ 是 $n$ 个离散 token 组成的推理段、$u^{(i)}$ 是工具调用、$o^{(i)}$ 是观察、$a$ 是答案,TAC-CoT 构造交错轨迹 $\tau_I = [C^{(1)}, u^{(1)}, o^{(1)}, \ldots, C^{(k)}, a]$:把每个推理段替换为 $b$($b<n$,实验中 $b=2$ 或 $3$)个连续思维 token $C^{(i)}=(c^{(i)}_1,\ldots,c^{(i)}_b)$,工具调用、观察和答案保持显式。每个连续 token 由末层隐状态过投影层得到 $c_t = \text{Proj}_\theta(h_t)$,经 inputs_embeds 反馈、绕过词表。推理循环为:生成 $b$ 个隐 token 后,比较"工具调用"与"答案"两个路由 logits;选工具则解码调用、等环境返回观察拼回上下文、再开一段隐式推理;选答案则直接生成最终答案。段数 $k$ 在推理时动态决定,总预算 $kb$ 因此是查询自适应的。
核心创新是"逐段路由"(per-segment routing)机制。已有隐式 CoT 把全部隐 token 作为一个不可分割的块消耗掉后才产生第一个显式输出,这带来两个结构性缺陷:轨迹中途没有显式出口,无法插入工具调用;块大小固定,无法按难度伸缩。TAC-CoT 的本质区别是把"何时停止思考"变成在每个隐式段末尾做出的显式决策:比较动作 logits $\ell_{\text{act}}$ 与答案 logits $\ell_{\text{ans}}$,若 $\ell_{\text{act}} > \ell_{\text{ans}}$ 就发出工具调用并继续下一隐式段,否则当前段成为整合段并生成答案。这一改动一举三得:(1) 工具调用与观察天然嵌在隐式段之间,智能体的可执行接口得以保留;(2) 段数按需增长,预算从固定标量 $m$ 变成动态的 $kb$;(3) 隐式段吸收了本会被逐字生成的推理内容,轨迹变短、误差累积减少。与显式压缩方法(TokenSkip)的本质区别是绕过词表解码;与 CODI/SIM-CoT 的本质区别是把单一推理块重构为可迭代、可路由的段序列,首次把隐式推理接入智能体的推理-行动循环。
方法步骤详情
完整流程分四步。第一步,构造交错训练数据。对已有工具交互的来源(GSM8K-Aug-NL 的自然语言推理轨迹 + 同题 GSM8K-Aug 的算式标注 «86.7*15*.01=13.005»,各 38.5 万条),按问题对齐并把算式作为计算器调用插入轨迹;对只有问答对的来源(HotpotQA),用 DeepSeek-V3 作为 ReAct 式检索智能体(Wikipedia API)生成 4 万条完整轨迹,只保留预测答案命中金标的轨迹(过滤通过率 56.24%,总成本 102.73 美元;用不同模型 GPT-5.1 抽检 200 条,99% 判定有效)。第二步,学生训练:把每段 $R^{(i)}$ 切成 $b$ 块,辅助重建解码器 $D_\phi$(推理时丢弃)从每个连续 token 重建对应文本块,得到 $\mathcal{L}_{\text{implicit}} = -\sum_{i=1}^{K}\sum_{t=1}^{B} \log q_\phi(R^{(i)}_t \mid c^{(i)}_t)$;工具调用、观察、答案用交叉熵 $\mathcal{L}_{\text{explicit}}$ 训练,$\mathcal{L}_{\text{student}}$ 为两者之和。第三步,教师训练与蒸馏:同一骨干在显式轨迹上以 $\mathcal{L}_{\text{teacher}}$ 训练,然后在答案冒号 token 处按层对学生隐状态做 MSE 蒸馏,$\mathcal{L}_{\text{distill}} = \frac{1}{M}\sum_{l=1}^{M}\|\,\text{sg}[h^{\text{teacher}}_l] - h^{\text{student}}_l\,\|^2$。第四步,推理(Algorithm 1):编码问题后循环生成 $b$ 个连续 token,读路由 logits 决定发工具调用(观察注入后重启循环)还是生成答案。
技术新颖性
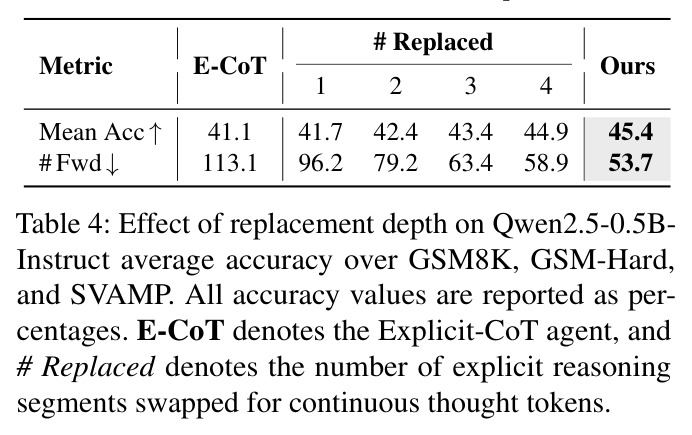
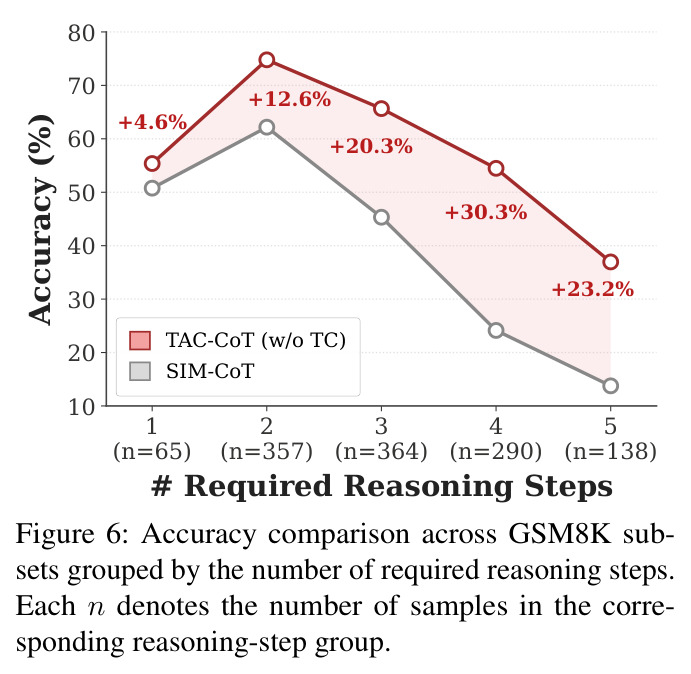
技术新颖性体现在四个层面。第一,结构创新:首次把隐式推理重构为"段序列 + 段间路由",将隐式 CoT 从单轮静态推理范式扩展为迭代式智能体骨架,填补了隐式推理与工具使用两条研究线之间的空白。第二,机制创新:查询自适应预算不是靠额外的预算预测器或元网络实现,而是作为路由机制的副产品自然涌现——每次工具交互后自然多出一段 $b$ 个隐 token,简单查询一段即止,难题自动展开,无需任何新模块。第三,训练适配:把 SIM-CoT 的步级重建监督迁移到交错轨迹上——由于只隐去推理段,辅助解码器只需重建被省略的推理内容而非整条轨迹,蒸馏信号与工具交互的时序精确对齐。第四,实证发现:替换深度实验(隐化 0 到 4 段,数学平均精度从 41.1% 单调升至 45.4%)首次系统证明隐式推理能缓解长轨迹误差累积,且收益随所需推理步数增大(1 步组 +4.6 点,4 步组 +30.3 点),为"隐式推理在智能体场景更有价值"提供了此前缺失的证据链。
实验结果
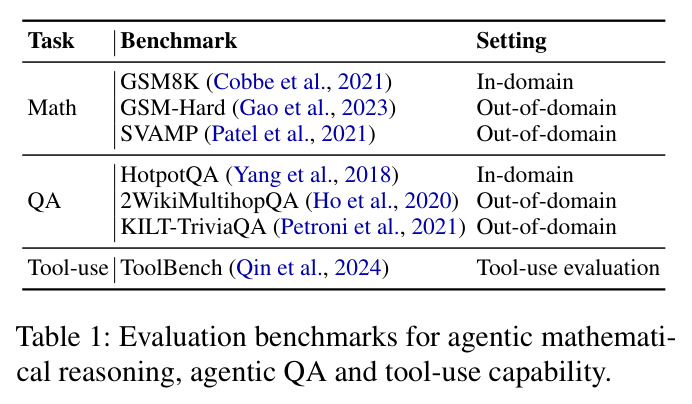
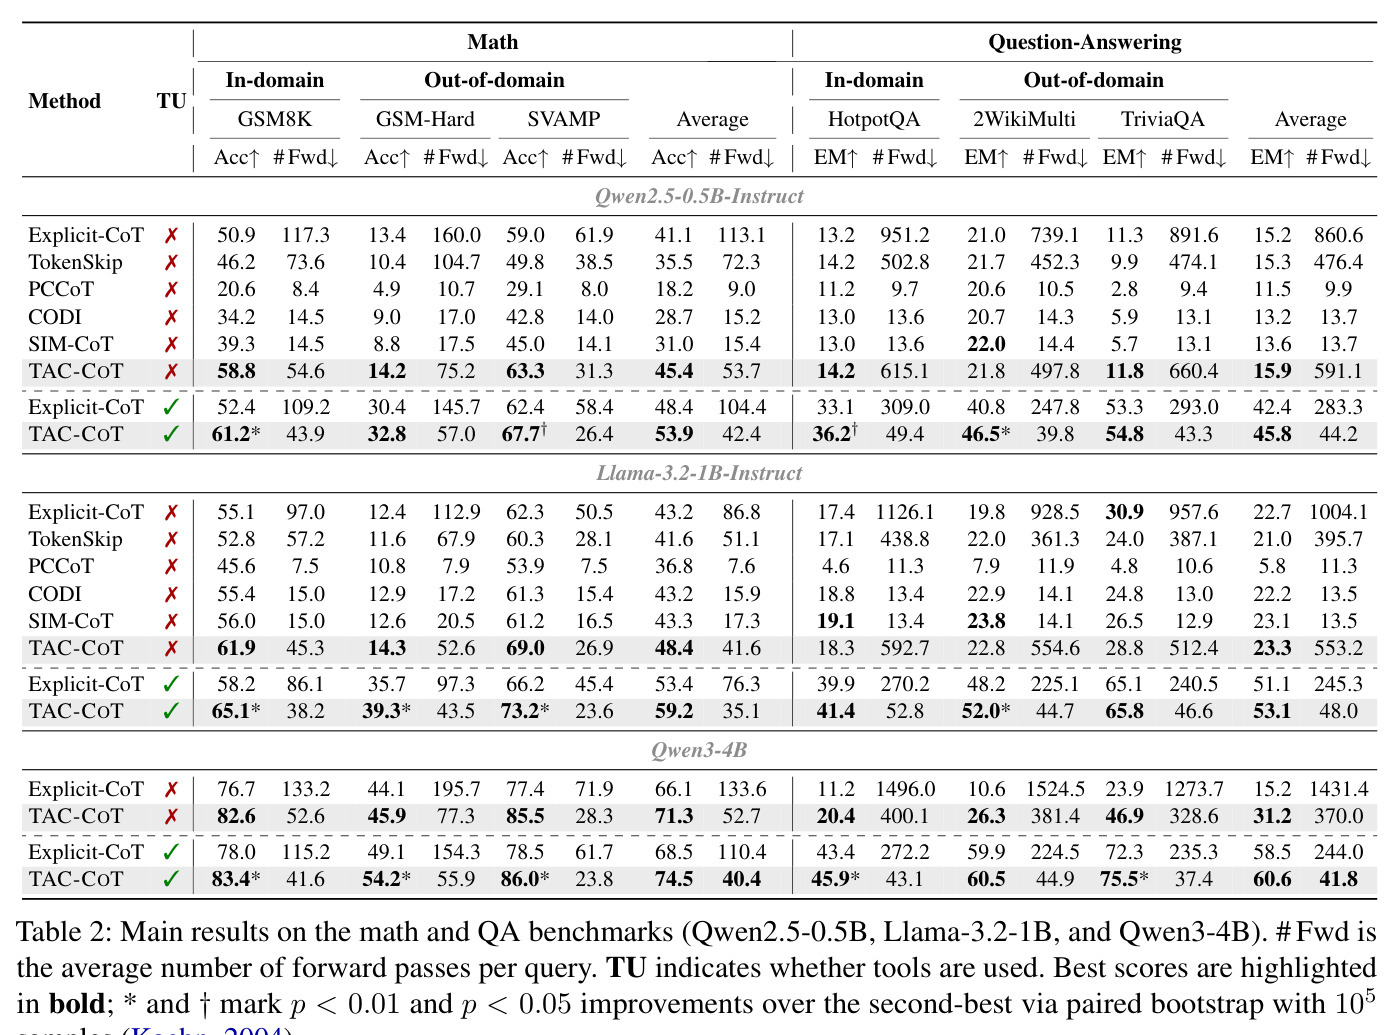
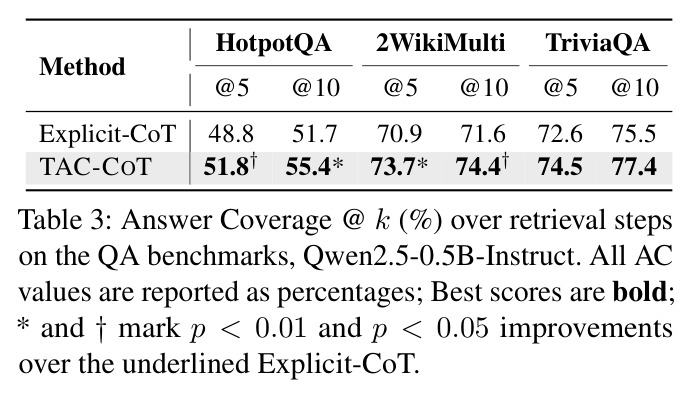
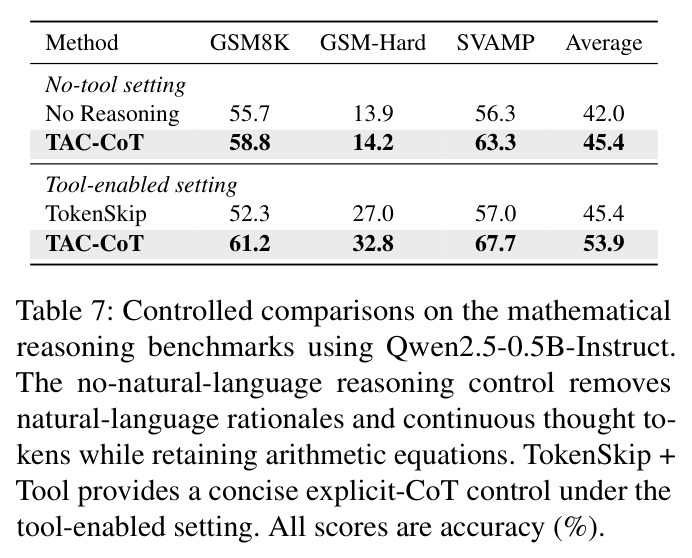
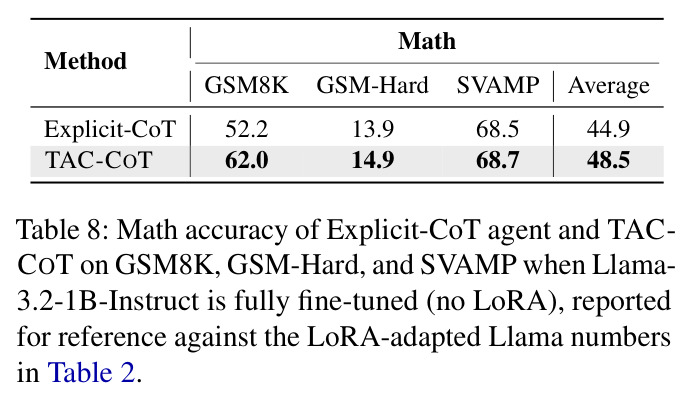
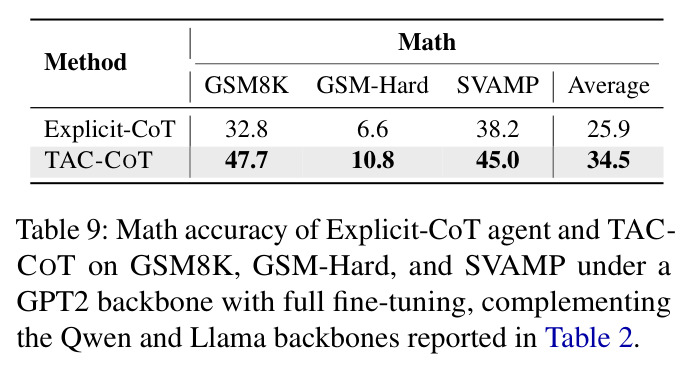
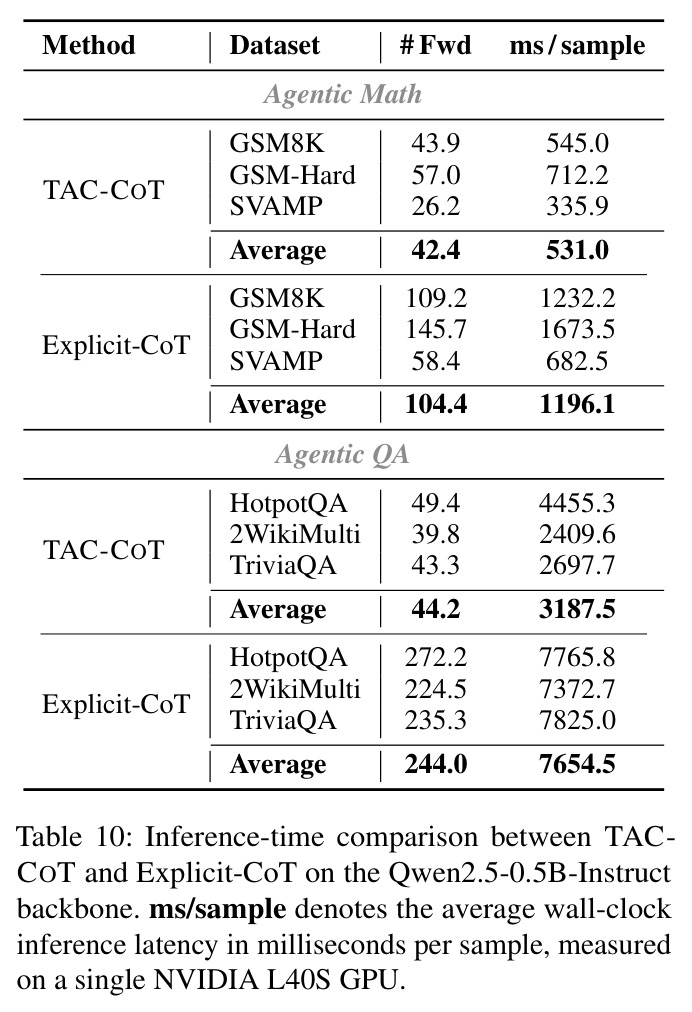
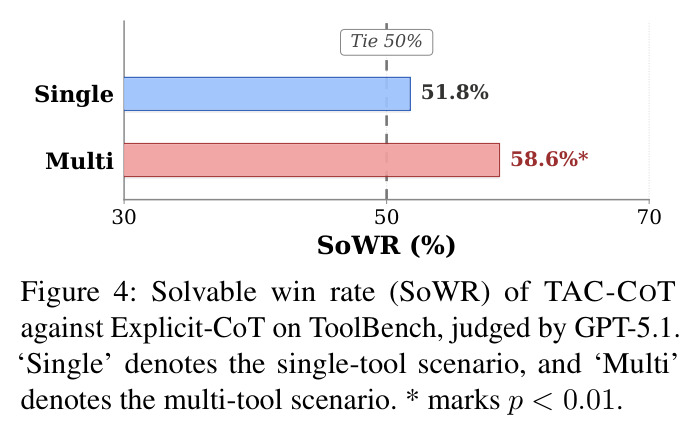
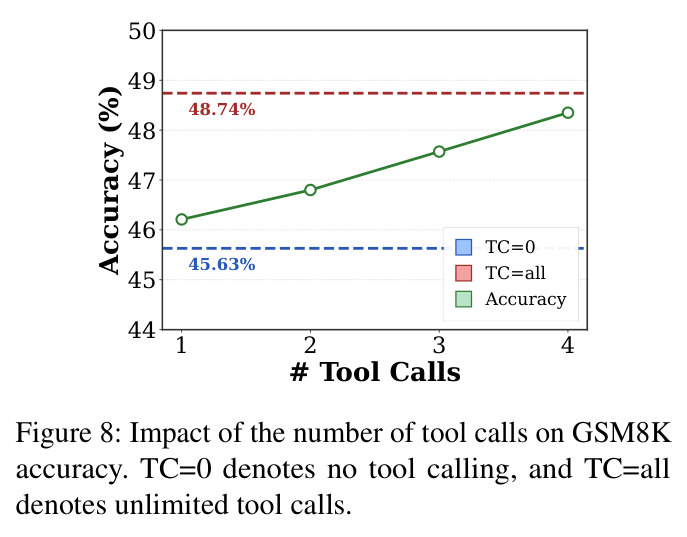
主实验(Table 2)覆盖三个骨干(Qwen2.5-0.5B、Llama-3.2-1B、Qwen3-4B)、六个基准与有无工具两种设定,结论高度一致:TAC-CoT 几乎在所有格子同时取得最高精度和相对显式 CoT 的大幅前向缩减。三骨干平均,数学精度 +5.8 个百分点、QA +2.4 点,最高单项提升 8.8 点(Qwen2.5-0.5B 有工具 GSM8K:61.2 vs 52.4),前向次数最高降 6.8 倍(Qwen2.5-0.5B QA:44.2 vs 283.3 次)。无工具时 TAC-CoT 也全面超过固定预算隐式基线:数学平均 45.4 vs SIM-CoT 31.0、CODI 28.7。诊断实验逐一验证设计目标:(1) Table 3 显示 TAC-CoT 的 AC@5(HotpotQA 51.8)已超过显式基线的 AC@10(51.7),说明更少检索步数内命中证据;(2) Figure 4 显示 ToolBench 单/多工具可解胜率 51.8%/58.6%(多工具 p<0.01),复杂交互获益更大;(3) Table 4 显示隐化 0 到 4 段时精度单调升(41.1→45.4)而前向单调降(113.1→53.7),Figure 5 显示长度失配时 TAC-CoT 退化更小,共同证明误差累积被缓解;(4) Figure 6 显示按 GSM8K 所需推理步数分组,相对 SIM-CoT 的增益从 1 步组 +4.6 点扩大到 4 步组 +30.3 点,证明自适应预算价值;(5) Table 10 显示单卡 L40S 实测墙钟加速 2.3 倍(数学)/2.4 倍(QA),排除外部开销后最高 3.8 倍。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 智能体数学 GSM8K(Qwen2.5-0.5B,有工具) | Accuracy (%) | 61.2(#Fwd 43.9) | Explicit-CoT 52.4(#Fwd 109.2) | +8.8 点,前向降 2.5 倍,p<0.01 |
| 智能体数学平均(Qwen2.5-0.5B,无工具) | Accuracy (%) | 45.4 | 最强隐式基线 SIM-CoT 31.0 | +14.4 点 |
| 智能体 QA 平均(Qwen2.5-0.5B,有工具) | EM (%) | 45.8(#Fwd 44.2) | Explicit-CoT 42.4(#Fwd 283.3) | +3.4 点,前向降 6.4 倍 |
| 智能体数学平均(Qwen3-4B,有工具) | Accuracy (%) | 74.5(#Fwd 40.4) | Explicit-CoT 68.5(#Fwd 110.4) | +6.0 点,前向降 2.7 倍 |
| HotpotQA 检索质量(Qwen2.5-0.5B) | Answer Coverage@5 (%) | 51.8 | Explicit-CoT 48.8 | +3.0 点(且超过基线 AC@10 的 51.7) |
| ToolBench 多工具场景(I2+I3) | Solvable Win Rate (%) | 58.6 | Explicit-CoT | GPT-5.1 评判的可解胜率,p<0.01 |
| GSM8K 需 4 步推理子组(无工具,vs 固定预算隐式方法) | Accuracy (%) | TAC-CoT | SIM-CoT | +30.3 点 |
| QA 实测时延(Qwen2.5-0.5B,单卡 L40S) | ms/样本 | 3187.5(平均 44.2 次前向) | Explicit-CoT 7654.5(244.0 次前向) | 墙钟 2.4 倍加速 |
局限与改进
作者承认两点局限:其一,自适应路由只发生在段级别而非 token 级,$b$ 个隐 token 组成的段是不可再分的原子单位,段内无法提前终止,控制粒度较粗;其二,更长交互视野(longer interaction horizons)下的实际部署稳健性尚未评估。我补充几点观察:其一,训练数据管线强依赖强教师模型——HotpotQA 的 4 万条轨迹由 DeepSeek-V3 合成(花费 102.73 美元,过滤通过率仅 56.24%),答案精确匹配过滤可能系统性丢弃"形式不同但语义正确"的轨迹,且学生会继承教师偏差;其二,隐式推理牺牲了可解释性,出错时只能靠案例研究倒推,无法像显式 CoT 那样直接审计中间步骤,这在高风险应用中是现实障碍;其三,实验限于 0.5B-4B 模型与数学/QA 两类任务,Qwen3-4B 无工具时 QA 平均 EM 仅 31.2,隐式推理在更大模型、代码生成、多轮对话等场景是否保持优势未经验证;其四,#Fwd 缩减 6.4 倍只换来 2.4 倍墙钟加速,差距来自并行开销与 API 延迟,说明工程优化空间尚大;其五,Qwen3-4B 使用 $b=2$ 是出于实际训练条件的妥协,段长的选择缺乏原则性指导,路由决策本身的错误率也没有被单独分析。
独立分析的弱点
独立分析的弱点及改进方向:(1) 路由可靠性存疑——是否调用工具由单次 logits 比较 $\ell_{\text{act}}$ vs $\ell_{\text{ans}}$ 决定,0.5B 小模型在边界情形可能过早作答或过度调用工具,论文未报告路由错误率及其对答案质量的影响;改进方向是引入路由置信度阈值或轻量级价值头做二次确认。(2) 段长 $b$ 全局固定(2 或 3),与"自适应"的精神不完全一致——真正灵活的方案应让段长随段内推理内容伸缩,可用早退(early-exit)机制或 token 级路由实现。(3) 数据管线可迁移性差——数学依赖 GSM8K-Aug 的算式标注对齐,QA 依赖 DeepSeek-V3 蒸馏加答案过滤,换一个新领域就要重做整套流程;改进方向是用强化学习(环境奖励直接优化路由与隐式推理)替代蒸馏式数据合成。(4) 可解释性缺失导致调试困难,可训练一个按需启用的探针解码器,把隐式段"翻译"回文本供人工审计。(5) 评测口径存在噪声空间——ToolBench 用 MirrorAPI 模拟而非真实 API,QA 每个数据集只采样 1000 例(95% 置信下最差误差约 ±3.1 点),而部分 QA 提升(如 TriviaQA 上 54.8 vs 53.3)幅度接近这一噪声水平,结论强度需谨慎解读。
未来方向
作者明确提出两个方向:把自适应路由细化到 token 级;在更长交互视野下评估实际部署。基于论文成果还可延伸:(1) 与强化学习结合——用任务奖励和环境反馈端到端优化路由策略与隐式段内容,摆脱对教师轨迹合成的依赖,并与 R1 式可验证奖励训练接轨;(2) 动态段长——让模型在段内自我评估推理充分性,提前退出或延长,实现真正的 token 级预算控制,这也呼应作者的第一点局限;(3) 在长视野智能体基准(SWE-bench、WebArena 类数十步交互任务)上验证隐式推理的稳定性,考察 KV cache 随段数增长的开销;(4) 隐式段的机制可解释性——用稀疏自编码器或线性探针研究连续 token 究竟编码了什么、能否被读取出来做审计;(5) 与 KV-cache 压缩路线(如论文引用的 KAVA)正交结合,同时压缩推理侧与上下文侧成本;(6) 把交错隐式段用作多智能体间的紧凑通信介质,降低多智能体系统的 token 交换开销。
复现评估
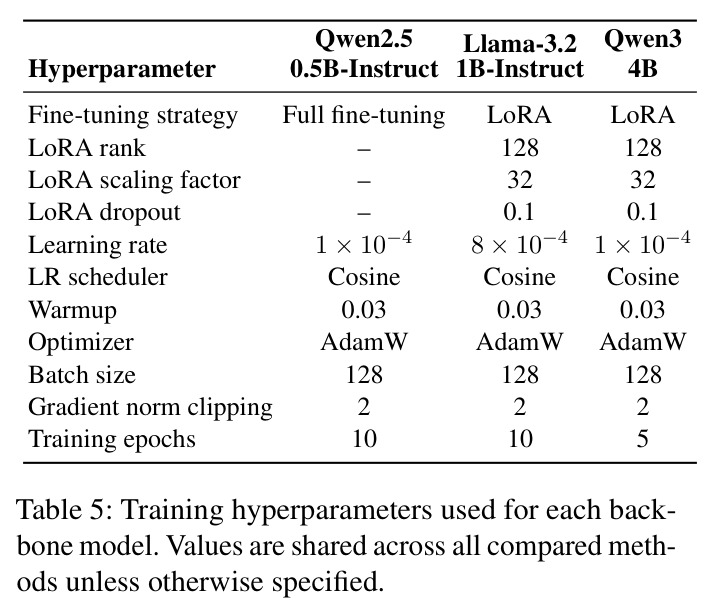
复现条件总体友好但有一处关键缺口。可复现的部分:论文给出完整超参数表(Table 5:Qwen2.5-0.5B 全参微调 lr $10^{-4}$,Llama-3.2-1B 与 Qwen3-4B 用 LoRA rank 128、$\alpha=32$,AdamW、cosine 调度、batch 128)、推理循环伪代码(Figure 10,含投影层结构 Linear→GELU→Linear→LayerNorm 与路由/观察注入细节)、QA 轨迹合成 prompt(Figures 11-12),以及数据成本(102.73 美元)。所有评测数据集(GSM8K-Aug(-NL)、GSM-Hard、SVAMP、HotpotQA、2WikiMultihopQA、KILT-TriviaQA、ToolBench/StableToolBench)均公开,QA 评测用每数据集 1000 个随机样本并给出样本量估计依据。缺口:正文未提及开源代码或模型权重,4 万条 DeepSeek-V3 合成轨迹是否释放未知,自行重建需要 API 预算且只有约 56% 通过率。算力需求温和:最大 4B 模型用 LoRA,推理测量单张 L40S 即可完成,训练预计单卡到少数卡可行。总体难度中等:有经验的工程师约一至两周可实现核心管线,但完全对齐论文数字(尤其教师轨迹质量带来的方差)存在不确定性。
论文图表
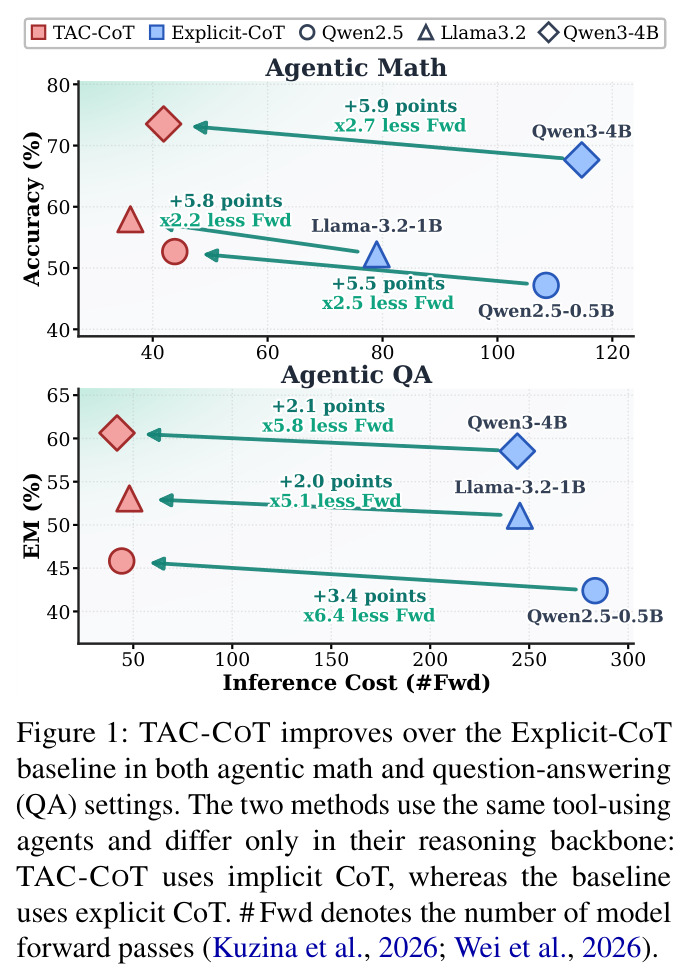
以推理成本(前向次数 # Fwd)为横轴、精度/EM 为纵轴的散点图,对比 TAC-CoT 与 Explicit-CoT:TAC-CoT 的点一致位于左上方,即精度更高且前向更少;覆盖 Qwen2.5、Llama3.2、Qwen3-4B 三个骨干的数学任务和 QA 任务。
论文的 teaser 图,一图概括全部核心主张:隐式推理骨架加工具交错同时带来精度与效率双赢,是读者建立第一印象的入口。
两个完整案例:数学题中 Explicit-CoT 把加班费率误用于全部 45 小时得 $940,SIM-CoT 固定预算直接猜 210,TAC-CoT 每步算式都有计算器托底得正确答案 $460;QA 题(808 海里外的岛)中 SIM-CoT 无检索幻觉出 Wake Island,Explicit-CoT 被 O'ahu 误导并编造事实,TAC-CoT 利用失败搜索的相似结果列表找到 Laysan 并验证。
具体展示三种方法的失败与成功模式,直观说明隐式推理加工具托底如何同时避免计算错误与事实幻觉。
四步伪代码:(1) 编码问题前缀并缓存 KV;(2) 循环 $B$ 次,末层隐状态经 Proj 反馈为连续 token;(3) 读取 logits 比较 action 与 answer 路由;(4) 贪婪生成动作 token 直到 </action>,闭合 token 与观察拼接后一次前向注入,回到第 2 步。投影层为 Linear→GELU→Linear→LayerNorm。
复现的核心工程细节:连续 token 如何绕过词表反馈、路由与观察注入如何用 KV cache 高效实现。
把 DeepSeek-V3 设定为 ReAct 风格 Wikipedia 智能体的完整 prompt:只允许 Search[实体]、Lookup[关键词]、Finish[答案] 三种动作、每轮一个动作、思考先于行动,并附 3 个 ReAct few-shot 演示。
数据构造完全透明,是复现 HotpotQA 轨迹合成管线(4 万条、56.24% 过滤通过率)的直接依据。